

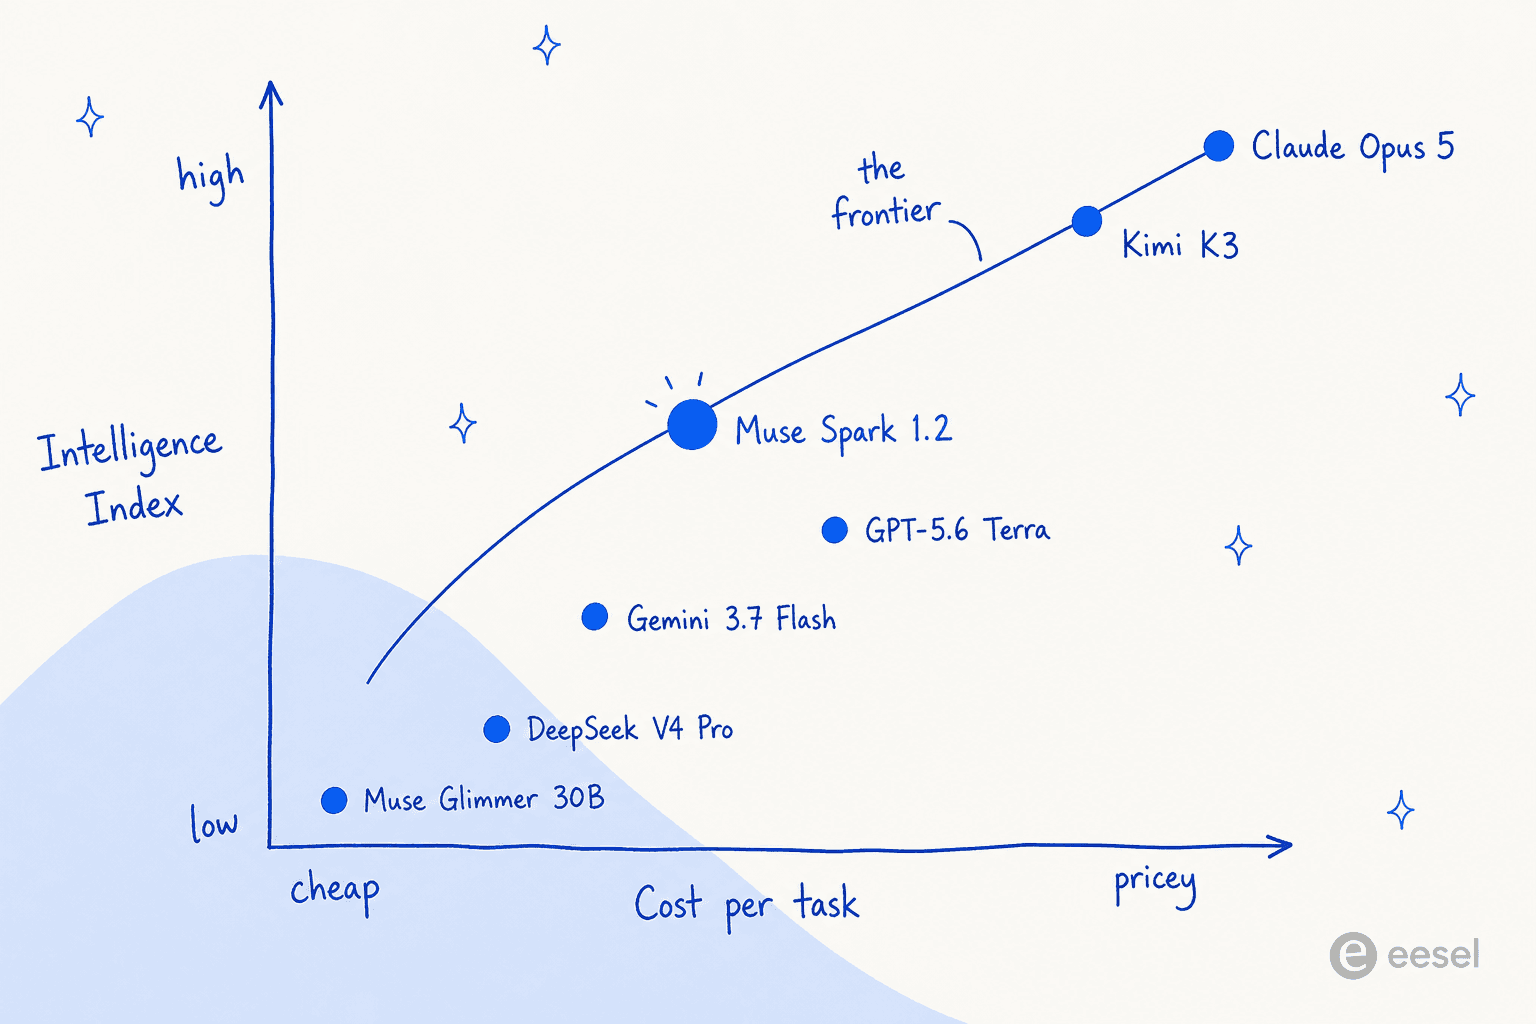
「Muse Spark 1.2の代替」を扱う記事の多くは、このモデルはもう時代遅れだと切り出します。そんなことはありません。Artificial Analysis Intelligence Indexで、Muse Spark 1.2よりタスクあたりのコストが低くて、スコアが高いモデルは存在しません。20モデル中7位の56.76で、1タスクあたり$0.3992です。ランキングでこれより上のモデルは、すべてコストが高くなります。
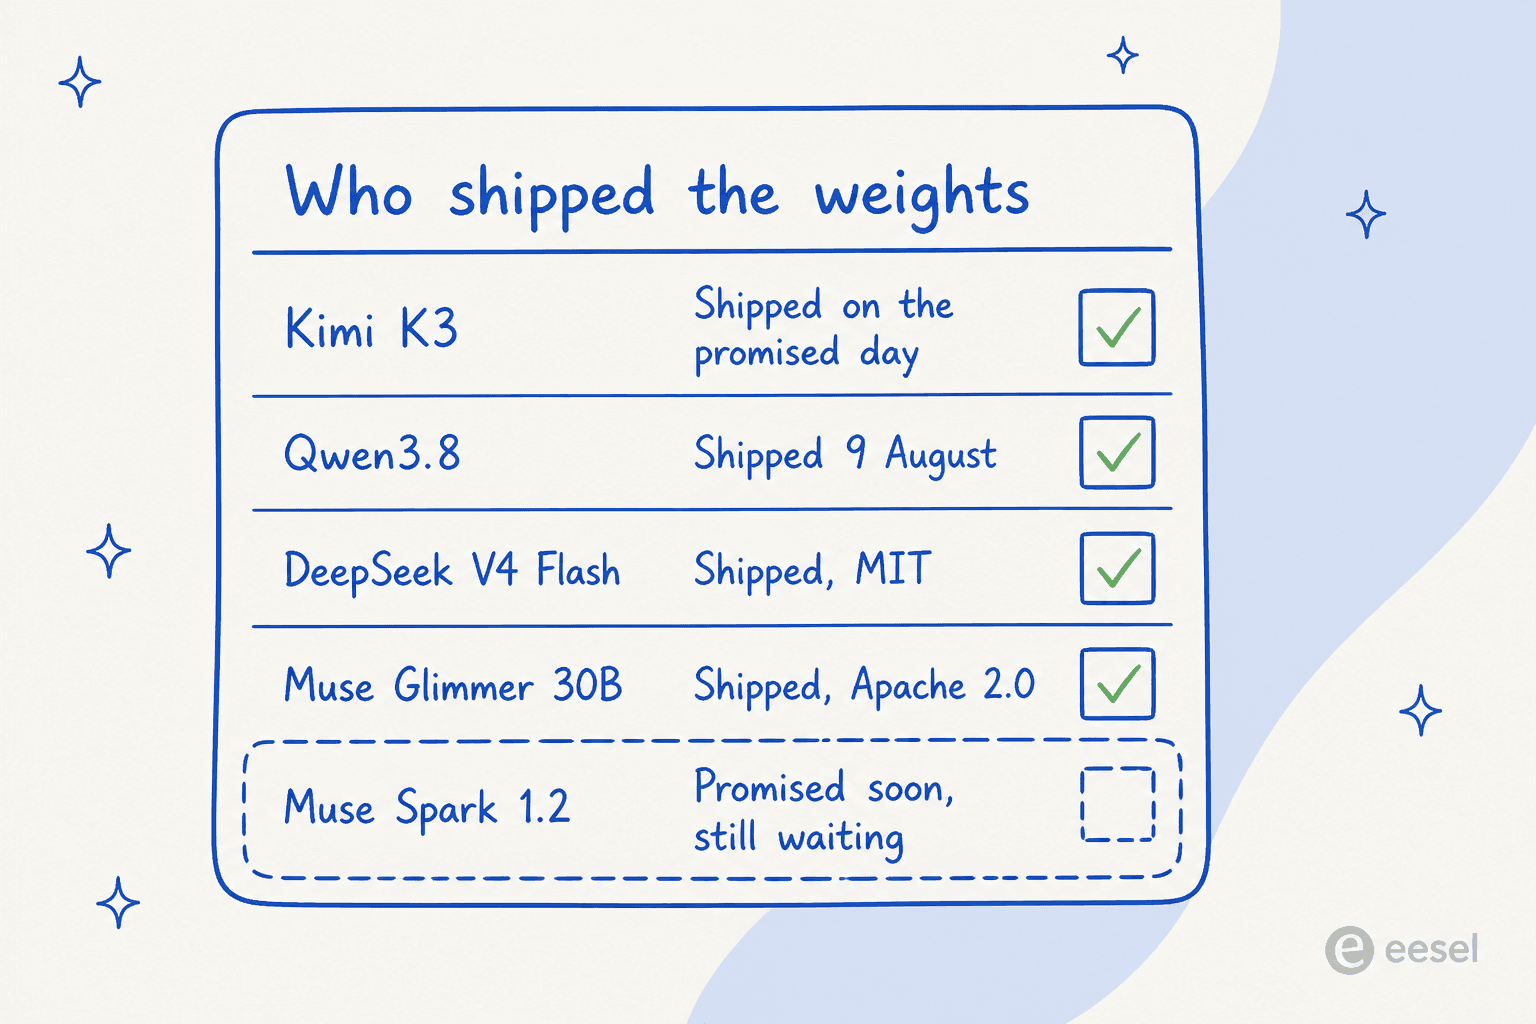
だから、乗り換える正直な理由は性能とは関係ありません。MetaのChief AI Officerは8月10日にMuse Spark 1.2のオープンウェイトを約束しましたが、ライセンスも日付も示されず、8日後の今も何も公開されていません。一方でMoonshotは、約束したまさにその日にKimi K3を公開しました。Qwenは8月9日に公開し、DeepSeekは数か月前からすでにMITです。
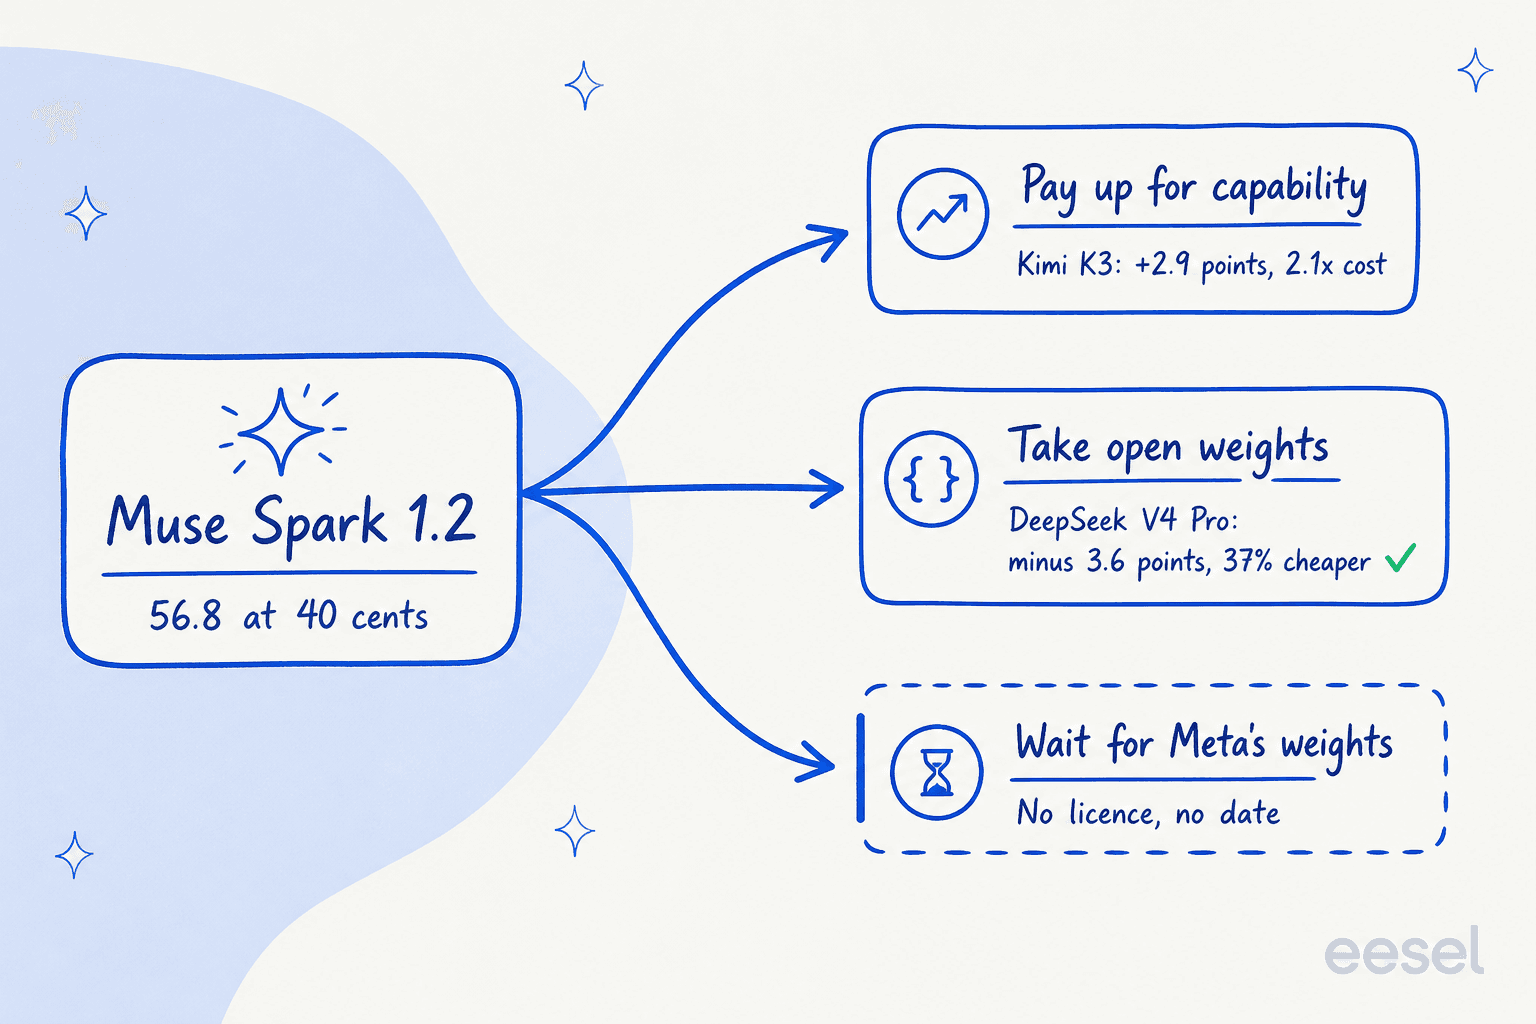
これで選択肢はかなりはっきり分かれます。本物の性能向上のためにより多く払うか、インデックスのポイントを手放して、自分で所有できる重みを取るかです。両方をより安く満たす選択肢は存在しません。以下で8つの代替モデルを、実際の数字でランク付けします。
1週間かける前にひとつだけ注意があります。選ぶモデルがサポートチケットに答えるなら、ボトルネックがモデル自体であることはめったにありません。私が一緒に働いたチームのAIは、データベースにまったくないブランドについて「はい、お客様の車種に対応しています」と自信満々に答えていました。ヘルプセンターに「全車種に対応しています」と書いてあったからです。どんなインデックススコアも、この一文は直せません。直せるのは検索です。
なぜ皆がMuse Spark 1.2の先を見ているのか
私はeeselでインテグレーションとAPI基盤を作っているので、新しいモデルが出るたびに、発表記事は飛ばして料金表とレート制限、そしてモデルのページを読みに行きます。Muse Spark 1.2が興味深いのは、はっきりした理由があります。ここでは、マーケティングとデータが通常とは逆の方向でずれているのです。発表時の打ち出し方は、価格性能比での実際の位置を過小評価し、所有できるものを過大に見せました。
人々が別のモデルを探し始める理由は、実際には3つあります。
重みは約束であって、ダウンロードではありません。 MetaのChief AI Officerは、オープンウェイト版が「近日中に」来ると言いました。Metaの認証済みHugging Face組織には現在4つのリポジトリがありますが、4つともMuse Glimmerです。Hugging Face全体でMuse-Sparkを検索しても、誰のものも結果はゼロです。
誰もモデルを独立して検証できません。 ランキングの大半のモデルについて、Artificial Analysisは出力速度とレイテンシを公開しています。Muse Spark 1.2では、その2つの欄が空白です。同じ表にあるMuse Glimmerにはそれがあります。このモデルの価格は分かっても、どれだけ速く答えるかは測れません。
安い枠は、あなたのトラフィックを代償にします。 muse-spark-1.2-contributor IDは入力が12.5倍安く、Meta自身のドキュメントは、これをプロンプトと出力を学習に使う許可と引き換えの割引価格だと説明しています。この取引の計算は、Muse Spark 1.2の料金の解説ですでに扱いました。
Metaの発表の4日前、あるHacker Newsのコメント投稿者は、Meta自身の投稿よりも上手く重みを公開すべき理由を述べていました。
"Meta, please go back to publishing weights. Your models aren't top-tier, this wouldn't hurt you at all at your current position in the rankings. They wouldn't have the best open-weight models, but the best western open-weight models."

Metaは4日後にまさにそれを行いましたが、公開したのは30Bの生徒モデルでした。フロンティアモデルのほうは、形容詞をもらっただけでした。
この8つの選び方
次の3つの基準で、この順に並べました。
ベンダーのグラフではなく、独立したスコア。 このページのインデックスの数字はすべて、Artificial Analysis Intelligence Index v4.1.1のものです。9つの評価を実行するので、どのラボも自分で比較対象を選べません。Muse Spark 1.2の発表時のグラフが、バージョン間でエージェントハーネスを入れ替えていたことを考えると、これは重要です。
定価ではなく、タスクあたりのコスト。 100万トークンあたりの料金が隠すのは、冗長さです。Muse Spark 1.2はインデックスの1タスクごとに30,430の出力トークンを使うので、実際のコストは見出しの$1.25から連想される額をかなり上回ります。実際の請求書に耐える数字は、タスクあたりのコストです。
重みが存在するかどうか。 リストの各モデルについて、プレスリリースを信じるのではなく、実際のリポジトリのライセンス欄を確認しました。8つのうち2つは、よく言われる説明とは異なるライセンスでした。
明らかな名前を1つ外しています。このリストにeeselのモデルはありません。eeselはモデルベンダーではなく、自分の雇用主をベンチマーク表に入れることこそ、この種の記事を役に立たなくするからです。
比較表
インデックスのスコアとタスクあたりのコストは、2026年8月18日に確認したArtificial Analysisのモデルボードによるものです。トークン料金は、同じ日に確認した各ベンダーの料金ページによるものです。
| モデル | インデックス | コスト / タスク | 入力 /1M | 出力 /1M | コンテキスト | 重み | ライセンス | 向いている用途 |
|---|---|---|---|---|---|---|---|---|
| Claude Opus 5 | 63.05 | $2.3369 | $5.00 | $25.00 | 1M | なし | プロプライエタリ | ランキングで最高の上限 |
| GPT-5.6 Sol | 60.93 | $1.2312 | $5.00 | $30.00 | 1.05M | なし | プロプライエタリ | OpenAIのツールでのフロンティア級の作業 |
| Grok 4.6 | 60.92 | $0.8367 | 変動 | 変動 | 2M | なし | プロプライエタリ | 中程度のコストでほぼフロンティア |
| Kimi K3 | 59.70 | $0.8375 | $3.00 | $15.00 | 1.05M | あり | Kimi K3 License | Muse Sparkを実際に上回るオープンウェイト |
| Qwen3.8 Max | 58.08 | $1.1320 | $2.00 | $6.00 | 1M | ベースのみ | qwen3.8-max | オープンな代替手段を持つホスト型の高性能 |
| Muse Spark 1.2 | 56.76 | $0.3992 | $1.25 | $4.25 | 1.05M | なし | プロプライエタリ | この記事で扱っている現行モデル |
| GPT-5.6 Terra | 56.58 | $0.5080 | $2.00 | $12.00 | 1.05M | なし | プロプライエタリ | より良いツールでの同等の置き換え |
| Gemini 3.7 Flash | 56.03 | $0.4022 | $0.75 | $3.75 | 1.05M | なし | プロプライエタリ | ほぼ同じコストで速度を優先 |
| DeepSeek V4 Pro | 53.20 | $0.2521 | $0.66 | $1.98 | 1M | あり | MIT | ここで最も安い寛容なライセンス |
| GPT-5.6 Luna | 52.32 | $0.0471 | $0.20 | $1.20 | 1.05M | なし | プロプライエタリ | ホスト型モデルの価格の下限 |
| Muse Glimmer 30B | 35.06 | $0.0732 | ローカル | ローカル | 131K | あり | Apache 2.0 | 自分のGPUでMetaのモデルを動かす |
ここに示したDeepSeekの料金はオフピーク時のものです。Geminiの料金は導入価格で、2026年12月31日まで適用されます。
コストを性能に対してプロットすると、判断の形はずっと分かりやすくなります。
乗り換えのルートを選ぶ
8つ全部を読む代わりに、候補を本当に分ける1つの質問に答えてください。
Muse Spark 1.2が満たしてくれない、本当に必要なものは何ですか?
1つ選んでください。どの答えにも代償があり、その数字を示しています。
Intelligence Indexの首位で63.05、Muse Spark 1.2より6.29ポイント上です。長いコンテキストの割増なしで、1Mのコンテキスト全体を標準価格で使えます。
代償:タスクあたり$2.3369に対して$0.3992。約11%の性能向上に5.9倍を支払います。
インデックス59.70で、20行のランキングでMuse Spark 1.2を上回る唯一のオープンウェイトモデルです。重みはMoonshotが言った日に公開されました。
代償:タスクあたり$0.8375、つまり2.94インデックスポイントのために2.1倍のコスト。ライセンスは独自のもので、MITではありません。
独自条件のないMITライセンスで、インデックスは53.20、信頼できる選択肢の中でタスクあたり最安の$0.2521です。コミュニティのリポジトリが662あり、そのうち316が量子化版です。
代償:Muse Spark 1.2より3.56インデックスポイント下で、UTCのピーク時間帯は料金が2倍になります。
Muse Sparkから蒸留された、Meta自身のApache 2.0モデル。約4ビットで20GB未満で動きます。今日ダウンロードできる実在のMetaモデルです。
代償:インデックス35.06で、Muse Spark 1.2より21.70ポイント下。有能なローカルエージェントですが、フロンティアの代替ではありません。
1. Claude Opus 5
向いている用途: 間違った答えのコストがAPIの請求額より大きいチーム。
Anthropicのフラッグシップは63.05でランキングの首位です。ここで唯一、Muse Spark 1.2との差が、ベンチマークハーネスなしでも気づくほど大きいモデルでもあります。
Muse Spark 1.2に勝る点。 インデックスで6ポイントで、実際には、序盤のミスが積み重なる長い多段階のタスクで差が出ます。また1Mのコンテキスト全体を標準価格で提供し、90万トークンのリクエストも9千トークンのリクエストと同じトークン単価で請求されると、Anthropicははっきり明記しています。OpenAIもxAIもこれはしていません。
勝らない点。 コストで、大差がつきます。そして、ほとんどの記事が触れないこと:Opus 5のAA-Omniscienceハルシネーション率は14ポイント上昇して50%になりました。インデックスのスコアが高いことは、より正直なモデルであることと同じではありません。
料金。 100万トークンあたり、入力$5.00、キャッシュ読み取り$0.50、出力$25.00。バッチは半額です。キャッシュ書き込みは5分のTTLで$6.25です。この上限が必要以上なら、Claude Sonnet 5は、9月1日に予定されていた値上げをAnthropicが取り消したため、今は恒久的に$2.00と$10.00です。
結論: 間違いが高くつき、トークン代は気にならないときの正しい選択です。大量の分類処理なら見送ってください。そのタスクが使わない性能のために、タスクあたり5.9倍を払うことになります。
2. Kimi K3
向いている用途: 本当の要件が「オープンウェイトで、今のより良いもの」という人。
Moonshotのフラッグシップは、このリストで最も興味深い1本です。人々がMetaに求めると言う2つの条件の両方を満たす唯一のモデルだからです。スコアは59.70でMuse Spark 1.2より上、しかも重みは今日、今すぐダウンロードできます。
Muse Spark 1.2に勝る点。 3ポイント近い差に加えて、自分でホストできる2.8兆パラメータ。注目すべきはこの点です。Moonshotの技術ブログは重みを2026年7月27日までに公開すると述べ、Hugging Faceへの最初の公開コミットは2026年7月27日です。名指しした日付を、その日のうちに守りました。
勝らない点。 2つあります。タスクあたりのコストは$0.8375で、2倍以上です。次にライセンスで、多くの記事が主張する内容とは違います。リポジトリ自身のメタデータはlicense: otherとlicense_name: "kimi-k3"で、Moonshot独自のライセンスです。オープンウェイトではありますが、寛容なオープンソースではありません。Openness Indexは38.89で、Muse Glimmerの44.44より下です。
料金。 100万トークンあたり、入力$3.00、キャッシュヒット$0.30、出力$15.00で、低予算ではなくClaude Sonnetの価格帯です。私のKimi K3レビューでは、どのレベルでも切れない推論エフォートの挙動に踏み込んでいます。
結論: Metaの重みを待っていた人にとっての標準的な答えです。タスクあたり約2倍を払い、公開前にライセンスを丁寧に読む必要はありますが、今日存在し、測定上も確実に優れています。
3. Qwen3.8 Max
向いている用途: 今はホスト型モデルで、後でセルフホストの退路も欲しいチーム。
Alibabaのフラッグシップはホスト版で58.08です。この項目では、執筆の途中で自分の調査に訂正されました。今月初めのQwen 3.8の重みは、約束されたまま未公開で、今のMuse Spark 1.2とまさに同じ立場でした。その後、8月9日に公開されました。
Muse Spark 1.2に勝る点。 ホスト版でインデックス1.32ポイント上で、オープンなベースのQwen3.8-2.4T-A95B単体でも57.70です。つまり、ダウンロードできる版でも、あなたが乗り換えようとしているモデルを上回ります。
勝らない点。 タスクあたりのコストは$1.1320で、ほぼ3倍です。オープン版はホスト製品と機能が同等でもありません。Qwen自身のモデルカードには、ホスト版のMaxには画像入力、非思考モードのサポート、標準で1Mのコンテキスト、組み込みツールが加わると書かれています。そしてライセンスはまた独自のqwen3.8-maxで、Apacheではありません。
料金。 100万トークンあたり、入力$2.00、暗黙的キャッシュ読み取り$0.25、出力$6.00。明示的キャッシュの読み取りは$0.17と安いものの、作成に100万トークンあたり$2.50かかるので、何度も繰り返すプレフィックスでしか元が取れません。実用的なアクセス方法はQwen3.8 Maxへのアクセス方法にまとめました。
結論: このリストで最良の保険です。ホスト型から始めて、モデルファミリーを変えずに自社ハードウェアへ移れます。Qwen3.8 Maxレビューには人間の選好の数字があり、自動化されたインデックスより好意的な方向を示しています。
4. GPT-5.6 Terra
向いている用途: スコアより周辺のツールが重要な、同等の置き換え。
OpenAIの中位モデルは56.58で、Muse Spark 1.2より0.18ポイント下です。実用上、2つは同じ性能で価格だけが違うモデルで、Metaの発表がSolではなくTerraと比較したのもそのためです(GPT-5.6 Sol)。当時あるコメント投稿者がこれに気づいていました。
"They chose to compare against Open AI's mid tier model Terra instead of Sol and still lost some benchmark against it. They left Opus in and got beat in all but one benchmark. Nothing wrong with trying to improve, but why the marketing games?"
Muse Spark 1.2に勝る点。 主にエコシステムです。Terraは、チームがすでに使っているであろうツールの中で動き、OpenAIはMetaが出していない速度とレイテンシの数値を公開しています。
勝らない点。 タスクあたり27%高く、しかもスコアはわずかに低いです。長いコンテキストの崖もあります。OpenAIのモデルページによれば、入力が272Kトークンを超えるプロンプトは、超過分だけでなくリクエスト全体が入力2倍、出力1.5倍で課金されます。Muse Spark 1.2には長いコンテキストの割増が一切ありません。
料金。 100万トークンあたり、入力$2.00、キャッシュ$0.20、出力$12.00で、これは長いコンテキストの倍率をかける前の額です。この崖がどこで効いてくるかは、GPT-5.6の料金の解説にあります。
結論: ツールと公開されたレイテンシの数値のために乗り換えるのであって、性能のためではありません。プロンプトが日常的に272Kトークンを超えるなら、移行する前に計算してください。
5. Gemini 3.7 Flash
向いている用途: スループットが制約になる大量処理。
GoogleのFlashシリーズは、タスクあたり$0.4022で56.03を記録し、どちらの軸でもMuse Spark 1.2と誤差の範囲に収まります。違いは、Googleが速度を公開していることです。Artificial Analysisは毎秒340.1トークンと計測し、測定した188モデル中1位です。
Muse Spark 1.2に勝る点。 計測された速度と、入力$0.75という安い定価。ここで、意図的に性能を下げることもできる唯一のモデルでもあります。lowエフォートでは、タスクあたり$0.16で50.9を記録し、分類作業ならそれが正解であることも多いです。
勝らない点。 現実的な注意点が2つあります。現在の料金は2026年12月31日までの導入価格で、2027年1月1日に$1.50と$7.50に倍増します。今組むコストモデルには崖が含まれることになります。ハルシネーション率も、前のバージョンの55.6%から64.5%に悪化しており、Gemini 3.7 Flashレビューで掘り下げました。
料金。 2026年末まで、100万トークンあたり、入力$0.75、キャッシュ$0.075、出力$3.75。最大出力は65,536トークンで、このリストの他のモデルよりかなり小さいです。
結論: Muse Spark 1.2への不満が実際にレイテンシなら最良の選択です。Metaのレイテンシは測ることすらできません。1月の価格変更は、後で驚かないよう今のうちに予算に入れてください。
6. DeepSeek V4 ProとV4 Flash
向いている用途: 好きに使える、最も安い重み。
スコアではなくライセンスで勝つ項目です。V4 Proはタスクあたり$0.2521で53.20を記録し、これもDeepSeek V4 Flashも、リポジトリのメタデータにはシンプルなmitライセンスが書かれています。独自条件はなく、横に利用ポリシーもありません。
Muse Spark 1.2に勝る点。 価格と自由度です。タスクあたり37%安く、MITライセンスで、この比較で最も厚いコミュニティのエコシステムがあります。検索すると662のリポジトリが見つかり、そのうち316が量子化版です。このエコシステムのおかげで、セルフホストが理屈の上だけでなく現実的になります。
勝らない点。 インデックスで3.56ポイント下がります。計画に入れておくべき癖もあります。DeepSeekはピーク時に2倍を請求し、ピークはUTCの01:00から04:00と06:00から10:00と定義されています。ヨーロッパのサポート窓口は毎日その時間帯に当たりますが、米国ではほとんど当たりません。データポリシーについては、DeepSeekの有料APIの規約は学習への利用を許可するのではなく言及していない状態で、インフラは中国の法律の下にあります。
料金。 V4 Proはオフピークで入力$0.66、出力$1.98で、ピーク時は倍になります。V4 Flashはオフピークで$0.22と$0.66とはるかに安く、スコアは51.77です。ピーク時間の計算は、DeepSeek V4 Flashの料金の記事で詳しく説明しています。
結論: 要件が「MITの重みで、安く」なら、これが答えで、リストの他に競合するものはありません。ワークロードが規制対象の顧客データに触れるなら、まずデータの所在地を解決してください。
7. GPT-5.6 Luna
向いている用途: フロンティアモデルで動かすべきではなかった、大量処理の作業。
Lunaはタスクあたり$0.0471で52.32を記録します。これはインデックススコアの92%を、Muse Spark 1.2の8.5分の1のコストで得られるということで、大量の分類処理を回している人が構成全体を見直すべきだと思わせる、ここで唯一の数字です。
Muse Spark 1.2に勝る点。 コストで、劇的に差があります。ほとんどの本番ワークロードはフロンティア向きではありません。タグ付けとルーティング、抽出、要約に、56ポイントものインデックスはまず要りません。Lunaは完全なホスト型で、レイテンシも公開されており、Metaのモデルにはないものです。
勝らない点。 4.44ポイント下で、その差は本格的な多段階の作業では現れます。これは働き者であって、推論者ではありません。
料金。 100万トークンあたり、入力$0.20、キャッシュ$0.02、出力$1.20で、GPT-5.6ファミリーの他のモデルと同じ、272K超の長いコンテキストの倍率がかかります。
結論: 表の中で最も過小評価されている行です。すべてを高いモデルへ移行する前に、トラフィックを分けて、そのうち実際に高いモデルが必要な割合を確かめてください。
8. Muse Glimmer 30B
向いている用途: 自分が所有するハードウェアで、今日Metaのモデルを動かす。
Metaの重みが欲しくてここに来たなら、実在するのはこれです。Glimmerは、Muse Sparkから蒸留された、Apache 2.0の下の297.8億パラメータで、コンテキストは131,072トークン、知識のカットオフは2026年1月です。
Muse Spark 1.2に勝る点。 ダウンロードできます。Metaは約4ビットに量子化しており、言語モデルは20GB未満になって、24GBのカードに収まります。タスクあたりのコストは$0.0732で、Openness Indexを持つ唯一のMetaモデルで、44.44です。コミュニティの反応はすぐに来ました。今ではGlimmerのリポジトリが296あり、755,125ダウンロードのunslothのGGUFビルドは、Meta自身の重みのリポジトリを上回っています。
勝らない点。 35.06対56.76は21.70ポイントの差で、ローカルで使える便利さではこれは埋まりません。ライセンスについて知っておくべき補足もあります。本物のApache 2.0のテキストの横に、リポジトリにはMeta作成のUSAGE_POLICY.mdが同梱されていて、未成年者による利用を制限し、軍事、兵器、重要インフラ向けの用途を禁じています。Apache 2.0はそうした条件を課さないので、実際にはApacheに加えて方針の文書が付いている形です。
料金。 ダウンロードは無料で、その後は自分の計算資源です。32GBのMac miniで動かしたある開発者は、実際にそれが何を意味するかを率直に語っていました。
"I am getting good results with muse-glimmer running locally, with the caveat that everything runs slowly (e.g., give it a task and then go walk outside or do Qi Gong exercises for a while)."
結論: ローカルエージェントのモデルとしては非常に優れていますが、Muse Sparkの代わりとしては不向きです。格下げの道ではなく、別のツールとして扱ってください。
コミュニティは実際に何と言っているか
Muse Spark 1.2への評価は、1本の線ではっきり割れます。ベンチマークを読んだ人はそのランキングを批判し、実際に動かした人は、無駄なトークンの少なさを称賛します。どちらも正しく、それが発表時の反応がこれほど矛盾して見える理由です。
最も鋭い懐疑的な見方は、発表当日に出ました。
"Somewhat surprised that Meta with all their resources couldn't make a model that matches Composer on any frontier. All the Sparks are dominated by some other model everywhere along the frontier. The use traces must be crucial to functionality which is why they're keeping prices so low."
2週間の独立した計測で、これにはある程度の答えが出ました。現在のArtificial Analysisのボードでは、Muse Spark 1.2は価格性能比で支配されてなどおらず、自分のコスト帯でフロンティア上にあります。コメントの後半、データ獲得戦略としての価格設定という部分は、はるかによく当たっています。
重みについての異論は、実のところ今回の発表に対するものではありません。その前の発表に対するものです。
"Meta in this case, started nicely with Llama, then switched to closed models, kicked out researchers to build data labeler CEO empire inside Meta. Now opening again, what's next? closing again?"
そして、私が最もよく見た立場は「乗り換える」でも「残る」でもありませんでした。オープンな成果物は受け取り、ホスト製品は断るというものでした。
"I'd also argue this is the case for any company releasing open weights. They're not righteous, they're marketing. That's not necessarily a bad thing! [...] I still will not use a hosted Meta product, but damn this model looks solid."
バランスのために:発表への最も声高な肯定は、BoxのCEOによるもので、彼はこれを製品の発売ではなく、カテゴリーの転換として読みました。
"Meta releasing Muse Spark 1.2 as open weights is a very big deal. America now finally has its response to the open weights AI race."
ただし、その反応は約束に対するものでした。8日が過ぎても、ダウンロードはまだ存在しません。
どの乗り換えでも解決しないこと
ここは私が最も気にしている部分です。私はこれらのモデルの下にあるレイヤーで仕事をしてきたからです。
一般的なコーディングやリサーチのワークロードで8つから選ぶなら、上の表でほぼ足ります。しかしMuse Spark 1.2の代替を探している人の多くは、間違った答えを返すサポート自動化を直そうとしています。その問題の解決策がモデルの入れ替えであることは、ほとんどありません。
冒頭に挙げた例は、私が知る中で最も分かりやすいものです。あるB2Bの技術サポートチームのAIは、データベースにない車のブランドについて、「はい、お客様の車種に対応しています」と自信満々に答えていました。モデルが壊れていたわけではありません。ヘルプセンターに「全車種に対応しています」とあり、AIがその一文を検索で取り出し、与えられた文章から正しく答えたのです。56.8のモデルから63.1のモデルに替えても、この結果は何も変わりません。失敗は推論ではなく、検索で起きたからです。
同じことはベンチマークのデータにも表れています。Muse Spark 1.2のAA-Omniscienceの正答率は、1.1の52.0%から45.4%へ実際には下がり、ハルシネーション率は50.0%から33.3%に改善しました。知識が増えたのではなく、答えるのを控えるのが上手くなったのです。汎用アシスタントなら妥当なトレードですが、サポートエージェントには不向きです。そこでは、答えを控えてもそれはチケットのままだからです。
サポートの精度を、モデルよりも大きく動かすものは3つあります。
- AIが何を見られるか。 ヘルプセンターの記事だけでなく、過去の解決済みチケット。ほとんどのツールは公開されたドキュメントだけで学習するので、まさに「全車種に対応しています」をそのまま繰り返してしまいます。
- 確信がないときに何をするか。 ライブの返信ではなく下書きへ、確信度に基づいてルーティングし、確信度の低い回答が顧客向けのミスではなくエスカレーションになるようにします。
- 顧客より先にテストしたか。 自社の過去のチケットでシミュレーションすることで、実際の解決率が分かります。公開インデックスのスコアが示すのは、他の誰かの数字だけです。
これらについてはサポート向けAIモデルで、失敗パターンそのものについてはサポートにおけるAIのハルシネーションでさらに詳しく書いています。
サポート業務にeeselを試す
モデルの比較にたどり着いた理由が、サポートAIが間違った答えを返し続けていることなら、モデルの等級は回すべきダイヤルではありません。eeselはAIチームメイトで、Zendesk、Freshdesk、Gorgias、HubSpot、Frontにつながり、初日から、公開のナレッジベースだけでなく、解決済みチケットの履歴からも学習します。
上記すべてに関わる要点はこれです。顧客に一度も触れる前に、自社の過去のチケット全体でシミュレーションを実行し、実際の解決率をテーマ別に確認できます。Gridwiseは最初の1か月でティア1リクエストの73%が解決されました。課金はチケット1件につき1クレジット(プランは月$299から500クレジット)で、予測できない100万トークン単位ではないため、このページにあるピーク時間や長いコンテキストの計算は、あなたの悩みではなくなります。

無料で試せて、カードは不要。1日以内に、そもそもモデルが問題だったのかどうかが分かります。eeselを試す。
結局、どれを選ぶべきか
このページから1つだけ持ち帰るなら、これにしてください。Muse Spark 1.2は、ドルあたりの性能では悪くない取引で、スコアだけを理由に乗り換えると、得るものより失うもののほうが多くなります。
乗り換えるなら、具体的な理由で。間違った答えが高くつくなら、Claude Opus 5が最も大きな実質的な差を買えます。今あるものを上回る重みが必要なら、Kimi K3が両方を満たす唯一のモデルで、タスクあたりのコストは約2倍です。MITが要件なら、答えはDeepSeekで、そこのライセンスはクリーンです。そして不満が速度なら、速度を公開しているのは、2つのうちGemini 3.7 Flashだけです。
そしてまだMetaの重みを待っているなら、実績を思い出す価値があります。Moonshotは日付を示し、それを守りました。Alibabaは1週間以内に公開しました。DeepSeekはずっとMITです。Metaは生徒モデルと形容詞を公開しました。
よくある質問
Meta Muse Spark 1.2のおすすめの代替モデルは?
Muse Spark 1.2はオープンソースですか?
muse-spark-1.2は重みが公開されていないプロプライエタリなAPIモデルです。Metaは8月10日にオープンウェイト版が近日中に出ると発表しましたが、ライセンスも日付も明示せず、その後何も公開されていません。実際にオープンなMetaのモデルは、Apache 2.0のMuse Glimmer 30Bです。全体像はオープンソースAIエージェントのまとめをご覧ください。Muse Spark 1.2の料金は代替モデルと比べてどうですか?
muse-spark-1.2 IDは入力100万トークンあたり$1.25、出力が$4.25で、Intelligence Indexの1タスクあたり$0.3992になります。これは、$0.8375のKimi K3の料金より、また$2.3369のClaude Opus 5より、タスクあたりで安くなります。Muse Spark 1.2の料金の詳しい内訳は料金の解説記事にあります。Muse Spark 1.2に最も近いオープンウェイトモデルは?
カスタマーサポート用途でMuse Spark 1.2から乗り換えるべきですか?
Muse Glimmer 30Bとは何ですか? Muse Spark 1.2の代わりになりますか?
Muse Spark 1.2に無料枠はありますか?
muse-spark-1.2-contributor IDは、Metaが今後のモデルの学習にあなたのトラフィックを使う代わりに、入力$0.10、出力$0.20で使え、上限は毎分100リクエストです。データを渡さずに請求額を下げたいなら、タスクあたり$0.0471のGPT-5.6 Lunaが、ランキングで最も安いホスト型の選択肢です。