

Metaは2026年8月5日にMuse Spark 1.2を公開し、コーディング向けのリリースだと説明しました。しかし独立した数値を読むと、コーディングこそが最も動いていない部分です。Artificial Analysisでは、Terminal-Benchが2.2ポイント動いた一方で、エージェント指数は9.6、GDPval Eloは254動きました。1.1を悩ませていた汎用エージェントの崩れは修正されましたが、Metaはそれを1文で触れただけでした。
2つ目に知っておくべきこと。Metaの主要なコーディングチャートは、2つの変数を同時に変えています。Muse Spark 1.2はMetaの新しいターミナルエージェントであるMuse Code内でベンチマークされ、1.1はmini-swe-agentでベンチマークされています。さらに、モデルはこのハーネスと共同で学習されています。つまり目にする差はモデルとハーネスの合算であり、チャートはその2つを切り分けてくれません。
3つ目は価格で、これがリリースの中で最も興味深い部分です。同じモデルにIDが2つあります。100万トークンあたり$1.25/$4.25か、Metaにトラフィックでの学習を許可すれば$0.10/$0.20です。通常の配分で約16倍になります。私はeeselでサポートキュー向けのAIエージェントを作っていますが、指摘したいのは、商談を潰すのを何度も見てきたパターンです。ボトルネックはモデルではありませんでした。ある購入検討者は、当社のエージェントに対して67項目の丁寧なテストを実施し、ナレッジの回答は堅実だと評価しながらも、チャットウィジェットが遅く、何度も固まったために離脱しました。トークンが安くなっても、トークンの周りにある問題は解決しません。
Metaが8月5日に実際に公開したもの
Metaの開発者ブログでMatthias ResoとJosh Waltersから2つが同時に発表されました。モデルと、それを動かすために作られたエージェントです。
Muse Spark 1.2がモデルです。Meta自身の説明は異例なほど控えめで、1.2を"a moderate improvement over Muse Spark 1.1"と呼び、"multi-file refactors, long debugging sessions and tasks that run well past a single prompt"に最適化したとしています。リサーチ記事はさらにあけすけで、このリリースを"our next step toward the frontier, with larger and much more capable models on the way."と位置づけています。Metaの誰もここでフロンティアモデルだとは主張していませんし、私はその言葉をそのまま受け取ります。これは、消費者向けの取り組みにより大きな約束が付く、MetaのAI推進の他の部分とは異なる姿勢です。
Muse Codeはベータ版のエージェントです。コマンド1つでインストールでき、ターミナルで動き、並列のサブエージェントを起動し、行ったことをすべて記録します。これがこのリリースで新しい部分であり、多くの報道が見落とした部分だと思います。これまでターミナル向けAIコーディングツールを使ったことがなければ、それが属するカテゴリです。
Muse Spark 1.1から変わらず引き継がれたものが3つあります。1,048,576トークンのコンテキストウィンドウ、標準料金表、そしてクローズドウェイトです。モデルの外で変わったのは利用可能な地域です。Metaは公開プレビューを米国外にも拡大しました。米国外から1.1に届かなかった人にとっては、これが本当の見出しでした。
Artificial Analysisはすでに Muse Spark 1.1を非推奨と表示し、1.2へ誘導しており、Metaが系譜をどう読ませたいかが分かります。
Muse Spark 1.2が実際に改善した点
ホワイトボードに書いておきたい部分です。Metaはこれをコーディングモデルとして売り出しました。コーディングの数値が最も動いていません。
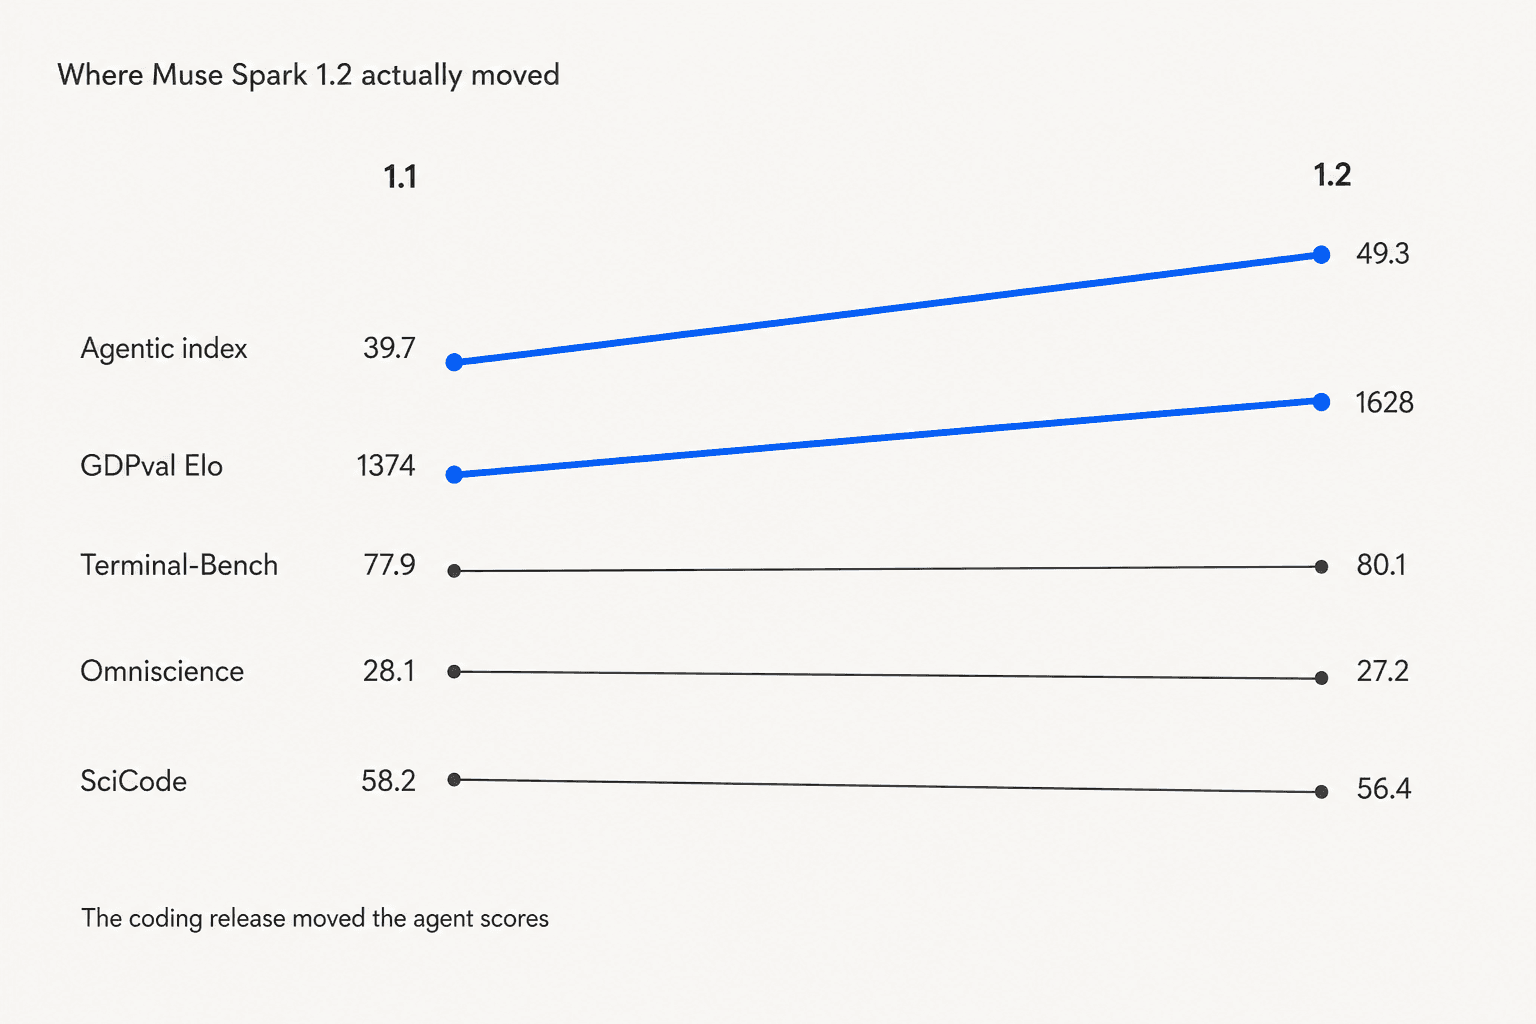
以下はすべてArtificial Analysisによるもので、両バージョンを同じハーネスで実行しており、だからこそ比較に価値があります。
| ベンチマーク | Muse Spark 1.1 | Muse Spark 1.2 | 変化 |
|---|---|---|---|
| エージェント指数 | 39.7 | 49.3 | +9.6 |
| GDPval-AA v2 (Elo) | 1374 | 1628 | +254 |
| Intelligence Index | 53.2 | 56.8 | +3.6 |
| tau-3 Banking | 31.8% | 34.9% | +3.1 |
| CritPt | 15.1% | 17.7% | +2.6 |
| Terminal-Bench 2.1 | 77.9% | 80.1% | +2.2 |
| AA-LCR (長いコンテキスト) | 81.3% | 83.3% | +2.0 |
| GPQA Diamond | 89.8% | 90.4% | +0.6 |
| Humanity's Last Exam | 46.2% | 45.5% | -0.7 |
| AA-Omniscience Index | 28.1 | 27.2 | -0.9 |
| SciCode | 58.2% | 56.4% | -1.8 |
コーディングのベンチマークであるSciCodeは後退しました。Metaが前面に出したコーディングベンチマークのTerminal-Benchは、エージェント指数の約5分の1しか動いていません。一方でGDPval-AA v2は、実際の専門的な成果物を盲検でペア比較して採点する評価ですが、254Eloポイント動き、Metaのチャート上でモデルをそのボードの最下位からOpus 5に次ぐ2位へ押し上げました。
私のMuse Spark 1.1レビューで、そのモデルの最も奇妙な点は中心にある矛盾だと指摘しました。Metaはエージェントモデルとして売り込んでいましたが、独立したエージェント評価が最悪の結果だったのです。1.2が埋めたのはその穴です。ただし、Metaのローンチ記事が指している穴ではありません。
今の顔ぶれの文脈を示すと、56.8でMuse Spark 1.2はそのボードの20モデル中13位で、63.1のClaude Opus 5や60.9のGrok 4.6の後ろ、56.6のGPT-5.6 Terraをわずかに上回っています。
ハルシネーションの数値は二度読む必要がある
同じ出典からもう1行。単一の指数スコアが隠してしまう類のものだからです。Artificial AnalysisはAA-Omniscienceを正確性とハルシネーション率に分けています。
| 指標 | Muse Spark 1.1 | Muse Spark 1.2 |
|---|---|---|
| 正確性 | 52.0% | 45.4% |
| ハルシネーション率 | 50.0% | 33.3% |
1.2はハルシネーションが約3分の1減り、正解は約8分の1減りました。答えを控えることを覚えたのです。顧客が向こう側にいる用途では本物の改善であり、答えを必要とする用途では本物の後退で、総合指数はわずかに悪化しています。間違った答えのコストが高いワークフローでモデルを選ぶなら、このトレードオフがおそらくこの記事で最も重要な数値であり、Metaのどのチャートにも載っていません。この問題のより広い話はサポートにおけるAIハルシネーションに、検出する側のツールはLLMトラッキングツールにあります。
Meta自身のチャートにあるハーネスの落とし穴
ここからが、ローンチ記事を読み返すきっかけになった部分です。
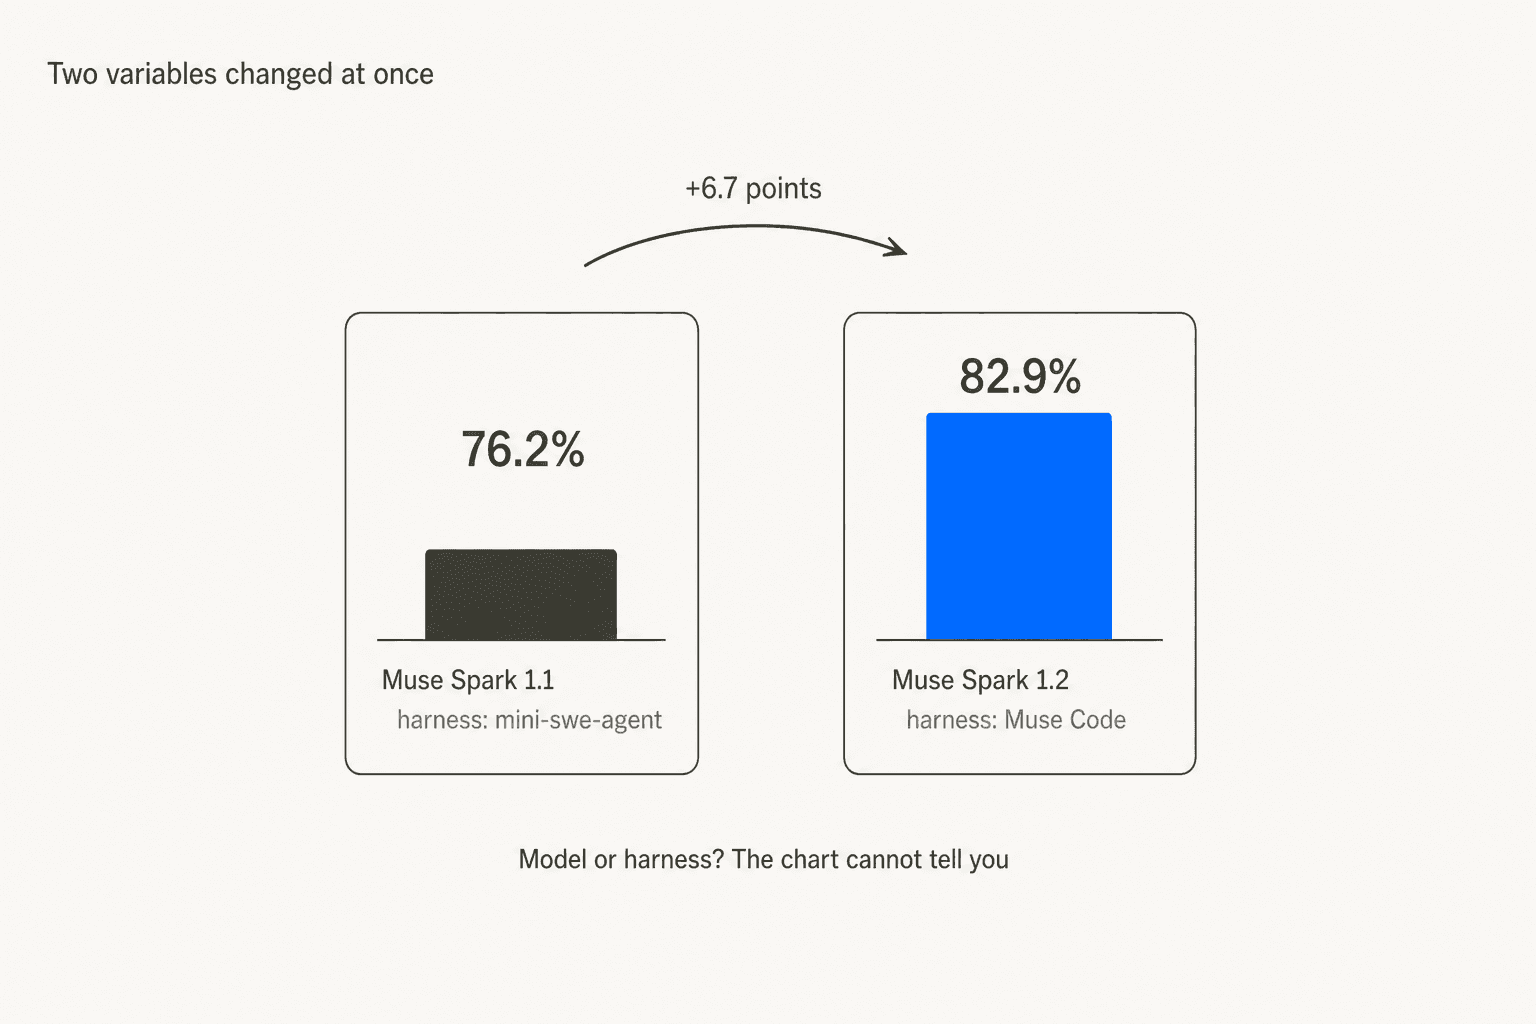
MetaのTerminal-Bench 2.1チャートは、Muse Spark 1.2を82.9%、Muse Spark 1.1を76.2%と示しています。各棒の下の小さな灰色の文字には、それぞれのモデルが動いたハーネスも書かれています。1.2はMuse Code、1.1はmini-swe-agentです。DeepSWEのチャートも同じです。Metaは隠していません。ちゃんと印刷されているのですが、目は棒を読み、脚注は読みません。
Metaはまた、"co-trained Muse Spark 1.2 with Muse Code"と明言しており、"rejection sampled harness trajectories"や、ゴール、コンパクション、サブエージェントのレシピ最適化も含まれます。つまりモデルは、採点されるハーネスに合わせて調整されたのです。
ハーネスが明記されていない唯一のチャートはMetaの社内コーディングベンチで、ページの中で最も差が小さいものです。
| モデル | Meta Internal Coding Bench |
|---|---|
| Opus 5 (max) | 79.4% |
| Muse Spark 1.2 | 70.6% |
| Muse Spark 1.1 | 68.3% |
| GPT 5.6 Terra (max) | 65.4% |
| Gemini 3.6 Flash (high) | 63.9% |
2.3ポイント。ハーネスが変数でなくなるチャートでの差です。変数である場合のTerminal-Benchの6.7ポイント、DeepSWEの6.3ポイントと比べてみてください。Metaが何かを細工したと言いたいのではありません。このモデルを自分のツールで動かすなら、ハーネスを統制した数値こそが体験を予測するもので、それがページ上で最も小さい数値だ、と言いたいのです。
Hacker Newsのローンチスレッドのコメントが、この一般的な話を私よりうまく言い表していました。
"Outputs are a little bit more deterministic if you control the harness. It is easy to benchmark across one harness, one system prompt and extract the most performance when you control the harness."

ちなみに、これはMeta固有の問題ではありません。いまやどのラボも自社のエージェントを出し、その中でベンチマークしています。Claude CodeからCodex、Grok Buildまで同じです。ここではMetaがチャートにハーネス名を印刷したため、特に分かりやすいだけです。
Muse Code、本当に新しい部分
Muse Codeは1行でインストールでき、任意のプロジェクトディレクトリでmuseとして動きます。
curl -fsSL https://dev.meta.ai/install.sh | bash
設計の核はファンアウトです。1回のプロンプトで親エージェントにタスクの束を渡すと、タスクごとに書き込み可能な子を、それぞれ独自のgit worktreeで起動するため、並列の子どうしが同じファイルに触れることはありません。
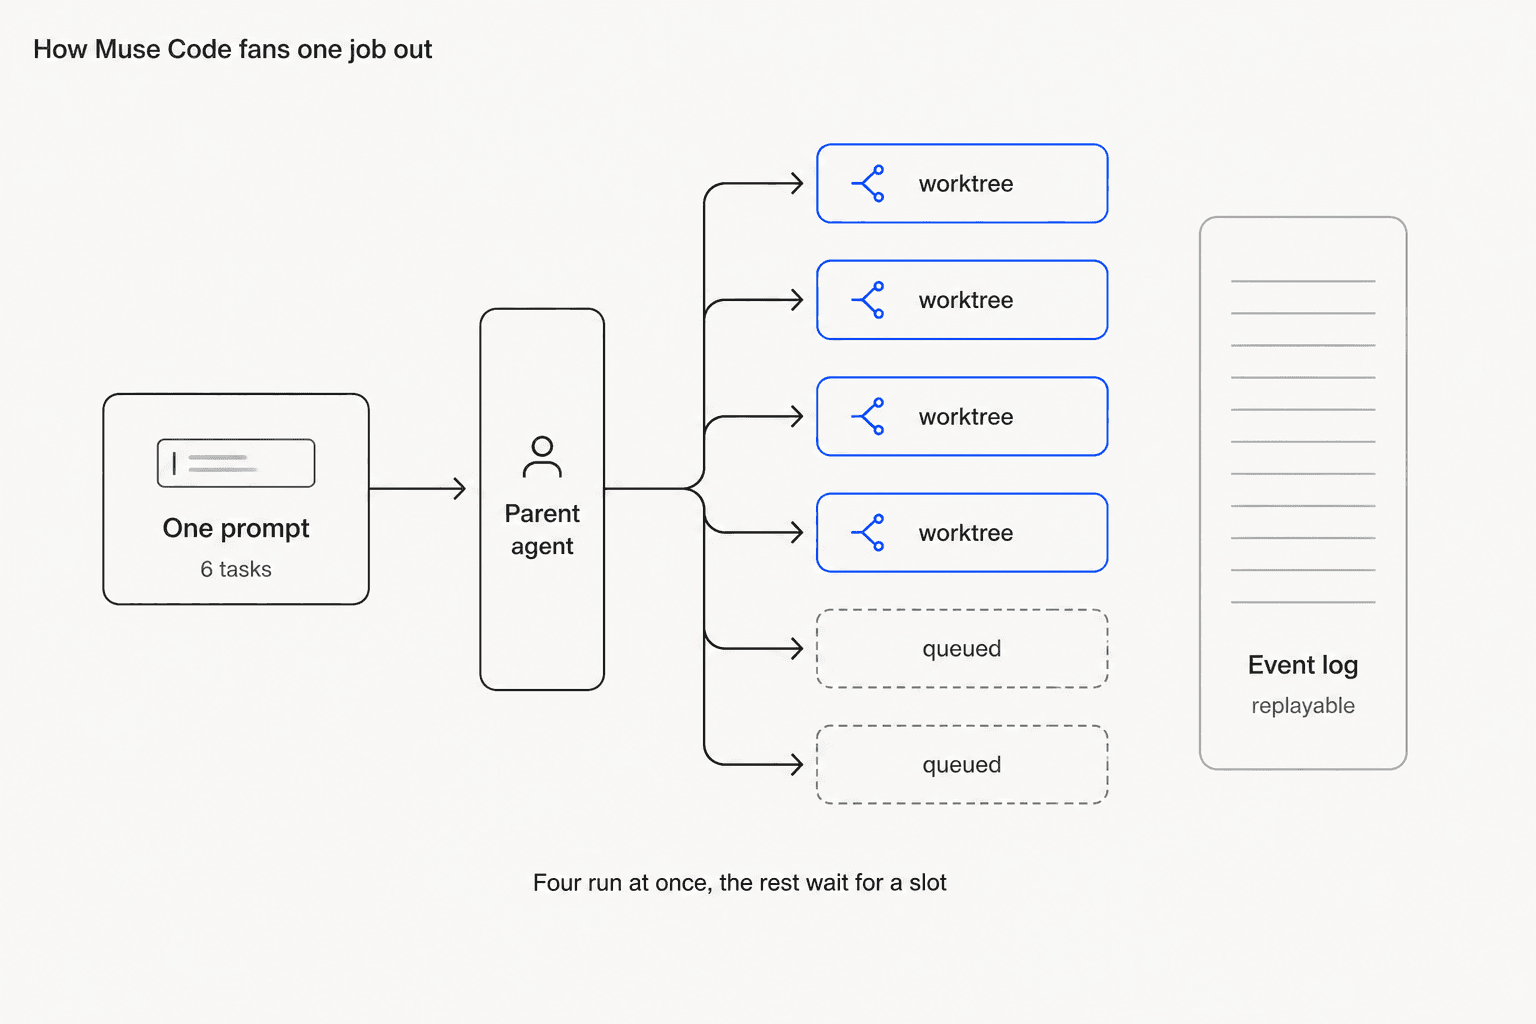
Meta自身のファンアウトのクックブックでは、サンプルのゲームリポジトリで6タスクのバッチを説明しています。親は6つの子を起動し、ホストの同時実行上限は4になるため、5番目と6番目のタスクは空きが出るまで待機します。
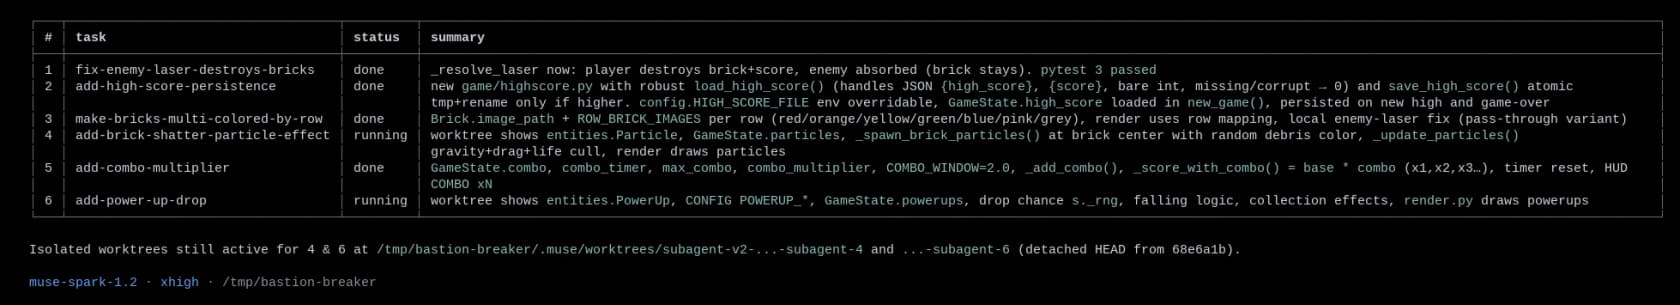
subagent_statusはその一覧を返し、各子のタスク、状態、変更内容の1行要約が含まれます。Meta自身のキャプチャにあるステータスバーに注目してください。muse-spark-1.2 · xhighです。デモでは努力レベルが高く設定されており、数値を自分の請求額と比べるときに覚えておく価値があります。worktreeは.muse/worktrees/の下にdetached-HEAD状態で、親のHEADからチェックアウトされ、手動のgit worktreeコマンドは不要です。Metaの実行では、バグを直した子は自分のworktree内で全テストスイートに合格し、親のmasterは同じテストにまだ失敗しています。
ほかに2つ挙げておく価値のある要素があります。
- 再生可能なイベントログ。 すべてのモデル呼び出し、ツール実行、承認、編集が、ディスク上のプレーンなJSONLに追記され、
jqで検索できます。同じログがmuse resumeを支えているため、クラッシュしたセッションは最初からプロンプトし直すのではなく、最後に記録されたステップから再開します。 - 同梱のスキル。 4つのプレイブックが組み込まれています。
/plan(実際のファイルに基づいて計画を立て、承認のために止まる)、/grilling(判断を迫る質問を1つずつあなたに投げかける)、/grill-with-docs、そして/taste(避けるべきビジュアルの初期設定を並べたアンチスロップのチェックリスト)です。明示的に呼び出したときだけ動くため、エージェントが勝手に/grillを使うことはなく、スキルは呼び出したターンだけ読み込まれます。
このカテゴリがどう形作られているかをもっと詳しく知りたければ、私のエージェント型コーディングCLIの記事がその全体像を扱っています。自前で作るのは別のプロジェクトで、Metaがここで作ったものに最も近い比較はClaude Code SDKの解説です。
ツール市場全体については、おすすめのAIコーディングアシスタントツールのまとめがあります。既存の本命と比べて検討する人は、Claude AIコーディングアシスタントの概要から始めてください。
Muse Codeについての正直な感想です。サブエージェントごとのworktree分離と、完全に再生できるイベントログは良いエンジニアリングで、Hacker Newsのコメント投稿者の反応は私と同じく、"Muse code is more interesting than the new model."でした。いま使っているハーネスに勝てるかどうかは、ベータ版とブログ記事では答えられません。
Muse Spark 1.2の料金とコントリビューターの取引
Metaは1つのモデルに2つのモデルIDを用意しており、その差こそが話の核心です。
| モデルID | コンテキスト | 入力 / Mtok | キャッシュ入力 / Mtok | 出力 / Mtok | データポリシー |
|---|---|---|---|---|---|
muse-spark-1.2-contributor | 1M | $0.10 | $0.002 | $0.20 | "Used to improve our products" |
muse-spark-1.2 | 1M | $1.25 | $0.15 | $4.25 | "Not used to improve our products" |
これらのラベルはMeta自身の文言で、モデルページにあるものです。標準レートは1.1から変わらないため、すでに旧モデルに支払っていたなら、1.2は価格面では無料のアップグレードです。
コントリビューターティアはリクエスト数ではなく、5時間のローリングウィンドウ内のトークン数でレート制限され、Metaは一部の国で利用できるとしています。Metaはまた、営業窓口経由でゼロデータ保持のリクエストを受け付けるようになったと述べており、これが標準ティアの法人向けの入口です。
入力と出力が3:1の通常の配分では、コントリビューターIDが100万トークンあたり$0.125、標準が$2.00になります。16倍で、その為替レートはあなたのトラフィックです。
これを確かめるための2つの数値です。Artificial Analysisは標準レートでMuse Spark 1.2をIntelligence Indexタスクあたり$0.399と測定しました。モデルがより多く考えるため、1.1の$0.292から37%増です。同じトークン配分をコントリビューターの料金表に当てはめるとタスクあたり約$0.017になり、そのボードで最も安いモデルである$0.027のDeepSeek V4 Flashを下回ることになります。この2つ目の数値は、AAが公表しているタスクあたりのトークンコストに基づく私自身の計算であり、実測値ではありません。また、Metaが公表していないキャッシュ書き込みが入力レートで課金されると仮定しています。DeepSeekとの比較は、じっくり考える価値があります。あのモデルはオープンウェイトで、誰にも学習されない場所で動かせるからです。全体像は私のDeepSeek V4 Flashレビューにあります。
標準レートでも、価値の主張は成り立ちます。Muse Spark 1.2はIntelligence Indexで56.8、タスクあたり$0.399。Claude Opus 5は63.1で$2.34です。指数が11%高いために6倍のコストです。その11%が重要かどうかは、完全にあなたのワークロード次第で、これはClaude Opus 5の代替で述べたのと同じ議論です。
推論コストについて1つ注意があります。Artificial Analysisが指数全体を実行するのにかかった$639.27のうち、$339.82は目に見えない推論トークンに使われました。Metaの/effortコントロールでそれを上げ下げでき、単純なタスクでは最初に触るつまみです。料金表だけでは予測しにくいAnthropic APIの料金も、同じ隠れた項目のせいです。
開発者の反応
ローンチスレッドは333ポイント、266コメントを集め、反応ははっきり分かれました。価格は興味深い、信頼の問題は決着していない、そしてハーネスへのロックインは現実だ、というものです。
価格については、反応は即座でした。
"If you are happy to share data for training, the contributor mode offers amazing price $0.10 / $0.20"
別の人は、同じ事実をデータにどれほどの価値があるのかという問いとして表現しました。
"Very interesting they have a way cheaper "contributor" version "used to improve our products", how much of that is price discrimination vs the data being that valuable? Roughly DeepSeek V4 Flash pricing, though you can get V4 from providers that don't train on your data"
Meta自身のエージェント以外でモデルを使おうと考えている人にとって最も鋭いデータは、まさにそれを試した開発者から出ました。
"It's useless. Tried with OpenCode + OpenRouter and it couldn't complete an simple task. It stuck using grep/search tools. I think Muse Spark was so heavily RL'd on the Meta harness that it make it useless or very token inneficient to use in other harness like Opencode."
これは1人の実行結果であり、モデルが"still generalizes to other coding agents you already use."ように複数のハーネスで学習したというMetaの主張と真っ向から食い違います。私はどちらも決着したとは見なしません。ワークフローを移す前に、自分のツールで少額の有料テストを行い、最初に確かめるべき具体的なポイントとして扱います。1つの環境に強く合わせて調整されたドメイン特化モデルにも、同じ助言が当てはまります。
別のコメント投稿者はOpenRouterでスループットを毎秒約150トークンと測定しており、このクラスでは高速です。APIそのものはOpenAI形式のリクエストを受け付けるため、置き換えはほぼベースURLの変更で済み、OpenAIとAnthropicのAPIで扱った移行と同じ形です。
そして「グローバルアクセスの拡大」という記述には、コントリビューターティアが依然として米国のみだと報告した少なくとも1人のユーザーから、はっきりと反論がありました。Meta自身の文言は見出しより狭く、安価なIDは"available in select countries"であり、モデルが世界中で使えるという約束とは違います。
オープンウェイトは来るが、日付はない
ローンチの4日後、MetaのChief AI Officerは、3世代のモデルにわたって多くの人が待っていた発表をしました。
"1/ big announcement today: we will be releasing an open weight version of muse spark 1.2 soon. we also are releasing muse glimmer, a 30B agentic model with open weights under apache 2.0. muse glimmer can run on 24GB of VRAM without losing agentic reliability. 🧵"
Glimmerは公開されました。Spark 1.2の重みはまだで、"soon"にはライセンスも日付もありません。実際に今ダウンロードできるもの、つまりApache 2.0の30B版Glimmerを前提に計画し、オープンウェイトのSparkは来ればうれしい驚き程度に考えます。Metaには、隣接するものを先に出してきた前例があります。同じパターンがMuse Imageでも見られました。
オープンウェイトこそがこの記事を読んでいる理由なら、今日提供されている有力な代替はQwen3.8 Maxです。残りの2つのどちらにするかを選ぶ前に読むなら、DeepSeek vs Kimi K3の比較です。
では、誰が実際にMuse Spark 1.2を使うべきか
数値と1週間付き合ったうえでの結論です。
- 予算を抑えて長時間のエージェント作業を回すなら、試す価値あり。 エージェント指数の上昇は本物で、コンテキストは本物の1Mであり、標準レートでタスクあたり約$0.40とOpus 5の約6分の1です。カーネル最適化のケーススタディが実像を示しています。1,000回超のツール呼び出し、最大24時間で、Muse Spark 1.2はベースライン比+68.7%に達し、6モデル中4位で、+74.0%のOpus 5、+71.2%のGPT-5.6 Sol、+69.6%のOpus 4.8に続きました。終点ではなく曲線を読むと、出だしも遅く、200回のツール呼び出しで約27%、その時点でOpus 5はすでに60%を超えていました。たどり着きますが、遠回りをします。
- コードが機密でないなら、試す価値あり。 コントリビューターティアはオープンウェイトモデル並みの価格で、何を対価にしているかをMetaがはっきり示しています。個人プロジェクト、OSS、使い捨てのプロトタイプなら、単純にイエスです。
- ボードの頂点が必要なら、おそらく不向き。 Opus 5はMetaが公開したすべてのチャートで首位で、Meta自身の社内チャートも含まれます。GPT-5.6 Solも指数では上にいます。不足しているのが知性ではなく生の速度なら、Gemini 3.6 Flashがより安価な答えです。
- ハーネスに全面的に賭けるなら、今はおそらく不向き。 最も強いコーディング数値はMuse Codeとの組み合わせによるもので、Muse Codeはベータ版であり、他の環境で動かした唯一の公開報告は芳しくありませんでした。この組み合わせは、移行ではなくテストを勧めます。
- 仕事がカスタマーサポートなら、単独では不向き。 ハルシネーションの減少と同時に起きた正確性の低下は、まさにサポート業務が気にするトレードオフで、どちらの数値もAPIから修正できません。キューで実際に機能する選択肢は私のおすすめのAIエージェントのまとめに、予算の考え方はAIカスタマーサービスのコストにあります。
eeselを試す
最後の点で締めくくりたいのは、これが私が毎四半期チームに見るミスだからです。このようなモデルのリリースは、サポート自動化プロジェクトを価格の判断のように見せます。そうではありません。muse-spark-1.2と、実際の顧客に安全に答えられるAIのあいだには、自社コンテンツに対する検索、信頼度のしきい値、エスカレーションのルール、そしてAIが何をするかを実行する前に知る方法があります。それがAIエージェントとチャットボットの違いであり、プロジェクトが実際に存在する場所です。
eeselはその層です。すでに使っているヘルプデスクに接続し、一般的なウェブクロールではなく自社の解決済みチケットから学習し、まずチケット履歴でシミュレーションするので、顧客が1人も目にする前に解決率と回答を確認できます。このシミュレーションの段階があるのは、自信ありげなボットが静かに誤った回答を返すのを見てきたからで、33%のハルシネーション率は本番で初めて知りたい数字ではありません。

キューが溢れているのでモデルを評価しているなら、反対側から始めてください。直近の数千件のチケットでシミュレーションを実行し、実際に何が解決されるかを確認してから、トークンについて議論してください。無料で試せて、開始にカードは不要です。
この判断の初期段階にいる方には、さらに2つの読み物があります。私のサポートに最適なLLMの記事は、モデル選びをきちんと扱っています。ビジネスケースの数字はAIエージェントと人間のコストにあります。
よくある質問
Meta Muse Spark 1.2の料金はいくらですか?
muse-spark-1.2 IDは、入力が100万トークンあたり$1.25、キャッシュが$0.15、出力が$4.25で、Muse Spark 1.1の料金と同じです。muse-spark-1.2-contributor IDは、入力$0.10、キャッシュ$0.002、出力$0.20で、Metaのモデルページにはトラフィックが製品改善に使われると明記されています。推論トークンはどちらも出力レートで課金されます。