

Reflection AI Beam とは?
Beam は、元 Google DeepMind の研究者2人が2024年に立ち上げたラボ、Reflection AI の初のモデルです。内部はスパースな Mixture-of-Experts(MoE)モデルで、総パラメータは 5010 億、各トークンでアクティブなのは 230 億です。学習の狙いはコーディングと推論の作業で、さらにエージェントのワークロードも対象です。
そのため、Kimi K3、Qwen3.8 Max、DeepSeek V4 Flash と同じ土俵に立つことにもなります。
また、今年のもう1つの米国製オープンウェイトの挑戦である Inkling の隣にも位置します。
私は仕事で AI エージェントを作っているので、ローンチ記事は試乗前の車のスペックシートのように読む癖があります。大事なのは、最終的に請求書とレイテンシのログに表れる数字です。Beam の場合、数字が面白いのは主にその作られ方です。
- 事前学習:
23.8Tトークンを、6,144基の NVIDIA GB300 GPU で4週間未満のうちに最初から最後まで実行。Reflection のローンチ記事による。 - 強化学習:
10.5K基の GB300 GPU で4週間、ほぼ100万の学習環境にわたり100 million超のロールアウトを生成。 - アーキテクチャ:
52層、ローカルとグローバルのアテンションを交互に配置、ほぼ均一に使われる細粒度のルーテッドエキスパート(最も忙しいエキスパートでも平均負荷の1.04x)。 - 入力: テキストのみ。API では画像、音声、ファイル入力は未対応。OpenAI 互換ドキュメントによる。
- ライセンス: Apache 2.0。FP8 と NVFP4 の量子化版とともに「今月中」と約束されている。Reflection のローンチスレッドによる。
ローンチは大きな注目を集めました。X の公式投稿は 8,492 件を超える「いいね」を集め、Hacker News のスレッドは最初の数日で 549 ポイントと 174 件のコメントに達しました。
今日使えるものと、発表されたものの違い
ローンチ関連の報道の多くはこの部分を飛ばしていますが、実はここが、Beam が今月のあなたの計画に入るかどうかを決める部分です。発表が語っているのは Reflection が学習したモデルで、開発者ドキュメントが語っているのは実際に呼び出せるモデルです。今のところ、この2つは同じではありません。
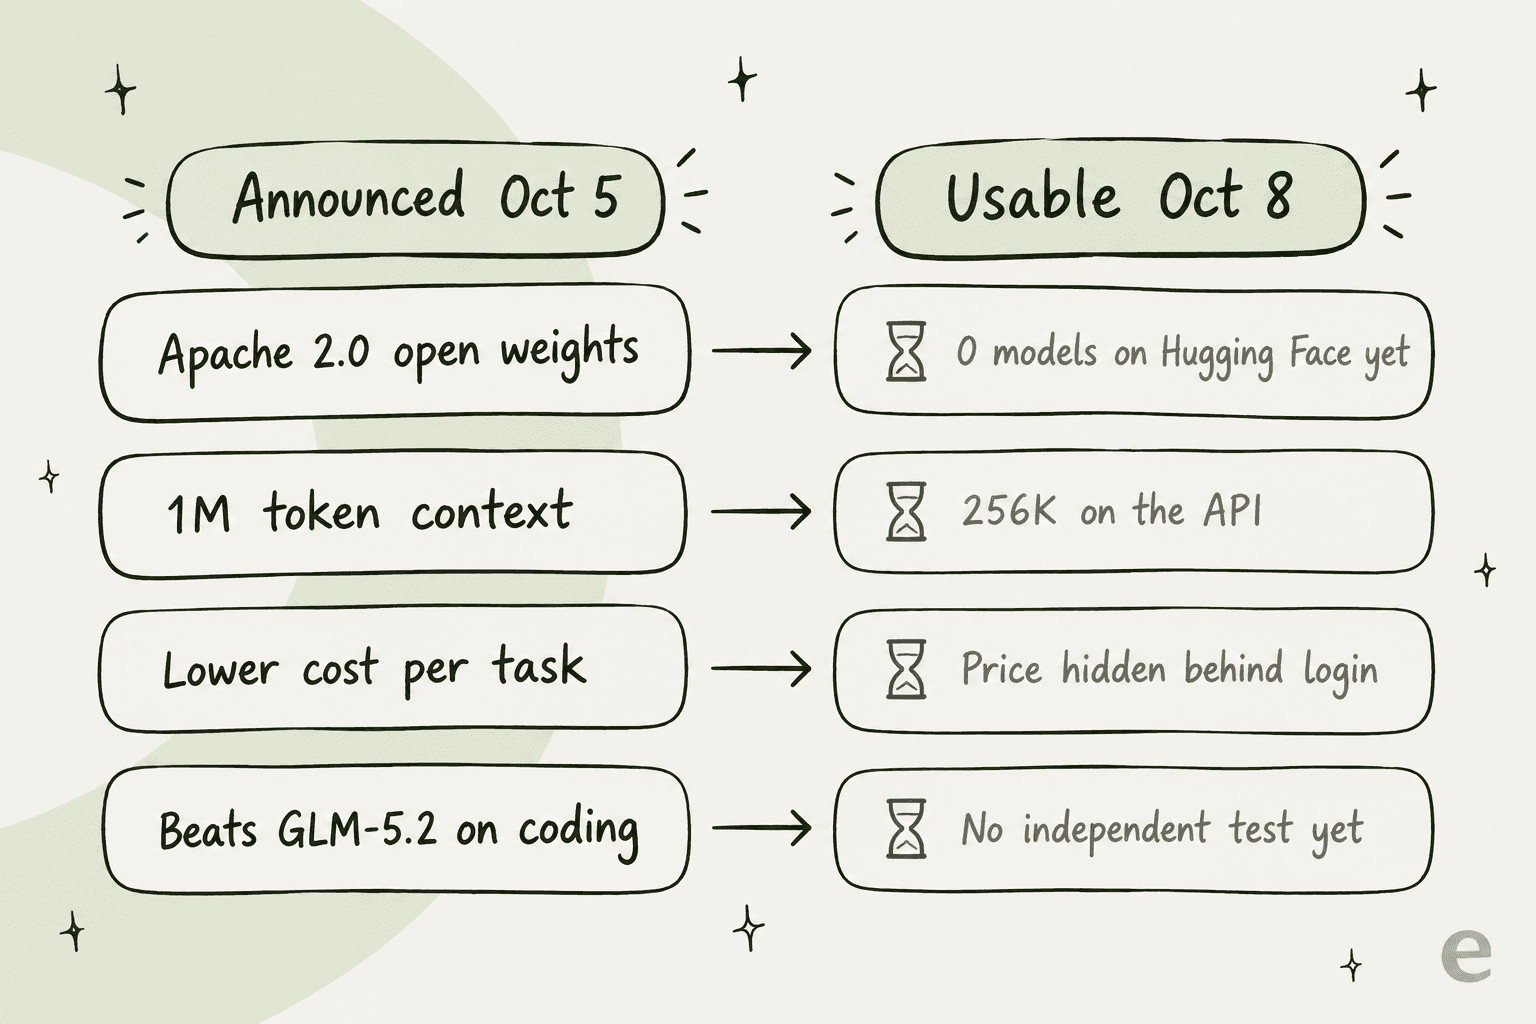
| ローンチでの発表 | API とドキュメントの記載(2026年10月8日) | |
|---|---|---|
| ウェイト | Apache 2.0、「今月中」 | Reflection の Hugging Face 組織には 0 件のモデル |
| コンテキストウィンドウ | 実効コンテキストを 1M トークンに拡張 | 256K のコンテキスト、最大出力 128K、「may change during beta」(Models) |
| アクセス | 「a select group of users」への早期アクセス | ウェイティングリスト。アクセスが有効になって初めてキーが発行される(Authentication) |
| 価格 | 効率による「lower cost」 | 公開料金なし。料金ページはログインの奥 |
| レート制限 | 言及なし | 組織ごとの制限と1日あたりのトークン上限があるが、数値は非公開(Rate limits) |
| 推論 | 調整可能な推論の強さ | 常にオン。low から max までの5段階、デフォルトは medium(Reasoning) |
| 知識のカットオフ | 記載なし | 2026年6月30日 |
最も強く指摘したいのはコンテキストウィンドウの差です。「1M トークン」を前提に長文書やリポジトリ全体を扱うワークフローを考えているなら、今のベータ API ではその4分の1に制限されます。学習時の能力と提供時の制限は別物なので、約束を破ったとは言いませんが、10月に何を作れるかは変わります。
Hacker News のユーザー adrian_b は、期限を端的に言い表しています。
"They claim that they will release the model as open weights later this month. That means that they have the 31th of October as the deadline to make true their claims."

Beam の仕組み:23B が働き、501B を保持する
MoE 設計は Beam の話のほぼすべてなので、わかりやすい言葉で1分だけ説明します。Mixture-of-Experts モデルは、ウェイトを多数の小さな「エキスパート」ネットワークに分け、トークンごとにルーターがそのうちの数個を選び、選ばれたエキスパートだけが計算します。だから 501B のモデルでも、トークンあたりの実行コストは 23B の密なモデルとほぼ同じで済みます。
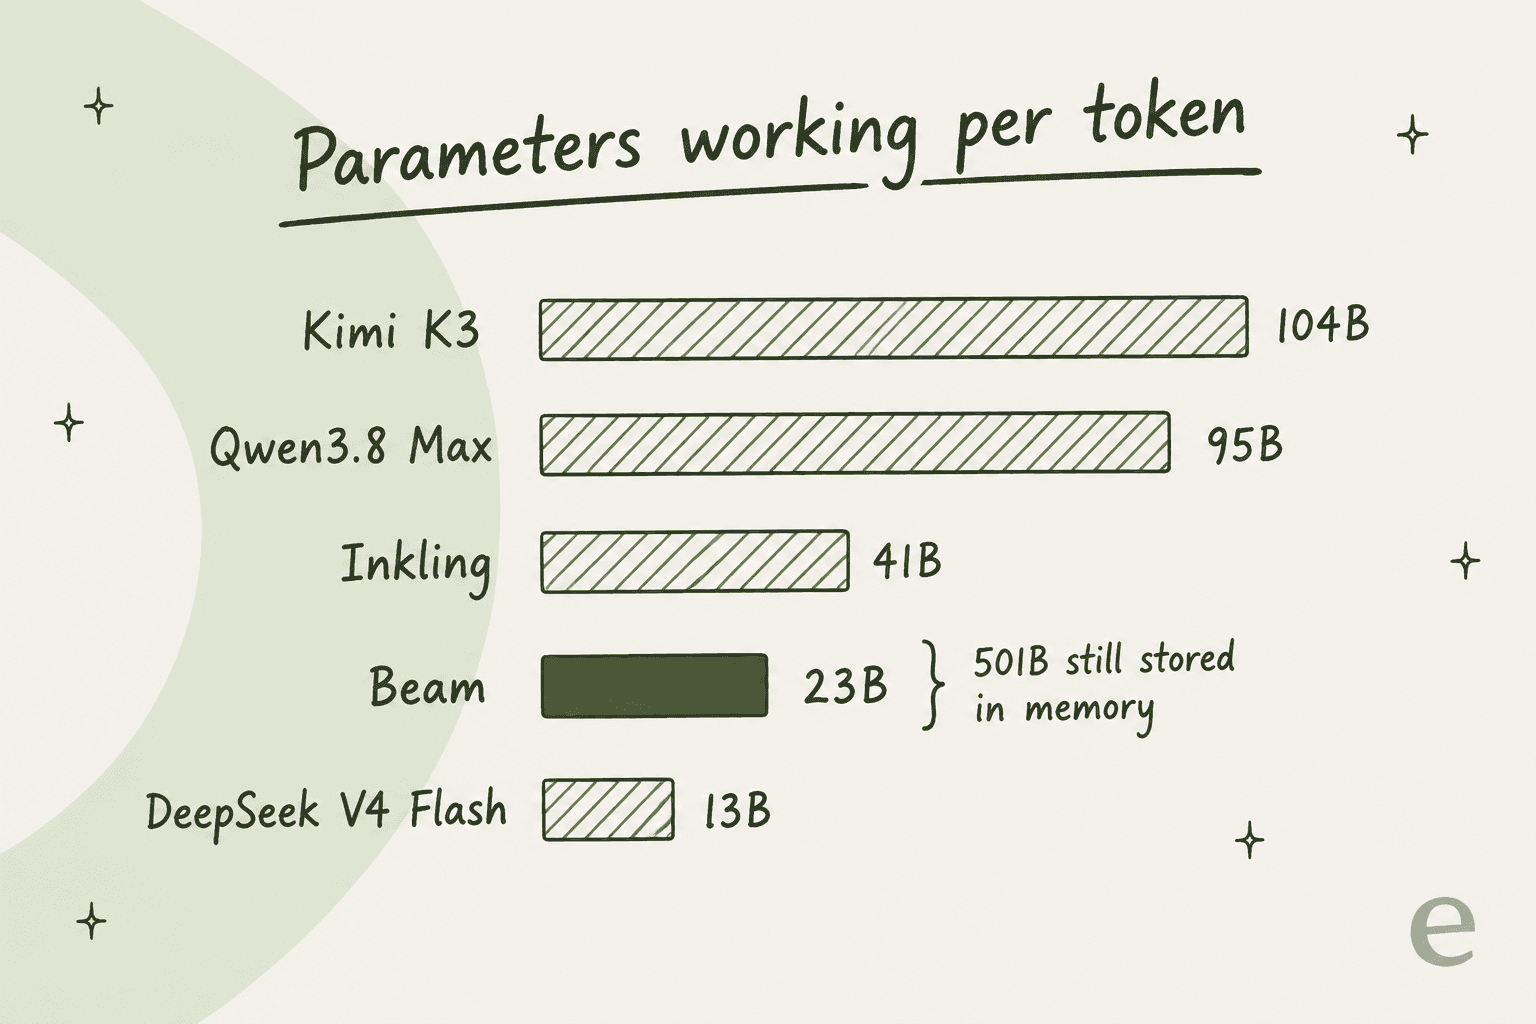
見落とされがちな落とし穴はこれです。アクティブパラメータが計算の請求額を決め、総パラメータがハードウェアの請求額を決めます。次のトークンでルーターがどのエキスパートも選び得るため、501B すべてをメモリに載せておく必要があります。つまり Beam はトークンあたりの実行は安いものの、ホストは小さくありません。総 2.8T・アクティブ 104B の Kimi K3 と比べれば、どちらの面でも軽く、アクティブが 13B しかない DeepSeek V4 Flash と比べれば、トークンあたりで多くの作業をします。
推論の長さももう1つの調整手段です。Reflection は、正解を報いつつ不要なトークンを抑える長さペナルティを付けて Beam を学習させ、そのトレードオフを reasoning_effort パラメータとして公開しました。効率のグラフでは、各モデルが使ったトークン数に対してスコアがプロットされています。
グラフの下で、Reflection 自身が正直な注意書きを添えています。コンピュートの推定にはプロンプトのプリフィル、アテンションのコスト、サービング時のオーバーヘッドが含まれておらず、"represent an approximate compute comparison rather than measured inference cost." だということです。言い換えれば、見えているのは効率の形であって、請求額ではありません。
Beam のベンチマーク:実際の位置
Reflection は幅広いベンチマーク表を公開しており、Beam を上回るモデルも載せている点は評価できます。以下は、エージェントとコーディングの作業で私が注目する行で、数値はすべて Reflection 自身の表から取っています。「NR」は not reported(未報告)の意味です。
| ベンチマーク | Beam | GLM-5.2 | Kimi K3 | Qwen3.8 Max | DeepSeek V4.1 Flash | Inkling |
|---|---|---|---|---|---|---|
| SWE-bench Verified | 80.9 | NR | NR | NR | NR | 77.6 |
| SWE-bench Pro v1 | 65.5 | 62.1 | NR | 67.7 | NR | 54.3 |
| Terminal Bench v2.1 | 80.1 | 81.0 | 88.3 | 86.6 | 90.6 | 63.8 |
| DeepSWE v1.1 | 44.4 | 44.0 | 68.0 | 51.0 | 74.2 | NR |
| MCP Atlas | 78.7 | 77.8 | 82.3 | 84.5 | NR | 76.0 |
| tau3 banking | 38.0 | 37.1 | 37.1 | 55.2 | NR | 25.0 |
| HLE (no tools) | 36.2 | 40.5 | 46.9 | 43.6 | 39.1 | 29.7 |
| GPQA Diamond | 90.5 | 91.2 | 93.5 | 92.6 | 90.9 | 87.2 |
行を横に読むと、全体像はかなり明確です。Beam は GLM-5.2 と互角に渡り合い、Inkling を余裕で上回りますが、Kimi K3、Qwen3.8 Max、DeepSeek V4.1 Flash には、それらの数値が報告されている項目で及びません。Reflection 自身の説明も同じで、Beam は "competitive with larger open models like GLM 5.2 and approaching Qwen 3.8-Max on coding and agentic tasks," 一方で "frontier open models like Kimi K3 remain ahead on raw capability." としています。
SWE-bench Verified の目立つ 80.9 には注釈が必要で、X のユーザー LuChai がうまく書いています。
"The 80.9 on SWE Bench Verified is the standout, but worth flagging that GLM-5.2 and Qwen 3.8 Max are both NR there"
これまでのところ、独立した第三者による評価もありません。10月8日時点で、Beam は Artificial Analysis に掲載されておらず(696 モデルの一覧に Beam の項目はありません)、Sierra の tau-bench リーダーボードにもありません。参考までに、Artificial Analysis は現在、Intelligence Index で Qwen3.8 Max を 45.4、Kimi K3 を 43.6、GLM-5.2 を 33.7 と評価しています。Beam が本当に GLM-5.2 の近くにいるなら、テストされた後は 30 台のどこかに入ると予想しており、最近の別の西側リリースである Mistral Large 4 がその物差しになります。
もう1つ良いと思ったのは、Reflection が RL の学習が頭打ちにならず改善し続けたことを示している点で、これはシリーズの次のモデルにとって良い兆候です。
Reflection AI Beam の料金はいくら?
簡潔に言うと、ウェイティングリストの外では、まだ誰も知りません。Reflection のプラットフォームも /pricing ページも、サインイン画面しか表示されません。商用規約によれば、料金はプラットフォーム上の "set forth in the pricing documentation" とされていますが、そのドキュメントも同じログインの奥にあります。
エラーと課金のドキュメントからわかるのは、課金の形だけです。
- クレジットまたはプリペイド残高(
402 insufficient_credits、prepaid_balance_exhausted) - 一部の組織では、API キーを作成する前にカードの確認が必要(
403 payment_method_required) - プランで決まる課金ティアと1日あたりのトークン上限
引用できる Beam の価格がないので、代わりに Beam の効率の話が意味を持つための価格帯を示します。以下は、Reflection の比較表に載っているモデルの各社公式 API 料金(1M トークンあたり)です。
| モデル | 入力 | キャッシュ入力 | 出力 | 出典 |
|---|---|---|---|---|
| Kimi K3 | $3.00 | $0.30 | $15.00 | Kimi platform |
| Qwen3.8 Max | $2.00 | $0.25 | $6.00 | Qwen Cloud |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | Z.ai pricing |
| DeepSeek V4.1 Flash | $0.30 | $0.006 | $1.20 (peak) | DeepSeek pricing |
| Reflection Beam | 非公開 | 非公開 | 非公開 | ウェイティングリストのみ |
Beam の品質が GLM-5.2 に近いとしましょう。その場合、効率の主張が活きるのは、価格が GLM-5.2 の $1.40 / $4.40 以下のときだけで、しかも Reflection 自身の表のほとんどの行でより高いスコアを、これらの料金のごく一部で出している DeepSeek V4.1 Flash に対しても説明が必要です。これらの数字がタスクごとにどうなるかは、GLM の料金と Qwen3.8 Max の料金の詳しい解説をご覧ください。
セルフホストは計算を変えますが、ハードウェアの請求額は変わりません。「run it on your desk」という投稿への X の返信が、それを率直に指摘しています。
"m5 studio 512GB is like $20 grand... this is realistically a $40k investment, to use 6 month old AI."
実データを送る前に読んでおきたいデータ規約
Reflection の規約は、サービスを2種類に分けています。有料の Standard Services では、あなたはコンテンツを "solely to operate and provide the Services." のために Reflection にライセンスします。無料または Discounted Services では、ライセンスははるかに広く、コンテンツを "create derivative works of, and otherwise exploit" する権利を含みます。どちらの場合も、安全性とコンプライアンスのためにコンテンツは30日間保持され、フラグが立てられたコンテンツは最大12か月保持されます。割引の早期アクセスプランで顧客との会話を使って Beam をテストしているなら、この条項は2回読むべきです。
今すぐ Beam を使うには
ウェイティングリストから抜ければ、API は簡単に組み込めます。Reflection は https://api.reflection.ai/openai/v1 で OpenAI 互換のエンドポイントを提供しており、OpenAI SDK で作ったコードは、ベース URL とキーを差し替えるだけで動きます。モデル ID は Beam-501B-A23B です。
作り始める前に知っておきたい、ドキュメント上の注意点がいくつかあります。
- サポートされているのは Chat Completions と Models のみ。 Responses API、embeddings、batch、files、assistants は使えません。
stopシーケンスは受け付けられるが無視される。 生成はそこで止まらないので、パース用途で頼らないでください。- 推論はオフにできない。 速度重視なら
low、難しいタスクならmaxを選びます。推論テキストは別フィールドのreasoning_contentで返ります。 nは 1 に固定で、logprobs はオフ。 評価ハーネスが1回の呼び出しで複数の補完をサンプリングする場合は、ループが必要です。- ツール呼び出しと構造化出力は使える。
parallel_tool_callsとjson_schemaを含みます。
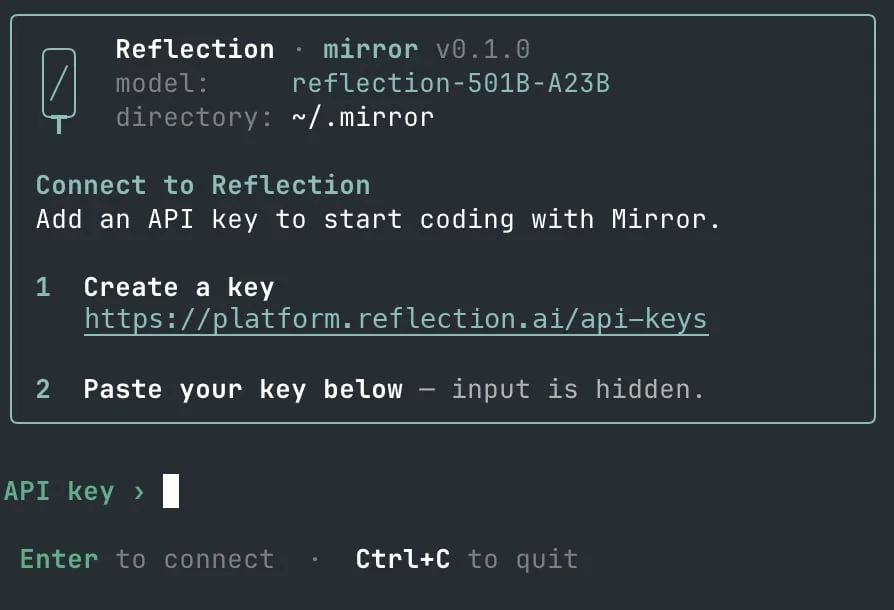
コーディング用途では、Reflection が独自のターミナルエージェント Mirror CLI を提供しており、デフォルトのモデルは Beam です。まだ初期ベータで、並列 worktree と AGENTS.md の指示、Linear や Notion などのツールへの MCP 接続に対応しています。Reflection のクイックスタートには、Beam を Pi、OpenCode、Hermes Agent につなぐ方法も載っており、すでにそれらのどれかを使っているなら便利です。
ハーネスをまだ選んでいる最中なら、その点は Pi コーディングエージェントとエージェント型コーディング CLIの記事で扱っています。
Reflection 自身のデモも、このエージェントという切り口を強く打ち出しています。私のお気に入りは、ニューヨークの地下鉄のライブマップで、Beam が MTA のドキュメントを検索して認証を突き止め、次に地下鉄の路線の形状データを見つけて、フロントエンドとバックエンドの両方を作りました。
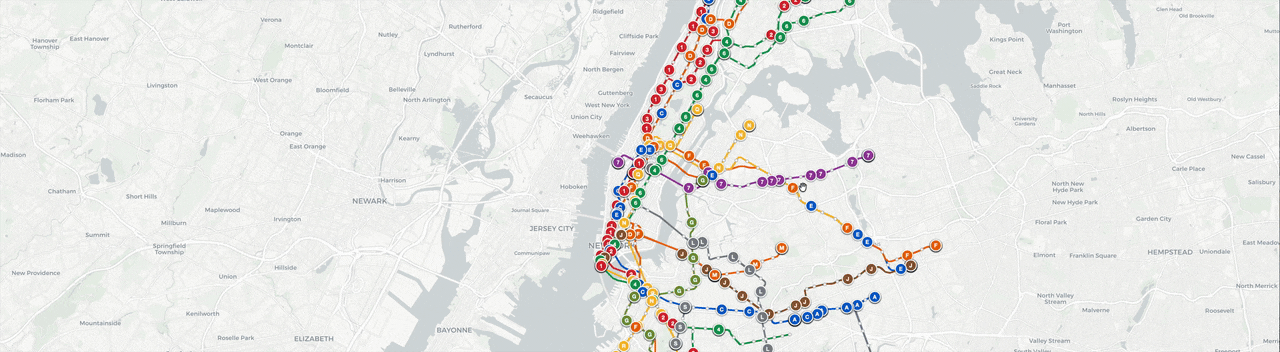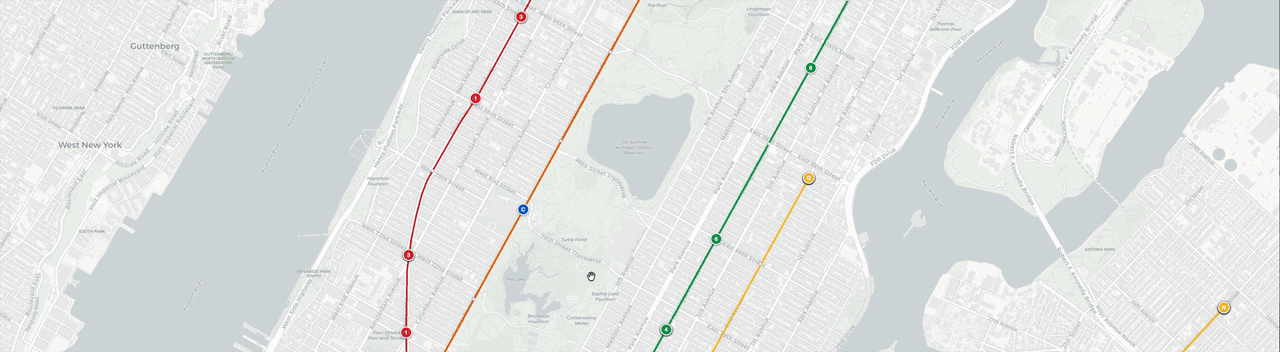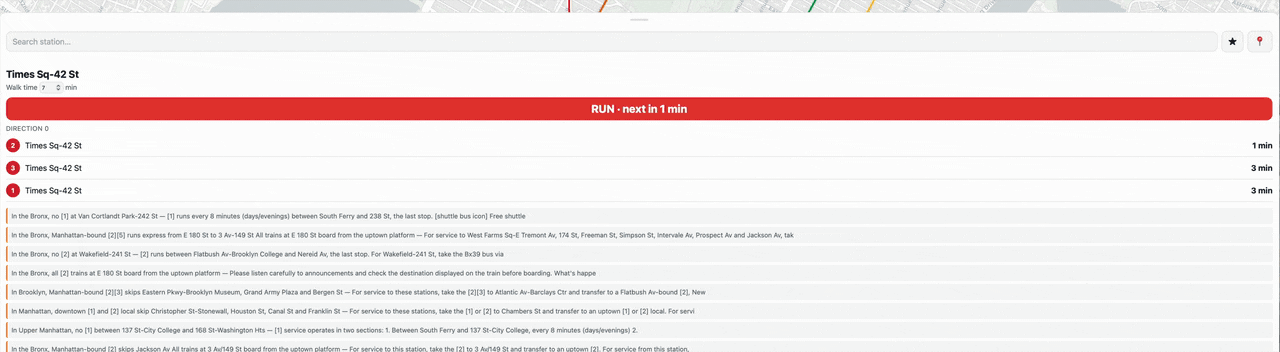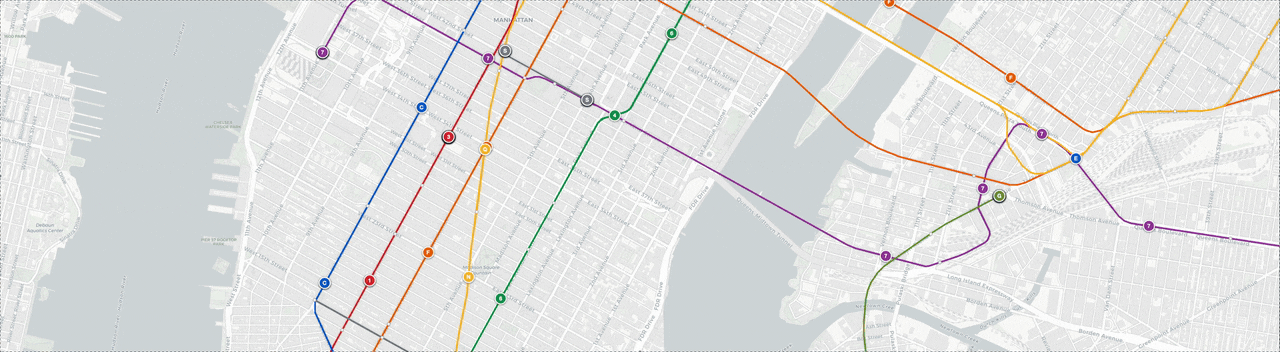
1つのデモはローンチ後に訂正が必要でした。Reflection の「Land or Water」デモは、当初、このパズルは公開から数日しか経っておらず、学習データに含まれていないはずだと主張していました。ある HN ユーザーがもっと古いものだと指摘した後、Reflection のチームメンバーが返信し、キャプションを変更したと伝えました。小さなことで、対応もオープンでしたが、デモを読むときには頭の片隅に置いておく価値があります。
開発者は Beam をどう見ているか
Hacker News のスレッドと r/LocalLLaMA、そして X と LinkedIn を見てきましたが、同じ3つのテーマが繰り返し出てきました。
「Show me the weights.」 ウェイトが公開されるまでは、Beam をオープンと数えない人が多くいます。r/LocalLLaMA のモデレーターは、まさにその理由でローンチのスレッドを削除しました。
"Until such time that weights become available, this is off-topic for LocalLLaMA."

「It's a generation behind, but it's American.」 コメントの多くは、Beam を6月のモデルである GLM-5.2 前後に位置づけています。盛り上がっているのはどこで作られたかという点で、中国発のモデルを使えないチームにとっては、それが判断のすべてです。
"I'm in a similar situation to you where we can't use Chinese AI models but we want to host on-prem due to data sovereignty concerns. ... I'm also keeping an eye on Reflection Beam"
「Nice efficiency claim, now let someone check it.」 肯定的な意見にも、この但し書きが付いています。JobNimbus の Chief AI Officer である Tyler Folkman は、実務家がどう見積もるかをまとめています。
"Nobody outside Reflection has verified any of this yet. ... When Beam's weights ship, I'm sizing them for my boxes by active parameters and quantized footprint, not the leaderboard."

Reflection は率直さでも評価されました。ある HN のコメント投稿者は、Kimi K3 のほうが上だと認めたことを "instead of making false claims." として称賛しました。私も同感で、自分を上回るモデルの名前を挙げるローンチ記事は、あるべき姿よりも珍しいからです。
Beam はカスタマーサポートに向いているモデル?
これは私が最も気にしている問いです。私の毎日は、サポートチケットに答える AI に費やされているからです。良いニュースは、Reflection が実際にサポート業務に近いベンチマークのスコアを報告していることです。
tau3 banking は Sierra の tau-bench に由来します。モデルを、698 件のポリシー文書がある模擬の銀行ヘルプデスクに置き、ツールを使って顧客の依頼を解決させます。タスクは、顧客のアカウントが正しい状態になって初めて合格となるため、丁寧でも間違った回答は0点です。各タスクには、平均で約 18.6 件の文書と 9.5 回のツール呼び出しが必要です。
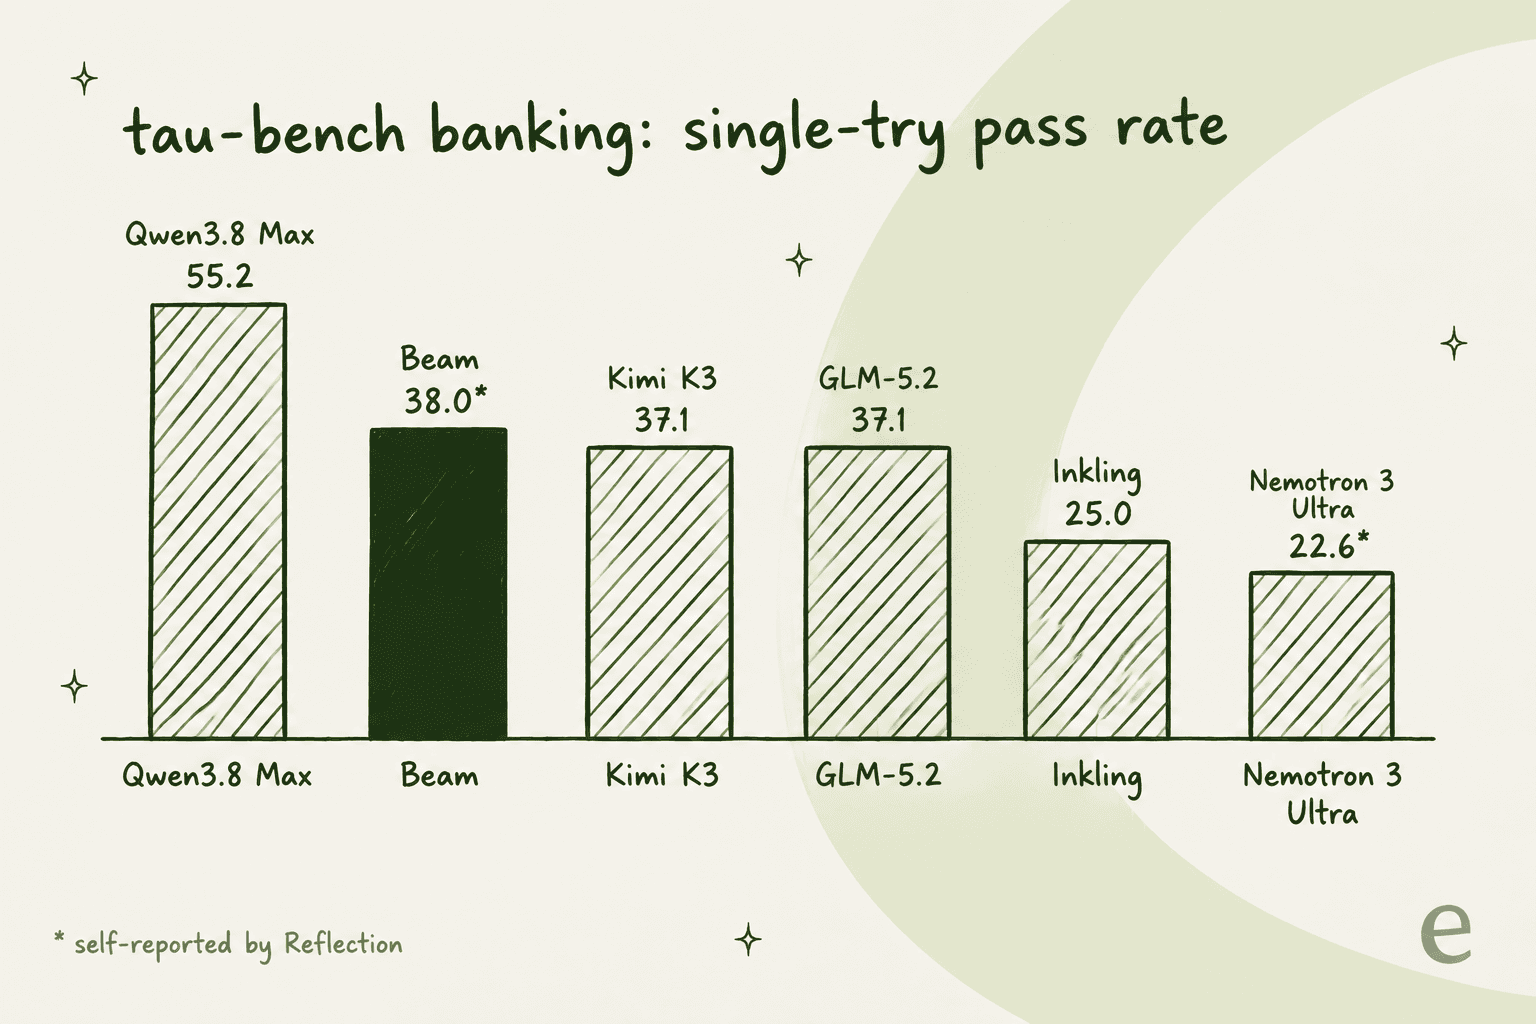
Beam の 38.0 は Kimi K3 と GLM-5.2(Sierra のリーダーボードではどちらも 37.1)とほぼ同等で、55.2 の Qwen3.8 Max には大きく及びません。Reflection はどのテスト設定で 38.0 が出たのかを明かしていないため、正確というより近い値として扱うのがよいと思います。一貫性を求めると全体が下がります。Sierra のボードでは、タスクが4回すべて合格する必要がある場合、Qwen3.8 Max は 55.2 から 35.1 に落ちます。
この最後の数字こそ、サポートチームにとっての本当の教訓です。サポートチケット向けの最適な AI モデルの解説で詳しく扱いましたが、最良のモデルでも、ポリシーの多いチケットを毎回正しく処理できるのは約3分の1程度です。新しいモデルに入れ替えても、これは解決しません。
解決するのは、モデルの周りの層です。つまり、実際のナレッジベースと過去のチケットに回答を根拠づけ、自信の低い返信は人間にエスカレーションし、本番に出す前に自社の履歴でテストすることです。導入ガイドでは、その導入の順序を説明しています。
私は実際のキューでこの失敗を見てきました。Zendesk を使う車両テレマティクスのチームでは、ボットが、データベースにないブランドの顧客に対しても「yes, we support your car model」と自信たっぷりに答えていました。原因は、あるヘルプ記事に「we support all models」と書かれていたことだけです。どんなベンチマークスコアでもこれは見つけられませんでしたが、自社の過去チケットに対するシミュレーションなら見つけられたはずです。
したがってサポートに関しては、価格が出てウェイトが公開されれば、Beam はエンジンの候補として妥当で、会社として中国発のモデルを除外しているならなおさらです。ただし、それだけではサポートエージェントではありません。その部分には、あなたのキューを理解している AI ヘルプデスクエージェントが必要で、AI ヘルプデスクのまとめではそれができるものを比較しています。
Reflection AI とは?
Reflection は2024年に、元 Google DeepMind の研究者である Misha Laskin(CEO)と Ioannis Antonoglou が共同設立しました。ローンチ記事で Laskin は、自身が物理学から AI に転じたきっかけを、2016年の AlphaGo にさかのぼって語っています。
背後には多額の資金があります。Reflection の自社記事は、2025年に NVIDIA、Sequoia、Lightspeed、DST、CRV、Eric Schmidt らの投資家から $2 billion を調達したと発表し、ニュースルームには、2026年4月のラウンドでのプレマネー評価額 $25 billion が記載されています。ローンチ記事で Laskin は、なぜオープンを選んだのかについても説明しています。
"Open also means safer. The best defence is a distributed one."
Antonoglou は X で、チームがすでに "already training the next, larger model." と付け加えました。つまり Beam は、はっきりとシリーズの第1弾です。
HN では1つの訂正も出ていました。この Reflection は、2024年の「Reflection 70B」モデルとは無関係です。あるコメント投稿者がローンチのスレッドでこの混同を訂正し、最初に指摘した人も撤回しました。
では、Beam を待つべき?
読者のタイプ別に、私ならこう考えます。
| あなたが... | 私の判断 |
|---|---|
| 米国製のオープンモデルが必要なチーム(政府、規制業種、「中国発モデルは使わない」方針) | 今すぐウェイティングリストに参加し、11月上旬の評価を計画する |
| 今、限られた予算でコーディングエージェントを作っている | 今は DeepSeek V4 Flash か GLM を使い、Beam が Artificial Analysis に載ったら再テストする |
| 最強のオープンモデルを求めている | Reflection 自身の表によれば、Kimi K3 か Qwen3.8 Max |
| セルフホストを検討している | FP8 と NVFP4 のウェイトを待ち、23B の計算量ではなく 501B のメモリで見積もる |
| サポートキュー向けにモデルを選んでいる | まずエージェントを選び、その後モデルを選ぶ。以下を参照 |
モデル競争を見守るサポートチームのための eesel
顧客への返信用にモデルを選んでいてここにたどり着いたなら、近道は、1つのローンチにキューを賭けなくてよいということです。eesel の AI ヘルプデスクチームメイトは、Zendesk、Freshdesk、Gorgias に接続し、過去のチケットとヘルプセンターから学び、誰かに返信する前に、実際のチケット履歴でシミュレーションを実行します。より良い、あるいはより安いモデルが出たときには、チームメイトが良くなり、何も作り直す必要はありません。

Beam の記事を読むターミナル派にも対応しています。eesel CLI を使えば、同じチームメイトをシェルから操作でき、ヘルプデスクの接続、常設の指示の編集、保留中のアクションの承認や拒否、アクティビティログの確認などができます。すべてのコマンドは JSON を返し、--dry-run フラグを付けると、送信前に実際の呼び出し内容を確認できます。さらに、すべてのワークスペースは MCP サーバーなので、Claude Code のようなコーディングエージェントから直接操作できます。
エージェントが自社のデータに根ざしていると、成果は早く出る傾向があります。Gridwise はトライアル後にこう述べています。
"In the first month, eesel is resolving 73% of our tier 1 requests."

100 クレジットで eesel を無料で試す(カード不要)か、料金ページで有料プランをご覧ください。