

llama.cpp v1.0.0は2026年11月13日に登場しましたが、見出しは速度の飛躍ではなく約束です。公開C APIへの破壊的変更が、これからはメジャーバージョンの繰り上げを意味するようになりました。libllamaの上に構築している人にとって最も重要な点です。サーバー利用者はまず安全性の変化を感じるでしょう。llama-serverは今、APIキーなしでネットワークアドレス上にツールを公開することを拒否します。インストールはllama.appから1行で、または新しい1MBのLlamaアプリを使ってください。代わりにサポートキューでAIを使いたいですか? eeselはホスト型モデルの上でそれを動かし、eesel CLIはコーディングエージェントがヘルプ記事をアップロードし、事前に回答をテストすることを可能にします。
llama.cppとは何ですか?
llama.cppは、大規模言語モデルとビジョンモデルを自分のハードウェア上で実行するオープンソースのエンジンで、依存関係なしの純粋なC/C++で書かれています。READMEファイルは、その目標を「最小限のセットアップで、幅広いハードウェア上で最先端の性能を出すLLM推論」と、ローカルでもクラウドでも、と説明しています。
規模を示す数字がいくつかあります。GitHubのリポジトリはMITライセンスの下で135,055のスターと25,608のフォークを獲得しており、2023年3月10日に作成され、v1.0の発表によれば今では150以上のモデルアーキテクチャに対応しています。プロジェクトを率いるのはggml-org、Hugging Face内に属するGeorgi Gerganovが率いるチームです。
私はeeselのプロダクトのためにインテグレーションとAPIを作っているので、ローンチのバナーよりも、バージョン番号がそれに依存するコードに何をするかの方が気になります。この記事全体をその視点で書いています。リリースノート、バージョニングのポリシー、変更の裏にあるプルリクエストを読みましたが、自分のマシンでベンチマークはしていないので、以下の速度に関する数字はメンテナー自身の数字からのものです。
その下にある中核のエンジンはggmlで、名前の挙がるほぼすべてのチップに対応するバックエンドを持つテンソルライブラリです。
| バックエンド | 対応先 |
|---|---|
| Metal | Apple Silicon |
| CUDA | NVIDIA GPU |
| HIP | AMD GPU |
| Vulkan | ほとんどのGPU |
| SYCL | Intel GPU |
| OpenCL | Qualcomm Adreno GPU |
| Hexagon | Snapdragon |
| CANN | Huawei Ascend NPU |
| WebGPU | ブラウザとWebGPU対応デバイス全般 |
| CPU(AVX、NEON、RVV) | x86、Arm、RISC-V |
この広い対応範囲こそ、多くのローカルAIツールがこの上に成り立っている理由です。オープンモデル向けのデスクトップチャットアプリを使ったことがあれば、裏でllama.cppが動いていた可能性は高いでしょう。Gemma 4やQwen3.8-Flash-Nextのようなオープンウェイトモデルが発売初日にGGUFファイル、llama.cppのモデル形式を出すのもこれが理由です。
v1.0というラベルは実際に何を約束していますか?
安定した境界を約束していますが、新機能ではありません。Hugging Faceでの発表でチームは、llama.cppとggmlの両方が「APIとABIの非互換性をメジャーバージョンの繰り上げで反映する」と述べています。このルールは今、すべてのggml-orgプロジェクトに適用されます。
| バージョンの繰り上げ | 発生する条件 |
|---|---|
| メジャー(2.0.0) | ./include内の公開C APIへの破壊的変更 |
| マイナー(1.1.0) | 後方互換の機能、バックエンドの更新、新しいモデル対応、APIの追加 |
| パッチ(1.0.1) | API変更のないバグ修正 |
多くの記事が見落としている点があります。この約束は公開C言語ヘッダー、libllama、libggmlを対象にしているということです。llama-serverのコマンドラインフラグ、ウェブUI、デスクトップアプリについては何も語っていません。この違いが、v1.0があなたにとって何かを変えるかどうかを決めます。
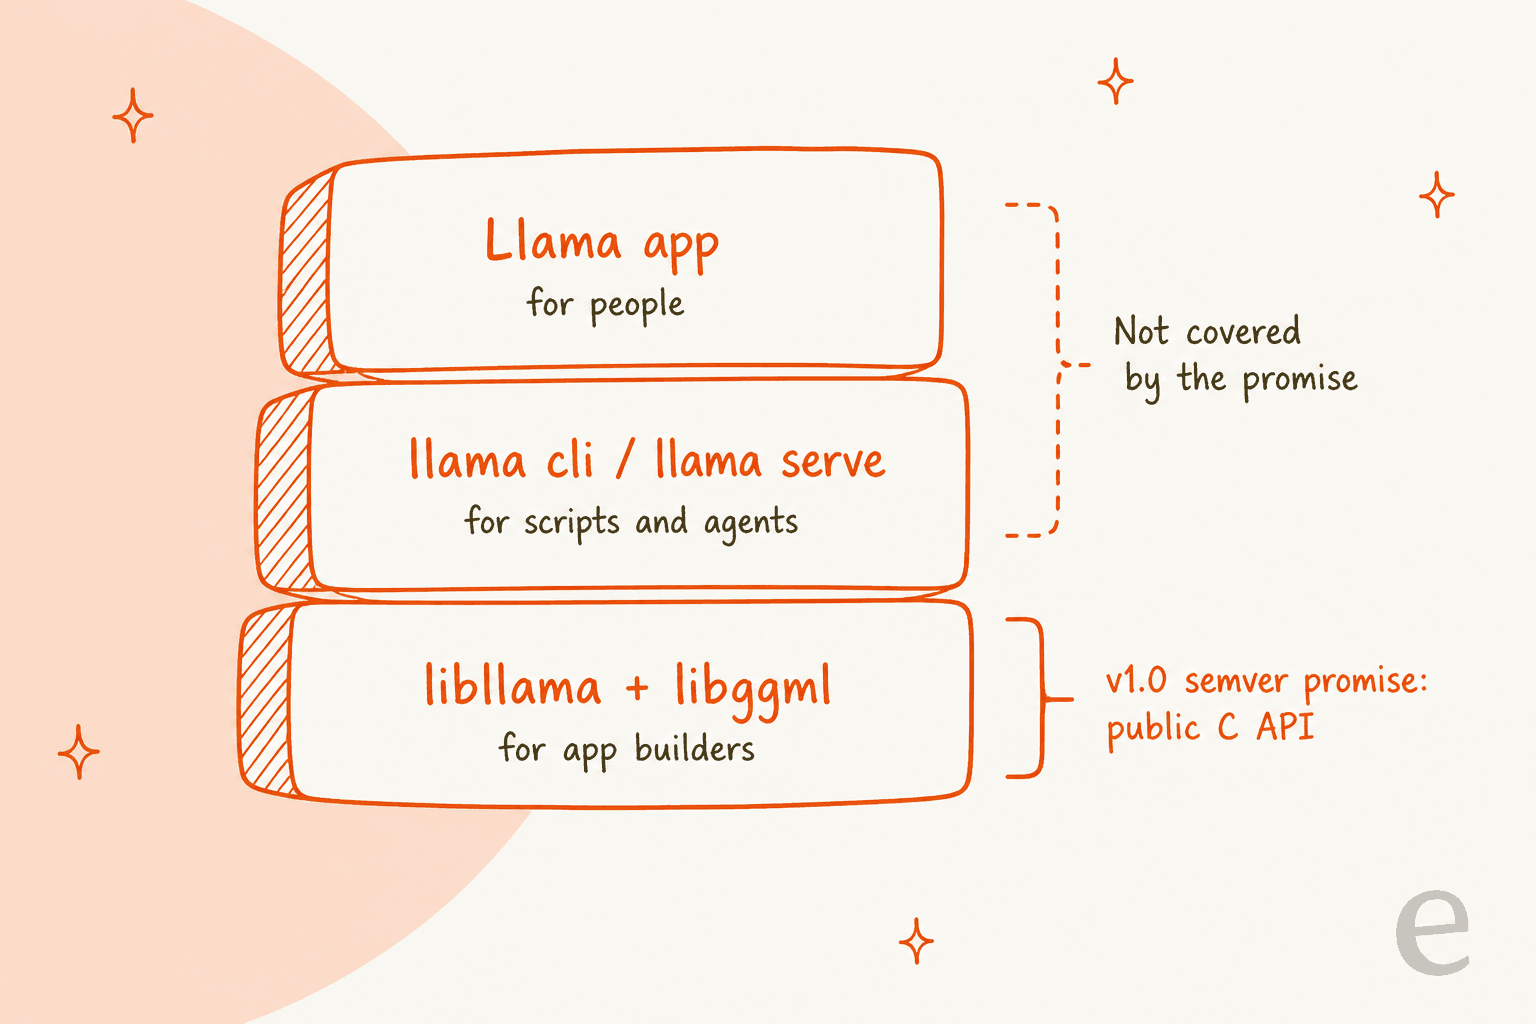
llama.cppをアプリに組み込んでいるなら、これは3年間待ち望んできたリリースです。パッケージャーも同じく望んでいました。バージョニングに関する議論で、Debian向けにパッケージ化している人が、セマンティックバージョニングによって「Debianで公開のサーチパス上にライブラリとして配布できるようになる」と書いています。破壊的変更をライブラリのバージョン繰り上げで示せるようになったからです。これによりllama.cppは、リポジトリにベンダリングするものから、システムライブラリへと変わります。
サーバーやアプリ経由でモデルを動かすだけなら、v1.0は主に整理のマイルストーンです。便利ですが、スタックを作り直す理由にはなりません。
ナイトリービルドは続く
ひとつ、人を混乱させる点があります。llama.cppはコミット数で名付けられたナイトリービルド、たとえばb12387を今も公開し続けており、リリースページによれば11月14日だけで5つ公開しています。v1.0.0タグは別の、もっと遅いトラックです。バージョニングのノートによれば、リリースタグが切られるのはllama.cpp内部のggmlのコピーが公開されたggmlと一致したときだけなので、タグからビルドしたものはシステム全体のggmlに対して安全にリンクできます。
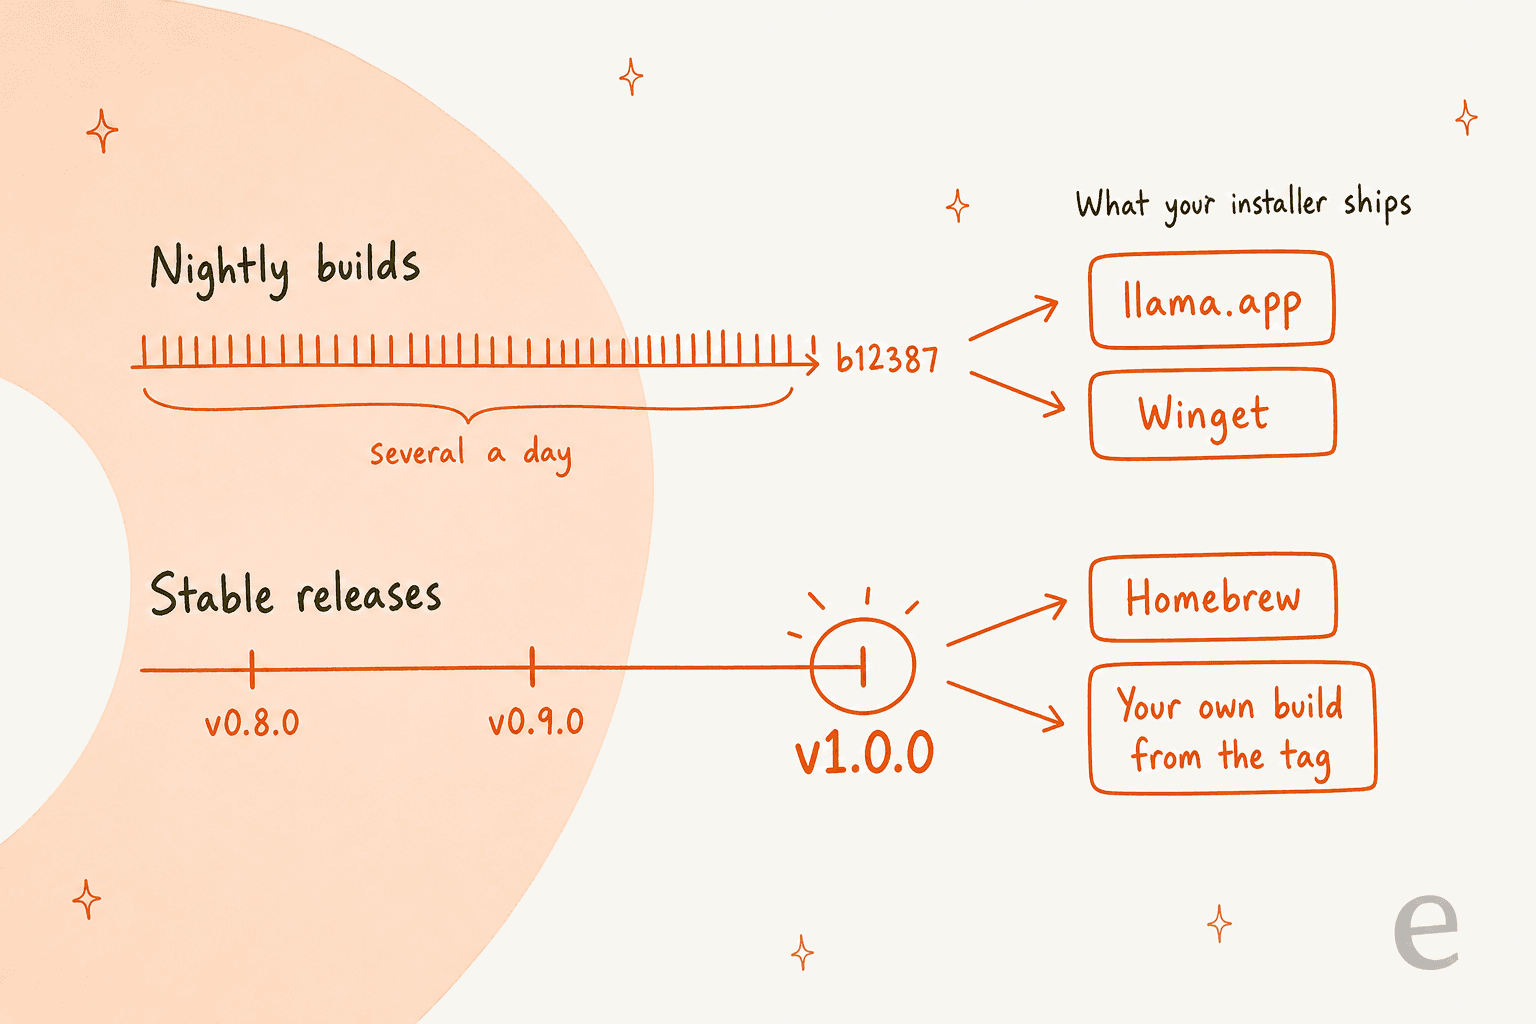
どちらのトラックに乗っているかは、インストール方法によります。同じノートによれば、llama.appインストーラーとWingetが配布しているのはナイトリービルドで、公式リリースではありません(切り替えはTODOとされています)。一方Homebrewのフォーミュラは今やリリースタグからビルドされます。つまり「自分はv1.0にいる」は、確認して初めて本当になります。
llama.cpp v1.0.0で何が変わりましたか?
リリースノートはv0.9.0以降の数百のコミットを含みます。知っておく価値のある変更を、誰が影響を受けるかでまとめました。
| 分野 | 変更 | 影響を受ける人 |
|---|---|---|
| C API | llama_set_warmup、35個の非推奨関数、--defrag-tholdを削除。NextN(投機的デコーディング)APIをllama-ext.hからllama.hへ移動 | libllamaをリンクしている人 |
| メモリ | -ctk/-ctv f8_e4m3によるFP8 KVキャッシュ | 長いコンテキストでVRAMが少ない人 |
| メモリ | CPUの割合を設定できるホストメモリのMoEエキスパートキャッシュ | 小さいGPU上の大きなmixture-of-expertsモデル |
| モデル | Kimi-K3.1-Pro、Ripple-65B-Preview、xing4_0、drama-3 TTS、Kimi-K3.1とMageVL-Cowork(ビジョン) | 新しいオープンモデルを試す人 |
| サーバー | /v1/audio/speechエンドポイント、CORS・DNSリバインディング・SSRFのセキュリティ修正 | llama-serverを運用する人 |
| ウェブUI | チャットグループ、ライブMarkdownエディタ、スマホ向けレイアウト、PDFサムネイル | 内蔵チャットを使う人 |
発売初日からの新モデル
新しいアーキテクチャは、私がすでに取り上げた最近のローンチと一致します。Kimi-K3.1-Proはノートによれば、K3のフルアテンション層をDSAに置き換えたもので、Ripple-65Bは新しい密な65Bアーキテクチャとして追加されました。Kimi K3のレビューやRipple-65Bのレビューを読んでいれば、これらは同じモデルで、今はGGUFファイルからローカルで動かせます。
FP8 KVキャッシュ
KVキャッシュは、モデルがこれまでの会話を覚えておくために使うメモリで、長いコンテキストではモデル本体に匹敵する大きさになることもあります。PR #28392は、テンソルごとの任意のスケールを持つOCP FP8キャッシュを追加します。どの8ビットのオプションを選ぶべきか、まだわかっていない人もいます。
"Sounds like now, 8 bit KV cache is ok for coding, but the question is which one? I see f8_e4m3, q8_0. Would be great to get more info about that."

私の見立てでは、リリースノートはこれに答えていないので、コーディング用のセットアップを切り替える前に、自分の実際の作業の長いセッションで両方を試してください。
MoEエキスパートキャッシュ
これが、私が一番注目している変更です。mixture-of-expertsモデルはトークンごとに重みの一部しか使わないため、PR #30966はよく使われるエキスパートをGPUメモリに保持し、キャッシュミスをCPU上で処理できるようにします。作者がQwen3.8-Flash-Nextで行ったチューニングの結果は、CPUの割合がなぜ重要かを示しています。6,464 MiBのキャッシュでは、デコードがCPU割合0で24.2トークン/秒だったのが、0.95の割合で47.6まで上がりました。19,392 MiBとより大きなキャッシュでは数字が逆転し、CPUの割合が高いほど遅くなります。このPRには、推測するのではなく自分にとっての最適点を見つけるためのチューニングスクリプト、scripts/moe-cache-tune.pyも付属しています。
これはEdge0-145BのようなシングルGPUの巨人の裏にあるのと同じ手法で、今ではメインのエンジンに組み込まれています。
llama-serverのセキュリティで何が変わりましたか?
これはアップグレード当日に、動いていたセットアップを壊す可能性が最も高い変更です。PR #32113により、非ループバックの--hostでツールやMCPを有効にしたままAPIキーなしで動かすことは、今ではエラーで拒否されます。--api-keyを追加するか、--allow-unauthenticated-toolsで明示的に許可する必要があります。
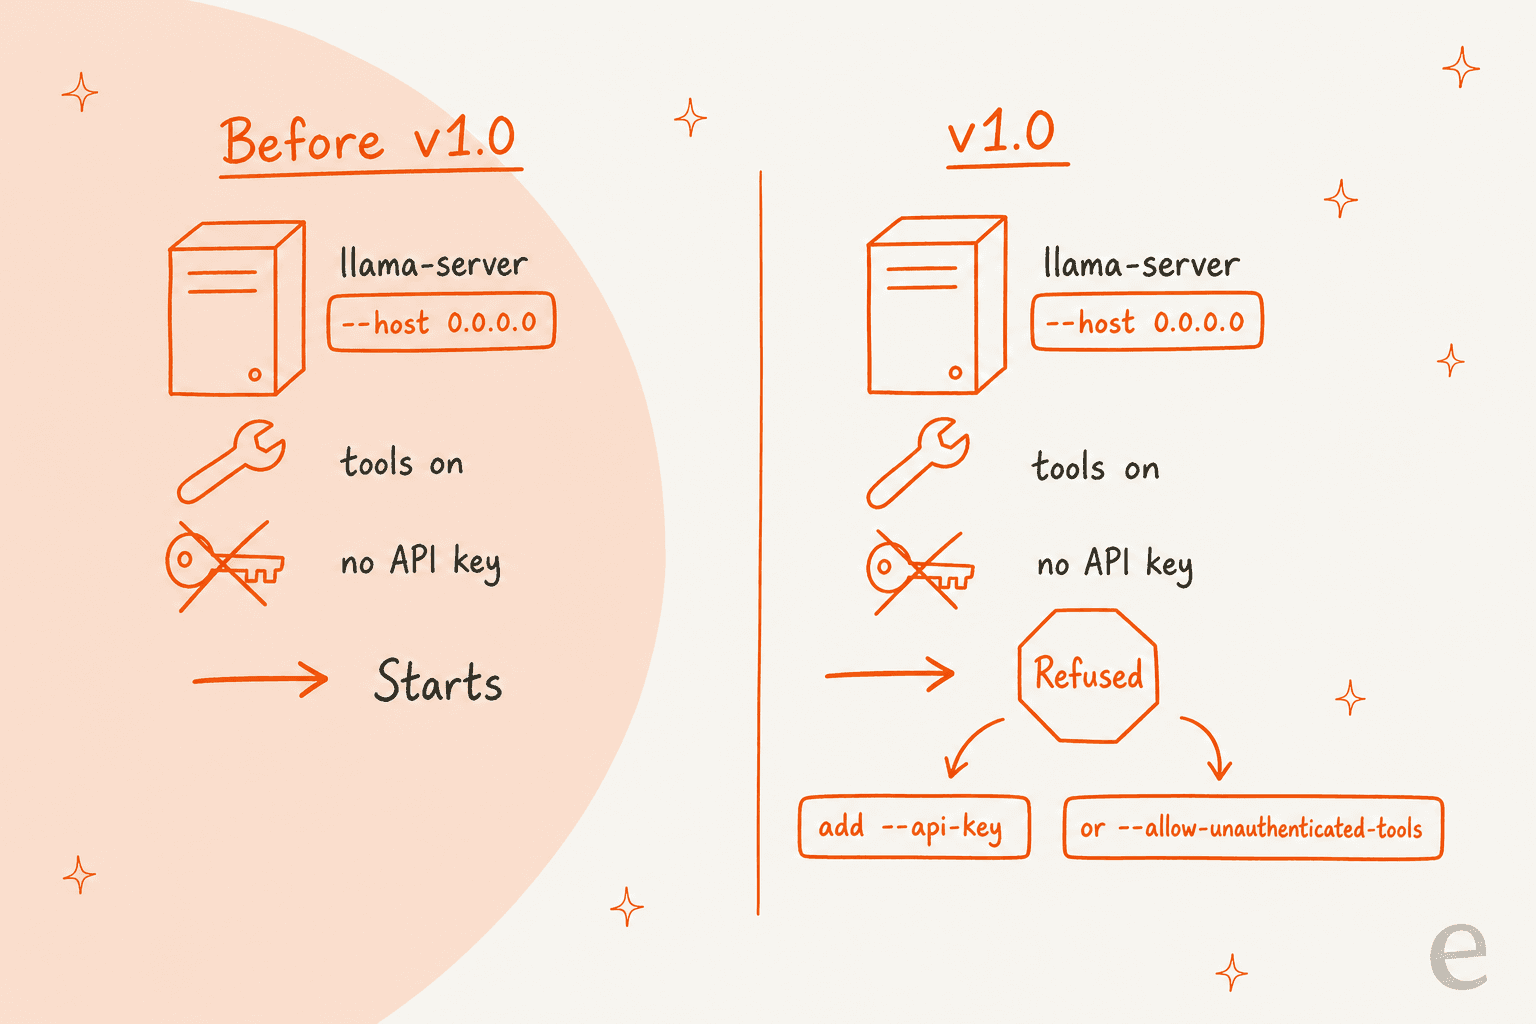
これを書いたメンテナーは、PRの説明の中でこのトレードオフについて率直でした。
"None of those are actually vulnerability, but since people nitpick this too much, we now forced to hurt the UX a bit"
それでも、私はこの厳しいデフォルトを支持します。llama-server内のツールはファイルを読み、シェルコマンドを実行できますし、ウェブUIに内蔵されたセットにはread_file、exec_shell_command、write_fileが含まれます。キーなしでLANに開いたままにしておくのは、同じWi-Fi上の誰かが見つけるまでは大丈夫、というタイプのセットアップです。同じリリースではHF_TOKENをhuggingface.coのホストに限定し、--cors-originsの処理とDNSリバインディングを修正し、オプトインの--media-allow-private-urlsを追加し、クライアントが切断したときにMCPのツール呼び出しをキャンセルするようにもなりました。
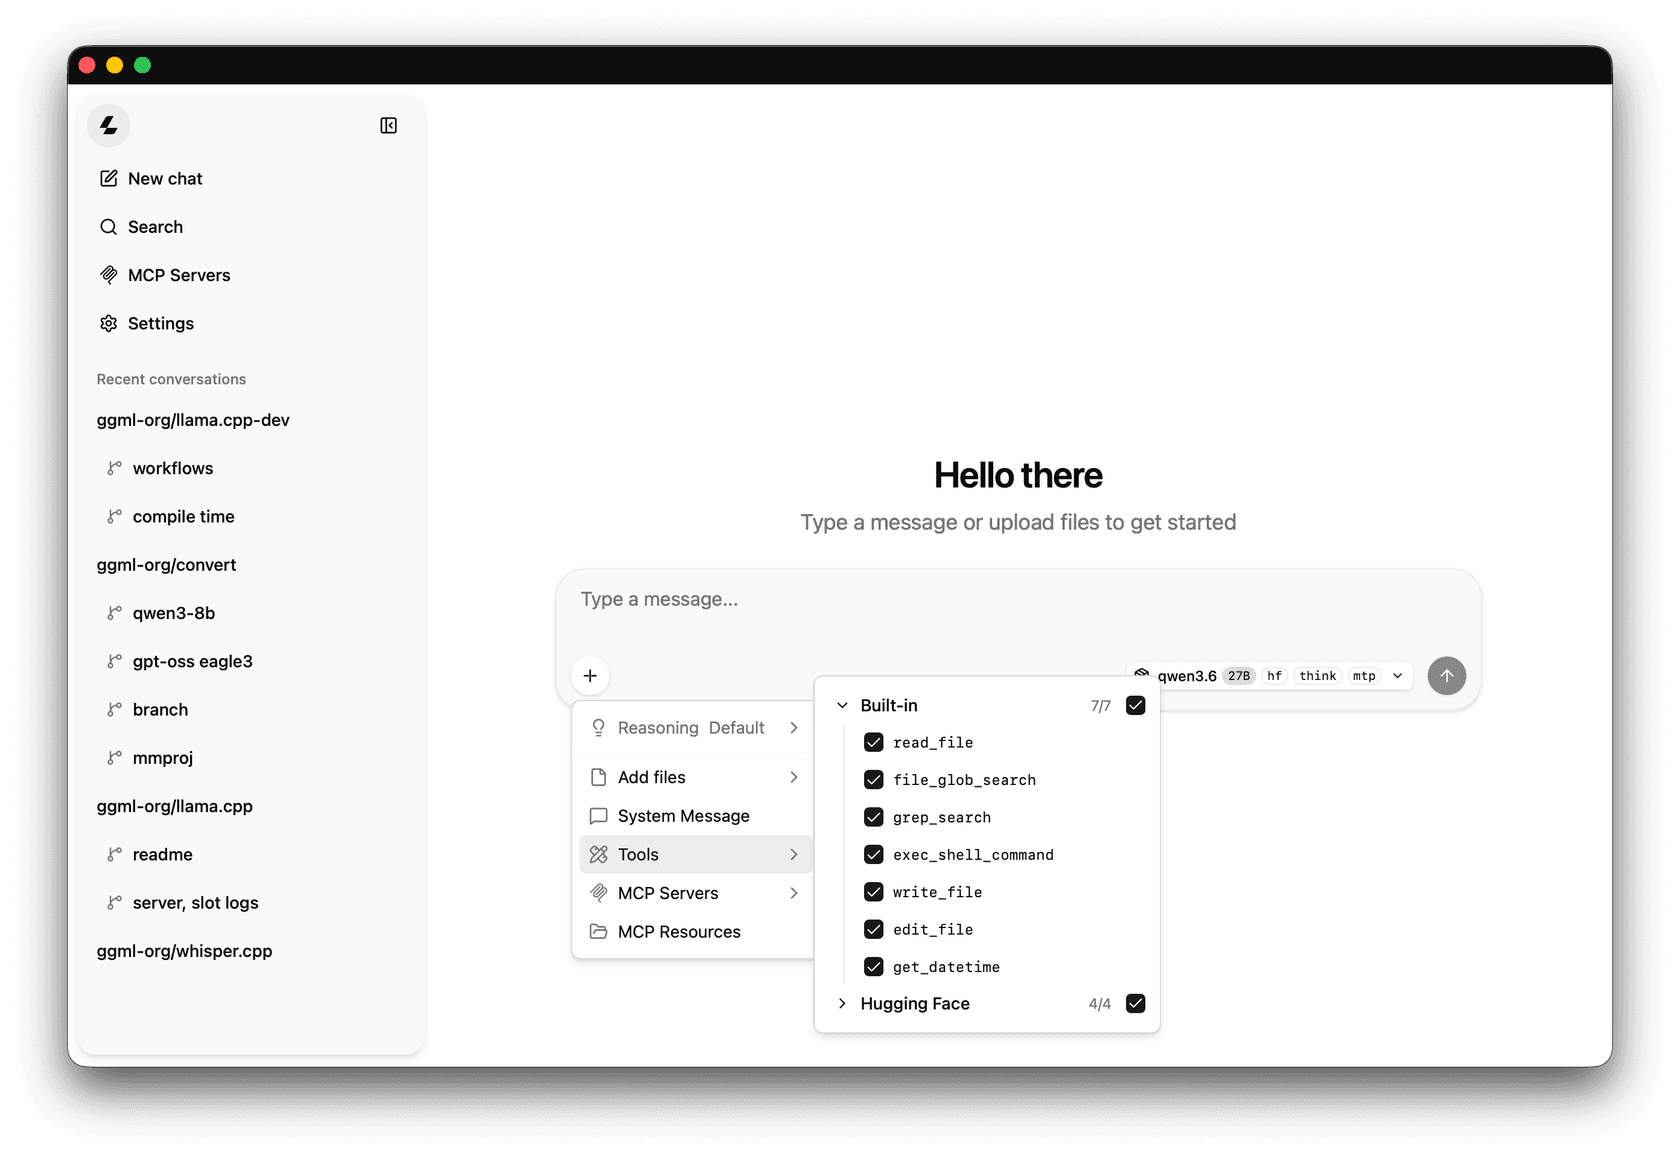
ローカルモデルを何かアクションを取れるものに組み込んでいるなら、AIエージェント向けMCPサーバーやClaude Codeのセキュリティに関する私のノートも同じ原則を扱っています。本当の攻撃対象はツールアクセスであり、モデルではありません。
llama.cpp v1.0はあなたにとって何か変わりますか?
自分の使い方を選べば、短い答えがわかります。
llama.cppをどう使っていますか?
--hostでツールやMCPを有効にして動かしている場合、v1.0は--api-keyなしでは起動を拒否します。--allow-unauthenticated-toolsではなくキーを追加してください。ポートが今は厳密に検証されるので、--cors-originsの値も見直してください。llama_set_warmupと35個の非推奨関数への呼び出しを削除し、llama_set_embd_state_srcをllama_set_ctx_state_srcに改名し、v1.xに固定してください。ここからは、破壊的なC API変更はメジャーバージョン2.0を意味します。libggmlに対してリンクし、ライブラリのバージョン繰り上げで破壊的変更を示せます。llama.cppをどうインストールして動かしますか?
3つの方法があり、新しいものが最も親しみやすいです。以下のコマンドはすべてREADMEとllama.appからのものです。
1. Llamaデスクトップアプリ(MacとWindows)。 同じチームが今、Llamaを配布しています。Mac向けのメニューバーアプリとWindows 11向けのシステムトレイアプリです。サイトによればダウンロードは1MB、インストール後は4MBで、無料、オープンソース、オフラインでも使えます。ハードウェアを確認し、モデルごとに量子化、コンテキストサイズ、投機的デコーディングを選んでくれ、5分間アイドル状態になるとモデルはアンロードされます。
メモリに応じて始めるモデルを提案してくれます。16GBのMacならGemma 4、24GBならGPT-OSS、32GBならQwen 3.8です。Macではbrew install --cask llama-appでもインストールできます。
2. コマンドライン(どのOSでも)。 1行で統一されたllamaバイナリをインストールできます。
curl -LsSf https://llama.app/install.sh | sh
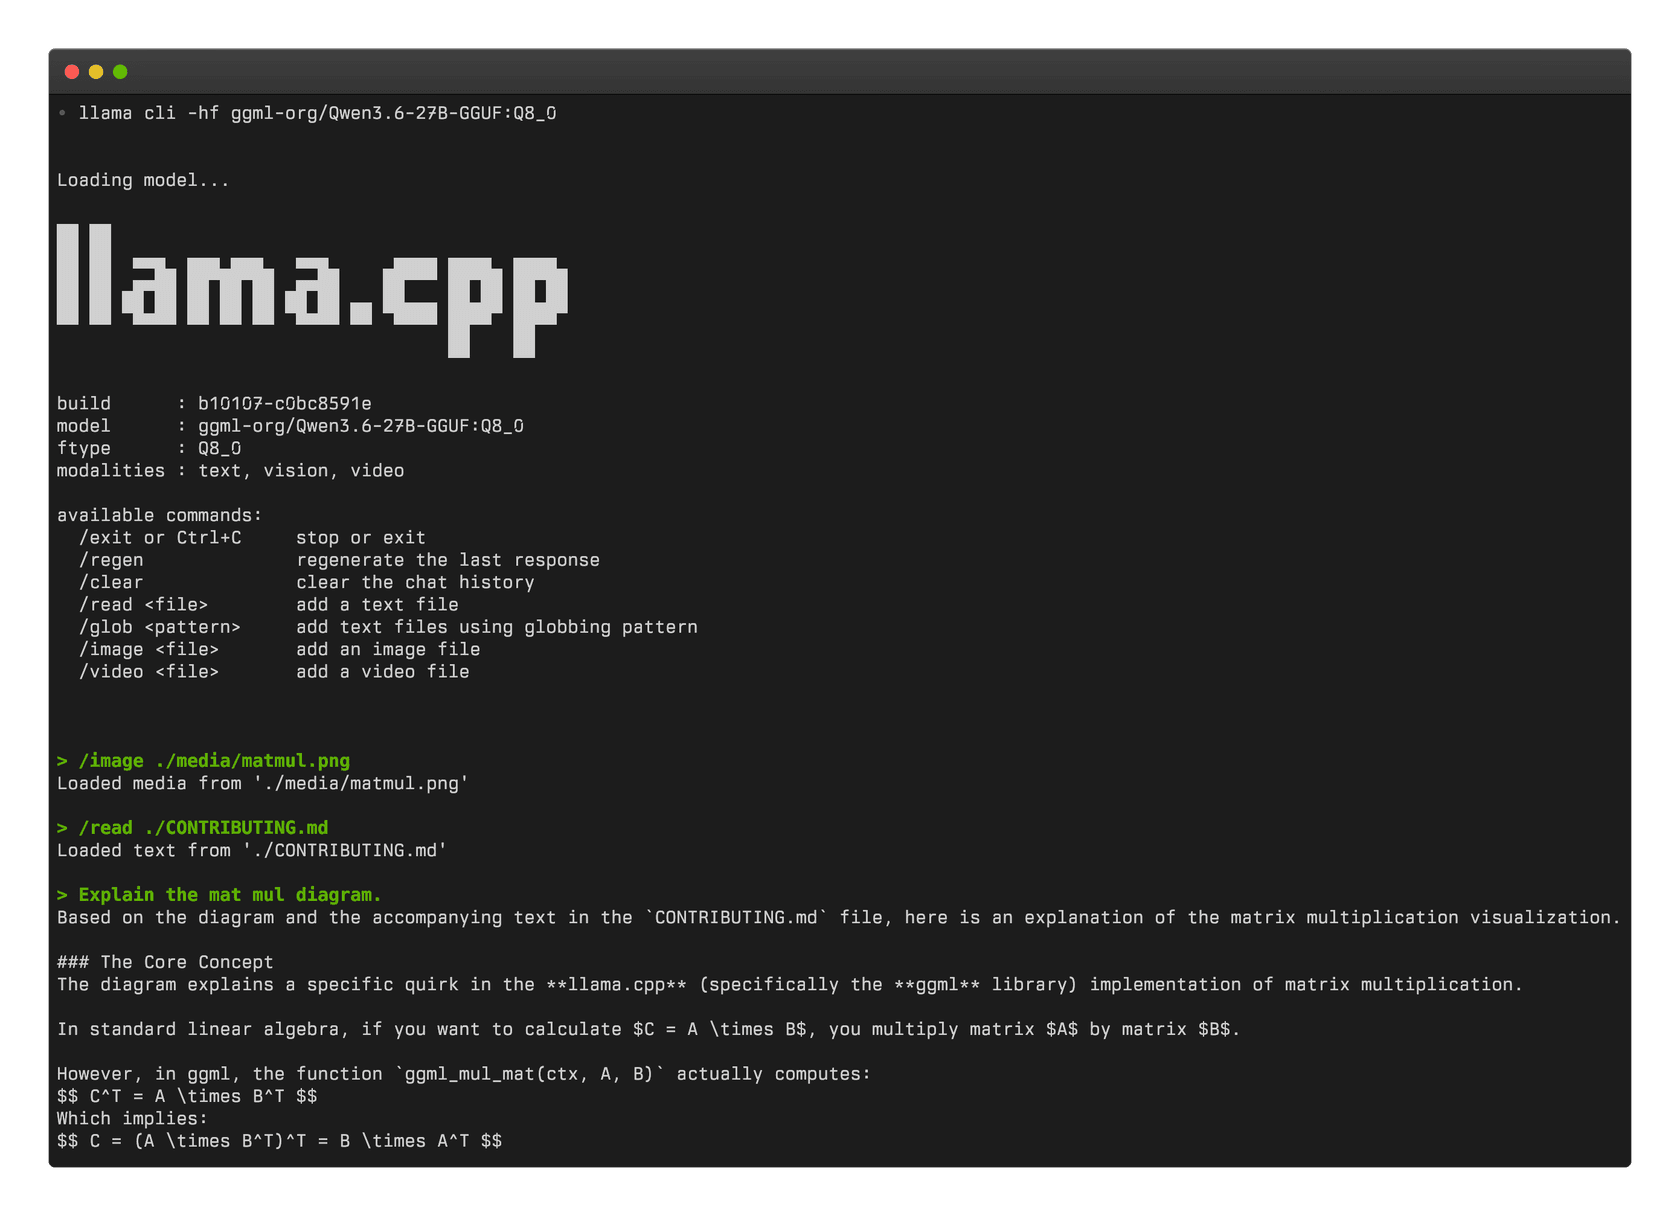
Windows PowerShellではirm https://llama.app/install.ps1 | iexです。その後、Hugging Faceからモデルをダウンロードしてチャットするか、OpenAI互換のサーバーを起動します。
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
3. パッケージマネージャーまたはソースから。 v1.0の発表には、Docker、Debian、Homebrew、conda-forge、MacPorts、Winget、iOSとmacOS向けのXCFramework、そしてLinux、macOS、Windows、Android、iOS向けのビルド済みバイナリが挙げられています。ソースからのビルドはビルドガイドにあります。
コーディングエージェントをそこに向ける
Llamaアプリはlocalhost:9931/v1でAPIを提供しており、サイトによればOpenAI互換とAnthropic互換の両方のエンドポイントに対応し、ストリーミング、ツール呼び出し、構造化出力、ビジョンにも対応しています。つまり、Cursor、OpenClaw、Claude Codeのようなツールは、ベースURLを変えるだけでローカルモデルを指すことができます。これは私のClaude Codeの環境変数のガイドで説明したのと同じパターンです。この方法自体をv1.0で自分では試していないので、あくまでドキュメントに書かれたルートとして扱ってください。
品質について手早く現実を確認しておきます。小さなローカルモデルは、難しいコーディング作業でホスト型のフロンティアモデルには及びません。DeepSeek V4 FlashとQwen 3.8 Maxの比較が、各階層でできることを知るより良い手がかりになります。
まだ足りないものは?
リリースとその反応から、3つのギャップが目立ちます。
- Linux向けデスクトップアプリがない。 LlamaはMacとWindowsのみで、Linuxユーザーはコマンドラインを使うことになります。発表記事へのコメント投稿者の一人も、まさにそれを聞いていました。
- 巨大な入力でのプロンプト処理。 同じ記事への別のコメント投稿者は、llama.cppは「巨大なプロンプト処理にはまだ改善が必要」と述べています。つまり最初のトークンが出るまでのプリフィル段階のことです。このリリースにはプリフィル関連の作業(Intel向けVulkan FlashAttentionのパス、CUDAの少ない行数向けmatmul)がありますが、名前を挙げられるような代表的な数字はありません。
- インストーラーはまだv1.0ではない。 上で触れたように、llama.appインストーラーとWingetはまだナイトリーを配布しています。ほとんどのユーザーにはそれで問題ありませんが、v1.0の安定性の約束は、タグからビルドするかHomebrewを使う場合にしか届かないということです。
これらはどれも見送る理由にはなりません。約束に頼る前に、自分がどのビルドの上にいるのかを確認する理由です。
llama.cppはサポートチームにとって何を意味しますか?
魅力は明らかです。自分のハードウェアから出ていかない顧客データと、トークンごとの課金がないことです。これはeeselの商談でよく聞くテーマです。デンマークのB2Bテレマティクス企業のある買い手は、トライアルの前に厳しい社内セキュリティレビューを通過する必要があり、最初の質問は、カード番号やパスワードを含むチケットデータが自社の環境内に留まるかどうかでした。
ローカルモデルはその一部にしか答えません。残りには答えません。どのヘルプ記事をエージェントが使えるか、いつ人にチケットを引き継ぐか、顧客が見る前にそれが正しいとどう分かるか、といった部分です。これらは、私が見てきたAIサポートのセキュリティレビューの裏にある質問の大半で、ベンダーセキュリティチェックリストとSOC 2とGDPRのガイドが詳しく扱っています。
その層を担うのがeeselのAIヘルプデスクのチームメイトです。すでにZendeskやFreshdeskで動かしているキューに参加し、あなた自身の知識から回答し、本番前に過去のチケットでシミュレーションされます。ベルリンのローン比較企業smavaは、月27,000件のZendeskチケットでこれを使い、820件のマクロとヘルプセンター記事からドイツ語で15,300件の返信ドラフトを用意しています。SE RankingはZendesk上でプロダクトごとに1つのeeselエージェントを動かし、返金や人への対応依頼はチームに引き継いでいます。
自社のサポートコンテンツ向けにモデルを検討しているなら、Claudeをヘルプデスクにつなぐ、AIエージェントの引き継ぎ、サポートにおけるAIハルシネーションの防止に関する私のガイドのほうが、リリースノートより先まで案内してくれます。
llama.cpp v1.0にアップグレードすべきですか?
libllamaをリンクしているなら、はい。これは文書化された互換性の約束を伴う最初のリリースなので、v1.xに固定して、ナイトリービルドの破壊的変更を追いかけるのをやめましょう。この整理を一度やれば終わりです。
llama-serverをネットワーク上で動かしているなら、慎重に、はい。アップグレードの前にAPIキーを追加して、新しいツールチェックでサービスが止まらないようにしてください。
デスクトップアプリを使っているなら、対応は不要です。すでにv1.0のすべてを含むナイトリービルドの上にいる可能性が高く、まだローカルモデルを試していなければ、新しいHugging FaceのLlamaアプリが最も簡単な入口です。ホスト型の代替については、Hugging Faceの代替のまとめとLLM追跡ツールのリストが次の良い読み物です。
サポートキューのAIにeeselを試す
顧客に答えるAIが欲しくてllama.cppを見ていたなら、eeselは量子化を選んだりGPUをサイジングしたりせずにそこへ連れていきます。ZendeskやFreshdeskなど他のヘルプデスクにつながるAIヘルプデスクのチームメイトで、あなたのヘルプセンターと過去のチケットだけから回答し、smavaが月27,000件のチケットで動かしているように、本番の会話に触れる前に過去の会話でテストされます。eesel CLIを使えば、コーディングエージェントが書き出したヘルプ記事やマクロをアップロードし、テストの質問をして回答を確認できます。ヘルプデスク自体の接続には、管理者権限を持つ人が今も必要です。eeselを試す、無料です。
よくある質問
llama.cppとは何ですか?
llama.cpp v1.0.0で何が変わりましたか?
llama.cppは無料ですか?
llama.cppはどうインストールしますか?
curl -LsSf https://llama.app/install.sh | shを、Windowsではirm https://llama.app/install.ps1 | iexを実行します。Homebrew、Winget、Docker、conda-forge、ビルド済みバイナリも使えます。その後llama cli -hf ggml-org/Qwen3.5-0.8B-GGUFでHugging Faceからモデルをダウンロードしチャットを開始します。llama.cpp v1.0は既存のセットアップを壊しますか?
llama_set_warmupなど削除された関数や--defrag-tholdオプションはなくなります。ツールやMCPを有効にしたまま非ループバックの--hostでllama-serverを動かし、APIキーがない場合、v1.0は--api-keyを追加するか--allow-unauthenticated-toolsで明示的に許可しない限り起動を拒否します。カスタマーサポートのMCPのガイドで、ツールアクセスがなぜこの関門を必要とするか説明しています。llama.cppとLlamaアプリの違いは何ですか?
localhost:9931/v1でOpenAI互換APIを提供します。Claude CodeやOpenClawのようなツールはこのローカルエンドポイントを指定できます。llama.cppでカスタマーサポートのチャットボットは動かせますか?
llama.cpp v1.0はインストーラーから入るバージョンですか?
llama --versionで確認してください。自分でモデルをホストする予定ならHugging Faceの料金の記事も参考にしてください。