

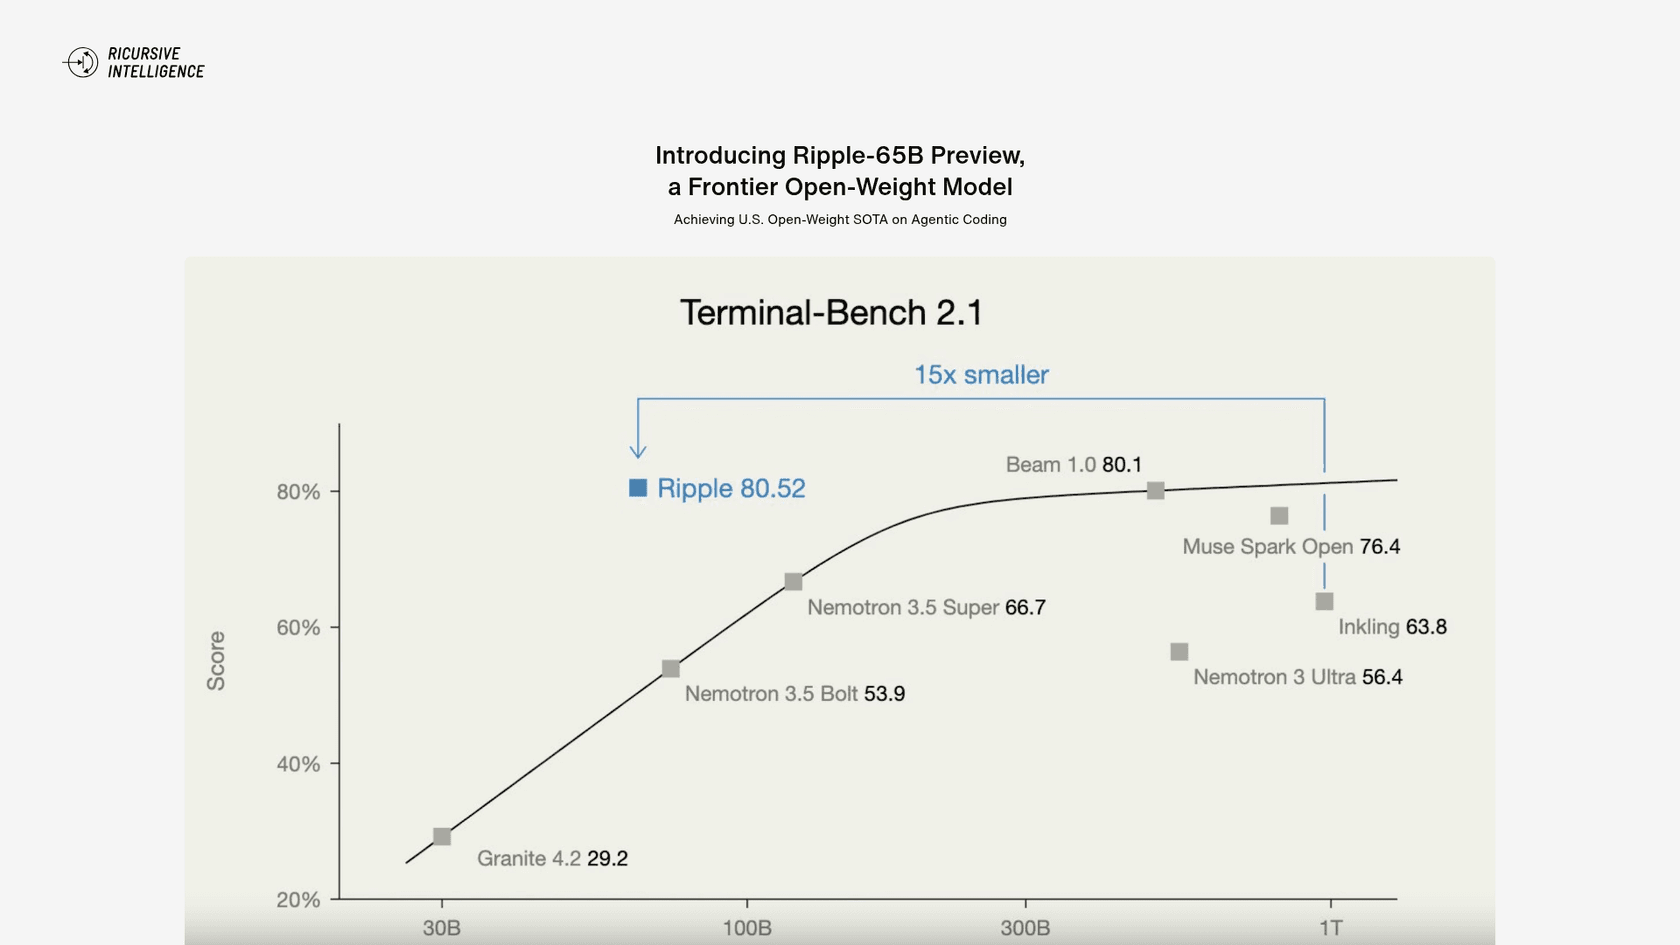
Ripple-65Bは、1台のマシンで動かせる米国製オープンモデルとしては最良ですが、オープンなコーディングモデル全体で最良というわけではありません。Terminal-Bench 2.1のスコアは80.5で、8倍近い大きさのReflectionのBeam(80.1)をわずかに上回ります。その項目を離れると、コーディングとエージェント系の5つのテストでBeamがリードし、BeamのAPIは100万トークンのコンテキストを提供する一方、Rippleは16,384です。
私の評価は3.5/5。DGX Sparkに収まるApache 2.0の米国製の重みが欲しいならRipple、APIだけ使いたいならBeamを選んでください。サポートエージェントには、eeselのような完成済みのチームメイトならモデル選びが不要になり、そのCLIを使えば、コーディングエージェントがヘルプドキュメントを読み込み、本番公開前に回答をテストできます。
Ripple-65Bとは?1分で解説
Ripple-65B Previewは、チップ設計向けAIを開発するラボRicursive Intelligenceが2026年11月4日に公開したオープンウェイトの言語モデルです。Ricursiveはゼロから学習させ、"a general-purpose variant of the proprietary model that powers our AI chip design platform." と説明しています。仕様を詳しく知りたい方は、同僚のRipple-65B解説記事をご覧ください。この記事は評価編です。
モデルカードにあるスペック表です。
| 項目 | Ripple-65B Preview |
|---|---|
| パラメータ数 | 合計65B、すべてアクティブ(Mixture-of-ExpertsではなくDense) |
| レイヤー数 | 80。グローバル層1つにつきスライディングウィンドウ層が4つ |
| 学習データ | 12Tトークン、テキストのみ、主に英語とコード |
| コンテキスト(公称) | 最大1Mトークン |
| ライセンス | Apache 2.0 |
| チェックポイント | BF16 instruct、NVFP4 instruct(実験的)、base、DFlash2ドラフトモデル |
| 推論 | 常に<think>タグ内で思考。オン/オフの切り替えや推論強度の段階なし |
| 研究開発費の総額 | $32M(Ricursive発表) |
最後の行が話題になっている点です。Ricursiveは、$32Mがゼロからの研究開発費の全額であると述べ、これを"one-tenth the cost of the previous open-weight SOTA on agentic coding." と表現しています。脚注によると、この「10分の1」はBeamの計算コストについてのRicursive自身の推定で、報道とReflectionの学習スケジュールをもとにしています。監査済みの比較ではなく、大まかな目安として受け取ってください。
どのようにレビューしたか
私はeesel AIエージェントの裏側の連携部分を作っているので、モデルカードは本番に組み込む前のAPI仕様書のように読みます。数字は何か、どこから来たのか、実際に呼び出すと何が壊れるのか、という観点です。eeselが実際のヘルプデスクにエージェントを導入してきた長年の経験から言えるのは、リーダーボードでは自社のチケットでモデルがどう動くかは分からないということです。だからこそ、eeselの導入はすべて、公開前に過去のチケットでシミュレーションします。
Rippleについては、公開日に自分のテストセットを回すAPIアクセスがなかったため、このレビューは一次情報のみに基づいています。
- Ricursiveのローンチ記事と、推論スクリプトを含むHugging Faceのモデルカード。
- 2026年11月5日に確認した、OpenRouter、GMI Cloud、Together AIの掲載情報。
- Hacker NewsとXでの初日の開発者の反応。
RippleはまだArtificial Analysisに載っていないため、以下のベンチマークはすべてRicursive自身の数字です。2つのページが必ずしも一致しないので、それぞれどのページの数字かを明記します。
Ripple-65BはBeamや他の米国製オープンモデルと比べてどうか
Ricursiveが最初に挙げる2項目ではRippleが勝ちます。ほかの項目の大半では勝てません。以下はモデルカードのinstruct表から、コーディングモデルの購入者に関係するコーディングとエージェント系の項目だけを抜き出したものです。
| ベンチマーク | Ripple-65B | Beam 501B | Muse Spark Open 816B | Inkling 975B | Nemotron 3 Ultra 550B |
|---|---|---|---|---|---|
| Terminal-Bench 2.1(自己申告) | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| SWE-bench Pro v2.0 Hard | 79.1 | 76.5 | 52.3 | 2.0 | 30.7 |
| SWE-bench Verified | 76.5 | 81.6 | 78.7 | 77.6 | 71.9 |
| SWE-bench Pro v1.0 | 61.42 | 66.1 | 58.2 | 54.3 | 46.9 |
| DeepSWE 1.1 | 44.3 | 43.3 | 60.0 | 1.8 | 0.2 |
| MCP Atlas | 71.67 | 80.8 | 89.2 | 76.0 | 62.2 |
| τ³-bench banking | 31.27 | 36.1 | 14.4 | 23.7 | 22.6 |
| SciCode | 39.4 | 49.2 | 58.5 | 46.1 | 44.6 |
目につく点が2つあります。1つ目は、Terminal-BenchでのBeamに対するリードは0.4ポイントで、正直に見れば同点です。2つ目は、Beamが5つのコーディング・エージェント系の項目でRippleを上回り、Muse Spark Openレビューで取り上げたMuse Spark OpenがDeepSWE、MCP Atlas、SciCodeを取っていることです。
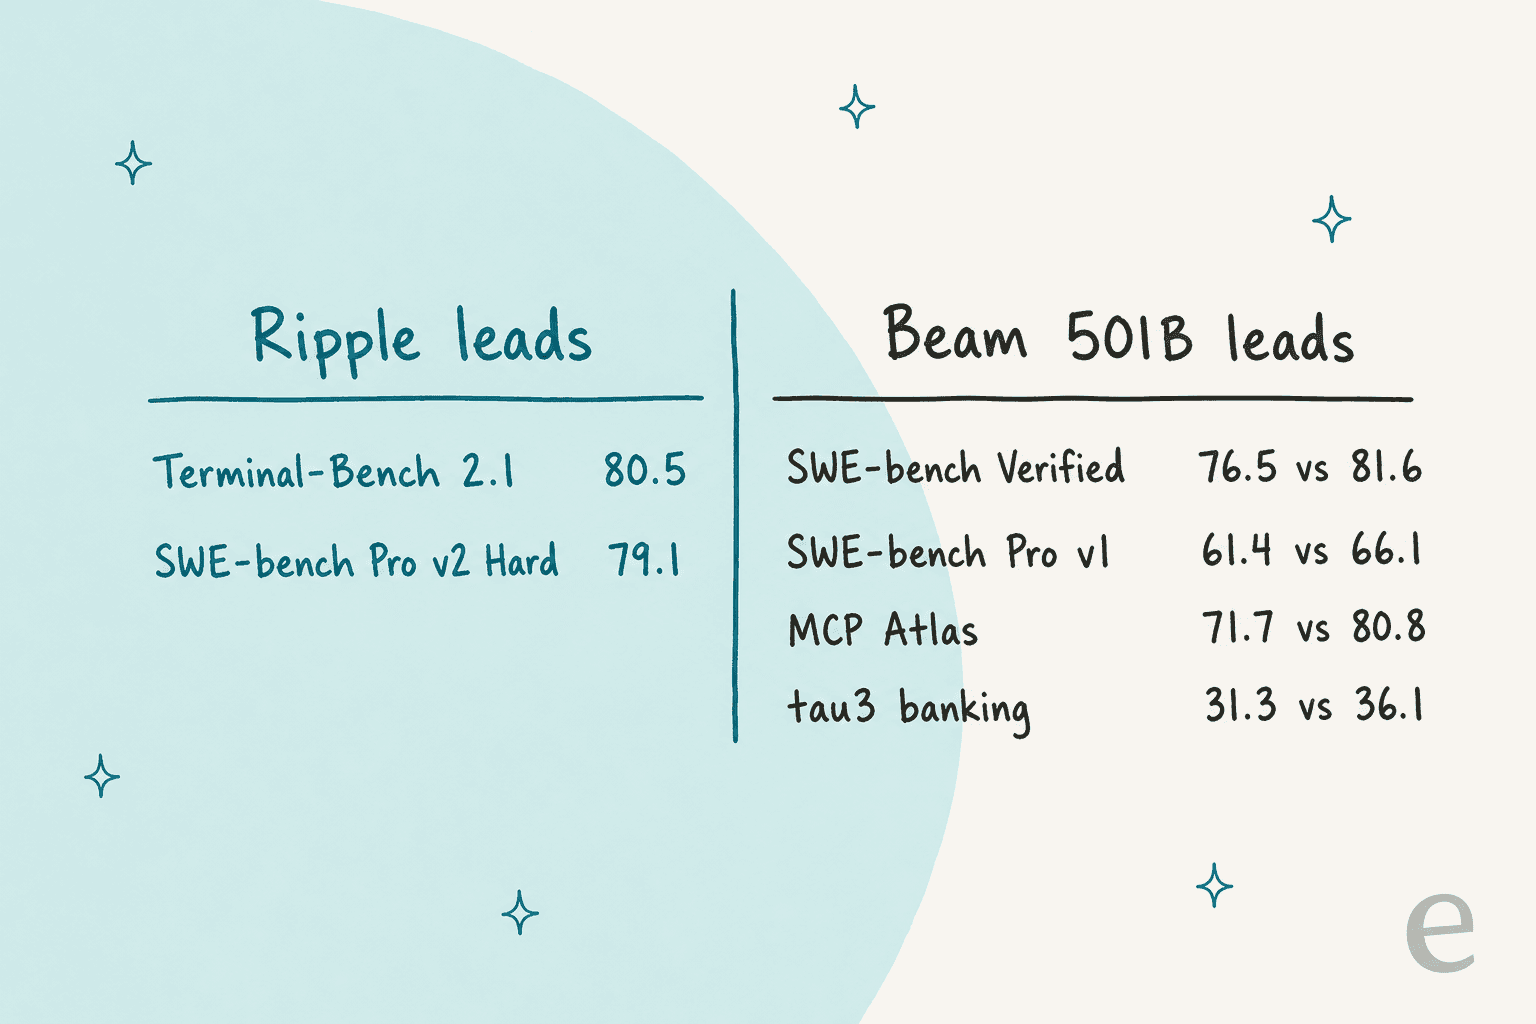
とはいえ、65Bモデルが最良の項目で501Bモデルに並んだことは、確かな成果です。Beamはトークンあたりのアクティブパラメータが23B、Rippleは65Bすべてがアクティブなので、「8倍小さい」という言葉ほど差は大きくありませんが、メモリの面ではRippleのほうがはるかにホストしやすいです。
どの数字を信頼すべきか
Ricursiveは数字のばらつきについて率直です。モデルカードには、競合のスコアは"official model card scores where available"で、残りは自社の内部実行だと書かれています。また、公式のTerminus 2ハーネスではTerminal-Bench 2.1のスコアが"universally lower (with the exception of Muse Spark Open)"になったとも記されており、両方を報告しています。
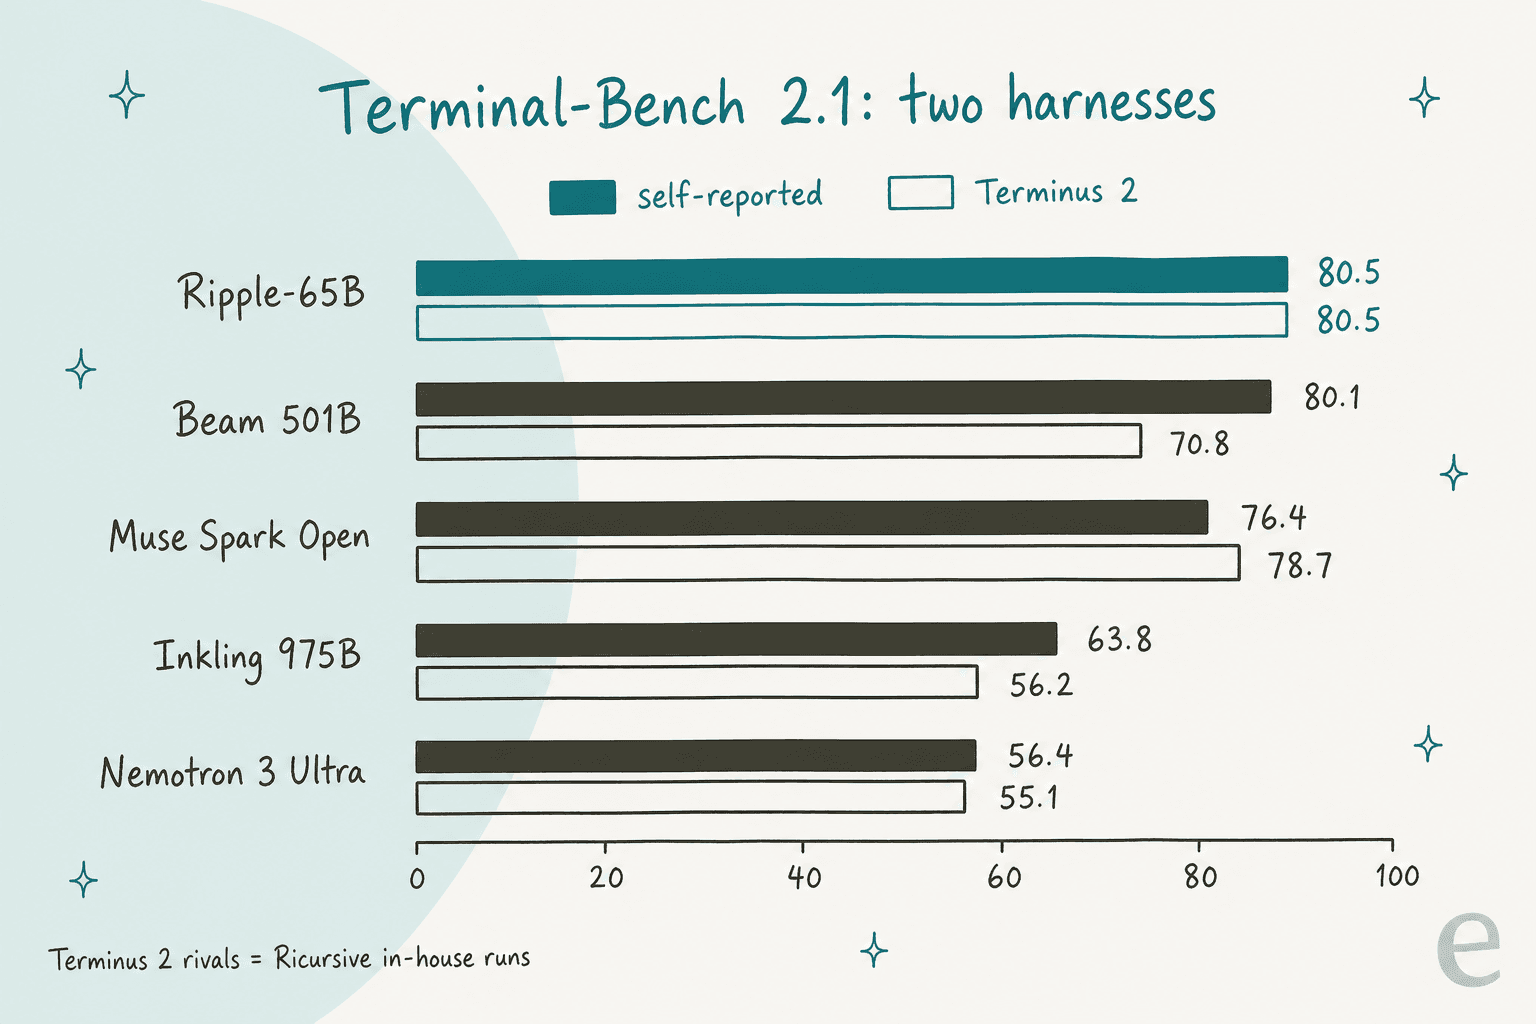
同じTerminus 2ハーネスでは、RippleのBeamに対するリードは10ポイント近くに広がります(80.5対70.8)。これはこのリリースで最も興味深い数字であり、最初に検証したい数字でもあります。そこでのBeamの数字はReflectionではなくRicursive自身の実行によるものだからです。
もう1つの問題点:ローンチ時のチャートとモデルカードで、一部の競合スコアが食い違っています。SWE-bench Pro v2.0 Hardについて、ローンチ記事ではMuse Spark Openが72.4、Inklingが39.6ですが、モデルカードでは52.3と2.0です。Ripple自身の数字は両ページで一致しています。プレビュー版のローンチなので、いずれ整合されるでしょうが、それまでは競合の列は目安として扱うのが良いでしょう。
Ripple-65Bの料金は?
Rippleは呼び出しコストが安いのですが、大きな落とし穴が1つあります。以下の価格は2026年11月5日に確認した各プロバイダー自身の掲載情報です。
| 経路 | 入力 / 1M | 出力 / 1M | キャッシュ読み取り / 1M | コンテキスト |
|---|---|---|---|---|
| GMI Cloud | $0.20 | $0.60 | $0.05 | 1,000,000と掲載 |
| OpenRouter(GMIが提供) | $0.20 | $0.60 | $0.05 | 16,384、最大出力14,745 |
| Together AI | 近日公開 | 近日公開 | n/a | 1Mと掲載 |
| Hugging Faceの重み | 無料(Apache 2.0) | 自前のハードウェア | n/a | 2x B200で最大1M |
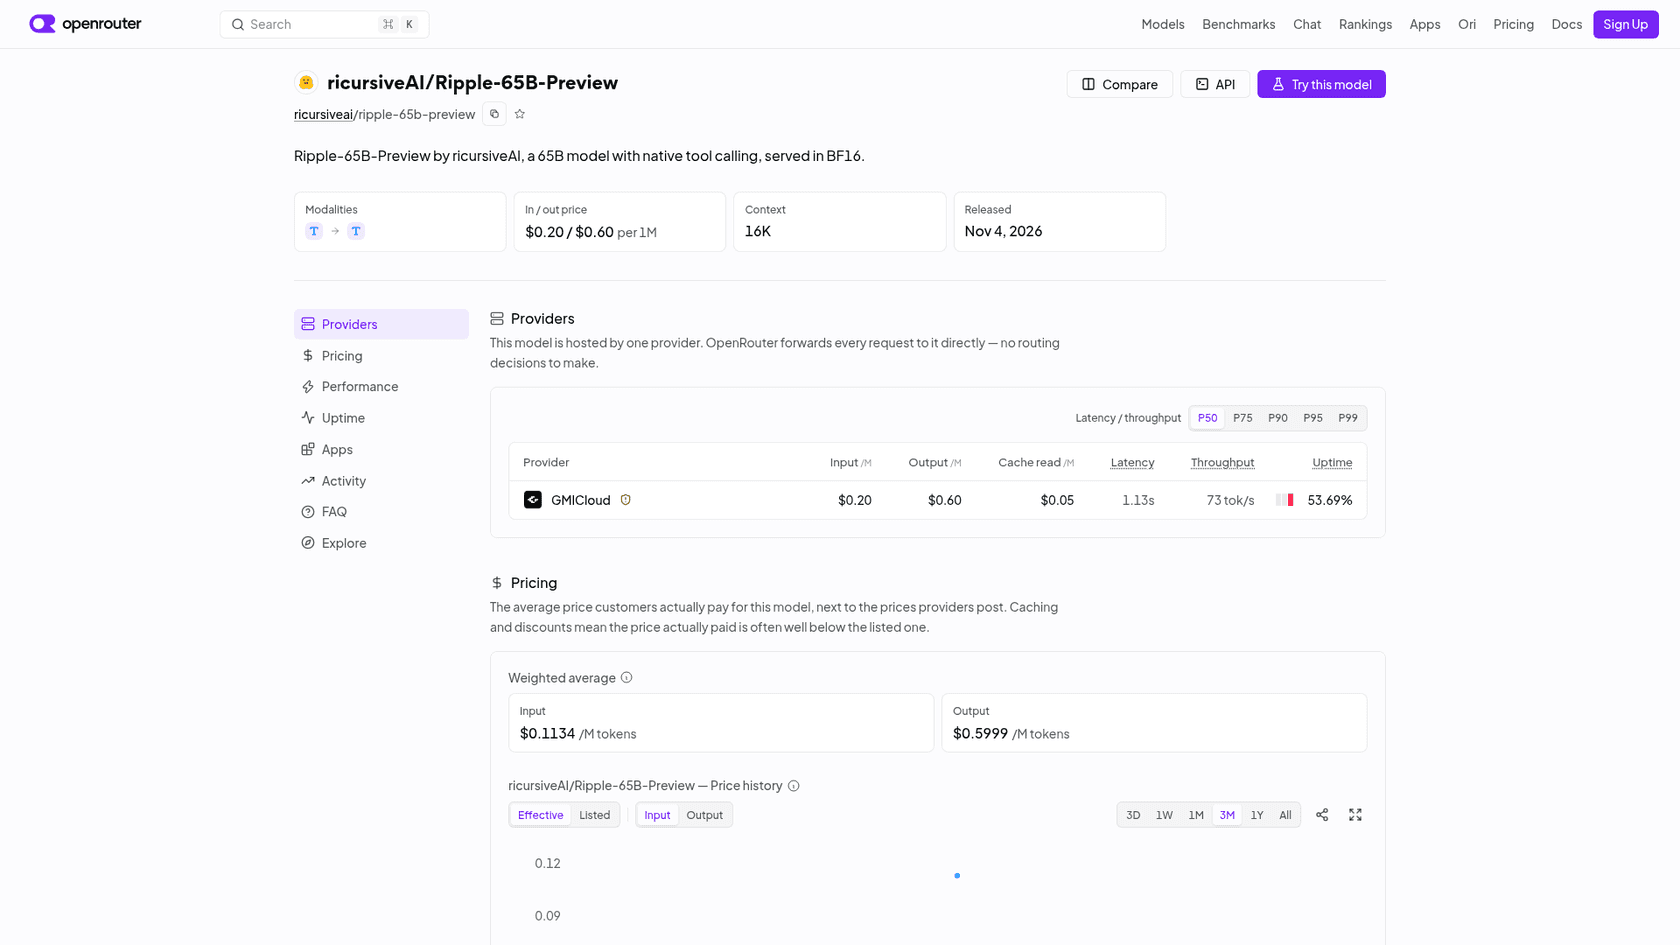
落とし穴はその16Kのウィンドウです。Claude Codeのようなコーディングエージェントや、ターミナルAIコーディングガイドで紹介したツールは、リポジトリを読み終える前に16,384トークンを使い切ることがあります。現時点でOpenRouter経由のRippleは、本来想定されたエージェント型コーディングには視野が狭すぎます。ページを取得した時点では、プロバイダーは1社のみで、稼働率53.69%、毎秒73トークンでした。2日目としては普通ですが、まだ本番に置けるものではありません。
OpenRouterの定価を使って、入力10M・出力1Mトークンのセッションをオープンな競合と比べるとこうなります。
| モデル | 1Mあたり入力 / 出力 | 入力10M + 出力1Mのコスト | OpenRouterでのコンテキスト |
|---|---|---|---|
| Ripple-65B Preview | $0.20 / $0.60 | $2.60 | 16,384 |
| Beam 1.0 501B | $0.25 / $1.00 | $3.50 | 1,048,576 |
| Qwen3.8 27B | $0.15 / $1.875 | $3.38 | 1,024,000 |
| DeepSeek V4.1 Flash | $0.045 / $0.50 | $0.95 | 1,048,576 |
| Inkling | $1.00 / $4.05 | $14.05 | 524,288 |
| Muse Spark Open | $1.25 / $4.25 | $16.75 | 1,048,576 |
つまりRippleはこのセッションでBeamより$0.90安い代わりに、コンテキストは64分の1です。ほとんどのAPI利用者にとって、このトレードは割に合いません。予算重視ならDeepSeek V4 Flashが引き続き有力で、Ricursiveがチャートから外した明らかな中国勢の比較対象がQwen 3.8です。Kimi K3も同様です。
自分のハードウェアで実際に動かせるか
はい。そしてここがRippleの強みです。Dense 65Bモデルは1台のマシンに載るほど小さく、Ricursiveはそのためのスクリプトを提供しています。ローンチ日の宣伝が省いているのは、各経路があなたに何を求めるかです。
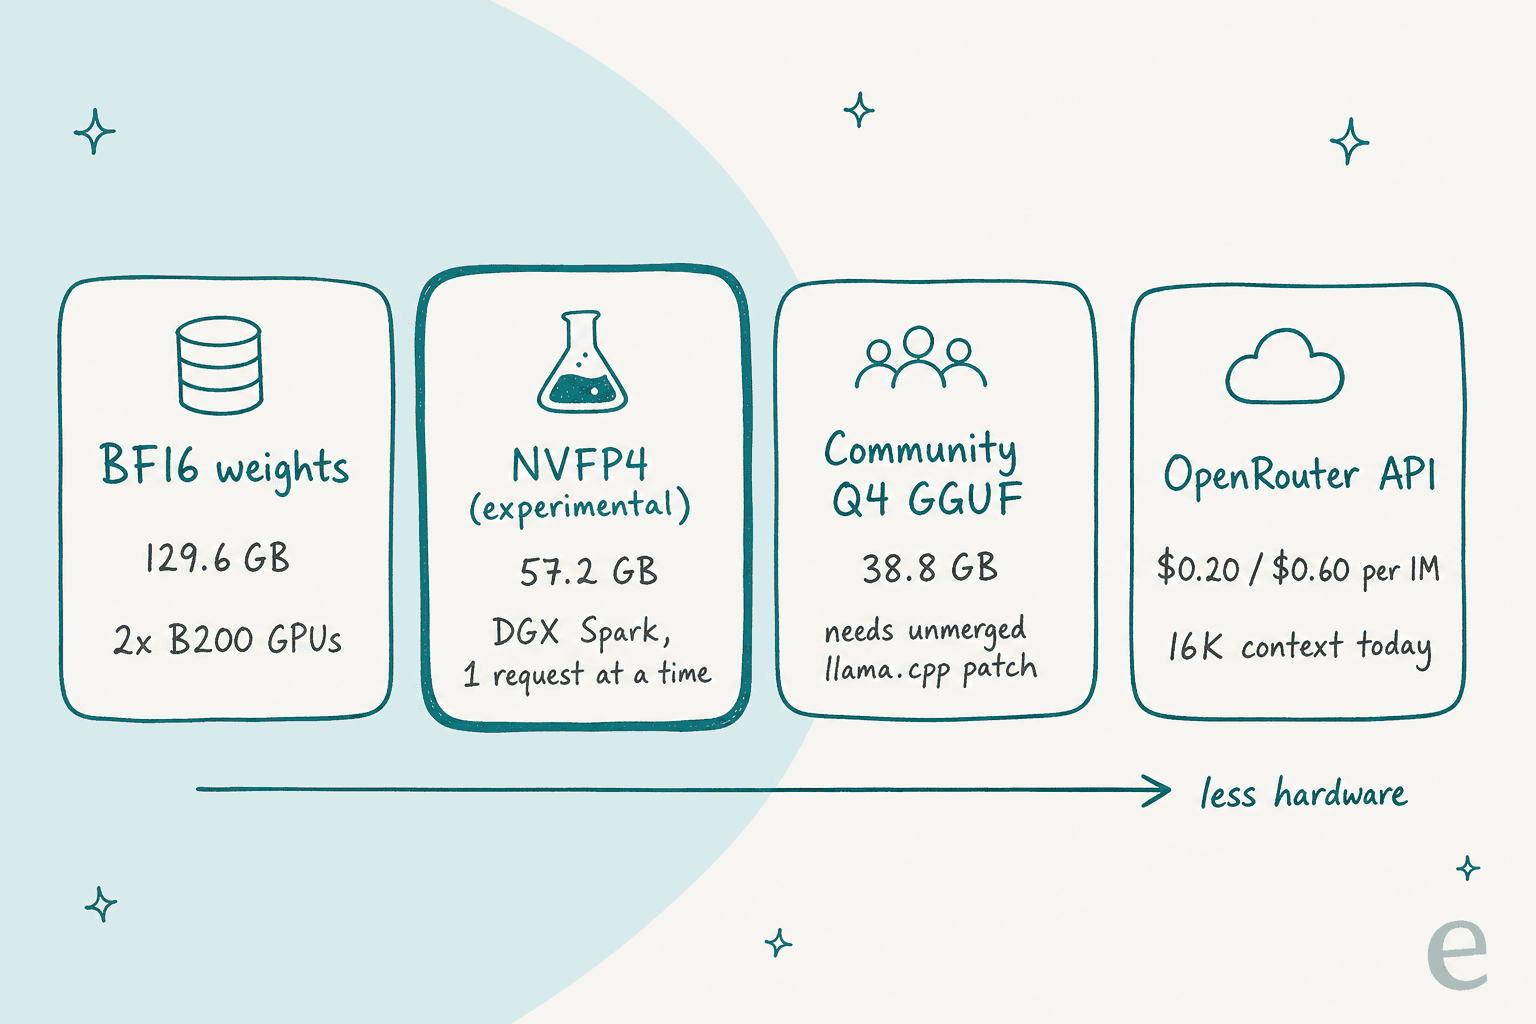
- 2x B200でのBF16。 サーバーのREADMEでは、SGLang 0.5.19とDFlash2ドラフトモデルを使い、デフォルトのコンテキストは1Mです。カードにはバッチ8で毎秒
250トークンとあります。 - DGX SparkでのNVFP4。 NVFP4チェックポイントは実験的と表示され、アテンションはBF16のままで、ローカルスクリプトは128Kコンテキストで1リクエストずつ処理します。
- コミュニティ製GGUF。 AtomicChatの量子化版はQ4_K_Mで
38.8 GBですが、llama.cppのパッチが入るまで、標準のllama.cpp、Ollama、LM Studioでは読み込めません。 - MLXビルドなし。 Ricursiveの共同創業者は"on a MacBook Pro"で動かせると投稿しましたが、Apple Siliconを扱う公式ガイドはまだありません。
Hacker Newsのコメントが、Denseモデルのトレードオフをうまく言い表していました。
"it's a 65B dense model and inference will be prohibitively slow on consumer grade hardware"

そして、適したハードウェアを持つ人からの反対側の意見です。
"Speaking as someone who has High-Memory Mac Studios, it is great that there is finally a model that will run at usable speeds with high quality."
エージェントに組み込む人向けに、小さな落とし穴がさらに2つあります。チャットテンプレートは"does not implement a thinking on/off switch or reasoning-effort levels"のため、すべての返信が推論の分のコストを払います。また、ツール呼び出しを強制するには厳密なスキーマが必要です。カードは"Non-strict required calls produced extra argument fields."と警告しています。OpenRouterのエンドポイントは今のところtool_choiceにnoneかautoしか受け付けません。
開発者の反応は?
初日の反応ははっきり割れました。学習コストはほぼ全員が称賛し、「最先端」という打ち出し方には反論が出ています。X側の反応です。
"this is like the avengers of open model SOTA"
これは$32Mの研究開発費総額に対するswyxの反応でした。スレッドが182ポイントに達したHacker Newsでは、最も返信が付いた不満はカテゴリーの狭さでした。
"Category narrowing to this degree really has diluted the term "SOTA" quite a lot"
複数のコメント投稿者が、チャートは米国のオープンモデルしか比較しておらずQwenを除外していると指摘しました。ある人はRippleのTerminal-BenchスコアをAlibabaのものと並べています。
"This model scores 80.5 on Terminal Bench 2.1 For reference Qwen 3.8 Flash Next (which is bigger than this model but probably cheaper to run due to MoE) scores 84.3, and Qwen 3.8-27B scores 73.0."
そして、このモデルが本当は誰のためのものかを私なりに説明してくれるコメントがこれです。
"There are several situations where some of us are explicitly prohibited from using models from companies not under the jurisdiction of the United States."
それが本当の市場です。セキュリティ部門が中国ラボの重みを禁止しているなら、このサイズの選択肢は乏しく、Rippleは今や1台のワークステーションに収まる最強の米国製オープンモデルです。
サポートエージェントにRipple-65Bを使うべきか
第一候補にはしません。理由はRicursive自身の表にあります。τ³-bench bankingは、カード上でカスタマーサービスのテストに最も近いもので、銀行の顧客に対してポリシーに従いツールを呼び出すエージェントを測ります。Rippleはここで31.27と、Beamの36.1に及びません。常時オンの推論(最初の返信が遅くなる)、"with a focus on agentic coding"という軽めの学習後調整、ホスト版16Kのコンテキストを合わせると、別の用途向けに作られたモデルです。何が重要かは、サポートに最適なLLMのガイドで詳しく解説しています。
より大きなポイントは、モデルはインフラだということです。サポートチームにとって難しいのはその周辺、つまりヘルプデスクを読み、過去のチケットから学び、いつ引き継ぐかを判断することです。それを担うのがeeselです。自分でホストするモデルではなく、AIヘルプデスクチームメイトのように、仕事のために採用するAIチームメイトです。3つの顧客事例を紹介します。
- SE RankingはZendesk上で製品ごとに1つのeeselエージェントを運用し、1か月で
4,650件の会話を処理し、返金、トライアル延長、Tier 2の質問はチームに引き継いでいます。 - TimengoはFreshdeskで利用し、約
5,300件の過去チケットとヘルプ記事から技術チケットへの返信を下書きしており、eeselが顧客に自動で返信することはありません。 - SamCartはFreshdeskとウェブサイトチャットで別々のエージェントを運用し、約
280件のヘルプセンター記事から回答しています。
ターミナルからツールを操作するのがお好みなら、eesel CLIを使うと、Claude Code、Codex、Cursorなどのコーディングエージェントが、エクスポートしたヘルプ記事やポリシーなどの承認済みナレッジをアップロードし、eesel chatでテスト質問を投げて、公開前に回答を確認できます。ヘルプデスク自体の接続には、承認する管理者権限を持つ人が引き続き必要です。このパターンの詳細はAIエージェントCLIのガイドに、もう一方の入口はMCPサーバーの解説にあります。
乗り換える前の注意点
- ホスト版のコンテキストは16K。 チャットには十分ですが、GMIやTogetherが引き上げるまで、リポジトリ規模のエージェント作業には小さすぎます。
- ベンチマークはまだ独立検証されていない。 Artificial Analysisに掲載がなく、ローンチ時のチャートとモデルカードで一部の競合スコアが食い違っています。
- ローカル環境はNVIDIA優先。 公式の方法にはB200かDGX Sparkが必要で、Macユーザーはコミュニティ製ビルドを待つことになります。
- 常に思考する。 速く簡単な返信のために推論を切る方法がありません。
- プレビュー版。 Ricursiveは学習後調整を"relatively light"と呼んでおり、NVFP4ビルドは実験的です。
結論:Ripple-65Bを動かすべき人は
私の評価:3.5/5。 Rippleは5人の学習チームによる初のモデルとして印象的で、$32Mという総コストはオープンモデルの今後にとって重要です。しかし、目玉の勝利は0.4ポイントの同点であり、モデルを実力で比べる購入者は、より多くの項目でBeamが先行していることに気づくでしょう。
- 使うべき人: 米国ラボ製のApache 2.0の重みが必要で、DGX SparkかB200を2基持ち、エージェントがターミナルで動く場合。これは確かなニッチで、Rippleがそこを押さえています。
- 見送るべき人: APIを呼び出す場合。Beam 1.0は
$0.25/$1.00で1Mのウィンドウがあり、ラボの出自を気にしないならDeepSeek V4 Flashのほうがはるかに安いです。 - 1か月待つべき人: Macを使う場合。llama.cppの対応がマージされ、誰かが実際の毎秒トークン数を公開すれば、ローカル運用の可否ははるかに明確になります。
より広い状況については、最大の米国製オープンモデルを扱ったInklingレビューをご覧ください。GLM-5.3 Flashレビューでは、より安価な中国製の選択肢を取り上げています。
Kimi K3の代替のまとめ記事では、オープンモデルを並べてランク付けしています。クローズド側では、Claude Sonnet 5.5が依然としてほとんどのコーディングエージェントの標準モデルで、GPT-5.6がそのすぐ後ろに続いています。
eeselを試す
サポートエージェントを動かすモデルを選ぶためにここへ来たなら、その手順は省けます。eeselは、Zendesk、Freshdesk、Gorgiasにつながり、過去のチケットとヘルプセンターから学び、誰かに回答する前に実際の会話でテストされるAIチームメイトです。SE Rankingは、セットアップから3製品で月4,650件の会話にまで拡大しました。プランは料金ページで、500クレジットが$299/monthから、無料トライアル付きです。eeselを試して、まず自社のキューで動かしてみてください。
