手短な答え:Xiaomi MiMo V2.6の実際のコスト
私はAIの料金ページを2年間見続けてきましたが、ほとんどのモデルのローンチでは、本当に知りたい数字が埋もれています。Xiaomiはその逆を行いました。2026年9月22日、MiMo V2.6ファミリー全体をオープンソース化し、MITライセンスのもとで公開し、API料金は前世代から据え置きました。
つまり、考えるべき価格は実質2つあります。ウェイトをダウンロードして自前のハードウェアで動かすならゼロ。誰かにGPUをホストしてもらうならトークンあたりのAPI価格です。ローンチ当日に確認した、OpenRouterによるホスト型価格の全リストは以下のとおりです。
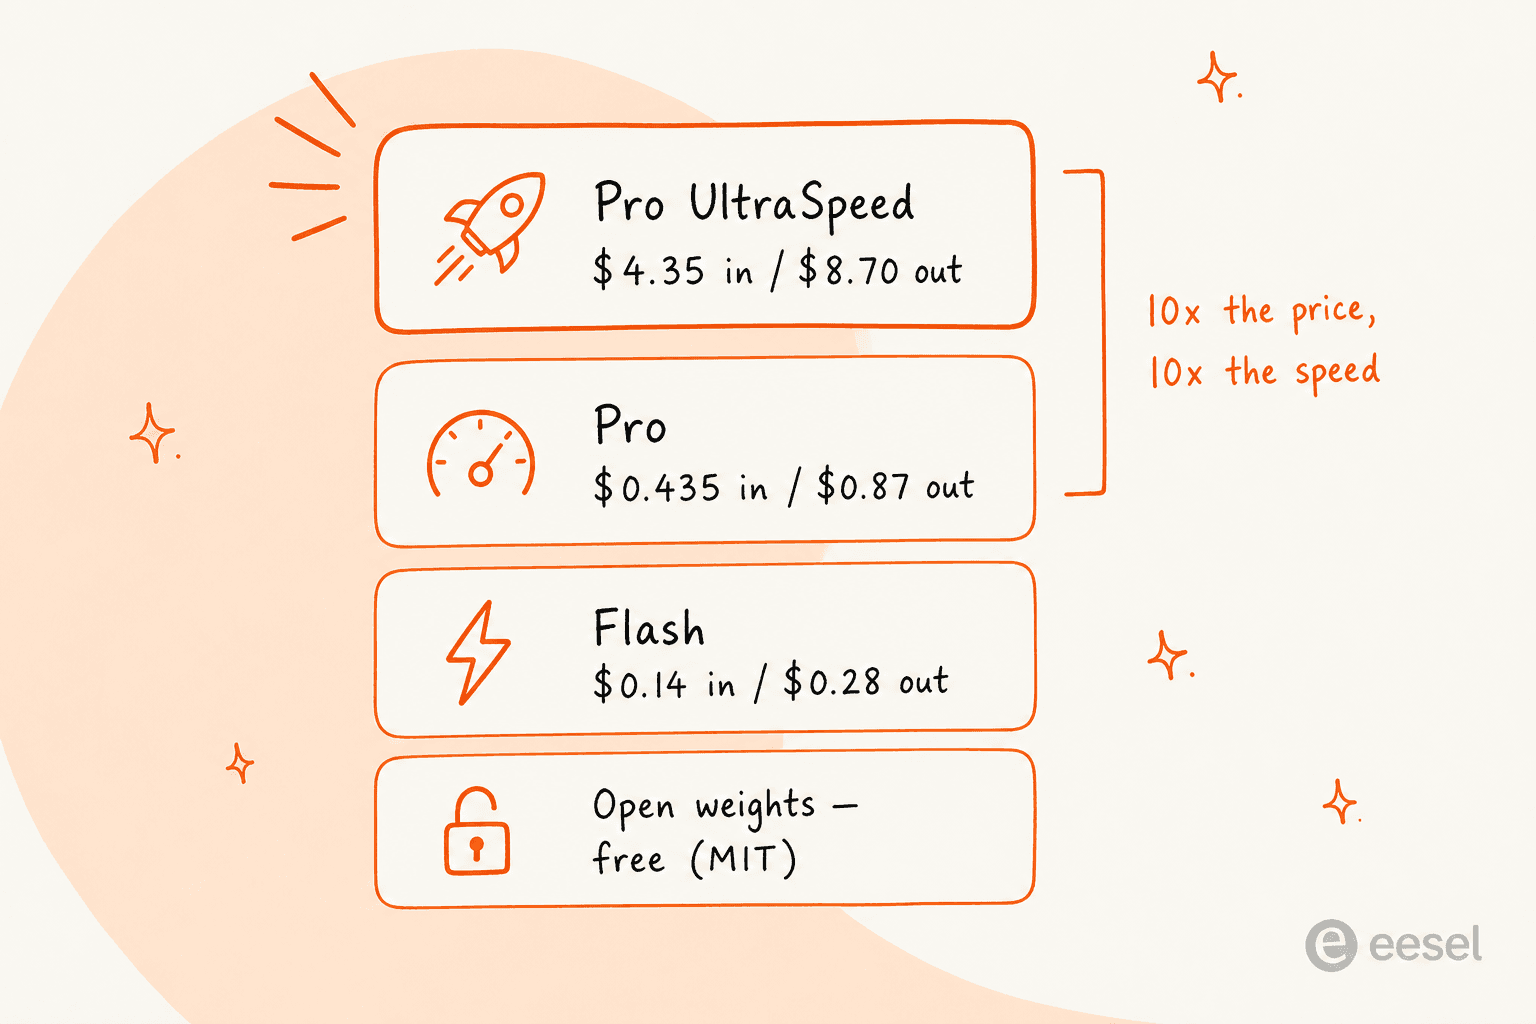
すべてのバリエーションは同じ100万トークンのコンテキストウィンドウを持ち、ネイティブでオムニモーダル(テキスト、画像、動画、音声)です。つまり、長いコンテキストや追加モダリティに割増料金を払う必要がありません。これは珍しいことであり、この料金設定が積極的に見える大きな理由の一つです。
4つのバリエーションと、それぞれの用途
MiMo V2.6は単一の価格を持つ単一モデルではありません。4つのチェックポイントからなるファミリーであり、間違ったものを選ぶことが最も早く払い過ぎる方法です。それぞれの位置づけは以下のとおりです。
MiMo V2.6 Pro(入力$0.435/出力$0.87)
Proはフラッグシップです。総パラメータ数1.02兆、アクティブパラメータ42BのスパースMixture-of-Expertsモデルです。オープンウェイトのベンチマークでトップに立つモデルであり、本格的なエージェント作業、長時間にわたるコーディング、複数ステップのツール利用に向いています。入力$0.435/出力$0.87という価格は、しのぎを削るフロンティアのクローズドモデルの多くより安く、これこそがこのリリース全体のポイントです。
MiMo V2.6 Flash(入力$0.14/出力$0.28)
Flashは効率重視のチェックポイントで、総パラメータ数309B、アクティブパラメータ15B。Xiaomiは知能・効率・コストの最良のバランスだと説明しています。入力$0.14/出力$0.28で、Proの3分の1の価格でありながら、Xiaomi自身の数字によれば犠牲になっている部分は驚くほど少ないです。AutomationBenchではProの53.1に対し52.3を記録しています。大量かつ範囲が明確なほとんどの作業では、Flashがコストパフォーマンスに優れた選択肢です。
MiMo V2.6 Pro UltraSpeed(入力$4.35/出力$8.70)
UltraSpeedは、追加の知能を買っているわけではないと気づくまでは分かりにくい存在です。これはProとまったく同じチェックポイントを、約10倍の出力速度(毎秒約116トークン)で提供するものです。Xiaomiはこれに対してProの10倍の料金を課しています。つまり純粋なレイテンシ税であり、顧客が入力しているところを見ているライブチャットエージェントのように、速度が実際のボトルネックになる場合にのみ支払う価値があります。夜間バッチ処理なら、10倍の無駄な出費になります。
MiMo V2.6 Distill-Qwen-9B(無料ウェイトのみ)
9Bディスティルは、MiMoが生成したデータでQwen3.5-9Bをファインチューニングした密なモデルです。有償APIには含まれておらず、ローカル推論やオープンな研究のための小規模でシングルGPUの出発点として存在します。すでにllama.cpp、LM Studio、Ollama向けのコミュニティ製GGUF量子化版があり、ワークステーションで動かせるモデルです。
見落とされがちなキャッシュ割引
上記の定価は、ヘビーユーザーが実際に支払っている金額ではありません。MiMo V2.6 Proはキャッシュ読み取りトークンを100万あたり約$0.0036としており、入力料金$0.435に対して99%の割引です。Xiaomiのベンチマークパートナーはこう表現しています。
"Despite the improvement, it retains the same attractive pricing at $0.435 per 1M input tokens (with a 99% cache-hit discount) and $0.87 per 1M output tokens."
なぜこれが価格において重要なのでしょうか。実際のワークロードはどれも同じコンテキストを何度も送信するからです。コーディングエージェントは同じリポジトリを何度も読み直します。サポートエージェントはチケットごとに同じポリシーとマクロを読み直します。そのコンテキストがキャッシュされれば、入力トークンにかかる費用はわずかになります。プロンプトを使い回すユースケースであれば、実質の入力価格は定価をはるかに下回り、このギャップこそがMiMoの総コストが本当にフロンティアと差をつける部分です。
MiMo V2.6の料金をフロンティアと比較する
これはまさにこのローンチのために用意された比較です。Artificial Analysis Intelligence Indexでは、MiMo V2.6 Proは46を記録し、オープンウェイトのトップモデルとなり、同日発表のGrok 4.7と並び、クローズドモデルのリーダーたちのすぐ後ろにつけています。
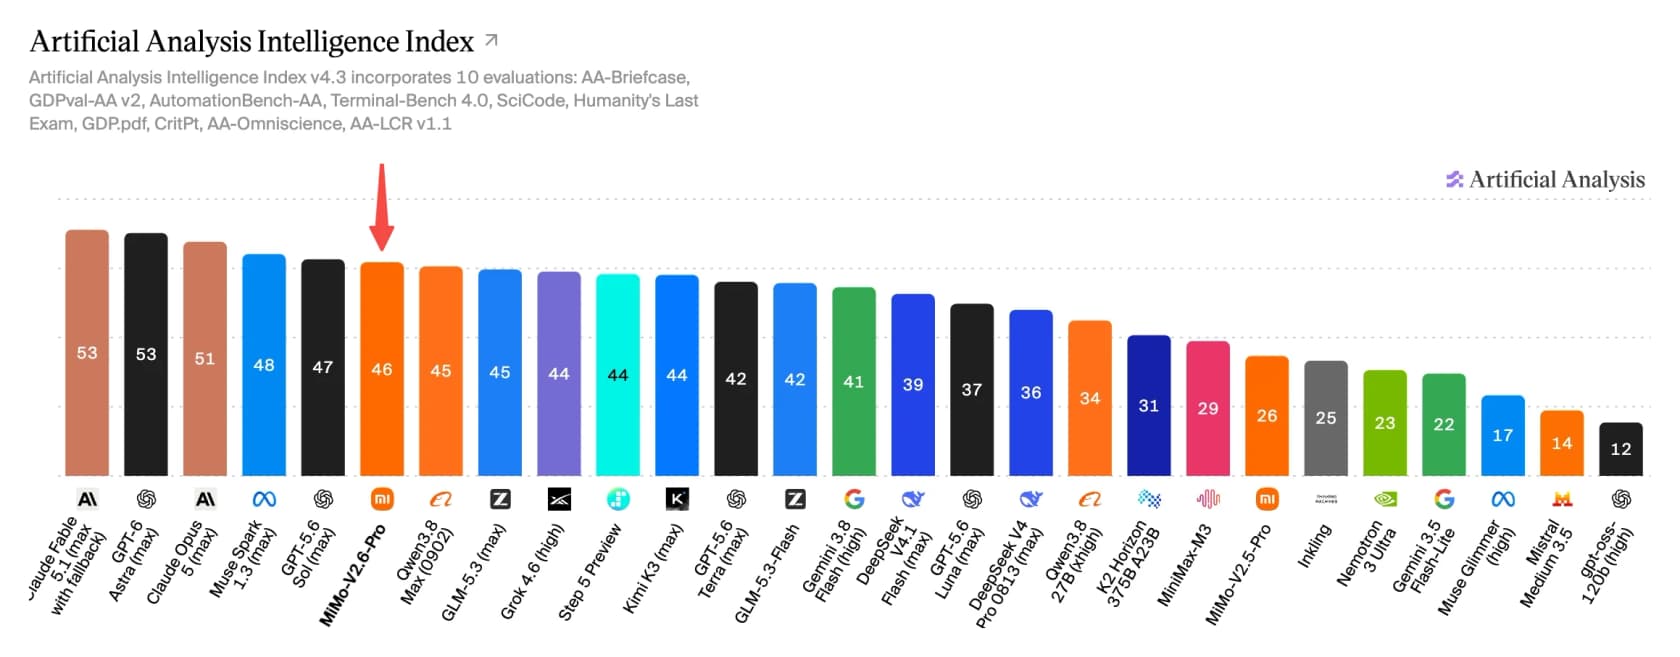
とはいえ、スコアだけでは料金の話は完結しません。コストにとって重要なのは、知能対タスクあたりコストのプロットです。ここでMiMo V2.6 Proは1タスクあたり約$0.13で緑色の「最も魅力的な象限」に入る一方、Claude Opus 5やGPT-6 Astraは同じ軸の$3〜$8の端に位置しています。
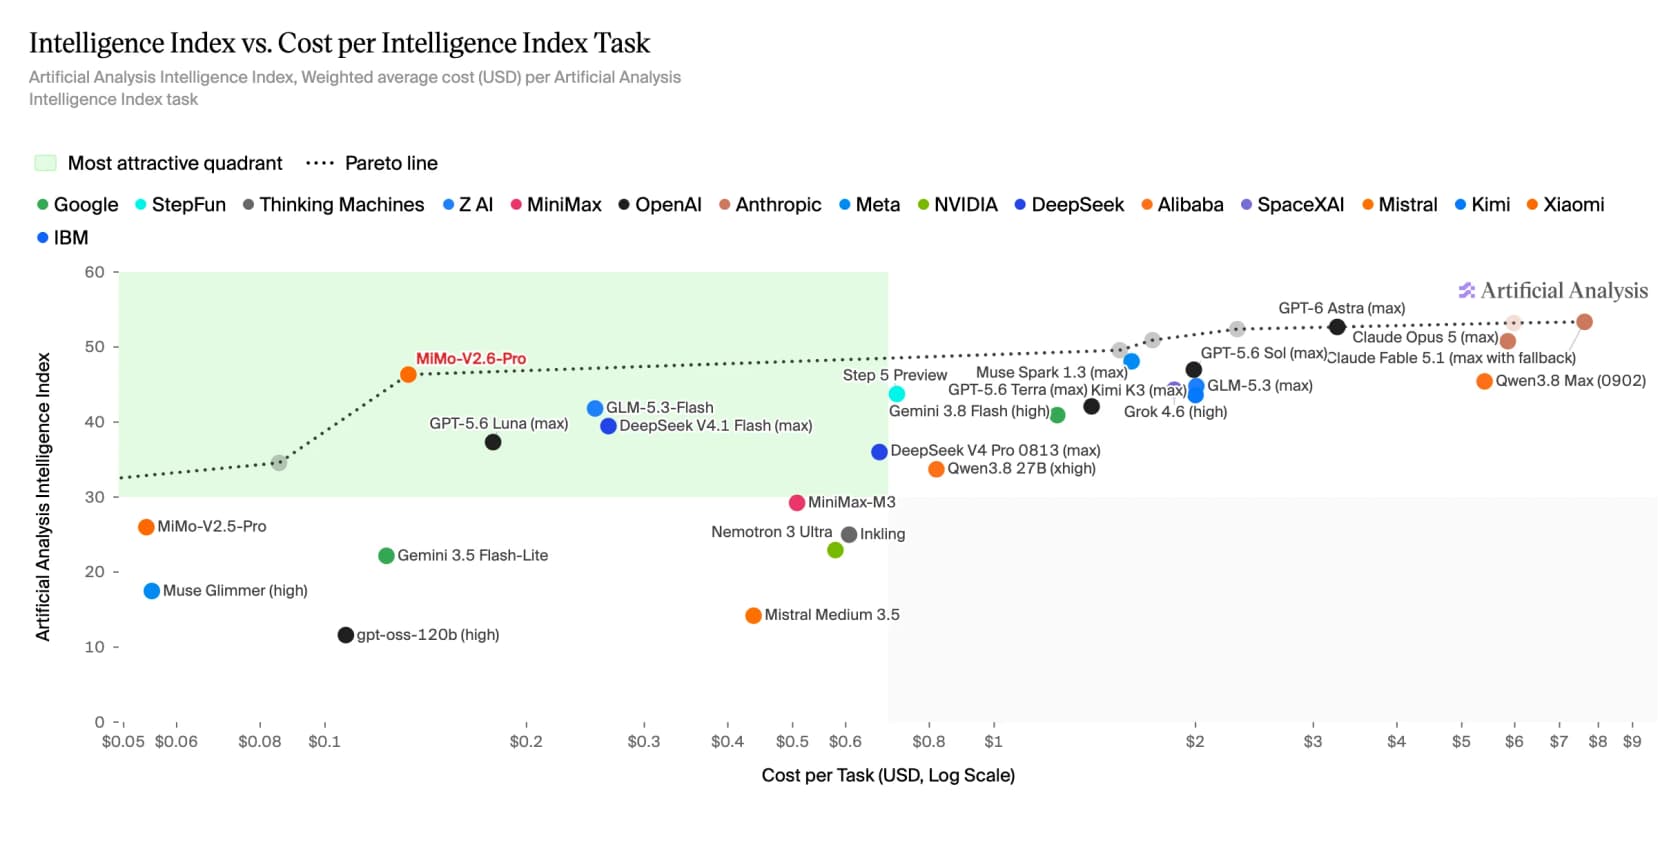
オープン系のフィールドに対しても同じく鋭さを見せています。FlashはDeepSeek V4.1 Flashのような最安ティアと並び、1.02TのProははるかに大きい2.8TのKimi K3を、ほとんどのベンチマークで上回りながら下回るコストで実現しています。このモデルを大量に使い込んだあるHacker Newsのコメント投稿者は、価値の計算をこうまとめています。
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."

公平を期すために言えば、料金についての記事は上限についても正直であるべきです。MiMoは最も難しいベンチマークではトップのクローズドモデルに後れを取っています。Terminal Bench 4.0ではGPT-6 Astraの59.6に対し34.9を記録し、ExploitBenchではGPT-5.6 SolやClaudeの70以上に対して47.9にとどまります。あなたの作業がそうしたフロンティア領域にあるなら、安いトークン価格だけがすべての判断材料ではありません。それ以外の用途であれば、このコストパフォーマンスは十分に説得力があります。
実例で見る:実際にいくら払うことになるか
100万トークンあたりの定価は抽象的です。ここでは、MiMo V2.6上での3つの現実的なワークロードのコストを示し、数字を実感してもらいます。
- Flashを使うソロ開発者。 Flashでコーディングしながら月間入力2000万、出力500万トークンを消費するとします。20 × $0.14 + 5 × $0.28 = 月$4.20。誤差レベルです。
- Proでコーディングエージェントを動かす小規模チーム。 月間入力3億、出力8000万トークンをProで使う場合:300 × $0.435 + 80 × $0.87 = キャッシュ割引適用前で月$200.10。プロンプトの再利用が多ければ、実際の請求額はそれよりずっと低くなります。
- Flashを使う大量サポートワークロード。 月間1万件のチケット、それぞれ約8Kの入力と1Kの出力、つまり入力8000万、出力1000万トークン:80 × $0.14 + 10 × $0.28 = 生のトークン代だけで月$14。
この最後の数字こそ、じっくり考える価値があります。1万件のサポート会話が、モデルのトークン代わずか$14。もしこれがAIサポートの本当のコストだとしたら、誰もが何年も前に導入していたはずです。実際はそうではなく、「$14のトークン代」と「実際に機能するサポートエージェント」の間のギャップこそが、次のセクションの本題です。
無料のウェイトは無料で動くわけではない
MiMo V2.6は本当にMITのもとでオープンなので、「自分でホストすればいい」は建前ではなく実際に成立するアドバイスです。しかし、ウェイトが無料だからといって運用が無料になるわけではありません。ハードウェア費用が見えにくいコストです。
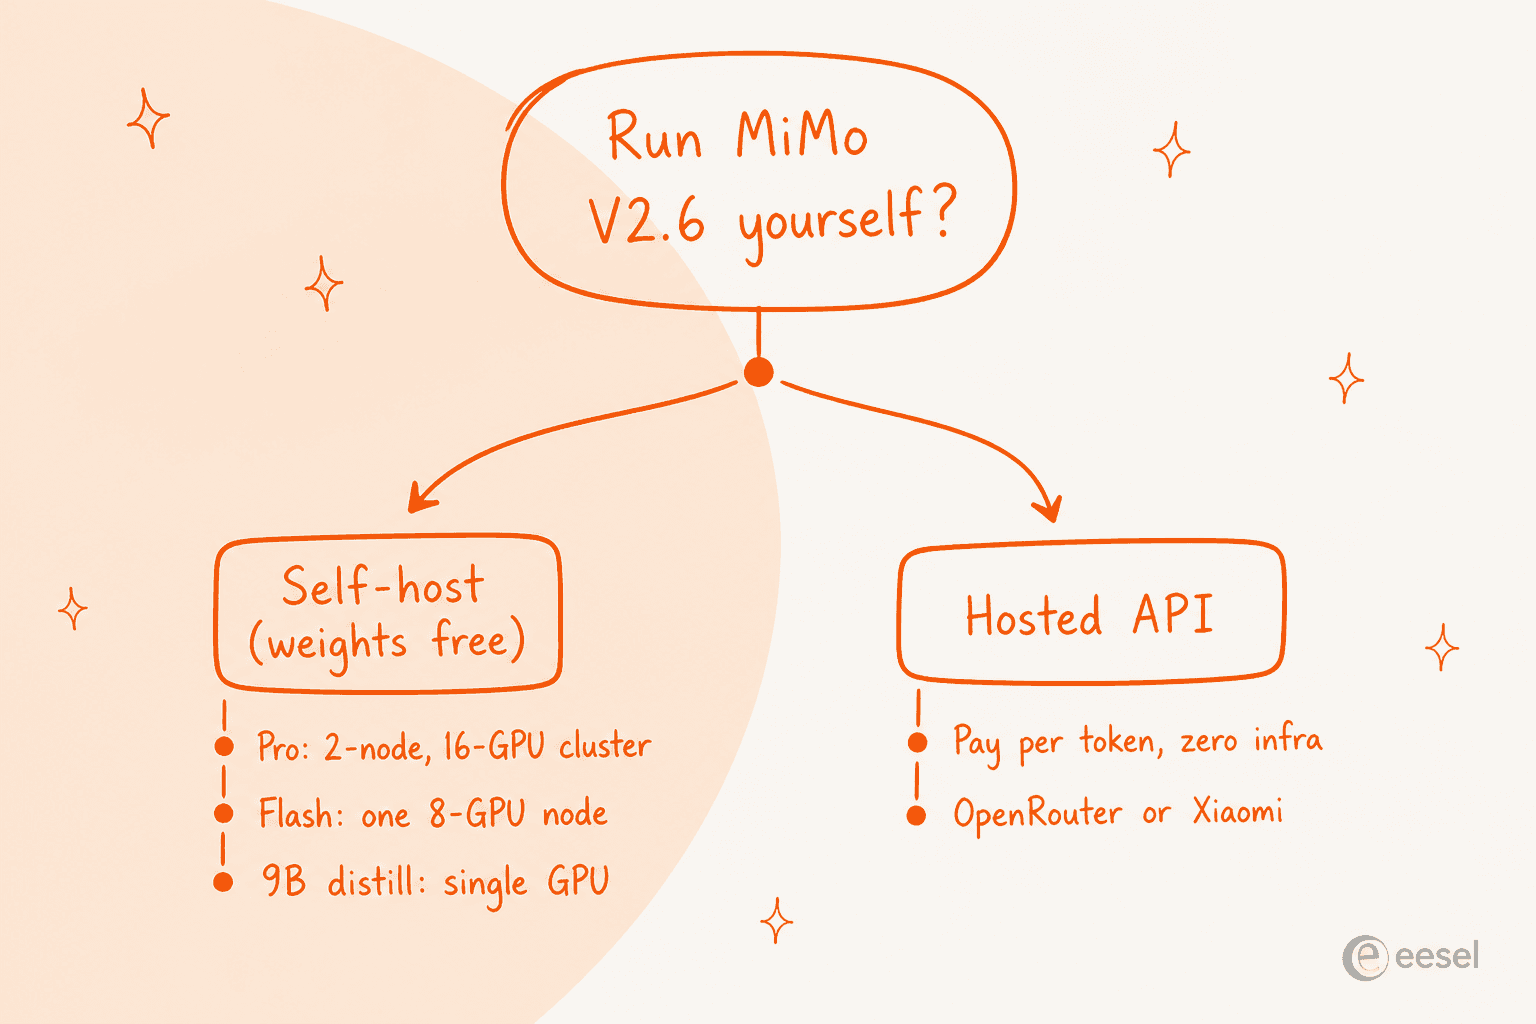
モデルカードによれば、各バリエーションに必要なものは以下のとおりです。
- Pro(1.02T/42Bアクティブ): リファレンスとなるSGLangでの起動には2ノード・16GPUのクラスター(テンソル並列16)が使われます。これはかなり大きなハードウェア投資です。
- Flash(309B/15Bアクティブ): 8GPUのシングルノードで動作します。
- Distill-Qwen-9B: 単一GPUで十分なほど小さく、ローカルツール向けのGGUF量子化版もあります。
すべてのチェックポイントはFP8として提供されており、メモリ使用量を現実的な範囲に抑えています。しかし正直なところ、セルフホスティングがAPIを上回るのは、安定した大量利用と埋められる遊休GPUがある場合だけです。断続的または低ボリュームの利用であれば、100万トークンあたり$0.14〜$0.87のホスト型APIのほうが、クラスターを常時稼働させておくよりほぼ常に安上がりです。「無料のウェイト」が「無料の運用」を意味すると決めつける前に、自分の利用率で計算してみてください。
価格表が決して示さない部分
ここで一歩引いて考える必要があります。私はヘルプデスク向けのAIを構築・運用することを生業としており、料金についての議論はほとんど常に本当の請求額を見落としているからです。
MiMo V2.6や、DeepSeek、Qwen、あるいはそれらのどれであれ、トークンのコストは本番システムの予算の中で最も小さな項目です。高くつくのは、モデルの周りに構築するすべてです。
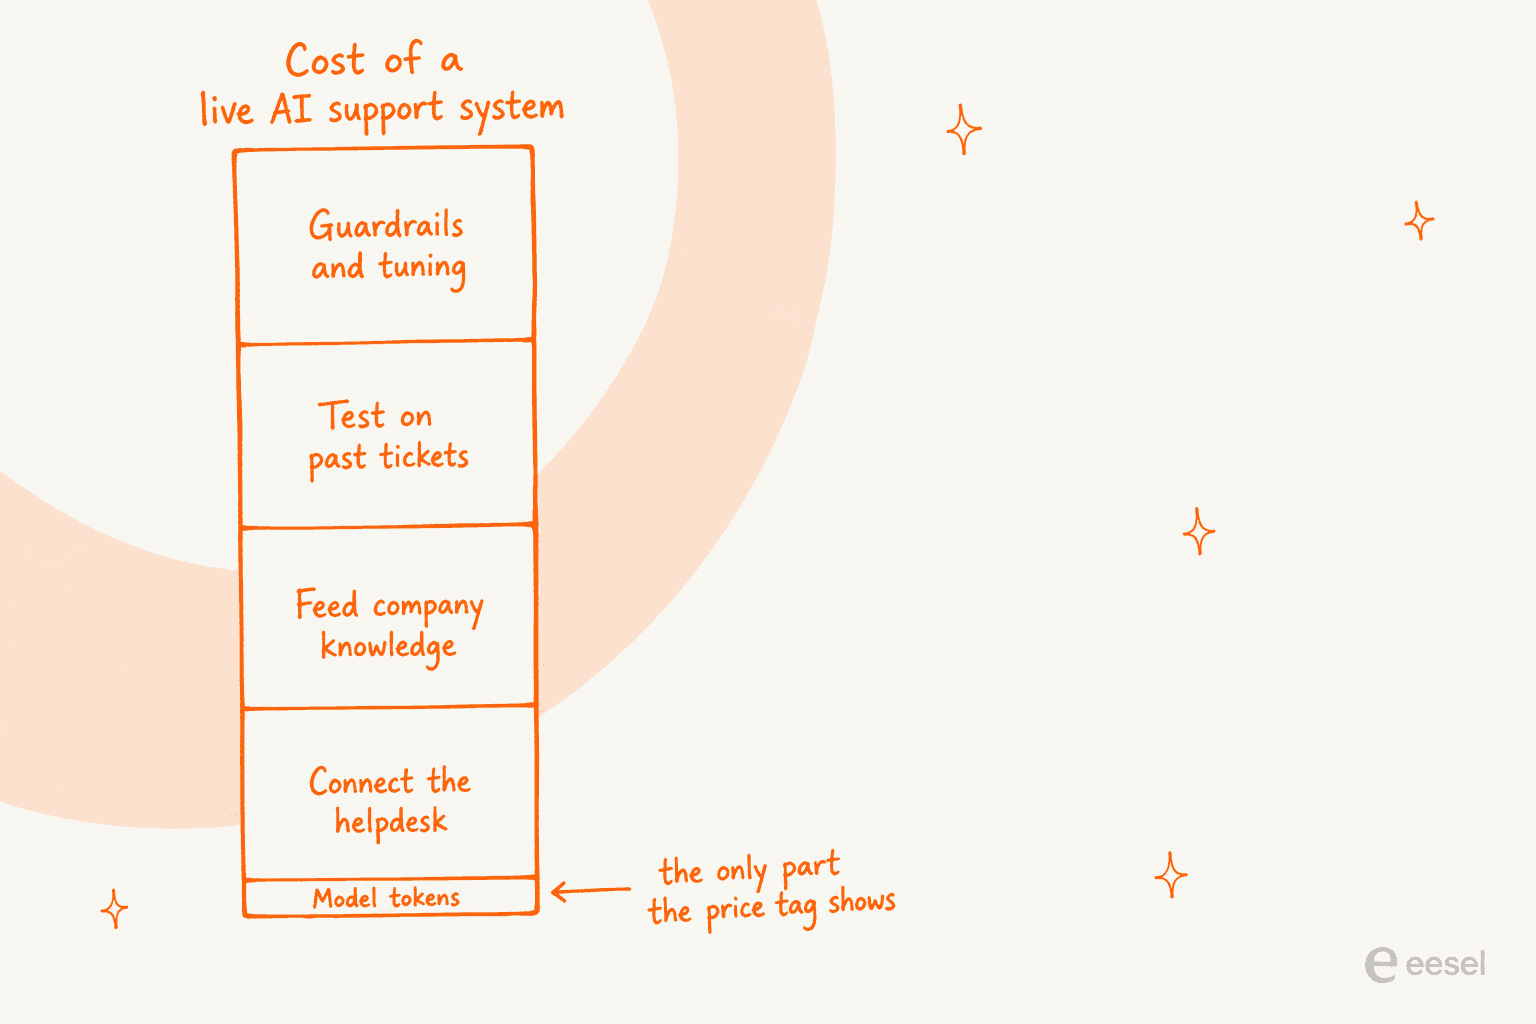
私たちはここ数年、ライブのサポートキューにAIエージェントを配置し続けてきましたが、繰り返し学んだ教訓は、どれほど安くて賢いモデルであっても、生のモデルはサポートエージェントではないということです。「$14のトークン代」から「顧客を任せられるエージェント」にたどり着くには、ヘルプデスクに接続し、ナレッジベースと過去のチケットを読み込ませ、ポリシーを教え、安全に実行できるアクションを与え、そして何よりも、本番投入前にテストする必要があります。自信たっぷりに聞こえるボットが静かに間違った回答をするのを何度も見てきました。だからこそ、どんなロールアウトもまず過去のチケットに対してシミュレーションすべきなのです。
これらはどれもOpenRouterの料金ページには現れません。それはモデルと、実際に機能するチームメイトとの違いであり、AIサポートの実際のコストが存在するのはまさにそこです。
eeselを試す
MiMo V2.6のようなモデルはエンジンです。eeselは、それを運転するために雇うチームメイトです。eeselはAIチームメイトのプラットフォームであり、AIヘルプデスクエージェントはすぐに働けるサポートチームメイトです。数分でヘルプデスクに接続でき、すでに過去のチケットとナレッジベースを読み込んでおり、実際のライブ顧客に一件でも応対する前に、何千件もの実際の過去の会話でシミュレーションできます。座席数に応じた定額課金ではなく、eeselは利用量に応じて課金するため、コストは実際に行われた作業に追従します。

ターミナルで作業することが多いなら、eeselには公開CLIとMCPサーバーがあり、ダッシュボードで管理しているのと同じチームメイトとワークスペースを、スクリプトから、あるいはClaude Code、Codex、Cursorのようなコーディングエージェントから操作できます。これはeeselを運用するうえでエージェントに優しい方法です。人が手動で操作するのも、スクリプトが自動化するのも、AIエージェントが呼び出すのも、すべて同じヘルプデスクチームメイトに対して行われます。それこそが、安価で有能なモデルを、実際にチケットを解決するものへと変える層です。無料で試す。
よくある質問
Xiaomi MiMo V2.6はいくらですか?
Xiaomi MiMo V2.6を最も安く運用する方法は?
Xiaomi MiMo V2.6は無料ですか?
Xiaomi MiMo V2.6の料金はDeepSeekやKimi K3と比べてどうですか?
MiMo V2.6 Pro UltraSpeedとは何で、なぜ10倍の値段がするのですか?
Xiaomi MiMo V2.6にはキャッシュ割引がありますか?
カスタマーサポートにXiaomi MiMo V2.6を使うべきですか?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.