Gemini 3.8 Flashの実態
Gemini 3.8 FlashはGoogleの主力モデルで、gemini-3.8-flashとしてリリースされ、チャットではなく長時間にわたるコーディングと自律型エージェントに真っ向から向けられている。
スペックは前世代から変わっていない。テキスト、画像、音声、動画、PDFを入力として受け取り、テキストを出力し、100万トークンのコンテキストウィンドウと64Kの出力上限を持つ。関数呼び出し、ツールとしての検索、コンピュータ操作にも対応している。Googleはこれらすべてをモデルカードで公開している。
実際にどこで利用できるかは対象ユーザーによって異なる。開発者はGoogle AI Studio、Gemini API、Android Studio、そしてGoogle Antigravityで利用できる。Antigravityでは今やこれがデフォルトモデルとなっている。この最後の点は、AIコーディングアシスタントを探しているなら重要だ。つまり自分で選んだつもりがなくても、すでに3.8を使っている可能性があるということだ。
企業向けにはGemini Enterpriseを通じて提供される。一般ユーザーはGeminiアプリ、検索のAIモード、Google Sheetsで利用できるが、Google AI ProまたはUltraでのみだ。これらの一般向けプランを検討しているなら、Google AI Plusのレビューで詳しく取り上げている。また、チームで勝手にGeminiが有効になってしまった場合に向けて、Workspace全体でGeminiを無効にするための別のガイドもある。
同じ発表の中にもう一つのモデルがあり、大半の報道はそれを埋もれさせてしまった。Gemini 3.8 Flash Cyberはサイバー業務向けに意図的に緩めた対策を備えたセキュリティ版で、新しいFairwind Programを通じて信頼された防御者に限定提供される。この件については後述する。今回の発表全体の中で最も印象的な数字がここにあるからだ。
Googleが公言していて、ほとんど誰も引用しなかった部分
このリリースの見方を一変させる一文がある。モデルカードから、4つの異なるセクションで繰り返されている。
"Gemini 3.8 Flash is based on Gemini 3.7 Flash."
これは適当に書かれた一文ではない。Architecture、Training Dataset、Hardware、Software、Safety Policies、Acceptable Usageの各セクションはすべて、何か新しいことを説明するのではなくGemini 3.7 Flashモデルカードを参照するにとどまっている。3.8 Flashは新しいベースモデルではなく、3.7 Flashをさらに追加学習させたものだ。
それを知ってしまえば、今回の発表の残りの部分は驚くようなことではなくなる。3週間というペースの説明になるし、価格が1セントも変わらなかった理由の説明にもなる。そして現実的な期待値を設定してくれる。これは改良版であり、その通りに振る舞う、ということだ。
Googleのブログも、性能向上の裏にある仕組みについて同様に率直だ。この文言はよく読む価値がある。トレードオフが機能のように装われているからだ。
"These performance gains stem from a core design choice: 3.8 Flash works harder. On complex tasks, it exhibits greater diligence, executing extra reasoning steps, and calling tools iteratively. At times, the model might use more tokens to maximize performance, especially at higher effort levels."
そして、アップグレードするかどうかを決めるべき一文がある。Googleは計算効率を重視する開発者に対し、"continue to rely on Gemini 3.7 Flash, which remains fully supported for efficiency-first workloads."と述べ、3.7 Flashを使い続けることを推奨している。ベンダーが自社の旧モデルの方が今でも正しい選択だと言うのは十分に珍しいことなので、額面通りに受け取る価値がある。
価格:3.7 Flashと同一、そして1月に倍になる
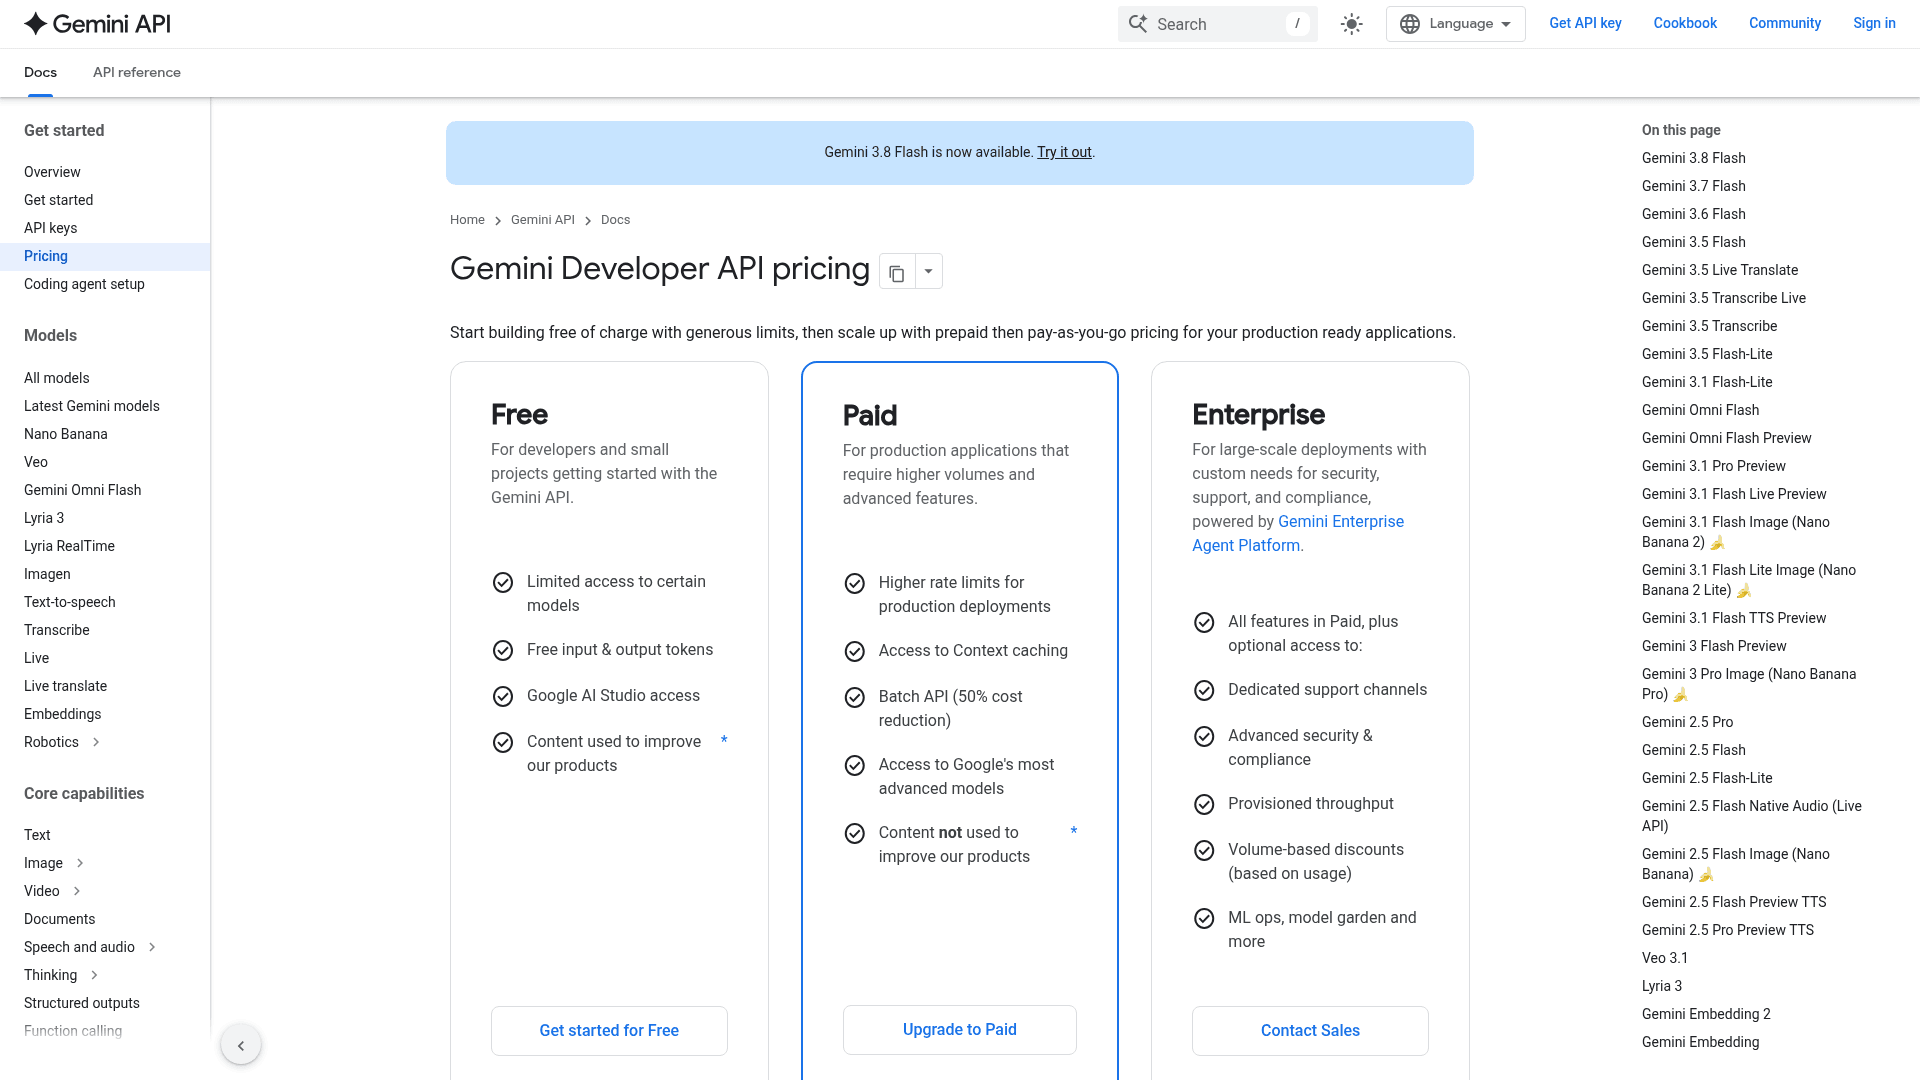
新しいモデルだからといって割高になっているわけではない。Gemini APIの料金ページでは、3.8 Flashと3.7 Flashが一行ずつ同じ料金で並んでいる。
| ティア | 入力 / 100万 | 出力 / 100万(思考含む) | キャッシュ読み取り / 100万 | 2027年1月1日から |
|---|---|---|---|---|
| Free | $0 | $0 | $0 | 変更なし |
| Standard | $0.75 | $3.75 | $0.075 | $1.50 / $7.50 |
| Batch | $0.375 | $1.875 | $0.0375 | $0.75 / $3.75 |
| Flex | $0.375 | $1.875 | $0.0375 | $0.75 / $3.75 |
| Priority | $1.35 | $6.75 | $0.135 | $2.70 / $13.50 |
この表の中には、実際に払われている以上の注意を払うべき点が3つある。
出力価格には思考トークンが含まれている。 あなたは決して目にすることのない、要約だけを見せられる推論に対して100万トークンあたり3.75ドルを支払っている。より一生懸命考えることが看板機能であるモデルにおいて、これこそが動くメーターだ。
キャッシュストレージは別途課金される。 読み取りは100万あたり0.075ドルだが、ストレージは100万トークンあたり時間単位で0.50ドルかかり、これも1月に倍になる。
グラウンディングはモデル別ではなく共有される。 すべてのGemini 3.xモデルを合わせて月5,000件のGoogle検索リクエストが無料になり、それを超えると1,000件あたり14ドルだ。Google Mapsのグラウンディングも同じ割り当てとなる。
そしてこの見出しの数字はプロモーションだ。ここに記載されているすべてのレートは2027年1月1日に倍になる。2027年の予算を0.75ドルで見積もっているなら、間違った数字で見積もっていることになる。これはLLMコストに関してチームが何度もやってしまうミスを私は見てきた。スプレッドシートではなく実際のLLM追跡ツールと組み合わせる価値がある。思考トークンのオーバーヘッドは誰も正確に予測できない部分だからだ。
近隣のモデルがいくら課金しているかの参考として、Claude Opusの料金とOpenAIのレート制限は、チームが乗り換えを検討する際に最も頻繁に比較される2つだ。
Googleが優位性を示すベンチマーク
Googleは4つの主要な結果を公表しており、3.8 Flashはそのすべてでトップだ。以下はDeepMindのモデルページからの全データで、これはプレスの要約ではなく一次情報だ。
| ベンチマーク | Gemini 3.8 Flash | Gemini 3.7 Flash | Claude Opus 5 | GPT-5.6 Sol | GPT-5.6 Terra | Claude Sonnet 5 |
|---|---|---|---|---|---|---|
| HLE-Verified | 54.9% | 53.6% | 54.4% | 54.5% | 51.1% | 31.0% |
| Vals Finance Agent v2 | 61.4% | 59.0% | 58.6% | 53.8% | 54.4% | 53.9% |
| Harvey's Legal Agent | 10.0% | 8.8% | 6.7% | 2.5% | 0.8% | 5.0% |
| DeepSWE v1.1 | 首位 | 下位 | 下位 | n/a | n/a | n/a |
誰かがこの表をスクリーンショットする前に、正直な注意点を2つ述べておく。
Harvey Legal Agentの行は大差の勝利のように見えるが、勝者のスコアは10.0%だ。その列のすべてのモデルがこのベンチマークに落第しており、3.8 Flashは最も落第の程度が軽いというだけだ。誰も合格しないテストでOpus 5を3.3ポイント上回るのは本物の結果ではあるが、小さな結果でもある。
そしてHLE-Verifiedでは、Opus 5との差はわずか0.5ポイントだ。Googleが主張しているのは、フロンティアモデルとの実質的な引き分けを、その価格のごく一部で実現したということであり、これがKOではなく本当の話だ。世代ごとの比較版が欲しいなら、GeminiとClaude Opusの比較とChatGPTとGeminiの比較がどちらも参考になる。
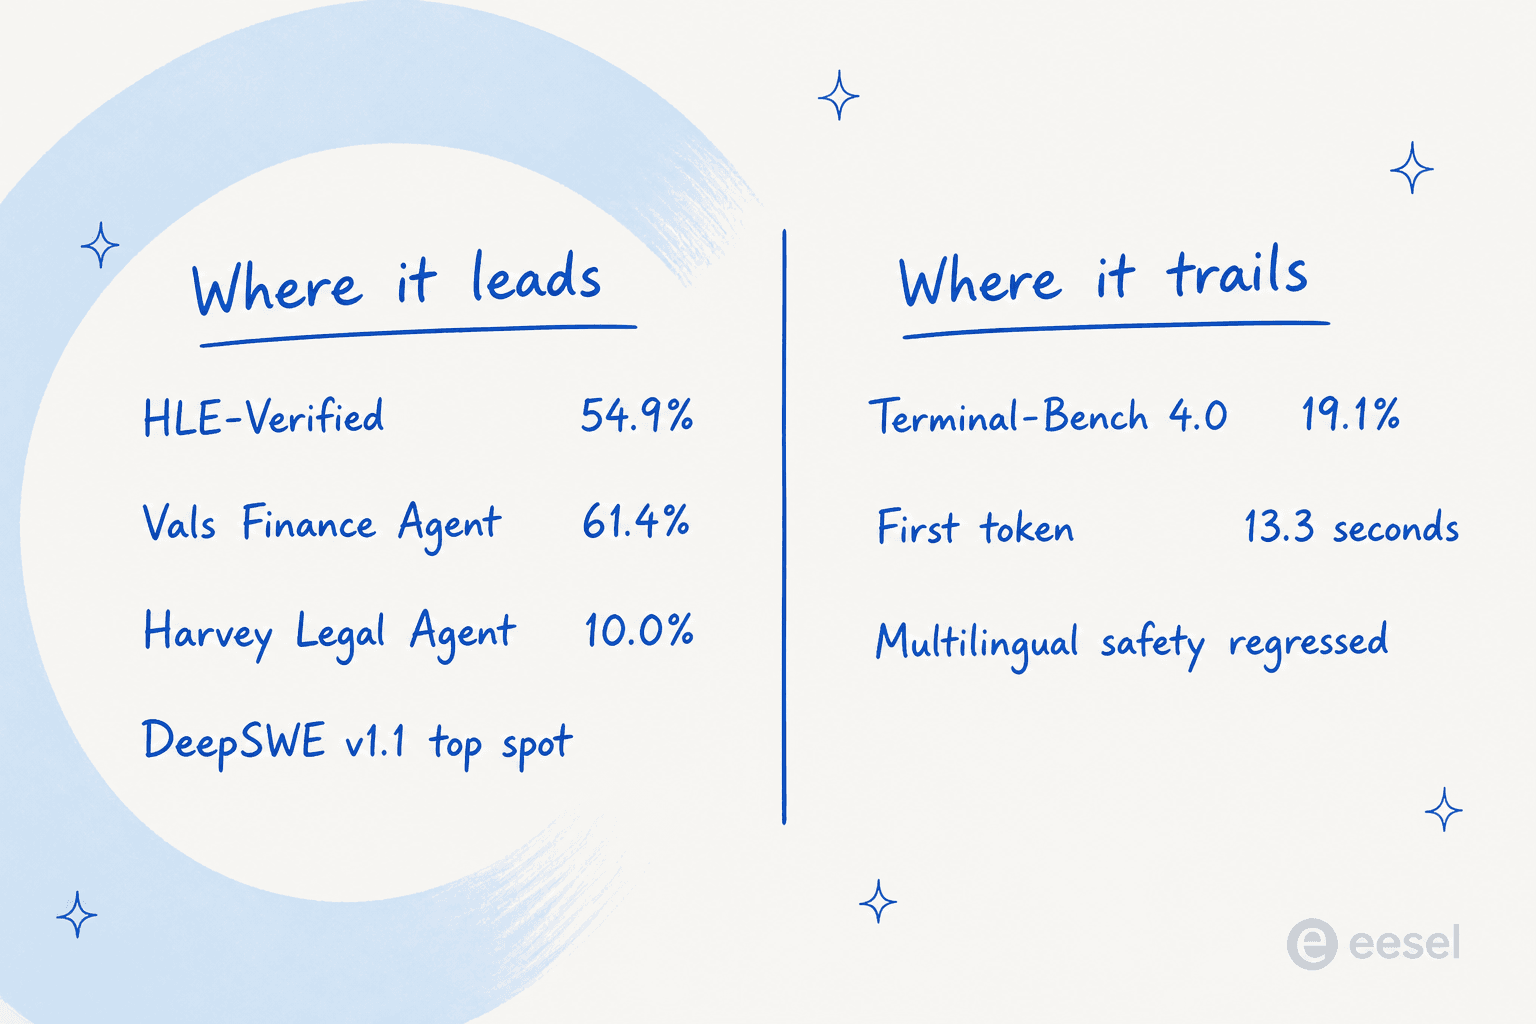
右側の列はGoogleの投稿ではカバーされていない部分で、モデルを発表した側ではなく実際に動かした人々からのものだ。
独立した数字がより有用な物語を語る
Artificial Analysisは9つのベンチマークからなるIntelligence Indexで3.8 Flashを高いエフォートレベルで実行した。その4つのサマリーカードは、発表記事のどの部分よりも意思決定に役立つ。
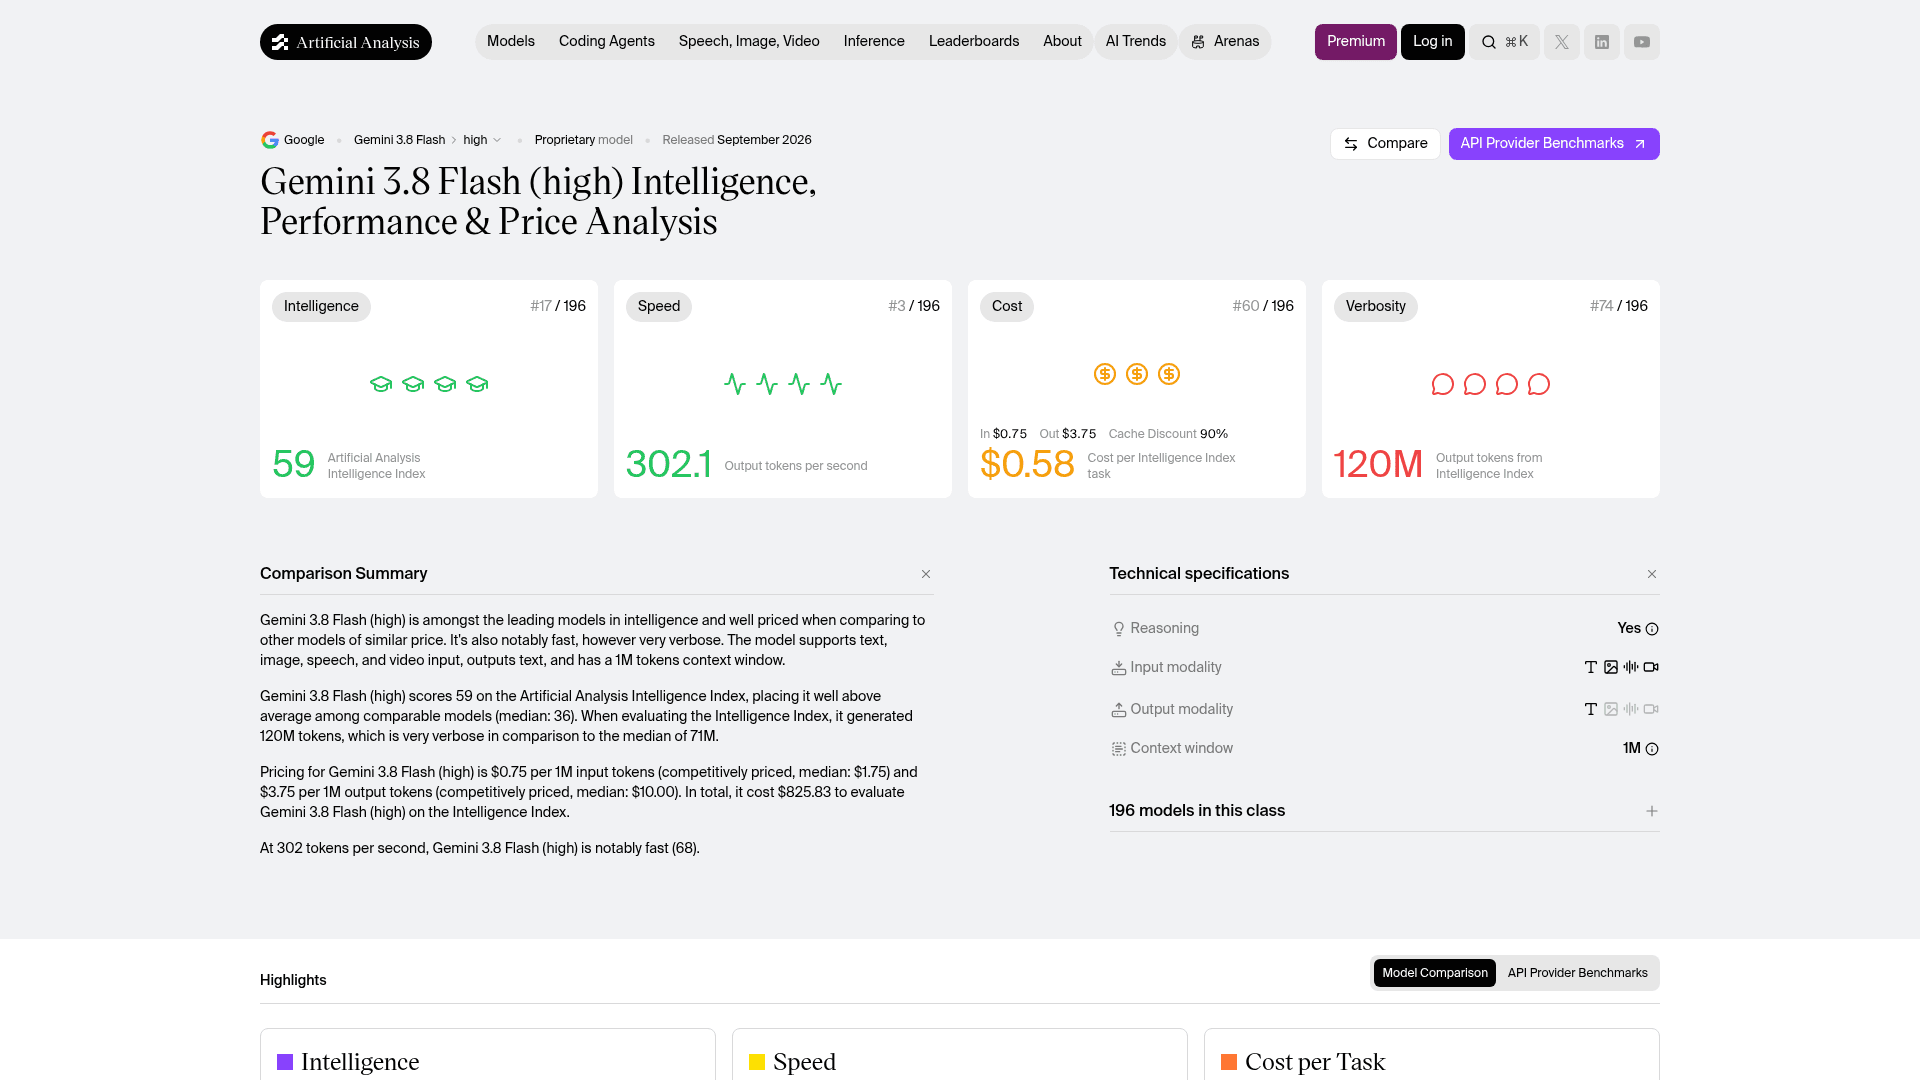
インテリジェンススコアは59で、196モデル中17位、クラス中央値36に対して高い。コストはインデックス1タスクあたり0.58ドルで60位。速度は毎秒302.1出力トークンで3位。そして冗長さはインデックス完了までに1.2億出力トークンで74位、中央値7,100万トークンに対して高い。Artificial Analysisは自身のまとめで「非常に冗長」と評している。インデックス全体を実行するコストは825.83ドルだった。
この冗長さの数字が、価格の物語を1つの数字に凝縮している。
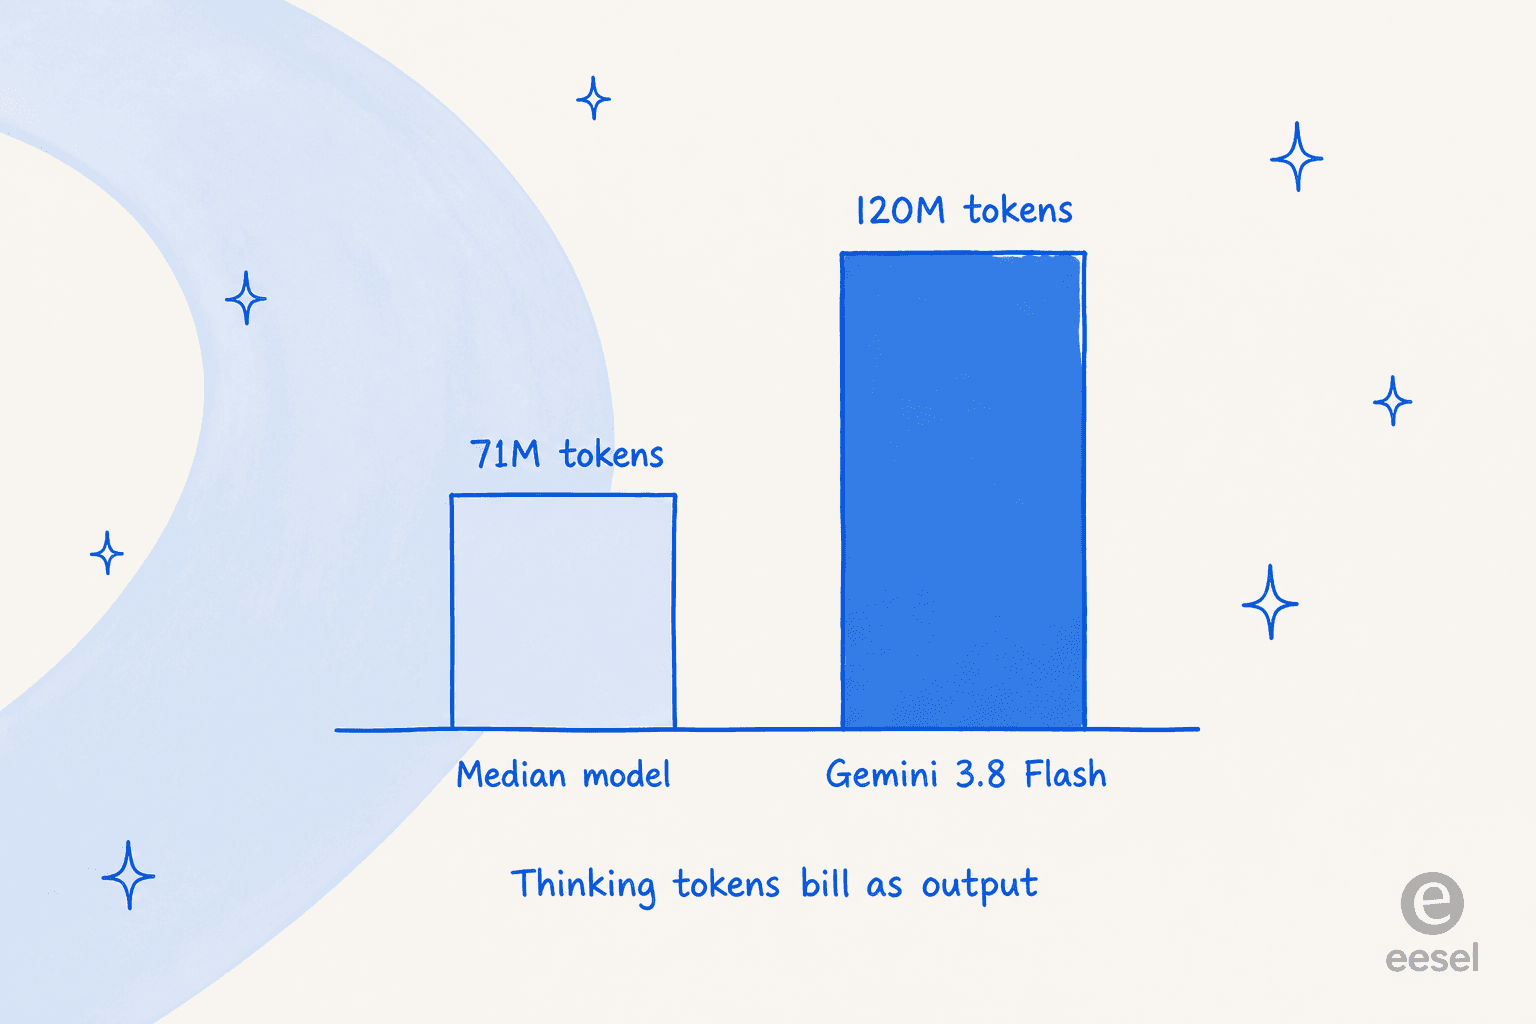
中央値より70%多い出力トークンを100万あたり3.75ドルで使うモデルは、料金表が示すほど安くはない。これが、発表日に775ポイントに達したHacker Newsのスレッドで最も鋭い指摘だった。
"On artificial analysis it's only equal to opus 5 medium effort. Opus 5 max scores 63. Further, opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference."

そして、ほとんど誰もが見逃したと私が思う数字がある。これは私自身のアーキテクチャの決定を変えるであろう数字だ。
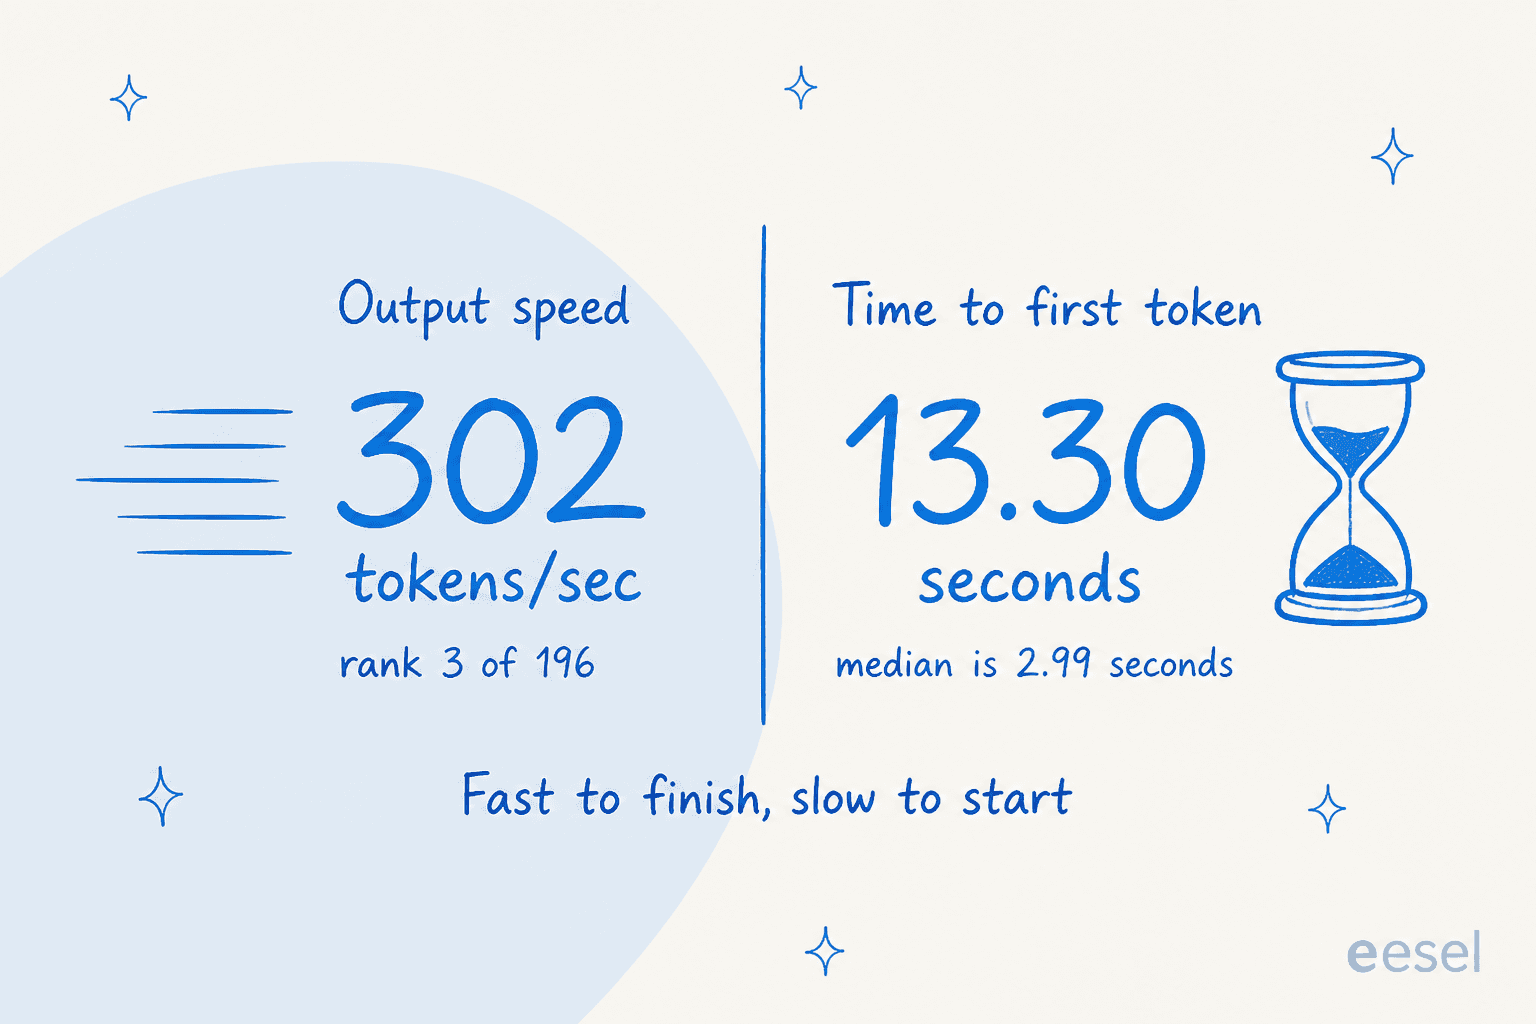
Artificial Analysisは、最初のトークンが出るまでの時間を13.30秒と計測しており、クラス中央値の2.99秒に対して非常に長い。スループットで世界3位の速さを持つモデルが、最初の一語を発するまでは典型的な速度の約4.5倍遅い。これはまず思考しているためだ。
この違いは非常に重要だが、常に見過ごされがちだ。スループットは長いジョブをどれだけ速く終えられるかを示す。最初のトークンまでの時間は、人間が何もない画面をどれだけ長く見つめるかを示す。一晩中リポジトリを処理し続けるバッチエージェントにとっては、スループットが重要でTTFTは関係ない。サポートの返信やチャットウィジェットのように人が待っているものにとっては、その13秒がユーザー体験のすべてになる。
実際に動かした人々の声
発表日の反応はきれいに二分され、その分裂はスループット対レイテンシの違いに沿っていた。
Google自身のデベロッパーアドボケイトは、トークン消費をコストではなく機能として位置づけた。これはベンダー側の主張として最も率直なバージョンだ。
"It takes smaller steps and verifies its work more often. This can leads to higher token usage but it uses those extra tokens effectively to run tests and verify changes, giving you much higher quality work overall, especially for more complex and long-running goals."
彼はGoogle DeepMindで働いているため、独立したテストではなくベンダー側の見方として扱うべきだという点は注記しておく。彼の投稿は308件のいいねを集めたが、2つ下の返信では、実際の作業で試した人物からの明確な反論があった。
"Do not want to be negative, but it is absolutely not usable for SWE. Same very negative experience as it is with Gemini 3.7 Flash. Cost more than Fable on a really simple SWE tasks."
私が見つけた最も有用なレビューは、長いベンチマークプロンプトを実行し、同日の夜に明快な長所と短所のリストを投稿した開発者からのものだった。
"This model takes its time to think and work through the tasks you have given it, at a really great price and speed. Plus - long thinking, not a airhead model anymore there is subsistence here. Cons - I want to be able to have a better chat with the model before it begins it work, can't test its own work, and cant run and view in its own browser in antigravity."
コードではなくチャット用途では、評価はより好意的で、特にFlashモデルが歴史的に苦手としてきた点についてだった。
"The context window remains the same at 1 million tokens, but its coding reasoning ability has improved significantly, and hallucinations have been greatly reduced, so the issues where it would hallucinate or make grammatical missteps have decreased a lot."
Hacker Newsでは、そのスレッドで最も実用的だったワークフローのアイデアは、何かを置き換えることではなかった。組み合わせることについてだった。
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green. Then I tell Opus to read the audit report and implement what it agrees with. Flash is really good at this, and it is blazing fast in Antigravity CLI."
懐疑派は、単なる感覚的な反論ではなく、具体的で確認可能な異論を持っていた。あるコメント投稿者は、Googleが省いたベンチマークを指摘した。
"There are important gaps in that hot take. For example, it's not even close to Opus 5 on Terminal-bench 4.0, 19.1% vs. 51.8%."
また複数の人がDeepSWEにおけるベンチマークの飽和を指摘しており、どのラボもすぐにトップを取ってしまう現状を考えれば、それは公正な指摘だ。あるコメントの言葉を借りれば、そのベンチマークは既に「明らかに『対処済み』」だという。私自身のアドバイスは、そのスレッドのzuzululu氏と同じだ。自分自身の評価セットを持っておくこと。公開のリーダーボードは、もうしばらく前からこれらのモデルを区別できなくなっている。
モデルカードの中で誰も引用していない2つのこと
私はモデルカードをきちんと読んだが、そこにある2つの詳細は私が見たどの報道にも取り上げられていなかった。
2つの安全性指標が悪化した。 Google自身の表では、低いほど良いMultilingual Safetyが+5.4ポイント、同じく低いほど良いUnjustified-refusals(不当な拒否)が+1.1ポイントとされている。Googleはこれを隠さず、率直に述べている。
"Safety performance across non-English languages regressed slightly relative to 3.7 Flash."
非英語ユーザーにサービスを提供しているなら、これは実質的な検討事項であり、本番環境でしか現れない種類の問題だ。
関連して知っておく価値があるのは、GoogleがFrontier Safetyの評価全体を3.8 Flashで再実施しなかったという点だ。カードによれば、チームは3.7 Flashを評価し、3.8 Flashには"meaningful new capabilities"(意味のある新しい能力)がないため、3.7の結果がそのまま引き継がれると結論づけた。共有ベースであることを考えれば理にかなっているが、これは実測ではなく推論だ。
比較表の基準ラベルが間違っている。 安全性の表には"Gemini 3.8 Flash vs. Gemini 3.7 Flash"という見出しがついているが、脚注1では、Toneの行は"compared to Gemini 3 Flash"(Gemini 3 Flashとの比較)で計測されていると書かれている。これは3.7との比較だと主張する列に、別の古いモデルが座っているということだ。Hacker Newsの読者が最初にこれを見つけ、「Chartcrime, the major AI lab tradition」(チャート詐欺、大手AIラボの伝統)と呼んだ。私はライブのカードを確認したが、脚注は今でもそのままだ。
どちらもスキャンダルというほどのものではない。だが両方とも、一次情報を読むこととプレスリリースを書き直すことの違いを分ける類の細部だ。
Gemini 3.8 Flash Cyber、より印象的な発表
このセキュリティ版は注目のごく一部しか集めなかったが、より強力な数字を持っている。
自律型脆弱性発見の標準ベンチマークであるCyberGymでは、Googleは3.8 Flash Cyberが3.5 Flash Cyberと"significantly larger frontier models"(著しく大きなフロンティアモデル)の両方を上回っていると述べている。20のプログラミング言語をカバーする社内ベンチマークでは、成功率70%を超える。Collinearが運営する外部のパッチ適用ベンチマークであるCWE-Benchでは、大手フロンティアモデルのpass@1が47.8%であるのに対し47.2%を記録しており、コストははるかに低い。
実運用での数字はベンチマークよりも優れている。GoogleのChrome Securityチームは、Chromeの脆弱性に対して、最良かつはるかに大きな商用モデルよりも2.6倍多くの正しいパッチを生成したことを発見した。Wizは社内の侵入テストベンチマークで、コストを2.3倍から5.2倍抑えつつ、リコールが7.5%から9.7%高いことを測定した。そしてGoogleのCloud Vulnerability Researchチームは、通常なら数か月かかるとされる作業である重大な基盤的脆弱性の発見に、これを使って2時間以内で成功した。
問題はアクセスだ。購入することはできない。Fairwind Programを通じて信頼された防御者にのみ提供され、これは申請して承認された政府機関、重要インフラの運用者、ソフトウェアメンテナーを意味する。それ以外の全員は、CBRNとサイバー攻撃に対するセーフガードが維持された標準モデルを使うことになる。
結局、乗り換えるべきか?
価格が同一である以上、これは純粋にワークロードの形状の問題だ。
3.8 Flashに乗り換えるべきケース: トークン数よりも品質が重要な、長時間にわたるエージェント型コーディング、複数ステップの調査、ドキュメント中心の作業を行っている場合。GleanのAIプロダクトリードは、自社の評価における長時間実行のドキュメントワークフローで、これが"completing more than three times as many tasks as Gemini 3.7 Flash"(Gemini 3.7 Flashの3倍以上のタスクを完了する)と報告している。現在Antigravityのデフォルトになっているため、すでに使っている可能性もある。
3.7 Flashのままにしておくべきケース: ワークロードが大量、短いコンテキスト、あるいはレイテンシに敏感な場合。Google自身がそう言っている。冗長さの差により、料金が同一であっても3.8は完了タスクあたりのコストが高くなる可能性があり、13.30秒のTTFTはインタラクティブな用途には失格となる。
どちらも検討しなくていいケース: コーディング用ではなく、プロダクト機能を支えるモデルを選んでいる場合。これは明言する価値がある。最良のAIエージェントや中小企業向けAIエージェントを書いた際に私が到達したのと同じ結論だ。モデルが結果を決めることはほとんどない。
サポートキューにAIを導入するならどういう意味を持つか
ここははっきり言いたい部分だ。これが私が最もよく見かけるミスだからだ。
カスタマーサポート向けAIを評価するチームは、モデルのベンチマークを比較するのに数週間を費やしながら、結局は自信満々に間違った回答をするものをリリースしてしまう。私が一緒に働いたあるサポートチームは、まさにこれに直面した。彼らのボットは、データベースに存在しない車種ブランドに対して「はい、そのお車のモデルはサポートしています」と顧客に伝えていた。なぜかというと、彼らのナレッジベースには「すべてのモデルをサポートしています」と書かれていたからだ。どんなベンチマークスコアもこれを直しはしない。これはモデルの失敗ではまったくなかった。検索(リトリーバル)とスコープの失敗であり、より賢いモデルであれば、その間違った回答をもっと流暢に述べただけだろう。
このパターンは繰り返される。ある顧客は、この要件をこれ以上ないほど明確に言い表した。
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
a DTC supplements CX lead, eesel customer research
これはモデルの要件ではなく、プロダクトの要件だ。信頼度ゲーティング、エスカレーションルール、範囲を絞ったトピックカバレッジ、そしてすでに回答済みのチケットに対するドライランこそが、AIサポートが機能するかどうかを決める。そのどれもリーダーボードには載らない。詳しく知りたければ、AIチャットボットが間違った回答をする理由を別に書いている。
上流の作業も同じくらい重要だ。チケット分類とサポートタグ付けを正しく行うことで、ボットはどのチケットに手を出すべきでないかを把握できるようになる。そして適切に整備されたナレッジベースこそが、そもそも回答を作り出してしまうことを防ぐものだ。
自社構築か購入かというバージョンの議論も、常に持ち上がる。
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES
3.8 Flashのようなモデルはインフラだ。それらはエンジンであって、従業員ではない。ヘルプデスクに組み込むということは、ドキュメントや過去のチケットに対する検索の構築、チケットシステムへのツール呼び出し、信頼度のしきい値、エスカレーションパス、そして顧客の目に触れる前にそのすべてをテストする方法を構築することを意味する。それが本当のプロジェクトであり、その下にあるモデルがGemini、Claude、OpenAIのモデルのいずれであっても同じプロジェクトだ。
eeselを試す
本当に欲しいものが、自分で組み上げるモデルではなくチケットに回答するAIなのであれば、私ならeeselから始める。eeselは生のインフラではなく、すぐに使えるAIチームメイトを提供しており、AIヘルプデスクチームメイトはZendesk、Freshdesk、Gorgiasといった既存のキューに参加し、あなたのヘルプセンターと過去のチケットで数分のうちに学習する。

その差別化要因は、モデルのベンチマークでは得られない部分だ。eeselのすべてのロールアウトは、まず実際の過去のチケットに対してシミュレーションされる。そのため、実際の顧客に何かを言う前に、AIが既に対応した顧客に何を答えていたはずかを確認できる。これが「すべてのモデルをサポートしています」のような失敗を捕まえるチェックであり、eeselが長年、自信満々なボットが実際のキューで間違いを犯すのを見てきたからこそ存在するものだ。無料で試すことができ、コンテンツがボトルネックでサポートがボトルネックでないなら、AIブログライターチームメイトも同じプラットフォーム上で動く。
その周辺の判断についてさらに知りたければ、AIヘルプデスクソフトウェアのまとめが市場全体をカバーしており、チケット自動化がその下にあるワークフロー層をカバーしている。
お金の面では、AIサポートのコスト削減が計算を示しており、エージェント対人間のコストは財務チームが実際に求める比較だ。
そして、プロダクト選びではなくまだモデル選びをしているなら、Geminiの代替ツールとトップAIエージェントが最も役立つ出発点となる2つだ。
よくある質問
Gemini 3.8 Flashとは何ですか?
gemini-3.8-flashとしてリリースされた。テキスト、画像、音声、動画、PDFの入力を処理し、100万トークンのコンテキストウィンドウと64Kの出力を持ち、長時間にわたるコーディングと自律型エージェント向けに調整されている。Google自身のモデルカードによれば、新しいベースモデルではなくGemini 3.7 Flashをベースに構築されている。より広い選択肢と比較したいなら、Geminiの代替ツールまとめでその他をカバーしている。Gemini 3.8 Flashの料金はいくらですか?
Gemini 3.8 FlashはGemini 3.7 Flashより優れていますか?
Gemini 3.8 FlashはClaude Opus 5より優れていますか?
Gemini 3.8 Flash Cyberとは何ですか、また使用できますか?
Gemini 3.8 Flashはカスタマーサポートに適していますか?
Gemini 3.8 Flashを無料で試せる場所はどこですか?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.