

Gemini 3.8 Flashとは実際何なのか
Gemini 3.8 FlashはGoogle最新の高速で安価なマルチモーダルモデルで、Gemini APIではgemini-3.8-flashとして利用でき、Googleのエージェント型開発環境Antigravityでもデフォルトモデルとして使われています。テキスト、画像、音声、動画、PDFを入力として受け取り、テキストを出力します。入力ウィンドウは100万トークン、出力は64Kです。リリースの全体的な内容についてはGemini 3.8 Flash概要で取り上げており、料金面はGemini 3.8 Flashの料金の記事にあります。今回はレビューです。時間をかける価値があるのか、実際どこに適しているのかを見ていきます。
レビューにとって最も有用な事実は、誰も見出しにしなかったものです。これは新しいモデルではありません。モデルカードは逐語的に、しかも4つの別々のセクションで、"Gemini 3.8 Flash is based on Gemini 3.7 Flash."と記載しています。アーキテクチャ、学習データ、ハードウェア、安全性ポリシーはすべて3.7 Flashのカードに依拠しています。つまり3.8は3.7のベースに対する事後学習のパスです。これが3週間という間隔を説明し、また価格が1セントも動かなかった理由も説明します。このレビューは「追加の事後学習は切り替える価値があるのか」という質問への答えとして読んでください。それが本当の問いだからです。
このレビューを決める唯一の数字
すべての発表記事はスピードを前面に出していました。ここに、それを再定義する数字があります。Artificial Analysisは、Gemini 3.8 Flashを毎秒305.1トークン、195モデル中3位と計測しています。これは本物であり、印象的です。しかし同じ計測ページは初回トークン到達時間が13.30秒であることも報告しており、この価格帯の中央値の推論モデルは2.99秒です。
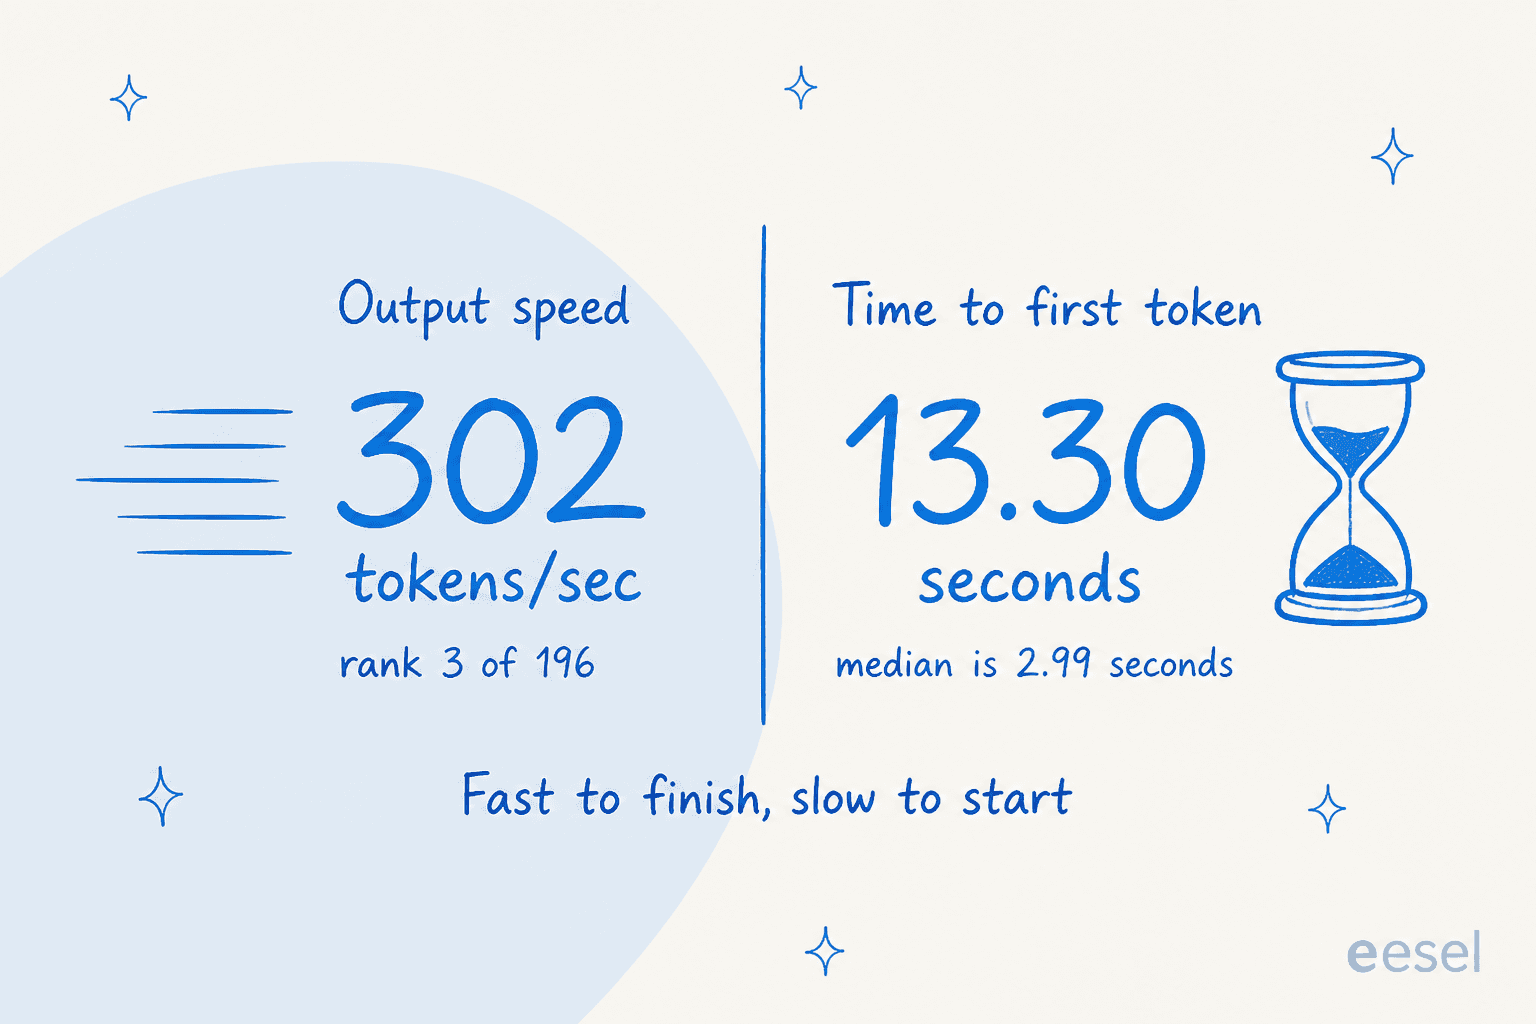
この2つの数字は、まったく異なる体験を表しています。スループットは、いったん始まった後にどれだけ速く文章が流れ出すかです。初回トークン到達時間は、何かが表示されるまで読み手が空白のボックスをどれだけ見つめ続けるかです。リポジトリを一晩処理するバッチエージェントにとって、事前の13秒の思考は見えないものであり、スループットこそがすべてです。チャットウィジェットを見ている人や、提案された返信を待っているサポート担当者にとっては、13秒の無音がすべての体験であり、その後どれだけ速くなってもそれを救うことはできません。
"3.8 Flash is the fast one"という言い方に私が反論し続けているのはそのためです。それは機械にとっての速いモデルであり、人間にとっての遅いモデルです。この一つの区別だけで、思いつく限りほぼすべての使用例が分類でき、それが以下のベンチマークが見た目より重要でない理由です。
本当に優れている点
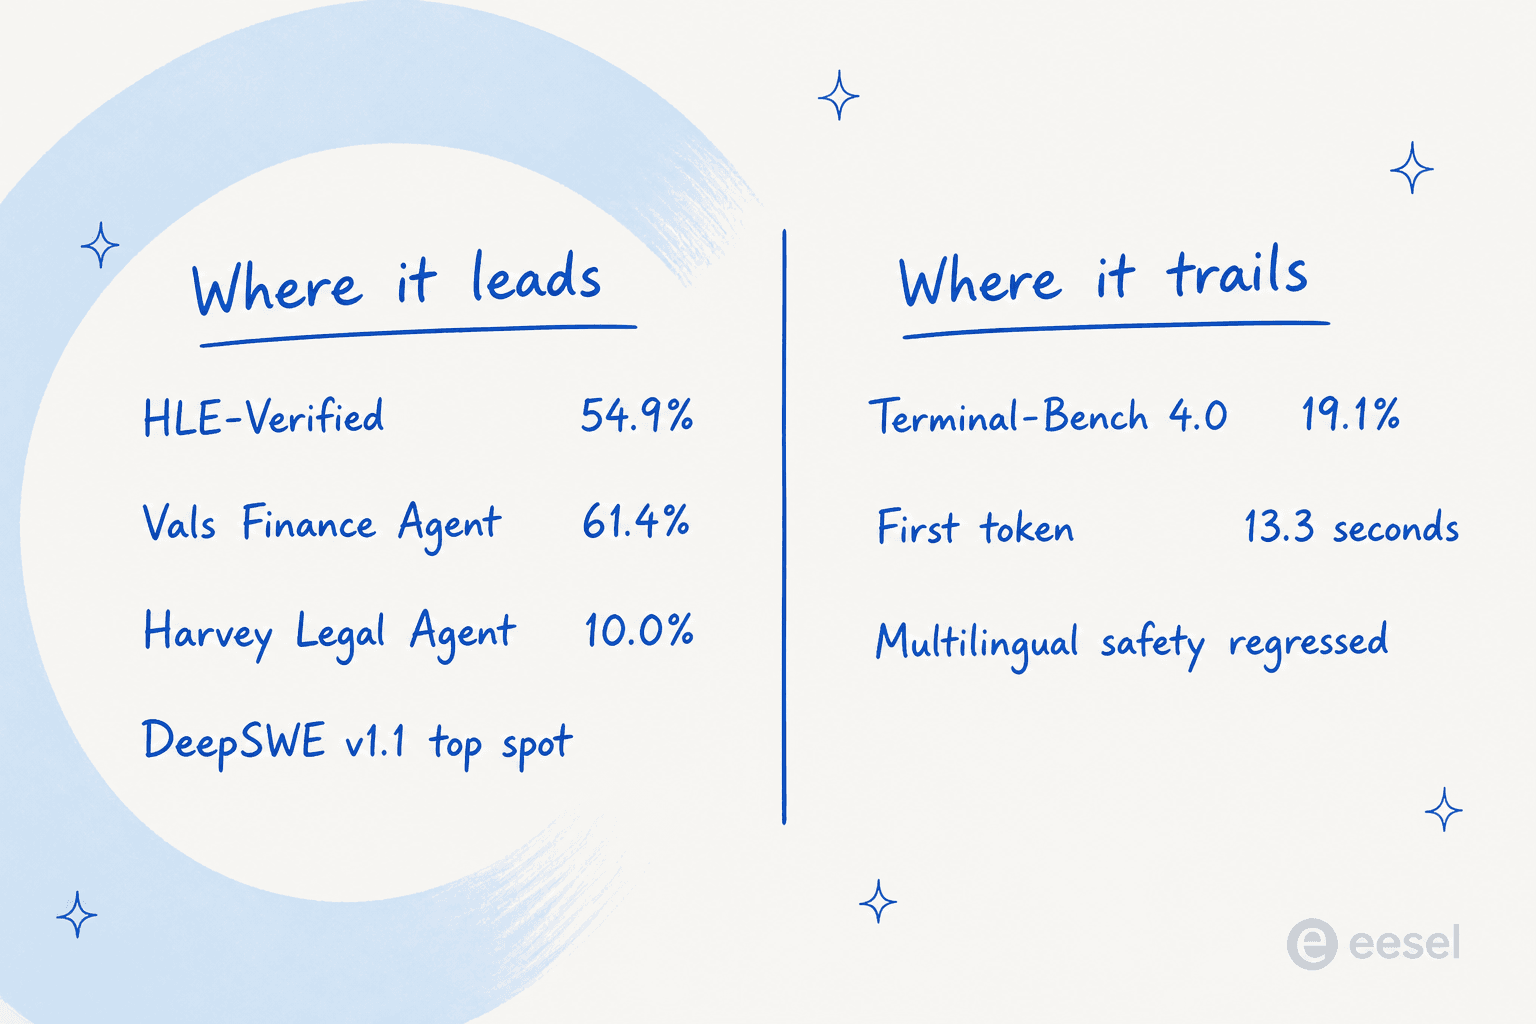
長時間実行するエージェント型コーディングタスクを与えると、3.8 Flashはその実力を発揮します。Google自身の数字によれば、HLE-Verifiedで54.9%を記録して首位に立ち(GPT-5.6 Sol、Claude Opus 5、そして自身の前身モデルを上回る)、Vals Finance Agent v2ベンチマークでは61.4%で勝利し、長時間のソフトウェア作業ではDeepSWEでトップに立っています。ベンチマークベンダーのdavidは、その魅力を明確にまとめています。"5x cheaper and 2x faster than Opus 5 for similar intelligence."
Intelligence Indexもコーディングの話を裏付けています。Artificial Analysisで59点を記録し、medium effortでClaude Opus 5と同水準であり、Flashクラスのモデルとしては強力な結果です。そして長時間タスクでの挙動は本物であり、ベンチマーク特有の現象ではありません。デザインパートナーのGlean社のThai Tranは、ドキュメント量の多いワークフローにおいて"completing more than three times as many tasks as Gemini 3.7 Flash in our evaluations"と報告しています。Hacker Newsではsimonwが13秒、1.8セントでHTMLビジュアライゼーションを生成し、スピードとフロントエンド品質の組み合わせを"pretty exciting."と評しました。
私が気に入っている実際の使い方のパターンは、panarkyによるもので、Flashをビルダーではなく監査役として使っています。
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green... it is blazing fast in Antigravity CLI. Easily 10x faster than Opus. Can't wait to try 3.8 Flash. If it's good enough, maybe I'll switch Flash to primary and make Opus the auditor."

これこそが3.8 Flashが構築された対象のワークロードの形です。安価で、速く、疲れることなく、長いタスクをこなす意欲があります。あなたがそうなら、他の最高のAIコーディングアシスタントツールと並んでショートリストに入れる価値があります。
弱点
コーディングのベンチマークで勝利するのと同じ"works harder"という設計が、他のあらゆる場面で使いにくくしている原因です。Googleはリリース記事の中でこの点について珍しく率直に述べています。3.8 Flashは"exhibits greater diligence, executing extra reasoning steps, and calling tools iteratively. At times, the model might use more tokens to maximize performance."つまり、たくさん考え、その分の代金を支払うことになるということです。
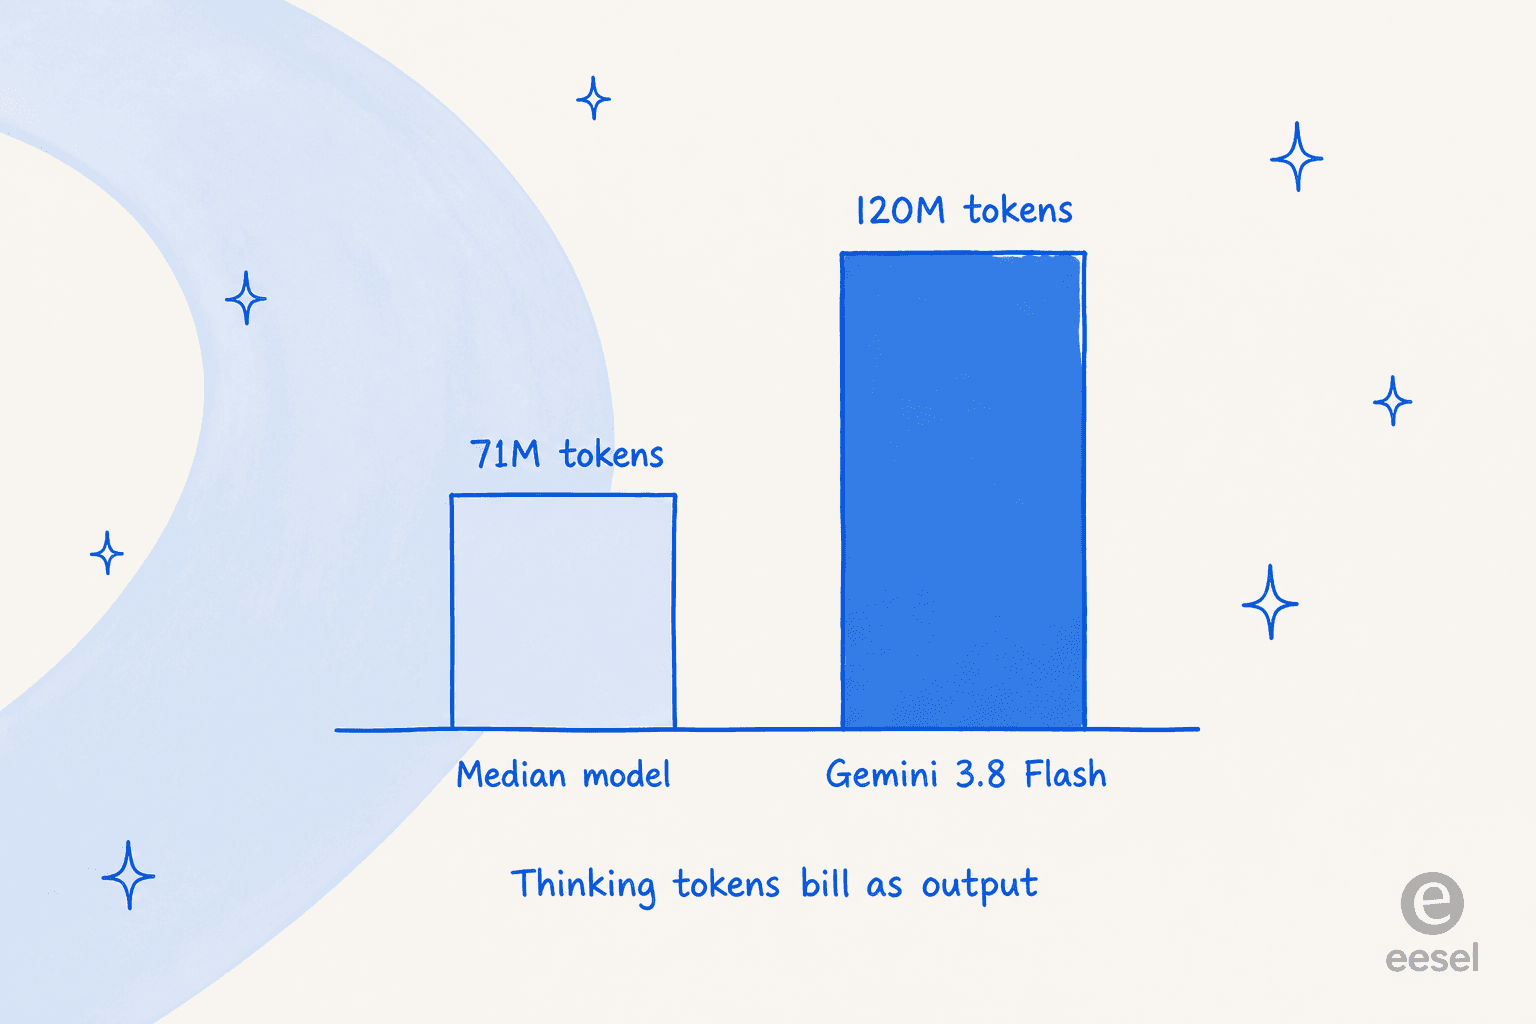
Artificial Analysisはこれを"very verbose"と指摘しました。Indexの実行に120Mの出力トークンを使用し、中央値71Mを大きく上回っています。Geminiは思考トークンを3.75ドルの出力レートで課金するため、この冗長性は表示価格が隠している直接的なコスト倍率になります。HNユーザーのbermudiは、同じベンチマークで3.7よりタスクごとに約1.1万トークン多く使うと数字を示し、"making it more expensive and slower in practice than the headline rate suggests."と述べています。Gemini 3.8 Flashの料金の記事に完全な計算がありますが、要点を言えば、モデルがより多くの100万トークンを出力すると決めた場合、100万トークンあたりの料率は実態を反映しなくなるということです。
それから、お世話をし続ける必要があるという問題もあります。mythzは私も共有するフラストレーションをこう表現しました。
"Whilst it's a fast model, having to baby sit through and approve prompts every few seconds ends up making it slower than the Auto approve modes of Claude/ChatGPT."
また、単純なプロンプトに対して過剰にやり過ぎることもあります。refulgentisは"Hi"と入力しただけで、偽の天気ウィジェットとToDoリストを備えた4パネルのアプリが返ってきたと報告しています。小さなことですが、最大限の作業をするように調整されたモデルの表れであり、それはまさに、範囲が狭く明確に定義されたタスクでは望ましくないことです。
さらに2つの正直な注意点があります。Terminal-Bench 4.0では19.1%にとどまり、Opus 5の51.8%に及ばないため、「Opus 5に匹敵する」というのは、Googleが見せることを選んだベンチマークにおいてのみ真実です。そしてモデルカードには2つの後退した安全性指標が記録されています。多言語での安全性が5.4ポイント、不当な拒否が1.1ポイント後退しており、Googleは率直に"safety performance across non-English languages regressed slightly."と述べています。Frontier Safetyの全体評価は再実施すらされておらず、推論によって3.7から引き継がれました。これらはいずれも単独では決定的な欠点ではありませんが、公正なレビューが指摘すべき類の詳細です。
実際に使ってみた人々の声
コミュニティの評価は有用な形で分かれており、それは上で述べた機械対人間という分断とほぼ完全に一致しています。
長時間のコーディング作業を実行する人々は、概ね気に入っていました。Seltaはこれを"quite a big update,"と呼び、コーディング推論の向上とスピードを維持したままの幻覚の減少を指摘しました。Conor Dartは"Google is back... this model takes its time to think and work through the tasks."と述べました。そしてscrlkは、ベンチマークが完全に見落としている点を挙げました。"Gemini's speed and quality doesn't degrade badly during weekday working hours compared to OAI, and especially Anthropic."負荷がかかった状態での安定性は本物の強みです。
飛躍的な進化を期待していた人々は、より冷ややかでした。markasoftwareは、Artificial Analysisでは"opus 5 medium effort"にしか匹敵しないと指摘し、"opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference."とも述べました。zuzululuは私と同じ結論に達しました。"i might consider 3.8 flash for simple side hobby projects or quick scaffolding but would not trust it for long agentic tasks."そしてpkos98は、発表当日のベンチマークに対する最も健全な懐疑論を提示しました。"Wait a week with your judgement, most likely, Google is just bench-maxing very hard."
取り上げる価値のある構造的な不満もあります。Kol Tregaskesは、これが"with no Pro model."という4連続のFlashモデルであると指摘しました。これは3.8 Flash自体への批判ではありませんが、背景として重要です。報道によれば3.5 Proは完全に見送られる可能性があり、Proクラスのモデルがラインナップに欠けている中で、Flashがフラッグシップの負荷を担っているということです。ベンダー間で比較しているなら、ChatGPT対Geminiと私のGeminiの代替案まとめが最も有用な出発点です。
結論: 3.7 Flashから切り替えるべきか
価格が同一であるため、これが唯一重要な比較であり、ほとんどのアップグレードの判断よりも明快です。
| あなたのワークロードが... | 選ぶべきモデル | 理由 |
|---|---|---|
| 長時間のエージェント型コーディング、ドキュメント量の多いタスク、夜間バッチエージェント | Gemini 3.8 Flash | ここで重要なベンチマークにおいて本当に優れており、価格は同じ。余分な思考には見返りがある |
| レイテンシーに敏感で、人間が介在する(チャット、リアルタイム対応) | Gemini 3.7 Flash | 13.30秒の初回トークンのコストは人に直接影響する。余分な冗長性は純粋なオーバーヘッド |
| コスト優先、大量処理、シンプルな呼び出し(分類、OCR、抽出) | Gemini 3.7 Flash | Googleがはっきりと述べている。"remains fully supported for efficiency-first workloads" |
| より大きなモデルの作業を再確認する監査役 | どちらのFlashでも可 | レビュアーとして使うには十分安価で速く、賢いパターンになる |
結論として、3.8 Flashはある一つの形の作業に対しては本当のアップグレードであり、もう一方の作業に対しては見かけ倒しのダウングレードです。Googleが両方を同じ価格で提供しているのは、寛大さではなく、新しいモデルが効率と丁寧さを引き換えにしていることの表れであり、あなたのワークロードがそのトレードオフのどちら側にあるかは、あなただけが知っています。もう一つ考慮すべき点があります。0.75ドルというレートはプロモーション価格で、2027年1月1日には1.50ドルに倍増します。今日の数字で予算を立てている人は、割引価格で予算を立てているということです。
サポートキューにAIを導入する場合、これは何を意味するのか
ここで正直に言わなければなりません。私がこれらのモデルをテストする理由は、まさにサポートチームが私に問い続ける質問に答えるためです。「どのモデルをチケットに使うべきか?」
正直な答えは、モデルこそが探すべき対象として間違っているということです。サポートのワークロードは、3.8 Flashが得意とすることのほぼ完全な逆です。チケットはコンテキストが短く、長時間タスクではありません。量が多いため、レイテンシーが積み重なり、初回トークンまで13秒の遅延を数千件の会話に乗じれば、実際のコストになります。そして生のモデルは、サポート自動化を実際に機能させる要素を何も提供しません。ヘルプセンターを知らず、過去のチケットを読むこともできず、ZendeskやFreshdeskの中に組み込まれることもなく、顧客に伝える前に何を言うつもりだったかを見せる方法もありません。
私は、自信があるように聞こえるボットがライブのキューで静かに間違った答えを出すのを見てきました。これはベンチマークスコアが決して警告してくれない種類の失敗です。だからこそ私が気にかけているのは、モデルのIntelligence Indexではなく、その周囲のシステムがまず実際のチケットに対してシミュレーションできるかということです。モデルはインフラです。サポートチームが本当に必要としているのは、コンテキストとガードレールが既に整った状態でヘルプデスクに組み込まれた従業員です。その下でのモデル選択は、プラットフォームが処理すべき詳細であり、発表時のベンチマークを読んで決めるべき判断ではありません。
eeselを試す
あなたが本当に求めているのが、自分でモデルを組み込むことではなくAIがチケットに回答することなら、私ならeeselから始めます。eeselは生のインフラではなく、すぐに使えるAIチームメイトを提供しており、AIヘルプデスクのチームメイトはZendesk、Freshdesk、Gorgiasの既存のキューに数分で加わり、あなたのヘルプセンターと過去のチケットで学習します。

その差別化要因は、モデルベンチマークでは得られない部分です。すべてのeeselの導入は、まず実際の過去のチケットに対してシミュレーションされるため、ライブの顧客に何かを伝える前に、すでに対応した顧客に対してAIが何を言っていたかを確認できます。チケットの分類やサポートタグ付けといった目立たない作業も処理し、試用は無料です。コンテンツがボトルネックであり、サポートではない場合は、同じプラットフォーム上で動くAIブログライターのチームメイトもあります。
数字の面では、AIサポートによるコスト削減が計算を示しており、エージェント対人間のコストは財務チームが実際に求める比較です。まだモデルを探している段階で、プロダクトを探していないなら、次に読むべきはトップAIエージェントと中小企業向けの最高のAIエージェントの2つのまとめです。