

Gemini 3.8 Flashの標準有料プランの料金は入力100万トークンあたり$0.75、出力100万トークンあたり$3.75です。これは3.7 Flashの料金と1行1行まったく同じで、Google自身のモデルカードによれば3.8は新しいベースモデルではなく3.7をベースに構築されているためです。
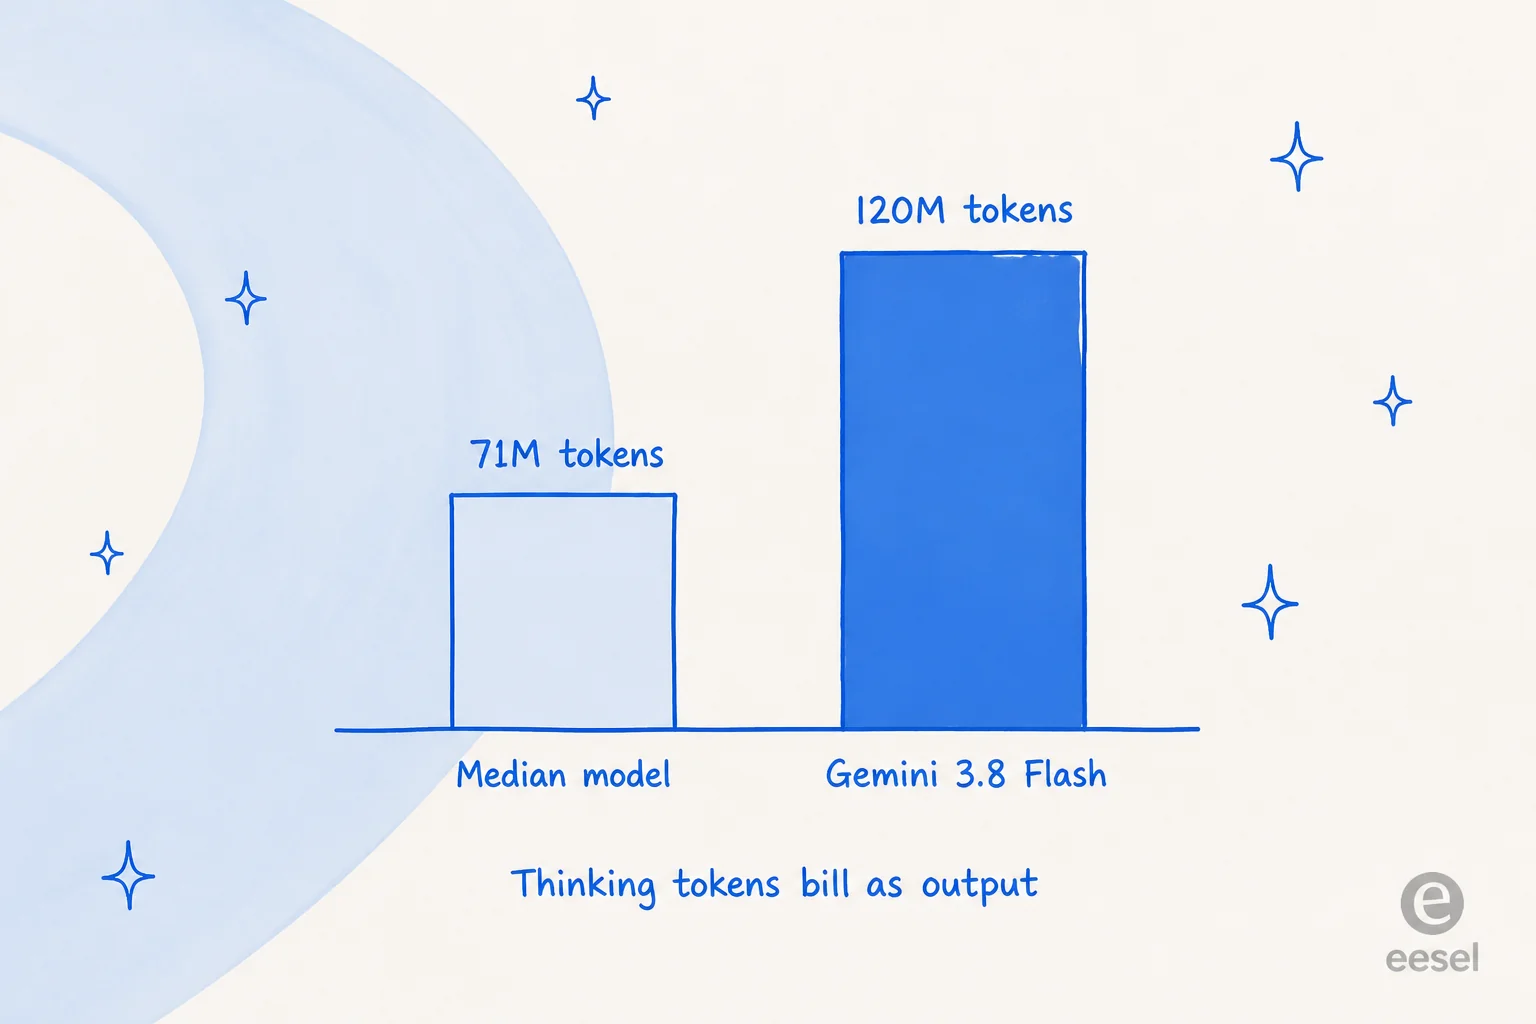
表示価格が隠していることが2つあります。まず、両方の数字は2027年1月1日に2倍になり、$1.50と$7.50になるため、今日の料金はプロモーション価格です。次に、出力トークンには思考トークンが含まれ、3.8 Flashは設計上冗長です。Artificial Analysisの指標では、中央値のモデルが71Mトークンで済んだのに対し3.8 Flashは120Mの出力トークンを消費しました。「より熱心に働く」モデルは、その余分な作業分をあなたに請求します。
私の見解:長時間のエージェント型コーディング作業には非常に安い料金であり、価格が同一なので3.7からの切り替えは無料です。しかし、大量かつレイテンシに敏感なワークロードのコストを見積もっているなら、$0.75という見出しの数字ではなく、実際のトークン消費量と2027年の料金を基準に予算を組んでください。そしてワークロードが顧客チケットへの対応であれば、モデルの料金はボトルネックではありません。これについては最後で詳しく触れます。
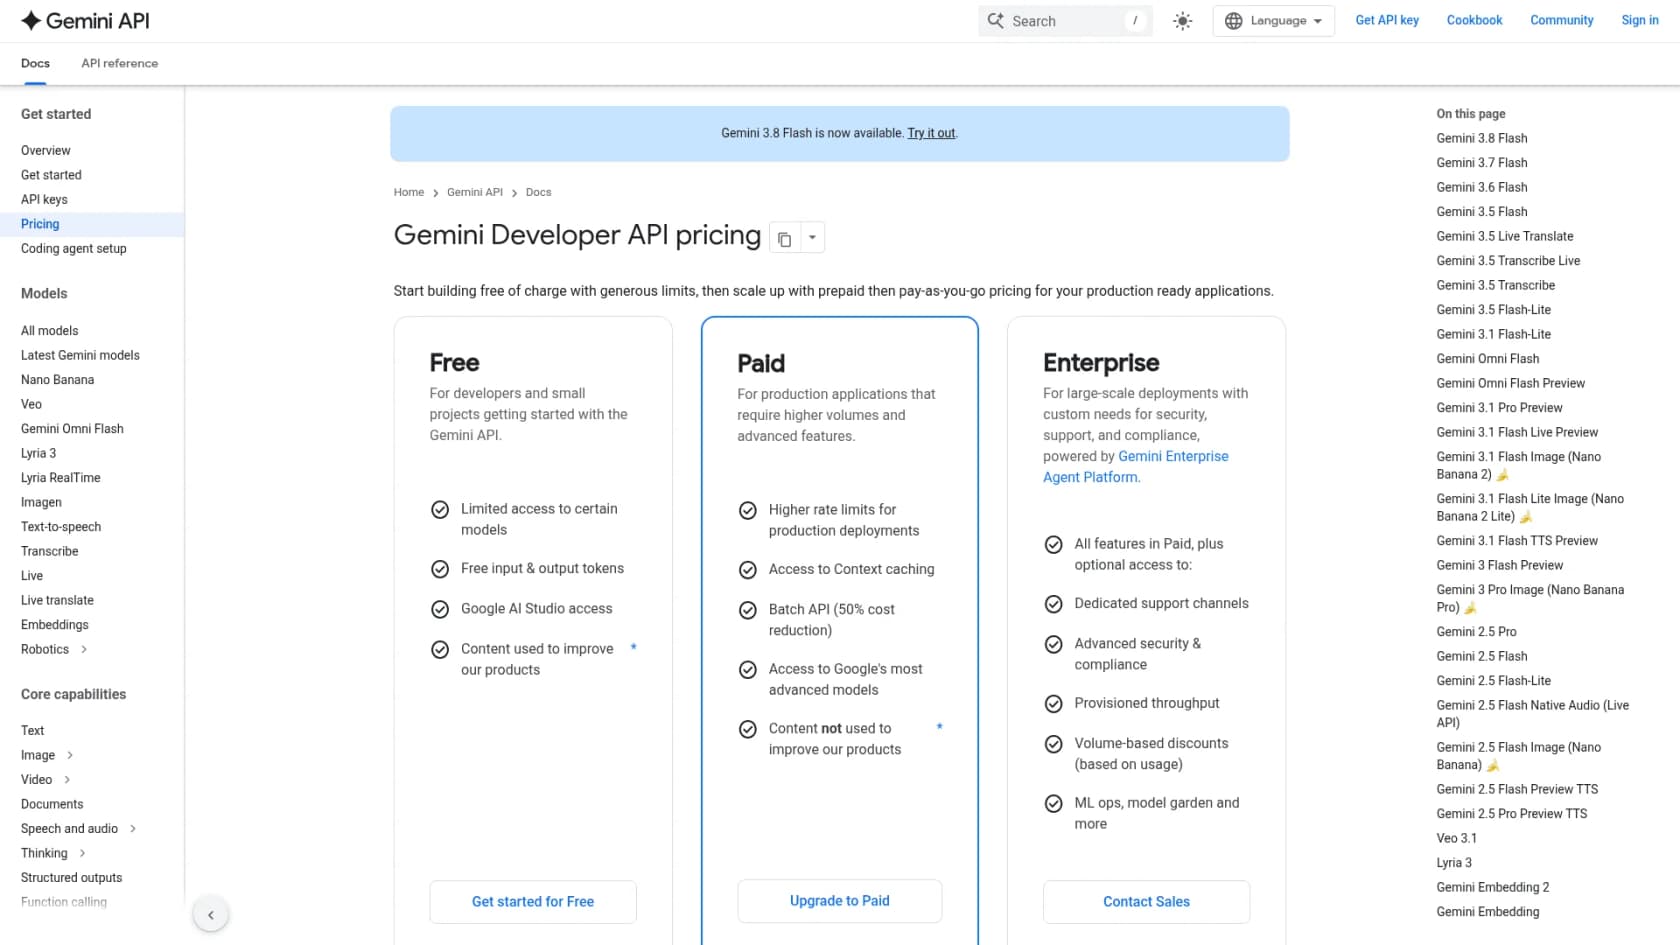
Gemini 3.8 Flashの料金一覧
Gemini APIにおけるgemini-3.8-flashの標準有料プランの公開レートを、100万トークンあたりでまとめました。2027年の列を今日の列のすぐ隣に置いたので、プロモーション価格であることが一目でわかります。
| 項目 | 2026年12月31日まで | 2027年1月1日から |
|---|---|---|
| 入力 | $0.75 | $1.50 |
| 出力(思考トークンを含む) | $3.75 | $7.50 |
| コンテキストキャッシュ、読み取り | $0.075 | $0.15 |
| コンテキストキャッシュ、保存(100万トークン/時間あたり) | $0.50 | $1.00 |
| バッチ・フレックス、入力 | $0.375 | $0.75 |
| バッチ・フレックス、出力 | $1.875 | $3.75 |
| 優先処理、入力 | $1.35 | $2.70 |
| 優先処理、出力 | $6.75 | $13.50 |
Googleのページを上から下まで読むだけでは見落としがちな点がいくつかあります。
- 出力料金には思考トークンが含まれます。 APIが返すのは要約だけですが、モデルの推論に対しても$3.75の料金が課されます。より多く推論するように調整されたモデルでは、これが請求額を押し上げる要因になります。
- バッチとフレックスはちょうど半額です。 作業がインタラクティブでない場合、一晩かけて処理するバッチジョブを使えば、使用するトークンのコストを半分にできます。
- グラウンディングは別途課金されます。 ツールとしてのGoogle Searchは月5,000件まで無料で、利用するすべてのGemini 3.xモデルで共有され、それを超えると1,000件あたり$14かかります。Google Mapsのグラウンディングも同じ枠を使用します。
- 本当に無料のプランがあります。 標準利用であれば入力、出力、キャッシュはすべて無料で、費用をかける前にプロトタイプを作るには十分です。
自分のワークロードで数字を試してみる
見出しの料金だけではわかることは限られています。重要なのは月間の利用量、入力と出力の比率、そしてどのプランを使うかです。以下に自分の数字を入力して、今日の月額コストと、2027年1月の価格上昇後に同じワークロードでかかるコストを比較してみてください。
隠れたコスト:3.8 Flashはあえて冗長になっている
購入判断を変える数字は、料金ページには載っていません。それは、モデルが1つのタスクにどれだけのトークンを消費するかという点にあります。
Googleは発表記事でこのトレードオフを率直に述べています。3.8 Flashは「より熱心に働き」、追加の推論ステップを実行し、ツールを繰り返し呼び出すため、「性能を最大化するために、モデルがより多くのトークンを使用することがある」としています。これは品質面ではメリットですが、請求額には思考トークンが$3.75の出力料金で課金されるため、コストとして跳ね返ってきます。
独立した検証データもそれを裏付けています。Artificial Analysisは3.8 Flashに対してIntelligence Index全体を実行するのに120Mの出力トークンを必要としましたが、同クラスの中央値は71Mでした。AA自身の一言での評価は「very verbose(非常に冗長)」でした。
Hacker Newsでは、あるコメント投稿者がマーケティングよりも鋭い数字を示しました。
"On artificial analysis it's only equal to opus 5 medium effort. Opus 5 max scores 63. Further, opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference."

つまり、作業単位あたりの実際のコストは、100万トークンあたり$3.75という数字が示唆するよりも高くなります。なぜなら3.8 Flashはタスクごとにより多くの単位を消費するからです。Artificial Analysisはその指標の中で、混合コストをタスクあたり$0.58としており、これはコスト効率で195モデル中59位という結果です。単純なトークン単価から想像されるような上位ではありません。自分のトラフィックでこれを注視したいなら、まさにそのためにLLM追跡ツールがあります。
3.7 Flashと同じ価格、では、どちらを選ぶべきか
これが本当の判断ポイントであり、Googleがその答えを示してくれています。3.8と3.7 Flashの価格は1セント単位まで同じなので、価格では決められません。Google自身のガイダンスがその代わりを果たします。「コンピュート効率が主な制約となる」ワークロードについては、開発者は「効率を重視したワークロードに対して完全にサポートされ続けるGemini 3.7 Flashを引き続き利用すべき」だとしています。
端的に言うと:
- 長時間のエージェント型コーディング、コストより品質重視: 3.8 Flash。Googleが公開したすべてのベンチマークで3.7を上回っており、切り替えも無料です。より広いカテゴリーを見比べたいなら、AIコーディングアシスタントのまとめ記事で全体像をカバーしています。
- 大量処理・レイテンシ重視・コスト優先: 3.7 Flashを使い続けましょう。同じ料金でトークン消費が少なく、発表スレッドではGoogleの社員が、3.8の余分なトークン使用は意図された仕様であり、バグではないと確認しています。
レイテンシにも注意点があります。3.8 Flashは純粋な出力速度では195モデル中3位ですが、最初のトークンが出るまでの時間は13.30秒で、中央値の2.99秒を大きく上回ります。人が待つあらゆる場面において、「高速」なモデルこそ応答を始めるのが最も遅いモデルなのです。これはスループットであって応答性ではなく、速度に関する見出しだけを見ると誤解しやすい点です。
他の最先端モデルとの料金比較
他モデルと比較検討しているなら、Gemini 3.8 Flashが実際に競合するモデルと比べて現在どの価格帯にあるか、100万トークンあたり・標準プランで見てみましょう。
| モデル | 入力 | 出力 | 備考 |
|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | 2027年1月に2倍 |
| Gemini 3.7 Flash | $0.75 | $3.75 | 同一料金、タスクあたりのトークン消費が少ない |
| Claude Opus 5 | ~$5.00 | ~$25.00 | タスクあたりの出力トークンが4分の1 |
| Claude Sonnet 5 | Opusより低い | Opusより低い | より安価なClaudeプラン |
同じHNスレッドでの率直な見方として、あるデベロッパーはGemini Flashが他のいくつかの安価なモデルと同様に、最先端プランの「コストのごく一部で90%の性能」を提供していると指摘しました。これが実際のアピールポイントであり、公正な指摘です。ただし、この「一部」というのは冗長性コストと1月の値上げを加える前の、生の料金で測られたものだということを覚えておいてください。Geminiの代替サービスのまとめでは他の選択肢もカバーしており、GoogleとOpenAIを比較検討しているなら、ChatGPTとGeminiの比較から始めるのがよいでしょう。もう一方の側についてはOpenAIモデル一覧も参考にしてください。
実際に利用できる場所
- 無料プラン: Google AI Studioから、入力・出力・キャッシュを無料で利用できます。プロトタイプ作成には十分です。
- Antigravityでのデフォルト: 3.8 FlashはGoogle Antigravityのデフォルトモデルで、余裕のあるクォータが用意されており、HNの複数の開発者がこれを実際の作業で試す最も安価な方法だと指摘しています。
- コンシューマー向けアプリ: GeminiアプリやSearchのAI Mode、Sheetsの中のGeminiがありますが、いずれもGoogle AI ProまたはUltraが必要です。どちらを選ぶか検討中なら、Google AIのプランを参照してください。
- オン・オフの切り替え方法: Workspace全体でGeminiへのアクセスを管理しているなら、Geminiの有効化・無効化の方法をご覧ください。
サポートボットの料金を検討している場合の意味
私は普段、購入者がどのようにヘルプデスク向けAIを探し、価格を検討するかについて考えることに多くの時間を使っています。そこで、モデルの料金ページを読んでいる理由がカスタマーサポートの自動化であるなら、ここが重要な部分です。
$0.75というトークン単価は、解決件数課金型のヘルプデスクアドオンと比べると非常に魅力的に見えます。しかし、この比較を成立させない要素が3つあります。サポート用モデルは短く量の多いチケットに対応するもので、13.30秒という最初のトークンが出るまでの時間は返信のたびに感じられます。3.8 Flashを長いコーディング作業で優秀にしている冗長さは、チケット対応の削減には不向きな特性であり、しかも出力料金として課金されます。そしてトークン単価は、サポート自動化を運用する実際のコストのごく一部に過ぎません。実際のコストを左右するのは、モデル呼び出し自体ではなく、モデルの周辺にある検索(リトリーバル)とテストの作業です。
私はこの3年以上、実際のサポートキューでAIエージェントが動く様子を見続けてきましたが、そのパターンは一貫しています。自信ありげに聞こえるモデルでも、静かに間違った回答をすることがあり、トークン単価がどうであろうとそれを解決することはできません。だからこそ、eeselのすべての導入プロセスでは、顧客に返信する前に実際の過去のチケットに対してシミュレーションを行い、解決率とチケットあたりのコストを、請求書で初めて知るのではなく事前に確認できるようにしています。
自分でサポート自動化を構築するためにモデルを選ぶなら、冗長性コストと2027年の料金を織り込んだうえで正直に見積もってください。モデルを自前でヘルプデスクに組み込みたくないのであれば、eeselは既存のツールに接続し、過去のチケットから学習するAIヘルプデスクチームメイトを提供しており、トークン計算をすることなく無料で試せます。これはエンジンを買うことと、すでに運転できる人を雇うことの違いです。