

要点
Mistral Large 4 は、私がこれまで見た Mistral の中で最大の飛躍です。Artificial Analysis Intelligence Index で Large 3 の 9.3 から 38.4 へ。さらに高速で、半額のプレビューセール中はトークン単価も安く、同じ月に欧州ホスティングとオープンウェイトの両方を約束しているフロンティア級モデルは私の知る限りこれだけです。
しかし、独立した数値では先頭ではなく中位です。Kimi K3 と Qwen 3.8 Max に及ばず、タスクあたりのコストが4分の1のモデルとほぼ同じスコアで、Artificial Analysis の知識テストでは間違えた問題の41.9%でハルシネーションを起こしました。Mistral の発表資料のチャートはサイバーと法務のテストを前面に出しており、それらの勝利は本物に見えますが範囲は限られています。
私の結論:EU のプロバイダーや拒否のないセキュリティ業務が必要なら選ぶ価値があります。ドルあたり最高の回答が欲しいだけなら見送りましょう。そして顧客対応に使うことを考えているなら、モデル選びよりも周りのガードレールのほうが重要です。それはまさに、eesel の AI ヘルプデスクチームメイトが Zendesk、Freshdesk、Gorgias 上ですでに担っている仕事です。
Mistral Large 4 とは?
Mistral Large 4 は Mistral の新しいフラッグシップで、2026年10月6日にパブリックプレビューとして公開され、"Le Chonk" の愛称で呼ばれています。モデルカードによると、総パラメータ1.05兆、トークンあたりアクティブ520億、16億のビジョンエンコーダ、100万トークンのコンテキストウィンドウを持つ Mixture-of-Experts の LLM です。ハイブリッドモデルで、reasoning_effort 設定で先に推論させることも、すぐに回答させることもできます。
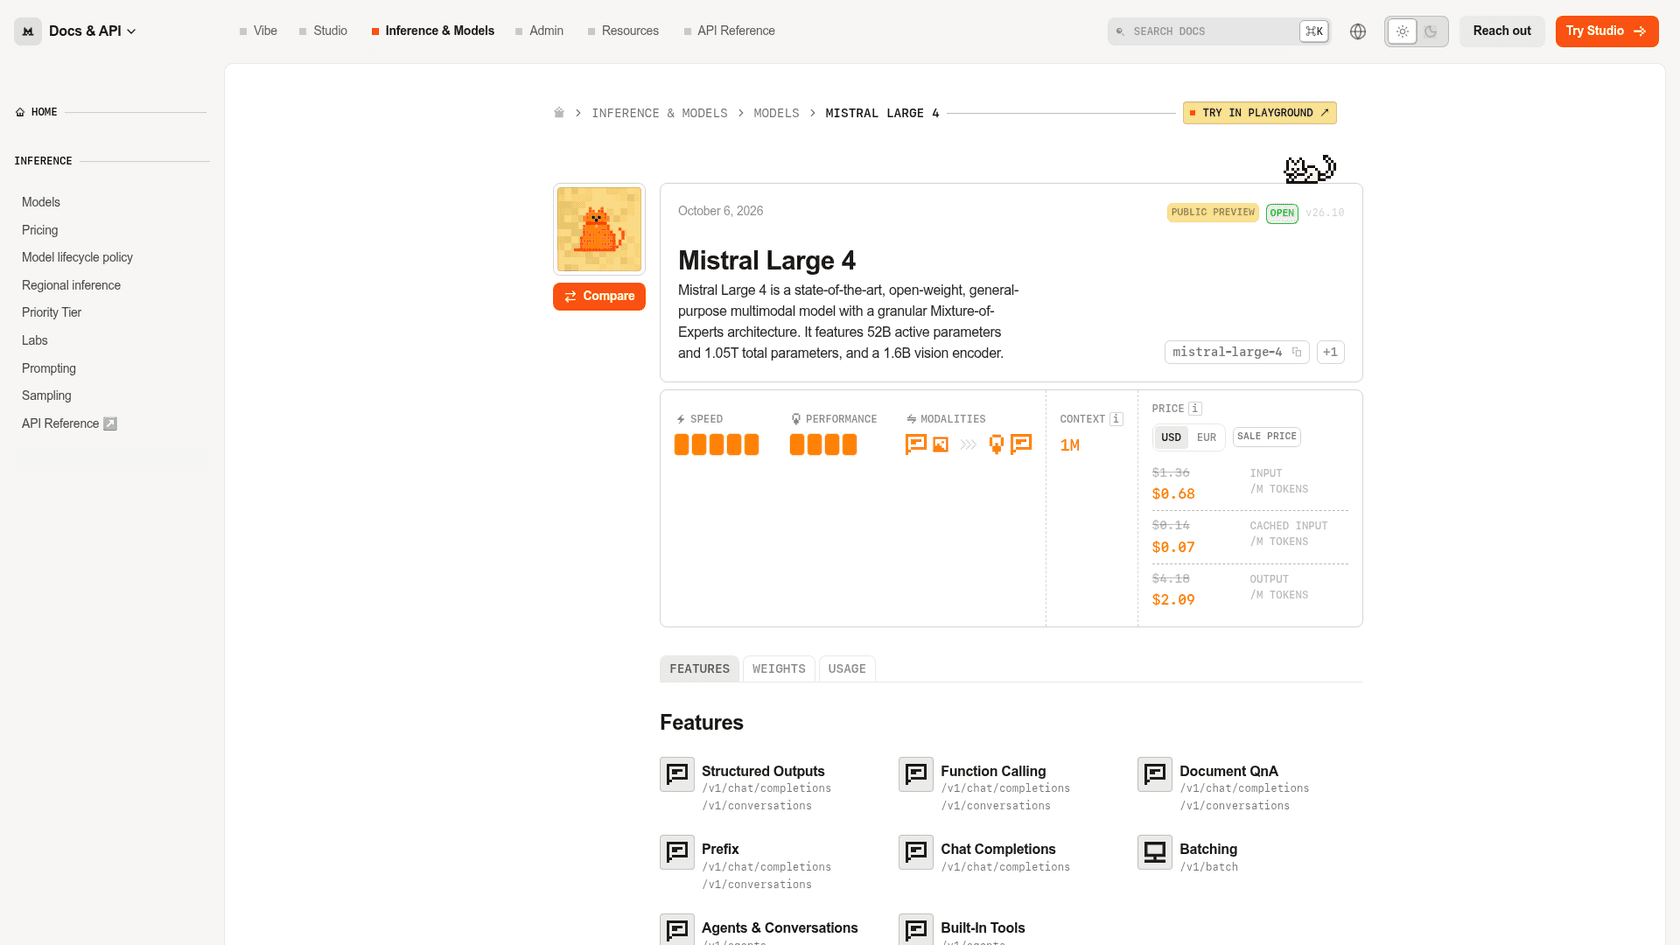
私の立場について一言。私は eesel のブログを執筆し SEO を担当しており、「Mistral Large 4 レビュー」と検索する人がパラメータ数に興味を持つことはまれです。もっと絞った疑問があります。乗り換えるほど十分に良いのか、何に使うのか。このレビューはその疑問に答えます。完全なスペック表は Mistral Large 4 の概要を、すべての料金プランは Mistral Large 4 の料金の解説をご覧ください。
私自身はこのモデルを動かしていないため、実際に使った人々の情報に頼っています。Artificial Analysis の独立テスト、Mistral 自身のドキュメント、そして最初の3日間の Hacker News、Reddit、X での実利用レポートです。
Mistral Large 4 レビューの概要
詳細の前に、短くまとめます。
| 確認した項目 | 結果 | 出典 |
|---|---|---|
| 総合的な知能 | AA Intelligence Index で 38.4(同価格帯の中央値:26) | Artificial Analysis |
| Large 3 からの飛躍 | 9.3 から 38.4、約4.1倍 | AA: Large 3 |
| 近い競合との順位 | Kimi K3(43.6)と Qwen 3.8 Max(45.4)の後ろ | AA |
| 価格(プレビューセール) | 100万トークンあたり入力 $0.68 / 出力 $2.09 | Mistral の料金 |
| AA タスクあたりのコスト | 定価で $1.13、セールで約 $0.57 | Artificial Analysis |
| ハルシネーション率 | AA-Omniscience で 41.9% | Artificial Analysis |
| 出力速度 | 116.1 トークン/秒、最初の回答トークンまで約 18.7 秒 | Artificial Analysis |
| 冗長さ | 指数の実行に 200M トークン、中央値は 81M | Artificial Analysis |
| オープンウェイト | 2026年10月末に公開予定、まだ未公開 | Mistral |
| 得意分野 | 拒否のないサイバータスク、法務エージェント業務、視覚的グラウンディング | Mistral の発表資料のチャート |
Mistral は実際に何を直したのか?
率直な見出しは、Mistral が再び競争に戻ってきたということです。昨年12月、Mistral Large 3 は同じ指数で 9.3 を記録し、フロンティアからはほど遠い位置でした。Large 4 は 38.4 です。安価な要約用のモデルと、AI エージェントを動かせるモデルの違いです。
Plotly のチームは発表当日にデータ分析ベンチマークで試し、別の角度から同じ飛躍を確認しました。
「4月の Mistral Medium 3.5 より10倍安く、正答率は58%から74%に上がる。間違いなく世代交代だ。」

問題は、その飛躍がどこから来たかです。Large 4 は推論モデルで Large 3 はそうではなかったため、向上分の多くは思考トークンで買ったものです。
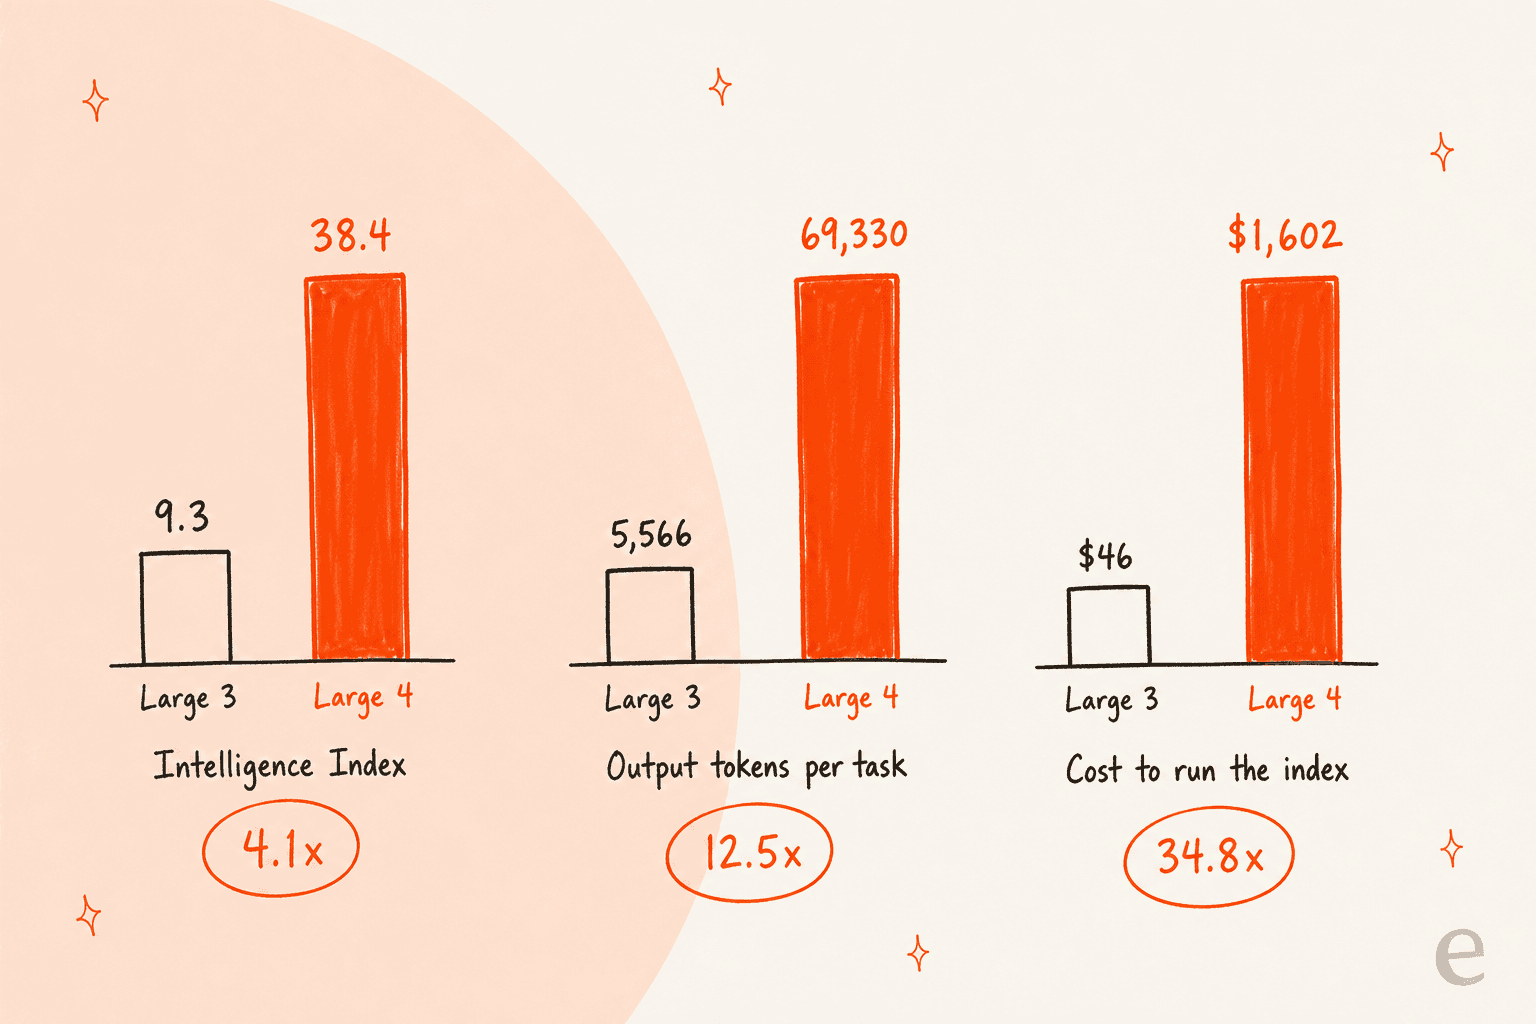
スコアは約4.1倍になりました。タスクあたりに書くトークンは12.5倍、定価で指数全体を実行するコストは34.8倍の、$46 から $1,602 になりました(Artificial Analysis による)。モデルへの批判ではありません。どのラボも推論のために同じ代償を払っています。ただし、トークン単価は Large 4 の実際のコストを知る手がかりとして不十分だということです。Artificial Analysis はこれを「非常に冗長」と評しています。指数の完了に200Mトークンで、中央値は81Mです。
独立ベンチマークでの Mistral Large 4 の比較
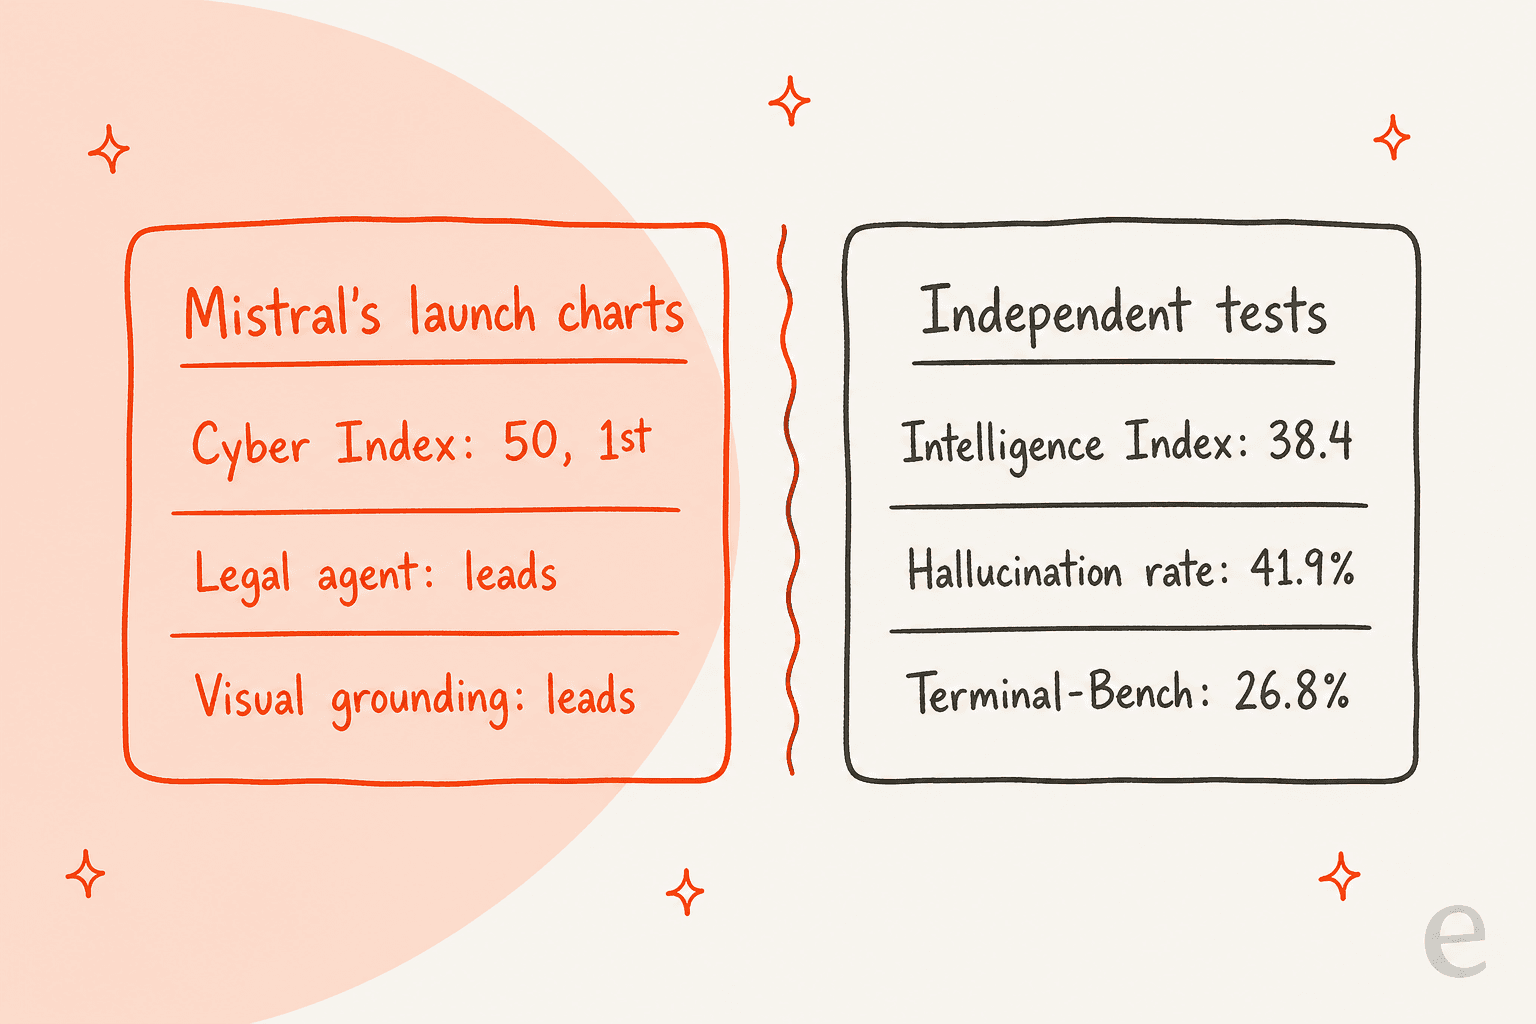
ここからレビューはあまり好意的でなくなります。Mistral の発表記事はチャートだらけで、そのほとんどが Large 4 の勝利を示しています。独立した状況はもっと入り混じっています。
10の評価を組み合わせた Artificial Analysis の v4.3.2 指数で、比較対象のモデルの中での Large 4 の位置は次のとおりです。
| モデル | AA 指数 | 100万あたりの入力 / 出力価格(定価) | AA タスクあたりのコスト | 出力速度 |
|---|---|---|---|---|
| Claude Sonnet 5.5 (Xhigh) | 51.9 | $2 / $10 | $2.01 | 100.7 t/s |
| Qwen 3.8 Max | 45.4 | $2 / $6 | $5.41 | 37.6 t/s |
| Kimi K3 | 43.6 | $3 / $15 | $2.00 | 41.7 t/s |
| Gemini 3.8 Flash | 40.9 | $0.75 / $3.75 | $1.24 | 125.2 t/s |
| DeepSeek V4.1 Flash | 39.5 | $0.30 / $1.20 | $0.27 | 216.1 t/s |
| Mistral Large 4 Preview | 38.4 | $1.36 / $4.18 | $1.13 | 116.1 t/s |
| GPT-5.6 Luna | 37.3 | $0.20 / $1.20 | $0.18 | 117.0 t/s |
数値はすべて Artificial Analysis のモデルページから、2026年10月8日に取得したものです。Large 4 のタスクあたりのコストは、現在のセール価格でおよそ半分になります。
2点が目を引きます。第一に、Large 4 は上位のどのモデルよりもタスクあたりのコストが低く、Kimi K3 や Qwen 3.8 Max より高速にストリーミングします。第二に、DeepSeek V4.1 Flash と GPT-5.6 Luna は約1ポイント差以内で、Mistral の50%セール後でもタスクあたりのコストはごく一部です。「まずまずの回答を大量に」が目的なら、この2つのほうが手強い競争相手です。
Mistral 自身の Terminal-Bench 4.0 のチャートは、見せ方がいかに重要かを示す好例です。Large 4 は28で Qwen 3.8 Max と Kimi K3 を上回りますが、40の GLM-5.3 には大きく及びません。
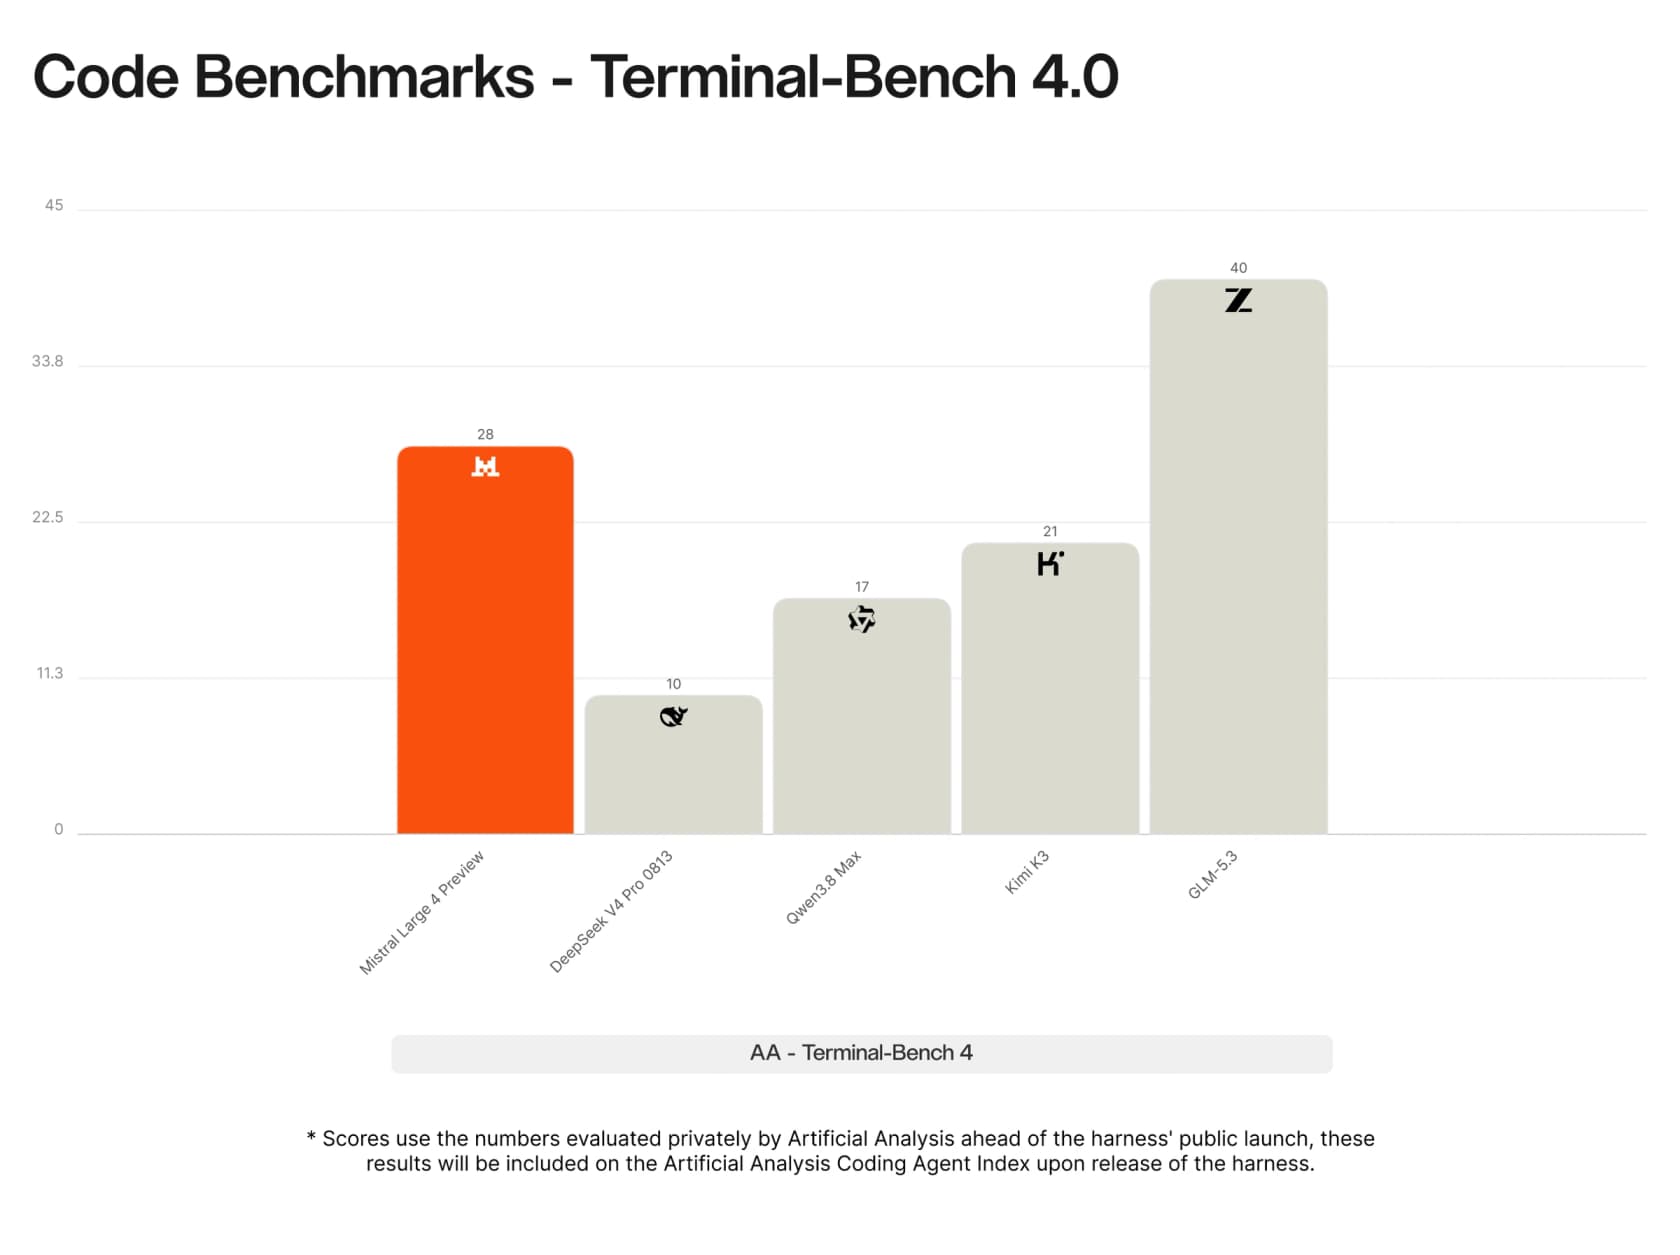
Hacker News の読者の中には、チャートの選び方についてもっと率直な人もいました。あるコメント投稿者は、マルチモーダルのチャートを Artificial Analysis の公開数値と照合し、食い違いを見つけました。
「このベンチマークは知らないが、AA の GDP.pdf の一覧では Sol 5.6 Max は27で、推論なしでも12.8を上回る。Sol 5.6 だけを都合よく選んだうえに、公開されているサードパーティのベンチマークスコアについて嘘までつくのは極めて奇妙だ。」
「嘘」とまでは言いません。ベンチマークのバージョンや設定は異なり、Mistral のチャートは別の実行を使っているのかもしれません。それでも、ベンダーのチャートは最良のケースとして読み、Artificial Analysis のページを基準として扱う十分な理由になります。
Mistral Large 4 が本当に強い分野
全体で中位であることは、あらゆる面で中位という意味ではありません。精査に耐える分野が3つあります。
拒否のないセキュリティ業務。 Mistral が示した Artificial Analysis の Cyber Index では、Large 4 は50で、41の Kimi K3 と DeepSeek V4.1 Flash を上回ります。チャートでより興味深いのは灰色のバーです。他のフロンティアモデルでは、多くの試行が安全ブロックに止められていました。
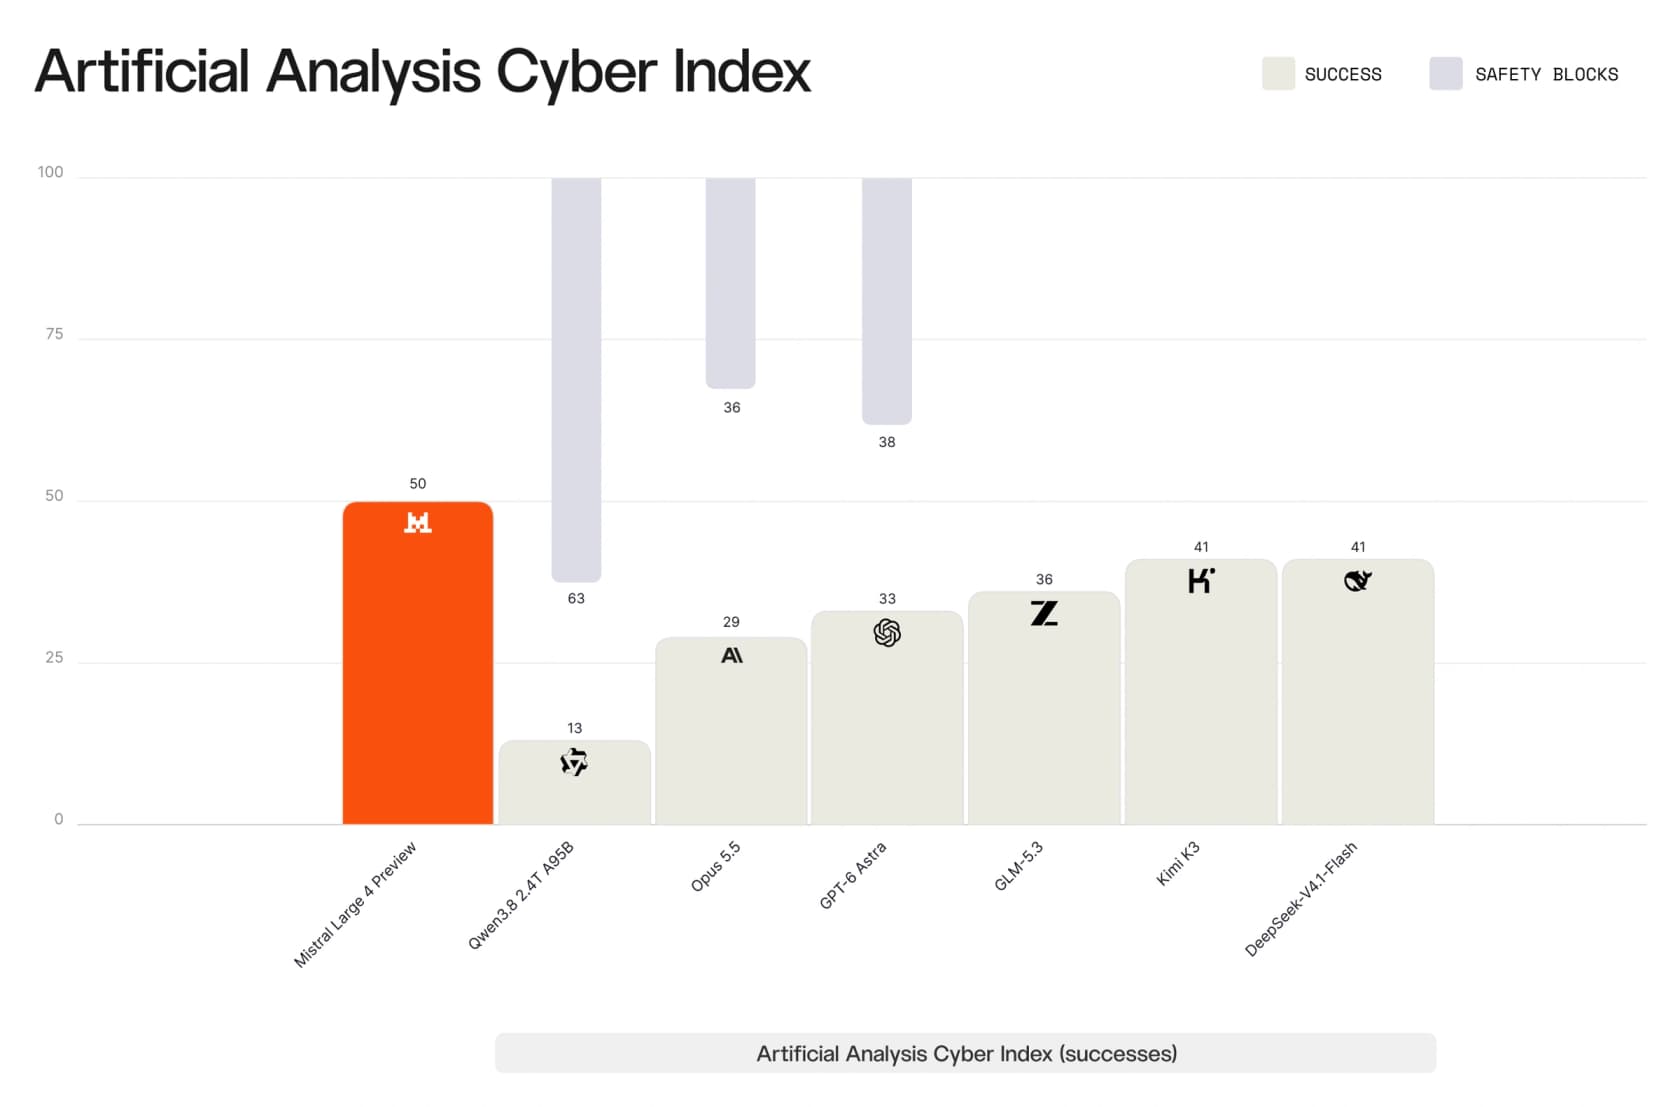
Mistral 共同創業者の Guillaume Lample は発表当日にまさにこの点を訴え、オープンモデルは「助けを拒否しない」と述べました。セキュリティチームを率いていて、現在のモデルが自社スタック内のエクスプロイトコードの確認を拒み続けるなら、Large 4 を試す現実的な理由になります。
法務・文書業務。 Vals.ai による Mistral のチャートでは、Large 4 が Harvey の法務エージェントベンチマークでトップで、Artificial Analysis は長文脈推論テストの AA-LCR で81.3%を付けています。長い契約書は100万トークンのウィンドウと相性が良いです。
話し始めてからの速度。 Mistral の API では毎秒116.1トークンで、Kimi K3 や Qwen 3.8 Max よりかなり高速にストリーミングします。Hacker News のある初期テスターは、その点を気に入って普段使いにしていました。
「OpenRouter 経由だと webui でとても速い(Kimi K3 よりかなり良い)。非常に冗長で、しばらくすると指示を忘れ始めるようだが、C と組み込みプログラミングについての30分のチャットで、良い情報をたくさんくれた。」
この引用の中ほどに注目してください。「指示を忘れ始める」は、チャット画面よりも本番でずっと重要になる問題です。
Mistral Large 4 の弱点
弱点も同じくらい具体的です。
事実の想起とハルシネーション。 顧客向けの用途で評価するなら、私が赤字で示す数値です。知識の質問を出し、推測するよりも「わからない」と答えたモデルを評価する AA-Omniscience では、Large 4 の正答率は25.8%、ハルシネーション率は41.9%で、総合スコアは -5.3 でした(Artificial Analysis による)。Hacker News のあるテスターも、クイズゲームで同じことを確認しています。
「Mistral Large 4 はあまり良くない。約40回の推測でゲームを解けることもあるが、Gemini 3.8 Flash や Grok 4.7 のような上位モデルはほとんどのパズルを一発で解く。私のベンチマークは AA Omniscience と一致している。」
最初の回答までの時間。 推論モデルなので、話す前に考えます。Artificial Analysis は、長いプロンプトで最初の回答トークンまで約18.7秒、10万トークンでは28.4秒と測定しました。バックオフィスのエージェントなら問題ありませんが、ライブチャットのウィジェットには厳しいです。
エージェント型コーディング。 Terminal-Bench では GLM-5.3 に及ばず、Artificial Analysis 自身の実行では26.8%でした。さらに辛辣な実利用レポートもありました。
「コード分析、画像分類、チェスの能力で少し試してみた。かなり古く感じられ、普段使っているものよりずっと遅れている。」

Mistral に公平を期すなら、これはプレビューです。Lample は X で強化学習の実行が「まだ進行中」だと述べており、最終版は重みとともに公開される予定です。スコアは10月末までに変わる可能性があります。
「オープンウェイト」は今日選ぶ理由になるか?
まだです。モデルカードには「Open」のバッジがありますが、ライセンス欄は空で、10月9日時点で Mistral の Hugging Face ページには Large 4 のリポジトリがありません。Artificial Analysis は、重みが公開されるまでプロプライエタリとして掲載しています。
公開されたとしても、1.05兆パラメータのモデルをほとんどのチームが余っている GPU で動かせるわけではありません。Mistral の発表ツイートへの最も「いいね」の多い返信がそれを端的に表していました。
「12GB の VRAM の私が『オープンウェイト、1.05Tパラメータ』を読んでいる図」
ここでのオープンウェイトの実用的な価値は、高性能なモデルを欧州の自社ハードウェアでホストしたい大企業や政府にあります。それ以外の人にとっては API であり、その API は、一般提供モデルの6か月ではなく1か月の廃止予告のプレビューです。プレビューの上に本番ワークフローを構築するということは、4週間前の予告で変更されうることを受け入れるということです。
Mistral Large 4 は誰が使うべきか?
ここまでを踏まえ、私の答えは2つの質問に集約されます。データを欧州(または自社サーバー)に置く必要があるか、そしてあなたのユースケースで生の精度が最も重要か。
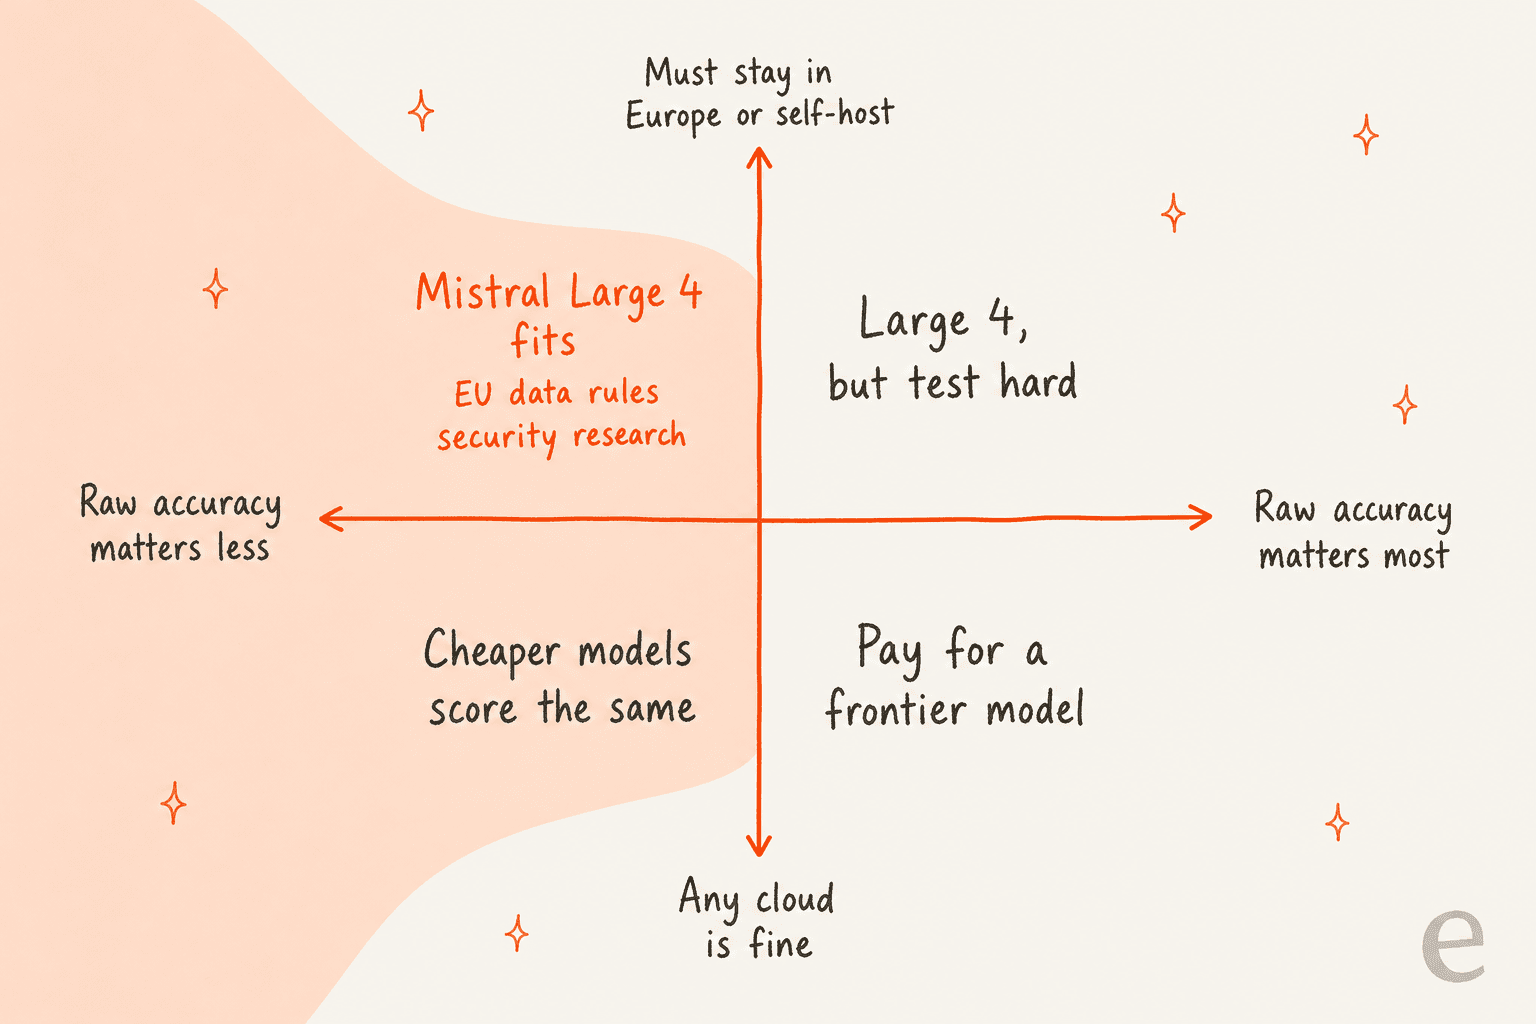
主権の論点は現実のもので、多くのコメント投稿者がはっきりそう述べていました。
「ほとんどの企業ワークフローでは、おそらく十分に良い。しかも習近平やトランプに魂を売らなくて済む。ヨーロッパ人として、もっとひどいものを覚悟していた。」
以下の適合チェックで、あなたのユースケースがどこに当てはまるか試してみてください。
あなたのワークロードで最も重要なことは何ですか?
1つ選ぶと私の判断が表示されます。
サポートチームを運営している場合の意味
モデルのレビューを読んでいる多くの人は今、より安価な欧州のモデルで自社のボットを動かせるかを考えています。わかります。でも、ハルシネーションの数値こそ、私がじっくり考えたい点です。
サポートボットが、ドキュメントではなくモデル自身の記憶から答えるとどうなるか、私は見てきました。今年の初め、eesel の有料顧客の何社かが使っていたボットは、ナレッジベースの検索が空だったとき、引き継ぐ代わりに学習データで穴を埋めていました。ある例では、実在の顧客に作り話のサブスクリプションの詳細を送りました。別の例では、サポートの質問に周期表の元素である「酸素」と答えました。これはフォールバックの問題でありモデルの問題ではなく、より大きなモデルでも解決しなかったでしょう。だからこそ、現在すべての eesel の導入は顧客に触れる前に過去のチケットでシミュレーションされます。
約7,000件のチケットを扱うサプリメントブランドの CX リーダーは、どんなベンチマークよりも的確に本当の要件を述べました。
「自信を持って対応できるチケットだけを処理し、それ以外には手を出さない AI が必要です。」
これは、まずルーティングと信頼度スコアの問題で、モデルの問題はその次です。ハルシネーション率41.9%のモデルは、この層をより重要にします。Large 4 で自作する場合は、サポート向け RAG、ハルシネーションを防ぐ方法、サポートに最適な LLM のガイドが出発点になります。また、Mistral を選ぶ理由が EU のデータ規則なら、まず SOC 2 と GDPR がベンダーに実際に何を求めているかを確認してください。モデルの母国は、その一部にすぎません。
試す価値のある Mistral Large 4 の代替
このレビューで迷いが生じたなら、必要なものに応じて次のあたりを見ます。
| 求めるもの | 検討先 | 理由 |
|---|---|---|
| より高い精度で、まだ手頃 | Sonnet 5.5 または Kimi K3 | AA 指数で 51.9 と 43.6 |
| 同じスコアでより低コスト | DeepSeek V4 Flash ファミリー、GPT-5.6 Luna | 39.5 と 37.3、タスクあたり $0.18〜$0.27 |
| 今日動かせるオープンウェイト | DeepSeek V4.1 Flash、GLM-5.3 | この AA の比較で Large 4 の隣にどちらもオープンウェイトとして掲載 |
| より安い Mistral | Large 3 または Small 4(Mistral AI の料金を参照) | 100万あたり $0.50/$1.50 と $0.15/$0.60 |
さらに長いリストは、Mistral の代替まとめと、Claude vs Mistral、ChatGPT vs Mistral の比較記事でさらに詳しく見られます。
結論
Mistral Large 4 は、停滞したように見えたラボの確かな復活です。スコアの飛躍は本物で、セール中の価格は妥当で、速度も良好です。欧州のプロバイダーや、セキュリティ業務で実際に助けてくれるモデルが必要なら、私が最初に試すのはこれです。
それ以外の人にとっては、数値はまだ乗り換えを正当化しません。タスクあたり4分の1のコストのモデルとほぼ同水準で、顧客向けの業務には許容できないほどハルシネーションが多く、今日試すバージョンは1か月前の予告で変わりうるプレビューです。10月末の最終版と重みの公開後にもう一度確認して、そこで判断します。
eesel を試す
サポートボット向けのモデルを選んでここに来たなら、近道があります。モデルはインフラであり、eesel は従業員です。eesel の AI ヘルプデスクチームメイトは Zendesk、Freshdesk、Gorgias に接続し、過去のチケットとヘルプセンターから学習し、実際のチケット数百件でシミュレーションを実行するため、顧客より先に回答を確認できます。モデルの選択、グラウンディング、「わからないので担当者に引き継ぎます」というフォールバックはすべてお任せで、料金は処理したチケットごとなので、冗長なモデルが請求に現れることはありません。プランは料金ページから無料で始められます。

eesel を試して、何かを決める前に直近1か月のチケットを再現してみましょう。