

Voxtral 3は、今ヨーロッパのラボから買える音声スタックの中で最もコストパフォーマンスが高く、私は5点満点中3.5点と評価します。バッチ文字起こしは素晴らしく、電話エージェントとしては有望ですがまだ初期段階です。Voxtral Small Transcribe 3は、Mistralの45言語テストで単語誤り率4.0%となりMicrosoft AI Transcribe 2と並び、料金は1分$0.004です。音声は100万文字あたり$13、オールインワンの音声エージェントAPIは1分$0.04です。
足かせは3つあります。すべてのモデルがパブリックプレビューであること、今回は重みがクローズドであること(Voxtral 1と2はオープンでした)、そしてSIP経由の電話通話はリリース時点でエンタープライズ限定であることです。さらにMistral自身のグラフでは、ライブ文字起こしでGemini 3.5 Realtimeがすべてのレイテンシ設定で上回っています。
サポートを運営しているなら、音声レイヤーは簡単な半分です。eeselでは、smava向けに毎月27,000件のZendeskチケットにドイツ語で対応しており、それを支えているのは優れたマイクではなく、過去のチケットでの学習です。音声モデルはエージェントに耳と声を与えますが、あなたのビジネスを知っている必要があることに変わりはありません。
Voxtral 3とは?
Voxtral 3は、Mistralの音声ファミリーで、2026年10月20日にリリースされました。これまで別々に買い揃えていた3つ、つまり音声認識モデル、音声合成モデル、そしてそれらをチャットモデルを挟んでつなぐ音声エージェントSDKをひとまとめにしています。
私は仕事で連携やAPIを作っているので、このリリースもあらゆるベンダーのドキュメントと同じように読みます。各モデルIDは実際に何をするのか、単位あたりいくらか、つなぐと何が壊れるのか。ラインナップは次のとおりです。
| モデル | 役割 | 料金 | 備考 |
|---|---|---|---|
| Voxtral Small Transcribe 3 | バッチ文字起こし、フラッグシップ | $0.004/min | 50言語、話者分離、翻訳と音声への質問応答にも対応 |
| Voxtral Mini Transcribe 3 | バッチ文字起こし、低価格 | $0.0035/min | 4Bパラメータ、制約のあるハードウェアにも収まる小ささ |
| Voxtral Mini Transcribe Realtime 3 | ライブ文字起こし | $0.008/min | 80msから2,400msまでのレイテンシ調整、発話終了検出 |
| Voxtral TTS 3 | 音声合成 | $13/1M chars | 35以上の言語、50以上の方言、音声クローン |
| 音声エージェントAPI(Mistral Small 4) | 通話パイプライン全体 | $0.04/min | 音声入力、推論、音声出力 |
| 音声エージェントAPI(より大きなモデル) | 通話パイプライン全体 | $0.08/min | 同じ構成で、より大きな推論モデル |
料金はリリース記事と各モデルのドキュメントページ、たとえばVoxtral Small Transcribe 3のモデルカードに基づいています。これらのページはどれも、モデルをPublic Previewと表示しています。今四半期に本番展開を計画しているなら、これは見た目以上に重要です。
Voxtral 3の文字起こしはどれくらい正確?
録音音声なら非常に正確です。ここはリリースの中で私が最も信頼する部分で、Mistralの文章よりも図表を注意深く読んでも、数字は崩れません。
45言語にわたるFLEURSベンチマークで、Voxtral Small Transcribe 3は言語を自動検出した場合に単語誤り率4.0%を記録しています。Mistralのグラフに載っている7モデルの並びは次のとおりです。
| モデル | 誤り率(言語指定あり) | 誤り率(言語検出) |
|---|---|---|
| Voxtral Small Transcribe 3 | 4.1% | 4.0% |
| Microsoft AI Transcribe 2 | 4.1% | 4.0% |
| Voxtral Mini Transcribe 3 | 4.6% | 4.5% |
| Gemini 3.5 Transcribe | 6.1% | 4.5% |
| Scribe v2 | 4.9% | 4.9% |
| GPT Transcribe | 6.3% | 5.6% |
| Whisper large-v3 | 16.0% | 14.9% |
一番上の行が同点であることに注目してください。リリース文には、Smallは「Whisper、Scribe v2、Gemini 3.5 Transcribeを上回る」とあり、それは事実ですが、小数点まで一致するMicrosoft AI Transcribe 2には触れていません。MistralがまとめたArtificial Analysisの単語誤り率インデックスのグラフでは、Voxtral Small Transcribe 3はFun-Realtime-ASR-previewとMicrosoft AI Transcribe 2に次ぐ3位です。素晴らしい結果ですが、見出しが示唆するほどの完全勝利ではありません。
ここでの静かな勝者はMiniモデルです。4.5%で、言語検出ありの音声ではGemini 3.5 Transcribeに並び、Miniのモデルカードによればリソースの限られた環境にも収まる小ささです。録音した通話を品質保証のために文字起こしするなら、1分$0.0035のMiniから始めます。
誰が何を言ったか:話者分離
話者分離(各発言をどの話者が言ったかのラベル付け)は、Voxtralがグラフで首位に立つ分野です。Mistralの複合話者分離ベンチマークは会議録音と電話通話を混ぜたもので、誤り率は次のとおりです。
- Voxtral Small Transcribe 3:
18.4% - Voxtral Mini Transcribe 3:
18.6% - Pyannote Orchestrator:
19.0% - Microsoft AI Transcribe 2:
20.3% - Scribe v2:
23.0% - Voxtral Mini Transcribe 2:
30.9% - Gemini 3.5 Transcribe:
38.4%
旧Miniの30.9%から新Miniの18.6%への改善は、今回のリリースで最大の単独の進歩です。サポートチームにとって、話者分離は通話録音を使える文字起こしに変えるものです。通話を採点したりクレームを抜き出したりする前に、どの行が顧客でどの行がエージェントかを知る必要があります。話者によって削除ルールが異なることも多いので、文字起こしから個人情報を削除する予定がある場合にも重要です。
製品名や専門用語:コンテキストバイアス
コンテキストバイアスは、製品名、SKU、人名などの用語リストをモデルに渡して、正しいつづりで書かせる機能です。Earnings-22のキーフレーズテストで、Voxtral Smallはコンテキストありで再現率94.6%、なしで81.4%です。Scribe v2はコンテキストありで94.3%、なしで84.0%です。
つまり用語リストがあれば両者は互角で、なければScribe v2の方が実際には多くのキーフレーズを拾います。実践上の結論は、Voxtralを使うなら必ず用語リストを送ることです。移行ガイドによれば、エントリは複数語のフレーズにもできますが、音声とコンテキストウィンドウを共有するため、長いリストは400エラーを引き起こすことがあります。
Voxtral 3はライブ通話に向いている?
良いが、最高ではありません。ここで私の評価は和らぎ、それを和らげるのはMistral自身のグラフです。
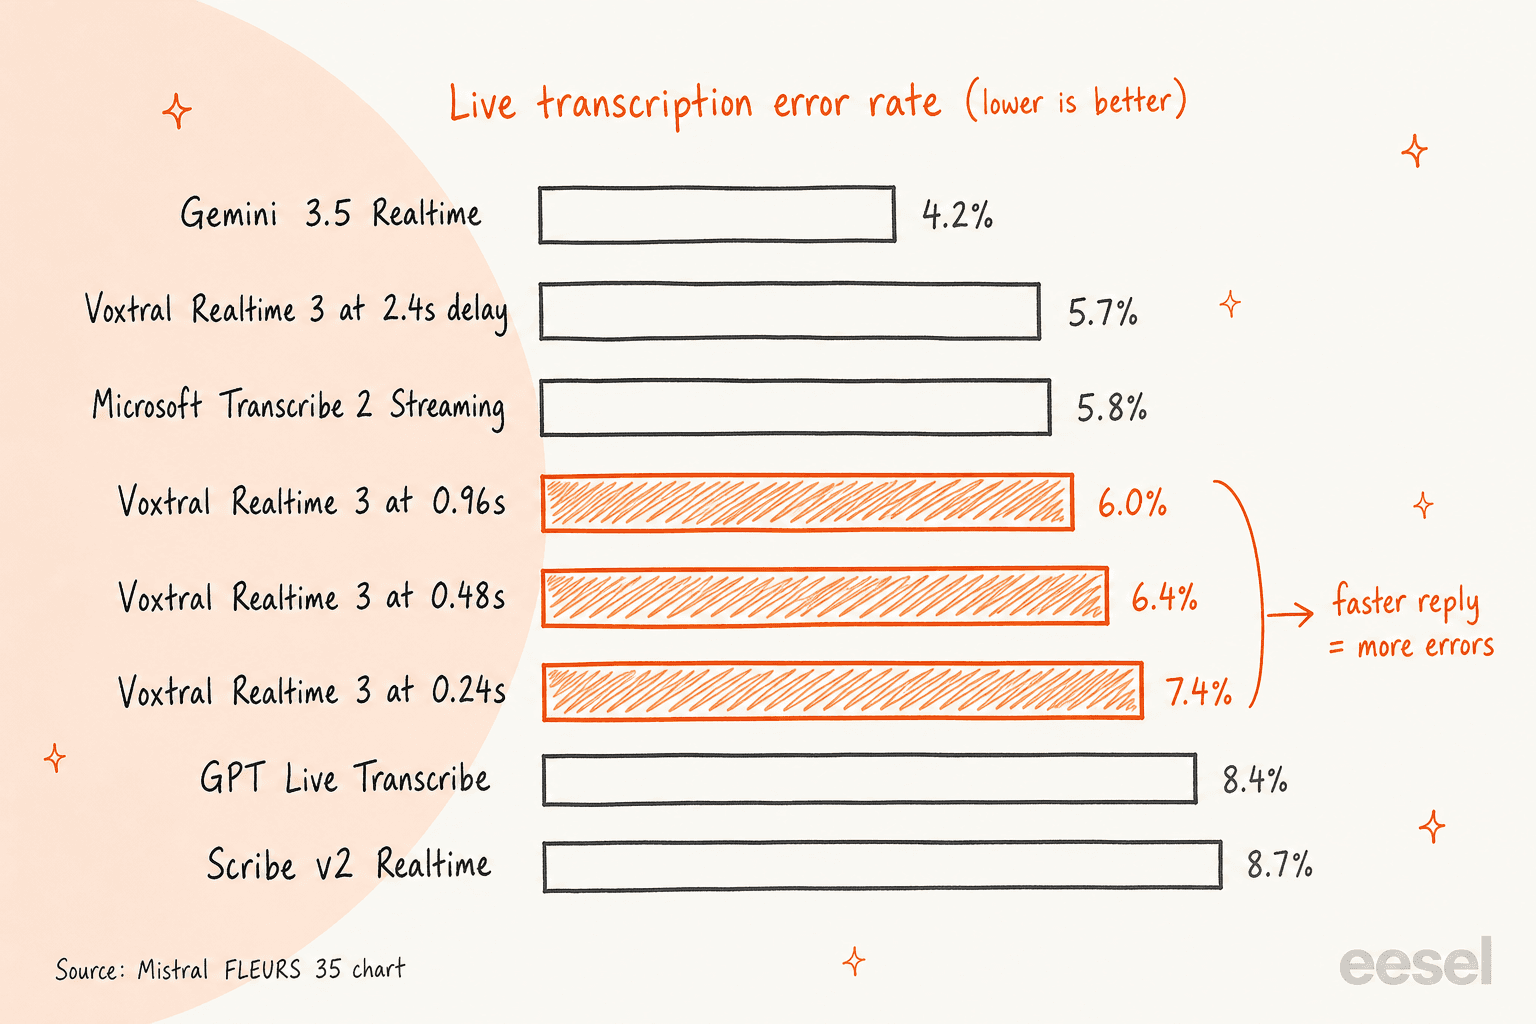
Voxtral Mini Transcribe Realtime 3にはレイテンシのダイヤルがあり、言葉を確定するまでの待ち時間を80msから2,400msの間で選べます。長く待つほど文脈が増え、誤りが減ります。Mistralの35言語リアルタイムテストでは次のとおりです。
| 設定 | 誤り率 |
|---|---|
| Gemini 3.5 Realtime Transcribe | 4.2% |
| Voxtral Realtime 3(2,400ms) | 5.7% |
| Microsoft AI Transcribe 2 Streaming | 5.8% |
| Voxtral Realtime 3(960ms) | 6.0% |
| Voxtral Realtime 3(480ms) | 6.4% |
| Voxtral Realtime 3(240ms) | 7.4% |
| GPT Live Transcribe | 8.4% |
| Scribe v2 Realtime | 8.7% |
目立つ点が2つあります。1つ目は、Mistral自身のグラフでGemini 3.5 RealtimeがVoxtralのどの設定も上回っていることです。2つ目は、反応の速い電話エージェントに実際に使う設定(約240〜480ms)が、Voxtralが最も精度を手放す設定だということです。それでも、どの設定でもGPT Live TranscribeとScribe v2 Realtimeは上回るので、堅実な選択肢です。ただし最も正確というわけではありません。
構築を始める前に確認しておきたい小さな点があります。リアルタイムモデルが対応する言語数について、Mistralのページ同士で食い違いがあります。リリース記事は35超、料金カードは40以上、グラフは35をテストしています。大きい方の数字を信じるのではなく、実際に使う言語でテストしてください。
良いニュースは発話終了検出です。リアルタイムモデルは、音と発言内容の意味の両方を使って、発信者が話し終えたタイミングを予測します。これにより、文の途中で間を置いた人にボイスエージェントが被せて話すことを防げます。カード番号を読み上げている最中に割り込んでくるボットに付き合った経験がある人なら、なぜ重要かわかるはずです。
Voxtral 3の音声はどれくらい自然?
十分自然で、得られるものに対して非常に安価です。Voxtral TTS 3は、見出しになる単一の数字ではなく、聞いた印象の面で最も改善した部分です。
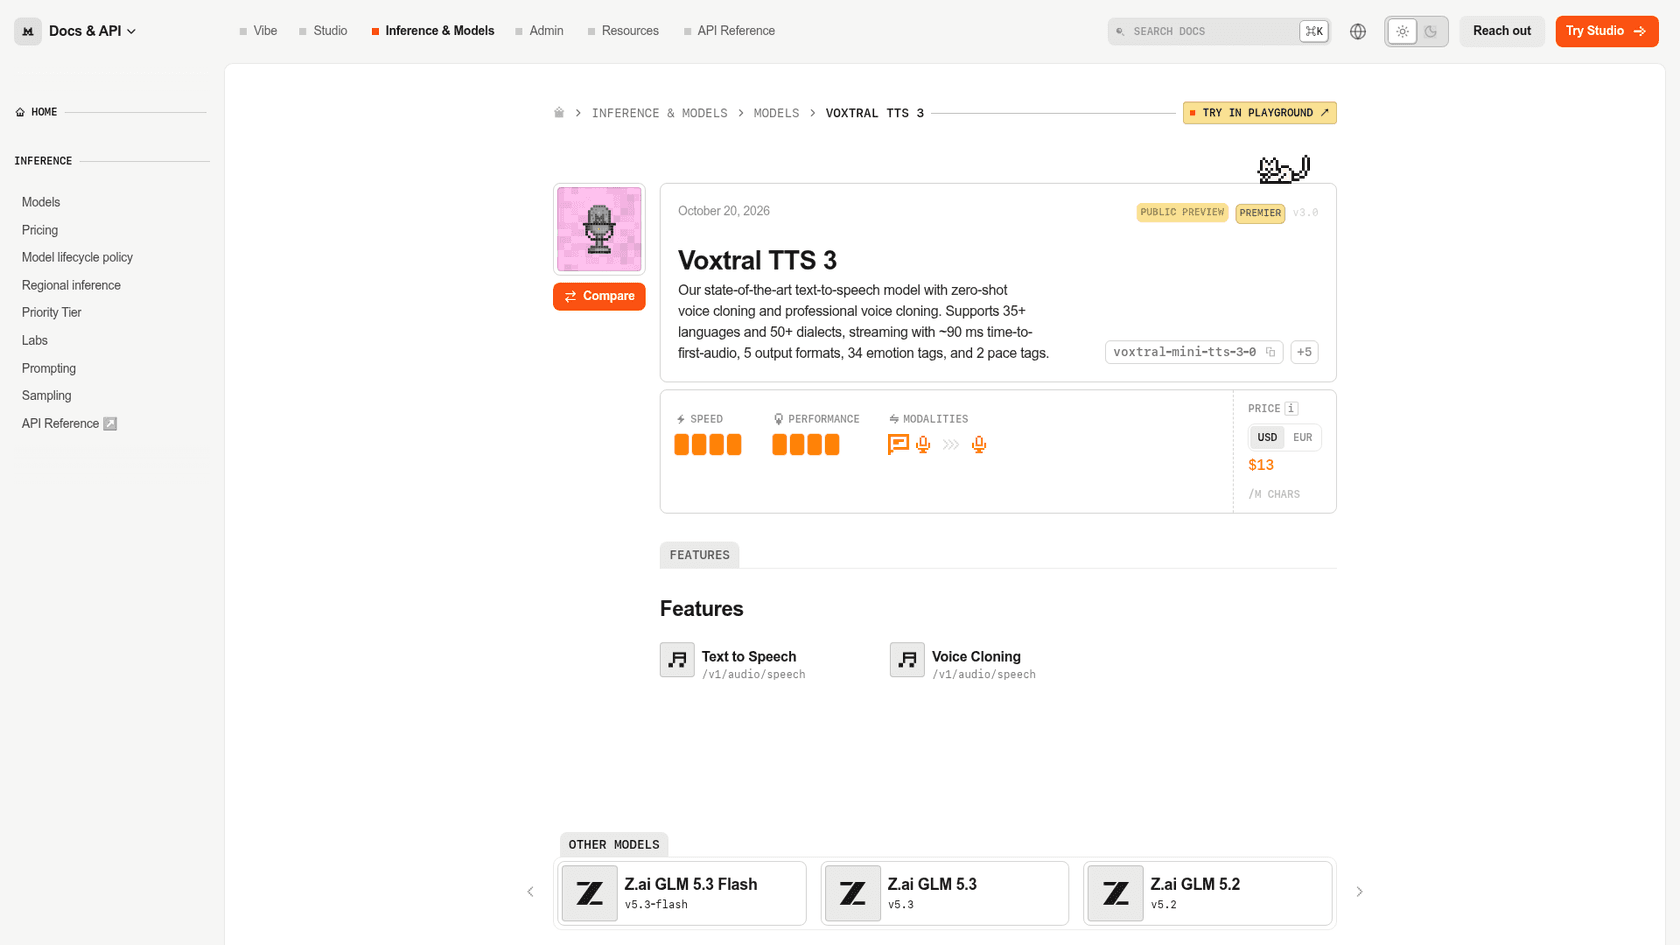
モデルカードの仕様は次のとおりです。
- 35以上の言語と50以上の方言、18言語のプリセット音声
- ストリーミング時、最初の音声まで約
90 ms [emotion=...]のようにインラインで挿入できる34種の感情タグと2種のペースタグ- ゼロショットの音声クローン、約30分の音声で学習する「Pro Voice」オプション
- 5種類の出力形式
リリースページの例は聴く価値があります。サポート音声が失敗しがちな点を、まさに狙っているからです。ある例では、Voxtral 1は便の時刻を「21,000pm on 10 over 10」と読みます。Voxtral 3は「21pm on October 10th」と読みます。別の例では、メールアドレスを発信者にきれいに読み返します。安い音声が恥をかかせるのは、こういう場面です。
価格について、Mistralは、100万文字あたり13ドルはOpenAI TTS-1、Deepgram、ElevenLabs Flash、Gemini Flashより運用コストが低いと主張しており、ドルあたりの品質グラフ(サポート台本の数字や珍しい名前をテストするBeSimple AIのVoice Code Benchに基づく)でも、Voxtral TTSは市場の安価な側に位置づけられています。これらはベンダー自身が作成し、審査にGeminiモデルを使ったグラフなので、結論ではなく候補リストとして扱ってください。本格的に比較するなら、自分の台本でElevenLabs、Cartesia Sonic 3、Gemini 3.8 Flash TTSと並べるか、ElevenLabsの代替リストを見てください。
移行ガイドからの注意点です。スタイル指示、つまり「温かく言って」という自由記述の制御は、リリース時点では利用不可と記されています。今あるのは感情タグとペースタグです。
Voxtral 3の音声エージェントSDKはどう動く?
このSDKは、カスタマーサポート向けの音声エージェントを作る人にとってリリースで最も興味深い部分であり、最も制限されている部分でもあります。
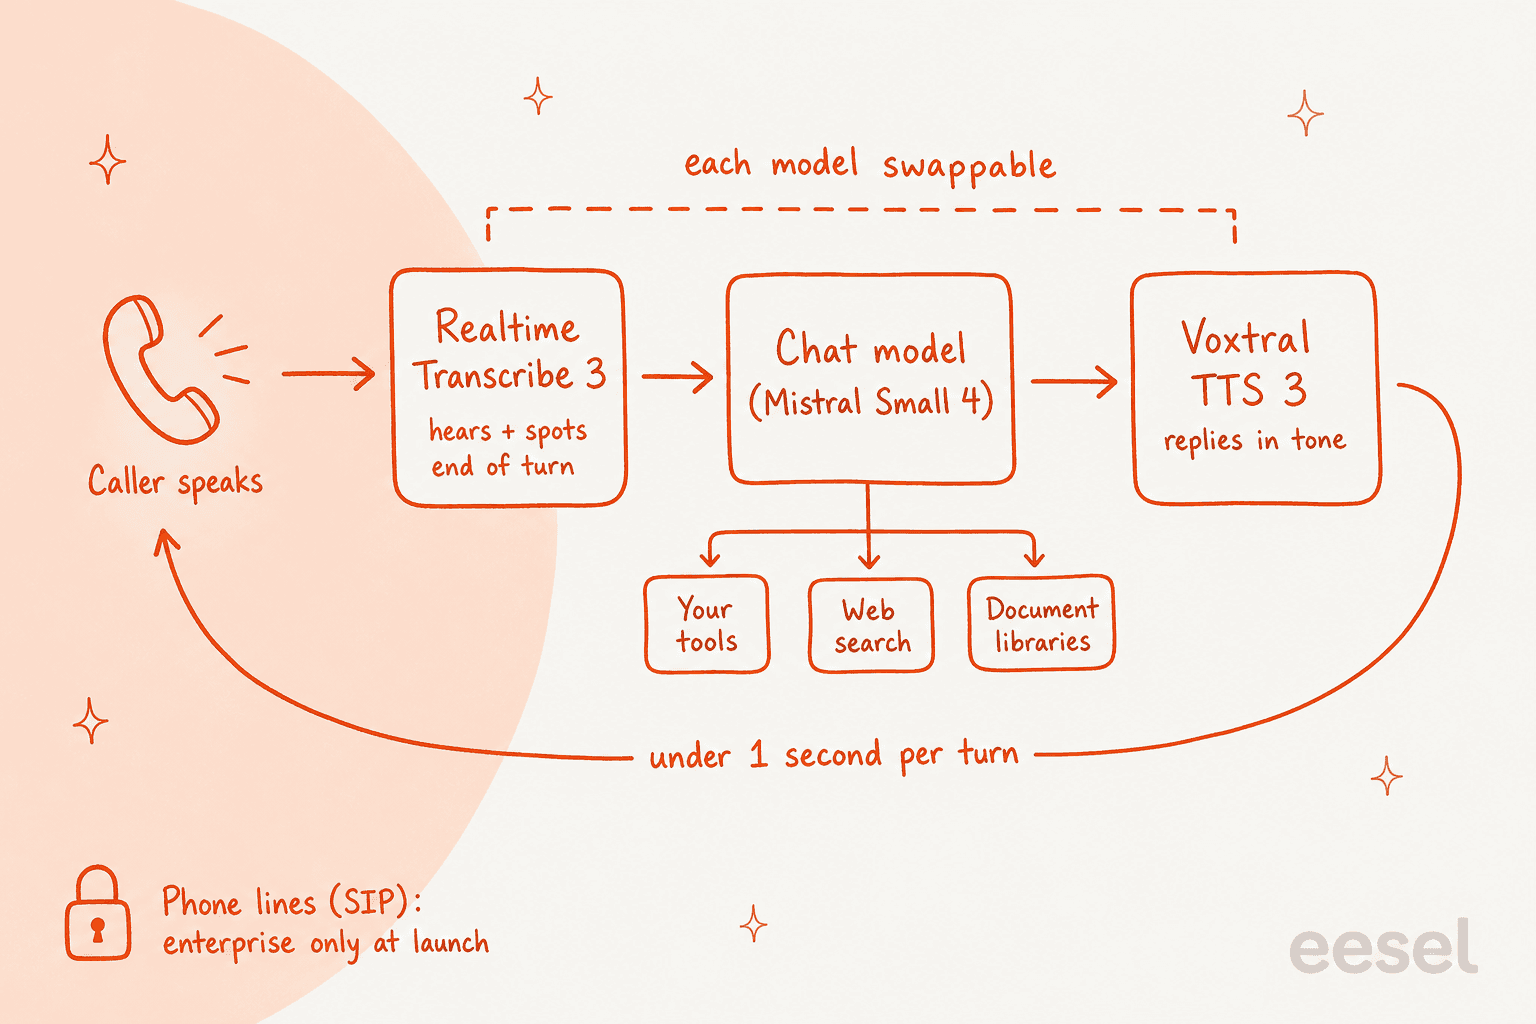
音声エージェントのドキュメントによれば、会話の各ターンは3つの段階を通ります。リアルタイムモデルが文字起こしして発話の終わりを見つけ、Mistral Small 4のようなチャットモデルが答えを書いてツールを呼び出し、Voxtral TTSがそれを読み上げます。Mistralによれば、各段階は互いにストリームでつながるため、各ターンは1秒未満で完了し、発信者は割り込めます。
開発者として気に入っている点は次のとおりです。
- 各段階が別々のモデルです。 エージェントを書き直さずに、推論モデルをより大きなものに替えたり、音声や言語を変えたりできます。
- エージェントはバージョン管理されます。 エージェント設定を保存すると、変更のたびに新しいバージョンができ、次のバージョンをテストしながら本番を既知のバージョンに固定できます。顧客と話すものには正しい設計です。
- 通話の開始、終了、失敗時にWebhookが発火するので、すべての文字起こしを自社の記録システムに保存できます。
- 音声伝送にLiveKitを使っており、PythonとTypeScriptのバインディングがありますが、使うためにLiveKitを知っている必要はありません。
気になる点は次のとおりです。
- 電話回線はリリース時点でエンタープライズ限定です。 ドキュメントには、SIPによる電話は「リリース時点ではエンタープライズ顧客向けに、アカウントチームを通じて提供」とあります。ブラウザやアプリの音声(WebRTC)は誰でも使えます。顧客が電話番号に電話してくるサポートチームにとっては、これが決め手になります。
- 電話通話ではクライアント側のツールが失敗します。 ドキュメントは、電話回線では通話中に自分のコードが一切動かないと明記しているため、電話エージェントに必要なもの(注文の照会、請求の確認など)はすべてサーバー側のツールでなければなりません。
- ツールはウェブ検索、ドキュメントライブラリ、ワークスペースコネクタ、独自の関数です。 ヘルプデスクや過去のチケットという概念は組み込まれていません。eeselの営業での会話で最も多く求められる機能は過去のチケットでの学習です。企業の本当の答えはそこにあるからです。Voxtralでは、それは自分で行う連携作業になります。
リリースのスレッドでHacker Newsのコメント投稿者が提起したセキュリティの問題もあります。このスレッドは770ポイント、202件のコメントを集めました。社内システムにつながれたボイスエージェントは、電話を持つ誰でも到達できるプロンプトインジェクションの標的です。
"I see companies hooking this up direct to the company intranet, and then users calling up and saying "Can you check this website for me?""

これはVoxtralの欠陥というより、ツールを呼び出すあらゆるボイスエージェントの仕事内容そのものです。ただ、電話エージェントは、狭いサーバー側ツールに留め、変更できる範囲を明確に制限する十分な理由になります。コールセンターのAIエージェントに何を許し何を許さないかを整理するなら、そこから始めてください。
Voxtral 3は実際にいくらかかる?
分単位の料金は、推論を足すまでは微々たるものです。Mistralの定価で、5分の通話1万件(5万分)にかかる費用は次のとおりです。
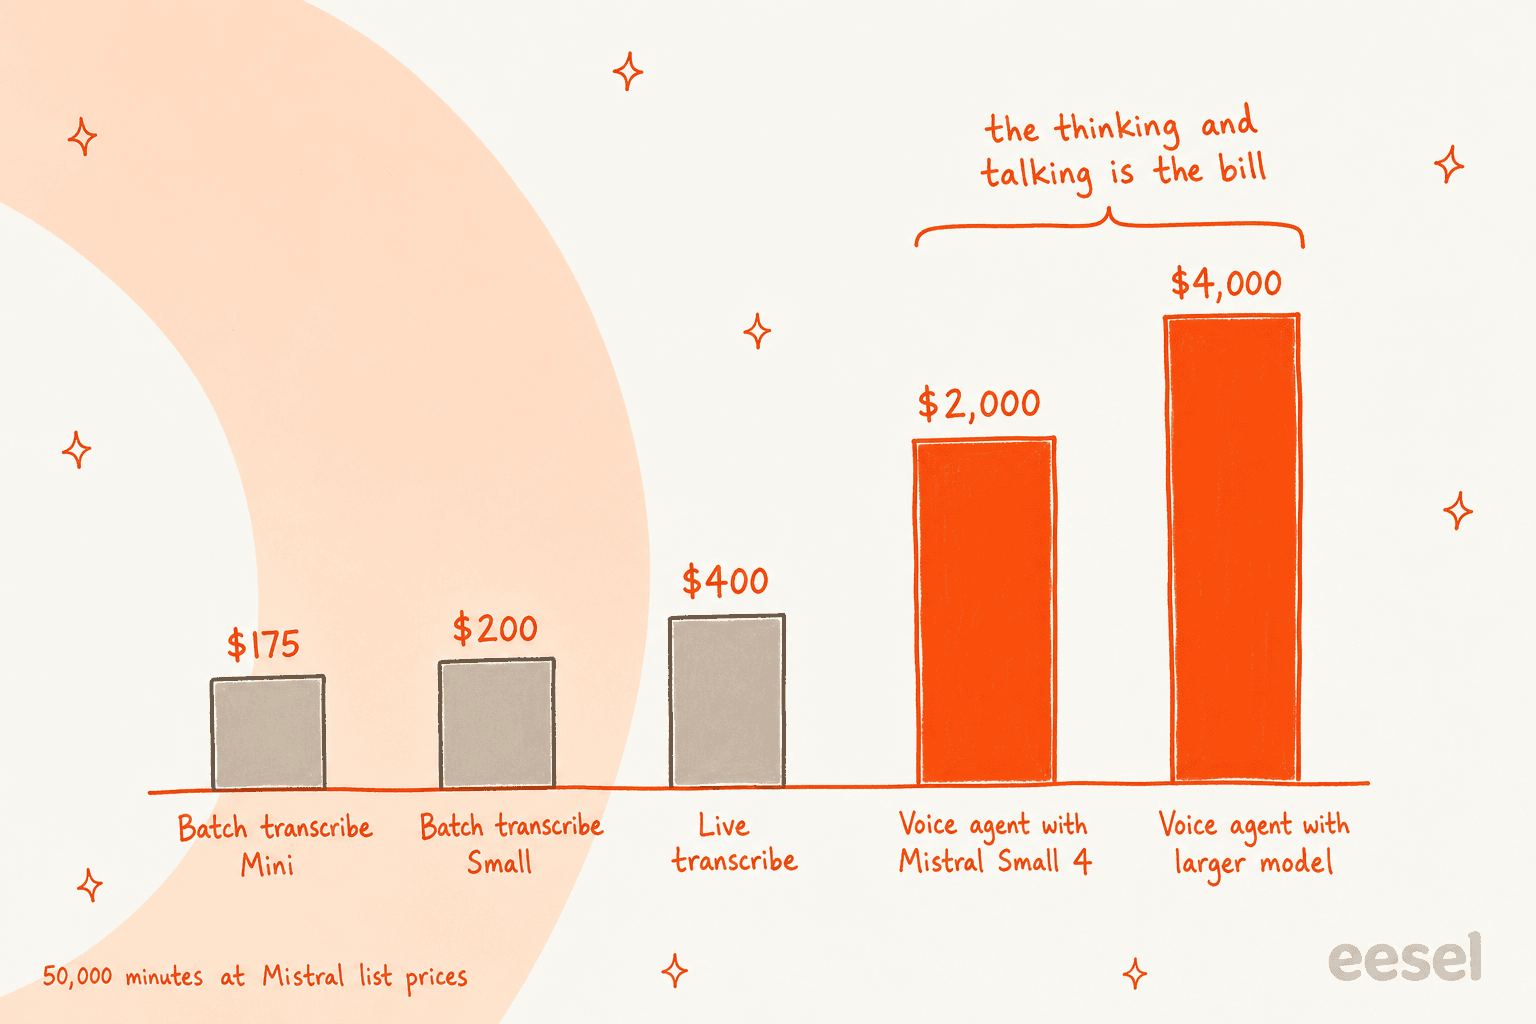
| 利用内容 | 料金 | 5万分 |
|---|---|---|
| バッチ文字起こし、Mini | $0.0035/min | $175 |
| バッチ文字起こし、Small | $0.004/min | $200 |
| ライブ文字起こし | $0.008/min | $400 |
| Mistral Small 4の音声エージェントAPI | $0.04/min | $2,000 |
| より大きなモデルの音声エージェントAPI | $0.08/min | $4,000 |
役に立つのはこのパターンです。すでに受けているすべての通話をQAのために文字起こしするコストは月に数百ドルです。AIエージェントに実際にそれらの通話へ応答させると、推論と音声が請求の中身になるため10〜20倍かかります。エージェントAPIで5分のサポート通話1件は、Mistral Small 4で$0.20になります。コールセンターのROIモデルに入れるべきはこの数字であって、$0.004ではありません。
$0.04というエージェント料金も、一見して競争力があります。参考までに、8月の私のGrok Voiceレビューでは、1分$0.08の競合を取り上げました。音声の料金は今年変動が激しいので、決める前に各ベンダーのページで最新の料金を確認してください。Mistral AIの料金の全体の内訳では、エージェントの裏で動くチャットモデルを扱っています。
なぜVoxtral 3の重みはクローズドなのか?
最も大きな反応を呼んだ変更で、それは当然の反応です。最初のVoxtralモデル(Mini 3BとSmall 24B、2025年7月)と、2026年1月のVoxtral Mini 4B Realtimeモデルは、すべてHugging Faceでオープンな重みとして公開されました。そのリアルタイムモデルだけで200万回以上ダウンロードされています。Voxtral 3には公開された重みがありません。
リリースには、Voxtral 3は「自社インフラでのセルフデプロイ向けに」利用できるとあり、あるコメント投稿者が説明するまで読者は混乱しました。
"You have to call sales to get access for on-prem deployment and the models. If it were open weights, it would be on Huggingface and they would have put a link in the post"
スレッドの最上位コメントは、落胆をはっきり表現しました。
"Closed model unfortunately, continues the theme of TTS / STT being really not great for local deployments."
Mistralのために公平を期すと、オープンなリリースを完全にやめたわけではなく、新モデルの連続リリースがそれを示しています。コメント投稿者たちは、前の週のTimestralと、約束されているMistral Large 4の重みを挙げていました。また、ある実務家は商業的な理屈を示しました。話者分離つきの優れた音声モデルは優れたテキストモデルより希少で、買い手はそれにプレミアムを払うというものです。エンタープライズのサポートチームにとって、クローズドな重みに契約によるオンプレミスは、普通の調達ルートです。自宅用アシスタントを作る趣味の人にとっては、行き止まりです。
Voxtral 2を使っているなら何が壊れる?
すでにVoxtral 2を呼び出しているなら、モデルIDを入れ替える前に移行ガイドを読んでください。よく書かれていて、何が壊れるかについて誠実です。
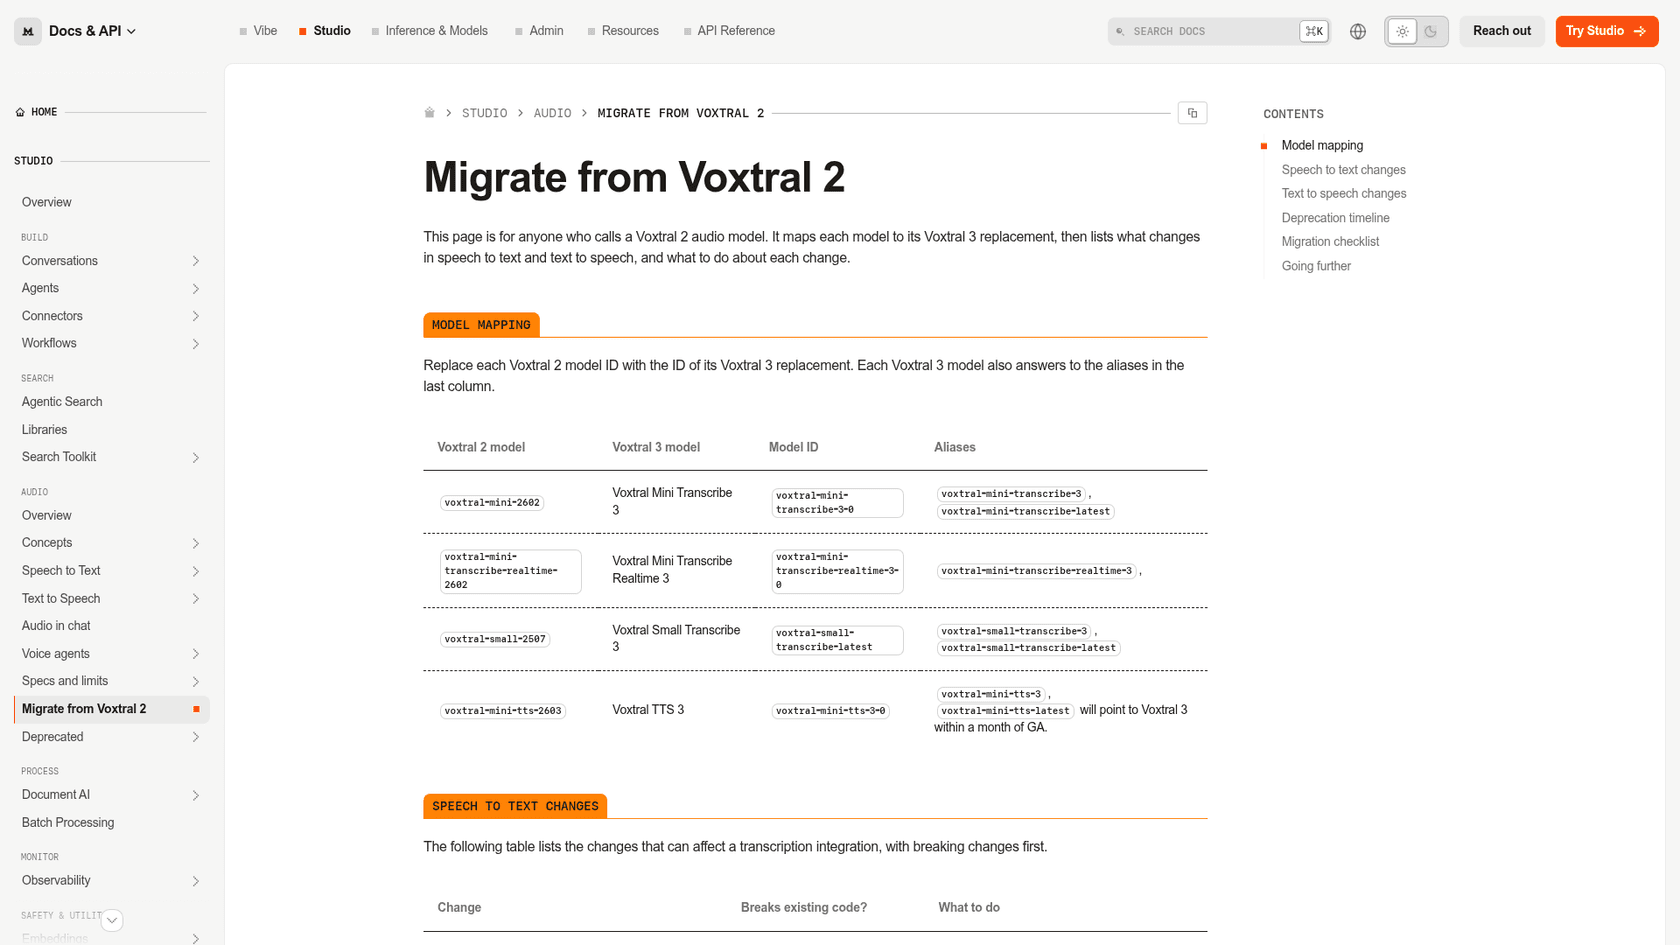
互換性を壊す変更を、私が確認する順に並べます。
- 単語タイムスタンプがなくなりました。
timestamp_granularitiesはsegmentだけを受け付け、wordを求めると400エラーが返ります。音声の再生に合わせて単語をハイライトしている場合、これは痛い変更です。 - リアルタイムセッションは、最初の音声チャンクが届いた時点で設定がロックされます。 後から
session.updateを送るとエラーが返るので、すべての設定を最初に送ってください。 - 2人が同時に話すと、話者分離されたセグメントが重なる場合があります。 表示側が重ならない前提で作られているなら、修正が必要です。
TTS側はおだやかです。gb_jane_sadのような旧プリセット音声は引き続き動き、ref_audioによるクローンも動きます。voxtral-mini-tts-latestというエイリアスは、一般提供から1か月以内にVoxtral 3へ切り替わるので、不意打ちを避けたいなら明示的なモデルIDに固定してください。
Voxtral 3は誰が使うべき?
買い手別の私の結論です。
| あなたが... | 評価 |
|---|---|
| QAや分析のために録音した通話を文字起こしする | はい。 トップに迫る精度、グラフ上で最高の話者分離、1分$0.0035〜$0.004。 |
| ヨーロッパ域内で音声を処理する必要があるEUのチーム | はい。 EUホストのAPIと契約によるオンプレミス。サポート向けのEU AI法のルールも併せて確認してください。 |
| ブラウザやアプリ内の音声アシスタントを作る | おそらく。 SDKはよく設計されエージェントの料金も低いですが、プレビューです。 |
| 今月、サポートの電話回線にAIを置きたい | エンタープライズ顧客でなければ、まだです。 AI電話サポートではSIPが制限されており、ヘルプデスク連携は自分で作ることになります。 |
| ローカルで動かすための重みが欲しい | いいえ。 Mistralの代替か、古いオープンなVoxtralモデルを見てください。 |
総合では、Voxtral 3に5点満点中3.5点をつけます。文字起こしモデルは4.5、音声は4、エージェントSDKは有望な3で、プレビュー段階と電話の制限に足を引っ張られています。MistralがSIPを全員に開放し、この価格のままモデルがプレビューを卒業すれば、この点数は上がります。
市場全体と比べるなら、私の音声サポートに最適なAIのまとめとAI音声企業のリストで、他の選択肢を扱っています。電話サポートを自動化する価値そのものをまだ検討中なら、コールセンター自動化から始めてください。
Voxtral 3の隣でeeselはどこに入るか
Voxtral 3はインフラです。非常に優れた耳と、安くて表現力のある声です。eeselは従業員です。私たちのAIヘルプデスクチームメイトは、すでに使っているヘルプデスク(Zendesk、Freshdesk、Gorgiasなど)に参加し、過去のチケット、ヘルプセンター、マクロから学び、顧客に1件でも返信する前に、実際のチケット履歴でテストされます。
これが、Voxtralがあなたに任せるサポートの半分です。ドイツのローン比較サイトsmavaでは、eeselが毎月27,000件のZendeskチケットにドイツ語で対応し、そのうち14,600件を分類し、820件のマクロとヘルプセンター記事から15,300件の返信を下書きしています。スイスのスーツケース店Koffer.chでは、顧客が書いた言語に合わせて、ドイツ語、フランス語、英語、イタリア語のいずれかで、スイス式の表記でFreshdeskの返信を下書きしています。これは翻訳の手順を挟まない多言語サポートです。どちらもそこに至るのに音声モデルは必要ありませんでしたが、もし電話にエージェントを置くことになれば、どちらもまさにそのチケットの知識が必要になります。
今のキューがメールとチャットなら、私はそこから先に自動化します。eeselを試して、自分の過去のチケットで無料で、何と答えたはずかを確かめてください。