

Nemotron 3.5 Transcribeは、NVIDIAが2026年10月28日に公開した無料のオープンウェイト音声モデルです。1つのチェックポイントで4つの仕事をこなします。40言語の文字起こし、最大8人の話者について「誰が何を言ったか」のラベル付け、31言語の翻訳、そして音声に関する質問への回答です。どの仕事をさせたいかは、普通の言葉のプロンプトで伝えます。
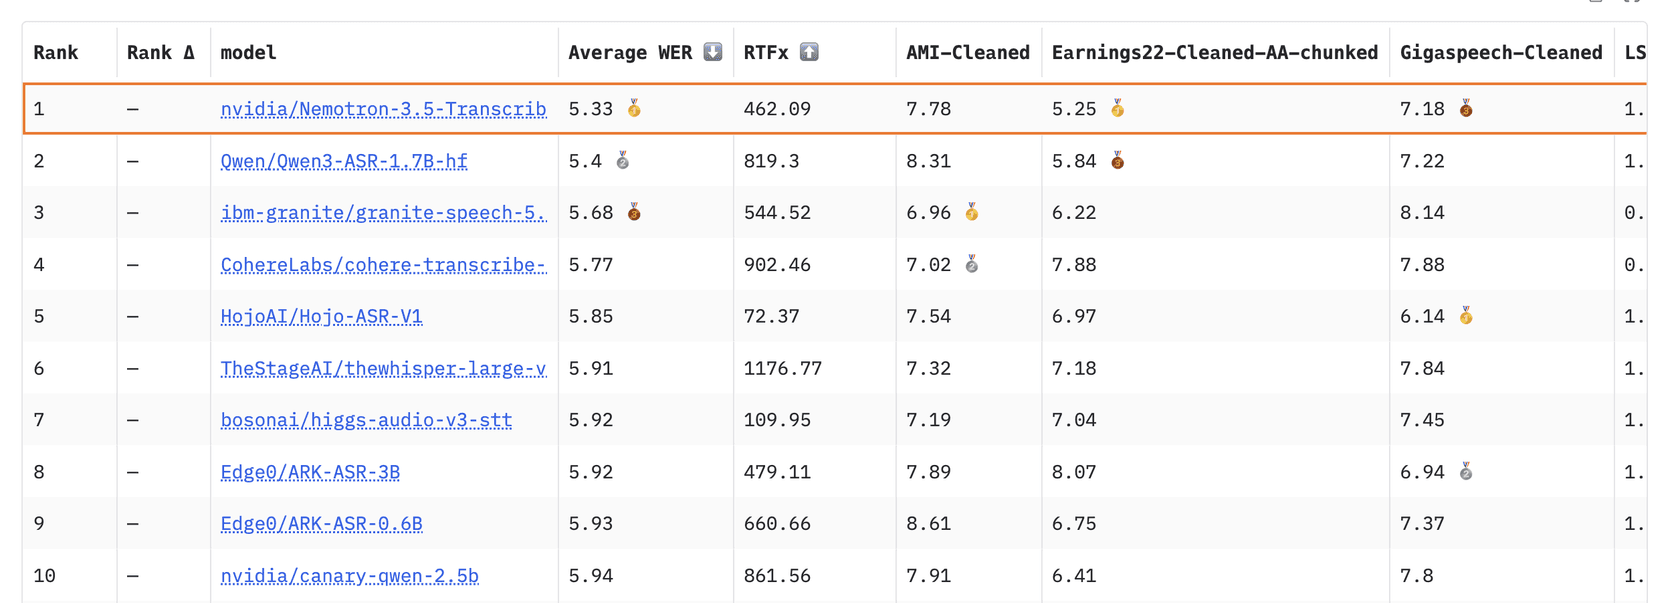
オープンモデルとしては精度が高く、Artificial Analysisで単語誤り率2.81%とオープンモデルで2位、Hugging Faceのオープン英語リーダーボードでは5.33%で1位です。難点はサイズと用途です。現時点では80GBのデータセンター向けGPUが必要で、録音にしか使えず、ライブ通話には対応しません。ハードウェアを用意したくなければ、DeepInfraが1分0.002ドルでホストしており、ほとんどの文字起こしAPIの約半額です。
サポートチームにとって、文字起こしは最初の一歩であって最後ではありません。私はeeselで働いており、開発に関わっているAIヘルプデスクチームメイトは、通話や留守番電話から生まれるチケットを引き取り、お客様の言語で回答します。Koffer.chでは、ドイツ語、フランス語、英語、イタリア語で対応しています。
Nemotron 3.5 Transcribeとは?
Nemotron 3.5 Transcribeは、NVIDIAのオープンウェイト音声モデルです。録音ファイルをテキストにし、その先は頼んだ種類のテキストに変えてくれます。NVIDIAはこれを音声拡張言語モデルと呼んでいます。音声エンコーダーが言語モデルにつながっているため、設定ではなく指示で出力を制御できます(モデルカード)。
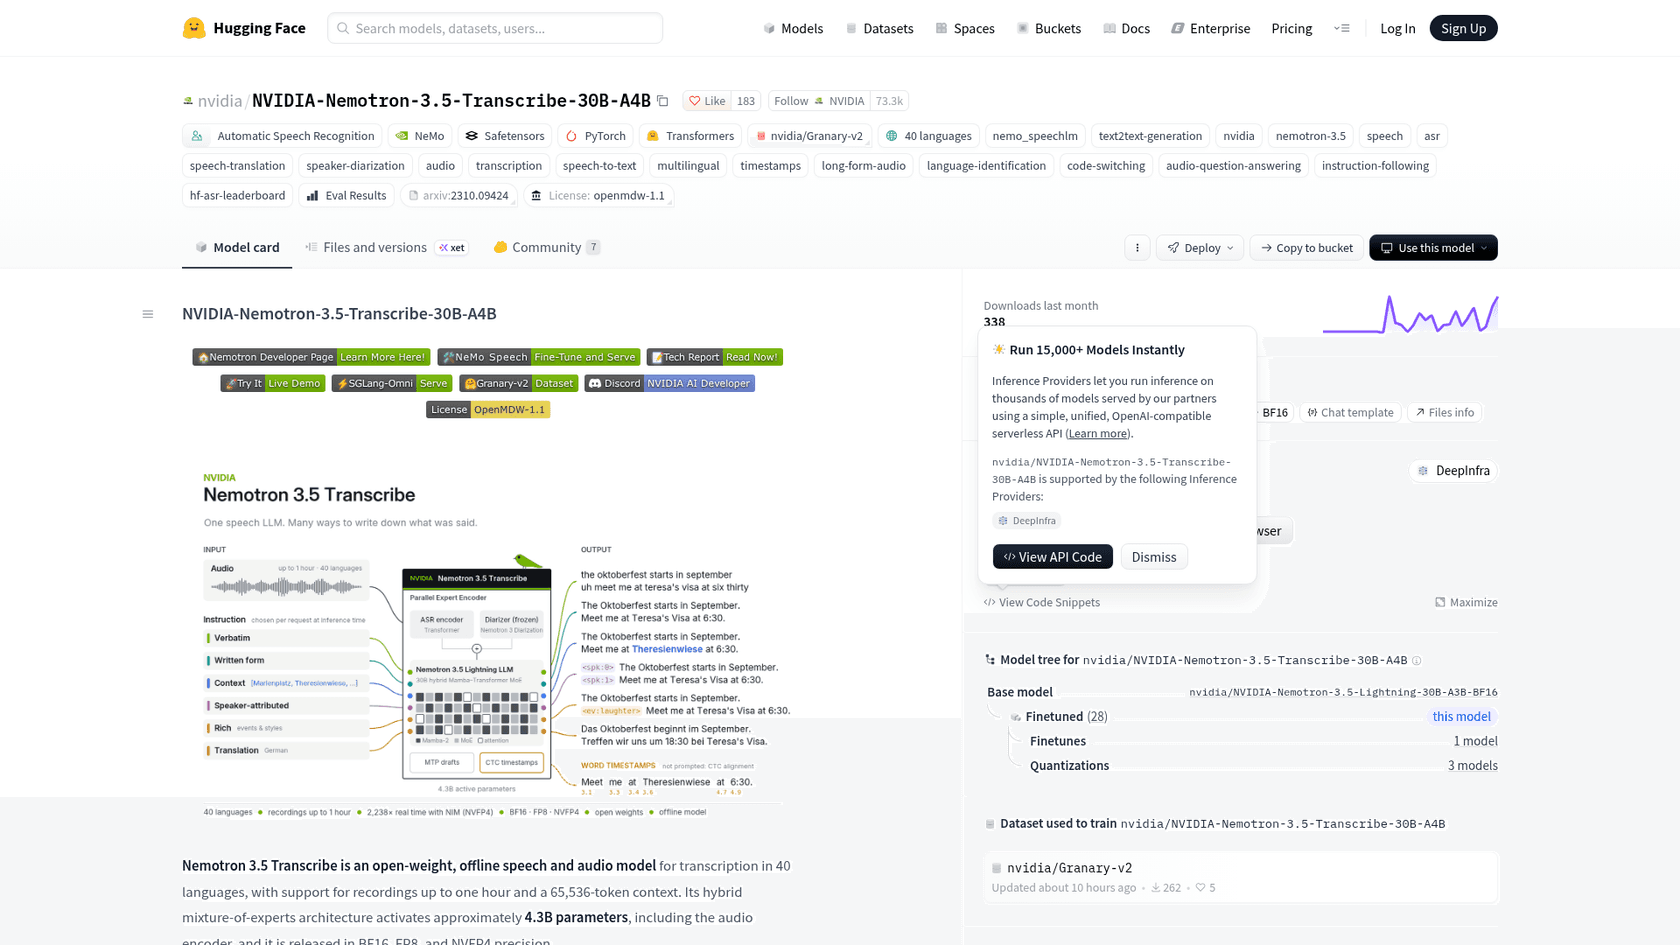
主な数字はすべて、NVIDIAのローンチブログとモデルカードによるものです。
| 仕様 | Nemotron 3.5 Transcribe |
|---|---|
| 公開日 | 2026年10月28日 |
| サイズ | 30B級のMixture of Experts、トークンあたり約4Bがアクティブ(カードでは音声エンコーダーを含め合計34B、アクティブ4.3B) |
| 文字起こし | 40言語 |
| 翻訳 | 31言語、英語との間 |
| 話者ラベル | 13言語、最大8人 |
| 最長の録音 | 1時間(65,536トークンのコンテキスト) |
| ライブストリーミング | 非対応、録音済み音声のみ |
| ライセンス | OpenMDW-1.1、商用利用可 |
| 精度形式 | 現在はBF16、FP8とNVFP4は今後予定 |
「約4Bがアクティブ」という点こそ、このサイズのモデルが実用的になる理由です。NVIDIAのNemotron 3.5 Lightning言語モデルをベースにした、MambaとTransformerのハイブリッドなMixture of Expertsなので、各トークンで働くのは重みのごく一部だけです。Nemotron 3.5 Super VLなど、このファミリーに共通する工夫です。
名前に関する落とし穴を1つ挙げておきます。「Nemotron 3.5 ASR」は別の小さなストリーミングモデルです。ネットで価格や速度の数字を見かけたら、どちらのモデルの話か確認してください。
何をさせられる?
逐語の文字起こし、整えた文字起こし、話者ラベル付き、翻訳、回答のどれでも、同じファイルから得られます。違いはプロンプトの1行だけです。NVIDIA自身の例は「Transcribe this recording and label each speaker」や「What decisions were made in this meeting?」のように素朴です(ローンチブログ)。
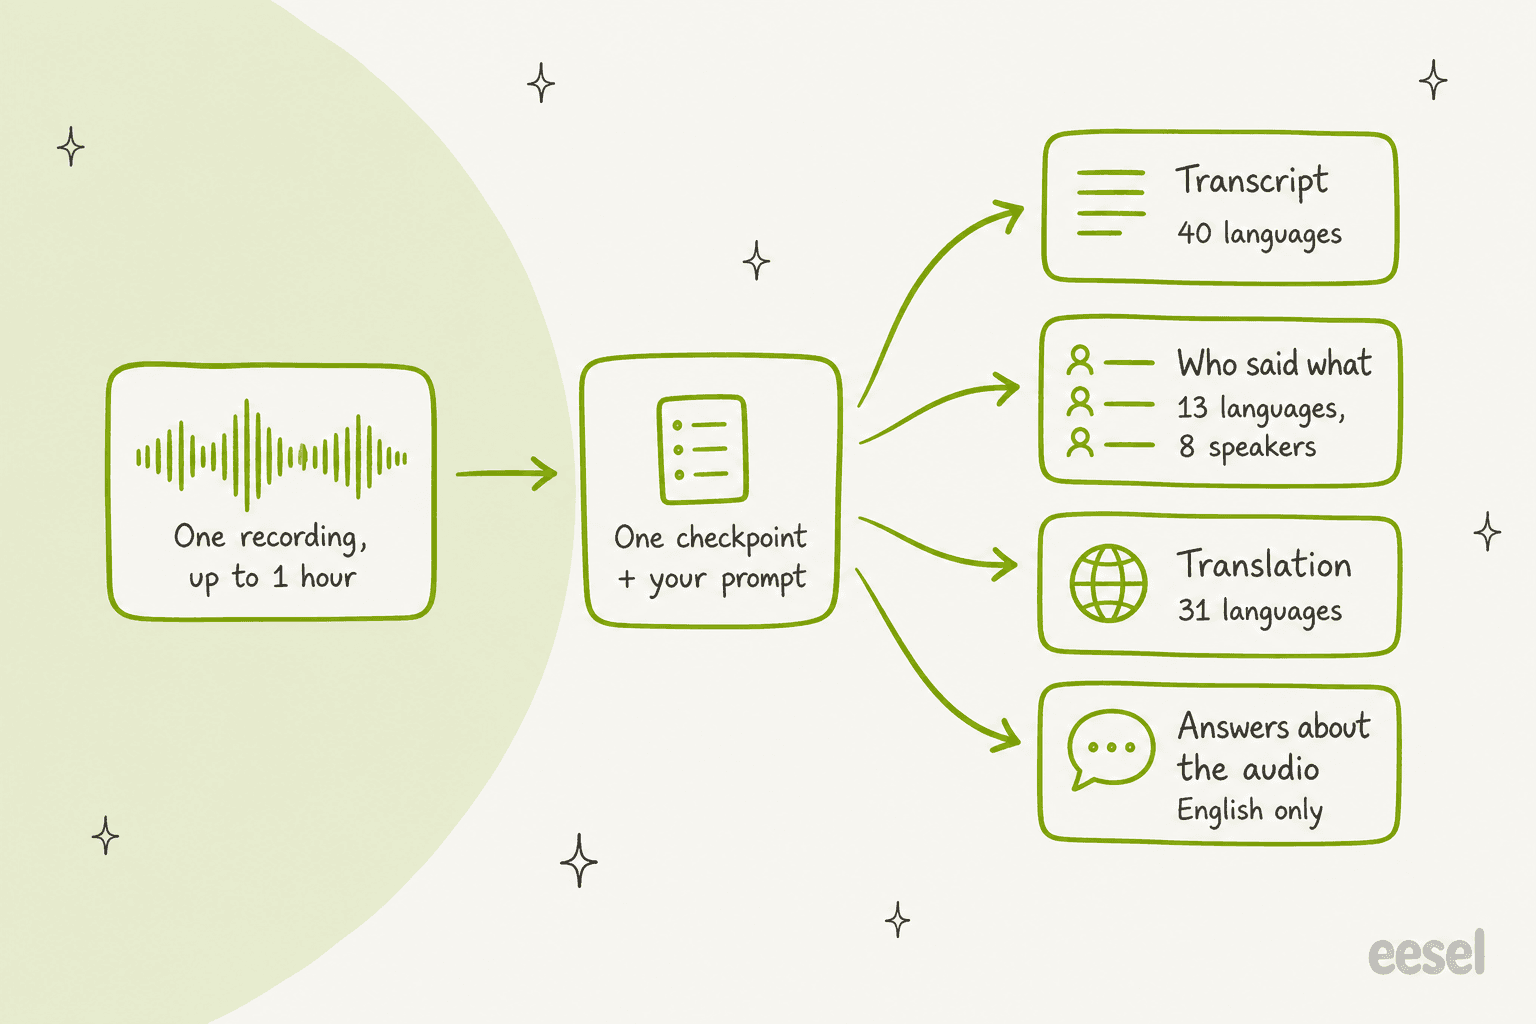
実務で特に重要なプロンプトは、モデルカードによると次のとおりです。
- 逐語かクリーンか。 「えーと」や言い直しをすべて残すか、取り除いてそれ以外は変えずにおくか。
- コンテキスト用語。 製品名、人名、専門用語を先に列挙します。NVIDIAの決算説明会の文脈テストでは、用語を与えるとキーワード再現率が58.16%から96.05%に上がりました。
- 話者とタイムスタンプ。 別の話者分離ツールを後で走らせる代わりに、話者タグと単語ごとのタイミングを1回で依頼できます。
- 正確な値。 プリセットを使うと、メールアドレス、URL、ファイルパス、注文番号が話されたとおりに書かれます。サポートの文字起こしで間違えられない部分です。
- 個人情報のタグ付け。 個人情報にタグを付けたり伏せたりするよう学習されており、誰かが読む前にサポートの文字起こしを匿名化する場合に便利です。
カードは、コンテキスト用語プロンプトの適した用途として「support recordings」を挙げ、応用分野にカスタマーサービスも載せています。つまり、コールセンターはNVIDIAの視野にしっかり入っています。
実際の精度は?
公開テストでは、オープン音声モデルとして1位か2位で、最高のクローズドモデルには一歩及びません。以下は、数字が示すことと、数字同士が食い違う点です。
Hugging Face Open ASRリーダーボード(英語)。 オープンウェイトモデルで1位、平均単語誤り率5.33%で、Qwen3-ASR-1.7Bの5.4%をわずかに上回ります(リーダーボード)。単語誤り率はモデルが間違える単語の割合なので、低いほど良い値です。
Artificial Analysis。 誤りインデックスで2.81%、オープンモデルでは2位、Voxtral Smallの2.77%にわずかに及ばず、そのモデルはアクティブパラメータが約6倍です(Artificial Analysis)。NVIDIA自身のブログは、これを1位タイと呼んでいます。全体ではクローズドモデルがまだ上で、MAI-Transcribe-2は2.04%、Gemini 3.5 Transcribeは2.60%です。音声エージェント向けのAgentTalkセットでは1.78%で、表全体でも上位に近い値です。
ただし、この数字には注釈を2つ付けたいところです。DeepInfraの公開エンドポイントでは同じインデックスで3.4%が出ており、2.81%はほとんどの人がまだ再現できない環境の値です。また決算説明会では5.69%で、ElevenLabs Scribe v2の3.95%に及びません。
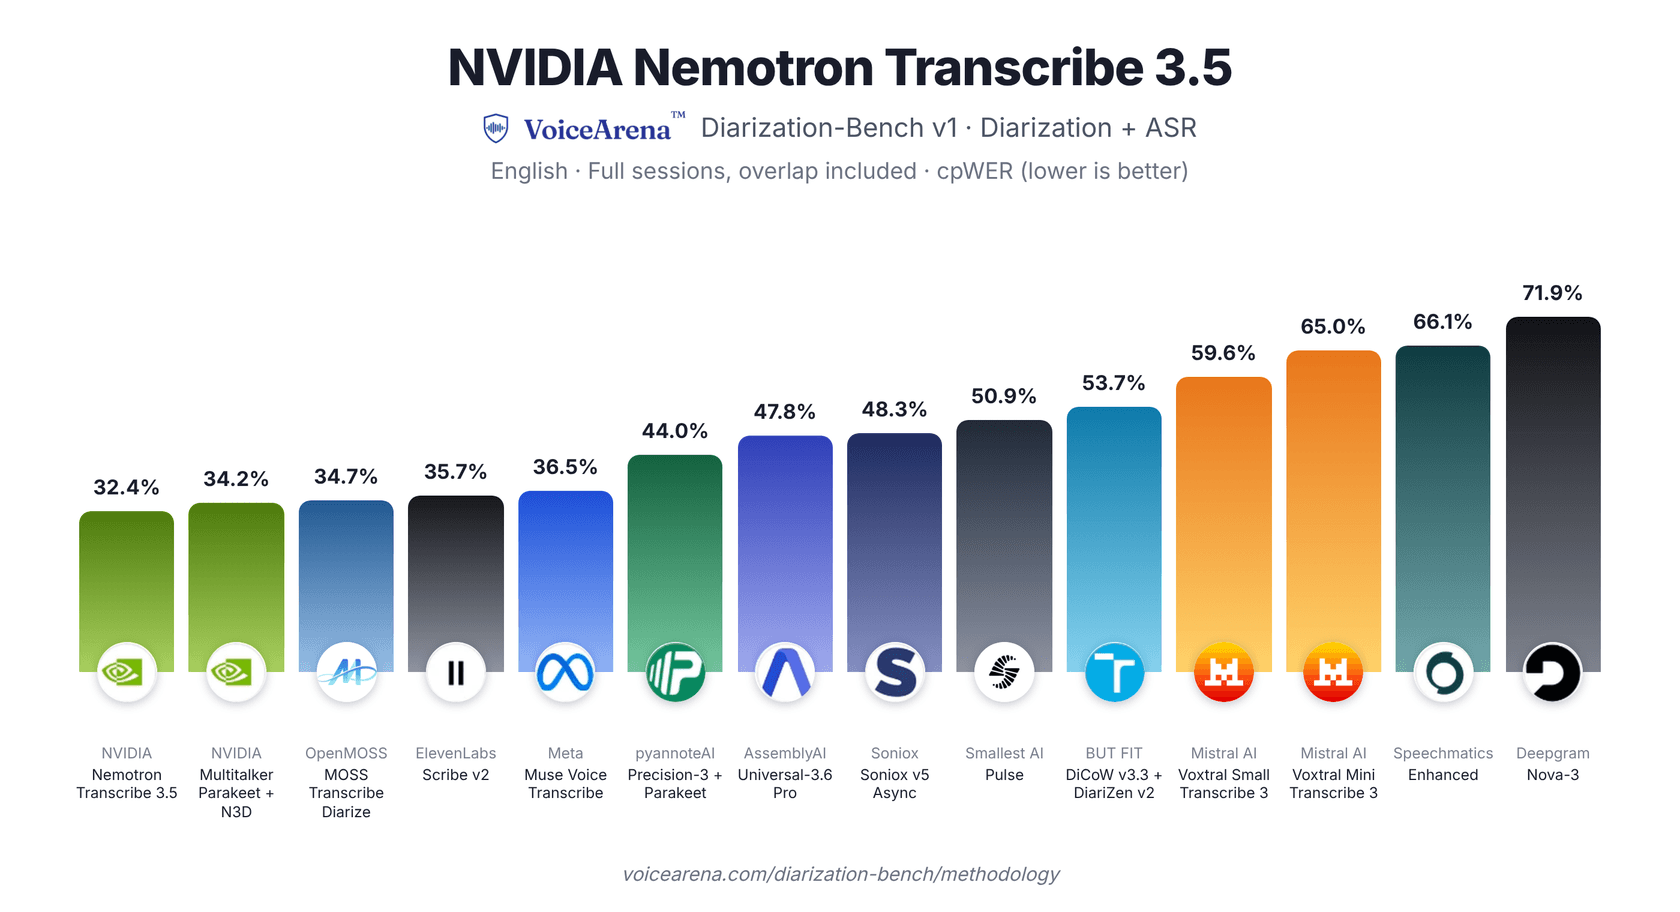
誰が何を言ったか。 ここが最も強い部分です。重なった発話を含む英語の完全なセッションを対象とするVoiceArenaの話者分離ベンチマークで、14システム中1位となり、話者を対応付けた後の誤りは32.4%でした。脱落した単語も他よりはるかに少なく、8.32%に対し中央値は約31%です(ローンチブログ)。
言語ごとの差。 NVIDIAは、英語、スペイン語、ドイツ語、フランス語、ヒンディー語、韓国語を含む13言語を「leading」、さらに15言語を本番利用可能としています。大きく遅れる言語もあり、FLEURSの誤りはギリシャ語で26.93%、ヘブライ語で20.97%、ノルウェー語は63.76%で、文字起こしにまったく対応していません(モデルカード)。お客様がノルウェー語で電話してくる場合、このモデルはまだ向きません。
公開1日後の反応は?
最初の反応は機能一覧には盛り上がっていますが、実際に試した人の評価は割れています。r/LocalLLaMAのスレッドは1日で193アップボートを超え、トップコメントがその雰囲気を決めました。
"Holy! This might be the holy grail of OS ASR models I have been looking for - something to dethrone venerable Qwen ASR."

今のところ唯一の実際のテストはHacker Newsで、日本語音声に4ビットのコミュニティ量子化版を使った人によるものです。本来の精度ではない可能性があると断っています。
"testing it against parakeet right now for ASR, it's slower, heavier, and has a higher error rate. but i'm doing a pass with the embedded translation to see if that's any good, it might be worth it."

翻訳についての続報も好意的ではなく(「disappointing model」)、フル精度の重みでの独立テストが出るまでは、ベンチマークの勝利はNVIDIAの数字として受け取っておくのが無難です。もう1つ繰り返し出てくるのがサイズです。あるRedditのコメントは「30b for ASR is such a luxury」と述べており、NVIDIA自身の0.6BのParakeetはほとんどの環境で動きます(Reddit)。
人々に最も好評だったのは、サポートや運用のチームにはおなじみの、全員が同時に話し出す雑然とした会議や通話の場面でした。
"finally a model that can follow a standup where everyone unmutes at once"
Nemotron 3.5 Transcribeはどう動かす?
今のところ入口は3つあります。無料デモを試す、ホスト型APIを呼ぶ、ハードウェアがあれば自分のGPUで動かす、です。
- デモを試す。 NVIDIAのHugging Face Spaceは、アップロードとプロンプトを受け付けます。何かを決める前に自分の音声を試すのに向いています。
- ホスト型APIを呼ぶ。 DeepInfraは1分0.002ドルで、データ保持なしで提供しています。BasetenとSimplismartもホストしていますが、分単価ではなくGPU時間か個別見積もりでの販売です。
- 自分でホストする。 モデルカードには、H100 80GB 1枚でのvLLM 0.32.0のレシピに加え、TransformersとSGLang-Omniの選択肢が載っています。vLLMサーバーはOpenAIのチャット形式で話すため、OpenAIの音声API向けのコードは小さな変更で移せます。
カードには、見落としやすい注意点もいくつかあります。
- 高速版はまだオープンではありません。 NVIDIAが謳う「100時間の音声を3分未満で」は、未公開のNVFP4の重みと独自の最適化サーバーを使った数字です。公開されているvLLM構成は「expected to be roughly two times slower」とされています。
- SGLang-Omniは文字起こしのみです。 このルートではタイムスタンプ、話者ラベル、翻訳が使えず、これらはこのモデルを選ぶ理由の半分です。
- 小型GPUは待ちです。 RTX 5090はNVFP4のみ、L40SはFP8のみの対応で、どちらのリポジトリも10月29日時点で未公開でした。
- ループすることがあります。 出力が止まらないまれなケース向けにNVIDIAは整理用の正規表現を提供しており、幻覚的な発話にも注意を促しています。名前や話者の切り替わりは抜き取りで確認してください。
自前のハードウェアでオープンモデルを動かすのが初めてなら、NVIDIAが配布に使うハブの基本をHugging Faceガイドで押さえられます。
いくらかかる?
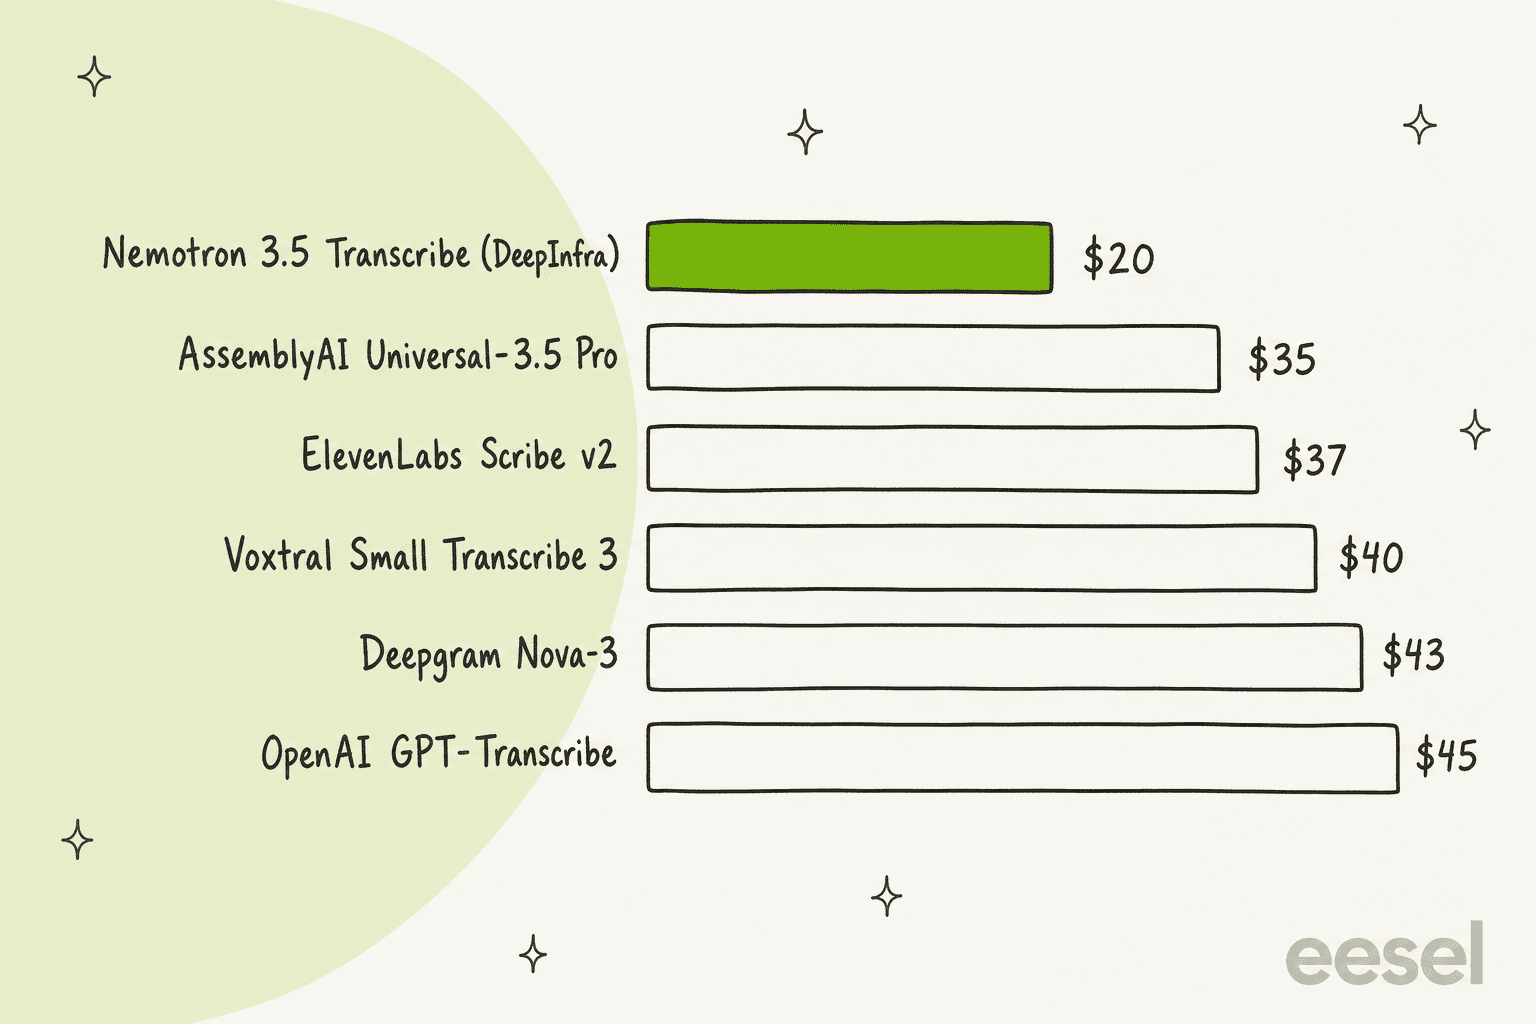
重みは無料なので、実際の価格はGPUやAPIに払う額です。ホスト型の料金で見ると、私が見つけた中で精度の高い選択肢として最安でした。毎月10,000分、約167時間の録音通話を、各社の公式ページの価格で計算したものがこちらです。
| モデル | バッチ価格 | 10,000分 | 出典 |
|---|---|---|---|
| Nemotron 3.5 Transcribe(DeepInfra) | 0.002ドル/分 | 20ドル | DeepInfra |
| AssemblyAI Universal-3.5 Pro | 0.21ドル/時 | 35ドル | AssemblyAI |
| ElevenLabs Scribe v2 | 0.22ドル/時 | 約37ドル | ElevenLabs |
| Mistral Voxtral Small Transcribe 3 | 0.004ドル/分 | 40ドル | Mistral |
| Deepgram Nova-3(録音済み) | 0.0043ドル/分 | 43ドル | Deepgram |
| OpenAI GPT-Transcribe | 0.0045ドル/分 | 45ドル | OpenAI |
| Gemini 3.5 Transcribe | 約0.005ドル/分 | 約50ドル |
機能を揃えて比べると、差はさらに広がります。Nemotronは基本の呼び出しにプロンプト指定、コンテキスト用語、話者ラベルが含まれます。AssemblyAIでは、Universal-3.5 Proにプロンプト指定(0.05ドル/時)と話者分離(0.02ドル/時)を足すと1時間0.28ドルになり、Nemotronの0.12ドルの2倍以上です。競合の詳細は、Gemini 3.5 TranscribeとVoxtral 3の解説をご覧ください。
自前ホストが音声1時間あたりで安くなるのは、GPUが稼働し続ける場合だけです。BasetenはH100を1分0.10833ドル(Baseten)、つまり1時間約6.50ドルで貸し出しています。NVIDIAはこのカードで、バッチ処理の英語に対しリアルタイムの260倍から410倍の速度を測定しており、GPU 1時間で260〜410時間分の音声を処理できます。私の計算では音声1時間あたりおよそ2〜3セントで、DeepInfraの12セントより安くなりますが、バッチを途切れず投入できる場合に限ります。月167時間のチームでは、ほとんど遊んでいるGPUに支払うことになるので、ボリュームが本格的になるまではAPIが有利です。
サポートチームでの使いどころは?
すでに録音があり、検索、採点、対応に使えるテキストが欲しい場面なら、どこでも使えます。ライブの会話は向きません。
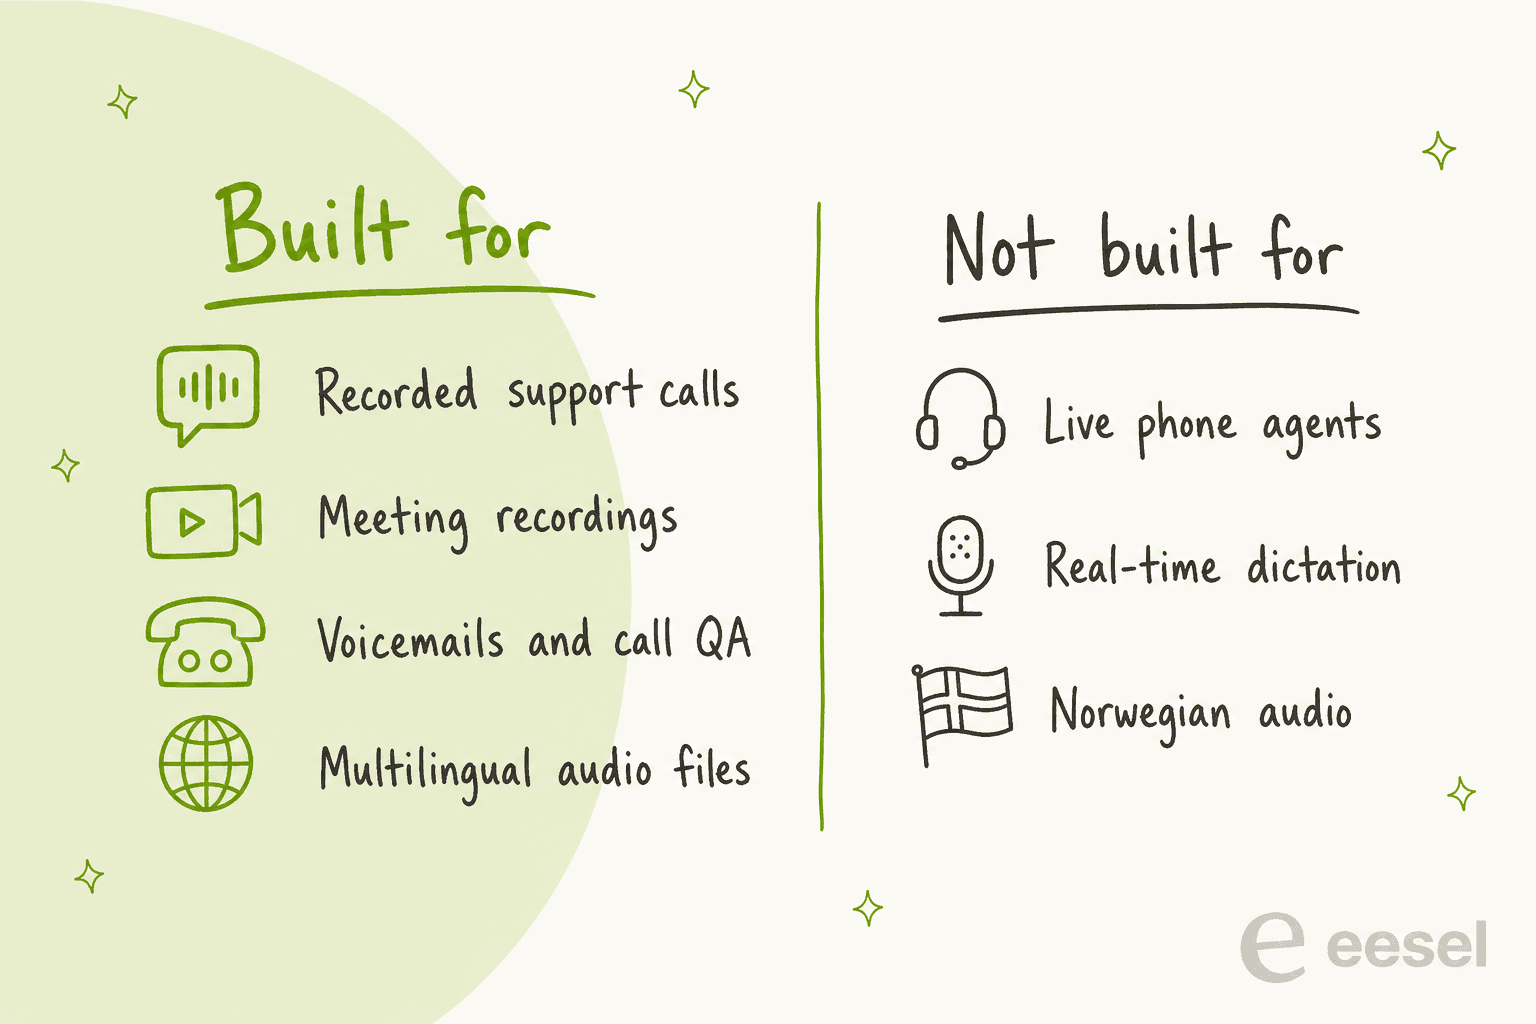
- 通話の品質管理。 話者ラベル付きの文字起こしがあると、エージェントの通話対応を採点しやすくなります。コールセンターの品質保証の地味な部分です。AIによるサポートQAと組み合わせれば、テキストを評価できます。
- 留守番電話と折り返し。 文字起こしして、テキストをチケットに載せれば、引き継ぐ人が先に聞く必要はありません。
- 要約と感情分析。 チャットの文字起こしと同じく、文字起こしがチケット要約と感情分析に使えます。
- 多言語キュー。 40言語を1つのモデルでカバーできれば、市場ごとに別のツールをつなぐより楽です。それが多言語カスタマーサポートの苦労の半分です。
発信者と会話することはできません。それにはストリーミングモデルを組み込んだAI音声エージェントや、私のおすすめAI音声エージェントリストのツールが必要です。何を返答すべきかを決めることもしません。返金依頼の完璧な文字起こしがあっても、返金ポリシーを知っている誰か、あるいは何かが必要です。
その後半部分が、私が毎日取り組んでいる領域です。eeselが実際のサポートキューでAIを運用してきた年月で、難しかったのは言葉をテキストにすることではありませんでした。会社自身のポリシーに基づいて正しく答えることと、いつ人に引き継ぐかを見極めることでした。だからこそ、どの導入でも、誰かに返信する前にチームの過去チケットでテストします。
Nemotron 3.5 Transcribeが重要な理由
「音声を他社のクラウドに送る」ことを任意にしてくれるからです。これまで、話者ラベルと翻訳を内蔵した高精度な音声モデルはクローズドなAPIで、オープンなものは単機能の小さなモデルで、つなぎ合わせる必要がありました。Nemotron 3.5 Transcribeは、そのすべてを自社データセンターで動かせる1つのオープンなチェックポイントにまとめ、商用ライセンスと、NVIDIAの学習データGranary v2(48言語、463,062時間)も併せて公開しています。
もう1つの変化は、カスタマイズが安くなったことです。NVIDIAの医療ケーススタディでは、インド訛りの臨床音声でファインチューニングし、誤りをそのままの30.8%から11.8%に減らしました。GB300 1枚で約14 GPU時間です(ケーススタディ)。
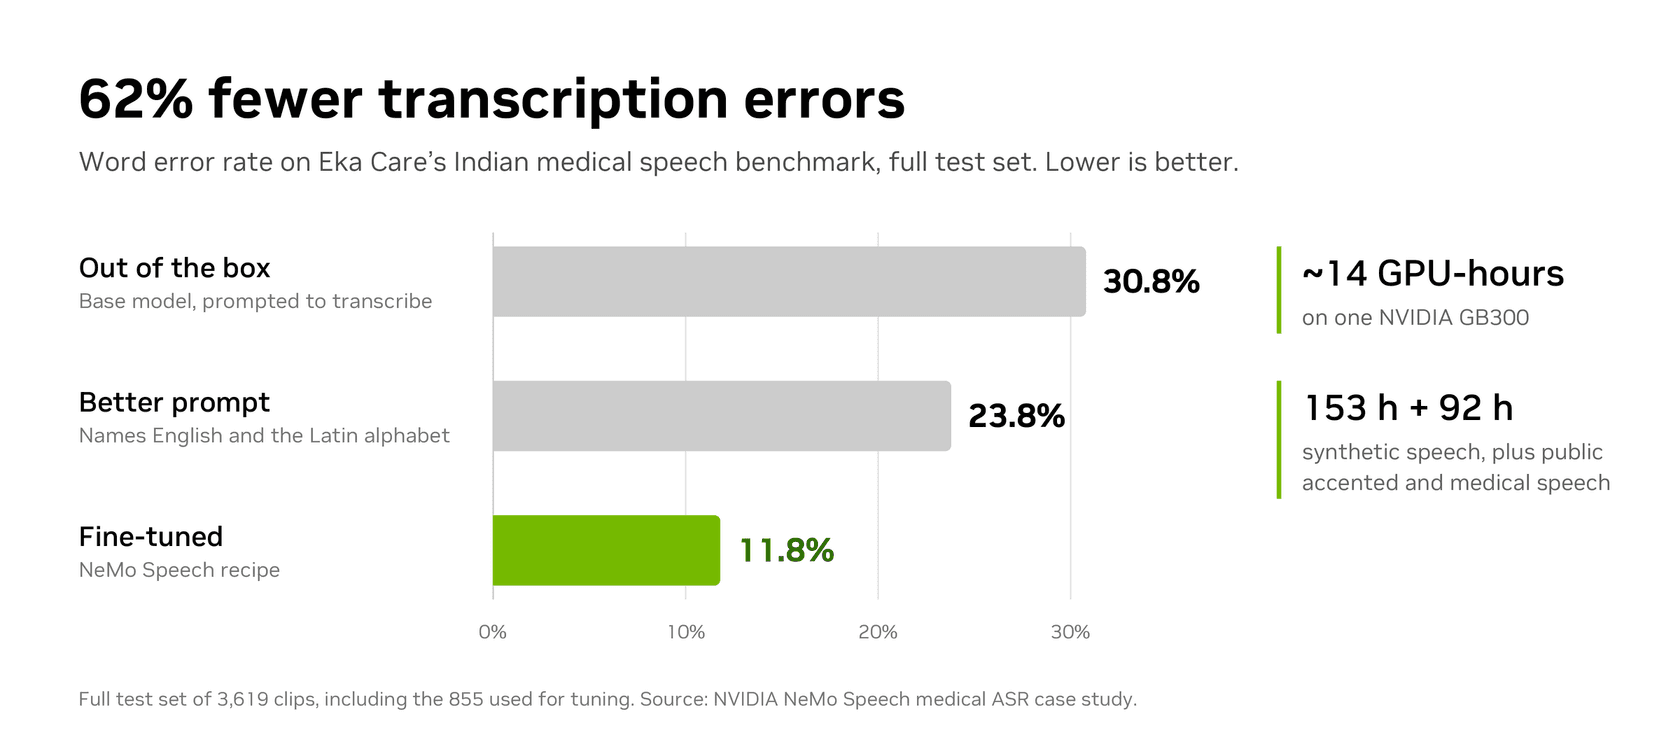
注目すべきは真ん中の棒です。学習なしで、プロンプトを改善しただけで30.8%から23.8%に下がりました。私の見解は、ファインチューニングの前に、まずプロンプトを試すことです。モデルに言語と文字体系、そして自社の製品名を伝えるのは無料で、ほとんどのサポートチームにとって効果の大部分はそこで得られます。
より広いスタックで他のオープンモデルと比較しているなら、NVIDIAのオープンなエージェント安全性プラットフォームと、私のオープンソースAIエージェントのリストが周辺の要素を扱っています。
eeselを試す
Nemotron 3.5 Transcribeはインフラです。優れた耳はあっても、職務記述書はありません。通話をテキストにするところまでです。その先の、チケットを読む、注文を確認する、お客様の言語で返信する、怒っているお客様をエスカレーションするといったことは仕事であり、それがeeselのAIヘルプデスクチームメイトの役目です。Zendesk、Freshdesk、Gorgiasに参加し、過去のチケットとヘルプセンターから学び、誰かに返信する前に何百件ものチケットでテストできます。

効果が最も出るのは言語です。smavaでは、1か月に27,000件のZendeskチケットを処理し、各チケットの言語とカテゴリにタグを付け、ドイツ語で返信を下書きしました。Koffer.chでは、お客様が書いてきた4言語のどれでもFreshdeskの返信を下書きし、ドイツ語にはスイス式の綴りを使います。
ターミナルからモデルを動かすのが好きなら、eesel CLIで同じチームメイトを操作できます。指示の読み取りと編集、人の承認待ちのアクションの承認、各実行のアクティビティログの確認ができ、JSON出力と書き込み時のドライランにも対応しています。Claude Codeのようなコーディングエージェントなら、文字起こしパイプラインと並べてサポートチームメイトを管理することもできます。eeselを無料で試すか、デモを予約して、自社のチケットで動くところをご覧ください。