

Voxtral 3はMistralの音声スタック全体を1回のリリースにまとめたものです。音声をテキストにするモデルが3つ、テキストを音声にするモデルが1つ、そしてそれらをチャットモデルにつないでAIが電話やブラウザで会話できるようにするボイスエージェントSDKで構成されます。2026年10月20日にリリースされ、すべてのモデルがまだ公開プレビューです。
価格は低めです。文字起こしは1分あたり$0.0035から$0.008、音声は100万文字あたり$13、エージェントのパイプライン全体は、Mistral Small 4が思考を担当して1分あたり$0.04です。注意点は2つあります。今回はウェイトが非公開であること、そしてSIP経由の電話回線はリリース時点ではエンタープライズ限定であることです。
サポートチームにとっての要点は、Voxtralが解決するのは聞くことと話すことであり、知っていることではないという点です。eeselでは実際のチケットに答えるAIエージェントを作っていますが、それを役立つものにするのは、企業の過去の回答を学ぶ作業です。たとえばsmava向けに月27,000件のドイツ語Zendeskチケットを処理しています。Voxtralはエージェントに耳と声を与えます。答えは、やはりどこかから持ってくる必要があります。
Voxtral 3とは?
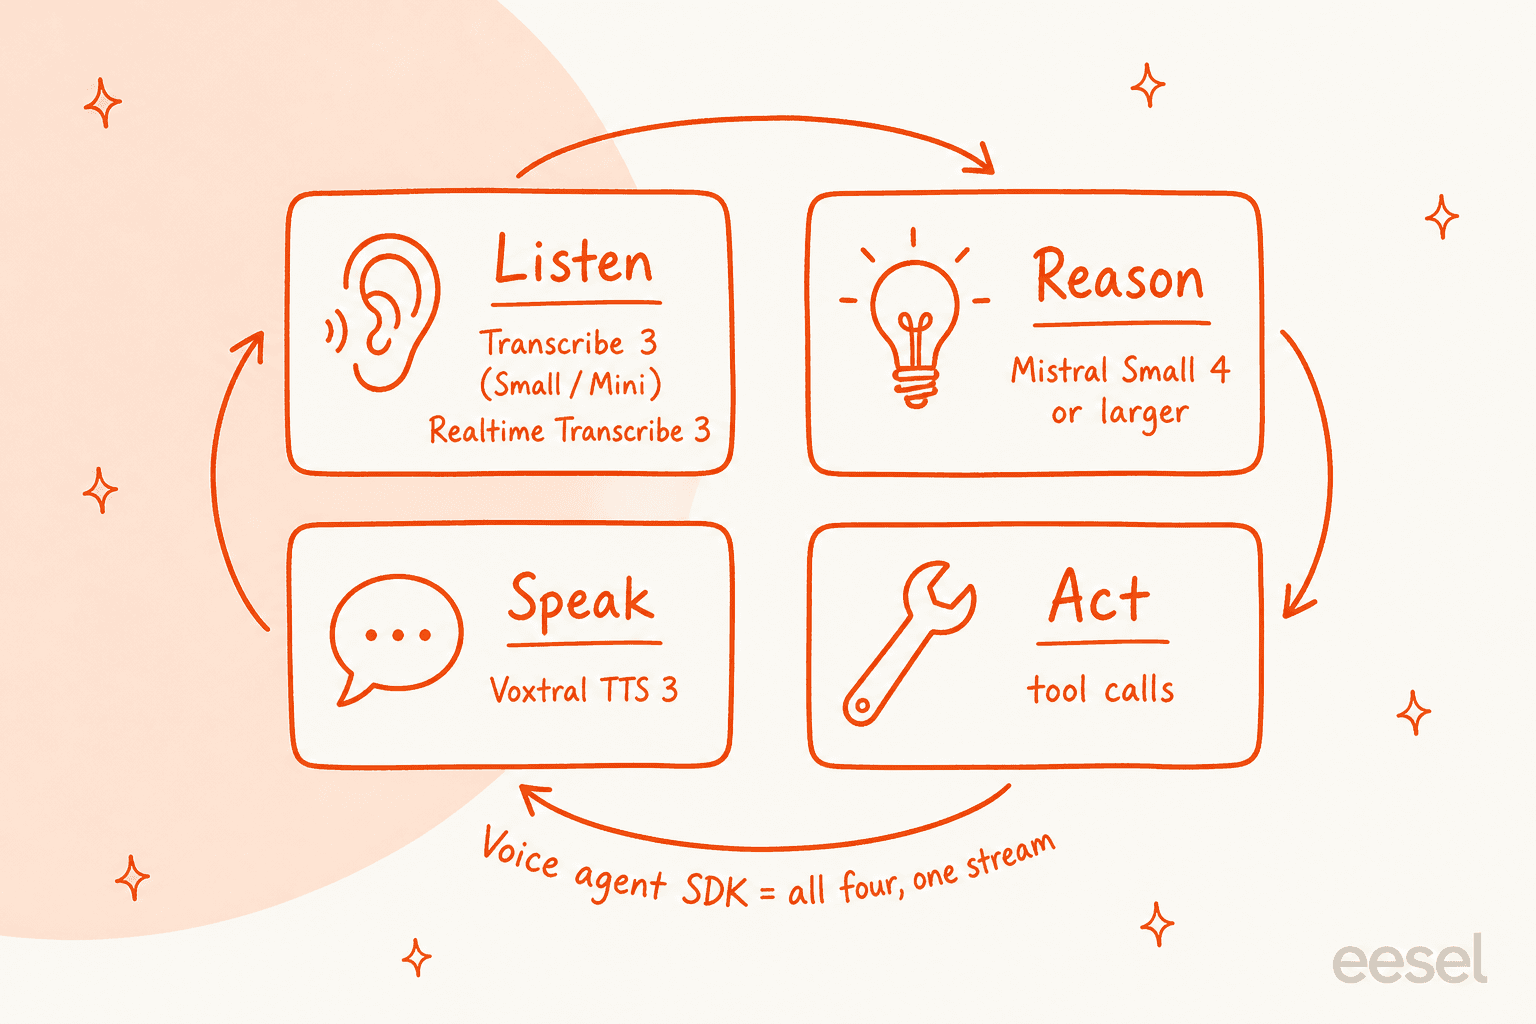
Voxtral 3は、MistralおよびMagistralチャットモデルを手がけるパリ拠点のラボMistral AIの音声モデルファミリーです。Mistralの主張は、動くボイスエージェントは4つの仕事を同時にこなす必要がある、というものです。正確に聞き取ること、相手の意図を推論すること、自然に話すこと、他のシステムで行動することです。Voxtral 3は、そのそれぞれに対応するパーツを備えた初めてのVoxtralリリースです。
私はeeselのエージェントが内部でどう動くかを担当しているので、このローンチで最も興味深いのは個々のベンチマークではありません。Mistralが、すべてをこなす1つのモデルではなく、入れ替え可能な別々のモデルに仕事を分けたことです。この選択が、Voxtral 3の良い点と扱いにくい点の大半を説明します。
Voxtral 3にはどのモデルがありますか?
モデルは4つ、APIプロダクトは1つです。実際に呼び出すモデルIDを含む一覧を、移行ガイドとローンチ時の料金から作成しました。
| モデル | モデルID | 役割 | 価格 |
|---|---|---|---|
| Voxtral Small Transcribe 3 | voxtral-small-transcribe-3-0 | フラッグシップのバッチ文字起こし、話者分離、翻訳、音声Q&A | $0.004/min |
| Voxtral Mini Transcribe 3 | voxtral-mini-transcribe-3-0 | より小さな4Bのバッチ文字起こしモデル | $0.0035/min |
| Voxtral Mini Transcribe Realtime 3 | voxtral-mini-transcribe-realtime-3-0 | 発話終了検出付きのライブ文字起こし | $0.008/min |
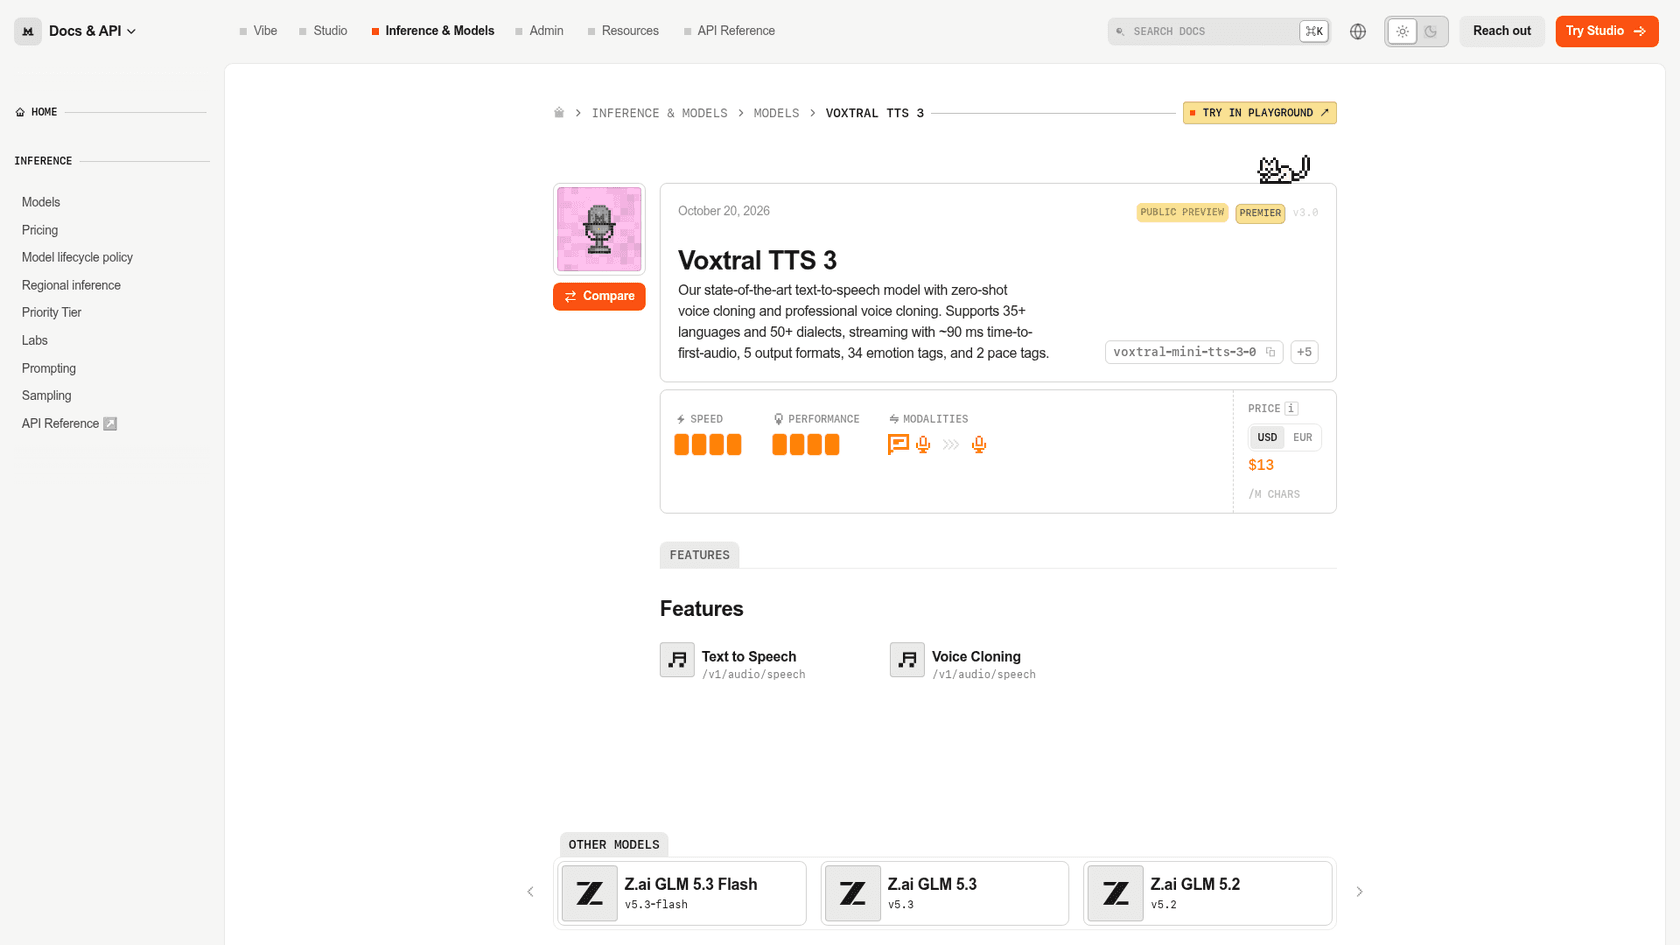
| Voxtral Mini TTS 3 | voxtral-mini-tts-3-0 | テキスト読み上げ、35以上の言語、音声クローン | $13/1M chars |
| ボイスエージェントAPI | n/a | リアルタイム文字起こし + チャットモデル + TTSを1本のストリームで | $0.04/min(Mistral Small 4)、$0.08/min(より大きなモデル) |
各モデルにはvoxtral-mini-transcribe-latestのような短いエイリアスもあります。1点注意があります。Mistralによると、voxtral-mini-tts-latestのエイリアスがVoxtral 3に切り替わるのは、一般提供開始から1か月以内とのことです。挙動を予測可能にしたいなら、完全なモデルIDを固定してください。
すべてMistralのAPIから、欧州、米国、グローバルのエンドポイントで利用でき、コードを書く前にStudioプレイグラウンドで文字起こし、音声、ボイスエージェントを試せます。
文字起こしモデル
Voxtral Small Transcribe 3は押さえておきたいモデルです。Mistralはこれを文字起こしと話者分離のフラッグシップと呼んでいます(話者分離とは、各発言を誰が話したかラベル付けすることです)。EUの公式言語24言語を含む50言語に対応し(多言語サポートに便利です)、モデルカードによれば音声からの翻訳、要約、関数呼び出しも行えます。コンテキストウィンドウは32kトークンです。
Mistralの45言語FLEURSテストでは、Smallは言語を自動検出した場合に単語誤り率4.0%を記録し、Microsoft AI Transcribe 2と並び、Whisper large-v3の14.9%を大きく引き離しています。Miniモデルは4.5%で、少し安くなります。Voxtralが首位でない部分も含め、すべてのグラフを私のVoxtral 3レビューで分解しています。
両方のバッチモデルはコンテキストバイアスに対応しています。用語のリスト(製品名、人名、SKU)を送ると、ファインチューニングなしでモデルが正しい綴りで書き起こします。Mistralのキーフレーズテストでは、このリストによってSmallの再現率が81.4%から94.6%に上がるので、オプションではなく標準設定として扱いましょう。
リアルタイムモデルは、ライブエージェントが使うものです。単語を確定するまでの待ち時間を選べ、待ち時間が長いほど誤りが減ります。また、音とことばの意味の両方を使って話者が話し終えたかを予測し、これが音声ボットが話の途中で相手を遮るのを防ぎます。電話をかけてきた人が注文番号を読み上げる間に間を置くAI電話サポートでは、これが重要です。
音声モデル
Voxtral Mini TTS 3は、35以上の言語と50以上の方言でテキストを音声に変換し、プリセット音声は18言語で用意されています。モデルカードには、ストリーミング時の最初の音声まで約90 ms、インラインで書ける34種類の感情タグと2種類のペースタグ、短いクリップからの音声クローンが記載されています。ブランドボイスには、約30分の音声からより近いコピーを作る「Pro Voice」があります。
ローンチページの音声サンプルは、サポート用の声がつまずきやすい点、つまりメールアドレス、フライトの時刻、ポンド建ての価格の読み上げを狙っています。Mistralは、100万文字あたり$13がElevenLabs Flash、OpenAI TTS-1、Deepgram、Gemini Flashより安いとも主張しています。ただし、新しい音を誰もが気に入っているわけではありません。
"The examples they give of how they "improved" the voices aren't great. Version 1 sounded like actual people, while this version sounds like generic AI slop voice."

これは1人のリスナーの意見で、声の好みは人それぞれです。それでも、声を選ぶ前に自分のスクリプトでサンプルを生成してみる十分な理由になります。
Voxtral 3のボイスエージェントはどう動きますか?
ボイスエージェントは、会話の1ターンごとに3段階のループを回します。ボイスエージェントのドキュメントによると、リアルタイムモデルが発信者を文字起こしして話し終わりを検出し、Mistral Small 4のようなチャットモデルが何を話すかを決めてツールを呼び出し、Voxtral TTSが返答を読み上げます。各段階は待たずに互いへストリームでつながるため、Mistralは各ターンが1秒未満で終わるとしており、発信者が割り込むとエージェントは話すのをやめます。
通話中、エージェントは関数呼び出し、ウェブ検索、ドキュメントライブラリ、独自の関数を使えます。たとえば発信者の本人確認や予約の登録です。ブラウザやアプリではWebRTCで、電話回線ではSIPで動作します。SDKは音声伝送にLiveKitを使っています。
Hacker Newsのコメント投稿者が、これがリリースの面白い部分である理由を的確に言い当てていました。
"I think the special sauce of this isn't the STT/TSS (although it does appear to be quite good) - it's the integration of a real-time reasoning model to actually do something with the raw text of the conversation, and whatever they're doing to hide tool call latency if the model needs to search for something."
私も同感ですが、ここは作業があなたに回ってくる部分でもあります。ツールは汎用的で、あなたのヘルプデスク、注文システム、過去のチケットについての知識は組み込まれていません。eeselの営業での通話では、過去のチケットから学ぶエージェントが群を抜いて多く求められています。企業の本当の答えがそこにあるからです。Voxtralでは、それをつなぐのは自分たちが担う統合作業になります。コールセンターAIエージェントに何を触らせるかを整理するなら、ツールをつなぐ前に決めておきましょう。
サポートにとって特に重要なローンチ時の制限は2つあります。SIP経由の電話通話はリリース時点ではエンタープライズ限定で、Mistralのアカウントチーム経由で手配します。一方、ウェブとアプリの音声は誰でも使えます。また、ユーザーのブラウザで動くツールは電話通話では動かないため、電話エージェントに必要なものはすべてサーバー側で動かす必要があります。
Voxtral 2からの変更点は?
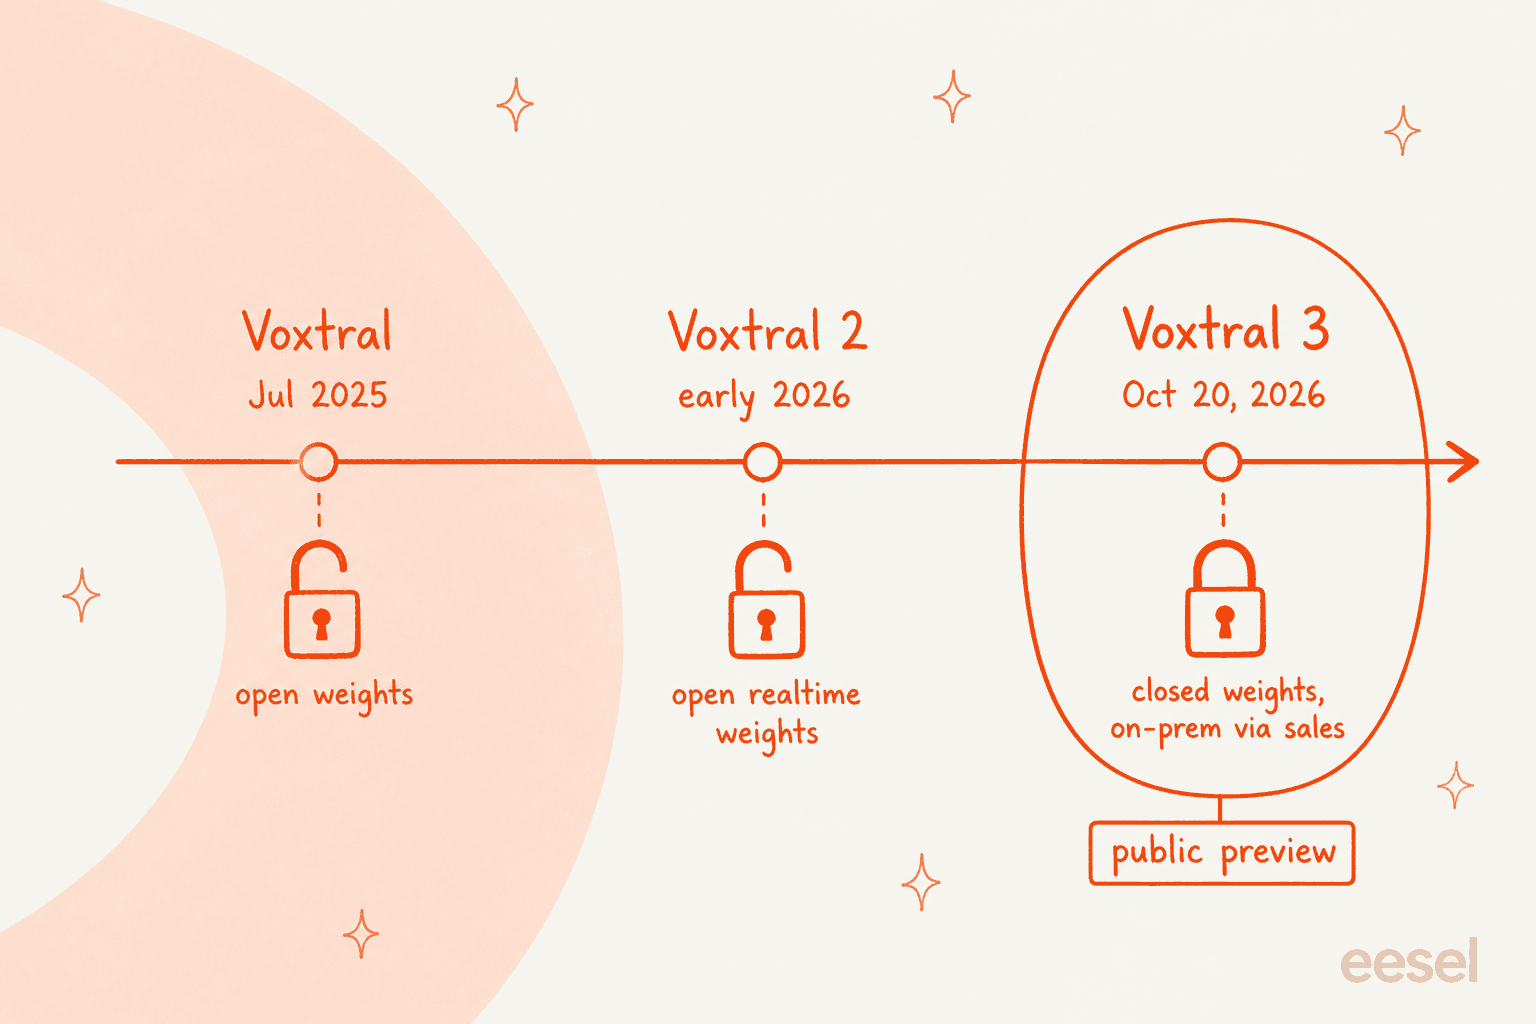
ひとことで言うと、言語の増加、話者分離の大幅な改善、新しいエージェント層、そしてウェイトの非公開化です。
改善された点:
- 話者分離。 Mistralの話者分離ベンチマークでのMiniモデルのエラー率は、Voxtral Mini Transcribe 2の
30.9%からMini Transcribe 3の18.6%に下がりました。通話録音では、どの発言が顧客のものかが分かることが価値の半分です。 - 言語。 バッチ文字起こしが50言語に対応し、リソースの少ないアジアおよびインド系言語が加わりました。
- コンテキストバイアス。 用語を複数語のフレーズにでき、自由形式のコンテキスト文はオフラインでも使えます。
- リアルタイム機能。 話者分離、話者リファレンス、ターン検出がリアルタイムセッションでも使えるようになりました。
- 音声制御。 感情は、
gb_jane_sadのような別々のプリセット音声から、インラインの[emotion=...]タグに移り、クローンした音声は一度保存してIDで再利用できます。
移行ガイドによると、壊れる点は次のとおりです。
- 単語単位のタイムスタンプはなくなりました。
wordの粒度を指定すると400エラーが返るので、セグメント単位のタイムスタンプに切り替えてください。 - リアルタイムセッションは最初の音声チャンクで設定が固定されるため、すべての設定を最初に送ってください。
- 2人が同時に話すと、話者分離されたセグメントが重なることがあります。
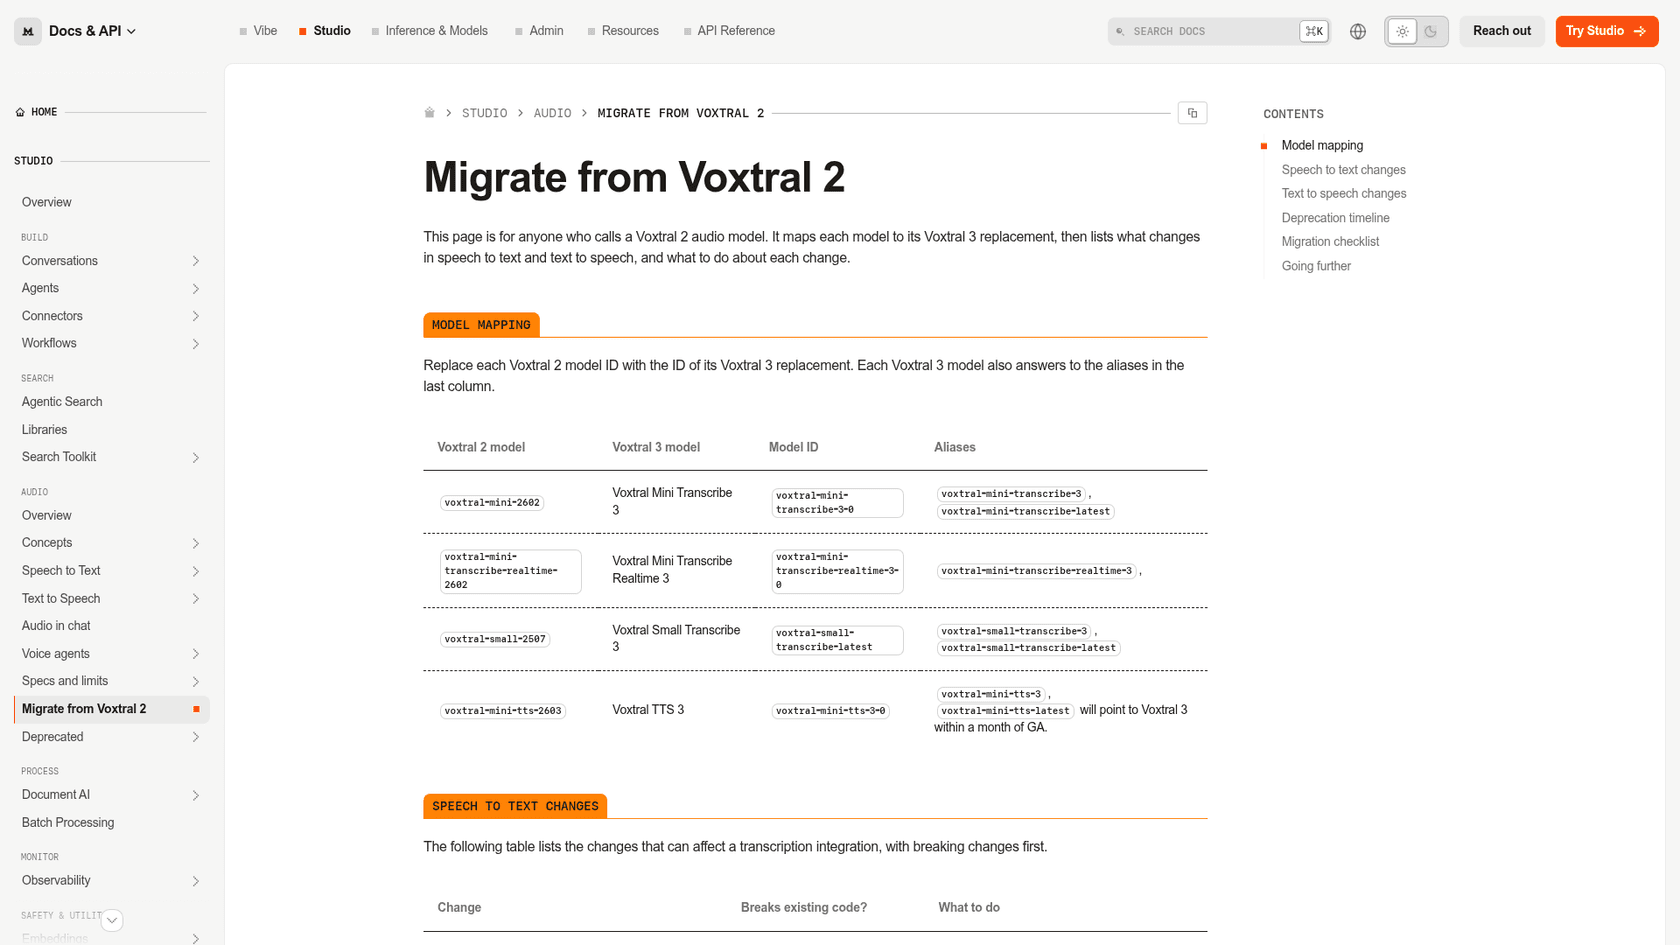
掲載されているのに未提供の機能が1つあります。「温かく言って」のような自由記述のスタイル指示は、ドキュメントで取り消し線が引かれ、ローンチ時点では利用できないとされています。
ウェイト非公開が重要な理由
2025年7月の最初のVoxtralモデルと、Voxtral Mini 4B Realtimeモデルは、Hugging Faceでオープンウェイトとして公開されていました。Voxtral 3は違います。ローンチでは「セルフデプロイ」に触れていますが、それは契約を意味します。オンプレミスやプライベートクラウドの構成はMistralの営業チームを通じて行います。
"You have to call sales to get access for on-prem deployment and the models. If it were open weights, it would be on Huggingface and they would have put a link in the post"
ノートPCで音声を動かす愛好家にとっては、実際の損失です。エンタープライズのサポートチームにとっては、EUでホストされるAPIに加えて契約によるオンプレミスは通常の調達であり、EU AI法の下で通話音声を扱うならおそらくより安全な道です。Mistralは他の分野ではオープンモデルを引き続き公開しており、Mistral Large 4の計画がその例です。
Voxtral 3の料金はいくらですか?
Voxtral 3は、文字起こしとエージェントは音声の分単位、音声は文字単位で課金されます。以下はMistralのローンチ時の定価です。
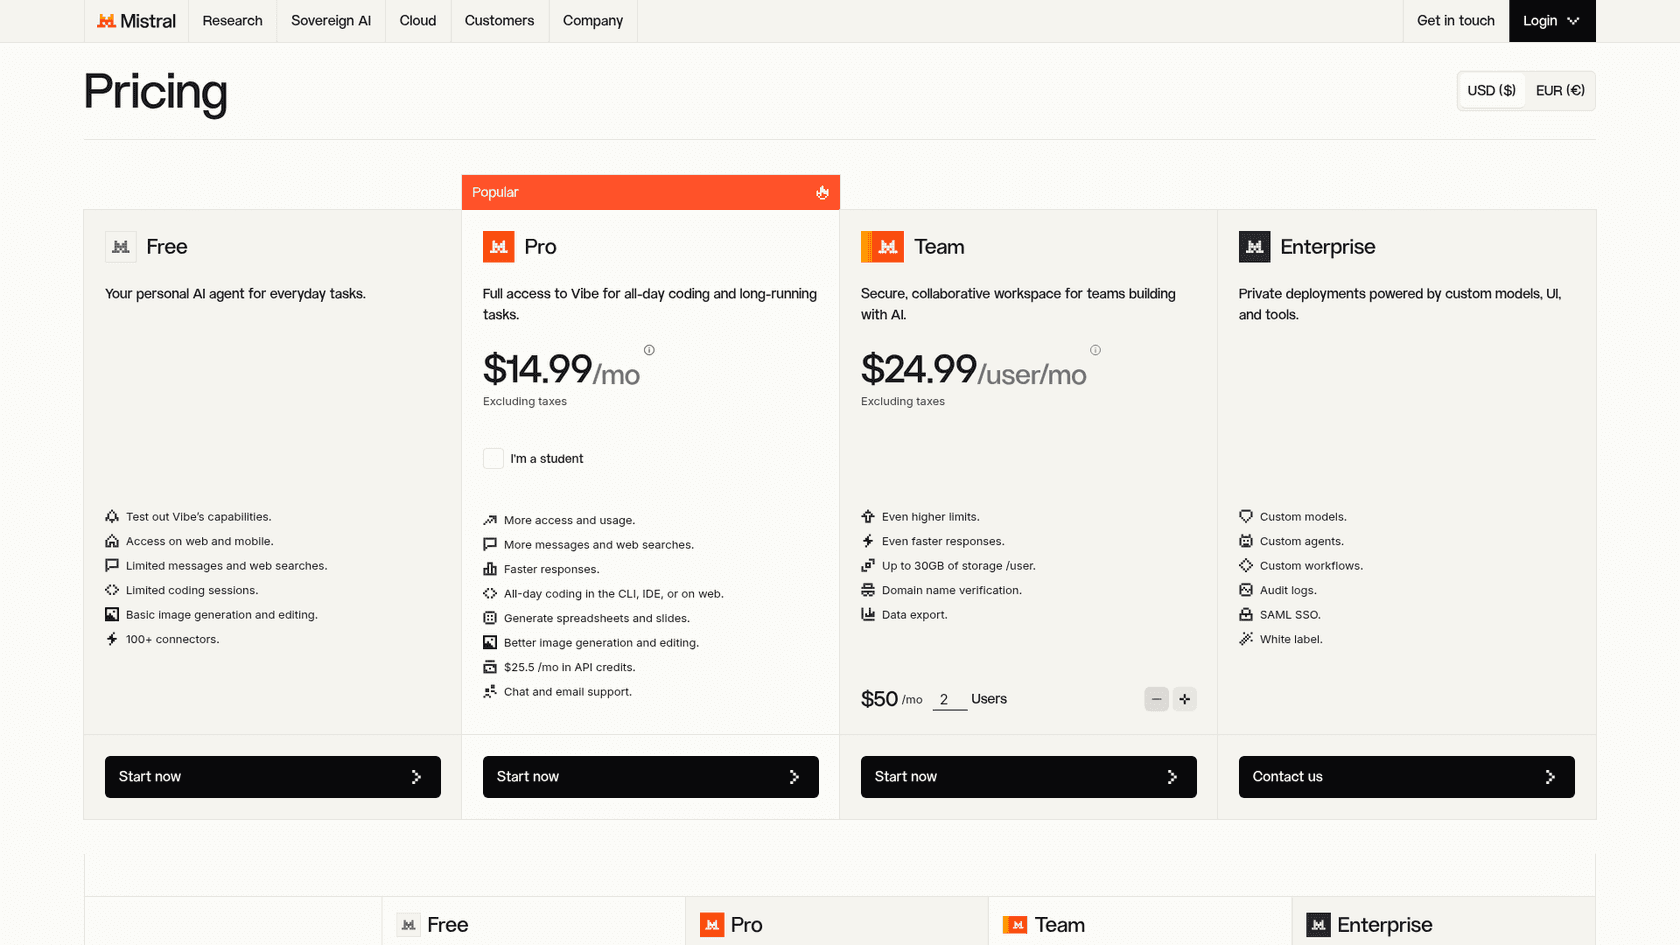
| ワークロード | 料金 | 5分の通話1,000件 |
|---|---|---|
| Miniで録音を文字起こし | $0.0035/min | $17.50 |
| Smallで録音を文字起こし | $0.004/min | $20 |
| ライブ文字起こし | $0.008/min | $40 |
| Mistral Small 4のボイスエージェント | $0.04/min | $200 |
| より大きなモデルのボイスエージェント | $0.08/min | $400 |
役立つのはこのパターンです。すでに受けているすべての通話を品質保証のために文字起こしするのは、小銭程度で済みます。AIに通話を受けさせると、推論と音声に費用がかかるため10倍から20倍になります。エージェントAPIでの5分の通話は$0.20です。これがコールセンターROIの計算に入れる数字です。
エージェントの背後にあるチャットモデルのコスト詳細は、Mistral AIの料金をご覧ください。競合の音声スタックについては、今年は音声の価格が急速に動いているため、GPT RealtimeとGrok Voice Think Fast 2を各ベンダーのページで比較してください。
どのVoxtral 3モデルを使うべきですか?
最大のモデルではなく、用途で選びましょう。私なら次のように割り当てます。
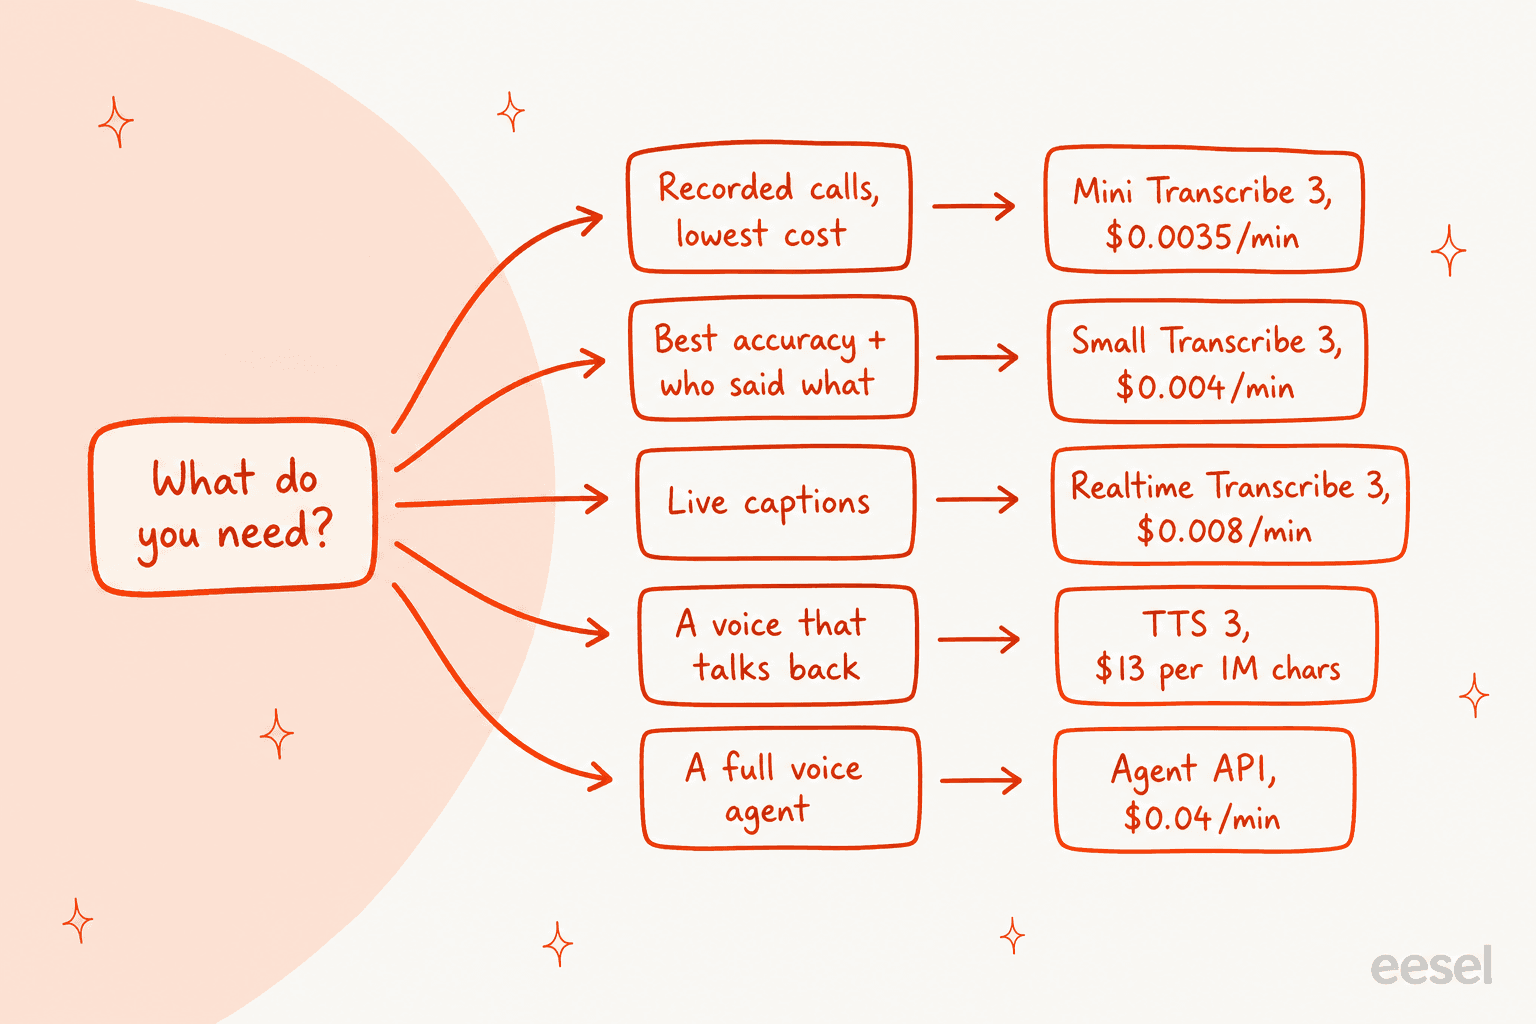
- 通話分析とQA: Mini Transcribe 3。Mistralのテストでは、Smallと半ポイント差で、リストの中で最も安いです。文字起こしを共有の場所に置く前に、PIIのマスキングと組み合わせてください。
- 会議や複数話者の録音: Small Transcribe 3。Mistralのグラフで最も優れた話者分離のためです。
- ブラウザやアプリ内の音声アシスタント: ボイスエージェントAPI。よく設計されていますが、プレビュー版であることを前提に計画してください。
- サポート電話番号のAI: SIPへのアクセスを得られるエンタープライズ顧客でない限り待ち、ヘルプデスク連携の構築予算を確保してください。
- ローカルでオフラインの音声: Voxtral 3ではありません。Mistralの代替か、以前のオープンなVoxtralウェイトを検討してください。
Voxtralを他の音声モデルと比較するなら、Gemini 3.5 Transcribe、MAI-Transcribe 2、Cartesia Sonic 3が最も近い候補です。
モデルではなく完成品を探すなら、AI音声企業と音声サポートに最適なAIのまとめがこの分野を網羅しています。
Voxtral 3がサポートチームにもたらすもの
Voxtral 3は、サポートエージェントの音声部分を安く、良いものにします。エージェントにあなたのビジネスを理解させてはくれません。多くの音声プロジェクトが行き詰まるのはこのギャップです。ボットは発信者の声を完璧に聞き取り、そのうえで返金ポリシーについて自信満々に間違った答えを返します。
eeselでは長年、実際のサポートキューにAIエージェントを置いてきましたが、導入のたびに同じ教訓が繰り返されます。精度は、エージェントが学ぶもの(過去のチケット、ヘルプセンターの記事、マクロ)と、顧客と話す前に実際の会話でテストすることから生まれます。だからこそ、eeselの導入はすべて、まず過去のチケットでシミュレーションされます。より良いマイクがあっても、この作業の順序は変わりません。
コールセンター自動化を計画しているなら、私なら次の順序にします。まず、答えが作られテストされる書面チャネルをカスタマーサポート向けAIエージェントで自動化し、そのうえで同じ知識に声を与えます。SIPが開放されたら、Voxtral 3は音声レイヤーの有力な候補です。
声の背後にある答えをeeselで
Voxtralはインフラで、eeselは従業員です。私たちのAIヘルプデスクチームメイトは、ZendeskやFreshdeskなど、すでにお使いのヘルプデスクに加わり、過去のチケットから学び、お客様が書いた言語で返信します。
この多言語対応は、Voxtralの言語リストだけでは実現できない部分です。スイスのスーツケース店Koffer.chでは、eeselがFreshdeskの返信をドイツ語、フランス語、英語、イタリア語のうち顧客に合わせて、スイス式の綴りで下書きします。smavaでは、月27,000件のドイツ語Zendeskチケットで稼働しています。
現在のサポートがメールとチャットで動いているなら、そこから始めましょう。ご自身の過去のチケットでeeselを無料で試し、どう回答したかを確認してください。