

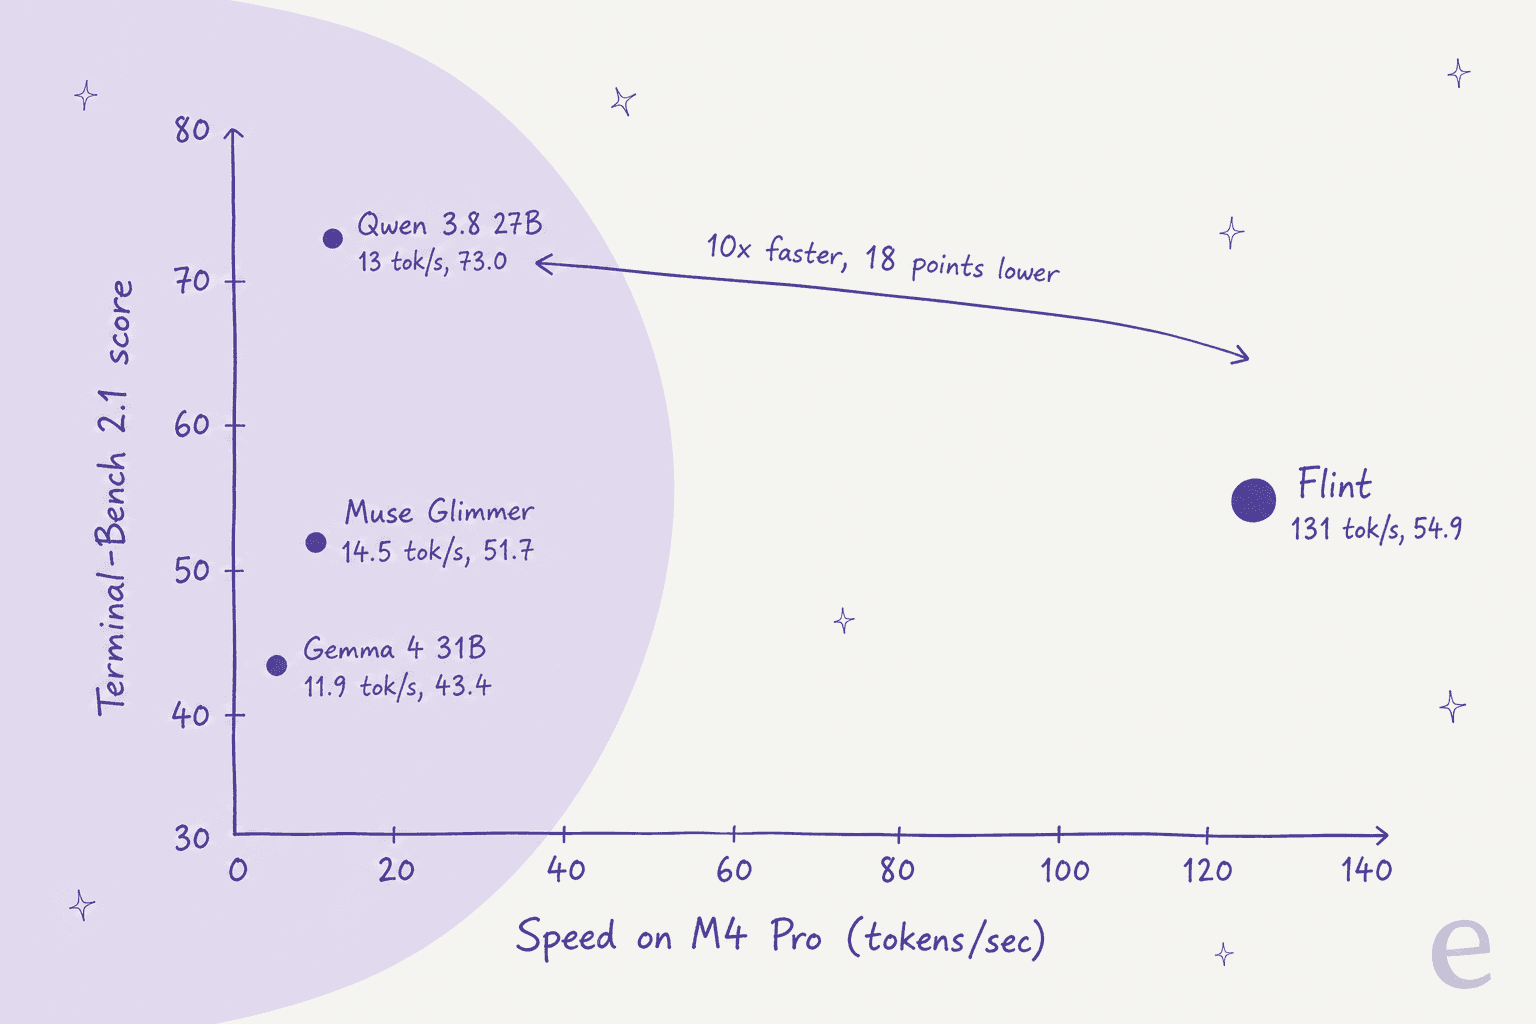
Recursive Flintは、今日ノートパソコンで動かせる最速のコーディングモデルで、しかも無料ですが、最良のモデルではありません。 M4 ProのMacBookでは毎秒131トークンを出力し、密なQwen 3.8 27Bの約10倍です。一方でQwen 3.8は、Recursive自身のチャートにある6つのコーディングベンチマークのうち4つでFlintを上回り、Terminal-Bench 2.1では18ポイント差をつけています。
私の評価は3.5/5です。オフラインで動くApache 2.0のコーディングエージェントが欲しく、作業を小さく明確なステップに分けられるなら、Flintを選んでください。回答ごとに最強のローカルモデルが必要な場合や、ツール呼び出しのループが決して失敗してはいけない場合は見送りましょう。OpenRouterの無料エンドポイントでは、現在ツール呼び出しの17.74%がエラーになります。
もし本当に必要なのがコードベースではなくサポートキューを担当するエージェントなら、素のモデルは適切なレイヤーではありません。eeselのAIヘルプデスクチームメイトは、こうしたモデルの上に立つ従業員のような存在で、あなたのコーディングエージェントはeesel CLIを使ってターミナルから操作できます。
Recursive Flintとは?
Recursive Flintは、40Bパラメータのエキスパート混合型コーディングモデルで、トークンごとに約2.5Bパラメータを活性化します。Recursiveが2026年10月21日に公開しました。入力も出力もテキストで、常時オンの推論とツール呼び出しを備え、リポジトリを読み、ファイルを編集し、テストを実行するコーディングエージェントを動かすという一つの仕事のために作られています。チャットアプリではなく、エージェント型コーディングCLIの下で動くエンジンだと考えてください。
Recursiveは、You.comのCEOでもあるRichard Socherが率いるラボです。掲げる目標は「再帰的に自己改善する超知能」で、Flintはそこへ到達するためのシステムの最初の公開テストです。そのシステムがEureka Machineで、アイデアを提案し、実装し、テストし、次に試すものを選ぶ自動研究ループです。Recursiveによると、少人数の人間とエージェントのチームがFlintを4か月足らずでゼロから構築し、Eureka Machineがデータ、学習レシピ、量子化、カーネルに取り組みました。
私はeeselのエージェントを支える統合とAPIを作っており、一週間のほとんどをモデルをツールループに組み込み、どこで壊れるかを観察して過ごしています。それがこのレビューの視点です。モデルカード、Recursiveのドキュメント、recエンジンのリポジトリ、OpenRouterのライブ統計を読み、コーディングモデルが実際にやるべきこと、つまり付きっきりで見守らなくても複数ステップのタスクを完了できるかでFlintを評価しました。
モデルカードから直接引いた、重要なスペックは次のとおりです。
| スペック | Recursive Flint |
|---|---|
| 総パラメータ数 | 39.8B |
| トークンあたりの活性パラメータ | 約2.5B(出力ヘッドを除くと約2.2B) |
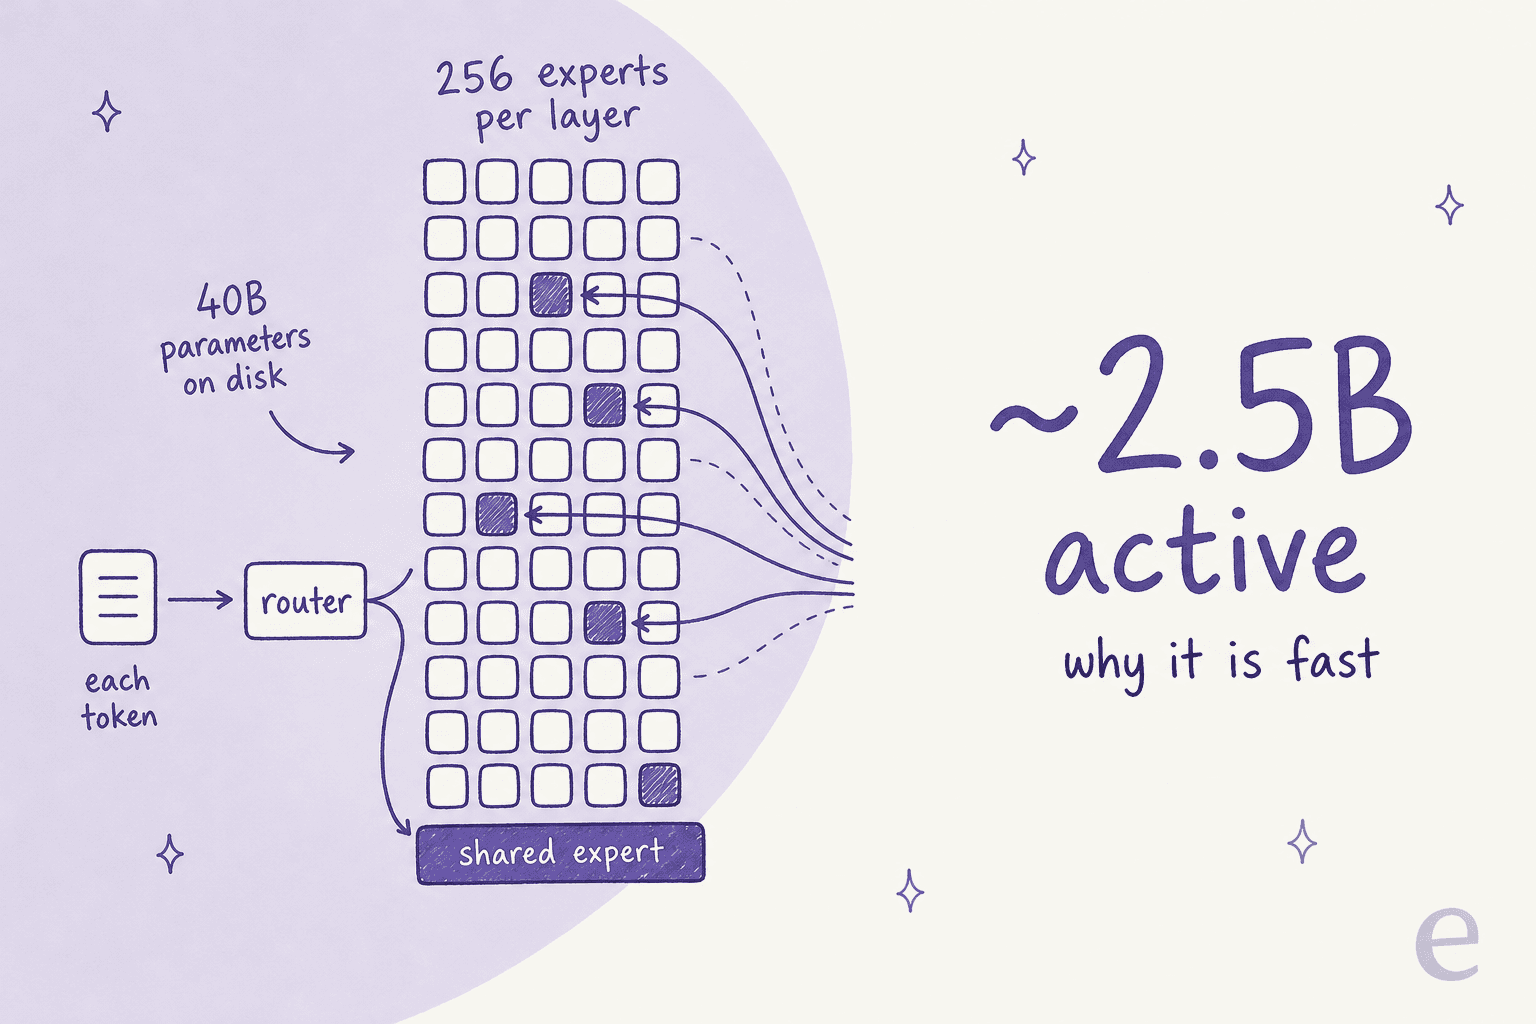
| エキスパート | MoE層ごとに256、トークンごとに6をルーティング、加えて共有1 |
| 層数 | 49(密2、MoE 47、スライディングウィンドウ35、フルアテンション14) |
| コンテキスト | 262,144トークンを文書化、最大512kまで対応、256k推奨 |
| 最大出力(ホスト型) | 65,536トークン |
| 知識のカットオフ | 2026年6月 |
| ライセンス | Apache 2.0 |
| 入力 / 出力 | テキスト / テキスト |
40Bのモデルがノートパソコンでこれほど速く動くのはなぜ?
ほとんどの部分が遊んでいるからです。すべてのトークンは、各層で256のエキスパートから6つを選ぶルーターを通り、さらに常に発火する共有エキスパートが1つ加わるため、チップがトークンごとに読む重みは約2.5Bパラメータ分だけです。密な27Bモデルは、トークンのたびに27B全部を読みます。
面白いのは、Recursiveがアーキテクチャだけで止まらなかったことです。ローンチ記事によると、Eureka Machineは量子化レシピも探索し、一般的なやり方に反して出力層を4ビットまで圧縮しました。活性パラメータが2.5Bしかないため、この出力層はトークンごとに読む重みの大きな割合を占めており、縮めると実際の速度向上につながります。最終的なNVFP4モデルは、Recursiveのベンチマーク全体で16ビット版との差が0.7ポイント以内に収まっており、LM Studioの掲載ページにはテストごとの差が示されています。Terminal-Benchでは53.7対54.9、SWE-bench Verifiedでは74.1対74.2です。
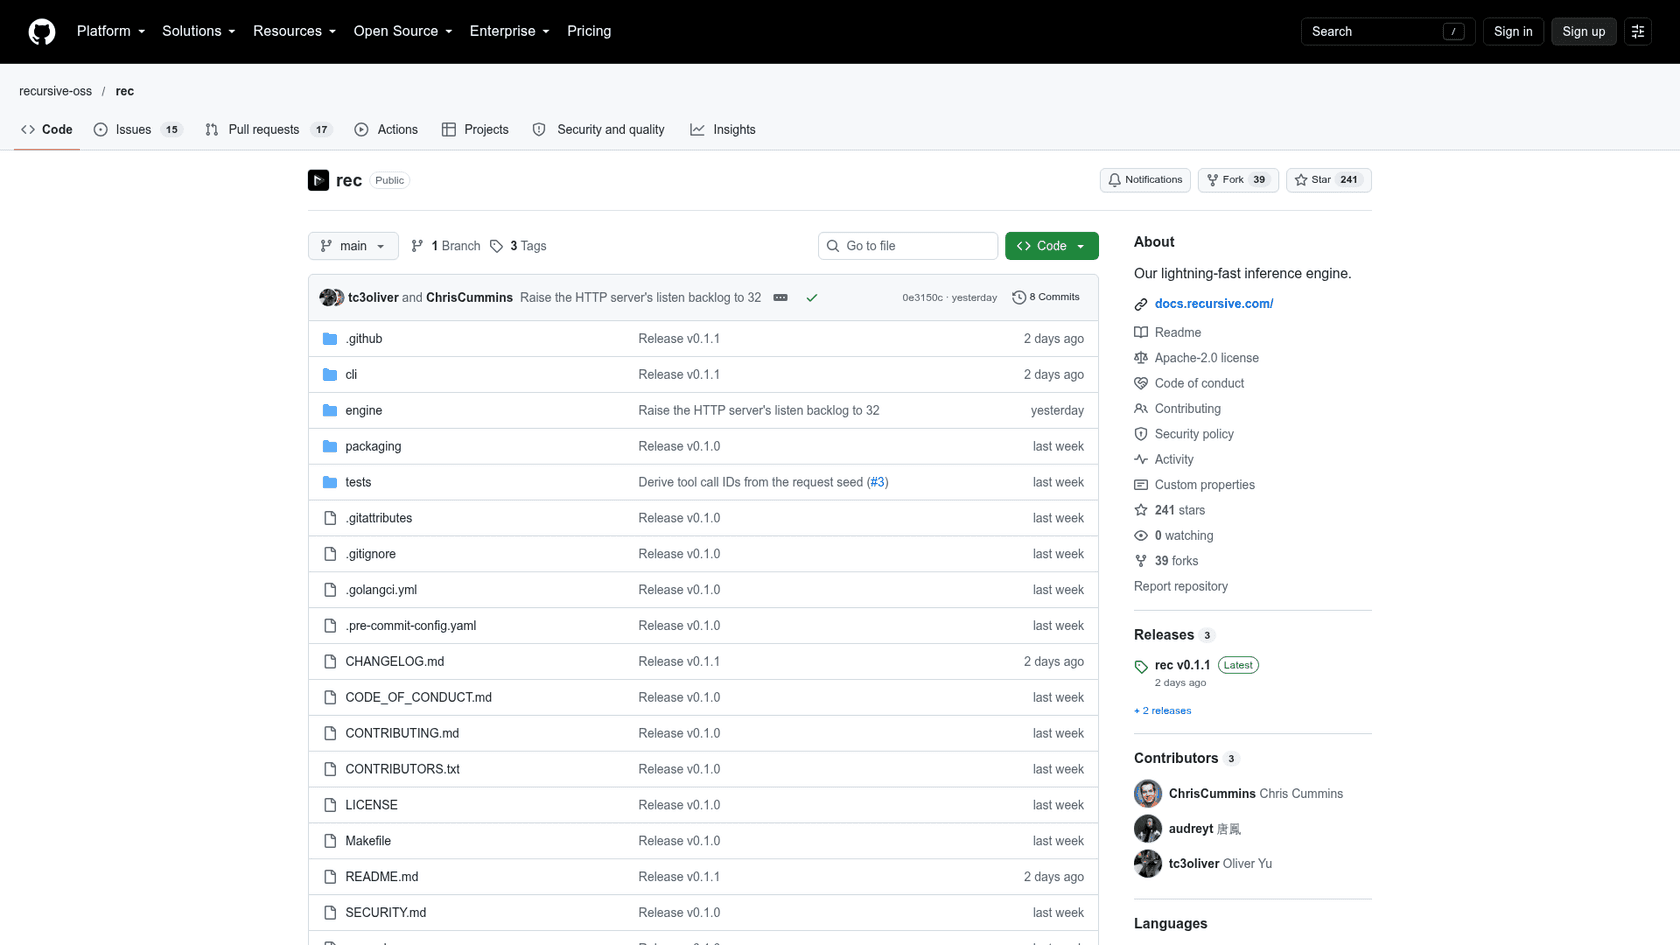
その後、M4とM5チップでデコード処理全体を融合するMetalの「メガカーネル」を含む、独自のカーネルを書きました。Recursiveがllama.cppを案内するだけでなく独自のエンジンrecを提供しているのはそのためです。詳しくは後述します。
Recursive Flintの実際の速度は?
非常に速いです。48 GBのApple M4 ProにおけるRecursive自身のチャートでは、Flintは1Kトークンのコンテキストで、MLX経由で毎秒131.22トークン、llama.cpp経由で87.98です。最も近いスパースな競合は、Laguna XS 2.1の68.84とQwen 3.6 35B-A3Bの65.55です。コーディングスコアが同程度の密なモデルはほとんど動きません。Muse Glimmerは14.54、Qwen 3.8 27Bは13.01、Gemma 4 31Bは11.92です。

長いコンテキストの数字を見ると、これが短いプロンプトだけの見せ技ではないと確信できます。128Kまでのコンテキストで平均すると、FlintはM4 Proで毎秒68.89トークンを維持しますが、Qwen 3.8 27Bは10.11まで落ちます。コーディングエージェントはほとんどの時間を長いコンテキスト(ファイルの内容、テスト出力、自分の過去の推論)の奥深くで過ごすため、見出しの数字より平均のほうが重要です。NVIDIAのRTX SparkではNVFP4ビルドが、短いコンテキストで毎秒155.82トークン、平均で101.95に達します。
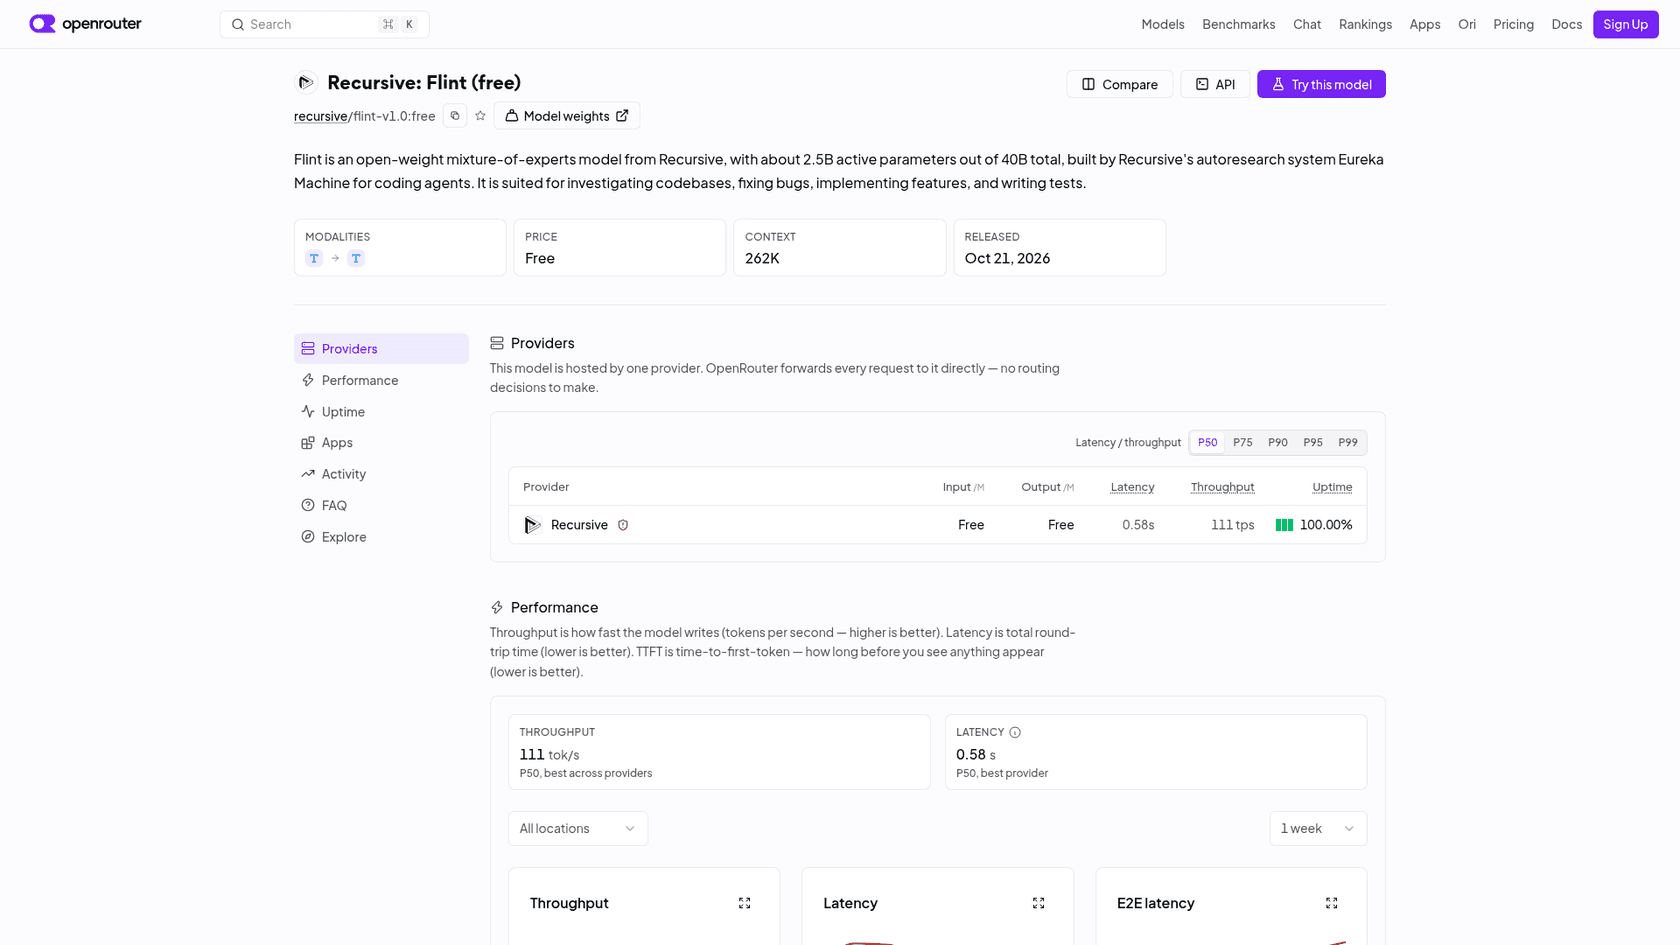
ホスト型でも高速です。OpenRouterのライブ統計では、Recursiveの唯一のプロバイダーエンドポイントから、P50スループットが毎秒111トークン、レイテンシが0.58秒と表示されています。
注意点が2つあります。これらはプリフィルを除いたRecursive自身の測定値なので、大きなプロンプトでは最初のトークンまでの時間がバーの印象より遅く感じられるでしょう。また、速度が出るのはFlintを正しくサポートするランタイムを使った場合だけです。トラブルシューティングのページは、CPUオフロードとメモリスワップに丸々1項目を割いています。
FlintはQwen 3.8、Gemma 4、Muse Glimmerと比べてどうスコアが違う?
ここで、ローンチ文面とチャートが食い違います。Recursiveは、Flintが「250億から400億パラメータの密なモデルのコーディング性能に匹敵する」と述べています。しかし自社のチャートでは、その中で最強のQwen 3.8 27Bに、エージェント型コーディングで重要なテストの大半で負けています。
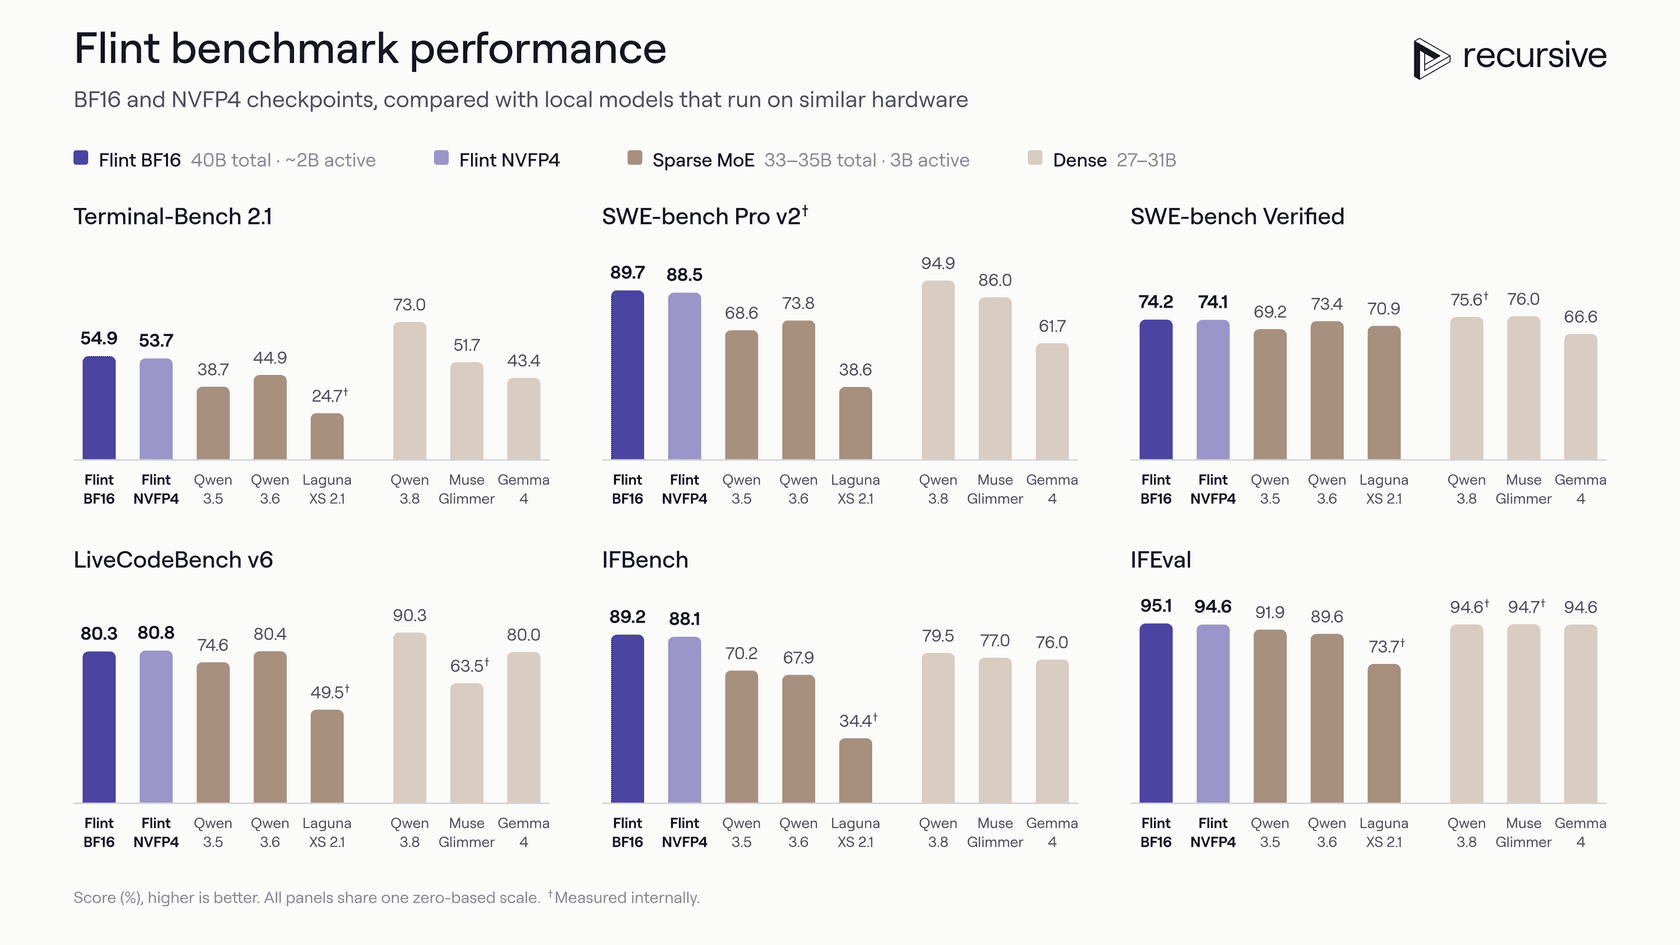
| ベンチマーク | Flint BF16 | Qwen 3.8 27B(密) | Muse Glimmer(密) | Gemma 4(密) | Qwen 3.6 35B-A3B(MoE) |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 54.9 | 73.0 | 51.7 | 43.4 | 44.9 |
| SWE-bench Pro v2 | 89.7 | 94.9 | 86.0 | 61.7 | 73.8 |
| SWE-bench Verified | 74.2 | 75.6 | 76.0 | 66.6 | 73.4 |
| LiveCodeBench v6 | 80.3 | 90.3 | 63.5 | 80.0 | 80.4 |
| IFBench | 89.2 | 79.5 | 77.0 | 76.0 | 67.9 |
| IFEval | 95.1 | 94.6 | 94.7 | 94.6 | 89.6 |
正直に読むと、3つの点が目立ちます。
- 同サイズの他のMoEモデルに対しては、Flintが明確に勝ちます。 Qwen 3.6 35B-A3Bには6項目中5項目で勝ち(LiveCodeBenchは0.1ポイント差の引き分け)、Terminal-Benchでは
10ポイント差です。Recursiveが最初に打ち出す主張で、実際に成り立っています。 - Qwen 3.8 27Bには6項目中4項目で負けます。 私が最も重く見るのは、Terminal-Bench 2.1での
18.1ポイントの差です。このテストが「タスクが終わるまでシェルを操作し続ける」ことに最も近いからです。 - 突出しているのは指示追従です。 IFBenchの
89.2は、チャート上のどの密なモデルよりも約10ポイント上で、明確でステップごとの指示を与えるようにというドキュメントの助言とも一致します。
Recursiveは方法論について率直で、その点は評価します。モデルカードによると、Terminal-Benchの実行ではWeb検索で見つけた解法は失敗として扱われ、他のモデルについて開発元が報告したスコアには同じ調整が適用されていない可能性があるとカードに書かれています。つまり、差の一部はより厳しい採点のせいかもしれません。ただし一部は、密な27Bモデルがトークンごとにより多く考えているというだけのことです。
これが本当のトレードオフです。Flintは少し劣る答えと引き換えに10倍速い。どのみちすべてのdiffを読む対話的なコーディングのループなら、私はこの取引をよく選びます。夜通し放置するエージェントなら選びません。
Flintの弱点はどこ?
制約の多くはRecursive自身が文書化しているもので、モデルについてではなくラボについては良い兆候です。
フロンティアモデルより短い手綱が必要です。 ローンチ記事にははっきり書かれています。「使い慣れた大型のクローズドなコーディングモデルより、多くのガイダンスが必要になるかもしれない」とし、作業を明確な指示つきの小さなサブタスクに分けることを勧めています。曖昧なチケットをClaude CodeやCursorに渡して席を離れることに慣れているなら、やり取りが増えると覚悟してください。
ツール呼び出しが思った以上に失敗します。 OpenRouterは、無料エンドポイントのツール呼び出しエラー率を17.74%と報告しています。30ステップのエージェントループでは、タスクごとに壊れた呼び出しが数回あり、ハーネス側で吸収する必要があります。ドキュメントは、よくある原因としてチャットテンプレートとパーサーの不一致を挙げており、モデルカードは履歴にreasoning_contentを残すよう求めているので、一部はこちら側で直せます。それでも、最初に注目する数字です。
長い推論が予算を食います。 推論は常にオンです。モデルカードは難しい問題に最低32,768出力トークンを推奨し、OpenCodeガイドは65,536を提案しています。ハーネスが出力をそれより低く制限していると、応答が思考の途中でfinish_reason: lengthで終わります。これはClaude Codeのコンテキストウィンドウで解説したのと同じ予算の問題です。
高速な経路はMac限定で、しかもどのMacでもありません。 READMEによると、recには48 GB以上のユニファイドメモリを持つM4 Pro、M4 Max、M5 Pro、M5 Maxが必要です。24 GBのマシンでもLM Studioで最小のGGUFを読み込めますが、LM Studio自身の掲載ページは、262Kのフルコンテキストが収まる保証はないと警告しています。
SLAつきの有料APIはまだありません。 リリースページによると、RecursiveのAPIへの直接アクセスは「一部のパートナーに限定」されています。OpenRouterとOpenCodeの無料枠は、容量とレート制限の対象です。お試しには十分ですが、顧客に課金するものには向きません。
コミュニティの反応はチャートと一致しています。Hacker Newsのローンチスレッドは、ゼロから作られたモデルの速度に感心しつつ、「見せてもらおう」という空気もありました。
"Pretty amazing for being trained from scratch, to have ~Qwen 3.8 27b quality with such an increase in tok/s performance. Excited to try it out and see how snappy it is."

"not as good as qwen3.8 yet, even the chart says good numbers"
どちらも的を射ています。私はその中間に置きます。対話的な作業では速度が決め手になるほどQwen 3.8に近いが、すべての場面で決め手になるほどではない、ということです。
Recursive Flintはどうやって動かす?
経路は4つあり、ハードウェアが自動的に1つを選んでくれます。
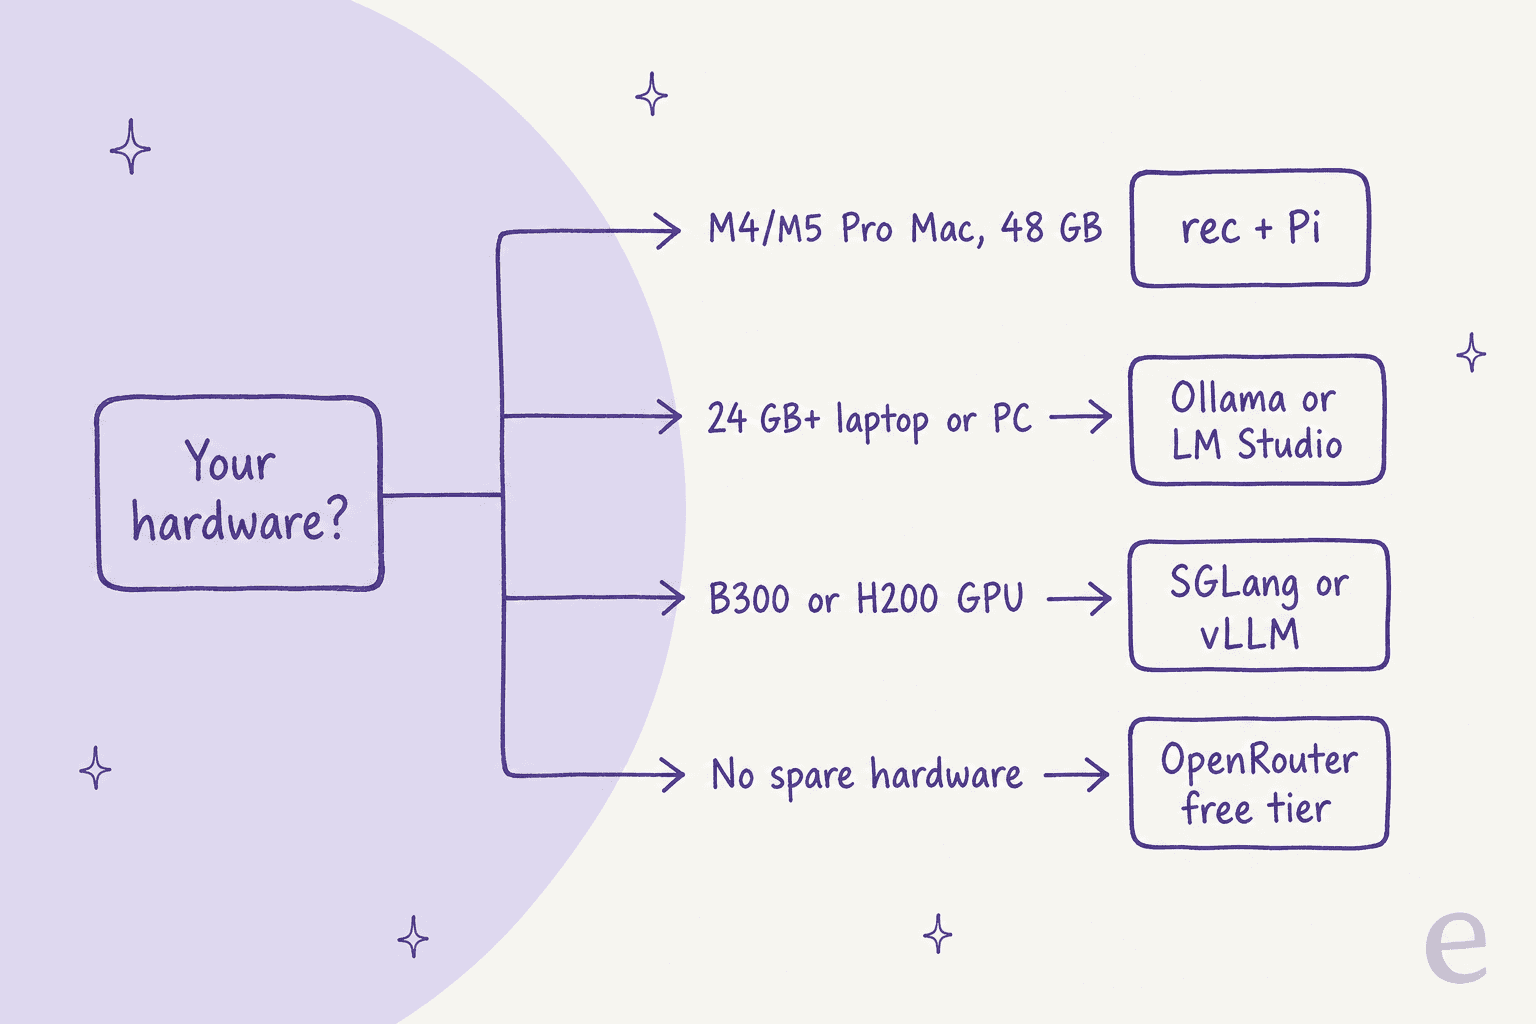
1. 対応するMac:recを使う。 Recursive独自のエンジンで、READMEはM4 Pro上でllama.cppの1.4倍から2.6倍のスループットを謳っています。curlコマンド1つでインストールし、プロジェクトフォルダでrec launch piを実行します。モデル(ディスク約30 GB)とPiハーネスをダウンロードし、OpenAI互換とAnthropic互換の両方のAPIを話すローカルサーバーを起動します。RecursiveはFlintがPiとの組み合わせで最も性能を発揮すると述べており、代替はrec launch opencodeです。注意点が1つ。recは単一セッション向けに作られているため、複数のエージェントを同時に動かすなら別のランタイムが必要です。
2. そこそこのノートPCやPC:OllamaまたはLM Studio。 ollama run flint:40b-a2b-qat-int4でRecursiveがパッケージした4ビットビルドを取得でき、ollama launch opencode、pi、codex、vscodeでハーネスに接続できます。詳しくはOllamaガイドにあります。LM Studioには、最低24 GBのRAMを要する24.20 GBのGGUFがあります。速度はMLXのバーよりllama.cppのバーに近くなると考えてください。
3. GPUサーバー:SGLangまたはvLLM。 Hugging Faceのリポジトリには、約80 GBのBF16チェックポイントと、1枚のB300またはH200で1レプリカを動かすSGLangの提供キットがあります。このリポジトリにはすでに93のコミュニティ量子化と14のファインチューンが集まっており、Recursive公式のビルドがスタックに合わなくても選択肢は豊富です。
4. 余分なハードウェアなし:無料のホスト型枠。 OpenRouterはrecursive/flint-v1.0:freeを無料で掲載しており、OpenCodeのモデルピッカーにも無料枠でFlint-40Bがあります。OpenRouterのページで最も利用が多いアプリはコーディングエージェントで、Kilo Codeは1週間で32.9Bトークン、Clineは12.2Bを流しました。Flintのスタイルが自分に合うかだけ見たいなら、これが5分でできるテストです。
どの経路を選んでも、Recursiveが勧める最初のタスクは良いものです。知っている小さなリポジトリを開き、Flintに関数を1つ説明させ、テストを追加し、そのテストで見つかった問題を直します。各ステップの後にdiffを確認してください。
Recursive Flintの料金は?
ライセンスの面では無料です。重みはApache 2.0で商用利用も無料、2つのホスト型経路も現在は無料です。実際のコストはハードウェアと電気代で、そこでFlintはひそかに費用を節約します。GPUラックではなく48 GBのMac 1台で済み、そのMac上で密な競合の10倍の速度で動くモデルは、すでに持っているマシンの1時間あたりでより多くの仕事をこなします。
| 経路 | 価格 | 制限 |
|---|---|---|
| Hugging Face上の重み | 無料(Apache 2.0) | BF16で約80 GB、MacとNVIDIA向けの量子化ビルド |
| Mac上のrec | 無料 | M4/M5 ProまたはMax、48 GB以上、単一セッション |
| Ollama / LM Studio | 無料 | 最小のGGUFで最低24 GBのRAM |
OpenRouter flint-v1.0:free | 入力$0、出力$0 | プロバイダーは1社、容量とレート制限あり |
| OpenCode無料枠 | $0 | 容量とレート制限あり |
| Recursiveの直接API | 非公開 | 一部のパートナーのみ |
長いエージェント型コーディングセッションがタスクあたり数ドルに達することもあるホスト型のフロンティアモデルと比べてみてください。Kimi K3.1 Proの料金の解説では、タスクあたりのコストを約$2.11としています。1日に数十件の小さく範囲の明確なタスクを回すなら、十分に良い無料のローカルモデルは、収支をあっという間に変えます。
Recursive Flintを使うべき人、見送るべき人は?
私の結論です。決め手は、考える作業のどれだけを自分で引き受けられるかです。
Flintを使うべき人:
- オフラインで動き、コードを手元のマシンに留めるコーディングエージェントが欲しく、48 GBのM4またはM5 Pro/MaxのMacを持っている。
- すべてのdiffを読みながら対話的に作業し、1分でわずかに良い答えを返すモデルより、数秒で答えるモデルに価値を感じる。
- オープンウェイトの上に構築しており、ファインチューンや再配布のために商用に寛容なライセンスが必要。これは、チームがオープンソースAIエージェントを選ぶのと同じ理由です。
当面は見送るべき人:
- 回答ごとに最強のローカルモデルが欲しい。27B密のQwen 3.8は、速度が10分の1でも、ほとんどのコーディングテストで勝ちます。そのファミリーの他のライバルはQwenの代替リストで扱っています。
- ツール呼び出しが1回壊れると実行全体が無駄になるような、長時間の無人エージェントを動かす。
- サポートとSLAつきの有料APIが必要。それはまだ存在しないので、GitHub CopilotやWindsurfのようなホスト型ツールのほうが安全な選択です。
Flintをホスト型の選択肢と比べているなら、私のKimi K3.1 ProレビューとDeepSeek V4 Flashレビューが近い代替をカバーしており、AIコーディングアシスタントツールは、それらを動かすハーネスを扱っています。
今月ほかに見ておく価値のあるオープンモデルとしては、Nemotron 3.5 Bolt、LFM3、Nanbeige 4.3を参照してください。
より大きな話は、モデルではなくラボです。4か月足らずでゼロから作られた40Bモデルであり、研究の多くを自動システムが担ったという主張こそ注目すべき点です。Recursiveの賭けは、モデルが1つ出るたびにEureka Machineがより優れた研究者になる、というものです。Flint 2が同じ速度でQwenとの差を縮めれば、このレビューはずっと前向きになるでしょう。
サポートチームを率いる人にとってのFlint
Flintはインフラです。コーディングエージェントが動くための土台となるモデルです。サポート用のモデル選びだけでも別の問題で、カスタマーサポート向けLLMのガイドで扱っています。課題がコードベースではなくサポートキューなら、難しいのは最初からモデルではありません。難しいのはその周り全部です。ZendeskやFreshdeskへの接続、過去のチケットからの学習、いつ引き継ぐかの判断、そして顧客の目に触れる前に自信満々の誤答をしないことの証明です。eeselは長年、本番のサポートキューにAIエージェントを置いてきましたが、何度も学び直されている教訓は、どのロールアウトも本番前に過去のチケットでシミュレーションしなければならないということです。
それがeeselのAIチームメイトであり、サポートリーダーにはAIエージェントのツールキットよりも先にこちらを勧める理由です。モデルの周りに製品を組み立てるのではなく、決まった仕事のためにすぐ働ける従業員だからです。サポート向けはAIヘルプデスクチームメイトです。
たとえばSE Rankingは、製品ごとに1つ、3つのZendesk接続で3つのeeselエージェントを動かし、1か月で4,650件の会話を処理しました。そのうち約2,100件のライブチャットで、eeselが最初に応答しています。SamCartは、Freshdeskのチケット用に1つ、ウェブサイトのチャット用にもう1つのエージェントを動かし、280本のヘルプセンター記事から回答しています。
そして、ここで2つの世界が出会います。eeselにはCLIがあるため、Flint、Claude Code、Codexで動かすのと同じコーディングエージェントが、ターミナルからサポートチームメイトを操作できます。eesel activityで各チケットでエージェントが何をしたかを読み、eesel instructionsで常設ルールを変更し、eesel approvalsで待機中のアクションを承認します。すべてのコマンドはJSONを出力し、--dry-runを付けると、書き込みが送信される前にその正確な呼び出しを確認できます。ドキュメントは、ダッシュボードをクリックして回る代わりにCLIを使うようAIエージェントに伝えるところまで踏み込んでいます。自作との比較に興味があれば、AIエージェントCLIとMCPサーバーの方法を別記事にまとめています。
eeselを試す
素のモデルの上に自作せずに、ヘルプデスク用のAIが欲しいですか?eeselのヘルプデスクチームメイトは、数分でZendesk、Freshdesk、Gorgiasに接続し、過去のチケットとヘルプセンターから学び、誰かに回答する前にそれらでテストされます。すべての操作はアクティビティログに記録され、ダッシュボードで読むことも、CLIで取得することもできます。無料で始められ、カードは不要です。
