

TorchTPUは、MetaのPyTorchチームと共同で開発されたGoogleのCloud TPU向けオープンソースPyTorchバックエンドで、2026年10月20日にオープンソース化されました。TPUをtpuという通常のPyTorchデバイスとして登録するため、ほとんどのコードでは、移植はdevice="cuda"をdevice="tpu"にすることから始まります。Googleが今は非推奨と呼ぶPyTorch/XLAを置き換えるものです。
ライブラリはApache 2.0で無料で、支払うのはTPUの利用時間です。Ironwoodはオンデマンドでチップ時間あたり$12.00、flex-startで$6.00、Trilliumは$2.70です。Googleは、5,000件近いHugging Faceモデルの98%がそのまま動くと報告しています。ただし、バージョンは0.2.0で、torch.compileは依然として静的シェイプを強制し、Googleも「動く」と「速く動く」は別の量の作業だとはっきり述べています。
自前のPyTorchモデルを学習・提供しているなら、JAXを学ばずにTPUを試す価値が出てきたのは今回が初めてです。チケット対応のように、AIに仕事をしてほしいだけなら、チップの問題は飛ばして構いません。eesel AIチームメイトがモデル層を担当し、SamCartはFreshdeskとウェブチャットで4つを運用しています。
TorchTPUとは?
TorchTPUは、GoogleがGeminiの学習と提供に使うカスタムAIチップであるGoogle Cloud TPU向けのネイティブPyTorchバックエンドです。Googleは2025年半ばにMetaのPyTorchチームとプロジェクトを開始し、2026年4月にGoogle Developers Blogで紹介し、10月20日のPyTorch Conference 2026でオープンソース化しました。コードはgoogle-pytorch/torch_tpuにApache 2.0で公開されており、現在のリリースはPyPIの0.2.0です。
私はeeselで機能やAIエージェントを作っていて、週のほとんどをチップより上の層で過ごしています。だから、ある発表が「1行変えるだけ」と言うなら、その1行が実際にどう実行されるのかを読みに行きます。ここでの結論は、注釈つきの良いニュースです。その1行で確かにモデルは動き、そしてその後に待っている作業について、ドキュメントは珍しいほど正直です。
Google Cloudの発表は、目標をシンプルに示しています。TPUがGPUやCPUと並ぶPyTorchのネイティブな選択肢になる、ということです。Metaが中心的なパートナーで、そのPyTorchエンジニアリング担当ディレクターが発表記事で理由を説明しています。
"We cannot be constrained by a single hardware architecture."
Jana van Greunen、MetaのPyTorchエンジニアリング担当ディレクター、Google Cloudブログより
10月28日にリポジトリを取得した時点で、782スター、105人のコントリビューター、4,677コミットがあり、コミットは1時間ごとに入っていました。PyTorchブログによれば、すでに"used in production for both inference and training workloads for some of the largest Google Cloud customers."とのことです。
何が新しいのか:PyTorch/XLAとの決別
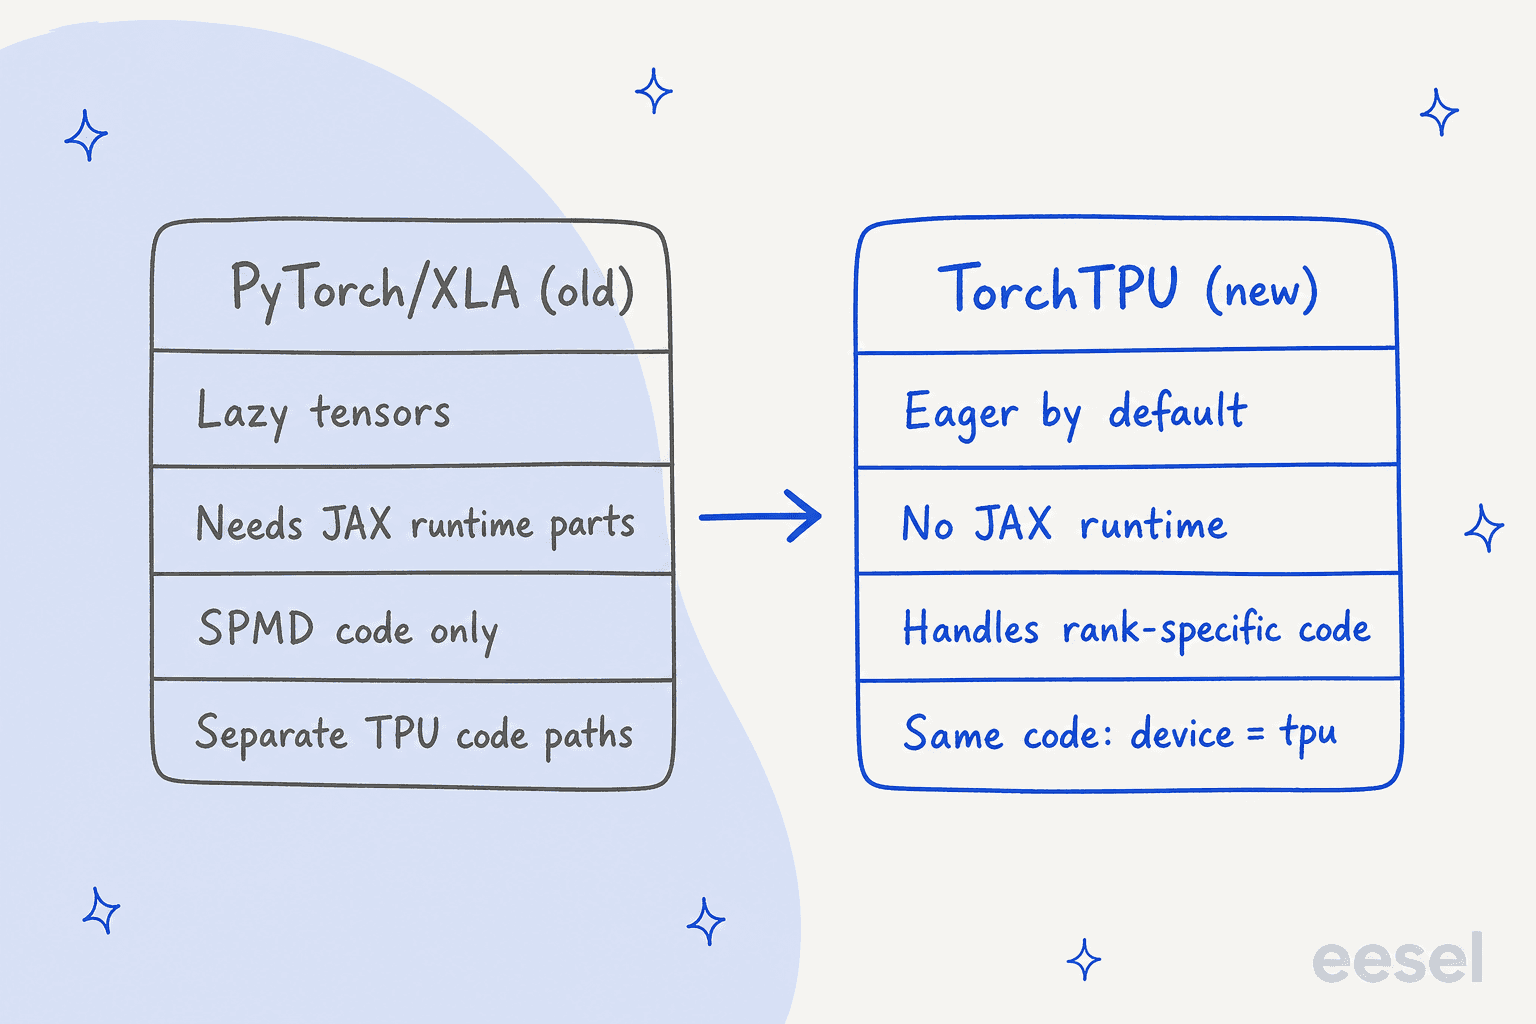
PyTorchは2020年からPyTorch/XLA経由でTPU上で動いてきたので、何が変わったのかは当然の疑問です。Google自身の答えはPyTorchブログで率直です。PyTorch/XLAはlazy tensorを使い、コンパイル可能な領域を示すために侵襲的なコード変更が必要で、コンパイル遅延が深刻で、本物のeagerモードがありませんでした。TorchTPUのFAQには現在、PyTorch/XLAは非推奨で、TorchTPUに置き換えられると書かれています。
旧スタックと付き合った人も同じように覚えています。4月のプレビューに関するHacker Newsのスレッドから:
"I did trained some research models using the existing PyTorch/XLA on TPUs, and it was a mess of undocumented behavior and bugs (silently hanging after 8 hours of training!)."

TorchTPUは、ツリー外ハードウェア向けのPyTorch公式の枠であるPrivateUse1に接続するため、TPUテンソルは通常のPyTorchテンソルになります。JAXランタイムへの依存はなく、PyTorchの「デバイスごとに1プロセス」モデルに従い、rank 0だけ少し余分な処理をするコードも扱えます。SPMD専用だった旧スタックにはできなかったことです。
もう1つの注目すべき変化は、周囲のエコシステムです。Googleは、TorchTPUと同時に、vLLM(Inferactと)、SGLang(RadixArkと)、TorchTitan、Ray(Anyscaleと)、TorchRec向けのバックエンドを出荷し、Hugging FaceのTransformers v5とDiffusersでのネイティブ対応も実現しました。Hugging Faceは、Optimum TPUラッパーはもう不要だと言っています。
タイミングにも注目に値します。AWSは、Trainium向けのネイティブPyTorchバックエンドであるTorchNeuronを、同じ日に同じカンファレンスで発表しました。両クラウドとも同じ結論に達したのです。コードが存在するのはPyTorchなので、チップはPyTorchデバイスに見えなければならない、と。
TorchTPUの仕組み
内部では、TorchTPUには2つの経路があり、どちらもGoogleのXLAコンパイラに行き着きます。eager経路は、PyTorchディスパッチャに登録されたC++バックエンドです。コンパイル経路は、GPUのようにTorchInductorを通すのではなく、FXグラフ全体を1つのStableHLOプログラムに変換するTorchDynamoバックエンドです。
TorchTPU入門ドキュメントによると、eagerモードには3つの設定があります。
- Strict(既定)は、GPU上のPyTorchと同様に、ATen演算を1つずつ非同期でTPUに送ります。
- Debug(
TORCH_TPU_LAUNCH_BLOCKING=1)は、境界チェック付きで各演算を同期的に実行します。CUDA_LAUNCH_BLOCKINGのTPU版です。 - DeferAndFuse(
TORCH_TPU_DEFER_AND_FUSE=1)は、.cpu()や.item()のように値が必要になるまで演算を保留し、そこでまとめて融合・コンパイルします。Googleによれば、Strictより50%以上高速になり得て、HBMメモリの使用量も減ります。
3つとも、3階層のコンパイルキャッシュを共有します。プロセスごと、1ホスト内のプロセス間共有、そしてCloud Storage上の任意の永続層です。この永続層により、フリート全体が再起動のたびに同じグラフを再コンパイルせずに済みます。
**torch.compile(model, backend="tpu")**が本番向けの経路です。引き換えに厳格さが求められます。XLAは静的シェイプを求めるため、TorchTPUは現在、自動でdynamic=Falseに設定します。Googleは、最大サイズを与えればグラフを1回だけコンパイルする「bounded dynamism」を開発中です。初期テストでは、839件の因果LLMのうち834件で正しい結果が出ましたが、機能表ではまだ実験的とされています。
損失曲線を比べる前に知っておきたい精度の違いもあります。TPUの行列演算ユニットはbfloat16で乗算してFP32で累積するため、TorchTPUは既定で「medium」精度を使い、CUDA上のPyTorchは既定で完全なFP32を使います。「high」や「highest」も指定できますが、行列演算のコストはおよそ3倍と6倍になります。
カスタムカーネルについては、TorchTPUはPallas(JAX由来のGoogleのカーネル言語)とTokamaxカーネルライブラリを本番対応、PyTorchのポータブルなカーネルDSLであるHelionを実験的としてサポートしています。カスタムCUDAカーネルは引き継げません。
各層がどれだけ効くかを見るために、PyTorchブログはFLUX画像モデルをスタックの各段階で順に見ていきます。
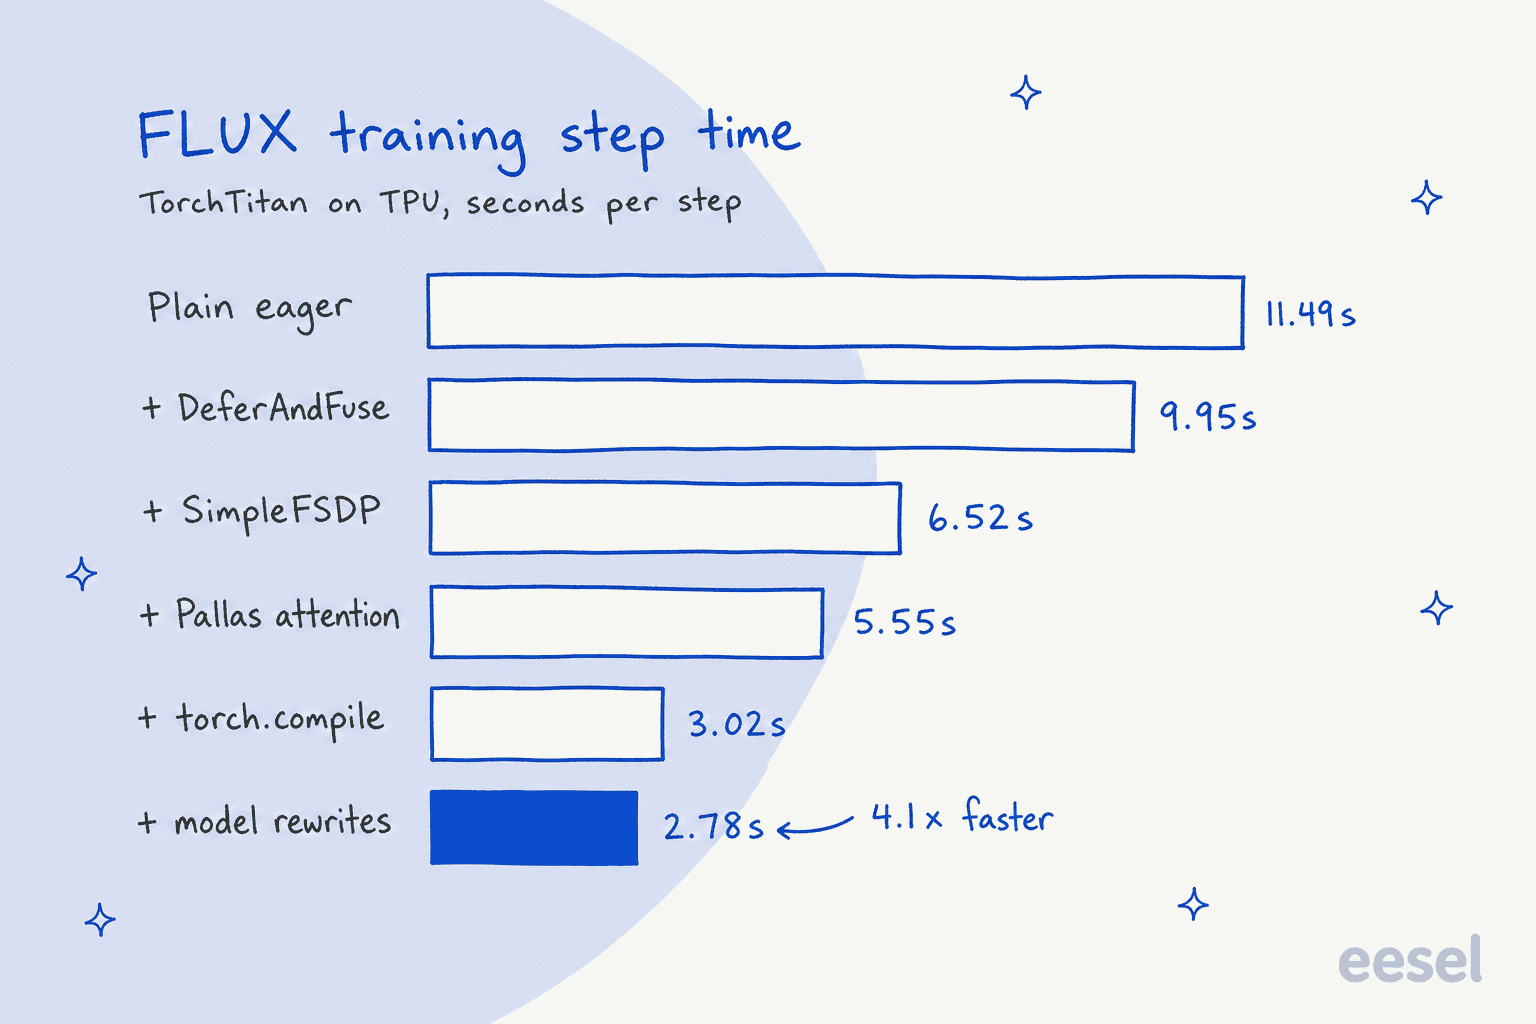
私にとって、このグラフは「1行」という売り文句の正直な版です。1行で手に入るのは11.49秒のステップです。2.78秒のステップには、さらに5段階の作業が必要で、torch.compileだけでも最大の単独ジャンプです。
コード変更の中身
入門ガイドは、Python 3.11以降を使うTPU VM(v6eが最も簡単)で動かします。
pip install torch_tpu==0.2.0 --extra-index-url https://download.pytorch.org/whl/cpu
追加のインデックスは残してください。ないと、pipはPyTorchのCUDA版を取得しますが、それははるかに大きく、TPUでは役に立ちません。そのうえで、デバイスを変更します。
import torch
device = torch.device("tpu")          # was "cuda"
model = MyModel().to(device)
compiled = torch.compile(model, backend="tpu")   # optional, for speed
分散ジョブでは、2つ目の変更があります。dist.init_process_group(backend="nccl")はbackend="tpu_dist"になり、TorchTPUには、通常のtorchrunが知らないTPU固有の設定が2つ(スライスのトポロジーとチップのアドレス)必要です。1つのコマンドがそれらを出力してくれます。
eval $(python -m torch.tpu.distributed | sed 's/^/export /')
torchrun --nproc_per_node=8 train.py
Hugging Faceのモデルなら、さらに短くなります。Hugging Faceの発表記事によれば、AutoModelForCausalLM.from_pretrained(model_id, device_map="tpu")で重みが直接TPUに読み込まれ、Diffusersのパイプラインはpipe.to("tpu")だけで済みます。
つまり、私がこれまで取り上げたほとんどのオープンモデル、たとえばQwen、Gemma 4、DeepSeek V4 Flashは、device_mapひとつでTPUに載せられます。
Googleは、プレビュー版のTPUエージェントスイートも出荷しました。コーディングエージェント(現在はClaude CodeとAntigravity、CodexとCursorは"coming soon")にインストールして、オンボーディング、プロファイリング、推論チューニングを担わせるスキルです。この種の移植がどこに向かうかを示すサインです。このような機械的な置き換えは、Claude CodeやOpenAI Codexが得意とする作業で、コンパイルログは自分で読むことが前提です。
TorchTPUの料金は?
ライブラリは無料です。TorchTPUはApache 2.0で、PyPIからインストールできます。支払うのはTPUの利用時間で、GoogleはCloud TPUの料金ページでチップ時間あたりで価格を設定しています。課金はTPUノードがREADY状態にある間続くため、忘れて放置したアイドル状態のノードにも課金されます。
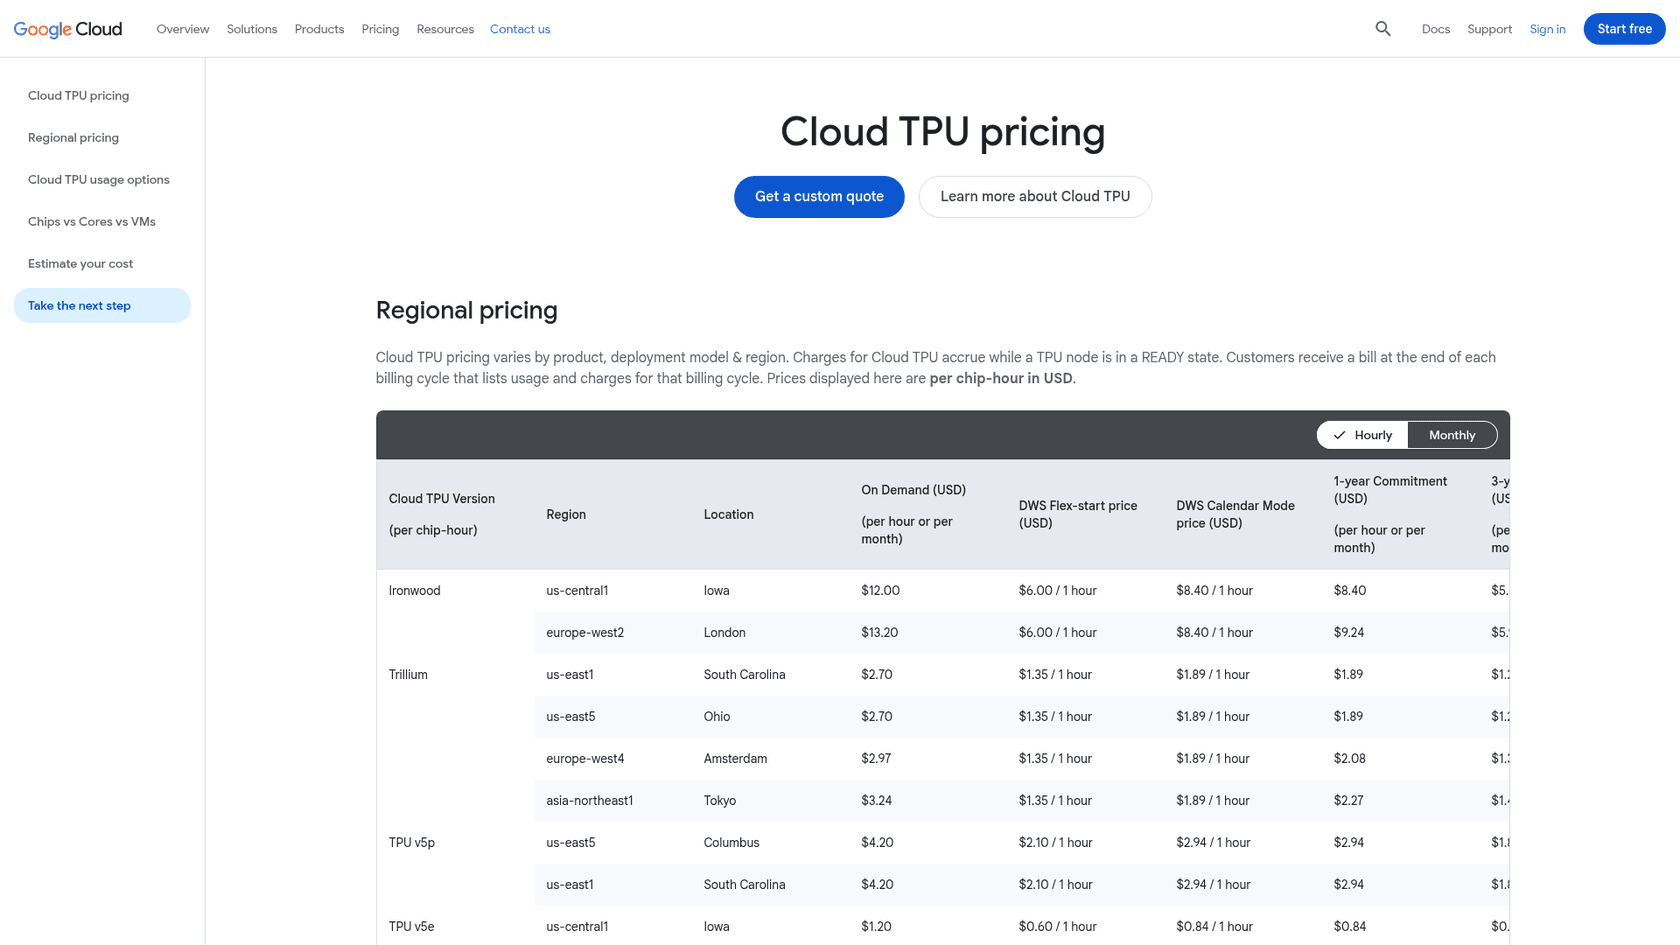
以下は、TorchTPUが対応する4世代の米国料金で、2026年10月28日に確認したものです。
| TPU | リージョン | オンデマンド | DWS Flex-start | 1年コミット | 3年コミット |
|---|---|---|---|---|---|
| Ironwood (v7) | us-central1 | $12.00 | $6.00 | $8.40 | $5.40 |
| Trillium (v6e) | us-east1 | $2.70 | $1.35 | $1.89 | $1.22 |
| TPU v5p | us-east5 | $4.20 | $2.10 | $2.94 | $1.89 |
| TPU v5e | us-central1 | $1.20 | $0.60 | $0.84 | $0.54 |
Flex-start(GoogleのDynamic Workload Schedulerの一部)は、どの世代でもオンデマンド料金の半額で、その代わりに空き容量ができるまで待つことになります。Google Cloudコンソールの課金はチップ時間ではなくVM時間単位なので、複数チップのVMでは表より大きな数字が表示されます。ヨーロッパとアジアのリージョンは高く、Ironwoodはロンドンのオンデマンドで$13.20です。
ただし、チップ時間は仕事量の単位ではありません。ここが見落とされがちな点です。Ironwoodのチップ1つはPyTorchデバイス2つとして見え、GPU、Trainium2チップ、TPUは、1時間あたりにこなす仕事量がそれぞれ違います。Googleが引用している唯一のサードパーティの数値は、SemiAnalysisのInferenceXベンチマークによるもので、vLLM-TorchTPUを使うTPU v7が8K/1KテストでQwen 3.5を100万トークンあたり2.01セントで提供しました。これは自分のモデルをベンチマークする理由と受け取るべきで、あなたの価格ではありません。
現在存在するネイティブPyTorchバックエンド間でチップあたりの価格を比べるには、アクセラレーターを選んでください。
チップを選んで、定価とバックエンドを比べてください。価格はGoogle Cloud TPUとAWS Capacity Blocksの料金ページに基づいており、チップ時間あたりでこなせる仕事量はチップごとに異なります。
比較のGPU側については、CoreWeaveの料金とLambdaの料金の解説でネオクラウドを、AWSの料金ガイドでTrainiumの本拠地を扱っています。
ベンチマークとモデルの対応範囲
Googleは今回の発表で、AWSがTorchNeuronで出したよりも多くの数字を公開しており、そのほとんどが実際に役立ちます。まず対応範囲から見ましょう。0.2.0のリリースでは、速度よりも「自分のモデルがそもそも動くか」の方が重要だからです。PyTorchブログによれば、Googleは人気のHugging Faceモデル約5,000件を、eagerモードとコンパイルモードで継続的にテストしています。
| テスト | 結果 |
|---|---|
| エンドツーエンドでテストしたモデル | 500以上のアーキテクチャファミリーにわたる4,917件 |
| クラッシュせずに動作 | 98%(4,917件中4,821件) |
| 数値がGPUと一致 | 97%(代表的な657モデル中638件) |
| Bounded dynamism、正しい数値 | 99%(因果LLM 839件中834件) |
最初に見るべきは、数値一致の行だと思います。eeselでは、「動く」と「正しい答えを出す」は別のテストだと痛い目を見て学びました。サポートエージェントはデモでは見事でも、実際のチケットでは自信満々に間違った答えを出すことがあり、だからこそ、すべての導入はまず顧客の過去のチケットでシミュレーションされます。Googleがクラッシュの有無だけでなく、出力をGPUのベースラインと照合していることは、コンパイラ版の同じ習慣です。
速度については、3つの結果が目立ちます。
- カスタムカーネルなしの素のPyTorch。 標準モジュールで書かれた純粋なPyTorchのMuse Glimmer 30Bは、TPU v7チップ1つでprefillのMFU 59%、4つで学習のMFU 38%に達しました。TorchTitanチームがGPU向けに書き、最小限の移植をしたバージョンは36%でした。
- JAXに近い性能。 TorchTitanのQwen3 MoE 235Bは、TPU v7チップ64個で毎秒1,828トークンを処理し、MaxText上のJAXで同じモデルを動かした場合の1,937に対して約94%で、Googleの本家フレームワークに迫る数字です。
- スケール。 同じモデルを1,024から8,192個のIronwoodチップにスケールしても、MFUは28.8%から27.1%にしか動きませんでした。GoogleのCloudブログは、Qwen 3 8Bで最大52%のMFUも挙げています。
推薦モデルにも独自の結果があります。TPU v7xチップ32個でのDLRM v2は、埋め込み検索にTPUのSparseCoreを使い、GoogleがチューニングしたJAX版と同じ18.3 msのステップ時間に達しました。これらはすべてGoogleのハードウェア上でのGoogle自身の数字なので、独立した結果が出るまでは上限値として扱います。
TorchTPUがまだできないこと
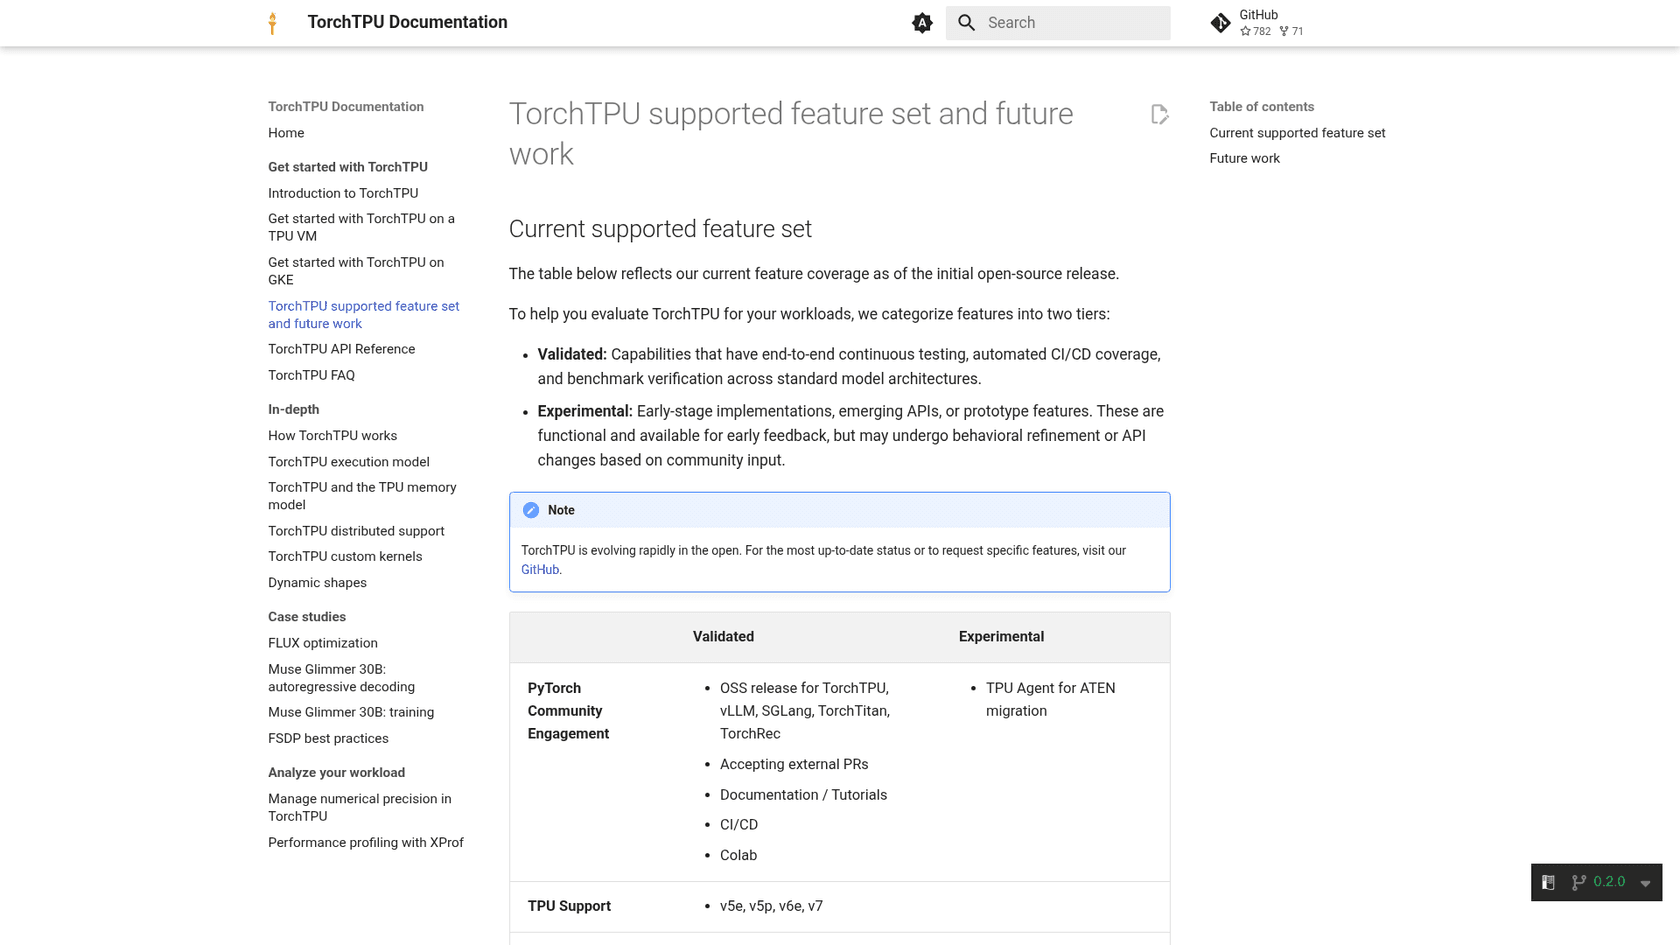
Googleは、不足点について率直です。機能表はすべてを「Validated」と「Experimental」に分けており、PyTorchブログは粗い部分を詳しく挙げています。
- compile下での動的シェイプ。
torch.compileは現在dynamic=Falseで動きます。可変のバッチサイズやシーケンス長は、bounded dynamismが出るまで、パディング、バケット化、再コンパイルを意味します。 - FlexAttention。 まだ非対応です。GoogleはGPUモデルを移植する際、
F.scaled_dot_product_attentionに置き換えました。 - 分散処理のエッジケース。 FSDPv2とrankごとに異なるコード(MPMD)は動きますが、「low perf」と記されています。既定の「skinny collectives」はエンドツーエンドで30〜40%のコストになり得ます。
@spmd_safeデコレーターやSimpleFSDPで取り戻せます。 - TPUデバイスごとに1プロセス。 TPUは1つのプロセスからしか開けないため、トレーナーとサンプラーを同じチップに同居させるRL構成は、そのままでは動きません。
- GPU向けの形のモデル。 TPUの行列ユニットは128や256の次元を好みます。アテンションヘッドを64に固定するモデルは、よくあることですが、動くものの速度を取りこぼします。
- まだチューニング中のモデルファミリー。 GLM、Kimi、DeepSeek、GPT OSS、Mamba、LSTM/GRUは実験的とされています。フルスケールの事前学習は"future exploration"で、推論とファインチューニングが本番対応の作業です。
より大きな限界は、コードにはまったくありません。TPUはGoogle Cloudのチップ(加えて非常に大きな顧客向けのオンプレミス契約)であり、379ポイント、93コメントのHacker News発表スレッドでは、この話に何度も戻っていました。
"TPUs are unobtanium so while I appreciate Google's effort here I also recognize that it is not something that will be useful to me."
オンプレミスのTPUを評価したチームの別のコメント投稿者は、購入者側の視点を一言でまとめました。
"We've evaluated them but decided to stick with Nvidia, at least for one more generation."
そして4月のプレビューに関して、ある返信はマーケティングよりも正確にこの売り文句を言い表しました。「just change one line and it works」は、「just change one line and you will get peak performance on the TPU」と同じ約束だったことはありません(xrikcus, Hacker News)。これはGoogle自身のドキュメントと一致しており、良い兆候です。
他のモデル実行方法とTorchTPUの比較
自前のPyTorchモデルを学習・提供するチームにとって、選択肢は今こうなっています。
| 選択肢 | 管理するもの | コード変更 | 向いているケース |
|---|---|---|---|
| Cloud TPU上のTorchTPU | TPU VMまたはGKE、コンパイルキャッシュ、シェイプ | "tpu"、tpu_dist、compile用の静的シェイプ | 大規模で安定したジョブを持つGoogle Cloudのチーム |
| AWS Trainium上のTorchNeuron | インスタンス、コンパイルキャッシュ、シェイプ | "neuron"、compile用の静的シェイプ | AWSにコミットしているチーム |
| NVIDIA GPU(CoreWeave、ハイパースケーラー) | インスタンスまたはクラスター | CUDAコードなら不要 | カスタムCUDAカーネル、最速の立ち上げ |
| サーバーレスGPU(Modal、Baseten) | 自分のモデルコード | 小さなラッパー | 容量計画なしの断続的な推論 |
| ホスト型モデルAPI(Groq、Fireworks AI) | なし | APIコールのみ | ハードウェアに触れずにオープンモデルを使う |
最初の2行は、かつて「JAXで書き直す」「学習スタックを書き直す」と書かれていました。今ではGPUの行にかなり似ており、それが両方の発表の狙いです。どれを選ぶかは、主に今どのクラウドに支払っているかと、必要なときにどのチップが空いているかで決まります。
自前のサービングスタックではなく、Google Cloud上のエージェントが最終目標なら、GoogleのAgent Development KitとGemini APIはこれらすべての1層上に位置し、Gemini自体もTPUで学習・提供されています。
TorchTPUが向いている人
TorchTPUは、すでにPyTorchを書いていて、Google CloudでTPUの容量を確保でき、パイロットが元を取れるほどアクセラレーターに費やしているチーム向けです。研究チームは、eagerモードとDebug設定から最も恩恵を受けます。TPUがデバッガ上でようやく他のデバイスと同じように振る舞うからです。推論チームは、vLLM-TorchTPUとSGLang-TorchTPUから最も恩恵を受けます。同じサーバーとAPIのまま、下のハードウェアだけを入れ替えられます。
カスタムCUDAカーネルに依存するコードの場合、コンパイルモードで今すぐ動的シェイプが必要な場合、TPUクォータを確保できない場合は向きません。そして、モデルの重みにまったく触れないなら、やはり向きません。eeselでお話しする企業のほとんどは、この最後のグループです。AIに仕事をしてほしいのであって、どのチップで動くかは他の誰かが決めることです。
eeselの位置づけ:これはインフラ、eeselは従業員
TorchTPUは、ハードウェア層を試すコストを下げ、切り替えやすくします。これはモデルを作るすべての人にとって良いことで、時間とともにAI製品の運用コストを下げます。しかし、チケットに返信したり、ブログ記事を書いたりはしてくれません。それらは仕事であり、仕事にはコンテキストが必要です。ヘルプセンター、過去のチケット、返金ルールといったものです。
eeselが働くのはその層です。eeselはAIチームメイトのプラットフォームで、特定の仕事のためにすぐに働けるチームメイトを採用できます。現在はAIヘルプデスクチームメイトとAIブログライターがあります。ヘルプデスクチームメイトは既存のキューに加わり、ヘルプセンターと過去のチケットから学習し、実際の顧客に返信する前に、過去の会話でテストされます。
SamCartは、実際にどうなるかを示しています。eeselをFreshdeskとウェブチャットで運用し、チャネルごとに別々のエージェントが約280件のヘルプセンター記事から回答しています。Freshdeskのエージェントは、担当者がチケットを引き継ぐまでの最初の返信だけを送り、月8,000件のインタラクションのプランでカバーできています。
金地金の事業者向けに取引ソフトウェアを作っているOroSoftは、慎重な使い方をしています。サポート担当者がFreshdeskのチケットでeeselにメンションすると、約6,100件の解決済みチケットに基づき、出典を明記した下書きが返ってきます。回答を裏づける情報がなければ、推測せずに人間を求めるメモを残します。これは、Googleの数値一致チェックと同じ規律を、顧客への返信に適用したものです。
固定したpipインデックスからバックエンドをインストールしたばかりの読者なら、おそらくこちらもターミナルから設定したいはずです。eesel CLIは、ダッシュボードと同じチームメイトとワークスペースを操作します。npx @eesel/cli init chat-bubble --site https://your-site.comは、エージェントを作成し、ウェブサイトにチャットバブルを追加し、アカウントなしでサイトの読み取りを始めます。その後はeesel loginでワークスペースが維持されます。そこから、eesel integrations connect freshdeskでヘルプデスクを接続し、eesel files uploadで知識を追加し、eesel chatでエージェントと会話し、eesel approvalsで保留中のアクションを承認できます。
この設計だからこそ、GoogleのTPUエージェントスイートが連携するのと同じように、コーディングエージェントとも連携できます。Claude CodeやCursorのようなエージェントが、セットアップを実行し、結果を読み、失敗した部分を修正できます。すべてのワークスペースはMCPサーバーでもあるため、同じエージェントがeeselに直接問い合わせることもできます。設定する場合は、Claude Code CLIリファレンスをご覧ください。

上のログは、eesel activityがターミナルに新しい順で出力する内容です。料金はサポートチームがすでに数えている単位で示されています。料金ページでは、チケット1件またはチャット1件が1クレジットで、プランは月$299で500クレジットから、無料プランでは100クレジットですべてを試せます。
eeselを試す
TorchTPUを使えば、自分のモデルに最も安いチップを選べます。eeselを使えば、サポート業務ではその判断を省けます。Freshdesk、Zendesk、Gorgiasにつなぐヘルプデスクチームメイトが、過去のチケットから学び、本番の会話に触れる前に過去の会話で実力を証明します。技術的な質問が多いSaaSチームなら、AIヘルプデスクAPIとCLIで、セットアップ全体をスクリプト化できます。eeselを無料で試すか、ターミナルからnpx @eesel/cliで始めてください。
よくある質問
TorchTPUとは何ですか?
tpuデバイスを追加するため、eagerモード、torch.compile、torch.distributedがTPU v5e、v5p、Trillium、Ironwoodで動作します。2026年10月20日にオープンソース化されました。これはチップの層の話です。仕事をこなすAIが欲しいなら、スタックの反対側にはAIチームメイトがあります。TorchTPUは無料ですか?
torch_tpuとしてインストールできます。支払うのはそれが動くTPUの利用時間で、TPU v5eはチップ時間あたり$1.20、Ironwoodはus-central1のオンデマンドで$12.00です。チップを動かしたくない場合の、Googleの請求のうちモデル側についてはGeminiの料金ガイドで解説しています。TorchTPUはPyTorch/XLAを置き換えますか?
torch.compileバックエンドと同じフロントエンドであるTorchDynamo経由でコンパイルします。AWSもTrainium向けにTorchNeuronで同じ動きをしました。TorchTPUは本当にコード1行の変更だけで済みますか?
"cuda"を"tpu"に、backend="nccl"をbackend="tpu_dist"に変えます。速く動かすとなると、そうはいきません。Google自身のドキュメントにも、モデルのシェイプ、シャーディング、演算はGPU向けに調整されている可能性があると書かれており、最高速度を出すにはコンパイル作業、より広いアテンションヘッド、Pallasカーネルが必要です。Claude Codeのようなコーディングエージェントはその移植の多くを担え、GoogleはそのためのTPUエージェントスイートも提供しています。TorchTPUはどのTPU世代に対応していますか?
TorchTPUはHugging Face Transformersで動きますか?
device_map="tpu"でモデルをそのままTPUに読み込み、Diffusersはpipe.to("tpu")で動きます。Googleは、テストしたHugging Faceモデル4,917件のうち98%がクラッシュせずに動くと報告しており、Hugging FaceはOptimum TPUはもう不要だと述べています。このプラットフォームについてはHugging Faceの概要でさらに詳しく書いています。TorchTPUはAWS Trainium上のTorchNeuronとどう違いますか?
torch.compile、当面は静的シェイプです。TorchTPUはTPU 4世代に対応しXLAに変換し、TorchNeuronはTrainium2とTrainium3に対応しNeuronコンパイラに変換します。Trainium2のチップ時間あたり料金はEC2 Capacity Blocksで$2.235で、オンデマンドのTrilliumとv5pの間に入ります。この請求の残りの部分はAWSの料金解説をご覧ください。