

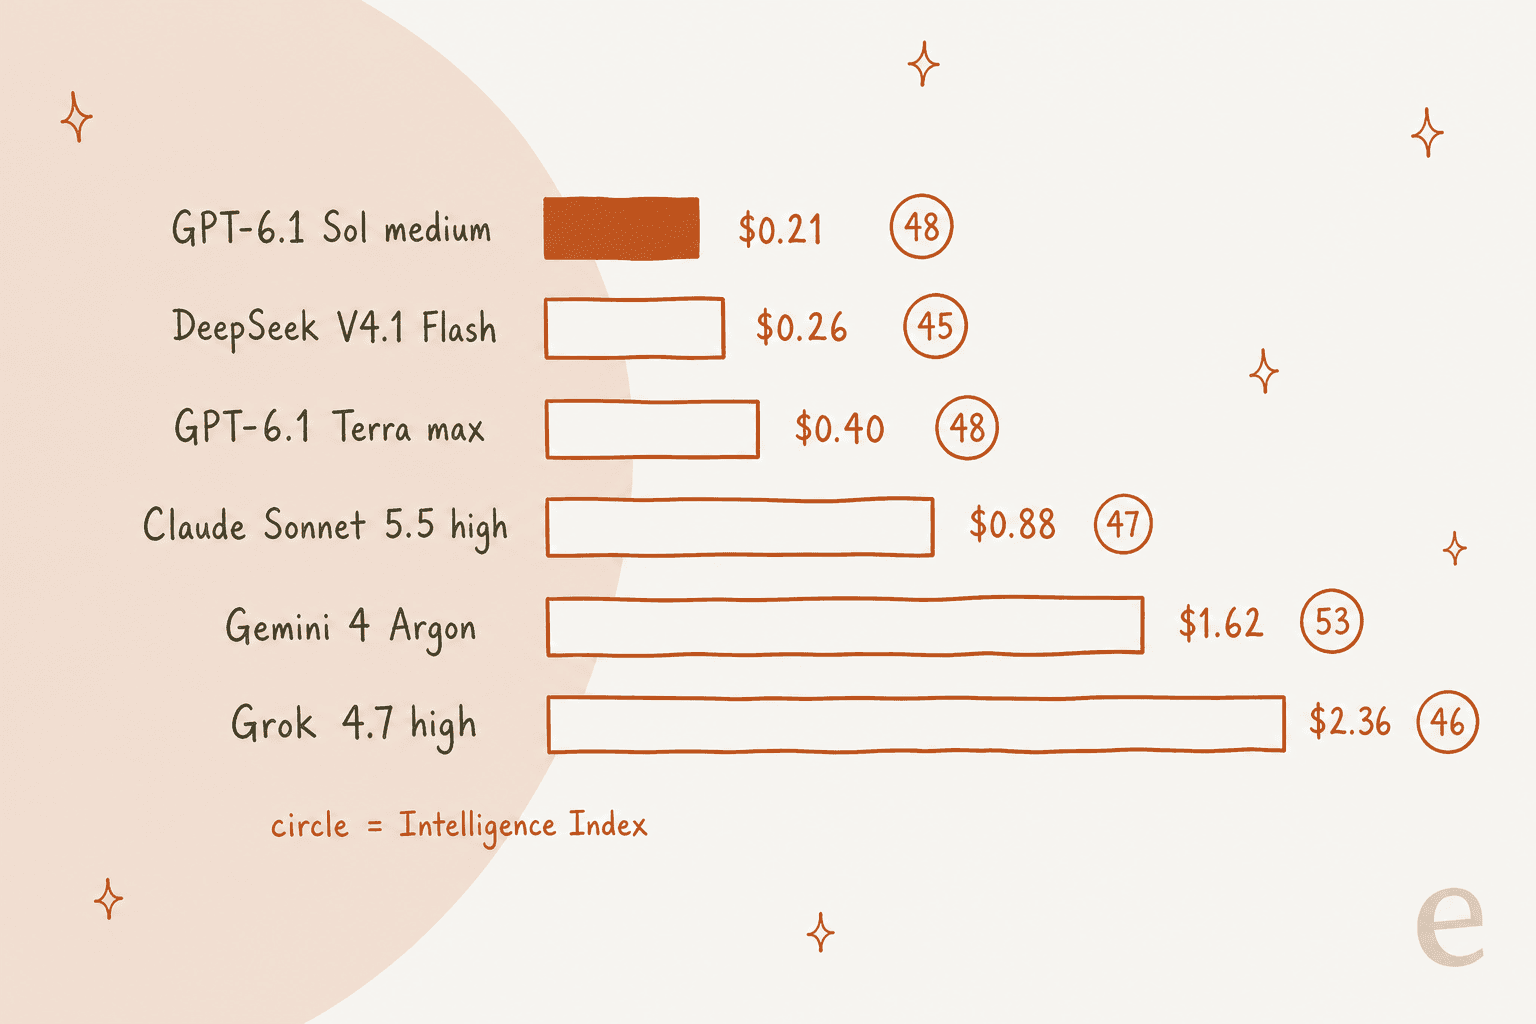
ほとんどのチームにとって GPT-6.1 Terra の最良の代替は、中程度の負荷設定の GPT-6.1 Sol です。Sol はトークンあたりの価格が2倍なので逆に聞こえますが、タスクあたりで見ると話が変わります。Artificial Analysis では Sol medium が 47.8 で1タスク $0.21、Terra max が 48.1 で1タスク $0.40 です。Terra を最大負荷に上げようとしていたなら、代わりにモデルを替えてください。
OpenAI から離れたい場合は次のとおりです。コーディングとエージェントには Claude Sonnet 5.5($2/$10)、最も安い請求額には DeepSeek V4.1 Flash(オフピーク $0.15/$0.60、オープンウェイト)、最難関の推論には Gemini 4 Argon(12月1日に倍になるプロモ価格)です。月100万リクエストの場合、定価での請求額は DeepSeek の $480 から Sol または Sonnet の $7,000 までで、Terra は $3,500 です。
モデルをサポートキューに使うなら、モデルの重要度は思ったより低くなります。私の GPT-6.1 Terra レビューでは、Terra は16件中15件、Sol は16件を正しく処理し、唯一のミスは知能ではなくエスカレーションルールの問題でした。そのルールは eesel が担当する層にあり、Koffer.ch が Freshdesk 上ですべての返信を下書きとして運用しているのと同じ仕組みです。
なぜ GPT-6.1 Terra 以外を探すのか?
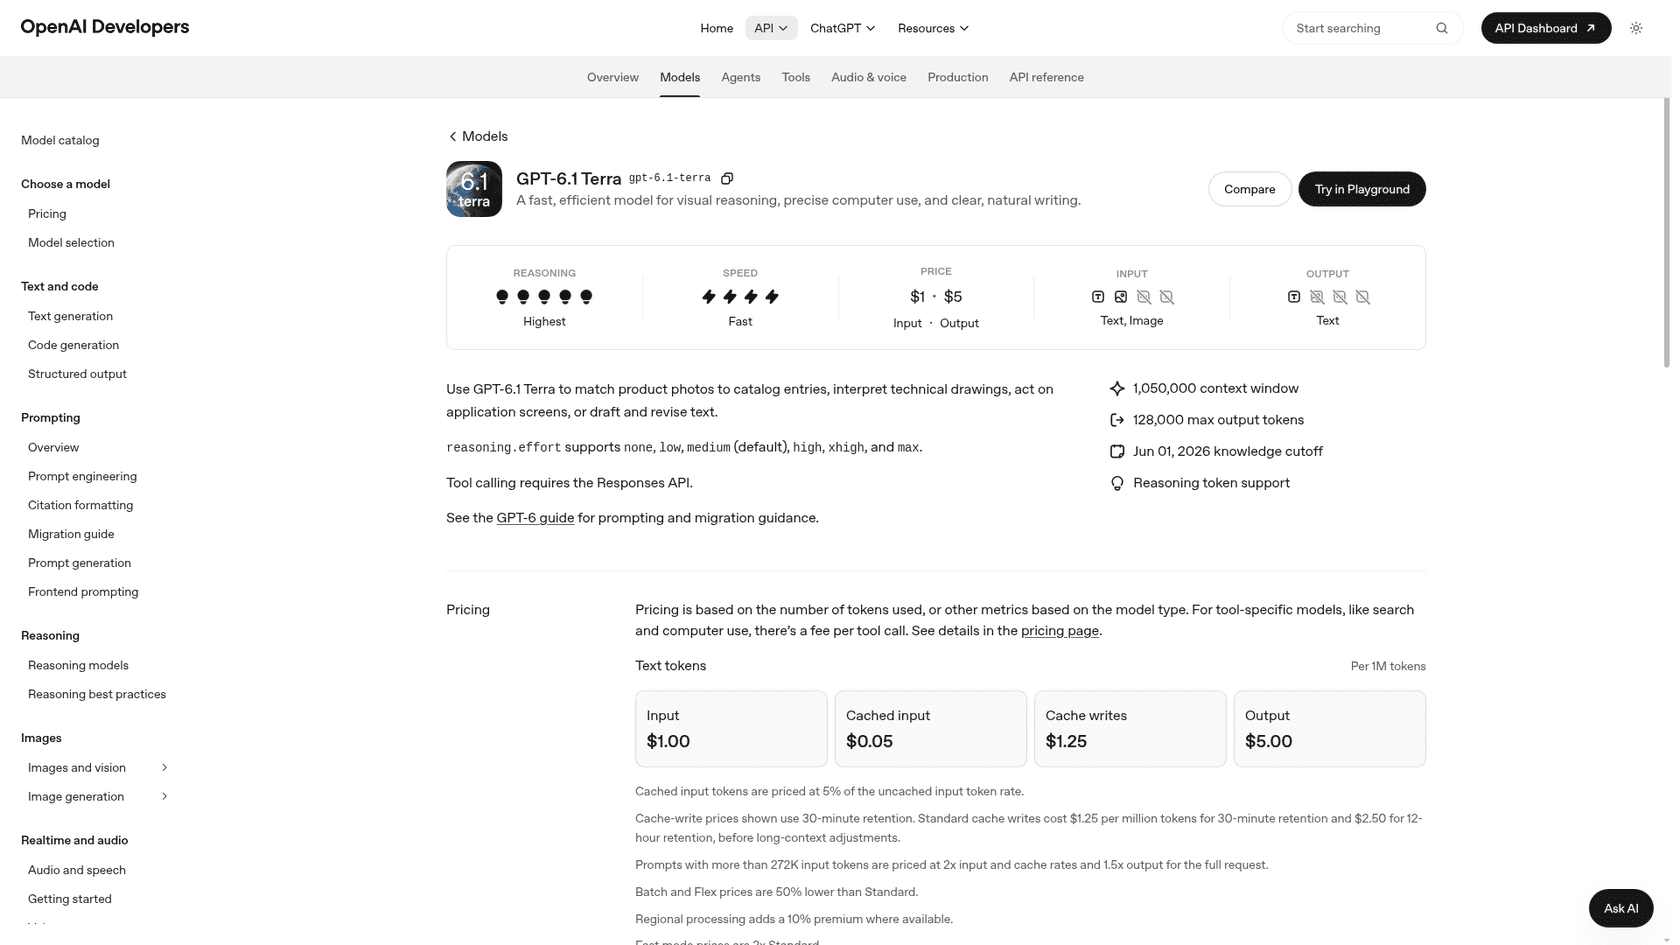
先に言っておくと、Terra は良いモデルです。GPT-6.1 Terra は2026年10月26日に、入力100万トークンあたり $1、出力100万トークンあたり $5 でリリースされました。コンテキストウィンドウは 1,050,000 トークンで、Sol や Astra にはない推論負荷 none もあります。私自身のサポートチケットでは、試した中で最速で、1件あたり 2.5s から 3.1s でした。
それでも別のモデルを探す人はいて、理由はたいてい次のどれかです。
- 負荷を上げると高くなる。 Terra の Intelligence Index は、低負荷の
36.2から max の48.1まで上がります。しかし Artificial Analysis によると、タスクあたりのコストは$0.05から$0.40に、タスクあたりの時間は29sから384sに増えます。最上位まで上げると、Sol ではないものに Sol の料金を払うことになります。 - コーディングとターミナル作業は大型モデルに劣る。 Hacker News のローンチスレッドでは、Terminal-Bench 4.0 が何度も話題になりました。あるコメントでは Terra max が 50%、Claude Opus 5.5 が 70% とされていました。
- 単一ベンダーのリスク。 プロダクト全体が OpenAI の1つのモデルに乗っていると、彼らの価格変更や障害がそのまま自分たちのものになります。
懐疑的なコメントが1点目をうまく言い表しています。
"Terra XHigh more expensive than Sol Low and still does worse."

そして、以下の表を読むあいだ常に念頭に置いておくべきコメントがこちらです。
"Per token, yes. But per task it's not even necessarily the case depending on how much thinking is needed."
選定と価格付けの方法
私は eesel の顧客のヘルプデスク上で動く AI エージェントを作っており、レビュー用の80チケットの Terra 評価も自分で実施しました。長年ライブのキューを扱ってきて、トークン価格は測るべき指標ではないと学びました。価格が半分でも再試行が2倍なら、本番では何も節約になりません。そこで、以下の各候補は次の基準で評価しました。
- 100万トークンあたりの定価: 2026年10月28日に各ベンダー自身の料金ページから取得。
- タスクあたりのコストと Intelligence Index: Artificial Analysis より。全モデルに同じテストスイートを走らせ、各モデルが実際に使った量を記録しています。
- ある購入者の月額請求: 月100万リクエスト、各リクエストが入力2,000トークン・出力300トークンのプロダクトを想定します。合計で入力20億トークン、出力3億トークンで、キャッシュと思考トークンは含みません。
購入者になったつもりで ChatGPT にも同じ質問をしました。候補リストは Sonnet 5.5、Gemini 3.6 Flash、DeepSeek V4.1 Flash、Gemini 4 Argon、Grok 4.7 でした。ほとんどはそのまま残しました。Gemini 3.6 Flash は 3.8 Flash に差し替え(同価格で新しいモデル)、ChatGPT が挙げなかった Sol と Haiku 5.5 を加えました。
GPT-6.1 Terra の代替モデル比較
| モデル | 入力 / 出力(100万あたり) | キャッシュ入力 | コンテキスト | AA Intelligence Index | AA タスクあたりコスト | 最初のトークンまでの時間 | オープンウェイト | 月額請求(購入者モデル) |
|---|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra(基準) | $1 / $5 | $0.05 | 1.05M | 48.1 (max) | $0.40 | 1.3s (low) | なし | $3,500 |
| GPT-6.1 Sol | $2 / $10 | $0.10 | 1.05M | 47.8 (medium) | $0.21 | 4.4s | なし | $7,000 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 1M | 46.8 (high) | $0.88 | 3.1s (medium) | なし | $7,000 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 オフピーク | $0.003 | 1M | 45.1 (max) | $0.26 | 1.2s | あり | $480(オフピーク) |
| Gemini 3.8 Flash | $0.75 / $3.75 12月31日まで | $0.075 | 1M | 40.9 (high) | $3.49 | 28.3s (high) | なし | $2,625 |
| Gemini 4 Argon | $2 / $10 11月30日まで | $0.10 | 1M | 52.6 (high) | $1.62 | 48.2s | なし | $7,000 |
| Grok 4.7 | $2 / $6 | 該当なし | 500K | 46.3 (high) | $2.36 | 5.4s (low) | なし | $5,800 |
| Claude Haiku 5.5 | $0.10 / $0.50 プロンプト100Kまで | $0.01 | 1M | 37.8 (high) | $0.08 | 26.7s (high) | なし | $350 |
目立つ点が2つあります。DeepSeek V4.1 Flash は請求額で Terra の約7分の1、指数では3ポイント以内に収まっています。もう1つは Gemini 3.8 Flash で、トークンあたりは安いものの、回答前に大量に考えるため、タスクあたりでは最も高い部類です。指数、タスクあたりコスト、最初のトークンまでの時間はすべて Artificial Analysis のモデルページのもので、括弧内の負荷設定での値です。
1. GPT-6.1 Sol
おすすめの用途: すでに OpenAI API を使っていて、連携コードを1行も変えずに判断力を上げたいチーム。
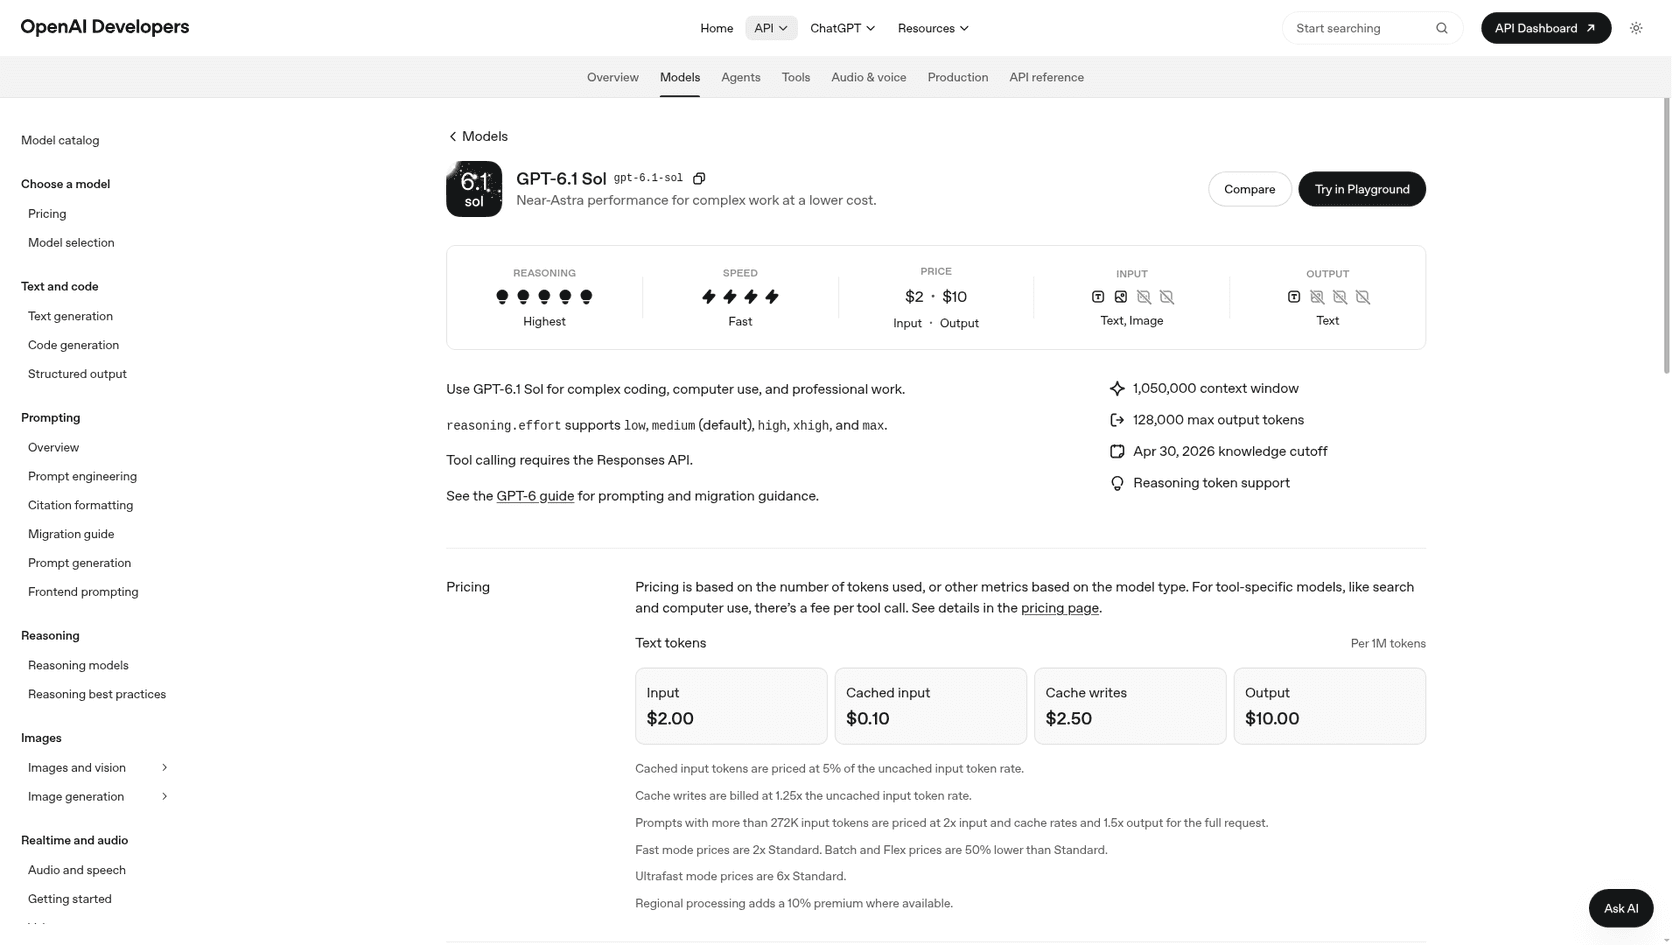
Sol は Terra の兄貴分と考えてください。OpenAI のラインナップで Terra と GPT-6 Astra の間、1段上に位置します。API、ツール、gpt-6.1 世代はすべて同じなので、切り替えはモデル名を変えるだけです。
長所
- 中程度の負荷の Sol は、Artificial Analysis の指数で Terra max に並び、タスクあたりのコストはおよそ半分です(
$0.21対$0.40)。 - 私のサポートテストでは判断力が最高で、16件中16件でした。対応できないスペイン語の住所変更をエスカレーションした唯一の構成でもありました。
- AA では、高負荷時の幻覚率は
49%で、Terra max の38%より高くなっています。つまり事実面で慎重なモデルではありません。強みはエッジケースの判断です。
短所
- 遅いです。AA の計測では medium で毎秒約
54出力トークンで、Terra の91より遅く、最初のトークンは4.4sで、Terra low の1.3sより遅くなります。 - 短くて簡単なリクエストは Sol のほうが高くなります。私のテストでは1,000チケットあたり
$1.62で、Terra low の$0.75と比べて高くなりました。 none負荷がないため、思考なしの高速経路はありません。
料金: OpenAI の料金ページによると、100万トークンあたり入力 $2、キャッシュ $0.10、出力 $10。バッチなら半額の $1/$5 です。
私の見解: 簡単な8割は Terra low に任せ、高負荷が必要になりそうなものは Sol medium にルーティングしてください。Terra からのアップグレード先は Terra max ではなく Sol です。詳しい数値は GPT-6.1 Sol のレビューにあります。
2. Claude Sonnet 5.5
おすすめの用途: コーディングツール、ターミナルエージェント、複数ステップのツール利用。
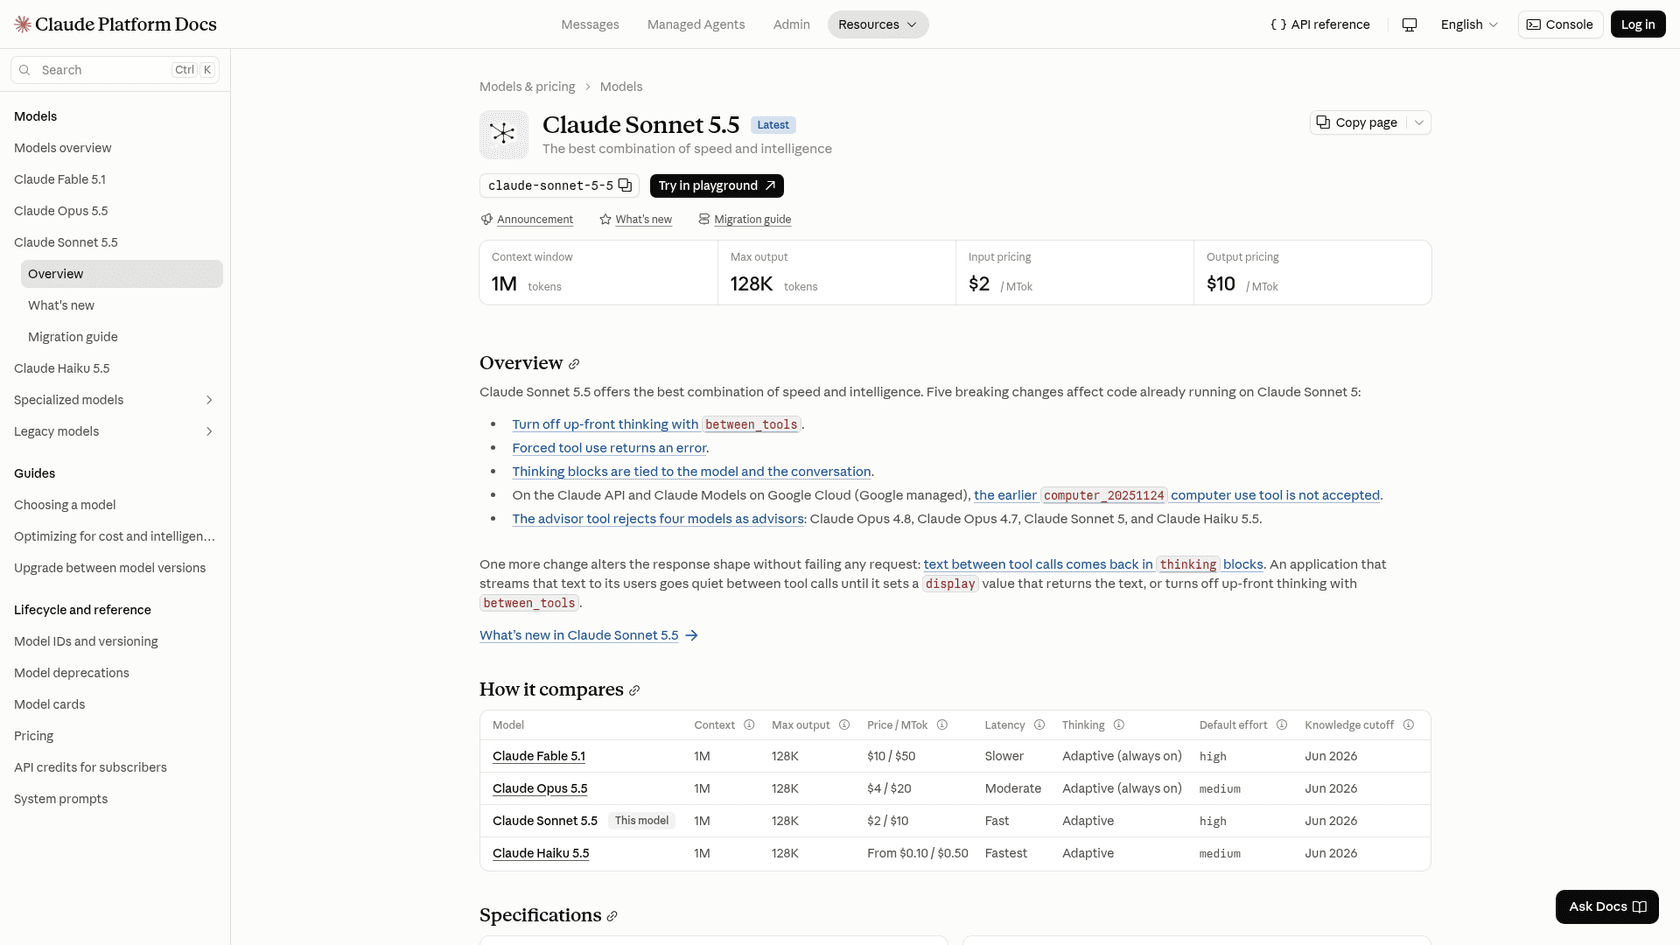
Anthropic の中位モデルで、2026年9月28日に登場しました。ChatGPT はこれを "best first alternative to test" と呼びましたが、エージェント用途ではその通りだと思います。
長所
- この価格帯で最高のコーディング数値です。Anthropic の報告では、Terminal-Bench 4.0 で
70.6%(Opus 5.5 の66.4%を上回る)、コンピューター操作の OSWorld 2.1 で80.1%です。 - 価格は Sol と同じ
$2/$10で、1M のコンテキストウィンドウと128Kの出力があります。 - 中程度の負荷では最初のトークンが速く(AA で
3.1s)、毎秒約107出力トークンです。
短所
- 高負荷では AA で1タスク
$0.88かかります。Sol medium の4倍以上で、指数スコアは低くなります。 - AA では高負荷時の幻覚率が
65%で、ここに挙げたクローズドモデルの中で最も高くなっています。 - 移行は簡単ではありません。Sonnet 5.5 では
thinking: disabledと強制のtool_choiceのどちらも 400 エラーを返すため、古い Claude モデル向けのコードは修正が必要です。
料金: Claude の料金ページによると、入力 $2、出力 $10、キャッシュヒット $0.10。バッチは $1/$5 です。
私の見解: プロダクトがコードを書く、実行する、あるいはブラウザを長時間操作するなら Sonnet 5.5 にしてください。下書きや抽出のような短いテキスト作業は、Terra や Sol のほうが1ドルあたりの成果が高くなります。さらに詳しくは Claude Sonnet 5.5 のレビューと Sol vs Opus 5.5 の比較をご覧ください。
3. DeepSeek V4.1 Flash
おすすめの用途: トークン費用が最大の制約になる大量のチャット、抽出、RAG、または自分でホストできるウェイトが欲しい場合。
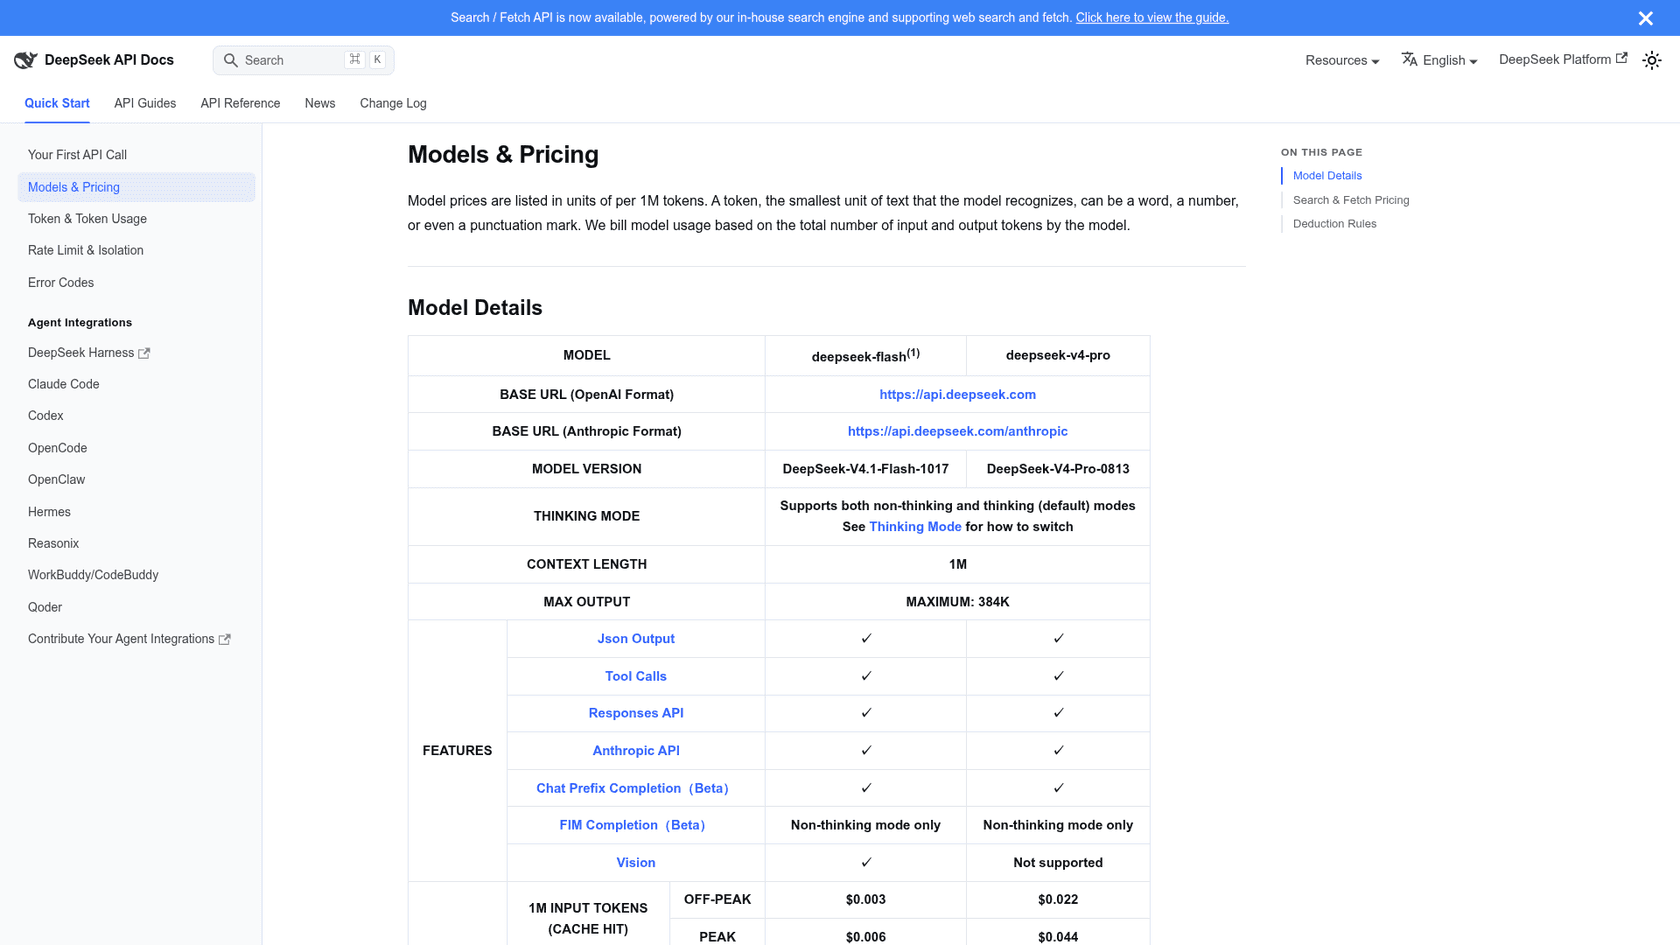
API 上の名前は現在シンプルに deepseek-flash で、DeepSeek-V4.1-Flash-1017 チェックポイントが処理します。deepseek-v4-flash などの古い名前も引き続き動作し、Flash の価格で課金されます(DeepSeek の料金ドキュメントより)。
長所
- スコアが45を超えるモデルの中で最も請求額が低いです。購入者モデルは、Terra の
$3,500に対しオフピークで月$480です。 - キャッシュヒットはオフピークで100万トークンあたり
$0.003なので、繰り返しのシステムプロンプトはほぼ無料です。 - ウェイトがオープンなので、データ所在地が重要な場合は自己ホストできます。画像も読め、ツール呼び出しにも対応し、OpenAI と Anthropic の両方の API 形式を話せます。
- ここで最も速い最初のトークンで、Artificial Analysis では
1.2sです。
短所
- ピーク料金ではすべてが倍の
$0.30/$1.20になります。ピーク時間帯は平日の UTC 01:00〜04:00 と 06:00〜10:00 で、ヨーロッパの午前の勤務時間にちょうど重なります。 - 1017 チェックポイントの max での AA の幻覚率は
67%なので、自社のドキュメントに根拠づけて使ってください。 - サーバー側の Search と Fetch の呼び出しは、2026年11月1日から1,000リクエストあたり
$0.75で課金が始まります。
料金: 入力 $0.15(キャッシュミス)、キャッシュヒット $0.003、出力 $0.60(オフピーク)。ピーク時は $0.30、$0.006、$1.20。
私の見解: トラフィックがほぼ単純で、別のベンダーでも構わないなら、DeepSeek は真剣に検討する価値のある最も安い乗り換え先です。HN のコメントが、その棲み分けを端的にまとめています。
"If all I want is coding at a cheaper price, then deepseek is a good model for that."
セットアップについては DeepSeek V4.1 Flash 1017 のレビューと DeepSeek API ガイドで説明しています。
4. Gemini 3.8 Flash
おすすめの用途: 誰も返信を待っていない、マルチモーダルのバッチ処理(PDF、動画、音声)。
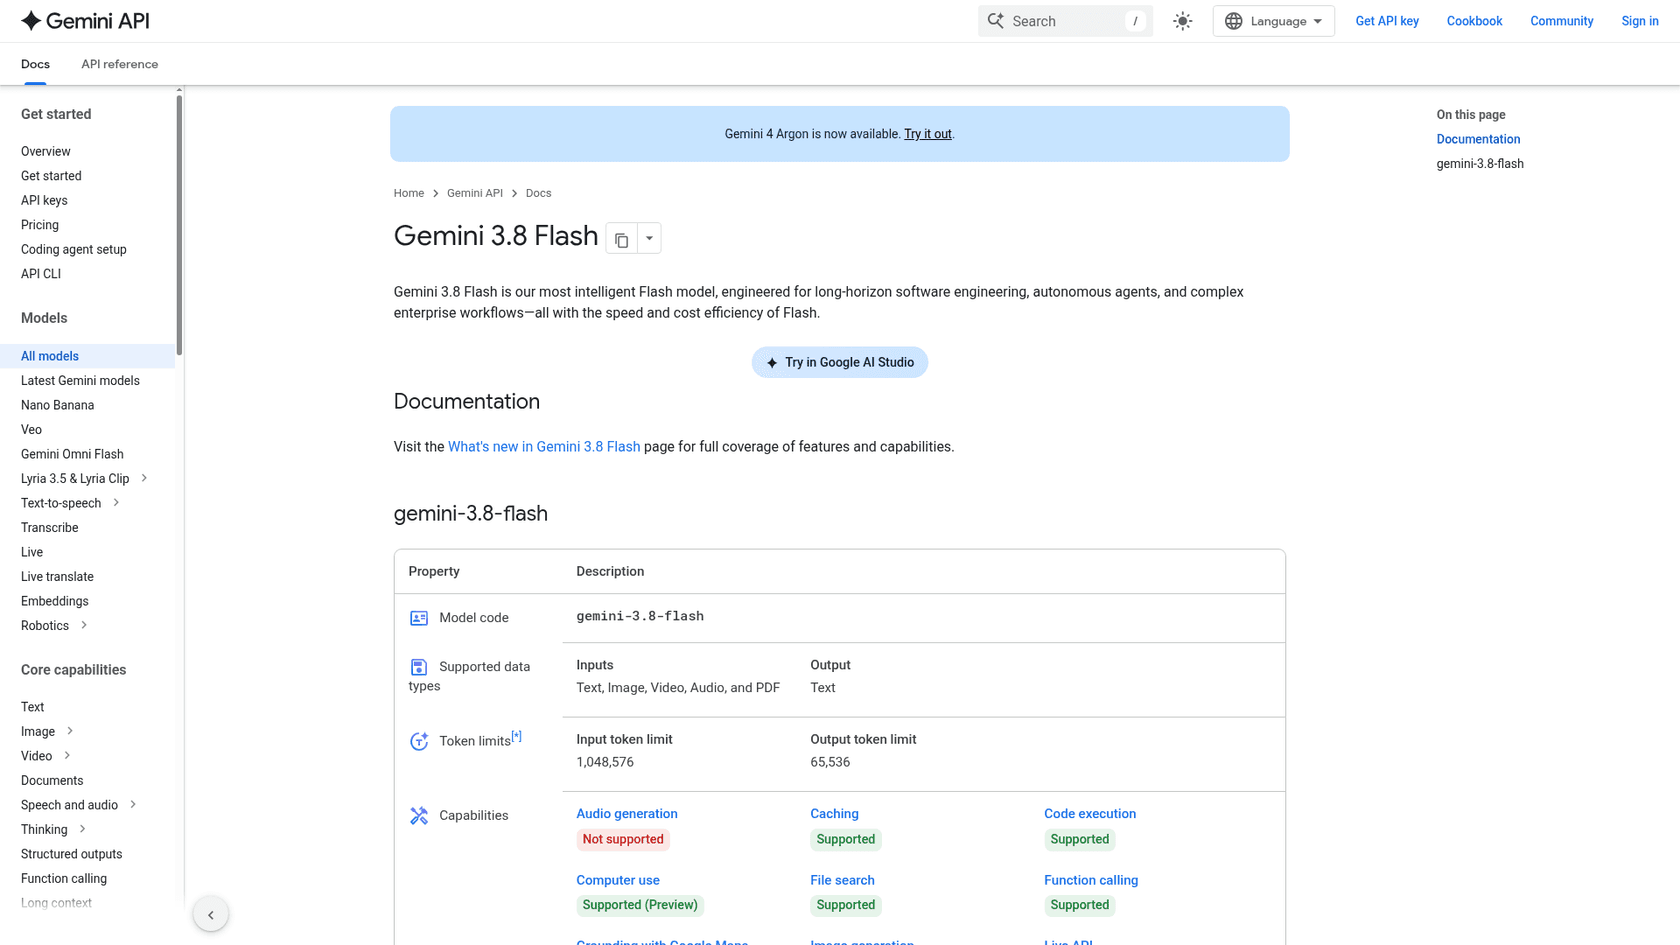
この枠での ChatGPT の選択は Gemini 3.6 Flash でした。しかし Gemini の料金ページでは 3.6 Flash と 3.8 Flash の価格はまったく同じで、Google は 3.6 を "previous generation Flash model" と呼んでいます。Google の Flash 帯を試すなら、3.8 を試してください。
長所
- 2026年末まではトークンあたり Terra より安く、入力
$0.75、出力$3.75で、購入者モデルは$2,625になります。 - テキスト、画像、動画、音声、PDF を入力でき、ここにある他のどのモデルより幅広いです。
- テスト用の無料枠があり、Terra にはありません。
短所
- 2027年1月1日に価格が
$1.50/$7.50に倍増し、トークンあたり Terra を上回ります。 - よく考えます。AA では高負荷で1タスク
$3.49、最初のトークンまで28.3sで、誰かが画面を見つめているチャットウィンドウには向きません。 - Google 自身のローンチノートにも、3.8 Flash は性能を最大化するためにより多くのトークンを使うことがあると書かれています。詳細は Gemini 3.8 Flash のレビューをご覧ください。
料金: 2026年12月31日まで $0.75/$3.75、その後 $1.50/$7.50。Batch と Flex は半額です。
私の見解: トークン課金で夜間にドキュメントを処理する用途には向いています。対話的な用途や、1月以降も動かし続けるものは、先にタスクあたりのコストを計算してください。
5. Gemini 4 Argon
おすすめの用途: 最難関の推論、リサーチ、長時間の自律エージェントなど、正しい答えに価格を払う価値がある場合。
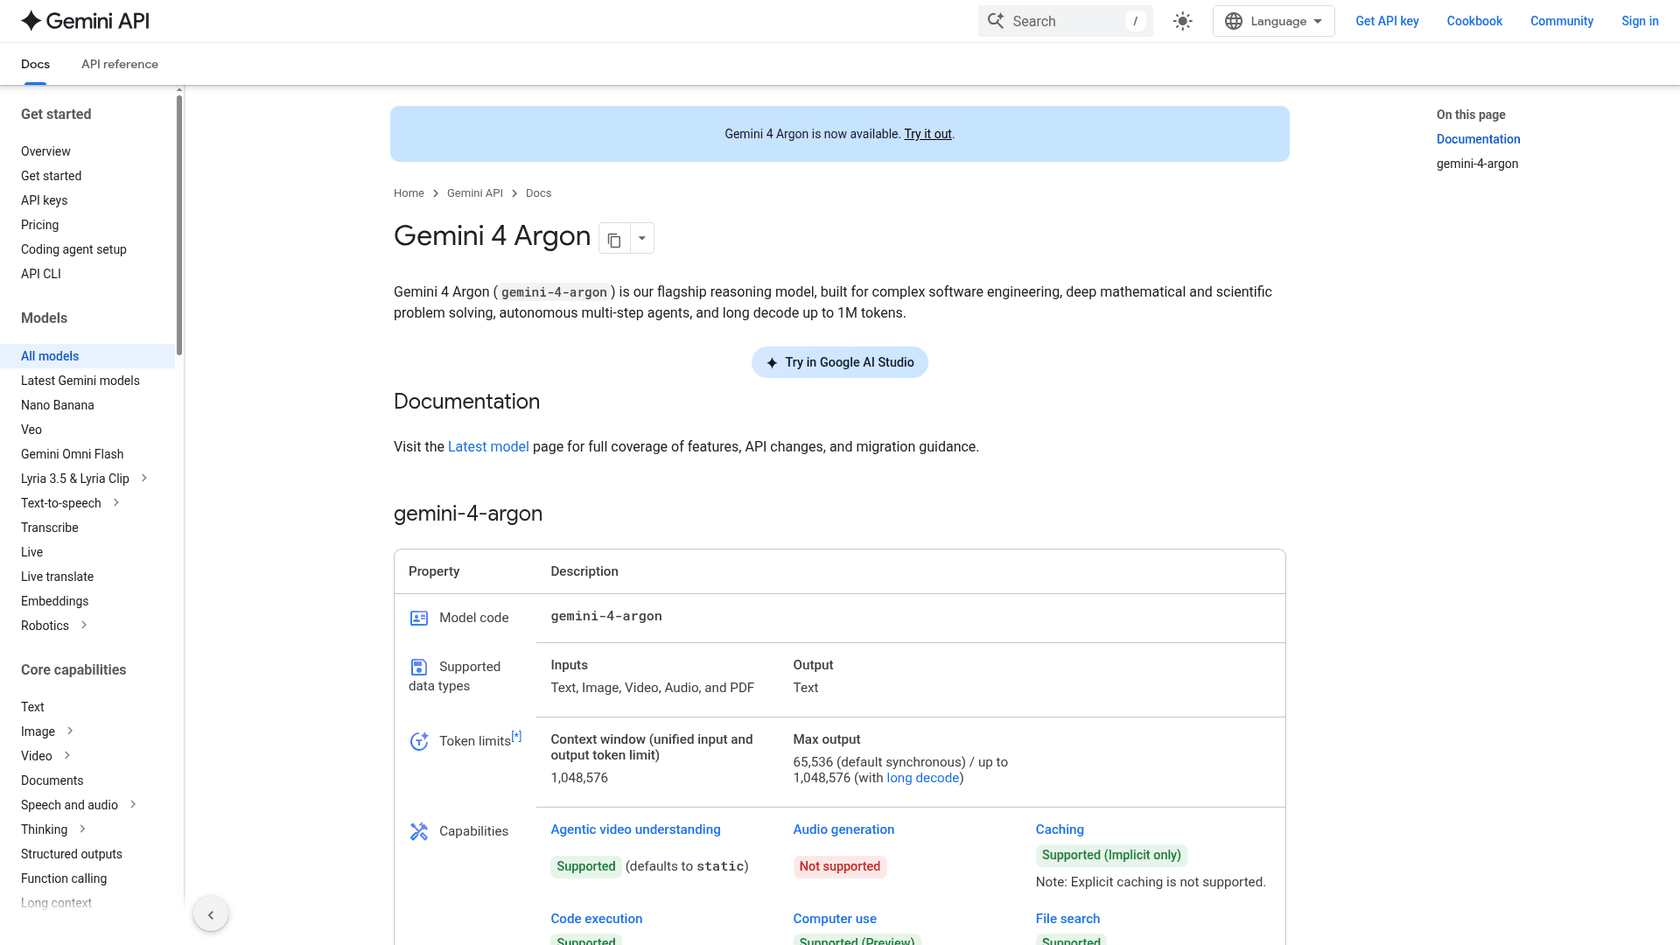
2026年9月30日にリリースされた Google のフラッグシップで、このリストにこれ以上高得点のものはありません。
長所
- ここで最高の Intelligence Index
52.6で、Artificial Analysis では Terra max を4ポイント以上上回ります。 - AA の幻覚率
15%はこのリストで最低で、Terra max の38%と対照的です。誤った事実が最大のリスクなら、Argon はここで最も安全なモデルです。 - 1M のコンテキストと長い出力。
短所
$2/$10の価格は導入価格にすぎず、11月30日で終わります。12月1日からは$4/$20になり、購入者モデルの請求額は$7,000から$14,000に倍増します。- 遅く、AA では最初のトークンまで
48.2s、毎秒約80トークンです。 - 無料枠はなく、キャッシュは暗黙的なもののみです。
料金: Gemini の料金ページによると、2026年11月30日まで $2/$10、その後 $4/$20。プロモの詳細は Gemini 4 Argon の料金ガイドにあります。
私の見解: Argon は、ルーターがエスカレーションする高価な専門家として扱い、日常トラフィックの Terra の代わりにはしないでください。また、予算はプロモ価格ではなく12月の価格で組んでください。詳しくは Gemini 4 Argon のレビューをご覧ください。
6. Grok 4.7
おすすめの用途: 比較テストに4社目の独立したベンダーを加えたい場合、特に出力の多い長い回答。
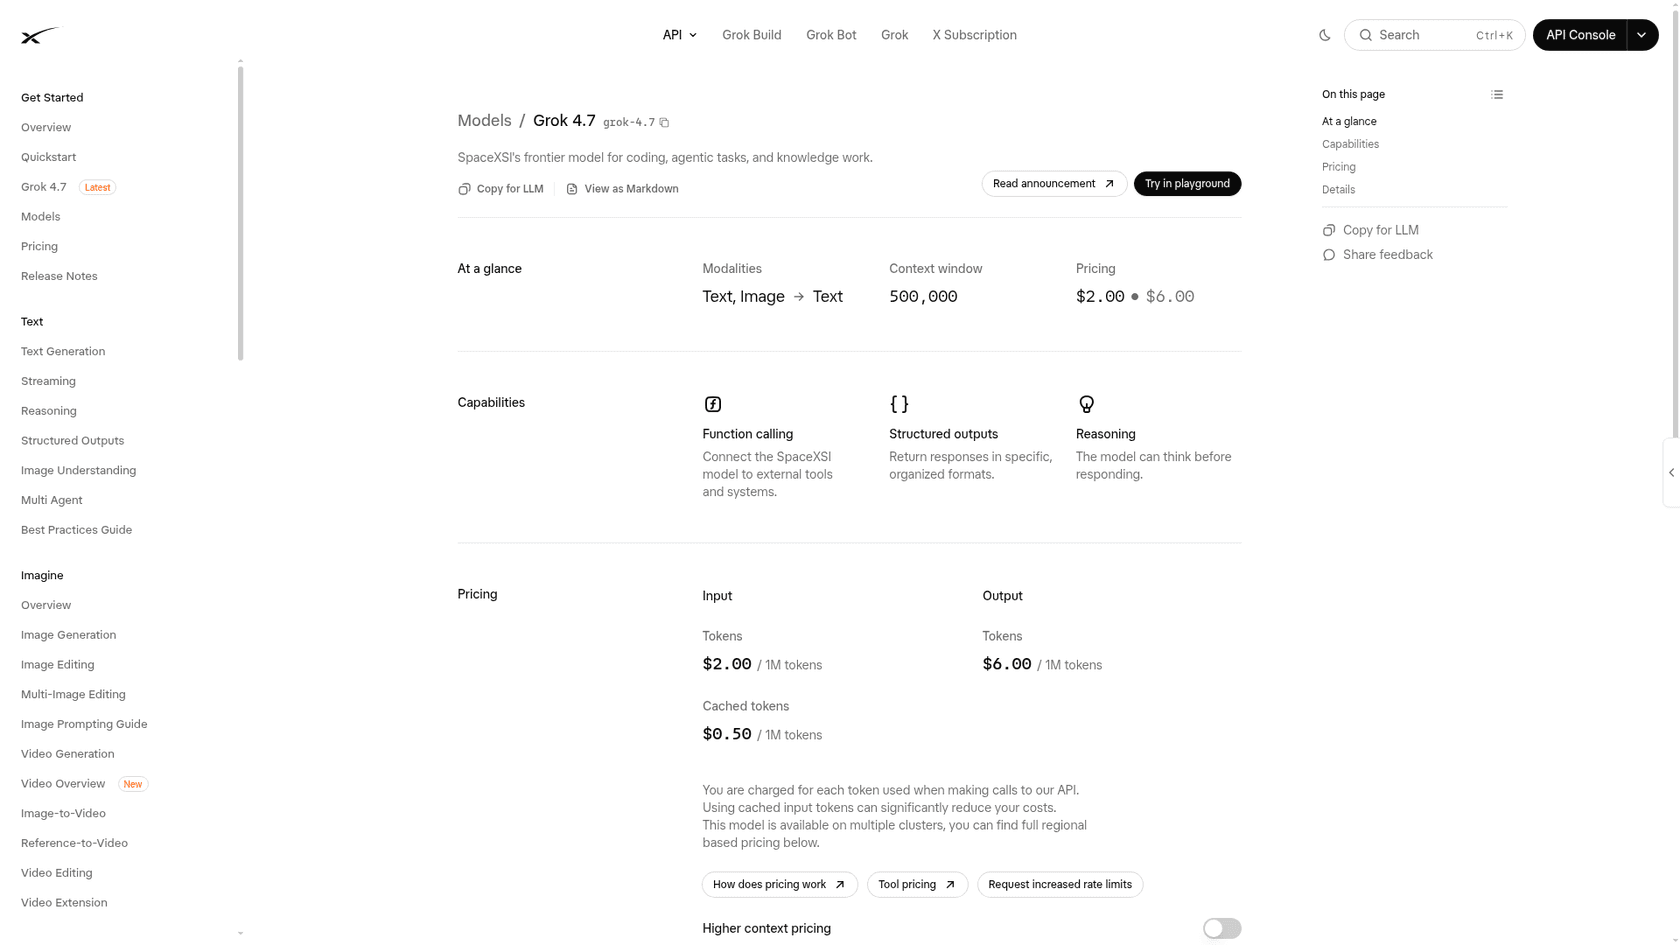
xAI のフラッグシップで、そのモデルページでは "our flagship model for code and everything else" と説明されています。
長所
- フロンティアモデルとして出力が安く、100万あたり
$6で、Sol と Sonnet の$10より安く、購入者モデルは$5,800になります。 - 高負荷時の AA 幻覚率は
32%で、Terra max より低いです。 - 推論は設定可能で、サーバー側の Web 検索と X 検索ツールがあります。
短所
- 500K トークンで、ここにある他のモデルの半分のコンテキストです。
- タスクあたりが高いです。AA では高負荷で
$2.36、指数は46.3で、このリストで最悪の比率です。 - 高負荷では最初のトークンに
45.7sかかりますが、低負荷なら5.4sに短縮されます。
料金: xAI ドキュメントによると、100万あたり入力 $2、出力 $6。
私の見解: 大手3社だけに頼らないよう、比較テストに1枠は入れる価値があります。ただし、この数値では Sol や Sonnet より優先はしません。残りについては Grok 4.7 のレビューで触れています。
7. Claude Haiku 5.5
おすすめの用途: 顧客に直接出さない、大量のタグ付け、ルーティング、分類。
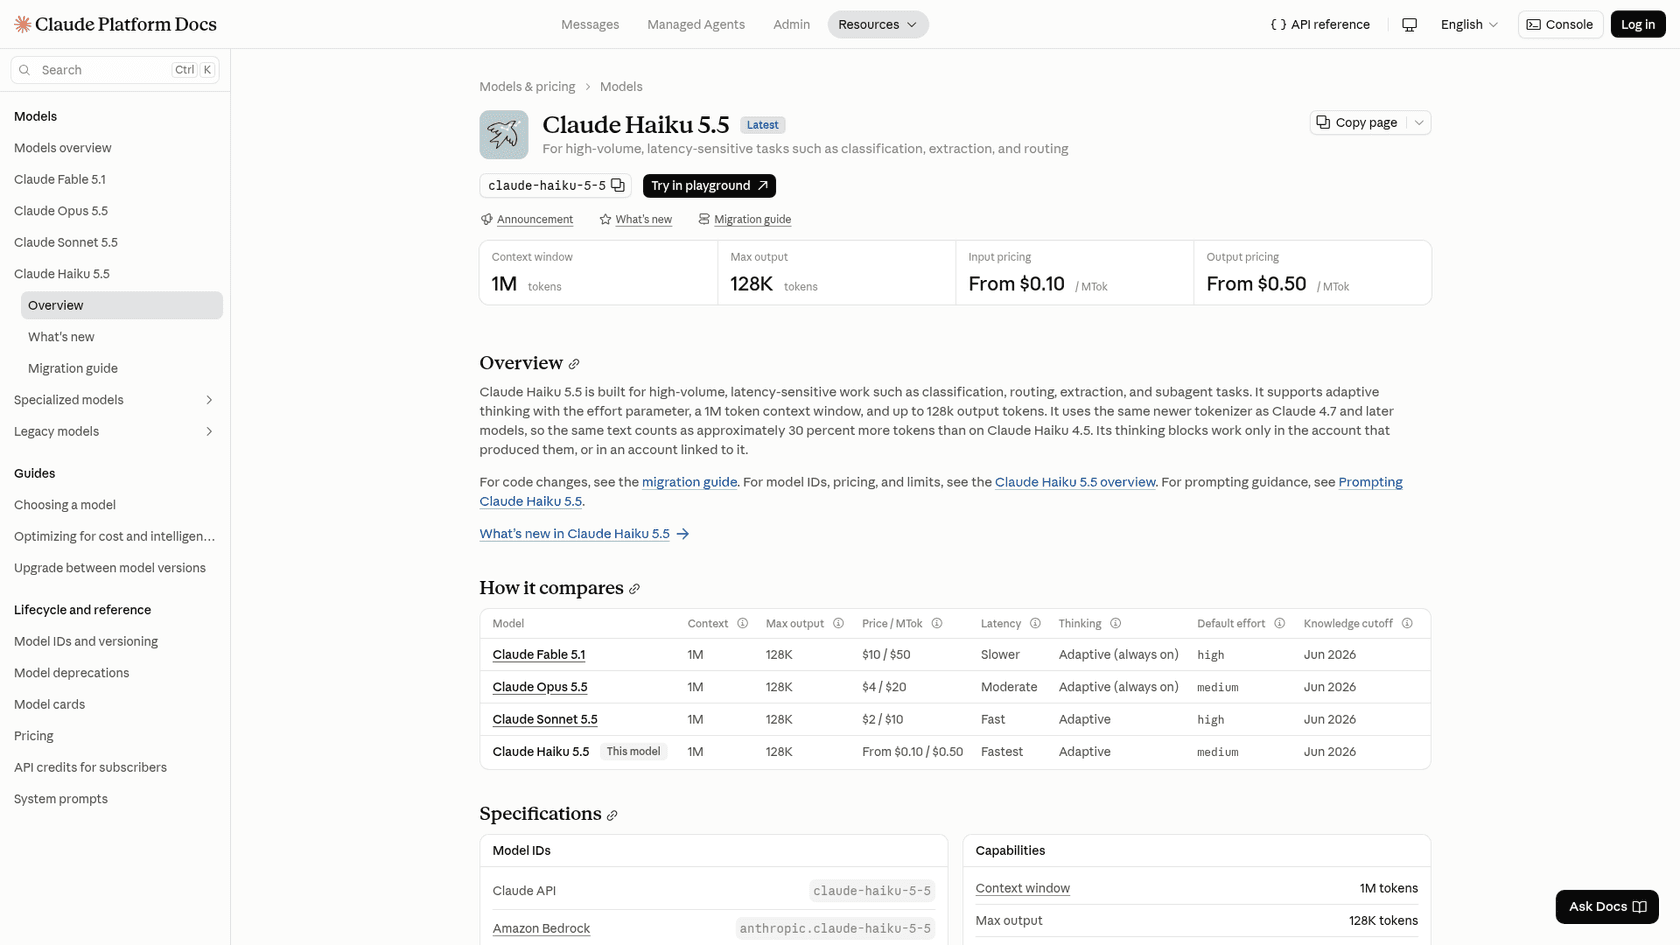
Terra では仕事に対してモデルが大きすぎるなら、横ではなく1段下げてください。Claude Haiku 5.5 は Anthropic の小型モデルで、2026年10月7日に登場し、GPT-6 Luna と同じ $0.10/$0.50 の価格帯です。
長所
- 購入者モデルは月
$350で、Terra の請求額の10分の1です。 - AA のスコアは高負荷で
37.8、1タスク$0.08で、Luna の32.9を上回ります。 - AA では毎秒約
185出力トークンで動作します。
短所
- プロンプトが100,000トークンを超えると5倍になり、入力
$0.50、出力$2.50です。ある HN ユーザーは、このモデルを "destroyed by Anthropics crazy decision to price it x5 after 100k context" と呼びました(rockdoe)。 - 指数は Terra より
10ポイント低いので、乗り換えではなく1段下のモデルとして扱ってください。
料金: Claude の料金ページによると、100Kトークンまでのプロンプトは $0.10/$0.50、それ以上は $0.50/$2.50。
私の見解: Haiku 5.5 や Luna は、ルーターの安価な最初の一次処理として優れています。プロンプトを100K未満に保つだけです。ベンチマークは Claude Haiku 5.5 のレビューにあります。
あなたのプロダクトに合う GPT-6.1 Terra の代替はどれか?
リーダーボードではなく、仕事から考えてください。スクリーンショットをうまく読めても、間違ったボタンをクリックするモデルはあります。数学が得意でも、チャットウィンドウでは遅く感じるモデルもあります。
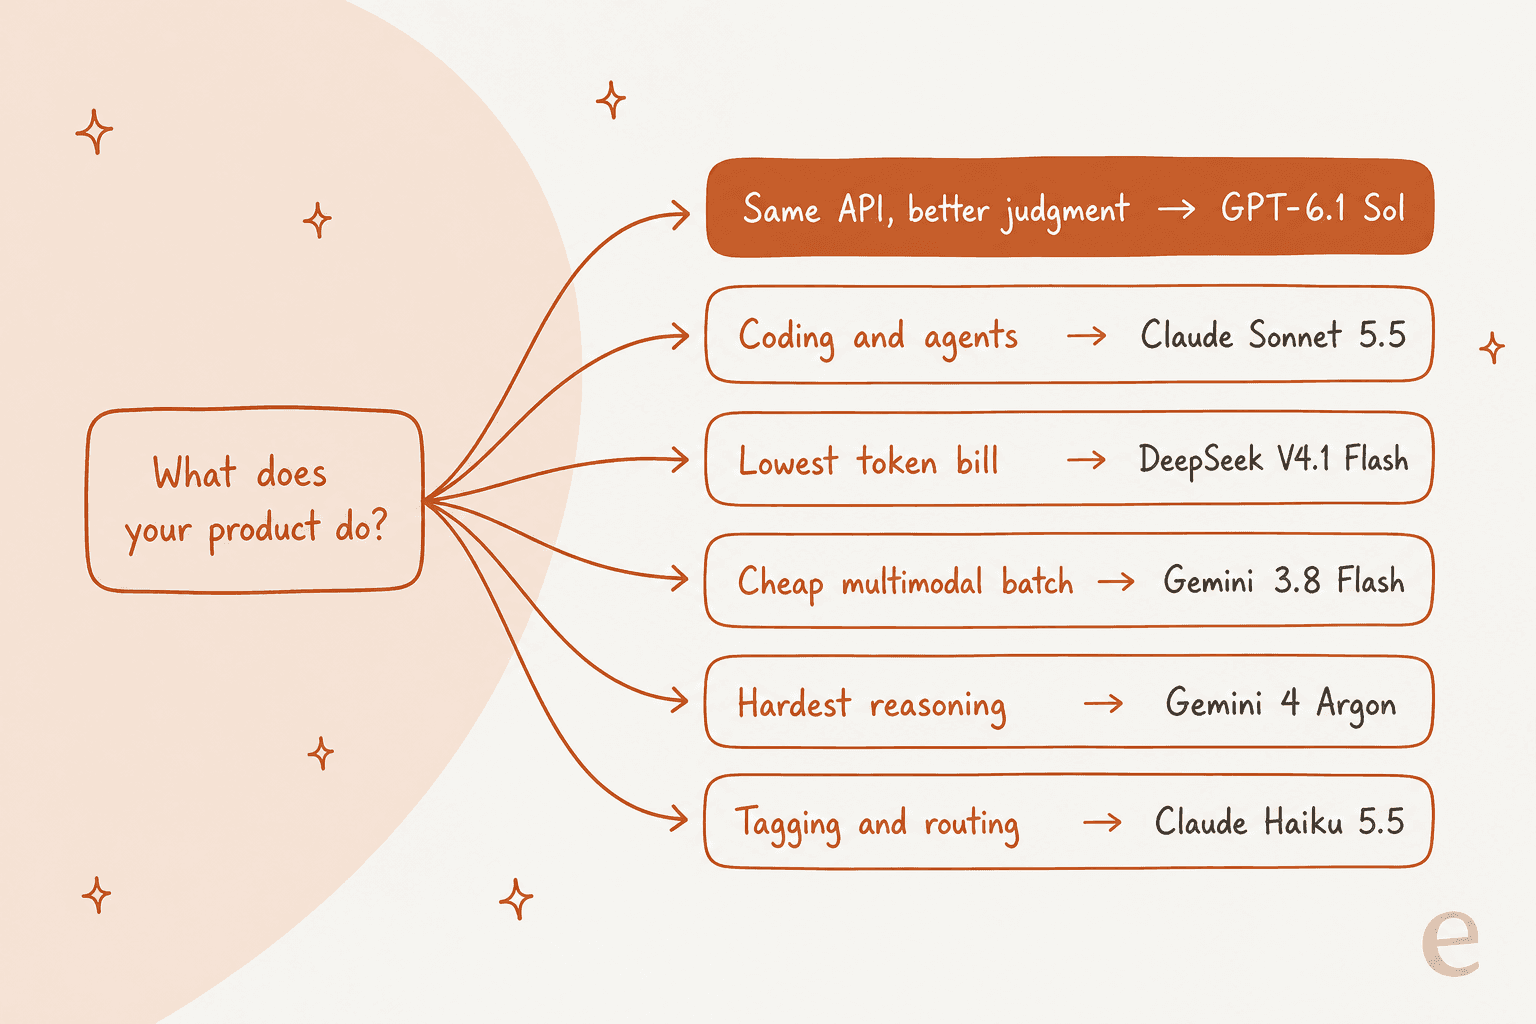
| プロダクトの主な用途 | 最初に試すもの | 理由 |
|---|---|---|
| 顧客向けの下書きとチャット | Terra low、Sol medium | 最初のトークンが速く、文章が良く、エッジケースには Sol |
| コーディングまたはターミナルエージェント | Claude Sonnet 5.5 | Anthropic によると Terminal-Bench 4.0 で 70.6% |
| 大量の抽出または RAG | DeepSeek V4.1 Flash | オフピーク $0.15/$0.60 とオープンウェイト |
| 夜間の PDF、動画、音声の処理 | Gemini 3.8 Flash | 最も幅広い入力タイプで、2027年まで安い |
| リサーチと最難関の推論 | Gemini 4 Argon | AA 指数が最高、幻覚率が最低 |
| タグ付けとルーティング | Claude Haiku 5.5 または GPT-6 Luna | $0.10/$0.50 |
| 自己ホスト、またはデータ所在地の制約あり | DeepSeek V4.1 Flash、または Qwen 3.8 | 自分で動かせるウェイト |
ここに合うものがなければ、あと2つ知っておく価値があります。Kimi K3.1 Pro は AA で 55.1 を記録しましたが、毎秒約 46 トークンと遅いです。Mistral Large 4 はまだプレビュー段階です。
乗り換える前のモデル比較テストの進め方
リーダーボードが示すのは、他人のテストでモデルがどうだったかです。必要なのは、あなたのテストでどうなるかです。次は私が行うやり方で、Terra のレビューでの評価と同じ形です。
- 実際のリクエストを100〜500件集める。 匿名化し、誤字、1通に2つの質問、ツールのタイムアウト、プロンプトインジェクションといった厄介なものも残します。
- 3つの挑戦者を選ぶ。 Terra を基準にして、上の表から自分の仕事に合う2〜3行を加えます。
- ユーザーが感じることを測る。 タスク成功率、でっち上げた事実、
p50とp95のレイテンシ、ツール呼び出しの精度、再試行、成功したタスクあたりのコスト。 - 最初は手作業で採点する。 最初の実行では、すべての出力を自分で読みます。採点基準を信頼できるようになったら自動化します。その際は OpenAI のエージェント評価ツールが役立ちます。
- 単体のモデルだけでなくルーターも試す。 すべてを安価な既定モデルに送り、難しいケースや不確かなケースをエスカレーションします。
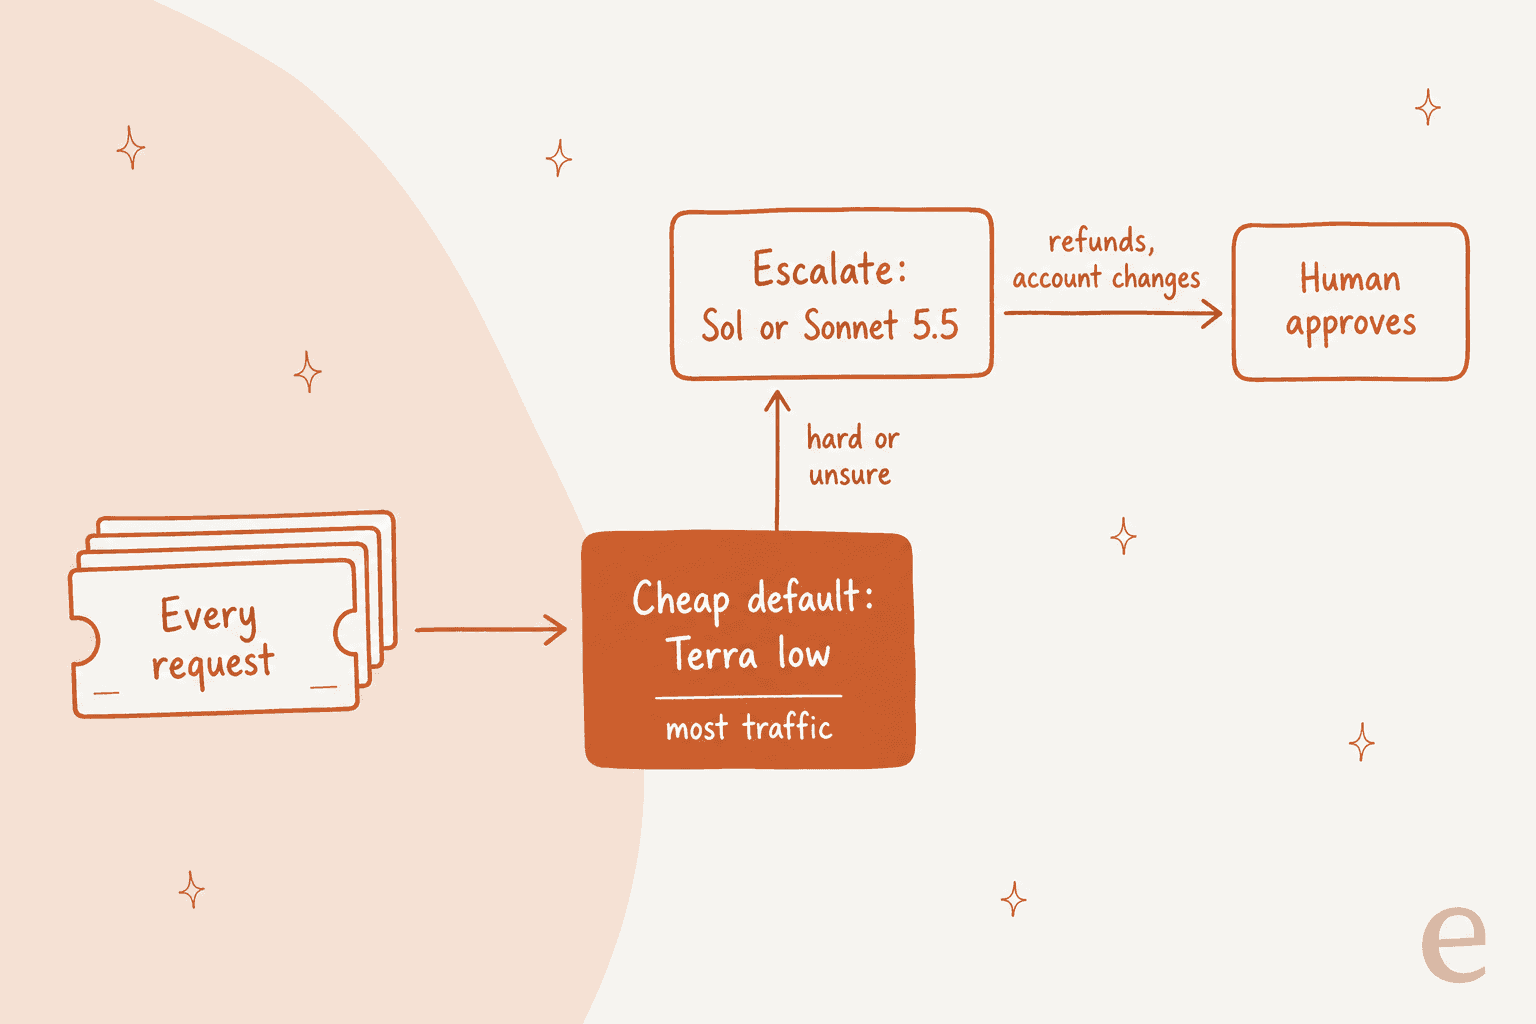
節約の大半はルーティングから生まれます。OpenAI は Terra の none と low の負荷をまさにこの高速経路のために作っており、HN のユーザーはこれについて繰り返し同じ疑問に戻っていました。
"Is a high effort terra above a low effort Sol? Are larger models mostly always better regardless of effort?"
AA のデータを見る限り、答えはしばしば「いいえ」で、自社のワークロードでどうなるかは測るしかありません。キャッシュはどの選択肢でも効きます。Terra のキャッシュ入力は $0.05 で95%の割引です。スケールする前に、OpenAI API の料金ガイドで Batch とレート制限も確認してください。
モデルをサポートキューに使う場合
Terra の代替を比較しているチームの多くは、実際にはサポートボットを作っています。私は長年ライブのヘルプデスクキューに AI エージェントを導入してきて、いつも同じことを目にします。弱点になるのはモデルではなく、その周りのルールであることがほとんどです。私の80回の Terra テストでは、16件中15件を下回ったモデルはありませんでした。唯一の本当の失敗は、none の Terra がスペイン語圏の顧客に、変更する手段がないのに "we've noted the new address" と伝えたことでした。
これはエスカレーションの問題です。大きなモデルにお金を払うのではなく、引き継ぎのタイミングを決める層で解決します。AIの幻覚を防ぐのは、どのモデルが言葉を書くかに関係なく、ヘルプセンターと過去のチケットに回答を根拠づけることです。そして、有料の顧客への誤った約束に比べれば、トークン費用はAIカスタマーサービスのコストのごく一部です。
SamCart は、この層が実際にどう見えるかを示しています。1つの eesel エージェントが Freshdesk のチケットを、別のエージェントが Web チャットを担当し、どちらも約280件のヘルプセンター記事から回答し、月8,000件のやり取りに合わせたプランで運用されています。スイスのスーツケース店 Koffer.ch は、Freshdesk 上で、ドイツ語、フランス語、英語、イタリア語のすべての返信を下書きとして保持しています。これはまさに、安価なモデルで十分に役目を果たせる構成です。
コードから操作したいですか?eesel CLI は、ダッシュボードで設定するのと同じチームメイトを実行します。eesel chat で返信をテストし、eesel activity でエージェントが何をしたかを確認できます。変更は --dry-run でプレビューできます。すべてのコマンドは JSON を返します。各ワークスペースは MCP サーバーでもあるため、Terra や Sonnet で動くコーディングエージェントが、サポートのチームメイトをツールとして呼び出せます。
eesel を試す
Terra、Sol、Sonnet はエンジンです。作っているものがサポート自動化なら、eesel は、その上ですでにその仕事をこなしているAIヘルプデスクのチームメイトです。すでに使っているヘルプデスク(Zendesk、Freshdesk、Gorgias など)に参加します。ヘルプセンターに加えて過去のチケットやマクロからも学習し、設定したエスカレーションルールに従います。実際の顧客に回答する前に、実際の過去チケットでシミュレーションを実行するため、その返信をチームが実際に送った内容と比較できます。

料金は月額固定のクレジットプランで、チケット1件またはチャット1件が1クレジットです。月 $299 で500クレジットから始まり、すべての機能と無制限のシートが含まれます。トークン単位の課金がないため、Terra のような安価なモデルが登場しても請求額は変わりません。無料プランから始めて、キューの一部で eesel を試してください。