なぜ今 Argon の代替が必要なのか
eesel では、人々が実際に何を検索しているかを見る時間が長く、今週の「Gemini 4 Argon 代替」は実のところ1つの問いです。代わりに今日、何が使えるのか。もっともな問いであり、かなり切実です。Google は 9月30日に Argon を発表し、初日は Fairwind Program のサイバー防御者にだけ提供しました。Google は、有料 API 顧客と Google AI Ultra の加入者が次だとしていますが、いつになるかはまだ明らかにしていません。
念のため、これを書く前にもう一度確認しました。10月1日 08:13 UTC に、gemini-4-argon と gemini-4-argon-preview はどちらも 404 NOT_FOUND を返し、私のキーが一覧した61モデルに Argon は含まれていませんでした。一覧で最新の Pro モデルは gemini-3.1-pro-preview でした。つまり、今月出荷すべきプロダクトがあるなら、Argon はまだ選択肢になりません。ローンチ日のこのビルダーの懸念も、依然として当てはまります:
"Hopefully they sort out their infrastructure and model versioning so that we can feel confident building production applications on top of their APIs. The capacity limitations I've experienced with them in the past have been deeply problematic."

ただし Argon には公平であるべきです。強力なモデルであり、その機能の一部は代替が難しいからです。Artificial Analysis では高エフォートで 52.6 を記録し、GPT-6 Astra とほぼ同水準です。AutomationBench では 77.5% で1位です。ここで唯一、出力上限が100万トークンのモデルでもあります。GPT-6.1 Sol は128K、Gemini 3.1 Pro は65,536で止まります。そして、呼び出せる他のどのモデルよりもはるかに頻繁に「わかりません」と言います。
Argon が最も得意なことと、それぞれを何で置き換えるか
良い代替は、「Argon」全体ではなく、あなたが求めていた特定の部分を置き換えます。10月1日 08:14 UTC に、Argon とこの記事のすべてのモデルの Artificial Analysis のページを取得したため、以下のスコア、コスト、ハルシネーション率はすべて、1つの指数の同じ1日のものです。
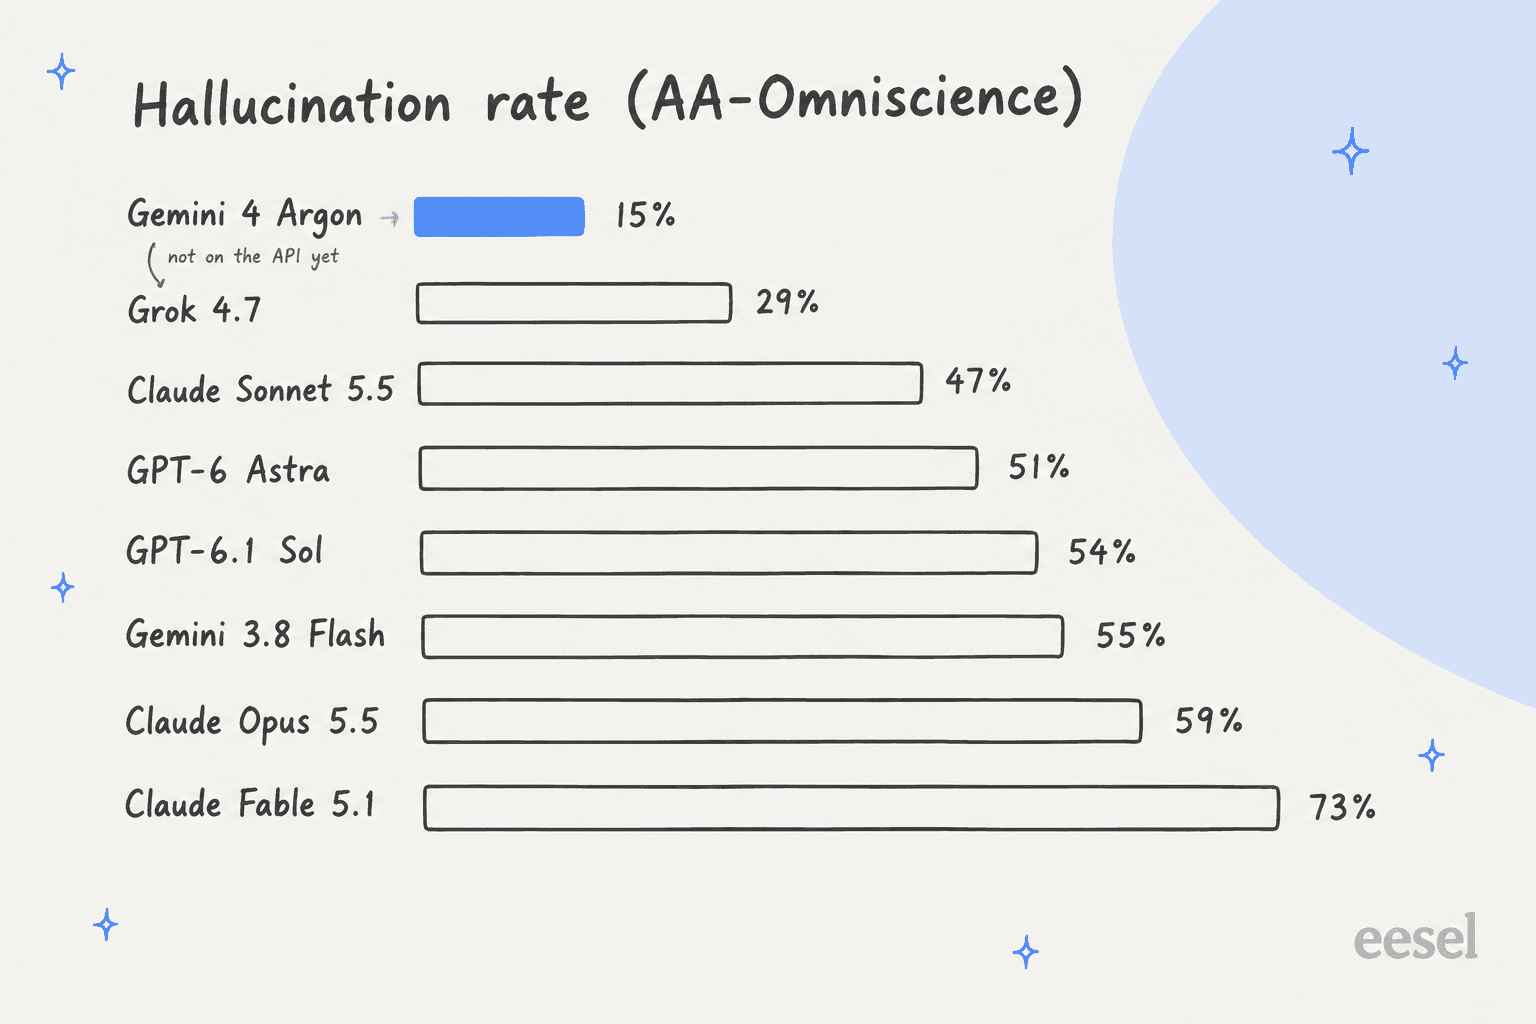
AA-Omniscience のハルシネーション率とは、正解できなかった質問のうち、それでも答えて間違えた割合です。そのため、数字が少し奇妙に見えることがあります。Claude Fable 5.1 はここで最も正答率が高く(67%)、ハルシネーション率も最も高い部類(73%)です。わからないときに、たいてい推測するからです。Argon は逆で、正答率は 50% ですが、答えられない質問のほとんどを辞退します。
100問あたりで見ると、より明確になります。Argon は約50問正解し、約8問間違えます。GPT-6 Astra は約63問正解し、約19問間違えます。Grok 4.7 は約15問間違え、利用可能なモデルでは Argon に最も近いですが、正解も少なめです(約47問)。
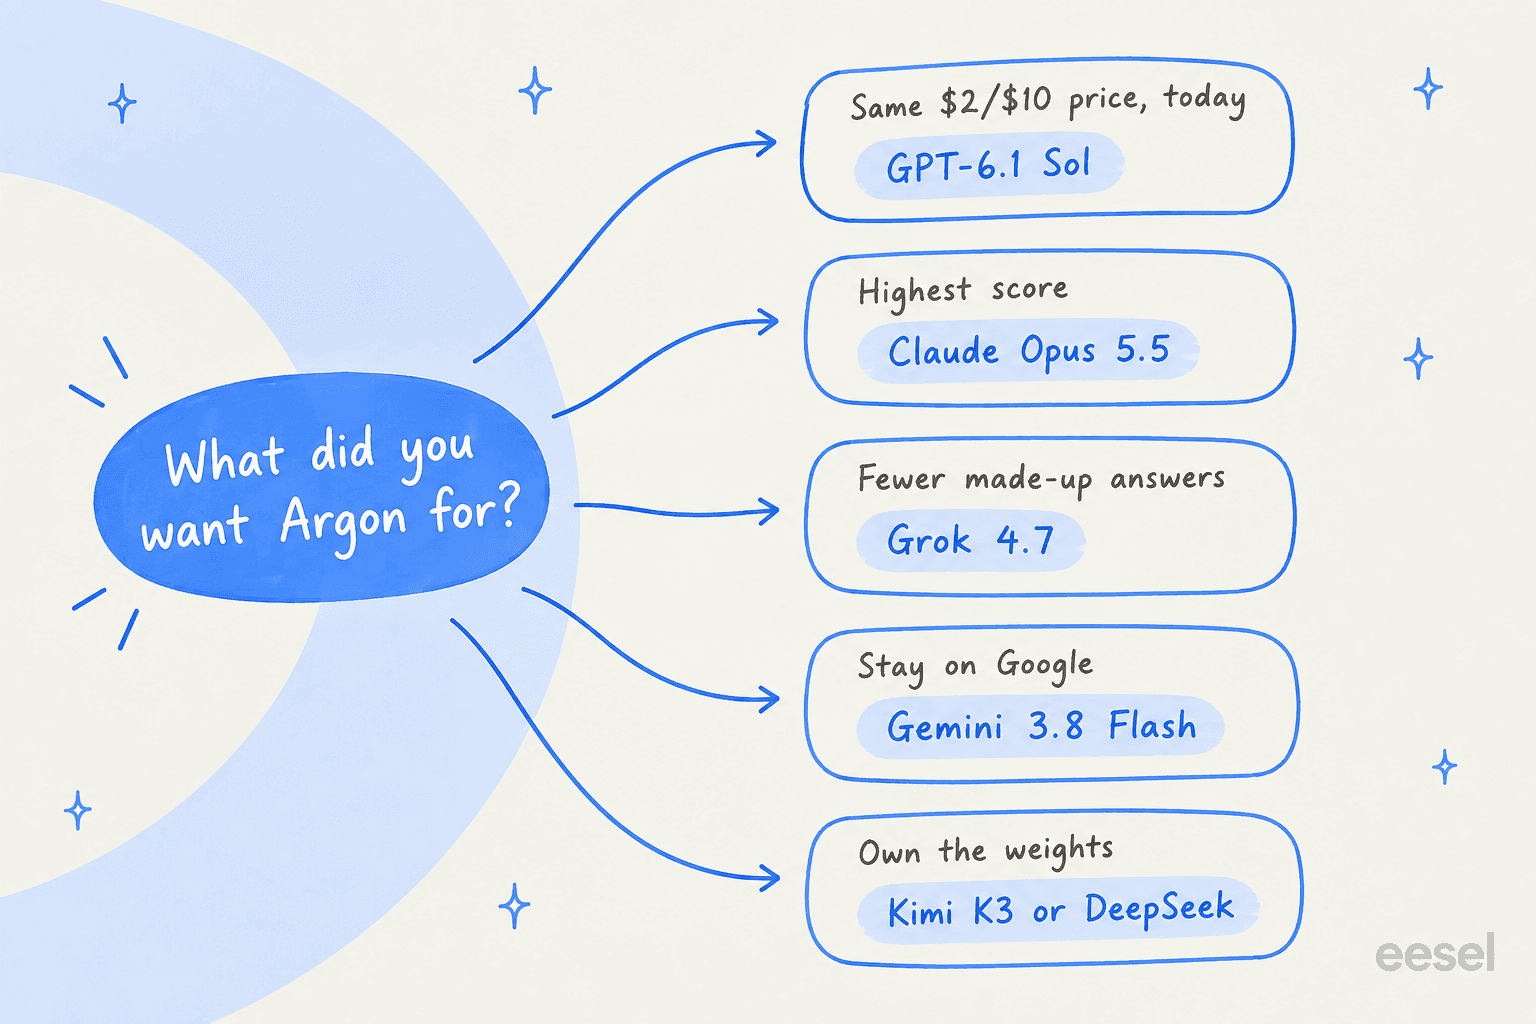
| Argon に求めていたこと | Argon の数値 | 今日呼び出せる最良のモデル |
|---|---|---|
| $2/$10 で高いスコア | 1タスク $1.99 で 52.6 | GPT-6.1 Sol:$0.72 で 51.8 |
| 価格を問わず最高のスコア | 52.6(指数8位) | Claude Opus 5.5:$5.98 で 57.6 |
| でっち上げの回答が少ない | ハルシネーション率15% | Grok 4.7:29% |
| エージェントのワークフロー | AutomationBench 77.5% | Claude Sonnet 5.5 max:71.3% |
| 長い文書 | 長文脈推論 79.7% | Kimi K3:88.7% |
| 非常に長い出力 | 出力100万トークン | まだ並ぶものはありません |
| Google に留まる | API にない | Gemini 3.8 Flash または 3.1 Pro |
この長文脈の行は意外でした。Google 自身の表は Argon の GraphWalks スコアを先頭に置いていますが、Artificial Analysis の長文脈推論テストでは、このリストの Grok 4.7 以外のすべてのモデルが Argon より高いスコアです。トップは Kimi K3 の 88.7% です。
これらの代替をどう選び、どうテストしたか
このリストのすべてのモデルは、今日、公開 API で利用できます。選定は4つの観点で行いました。各ベンダー自身の料金ページの価格、同じ Artificial Analysis のスナップショットからのスコアとタスクあたりのコスト、ハルシネーション率、そして Argon を求めていた具体的な理由をどれだけカバーするかです。
そのうえで、Argon が知られている点について独自のテストを行いました。ハルシネーションのベンチマークは、資料なしの雑学クイズを出題します。サポートボットはヘルプセンターをもとに動きます。そこで、モデルの前にナレッジベースがある場合でも、Argon の誠実さの優位が現れるのかを知りたかったのです。
セットアップは、架空の SaaS 企業の短い返金・配送ポリシーで、GPT-6.1 Sol のレビューのテスト環境を再利用しました。12問を出しました。ポリシーが答えている4問と、答えていない8つの罠(PayPal、稼働率 SLA、EU でのデータ保存、電話窓口、API レート制限、Salesforce 連携、ブラックフライデーの日付、HIPAA)です。直接アクセスできる5つのモデル(GPT-6.1 Sol、GPT-6 Astra、GPT-6 Luna、Gemini 3.8 Flash、Gemini 3.1 Pro Preview)を3つのモードで、合計160回呼び出しました:
- Strict: 「ポリシーのみに基づいて答えてください。カバーされていない場合は、そう伝えて人間に引き継いでください。」
- Loose: 「できるだけ役に立ってください」。ポリシー自身の「推測せずエスカレーション」の行は残したままです。
- Bare: 「できるだけ役に立ち、顧客に直接的な答えを返してください」。「推測しない」の行は削除しました。
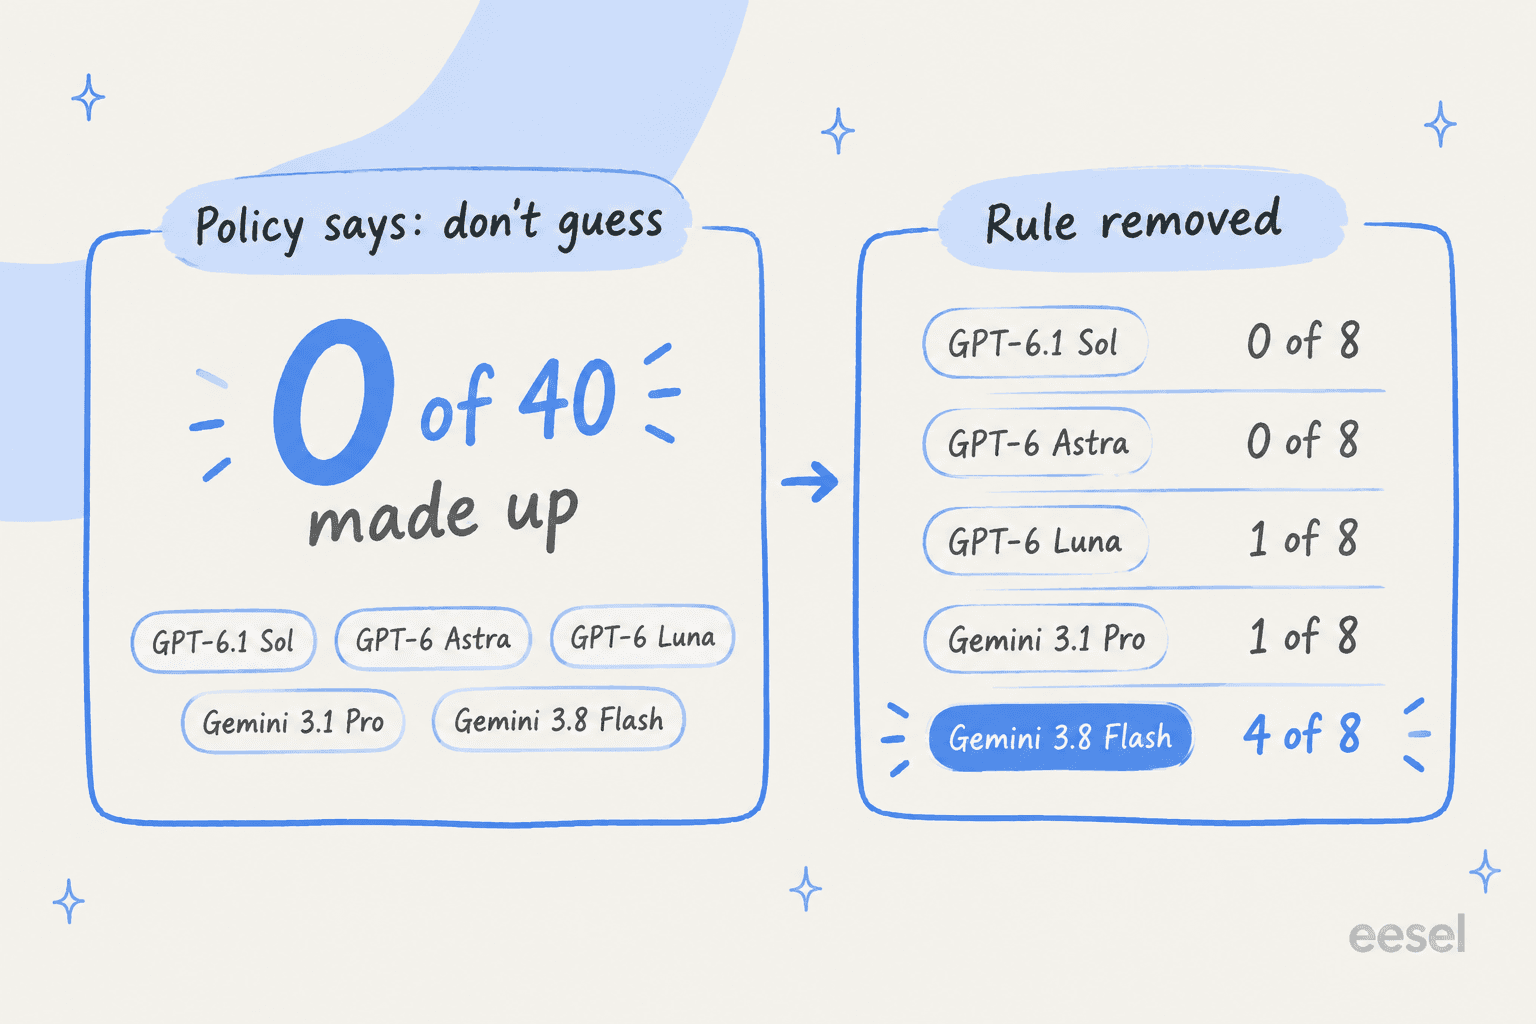
strict と loose のモードでは、どのモデルも罠への回答を40件中0件しかでっち上げず、カバーされた4問にはすべて正解しました。分かれるのは bare モードです。GPT-6.1 Sol と GPT-6 Astra は、それでも何もでっち上げませんでした。Luna は「We haven't announced this year's Black Friday sale start date yet」と言い、Gemini 3.1 Pro は「We don't currently offer phone support.」と言いました。Gemini 3.8 Flash は4つの回答をでっち上げ、そのうち1つは法務メールに載りかねない類のものでした:「our standard services are not certified as HIPAA compliant, and we do not sign Business Associate Agreements (BAAs) under our standard plans.」また、support@acmecloud.com という偽のアドレスも1つ作り出しました。
注意点が2つあります。整った12問のポリシーというのは、かなり小規模で好条件のテストです。また、Argon 自身、Grok、Claude の各モデルは通せなかったため、これはリーダーボード全体ではなく、指示の効果を示すものです。それでも結果は指数と一致しています。プロンプトのルールは、モデルの選択よりもはるかに結果を動かしました。
全体は以下のとおりです。
| モデル | 選ぶ最大の理由 | API 価格(入力 / キャッシュ / 出力、100万あたり) | AA スコア / タスクあたりのコスト | ハルシネーション | 最大出力 | ウェイト | 私のテスト(bare モード) |
|---|---|---|---|---|---|---|---|
| Gemini 4 Argon(基準) | 利用不可 | $2 / $0.10 / $10 プロモーション、その後 $4 / $0.20 / $20 | 52.6 / $1.99 (high) | 15% | 1M | クローズド | 実行できず |
| GPT-6.1 Sol | 同じ価格、今日使える | $2 / $0.10 / $10 | 51.8 / $0.72 (max) | 54% | 128K | クローズド | 0/8 でっち上げ |
| Claude Opus 5.5 | 最高のスコア | $4 / $0.20 / $20 | 57.6 / $5.98 (max) | 59% | - | クローズド | - |
| Grok 4.7 | でっち上げが少ない | $2 / $0.50 / $6 | 46.4 / $3.74 (xhigh) | 29% | - | クローズド | - |
| GPT-6 Astra | 同じスコア、OpenAI | $10 / $1 / $50 | 52.7 / $3.26 (max) | 51% | - | クローズド | 0/8 でっち上げ |
| Claude Sonnet 5.5 | エージェントのワークフロー | $2 / $0.20 / $10 | 56.0 / $7.62 (max) | 47% | - | クローズド | - |
| Claude Fable 5.1 | 最高の正答率 | $10 / $0.25 / $50 | 53.4 / $7.63 (max) | 73% | 128K | クローズド | - |
| Gemini 3.8 Flash | Google、無料枠 | $0.75 / $0.075 / $3.75 | 40.9 / $1.24 (high) | 55% | - | クローズド | 4/8 でっち上げ |
| Gemini 3.1 Pro Preview | Google の Pro モデル | $2 / $0.20 / $12 | 29.7 / $0.67 | 51% | 65,536 | クローズド | 1/8 でっち上げ |
| Kimi K3 | オープンウェイト、長い文書 | $3 / $0.30 / $15 | 43.6 / $2.00 (max) | 53% | - | オープン | - |
Gemini 4 Argon を何に使いたかったですか?
あなたの理由に最も近いものを選んでください。
1. GPT-6.1 Sol:同じ価格表、今日使える
最適な用途: Argon の $2/$10 という価格でフロンティアに近いモデルを求めていて、今月中に本番で必要なチーム。
Argon の価格が気に入っていたなら、これが最も近い乗り換え先です。GPT-6.1 Sol は Argon の1日前、9月29日の OpenAI DevDay で発表され、そのモデルページには入力 $2、キャッシュ $0.10、出力 $10、Argon のプロモーションとまったく同じ価格表が1行ずつ載っています。コンテキストウィンドウは1,050,000トークン、最大出力は128,000トークン、知識のカットオフは2026年4月です。
スコアも近いです。Artificial Analysis では、6.1 Sol は最大エフォートで 51.8、Argon は 52.6 です。差が出るのはタスクあたりのコストです。6.1 Sol は1タスクあたり約38K出力トークンで、Argon の62Kより少ないため、Argon が $1.99 のところ $0.72 です。Argon のプロモーションが終わると $3.98 で、5倍以上になります。ローンチ日のコメント投稿者たちは、かなり素早く計算しました:
"Sol 6.1 scores one point less than Gemini 4 on intelligence AND costs less than half ($0.72 vs $1.99) per task."
トレードオフは誠実さにあります。6.1 Sol のハルシネーション率は最大エフォートで 54%、Argon は 15% です。私のテストでは、実際にはそれが表れませんでした。bare モードでも罠への回答を8件中0件しかでっち上げず、これを達成したのは Astra のほかにこれだけでした。API にも粗い部分がいくつかあります。6.1 Sol は none エフォートを受け付けず、Chat Completions はツール呼び出しなしでのみ動くため、Responses API を前提に計画してください。
長所: Argon のプロモーションと同じトークン単価、タスクあたり2.7倍安い、今日使える、bare モードのテストで0/8でっち上げ。
短所: 指数での Argon のハルシネーション率の約3.5倍、none エフォートなし、出力上限128K。
料金: 100万トークンあたり入力 $2、キャッシュ $0.10、出力 $10。入力が272Kを超えるプロンプトは高い料金で課金されます。詳細は GPT-6.1 Sol pricing をご覧ください。
私の見立て: これがデフォルトの選択です。Argon の価格を今日、Argon のタスクあたりコストの約3分の1で得られ、Google が API を開いたときには、いつでも Argon と A/B 比較できます。
2. Claude Opus 5.5:より高い天井
最適な用途: 難しいコーディング、長時間のエージェント実行、そしてスコアのために Argon を求めていた専門的な作業。
魅力が「Google のフロンティアモデル」だったなら、Claude Opus 5.5 は呼び出せるフロンティアモデルです。Artificial Analysis で最大エフォートの 57.6 を記録し、Argon より約5ポイント上で、そこでの Terminal-Bench 4.0 でも上回っています(59.6% 対 57.1%)。価格表もおなじみです。入力 $4、キャッシュ $0.20、出力 $20 は、プロモーション後の Argon の価格とまったく同じです。
公平な比較は中エフォートでのものです。Opus 5.5 medium は1タスク $1.34 で 51.2、つまり、より少ない費用で Argon 並みです。ある HN のコメント投稿者は、高エフォートで同じ点を指摘しました:
"It's comparable to Opus 5.5 on "high" (54 vs 53; $1.82 vs $1.99), crushes every model except the most modern OAI/Ant ones, has way lower hallucination than every existing model and probably broader support for multimodal like existing Gemini models."
その引用は、Opus に反対する正直な論拠でもあります。ハルシネーション率は max で 59%、medium で 68% なので、答えに自信がないとき、Argon より推測しがちです。出典と照らして誰も答えを確認しないオープンなリサーチが仕事なら、それは大きな問題です。
長所: ここで最高のスコア、プロモーション後の Argon の価格表、強力なターミナルコーディング、100万コンテキスト。
短所: max で1タスク $5.98、Argon より推測が多い、管理するベンダーがもう1つ増える。
料金: 100万トークンあたり入力 $4、キャッシュ読み取り $0.20、出力 $20。Batch は50%オフ。詳細は Claude Opus 5.5 pricing をご覧ください。
私の見立て: Argon 水準の作業には Opus 5.5 を medium で使い、追加の6ポイントが元を取れるタスクのために最大エフォートを取っておきましょう。その線引きは Opus 5.5 のレビューで扱っています。
3. Grok 4.7:Argon の誠実さに最も近いもの
最適な用途: 間違った答えのコストが「わかりません」より大きい、リサーチ、分析、Q&A。
これは最も分かりやすい選択ではありませんが、私が最も頻繁に挙げるものです。Grok 4.7 は AA-Omniscience でハルシネーション率 29%、今日呼び出せるモデルで最も低い値です。Argon は15%で、このリストのほかはすべて47%以上です。100問あたりでは、Grok は約15問の誤答、GPT-6 Astra は約19問、Argon は約8問です。
サイバー分野でも Argon と並びます。Google 自身の表では、Argon、Grok 4.7、GPT-6 Astra が CWE-bench v1 で 68% で並んでいます。価格も紙の上では良好です。xAI のモデルページによると、100万あたり入力 $2、出力 $6 で、出力は Argon のプロモーションより40%安くなります。
ただし、落とし穴は現実のものです。同じテストでの Grok の正答率は 47.5% で Argon より低く、そのため辞退が多くなり、答える数は減ります。書き出す量もかなり多く、xhigh エフォートでは1タスク $3.74 で、スコアは 46.4 です。さらに、プロンプトが200Kトークンを超えると、超過分だけでなくリクエスト全体が $4/$12 で課金されます。ローンチ日のコメントのひとつが、テストする価値のある癖を指摘していました:
"What keeps both Gemini and Grok from actually being frontier class AIs is effort. Both AIs rush to give you a response even when the effort is set to the highest setting. Hopefully, Argon isn't as prone to satisficing and premature convergence compared to its predecessor"
長所: 今日得られる最低のハルシネーション率、CWE-bench v1 で Argon と並ぶ、安い出力単価、50万コンテキスト。
短所: Argon より正答率とスコアが低い、xhigh で1タスク $3.74、200K での長文脈価格の段差。
料金: 200K未満で100万トークンあたり入力 $2、キャッシュ $0.50、出力 $6。それを超えると $4/$1/$12。Grok 4.7 pricing をご覧ください。
私の見立て: Argon の15%という見出しに惹かれたのなら、Grok 4.7 は今月手に入る最も近いものです。誠実な「わかりません」が自信満々の推測より価値を持つ場面で使い、実践的なメモは Grok 4.7 のレビューをご確認ください。
4. GPT-6 Astra:Argon とスコアが双子
最適な用途: すでに OpenAI を使っていて、Argon とまったく同じスコア水準に加えて Ultrafast モードも欲しいチーム。
GPT-6 Astra は、Artificial Analysis が Argon と並べたモデルです。最大エフォートで Astra は 52.7、Argon は 52.6 です。正答率では Astra が明確に上で、63% 対 Argon の 50% です。ハルシネーションでは 51% で、わからないときに推測することが多くなります。
トークン効率も良好です。Astra は1タスクあたり約27K出力トークンで、Argon の62Kより少なく、だからこそ Artificial Analysis は、Argon のコスト優位は書く量が少ないからではなく価格に由来すると述べています。Astra は1タスク $3.26、Argon はプロモーション中は $1.99、その後は $3.98 なので、プロモーション後は Astra のほうが安いです。私のテストでは、Astra は bare モードで罠への回答を8件中0件しかでっち上げず、6.1 Sol と並んで最もクリーンな結果でした。
長所: Argon と同じスコア、より高い正答率、プロモーション後の Argon よりタスクあたり安い、Ultrafast モードが今すぐ使える、私のテストで0/8でっち上げ。
短所: 100万あたり $10/$50、6.1 Sol はタスクあたり約5分の1のコストでほぼ同等、指数でハルシネーション51%。
料金: 100万トークンあたり入力 $10、キャッシュ $1、出力 $50。Batch と Flex は50%オフ。GPT-6 Astra pricing をご覧ください。
私の見立て: Ultrafast や、その最後の1ポイントの正答率が今日必要なら、Astra は理にかなっています。それ以外の人には、GPT-6.1 Sol がはるかに安く、ほぼ同じ結果を出します。より広い比較は GPT-6.1 Sol の代替ガイドをご覧ください。
5. Claude Sonnet 5.5:同じ定価でエージェントワークフロー向けの選択
最適な用途: Argon の AutomationBench でのリードが目に留まった、複数ステップのエージェントとターミナルコーディング。
Argon の最も印象的な独立した数値は AutomationBench です。Artificial Analysis で 77.5%、1位です。呼び出せる最も近いモデルは、最大エフォートの Claude Sonnet 5.5 で、71.3% です。Sonnet はそこでの Terminal-Bench 4.0 でも Argon を上回り(63.6% 対 57.1%)、定価は同じ $2/$10 です。
LinkedIn のある実務家が、各ラボの自己申告の数値を引用して、ベンチマークの分かれ方をうまく表現していました:
"On Terminal-Bench 4.0, the one benchmark Google and Anthropic both publish, Argon scores 57.4%. Sonnet 5.5 scores 70.6%. Same price, 13 points apart."

タスクあたりのコストは、より詳しく見る必要がある部分です。最大エフォートでは Sonnet 5.5 は 56.0 ですが、1タスクあたり約194K出力トークンを書くため $7.62 かかります。高エフォートでは $1.08 で 46.7 です。また、エージェントが tool_choice でツール呼び出しを強制すると、Sonnet 5.5 は 400 を返すので、切り替える前に確認してください。
長所: Argon のプロモーションと同じ $2/$10 の定価、呼び出せる中で最強の AutomationBench とターミナルのスコア、Claude モデルの中で最低のハルシネーション(max で47%)。
短所: max で1タスク $7.62、tool_choice の強制はエラーを返す、高エフォート設定ではトークン数が大きい。
料金: 100万トークンあたり入力 $2、キャッシュ読み取り $0.20、出力 $10。Batch は $1/$5。Claude Sonnet 5.5 pricing をご覧ください。
私の見立て: エージェント作業なら、Sonnet 5.5 が最も強力な代替です。高エフォートから始め、エージェントが同じステップで失敗し続けるときだけ上げてください。エフォートの計算は Sonnet 5.5 のレビューにあります。
6. Claude Fable 5.1:最も正確なモデル、ただしプレミアム価格
最適な用途: どのみちすべての回答を確認する専門的な作業で、コストよりも正確さが重要な場合。
Claude Fable 5.1 は Anthropic の一般提供で最も高性能なモデルで、Artificial Analysis で 53.4 を記録し、Argon をわずかに上回ります。この記事のどのモデルよりも正答率が高く、67% で、クローズドモデルの中では長文脈推論のスコアも最高の 85.3% です。
ここで最もハルシネーション率が高いのも 73% で、Argon の鏡像です。Fable は正解する質問も多いですが、答えるべきでない質問にも多く答えます。すべての行を読む弁護士やアナリストなら問題ありませんが、顧客に直接届くものには適しません。
そして価格です。入力 $10、出力 $50、キャッシュ読み取りは $0.25 です。最大エフォートでは1タスク $7.63 です。LinkedIn のある Google 社員は、まさにこの差を使って Argon を売り込みました:
"I've been testing it using our internal AI tool, and the performance is incredible. What stands out more is the cost. 5x cheaper than GPT-6 Astra and Claude Fable 5.1 at current pricing."
これはプロモーション価格でのトークン単価の話です。Artificial Analysis のタスク単位では、Argon は Fable より約3.8倍安く、それでも大きな差です。
長所: ここで最高の正答率、強力な長文脈推論、フロンティアモデルとしては安いキャッシュ読み取り、128K出力。
短所: 100万あたり $10/$50、ハルシネーション率73%、ツール使用の強制は 400 を返す。
料金: 100万トークンあたり入力 $10、キャッシュ読み取り $0.25、出力 $50。Batch は $5/$25。Claude Fable 5.1 pricing をご覧ください。
私の見立て: 人間の専門家が出力をレビューし、最も正解する可能性が高いモデルを求めるときに Fable を選びます。無人で動かすものには、Opus 5.5 または 6.1 Sol のほうが安全な出費です。
7. Gemini 3.8 Flash:実際に構築できる Google のモデル
最適な用途: Google Cloud や AI Studio に取り組んでいるチーム、無料枠でのプロトタイプ、安価なバッチ作業。
Argon が開くまで Google に留まりたいなら、Artificial Analysis の数値では Gemini 3.8 Flash が API 上で最良の Gemini モデルで、高エフォートで 40.9 です。Argon の52.6にはかなり届きませんが、Gemini 3.1 Pro Preview の29.7より上です。ここが人々を戸惑わせる点で、新しい Flash のほうが古い Pro より高いスコアを出しています。
安価で、無料枠もあります。Gemini の料金ページには、2026年12月31日まで入力 $0.75、出力 $3.75、2027年1月1日から $1.50 と $7.50 と記載されています。2027年の料金で予算を立てるほうが無難です。
ここでは私のテストが注意点です。bare モードでは、Gemini 3.8 Flash は8件中4件の回答をでっち上げ、その中には HIPAA の件と、存在しないサポート用メールアドレスが含まれていました。「推測しない」ルールがあれば、何もでっち上げませんでした。つまり、厳格なルールを与えればサポートに適した良いモデルであり、与えなければ危ういモデルです。ある HN のコメント投稿者は、Google のキャッシュについて別の懸念を示していました:
"And this pricing is their 'discount pricing'. Add that to AI studio and Vertex's famously terrible caching, it is hard to see this as competitive."
長所: 今日の API で最高の Gemini スコア、無料枠、ここで最も安いクローズドモデル、私のテストで平均 2.6s の応答。
短所: Argon のスコアをかなり下回る、2027年1月1日に価格が倍になる、厳格なプロンプトなしでは8件中4件をでっち上げた。
料金: 2026年12月31日まで100万トークンあたり入力 $0.75、キャッシュ読み取り $0.075、出力 $3.75。その後は $1.50/$0.15/$7.50。Gemini 3.8 Flash pricing をご覧ください。
私の見立て: 後で Argon に移行する予定なら、今 3.8 Flash で構築しておけば、同じ API とツールに留まれます。ただし、「推測しない」ルールは初日からプロンプトに書いてください。残りは Gemini 3.8 Flash のレビューで扱っています。
8. Gemini 3.1 Pro Preview:Google の慎重な選択肢
最適な用途: Flash よりでっち上げの回答を減らしたく、低めのスコアを許容できる Google スタックのチーム。
Gemini 3.1 Pro Preview は、私の API キーが到達できた最新の Pro モデルで、紙の上では Argon の前身です。Artificial Analysis は Argon がそれを +23 ポイント上回ると述べており、スナップショットと一致します。3.1 Pro は 29.7 です。そのモデルページには、入力上限1,048,576トークン、出力上限65,536トークンと記載されています。
このリストにある理由は、スコアではなく挙動です。ハルシネーション率は 51% で、3.8 Flash の55%より少し良く、正答率は 55% です。私の bare モードのテストでは、Flash の4件に対して8件中1件をでっち上げました。また、思考に多くのトークンを使うため、私の実行の中で最も遅く最も高価で、1,000回答あたり約 6 から 9 秒、$6 から $10 でした。
長所: 私のテストで 3.8 Flash よりでっち上げが少ない、100万入力コンテキスト、Batch は半額。
短所: このリストで Artificial Analysis スコアが最も低い、まだプレビューモデル、遅くトークンを多く使う、200K超の長文脈割増。
料金: 200Kまでは100万トークンあたり入力 $2、キャッシュ $0.20、出力 $12。それを超えると $4/$0.40/$18。Batch は $1/$6。無料枠なし。詳細は Gemini の料金ガイドをご覧ください。
私の見立て: Google に縛られていて、仕事が少量で慎重な回答であるときだけ 3.1 Pro を選びます。それ以外のほとんどでは、Argon が開くまで、3.8 Flash か他社のモデルのほうが良い出費です。
9. Kimi K3:オープンウェイトと最高の長文脈スコア
最適な用途: セルフホストが必要なチーム、または非常に長い文書のために Argon を求めていたチーム。
Argon はクローズドなので、ダウンロードできるウェイトが必要なら、リストはかなり短くなります。Moonshot AI の Kimi K3 は、完全なウェイトをカスタムライセンスで Hugging Face に公開しており、最大エフォートで Artificial Analysis の 43.6 を記録します。また、私が確認したどのモデルよりも長文脈推論のスコアが高く、88.7% で、Argon の 79.7% を上回ります。
ホスト型 API では、Kimi の料金ページによると、100万あたり入力 $3、キャッシュ $0.30、出力 $15 で、トークン単価では Argon のプロモーションより高くなります。タスク単位では $2.00 で、Argon とほぼ同じです。推論はオフにできません。
より安価なオープンの選択肢は DeepSeek V4.1 Flash で、MIT ライセンス、オフピークで100万あたり $0.15/$0.60、1タスク $0.27 です。ただし、Argon のような誠実さが必要な顧客向けのものには近づけないほうがよいでしょう。指数でのハルシネーション率が 96% だからです。
長所: このリストで最強のオープンウェイト、ここで最高の長文脈推論スコア、100万コンテキスト、画像・動画入力。
短所: カスタムライセンスで MIT や Apache ではない、ホスト型 API はトークン単価で Argon のプロモーションより高い、ハルシネーション率53%。
料金: 100万トークンあたり入力 $3、キャッシュヒット $0.30、出力 $15。Kimi K3 pricing をご覧ください。
私の見立て: Kimi K3 は、セルフホストや文書の多い作業向けの選択です。ホスト型 API だけで足りるなら、6.1 Sol のほうが安く、スコアも高いです。
セキュリティ作業のために Argon を求めていた場合
Argon の最初のユーザーはセキュリティチームなので、そのために来た読者もいます。Google 自身の数値はかなり強力です。実世界の脆弱性ベンチマークで 85.8、Gemini 3.8 Flash Cyber の 71.0 に対して、Wiz のブラックボックス侵入テストでは 70.9% 対 58.2% です。いずれもローンチ記事によります。
フロンティアラボはどこも、最強のセキュリティモデルを同様に制限しています。Anthropic の Claude Mythos 5.1 は Project Glasswing の背後にあり、OpenAI の GPT-5.6-Cyber は独自の信頼されたアクセスプログラムの背後にあります。これらのプログラムに参加していない場合、今日サインアップできるツールは Codex Security Cloud の代替ガイドで扱っています。上記の汎用モデルの中では、GPT-6 Astra と Grok 4.7 が CWE-bench v1 で Argon と並ぶため、出発点として妥当です。
サポートにおけるハルシネーションについて、私のテストが示すこと
このテストは、Argon の見出しの数字の読み方を変えました。ハルシネーション率15%は、資料なしの結果です。モデルは何も手元にない状態で雑学に答えます。サポートボットは資料なしではありません。ヘルプセンターとマクロ、ポリシーがあり、それが尽きたときに何をするかを指示が教えます。その設定では、モデルよりも指示のほうが大きな働きをしました。ルールがあれば40件中0件のでっち上げ、なければ8件中最大4件です。
eesel は、実際のキューでも bare モードの失敗を見てきました。今年の初め、有料の eesel 顧客の何社かで、ナレッジベースが空で返ってきたときに、ボットが一般知識で実際の顧客に回答していて、あるボットはサポートの質問に「Oxygen」と答えました。別のチーム、Zendesk を使う B2B の技術サポートグループは、別の理由で心配していました。ヘルプセンターに「we support all models」と書いてあったため、ボットが、サポートしていない製品を喜んで確認してしまったのです。どちらの問題もモデルではありませんでした。どちらも根拠づけとフォールバックの問題で、だからこそ、あらゆるサポートボットで私が最初に確認するのは、稼働前に過去のチケットでテストした、「わからないと伝えて引き継ぐ」という厳格なルールです。
それは購入者が求めていることでもあります。月に約7,000件のチケットを扱う CX リーダーは、営業の電話で eesel チームに、AI は自信のあるチケットだけを引き受け、残りは人間に任せるべきだと伝えました。それは引き継ぎのルールです。Argon の誠実さは良い予備になりますが、そのルールは今日、どのモデルでも設定できます。方法は AI ハルシネーション防止ガイドと AI エスカレーションガイドで扱っています。
eesel を試す

サポートボットをより信頼できるものにするために Argon を待っていたなら、待つ必要はありません。eesel は、Zendesk、Freshdesk、Gorgias の既存のキューに加わり、ヘルプセンターと過去のチケットから学習し、根拠を示せるものにだけ回答する AI ヘルプデスクのチームメイトです。誰かに返信する前に、チケット履歴でシミュレーションを実行するため、どの質問に答え、どれを引き継ぐかがわかります。Argon が開放されたときは、ルールはそのままで、モデルだけを変えられます。
ターミナルで作業するなら、eesel CLI がダッシュボードと同じチームメイトとワークスペースを操作します。古いチケットのバッチでシミュレーションをスクリプト化し、回答を自分のレビューシートに取り込み、Claude Code、Codex、Cursor のようなコーディングエージェントに設定を任せることもできます。eesel を無料で試し、モデルを選ぶ前に自分のチケットで実行してみてください。
よくある質問
現時点で最も良い Gemini 4 Argon の代替は何ですか?
Gemini 4 Argon はもう使えますか?
gemini-4-argon に対してまだ 404 を返しており、私のキーで一覧できた61モデルにも含まれていませんでした。Google は、有料 API 顧客と Google AI Ultra の加入者が次で、時期は未定としています。Gemini 4 Argon の概要記事で、わかっていることを追跡しています。Gemini 4 Argon の代替で最もハルシネーションが少ないのはどれですか?
Gemini 4 Argon に代わる Google のモデルはありますか?
GPT-6.1 Sol は Gemini 4 Argon より安いですか?
Gemini 4 Argon に代わる最良のオープンウェイトモデルは何ですか?
カスタマーサポートボットに Gemini 4 Argon は必要ですか?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.