Cohere Embed 5とは何か
Cohereは、Commandモデル、Rerank、ドキュメントパーサーのParse 5を手がけるエンタープライズ向けAI企業です。エンベディングモデルは、あらゆる検索やRAGシステムの目立たない部分で、テキストのかたまり(または画像)を数値のリストに変換します。意味が近いチャンクは近くに配置されます。ユーザーが質問すると、その質問も数値に変換され、システムが最も近いチャンクを取得します。
エンベディングモデルが弱いと、正しい答えがそもそも取得されず、巧みなプロンプトでは直せません。これはAIエンタープライズ検索を支えるのと同じレイヤーです。
Embed 5はCohereのフラッグシップとしてEmbed 4を引き継ぎ、2つのティアがあります。Proは「optimized for maximum quality across multimodal, multilingual, financial, code, and parsed-document retrieval」、Fastは「brings highly competitive performance to latency- and cost-sensitive workloads」とされています。
私はeeselでAIエージェントを作る仕事をしており、デバッグ時間の大半は検索レイヤーに費やしているため、まずこのスペックを探しました。Cohereのモデルドキュメントとリリース記事から、並べて示します。
| Embed 5 Pro | Embed 5 Fast | Embed 4(旧版) | |
|---|---|---|---|
| APIモデルID | embed-v5.0-pro | embed-v5.0-fast | embed-v4.0 |
| テキスト料金(100万トークンあたり) | $0.12 | $0.08 | $0.12 |
| 画像料金(100万トークンあたり) | $0.40 | $0.40 | $0.47 |
| コンテキスト長 | 128Kトークン | 128Kトークン | 128Kトークン |
| 入力 | テキスト、画像、テキスト+画像の統合 | テキスト、画像、テキスト+画像の統合 | テキスト、画像、混在 |
| 出力次元 | 256〜2048(デフォルト2048) | 256〜2048(デフォルト2048) | 256〜1536(デフォルト1536) |
| フォーマット | float, int8, binary | float, int8, binary | float, int8, binary |
| 言語 | 100+ | 100+ | 多言語 |
| 向いている用途 | オフラインのインデックス作成、品質重視の検索 | ライブクエリ、エージェントのループ、大量処理 |
Embed 4の料金は、Cohere自身の料金ページにはもう掲載されていないため、Microsoft FoundryのCohere料金から取っています。OpenAIの3シリーズから移行する場合、そのAPI料金はtext-embedding-3-largeの$0.13が上限のままです。Cohereの表には見落とされがちな小さな点が2つあります。デフォルトの出力が1536から2048次元に増えたことはストレージに影響します(詳しくは後述)。また、画像入力は100万トークンあたり$0.47から$0.40に安くなりました。
Embed 5の仕組み:Proでインデックス、Fastでクエリ
私ならこの機能を軸に設計しますし、宣伝されることが最も少ない機能でもあります。OpenAIエンベディングAPIを含め、ほとんどのエンベディングファミリーでは1つのモデルを選んで使い続ける必要があります。異なるモデルのベクトル同士は比較できないためです。CohereはProとFastを単一の共有空間に学習させたので、Fastでエンベディングしたクエリを、Proでエンベディングしたドキュメントと直接照合できます。
これが重要なのは、インデックス作成とクエリが正反対のものを求めるからです。インデックス作成は一度(またはドキュメント更新のたび)だけ行われ、誰も待っていないので、お金で買える最高の品質が欲しい場面です。クエリはユーザーのリクエストごとに発生し、レイテンシの予算内で実行されるため、重要なのは速度です。共有空間があれば、それぞれの側を別々に選べます。
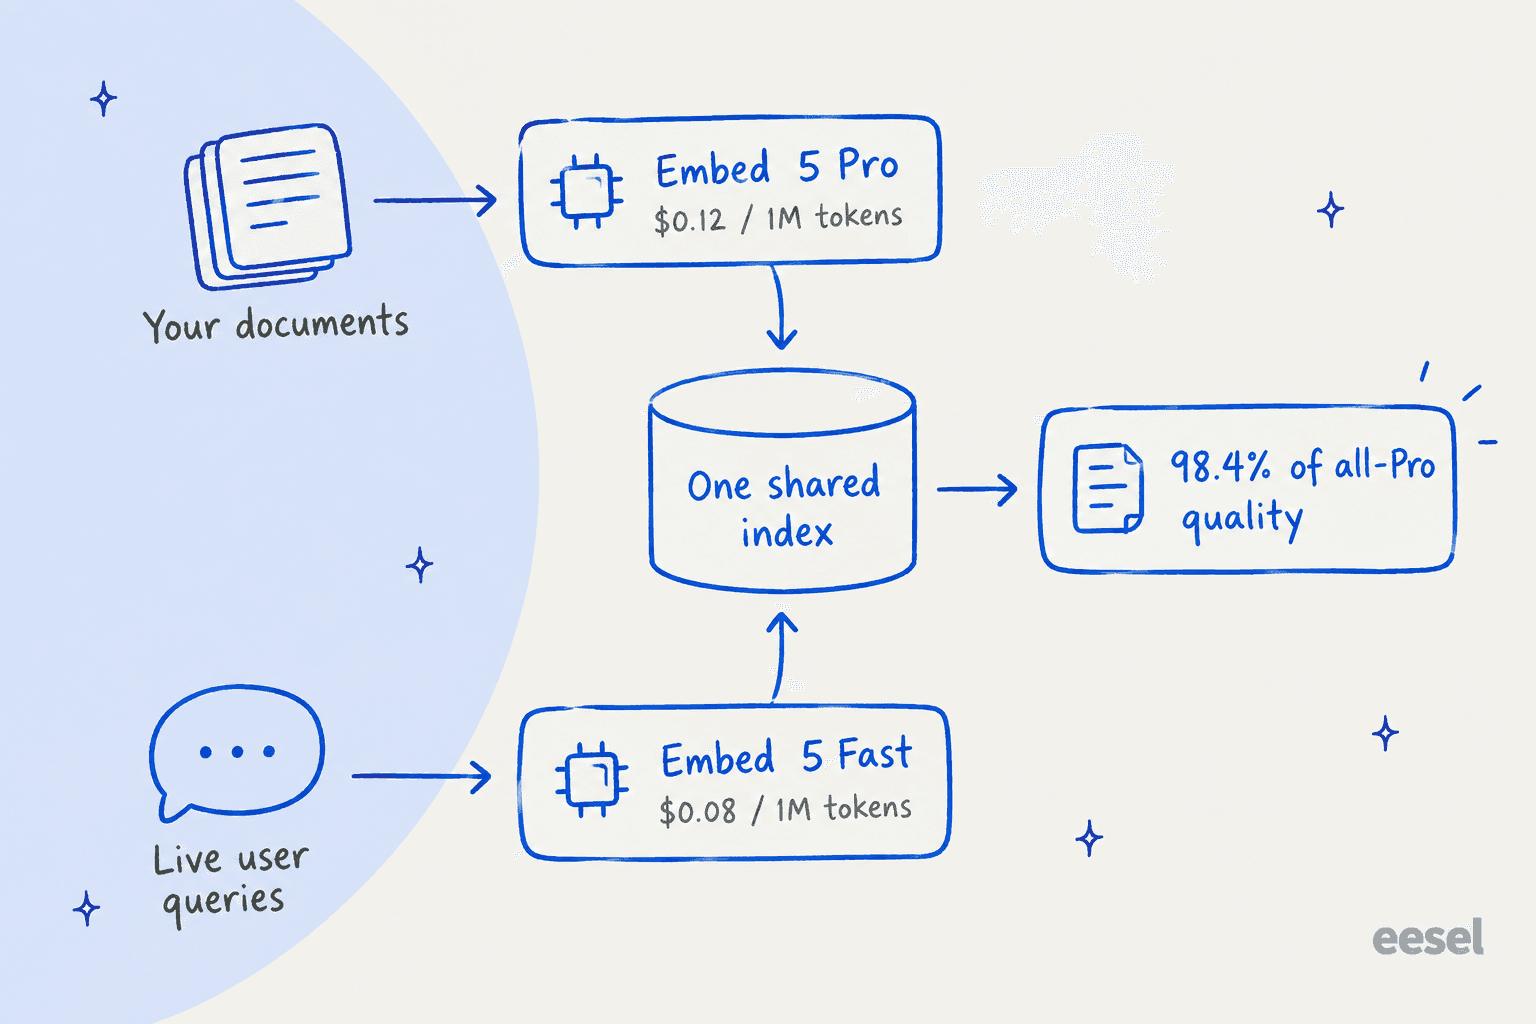
Cohereは40の開発用データセットですべての組み合わせを実行し、Proのドキュメント+Proのクエリを100とするようにスコアを正規化しました。
| 平均検索品質 | Fastでインデックスしたドキュメント | Proでインデックスしたドキュメント |
|---|---|---|
| Fastでのクエリ | 96.6 | 98.4 |
| Proでのクエリ | 97.3 | 100 |
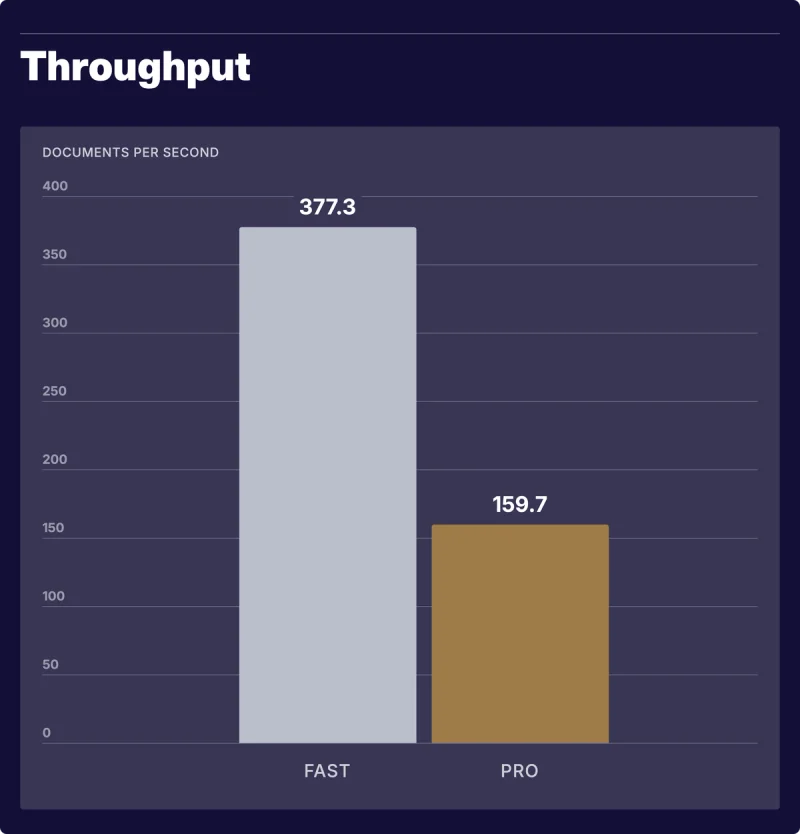
つまりProのインデックス+Fastのクエリは98.4で、損失は1.6%です。その一方で、FastはクエリのときにProの約2.4倍のスループットで処理します(Cohereのテストで1秒あたり377.3件対159.7件)。Cohere自身がまさにこのパターンを推奨しており、脚注には知っておくべき注意点があります。両側で同じ出力次元を使う必要があるということです。このペアリングは、Matryoshka切り詰めとint8量子化を加えても成り立つため、圧縮したインデックスでも使えます。
呼び出し方に影響する、EmbedリファレンスのAPI詳細をいくつか挙げます。
input_typeは必須です。 インデックス作成時はsearch_document、クエリ時はsearch_queryを使います。classificationとclusteringのモードもあります。- 1回の呼び出しで96件の入力。 各入力にテキストと画像の部分を混在でき、ペイロード合計の上限は20MBです。
- 切り詰めのデフォルトは
ENDです。 128Kのコンテキストなら到達することはまれですが、長いドキュメントの末尾が黙って切り捨てられるよりエラーのほうがよければ、truncateをNONEにしてください。 - レート制限はリクエストごとではなく入力ごとです。 レート制限のページによると、トライアルキーも本番キーもテキスト入力は毎分2,000件、画像入力は毎分5件対400件です。トライアルキーは無料ですが、月1,000回の呼び出しまでで、本番利用は認められていません。
ベンチマーク:強力だが、注意書きを読もう
Cohereが公表した数値は良好です。以下は、8つの領域のエンタープライズ文書を対象とするViDoRe V3の主要な表です。
| モデル | ViDoRe V3平均 | テキスト料金(100万トークンあたり) |
|---|---|---|
| Cohere Embed 5 Pro | 85.8 | $0.12 |
| Cohere Embed 5 Fast | 84.5 | $0.08 |
| Voyage 4 Large | 83.7 | $0.12 |
| Gemini Embedding 2 | 83.2 | $0.20 |
| Cohere Embed 4 | 77.0 | $0.12 |
| OpenAI text-embedding-3-large | 75.5 | $0.13 |
| Jina Embeddings v5 Text Small | 74.5 | $0.05 |
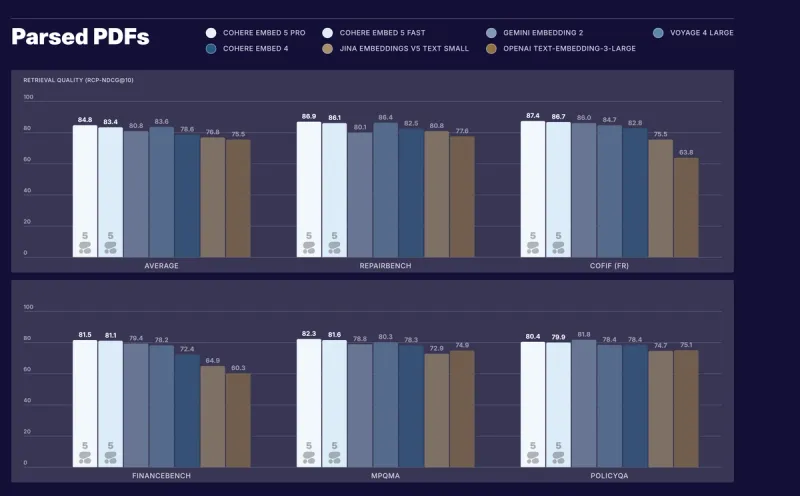
同じテストでProはEmbed 4から8.8ポイント向上し、最大の伸びは人事(+11.4)と産業文書(+10.3)です。Cohere独自の解析済みPDFスイートでも84.8でトップです。金融検索では、FinanceBench(80.1)とFinQA(90.0)、ViDoRe V3 Finance(85.0)で1位となり、いずれもFastが2位です。
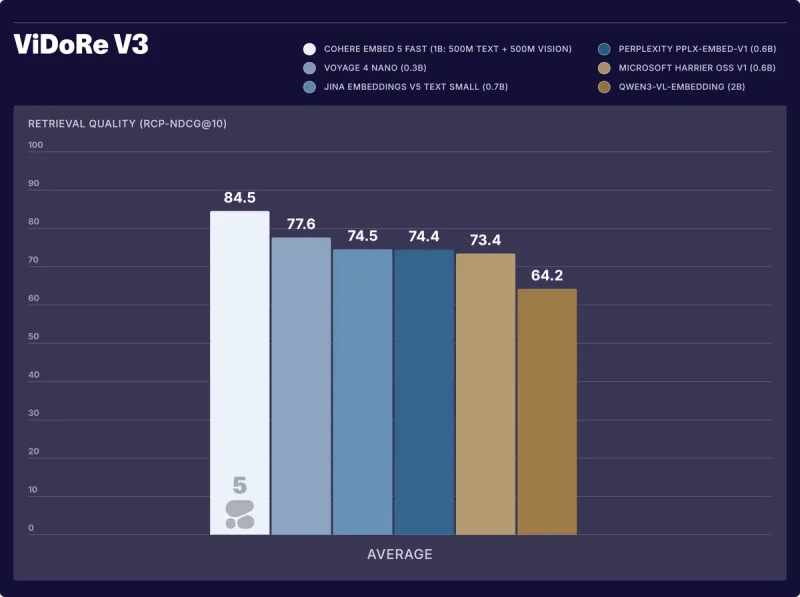
私にとって最も印象的な結果は、実はFastです。ViDoRe V3で他のコンパクトなモデルと比べると84.5で、Voyage 4 Nanoは77.6、Qwen3-VL-Embeddingは64.2です。Cohere自身のグラフ(下)の凡例では、Fastは約10億パラメータ、テキスト5億とビジョン5億とされており、リリース記事では、サイズが約半分でありながらQwen3-VL-Embedding-2Bを約20ポイント上回るとしています。
ここからが注意書きです。公平に読むには必要だからです。
これは新しい指標で、ベンダー自身が実施したものです。 Embed 5は、Cohereが同じ日に公開した手法であるRCP-nDCG@10で採点された最初のモデルファミリーです。Cohere自身の脚注には、固定された候補集合を並べ替えてモデルを評価するため、「scores therefore reflect reranking quality rather than first-stage retrieval performance.」とあります。妥当な測定方法であり、コードも公開されていますが、インデックス全体に対して単純なtop-10検索を実行して得られる数値と同じではありません。また、データセットの一部は内部のもので、たとえば「High Finance」セットはCohereが自分でアノテーションしました。
Gemini Embedding 2は、ヨーロッパ以外の言語の大半で勝っています。 Proはヨーロッパのセット(ドイツ語、フランス語、スペイン語、イタリア語、ロシア語の平均77)でリードしています。しかしCohere自身の10言語の表では、Gemini Embedding 2が10言語中9言語でProを上回ります。日本語、韓国語、アラビア語、ペルシア語、ヒンディー語、ベンガル語、テルグ語、インドネシア語、タイ語です。Proがわずかに上回るのは中国語だけです(82対81)。差が最も大きいのはテルグ語で、91対80です。
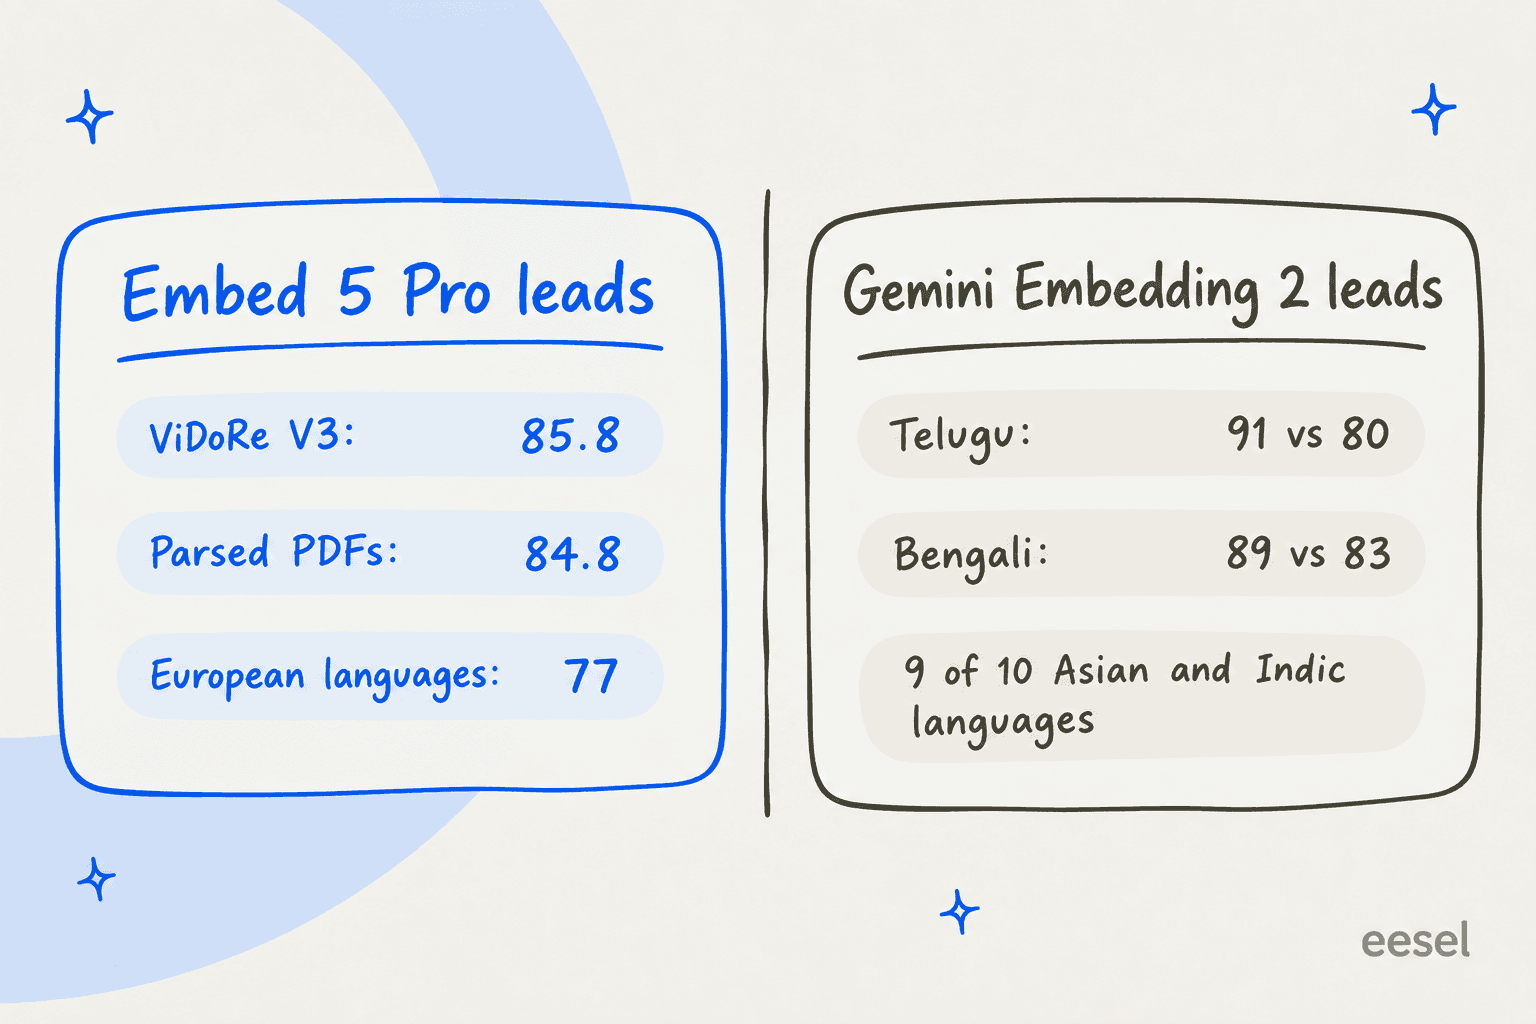
サポートの問い合わせやドキュメントがヒンディー語、タイ語、ベンガル語に大きく偏っているなら、この表はリリース全体で最も有用な情報であり、これを掲載したCohereは評価に値します。ヨーロッパと英語圏で多言語ナレッジベースを運用するチームにとっては、これらの数値ではProのほうが強い選択肢です。
コミュニティの反応は、リリースの翌日らしくまだ早く、数も少ないです。私が見つけた実務者の声で最も有用なのは古いもので、Embed 5そのものではなくCohereのエンベディング全般についてです。
"My experience with Cohere and interacting with their sales engineers has been boring, I say that is the most flattering way possible. Embeddings are a core service at this point like VMs and DBs. They just need to work and work well and thats what they're selling."

これはここでの売り込みとよく合致します。Embed 5は刺激的であろうとはしていません。検索の下に位置する、退屈で信頼できるレイヤーであろうとしています。
Cohere Embed 5の料金
Embed 5の課金は入力トークンごとで、出力には課金されません。Cohereが公開しているすべてを、料金ページとリリース記事から示します。
| オプション | Embed 5 Pro | Embed 5 Fast | 課金単位 |
|---|---|---|---|
| Cohere API、テキスト | 100万トークンあたり$0.12 | 100万トークンあたり$0.08 | 入力トークン |
| Cohere API、画像 | 100万トークンあたり$0.40 | 100万トークンあたり$0.40 | 画像トークン |
| トライアルキー | 無料、月1,000回の呼び出し | 無料、月1,000回の呼び出し | 本番利用不可 |
| Model Vault Small | $3.00/時間または$2,000/月 | $3.00/時間または$2,000/月 | 専用インスタンスごと |
| Model Vault Medium | $5.00/時間または$3,250/月 | $5.00/時間または$3,250/月 | 専用インスタンスごと |
| Amazon SageMaker | ホスト1時間あたり$2.39〜$8.48 | ホスト1時間あたり$2.39〜$3.36 | ソフトウェア料金+AWSインスタンス費用 |
| Microsoft Foundry | 未公開(プレビュー) | 未公開(プレビュー) |
SageMakerの料金は、Embed 5 ProのAWS Marketplaceの掲載情報によるもので、Fastにも対応する掲載があります。Cohereは毎月末、または未払い額が$250に達した時点で早めに請求します。その他のカタログ(Rerank、Parse、Command)については、私のCohere料金完全ガイドをご覧ください。PDFの解析も行う場合は、Parse 5の料金の解説がその課金メーターを扱っています。
予算を決める前に知っておきたかった、課金に関する3つの注意点があります。
- 画像トークン数は文書化されていません。 料金は画像トークン100万あたりですが、Cohereは1画像あたりのトークン数の計算式を公開していません。APIレスポンスは画像を件数(
"images": 1)で報告するため、100万枚のページ画像をエンベディングする前に、小さなテストバッチを実行して請求額を確認してください。 - Model Vaultが元を取れるのは非常に大量の処理のときだけです。 月$2,000のSmallインスタンスは、API料金で換算すると約167億のProトークン、または250億のFastトークンに相当します。それ以下ならAPIのほうが安くなります。Vaultを選ぶ本当の理由は、価格ではなく、分離と確保された容量です。
- Bedrockではまだ使えません。 Amazon Bedrockは依然としてEmbed 4を掲載しており、100万トークンあたり$0.12で、Embed 5のSKUはありません。OpenRouterにはCohereのエンベディングモデルがまったくありません。
ここでトークン単価が最も重要でない数字である理由
現実的なサポート環境で計算してみましょう。私が日々仕事をしているのはこの世界だからです。ヘルプセンターの記事が2,000件(各約1,500トークン)、過去のチケットが20万件(各約600トークン)あるとすると、合計で約1億2,300万トークンです。これをすべて一度Proでエンベディングすると約$14.76、Fastなら約$9.84です。月5万件の顧客の質問を1件30トークンとすると150万トークンで、Fastなら約12セントです。つまり、エンベディングの費用は実質的に誤差です。
誤差にならないのはストレージで、次元数と精度の両方に比例して増えます。Cohere自身の例では、2048次元のfloat32ベクトルは8 KB、1024次元のint8ベクトルは1 KB、256次元のバイナリベクトルは32バイトです。
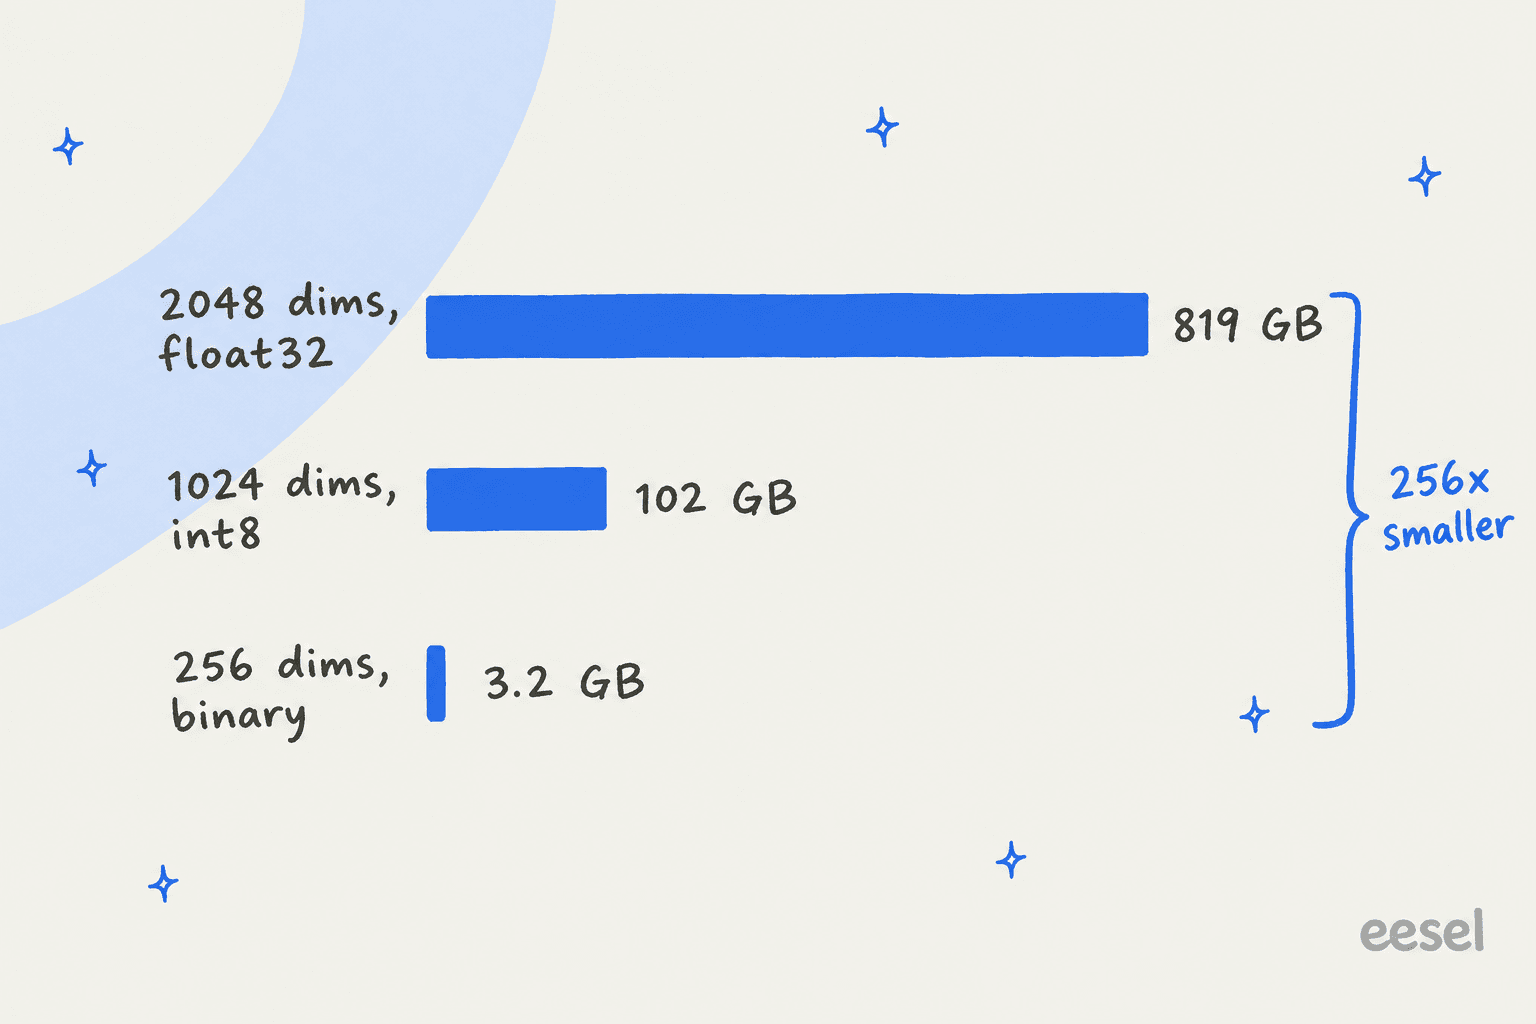
1億チャンクの場合、デフォルトのfloat32出力は生ベクトルで約819 GBです。PineconeのStandardプラン(またはホスト型のベクトルストア)で1 GBあたり月$0.33とすると、インデックスのオーバーヘッド前で毎月約$270かかります。同じチャンクを1024次元のint8にすると約102 GBで、月約$34です。この1億チャンクを一度エンベディングする費用(1チャンク約500トークンとして)は、Proで約$6,000の一回限りの費用です。インデックスを作る前に、次元数と精度を決めてください。あとで変更すると、すべてを最初からエンベディングし直すことになるからです。
Cohereの推奨もこれと一致します。「For most deployments, we recommend 1,024-dimensional int8 vectors as the ideal performance-efficiency point,」そしてint8は「retains near-full-precision retrieval quality.」バイナリは最小で、精度はいくらか落ちますが、リランカーの前段の高速な一次選別として優秀です。
Embed 4からのアップグレード:計画すべきこと
現在Embed 4を使っているなら、アップグレードはモデル名を差し替えるだけでは済みません。計画しておくべき点は次のとおりです。
- すべて再インデックスします。 CohereはProとFastが互いに空間を共有するとしています。Embed 4のベクトルがEmbed 5のベクトルと比較できるかについては何も述べていないので、比較できないものと仮定し、完全な再エンベディングを予算に入れてください。上記の価格なら通常は金額的に安く済みますが、エンジニアリングの工数は高くつきます。
- デフォルトの次元数に注意します。 Embed 4のデフォルトは1536、Embed 5は2048です。ベクトルデータベースのインデックスが1536に固定されているなら、
output_dimension=1536を渡す(Embed 5は対応しています)か、インデックスを作り直してください。 - クラウド環境を確認します。 BedrockやOracle OCI経由でCohereを呼び出している場合、Embed 5はまだありません。リリース時の提供先は、Cohere API、Model Vault、Microsoft Foundry、SageMakerです。
- バッチジョブ。 Cohereは大規模取り込み向けにバッチエンベディングが利用できるとしていますが、ドキュメントの表にはv5モデルについて標準のEmbedエンドポイントしか載っていません。一括処理のパイプラインを設計する前に、お使いのモデルでEmbed Jobsが使えるか確認してください。
モデルを責める(あるいは称賛する)前に、まずパイプラインの他の部分を確認しましょう。エンベディングのファインチューニングに関するr/Ragのスレッドへのこの返信は、モデル入れ替えについて私が見つけた最も実用的なアドバイスです。
"more than I expected. but only after chunking was already clean. dirty chunks make every embedding model look bad."

これは私自身の経験とも一致します。実例が欲しければ、Zendesk Guide上のセマンティック検索のガイドがチャンク分割の側面を順を追って説明しています。より良いエンベディングモデルが最も効果を発揮するのは、チャンク分割がすでにしっかりしていて、ハイブリッド検索とリランカーが整っているときです。
Embed 5が合う場面と合わない場面
独自の検索やRAGスタックを構築するプラットフォームチームで、特に長文、視覚的に豊富な文書、金融文書を扱うなら、Embed 5は優れた選択です。128Kのコンテキストにより不自然なチャンク分割が減り、テキストと画像を統合した入力でスライドやスキャンしたページにも対応できます。さらに、Pro/Fastの分離により、速度と品質のきれいなダイヤルが得られます。Parse 5でPDFをMarkdownに変換し、Rerankで一致結果を並べ替えれば、Cohereの検索スタック一式がそろいます。Cohereはまた、マネージド検索プラットフォームのCompass Cloudがプライベートベータに入ったと発表しました。
"Cohere seems to be doing a lot on the search side this year with their parsing model, Compass Cloud announcement, and now Embed 5... exciting stuff"
本当の目的が、チーム向けのAIナレッジベースや、ヘルプセンターと過去のチケットからお客様の質問に答えるAIのような、日常的に使うツールであるなら、スタックの階層が違います。エンベディングモデルが渡してくれるのはベクトルです。チャンク分割、ベクトルデータベース、リランカー、GPT-6.1 Solのような生成モデル、ガードレール、そして回答をヘルプデスクに組み込む手段が、依然として必要です。
トレードオフを深く知りたい場合は、まずRAGと素のLLMの比較から始めてください。ヘルプセンターに特化した内容としては、RAGとファインチューニングの比較という別のガイドがあります。
ライブのサポートキューでAIを運用して最もつらかった教訓は、検索の品質ではなく、検索結果が空で返ってきたときに何が起こるかに関するものです。ナレッジベースに関連する情報がなく、モデルが学習データでその穴を埋めた結果、有料顧客のボットが実際のお客様に自信たっぷりのでたらめな主張で回答するのを見てきました。より良いエンベディングモデルはこれを減らしますが、不可能にはしません。解決策は上のレイヤーにあります。関連するものが見つからないときの確実なフォールバックと、公開前の実チケットでのテストです。
パイプラインではなく答えが欲しいなら、eeselをお試しください
サポートの課題がきっかけでエンベディングモデルについて読んでいるなら、eeselが近道です。eeselはAIチームメイトプラットフォームで、そのAIヘルプデスクのチームメイトは、組み立て済みの検索スタック一式です。ヘルプセンター、ドキュメント、過去のチケットに接続し、ヘルプデスク、Slack、共有可能なリンク内で返信を下書きまたは送信します。ベクトルのサイズ設計も、新しいモデルが出たときのインデックス再構築も不要です。
ほとんどのサポートチームがすでに使っているヘルプデスクに対応しています。Zendeskではマクロと解決済みチケットから回答し、FreshdeskとGorgiasでは、担当者と同じキューで作業します。

実際のお客様に触れる前に、eeselは過去のチケットで導入をシミュレートするため、送信したはずの返信と解決率を事前に確認できます。あらゆるチケット解決の自動化は、こうして本番のキューでの居場所を勝ち取ってほしいと私は考えています。
ターミナルでの作業が好きでここに来たのなら、eesel CLIを使うと、同じチームメイトをコマンドラインから動かせます。eesel integrations connectで連携を接続し、常設の指示を編集し、保留中のアクションを承認または拒否し、eesel activityですべての実行を確認できます。すべてのコマンドはJSONを返し、--dry-runに対応しているので、スクリプトやClaude Codeのようなコーディングエージェントからも操作できます。ターミナルからのエージェント管理の詳しい手順と、カスタマーサポート向けCLIについての短い解説があります。
eeselを試す:ご自身のチケットで無料でお試しいただけます。
よくある質問
Cohere Embed 5の料金はいくらですか?
テキスト100万トークンあたり$0.12、Embed 5 Fastが$0.08です。画像入力はどちらも画像100万トークンあたり$0.40です。専用のModel Vaultインスタンスは1時間$3.00(月額$2,000)から始まります。Cohere全体の料金表については、このCohereの料金解説をご覧ください。Embed 5 ProとEmbed 5 Fastの違いは何ですか?
Cohere Embed 5はOpenAIのエンベディングより優れていますか?
Embed 4からEmbed 5へ移行するには、データを再エンベディングする必要がありますか?
output_dimensionを明示的に指定してください。Cohere Embed 5はAmazon Bedrockで使えますか?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.