Cohere Embed 5の料金を一目で
Cohereは2026年9月30日にEmbed 5ファミリーを2つのティアで発表しました。どちらも128Kのコンテキストと100以上の言語に対応し、入力はテキスト、画像、またはテキストと画像を融合したものが使えます。公表されているすべての価格を1つの表にまとめました。Cohereの料金ページ、発表記事、クラウドマーケットプレイスの掲載情報から直接取っています。
| オプション | 価格 | 課金単位 | 向いている用途 |
|---|---|---|---|
| トライアルキー | 無料、月1,000回の呼び出し | 該当なし(本番利用不可) | テスト |
| Embed 5 Pro、テキスト | $0.12 / 100万トークン | 入力トークン | ドキュメントのインデックス化 |
| Embed 5 Fast、テキスト | $0.08 / 100万トークン | 入力トークン | クエリ、エージェントのループ |
| Embed 5 ProまたはFast、画像 | $0.40 / 100万トークン | 画像トークン | ページ画像、スライド |
| Model Vault Small(ProまたはFast) | $3.00/時間 または $2,000/月 | 専用インスタンス | 安定した大量処理 |
| Model Vault Medium(ProまたはFast) | $5.00/時間 または $3,250/月 | 専用インスタンス | 非常に大量の処理 |
| Amazon SageMaker | $2.39〜$8.48/ホスト/時間 のソフトウェア料金 + インスタンス | 時間 | すでにAWSを使っているチーム |
| Microsoft Foundry | プレビューで掲載、価格は未定 | 該当なし | Azureを使っているチーム |
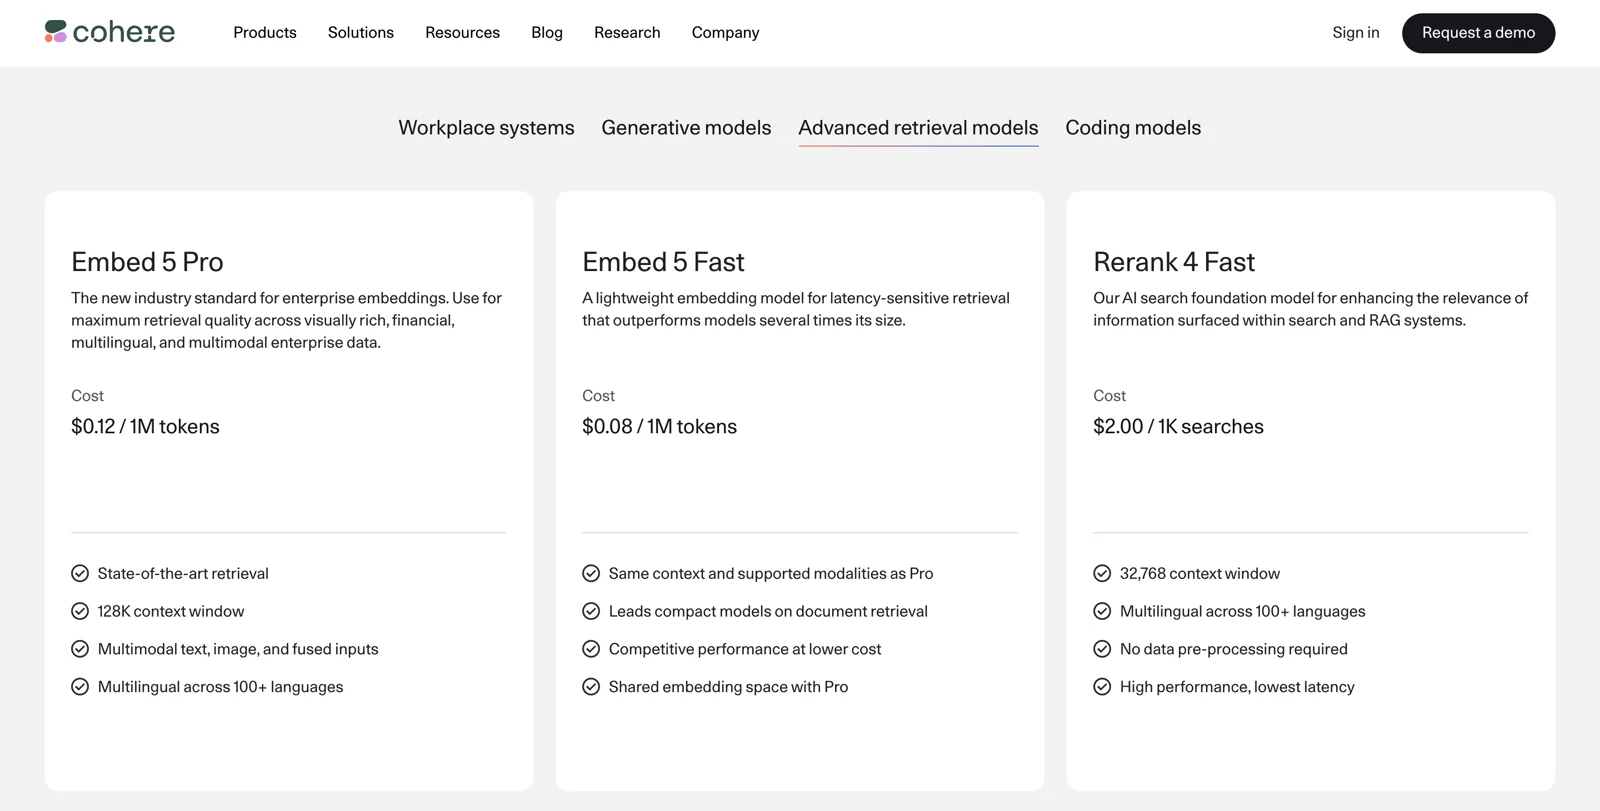
同じタブには、1,000ページあたり$1.50のParse 5や、1,000検索あたり$2.00からのRerank 4も載っており、Embed 5と合わせてCohereが販売する検索スタック一式になります。カードを読んで気づいた点が2つあります。1つ目は、Model VaultではProとFastの料金が同じなので、専用インスタンスでは「Fastのほうが安い」という理屈が消え、Fastを選ぶ理由は速度だけになることです。2つ目は、Embed 4が料金ページから完全に消えていることです。モデルのドキュメントには非推奨の告知なしにまだ載っています。今Embed 4を使っていても何も壊れませんが、Cohereがどこに移行してほしいのかは、かなりはっきりしています。(ラインナップの残りはCohere AIのレビューで扱っています。)
私はeeselで連携機能を作っていますが、ヘルプセンターと数年分のチケットをAIが検索できる形にするeeselの部分は、まさにこのレイヤーです。だから埋め込みの料金カードを読むときは、配管工が配管の見積もりを読むように読みます。単価は確かに重要ですが、本当に見積もっているのは、その配管がつながるものすべてです。
Embed 4からの変更点
要点は、Cohereは価格を据え置き、それ以外のほぼすべてを動かしたということです。AzureのCohere料金とCohereの8月時点の料金スナップショットにあるEmbed 4の料金を使って、並べて比較します。
| Embed 4 | Embed 5 Pro | Embed 5 Fast | |
|---|---|---|---|
| テキスト、100万トークンあたり | $0.12 | $0.12 | $0.08 |
| 画像、100万トークンあたり | $0.47 | $0.40 | $0.40 |
| Model Vault Small | $4.00/時間、$2,500/月 | $3.00/時間、$2,000/月 | $3.00/時間、$2,000/月 |
| デフォルトの次元数 | 1536 | 2048 | 2048 |
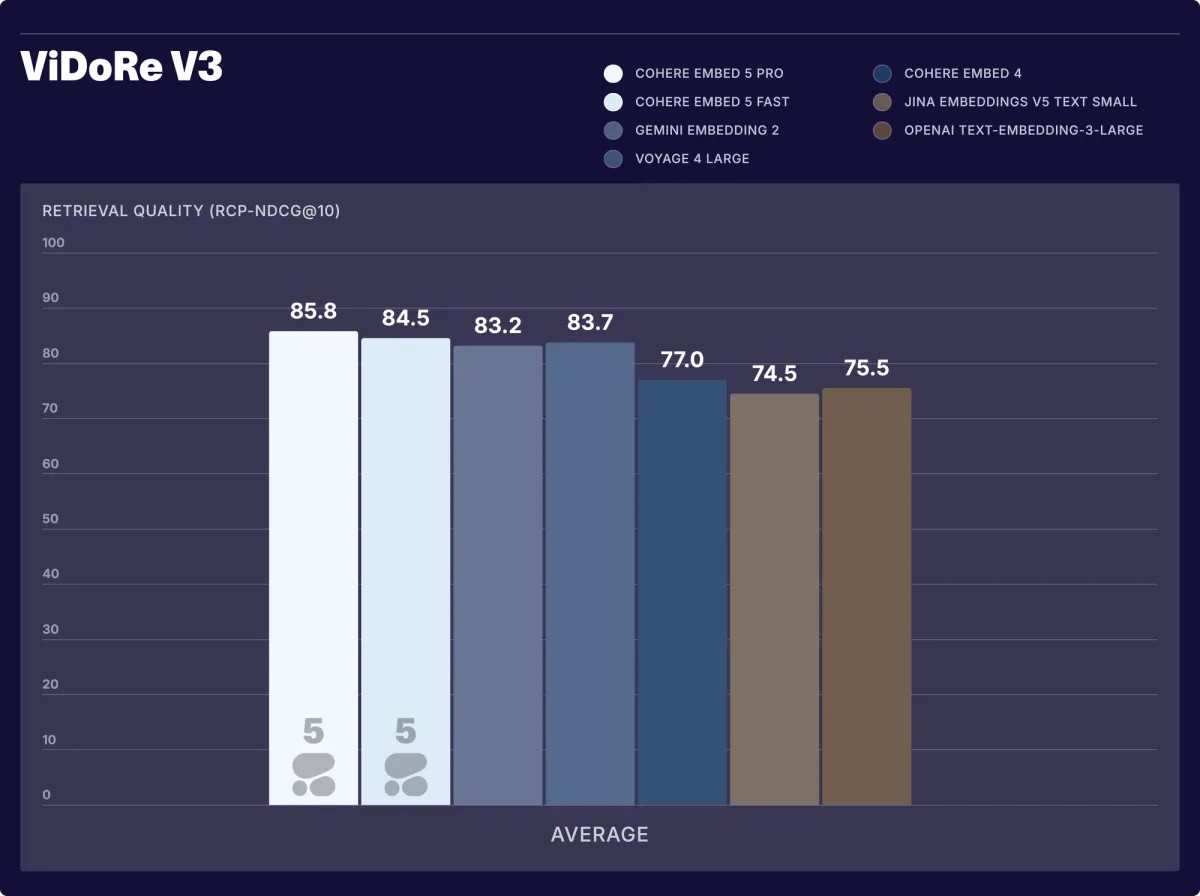
| ViDoRe V3スコア(Cohere) | 77.0 | 85.8 | 84.5 |
つまり、テキスト料金は同じまま品質が8.8ポイント向上し、画像は15%安く、専用インスタンスは月$500安くなりました。一方、Fastはこれまで存在すらしませんでした。
私が丸をつけるのは、デフォルトの次元数の行です。トークンあたりの価格は同じですが、各ベクトルはデフォルトで3分の1大きくなります。モデルを入れ替えてデフォルト設定のままにすると、埋め込みの請求は変わらず、ベクトルデータベースの請求が増えます。簡単で実際にお金を節約できる対処法は、後ほど説明します。
課金対象のトークンとは
Cohereの課金ドキュメントでは、embedは埋め込まれたトークン数に基づいて課金され、Cohereが裏で追加するトークンは課金されないと説明されています。支払うのは入力分だけです。埋め込み呼び出しが返すのはテキストではなく数値のリストなので、出力トークンの料金はまったくありません。
実際の請求を左右する詳細がいくつかあります。
- バッチ処理でも価格は変わりません。 各embed呼び出しは最大96件のテキストまたは入力を受け付けます。スループットには有利ですが、トークンあたりのコストは同じです。
- 画像はトークン単位で課金されますが、換算方法は公開されていません。 ドキュメントにはリサイズ(2,458,624ピクセルを超える画像は縮小されます)の説明はありますが、画像1枚あたりのトークン数の計算式はありません。大量のPDFアーカイブの予算を立てる前に、小さなサンプルで試すのがおすすめです。
- バッチ割引の記載はありません。 発表記事にはバッチ埋め込みが利用可能とありますが、Embed Jobsガイドには今もv3.0モデルでしか動作しないと書かれています。Googleのような50%のバッチ料金を前提に計画しないでください。
- トライアルキーは制限が厳しいです。 テキスト埋め込みはトライアルでも本番でも毎分2,000入力ですが、画像埋め込みはトライアルが毎分5入力、本番が400入力です。
あとは単純な計算で、入力トークン数に料金を掛けるだけです。OpenAI APIや、他のほとんどのホスト型埋め込みサービスと同じ課金モデルです。
「Proでインデックス、Fastでクエリ」の裏ワザ
私にとって、今回の発表で最も役立つのがこれで、技術的な機能の顔をした料金面の機能です。ProとFastは1つの埋め込み空間を共有しているので、Fastで埋め込んだクエリで、Proが作ったインデックスを検索できます。何も作り直す必要はありません。
"For many customers, we recommend the following deployment pattern: index with Pro, query with Fast."
Cohereは40の開発用データセットで、あらゆる組み合わせをテストしました。すべてProの構成を100とすると、ProのインデックスをFastでクエリした場合は98.4、FastのインデックスをProでクエリした場合は97.3、すべてFastの場合は96.6でした。脚注にひとつ落とし穴があり、両側で同じ出力次元を使う必要があります。
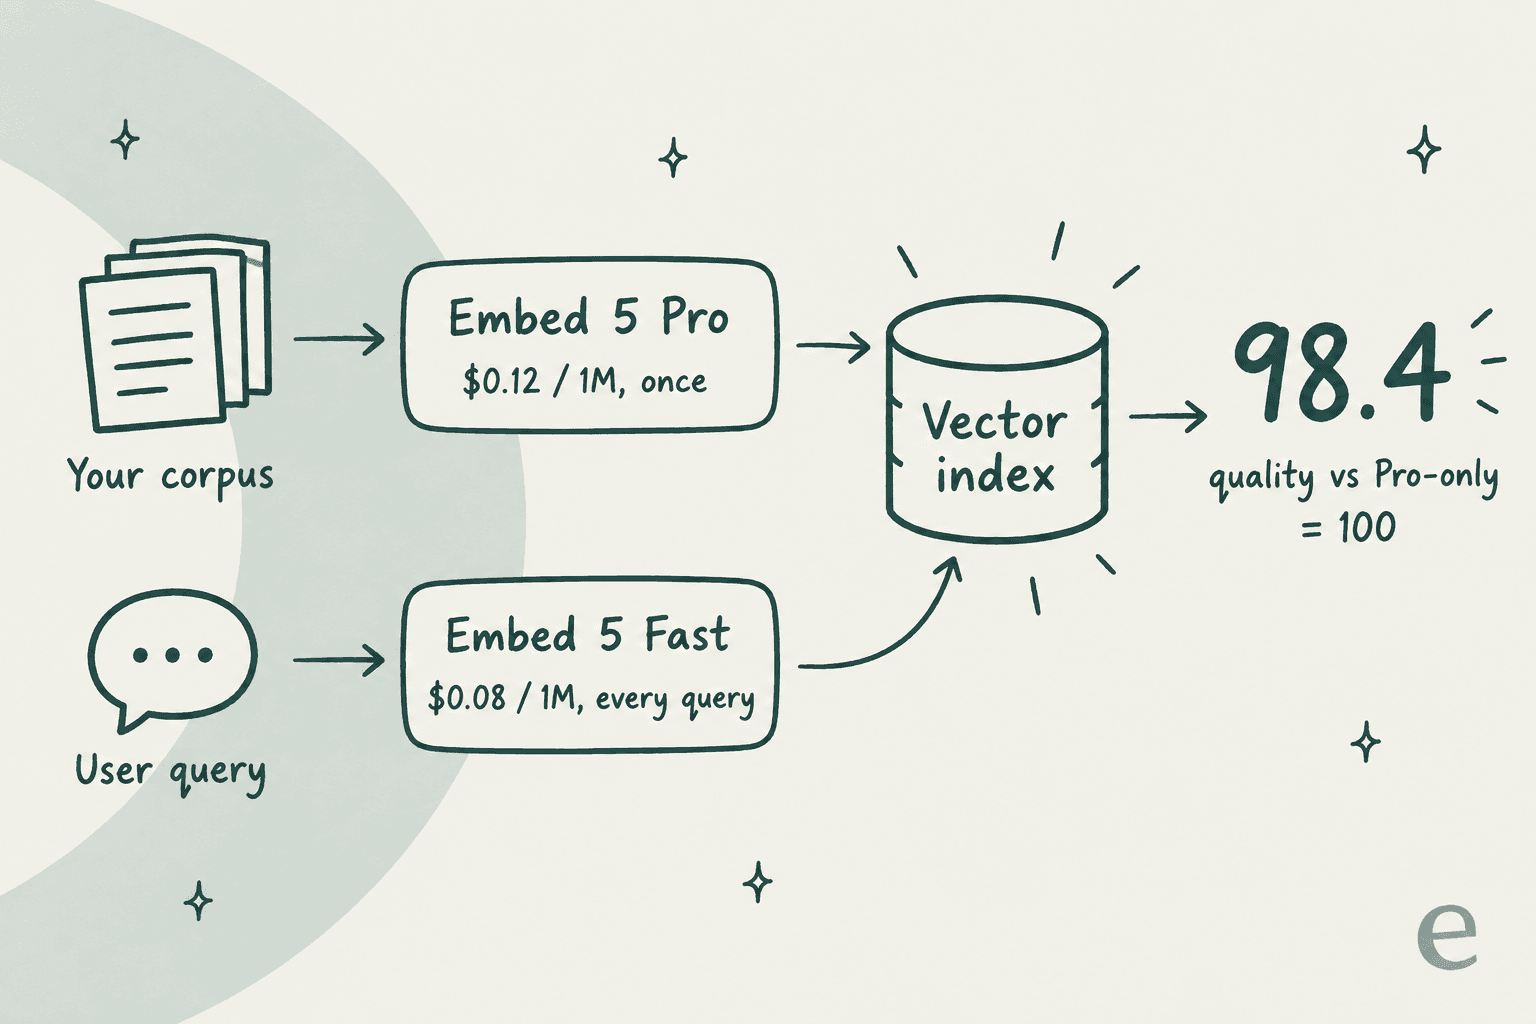
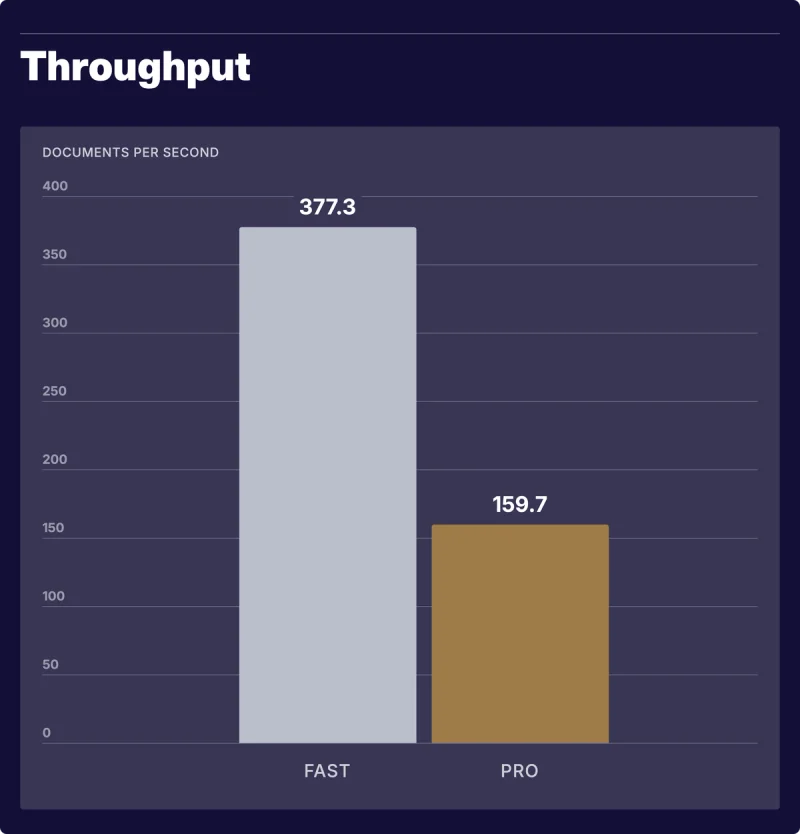
では、なぜコストに関係するのでしょうか。ほとんどの検索やRAGシステム(全体像はサポート向けRAGパイプラインをご覧ください)では、インデックス作成は一度(と更新)だけですが、クエリは永遠に続くからです。たまにしか行わない部分にはPro料金を、毎秒行う部分にはFast料金を払うことになります。さらにCohereのスループットテストでは、Fastは毎秒377.3件のドキュメントを処理し、Proの159.7件を上回りました。クエリは安くなるだけでなく速くもなります。
ただ、よくある見方には少し異を唱えたいところです。ほとんどのチームでは、クエリ側はごくわずかだからです。月30,000件の質問を1件約100トークンで処理するサポートボットが送るクエリトークンは300万で、Proなら$0.36、Fastなら$0.24です。「Fastは節約になる」という見出しが成り立つのは、モデルが1タスクで何十回も検索するエージェントループの規模です。普通のヘルプセンターなら、レイテンシのためにFastを選び、そのコストは気にしなくてかまいません。
料金ページに載らないコスト:ベクトルストレージ
作成したベクトルはどこかに置く必要があり、たいていはベクトルデータベースで、その置き場所は毎月課金されます。埋め込み予算の中で、私が最も過小評価されていると感じるのがこの部分です。埋め込みAPIはドキュメントごとの一度きりのコストですが、データベースは家賃だからです。
Embed 5では出力サイズ(256、512、768、1024、1536、2048次元)と形式(float、int8、binary、およびいくつかのバリエーション)を選べます。Cohere自身の例では、1億チャンクをデフォルトの2048次元floatで保存すると819 GB、256次元binaryなら3.2 GBで、256分の1です。
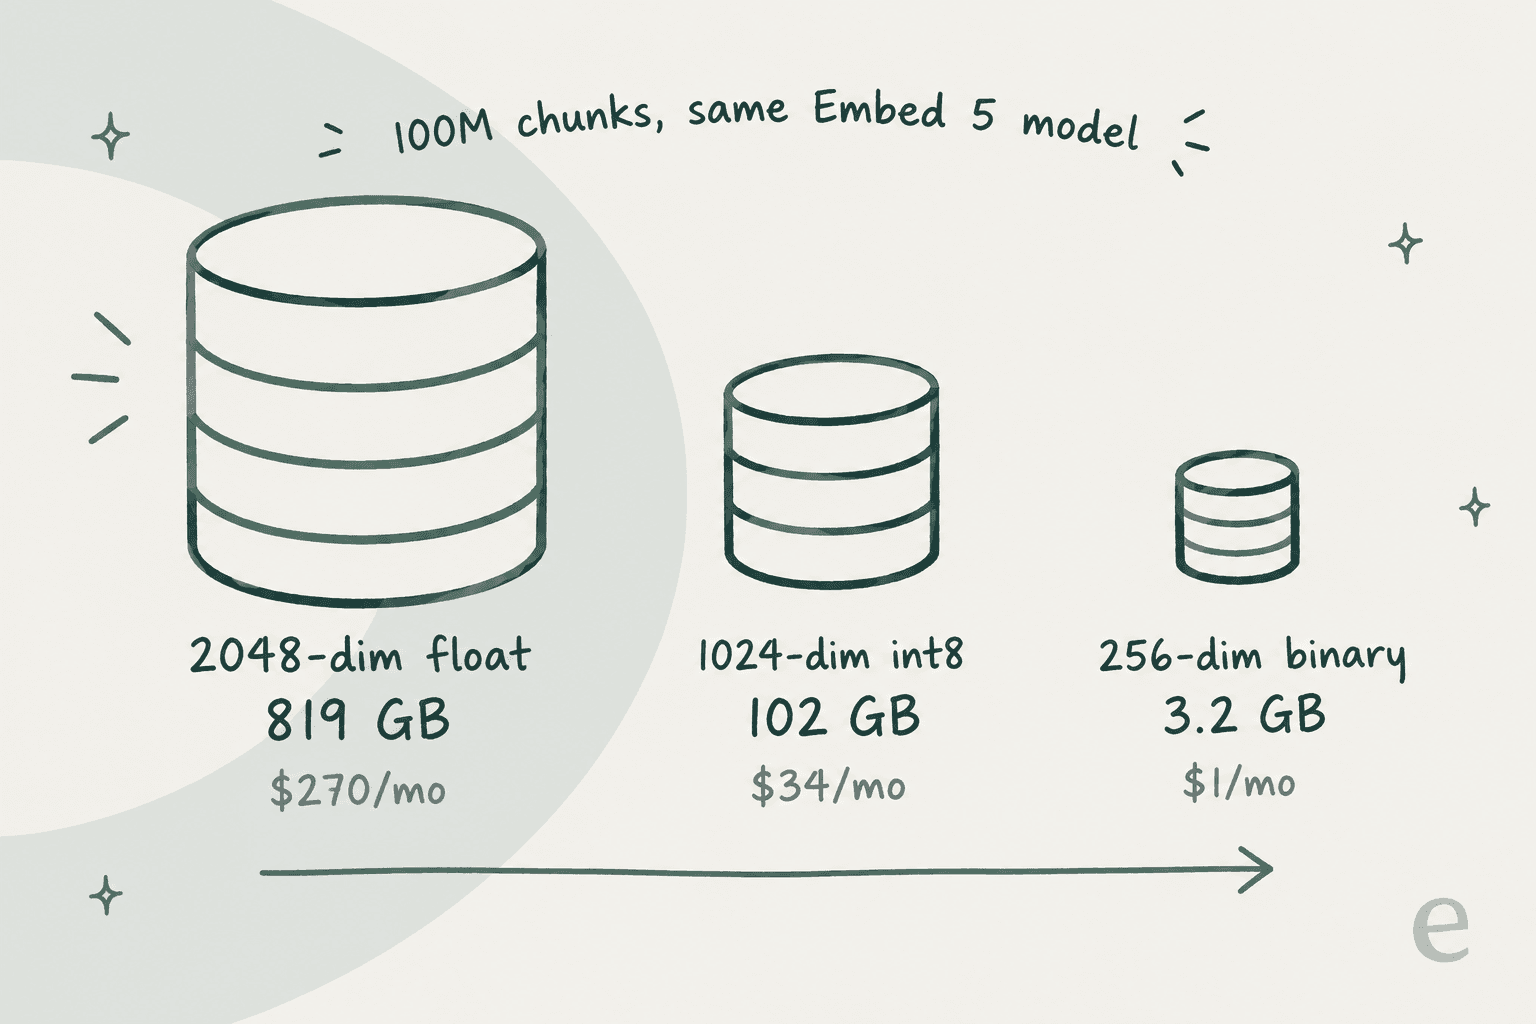
この3つのサイズを、Pineconeのサーバーレスプランの月額$0.33/GBで見積もりました(生のベクトルバイトのみで、インデックスのオーバーヘッドとメタデータは含みません)。差は月$270対$34対約$1です。2年間では、デフォルトのfloat設定はストレージだけで約$6,500かかり、Proで500億トークンを埋め込む費用$6,000を上回ります。
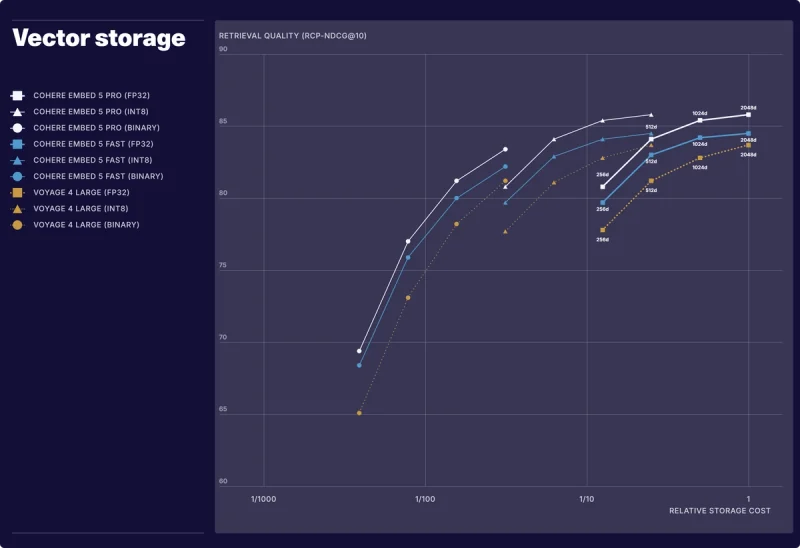
小さくすることで失う品質は、想像より小さいです。Cohereのグラフは検索品質を相対ストレージコストに対してプロットしており、int8の線はfloatの線とほぼ重なっています。Cohere自身の推奨は1024次元のint8で、私もこの設定から始めます。
他のデータベースは価格の付け方が異なり、請求の形も変わります。Weaviate Cloudは保存したベクトル次元100万あたりで課金します(Flexで$0.00465から)。つまり2048次元は文字どおり1024次元の2倍かかります。PineconeもStandardでは読み取りユニット100万あたり$16〜$18に加えて月額最低$50で、小さなインデックスではストレージよりこちらのほうが効いてきます。データベースの選択肢は、Weaviateの料金の解説とWeaviateの代替のまとめで詳しく比較しています。
データベースをまったく運用したくない場合は、OpenAIのホスト型オプションをベクトルストアのガイドで扱っています。ただし、OpenAI自身の埋め込みモデルに縛られます。
Embed 5の請求額を見積もる
ご自身のコーパスとトラフィックを入力してください。計算ツールは公表されているAPI料金と、Pineconeのストレージ料金$0.33/GBを使っているため、ストレージの行は下限として見てください。
1024次元のint8から、Embed 5のデフォルトである2048次元のfloatに切り替えてみてください。100万チャンクでは、インデックス作成の費用はまったく変わらず、ストレージの行が8倍に跳ね上がります。
API、Model Vault、クラウドマーケットプレイスの比較
Model Vaultは、トークン単位のメーターを、専用のシングルテナントインスタンスの定額家賃に置き換えます。損益分岐の計算は簡単です。
| インスタンス | 月額 | Proでの損益分岐 | Fastでの損益分岐 |
|---|---|---|---|
| Small | $2,000 | 月約167億トークン | 月約250億トークン |
| Medium | $3,250 | 月約271億トークン | 月約406億トークン |
月160億トークンは1日あたり約5.5億です。これだけ埋め込むチームはごくわずかなので、ほとんどの場合、APIのほうが安い選択肢のままです。Cohereは、Smallインスタンスが月にどれだけのトークンを処理できるかも公表していません。1つのインスタンスでピークをまかなえると考える前に、営業にスループットを確認してください。
それでもModel Vaultを買う人がいるのは、価格よりも管理のためです。共有テナンシーがなく、スループットが保証されるので、セキュリティレビューの説明もすっきりします。これはCohereのエンタープライズ導入に関する訴求全体に合致します。完全に自社ネットワーク内で動かす必要がある場合は、プライベートデプロイメントを通じて、両モデルともvLLMでセルフホストできます。価格は営業が決めます。
第三の道がマーケットプレイスです。Amazon SageMakerでは、Embed 5はホストごとの時間単位のソフトウェア料金(ml.g5.xlargeで$2.39、最大のProインスタンスで$8.48)に、SageMakerインスタンス自体の費用が加わる形で課金されます。Microsoft Foundryは両モデルをプレビューで掲載していますが、価格はまだありません。Amazon BedrockとOracle OCIは10月1日時点でEmbed 4のみを扱っており、Bedrockでは100万トークンあたり$0.12です。会社でクラウド支出のコミットメントがあるなら、素の料金が割高でも、マーケットプレイス経由に意味がある場合があります。
実例:実際のチームはいくら払うのか
以下は3つのシナリオで、公表されている料金を使い、特記がない限り1024次元int8のストレージで計算しています。
サポートチームのヘルプセンターとチケット履歴。 約800トークンのヘルプ記事2,000本と、約400トークンの過去チケット50,000件で、合計2,160万トークンです。Proでのインデックス作成は一度きりで$2.59。月30,000件のクエリをFastで処理すると月$0.24です。ベクトルはPineconeの無料枠の2 GBに収まります。この場合の埋め込み費用は端数のようなものです。本当のコストは、チャンク分割と同期の構築、権限、その上のLLMレイヤーにかかるエンジニアリングで、Zendesk Guide上のセマンティック検索で解説しているのと同じトレードオフです。
社内検索ツール用のドキュメントアーカイブ。 500トークンのチャンク2,000万個は100億トークンです。Proでのインデックス作成は$1,200、Fastなら$800です。2048次元floatのストレージは約164 GBで、Pineconeで月$54。1024次元int8なら約20 GBで月$6.76です。次のモデルが出たときの再インデックスにはまた$1,200がかかり、PDFを先に解析する必要があるなら、Parse 5がページごとの料金を別に上乗せします。
ステップごとに検索する大量処理のエージェント。 1日5億のクエリトークンは月150億です。Fastなら月$1,200、Proなら$1,800です。どちらもModel Vaultの$2,000のラインを超えないので、専用キャパシティが必要でない限りAPIが勝ちます。
3つに共通する教訓は、埋め込みAPIが高くつく部分になることはほとんどないということです。高くつくのはストレージと再インデックスであり、パイプラインを保守する人でもあります。
Embed 5の料金は他と比べてどうか
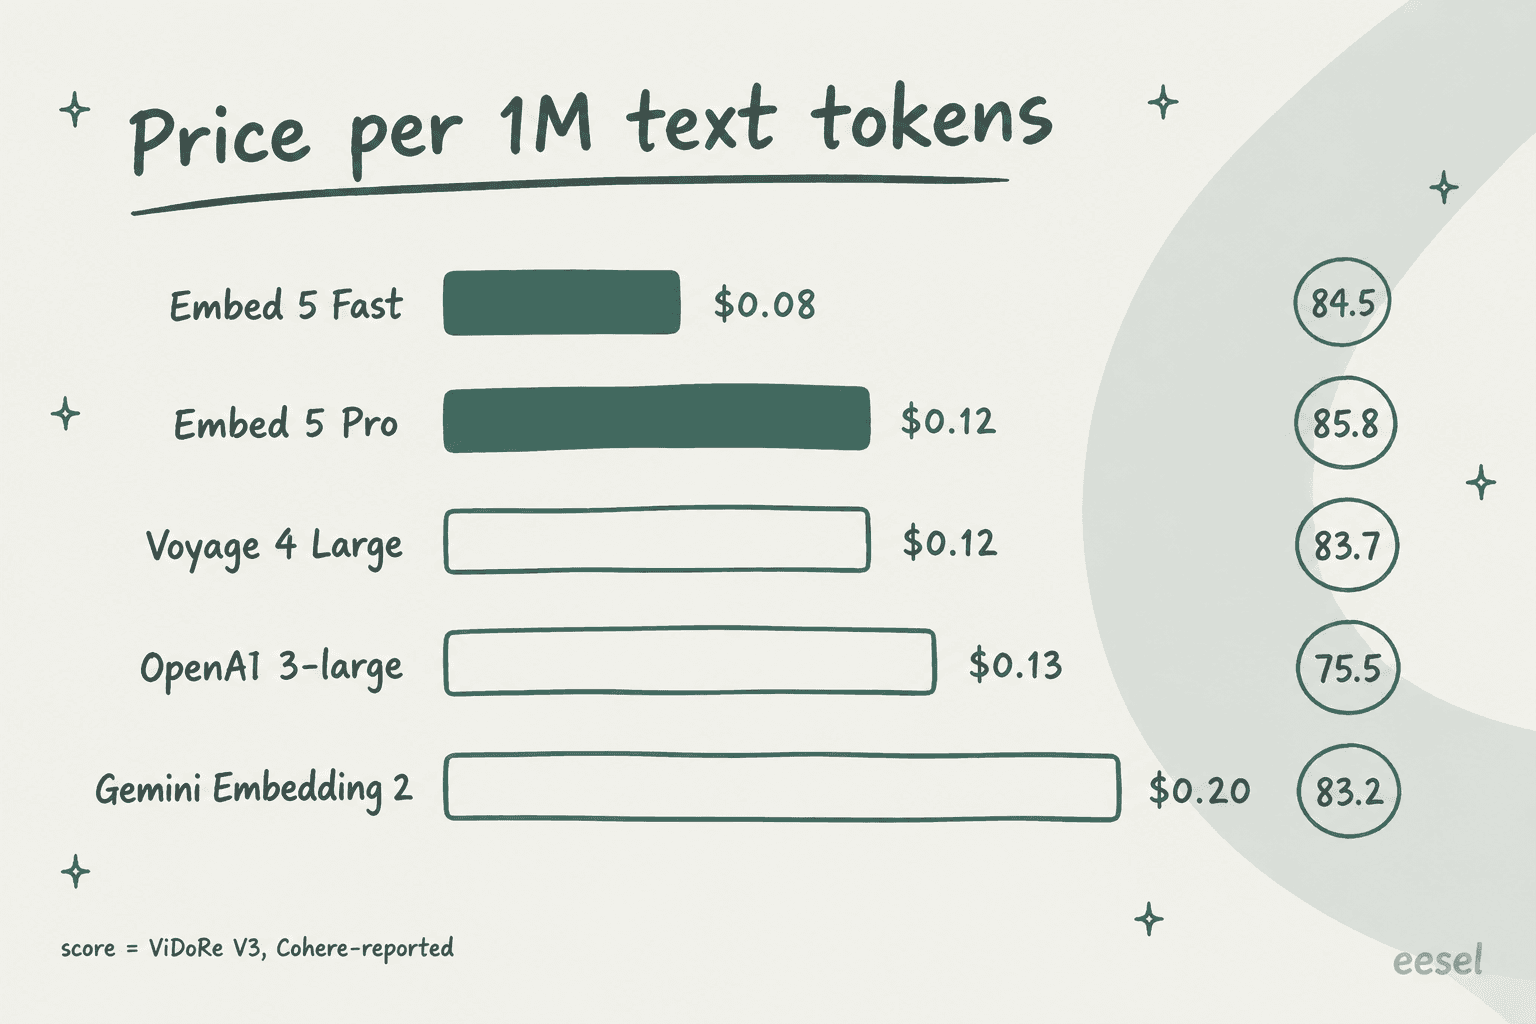
Embed 5を他の主力埋め込みモデルと並べました。価格はいずれもベンダー自身の料金ページから取っています。スコアは発表記事にあるCohereのViDoRe V3の数字なので、独立したテストではなくCohere自身のテストとして読んでください。
| モデル | テキスト / 100万トークン | バッチ | 無料枠 | ViDoRe V3(Cohere) |
|---|---|---|---|---|
| Cohere Embed 5 Pro | $0.12 | 記載なし | 月1,000回のトライアル | 85.8 |
| Cohere Embed 5 Fast | $0.08 | 記載なし | 月1,000回のトライアル | 84.5 |
| Voyage 4 Large | $0.12 | 33%オフ | 2億トークン | 83.7 |
| Gemini Embedding 2 | $0.20 | $0.10 | あり | 83.2 |
| OpenAI text-embedding-3-large | $0.13 | 該当なし | なし | 75.5 |
| OpenAI text-embedding-3-small | $0.02 | 該当なし | なし | 該当なし |
| Jina Embeddings v5 | $0.045〜$0.05 | 該当なし | 1,000万トークン、非商用 | 74.5(v5 Small) |
| Mistral embed | $0.10 | 該当なし | 該当なし | 該当なし |
Embed 5 Fastは、上位スコア帯で最も安いモデルです。ProはVoyage 4 Largeと価格が並び、Cohereのテストではわずかに上回ります。Gemini Embedding 2は通常料金ではFastの2.5倍ですが、バッチ価格$0.10なら、オフラインのインデックス作成では差がかなり縮まります(通常料金はGeminiの料金のガイドを参照)。OpenAI埋め込みAPIはProより1セント高く、このベンチマークではスコアがかなり低くなります。
ここで正直に述べておくべき注意点が2つあります。トークンあたりの純粋な価格だけが目的なら、OpenAIの3-smallとVoyage 4 Liteはどちらも$0.02で、Fastの4分の1です。また、Cohere自身の多言語表では、テストされたアジアと中東の10言語のうち9言語でGemini Embedding 2がProを上回り、差が最も大きいのはテルグ語(91対80)です。コーパスの大半がヒンディー語、日本語、アラビア語なら、決める前にGeminiを試す価値があります。$0.10のMistralの埋め込みモデルは、ヨーロッパのデータ向けのもう1つの選択肢です。Mistral AIの料金のメモをご覧ください。より幅広い一覧は、埋め込み以外のベンダーも比較したCohere AIの代替の記事にあります。
開発者の声
この記事を書いている時点でEmbed 5は公開1日目なので、実際のユーザーレビューはまだありません。あるのは、Cohereの埋め込み全般についての安定した実績で、繰り返し出てくるテーマは信頼性です。
"It has the most crisp, steady P50 of any external service I've used in a long time."

反対意見は、大量利用時のコストと、クローズドなAPIに依存することについてが多く、これはホスト型の埋め込みモデルすべてに当てはまります。
"The API can also become expensive when you start using it more frequently."

"Voyage for embeddings + rerank is totally defensible - Cohere is popular partly because it's been the default in a lot of examples, not because it's always better."

最後の意見は妥当だと思いますし、Embed 5の数字は両方の側面を裏付けています。ProはCohere自身のベンチマークでは勝っていますが、同価格のVoyage 4 Largeに対して2.1ポイント差です。すでにVoyageをうまく運用しているなら、急いで移行する理由はありません。Embed 4を使っているなら、Embed 5への移行はトークンあたり追加費用がなく、ほぼ純粋なプラスです。LangChainのCohere連携なら、切り替えはモデル名を1行変えるだけですが、コーパスの再埋め込みは必要です。
どのEmbed 5の料金プランが合うか
状況別のおすすめは次のとおりです。
- プロトタイプ中。 トライアルキーを使い、その後は従量課金の本番キーに移ります。Model Vaultはまだ考えなくて大丈夫です。
- 固定のコーパスで検索やRAGを構築する。 Proでインデックスを作成し、Fastでクエリを実行し、1024次元のint8で保存します。Cohereが提供する中で、最も安く高品質な構成です。
- 常に検索するエージェントを動かす。 2.4倍のスループットが必要なら両側でFast。品質を重視するなら、ProのインデックスにFastのクエリを組み合わせます。
- 月に数百億トークンを埋め込む、または分離が必要。 Model Vaultの料金を確認し、契約前に営業にインスタンスごとのスループットを尋ねてください。AWSなら、SageMakerや、すでに払っているかもしれないBedrockエージェントの料金と比較します。
- 主にアジア言語のコンテンツを埋め込む。 まずご自身のデータでGemini Embedding 2とProを比較してください。
- ドキュメントから回答するサポートボットが欲しいだけ。 埋め込みの判断自体を飛ばして、検索を代わりに処理してくれるAIナレッジベースやヘルプデスクのチームメイトを検討してください。
目的がサポート回答ならeeselを試す
埋め込みモデルの料金を調べている人の多くは、検索エンジンそのものを作りたいわけではありません。ヘルプセンターのために、RAGとファインチューニングのどちらにするか選んでいることがよくあります。最終的に欲しいのは、ヘルプセンターと過去のチケットから顧客に回答するボットです。そこで一度立ち止まり、そもそも基盤を自前で持つ必要があるのかを考えるべきだと思います。
eeselでは、両方の立場でこの判断をするチームを見てきました。Zendeskを使い、月約$1,700を支払っていたオランダのWebホスティング会社は、社内で独自のAIを構築するためにeeselを離れました。その後のチームの所感は、モデルのコストとは無関係でした。
"A lot of their friction came from setup complexity (handovers, Zendesk integration, business hours logic) and a lack of clear guidance on how to configure things correctly."
これは埋め込みの料金ページには決して出てこない部分です。ベクトルは安いのです。本当の作業は、引き継ぎと連携、そしてその周りのルールにあります。

eeselはAIヘルプデスクのチームメイトで、Zendesk、Freshdeskなどの既存のキューに参加し、ナレッジベースと過去のチケットから学習します。顧客と話す前に、実際のチケットを流して試すこともできます。選ぶ埋め込みモデルも、調整する次元数もなく、ベクトルデータベースの請求も届きません。
料金は固定のクレジットプランで、月500クレジットで$299からです。対応したチケットまたはチャット1件が1クレジットです。
開発者の方も、この方法でコントロールを失うわけではありません。詳しくはカスタマーサポートエージェントAPIのガイドで解説しています。eesel CLIを使えば、ターミナルから連携の接続、チームメイトの指示の編集、保留中のアクションの承認または拒否、アクティビティログの閲覧ができます。JSON出力とスクリプト用の--dry-runフラグもあります。Claude CodeのようなコーディングエージェントもMCP経由で操作できます。
このワークフローについては、ターミナルからエージェントを管理するとサポート向けCLIの解説記事でさらに書いています。
eeselを無料で試して、埋め込み呼び出しを1行も書かずに、ヘルプセンターが実際に動くサポートチームメイトになる様子をご覧ください。
よくある質問
Cohere Embed 5の料金はいくらですか?
Embed 5 ProとEmbed 5 Fastの料金の違いは何ですか?
Cohere Embed 5はEmbed 4より高いですか?
Cohere Embed 5に無料枠はありますか?
Cohere Model VaultがEmbed 5 APIより安くなるのはいつですか?
Cohere Embed 5の料金はOpenAIの埋め込みと比べてどうですか?
AIサポートエージェントを作るのにCohere Embed 5は必要ですか?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.