TypeSafe Jevの正体
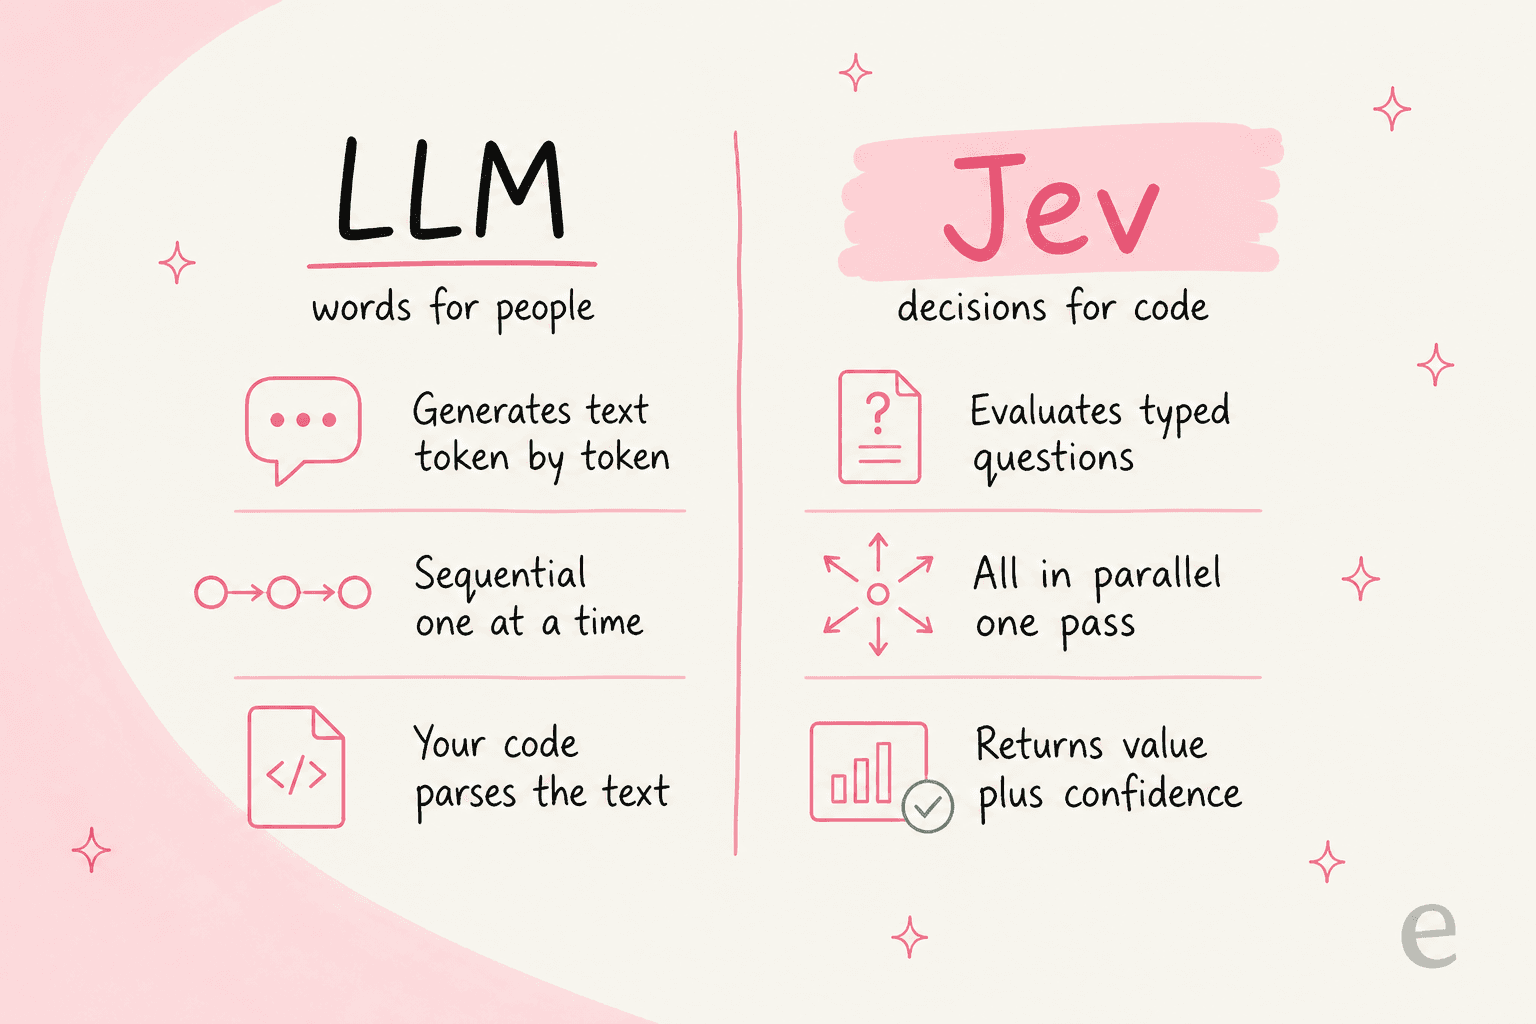
TypeSafe AIはサンフランシスコの研究所で、2年間のステルス期間を経て2026年9月15日にJevをリリースしました。ホームページの表現はあえて挑発的で、LLMは「人のために言葉を生成する」のに対し、「Jevは型付きの意思決定を生成し、コードにより近い」と謳っています。ローンチ記事はさらに簡潔な一言で、Jevを「フロンティア級の知能を持つ関数呼び出し: 非構造化の状態が入り、型付きの確率的意思決定が出る」と表現しています。
名前そのものが、この思想全体を物語っています。「System One」はダニエル・カーネマンの速く直感的なシステム1思考を踏まえたもので、「Jev」は経済学者ウィリアム・スタンレー・ジェヴォンズにちなんでおり、彼のパラドックスは「あるリソースのコストが下がるたびに、その利用がはるかに拡大する」というものです。TypeSafeは、安価で高速な型付き意思決定が、遅い生成呼び出しが今日ではまだ高すぎるあらゆる場面で使われるようになると賭けています。
同社はまた、チャットとは「正反対の研究方向」を選んだとも述べています。より多くのRLHFを重ねる代わりに、**Reinforcement Learning for Calibrated Decisions(RLCD)**と呼ぶ新しい目的関数と、新しいアーキテクチャおよびサンプラーで学習させました。訴求ポイントは3語に集約されます: 文字列ではなく意思決定、キャリブレーションされた確信度、コードにより近い。彼らのタグライン「Build Prod, Not God」が、誰に向けて語りかけているかを物語っています。
仕組み: 状態と質問を並列に評価する
これは私にとって腑に落ちた部分であり、どの主張を検証するよりも先に理解しておく価値があります。ドキュメントは、Jevが解消しようとしているミスマッチをこう説明しています:
"you are coercing a text-generation system into outputting structured decisions, then parsing the results back into something your code can depend on."
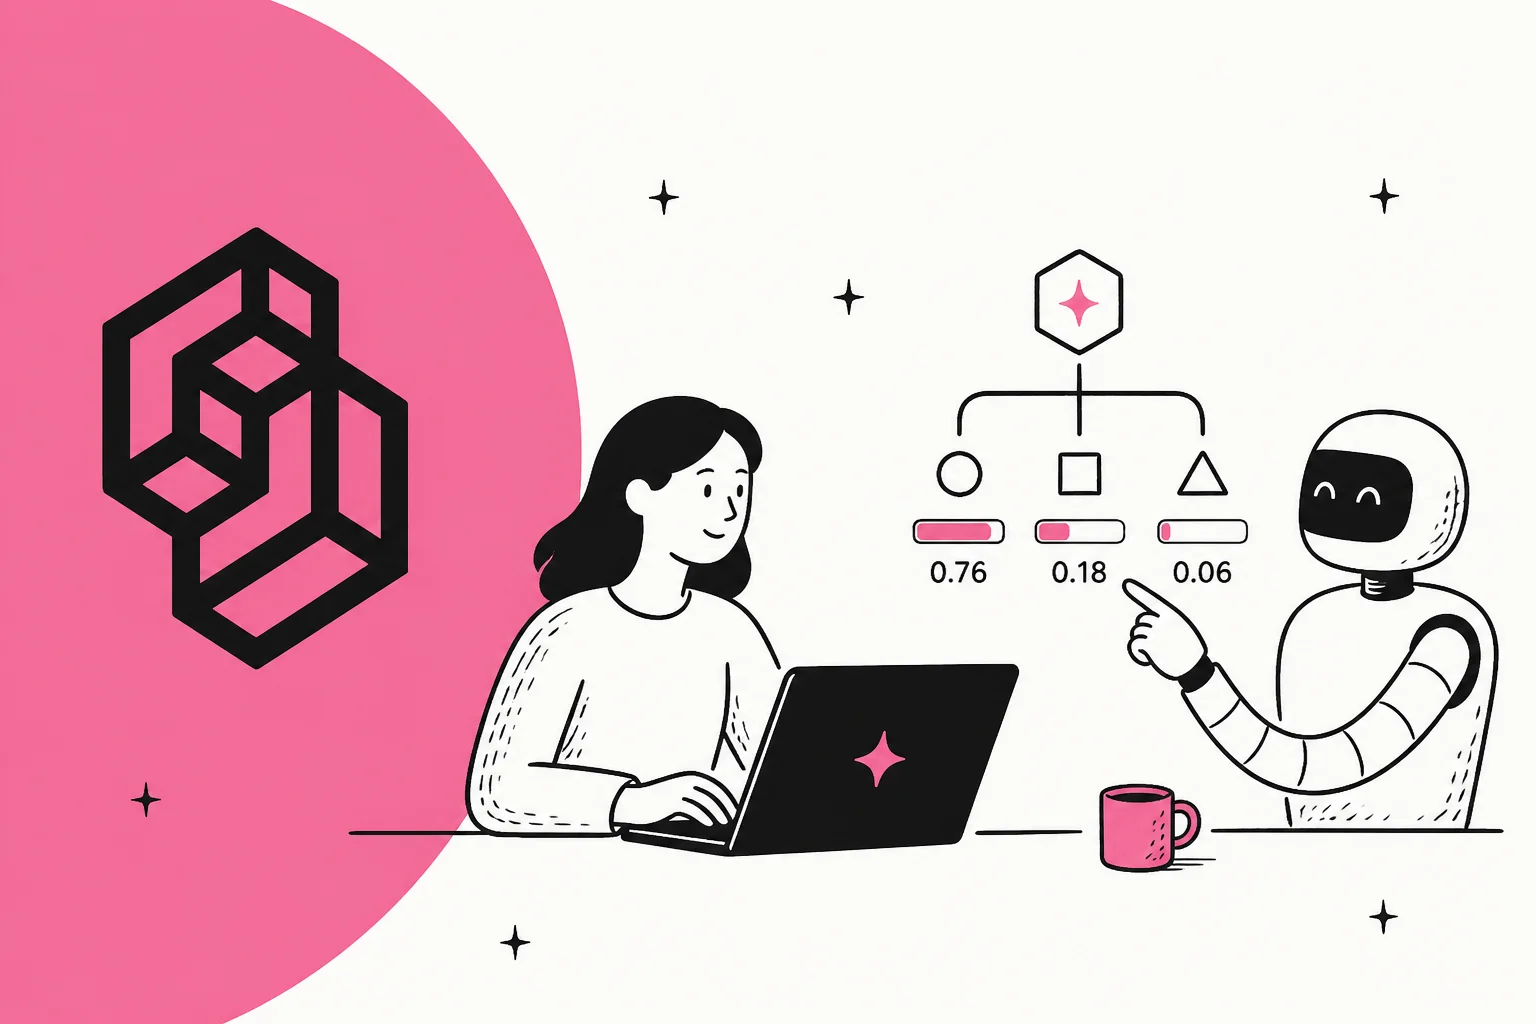
LLM機能をリリースしたことがある人なら誰でも、まさにその痛みを感じたことがあるはずです。Jevのモデルは異なります。状態(state)(文字列、または構造化オブジェクト)と、型付きの**質問(questions)**群を送ると、その状態に対して各質問を並列に、単一のパスで評価します。あなたのコードは、返ってきた型付きの回答をもとに分岐、ソート、ルーティングを行います。
プリミティブはわずか3種類で、実際に必要となる形にちょうど対応しています:
| 質問タイプ | 何を尋ねるか | 何を返すか |
|---|---|---|
| Noul | この文は真か? | 単一の確率(0〜1) |
| Choice | リストから1つの選択肢を選ぶ | 選択結果、選択肢ごとの確率、確信度 |
| Score | ルーブリックに沿って状態を採点する | 数値スコア、レベルごとの確率、確信度 |
私が最も気に入っている設計上の判断は、各質問が同じ状態に対して独立に評価されるため、質問を増やしてもレイテンシはほとんど変わらず、コンテキストロット(context-rot)も決して発生しないという点です。TypeSafeの構成に関するガイダンスは、すべての質問を原子的に保つこと、つまり「知識のある人なら数秒で下せる類の判断」に留め、難しい部分は1つの巨大なプロンプトではなくコード側で組み立てることを推奨しています。「このスタートアップのピッチを評価して」と尋ねる代わりに、市場規模、実現可能性、差別化について個別に質問し、その後で自分のスコアを独自の計算式で組み合わせるのです。
Cloudflareのモデルページは、正直なところ私たち自身のプロダクト仕様のような、あるサポート例を使ってこれを具体化しています。状態"Help! My payouts have been failing for 3 days."を3つの質問とともに送ると、次のような結果が返ってきます:
is_urgent(Noul):0.95department(Choice):"billing"、確信度0.8、確率 {billing 0.87, technical 0.13}frustration(Score): Calm/Frustrated/Very angryの尺度で1.04、確信度0.94
これは1回の呼び出しでのチケットトリアージです。同時に、Jevが何であるかを最も明確に示す例でもあります。つまり、キャリブレーションされた確率を持つ非常に高速な分類器であり、話すものではないということです。
各主張を1つずつ検証する
TypeSafeのマーケティングは大胆なので、主要な主張を順番に取り上げ、成立している部分と誇張されている部分を分けていきます。
速度: 想定されたタスクにおいては高速
TypeSafeは、フロンティアLLMの3〜329秒に対して70〜500ミリ秒のエンドツーエンドを主張しており、40倍から200倍高速と表現しています。単一の並列パスは、高速であることの実際のアーキテクチャ上の理由であり、外部からの証拠も心強いものです。VercelのCEOは本番環境での実績を報告しています:
"Jev is up to 18x faster (p95) and more accurate. It's coming to @vercel AI Gateway and likely new default."
Hacker Newsで繰り返し指摘された妥当な留保は、この比較がフェアなものではないという点です。すべての型名、スキーマ、散文を生成する生成モデルは、制約された意思決定だけを出力するモデルよりも多くの作業をこなしています。速度そのものは本物ですが、倍率は何と比較するかによって変わります。
価格: 安価だが、正直な注釈付き
入力100万トークンあたり0.042ドル、出力無料という条件で、Jevはフロンティアモデルというよりインフラのような価格設定になっています。TypeSafeは、これがClaude Fable 5.1の入力価格の238分の1だと主張しています。評価すべき点として、彼らは補助金の疑問を避けるのではなく正面から取り上げています。
"We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
計画を立てる前に知っておくべきこと: 料金ページはまだ存在せず(現時点で/pricingのURLはすべて404になります)、公開されたプラン階層やレート制限もなく、アクセスはウェイトリストの向こう側にあります。これはアーリーアクセス製品のローンチ価格なので、方向性を示すものとして扱ってください。コストをモデル化しているなら、Qwenの価格に関する当社のガイドが、ローンチ時の数字がいかに速く変わるかを示しています。同じ教訓はGemini 3の価格の解説にも共通しており、もしウェイトリストが障害になっているなら、Qwenの代替一覧には今すぐ使える選択肢が並んでいます。
「ハルシネーションを起こせない」: 半分正しく、誇張されている
これは最も強い反発を受けたフレーズで、私はそれももっともだと思います。出力が数学的にあなたのスキーマに制約されているため、Jevは型エラーを起こすことができません。その部分は本物で有用です。しかしマーケティングは「型エラーがない」から「ハルシネーションを起こせない」へとすり替わっており、Hacker Newsスレッドのトップコメントはそれを容認しませんでした:
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"

擁護派には理にかなった反論がありました。キャリブレーションされた確信度スコアがあれば、0.1という値を見て無視することができ、それは確信を持って間違えるモデルとは違うというものです。別のコメント者は、この主張を測るべき基準をこう設定しました:
"What we would want to see is a confidence value that is in line with the actual correctness. If the value is 0.9 for 1000 different answers, then approximately 900 of those answers should be correct."
それは正しいテストであり、まさにRLCDが最適化しようとしているものです。私の見立てでは、キャリブレーションされた確信度は本物の安全機能であり、もっと多くのモデルに搭載してほしいと思います。「ハルシネーションを起こせない」は、モデルが実際に守っている約束よりも強い表現であり、TypeSafeは「キャリブレーションされた確信度を備えたtype-safe」と言った方が、より確かな立ち位置になるでしょう。
ベンチマーク: じっくり読む価値のあるチャート
TypeSafe自身のワークフロー評価は「193.6倍高速、444.6倍安価」という印象的な見出しを掲げていますが、ブログ自身も認めている通り、それは「実際の利益の中でも上振れした値」です。その下にあるチャートは見出しよりもずっと誠実で、彼らが公開したものの中で最も有用な単一の情報です。
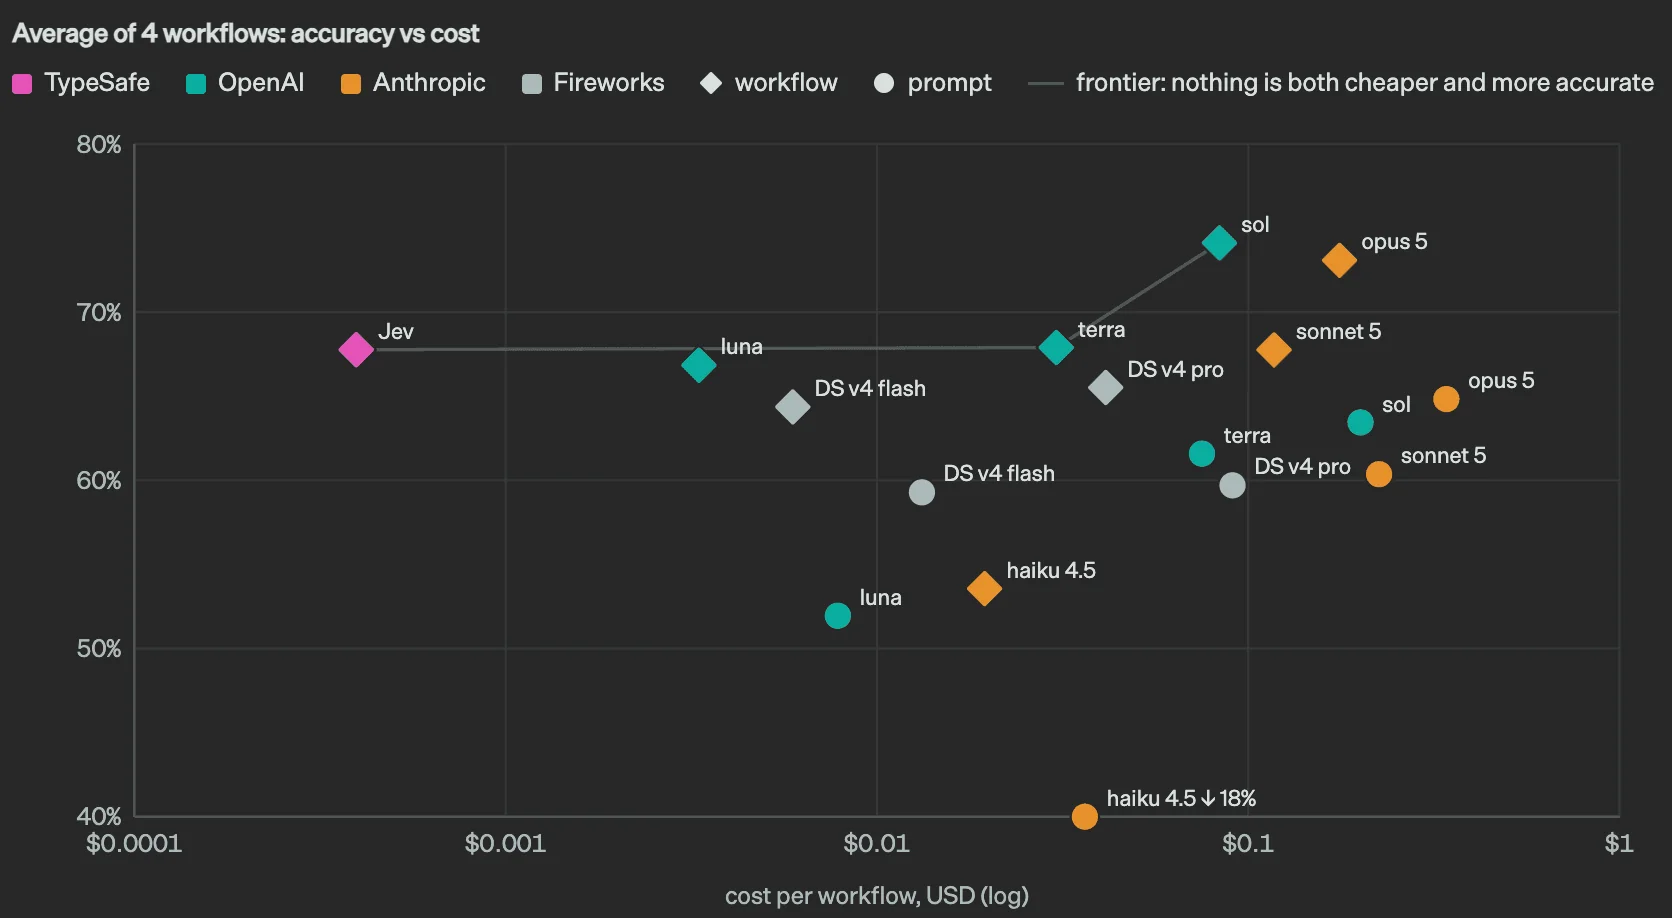
よく読むと、本当の主張が見えてきます。Jevは、中位クラスの推論モデルとほぼ同等の精度で、ワークフローあたりのコストの何分の一かでフロンティア上に位置しています。チャートの中で最も精度が高い点ではありません。それでも競争力を保ちながら最も安価な点であり、大量の意思決定業務にとってはそれこそが重要になることが多いのです。あるトップコメント者の冷静な指摘がこれをよく捉えています:
"Seems like a more accurate title would be "Jev: Trading general purpose generation for fast typed inference"."
開発者たちが実際にJevで何をしているか
Xでの反応を見て、私はここに本物の何かがあると最も強く確信しました。それが単なる感想ではなくデモだったからです。最も大きかった2つの投稿は、どちらもエージェントのコンテキストを圧縮することに関するものでした。ある開発者はJevを瞬時のコンパクション(圧縮)に使いました:
"in 2026, why is compaction still a summarization prompt? Jev can make it instant by scoring every tool call and dropping what's irrelevant"
別の開発者はこれをClaudeに組み込み、ツール呼び出しのレビュアーとして使い、あるセッションを約1秒で「ほぼ100万から8万6000トークンへ」縮小したと報告しています。これはまさにJevが得意とする種類の仕事です。つまり、大きなモデルにとっては明らかにオーバースペックだった、高速で安価かつ大量の判断です。これは、フロンティア級の頭脳を必要としない小さなチェックである、優れたエージェントアシストツールの背後にあるのと同じ発想です。
手放しの称賛ばかりではなく、反論にも耳を傾ける価値があります。開発者Theo Browneの率直な「Please don't do this」という返信は、本物の懸念を捉えていました。つまり、汎用モデルの推論が本当に重要な場面でも、人々がSystem Oneの分類器に手を伸ばしてしまうのではないかというものです。どちらも同時に真実です。Jevは、バグレポートのトリアージであれエスカレーションの判断であれ、範囲の狭い意思決定には優れていますが、オープンエンドな問いには不向きです。どちらであるかを見極める規律が求められます。
型付き意思決定モデルが適する場面、適さない場面
ここからは正直な境界線を示します。「何にでも使える」と言うレビューは役に立たないからです。
Jevが適するのは、その仕事があなたのコードが消費する意思決定である場合です。ルーティングとトリアージ、緊急度・感情スコアリング、スパムや不正利用のフラグ立て、チケットのタグ付け、あるいはツール呼び出しが実行される前のレビューなどです。これまでLLMを無理やりJSONに出力させていた場所ならどこでも、型付き意思決定モデルはより洗練されたプリミティブであり、キャリブレーションされた確信度は、いつ自動的に実行するか対エスカレーションするかを判断する実際のレバーを与えてくれます。
出力そのものが目的である場合には適しません。Jevは返信を書いたり、自らの推論を説明したり、会話を続けたり、本当に新しい問いのロングテールに対応したりはしません。また、3万2000トークンのコンテキストウィンドウを持ち、ローンチ週の製品として、オープンな利用可能性ではなくアーリーアクセスのウェイトリストという制約もあります。返信そのものについては、最良のAIチャットボットビルダーのまとめで比較しているような汎用モデルが依然として必要ですし、あなたが小規模なチームなら中小企業向けAIエージェントのガイドも参考になります。
私がたどり着いた最も有用なメンタルモデルはこうです。Jevは速い反射神経であり、熟考ではありません。TypeSafe自身のセキュリティワークフロー図はこのパターンをよく示しています。小さなBool、Score、Choiceの質問からなるパイプラインで、その間でどのアクションを取るかをあなたのコードが選びます。
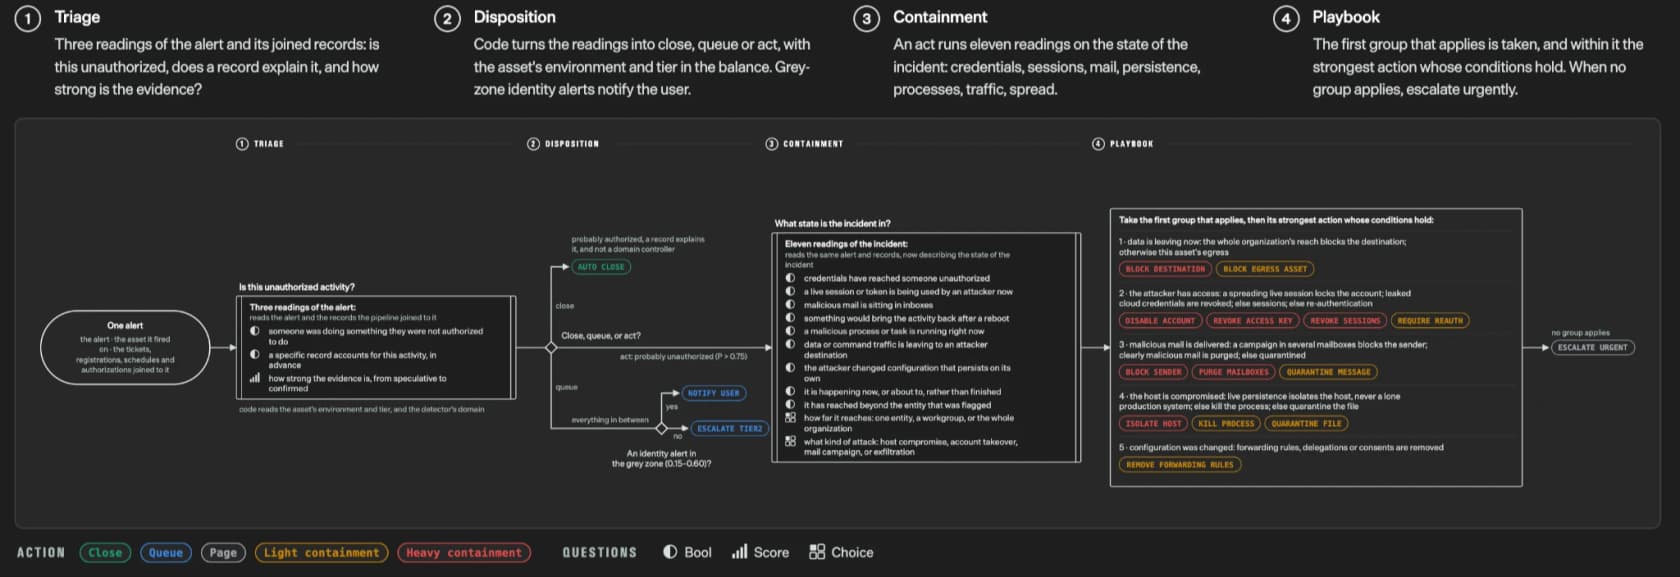
判断をより早くするために、私が実際にたどるであろう思考の流れを示します:
Jevを一目で
| モデル | Jev(jev-1.13.0)、初の公開System Oneモデル |
| 返すもの | キャリブレーションされた確信度付きの型付き意思決定(Noul / Choice / Score) |
| レイテンシ | エンドツーエンドで70〜500ミリ秒、単一の並列パス |
| 価格 | 入力0.042ドル/MTok、出力無料(ローンチ価格、階層なし) |
| コンテキストウィンドウ | 3万2000トークン |
| アクセス | アーリーアクセスのウェイトリスト、加えてCloudflare Workers AI上のtypesafe/jev |
| 最適な用途 | 大量の構造化意思決定、ツール呼び出しのレビュー、コンパクション |
| 不向きな用途 | 返信の作成、散文での推論、オープンエンドな会話 |
サポートチームを運営しているなら何を意味するか
Jevの旗艦デモがサポートチケットであるのは偶然ではありません。トリアージこそSystem Oneの教科書的なタスクだからです。とはいえ、私はライブのキューで十分な時間を過ごしてきたので、その落とし穴を知っています。優れたトリアージの判断は、カスタマーサービスの自動化におけるほんの最初の一歩に過ぎません。これは私が何度も立ち返る、開発者としての区別です。分類はすでにAIが信頼できる領域であり、生成された返信、そして人間エージェントとのコスト比較は、まだつまずく領域です。
あるコンシューマー向けブランドのために私が支援したトライアルで、284件のチャットと100件のチケットによるクロスバリデーションを通じて、まさにその分裂を目の当たりにしました。型付き意思決定は非常に優れており、トリアージ精度93%、スパム検出は誤検知ゼロで100%でした。一方で下書きされた返信には依然として7%の事実誤認率があり、そのまま送れるほどきれいだったのはわずか12%でした。
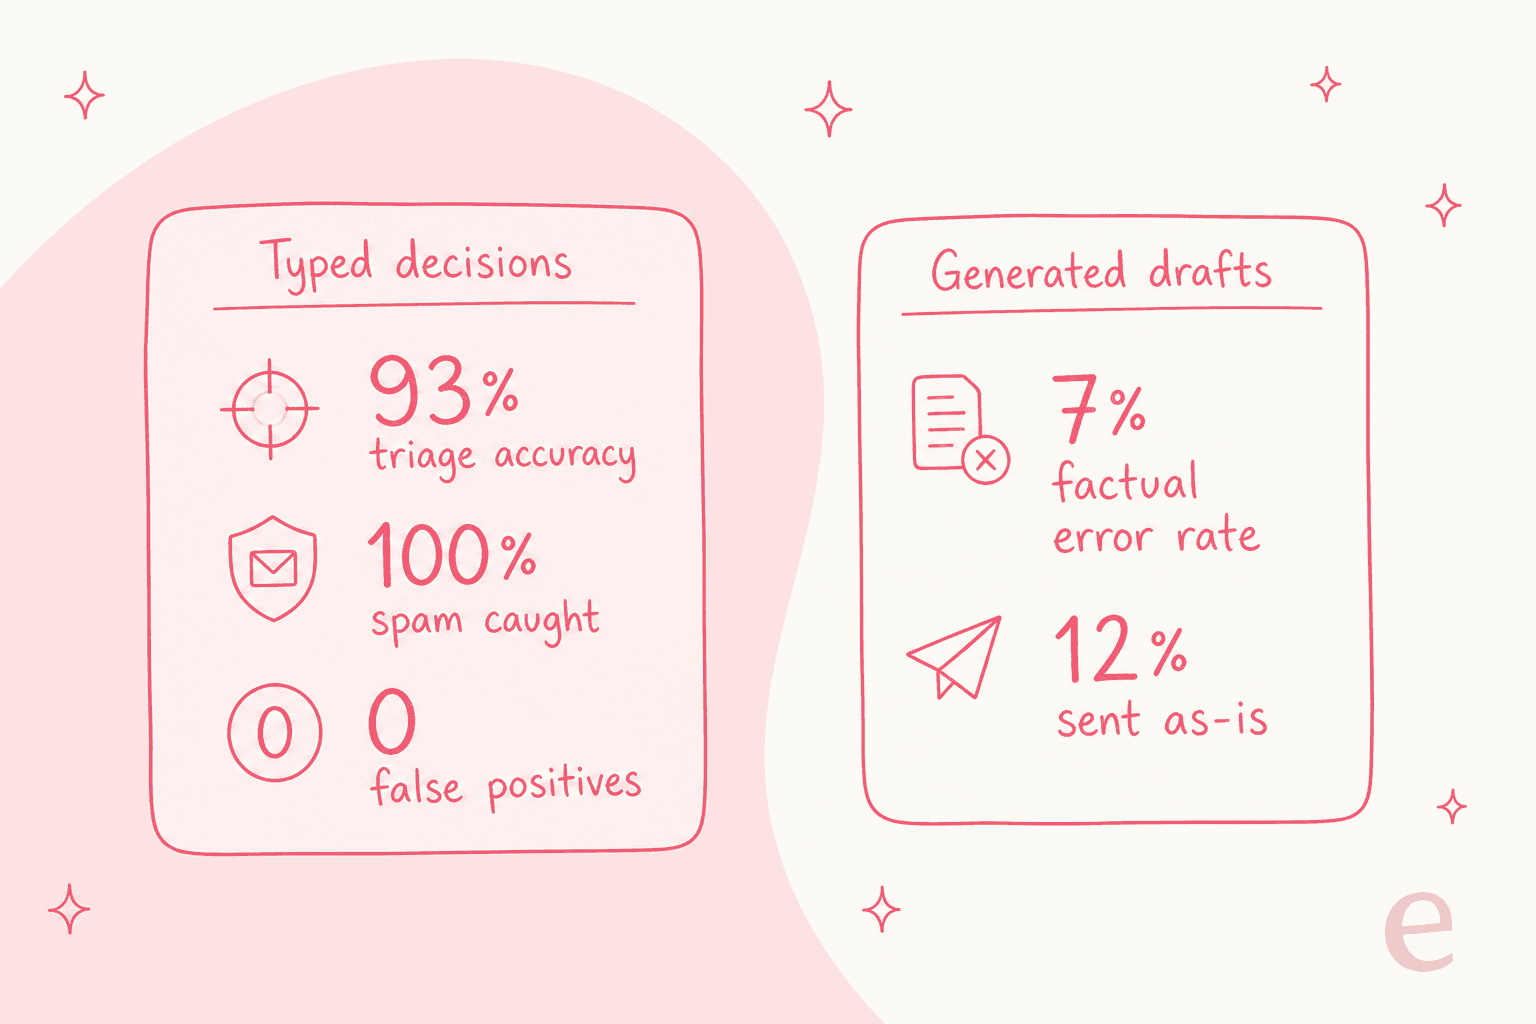
これこそがJevのようなモデルが刺激的である理由のすべてであり、同時にそれがゴールではない理由でもあります。型付き意思決定モデルはインフラです。その上に成り立つサポート業務、つまりヘルプデスクへの接続、ナレッジの読み込み、返信の下書き、アクションの実行、いつエスカレーションすべきかの判断、そして本番投入前にそれが機能することを証明すること、これは従業員の仕事です。
それがeeselの立ち位置です。Jevが高速なビルディングブロックであるのに対し、eeselのAIヘルプデスクチームメイトは即戦力の新規採用者です。主要なヘルプデスク連携(Zendesk、Freshdesk、Gorgias、Front、Help Scout、HubSpot)に接続し、そのままライブキュー上でトリアージ、下書き作成、解決までを行います。
重要なのは、たった1人の顧客に回答する前に過去のチケットに対してシミュレーションを行うため、ローンチ時のチャートではなく、あなた自身のデータに基づいた精度を確認できることです。座席数ではなく処理したチケットごとに課金されるため、経済性が実際の仕事に連動します。
そしてこの記事が本当に対象としている開発者にとって、eeselはダッシュボードだけの存在ではありません。同じチームメイトはeesel CLI(npx @eesel/cli)から操作可能です。人はターミナルから実行でき、スクリプトはAPIトークンを使ってCIで自動化でき、Claude Code、Codex、Cursorのようなコーディングエージェントは直接それを操作できます。連携の接続、常設インストラクションの編集、human-in-the-loopのアクションの一覧表示と承認、実行ごとのアクティビティログの閲覧まで、すべてJSONとして行え、書き込みが実行される前にプレビューする--dry-runも使えます。すべてのワークスペースはMCPサーバーでもあるため、Jevに向けるのと同じエージェントを、あなたのサポートチームメイトにも向けることができます。ラインナップはサポートだけにとどまらず、コンテンツ向けのAIブログライターチームメイトも存在します。Jevが気に入る理由が、知能をコードのように扱うところにあるのなら、それはターミナルからチームメイトを操作することを気に入る理由と同じです。
私の結論
Jevは、より優れたチャットボットを追い求めていないからこそ、今年最も興味深いモデルローンチの1つです。それは本物で有用なプリミティブです。キャリブレーションされた確信度を備えた、高速で安価かつtype-safeな意思決定であり、それらをコードの中で組み立てるためのすっきりとしたメンタルモデルです。 速度と価格は本来の用途に対しては十分に通用し、「ハルシネーションを起こせない」という主張は誇張されており、ベンチマークの見出しは、その下にある(それでも十分に良い)現実よりも大きな声を上げています。
エージェント型システムを組み立てている開発者であれば、ウェイトリストに登録し、これまで大きなモデルに無理をさせて行わせていた大量の意思決定という、Jevが強みを発揮する場所でまさにそれを使ってください。これらのシステムが本番環境でどのように見えるかについての大きな全体像は、AIエージェントの実例や最良のAIチームメイトのまとめが良い次の読み物になるでしょう。
ただし、反射神経を神経系全体と取り違えないでください。意思決定は簡単な1インチであり、エンドツーエンドの仕事は依然として1マイルなのです。
よくある質問
TypeSafe Jevとは何ですか?
Jevは、TypeSafe AIが初めて手がけたSystem Oneモデルで、2026年9月15日にローンチしました。チャットボットのようにテキストを生成する代わりに、型付きの質問を状態(state)に対して評価し、確信度スコア付きの構造化された意思決定を返します。汎用LLMというよりも高速な分類器に近く、これこそがこのTypeSafe Jevレビューの核心です。
JevはLLMですか?
いいえ、TypeSafeもそこは慎重に明言しています。Jevは散文で推論したり説明を書いたりしません。型付きの値と確率を1つ返すだけで、それ以上に複雑な処理は別々の質問に分割し、あなた自身のコードで再結合します。会話的な回答が必要なら、汎用モデルかサポート向けのAIエージェントが適切なツールです。
Jevは本当にハルシネーションを起こさないのですか?
出力があなたのスキーマに制約されているため、型エラーを起こすことはできません。しかし判断そのものについては、確信を持って間違えることは依然としてあり得ます。これはHacker Newsのコメント欄が最も強く突いた点です。率直に言えば、キャリブレーションされた確信度スコアは本物の安全機能ですが、「ハルシネーションを起こせない」というのは、モデルが実際に保証している内容よりも強い表現です。
Jevの料金はいくらですか?
TypeSafeは入力を100万トークンあたり0.042ドルと価格設定しており、出力トークンは無料としています。単独の料金ページやプラン階層はまだ存在せず、アクセスはアーリーアクセスのウェイトリスト経由です。Cloudflare Workers AI上では、課金はCloudflareのダッシュボードに委ねられます。
System Oneモデルで何を構築できますか?
あなたのコードが直接消費する構造化された意思決定です: チケット分類、ルーティング、緊急度・感情スコアリング、ツール呼び出しのレビュー、コンテキストの圧縮などです。これまでLLMを無理やりJSONに出力させ、それをパースし直していた場所ならどこでも適しています。これらの意思決定の上に成り立つエンドツーエンドのサポート業務については、カスタマーサービス向けの最良のAIエージェントをご覧ください。
サポート用途では、JevはGPTやClaudeより優れていますか?
役割が異なります。Jevは範囲の狭い意思決定(これは緊急か? どのキューか?)においてより高速かつ安価ですが、サポート用途に最適なLLMのようなモデルは引き続き返信文を書きます。ほとんどの本番システムは両方を使うか、あるいはすでにそれらを組み合わせたチームメイトにワークフロー全体を任せることになるでしょう。
TypeSafe Jevにはどうやってアクセスすればよいですか?
console.typesafe.aiでアーリーアクセスに登録するか、Cloudflare Workers AIのモデルID typesafe/jev経由で利用するか、既存のLLMをTypeSafeのオープンソースSystem Oneアダプターでラップしてください。詳細はドキュメントにすべて記載されています。


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.