TypeSafe Jevの正体
TypeSafeはサンフランシスコのAIラボで、Jevをローンチするまで2年間ステルスモードで過ごしました。その打ち出し方は意図的に挑発的です。TypeSafeのホームページでは、LLMは「人のために言葉を生成する」のに対し、「Jevは型付き意思決定を生成し、コードにより近い。信頼性があり、速く、自己一貫性があり、type-safeだ」としています。ローンチ記事はJevを「フロンティア級の知能を持つ関数呼び出し。非構造化の状態が入り、型付きの確率的意思決定が出る」と呼んでいます。
この名前は二重の内輪ネタになっています。「System One」は、ダニエル・カーネマンの著書『ファスト&スロー』にちなんでおり、速く直感的なシステム1思考と、遅く熟慮的なシステム2推論との区別から取られています。チャットモデルはシステム2を追い求めます。Jevはシステム1向けに作られています。つまり、知識のある人が数秒で下す瞬時の判断です。「Jev」自体は経済学者ウィリアム・スタンレー・ジェヴォンズにちなんで名付けられており、TypeSafeはその逆説を自社のテーゼとして引用しています。知能のコストが一桁下がるたびに、ユースケースは桁違いに増える。
この全体の前提は、チャットボットを心地よく会話できるものにした技術であるRLHFが、同時に機械が消費するには信頼できないものにもした、というものです。TypeSafeの主張は、「正反対の研究方向を取った」というもので、**Reinforcement Learning for Calibrated Decisions(RLCD)**と呼ぶ新しいアルゴリズムで新しいクラスのモデルを訓練しました。
Jevの仕組み: 状態が入り、型付き意思決定が出る
中心となるループは、1回のリクエストに対して1回のレスポンスです。状態(state)(単純な文字列でも構造化されたオブジェクトでもよい)と、型付きの質問のセットを送信します。Jevは同じ状態に対して各質問を並列に評価し、確率と確信度付きの型付き回答を返します。あなたのコードは、それらの回答に基づいて分岐、ソート、振り分けを行います。
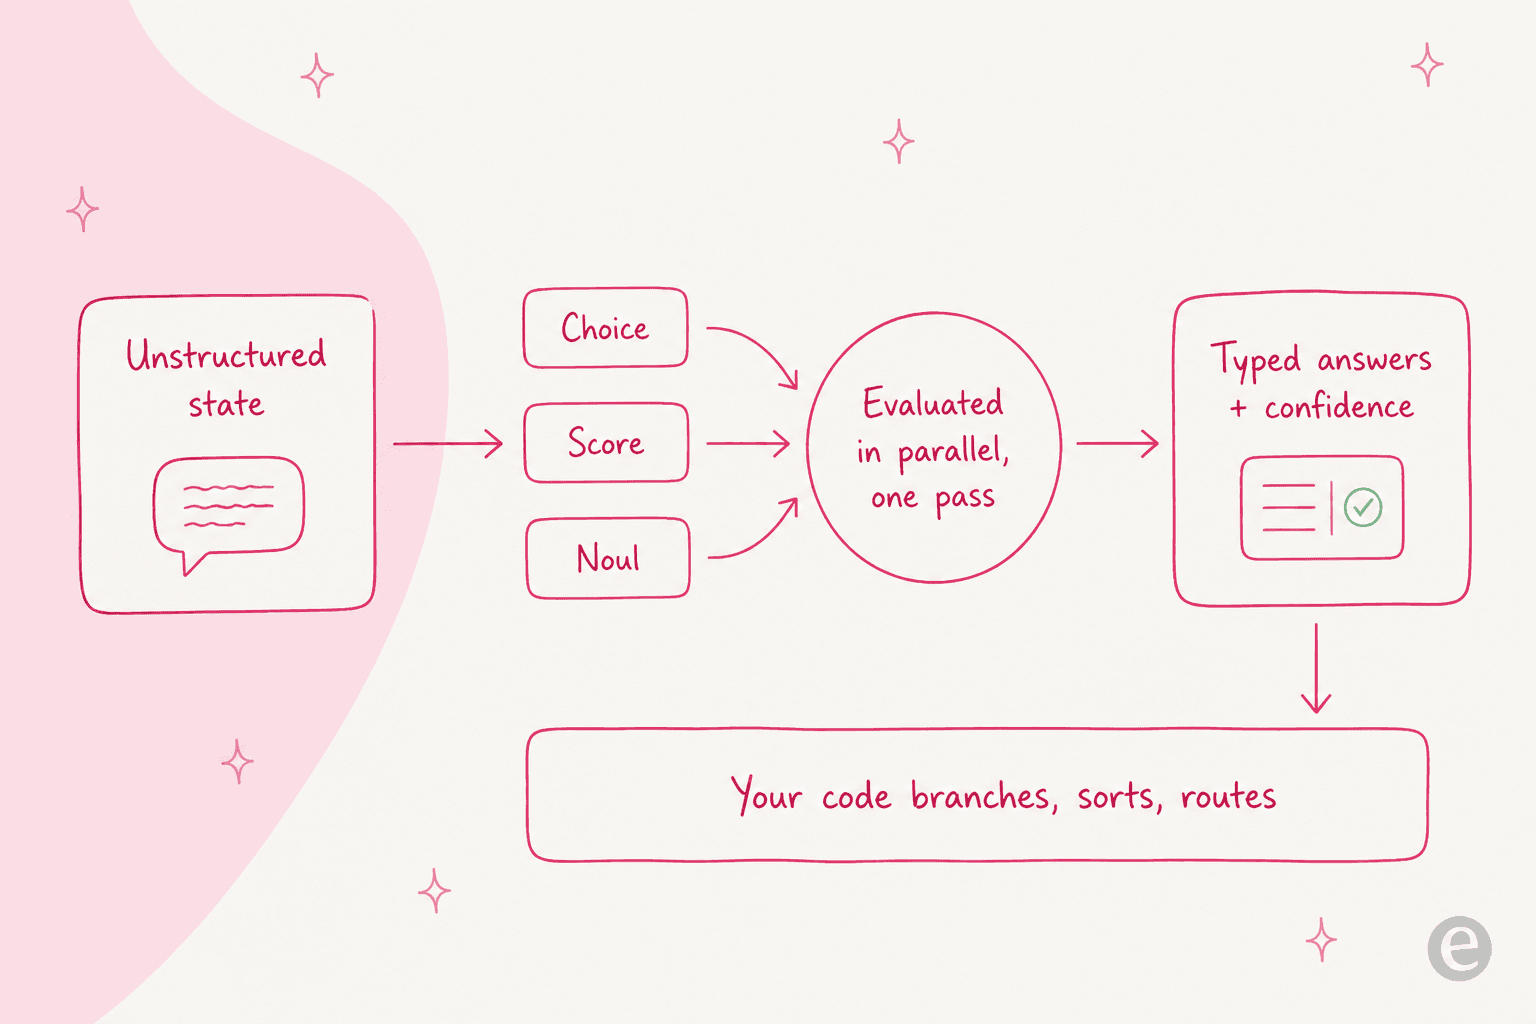
最も重要な設計上の選択は、各質問が同じ状態に対して独立して、孤立した形で評価されることです。TypeSafeによれば、質問を追加しても応答時間はほとんど変わらず、それぞれが個別に採点されるため、一つのプロンプトに大量の指示を詰め込んだときに忍び寄る「コンテキストの劣化(context-rot)」も起きません。
TypeSafeのアドバイスは、各質問をアトミック(単一の要素)に保つことです。「このスタートアップのピッチを評価して」と尋ねる代わりに、各次元を個別に尋ね(市場規模、技術的実現可能性、差別化)、そのスコアを自分の式で組み合わせます。優先順位が変わったときは、プロンプトを書き直すのではなく、コード内の係数を変更します。メガプロンプトをうまく振る舞わせようと苦労したことがあるなら、この分解の発想はなじみ深いはずで、優れたAIワークフロー自動化を支えているのも同じ論理です。
3つのプリミティブ: Noul、Choice、Score
Jevはちょうど3種類の質問タイプを提供しており、1回のAPI呼び出しでこの3つすべてを組み合わせることができます。
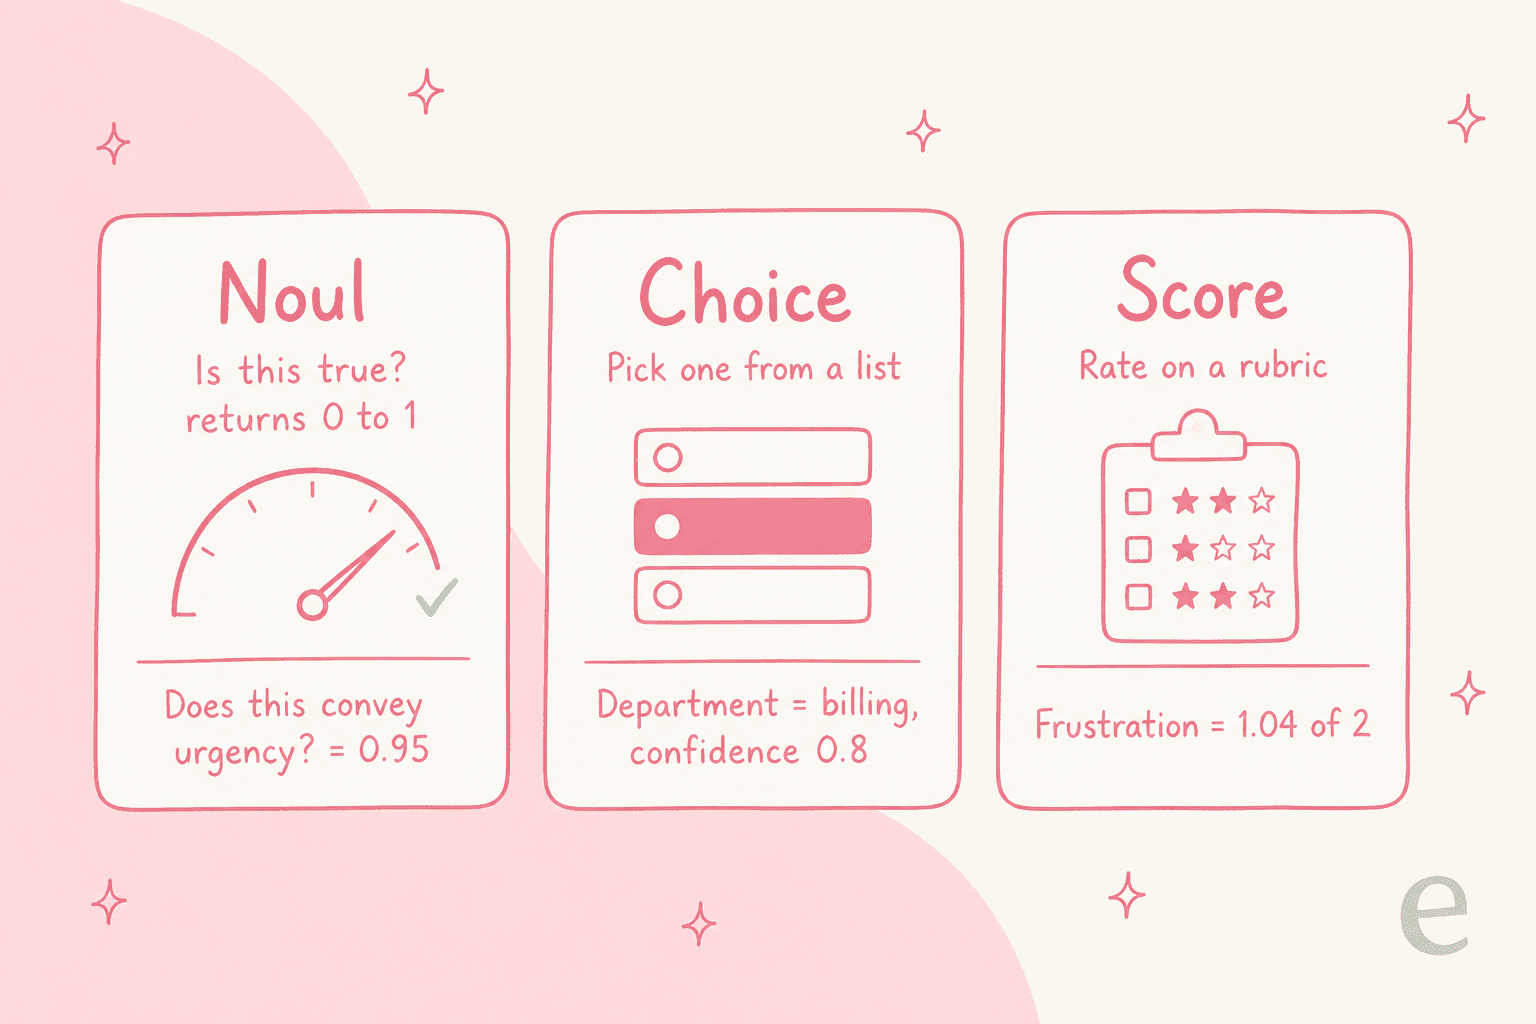
- **Noul**は「この主張は真実か?」に答え、0から1の単一の確率を返します。
- **Choice**は定義したリストから1つの選択肢を選び、選ばれた結果、選択肢ごとの確率、確信度を返します。
- **Score**は定義したルーブリックに基づいて状態を評価し、数値(2段階のうち1.04のように、段階の間に落ち着くこともあります)、段階ごとの確率、確信度を返します。
Cloudflareが公開している実例は、意味深いことにサポートチケットです。「Help! My payouts have been failing for 3 days」というメッセージと3つの混合質問をJevに与えると、is_urgent(Noul)が0.95、department(Choice)がbillingで確信度0.8、frustration(Score)が冷静から非常に怒っているまでのスケールで1.04と、すべてが1回の呼び出しで返ってきます。これはトリアージ、振り分け、感情分析を1回のリクエストで行うということであり、AIチケットトリアージのステップに必要なのはまさにこの種の判断です。
Jevが通常のLLMと決定的に違う点
1つだけ心に留めておくメンタルモデルがあるとすれば、これです。LLMは書き、Jevは決める。
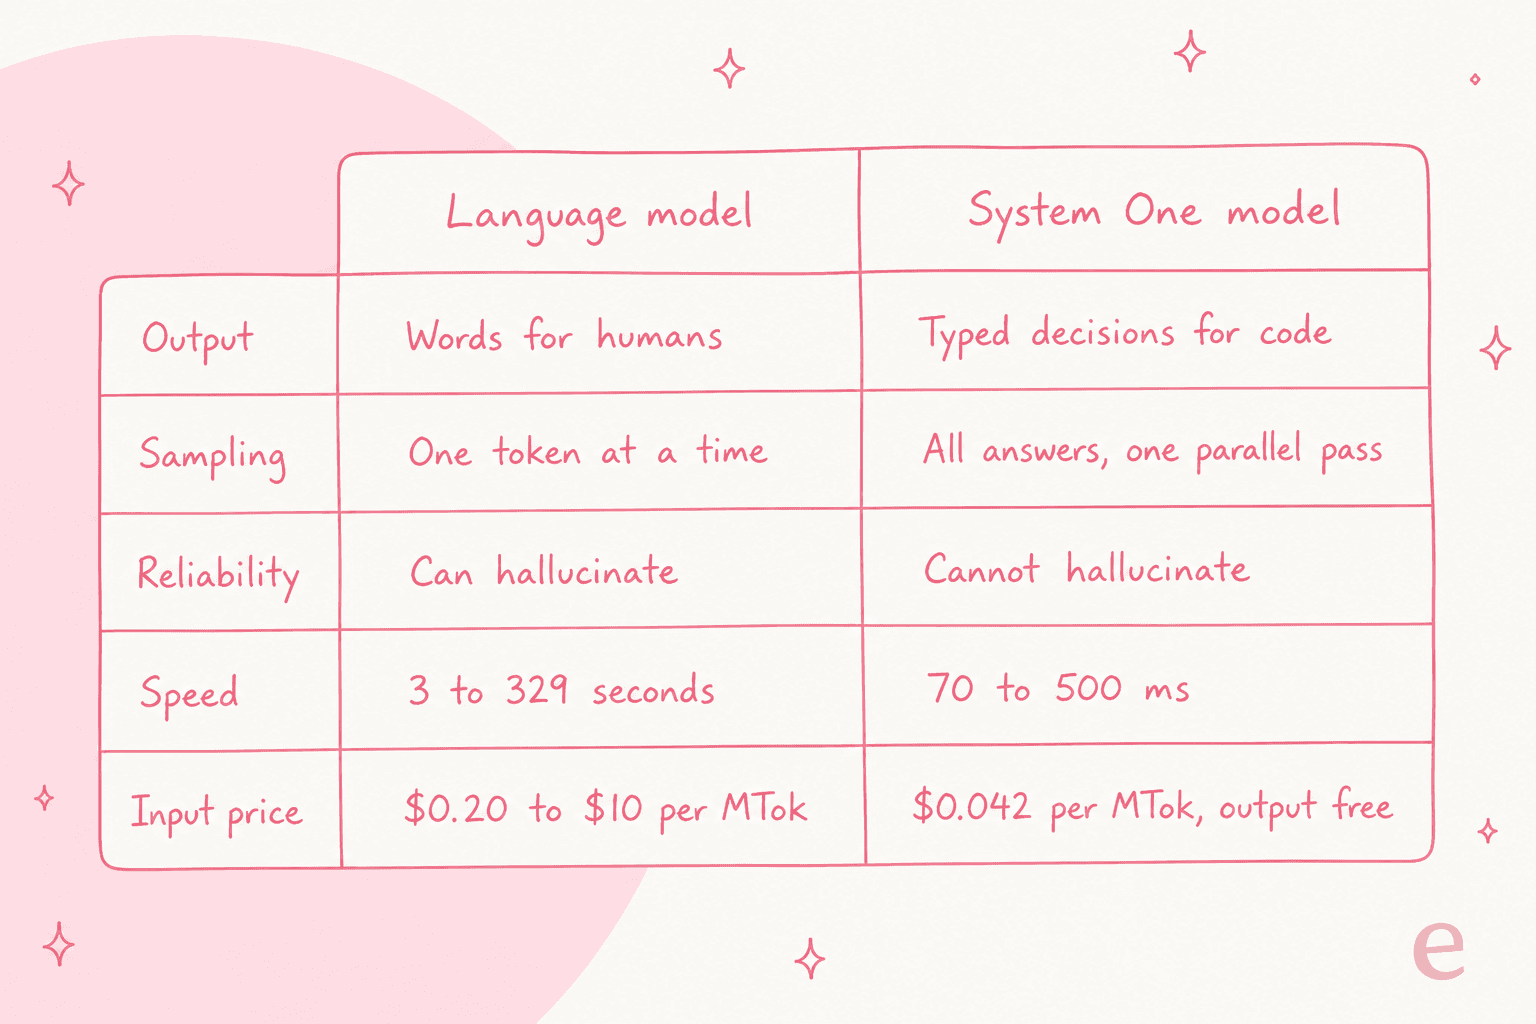
言語モデルは、人間が読める文字列を生成するまで、一度に1つずつトークンを順番にサンプリングします。Jevは単一の並列パスですべての出力を生成し、自由なテキストは一切生成しません。だからこそ高速であり、だからこそこの比較は必ずしもフェアではないのですが、その点には後ほど戻ります。開発者にとっての実用的な結論は、現在LLMにJSONの塊を無理やり出力させ、それをパースして有効であることを祈っている場面すべてに、Jevが収まるということです。これは、AgentKit対Anthropic APIにも出てくる「実際にはどの層を選んでいるのか」という同じ問いです。
TypeSafeが主張する数字
TypeSafeは数字を出し惜しみしません。ここに、それぞれの注意点とともに示します。
| 主張 | Jev | TypeSafeが述べる基準 |
|---|---|---|
| エンドツーエンドのレイテンシ | 70ミリ秒から500ミリ秒 | フロンティアLLMでは3秒から329秒 |
| 速度の倍率 | 40倍から200倍高速 | System One形式のクエリにおいて |
| ワークフローの見出し | 193.6倍高速、444.6倍安い | 「実世界の成果の中でも上位の水準」 |
| 入力価格 | 0.042ドル / MTok、出力は無料 | Claude Fable 5.1より238倍低い |
| コンテキストウィンドウ | 32,000トークン | モデルバージョン jev-1.13.0 |
JevはすでにCloudflare Workers AI上でtypesafe/jevとして稼働しており、TypeSafeはウェイトリストから早期アクセスを開放しています。まだ独立した価格ページはなく、0.042ドルという数字はホームページとローンチ記事から来ています。持続可能性について、TypeSafeはローンチ記事で清々しいほど率直です。"We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
最も信頼できる外部のデータポイントは、Jevを実際の製品に組み込んだVercelのCEOからもたらされました。
"We're seeing extraordinary results from @typesafeai. Default mode in 𝚏𝚡 is auto, with a safety reviewer analyzing every command. That reviewer runs on GPT Luna today. Jev is up to 18x faster (p95) and more accurate."
実際の安全性レビューのステップで18倍の高速化というのは、200倍というマーケティング上の数字よりもはるかに地に足のついた主張であり、Jevが本当に輝く場所を示しています。それは、より遅いシステムの手前に置かれる高速なチェッカーです。
「ハルシネーションを起こせない」の本当の意味
これは、Hacker Newsのローンチスレッド(1,929ポイント、508コメント)を炎上させた主張であり、ほとんどの人が誤解するであろう点なので、じっくり見る価値があります。
Jevは型エラーを起こすことも、リストになかった選択肢を返すこともできません。その機械的な意味では「ハルシネーションを起こせない」といえます。しかし型付きの回答であっても確信を持って間違っている可能性はあり、複数のコメント投稿者がこの点を鋭く指摘しました。
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"

擁護する側の主張は、Jevが常に確信度の値を渡してくれるので、確実な回答には行動を起こし、不安定な回答は人間に振り分けられるというものです。
"they mean they produce a confidence value for every result, so you could see for example it has 0.1 confidence, and you can disregard the result."
本当の試金石はキャリブレーションであって、「ハルシネーションを起こせない」というスローガンではありません。 あるコメント投稿者が言うように、モデルが千件の回答に対して0.9と述べたなら、そのうち約900件は正しいはずです。RLCDはまさにそこに最適化されているとされています。独立したキャリブレーションの数字が出てくるまでは、「ハルシネーションを起こせない」を「常に正しい」ではなく「不正な形式の出力を返さない」という意味で扱うべきです。実際の顧客の質問にAIを展開する人にとって、その区別がすべてであり、だからこそ私たちはサポートにおけるAIハルシネーションを防ぐためにグラウンディングとテストにこれほど力を入れているのです。
Jevを支える人々
TypeSafeには軽視できない経歴があります。創業者兼CEOのDiogo Almeida氏は、ChatGPTにつながる研究路線であるOpenAIでのRLHFとInstructGPTの共同発明者で、以前はGoogle Brainに在籍していました。彼にはCOOのSasha Sheng氏(元Meta/FAIR)とCTOのErik Gafni氏が加わっており、チームはOpenAI、Google Brain、Meta、Stripe、Airbnb、Dockerの出身者で構成されています。
同社は"トップクラスの投資家に支えられている"と述べていますが、自社ページで資金調達額を公表していないため、ここでは金額を挙げません。「Build Prod, Not God」というタグラインが、その姿勢を物語っています。これはAGIを追い求めるのではなく、信頼できるプロダクションのパーツを出荷することに最適化しているチームです。
Jevを実際に使うべきか?
ドキュメント、デモ、そして批判に目を通した上での私の見解を紹介します。
仕事があなたのコードが消費する、狭く明確に範囲づけられた意思決定であるとき、Jevを使いましょう。振り分け、モデレーション、意図検出、スコアリング、抽出ゲート、あるいはより大きなモデルの手前に置く高速な安全性チェックなどです。Hacker Newsで最も説得力のある開発者の意見は、すでに手作業でこれを行っていた人からのものでした。
"this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... Jev's focus on structured I/O and confidence scores are game changing. If this does at all what it claims, I think this is going to quickly become the new standard approach for agentic systems."
生成、説明、複数ステップの推論が必要なときは、Jevを使うべきではありません。スレッド全体で最も支持を集めたコメントが、正直な位置づけを言い当てています。
"Seems like a more accurate title would be 'Jev: Trading general purpose generation for fast typed inference.'"
そして、開発者のTheo Browne氏を含む最も声高な懐疑派は、バイラルなデモが本来単純な分類器やルールが担うべき仕事にJevを押し込んでいると主張しました。これは正当な警告です。これほど高速なツールは過剰利用を招きます。守るべき一線は、Jevはプリミティブだということです。優れた意思決定を与えてくれますが、パイプライン、エスカレーションのロジック、ディフレクション戦略、そして意思決定の後に起きるすべてのアクションは、依然としてあなたの責任です。
eeselを試す
サポートを運営しているなら、これまでの話を正直に翻訳するとこうなります。Jevは素晴らしいエンジンであって、車そのものではありません。 チケットが緊急で、課金関連で、苛立った顧客からのものだと114ミリ秒で教えてくれます。しかし、チケットを開いたり、ヘルプセンターに基づいた返信を下書きしたり、返金を適用したり、判断に自信がないときに人間に引き継いだりはしません。それは誰かが構築する必要があります。
eeselは、その完成したチームメイトです。ヘルプデスクに組み込むAIサポートチームメイトで、Jevがプリミティブとして公開しているトリアージ、振り分け、エスカレーションの判断をすでに行い、それをエンドツーエンドで実行します。既存のカスタマーサービスキューに加わり、過去のチケットとヘルプセンターから学習し、実際の顧客に触れる前に過去のチケットに対してシミュレーションすることもできます。

そして、Jevの開発者向けの使い勝手を気に入ったなら、これも気に入るはずです。eeselはダッシュボードだけのツールではありません。eesel CLI(npx @eesel/cli)は、同じチームメイトとワークスペースをターミナルから操作します。人はeesel chat、eesel activity、eesel approvalsを手動で実行でき、スクリプトはCIでそれを自動化でき、Claude Code、Codex、Cursorのようなコーディングエージェントも操作できます。すべてのコマンドがJSONを出力し、--dry-runが実行前に正確な呼び出し内容を示すからです。すべてのワークスペースはMCPサーバーでもあります。Jevは意思決定を与え、eeselはそれに基づいて行動するチームメイトを与え、あなたのエージェントがそれを操作できるようにします。eeselを無料で試すことができます。
よくある質問
TypeSafe Jevとは何ですか?
TypeSafe Jevは、初めて一般公開されたSystem Oneモデルです。テキストを生成する代わりに、型付きの質問を状態(state)に対して評価し、確率と確信度スコア付きの型付き意思決定を返します。一次対応のトリアージや振り分けなど、ソフトウェアが直接消費する狭く構造化された判断のために作られています。
TypeSafe Jevの料金は?
TypeSafeはJevの価格を入力100万トークンあたり0.042ドル、出力は無料としており、同社はこれをClaude Fable 5.1と比べて入力価格が238分の1だと説明しています。公開されたプラン別の料金表はまだなく、アクセスは早期アクセスのウェイトリスト経由です。
Jevは本当にハルシネーションを起こせないのですか?
型エラーを起こしたり、与えられたリストにない選択肢を作り出したりすることはできませんが、確信度の高い誤った型付き回答はやはり起こり得ます。この点はHacker Newsでも議論されました。本当の試金石はキャリブレーション(較正)です。サポートキューで根拠のある回答を求めるなら、AIハルシネーションを防ぐガイドと同じ規律が当てはまります。
JevはLLMの代替になりますか?
いいえ。Jevは高速な型付き意思決定を行いますが、文章を書いたり、段階的に推論したり、会話をしたりはしません。多くのチームはLLMと組み合わせ、分類と振り分けのステップにJevを使います。実務ではルールベースとAIエージェントの使い分けと似ています。
Jevは通常のAIカスタマーサービスエージェントとどう違いますか?
Jevはインフラです。自分のコードに組み込む意思決定のプリミティブです。eeselのようなAIカスタマーサービス製品は、それらの意思決定を行い、ヘルプデスク内でアクションを実行する完成したチームメイトです。eesel CLIを使えば、ターミナルから操作することもできます。


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.