なぜ人はGrok 4.7の代替を探すのか
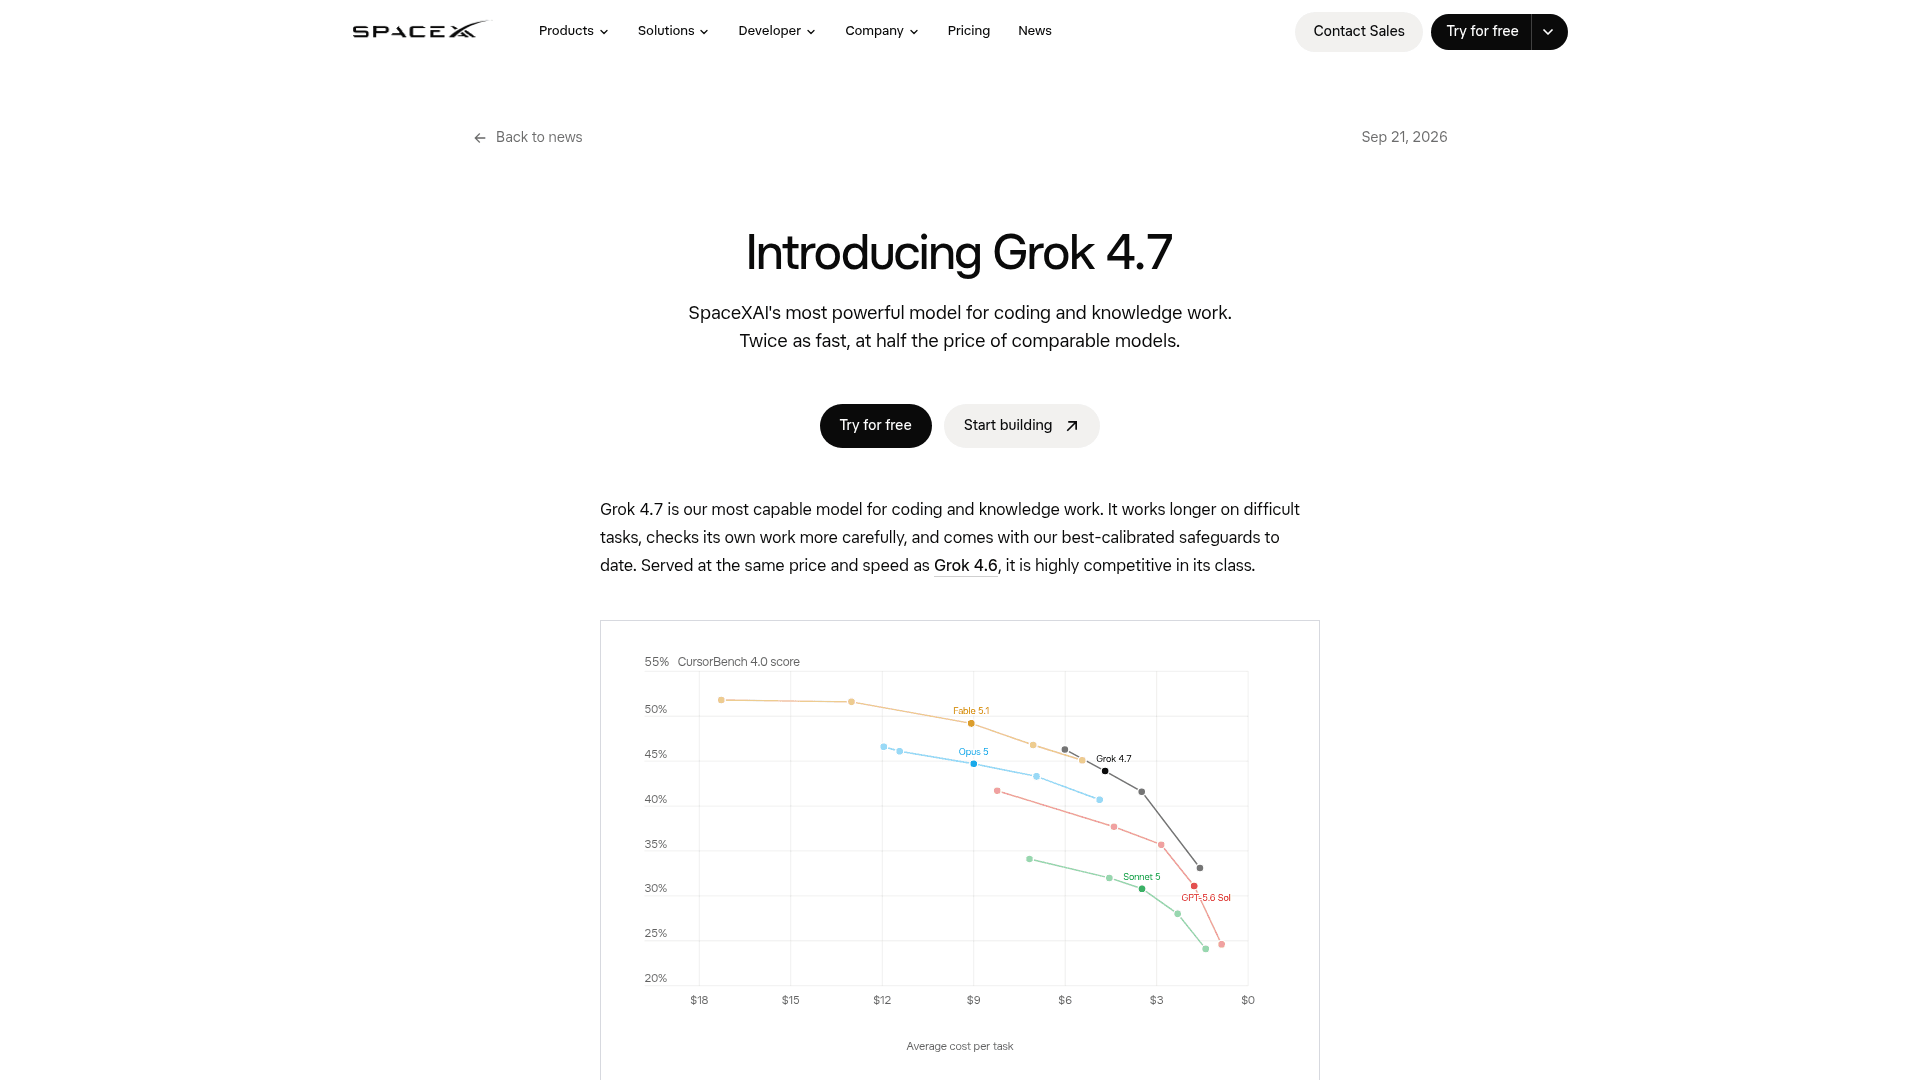
Grok 4.7は強力なデフォルトの選択肢なので、他を探す理由は特定のものになりがちだ。私がよく聞くのは20万トークンの価格の崖だ。リクエストが20万プロンプトトークンを超えると、xAIの料金ページによれば、Grok 4.7はそのリクエストのすべてのトークンを2ドル/6ドルではなく4ドル/12ドルで課金する。ワークロードが長文ドキュメントや大規模コードベースであれば、この倍増は計算を変えてしまうし、一部の代替はまったく課金しない。
その他の理由はポリシーと能力に関するものだ。Grokはクローズドなので、オープンウェイトが必要なら選択肢から外れる。テキストと画像を入力として受け取りテキストを出力するので、ネイティブな音声や動画の理解が必要ならGeminiを検討することになる。そして一部のチームは単純に知能チャートの絶対的な頂点を求めており、そこには依然としてClaudeがいる。Grok 4.6のユーザーは、前世代の文脈を知るためにGrok 4.6レビューも読める。
これらをどう比較したか
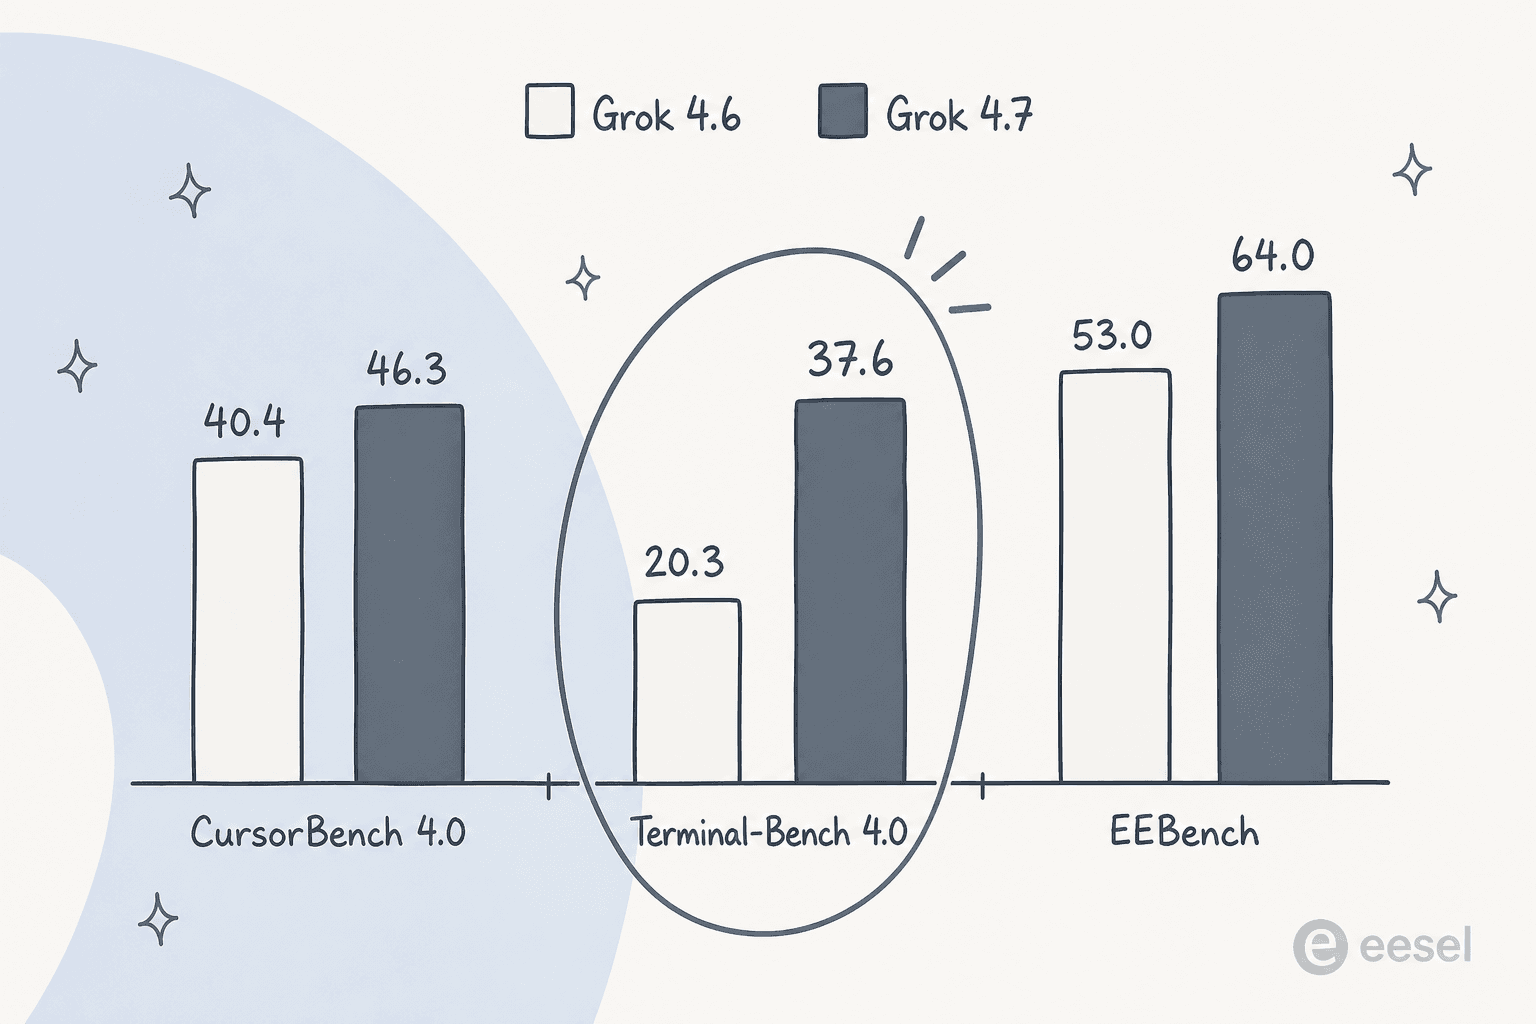
私は一次情報源に絞った。各ベンダー自身のモデルおよび料金ページに加え、各メーカーが公開しているベンチマーク表だ。価格は2026年9月時点でドキュメントページに掲載されている実際の数字であり、プロモーションが失効する場合(Geminiのものは2027年1月1日に失効する)はその旨を明記した。知能ランキングを引用する際は、各メーカー自身のチャートと、独立系のArtificial Analysis指数を出典としており、他のリストを書き写しただけの第三者のリストは使っていない。
特に重視した2点は、買い手が見落としがちな点だ。20万トークンの価格の崖、そして「安い」数字が実際に支払う数字なのかどうかだ。トークン単価は安いがタスクごとに冗長なモデルは安くない。該当する箇所ではそれを指摘した。
一目でわかるGrok 4.7の最良の代替
ここに全体の顔ぶれを一画面にまとめた。価格は各ベンダーのリアルタイムのドキュメントに基づく100万トークンあたりの金額だ。
| モデル | メーカー | 入力 / 出力 | コンテキスト | 20万の崖 | オープンウェイト | ネイティブ画像入力 | 最適な用途 |
|---|---|---|---|---|---|---|---|
| Grok 4.7 | xAI | 2ドル / 6ドル | 500k | あり(2倍) | なし | 画像 | 安価なフロンティアコーディング |
| Claude Fable 5.1 | Anthropic | 10ドル / 50ドル | 1M | なし(均一) | なし | 画像 | 最高の知能 |
| Claude Opus 5.5 | Anthropic | 4ドル / 20ドル | 1M | なし(均一) | なし | 画像 | 長時間のエージェント型コーディング |
| GPT-6 Sol | OpenAI | 2ドル / 10ドル | 大 | あり(2倍) | なし | 画像 | エコシステム+バランス |
| Gemini 3.8 Flash | 0.75ドル / 3.75ドル | 1M | なし(均一) | なし | 画像、音声、動画 | マルチモーダル+安価 | |
| DeepSeek V4.1 Flash | DeepSeek | 約0.22ドル / 0.66ドル | 1M | なし | あり(MIT) | なし | 最安、自己ホスト |
| Kimi K3 | Moonshot | 3ドル / 15ドル | 1M | なし | あり | 画像、動画 | オープンウェイトのフロンティア |
| Qwen 3.8 Max | Alibaba | 2ドル / 6ドル | 1M | なし | ベースのみ | 画像、動画 | Grokの価格、オープンなベース |
リストの前に公平性について一言。Geminiの0.75ドル/3.75ドルは2026年12月31日までのプロモーション料金で、その後は倍になる。DeepSeekのオフピーク料金は中国のビジネスアワー中はおおむね倍になる。そしてQwen 3.8 Maxのオープンなベースは、ホスト版と機能的に同等ではない。詳細は各項目に記載した。
1. Claude(Fable 5.1とOpus 5.5)
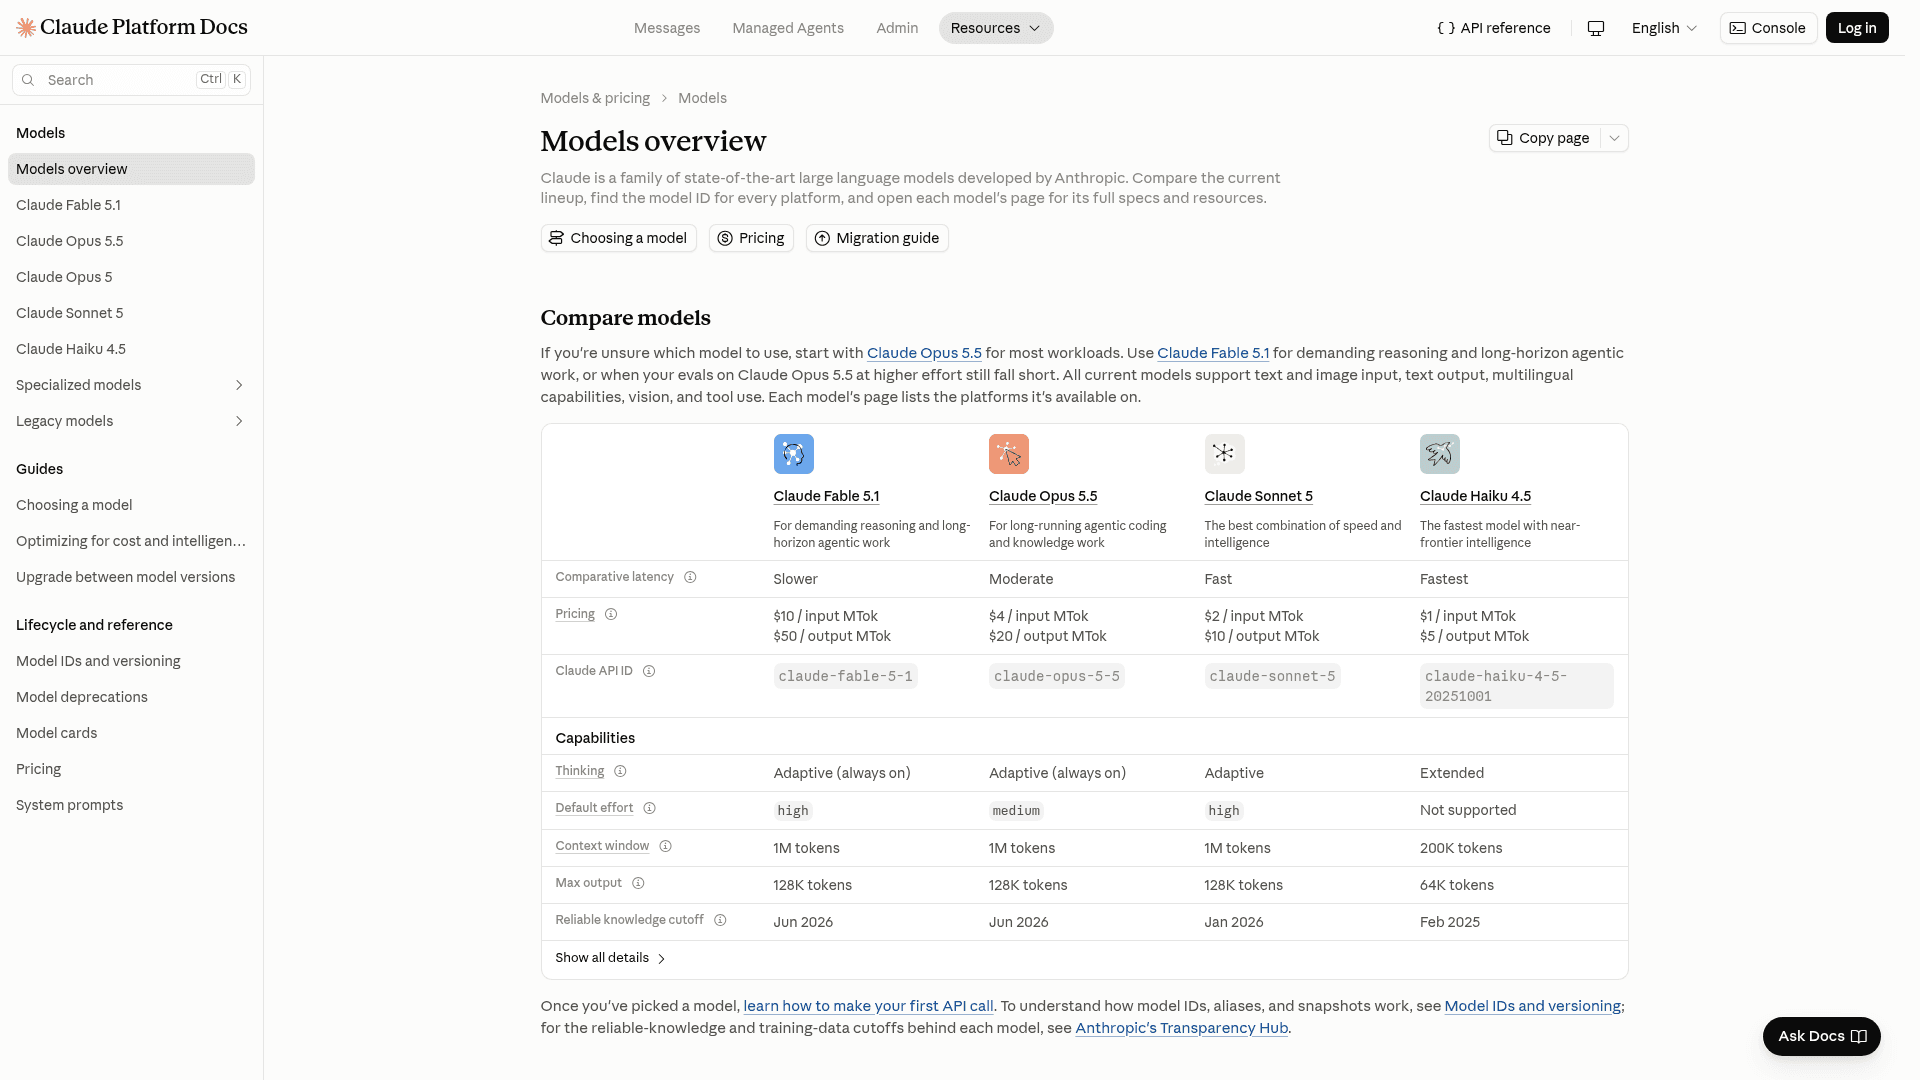
Grok 4.7の売り文句が「安くてフロンティアに近い」だとすれば、Claudeの売り文句は「実際にフロンティアである」だ。AnthropicのFable 5.1はほとんどの公開リーダーボードで打倒すべきモデルであり、Opus 5.5はそのすぐ下に位置し、長時間のエージェント型コーディングの主力となっている。
注目点。 Fable 5.1はCursorBench、Terminal-Bench、AA BriefcaseリーダーボードでGrok 4.7を上回り、専門業務指数のGDPvalでも首位に立つ。両方のClaudeモデルは1Mコンテキストウィンドウを持ち、20万トークンの価格の崖がないため、長文ドキュメントの作業は単一の均一料金で課金される。Fableのキャッシュ読み取りは100万あたり0.25ドルと異例に安く、繰り返しのエージェント呼び出しを表示価格が示唆するよりはるかに痛みの少ないものにしている。
長所。 この特集で測定された中で最高の知能。コンテキストウィンドウ全体を通じた均一料金。強力で文書化の行き届いたツール利用と成熟したSDK。
短所。 高価だ。Fable 5.1はGrok 4.7の料金のおよそ5倍であり、Opus 5.5でさえ2倍だ。コミュニティの報告によれば、Fableのセーフガードが自社のセキュリティコードで誤作動することがあり、また出力には統計的なテキスト透かしが入るようになった。
料金。 Fable 5.1は10ドル/50ドル、Opus 5.5は4ドル/20ドル、より安価な兄弟モデルのSonnet 5は2ドル/10ドルだ。3モデルともコンテキストは1Mで均一料金だ。
私の見解。 最後のわずかな性能差にお金を払う価値がある場合、あるいは高負荷時のGrokですでに天井にぶつかっていた場合はClaudeを選ぶとよい。負荷レベルのトレードオフについてはClaude Opus 5の記事を参照してほしい。
2. GPT-6 Sol
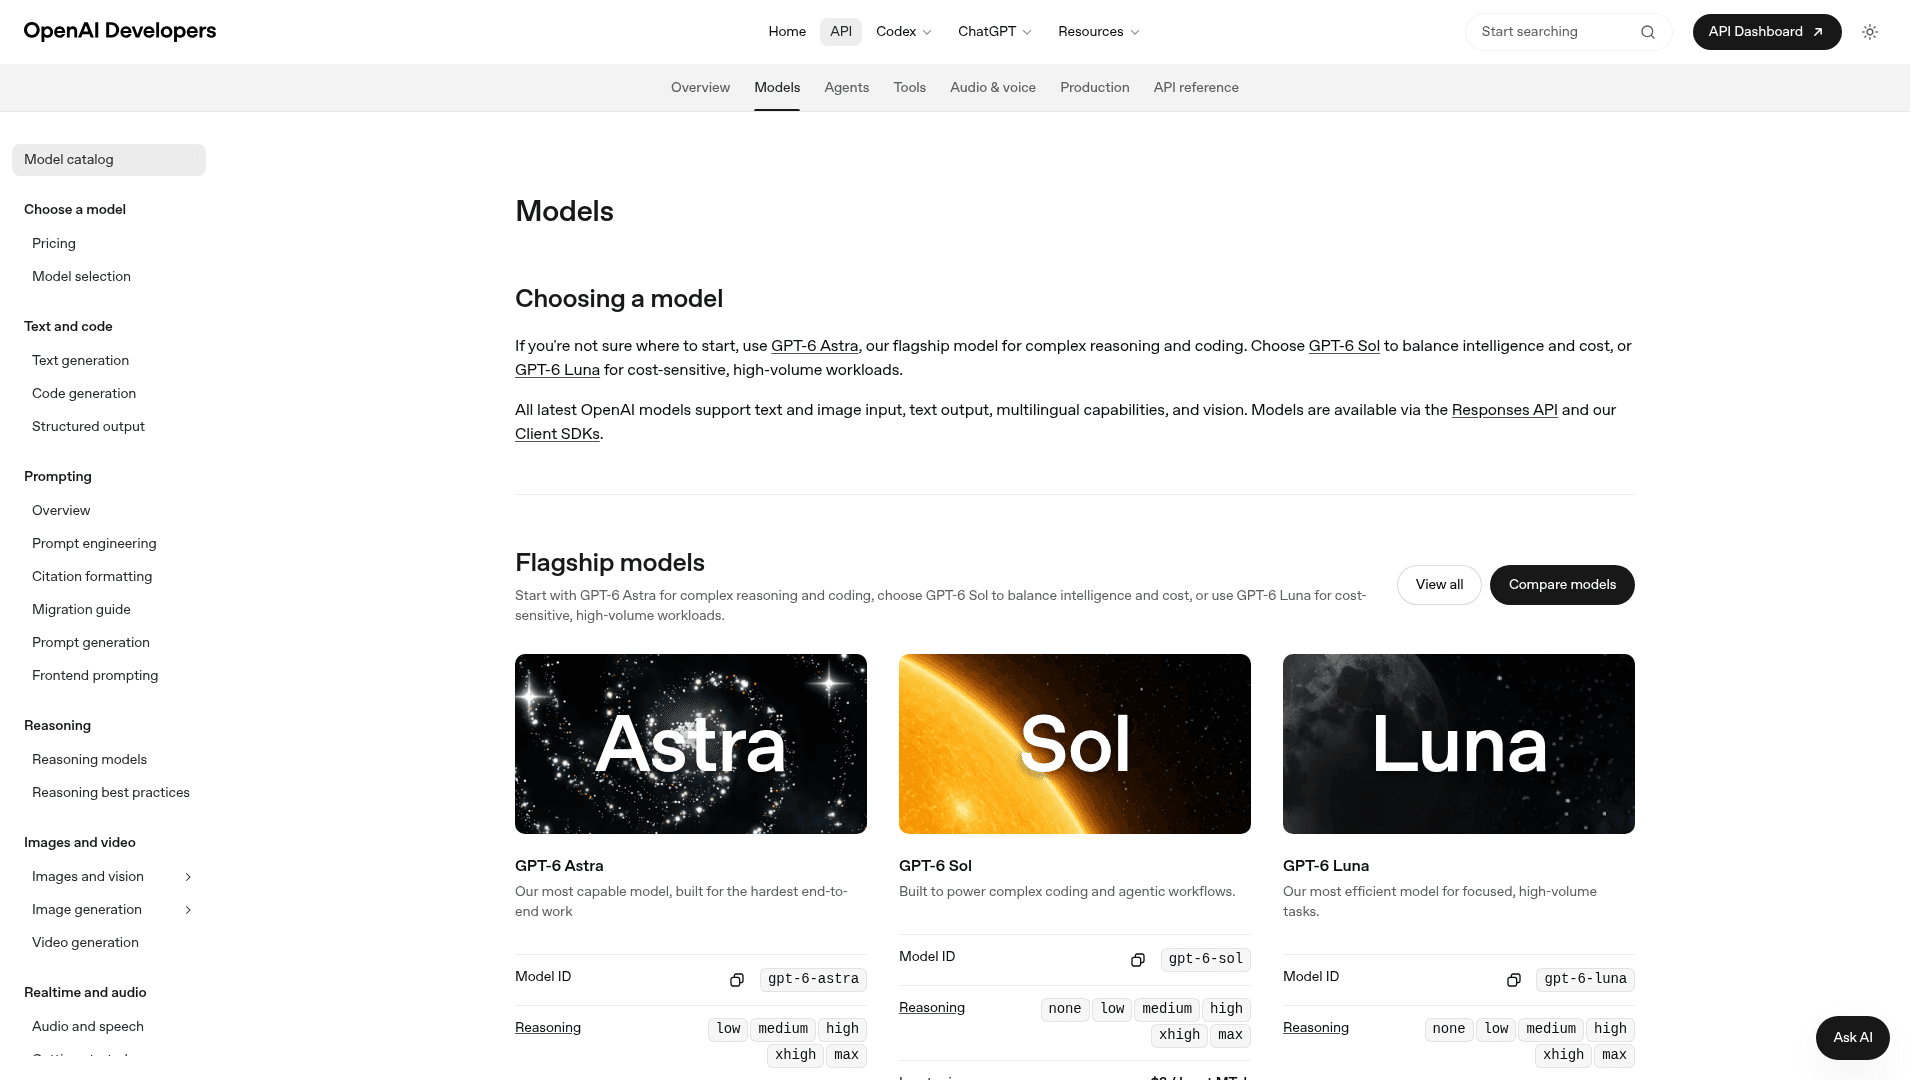
OpenAIのGPT-6 SolはxAIが最も激しく追いかけているモデルであり、最も直接的な乗り換え先だ。OpenAI自身の言葉を借りれば「複雑なコーディングとエージェントワークフローを支える」ために構築された中価格帯のクローズドモデルだ。Claude Opus 5.5と同じ2026年9月22日にローンチされた。
注目点。 エコシステムだ。Solはここに挙がったどのモデルよりも多くのツール、SDK、下流の製品に組み込まれており、それがしばしばチームがこれを選ぶ本当の理由になっている。出力トークン単価はGrokより高いものの、タスクを終えるために消費する出力トークン数が少ないため、最も賢いClaudeよりもタスクあたりでは大幅に安い。
長所。 巨大なツール・統合面。価格と知能の両方で理にかなった中間に位置する。設定可能な推論はなしから最大まで。
短所。 Grokと同じ20万トークンの価格の崖があり、長いリクエストでは倍になる。Artificial Analysisの知能指数では、最大負荷時のスコアが最上位のClaudeに後れを取る。そして短コンテキスト料金でGrok 4.7より出力が5分の1高い。
料金。 フラッグシップのSol層で2ドル/10ドル、崖を超える長コンテキストでは倍になる。より安価な兄弟モデルはTerraとLuna。旧世代のGPT-5.6も依然として利用可能だ。
私の見解。 すでにスタックがOpenAIを使っているなら無難なデフォルトだ。コストに敏感で新規に始めるなら、Grok 4.7かQwenの方が出力価格で下回る。
3. Gemini 3.8 Flash
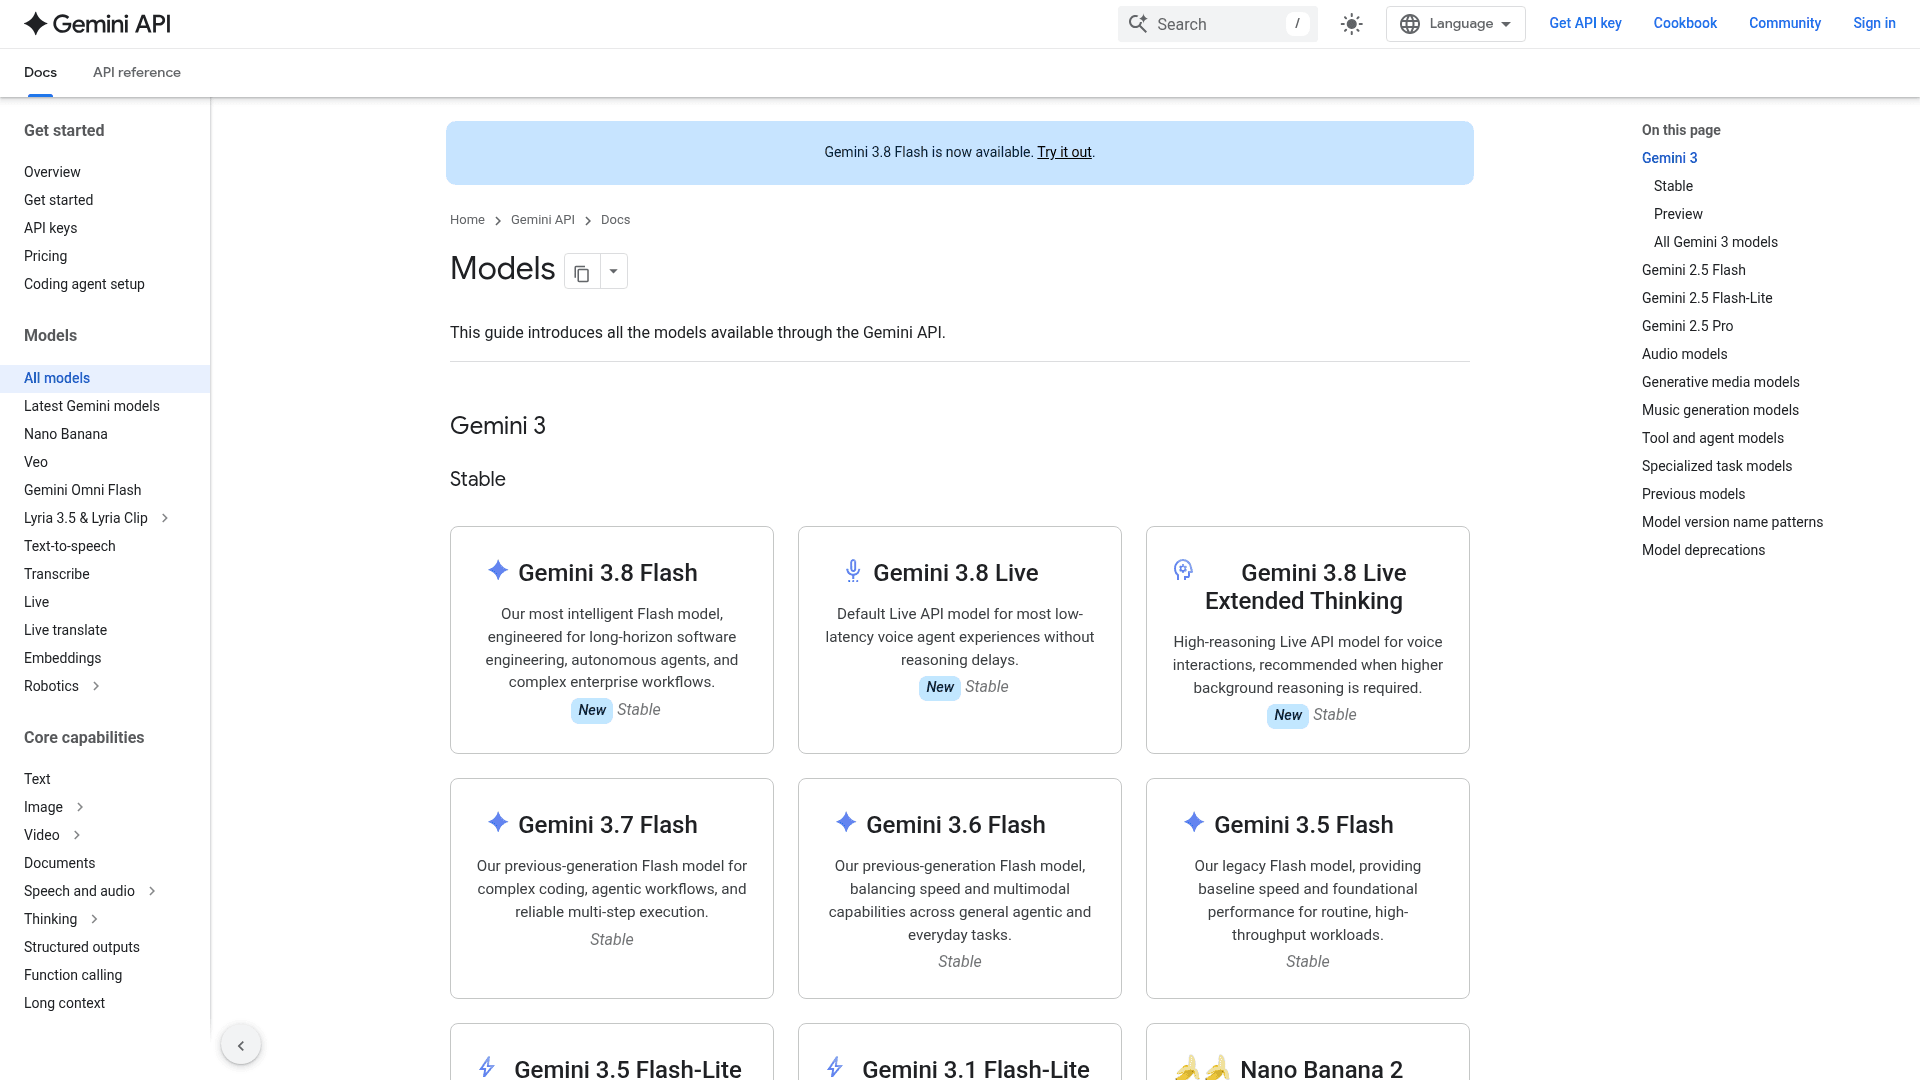
GoogleのGemini 3.8 Flashは、この分野のマルチモーダルかつ安価な一角だ。ここに挙がった中で唯一音声と動画をネイティブに入力できるモデルであり、リスト価格はDeepSeek以外のすべてを下回る。
注目点。 テキスト、画像、音声、動画、PDFのネイティブ入力がすべて単一のAPIを通じて可能だ。価格の崖がない100万トークンのコンテキストウィンドウ。そして0.75ドル/3.75ドルという価格はGrokのコストのほんの一部であり、無料枠から始められる。
長所。 この特集で最高のマルチモーダル対応。得られる知能に対して非常に安価であり、Artificial Analysis指数でも好スコアを出す。Google Searchのグラウンディングに直接接続できる。
短所。 応答性が難点だ。Artificial Analysisは最初のトークンまでの時間を13.3秒と計測しており、これはクラス中央値の約3秒に対して大きく、人間がライブで待つような用途には向かないが、夜間バッチ処理には問題ない。冗長でもあるため、安いトークン単価がタスクごとに膨らむことがある。そしてプロモーション価格は2027年1月1日に1.50ドル/7.50ドルへと倍増する。効率重視のワークロードには3.7 Flashにとどまることを、Google自身が提案している。
料金。 2026年12月31日までは0.75ドル/3.75ドル、その後は1.50ドル/7.50ドル。BatchとFlexは半額だ。
私の見解。 入力がマルチモーダルであるか、タスクがバッチ処理で価格に敏感な場合の選択肢だ。チャットウィジェットのようなレイテンシに厳しい用途は避けた方がよい。
4. DeepSeek V4.1 Flash
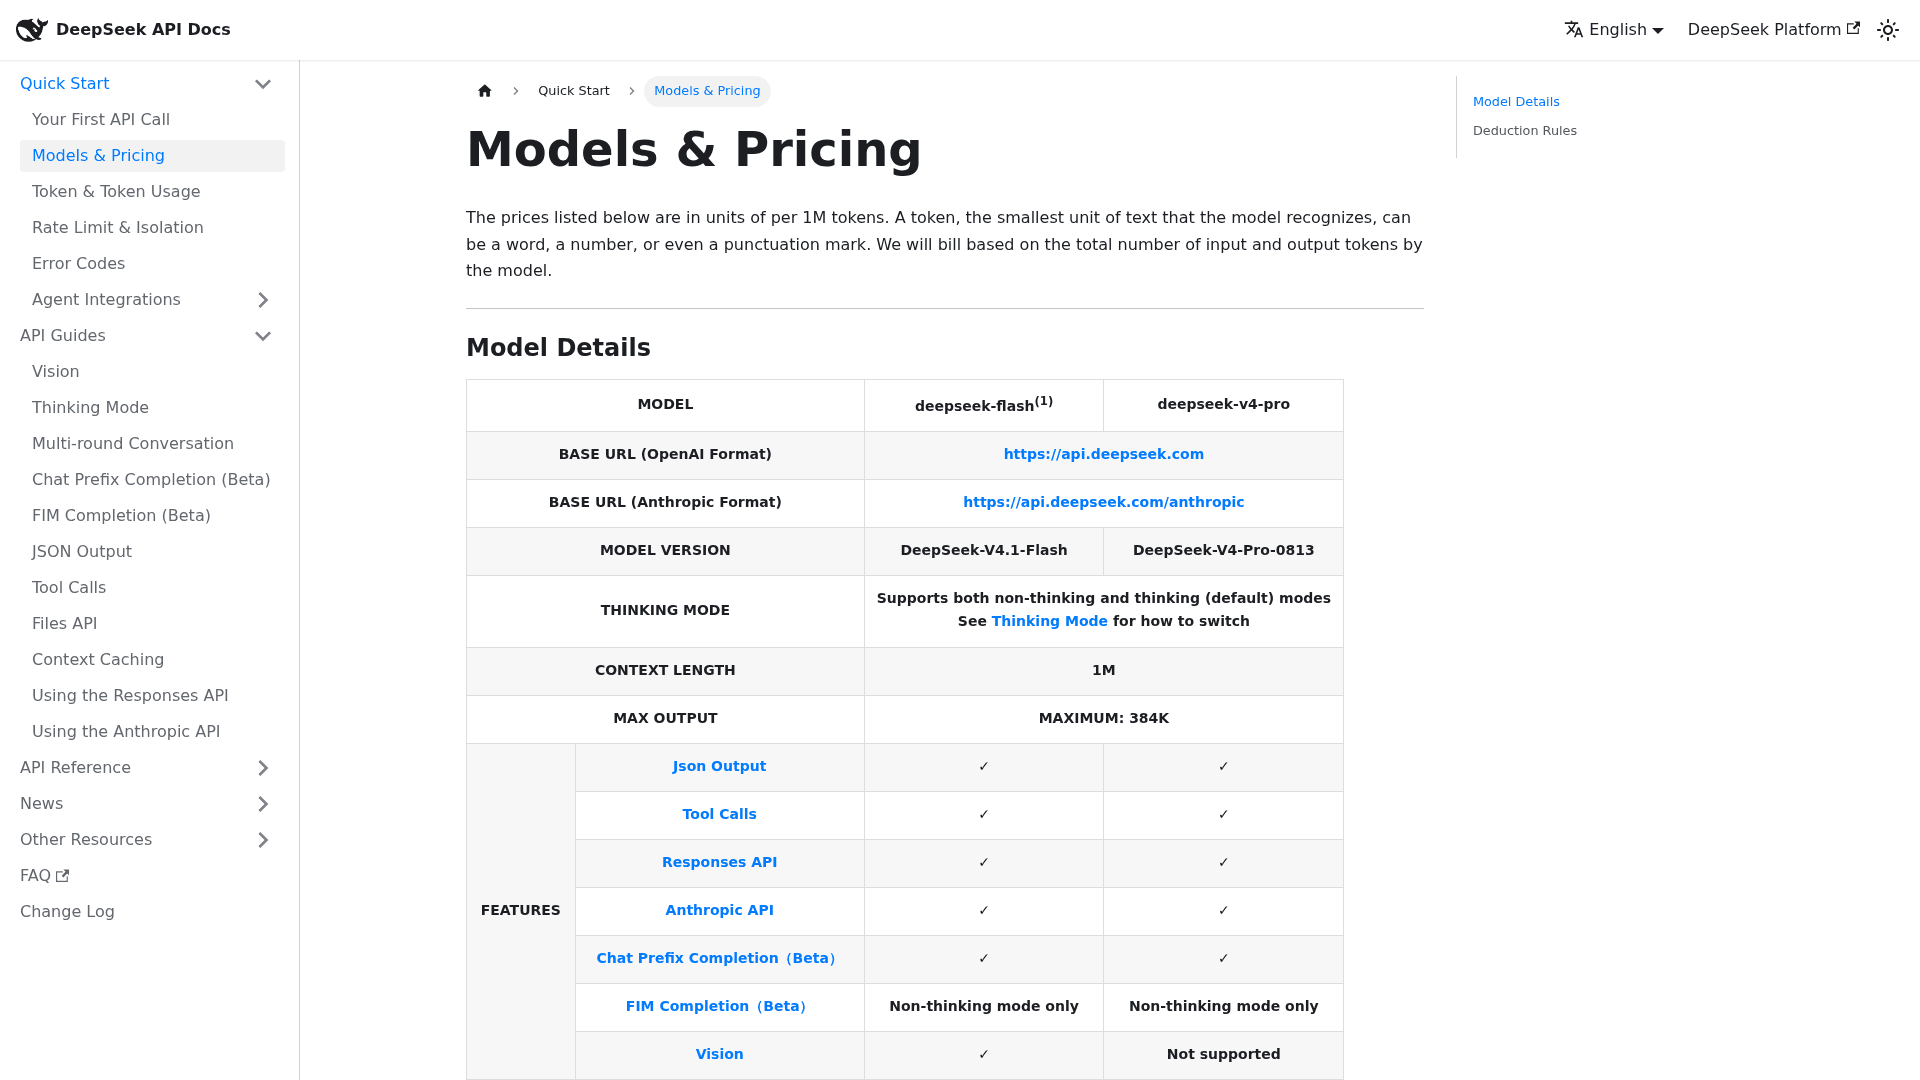
DeepSeek V4.1 Flashは、Grokに対する低価格かつオープンな回答だ。MITライセンスの下で配布されているため、ウェイトをダウンロードして自分で実行でき、ホスト版の料金はここに挙がった信頼できるモデルの中で最安だ。
注目点。 価格だ。オフピーク時は100万あたり入力約0.22ドル、出力0.66ドルで、Grok 4.7のほんの一部だ。MITのオープンウェイトは自己ホストすればトークン単位の請求が一切ないことを意味し、384kの最大出力を持つ100万トークンのコンテキストウィンドウも維持している。
長所。 ホスト版でも自己ホストでも信頼できる選択肢の中で最安。この能力レベルでは珍しく、本当にオープンなライセンス。Anthropic形式とOpenAI形式の両方のAPIエンドポイント。
短所。 安い設定と良い設定は同じウェイトの異なる実行であり、独立系の評価では最大負荷時で約50、推論なしで29とされ、推論トークンは出力料金で課金される。テキストのみで、文書化された画像入力はない。オフピーク料金は中国のビジネスアワー中はおおむね倍になる。ホスト版APIの利用規約はトレーニング利用について明言しておらず、データは中国本土に置かれるため、規制対象の顧客データにそのまま使えるわけではない。
料金。 オフピーク時で約0.22ドル/0.66ドル、ピーク時(UTCで1:00〜4:00および6:00〜10:00)は倍になる。Proはその上の段階だ。
私の見解。 純粋なコストでは明確な勝者、特に自己ホストの場合。何か機密性の高いものを送る前に、データの保管地域に関する細則を読んでほしい。
5. Kimi K3
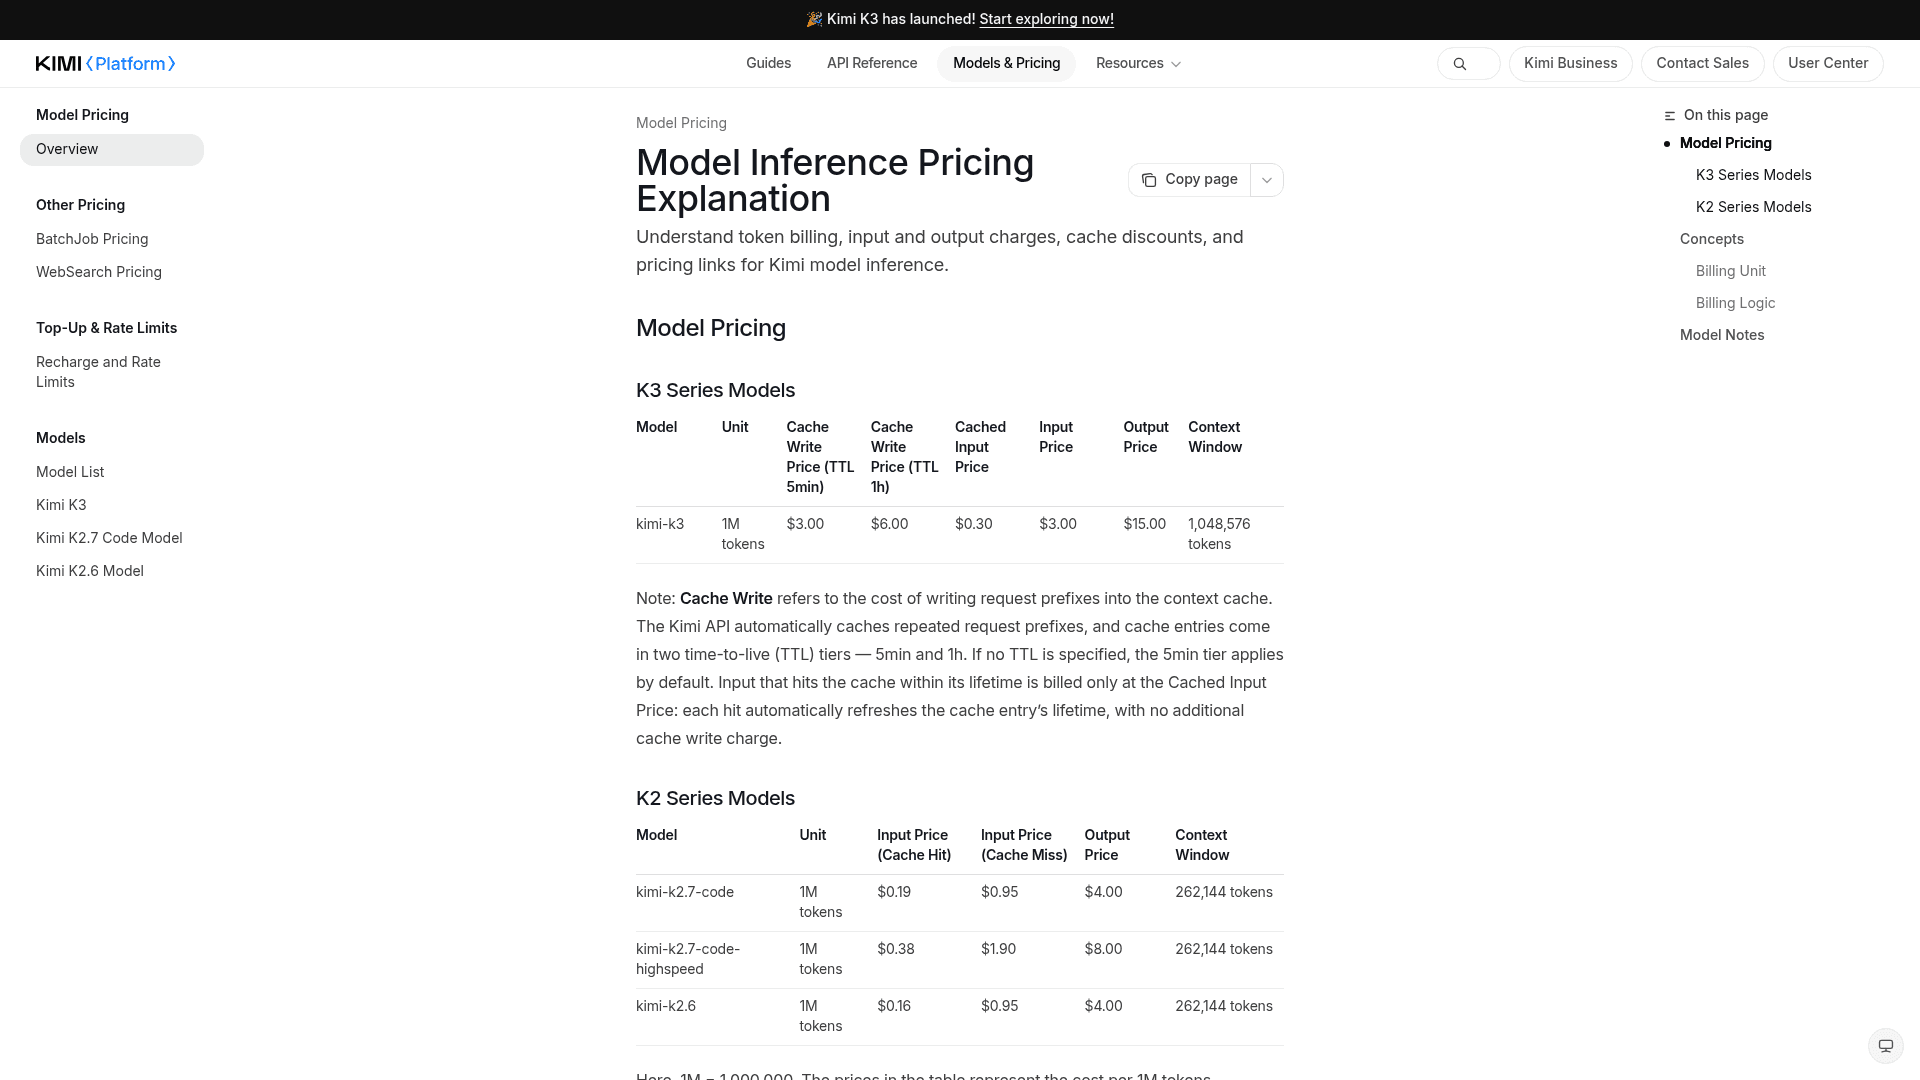
MoonshotのKimi K3は、独立系ベンチマークで最高スコアを出すオープンウェイトモデルだ。2.8兆パラメータのMixture-of-Expertsモデルで、104Bがアクティブであり、Moonshotは予定通りウェイトをHugging Faceに公開した。
注目点。 Artificial Analysisの知能指数で約57を記録し、ほとんどのオープンモデルを上回り、クローズドなフロンティアにのみ後れを取る。ネイティブな画像理解、100万トークンのコンテキスト、そして本当にオープンなウェイト公開により、ここに挙がった中で実際にホストできる最も高性能なモデルとなっている。
長所。 この特集で最も強力なオープンウェイトの知能。設定可能な推論負荷を持つ本物の100万コンテキスト。ウェイトは公開されており、コミュニティによる量子化もすでに利用可能だ。
短所。 ホスト版APIは安くない。3ドル/15ドルはClaude Sonnetの価格帯に位置し、経済的な層ではない。推論はオフにできず、速度を上げることしかできないため、超低コストモードは存在しない。そして公開画像URLは受け付けず、base64かファイルIDを渡す必要がある。
料金。 入力3ドル、出力15ドル、キャッシュ0.30ドルで、コンテキストは1,048,576トークンだ。
私の見解。 フロンティアに近い品質とオープンウェイトの両方が欲しく、より高いホスト料金を許容できるか自分で実行できる場合の選択肢だ。
6. Qwen 3.8 Max
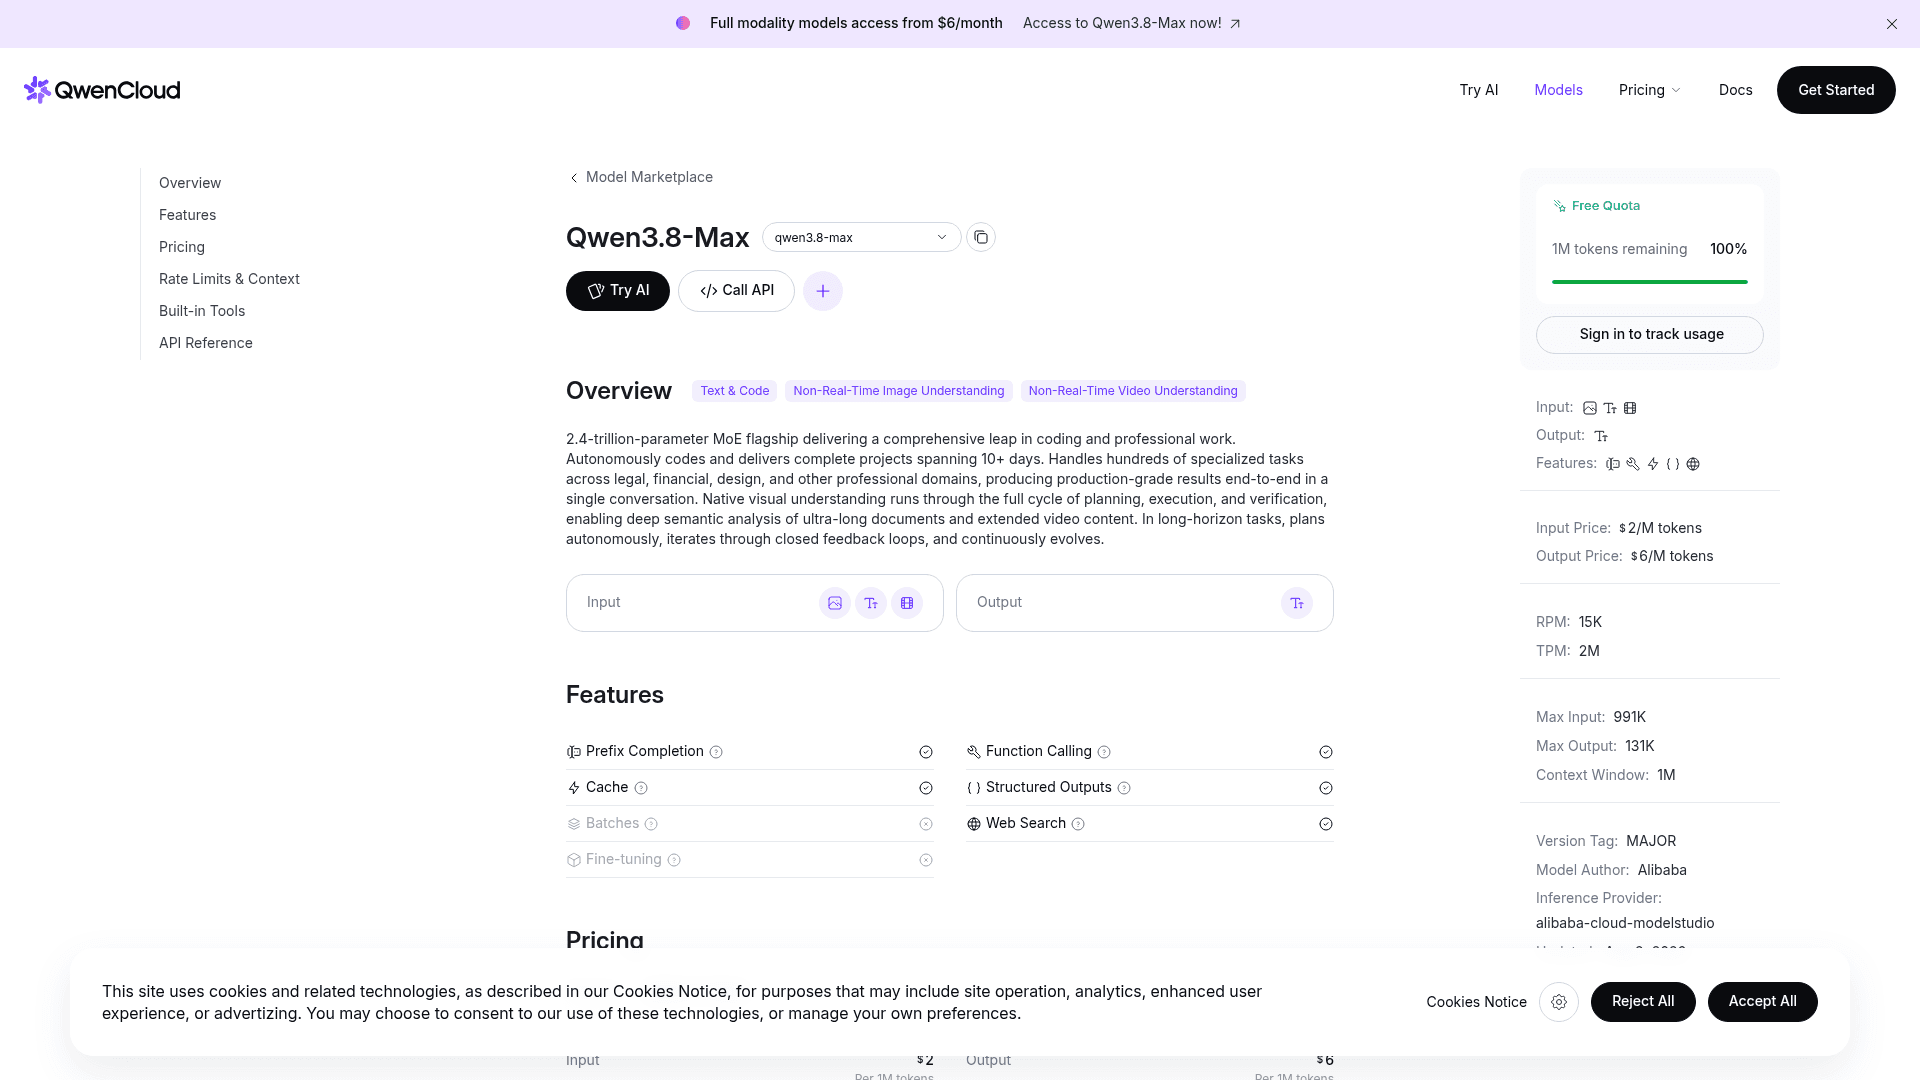
AlibabaのQwen 3.8 Maxは最も直接的な価格の一致だ。Grok 4.7とまったく同じ2ドル/6ドルを課金しながら、より大きな均一コンテキストウィンドウを持ち、下にはオープンなベースモデルがある。
注目点。 Grokと同じ料金で、20万の崖がなく、独立系ランキングでも高評価(Artificial Analysisで概ね6位、指数は約58)だ。2.4兆パラメータのMoEで、ネイティブな画像・動画理解と組み込みツールを備え、Alibabaはオープンなベースモデルも公開している。
長所。 1Mコンテキストウィンドウ全体で均一課金しながらGrokの価格に一致する。ネイティブなマルチモーダル入力。スタックの一部を自己ホストしたいチーム向けのオープンなベース。
短所。 オープンなベースはホスト版Maxと機能的に同等ではない。画像理解、非思考モード、組み込みツールはホスト版限定だ。独自の付属コーディングハーネスが出力を131kの上限よりはるかに低く制限しているため、公表されている出力上限はほとんどのユーザーにとって理論上のものにとどまる。そして大型のオープンチェックポイントのライセンスはApacheではなく独自のQwenライセンスだ。
料金。 100万あたり2ドル/6ドル、暗黙のキャッシュ読み取りは約0.25ドルで、コンテキストは1M、最大出力は131kだ。
私の見解。 Grokの価格が気に入っているが、均一な長コンテキスト課金とマルチモーダルの選択肢が欲しいなら、Qwenがこのリストの中で最も近い乗り換え先だ。
7. eesel: モデルではなくチームメイトが欲しいとき

ここからが正直な話だ。上に挙げたすべてのモデルはエンジンにすぎない。単体でサポートチケットを解決したり、ヘルプセンター向けの返信を書いたり、公開できるブログ記事を書いたりするものはひとつもない。あなたが買うのは仕事をこなすモデルではなく、仕事をこなすものを作るためのモデルだ。そしてこの2番目のステップこそが、実際のコストとリスクの大半が存在する場所だ。
私たちの顧客の一人であるGENERAL BYTESのKarelは、自作か購入かの判断を率直に語ってくれた。
「独自のLLMアプリケーションを書こうとすることもできましたが、そこに時間を投資したくありませんでした。私たちが保守する必要のないものが欲しかったのです。」
── Karel、GENERAL BYTES
これがeeselが埋めるギャップだ。eeselはAIチームメイトのプラットフォームであり、トークンを借りて残りを自分で組み立てる代わりに、定義された仕事のためにすぐ働けるチームメイトを雇うことになる。現在のラインナップはAIヘルプデスクチームメイトとAIブログライターだ。それぞれがその役割に必要な統合、スキル、社内コンテキストにすでに接続された状態で届き、内部ではこの特集で取り上げたようなフロンティアモデルが動いている。
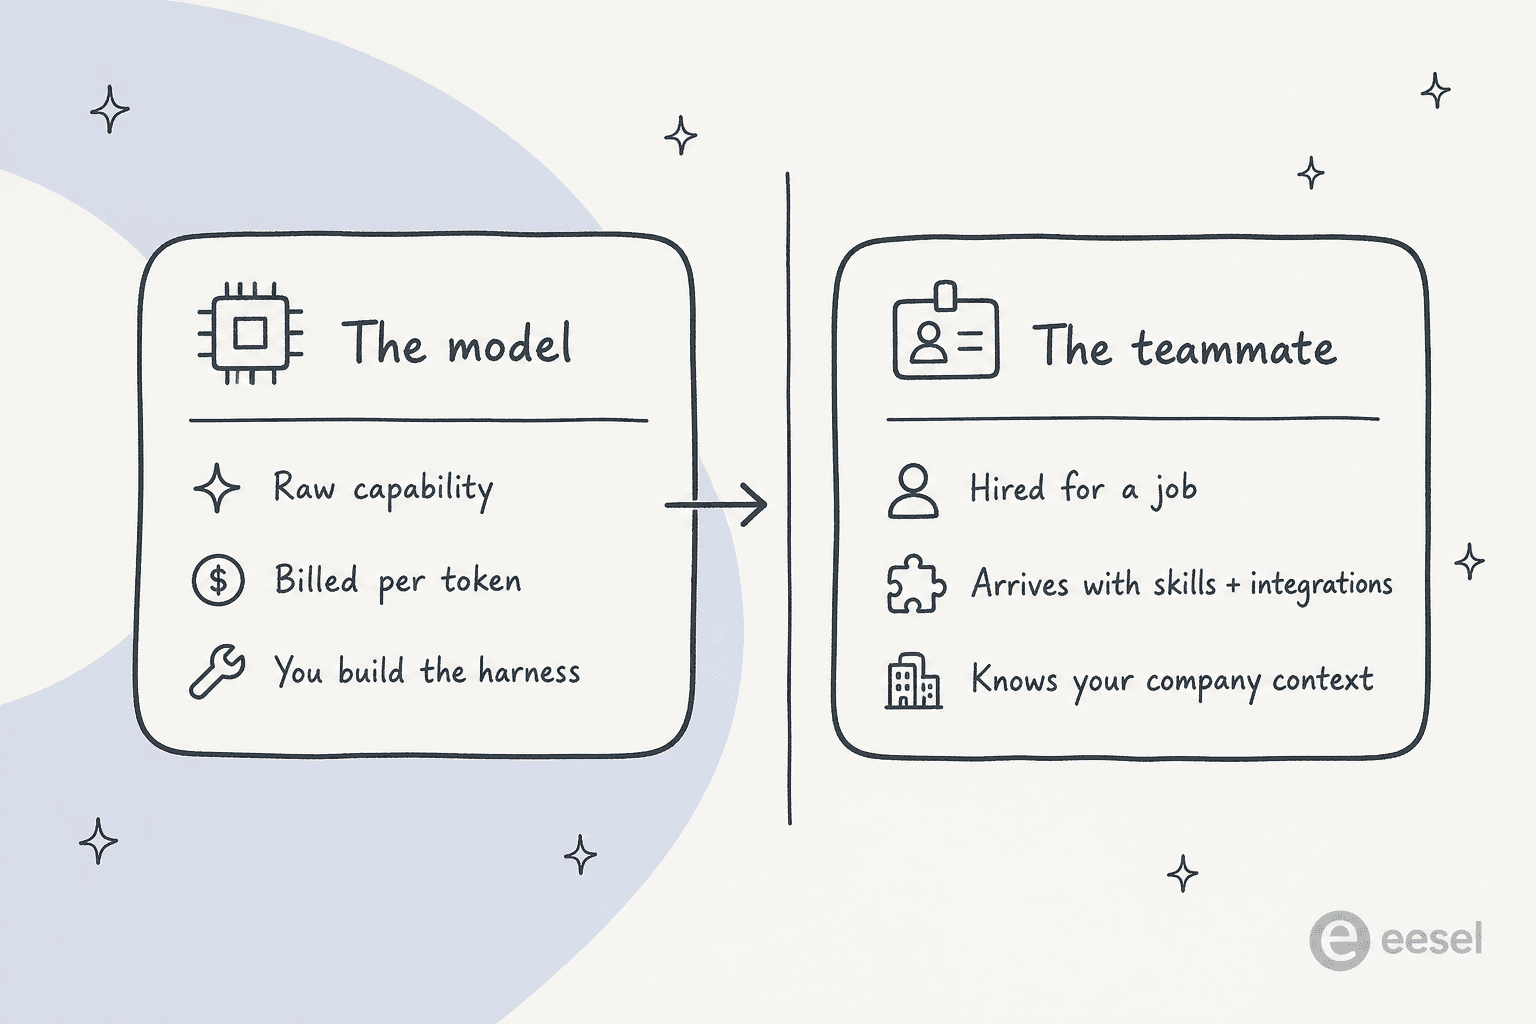
コマンドラインが好きなエンジニア向けに、そのチームメイトはスクリプト化できる。eesel CLIを使えば、同じチームメイトとワークスペースをターミナルから操作したり、スクリプトに組み込んだり、Claude Code、Codex、Cursorのようなコーディングエージェントから操作したりできる。人々をxAIのAPIへと向かわせる「モデルへのプログラム的なアクセスが欲しい」という発想は、一段上のレベルで満たされることになる。あなたが得るのは、すでにあなたの文脈を持つチームメイトへのプログラム的なアクセスであり、その上に製品を組み立てる必要のある裸の補完エンドポイントではない。
私が最も大切にしている部分は、長年このインフラを構築してきた経験から言うと、実際の顧客に触れる前に、自社の過去のチケットに対してロールアウトをシミュレートできることだ。ベンチマークのスコアは、あるモデルが自社のデータに対して自信満々に誤った答えを出すかどうかを教えてくれない。実際の過去のチケットに対するシミュレーションはそれを教えてくれる。それがモデルを選ぶことと、それを実際に導入することの違いだ。
どのGrok 4.7代替を選ぶべきか
自分にとって最も重要な優先事項を選び、おすすめを読んでみてほしい。
結論
Grok 4.7は価格性能比で打ち負かすのが難しく、勝つ代替とはあなたの実際の優先事項に合ったものだ。知能ならClaude、コストならDeepSeekかGemini、オープンウェイトならKimi K3かQwen、エコシステムならGPT-6 Solだ。Grok 4.5世代の中で選んでいるなら、Grok 4.6の記事が旧世代を扱っている。
しかし本当に必要なのがチケットの解決やコンテンツの制作といった仕事の完了であれば、これらのどれも単体では答えにならない。それがエンジンを借りることとチームメイトを雇うことの違いだ。
モデルを比較するのは簡単な部分にすぎない
この特集のすべてのモデルは、トークン単位で知能を売っている。難しいのは、それを自社のデータで実際の仕事を確実にこなすものへと変えることだ。eeselはフロンティアモデルを、あなたのヘルプデスクとドキュメントをすでに理解しているAIチームメイトへとパッケージ化し、本番投入前に自社の過去のチケットでシミュレートできるようにするので、顧客とのやり取りをベンチマークのスコアに賭けずに済む。
eeselを無料で試すか、デモを予約して自社データでの動作を確認してほしい。

よくある質問
Grok 4.7の最良の代替は何ですか?
何を重視するかによります。知能の高さを最優先するなら、ClaudeのFable 5.1がほとんどのボードで首位に立ちます。より安価なクローズドモデルで巨大なエコシステムが欲しいなら、GPT-6 Solが無難な選択です。自前でホストできるオープンウェイトのモデルを求めるなら、DeepSeek V4.1 Flashが信頼できるGrok 4.7代替の中で最安です。Qwen 3.8 MaxはGrokの2ドル/6ドルという料金に正確に一致します。
Grok 4.7より安い代替はありますか?
はい。Grok 4.7は入力100万トークンあたり2ドル、出力6ドルですが、DeepSeek V4.1 Flashはオフピーク時で約0.22ドル/0.66ドルで動作し、オープンウェイトです。Gemini 3.8 Flashは2026年末まで0.75ドル/3.75ドルを提示しています。どちらもGrok 4.7より大幅に安く、知能面、そしてDeepSeekの場合はデータの保管地域の面で通常のトレードオフがあります。
Grok 4.7の最良のオープンウェイト代替は何ですか?
Grok 4.7はクローズドです。自前でホストできるオープンウェイトが必要な場合、最も有力な選択肢はKimi K3(2.8兆パラメータ、MoE)、Qwen 3.8 Maxのオープンなベースモデル、そしてMITライセンスのDeepSeek V4.1 Flashです。運用コストが最も低いのはDeepSeekで、独立系ベンチマークで3つの中で最高スコアを出すのはKimi K3です。
Grok 4.7とClaude、どちらが優れていますか?
純粋な知能ではClaudeが勝ります。Fable 5.1はCursorBench、Terminal-Bench、AA Briefcaseリーダーボードでいずれも Grok 4.7を上回ります。しかしGrok 4.7の価格はFable 5.1のおよそ5分の1なので、本当の論点は最後のわずかな性能差にお金を払う価値があるかどうかです。詳細な直接比較はGrok 4.7レビューで扱っています。
Grok 4.7は代替と比べてどのくらいの費用がかかりますか?
Grok 4.7は20万トークン未満で100万トークンあたり2ドル/6ドルで、これはQwen 3.8 Maxと正確に同じです。GPT-6 Solは2ドル/10ドル、Claude Opus 5.5は4ドル/20ドル、Fable 5.1は10ドル/50ドルです。安価な側にはDeepSeekとGemini Flashが位置します。詳しい数字はGrok 4.7の料金ガイドとxAIの料金の概要にまとまっています。
Grok 4.7の代替の中に20万トークンの価格の崖を避けられるものはありますか?
あります。Grok 4.7はリクエストが20万プロンプトトークンを超えると料金が倍になり、GPT-6 Solも同様です。ClaudeとGeminiはコンテキストウィンドウ全体を通じて単一の均一料金を課すため、長文ドキュメントや大規模コードベースの作業では表示価格が示唆するより結果的に安くなることがあります。
カスタマーサポート向けのGrok 4.7の最良の代替は何ですか?
これらのモデルはいずれも単体ではサポートツールではなく、あくまでエンジンです。仕事がチケット対応であれば、eeselのようなカスタマーサービス向けAIプラットフォームがフロンティアモデルをあなたのヘルプデスク、ナレッジベース、サポート自動化のワークフローと組み合わせるので、トークンを借りるのではなくチームメイトを雇うことになります。


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.