Grok 4.7とは実際何なのか
Grok 4.7は、コーディング、エージェント型タスク、ナレッジワーク向けのxAIのフロンティアモデルだ。APIではgrok-4.7として提供され、500kのコンテキストウィンドウ、テキストと画像の入力、出力上限のないテキストのみの出力を備えている。詳細はxAIのリリースノートを参照。推論の労力はlow、medium、high(デフォルト)、xhighの間で設定可能なので、リクエストごとにモデルがどれだけ深く考えるかを調整できる。
内部的には、xAIはGrok 4.7がGrok 4.6よりも新しく大きなベースモデルを使っていると述べている。ここは正確に伝えておきたい。多くの報道が正確なパラメータ数を挙げていたが、xAI自身の資料は数字を公表せずに「より大きなベースモデル」とだけ説明しており、出回っている具体的な数字は同社が実際に発表したものではない。xAIが実際に主張しているのは変化の形であり、その形こそが興味深い部分だ。
トレーニングは、完了までに何時間もかかる難しい問題に重点を置いた上で、より長い強化学習で強化された。xAIはまた、モデルがGrok Botのハーネス、つまりモデルがチャットし、ツールを呼び出し、タスクを進めていくための足場をネイティブに理解するよう訓練した。平たく言えば、単一の質問にうまく答えることへの最適化を減らし、話の筋を見失わずに長く複数ステップにわたる仕事をやり遂げることへの最適化を増やしたということだ。
Grok 4.6から何が変わったのか
その飛躍を見る一番わかりやすい方法は、xAIが公開したベンチマークで両モデルを並べてみることだ。伸びは一様ではなく、どこに集中しているかがこのリリースの本当の狙いを物語っている。
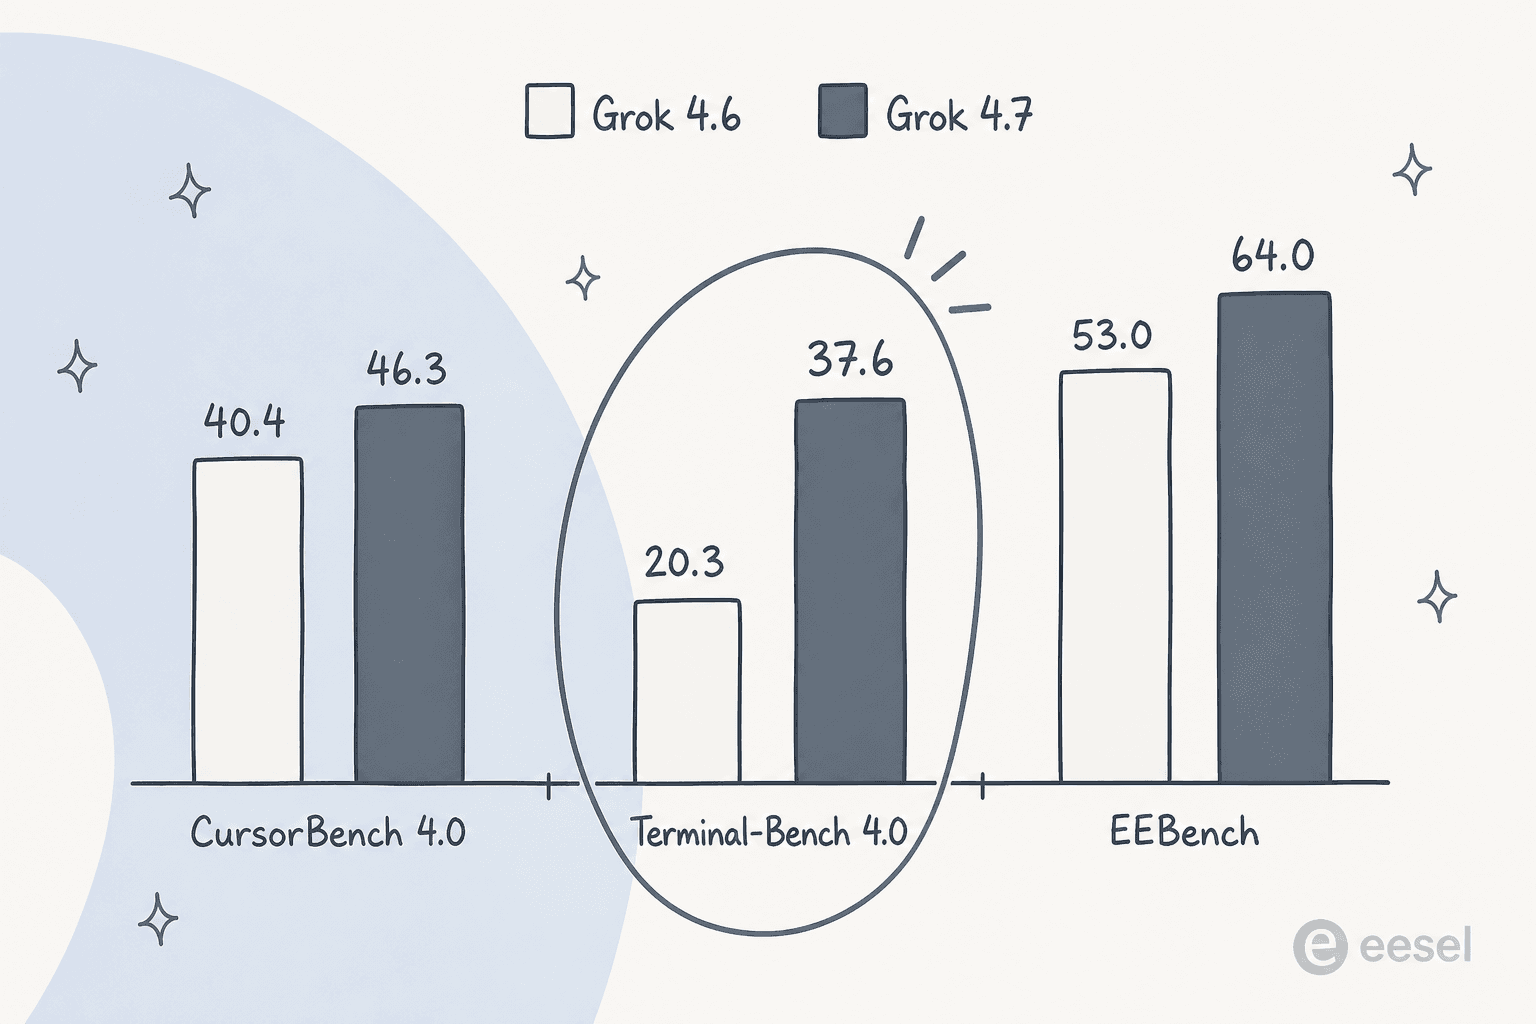
最大の動きはTerminal-Bench 4.0で見られる。これは実際のターミナル上での数時間にわたる作業を測るベンチマークで、Grok 4.6は20.3%だったのに対し、Grok 4.7はほぼ2倍の37.6%まで伸ばしている。これはまさに、より長いRLの実行が狙っていた長時間タスクの種類であり、このリリースが真価を発揮する場所だ。コーディングとエンジニアリングも同じ流れをたどっており、CursorBench 4.0は40.4%から46.3%へ、EEBench(電気工学)は53.0%から64.0%へと跳ね上がっている。
以下により詳しい表を示す。数字に文脈を持たせるため、GPT-5.6 SolとFable 5.1も併記した。Grok 4.7の数値はすべてxHigh、Grok 4.6はHighでの結果だ。
| ベンチマーク | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| 入力価格 / 100万 | $2 | $2 | $4 | $10 |
| 出力価格 / 100万 | $6 | $6 | $20 | $50 |
| CursorBench 4.0(コーディング) | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%* | 65.2% | 72.7% | 70.0% |
| Terminal-Bench 4.0 | 37.6% | 20.3% | 37.3% | 57.9% |
| EEBench(電気工学) | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1(Elo) | 1,657 | 1,546 | 1,487 | 1,678 |
| Harvey Legal Agent | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
*Grok 4.7のDeepSWEスコアはhighの労力で測定されている。数値はxAIのGrok 4.7発表より。
これを完全な圧勝と読む前に、正直な留保点を二つ挙げておく。Fable 5.1は依然としてCursorBench、Terminal-Bench、臨床推論で表の首位に立っており、最高スコアだけを気にしてコストを問わないなら、こちらが優位だ。またHealthBench Professionalでは、GPT-5.6 Sol(60.5%)とFable 5.1(62.1%)のどちらもGrok 4.7の56.7%を上回っている。Grok 4.7の物語は「すべてにおいて最高」ではない。「価格のごく一部で最高にかなり近い」ということだ。
Grok 4.7の料金と、Fastの割増分
料金こそこのモデルが面白くなるところなので、「〜から」という数字を振りかざすだけでなく、きちんと書き出しておく価値がある。
| ティア | 入力 / 100万 | キャッシュ入力 / 100万 | 出力 / 100万 |
|---|---|---|---|
grok-4.7、プロンプトが20万トークン未満 | $2.00 | $0.50 | $6.00 |
grok-4.7、プロンプトが20万トークン以上 | $4.00 | $1.00 | $12.00 |
| Grok 4.7 Fast(CursorとGrok Buildのみ) | 上記料金の2倍 | 2倍 | 2倍 |
最初の落とし穴は長文コンテキストのティアだ。リクエストが20万トークンを超えると、より高い料金がリクエスト全体のすべてのトークンに適用され、20万を超えた分だけに適用されるわけではない。つまり21万トークンのプロンプトは、大部分が2ドル/6ドルではなく、全体が4ドル/12ドルで課金される。ゆっくりとコンテキストを積み上げていく長いエージェントループにとって、この崖は現実の問題であり、それこそxAIが会話を膨らみすぎる前に縮小するコンテキスト圧縮APIを出した理由だ。
二つ目はFastバリアントだ。Grok 4.7 Fastは同じモデルを出力速度2倍で提供するもので、トークン価格も2倍になり、パブリックAPIではなくCursorとGrok Build内でのみ利用できる。これはレイテンシとお金のトレードオフであり、コードがリアルタイムで流れてくるのを見ているときのように1秒が重要な場面では価値があり、速度が問題にならないバッチ処理やバックグラウンド作業ではスキップしてもよい。
そのほかにも、ほとんどの記事が見落としているメーターがある。APIでは、xAIの料金ページがツール呼び出しを個別に記載しており、ウェブ検索、X検索、コード実行は1,000回あたり5ドル、ファイル添付検索は1,000回あたり10ドル、RAG方式のコレクション検索は1,000回あたり2.50ドルとなっている。Priority Processingはすべてのトークン料金を2倍にする。これらのどれも予算を破綻させるほどではないが、常に検索と実行を行うエージェントのコストをモデリングしているなら、トークン価格だけが請求額のすべてではない。
要点はこうだ。Grok 4.7は大量に運用されることを前提に価格設定されている。これは意図的なポジショニングであり、ループする作業に対して、より高価なフロンティアモデルよりもこちらを選ぶ最も明確な理由になっている。
Grok 4.7はGPT-5.6 SolやFable 5.1と比べてどこに位置するか
性能とコストをプロットすると、Grok 4.7は混雑しつつも依然として価値のある一角、つまりスコアは高く価格は低いという位置に収まる。
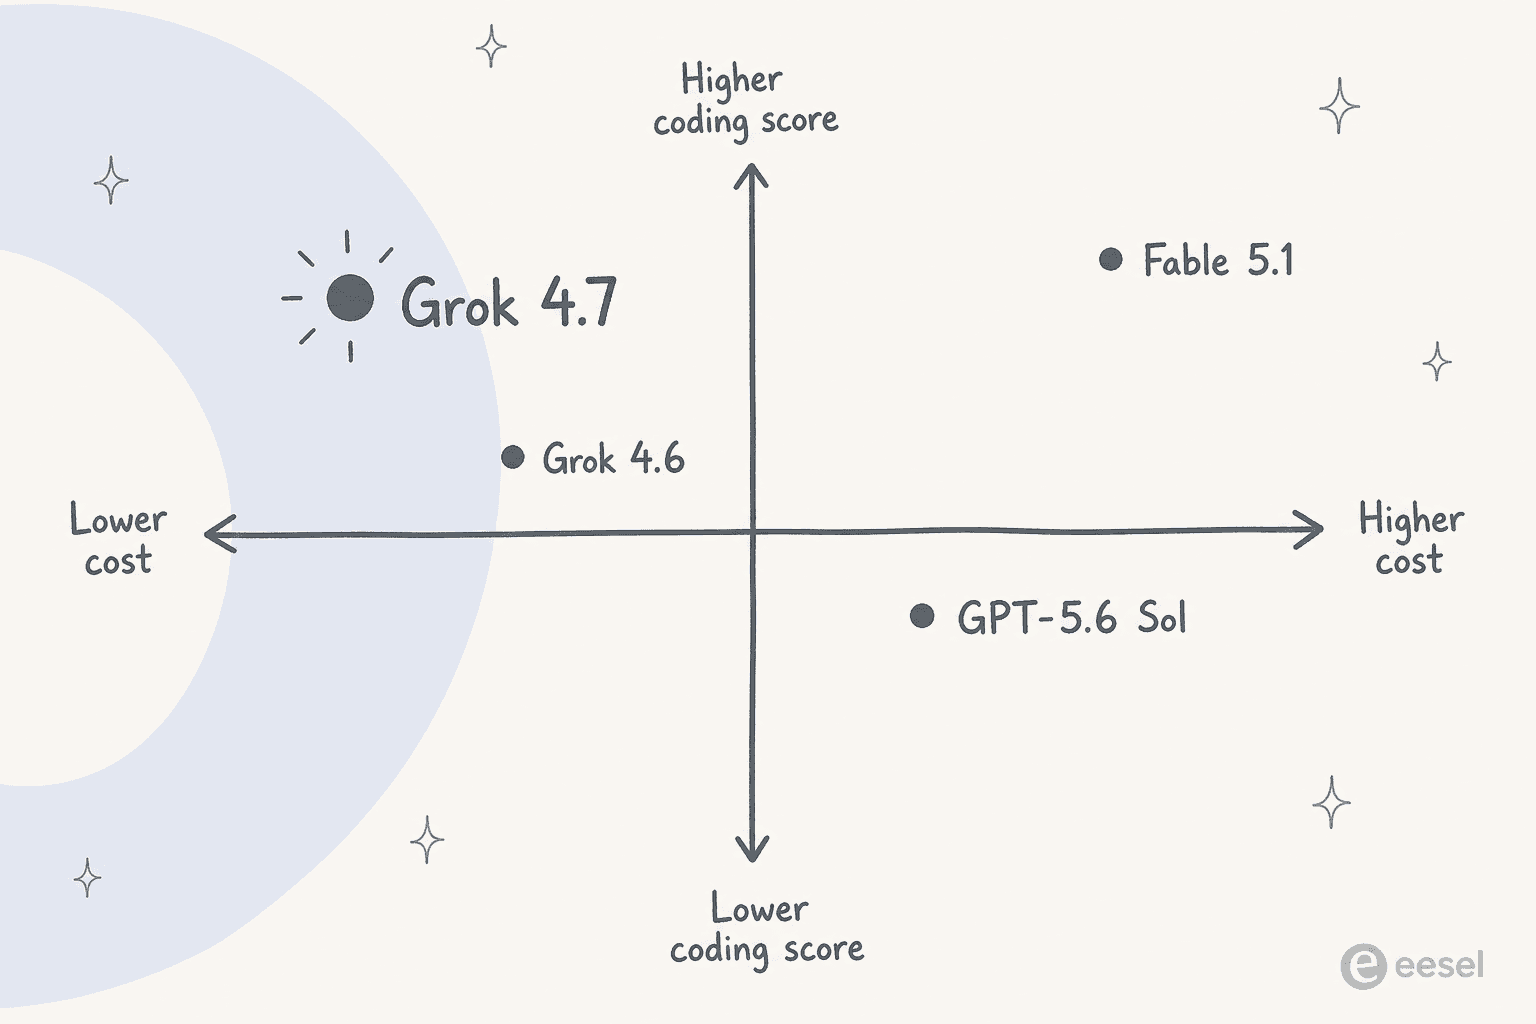
GPT-5.6 Solと比べると、Grok 4.7はほとんどのエージェント型作業とエンジニアリング作業でより良い取引となる。CursorBench、EEBench、Terminal-Bench、Harveyの法務ベンチマーク、AA BriefcaseでSolを上回りながら、入力価格は半分、出力価格は3分の1未満だ。Solは臨床推論で確かな優位を保ち、DeepSWEでもわずかにリードしているため完全な圧勝ではないが、この価格差がGrok 4.7をコストに敏感なエージェント作業のデフォルトの選択肢にしている。
Fable 5.1と比べると、正直な見立てでは、Fableは依然として純粋なコーディングと長時間のターミナル作業でより強いモデルであり、専門知識に関するGDPvalのElo評価は1,735でGrok 4.7の1,695を上回る。しかしFableは100万トークンあたり10ドル/50ドルを課金しており、これはGrokの料金の5〜8倍にあたる。したがって問いは「どちらが賢いか」(多くの場合Fable)ではなく、「限界の1ポイントにいくら払う気があるか」になる。多くの本番ワークロードにとって、Grok 4.7は請求額を正気に保ってくれる答えだ。
安全性とサイバーセキュリティ
xAIは今回のサイクルで安全性に本気の重みを置いており、それはこのリリースの中でも特に具体的な部分の一つだ。Grok 4.7はまったく新しいセーフガードスタックとともに構築されており、xAIは拒否とジェイルブレイク耐性に関して同社がテストした中で最も強いモデルだと述べている。
その主張を検証可能にしているのが具体的な数値だ。危険なサイバータスクを対象とするxAIのベンチマークHackerBench v0.3では、Grok 4.7が通過させる危険なデュアルユースプロンプトはわずか3.3%にとどまる一方、xAIによれば正当なセキュリティ作業をブロックすることはめったにないという。またLatchBioのバイオセーフティ・ベンチマークでも62.4%で首位に立っている。狙いは、同じタスクの危険なバージョンに対する手軽な道具になることなく、実際のセキュリティ・研究業務に有用であり続けるモデルであり、xAIは防衛研究のために選ばれたサイバーセキュリティパートナーに対し、モデルのレッドチーム機能への招待制アクセスを提供し始めている。ベンチマークはベンダー自身のものなので出発点として捉えるべきだが、方向性は明らかだ。
Grok 4.7は実際に誰向けなのか
数字と向き合った上で、私はここに落ち着く。コードを書いたり、エージェントを構築したり、トークンコストが積み重なるAPI上で何かを出荷したりするなら、Grok 4.7は有力な選択肢だ。フロンティアに近いスコアとGrok 4.6の価格の組み合わせこそ、注目すべき唯一の理由であり、長時間タスクでの伸びは、しばらく動き続ける仕事において4.6より持ちこたえることを意味する。
実際のユーザーも「常時稼働させる」という視点を裏づけている。あるヘビーなGrok購読者は、日常業務に組み込んでも上限に近づくことすらないと語っている。
「Grokボットに15分ごとにメールを監視させて、私の代わりにファイリングしてもらっている。もう一つのボットは血液検査の結果を監視していて……それでも自分のクォータを使い切ることには全く近づかない。」

期待値を調整すべきだと思うのは、深く込み入ったコードの領域だ。フロンティアモデルはどれもスクリプトを一発で書き上げる能力を伸ばしており、それは確かに本物だが、大規模なコードベースを維持していくのとは別の話だ。同じスレッドである開発者はこう述べている。
「モデルはワンショットでの精度をどんどん上げている。それは、ちょっとした使い捨てスクリプトのような多くの場面では役に立つ……でも、コード本体の作業そのものには、あまり役に立たない。」
これはこのクラスのどのモデルにも当てはまる公正な見方であり、Grok 4.7も例外ではない。価格が優位に立つ中程度の難易度の作業の量をこなすためにこれを使い、本当に最後の数ポイントが必要なタスクにだけ、最も高価なモデルを取っておくといい。
フロンティアモデルはエンジンであって、従業員ではない
ここでTL;DRで約束したリフレームを示す。というのも、「どのモデルを使うべきか」というほとんどの記事が省いてしまう部分だからだ。
Grok 4.7はインフラだ。トークン単位で借りる優れたエンジンであり、あなたの会社、チケット、トーン、ツールについて何も知らない状態でやってくる。それを実際の仕事をこなす何かに変えるには、誰かがハーネスを構築しなければならない。ナレッジを接続し、統合を配線し、ガードレールを書き、エスカレーションを処理し、すべてを動かし続ける必要がある。それは設定のトグル一つではなく、本物のプロジェクトだ。
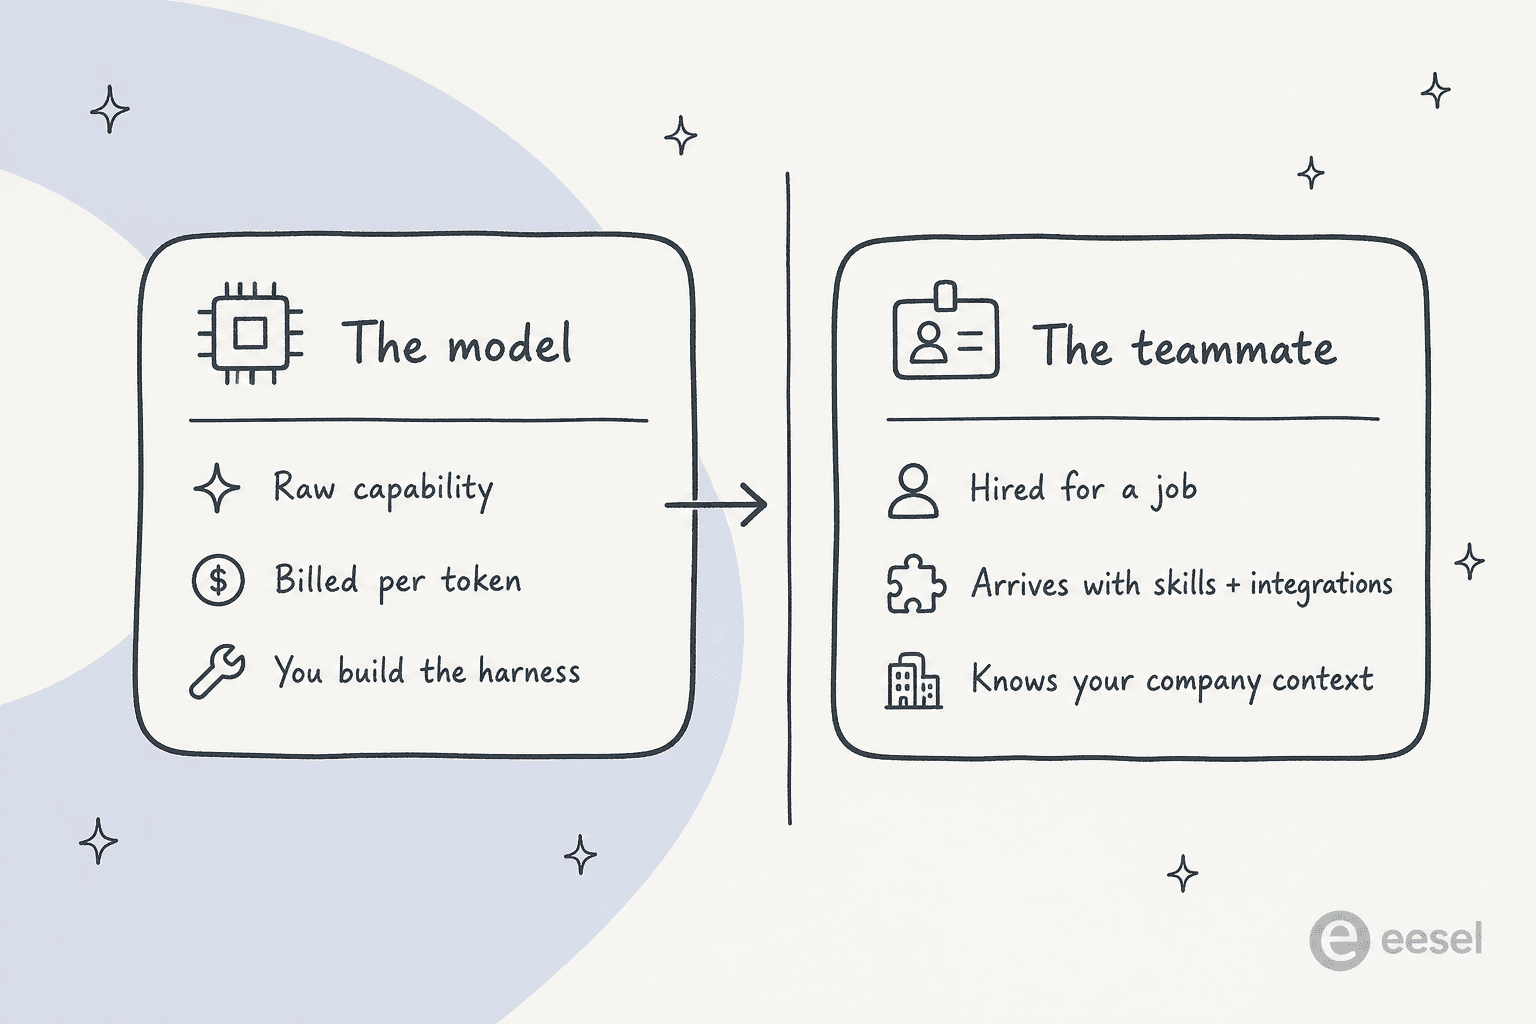
そのギャップこそeeselの発想全体だ。モデルと空のハーネスを渡す代わりに、eeselはすぐに働けるチームメイトを特定の仕事のために雇えるAIチームメイトプラットフォームだ。現在のラインナップは、サポートキューに参加するAIヘルプデスクチームメイトと、長文記事を調査・執筆するAIブログライターだ。それぞれがすでにその役割に必要なスキル、統合、会社のコンテキストを備えた状態で登場し、裏側ではフロンティアモデル上で動作しているため、配管部分を自分で所有することなく能力だけを手に入れられる。
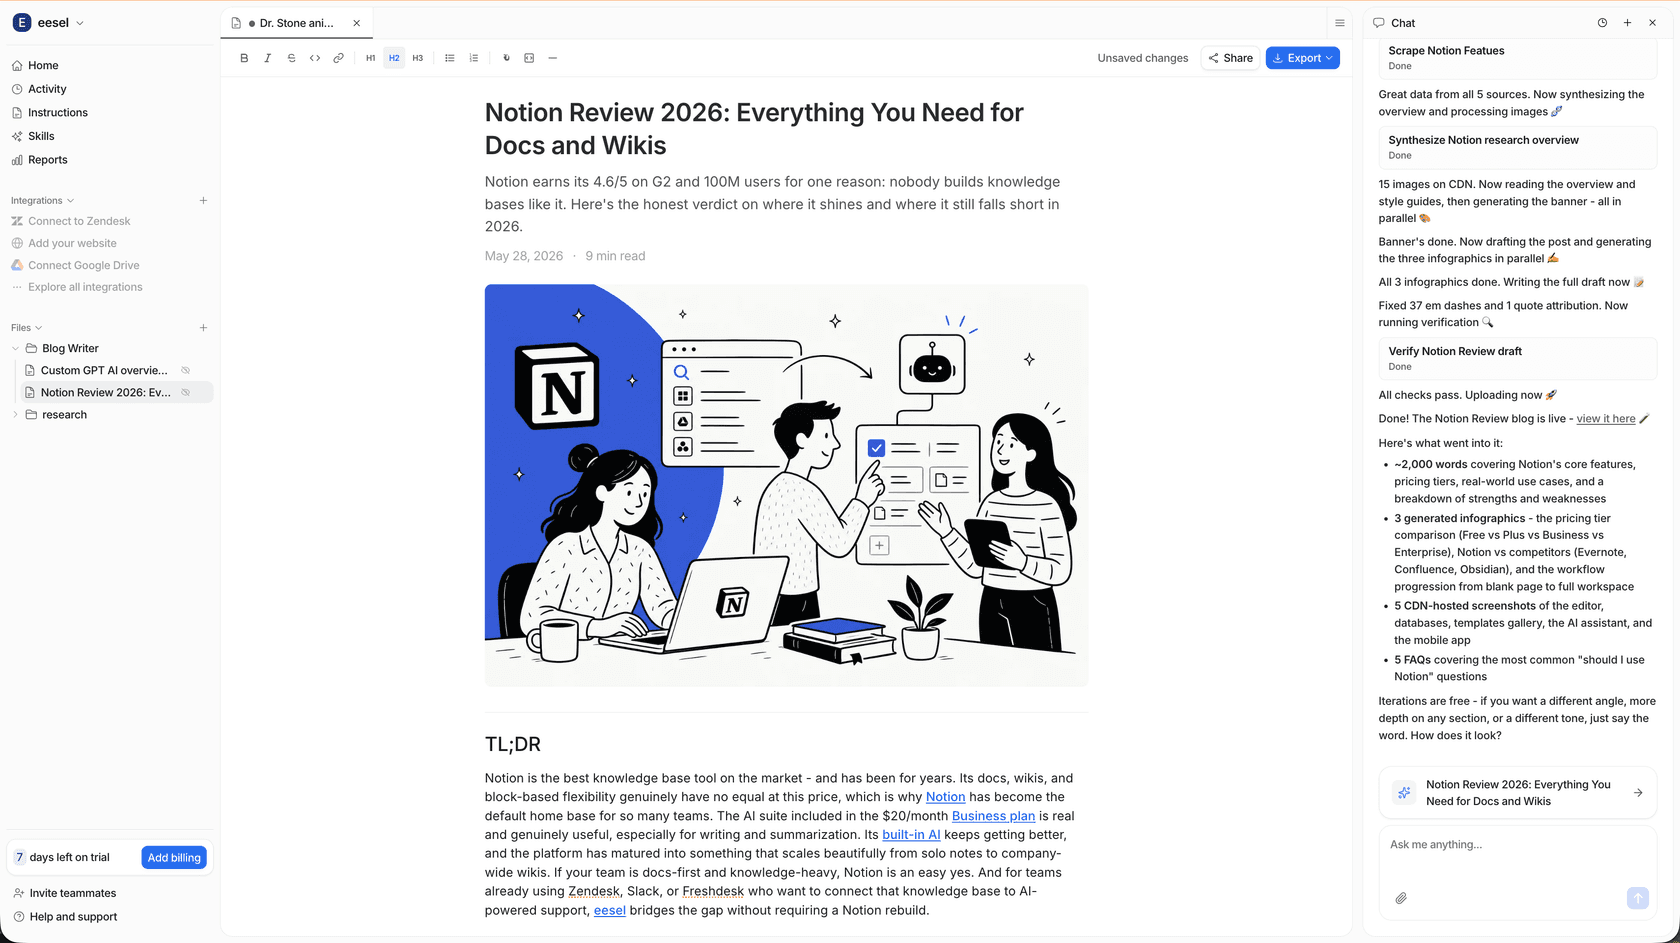
そして、ターミナルに生きているからこそGrok 4.7が気に入ったという人には、eeselもそこで出会える。eesel CLIは、ダッシュボードと同じチームメイトとワークスペースをコマンドラインから操作できるものだ。人が直接実行することもできれば、スクリプトが自動化することもでき、Claude Code、Codex、Cursorのようなコーディングエージェントがそれをドライブすることもできる。チームメイトの指示内容を確認したり、テストメッセージを送ったり、JSON形式の結果とアクティビティを読み戻したり、オーナーが承認するための限定的な変更を提案したりでき、それらすべてをシェルから離れずに行える。これは生のモデルAPIを魅力的にしているのと同じ「エージェントをプログラムから操作する」パターンを、すでにその仕事を知っている従業員に向けたものだ。eeselを試すのは無料だ。
よくある質問
Grok 4.7の料金はいくらですか?
Grok 4.7の料金は、入力トークン100万個あたり2ドル、キャッシュ入力0.50ドル、出力6ドル(プロンプトが20万トークン未満の場合)で、リクエストが20万トークンを超えると4ドル/1ドル/12ドルに倍増する。詳細はxAIの料金ページを参照。これはGrok 4.6と完全に一致しており、アップグレードは価格を上げることなく性能を追加している。
Grok 4.7とGrok 4.6の違いは何ですか?
Grok 4.7はより大きなベースモデルと、数時間単位のタスクに重点を置いたより長い強化学習を使用しており、Terminal-Bench 4.0のような長時間実行のエージェント型ベンチマークで最大の伸びを記録している。両モデルとも500kのコンテキストウィンドウと同じトークン料金を共有している。
Grok 4.7はコーディングに向いていますか?
はい、コーディングは最大の強みだ。CursorBench 4.0で46.3%を記録し、xAIが公開したすべてのソフトウェアベンチマークでGrok 4.6を上回っており、CursorやGrok Buildの中でも提供されている。より深いコード作業では、チームは最も難しいタスクに対して依然としてより高価なモデルと組み合わせることが多い。
Grok 4.7にはどうやってアクセスしますか?
xAIのAPIでgrok-4.7として呼び出すか、Grok Buildで無料で使うか、Cursor内でアクセスできる。生のトークンではなく、その知性に明確な仕事をさせたいなら、eeselのようなAIチームメイトプラットフォームが、フロンティアモデルにスキル、統合、会社のコンテキストを組み合わせて実際の役割に仕立ててくれる。
Grok 4.7はGPT-5.6 SolやFable 5.1より優れていますか?
何を重視するかによる。Grok 4.7はGPT-5.6 Solをコーディングとエージェント型のほとんどのベンチマークでわずかな価格で上回る一方、Fable 5.1は最高峰のコーディングとターミナル作業では依然として先行しているが、トークンあたりの価格は5〜8倍かかる。コストに敏感な大量の作業には、Grok 4.7が通常より良い選択となる。
Grok 4.7 Fastとは何ですか?
Grok 4.7 Fastは同じモデルを出力速度2倍で提供するもので、トークン価格も2倍になる。パブリックAPIではなく、CursorとGrok Build内のみで利用できる。コードがリアルタイムで流れてくるのを見るときなど、低レイテンシが重要な場合には価値があり、バッチ処理やバックグラウンド処理ではスキップ可能だ。

Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.