Grok 4.7とは何か
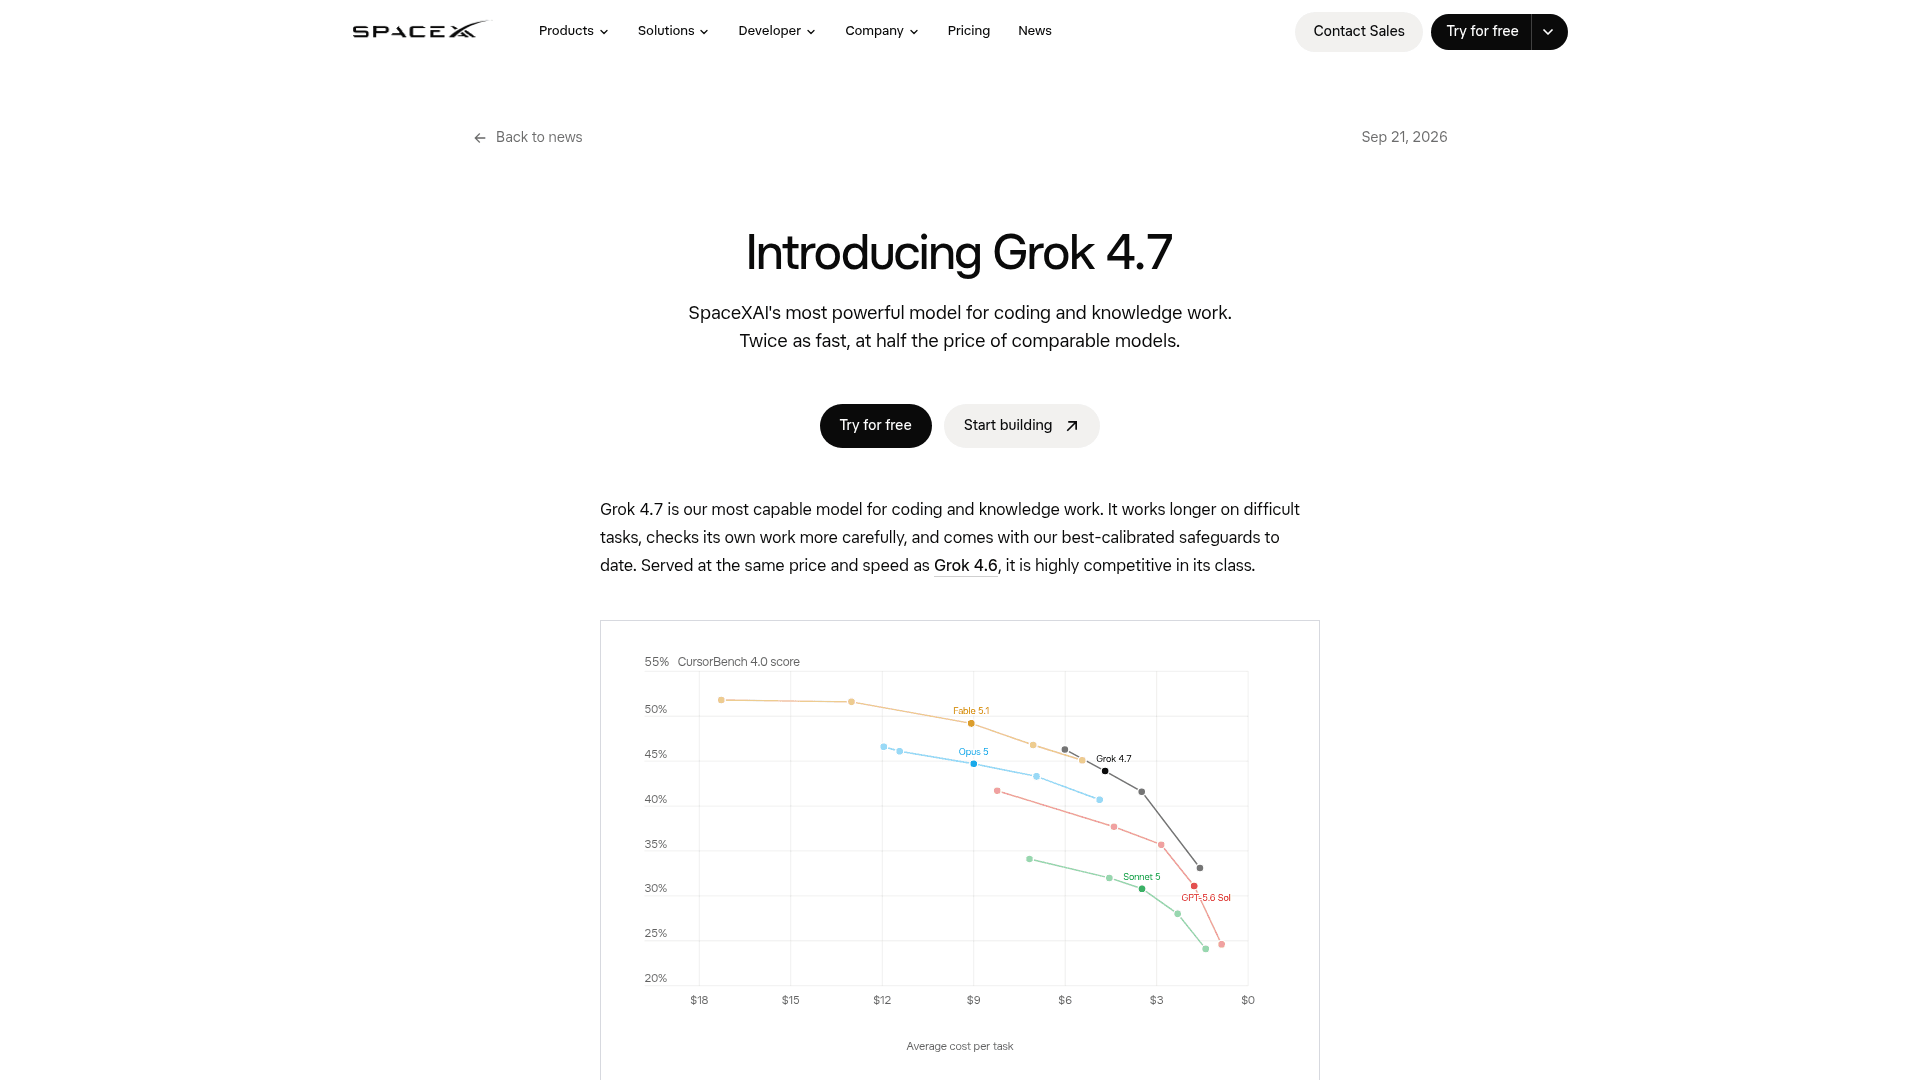
Grok 4.7は、コード、エージェント、知識労働向けのxAIのフラッグシップモデルで、xAI APIではgrok-4.7としてリリースされています。Grok 4.6から500kトークンのコンテキストウィンドウを引き継ぎ、テキストと画像を入力として受け取りテキストを返し、推論の強度を低・中・高・xHighの4段階で設定できます。知識のカットオフは2026年5月で、他のGrokモデルと同様に、サーバー側のウェブおよびX検索ツールを有効にしない限り、リアルタイムの出来事は把握していません。
興味深いのは構築の中身そのものです。xAIは4.6よりも新しく大きなベースモデルの上で4.7を訓練し、その後、数時間かかる問題に重みを置いたより難しいタスクの組み合わせで、より長い強化学習パスを実行しました。またGrok Botのハーネスをネイティブに理解するように訓練されており、これが生のチャットモデルに比べて、複数ステップにわたるツール呼び出し作業でより流暢に感じられる理由です。それに合わせて全く新しいAPI機能も登場しました。長い履歴を料金の崖の下に収めるためのContext Compaction APIです。
Grok 4.7はより広いラインナップにおけるテキストとコードの頭脳であり、本レビューはこのモデルについてのみ扱います。他の部分を探しているなら、xAIはそれらを分離しています。画像と動画はGrok Imagineが、音声はGrok Voice APIが担当し、エージェントビルダー側はGrok Botにあります。以下はすべてgrok-4.7単体についての内容です。
Grok 4.6から実際に何が変わったか
Grok 4.5から4.6へのアップグレードは、Grok 4.5レビューで指摘した通り漸進的なものでした。4.7への飛躍は、少なくとも1点においてはそうではありません。それを最もはっきり示すのが、xAIが公開したベンチマークの差分です。
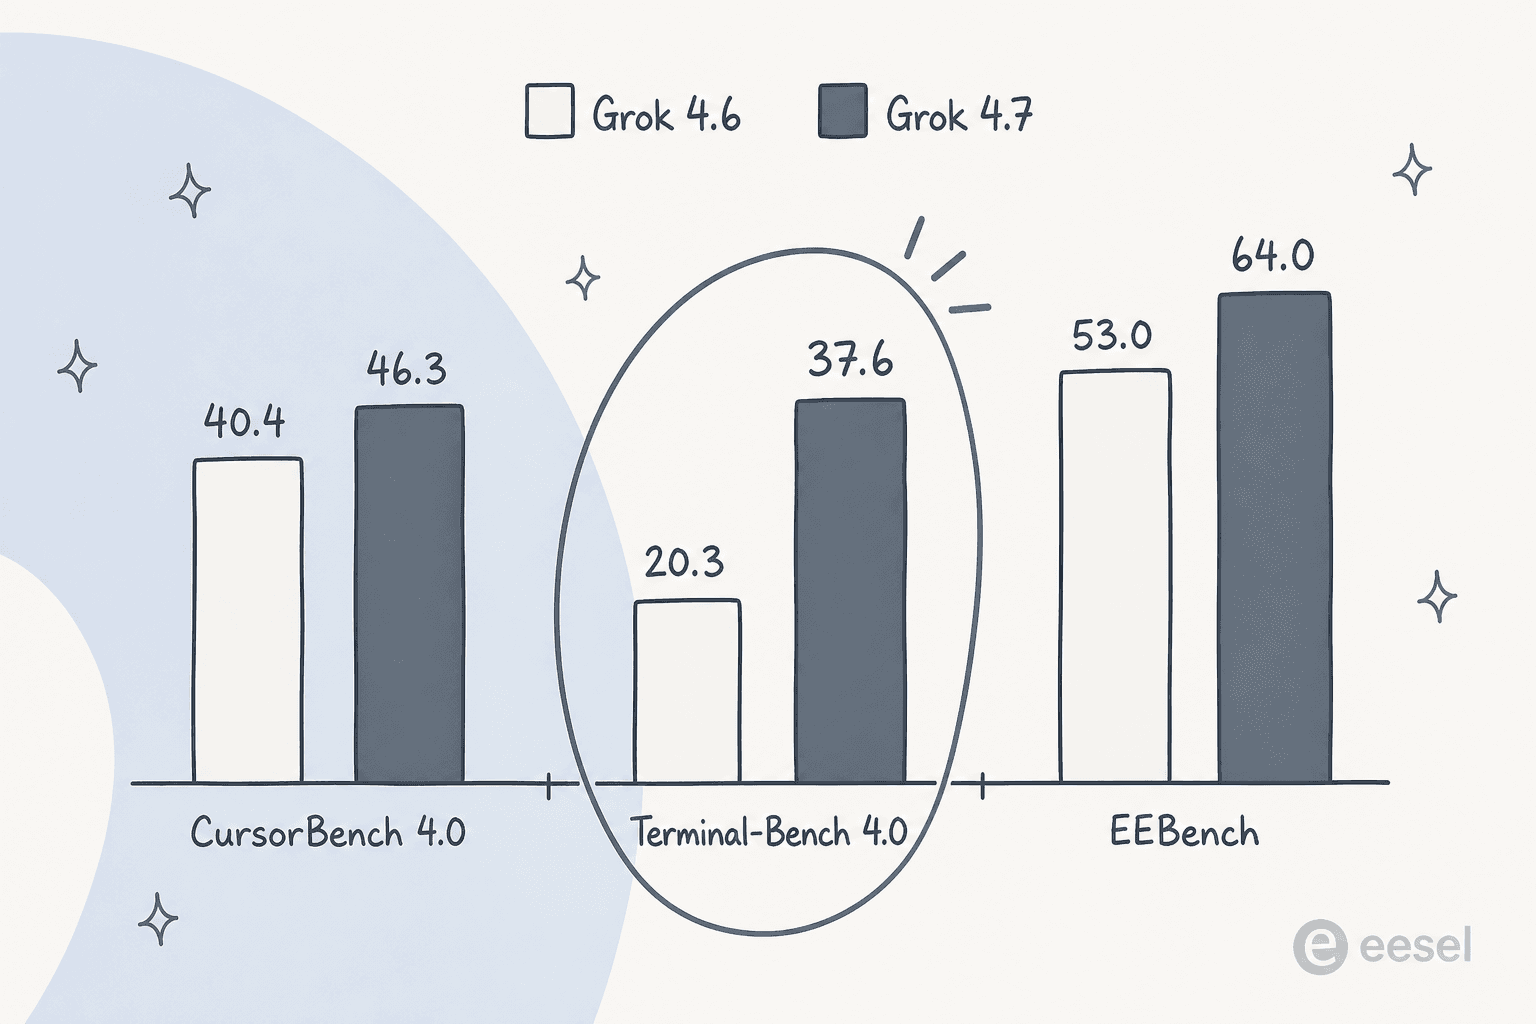
CursorBench 4.0は40.4から46.3へ、EEBench(電気工学)は53.0から64.0へと上昇しました。どちらも堅実な結果です。特筆すべきはTerminal-Bench 4.0で、20.3から37.6へとほぼ倍増しました。これは4.6から4.7への単一の伸びとしては最大であり、モデルが要点を見失わずに長く複数ステップにわたるターミナル作業をどれだけうまくこなせるかを直接示す数値です。あなたのユースケースが、一つのプロンプトに答えるのではなく実際のタスクリストをこなし続けるエージェントであるなら、これが重要な数値であり、Grok 4.6レビューではまだ示せなかった数値です。
残りの改善点はより静かなものです。自己検証の向上、長いコンテキストのより安定した扱い、そしてドキュメントとプレゼンテーションの出力強化で、これはGDPvalとAA Briefcaseというプロフェッショナルワーク系ベンチマークの向上として表れています。これらはどれも他社では無料で手に入るものではなく、ここでは同じ価格のまま手に入ります。
ベンチマークを正直に読む
xAIはGrok 4.7 xHighをGrok 4.6 High、GPT-5.6 Sol Max、Fable 5.1 Maxと比較しました。以下はローンチページそのままの主要な表で、4.7が勝っている部分と勝っていない部分の両方が見えます。
| ベンチマーク | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| 入力 $/1M | $2 | $2 | $4 | $10 |
| 出力 $/1M | $6 | $6 | $20 | $50 |
| CursorBench 4.0 | 46.3 | 40.4 | 41.7 | 51.8 |
| DeepSWE v1.1 | 71.0* | 65.2 | 72.7 | 70.0 |
| Terminal-Bench 4.0 | 37.6 | 20.3 | 37.3 | 57.9 |
| EEBench | 64.0 | 53.0 | 39.4 | 56.4 |
| AA Briefcase v1.1 (Elo) | 1657 | 1546 | 1487 | 1678 |
| Harvey Legal Agent | 19.6 | 15.8 | 2.5 | 6.7 |
| HealthBench Professional | 56.7 | 48.5 | 60.5 | 62.1 |
*高強度でのスコア。出典: xAI、Grok 4.7ローンチ。
公正に読めば、状況ははっきりしています。Grok 4.7はEEBenchとHarvey Legal Agentベンチマークで明確に勝利しており、Fableのスコアを2倍以上上回り、それ以外でも競争力があります。しかし、CursorBench、Terminal-Bench、AA BriefcaseではFable 5.1が首位に立ち、DeepSWEではGPT-5.6 Solがわずかにリードし、HealthBench ProfessionalではGrok 4.7は両方に負けています。つまり、あなたの仕事がピークのコーディング精度や臨床推論であり、予算が問題にならないなら、Grok 4.7は選ぶべきモデルではありません。その能力を大量に運用することがあなたの仕事なら、次のグラフが決め手になります。
価格こそがすべての論点
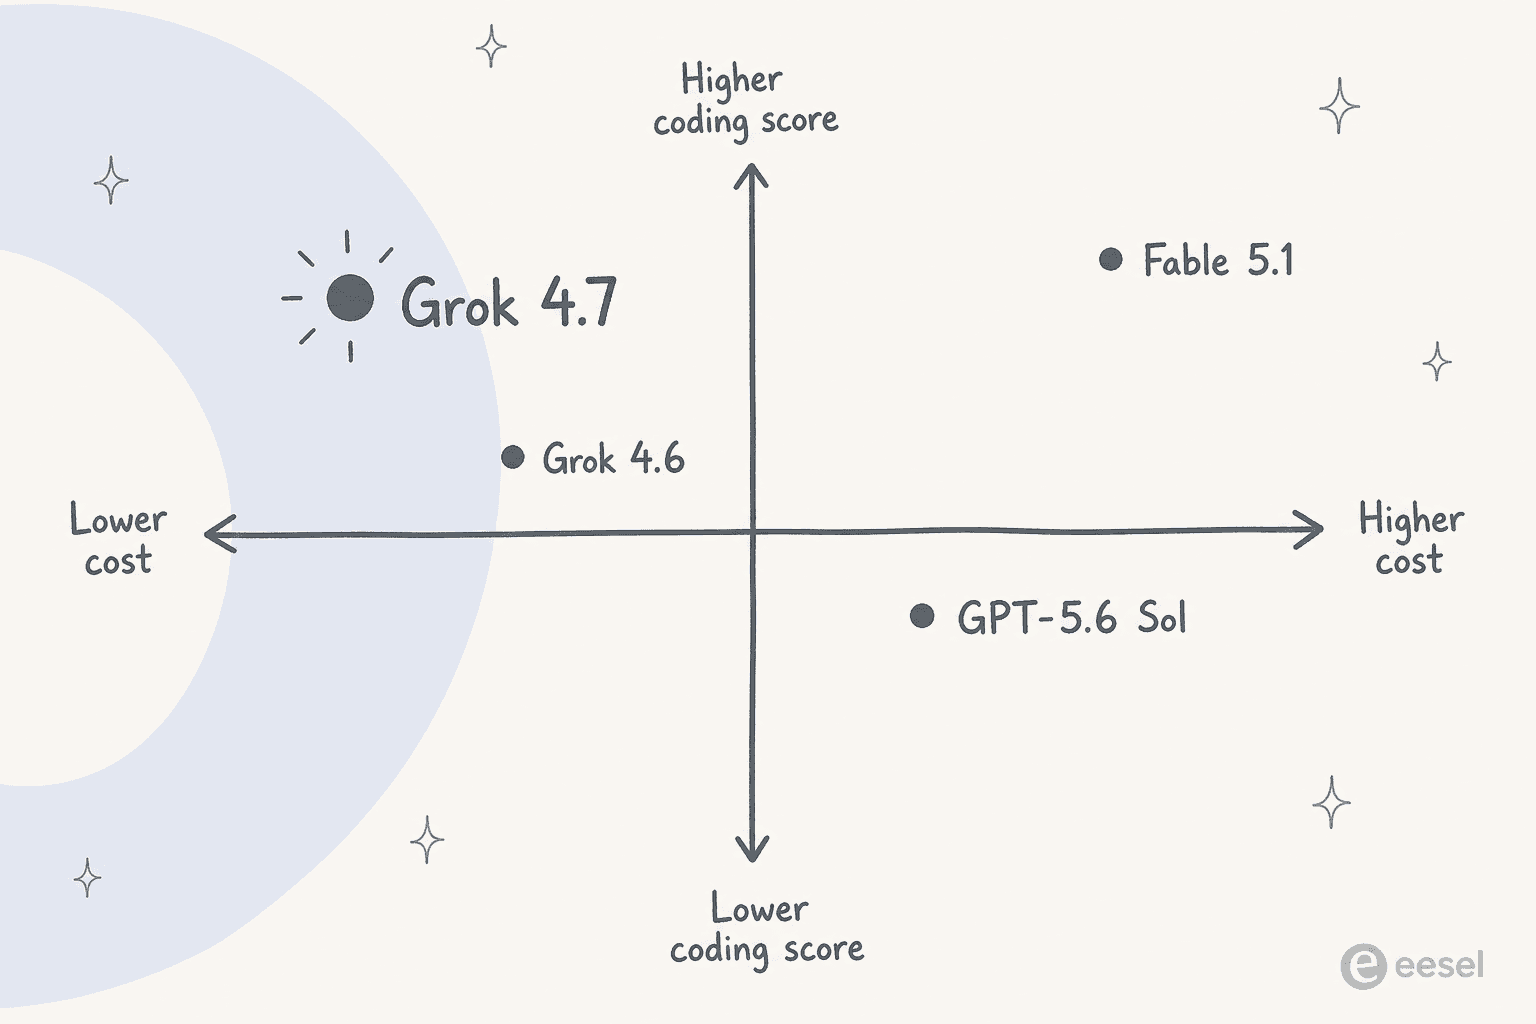
Grok 4.7は、Grok 4.6の価格でおおむねFableに匹敵する能力を提供します。具体的には、5万トークンを読み込み1万トークンを書き出すタスクのコストは、Grok 4.7で約0.16ドル、GPT-5.6 Solで0.40ドル、Fable 5.1で1.00ドルです。これに1日に何千回も実行するエージェントを掛け合わせると、モデル選びはベンチマークの小数点の話ではなく、あなたの請求額の話になります。
正直であるために、2つの注意点があります。まず200kの崖です。プロンプトのトークンが200kを超えると、料金は超過分だけでなくリクエスト全体のすべてのトークンに対して4ドル/1ドル/12ドルへと倍増します。これはまさにContext Compaction APIが回避するために存在するものです。次に、ローンチ時のチャートは4ドル/20ドルの旧GPT-5.6 Solと比較していましたが、OpenAIはその翌日に2ドル/10ドルでGPT-6 Solを発表したため、実際の出力価格差はチャートが示唆する70%ではなく40%です。それでもxAIの料金はそのクラスで依然として最も強力ですが、スライドが示すほど大きな差ではありません。メーターごとの詳細な内訳はGrok 4.7の料金ガイドにあります。
知っておくべきFast版の割増料金もあります。Grok 4.7 Fastは同じモデルで出力速度が2倍、トークン価格も2倍になったもので、公開APIではなくCursorとGrok Buildの中でのみ存在します。コードがリアルタイムで生成されるのを見ていてレイテンシが痛手になる場合には払う価値がありますが、誰も待っていないバッチ処理や夜間ジョブでは無駄なお金になります。
大量のエージェントを動かしている(ツール呼び出し、ターミナル作業)
はい、切り替えるべきです。ここが最適地点です。Terminal-Benchの飛躍と2ドル/6ドルの価格は、まさにエージェントループが求めているものです。200kの崖に注意し、Context Compactionを使ってください。
コストは関係なく、最高のコーディング精度が必要
最も難しいタスクにはFable 5.1にとどまってください。多くのチームは大半の作業をGrok 4.7に振り分け、最もピークなケースのみをより高価なモデルにエスカレーションしています。
臨床または健康に関わる推論を行っている
選ぶべきではありません。Grok 4.7はHealthBench ProfessionalでGPT-5.6 SolとFable 5.1に後れを取っています。価格ではなくこのベンチマークで選んでください。
サポートチケットへの回答やブログ執筆をAIにさせたい
生のモデルは間違ったレイヤーです。すでにあなたの製品を知っていて、あなたのツールに接続されているチームメイトが必要です。最後のセクションへ進んでください。
今回xAIが真剣に取り組んだ安全性
これは1段落を割く価値があります。本当の変化だからです。Grok 4.7はまったく新しい安全対策スタックとともにリリースされ、xAI自身のテストによれば、拒否とジェイルブレイク耐性においてこれまでで最も強力なモデルです。HackerBench v0.3では、正当なセキュリティ作業をほとんどブロックすることなくリスクのあるデュアルユースプロンプトのわずか3.3%しか通過させません。また、LatchBioのバイオセーフティベンチマークでは62.4%でトップに立っています。xAIはまた、選ばれたサイバーセキュリティパートナーに対して、モデルのレッドチーム機能への招待制アクセスを提供し始めました。まさにこの軸で以前のモデルが批判を浴びていた企業にとって、これは単なるプレスリリースの文言ではなく、意味のある、検証可能な改善です。
実際に構築している人たちが言っていること
ベンチマークはxAIが語るストーリーです。ここでは独立系開発者が報告している内容を紹介します。私が見つけた最も有用なシグナルは範囲についてのものでした。このモデルは小さなものを見事にワンショットでこなす一方、既存の大規模なコードベースでは熱狂が冷めるというものです。
"I agree, the models keep getting better at one shotting. That's useful in a lot of situations, like for small one-off scripts that filter/transform some tool call, or make a clever bash call. For the code itself, it doesn't help me much though."

これはベンチマークの傾向とも一致しています。範囲が限定され、よく仕様が定まったタスクには強い一方、「この20万行のリポジトリを理解する」といった仕事ではそれほど魔法のようにはいかないということです。もう一つ繰り返し出てくるテーマは、日常的なヘビーユーザーが使用上限にほとんど達しないという点で、他のツールでクレジット上限に痛い目に遭った経験があるなら重要なポイントです。
"I use the crap out of Grok in my daily life, including to build a couple self-hosted apps as an amateur. I have a Grok bot monitor my email every 15 minutes and file things away for me... and I never even get close to using my quota."
どちらも本レビューの一貫したテーマと一致しています。1日中頼れる安価で高スループットのエンジンとして、Grok 4.7は期待に応えます。どちらのコメンターも描いていないのは、すでに自社を知った状態で登場するシステムであり、それこそが最後のセクションで埋めたいギャップです。
Grok 4.7を使うべき人
コードを書き、エージェントを動かし、APIの上に構築していて、タスクあたりのコストを気にするなら、Grok 4.7を選ぶべきです。これは2026年にAI製品を構築するほとんどの人に当てはまります。大量のエージェントループにとって自然なデフォルトの選択肢であり、最も難しい5%の仕事をClaude Opus 5やFableにエスカレーションする場合でも、賢いベースレイヤーになります。低価格フロンティア分野の他のモデルと比べると、エージェント業務においてKimi K3やDeepSeek V4 Flashよりも優れたオールラウンダーです。
また、ターミナルタスクではQwenを上回り、価格ではGPT-5.6 Solを下回りながら、ほとんどのコーディングでは互角です。エディタ内ではCursorに組み込まれているため、日常的にはそのコミュニティがすでに議論している同じツールと競合します。
予算に関係なく最高のコーディング精度が必要な場合、あなたの仕事が臨床分野である場合、あるいは本当に欲しいものがモデルではなく完了した仕事そのものである場合は、スキップするか、少なくとも真っ先には選ばないでください。この最後のケースは、モデルレビューという枠組みが認めている以上によくあることで、そこで率直に話したいと思います。
モデルレビューが通常見落とす部分: エンジンは従業員ではない
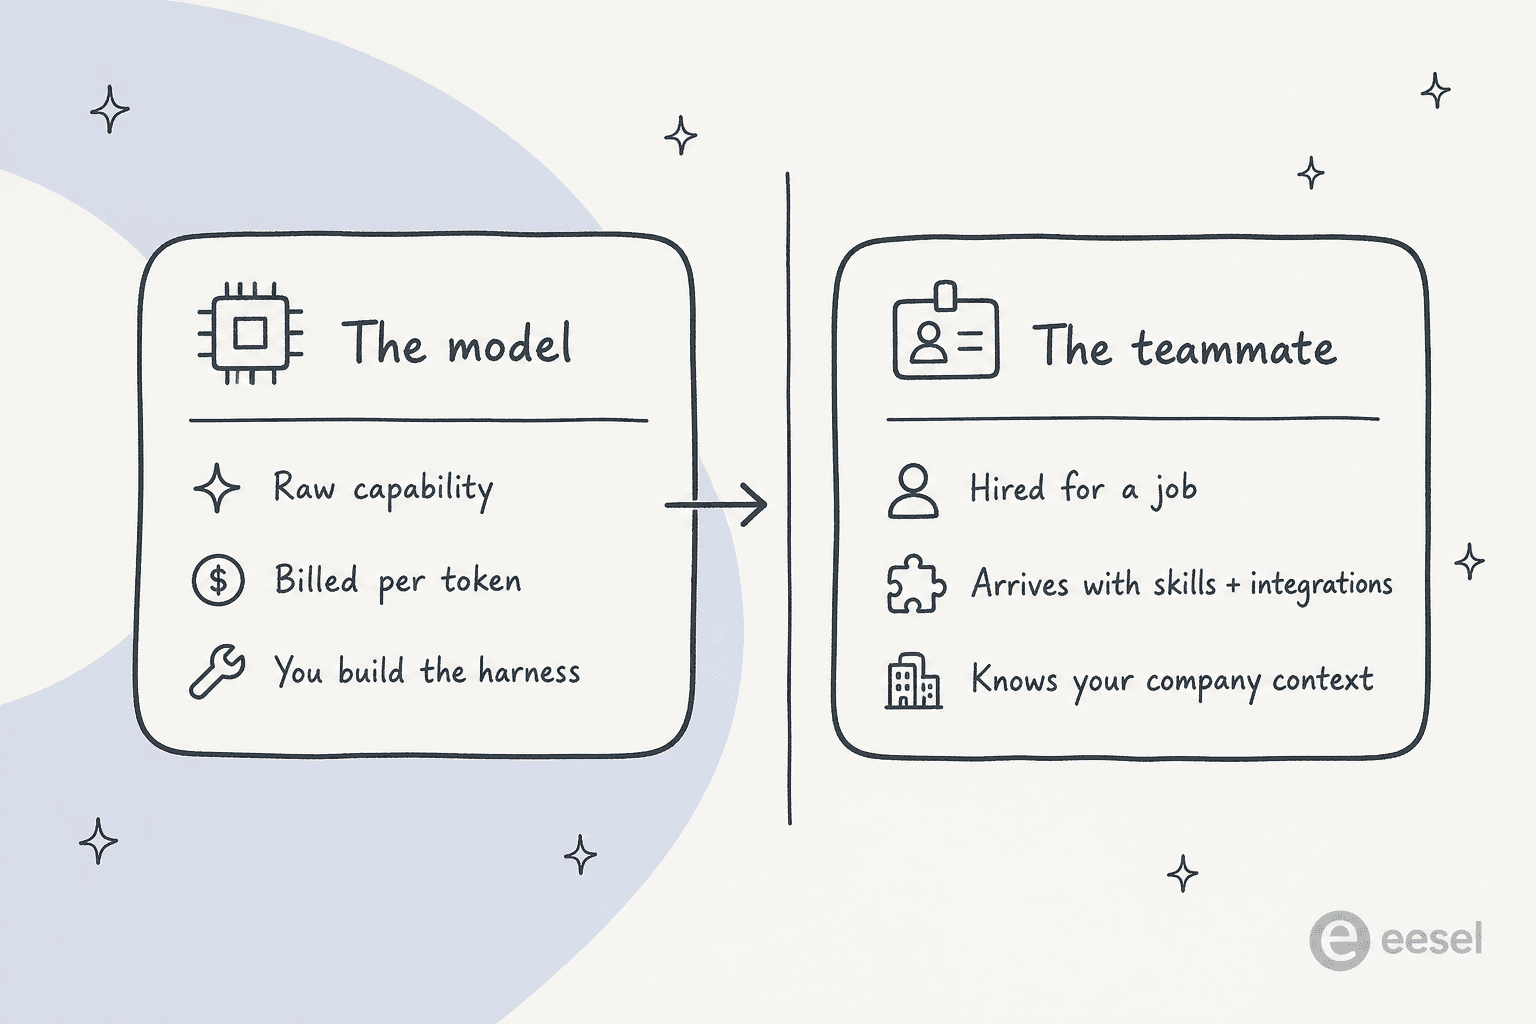
実際のサポートキューにAIを載せてきた3年間が私に教えてくれたのはこういうことです。フロンティアモデルは信じられないほど有能なエンジンであり、エンジンは従業員と同じものではありません。 Grok 4.7はトークン単位で生の知能を提供します。あなたの返金ポリシーを知りませんし、あなたのヘルプデスクにも接続されておらず、過去のチケットを見たこともありません。そして、どの質問なら自信を持って答えられ、どれを人間に任せるべきかを自ら判断することもありません。それらすべてを配線するのは実際のプロジェクトであり、ベンチマークスコアが何も語らない部分です。
これは、いずれすべてのチームが直面する自作か購入かの選択です。あるインフラ企業の顧客は、それを率直にこう表現しました。
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
これがeeselが埋めるために作られたギャップです。eeselはAIチームメイトのプラットフォームであり、生のトークンをレンタルするのではなく、特定の仕事のためにすぐ働けるチームメイトを雇います。現在のラインナップには、既存のサポートキューに加わるAIヘルプデスクチームメイトと、リサーチに基づく高品質なコンテンツのために最高のAIライティングツールと肩を並べるAIブログライターがあります。それぞれがすでにフロンティアモデルの上に構築されており、その役割に必要なスキル、連携機能、会社のコンテキストをすでに備えています。
サポートチームメイトはあなたの過去のチケットで訓練され、あなたのトーンで下書きを作成するか完全に回答し、自信のあることだけを処理します。これはまさに、モデルをトークン単位で使うアプローチではあなた自身が構築しなければならない制御です。この違いこそがAIエージェント対ルールベースのチャットボットにおける議論の核心であり、AIによるカスタマーサービスが単なるプロンプトではなく製品カテゴリである理由です。
証拠はベンチマークではなくキューの中にあります。あるモビリティプラットフォームの顧客は、eeselが最初の1か月でティア1リクエストの73%を解決するのを見ましたし、別の顧客はサポートの作業時間を最大80%削減したと報告しています。これらは、Terminal-Benchで良いスコアを出したモデルからではなく、仕事を知っているチームメイトから得られる数字です。コスト面をまだ検討中なら、AIエージェント対人間のエージェントのコストの内訳と、より広範なAIカスタマーサービスソフトウェアの全体像が、次に読むべき記事です。
モデル自体を自分で操作したい場合
Grok 4.7が対象としている開発者にとって、知っておく価値のある中間的な道があります。eeselは、同じチームメイトとワークスペースをエージェントに適した形で公開するコマンドラインインターフェースとMCPサーバーを提供しています。人間はターミナルから操作でき、スクリプトは自動化でき、Claude Code、Codex、Cursorのようなコーディングエージェントは直接操作できます。つまり、そもそも生のAPIに興味を持たせたプログラム可能でヘッドレスな制御を得られますが、それが向く先は、実行のたびにゼロから教え込む必要がある空白のモデルではなく、すでにあなたの会社を知っているチームメイトです。これは、ダッシュボードをクリックするのではなくコードからチケットのトリアージを自動化するのと同じ発想です。
自社のチケットで試してみたいですか? eeselは数分であなたのヘルプデスクに接続し、あなたの履歴で訓練され、実際のチケットに1件でも答える前に、過去の何千ものチケットに対してシミュレーションできます。無料でお試しいただけます。

私の結論
Grok 4.7は、それが何であるかという点で推奨しやすいモデルです。フロンティアにおける最高のコストパフォーマンス、特にエージェントと大量のコーディング作業において。 すべての軸で最も賢いモデルというわけではなく、GPT-6 Solが登場した今、ローンチ時のチャートは価格差を実際以上に見せていますが、コストに敏感な作業においては、私が最初に手を伸ばすモデルです。ただし、自分が何を買っているのかは忘れないでください。モデルはトークン単位で能力を提供します。信頼できる形で仕事を完了させることが必要なら、それにはチームメイトが必要であり、それはまったく別の購入です。
よくある質問
Grok 4.7は良いモデルですか?
コーディングとエージェント業務を低コストで行うなら、はい。今回のGrok 4.7レビューでは、長時間にわたるターミナル作業において最近のxAIリリースの中で最大の伸びを記録し、価格性能比ではフロンティアの地位を維持しています。すべての指標で最も賢いモデルというわけではなく、ClaudeのFable 5.1が依然としてピークのコーディングとターミナル作業でリードしていますが、そのクラスでは最高のコストパフォーマンスです。
Grok 4.7の料金はいくらですか?
xAIの料金ページによると、Grok 4.7は入力100万トークンあたり2ドル、キャッシュは0.50ドル、出力はプロンプトが200k以下なら6ドルで、200kを超えると4ドル/1ドル/12ドルになります。これはGrok 4.6と同一です。検索やコード実行のメーターを含む詳細な内訳は、Grok 4.7の料金ガイドにあります。
Grok 4.7はGPT-5.6 Solより優れていますか?
xAI独自のベンチマークセットでは、Grok 4.7はほとんどのコーディングおよびエージェントタスクでGPT-5.6 Solを大幅に低い価格で上回りますが、臨床推論ではSolがわずかにリードしています。OpenAIはその後2ドル/10ドルでGPT-6 Solを発表しているため、実際の価格差はローンチ時のチャートが示すよりも狭いことに注意してください。
Grok 4.7とGrok 4.6の違いは何ですか?
Grok 4.7はより大きなベースモデル上で動作し、数時間かかるタスクに重みを置いた、より長い強化学習を経ています。最大の向上はTerminal-Bench 4.0で見られ、4.6のスコアをほぼ倍増させました。どちらも500kのコンテキストウィンドウと同じ料金を維持しているため、これは無料の能力アップです。前回のリリースについてはGrok 4.6レビューで扱っています。
Grok 4.7はコーディングに向いていますか?
コーディングはその最大の強みです。CursorBench 4.0で46.3%を記録し、xAIが公開したすべてのソフトウェアベンチマークでGrok 4.6を上回っています。CursorとGrok Buildに組み込まれており、コミュニティの開発者からは、小さなスクリプトをワンショットで作るのが得意な一方、既存の大規模なコードベースではそれほど劇的な変化はないと報告されています。
Grok 4.7 Fastとは何ですか?
Grok 4.7 Fastは同じモデルの出力速度を2倍にし、トークン価格も2倍にしたもので、公開APIではなくCursorとGrok Buildでのみ利用できます。コードがリアルタイムで生成されるのを見るときのように、レイテンシが重要な場合はその追加コストを払う価値がありますが、誰も待っていないバッチ処理や夜間ジョブでは省略できます。詳しくはxAIの料金の概要をご覧ください。
Grok 4.7にはどうやってアクセスできますか?
xAIのAPIでgrok-4.7として呼び出すか、Grok Buildで無料で使うか、Cursor内でアクセスできます。生のトークンではなく、明確な仕事をこなす存在としてその知能を使いたいなら、AIチームメイトがフロンティアモデルにスキル、連携機能、会社のコンテキストを組み合わせ、サポート業務の自動化のような実際の役割を担います。


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.