Exa Agent Ultraとは実際に何か
まず会社の説明です。ExaはAIエージェント向けに作られた検索APIで、モデルにウェブへのリアルタイムのアクセスと、構造化された出典付きの結果を提供します。小さな会社でもありません。Exaは50万人の開発者がこれを使って開発していると述べており、インデックスは1,000億ドキュメントとしています。CognitionのDevin、Cursor、Firefoxはいずれも情報検索にこれを利用しています。
Agent Ultraはそのインデックスの上に成り立っています。Exa Agent APIはExaの「フロンティア級のウェブリサーチのための単一API」で、どれだけ本気で働かせるかを決める唯一のダイヤルが労力です。レベルはminimal、low、medium、high、xhigh、auto、ultraで、デフォルトはautoです。Ultraはその階段の最上位で、変更履歴では2026年9月24日付けになっています。
私の理解の助けになった考え方は、固定レベルは質問に答え、Ultraは調査をやり遂げる、というものです。Exaはこれを「完全性と正確性が最も重要な、最も難しいリサーチのために作られた」モードと位置づけています。つまり、ディープリサーチ、リスト作成、エンティティの拡充など、使い尽くすまで実行する必要のあるあらゆるタスクです。
具体的には、「ブラウザ自動化ツールを作っている米国の全企業」、「過去12か月でHead of Riskを採用したシリーズAからCのフィンテックすべて」、あるいは「この企業は病院に販売しているか?」のように判断を要する項目でリストを拡充する、といった仕事です。それぞれの回答には根拠として引用されたURLが付きます。こうしたリストを手作業で作ろうとしたことがあれば、Exaがどんな面倒な作業を狙っているのかよくわかるはずです。
Agent Ultraの内部の仕組み
興味深いのは、個々のモデルではなくオーケストレーションです。クエリを送ると、Exa Agentはタスクをサブタスクに分割し、サブエージェントを割り当てて複数の領域を同時に調べます。Ultraはサブエージェントの数とソースの数を大幅に引き上げるだけです。
全体をまとまりのあるものにしている設計上の選択は2つあります。1つ目はモデルの組み合わせです。Exaは「タスクが必要とするところにフロンティア級の知能を、十分なところにはより高速なモデルを」配置するとしており、些細なサブステップごとにフロンティア級の料金を払わずに済みます。2つ目はExaのトークン効率の良いハイライトモデルで、ページ全体をコンテキストに詰め込む代わりに最も関連性の高い抜粋を取り出し、トークン使用量を最大94%削減するとされています。コスト面の優位性の多くはここから生まれます。
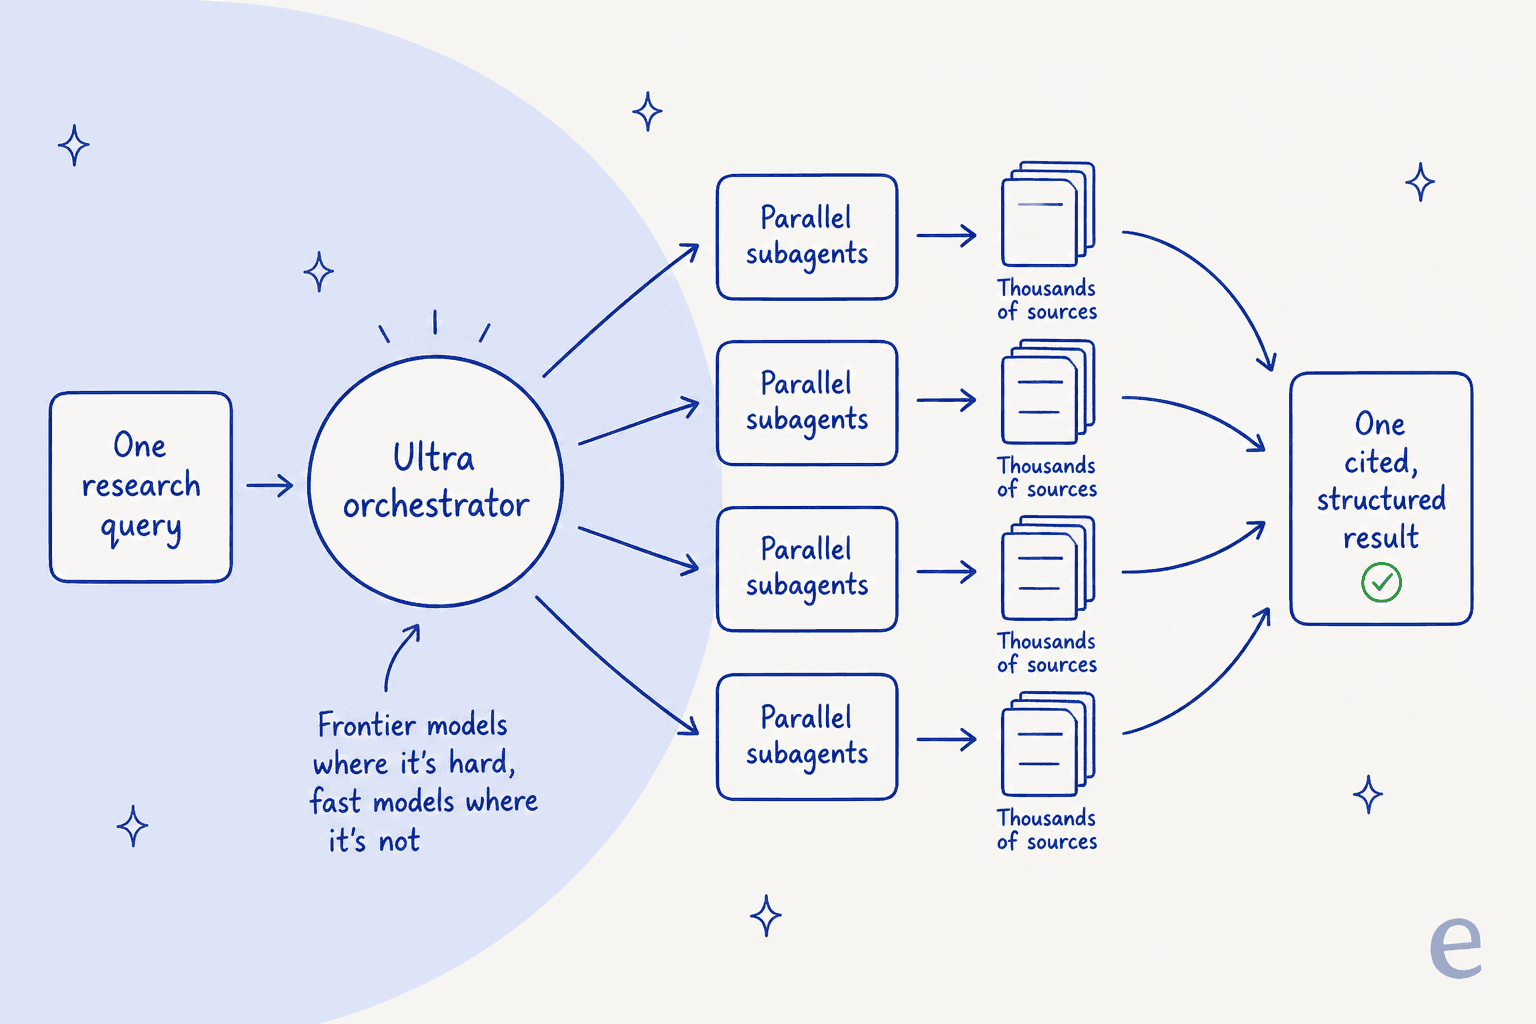
/searchや/contentsの呼び出しを自分で一つずつオーケストレーションする代わりに、まとめられたリサーチが根拠付きの1つの結果として返ってきます。完了した実行には、自然言語の回答用のoutput.text、outputSchemaを渡したときにスキーマ検証済みのJSONを返すoutput.structured、フィールド単位の出典を示すoutput.groundingが含まれます。また、agent_runツールを使ってExaのMCPサーバーからすべてを操作することもでき、Claude CodeやCursorのようなコーディングエージェントが直接呼び出せます。
ベンチマークの主張とその読み方
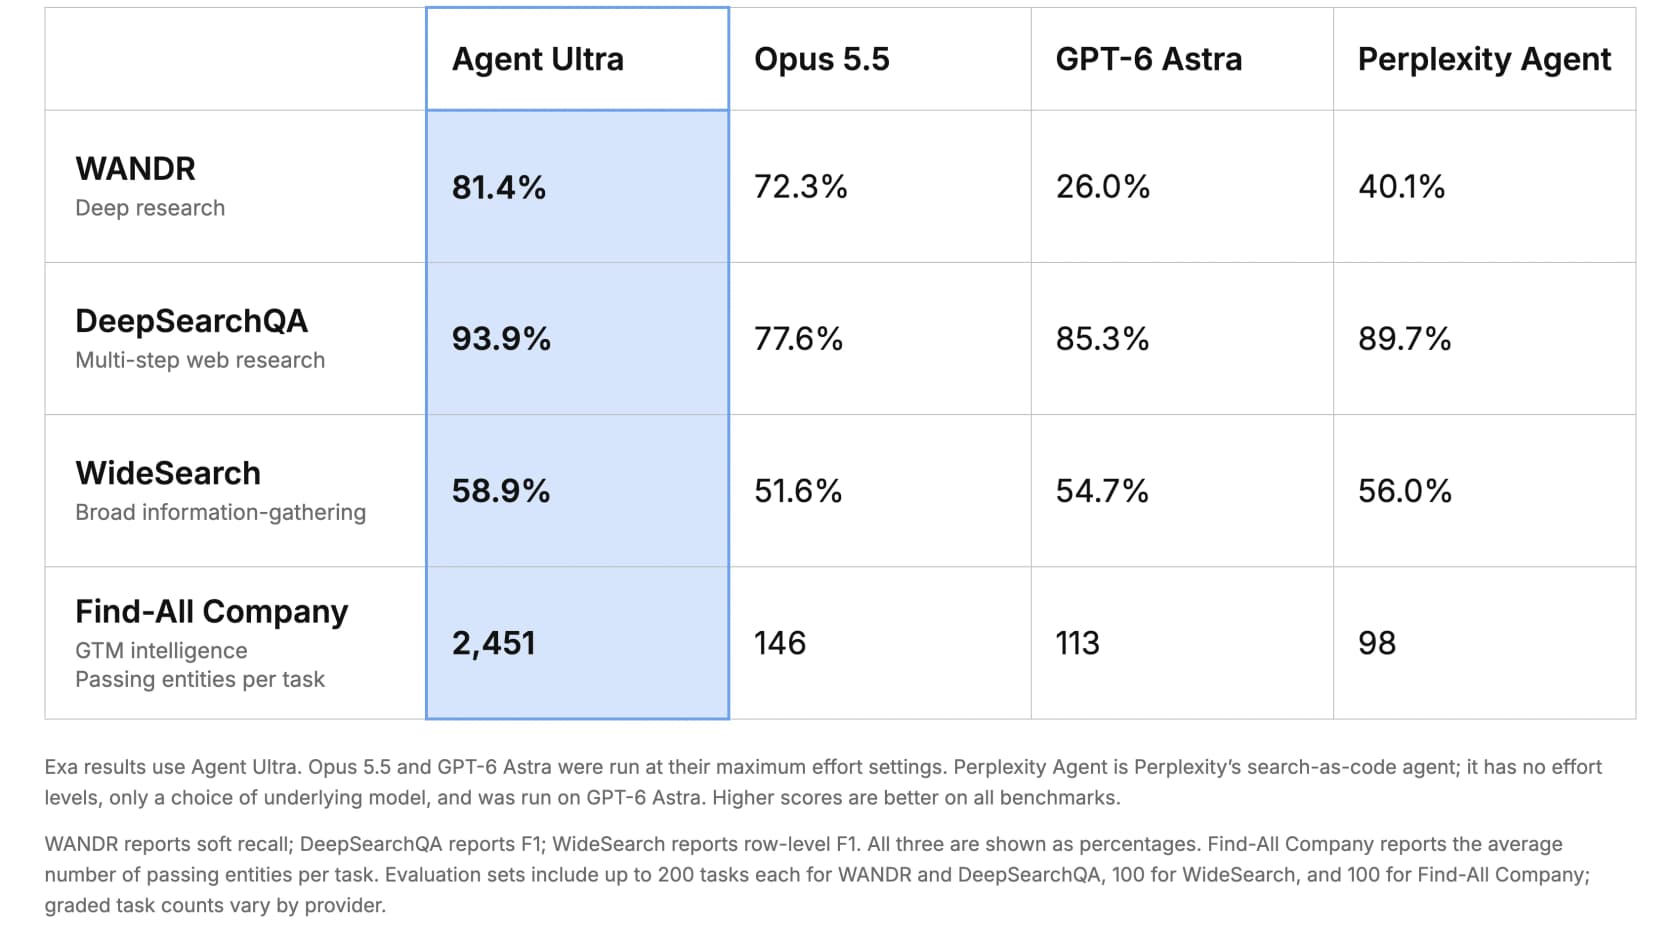
ここでExaは大きく出ます。同社によると、Agent Ultraは最大労力設定のOpus 5.5、GPT-6 Astra、Perplexity Agentを4つのベンチマークで上回ります。数値は次のとおりです。
| ベンチマーク | 測定内容 | Agent Ultra | Opus 5.5 | GPT-6 Astra | Perplexity Agent |
|---|---|---|---|---|---|
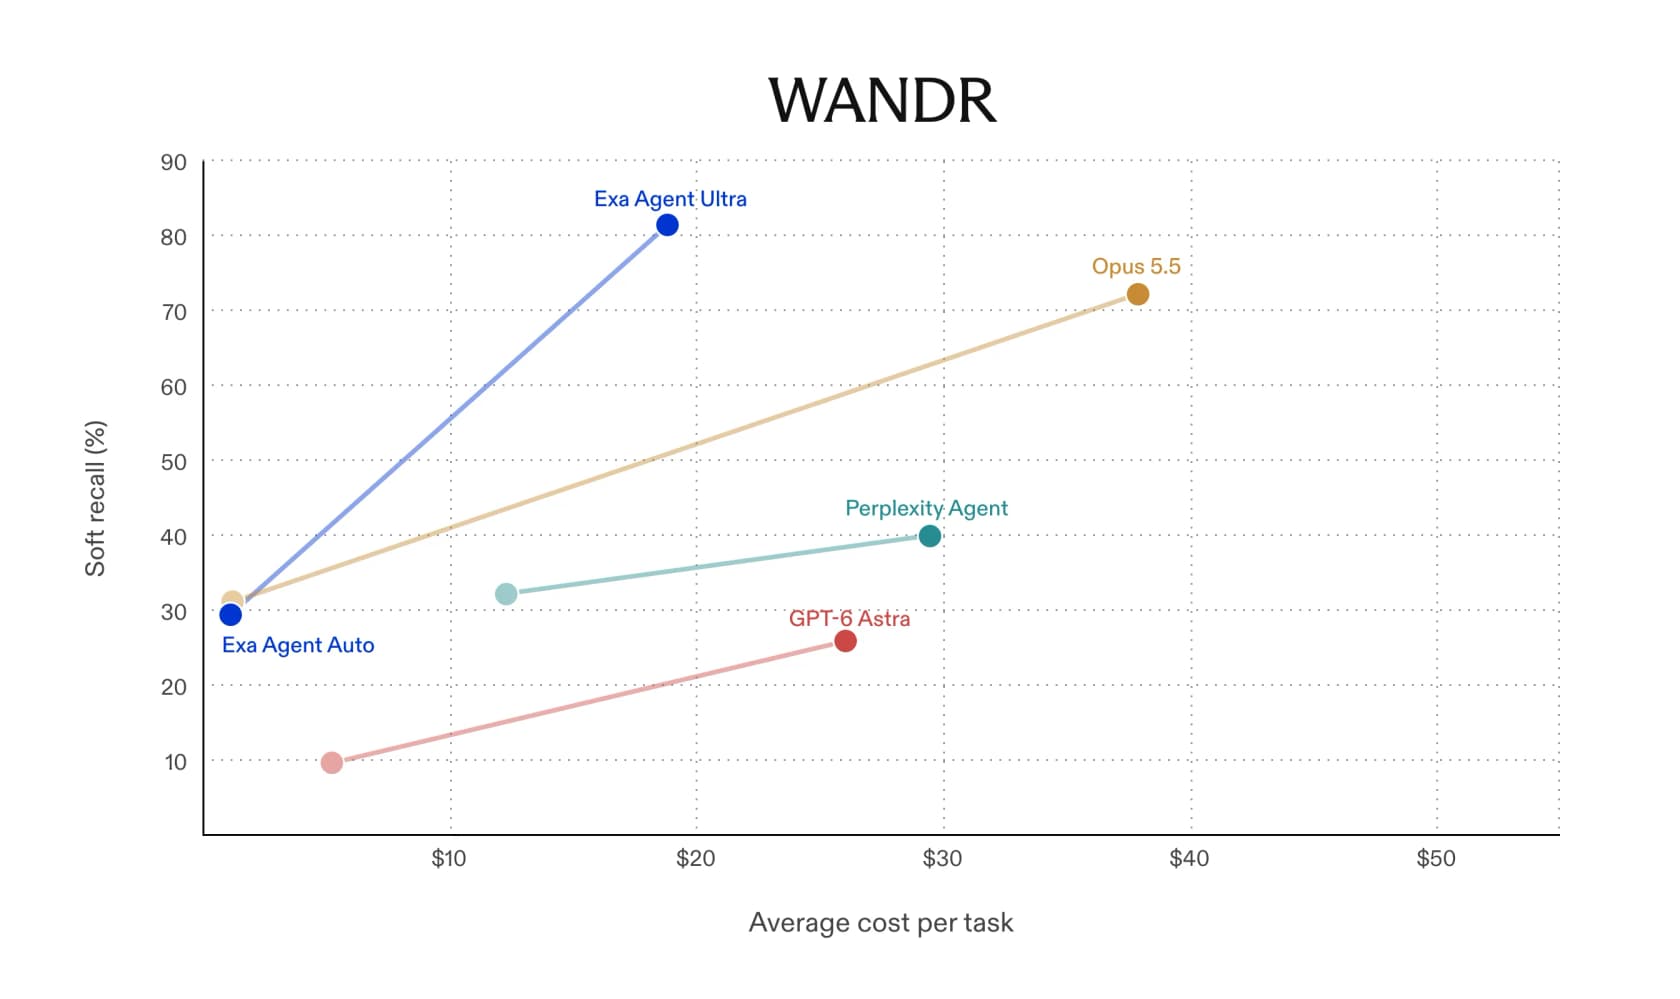
| WANDR | ディープリサーチ(ソフトリコール) | 81.4% | 72.3% | 26.0% | 40.1% |
| DeepSearchQA | 複数ステップのウェブリサーチ(F1) | 93.9% | 77.6% | 85.3% | 89.7% |
| WideSearch | 幅広い情報収集(行F1) | 58.9% | 51.6% | 54.7% | 56.0% |
| Find-All Company | GTMインテリジェンス(1タスクあたりの合格エンティティ数) | 2,451 | 146 | 113 | 98 |
目を引くのはFind-All Companyの行です。1タスクあたり平均2,451件の合格エンティティで、次点のシステムは146件です。「使い尽くすまで実行する」という設計が数字になって表れています。ExaのWANDRのグラフはコスト面の話も示しており、Ultraは1タスクあたり約18ドルでソフトリコール約81%、Opus 5.5は約38ドル近くかけて約72%に届く程度です。
では率直な読み方です。これらはExa自身のベンチマーク実行で、Exaが保守するテスト環境で行われ、Exaが選んだモデル(採点者としてgpt-6-lunaを使用)が判定しています。Exaは方法論について透明であり、それは評価できますし、競合他社の数値も公開されているものは報告しています。しかしベンダーのベンチマークは構造上ベンダーに有利になるので、公平な立場は「印象的で、もっともらしく、未検証」です。コミュニティ側では、公開時にXで大きく盛り上がりましたが、実際に使った証拠というよりは主に期待先行でした。
"So perplexity is dead 2x now"
この返信はExaの公開投稿への返信の最上位になり、投稿自体も約2,000件のいいねを集めました。何人かの実務者は「今試している」とコメントしており、公開から2日たった時点の独立した検証はおおむねその程度です。本当にまだ早い段階なので、リーダーボードを確定したものとして扱う前に、外部のテストを待つつもりです。
Exa Agent Ultraの料金
Exaは従量課金でシート課金はなく、Agentの労力レベルがそのまま価格に対応します。固定レベルは1リクエストあたりの価格が予測でき、Ultraだけが従量計測の例外です。
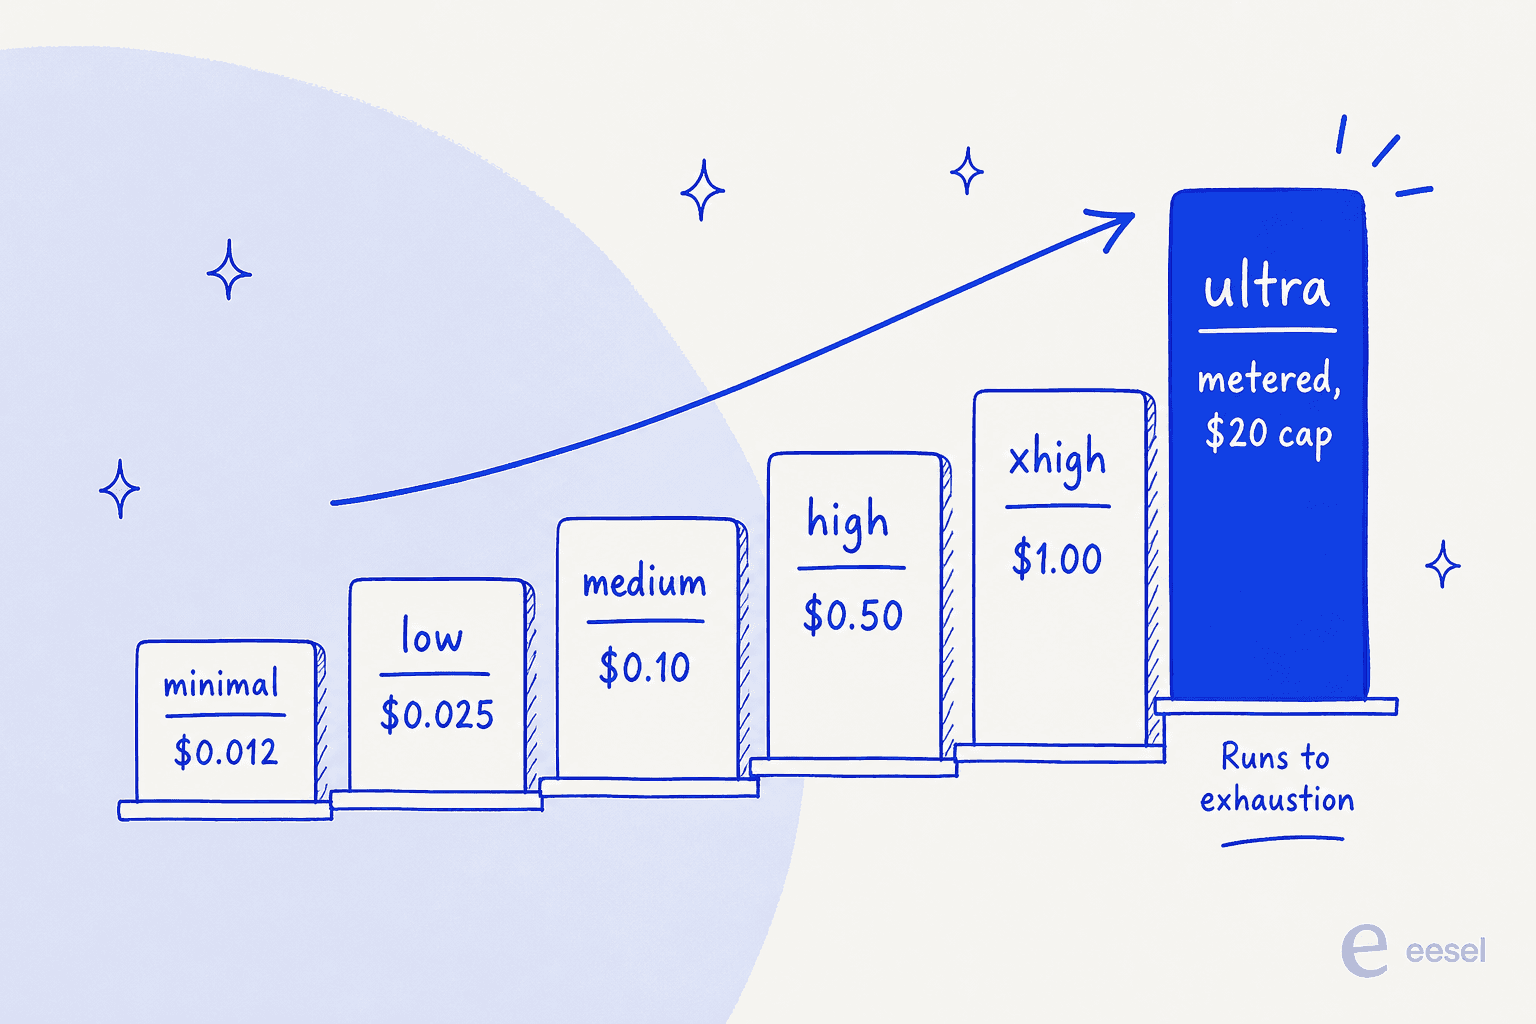
| 労力レベル | 価格 | 最適な用途 |
|---|---|---|
| minimal | $0.012 / リクエスト | 軽い検索、最低コスト |
| low | $0.025 / リクエスト | 単純で範囲の狭い事実確認タスク |
| medium | $0.10 / リクエスト | デフォルトの出発点 |
| high | $0.50 / リクエスト | より難しいリサーチ、より厳密な網羅性 |
| xhigh | $1.00 / リクエスト | 高価値のタスク、検証重視 |
| ultra | 従量計測、デフォルト上限$20 | 網羅的なリスト作成とリサーチ |
従量計測される実行の内訳として、ExaはAgent Compute Unitsを1ユニット0.10ドル、検索ツール呼び出しを0.005ドル、メールの拡充を0.02ドル、電話番号の拡充を0.07ドルで請求します。budget.maxCostDollarsパラメータはautoとultraの実行の上限を設定し、1ドルから100ドルまで指定でき、budget.maxDurationSecondsでは実行時間を5分から3時間まで制限できます。早く終わった実行は上限より安くなり、途中で止めて、それまでに見つかった結果を残すこともできます。
デフォルト上限の20ドルは、じっくり考えるべき数字です。本当に網羅的な市場マップであれば、人が丸一日かかるリサーチタスクに20ドルは破格です。何百回も実行されるワークフローでは、同じ上限でも実際のお金になり、だからこそExaは予算のダイヤルを用意しています。クレジットカード不要で月10ドル分のクレジットが付く無料のStarterティアもあるので、本格的に導入する前に自分のタスクで試せます。
位置づけ:リサーチ用インフラであり、サポート担当の採用ではない
ここが最も伝えたい部分です。「あなたの代わりにリサーチするAI」という見せ方は、誤った思い込みを招きやすいからです。Exa Agent Ultraはインフラです。リードを拡充するGTMパイプライン、市場をマッピングするデューデリジェンスのワークフロー、自分で構築するリサーチエージェントには素晴らしいエンジンです。どの場合でも、コードを書き、スキーマを定義し、APIを取り巻くワークフローを自分で持つことになります。
これは、サポートキューにAIを置く仕事とはまったく別物で、その違いにチームは何度もつまずいています。
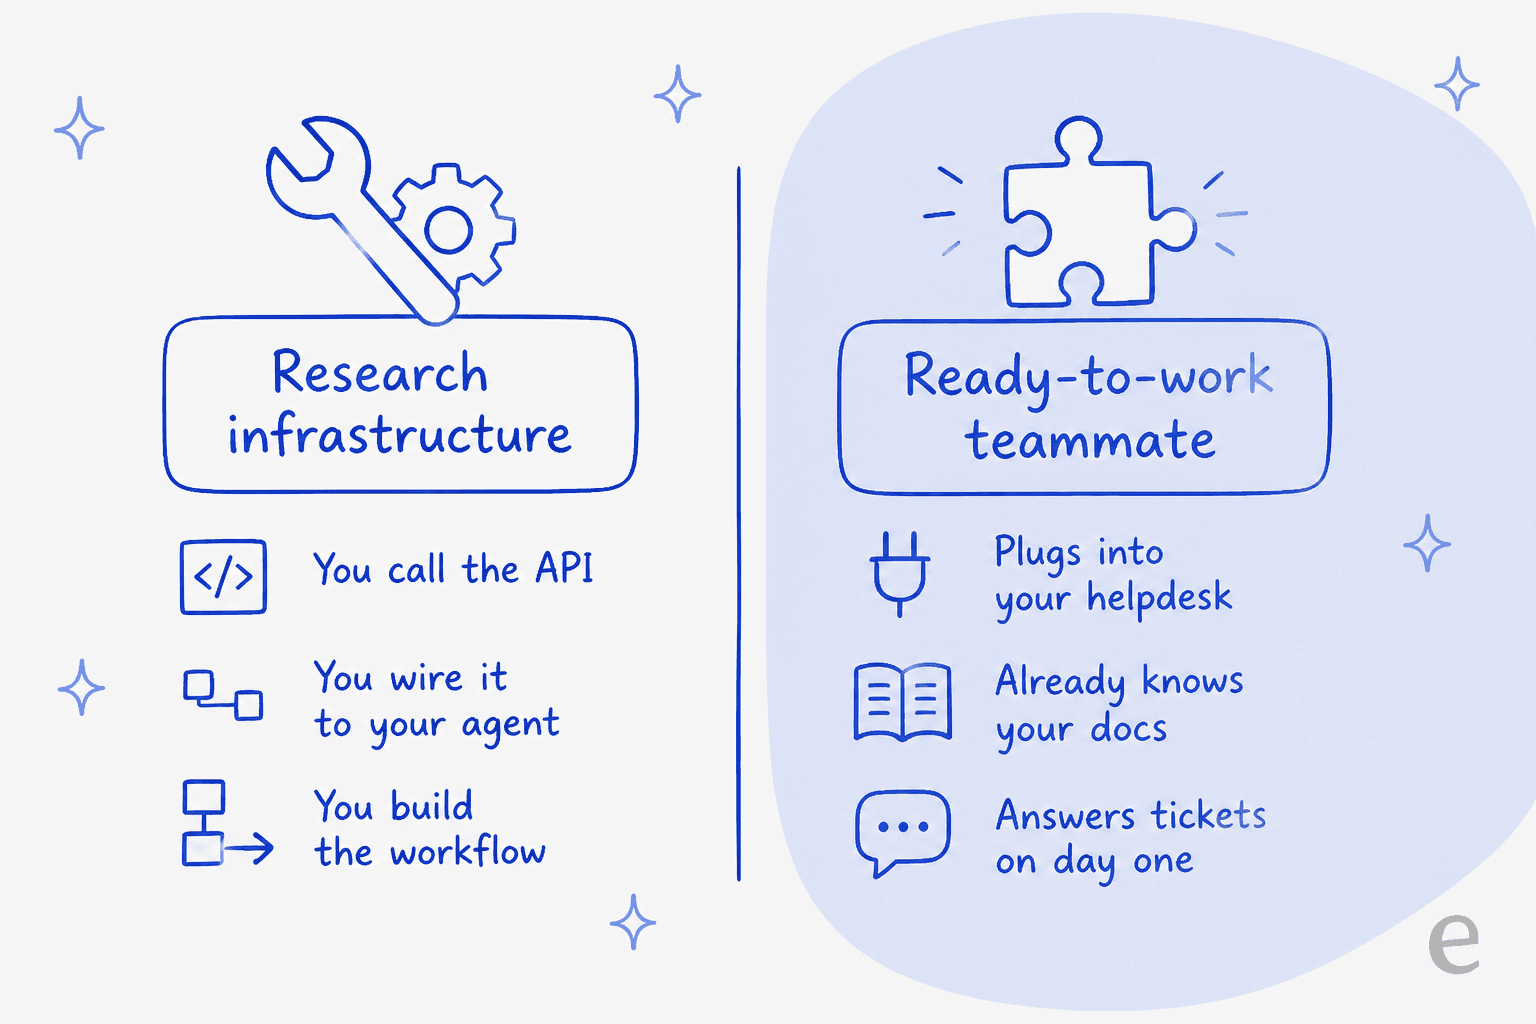
私はeeselでプロダクトを担当しており、何千もの実際のチケットと顧客への導入を通じて、何年も実際のサポートキューにAIを載せてきました。そこで得た教訓は、サポート自動化で難しいのは素の検索品質ではないということです。難しいのは、信頼、チケットの連携、社内ナレッジへの根拠づけ、そして人に引き継ぐタイミングを知ることです。リサーチAPIは、どれほど優れていても、これらを最初から提供してはくれません。ヘルプデスクとの接続、エスカレーションのロジック、安全性のチェックを、その上に自分で構築することになります。
これがインフラとチームメイトの境界線であり、私たちがeeselをAPIではなくAIチームメイトのプラットフォームと考える理由です。決まった仕事のためにチームメイトを迎えれば、すぐに働ける状態で現れます。
eeselを試す
本当に必要なのがリサーチのパイプラインではなくサポートなら、まさにそのために作られているのがeesel AIエージェントです。Zendesk、Freshdesk、Gorgiasに接続し、過去のチケットとヘルプドキュメントから学習して、初日から返信の下書きや送信を行います。API連携のための接続コードは不要です。そして、自信満々のボットが自信満々に間違えることもあるため、すべての導入はまず過去のチケットでシミュレーションされ、顧客の目に触れる前に解決率を確認できます。
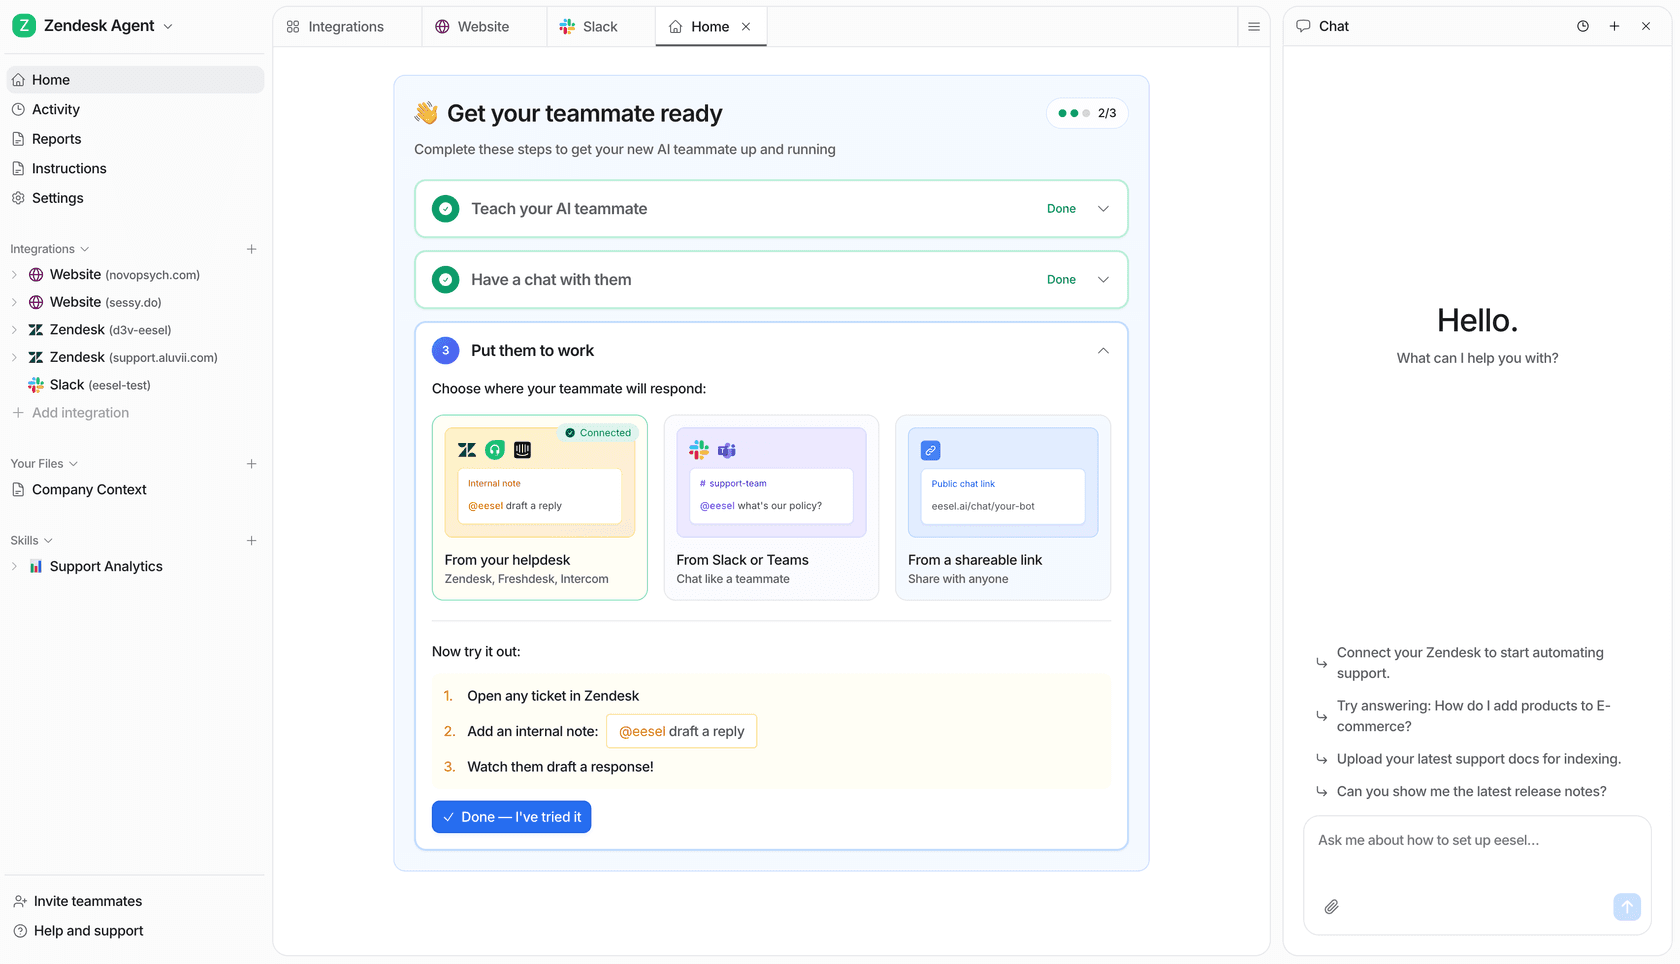
ターミナルやコーディングエージェントからExaを操作するという発想が気に入ったなら、eeselもそこで対応します。eesel CLIはダッシュボードと同じチームメイトとワークスペースを操作し、JSONを出力するので、人が手で実行することも、スクリプトで自動化することも、Claude Code、Codex、Cursorのようなコーディングエージェントが直接操作することもできます。チームメイトの指示を確認し、架空のテストプロンプトを送り、正確な回答と使われたソースを確認したうえで、担当者が承認できるよう的を絞った指示の変更を提案できます。これは、ExaのようなAPIに人々が惹かれる、エージェントに優しいヘッドレスな操作性と同じものを、リサーチスタックの組み立てではなく、サポート運用という本来の仕事に向けたものです。eeselを無料で試して、ご自身のチケットで動作を確かめられます。
よくある質問
Exa Agent Ultraとは何ですか?
Exa Agent Ultraは、Exa Agent APIの最も高い労力レベルです。1件のリクエストを並列のサブエージェントに分割し、何千ものソースを読み込んで、出典付きの構造化された結果を返すディープリサーチ用エンドポイントです。手早い検索ではなく、網羅的なリスト作成やエンティティの拡充を目的に作られています。この種のリサーチを、生のAPI呼び出しではなくサポート用のAIエージェントとして使いたい場合は、別の製品カテゴリになります。
Agent Ultraは他のExaの労力レベルとどう違いますか?
Exa Agentでは労力は1つのダイヤルです。minimal、low、medium、high、xhigh、auto、ultraの順になっています。固定レベルは1リクエストあたりの価格が決まっていますが、ultraは従量課金で、タスクを使い尽くすまで実行します。ダイヤルを上げるほど、1タスクあたりのコストが上がる代わりに、サブエージェント、ソース、検証が増えます。
Exa Agent Ultraはカスタマーサポートに向いていますか?
これは情報検索のインフラなので、ウェブで出典付きのリサーチを集めるのには優れていますが、ヘルプデスクに参加したり、社内ドキュメントを学習したり、自分から返信を送ったりはしません。一次対応のサポートには、チケットキューに接続して自社の知識で回答するチームメイトが必要で、それがeesel AIエージェントの役割です。
Exa Agent Ultraのベンチマーク結果はどうでしたか?
Exaによると、Agent Ultraは4つのリサーチ系ベンチマークでOpus 5.5、GPT-6 Astra、Perplexity Agentを上回りました。WANDRのソフトリコールは81.4%、DeepSearchQAのF1は93.9%、WideSearchの行レベルF1は58.9%、Find-All Companyでは1タスクあたり平均2,451件のエンティティが合格しました。これらはExa自身のベンチマーク実行なので、独立したテストが出るまではベンダーの数値として扱ってください。導入するAIエージェントでは、リーダーボードよりも自社のデータで試すことのほうが重要です。


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.