

多くのチームにとってのGemini 4 Carbon代替の最良は、CarbonのベースモデルであるGemini 4 Argonです。今日からAPIで同じ導入価格の$2/$10で使え、Artificial Analysisでの作り話の割合はCarbonの11%に対して4%でした。Carbon自体はGoogleのFairwind Programを通じてサイバー防御担当者に限定されており、それ以外の人への提供日は未定です。
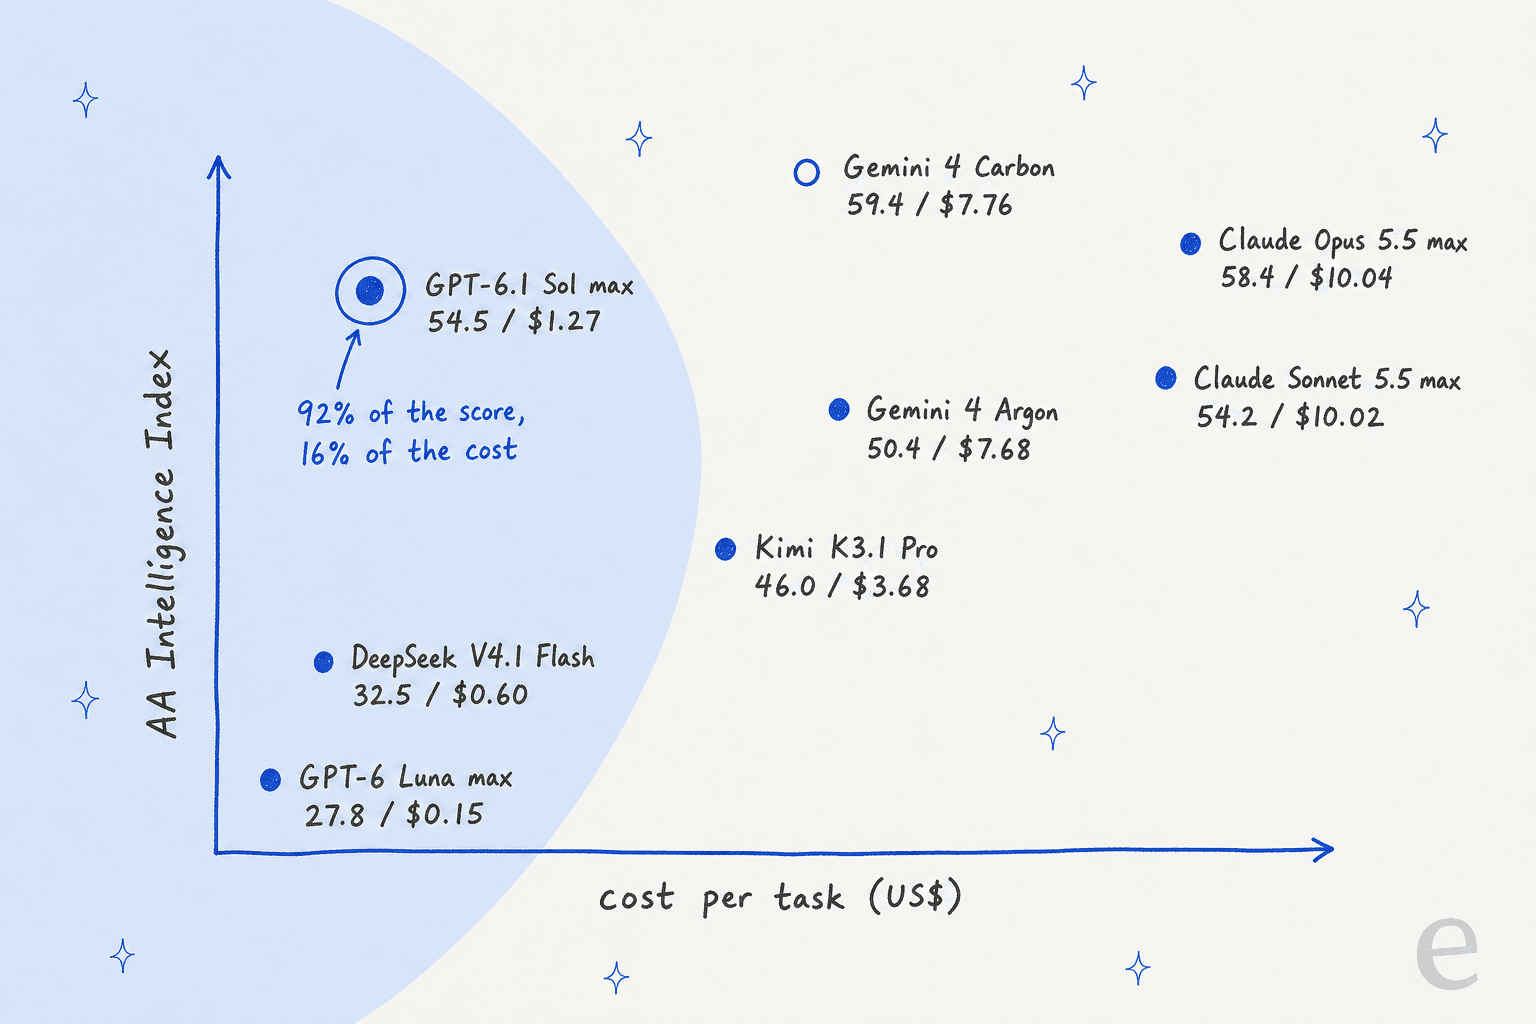
スコア目当てでCarbonを求めていたなら、GPT-6.1 Solは最大の推論負荷でCarbonのインデックススコアの92%を、タスクあたりコストの16%で達成します($1.27対$7.76)。Claude Opus 5.5は素のスコアで最も近い(58.4)ものの、タスクあたりでは最も高額です。Kimi K3.1 Pro、DeepSeek V4.1 Flash、GPT-6 Lunaは、長いコンテキスト、オープンウェイト、安価なトリアージをカバーします。
サポートエージェント用にCarbonを検討していたなら、モデルよりも、何を読ませるかの方が重要です。私はeeselの裏側の連携を作っていて、AIヘルプデスクチームメイトがこれらのどのモデルでも、ヘルプセンターと過去のチケットから回答します。SamCartは、Freshdeskのチケット用とWebサイトのチャット用に1つずつエージェントを動かし、280本のヘルプ記事から回答しています。
なぜGemini 4 Carbonの代替を探す人が多いのか?
ほとんど誰も使えないからです。GoogleはGemini 4 Carbonを発表し、2026年10月28日に、"starting this week"で一部のサイバー防御担当者に提供し、その後、信頼できるパートナーへ徐々に広げ、開発者、企業、一般ユーザーは"coming soon"に分類されていると述べました。この最後のグループについては日付がありません。
この関門はFairwind Programを通ります。Googleはこれを、優先度の高い防御担当者、"like governments, healthcare providers, and telecommunications services"向けの早期アクセスだと説明しています。650を超えるパートナーと連携し、申し込んだ組織の身元調査を行います。サポートチームやSaaSプロダクトを運営しているなら、少なくとも今は対象外です。
Carbonは強力なので、少し残念です。Artificial Analysis Intelligence Indexで59.4とトップを走り、Google自身のベンチマーク表の17行すべてでArgonを上回り、価格はArgonと同じ、入力100万トークンあたり$2、出力$10で、導入期間後は$4/$20です。すべてはGemini 4 Carbon解説記事で見てきました。
発表時のHacker Newsのスレッド(735ポイント)は、空気をよく捉えていました。
"I can't tell if they're withholding access to manufacture some sense of scarcity but the delays are really prolonged."

Argonの前例は、少しだけ助けになります。Argonは9月30日に発表され、10月13日、約2週間後にリリースされました。あるHacker Newsのコメント投稿者が指摘したとおりです。ただしArgonはセキュリティプログラムに限定されたことがないので、Carbonが同じスケジュールをたどると見込んでプロダクトのローンチを計画することはおすすめしません。
これらの代替をどう選んだか
購入者が最初に取る行動から始めました。ChatGPTに、新しいチャットで、Carbonがサイバー専用になった今、AIサポートエージェント向けの最良の代替を尋ねました。GPT-6.1 Sol、Gemini 4 Argon、Claude Sonnet 5.5、GPT-6 Lunaを候補に挙げ、安価なモデルがトリアージし、強いモデルが難しいケースを引き受ける2モデル構成を提案しました。4つともこのリストに入っており、このルーティングの考え方が最後のセクションの土台になっています。
次に、Carbonと同じベンチマークで競合するモデルを加え、2026年10月29日にすべての価格をベンダー自身の料金ページで確認しました。スコアのデータはArtificial Analysisによるもので、Carbon、Argon、その他を同じインデックスでリスト価格にて走らせています。モデルごとに3つの数字を取りました。
- Intelligence Index v5.0、Carbonがトップの見出しスコア。
- タスクあたりコスト、インデックスの1タスクがリスト価格で実際にいくらかかったか。推論トークンもすべて含みます。安い料金表が実際に安いかどうかが分かる数字です。
- AA-Omniscienceでのハルシネーション率:知らないと答えるべきときに、誤った回答をする頻度。顧客に向き合うものでは、私が最も重視する数字です。
eeselは長年、実際のサポートキューにAIエージェントを置いてきましたが、自信ありげなボットが静かに誤った回答をする場面を見てきました。だからこそ、eeselのすべての導入は、実際の顧客に回答する前にチームの過去のチケットで検証され、ここでもハルシネーションの列を見出しスコアと同じだけ重視しています。
Gemini 4 Carbonの代替を一覧で
リスト全体を1つの表にまとめました。価格は2026年10月29日時点の標準APIレートで、100万トークンあたりです。AAの数字は、特記がない限り各モデルの最高の推論負荷設定で、リスト価格です。
| モデル | 今日使える? | 入力 / 出力(100万あたり) | キャッシュ入力 | AA Index v5.0 | AAタスクあたりコスト | 作り話の割合 | コンテキストウィンドウ | オープンウェイト | 最適な用途 |
|---|---|---|---|---|---|---|---|---|---|
| Gemini 4 Carbon(基準) | サイバー防御担当者のみ | $2 / $10 導入価格、その後$4 / $20 | 入力95%オフ | 59.4 | $7.76 | 11% | 1M | いいえ | セキュリティとコーディング(アクセスできれば) |
| Gemini 4 Argon | はい、Gemini API | $2 / $10(11月30日まで)、その後$4 / $20 | $0.10、その後$0.20 | 50.4 | $7.68 | 4% | 1,048,576 | いいえ | 作り話が最少 |
| GPT-6.1 Sol | はい、OpenAI API | $2 / $10 | $0.10 | 54.5 | $1.27 | 52% | 1,050,000 | いいえ | ドルあたりスコアが最高 |
| Claude Opus 5.5 | はい、Claude API | $4 / $20 | $0.20 | 58.4 | $10.04 | 50% | 1M | いいえ | 素のスコアが最も近い |
| Claude Sonnet 5.5 | はい、Claude API | $2 / $10 | $0.10 | 54.2 | $10.02 | 43% | 1M | いいえ | 文章の質、ツール利用 |
| Kimi K3.1 Pro | はい、Kimi API | $2 / $10 | $0.20 | 46.0 | $3.68 | 37% | 1,048,576 | まだ | 長いコンテキスト、エージェント作業 |
| DeepSeek V4.1 Flash | はい、DeepSeek API | オフピーク$0.15 / $0.60、ピーク$0.30 / $1.20 | オフピーク$0.003 | 32.5 | $0.60 | 64% | 1M | はい | セルフホスティング、最安の請求額 |
| GPT-6 Luna | はい、OpenAI API | $0.10 / $0.50 | $0.01 | 27.8 | $0.15 | 79% | 1,050,000 | いいえ | 安価なトリアージとルーティング |
目を引くことが2つあります。1つ目は、これらのうち5つのモデルがCarbonと同じ$2/$10の料金表を共有しているため、トークン価格では差がつかないことです。差がつくのはタスクあたりコストで、各モデルが考えるのにどれだけトークンを消費するかを反映しています。2つ目は、作り話の割合の列が4%から79%まで開いていて、インデックススコアの差よりずっと大きいことです。
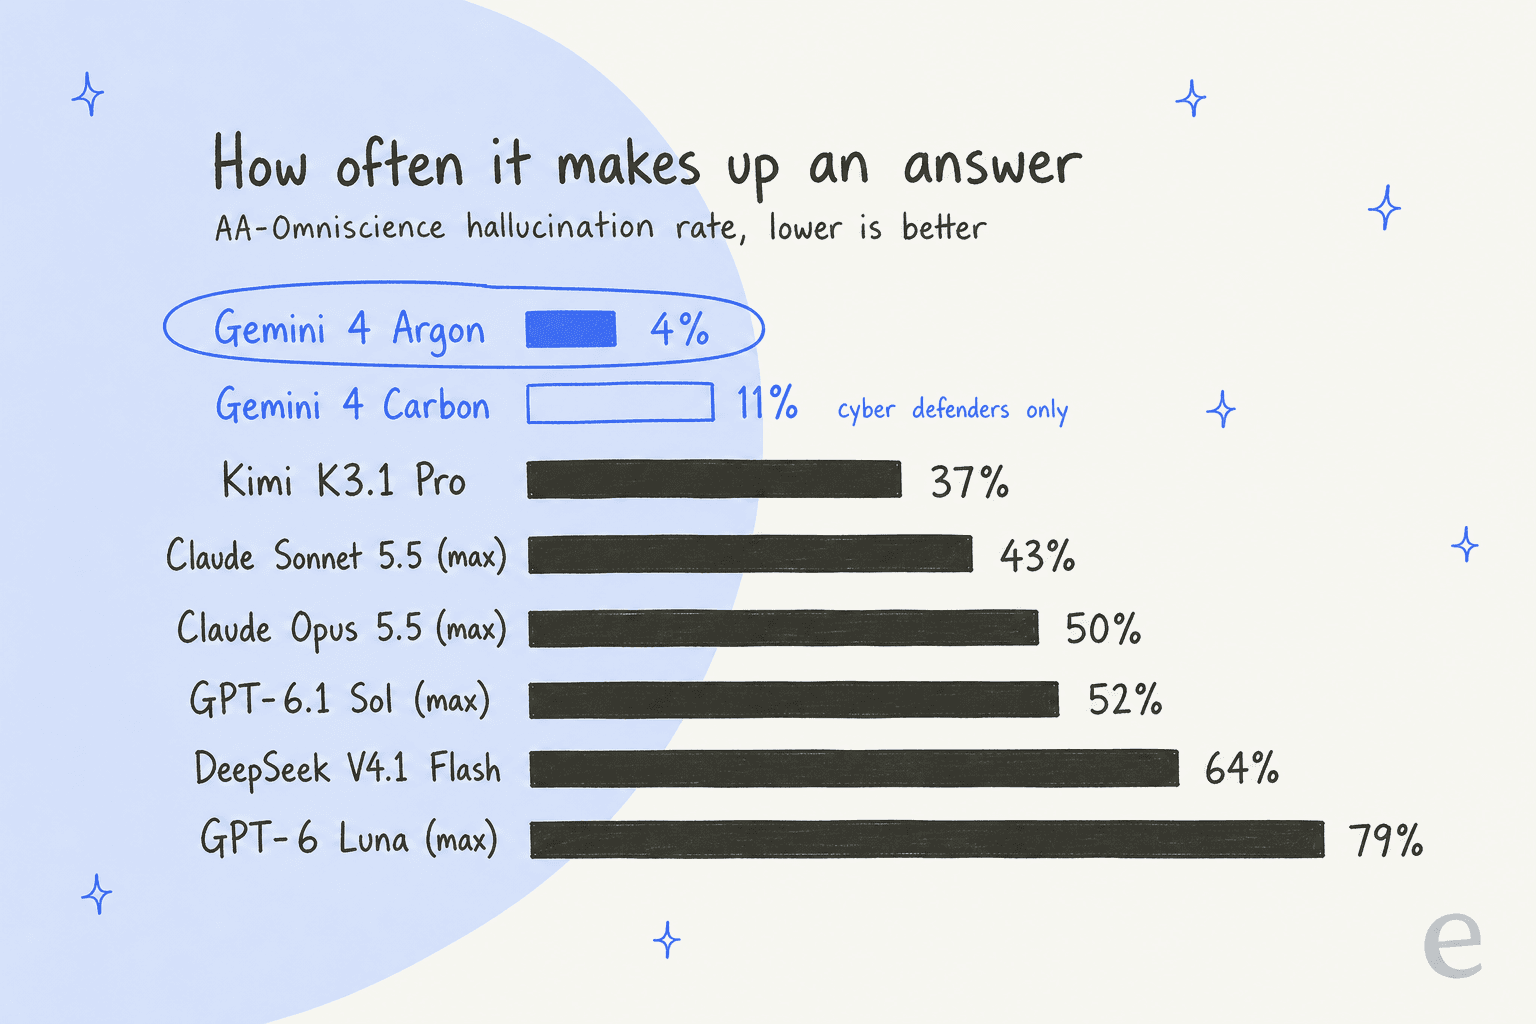
このグラフが、私の最初の推薦がスコアが最も近いモデルではない理由です。Googleが「知らないことについてより正直」だと言うことにCarbonの魅力を感じていたなら、まさにそのテストでArgonはすでに先を行っています。
1. Gemini 4 Argon
**最適な用途:**顧客向けエージェントにCarbonを求めていて、高いスコアよりも作り話の少なさを必要とするチーム。
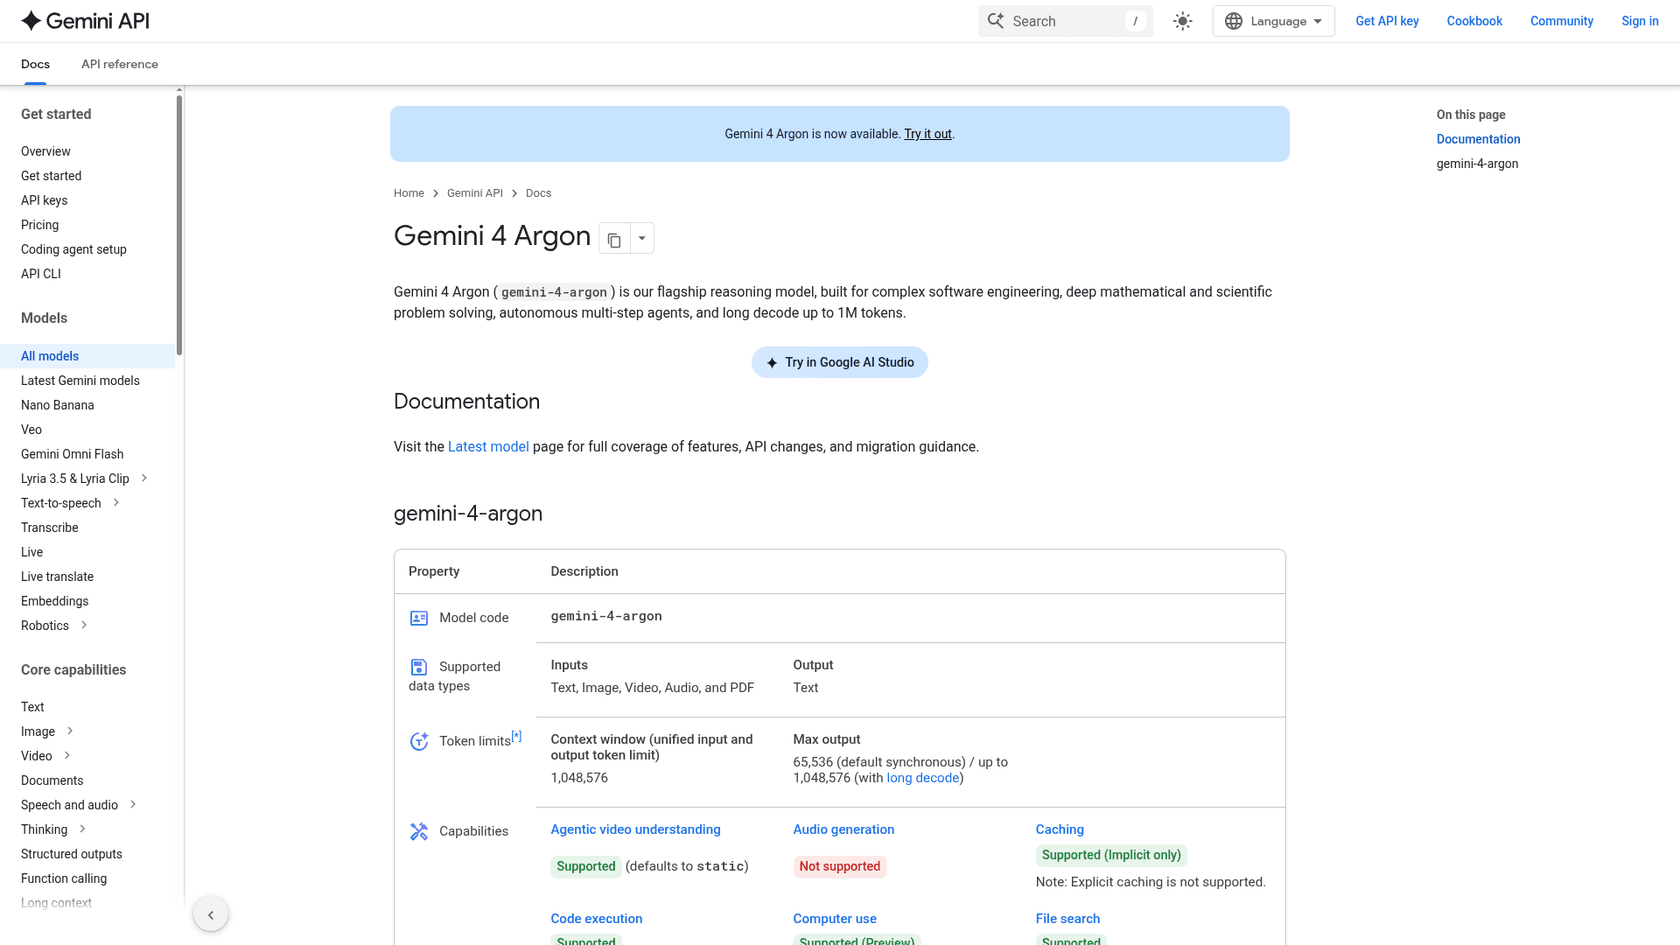
ArgonはCarbonのベースになっているモデルなので、最初に当たるのが当然です。Gemini APIとGoogle AI Studioで一般提供されており、コンテキストウィンドウは1,048,576トークン、long decodeで最大1Mの出力トークンです。すでにコードでGeminiを呼んでいるなら、後でCarbonに切り替えるのはモデル名の変更だけです。
Artificial AnalysisでArgonのスコアは50.4、Carbonは59.4なので、Carbonの方が賢いモデルです。しかしArgonのハルシネーション率は4%で、Carbonの11%より低く、私が確認した中で最低です。AutomationBench(複数ステップの業務ワークフロー)ではArgonが77.5%、Carbonが77.8%でした。Argonはインデックス1タスクあたりのコストも少し安い($7.68対$7.76)です。サポートエージェントにとって、実際に重要な差はかなり小さいです。
"For what it's worth: Argon is a pretty good model, and this is coming from someone who just sticks with Opus 5.5 mostly across the board. For the current introductory price, it provides an exceptional value."
長所
- Carbonと同じ料金表なので、Carbonが開放されてもコストモデルは変わりません。
- このリストで、大差をつけて作り話の割合が最低です。
- Google Searchグラウンディングには、月5,000件の無料リクエストが含まれます。
短所
- 長く考えるタイプです。AAの1タスクあたり出力116Kトークンで、スコアの割にタスクあたりの請求額が高くなります。
- 暗黙的キャッシュのみです。Claudeのようにキャッシュを明示的に固定することはできません。
- 全員が評価しているわけではありません。あるHacker Newsユーザーは、現行のClaudeやSolのモデルより"a clear tier below"だと述べました。
料金
| ティア(100万トークンあたり) | 入力 | 出力 | キャッシュ入力 |
|---|---|---|---|
| 標準、2026年11月30日まで | $2.00 | $10.00 | $0.10 |
| 標準、2026年12月1日から | $4.00 | $20.00 | $0.20 |
| BatchまたはFlex、11月30日まで | $1.00 | $5.00 | $0.05 |
| Priority、11月30日まで | $3.60 | $18.00 | $0.18 |
検索グラウンディングは月5,000件まで無料、その後は1,000件あたり$14です(Googleの料金ページより)。Argonに無料枠はありません。12月の価格改定についてはGemini 4 Argonの価格の記事で説明しています。
**私の見解:**顧客に回答するものを作るなら、ここから始めてください。12月1日の価格2倍化を予算に組み込み、主にスピードとコストが必要ならSolを検討してください。ほかの選択肢はGemini 4 Argon代替のまとめで扱いました。
2. GPT-6.1 Sol
**最適な用途:**Carbonの知能は欲しいが請求額を気にするチーム。
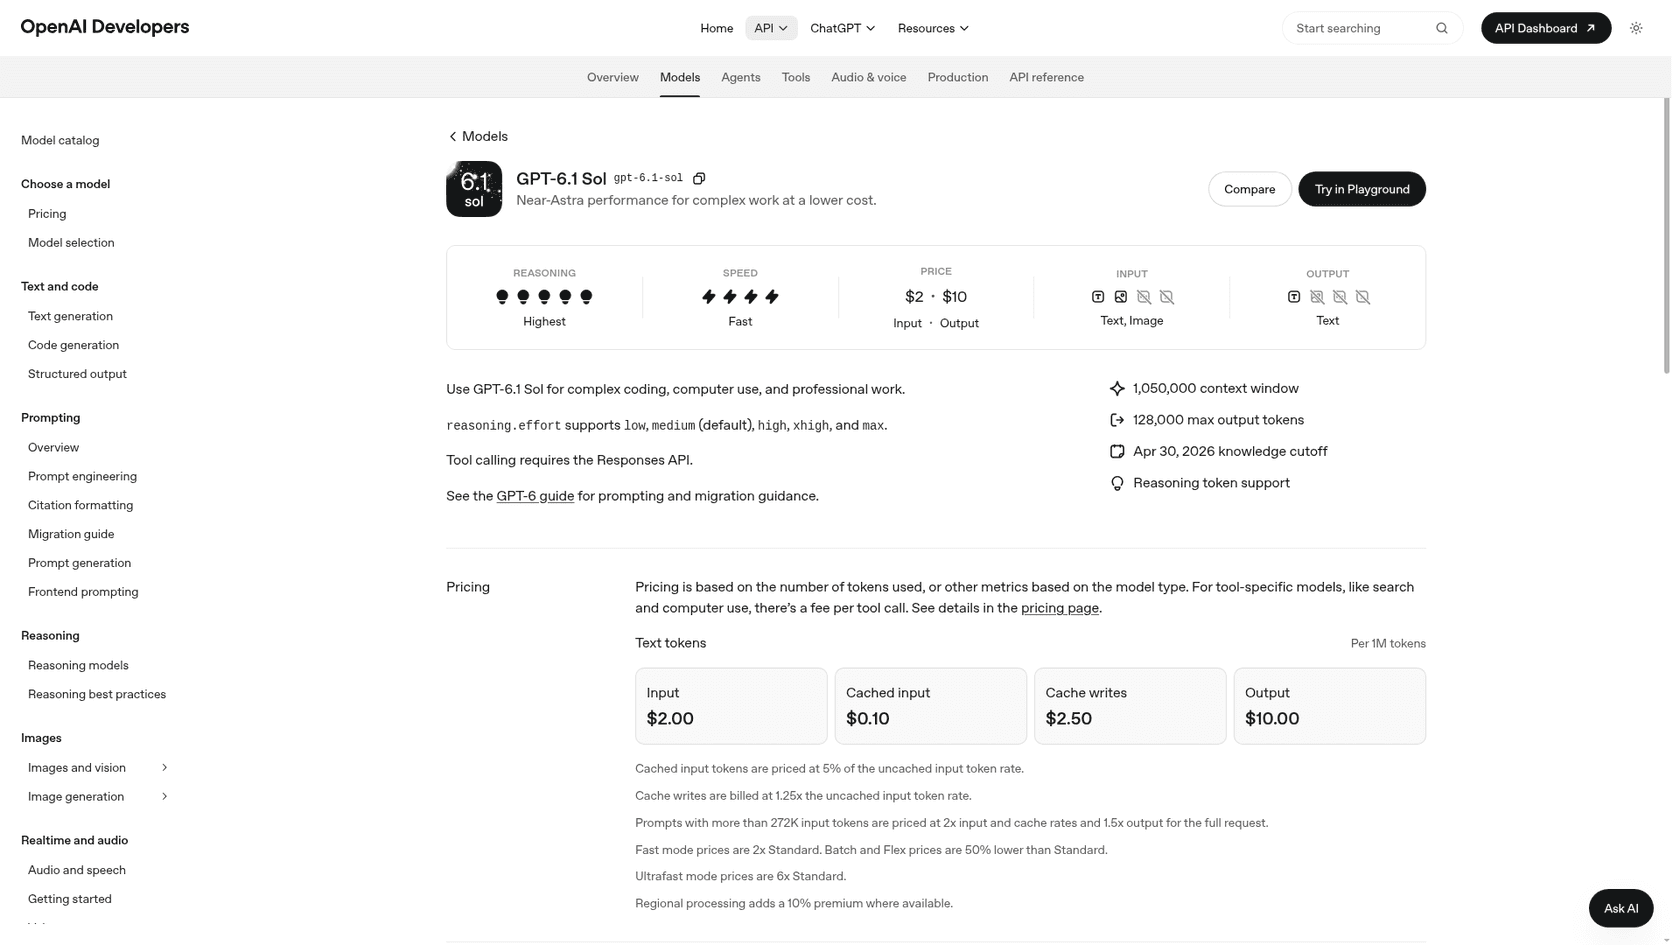
SolはChatGPTがサポートエージェント向けに最初に挙げたモデルで、数字もそれを裏付けています。OpenAIのモデルページは、"Near-Astra performance for complex work at a lower cost"と説明しており、コンテキストウィンドウは1,050,000トークン、推論負荷はlowからmaxです。
最大の推論負荷で、SolはArtificial Analysisインデックスで54.5、タスクあたり$1.27で、Carbonの$7.76に対してです。Carbonのスコアの92%を、コストの16%で達成します。xhighでは52.3で$0.76、mediumでは46.1で$0.36で、私ならサポートエージェントはこの設定から始めます。
長所
- このリストで、ドルあたりのスコアが最高です。
- 推論負荷が5段階あるので、1つのモデルで安価なチケットも難しいチケットもカバーできます。
- 待てるものはBatch価格で請求額が半分の$1/$5になります。
短所
- 最大の推論負荷でAA-Omniscienceの作り話の割合が52%でした。自社コンテンツに基づかせる必要があります。
- ツール呼び出しにはResponses APIが必要なので、古いChat Completionsのコードは移行が必要です。
- 入力トークンが272Kを超えるプロンプトは、入力が2倍、出力が1.5倍で課金されます。
料金
| モード(100万トークンあたり) | 入力 | 出力 | キャッシュ入力 |
|---|---|---|---|
| 標準 | $2.00 | $10.00 | $0.10 |
| Batch / Flex | $1.00 | $5.00 | $0.05 |
| Fast | $4.00 | $20.00 | $0.20 |
| Ultrafast | $12.00 | $60.00 | $0.60 |
価格はOpenAIの料金ページによります。GPT-6.1 Solの価格ガイドに計算例があります。
**私の見解:**Googleに残る理由がなければ、デフォルトの選択です。ただし、顧客への回答を記憶に頼らせないでください。GPT-6.1 Solレビューで、つまずく点を扱っています。
3. Claude Opus 5.5
**最適な用途:**Carbonのスコアに最も近いものが欲しく、そのために支払う意思があるチーム。
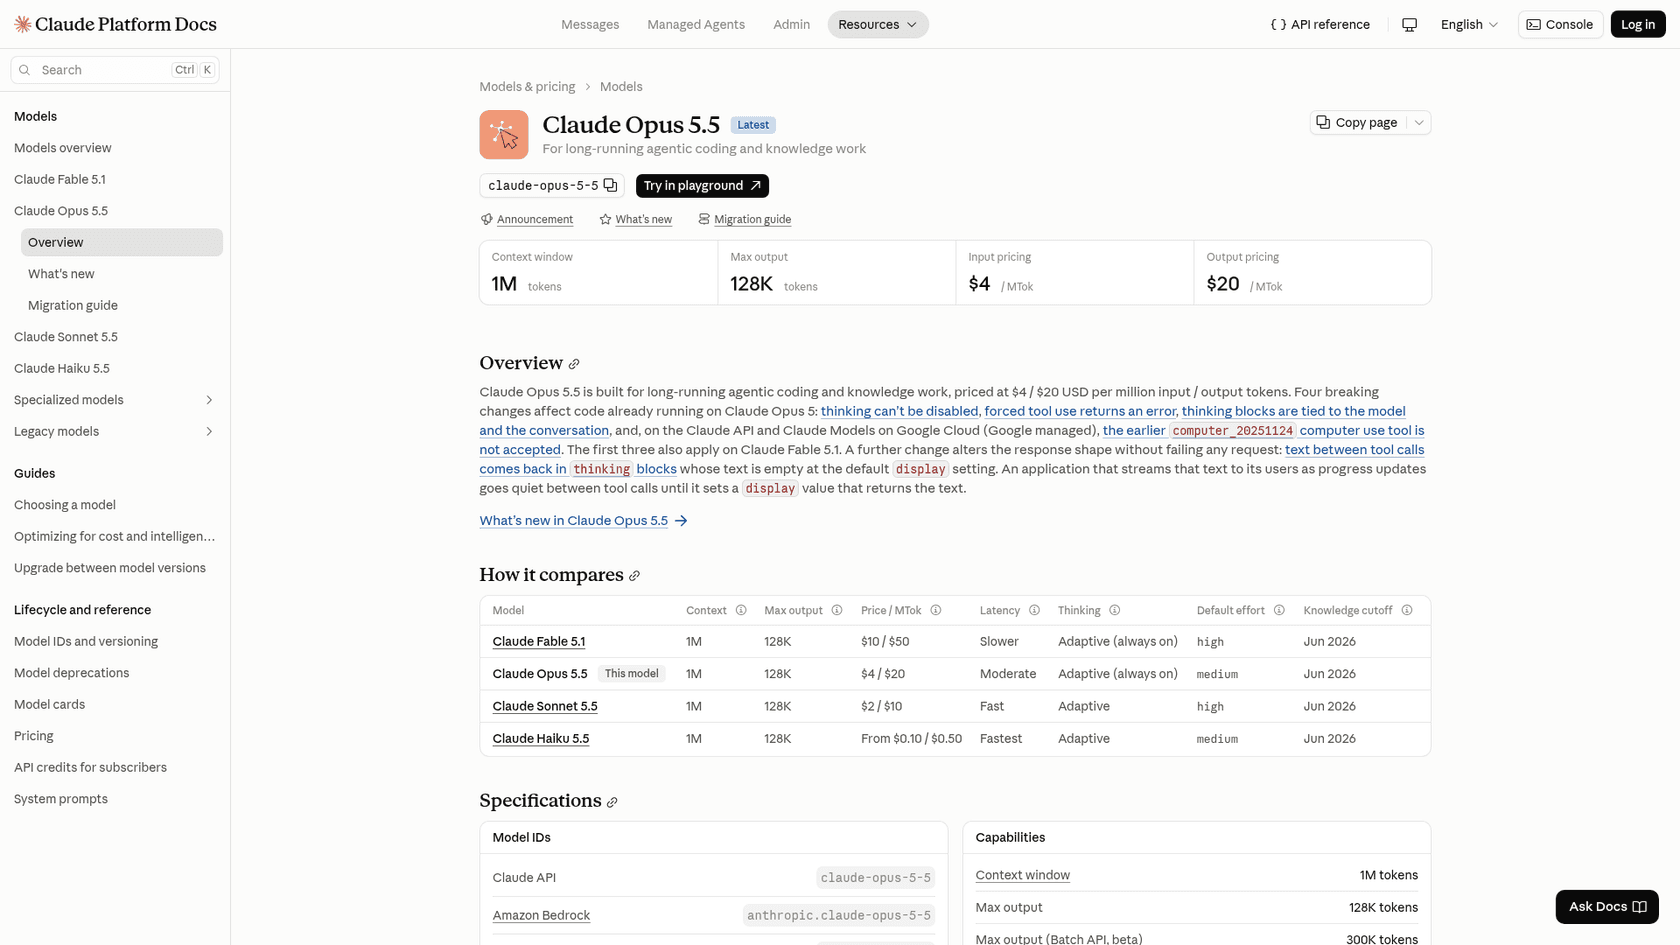
Opus 5.5は、Carbonがかろうじて上回ったモデルです。Artificial Analysisでは最大の推論負荷で58.4、Carbonの59.4に1ポイント差で、Google自身の表ではコンピューター操作のOSWorld-2.1で87.2%対Carbonの81.5%と、今もリードしています。Anthropicはこれを"long-running agentic coding and knowledge work"向けに位置づけています。
お金の面での落とし穴は請求額です。最大の推論負荷ではAAの1タスクが$10.04かかり、このリストで最高です。xhighの方が良い折衷で、57.0で$6.05、これでもタスクあたりコストではCarbonより安くなります。またAnthropicは、Opus 5.5がOpus 5からAPIの挙動を一部変更した(thinkingは無効化できず、ツールの強制使用はエラーを返す)と述べているので、切り替える前に移行ガイドを確認する価値があります。
"I've found its worse in most tasks, especially when ranked on a cost-per-task metric."
この返信はClaude Fable 5.1とOpus 5.5の比較についてのものですが、ここでAnthropicの推薦がFableではなくOpusである理由をうまく要約しています。
長所
- 実際に購入できるものの中で、Carbonに最も近い素のスコアです。
- プロンプトキャッシュのヒットは入力の5%($100万あたり$0.20)で、通常の10%より安いです。
- セキュリティが業務の一部なら、AnthropicのCyber Verification Programの対象にもなります。
短所
- 最大の推論負荷でタスクあたりコストが最高です($10.04)。
- 最大の推論負荷でAA-Omniscienceの作り話の割合が50%でした。
- Fastモードは$8/$40で、標準の2倍です。
料金
| モード(100万トークンあたり) | 入力 | 出力 | キャッシュ読み取り |
|---|---|---|---|
| 標準 | $4.00 | $20.00 | $0.20 |
| Batch | $2.00 | $10.00 | n/a |
| Fastモード | $8.00 | $40.00 | n/a |
Anthropicの料金ドキュメントより。詳しくはClaude Opus 5.5の価格の記事をご覧ください。
**私の見解:**エージェント型のコーディングや深いリサーチのように、仕事が難しくて長いなら、xhighのOpus 5.5を選んでください。サポートキューにとっては、ほとんどのチケットに必要以上のモデルです。詳細はClaude Opus 5.5レビューにあります。
4. Claude Sonnet 5.5
**最適な用途:**トーンが重要な、顧客向けの文章作成とツール利用。
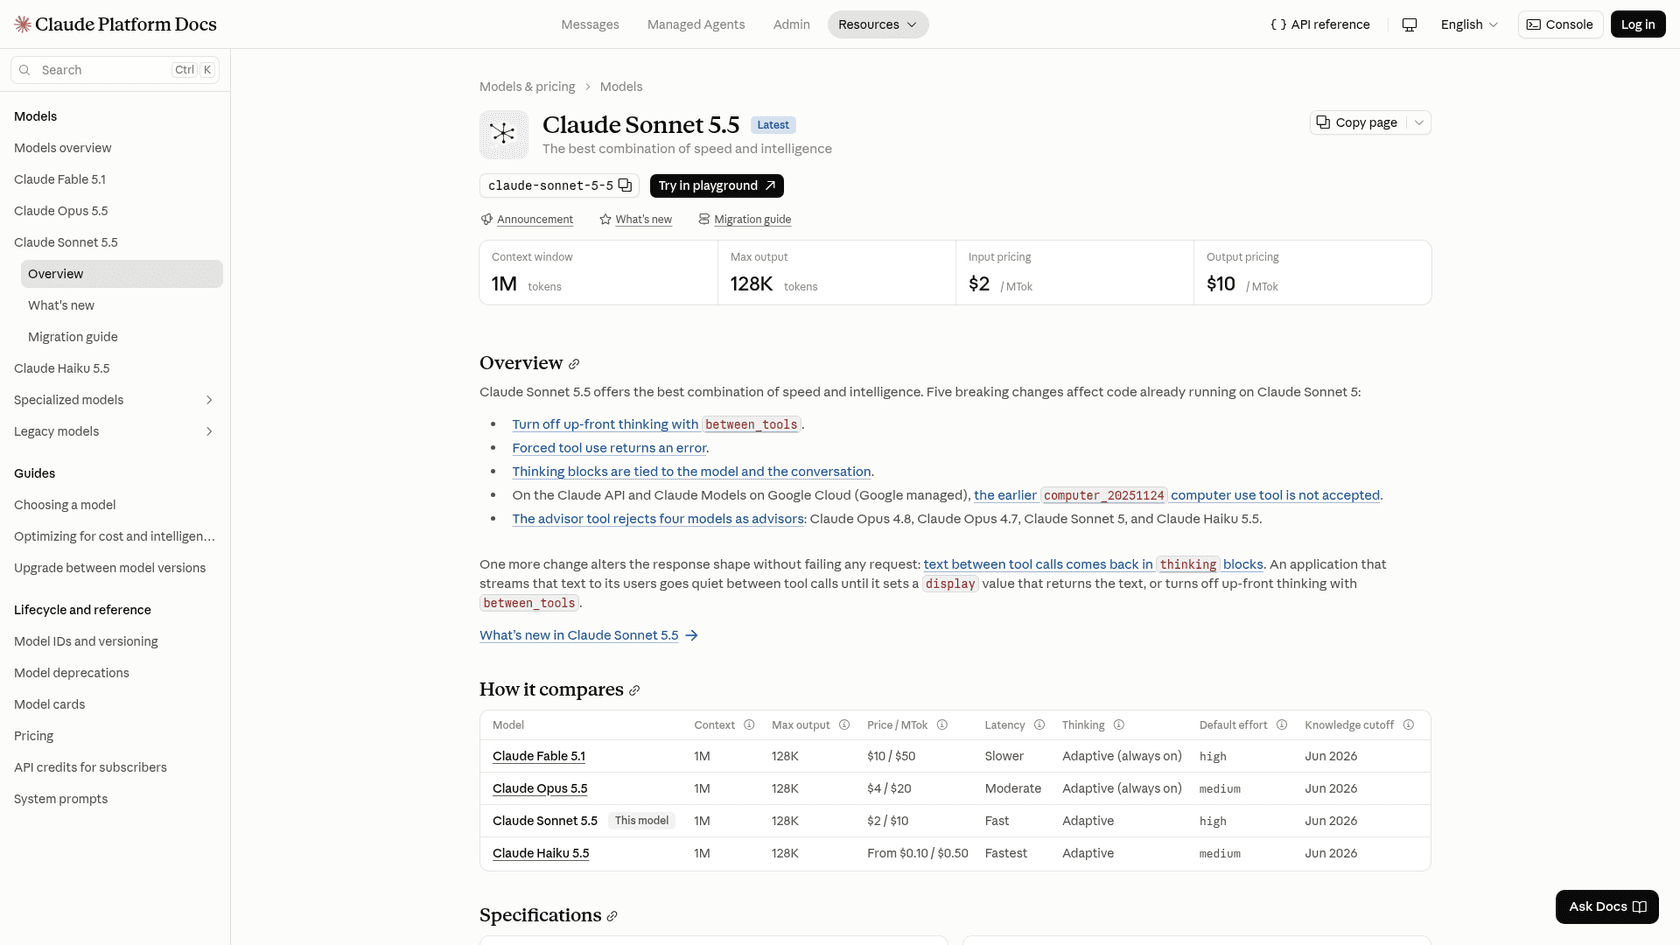
Sonnet 5.5はChatGPTが挙げた3つ目のモデルで、"nuanced, high-quality customer conversations"向けです。Anthropicはラインナップの中で"the best combination of speed and intelligence"と呼び、価格はCarbonの導入価格と同じ$2/$10です。
スコアは推論負荷によって大きく変わります。maxではSonnetはArtificial Analysisで54.2とSolに近いですが、その実行はタスクあたり$10.02かかりました。highでは41.1に下がり、$1.64です。ハルシネーション率は、最大の推論負荷でここにあるAnthropicとOpenAIのフロンティアモデルの中で最良(43%)で、maxでのAutomationBenchのスコア(71.8%)は、2つのGemini 4モデルとKimiにしか負けていません。
長所
- Anthropicの中位モデル:Opus 5.5より速く、トークン価格は半分です。
- キャッシュヒットは100万あたり$0.10、入力の5%です。
- Opusと同じAPIとツールなので、両者の間でルーティングできます。
短所
- maxの推論負荷では、タスクあたりコストがOpus 5.5と同じです。
- maxからhighへのスコア低下が大きいです(54.2から41.1)。
- オープンウェイトはなく、セルフホスティングもできません。
料金
| モード(100万トークンあたり) | 入力 | 出力 | キャッシュ読み取り |
|---|---|---|---|
| 標準 | $2.00 | $10.00 | $0.10 |
| Batch | $1.00 | $5.00 | n/a |
Anthropicの料金ドキュメントより。Claude Sonnet 5.5の価格ガイドで、推論負荷ごとのコストを詳しく説明しています。
**私の見解:**サポート返信向けの堅実なデフォルトで、mediumかhighの推論負荷にグラウンディングを組み合わせて使います。タスクが難しい場合を除き、maxは避けてください。詳しくはClaude Sonnet 5.5レビューをご覧ください。
5. Kimi K3.1 Pro
**最適な用途:**フロンティア並みの料金表での、長いチケット、長いドキュメント、複数ステップのツール作業。
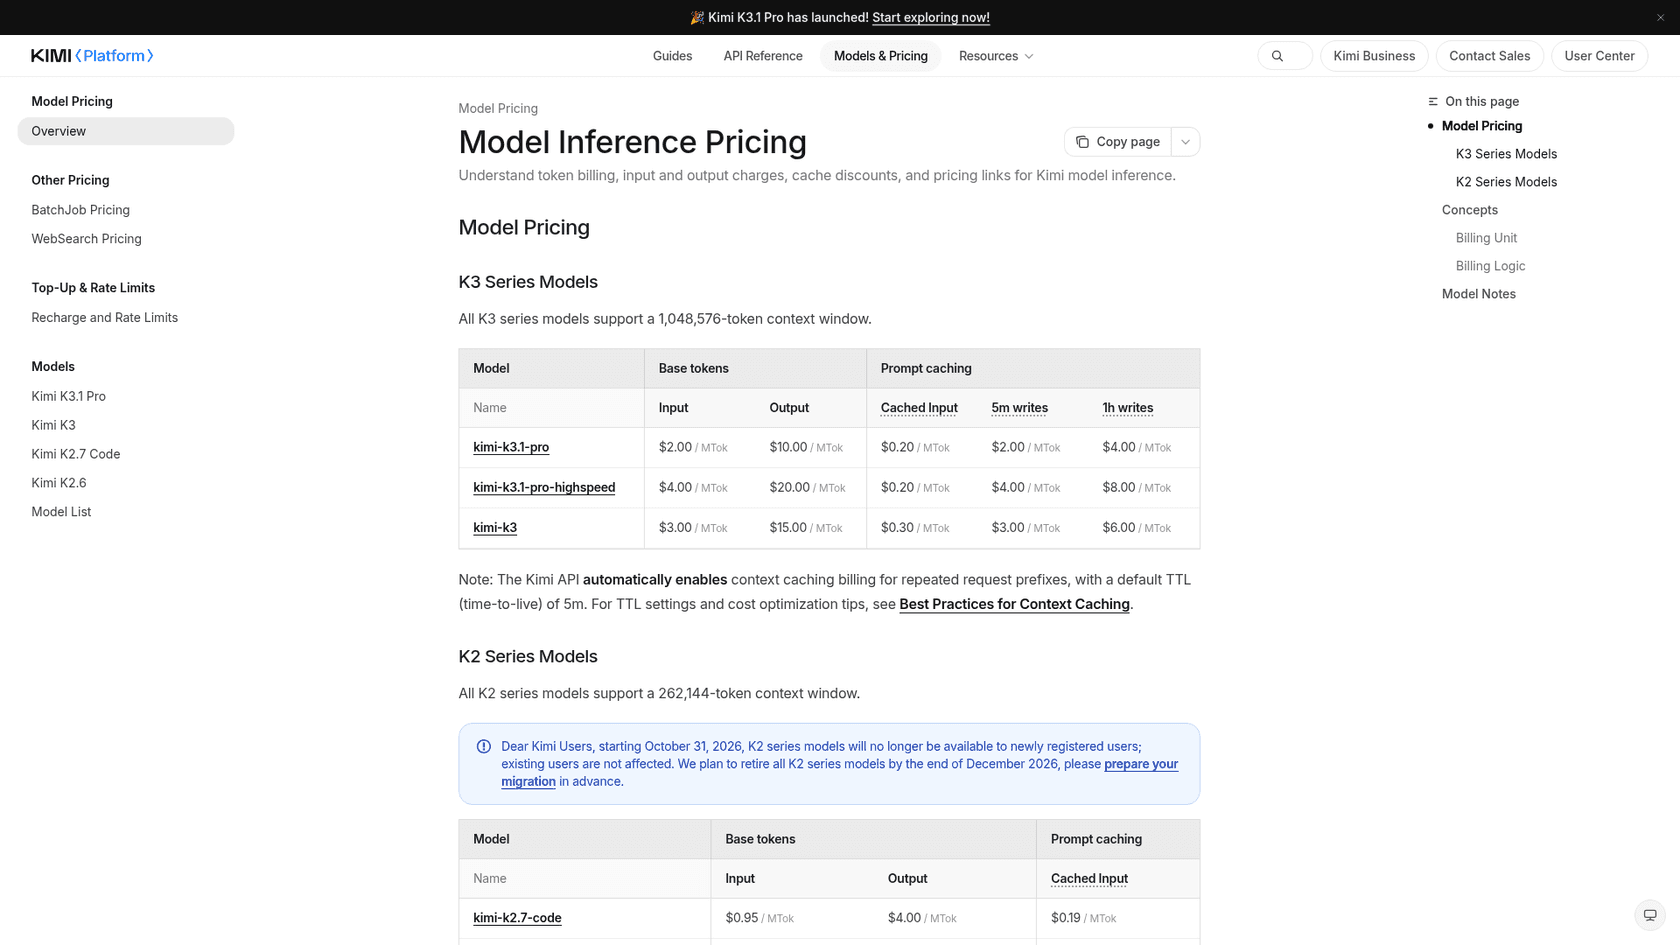
MoonshotのKimi K3.1 Proは、このリストの中では目立たない存在です。Artificial Analysisインデックスのスコアは46.0とほかより低いものの、私の比較で最良の長いコンテキストの推論結果(AAの長いコンテキストテストで86.3%、Carbonは79.3%)と、AutomationBenchで73.3%を記録しました。その37%のハルシネーション率は、Gemini 4ファミリー以外で最低です。
AAの1タスクが$3.68で、Carbonの半分ですが、ここで最も遅く、出力は毎秒約36トークンです。バックグラウンドで返信を下書きするサポートエージェントならこの速度で問題ありませんが、ライブチャットには向きません。
長所
- グループで最良の長いコンテキストのスコアです。
- 購入できるモデルの中で、作り話の割合が2番目に低いです。
- Carbonの導入価格と同じ$2/$10の料金表です。
短所
- 出力が遅く、ライブチャットには向きません。
- 見出しスコアが米国のフロンティアモデルより低いです。
- オープンウェイトはまだ利用できず、今のところAPIのみです。
料金
| モデル(100万トークンあたり) | 入力 | 出力 | キャッシュ入力 |
|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 |
Kimi Platformの料金ページより。Kimi K3.1 Proの価格の記事に、タスクごとの計算があります。
**私の見解:**チケットが長くて雑然としている場合や、エージェントが大きなドキュメントを読む場合は、試す価値があります。レイテンシが重要ならhighspeedティアを使ってください。詳しくはKimi K3.1 Proレビューをご覧ください。
6. DeepSeek V4.1 Flash
**最適な用途:**オープンウェイト、セルフホスティング、またはトークンあたり最安の請求額が必要なチーム。
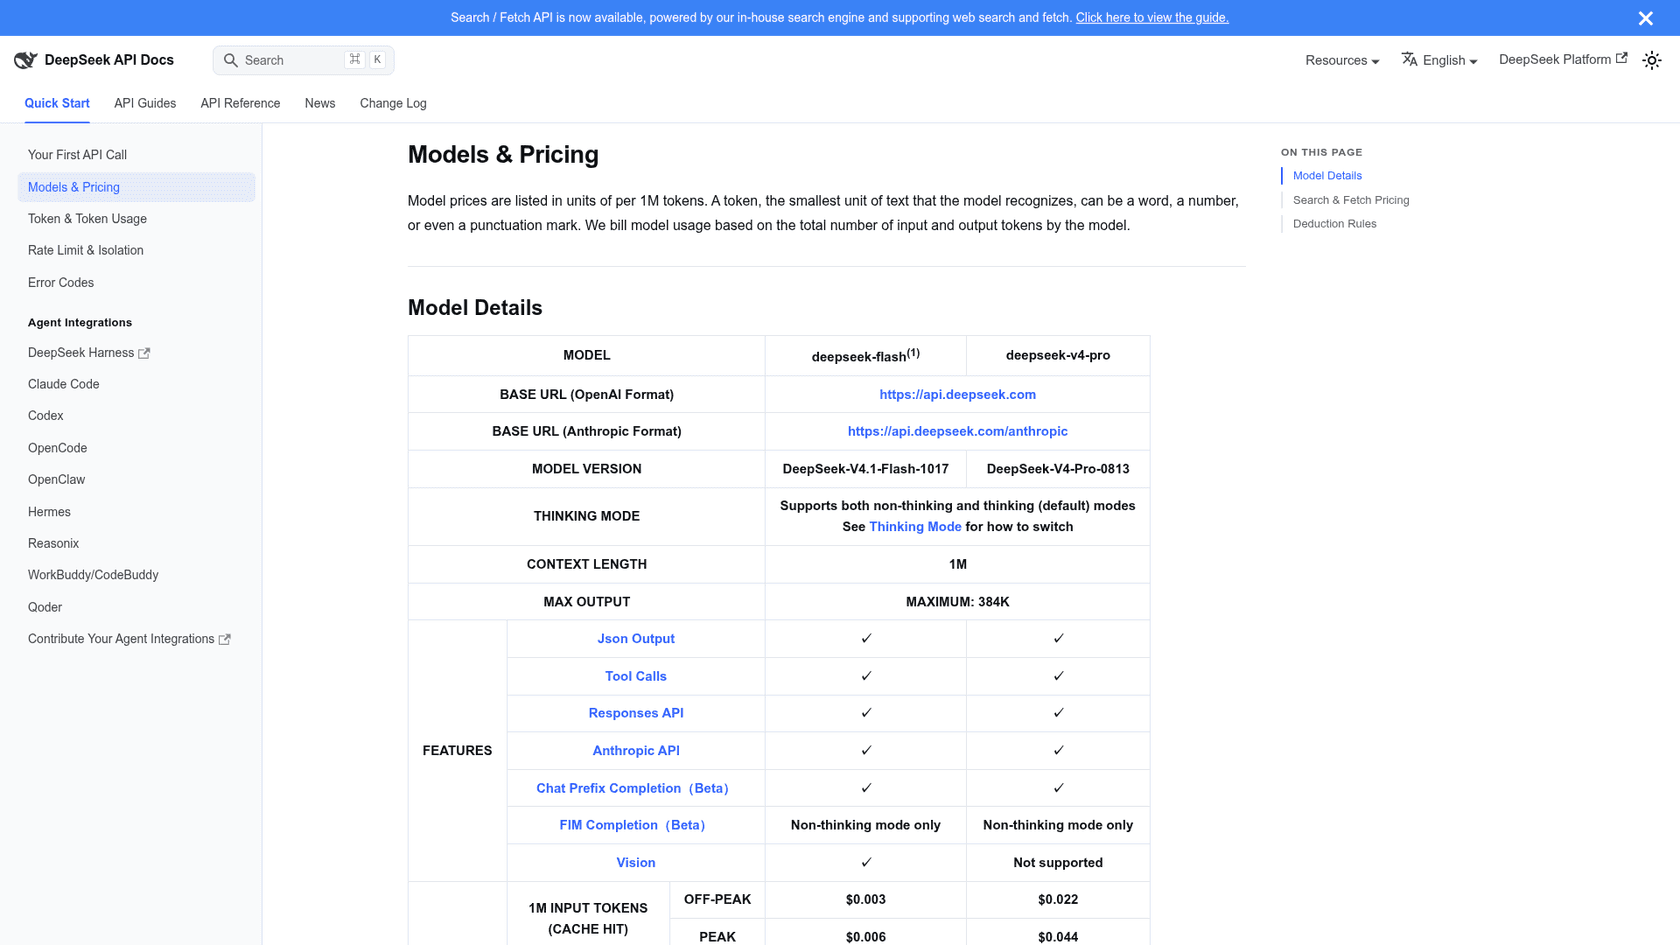
DeepSeek V4.1 Flashはこのリストで唯一オープンウェイトのモデルで、データを自社サーバーの外に出せない場合に重要です。APIではオフピークで入力$0.15、出力$0.60で、ピーク時間(平日のUTC 01:00〜04:00と06:00〜10:00)はその2倍です(DeepSeekの料金ページより)。
Artificial Analysisインデックスでは最大の推論負荷で32.5、タスクあたり$0.60で、ハルシネーション率は64%です。有能で安価な働き者であって、Carbonクラスのモデルではなく、しっかりした指示が必要です。
"I use DeepSeek too but it's more of a workhorse model, requires a lot more guiding and sometimes struggles to get where I want it."
長所
- オープンウェイトなので、セルフホスティングできます。
- フロンティアに近いものの中で最安のAPI請求額で、キャッシュヒットはオフピークで100万あたり$0.003です。
- 1Mコンテキスト、384K最大出力、ツール呼び出し、ビジョンに対応します。
短所
- スコアがCarbonよりはるかに低いです(32.5対59.4)。
- 作り話の割合が64%なので、グラウンディングが必須です。
- ピーク時の価格により、アジアとヨーロッパの平日の朝はコストが2倍になります。
料金
| 100万トークンあたり | オフピーク | ピーク |
|---|---|---|
| 入力、キャッシュヒット | $0.003 | $0.006 |
| 入力、キャッシュミス | $0.15 | $0.30 |
| 出力 | $0.60 | $1.20 |
DeepSeekのSearchとFetch APIは1,000リクエストあたり$0.75で、サーバー側のツール呼び出しの課金は2026年11月1日に始まります。ピークのスケジュールはDeepSeek V4.1 Flashの価格の記事で扱っています。
**私の見解:**セルフホスティングやトークンあたりコストが制約のときに選んでください。品質面でのCarbonの置き換えとしては選ばないでください。DeepSeek V4.1 Flashレビューをご覧ください。
7. GPT-6 Luna
**最適な用途:**強いモデルが残りを見る前に、簡単なチケットを仕分けて回答する、安価な一次対応モデル。
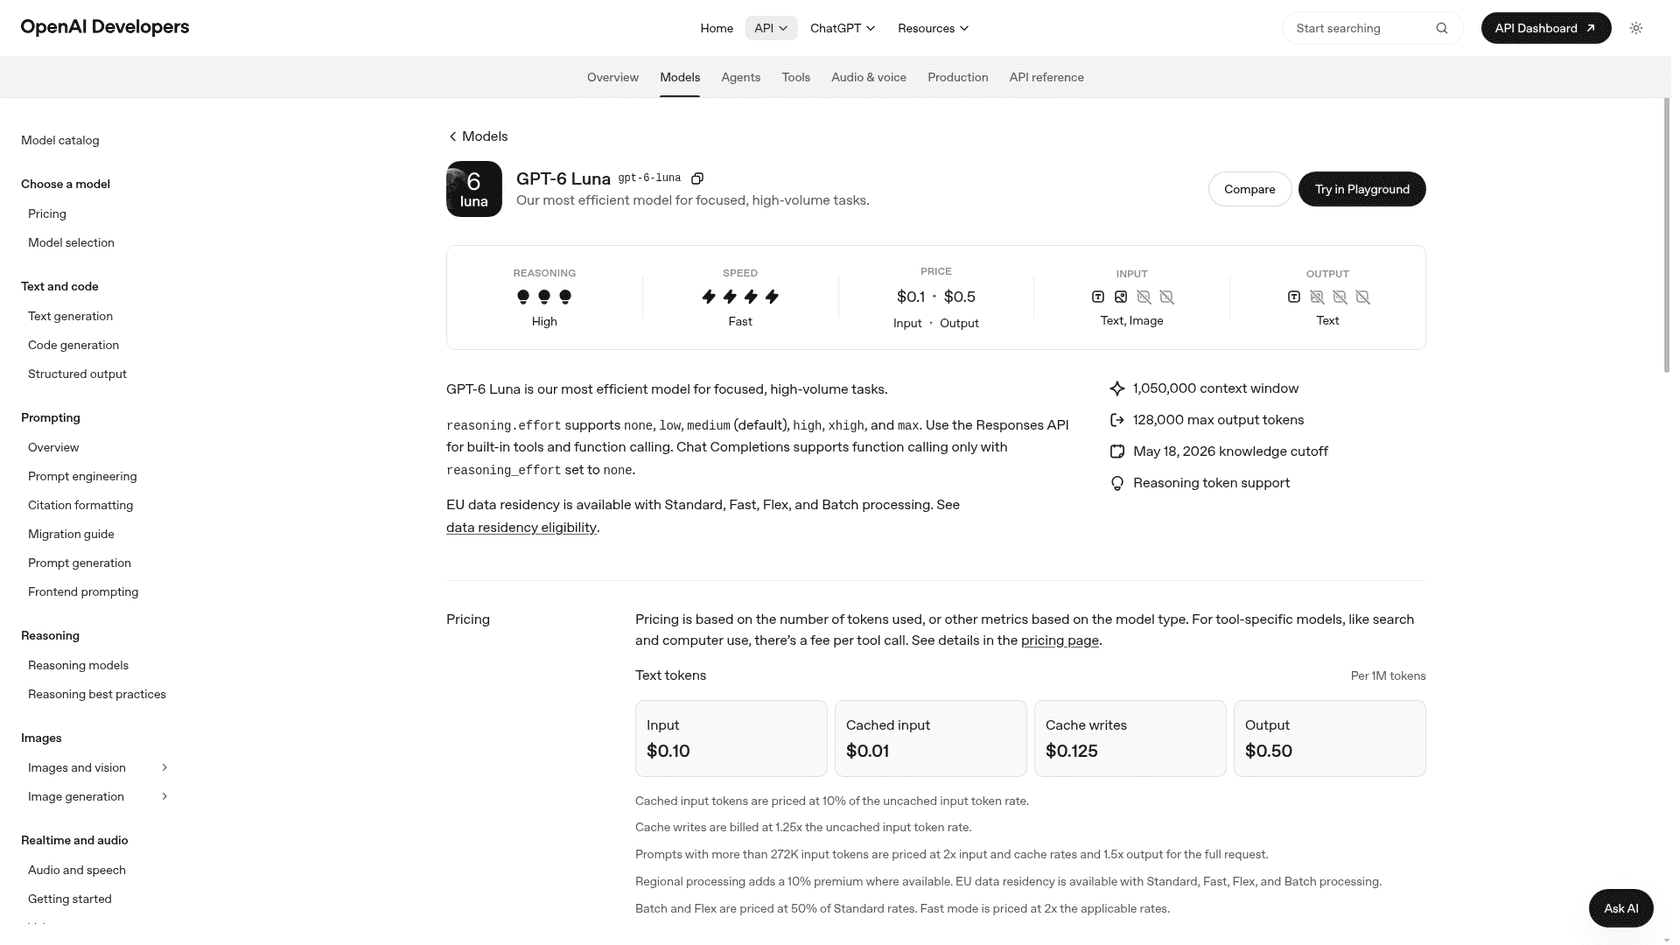
LunaはChatGPTの4番目の推薦で、"high-volume, repetitive requests"向けです。OpenAIはこれを"most efficient model for focused, high-volume tasks"と呼び、100万トークンあたり入力$0.10、出力$0.50で、Carbonの導入価格の20分の1です。
単独ではCarbonの代わりにはなりません。LunaはArtificial Analysisインデックスで最大の推論負荷で27.8、タスクあたり$0.15で、AA-Omniscienceでは79%の確率で作り話をしました。役割はトリアージです。チケットにタグを付け、注文状況の質問を自社データから回答し、それ以外はすべて上位へ引き継ぎます。
長所
- このリストでタスクあたりが最安です。
- 高速で、1,050,000トークンのウィンドウがあります。
- Solと同じAPIなので、両者の間のルーティングが簡単です。
短所
- ここで最も作り話の割合が高いです(最大の推論負荷で79%)。
- 判断が必要なものには向きません。
- 出力はテキストのみです。
料金
| モード(100万トークンあたり) | 入力 | 出力 | キャッシュ入力 |
|---|---|---|---|
| 標準 | $0.10 | $0.50 | $0.01 |
| Batch / Flex | $0.05 | $0.25 | $0.005 |
| Fast | $0.20 | $1.00 | $0.02 |
OpenAIの料金ページより。作り話が少ない安価なトリアージモデルが欲しいなら、Claude Haiku 5.5は100Kトークンまでのプロンプトで同じ$0.10/$0.50で、最大の推論負荷でのハルシネーション率は34%でした。
**私の見解:**Luna(またはHaiku 5.5)は安価な第一層として使い、単独のモデルにはしないでください。詳しくはGPT-6 Lunaの価格の解説をご覧ください。
実際のセキュリティ業務にCarbonが必要だったら?
その場合は、汎用モデルで妥協せず、限定プログラムに申し込んでください。汎用モデルは、サイバー関連の業務の一部をあえてブロックするからです。ルートは3つあります。
| ルート | 得られるモデル | 参加方法 | コスト |
|---|---|---|---|
| Google Fairwind | Gemini 4 Carbon | 関心フォーム、身元調査、これまでに650以上のパートナー | Carbonの導入価格$2/$10、その後$4/$20 |
| OpenAI Daybreak | GPT-5.6-CyberとDaybreakのアクセスティア | 申請。OpenAIは防御担当者向けに$10億のDaybreakクレジットを提供 | OpenAIの料金表でgpt-5.6-cyberは100万あたり$12.50 / $75 |
| Anthropic Cyber Verification Program | サイバー関連のブロックが少ないClaude Opus 5.5、Sonnet 5.5、Mythos 5.1 | 組織ごとに1回申請。7営業日以内に判断 | 標準のClaude API価格 |
Anthropicのプログラムは、3つの中で最も入りやすいものです。2026年10月の更新で3つのアクセスティアが追加され、Opus 5.5を"most capable cyber model yet"と呼んでいます。独立した研究者、メンテナー、バグバウンティハンターは個人として申請できますが、個人は今のところDefenseティアのみです。これらのプログラムをより詳しく比較したものは、GPT-5.6-Cyber代替の記事にあります。
制限を好まない人もいます。
"Too bad you won't be able to use it to secure your open-source projects. If you try it'll throw up a prompt telling you to use some initiative you can't use or afford while the provider collects the findings."
日常的なセキュリティ業務なら、プログラムはまったく不要かもしれません。Anthropicは、一般提供のモデルでも、安全なコードレビュー、脅威モデリング、既知の問題の修正、セキュリティアラートのトリアージには使えると述べています。
どのGemini 4 Carbon代替を選ぶべきか?
Carbonを何に使いたかったのかから始めましょう。下のマップは、私なら判断をこう振り分けるという図です。
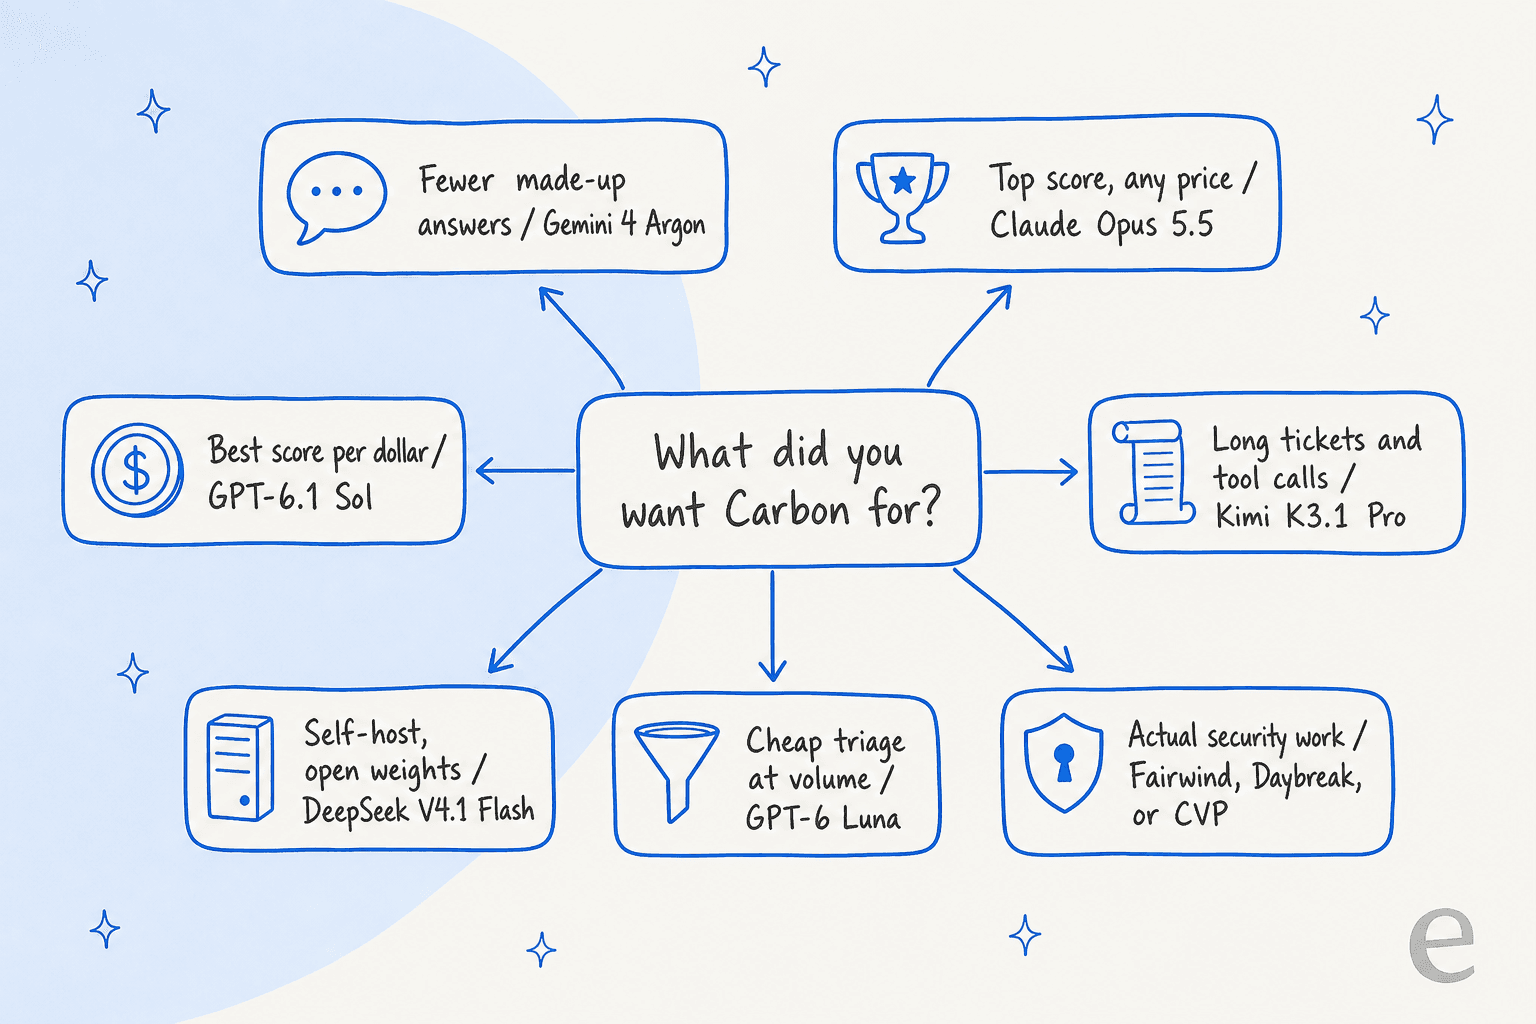
多くの読者にとって、正直な答えは1つではなく、モデルのペアです。ChatGPTの2モデルの提案は正しいです。LunaやHaiku 5.5のような安価なモデルが簡単で大量の作業を扱い、より強いモデル(Argon、Sol、Sonnet 5.5)が難しいケースを引き受けます。これらのうち5つのモデルはトークンあたりの価格が同じなので、強い方のモデルの選択は、料金表ではなく、タスクあたりコストと作り話の割合で決まります。
そして、ここではっきり言っておきたいことが1つあります。サポートキューにおけるCarbonとArgonの差は、グラウンディングされたエージェントとされていないエージェントの差よりも小さいのです。これらのモデルはどれも、ドキュメントがカバーしていないことを尋ねられると答えを作り上げます。解決策はモデルを取り巻くレイヤーで、そこが私が実際に取り組んでいる部分です。
この選択は実際のサポートエージェントでどう現れるか?
eeselでは、モデルは設定の1つにすぎません。顧客が正しい回答を得られるかどうかを決めるのは、AIチームメイトが何を読み、何をすることを許されているかです。チームがヘルプデスクを接続すると、エージェントは過去のチケット、ヘルプセンター、社内ドキュメントから学び、人に引き継ぐ条件についての書面のルールに従い、実際に誰かに回答する前に過去のチケットでシミュレーションされます。
Freshdeskの2社の顧客が、その様子を示しています。ERPソフトウェア会社のQontroは、すべてのFreshdeskチケットにヘルプ記事がリンク済みの返信下書きが付き、1か月で190件のチケットを下書きし、9,800件の過去のチケットとヘルプ記事から回答しています。SamCartはチャネルごとにエージェントを動かし、1つはFreshdeskのチケット、もう1つはWebサイトのチャットで、月8,000件のやり取りに合わせたプランです。
どちらも、フロンティアのセキュリティモデルは必要としませんでした。必要だったのは、推測せずに「担当者を呼びます」と言えるエージェントです。サポートキュー向けのモデルを比較しているなら、サポートチケット向け最良モデルのガイドがそのトレードオフを掘り下げていますし、カスタマーサポート向けLLMの記事も同様です。
eeselを試す
サポートエージェントの中でCarbonを使いたくてここに来たなら、eeselが近道です。Freshdesk、Zendeskなどのヘルプデスクに接続するAIヘルプデスクチームメイトで、過去のチケットとヘルプセンターから学び、顧客に返信する前に自社のチケット履歴でテストされます。モデル選びは任せられ、これらのどのモデルにも作り話をさせないグラウンディングも手に入ります。
プランはeeselの料金ページでご覧いただけます。または、自社のチケットでeeselを無料で試すこともできます。