

Gemini 3.7 Flashは非常に優れたモデルですが、静かに「安いモデル」ではなくなりました。速さは本物です。Artificial Analysisの計測では毎秒340.1トークンで、現在追跡中のモデルで最速です。2026年8月13日に一般提供が始まりました。発売時の価格は、入力100万トークンあたり$0.75、出力100万トークンあたり$3.75でした。
そして落とし穴ですが、これはベンチマークのグラフではなく料金表にあります。この価格は導入価格です。2027年1月1日に$1.50と$7.50へ倍増します。さらに、旧Flashモデルを大量分類に使えるようにしていた思考レベルminimalがなくなり、最安の下限はlowになりました。しかも思考トークンは、返ってくるのがその要約だけであっても、出力と同じ料金で課金されます。
私はeeselで連携機能とモデル周りの基盤を作っています。当社のエージェントは実際のヘルプデスクで本番ボリュームを処理しており、ある顧客はZendeskで月10万件以上のドイツ語チケットを流しています。この仕事のせいで、ベンチマーク表だけでモデルを選ぶことには強い抵抗があります。結論として、コーディング、エージェント、ドキュメント処理では3.7は本当のアップグレードです。しかし、Flashを選んだ元の理由が「安い層だから」だったなら、3.7はあなたの乗り換え先ではなく、Google自身の価格表もそれを静かに認めています。
Gemini 3.7 Flashとは実際に何か
Gemini 3.7 Flashは、Gemini AIシリーズで最新の主力モデルです。gemini-3.7-flashとして提供され、プレビューではなくGAと表示されています。Googleの位置づけは率直で、"our most intelligent workhorse model yet for coding and agents."というものです。
1Mトークンのコンテキストウィンドウと64kの出力上限を持ちます。入力はテキスト、画像、動画、音声、PDFに対応しますが、出力はテキストのみです。6つのサービスで利用可能で、AI StudioとGemini API、さらにGoogle Antigravityが含まれ、AntigravityではAntigravityエージェントの背後でデフォルトモデルになっています。
以下を読むうえで重要な背景が1つあります。現在、安定版のGemini 3 Proは存在しません。gemini-3-pro-previewは終了扱いで、一覧に残るProはプレビュー版の3.1 Proだけです。これはGemini 3の発表時の構成とは大きな変化です。そのため、名前に「Flash」が付くモデルにしては、ラインナップの中でFlashが背負う役割が重くなっており、位置づけと価格設定の多くがそれで説明できます。
モデルよりAPIのほうが大きく変わった
ここがあなたの午後を実際に潰す部分ですが、ほとんど誰も最初に書きません。
Gemini 3.5 Flash、Gemini 3 Flash Preview、Gemini 3.1 Proから移行する場合、Googleの移行チェックリストは次の対応を求めます。temperature、top_p、top_k、candidate_countを削除する。数値のthinking_budgetをthinking_level文字列に置き換える。事前入力されたモデルのターンを削除する。複数ターンの履歴をサーバー側のprevious_interaction_idに移す。Gemini 3.6 Flashはすでにサンプリングパラメータを廃止していたため、3.6から3.7への移行はほぼ無料です。それ以外の方は全面的な整理が必要です。
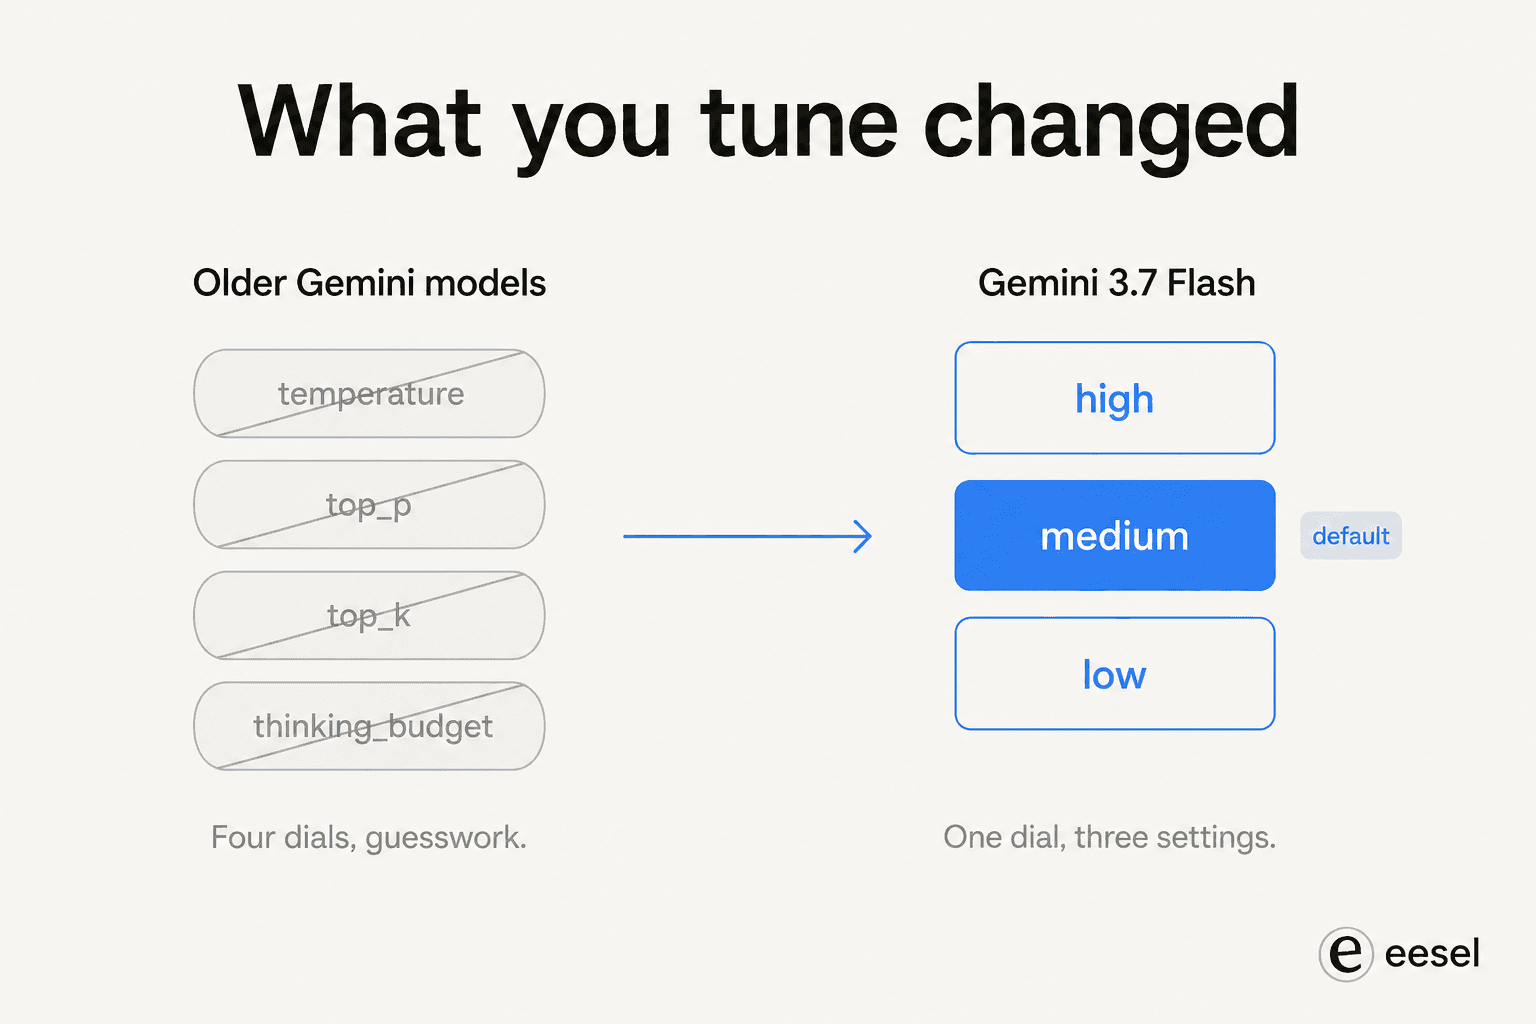
4つのつまみの代わりに、3段階の1つだけになり、generation_config内で設定します。
| レベル | Googleが想定する用途 | コストの特徴 |
|---|---|---|
low | 遅延が重要な作業:インシデント対応、リアルタイムチャット、下書き、高速なデータ分析 | 利用可能な最安の下限 |
medium(デフォルト) | 複雑なコードとエージェント用途、初回精度が高い | 何も設定しない場合のデフォルト |
high | 難しい数学、最も難しいコーディングとエージェントタスク、長時間のツール利用 | "Higher token consumption and cost" |
これが、誰もプレスリリースに書かなかった後退です。Gemini 3.6 Flash、3.5 Flash、3.5 Flash-Lite、3 Flash Previewはすべて第4のレベルminimalを受け付けます。Gemini 3.7 Flashは受け付けません。347件のコメントが付いた発表スレッドで、これを指摘したのはSimon Willisonだけでした。
"The 'introductory pricing' for this 3.7 Flash model is really weird.
It's scheduled to double in price on December 31, 2026, but who would anticipate still using this model five months from now? Especially since 3.6 Flash came out just three weeks ago!"

minimalを失う影響は、聞こえ以上に大きいものです。FlashをOCRやタグ付け、あるいはチケット分類に使っていたなら、採算を成り立たせていたのがminimalでした。lowは確かに下限ですが、同じ下限ではありません。
もう1つの静かな変更です。ページ上のコードサンプルはすべて、generateContentではなく、モデルと同時にGAとなったInteractions APIを使っています。旧形式で作られたコードベースにスニペットをコピーする前に、知っておく価値があります。
どれくらい速いか、その速さはどう分布するか
速度の面では、3.7 Flashは依然として他を寄せ付けません。Artificial Analysisの計測では毎秒340.1出力トークンで、追跡する188モデル中1位、クラス中央値は68.6です。Intelligence Indexは56で、188モデル中17位、クラス中央値34を大きく上回ります。
実運用の数値はそれほど華やかではありませんが、より役に立ちます。OpenRouterではP50が毎秒93トークン、レイテンシは1.85秒です。プロバイダー別の差は大きく、Google AI Studioは毎秒124トークン・1.74秒、Vertexは毎秒84トークン・2.02秒です。
最初のトークンまでの時間が弱点で、どの思考レベルを選ぶかに完全に左右されます。Artificial Analysisの計測では、highの中央値は最初のトークンまで9.83秒、p95は49.5秒で、クラス中央値は2.88秒です。lowでは0.74秒まで下がります。使えるインタラクティブな遅延と、ユーザーが文句を言う遅延との違いです。
ここから、データセット全体で最も実用的な発見が見えてきます。
| 思考レベル | Intelligence Index | 最初のトークンまでの時間 | ベンチマーク1タスクあたりのコスト |
|---|---|---|---|
high | 56.0 | 9.83s | $0.40 |
medium | 53.5 | 4.22s | $0.26 |
low | 50.9 | 0.74s | $0.16 |
lowでも50.9で、highフル稼働のGemini 3.6 Flashとの差は1ポイント以内、タスクあたりのコストは40%、待ち時間は約13分の1です。つまり、3.6 Flashから移行してデフォルトのmediumのままにしているなら、不要な推論に対して余分に払っている可能性が高いということです。
奇妙なのは、OpenRouterのトラフィックの93.1%が、遅いほうのエンドポイントであるVertexに向かっていることです。こちらにはプラットフォーム側の50%割引が付いているためです。人々は価格のために遅延を手放しており、このモデルを実際に何のために買っているかがわかります。
速度の話全体に対する強い反論もあり、数字が伴っています。Artificial Analysisの計測では、高い推論設定で3.7 Flashは3.6 Flashよりトークン使用量が約40%増え、1タスクあたり平均37kの出力トークンになります。毎秒トークン数と回答までの時間は同じではありません。
"Sol high is almost the same speed if you take into account drastically lower token use. Look at the artificial analysis speed vs token use. Gemini is 7x faster but 5x more tokens. And that's with Sol high being a substantially better model."
その40%のトークン増は、速度のバッジを付けた値上げです。料金表は動いていません。動いたのは、1タスクあたりの課金対象の出力トークン数で、思考トークンもここで出力料金に乗ります。下の計算ツールを使うときは、これを念頭に置いてください。
ベンチマーク:Googleが前面に出さなかったものも含めて
Googleは、Gemini 3.6 Flash、Claude Sonnet 5、GPT-5.6 Terra、Muse Spark 1.2との21行の比較表を公開しました。評価できる点として、負けた行も公開しています。特に重要な行は次のとおりです。
| ベンチマーク | Gemini 3.7 Flash | Gemini 3.6 Flash | Claude Sonnet 5 | GPT-5.6 Terra | Muse Spark 1.2 |
|---|---|---|---|---|---|
| 入力価格、$/1M | $0.75 | $0.75 | $2.00 | $2.00 | $1.25 |
| 出力価格、$/1M | $3.75 | $3.75 | $10.00 | $12.00 | $4.25 |
| AA Intelligence Index | 56 | 52 | 55 | 57 | 57 |
| FrontierCode 1.1 Main | 43.6% | 34.4% | 42.7% | 41.3% | - |
| DeepSWE v1.1 | 65.3% | 48.6% | 53.8% | 69.6% | 54.9% |
| Code Arena (Elo) | 1588 | 1538 | 1541 | 1523 | 1535 |
| Terminal-bench 2.1 | 85.8% | 78.0% | 80.4% | 87.4% | 82.9% |
| Terminal-bench 3.0 | 14.9% | 5.4% | 14.6% | 20.8% | - |
| AutomationBench(非公開) | 30.4% | 17.0% | 10.7% | 23.6% | - |
| GDPVal-AA v2 (Elo) | 1525 | 1422 | 1598 | 1578 | 1628 |
| Harvey LAB-AA(法務) | 90.7% | 85.1% | 90.1% | 85.2% | - |
| GDP.pdf(PDF理解) | 34.0% | 22.0% | 28.0% | 24.7% | 16.0% |
| CharXiv Reasoning(ツールなし) | 84.5% | 85.2% | 77.0% | 85.9% | - |
| CharXiv Reasoning(ツールあり) | 88.7% | 89.4% | 88.3% | - | - |
| LVBench(長尺動画) | 85.4% | 84.2% | 68.5% | 78.9% | - |
| GDM-MRCR v2 @128k | 97.0% | 91.8% | 81.5% | 93.5% | - |
| OSWorld-2.0(コンピュータ操作) | 47.9% | 33.8% | - | 50.2% | - |
| HLE-Verified | 53.6% | 51.2% | 31.0% | 51.1% | - |
この表の率直な読み方をいくつか挙げます。
**前モデルに対する伸びは大きく、本物です。**DeepSWEが48.6%から65.3%へ、AutomationBenchが17.0%から30.4%へというのは、誤差の範囲ではありません。Google自身の本文では、3.6 FlashのDeepSWEを48.6%ではなく49.0%と記しており、本文とグラフの間に小さな食い違いがありますが、方向性に疑いはありません。
**エージェント型のターミナル作業は、依然としてGPT-5.6 Terraの領域です。**Terminal-bench 2.1、Terminal-bench 3.0、DeepSWE、OSWorld-2.0はすべてTerraが取っています。実際のリポジトリを長時間かけて処理するコーディングエージェントが用途なら、重要な4つのベンチマークがすべてTerraです。Hacker Newsの何人かが、これを低価格の選択肢ではなくTerraの競合として読んだ理由もそこにあります。
**Gemini 3.6 Flashに2行負けています。**どちらもCharXivのグラフ推論で、ツールなしが84.5対85.2、ツールありが88.7対89.4です。差は小さいものの、「3.7はあらゆる面で3.6に勝つ」というのは正しくありません。グラフが主な用途なら、移行前に確認してください。
独立したテストにしか現れない数値がもう1つあります。Artificial Analysisは、**3.7 Flashのハルシネーション率を64.5%、3.6 Flashを55.6%**と計測しています。精度は上がりましたが、ハルシネーションも一緒に上がりました。
Googleに公平を期すと、この数値は基準によって見え方がまったく変わります。同じデータをRedditで検討していた読者が、より長い文脈に置いています。
"Flash 3 had 93 % hallucination but also very good world knowledge. 3.7 Flash has 65 %. This is a considerable improvement but it still lacks behind 3.1 Pro. […] Both Gemini Flash and GPT Sol are very good at getting the right answer, better than all other models except Claude Fable and Opus. It's just that when they don't get it right hallucination is likely or almost guaranteed."

つまり、Flash 3よりはずっと良く、直接置き換える前モデルよりはわずかに悪く、3.1 Proにはまだ及びません。最後の点が重要で、なぜ私が気になって眠れないのかは後で説明します。
情報源について2点の注意があります。Artificial Analysisには、3.7 FlashのSWE-Bench Verified、AIME、LiveCodeBench、MMLU-Proのスコアがないため、それらで出回っている数字はGoogle自身のグラフであり、独立した実行結果ではありません。また、コンテキストウィンドウは情報源によって異なり、Artificial Analysisは1,000,000、GoogleのVertexカードは1,048,576としています。
料金と、その価格が終わる日
見出しには、入力100万トークンあたり$0.75、出力100万あたり$3.75とあります。アスタリスクこそが話のすべてです。
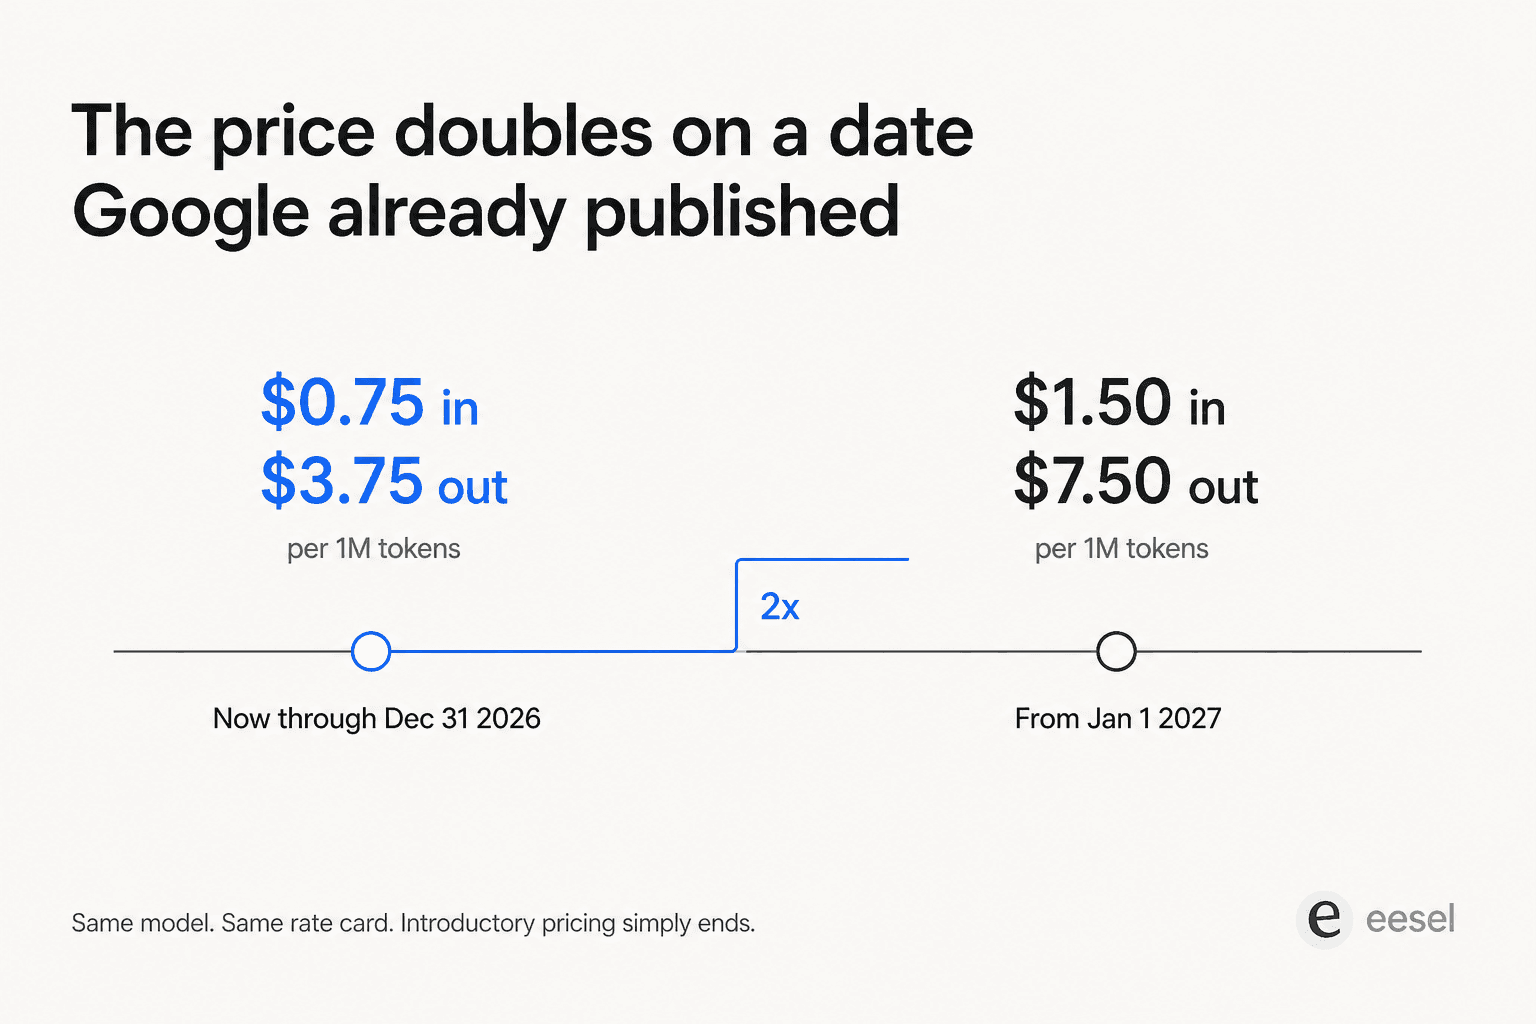
Googleの料金ページから取った料金表の全体は次のとおりです。
| 項目 | 2026年12月31日まで | 2027年1月1日から |
|---|---|---|
| 入力、100万トークンあたり | $0.75 | $1.50 |
| 出力(思考を含む)、100万あたり | $3.75 | $7.50 |
| バッチモード 入力 / 出力 | $0.375 / $1.875 | $0.75 / $3.75 |
| Flexモード | バッチと同じ | バッチと同じ |
| Priorityモード | $1.35 / $6.75 | $2.70 / $13.50 |
| コンテキストキャッシュ読み取り、100万あたり | $0.075 | $0.15 |
| コンテキストキャッシュ保存、100万あたり1時間 | $0.50 | $1.00 |
| Google Search grounding | 全3.xモデル合計で月5,000リクエスト無料、以降1,000リクエストあたり$14 | 同じ |
注目すべき点がいくつかあります。コンテキスト長による価格の段差がないため、90万トークンのプロンプトも900トークンのプロンプトもトークンあたりの価格は同じで、3.1 Pro Previewとは違います。モダリティによる割増もなく、音声と動画の入力はテキストと同じ料金で、3 Flash Previewが音声に倍の料金を課していたのとは対照的です。さらに、groundingは3.x世代で大幅に安くなり、1,000リクエストあたり$35から$14に下がりました。
奇妙に見えるのは、Gemini 3.6 Flashが今や3.7 Flashとまったく同じ価格だという点です。導入価格も期限も同じで、その後の通常価格も同じです。Googleの本文は3.7 Flashを元の3.6 Flashの約半分のコストと説明しますが、これは定価に対しては正しく、今日3.6 Flashにかかっているコストに対しては正しくありません。新しいモデルにプレミアムはなく、CharXivやminimalがあなたにとって不可欠でない限り、3.6にとどまる理由はほぼありません。3.6 Flashの料金内訳は、今や同じ料金表なので引き続き有効です。
ご自身のボリュームを入力してみてください。
見えない思考にお金を払っている
これは人を驚かせる項目で、Googleのthinkingドキュメントにはっきり書かれています。"When thinking is turned on, response pricing is the sum of output tokens and thinking tokens."
さらに数段落下に、より鋭い一文があります。"Pricing is based on the full thought tokens the model needs to generate, despite only the summary being output from the API."
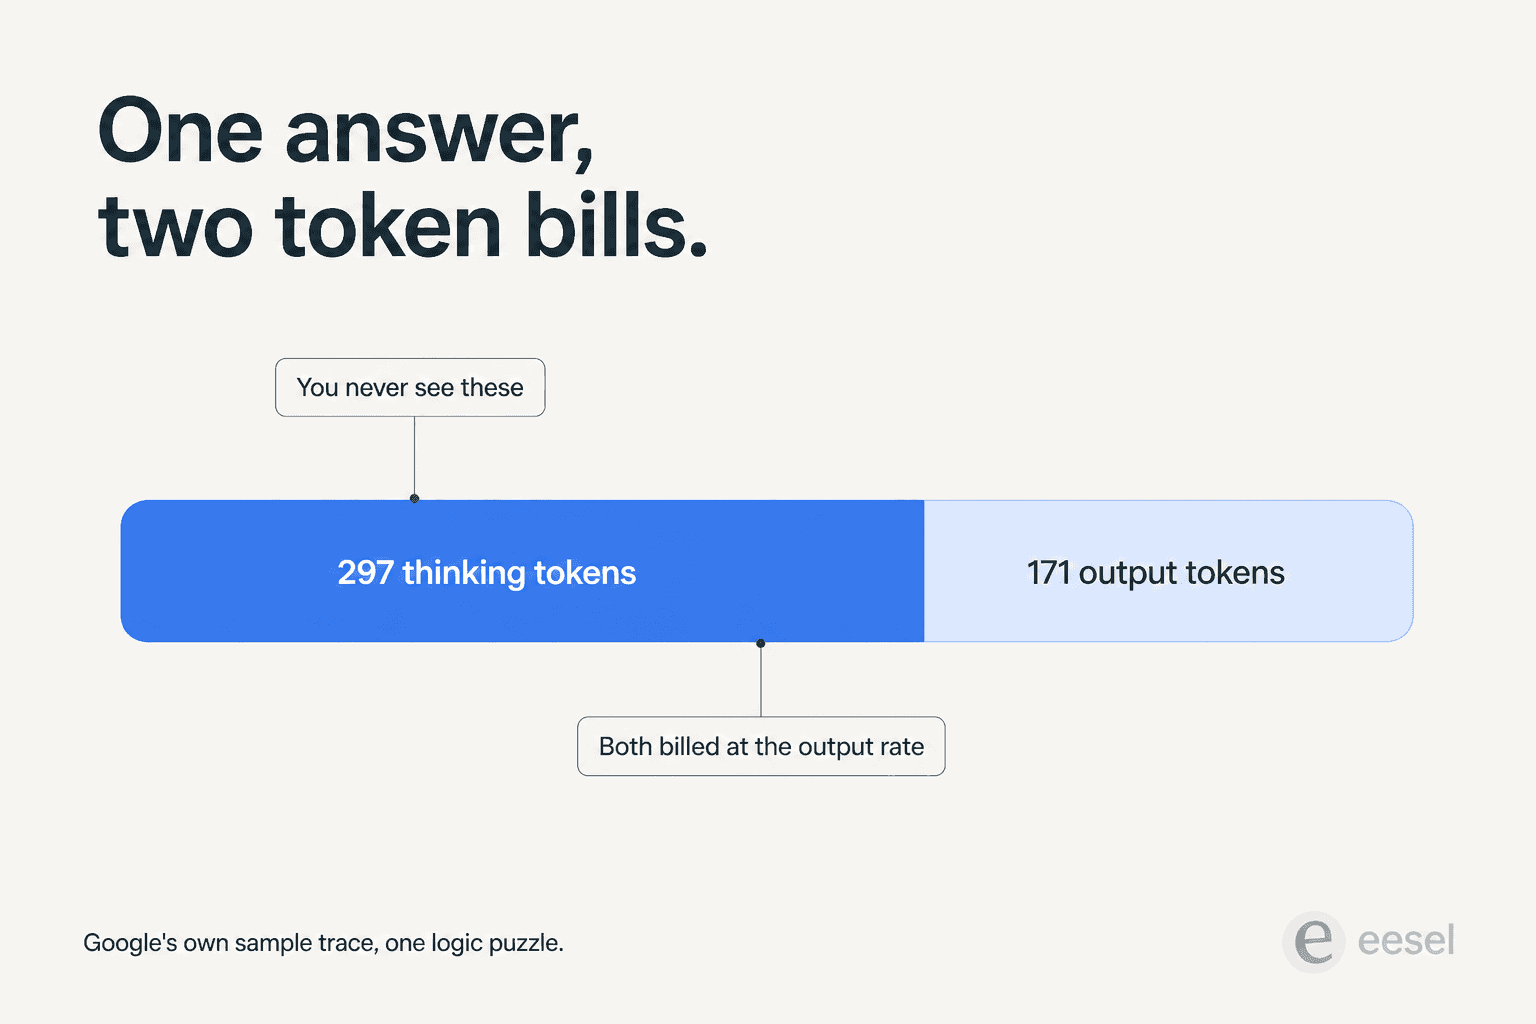
Google自身の、3つのヒントがある論理パズルのサンプルトレースでは、297の思考トークンに対して171の出力トークンを消費します。つまり、その回答の出力請求のほぼ3分の2は、呼び出し側が受け取らない推論、要約しか返ってこない推論に対するものでした。件数はusage.total_thought_tokensとして公開されているので測定はできますが、自分で探しに行く必要があります。複数のモデルを並べて運用しているなら、こうした点をつかむためにLLMトラッキングツールがあります。
これを本番ワークロード全体に掛けると、mediumがデフォルトであることは肩をすくめて済ませられない現実の判断になります。上の計算ツールの思考オーバーヘッドのスライダーがゼロではなく75%に設定されているのも、そのためです。
要約方式を役に立たないどころか悪いと感じる開発者もいます。発表スレッドから引用します。
"I really, really like DSv4 Flash because you see the full, real thinking text. That's been so useful for helping steer the model; as well as seeing its thoughts and correcting any errors, or expanding on it. It's so difficult for me to use closed models with no or summarised thinking now."
開発者は実際に何と言っているか
発表スレッドは約8時間で621ポイント、347コメントに達し、そのスコアより内容のほうが興味深いものでした。
スレッド全体で最も引用された数字は、競合の価格でした。
"Ever since the insane discount with GPT-5.6 Luna, not much excites me anymore. I mean just look at the benchmarks, even though Gemini 3.7 Flash performs well on the DeepSWE 1.1, Luna (Max) still performs way better.
> Starting January 1, 2027, $1.50/1M input tokens and $7.50/1M output tokens will apply.
Compare this to Luna which is at $0.2/1M input ($0.02 cached) and $1.2/1M output."
位置づけの修正は数コメント後に現れ、これがスレッド全体で最も有用な指摘でした。
"They need to release benchmarks against Luna/Terra. Luna is much cheaper which feels like it undercuts the need for Flash.
I've always considered the Flash series of models to be for low-cost, high-volume, mostly text-based use cases (e.g. summarization, parsing, formatting), emphasis on low-cost."
これが捉え直しです。Flashはもう市場の底辺では競っておらず、そこで競うのはFlash-Liteです。安いからFlashが好きだったなら、次に欲しいモデルは1段下の層か、Googleファミリーの外にあります。
まず見るべき明らかな候補はQwenとKimiです。同程度の予算で欧米のホスト先が必要なら、Mistralが最も近い比較対象になります。
最も鋭い実践的な評価は、opencodeで行った画像からHTMLへのテストで、3.7 FlashをClaude Opus 5とGrokと比べたものから出ました。
"It's not a bad model by any means, but I just don't know what situation I'd reach for 3.7 Flash first for. Google really needs a differentiator, especially given how hard it is to get an API key from them. They can't be high friction and non-pareto."
この最後の一節が、その日最大のサブスレッドを開き、そこではモデルは主題ではありませんでした。主題は、Googleから買えるのかどうかでした。あるコメント主は、新しいキーで"Failed to create project, The request is suspicious. Please try again"というエラーが出たと報告し、別のコメント主は10年選手のCloudアカウントで同じ現象が起き、2日後にようやく動いたと報告しました。運用上、最も痛いのは次のものです。
"There are places where you CAN set a limit. This seems great until you are at the center of a huge traffic spike because of good pr and so you try to change it to a larger number only to be told you need to wait 24 hours for the setting to change.
Biggest traffic day of the decade and our site was down because of google."
公平を期すと、これはスレッドの下のほうで反論されています。あるコメント主は新規アカウントで、ページを離れずに2クリックでキーを作成でき、Googleは現在Gemini APIに利用上限も提供しています。つまり、摩擦はある人には現実で、別の人には問題にならず、それ自体が一種の問題です。対比として、OpenAIのレート制限やGPT-5 Pro APIの料金は、ほとんどの人がサポートチケットなしで済むように文書化されています。
Flashが今でも圧勝する領域
視覚とドキュメントです。スレッドの批判的な人たちでさえ、この1つの軸では認めていました。
ベンチマーク表をもう一度見てください。GDP.pdfはTerraの24.7%に対して34.0%、LVBenchはSonnet 5の68.5%に対して85.4%、さらに128kのニードルテストは97.0%です。これは運の良い3行ではなく、一貫した全体像です。あるコメント主は、どんなベンチマークよりうまく実用面を語りました。テキスト中心のモデルが外した植物の問題を、Geminiが写真から正しく診断したという話です。
"That's been my association as well. I see Flash get brought up a lot in relation to things like OCR and PDF processing frequently, and a lot of other routine multimodal workloads."
スケールに関する主張もあり、私には意外でした。
"did you try to ingest 1M documents per hour with any provider except GCP with Flash? None work at scale. Deepseek, Luna, Mistral all fail. 1 in 3 requests is a fail. I stopped trying. The only thing that works at scale is gemini flash."
トークンあたりの安さと、大量処理での信頼性は別のもので、価格比較のスレッドはこの区別をほとんど飛ばします。
Googleが挙げる顧客も同じところに行き着きます。Browser Useの共同創業者Gregor Zunicは、エージェントが"35% cheaper than 3.6 Flash, with a +8% observed prompt-cache hit rate and fewer tool errors."だったと報告しています。これは料金表ではなく総支出として読むべきです。2つのモデルは現在同じ料金で課金されるため、節約分はキャッシュヒットと再試行されるツール呼び出しの減少から来ています。HarveyのNiko Grupenは、同社のLegal Agent Benchでall-passが+2.6ポイントだったと報告しています。Nunu.aiのKyrill Huxは、GPT-5.6 Terraと同等で"at around half the cost."だと述べています。これらは発表ページに載ったベンダー提供の引用なので、その分割り引いて受け取ってください。
第三者の評価で最も有用だったのはCognitionで、Devinに組み込んだうえで、どこに合うかを具体的に述べています。
"On FrontierCode 1.1, it reaches Claude Sonnet 5-level performance at less than half the cost, with the low latency the Flash series is known for. […] Within Devin, Gemini 3.7 Flash performs particularly well on tightly scoped refactors, where it delivers minimal diffs that match repo conventions."
"Tightly scoped refactors"は的確で正直な線引きで、長時間作業側についてターミナルエージェントのベンチマークが示すことと合致します。
Gemini 3.7 Flashを使うべき人、使うべきでない人
**使うべき場合:**ドキュメント抽出、PDFとグラフの処理、長いコンテキストでの検索、動画理解、モックからのWebやUIのコード生成を行っている場合です。Code Arenaの1588 EloはGoogleの表で最高スコアで、ドキュメント系ベンチマークは接戦ではありません。すでにAntigravityを使っているなら、そこではデフォルトなので、これが正しい選択です。
**見送るべき場合:**用途が長時間のターミナルコーディングエージェントなら、まさにそれを測る4つのベンチマークでGPT-5.6 Terraが勝っています。価格の下限が目当てでFlashに来た場合も見送ってください。minimalの喪失、出力として課金される思考トークン、1月に倍増する料金を考え合わせると、安価な層という論点は、静かにFlash-Liteと、出力で1桁安い競合へ移りました。
**待つべき場合:**3.6 Flashを使っていて、CharXiv型のグラフ推論があなたにとって不可欠な場合です。同じ金額で、わずかに悪化する2つのベンチマーク行を買うことになります。
まだ選択肢を比較しているなら、読む価値があるまとめはGemini代替サービス、Gemini 3代替サービス、Claude代替サービスです。
ツール面では、モデルより、それを動かすハーネスのほうが重要です。これを読んでいる方の多くは、生のAPI呼び出しではなくエディタ経由で3.7 Flashに触れるでしょう。その層については、おすすめAIコーディングアシスタント、エージェント型コーディングCLI、Cursorの料金の記事で扱っています。
サポートキューにモデルを載せるなら、これが意味すること
ここでハルシネーションの数字に戻ります。ここから私の本業が始まるからです。
Artificial Analysisは、Gemini 3.7 Flashのハルシネーション率を64.5%と計測しており、3.6 Flashは55.6%です。精度は向上し、同時にハルシネーションは悪化しました。この組み合わせは矛盾ではなく、予防線を張らず答えに踏み込むようチューニングされたモデルの通常の姿です。コンパイラが修正してくれるコーディングエージェントにはうってつけです。出力がそのまま顧客に届く場合は、リスクになります。
まさにこのワークロードを本番で動かしている人が、私よりうまく線引きをしています。
"Yeah we use it for auto-triage of incidents, attempts to auto-remediate, and escalation to human. But for actual development, it's not a viable option for us."
トリアージ、試行、そしてエスカレーション。これが正しい形で、そこでは人間が後付けではなく最後のステップになっている点に注目してください。
当社は何年も、実際のヘルプデスクで本番ボリュームのAIエージェントを運用してきました。その中には、Zendeskで月10万件以上のドイツ語チケットを処理する貸金業者や、Freshdeskで月5万件以上を扱うEコマースチームがあります。この経験から言えるのは、ベンチマークのスコアは、モデルがあなたのチケットでどう振る舞うかをほとんど教えてくれないということです。同じモデル、同じヘルプデスク、同じ業界の2つのチームでも、ナレッジベースの形が違うので、得られる回答は変わります。
したがって、モデルの選択は、その周りにあるものよりも重要度が低いのです。本当に正しいドキュメントを見つける検索で、これはモデルの問題ではなくRAGの問題です。信頼度によるルーティングで、確信度の低い回答は送信ではなく下書きになります。そして、顧客が一言でも目にする前に、自社のチケット履歴で行う予行演習で、これはサポート自動化の導入の多くが飛ばす手順です。
どれもモデル自体ではないことに注目してください。AIチャットボットが誤答する理由の大半は、モデルが賢くないからではなく、コンテンツと検索の失敗であり、ナレッジベースを直すほうが、今週出たばかりのモデルに乗り換えるより数字を動かすことが多いのです。
この最後の点が議論のすべてです。リーダーボードから64.5%のハルシネーション率を読み取って、顧客が受け取る結果を予測することはできません。できるのは、完了済みチケット500件でエージェントを動かし、回答を自分で読むことです。これは、チケット自動化ツールを比較したり、AIヘルプデスクプラットフォームから選んだりするための唯一の誠実な方法でもあります。どのベンダーのデモも、あなたのデータではなく自社のデータで作られているからです。

トークンの価格を気にする理由がサポート予算なら、最初にやるべき安上がりな比較はAIエージェントと人間のコストで、100万あたり$3.75と$7.50の差をかすませがちです。これはサポートにおけるAIの節約額で数字にしています。
eeselを試す
サポートの基盤としてGemini 3.7 Flashを評価していてここに来たのなら、率直な助言は、モデルカードの比較をやめて、自分のチケットでテストを始めることです。それこそがeeselの目的です。Zendesk、Freshdesk、Gorgias、HubSpot、Front、Slackに数分で接続し、ヘルプセンターだけでなく、すでに解決したチケットからも学習し、そのうえでチケット履歴に対するシミュレーションを実行します。何かが本番に出る前に、テーマごとに、実際に送信していたであろう回答がそのまま見えます。
料金は月額固定で、500クレジットで月$299から(チケットまたはチャット1件につき1クレジット)、1席ごとの料金はありません。そのため、多くのベンダーより簡単にトークン課金と比較できます。ある顧客は最初の月にティア1の問い合わせの73%を解決し、成果は7日間のトライアルのうちに見えました。
eeselを無料で試し、直近の数百件のチケットで動かして、モデルが十分に良いかどうかをシミュレーションに判断させてください。その答えは、このページのどのベンチマーク表より価値があり、私のものも含みます。