

要点
DeepInferはDeepSeek自身のAPIを動かしているエンジンで、2026年10月20日からGitHubでApache 2.0ライセンスの無料公開となりました。コードは無料ですが、効率よく動かすための入場券は約128基のBlackwell GPUです。これはDeepSeek自身が挙げる最小の効率的な単位です。AWSが掲載する最安のBlackwell料金で計算すると1日あたり約32,500ドルで、同じ金額でDeepSeek APIのオフピーク価格なら540億出力トークンが買えます。
つまり、このリリースは重要ですが、「DeepSeekを自前で動かすキット」としてではありません。対応モデルは1つ(V4.1 Flash)、対応チップは2系統で、DeepSeekの数字を支えているKVキャッシュシステムとロードバランサーは含まれていません。本当の対象は推論プロバイダーとラボであり、本当の影響は他社のAPI価格に表れます。
AIに顧客対応をさせたくてDeepInferを読んでいるなら、GPUの計算は丸ごと飛ばして構いません。私はeeselの裏側のエージェントを作っており、SE RankingはZendesk上で3つを稼働させ、自前の推論スタックなしで1か月に4,650件の会話を処理しています。
DeepInferとは?
DeepInferはDeepSeekの社内推論フレームワークです。学習済みモデルを受け取り、何百万人ものユーザーに高速かつ低コストで提供するソフトウェアです。GitHubのREADMEは、これを"the high-performance inference framework that powers DeepSeek's large-scale production services."と呼んでいます。DeepSeekは2026年10月20日にXで発表し、Hacker Newsのスレッドは数日で2,353ポイント、892コメントに達しました。
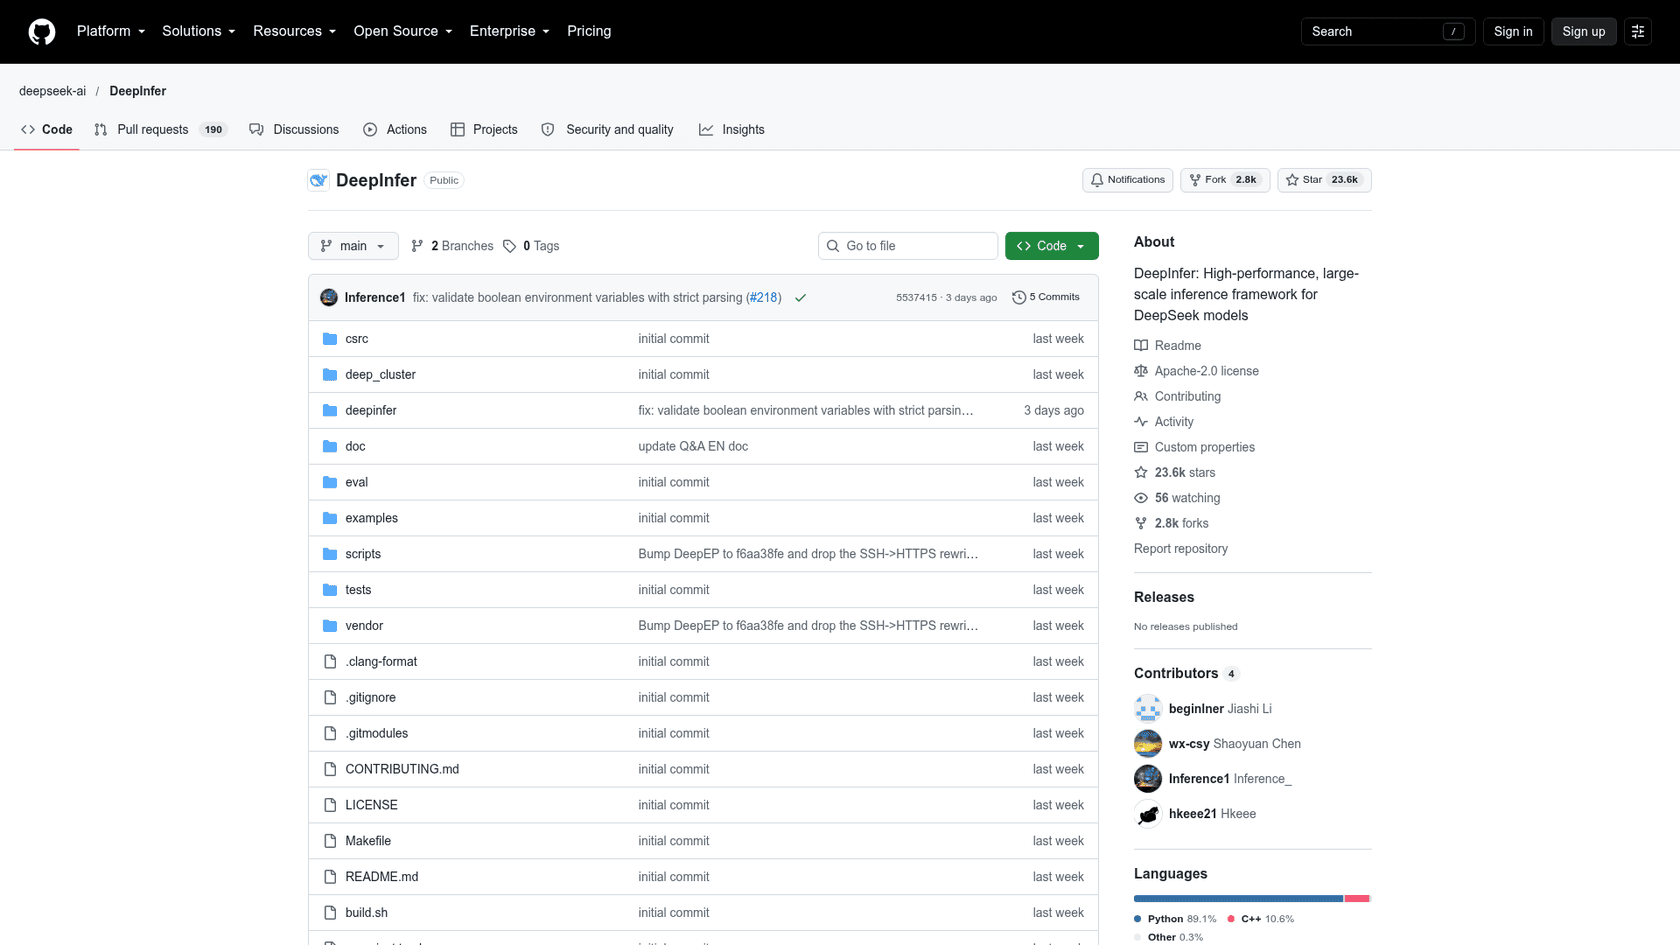
「推論フレームワーク」が初めての方へ。学習はモデルを作る工程で、推論は誰かがモデルに質問するたびに行われる処理です。vLLMやSGLangのようなオープンソースエンジンが、すでにほとんどのオープンモデルでこの役割を担っています。DeepInferはDeepSeekによる独自の派生で、READMEは率直に"was originally built primarily on vLLM, with additional inspiration from SGLang and TensorRT-LLM."と書いています。
公開内容の要約を、READMEからそのままお見せします。
| DeepInfer、2026年10月リリース | |
|---|---|
| ライセンス | Apache 2.0 |
| 対応モデル | DeepSeek-V4.1-Flashのみ |
| 対応ハードウェア | NVIDIA SM100 GPU、Huawei Ascend 950 NPU |
| ソフトウェア | Linux、GCC 13+、Python 3.12、CUDA 13またはCANN 9.2 |
| モード | オフライン推論(バッチ)、すぐ使えるAPIサーバーではない |
| 言語 | Python 89.1%、C++ 10.6% |
| 同時公開 | deepseek-recipe、APIからトークンへのエンコーダー |
提供対象のモデルはDeepSeek V4.1 Flashで、100万トークンのコンテキスト、ビジョン、ツール呼び出しに対応しており、私のV4.1 Flash 1017レビューで取り上げました。DeepSeekは"inference code for future DeepSeek models"も同じリポジトリに追加されると述べています。
DeepSeekは実際に何を公開したのか?
見出しは「完全オープンソース」ですが、READMEはもっと慎重です。そのギャップこそが、DeepInferを理解するうえで最も役立つ点です。
READMEによると、含まれているものは次のとおりです。
- 最適化されたカーネル:DeepSeekの過去のオープン公開物から。FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect、さらに独自のTileLangカーネル。
- 並列化:アテンションのデータ並列、エキスパート負荷分散(EPLB)付きのMoEエキスパート並列。
- DSpark投機的デコーディング:信頼度に基づいて検証をスケジューリング。
- SWA bounded replay:prefillの計算量を減らす工夫(詳細は後述)。
- 非同期スケジューリング:ステップ間でGPUがCPUを待たない。
- バッチ不変推論と決定的サンプリング:NVIDIAのみ。バッチ内の他のリクエストに関係なく、同じ入力なら同じ出力。
- 構造化出力:正規表現、JSONスキーマ、EBNF文法による制約。
そして含まれていないもの。READMEは"required for a complete inference service (not included in this release)"として3点を挙げています。
- KVキャッシュシステム。
- ビジョンエンコーダー / prefill / decodeの分離("most required engine functionality is already implemented")。
- prefillとdecodeの両方におけるデータ並列レプリカ間のロードバランシング。
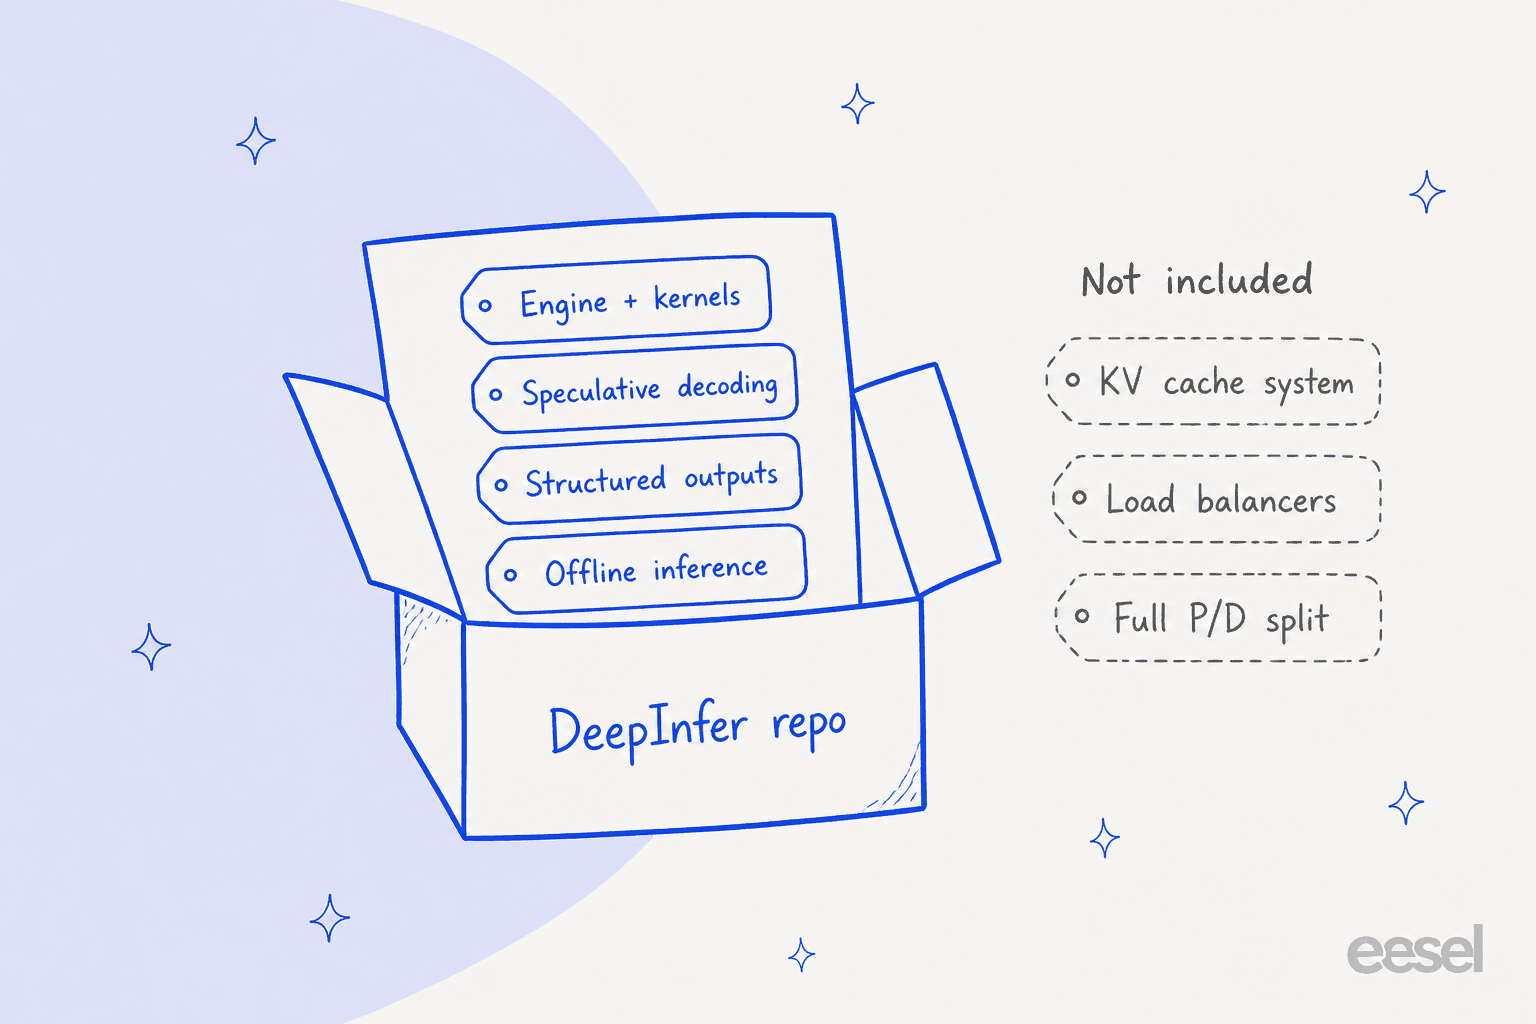
DeepSeekのデプロイメントQ&Aはその理由を説明しています。KVキャッシュとロードバランシングの部分は"are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced."とのことです。同じ文書は、その欠けている部分の仕組みをかなり詳しく説明しており、これは親切です。自分で作る必要がある部分の設計書になっています。
Hacker Newsはこれにすぐ気づきました。最も簡潔な指摘がこちらです。
"Notably missing their kv cache system"

これが重要なのは、DeepSeekの低価格の源泉がKVキャッシュだからです。同社のAPIはオフピークでキャッシュ済み入力トークン100万あたり0.003ドル、キャッシュなしで0.15ドルと、50倍の差があります。その差を生み出すエンジンこそが、手に入らない部分です。
DeepInferはどう動くのか?
DeepInferは、サービング処理を別々のGPUプールで動く独立した段階に分け、ロードバランサーと共有キャッシュでつなぎます。DeepSeekがQ&Aで公開したアーキテクチャは次のとおりです。
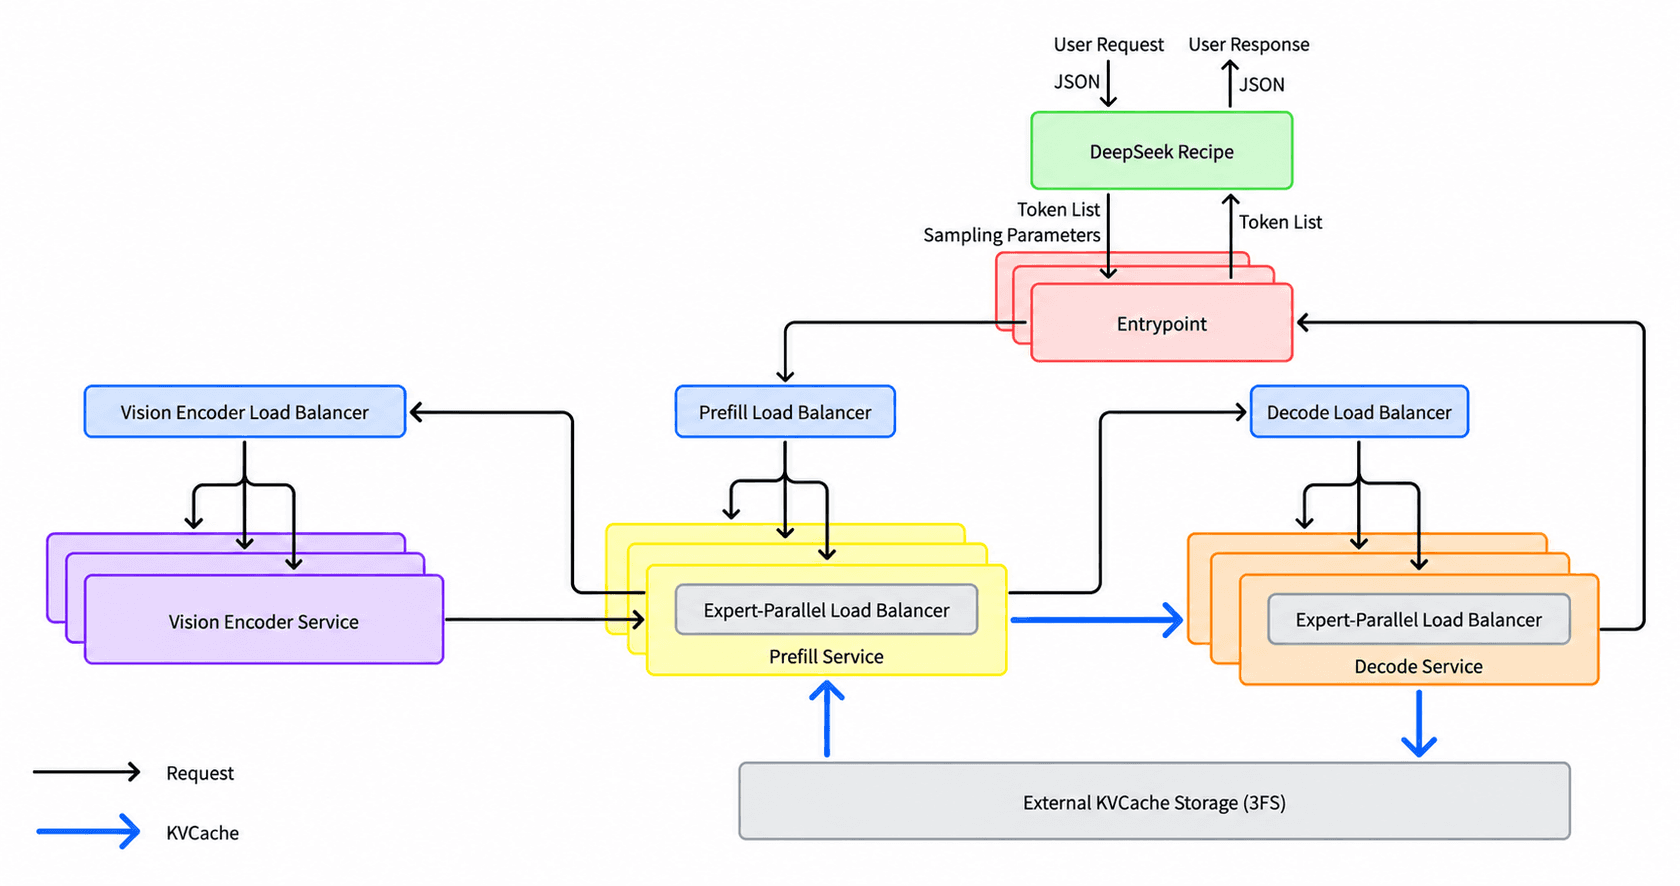
上から順に見ていきます。
- DeepSeek Recipeは、受け取ったJSONリクエスト(Chat Completions、Responses、Messages APIの形式)をトークンに変換し、出力トークンをストリーミングレスポンスに戻します。Rustで書かれ、Pythonバインディングがあります。
- エントリーポイントはキャッシュに一致するプレフィックスがあるか確認し、リクエストを振り分けます。
- Prefillはプロンプト全体を読み、アテンション状態を作ります。DeepSeekは"ordinary 8-GPU machines"で、エキスパート並列2〜8で動かしています。
- Decodeは回答を1トークンずつ生成します。ここは広く展開されます。エキスパート並列は64〜128 GPUです。
- KVキャッシュは専用のストレージクラスターに書き込まれ、同じプレフィックスを持つ次のリクエストがprefillを省略できます。
分けているのは、2つの処理がハードウェアに別々の負荷をかけるからです。Prefillは長いプロンプトに対する大きな計算の塊で、decodeはメモリ転送がボトルネックになる小さなステップの長い連続です。別々のGPUプールで動かすことで、それぞれを調整でき、最初のトークンまでの時間と、その後の各トークンの速度を独立して制御できます。
ワイドなエキスパート並列
V4.1 FlashはMixture-of-Expertsモデルで、各トークンはモデル内の「エキスパート」サブネットワークの一部だけを活性化します。エキスパートを8基ではなく64基のGPUに分散させると、各GPUが持つエキスパートが減り、ステップごとに動かすメモリが減ります。DeepSeek自身のチャートがその効果を示しています。
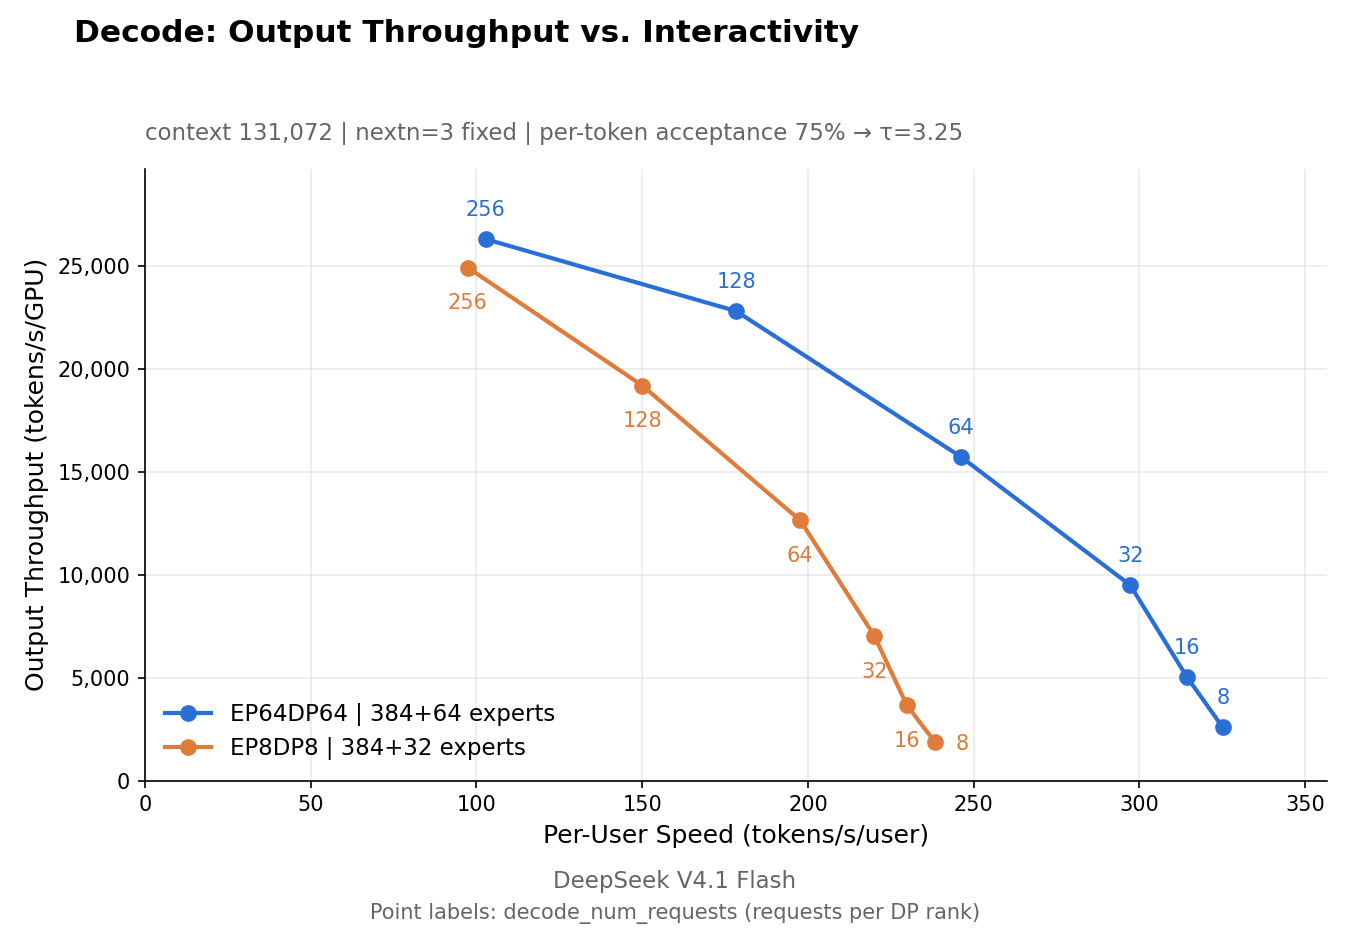
ランクあたり64リクエストの場合、EP64構成は1GPUあたり毎秒約15,700トークン、ユーザーあたり毎秒約246トークンです。EP8は約12,600で、ユーザーあたり198と遅くなります。ワイドにすることで、DeepSeekは速さと安さを両立できています。そして、それが最小構成がこれほど大きい理由でもあります。
DSpark投機的デコーディング
投機的デコーディングでは、小さなドラフトモデルが次の数トークンを予測し、メインモデルが1回のパスでそれを検証します。DeepSeekの工夫は、「Confidence Head」がどの予測が当たりそうかを見積もり、有望なものにだけ検証の計算を使う点です。Q&Aによると、これでステップあたりの検証対象ドラフトトークンが約30%減り(5.00から3.2〜4.4へ)、受理される長さはほぼ変わりません(3.29対3.20)。結果として、本番の運用点でスループットが+4〜7%向上します。控えめですが、1日155兆トークンの規模では、5%は大量のGPUに相当します。
SWA bounded replay
これが最も巧みな部分です。キャッシュ済みプレフィックスにスライディングウィンドウ・アテンションの状態の一部が欠けているとき、DeepInferはウィンドウ全体ではなく最後の128トークンだけを再計算します。Q&Aによれば、再計算コストは"a constant, independent of context length and layer count"になり、decoder側のバージョンでは"nearly halving total prefill computation"になります。READMEではDEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compactで有効にします。
自分で作る必要があるKVキャッシュ
DeepSeekのキャッシュ層は巨大です。Q&Aによると、3FSファイルシステム上に約100 PiBのSSDストレージがあり、キャッシュ済みプロンプトはエージェントのトラフィックで3日、チャットボットのトラフィックで7日保持され、オンラインではGPUあたり約14.4 TBの論理キャッシュを持ちます。この長い保持期間こそ、DeepSeekに戻ってくる会話が非常に安い理由であり、"tightly coupled to our internal infrastructure"な部分です。
DeepInferを動かすには何が必要か?
DeepInferが自分向けかどうかは、2つの数字で決まります。ハードウェア要件と、最小クラスターサイズです。
ハードウェア。 NVIDIA SM100(Blackwell)GPUとHuawei Ascend 950 NPUのみ。Hopper(H100/H200)や一般向けカードは非対応です。コミュニティのリポジトリDeepinfer-SM80は、すでにアイデアを旧世代のAmpere GPUに移植しており、人々が実際に持っているハードウェアで動くバージョンへの需要の大きさがうかがえます。
セットアップ。 マシンがあれば、手順は短いです。
# Use `ascend` instead for the Ascend platform
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
python examples/offline_inference.py --ep 8
初回実行時に、Hugging Faceからdeepseek-ai/DeepSeek-V4.1-Flash-1017チェックポイントをダウンロードします。これはオフライン(バッチ)推論で、プロンプトを渡すと出力が返ってきます。OpenAI互換サーバーは同梱されていません。
最小クラスター。 多くの報道が触れていない点です。Q&Aには"the smallest efficient deployment unit is 64 GPUs of prefill plus 64 GPUs of decode."とあります。技術的にはprefillノード1つとdecodeノード1つでも動かせますが、decodeはEP64以上向けに調整されており、上記の効率の数字はそれを前提としています。
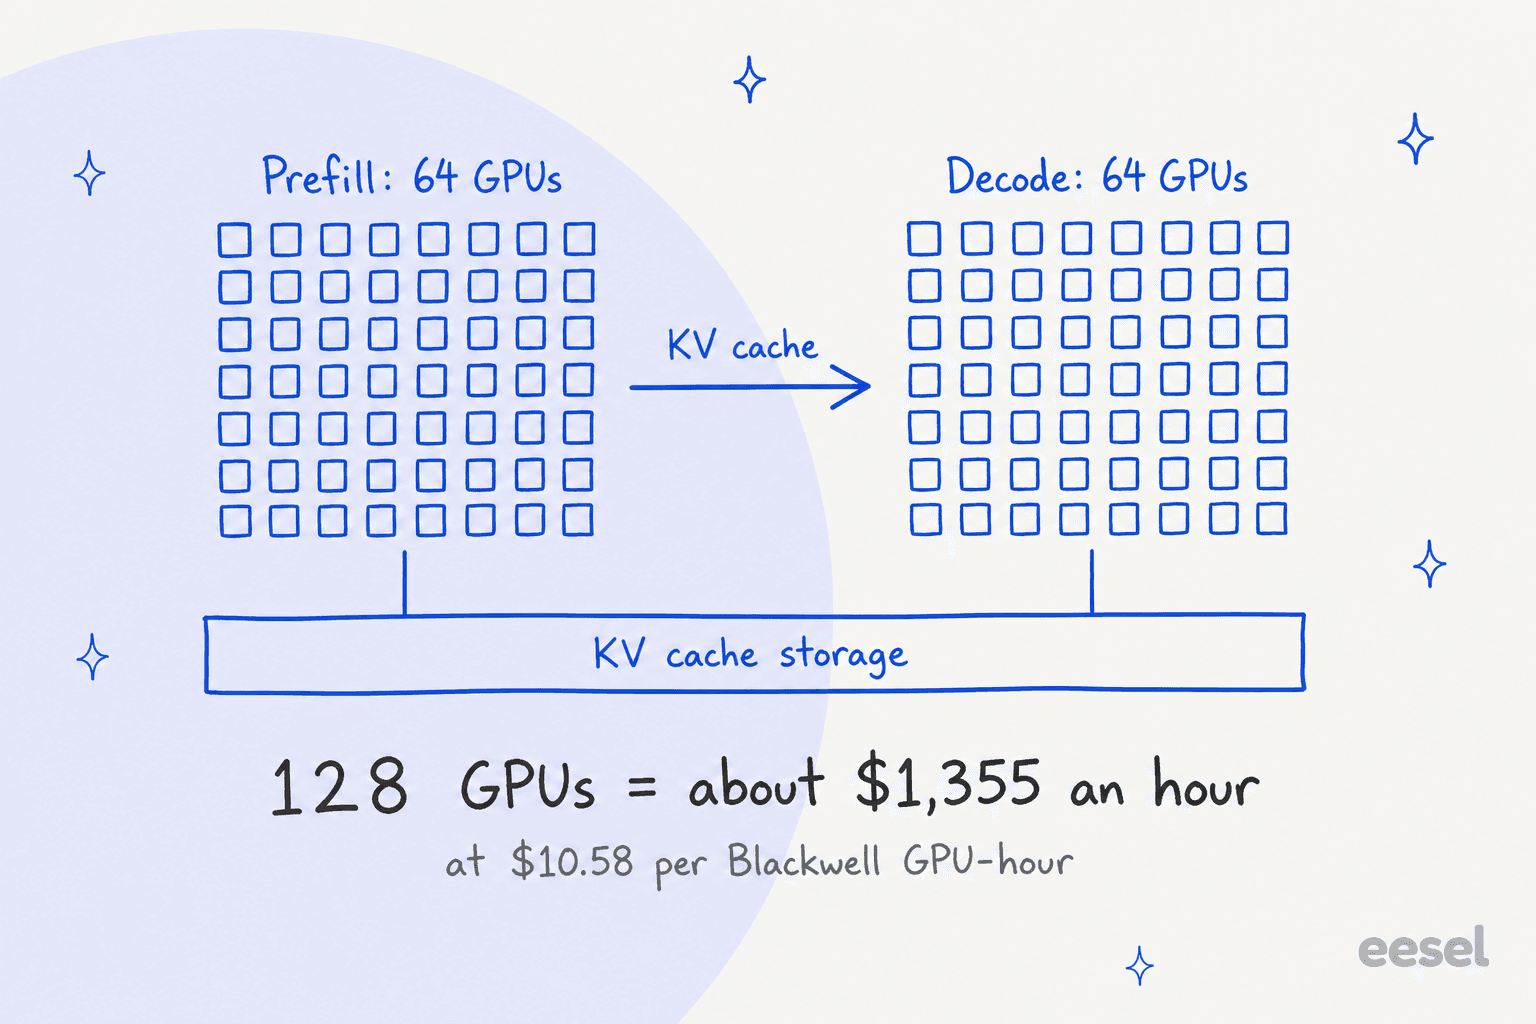
さらにストレージも必要です。DeepSeekは、KVキャッシュストレージサーバー1台あたり30.73 TBのSSDを20本、それぞれ読み出し40 GB/s以上で、24時間分のデータを保持できる容量にすることを推奨しています。READMEを読んだチームのほとんどは、そんなものを遊ばせてはいません。
DeepInferの費用はいくらか?
DeepInfer自体は0ドルです。それ以外はすべてハードウェアで、公平な比較対象はDeepSeek APIをそのまま呼び出す場合です。
DeepInferが提供するのと同じモデルについて、DeepSeekが料金ページで請求している金額は次のとおりです。
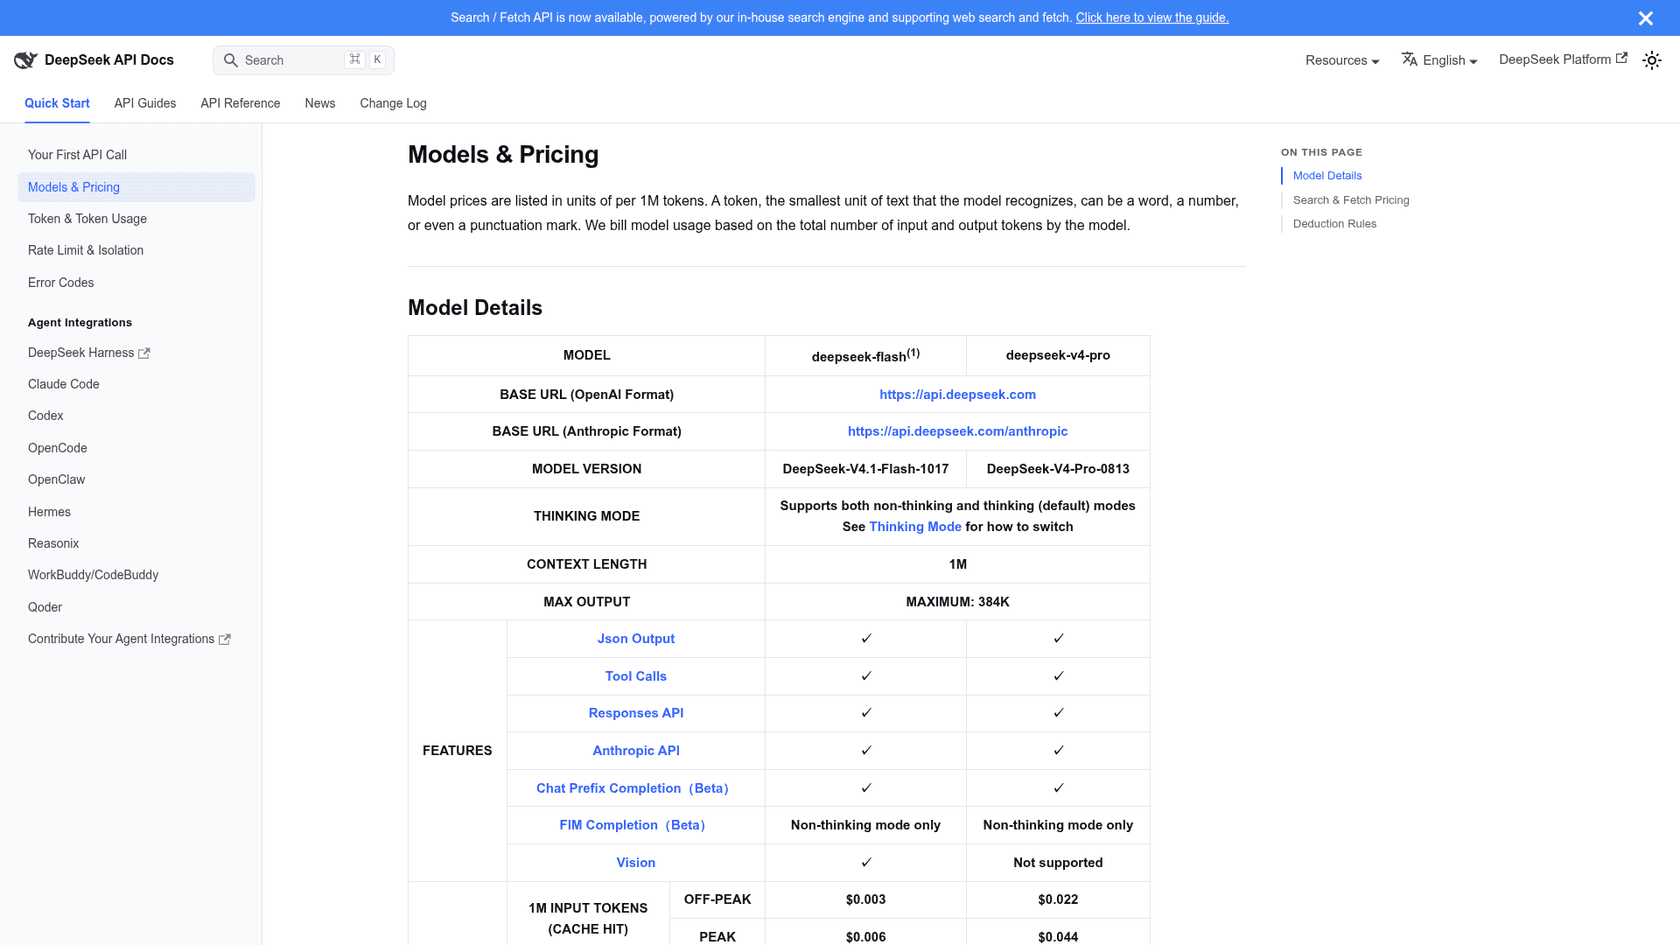
| 100万トークンあたり | V4.1 Flash、オフピーク | V4.1 Flash、ピーク | V4 Pro、オフピーク | V4 Pro、ピーク |
|---|---|---|---|---|
| 入力、キャッシュヒット | $0.003 | $0.006 | $0.022 | $0.044 |
| 入力、キャッシュミス | $0.15 | $0.30 | $0.66 | $1.32 |
| 出力 | $0.60 | $1.20 | $1.98 | $3.96 |
ピーク時間帯は平日のUTC 01:00〜04:00と06:00〜10:00で、それ以外は週末を含めて半額です。私のV4.1 Flash料金ガイドでは、この時間帯を詳しく解説しており、V4 Flash vs V4 Proの比較では、大きいモデルが見合うケースを扱っています。
次にセルフホスティング側です。AWS EC2 Capacity Blocksでは、GB200がアクセラレーター1時間あたり10.582ドル(US East Dallas Local Zone)、B200が14.208ドル(オハイオ、バージニア、オレゴンなど)です。どちらもSM100 Blackwellです。
| 128 GPUクラスター | 1時間 | 1日 | 30日 |
|---|---|---|---|
| GB200、$10.582/GPU時間 | $1,354 | $32,508 | $975,240 |
| B200、$14.208/GPU時間 | $1,819 | $43,647 | $1,309,402 |
これはストレージサーバー、ネットワーク、不足しているKVキャッシュとロードバランサーを作るエンジニアの費用を含まない金額です。32,508ドルあれば、DeepSeekのオフピーク料金で542億出力トークンが買えます。ピーク料金なら270億です。
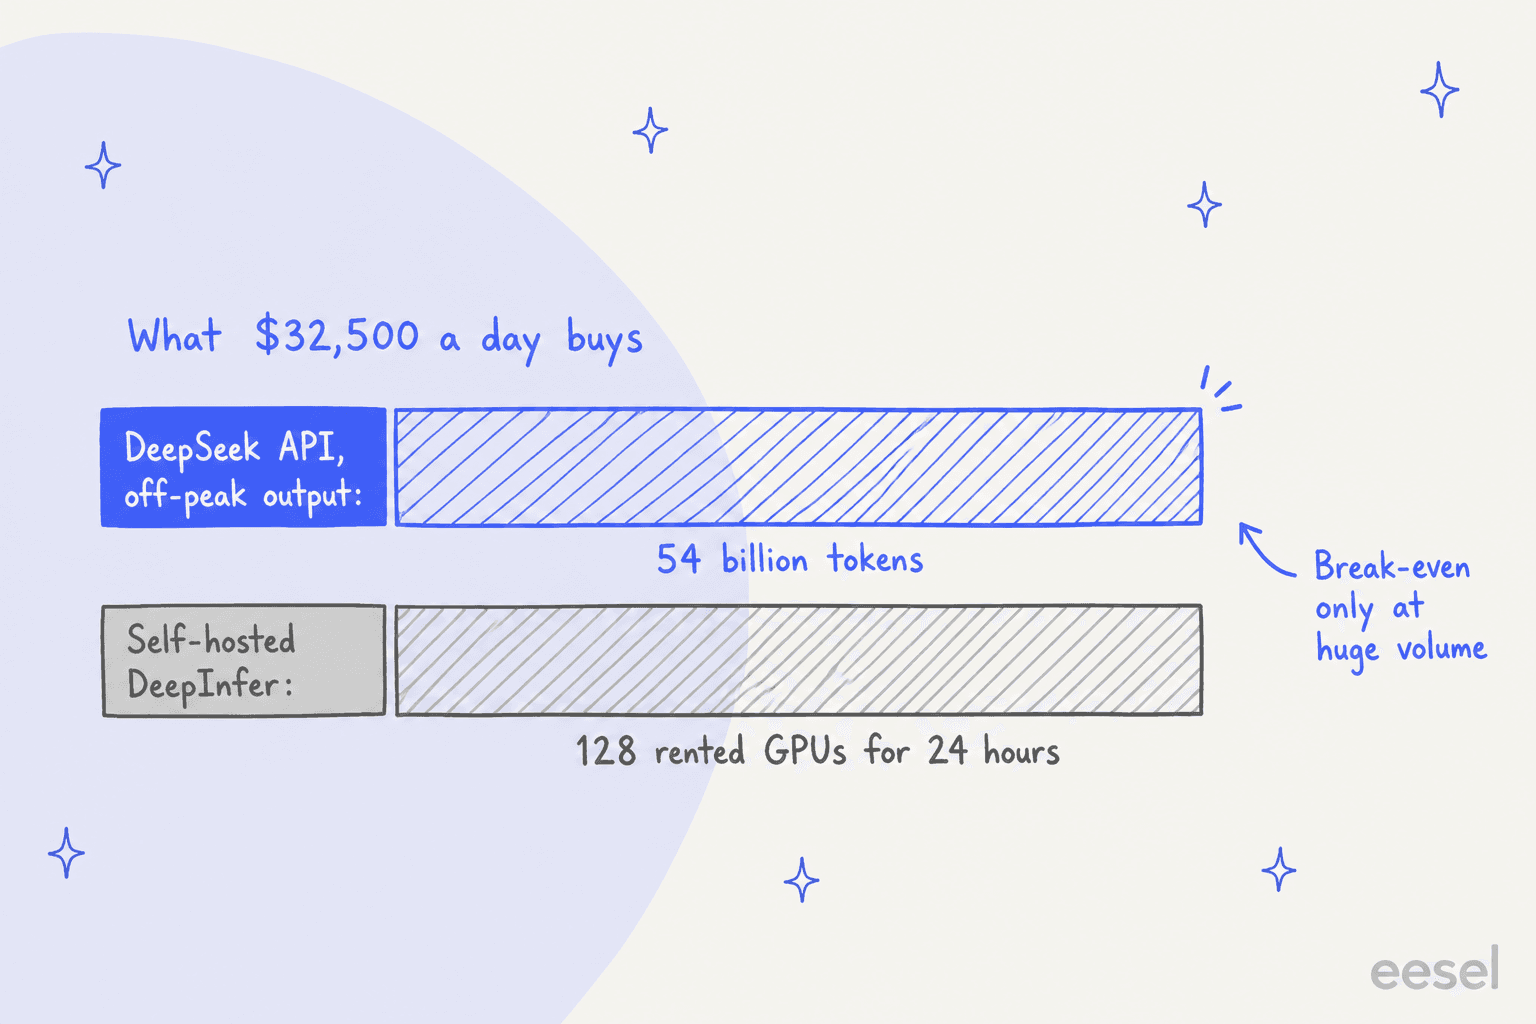
128基のGPUで、そもそもそれだけ生成できるのでしょうか。DeepSeek自身のdecodeベンチマーク(ランクあたり64リクエストで1GPUあたり毎秒約15,700トークン)を64基のdecode GPUに当てはめると、上限は1日約870億出力トークンです。DeepSeekは、ロードバランシングで"roughly 80% of a perfectly balanced offline benchmark"に達するとしており、これで約690億になります。つまり、セルフホストがオフピークのAPIに勝つのは、DeepSeek自身の本番効率の約80%を24時間維持でき、しかもDeepSeekが公開していないインフラを備えている場合だけです。これは見積もりであって、正式な試算ではありませんが、判断の形は見えてきます。
ご自身の使用量で試算してみてください。
デフォルトの数値(1日の出力5億トークン、入力30億トークンという、かなり忙しいプロダクト)では、APIは1日約680ドル、GPUは32,508ドルです。ハードウェアだけでクラスターが勝つには、その約48倍のトラフィックが必要です。
GPU時間あたり38ドルという数字が示すもの
ローンチで最も引用された一文は、READMEではなくQ&Aにあります。"A single cluster currently serves 155 trillion tokens per day, with overall revenue of US$38 per GPU-hour (at valley pricing)."。Valley pricingとはオフピーク料金のことです。
上記のAWS料金と並べると、DeepSeekは同じ1時間にBlackwell GPUを借りる費用の約2.7〜3.6倍を稼いでいることになります。それでいてオフピークの出力は100万トークンあたり0.60ドルです。DeepSeekはこの数字がどのカードを指すのか述べておらず、自社のコストも明かしていないため、利益率ではなく売上として受け取ってください。HNもこの差に気づきました。
"For comparison, rental prices seem to be ~$2.75/ per H-100-hour [1]. Meanwhile, Deepseek says "38 USD per hour per card". They haven't specified which card as far as I can tell."
要点は、DeepSeekが裕福だということではありません。サービングスタックがここまで効率的なら、安いAPI価格でも実際に事業として成り立つということです。同じオープンウェイトに高い料金を付けているすべてのプロバイダーに圧力がかかり、DeepInferはそのためのお手本を渡します。
DeepInferについて開発者は何と言っているか
反応は3つに分かれました。オープン化への期待、欠けているものへの懐疑、そして誰が得をするのかという鋭い指摘です。
HNスレッドからの懐疑的な意見です。
"Deepseek released just enough to stir the pot but not enough to cook your own from scratch. Wake me up when we can clone, point it at a dozen H100s we own, and get a working production service."
どちらの点も妥当です。H100は非対応で、本番用の部品も揃っていません。一方で、このリリースの前から、サードパーティのホスト事業者はDeepSeekのモデルで激しく競っていました。
"Together.ai, Baseten, and others have already achieved higher throughput, lower latency, and lower E2E latency for DeepSeek V4.1 Flash 1017 than DeepSeek's own inference service."
Together AI、Baseten、Fireworks AIのようなプロバイダーこそ、DeepInferのカーネルやdeepseek-recipeエンコーダーを実際に活用できる存在です。DeepSeekはこのエンコーダーを"fully aligned with the official DeepSeek API, so third-party deployments get the same API behavior as the official one."としています。開発者にとっては、サードパーティのホストで動くDeepSeekモデルも、DeepSeek本家と同じようにツール呼び出しや推論を解釈するはずだ、ということです。目立ちませんが、実際に意味のある改善です。
そして、エンジンとは関係のない料金モデルについての指摘です。
"Even though their API price is cheap compared to OpenAI/Anthropic, I still can't "afford" to use their API because the subscriptions from OAI/Anthropic provide far higher value and peace of mind. I know for sure how much I need to pay each month."
DeepSeek自身の発表は、目的を"the community lower compute costs, reduce energy use, and make AI more affordable."の手助けだと述べています。この投稿はXで43,339件のいいねを集めました。
DeepInferはvLLMやSGLangとどう違うのか?
DeepInferは、まだvLLMやSGLangの汎用的なライバルではありません。それらをベースに作られた専門エンジンです。各プロジェクトのREADMEに基づく3者の比較は次のとおりです。
| DeepInfer | vLLM | SGLang | |
|---|---|---|---|
| モデル | DeepSeek V4.1 Flashのみ | 多数のオープンモデルファミリー | 多数のオープンモデルファミリー |
| ハードウェア | Blackwell(SM100)、Ascend 950 | 複数のGPU・アクセラレーターベンダー | 複数のGPU・アクセラレーターベンダー |
| オンラインAPIサーバー | このリリースには含まれない | あり、OpenAI互換 | あり、OpenAI互換 |
| 由来 | 主にvLLMをベースに構築 | オリジナルプロジェクト | オリジナルプロジェクト |
| 向いている用途 | DeepSeekの本番ノウハウの研究や再利用 | ほとんどのオープンモデルの提供 | ほとんどのオープンモデルの提供 |
今週、オープンモデルを提供するエンジンを選ぶなら、答えは今もvLLMかSGLangです。DeepInferは、これらのプロジェクトに次に取り込まれそうなアイデア(ワイドEP、DSpark、bounded replay)を探す場所です。GoogleのTorchTPUが同じ日にローンチされましたが、性格は同じです。チップを運用する人にとっては重要な基盤ですが、それ以外の人には見えない存在です。
DeepInferは誰にとって重要か?
短く答えると、スター数から想像されるより少数です。
- **推論プロバイダーと大手ラボ:**はい。フロンティア規模のMoEモデルを安く提供するための動作するリファレンスで、欠けている部分の設計も書かれています。
- **研究者とインフラエンジニア:**はい、学習教材として。Q&Aドキュメントは、私が読んだ中でも本番のLLMサービングに関する公開資料として最も詳細なものの1つです。
- **厳格なデータ要件があり、DeepSeekを自社ハードウェアで動かしたいチーム:**おそらく。すでにBlackwellやAscendを大規模に運用しているなら。決定的サンプリングモードは、監査にとって大きな利点です。
- **スタートアップとアプリ開発者:**いいえ。APIを使うか、Fireworks AIのようにオープンモデルを代わりに提供してくれるホストを使ってください。1つのモデルファミリーに決める前に、Kimi K3.1 ProやQwen 3.8 Maxと比較しましょう。
- **サポート・運用チーム:**いいえ。必要なのはエンジンではなく、回答です。
DeepInferはAIを提供するコストの下限を下げますが、AIを自前で運用するあなたのコストを下げるわけではありません。この2つは別のものですが、盛り上がった報道の多くはそれを混同しています。
eeselの立ち位置:これはインフラであり、eeselは従業員
DeepInferはインフラで、トークンをより安く生成できるようにします。eeselはそのスタックの反対側にあたる、仕事のために採用するAIチームメイトです。現在はAIヘルプデスクチームメイトとAIブログライターがあり、それぞれの役割に必要なスキル、連携、会社のコンテキストが最初から組み込まれています。
サポートチームにとって、モデルのコストが難しい部分だったことはありません。DeepSeekのオフピーク料金なら、キャッシュなしの入力6,000トークンと出力800トークンのチケット1件は約0.0014ドル、1セントの約7分の1です。本当に時間がかかるのは、最も優秀な担当者のようにエージェントに回答させることです。ヘルプセンターや過去のチケットを読み、引き継ぐべきタイミングを把握し、顧客に見せる前に実際の履歴で証明する必要があります。自信満々のボットが本番のキューで誤った回答をするのを見てきたので、eeselの導入はすべて、まず過去のチケットでシミュレーションされます。
SE Rankingは、その具体例です。1つのサポートチームで3つの製品を販売しているため、3つのZendesk接続に3つのeeselエージェントを稼働させ、それぞれが約16,800ページのナレッジから自社製品について回答しています。1か月(2026年8月8日〜9月8日)で4,650件の会話を処理しました。内訳はZendeskのチケット2,554件とライブチャット2,102件で、約2,100件のチャットはまずeeselが回答しました。GPUクラスターは関係していません。

ヘルプデスク内でAIにいくらかかるかを比べたいなら、推論エンジンよりも、私のZendesk AIの料金の解説とAIカスタマーサポートのガイドのほうが良い出発点です。また、どのモデルがサポートに本当に向いているか知りたい方のために、サポート向けのベストLLMについての見解を随時更新しています。
ターミナルが好きな開発者向けには、eeselにCLIがあり、ダッシュボードと同じチームメイトとワークスペースを操作できます。あなた自身、スクリプト、またはClaude Codeのようなコーディングエージェントが、ブラウザを開かずにヘルプデスクを接続し、ナレッジを追加し、過去のチケットでエージェントをテストできます。これこそ、多くのチームが「オープンなインフラ」に実際に求めているエージェント向けのアクセスです。
eeselを試す
DeepInferは、GPUクラスターを運用する人向けです。ZendeskやFreshdesk、Gorgiasで顧客に回答するAIが目的なら、eeselは過去のチケットとヘルプセンターから学習し、公開前に実際の履歴でテストされるヘルプデスクチームメイトで、料金ページにあるとおり、500件のチケットまたはチャットで月299ドルから始まります。100クレジットでeeselを無料で試すか、ターミナルからnpx @eesel/cliで始められます。
