

この2つのモデルはわずか2日違いで登場し、すぐに同じ土俵の対決として語られるようになった。DeepSeek V4 Flashは2026年7月31日にパブリックベータとなり、Qwen 3.8 Maxは8月2日に一般提供を開始したため、それ以降に書かれた比較記事はどれも価格比較に終始している。価格差は歴然としている。Flashは100万トークンあたり入力$0.14、出力$0.28。Qwenは$2.00と$6.00だ。
興味深いのは、その価格差が公開の横並び比較が唯一存在するDeepSWEでどれほどの差を生んでいないかという点だ。両者はQwenが56.6、Flashが54.4と、出力価格が21倍違うのにわずか2ポイント差で並ぶ。では料金の差は何を買っているのかというと、能力の「形」の違いだ。Flashはテキスト専用でMITライセンスのオープンウェイト、Qwenは画像・動画・ドキュメントを受け付けるがウェイトは依然未公開のままだ。さらにDeepSeek自身のベンチマーク表によれば、Flashは思考オフでHLEが8.1、最大努力設定で34.8となっており、実質的に「安い設定」と「性能の良い設定」は同じモデルの別の実行結果にすぎない。推論トークンは出力料金で課金されるため、$0.28という見出しの数字がきれいに成立するのは、モデルがはるかに弱いモードに限られる。
私はeeselでAIエージェントを構築している立場から、どちらのモデルを選ぶ前にも指摘しておきたいことがある。自信満々に間違った回答をするモデルは、トークンが安いほどむしろコストがかさむ。あるB2B技術サポートチームの顧客は、ナレッジベースに「すべての車種に対応」と書かれていたせいで、初期のボットがデータベースにまったく存在しない車種ブランドへの対応を平然と認めてしまうのを目の当たりにした。どちらの価格表にもそれを防ぐ仕組みはない。eesel AIはまさにその層であるために存在している。
60秒でわかるスコアボード
| Qwen 3.8 Max | DeepSeek V4 Flash | |
|---|---|---|
| モデルID | qwen3.8-max | deepseek-v4-flash |
| 固定ビルド | Qwen3.8-Max | DeepSeek-V4-Flash-0731 |
| リリース日 | 2026年8月2日 | 2026年7月31日 |
| 入力 / 100万 | $2.00 | $0.14 |
| キャッシュ入力 / 100万 | $0.25 | $0.0028 |
| 出力 / 100万 | $6.00 | $0.28 |
| コンテキストウィンドウ | 1,000,000 | 1,000,000 |
| 最大出力 | 131,072 | 384,000 |
| アーキテクチャ | 総2.4T / アクティブ95B MoE | 総284B / アクティブ13B MoE |
| ウェイト | 約束済み・未公開 | オープン、MIT |
| 入力形式 | テキスト、画像、動画、ドキュメント | テキスト |
| デフォルト推論設定 | xhigh、preserve_thinking有効 | 思考オン、努力度high |
| 最大推論トークン数 | 262,144 | 非公開 |
| スループット上限 | 2M TPM、15K RPM | 同時2,500リクエスト |
| LMArenaテキスト順位 | #5、1496 | #79、1436 |
| AAインテリジェンス指数 | 未計測 | 50 |
| 予定されている価格変更 | 発表なし | ピーク時2倍 |
この中で2つの行が大きな意味を持つ。出力上限は静かに効いてくる要素で、Flashは1回の応答で384Kトークンを書けるのに対し、Qwenは131,072トークンにとどまる。これはチャットの返信ではなく長い成果物を生成する用途で効いてくる。もう一つはピーク時の価格変更予定で、これはスプレッドシートに書き留めておきたい項目だ。どちらの側でも唯一発表されている今後の価格変更だからだ。
実際にいくら払うことになるか計算する
上記の比率はトークン単位の話だ。実際に気になるのは請求額であり、それは料金表そのものよりもトラフィックの形に左右される。ダイヤルを動かしてみてほしい。
DeepSeek V4 Flashの正体
FlashはDeepSeekのV4ファミリーの中で小型に位置づけられるモデルであり、その「小型」という言葉には実質的な意味がある。DeepSeekのモデルダウンロード表によれば、Flashは総パラメータ284B、アクティブパラメータはわずか13BのMixture-of-Expertsモデルで、V4 Proの総1.6T・アクティブ49Bとは対照的だ。参考までに、DeepSeekの前世代モデルV3.2-Baseは総671B・アクティブ37Bだったので、Flashはその置き換え対象のモデルの半分以下のサイズしかない。アクティブパラメータ130億という数字は、マーケティングで「フロンティア」を謳うようなモデルというより、小規模言語モデルに近いトークンあたりの計算量を意味する。
APIのエイリアスの裏にあるビルドはDeepSeek-V4-Flash-0731で、DeepSeekはこれが新しいアーキテクチャではないことを珍しいほど率直に認めている。変更履歴には、プレビュー版と同じアーキテクチャ・サイズを維持し「事後学習をやり直しただけ」だと書かれている。この告白は重要だ。というのも、プレビュー版と0731の間のベンチマークの伸びは非常に大きいからだ。DeepSeekが公開した表では、同一のウェイトのまま、事後学習だけの違いでDeepSWEが7.3から54.4へと上昇している。
V4のモデルカードでは3つのアーキテクチャ上の要素が挙げられている。Compressed Sparse AttentionとHeavily Compressed Attentionを組み合わせたハイブリッド構成、層をまたいだ信号の安定性のためのManifold-Constrained Hyper-Connections、そしてMuonオプティマイザだ。誰もが引用する効率性の主張、V3.2比でシングルトークン推論FLOPsが27%・KVキャッシュが10%という数字はProで計測されたものでFlashではないため、このモデルについて語るときはその点に注意した方がいい。
これを生業にしている立場から気になる点が2つある。投機的デコーディングは別のドラフトモデルとしてではなくチェックポイント内に組み込まれており、vLLMでは1つのフラグを立てるだけで済む。DeepSeekは、これをドラフトパスに向けないよう明確に警告している。そしてウェイトはMITライセンスで、FP4とFP8の混合精度で約167GB、Hugging Face上にはすでに57種類の量子化版が公開されている。フロンティア級に近いモデルを自前のハードウェアで動かしたいのであれば、これがすべてを決める要素になる。
Qwen 3.8 Maxの正体
Qwenはほぼすべての軸で逆方向に進んだ。Alibabaのフラッグシップは総パラメータ2.4兆・アクティブ950億のスパースMoEであり、1兆パラメータを超える初のマルチモーダルモデルで、テキスト・画像・動画・ドキュメントを受け付ける。Qwenチームのプレビュー発表では「Fable 5に次ぐ性能」とされていたが、当時はベンチマーク表もモデルカードもライセンスもなかった。
8月2日の一般提供開始で数字の問題は解消された。だがオープン性の問題は解消されていない。GA発表の投稿では完全なベンチマークチャートと100万トークンのウィンドウが公開され、QwenCloudには現在$2と$6という実際の料金表があり、暗黙のキャッシュ読み取りは$0.25となっている。
ウェイトはHugging FaceとModelScopeでの公開が約束され、GA時点でも「来週」公開予定と改めて表明されたが、いまだに公開されていない。したがってライセンスについて正直に言えば、一方は今日時点でオープンソースであり、もう一方はまだ約束にすぎない。ウェイトが必要な場合にこれが何を意味するかは、私のQwen 3.8 Max代替案のまとめで詳しく扱っており、プレビュー時点の料金が現在の料金にどう変わったかはQwen 3.8 Max料金ガイドで追っている。
もう一つ知っておくべきなのは能力ではなくデフォルト設定についてだ。Qwenはデフォルトでxhigh推論とpreserve_thinkingが有効になっており、最大262,144の推論トークンを使う。そのすべてが出力レートで課金されるため、タスクあたりのコストとトークンあたりの料金は乖離し始める。これはOpus 5対Sonnet 5の比較で書いたのと同じ罠で、そちらでは価格の高いモデルの方が少ないトークン数で完了することでタスクあたりのコストで勝っていた。公平のために付け加えておくと、Qwen自身のコーディングハーネス設定ではmaxTokens: 65536と宣言されており、131Kという出力上限は実際に出荷されているツール側が求めている値ではない。
価格差と、それが隠している2つのこと
この価格差を縮尺どおりに図示してみた。倍率を文章だけで説明してもピンとこないからだ。
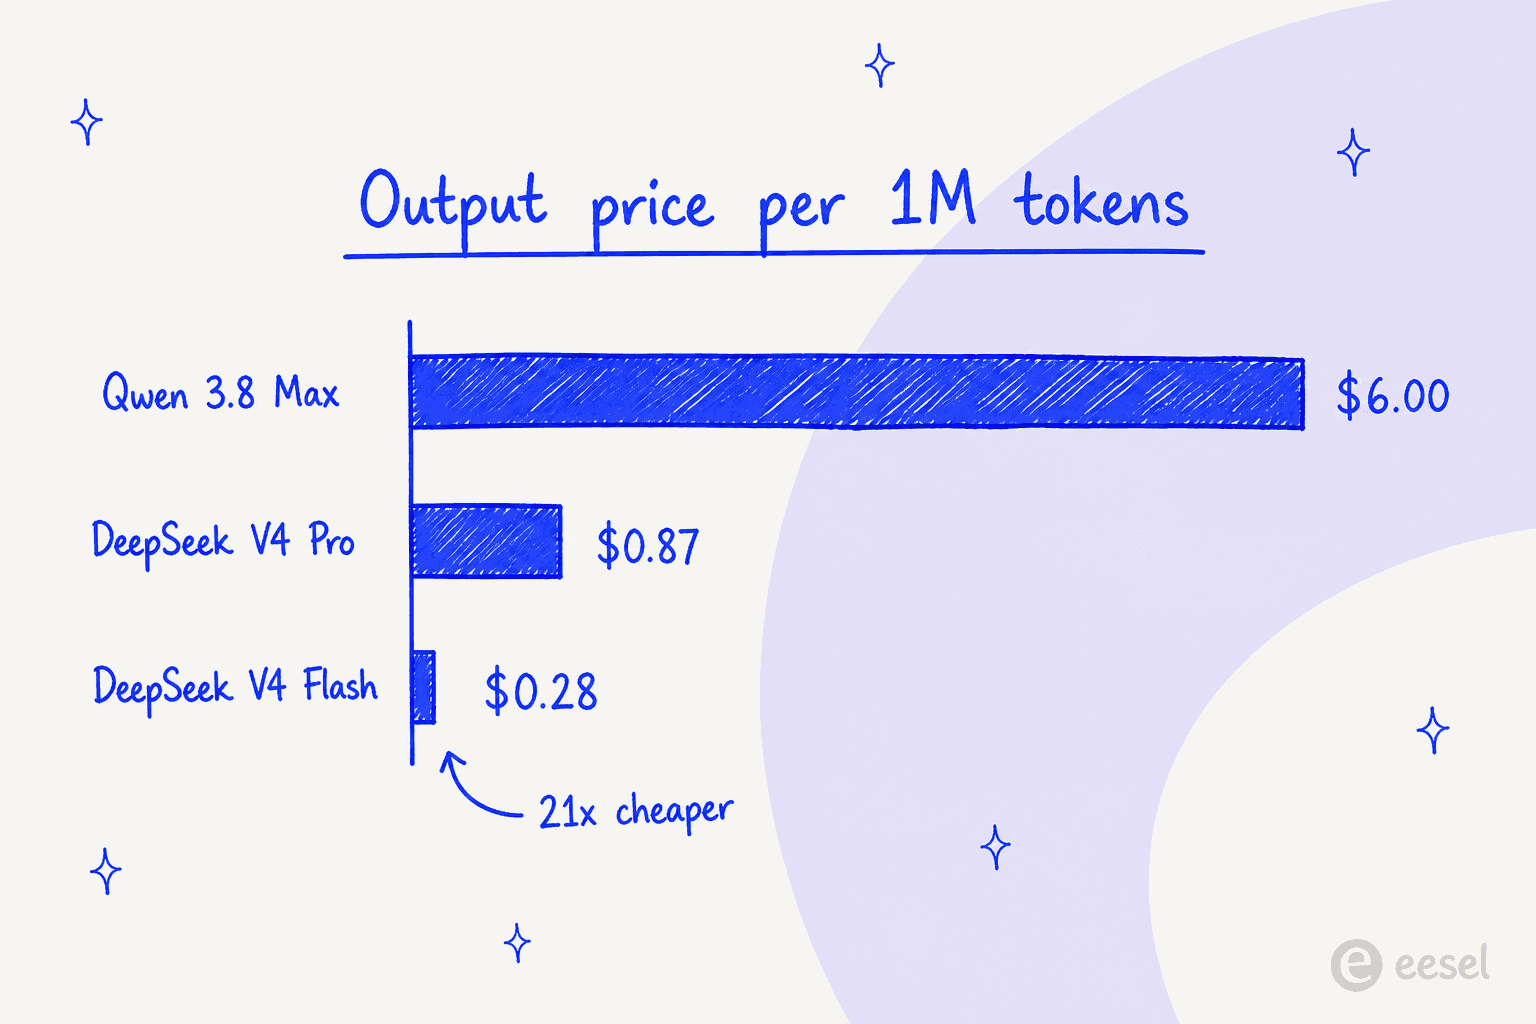
まず1つ目に隠れているもの。DeepSeekは入力料金をキャッシュヒットとキャッシュミスのレートに分けており、Flashではその差が$0.0028対$0.14、50倍の開きになる。キャッシュはコード変更なしでデフォルトで有効になっており、一見すると無料同然に聞こえるが、ヒットの判定方法を読むまでの話だ。
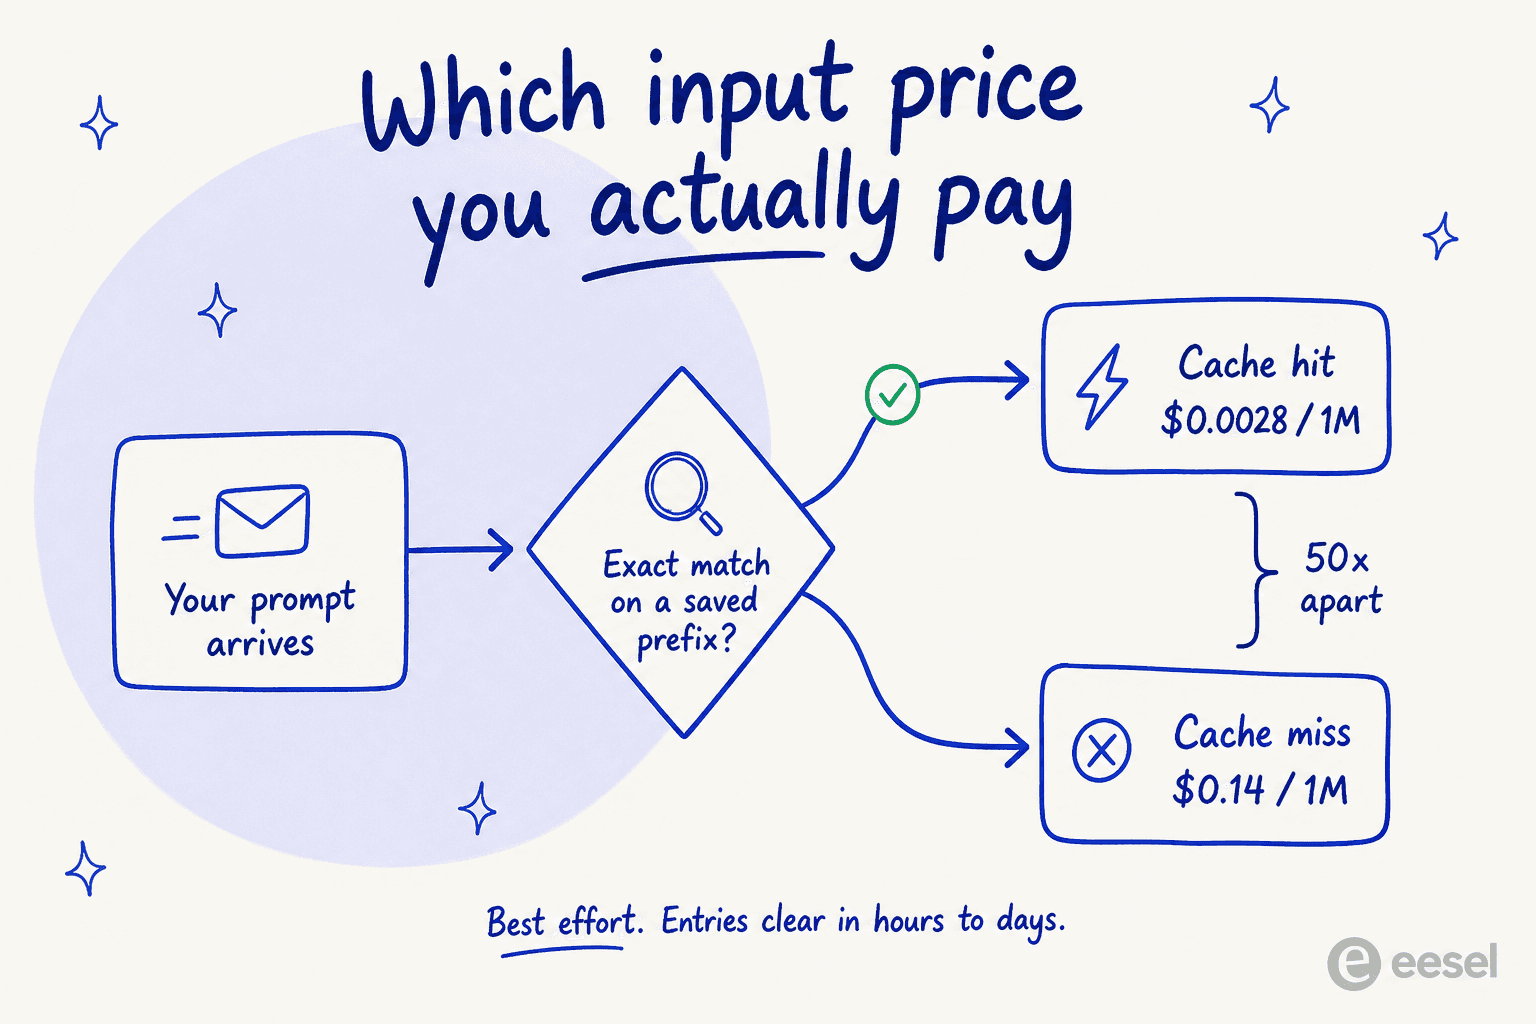
リクエストがヒットレートで課金されるのは、永続化されたキャッシュのプレフィックス単位に完全一致した場合のみだ。部分的な一致はまったくカウントされず、DeepSeekはこれをスライディングウィンドウ・アテンションのせいだとしている。DeepSeekはキャッシュを「ベストエフォート」と呼んでおり、ヒット率の保証はなく、未使用のエントリは「通常数時間から数日以内」に消去される。レスポンス内のprompt_cache_hit_tokensで呼び出しごとの内訳を確認できるし、そうすべきだ。なぜなら$0.0028というレートは予算計画の前提にできる定常状態ではないからだ。
2つ目に隠れているのは、DeepSeekの次の価格変更がどちらの方向に動くかという点だ。現時点でオフピーク割引は存在しない。その代わりに価格表では、北京時間の9:00〜12:00と14:00〜18:00のピーク時間帯について、すべての課金項目に対して「通常価格の2倍になる」と発表されている。UTCでは毎日01:00〜04:00と06:00〜10:00にあたる。適用開始日は未発表で、ピーク時のレート表も公開されていない。
私はこれとまったく同じ不安が営業の商談で表面化するのを何度も見てきた。以前話をしたある購入検討者は、前のベンダーの価格が2倍以上に跳ね上がった経験から、他の話をする前にまず契約上の価格固定について聞いてきた。開始日未定のまま「2倍になる予定」という一文があるだけで、今日のレートがどれだけ良く見えても、財務チームはそのベンダーを標準採用することを拒む。
ベンチマーク:誰の表を、誰のハーネスで動かしたのか
両ラボとも数字を公開している。だがどちらも相手のハーネスでは実行していないため、2つの表を単純に重ね合わせても、それは実在しない比較になってしまう。
DeepSeekが0731向けに公開した目玉の表は9つのエージェント系ベンチマークで構成されており、Flashはその全9項目でV4 Pro Previewを上回る一方、Claude Opus 4.8には全9項目で及ばない。Opusはその後さらに1世代進んでいる点は知っておく価値があり、その内容は私のClaude Opus 5レビューで扱っている。
| ベンチマーク | V4-Flash-0731 | V4-Flash Preview | V4-Pro Preview | Opus-4.8 |
|---|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 61.8 | 72.1 | 85.0 |
| NL2Repo | 54.2 | 39.4 | 38.5 | 69.7 |
| Cybergym | 76.7 | 38.7 | 52.7 | 83.1 |
| DeepSWE | 54.4 | 7.3 | 12.8 | 58.0 |
| Toolathlon-Verified | 70.3 | 49.7 | 55.9 | 76.2 |
| Agents' Last Exam | 25.2 | 15.8 | 16.5 | 25.7 |
| AutomationBench Public | 25.1 | 10.8 | 12.8 | 27.2 |
| DSBench-FullStack | 68.7 | 37.0 | 41.8 | 71.6 |
| DSBench-Hard | 59.6 | 25.8 | 31.1 | 71.7 |
脚注を読むと、これらの行がどれだけの重みを持つかが変わってくる。DeepSeekの0731モデルカードには、コードエージェントのタスクはmax推論努力設定で「DeepSeek Harnessのミニマルモード(公開予定)」で実行されたと書かれている。つまりこれらのスコアを生み出したハーネスは非公開であり、現時点では第三者が独立して再現することはできない。さらに9項目のうち2つ、DSBench-FullStackとDSBench-Hardは、DeepSeek自身の社内テストセットだ。
Alibabaのチャートも逆側から見た同じ形の問題を抱えている。コーディング系ベンチマークのうち6つはQwen社内の評価であり、競合のスコアは同一条件ではなく混在したハーネスから取られている。いくつかの行はライバルモデル自身によって採点されてもいる。このチャートについてはQwen 3.8 Max対GPT-5.6の比較記事できちんと検証している。
同一条件での比較が成立している唯一の場所は、DeepSeek自身のモード横断表の中であり、正直に言えばこの記事全体の中で最も有用な部分だ。
| ベンチマーク | Flash non-think | Flash high | Flash max |
|---|---|---|---|
| HLE (Pass@1) | 8.1 | 29.4 | 34.8 |
| Apex (Pass@1) | 1.0 | 19.1 | 33.0 |
| LiveCodeBench (Pass@1) | 55.2 | 88.4 | 91.6 |
| GPQA Diamond (Pass@1) | 71.2 | 87.4 | 88.1 |
| MRCR 1M (MMR) | 37.5 | 76.9 | 78.7 |
同じウェイト、同じ価格表。3つの設定。非思考モードのFlashはHLEで8.1、Apexで1.0だが、最大努力設定では34.8と33.0になる。このモデルで思考をオフにするのは小さなトレードオフではなく、オンにすれば推論トークンを出力レートで支払うことになり、384Kという上限まで埋める余地がある。$0.28という数字を引用する人には、まずこの一文を読んでほしい。
DeepSeekはFlashがProに劣る部分についても正直で、そこは評価したい。モデルカードの記述によれば、Flash-Maxはより大きな思考予算を与えれば同等の推論性能に達するが、「純粋な知識タスクと最も複雑なエージェント型ワークフローではやや劣る」という。数字もそれを裏付けている。SimpleQA-VerifiedはFlash Maxが34.1、Pro Maxが57.9だ。アクティブパラメータ130億という規模では世界知識の獲得にコストがかかり、この差はプレビュー版で計測されたものなので、0731がそれを埋めたと主張する根拠は誰にもない。
独立系ボードは何を語り、どこで意見が分かれるか
この比較の「わかりやすいバージョン」が崩れるのはここだ。独立した審判が2つ存在する。両者は異なるものを計測しており、現時点では正反対の方向を指し示している。
Artificial Analysisは、最大努力設定のDeepSeek V4 Flashにインテリジェンス指数50を与えており、オープンウェイトモデルの中で3位、タスクあたりコストは**$0.03だ。同じボードは、同じウェイトの非推論バリアントに29**というスコアを与えている。つまり先ほどの指摘はDeepSeekの社内表だけの話ではなく、外部の評価機関が「安い設定」と「良い設定」の間に21ポイントものインテリジェンスの振れ幅を計測したということだ。
Artificial Analysisはまた、価格面の話と矛盾する点も1つ指摘している。Flashはインテリジェンス指数を完了させるのに2億1000万の出力トークンを消費しており、これは同クラスの中央値である1億の2倍以上だ。ボード自身の言葉では「比較して非常に冗長」と表現されている。それでも実行全体のコストはわずか$72.02で、ここでは安いトークンが冗長さを吸収した形だ。しかしこの仕組みはQwenのデフォルト設定について指摘したのと同じもので、実際に冗長さの問題が計測されたのは安い方のモデルだったというわけだ。この数字はもっと多くのAIコーディングツールの比較記事で公開してほしいと思う。冗長さこそが料金表を実際の請求額に変える要因だからだ。
そのボードにおけるQwenはというと、そもそも掲載されていない。2026年8月3日時点、GAのわずか1日後の時点でQwen 3.8 MaxにArtificial Analysisのスコアは存在しない。Alibaba勢で最も高いのはQwen3.7 Maxの46だ。今週Qwen 3.8 Maxの独立系インテリジェンススコアを引用している人がいれば、それは間違ったモデルを引用していることになる。
自動評価ではなく人間の好み投票であるLMArenaは、まったく逆の話を語っている。
| ボード | Qwen 3.8 Max | DeepSeek V4 Flash |
|---|---|---|
| テキスト総合順位 | #5 | #79 |
| テキストElo | 1496 ± 10 | 1436 ± 4 (48,667票) |
| WebDev | #4、1668 | #8、1577 (-highとして) |
| ビジョン | #2、1305 | 対象外 |
Eloスコアで60ポイント、順位で74位分の差が、価格が21倍高いモデルの側についている。ただしこの表をスクリーンショットする前に2つ注意点がある。QwenのWebDevとテキストの行は「暫定」タグ付きで、ボード中最も広い信頼区間を持ち、わずか1,563票で±18、対するFlashは48,667票で±4だ。また素のdeepseek-v4-flashはWebDevにまったく登場しておらず、この行はQwenをFlashの-highバリアントと比較している。
つまりスコアボードをまとめるとこうなる。自動評価の複合指標はFlashを好み、Qwenはまだ計測されていない。一方で人間はデータが薄いながらもQwenを大差で好んでいる。この「自動評価対人間評価」の分裂は、私がGPT-5.6対Claudeの比較記事で見たのとまったく同じ構図であり、だからこそ私はこうした発表について単一の数字による判定を信用しない。
この2つが実は競合していない領域
価格を取り除くと、まったく違う姿が見えてくる。この2つは異なる象限に位置しており、あなたをここに導いた検索クエリはその違いを平坦にならしてしまっている。
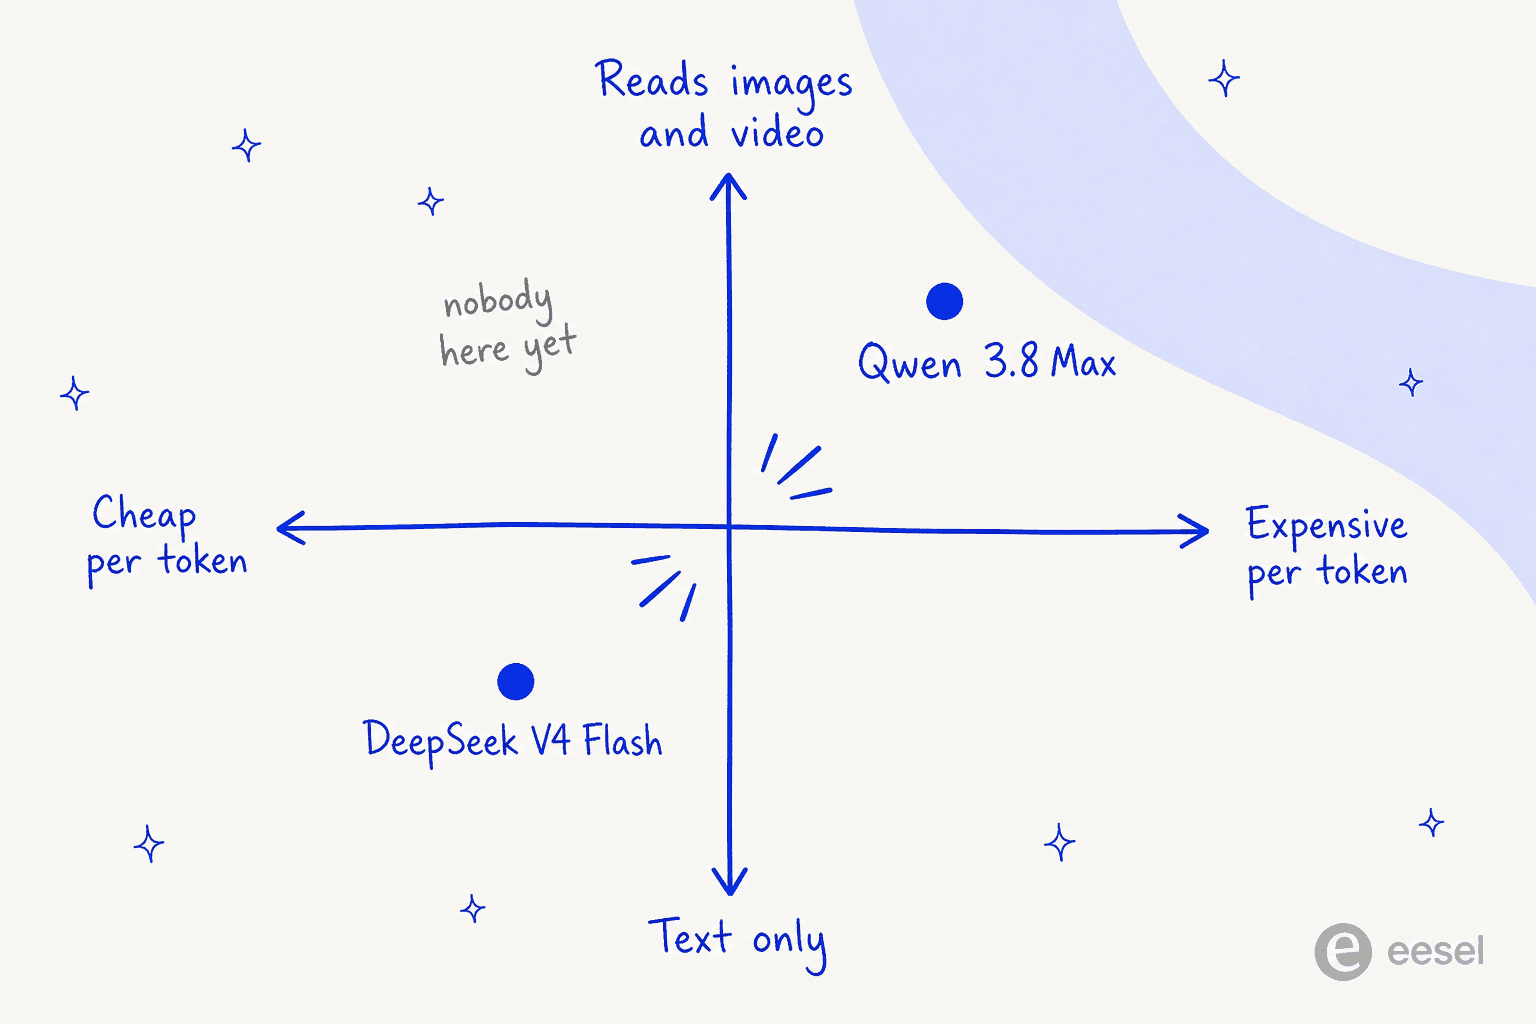
DeepSeekはV4 Flashについて画像・動画・音声・ドキュメントの入力を一切公開していない。コンフィグではビジョンエンコーダブロックを持たない因果言語モデルと宣言されており、Hugging Faceのパイプラインタグも「テキスト生成」だ。価格表の機能欄にはJSON出力、ツール呼び出し、FIMが並んでいるが、ファイル入力の行はどこにもない。DeepSeekのマルチモーダル関連の取り組みは、同じ組織内の別のモデルラインに存在している。正確を期すなら、画像入力は「文書化されていない」だけであり、「できない」と明言されているわけではない。
入力にスクリーンショットが含まれるなら、それだけで結論は決まる。顧客が壊れた製品の写真を添付するサポートキューや、図解入りのConfluenceページを読むAIエージェント、スキャンした請求書を処理するワークフローなどだ。Alibaba自身のチャートでは、ビジョン系の行はすべてQwenの明確な勝利であり、その能力はどんな価格であってもFlash側のボードには存在しない。これは、チームがカスタマーサポート向けの最良のLLMを評価する際に何度もぶつかる構図と同じだ。最も安いトークンは、たいてい添付ファイルを読めない。
入力がテキストで、ウェイトが欲しいならFlashの結論も同じくらい早く出る。MITライセンス、167GB、57種類のコミュニティ量子化版、そしてDeepSeek自身によるvLLMとSGLangのレシピが公開されている。Qwen 3.8 Maxは現時点でまったくセルフホストできず、それが私のオープンソースAIエージェントまとめの主張のすべてであり、この2つを同じノーコードAIサポートエージェントの代替可能なバックエンドとして扱うべきではない理由でもある。
実際の反応が語っていること
同一プロンプトでの横並びハンズオンはまだ誰も公開していない。片方がリリースされてまだ数時間しか経っていないことを考えれば当然だろう。存在するのは計算だ。最も鋭いものは、GA当日にある日本語のAIアカウントが投稿した1つのXの投稿によるもので、DeepSWEのスコアを並べている。Qwen 3.8 Maxが56.6、DeepSeek V4 Flashが54.4、Kimi K3が69、GLM 5.2が44。入力価格が14倍、出力価格が21倍違うのに、DeepSWEのスコア差はわずか2ポイント。
DeepSeekのローンチスレッドで誰に頼まれるでもなく投稿された「領収書」こそ、この反応全体の中で最も具体的なコストデータだ。
"I use deepseek for a lot of my personal day-to-day agent needs, and I will simply put this here and let this speak for itself, last 30 days:

ある返信はそれを上回り、12日間で21億トークンを$19.27で処理したとし、いわゆる「120倍安い入力キャッシュ」のおかげだとしつつ、そのトラフィックの大半はゴミを生成する実験的なループだったと認めている。
Qwen側で最も強いハンズオン報告は、品質についてのものではまったくない。とにかく処理を完了させることについてのものだ。
"Claude finished in around 16 min, but I spent close to 2 hours shepherding the Qwen build. For the implementation, there were signs it had good vision, but the timeouts make this very hard to use in a production setting."
Simon Willisonの「ペリカンテスト」も同じ結論に着地しており、価格も付いている。彼のHNコメントによれば、11分かかり、車輪を忘れ、コストは17セントだった。タイムアウトはモデルではなくハーネス側の問題だと反論する返信もある点も注記しておきたい。これは正当な指摘であり、どちらとも決着はついていない。
懐疑的な見方は両方向に向けられており、DeepSWEの計算をした同じアカウントは、その12日前にFlashの急上昇について率直な指摘をしていた。ウェイトが変わっていないのにDeepSWEが7.3から54.4になったことは、そのベンチマークが新しかった頃のスコアの悪さを考えるとベンチマーク対策(ベンチマクシング)の疑いを招くというものだ。これは覚えておく価値がある。再事後学習で47ポイントもの振れ幅を生み出すのは、本物の学習成果なのか、それとも調整された結果なのか、それを判断できる公開ハーネスは存在しないからだ。
Flashについて繰り返し出てくる不満は2つあり、もはや「発見」と呼べるレベルだ。1つ目は圧縮下での信頼性だ。
"DeepSeek V4 hallucinates like crazy and often forgets explicitly mentioned parts of the context. I guess compressing tokens and cherry-picking attention comes at a cost."
Artificial Analysisはこれに数字を付け加えている。FlashのAA-Omniscienceにおける幻覚(ハルシネーション)率は84%で、前世代からは12ポイントの改善だが、絶対値としてはまだ高い数字だ。
2つ目はトークンがどこに行くのかという話で、サポート業務に携わる人にとってはこちらこそが実際に結論を左右するポイントだ。
"The model is fantastic. And costs almost nothing. The only problem I see is that they will train on your data. There are zero-data-retention providers of DeepSeek models [...] But these are 3x to 5x more expensive than directly using DeepSeek."
顧客のチケットをルーティングしているのであれば、自社(ファーストパーティ)のレートはそのまま使えるレートではない。ゼロデータ保持のために3倍から5倍を支払うと、Flashの出力価格は$0.28から$0.84〜$1.40程度まで動き、それは価格表が最初に示していた話とはまったく別の会話になる。
私ならどちらを採用するか
自分で出力品質を計測できる大量のテキスト処理業務であれば、DeepSeek V4 Flashを選ぶ。価格は本物で、ウェイトはMITライセンス、2,500の同時実行上限はProの5倍、そして384Kの出力上限はどちらのカードでも最も語られていないスペックだ。lowではなくhighの努力設定で動かし、表示価格ではなく推論トークン分の予算を確保しておくこと。キャッシュヒット率は予算の内訳ではなく、あくまで「期待」として扱うべきだ。
入力が単純なテキストではない場合は、迷わずQwen 3.8 Maxだ。フロンティア級のマルチモーダルはFlashが属していないカテゴリであり、100万出力トークンあたり$6はそのために妥当な価格だ。人間による好みでのリードこそ、21倍の価格を払う最も強い論拠であり、正直な注意点として、そのリードは現時点でわずか1,563票に基づくものであり、まだ独立系のインテリジェンススコアの裏付けはない。
私がどちらかに気持ちを動かされるとしたら、それはどちらのラボも公開していない1つの数字、つまり「あなたの仕事」でそれぞれのモデルが何回の試行を必要とするかだ。3回リトライする$0.28のFlashは、1回で成功する$6.00のQwenよりも高くつく。私なら選ぶ前に、実際の入力を数百件、同じ推論努力設定で両方に通し、リトライの回数を数える。これは週末1つ分の作業だが、この記事に出てくるどのリーダーボードよりも役に立つ。
サポートキューに特化して言えば、正直なところこの比較自体が間違った軸だと思う。どちらのモデルもチケットに流暢な返信を作ることはできる。しかしどちらも御社の返金期限を知らないし、自信がないときにエスカレーションすることもない。御社のチームがすでに対応した4,000件のチケットも、どちらも読んでいない。この最後の部分は検索(リトリーバル)の問題であって、モデル選びの問題ではない。だからこそAIの幻覚防止はモデルのスペックではなく、プロダクトの機能として実装すべきものなのだ。
この話の「下流版」を私は常に耳にしている。ある購入検討者はテスト初日だけで200件のやり取りを消費し、月9,000件ペースでのインタラクションあたりコストをすぐに心配し始めた。だが彼らの本当の問題は、トークンのレートではまったくなかった。回答が正しいかどうかをそのセットアップの何も教えてくれなかったことこそが問題であり、それはあらゆるAIカスタマーサービスのコストモデルにおける本当の変数だ。だからこそ私は、代わりにAIチケット解決率を追っている。
サポート業務でeeselを試す
eesel AIは意図的にモデル非依存(モデルアグノスティック)に作られている。なぜなら「勝者モデル」は3週間ごとに入れ替わり、実際に自社が所有するのはその周りの層だからだ。汎用的なクロールではなく御社の過去のチケットとヘルプセンターで学習し、自信度のしきい値を持たせることで、確信の持てない回答は当て推量ではなくヘルプデスクへのハンドオフになる。そして実際の顧客に回答する前に、過去のチケットに対してシミュレーションを行う。

このシミュレーションのステップが存在するのは、この記事の冒頭で紹介した車種ブランドの逸話があるからだ。実際のサポートチケット自動化業務のためにQwenやDeepSeekを評価しているなら、最初に答えるべき問いはどちらのトークンが安いかではない。顧客がそれを目にする前に、御社自身のチケットでの解決率がどうなるかだ。
Zendeskを含め、御社がすでに運用しているヘルプデスクにそのまま接続でき、自分のキューで無料で試すことができる。