

中国の2社が2兆パラメータ超のフラッグシップモデルを17日違いで投入した。Moonshotの Kimi K3は7月16日に2.8兆パラメータで登場。AlibabaのQwen 3.8 Maxは8月2日に2.4兆パラメータで一般提供を開始した。どちらもフロンティア級のコーディング・エージェントスコアを主張し、どちらも100万トークンのコンテキストウィンドウを備えているが、両社とも自社のベンチマーク表に相手のモデルを載せていない。この不在こそが、この比較の本題だ。
料金表ではQwenが完勝している。100万トークンあたり入力$2・出力$6に対し、Kimiは$3と$15だ。しかし請求額では引き分けになる。唯一公開されている実測のトークン集計では、Qwenが同じ作業に1,800万入力トークンを消費したのに対し、Kimiは950万トークンで済んでいたからだ。この数値を両社の公開料金表に当てはめると、両者はわずか数ドルの差に収まる。オープンウェイトに関しては大差がついている。Kimiは7月27日、宣言した通りに正確にチェックポイントを公開したが、Qwenの重みはいまだに「来週」のままだ。
私はeeselでAIエージェント機能を開発しているので、どちらのモデルであれ顧客に使う前に指摘したいのは、どのチャートも測っていない部分だ。モデルが大きくなっても、自信満々の誤答は止まらない。あるeeselの顧客であるB2Bのテクニカルサポートチームでは、ヘルプセンターに「すべての車種に対応」と書かれていたせいで、ボットがデータベースに存在しない車種にも自信満々で対応可能だと答えてしまった事例があった。2.8兆パラメータをもってしても、これは直らない。直すのは検索範囲のスコープ設定と、確信度のしきい値を下回った場合に回答を拒否する仕組みだ。
60秒でわかる比較表
以下の数値はすべて、各社が公開している一次情報から2026年8月3日時点で確認したものだ。公表されていない項目は、集計サイトの数字を借りるのではなく、そのまま「未公表」と記載した。
| Qwen 3.8 Max | Kimi K3 | |
|---|---|---|
| モデルID | qwen3.8-max | kimi-k3 |
| 開発元 | Alibaba | Moonshot AI |
| リリース日 | 2026年8月2日(一般提供) | 2026年7月16日 |
| 総パラメータ数 | 2.4兆 | 2.8兆 |
| アクティブパラメータ数 | 950億 | 未公表 |
| 入力/100万トークン | $2.00 | $3.00 |
| 出力/100万トークン | $6.00 | $15.00 |
| キャッシュ入力/100万トークン | $0.25(暗黙)、$0.17(明示読取) | $0.30 |
| コンテキストウィンドウ | 1,000,000 | 1,048,576 |
| 長文コンテキスト追加料金 | なし | なし |
| 最大出力 | 131,072 | 未公表 |
| 最大推論バジェット | 262,144 | 未公表 |
| 入力モダリティ | テキスト、画像、動画 | テキスト、画像、動画 |
| 推論制御 | low / medium / xhigh、デフォルトはxhigh | maxのみ |
| オープンウェイト | 約束済み、未公開 | 2026年7月27日に公開済み |
| ライセンス | 未公表 | "other"とのみ記載 |
| モデルカード | なし | Hugging Faceに掲載 |
| ナレッジカットオフ | 未公表 | 未公表 |
| レート制限(最上位ティア) | 15K RPM / 2M TPM | 未公表 |
| コンシューマー向けチャット | Qwen Studio、無料 | Kimi.com、無料〜$199/月 |
3つの行がこの比較の核心を担っている。Qwenはアクティブパラメータ数を公表しているがMoonshotはしていない。これは重要な違いで、レイテンシと請求額を決めるのは総パラメータ数ではなくアクティブパラメータ数だからだ。Qwenはすべての料金指標で安い。そしてKimiは、両者のうち実際にダウンロードできる唯一のモデルだ。
Qwen 3.8 Maxとは何か
Qwenはalibabaのモデルファミリーで、Maxは安価なPlusおよびTurbo階層より上位に位置する独自のフラッグシップ系列だ。Qwen 3.8 Maxは二段階でリリースされた。7月19日にWorld AI Conferenceでプレビューが行われ、フロンティア級だという発言はあったものの数値は非公開のままだった。その後8月2日、ローンチ記事で5,000語を費やし、プレビューで伏せられていたすべてが公開された。
Alibabaが述べているアーキテクチャは、総パラメータ数2.4兆・アクティブパラメータ数950億の疎なMixture-of-Experts構造で、Qwen 3.5をベースに構築されている。ファミリー全体の歴史は私のQwenレビューに、旧世代のティアはQwen概要にまとめている。
推論の制御はreasoning_effortで行い、low・medium・xhighから選べ、デフォルトはxhighだ。Alibabaは「初期状態で最良の体験を提供するため」としてpreserve_thinkingもデフォルトで有効にしている。この点は後でコストの問題として再登場するので覚えておいてほしい。
Kimi K3とは何か
Kimi K3はMoonshot AIのフラッグシップで、その技術的な物語はQwenよりも独特だ。総パラメータ数は2.8兆で、MoonshotはStable LatentMoEというフレームワークの下で896個のエキスパートのうち16個を活性化していると説明している。さらに2つの新機構が加わる。ハイブリッドな線形アテンション機構であるKimi Delta Attentionと、Moonshotが別途オープンソース化した標準的な残差接続の代替であるAttention Residualsだ。Kimi K2.5と比較して約2.5倍のスケーリング効率があると主張している。
Moonshotは自社のローンチ記事で、自分たちの立ち位置について珍しいほど率直に述べている。
"While its overall performance still trails the most powerful proprietary models, Claude Fable 5 and GPT 5.6 Sol, Kimi K3 demonstrated frontier-level performance across our evaluation suite, consistently outperforming other tested models."
これをAlibabaのプレビュー時のポジショニングと比べてほしい。Alibabaは1つのスコアも公開する前から「Fable 5に次ぐ性能」を打ち出していた。同じ2社でも、自社のエビデンスに対する姿勢はまるで違う。より深い分析はKimi K3レビューとQwen 3.8 Maxレビューにまとめている。
K3にないのは推論ダイヤルだ。reasoning_effortはmaxしか受け付けず、lowとhighは「近日公開」とされているだけだ。安価な非思考SKUも存在しない。1つのモデル、1つの価格、常に思考し続ける仕様だ。
ベンチマーク:互いを測定していない両社
多くの直接比較記事がひそかにごまかしている部分がここだ。Alibabaは8月2日に16パネルのチャートを公開した。Moonshotは7月に独自のチャートを公開した。どちらのチャートにも、相手のモデルは含まれていない。
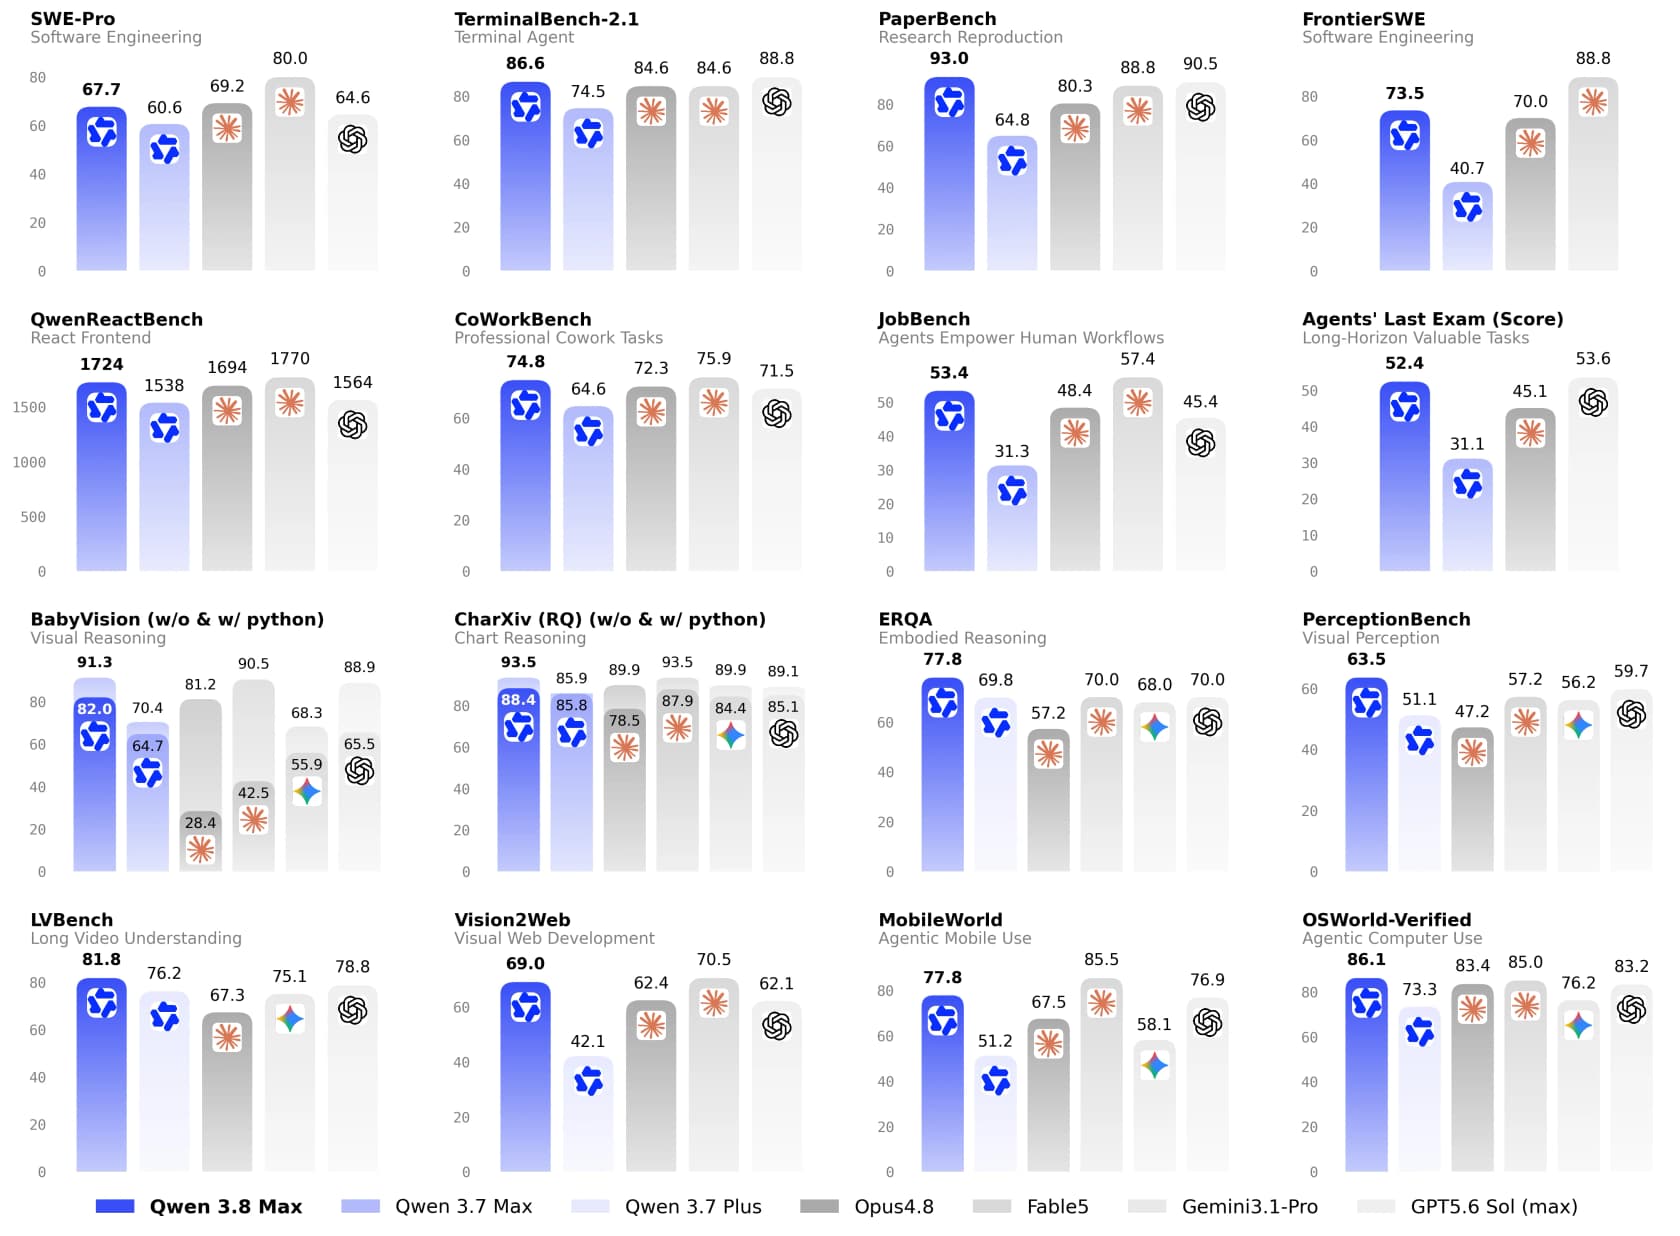
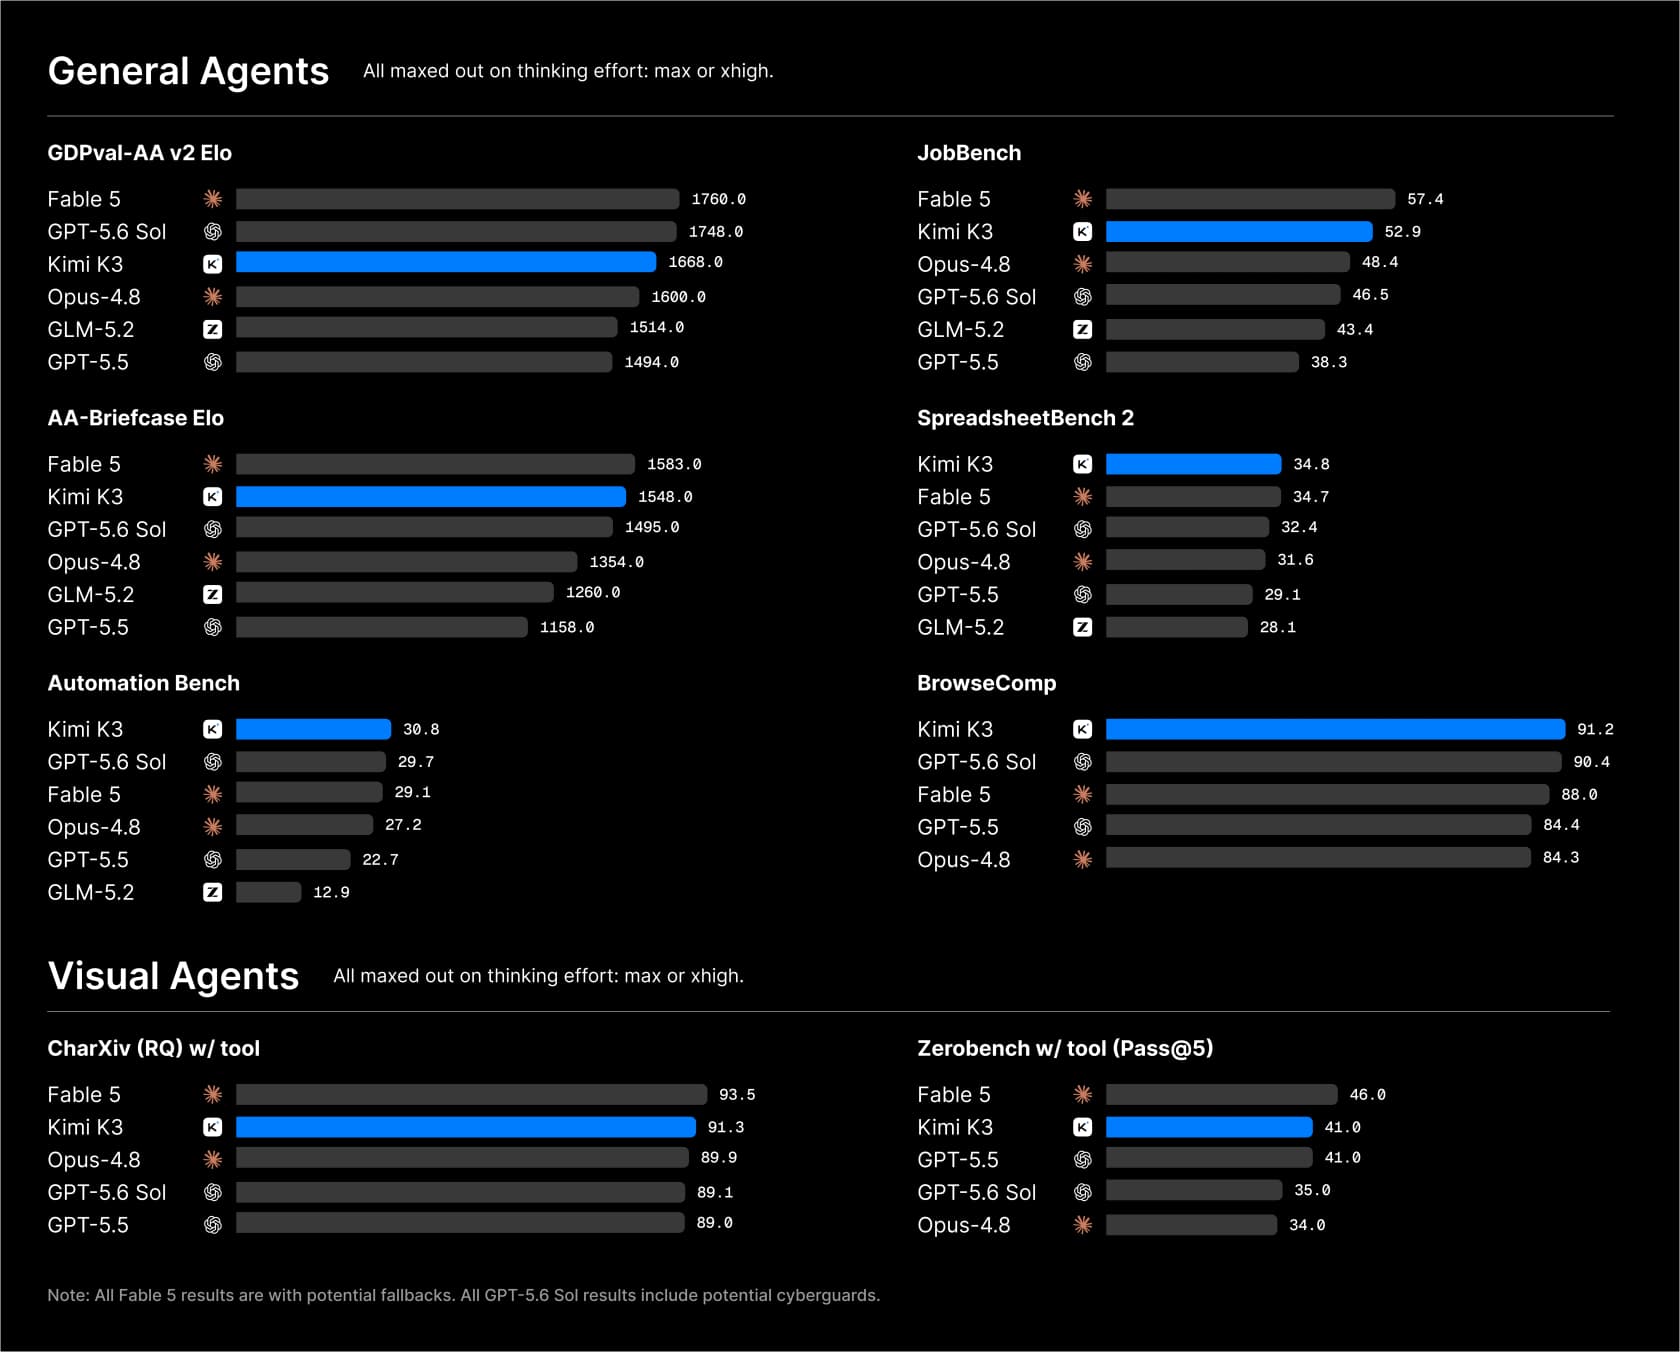
しかし両者を橋渡しする方法はあり、ほとんど誰もそれをやっていない。両方のチャートには同じ参照モデル、Claude Fable 5、Claude Opus 4.8、GPT-5.6 Solが含まれている。そのため同じ参照モデルの同じベンチマークで両社が同じスコアを報告している行は、両方のハーネスが同じように振る舞っているということであり、そこに限っては自社スコア同士を比較できる。参照スコアが食い違う行は比較できない。
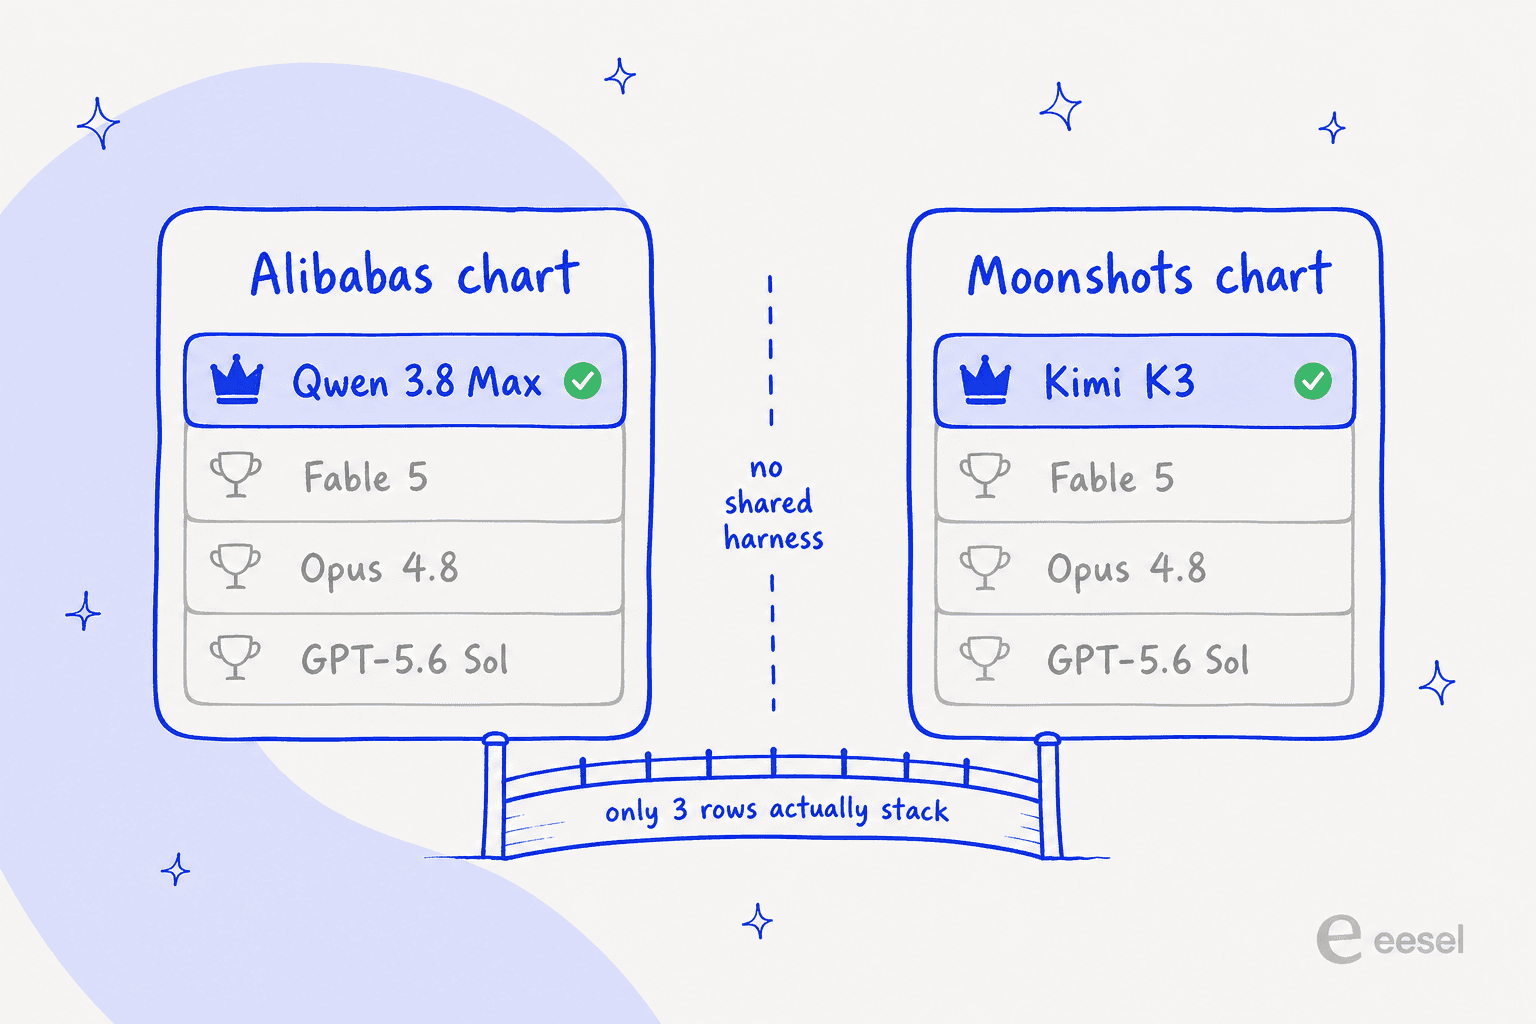
このテストを両方のチャートに適用すると、生き残るのはちょうど3行だけだ。
| ベンチマーク | 参照モデルの一致 | Qwen 3.8 Max | Kimi K3 | 勝者 |
|---|---|---|---|---|
| TerminalBench-2.1 | Fable 5が84.6、Opus 4.8が84.6、Solが88.8で両社一致 | 86.6 | 88.3 | Kimi、1.7差 |
| CharXiv(RQ、Python使用) | Fable 5が93.5、Opus 4.8が89.9、Solが89.1で両社一致 | 93.5 | 91.3 | Qwen、2.2差 |
| JobBench | Fable 5が57.4、Opus 4.8が48.4で両社一致。Solは45.4対46.5 | 53.4 | 52.9 | Qwen、0.5差 |
つまり、コーディング寄りの評価とチャート読解の評価で1勝ずつ、そしてエージェント的な知的作業では統計的に引き分け。これがこの2モデルの間で成立する誠実な直接比較のすべてだ。15行もの表を見せて勝者を宣言している記事があれば、それは異なるハーネスの数値を無理やり並べているということだ。
そして、これを厳密に扱うべき理由は、除外せざるを得なかった4行目にはっきり表れている。FrontierSWEでは、AlibabaのチャートはGPT-5.6 Solを88.8としているが、Moonshotのチャートでは71.3だ。同じモデル、同じベンチマークで17.5ポイントの差がある。どちらのチャートが正しいにせよ、一方が測っているものをもう一方は測っていないということであり、その差は両社が主張するどちらの優位差よりも大きい。
Alibabaの脚注も読む価値がある。コーディングベンチマークのうち6つは社内製で未公開であること、競合のスコアは再実行せず混在したハーネスから拾ってきたこと、Fable 5の結果には「フォールバックが関与している可能性がある」こと、そしていくつかの行は競合モデルによって採点されていること(gemini-3.1-pro-previewがPLawBenchを、Claude Opus 4.6がPaperBenchを採点)を開示している。Moonshotのチャートにも同種の注意書きがある。
唯一独立した評価として参照できるのがArtificial Analysisで、Kimi K3をIntelligence Indexで57点とし、評価した189モデル中4位、出力速度は毎秒約62トークンとしている。独自の長期知的作業評価では、K3のEloは1547に達し、同じまとめによればKimi K2.6から+732の伸びだという。
料金表はQwen、請求額は引き分け
Qwenは公表されているすべての料金指標で安い。入力は3分の1安く、出力は60%安く、暗黙のキャッシュ読取も$0.25とKimiのキャッシュヒット料金$0.30より安い。同じトークン数であれば議論の余地はない。
しかしトークン数は同じではない。同じWebアプリのビルド作業を両モデルでそれぞれのベンダーのハーネス上で実行した開発者が、その集計を投稿している。
"* Kimi K3: 9532k input (9172k cached), 114k output - cost $5.5
Qwen 3.8 Max: 18020k input (17836k cached), 114k output - cost $6.3"senko, Hacker News

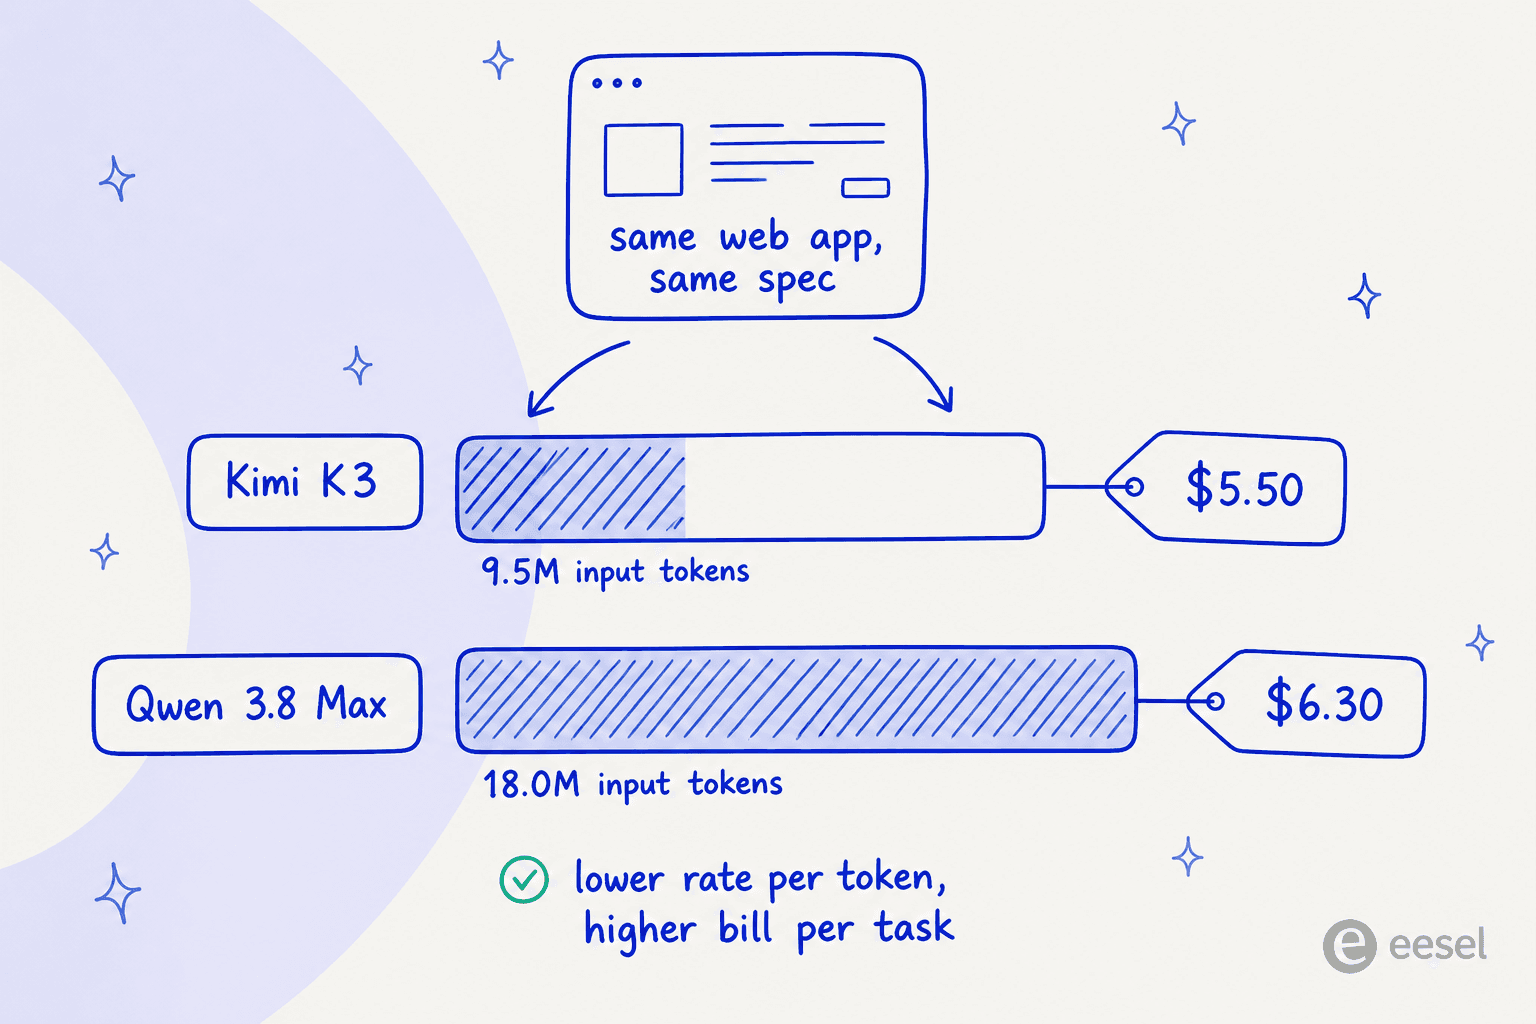
この$6.30は一般提供開始前のもので、8月2日に公開された料金表ではなくプレビュー時の条件で課金されている。同じトークン数を現在の料金で再計算すると、Qwenは約$5.51(非キャッシュ入力0.184Mを$2、キャッシュ入力17.836Mを$0.25、出力0.114Mを$6で計算)になる。Kimiは$5.54だ。出力単価が60%安いにもかかわらず、必要な入力トークンが1.9倍になることでほぼ相殺されている。
これこそが実際の請求額を決める数字であり、どちらの料金ページにも書かれていない。Qwenはxhigh推論とpreserve_thinkingをデフォルトで有効にしており、推論トークンは出力として課金される。Kimiも常にmaxで動作しており、そのコミュニティもこの結果についてはっきり指摘していた。
"The shift from "value" models to "intelligent, huge and slow" models coming from China is an interesting change in strategy. My main issue with GLM 5.2 and Kimi 3 is that they're extremely token hungry and thus feel slow(er) to use."
もはやどちらも「格安」の選択肢ではない。両モデルともClaude Sonnetの価格帯に位置しており、DeepSeek V3.2は依然としてその1桁下だ。「安い中国製モデル」という枠組みは、もう一世代前の話になっている。
自分の利用量、キャッシュされる入力の割合、そしてQwenがどれだけ冗長になると見込むかを入力してみてほしい。
冗長性スライダーを1.9倍より先に動かすと、出力トークン単価が2倍以上高いにもかかわらずKimiがコストで勝つようになる。3か月後に経理部門が注目するのは、この損益分岐点であって定価ではない。
オープンウェイト:唯一はっきりした違い
両モデルとも「オープン」だと発表された。だが実際にそうなのは片方だけだ。
Moonshotは2026年7月27日までに重みを公開すると言い、その通りに実行した。Kimi K3のリポジトリには7月27日最終更新のチェックポイントがあり、safetensorsのインデックスは合計2,779,931,837,184パラメータで、これは2.8兆という主張をプレスリリースではなく外部から裏付けるものだ。すでに83万7,000回以上ダウンロードされ、9,700件のいいねが付き、コミュニティによる量子化版もすでに存在する。ライセンスは"other"としか記載されていないので、ビジネスに使う前に必ず読んでほしい。
Qwen 3.8 Maxはまだ待っている状態だ。Alibabaのローンチ記事は、Hugging FaceとModelScopeへの重み公開を「来週」と3回にわたって約束しており、qwen.aiのホームページではリリースに「Open-Source」というタグが付けられているが、リポジトリもライセンスも日付も存在しない。8月2日時点での「来週」とは、8月9日の週を指す。
ここで興奮する前に2つの注意点がある。まず、8ビットの2.78兆パラメータのチェックポイントはデータセンター向けの成果物であり、ワークステーションで動かせるものではない。つまり「オープン」とは、大規模な監査可能性と自前ホスティングの話であって、ローカル実行の話ではない。ローカル実行が本当に必要なら、小型言語モデルが誠実な選択肢だ。次に、Hacker News上のローカルモデル派のコミュニティは、Qwenの発表をスケジュール上の対応と受け止めていることをはっきり示していた。
"I assume that this announcement has been prompted by that of Moonshot AI, which has just announced a 2.8T parameter open-weights LLM, Kimi K3, to be published on Huggingface by 27 July. Now the response of Alibaba is that they will also publish soon a big open weights LLM, the 2.4T parameter Qwen 3.8."
両方を実際に使った開発者たちの声
ベンチマークは能力を測る。だが実運用が測るのは、能力を忍耐力で割ったものだ。ローンチ後のスレッド全体を見ると、実地レポートはKimiに傾いており、その理由のほとんどは知能そのものについてではない。
Qwenのプレビュースレッドで最も鋭かったのは、直接的な比較のコメントだ。
"The few tests I ran were by no means comprehensive, but while kimi felt like the real deal qwen seems a bit of a benchmark princess."
4つのフロンティアモデルを数日間並行して試した開発者は、もう少し公平な立場に落ち着いている。
"Having tested K3, Qwen 3.8 max preview, Fable and Sol for the past few days, I partially agree. Don't trust the benchmarks, and the Chinese models really are slow and token-inefficient. However they do seem very close to SOTA [...] if I had to find an alternative, I could live with both K3 and Qwen3.8 just fine."
そしてある報告は、たった1つのワークロードの結果にしては踏み込みすぎだと私は思うが、スレッド内で最も繰り返し引用されている見解であり、結論としてではなくデータポイントとして読む価値がある。
"In my limited anecdotal experience, Kimi K3 is a bit better than Opus 4.8 and Qwen3.8 Max is disastrously bad. It can reason fine, but the moment it tries to do something it gets stuck into long second-guessing loops with no progress."
これをKimi側の声とも比較してみる価値がある。リリース当日は熱狂が高く、ある開発者はブラインドテストでAnthropicのフラッグシップと区別できなかったと述べている。
"I've been playing around with it for the past few hours, and I think it's an amazing model. I'm not sure I could tell the difference between this and Fable in a blind test."
このばらつきが気になるなら、1つに絞るよりも候補リストを持つほうが安全だ。この側の候補としては私はQwenの代替を挙げる。逆方向からのまとめとしてはKimi K3の代替があり、このモデル単体に絞ったQwen 3.8 Maxの代替リストも存在する。
いくつかの情報はどちらのモデルについても単純に公開されていない。ナレッジカットオフの記載なし、システムカードなし、Qwen側には安全性評価が一切なく、Kimi側には技術レポートが出るまでアーキテクチャ論文もない。もし調達担当者に聞かれたら、今の答えは「存在しない」だ。
フロンティアモデルが終わり、サポート業務が始まる境界
ここが私が最も気にしている部分だ。なぜなら、ここでチームが四半期分の時間を失うのを何度も見てきたからだ。
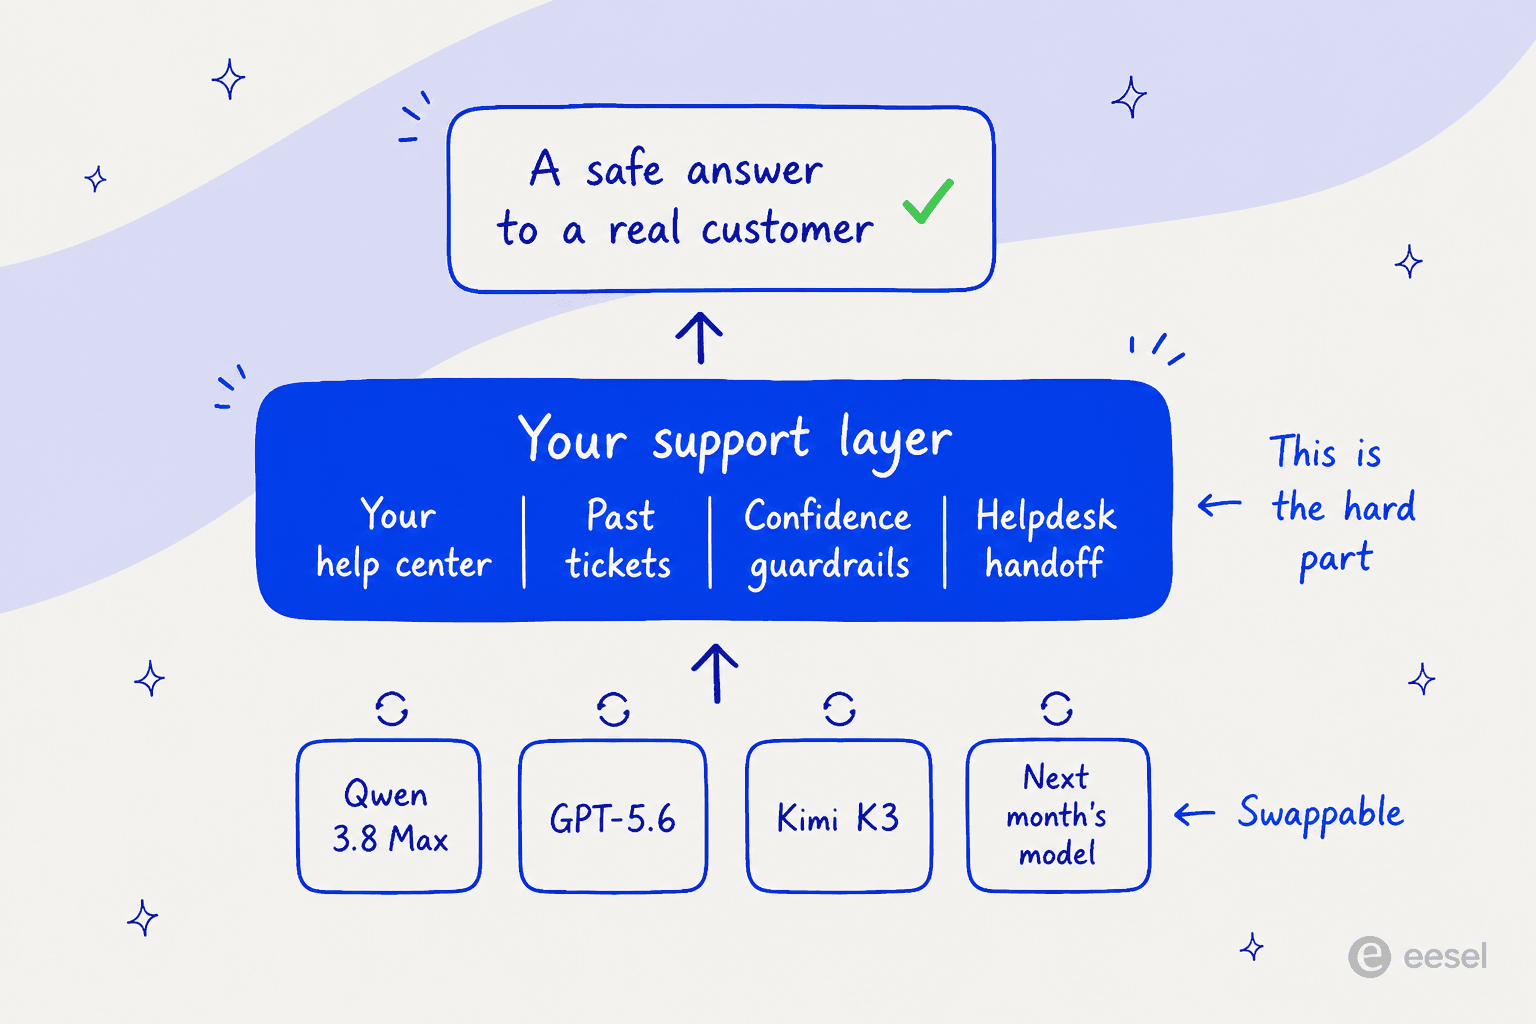
どちらのモデルも、あなたの会社の返金ポリシーを知らない。どちらも直近7,000件のチケットを読んでいない。どちらも、いま問い合わせてきている顧客がエンタープライズプランで、すでに2回エスカレーションしていることを知らない。ベンチマークスコアはサポートエージェントではなく、この2つの間の距離こそが、多くのAIサポート自動化プロジェクトが静かに頓挫する場所だ。
だからこそ、AIヘルプデスクを選ぶことはモデルを選ぶこととはまったく別の作業であり、チケット自動化の成否は生の推論力ではなく検索精度にかかっている。
私はeeselでエージェント層を作ることに時間を費やしてきたが、そこで繰り返し目にする失敗は「AIが知らない」よりもたちが悪い。それは自信満々の作り話だ。この記事の冒頭で紹介した車種の事例が最も分かりやすい例だ。モデルは言語の面で間違えたのではなく、スコープの面で間違えた。ヘルプセンターに「すべての車種に対応」と書かれていたのを文字通り受け取ってしまったのだ。そのチームが設定を正しく仕上げるまでの経緯を自ら振り返った言葉は「最初は試行錯誤だった」というものだった。2.8兆パラメータのモデルでも、より流暢に同じ主張をしていただろう。
これを直す仕組みは、月間7,000件のチケットを扱うサポートリーダーとの通話の中で出てきたもので、モデル選びとは何の関係もない。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
a CX lead at a 7,000-ticket-a-month DTC brand
これはモデルの決定ではなく、プロダクトの決定だ。だからこそeesel AIは本番投入前に過去のチケットに対するシミュレーションを実行し、実際の過去の会話に対する解決率と実際の返信内容を先に確認できるようにしている。
また、回答は確信度に応じてルーティングされ、推測するのではなく人間向けの下書きにするかエスカレーションする仕組みになっており、チケット分類も1つの巨大なプロンプトに詰め込むのではなく、独立したステップとして実行される理由もここにある。
そう考えると、この比較の戦略的な結論は少し拍子抜けするものになる。エンジンを差し替えられるように作れ、ということだ。モデル層は数週間ごとに性能が上がり、価格が下がっていく。Kimi K3はQwenより17日早く登場し、GPT-5.6は最安ティアをわずか一日で80%値下げした。9月にトップに立つモデルは、今日どちらのチャートにも載っていない。
同じ理由で、Geminiにも、今月の数字がどれだけ良く見えようと固定配線することはしないだろう。Grokにも同じことが言える。GLM 5.2はこの帯域に位置するもう1つの中国製フラッグシップで、そのビジネス面での評価も同じように肩をすくめて読んでいる。
結局どちらを選ぶべきか
何かをすぐにリリースしたくて、1つの答えが欲しいなら。
- トークン効率が請求額を左右する長いエージェントループ: Kimi K3。同じ作業をおよそ半分の入力トークンでこなしており、その差は高い料金表を上回る価値がある。
- チャート、文書、動画中心の作業: Qwen 3.8 Max。比較可能なハーネス上でCharXivを制しており、Alibabaは動画入力について、Moonshotが自社のローンチ資料で示していない具体的な上限を文書化している。
- 自前でホストしたり監査したりする必要がある場合: Kimi K3で、これは議論の余地がない。重みは実在し、パラメータ数もチェックポイントから裏付けが取れているが、Qwenのそれはいまだに約束のままだ。
- 下げられる推論ダイヤルが欲しい場合: Qwen 3.8 Max。
lowとmediumの推論レベルを持つのはこちらだけだ。Kimiはmaxか無かのどちらかしかない。 - トークンあたりのコストを最優先する場合: Qwen。すべての指標で安い。ただし予算を組む前に、完了タスクあたりのコストを必ず測ってほしい。
- 顧客対応が絡む場合: どちらも単体では答えにならない。まずレイヤーを選び、そこにモデルを選ばせるべきだ。試算は私のエージェントのコスト比較に、候補リストはおすすめのAIエージェントにまとめている。
私がやらないのは、どちらのチャートも確定したものとして扱うことだ。両社の間で成立する誠実な重なりは3行だけであり、Alibabaのコーディングベンチマークのうち6つは自社製の未公開評価で、どちらも第三者による再現は行われていない。
独立した数値が出そろう前に、両社の料金表はまだ動くと見ておいたほうがいい。だからこそ私はKimi K3の料金の内訳をリビングページとして更新し続けており、Qwen 3.8 Maxの料金についても同様だ。Qwen 3.8 Max vs GPT-5.6の比較記事も、この記事と合わせて更新が必要になるだろう。
eeselを試す
ベンチマークで勝つモデルではなく、実際にチケットをクローズしてくれるモデルが欲しくてここにたどり着いたなら、それはまさにeesel AIの存在意義そのものだ。Zendesk、Freshdesk、Gorgias、その他100以上のツールと連携し、あなたのヘルプセンターと過去のチケットから学習し、数分で下書きを始める。

差を生むのはエンジンではなく、信頼を積み上げる過程だ。実際のチケット履歴に対してシミュレーションを行い、数値を確認し、下書きモードから始め、納得できたときだけ自律動作に移行する。それがKimiであれQwenであれ、9月に登場する何かであれ、配線を組み直すことなく、フロンティアの進化をそのまま取り込める。eesel を試す、無料でクレジットカードも不要だ。