

TorchNeuronは、AWSのTrainiumチップ向けのオープンソースのPyTorchバックエンドで、2026年10月20日からパブリックベータです。Trainiumをneuronという通常のPyTorchデバイスとして登録するため、ほとんどのコードでは移植は本当に.to('cuda')を.to('neuron')に変えるだけです。ライブラリはApache 2.0で無料で、支払うのはTrainiumの利用時間です。EC2 Capacity BlocksでTrainium2チップ1時間あたり2.235ドル、H100は5.970ドルです。
見出しは落とし穴を隠しています。イーガーモードは簡単でデバッグしやすい道ですが、本番の速度はtorch.compileから得られ、Neuronでは静的な形状が必要で、変換できない演算子があると失敗します。しかもTrainium2とTrainium3でしか動かないため、Trainium1とInferentiaのユーザーは古いスタックに取り残されます。
自前のモデルをAWSで学習・提供しているなら、今週がパイロットを回すタイミングです。チケット対応のように仕事をこなすAIがほしいだけなら、チップの話は飛ばして構いません。eesel AIチームメイトがモデル層を引き受け、SE Rankingは3つの製品にまたがって月約4,650件の会話で運用しています。
TorchNeuronとは?
TorchNeuronは、AWS Trainium向けのネイティブPyTorchバックエンドです。TrainiumはAmazonが2015年にAnnapurna Labsを買収して以来開発してきた、独自AIチップのファミリーです。2026年10月19日にPyTorchブログで発表され、10月20日のPyTorch Conference North Americaでオープンソースのパブリックベータとして公開されました。コードはaws-neuron/torch-neuronxにあり、Apache 2.0です。
私はeesel向けにインテグレーションとAPIを作っていますが、「1行の変更で動く」は最も信用しない主張です。自分たちのページにも書いたことがあるからです。そこで、信じる前にドキュメント、リポジトリ、発表資料を読みました。結論から言うと、この主張はイーガーモードでは成り立ち、本当のエンジニアリングはコンパイルの段階に移ります。
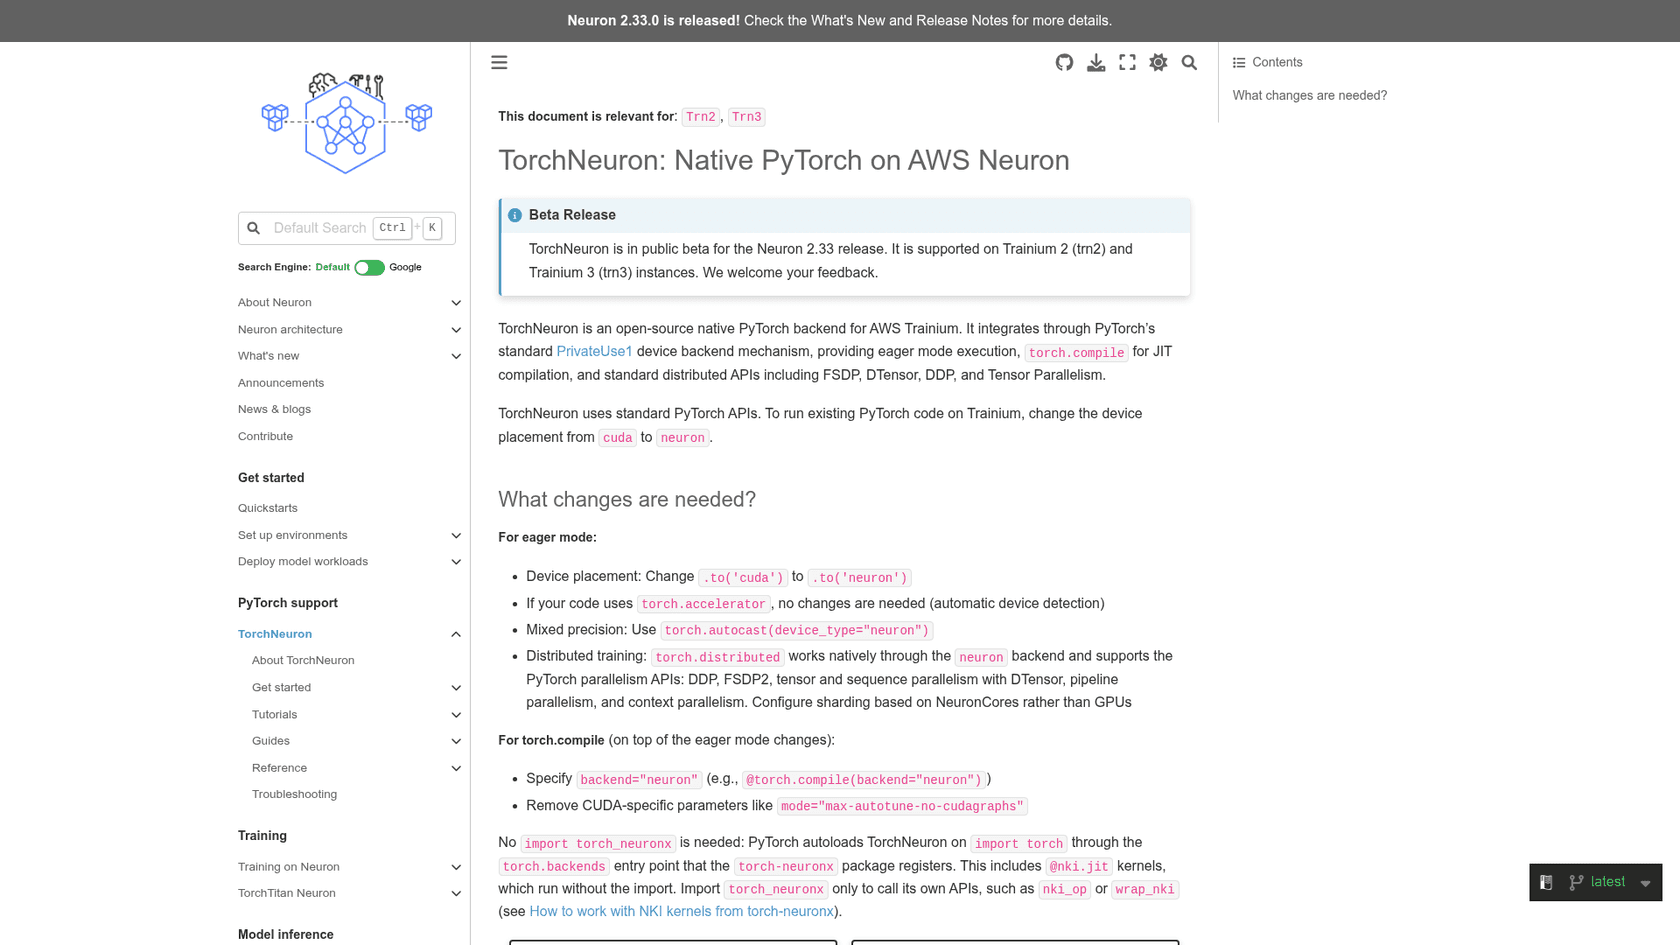
公式ドキュメントははっきり書いています。TorchNeuronはNeuron 2.33リリースのパブリックベータで、Trainium2(trn2)とTrainium3(trn3)のインスタンスで動作します。Amazon自身の説明(About Amazon)では、AI研究者と開発者の85%がPyTorchでコードを書いており、これまでそのコードを新しいチップに移すには何カ月もの書き直しと再検証が必要だったとされています。
AmazonのCEOアンディ・ジャシーは、同じ日にXで事業上の理由を述べました。
"Trying a new AI chip used to be a lot of work. You often had to rewrite your code, revalidate it, and sink many weeks in, betting this new chip is the right one for your workload."
何が本当に新しいのか
TrainiumはPyTorchを何年も前から動かしているので、何が変わったのかという疑問はもっともです。答えは内部の仕組みです。PyTorch 2.9まで、NeuronはPyTorch/XLA経由でPyTorchを動かしていました。これは遅延テンソルを使うため、グラフがトレースされてコンパイルされるまで何も実行されず、printやブレークポイント、Pythonの制御フローの挙動が不自然でした。AWSは、PyTorch 2.9がXLAベースの最後のバージョンで、2.10以降はネイティブサポートに移ると発表しました。
TorchNeuronは、カスタムハードウェア向けのPyTorch公式拡張ポイントであるPrivateUse1に接続します。PyTorchから見ると、TrainiumはCPUやCUDAと並ぶもう1つのデバイスにすぎません。だから発表記事は、torch.nn、torch.autocast、torch.distributed、torch.profilerがすべてneuronデバイスで書いたとおりに動くと言えるのです。
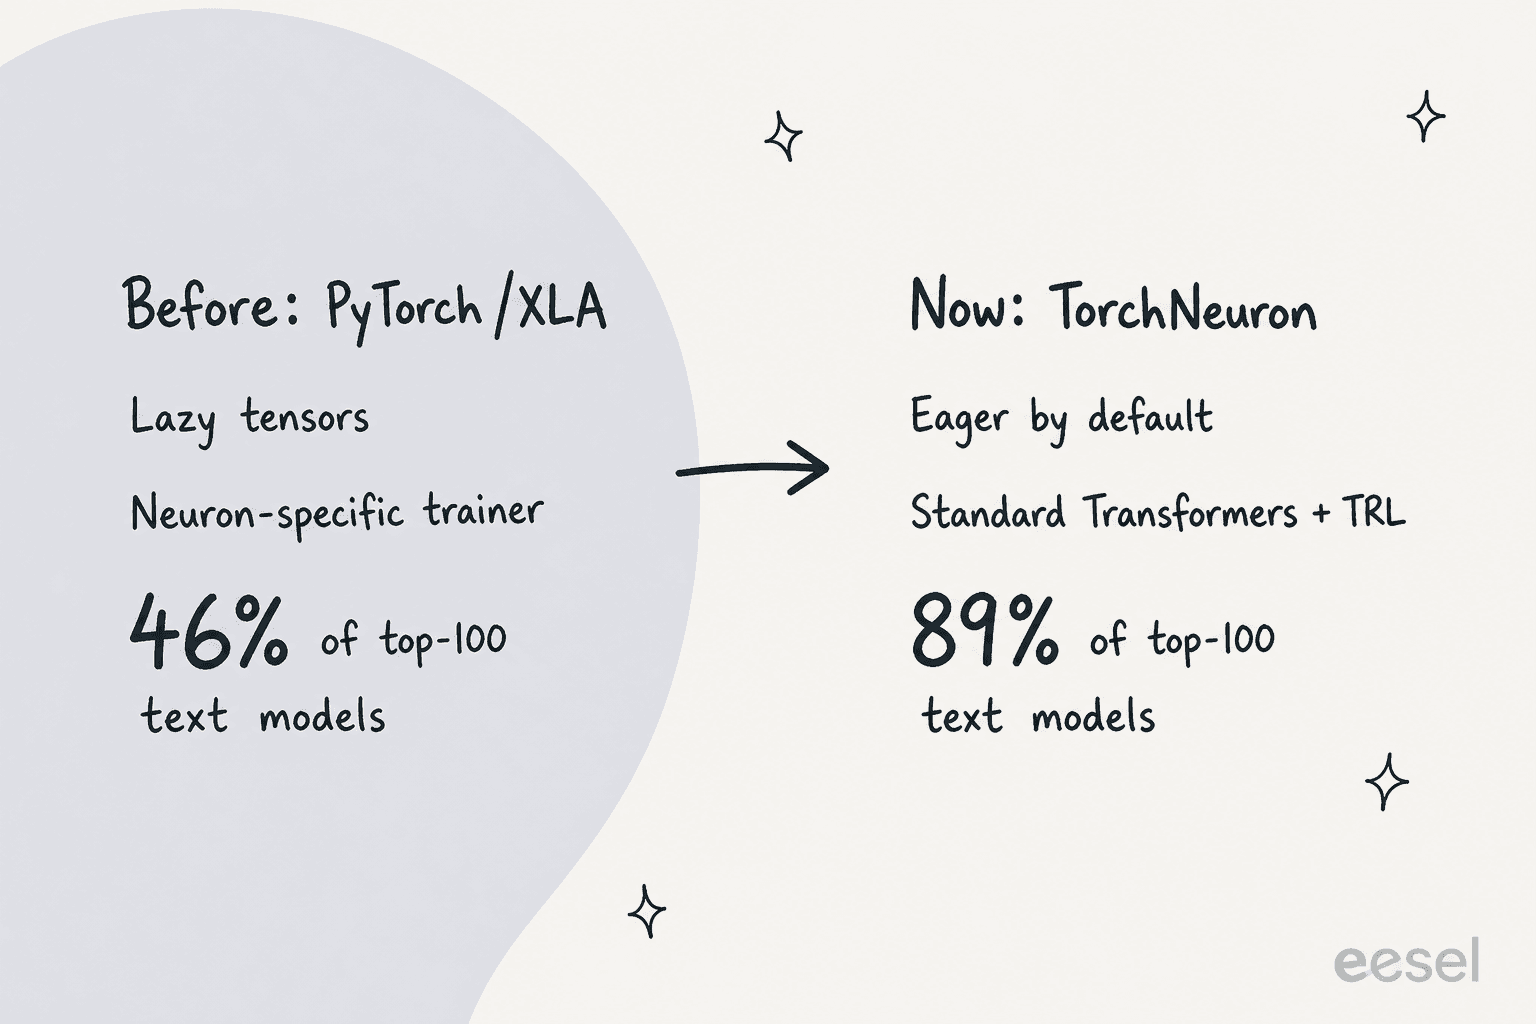
変化を最もはっきり示すのはHugging Faceの数字です。発表記事で、Hugging Faceはテキスト生成の上位100アーキテクチャの89%がそのまま動作すると述べています。従来のOptimum Neuron v0.4.5では46%でした。現在は、Optimum Neuronを経由せず、Transformers、Diffusers、Accelerate、PEFT、TRLをTrainium上で直接使うことを推奨しています。
変更前後を表にまとめます。
| PyTorch/XLA(2.14より前のtorch-neuronx) | TorchNeuron(torch-neuronx 2.14以降) | |
|---|---|---|
| 実行方式 | 遅延テンソル、トレースしたグラフ | デフォルトでイーガー、torch.compileは任意 |
| デバッグ | グラフ単位、printが遅れる | Pythonのprintとブレークポイントが使える |
| Hugging Faceの経路 | Optimum Neuronのラッパー | Transformers、TRL、Diffusersを直接 |
| 分散 | Neuron専用API | DDP、FSDP2、DTensor、TP、PP |
| チップ | Trn1、Trn2、Inferentia | Trn2とTrn3のみ |
| PyTorchバージョン | 2.9まで | 現行リリースでは2.14 |
最後の行は、発表時の報道が示すよりも重要です。制限のセクションで改めて触れます。
TorchNeuronの仕組み
内部では、TorchNeuronには2つのバックエンドがあります。イーガーモード用にPyTorchのディスパッチャーへ登録されたものと、torch.compile用にTorchDynamoへ登録されたものです。どちらもNeuronコンパイラに処理を渡し、NEFFファイル(Neuron Executable File Format)が生成され、Neuronランタイムがチップ上で実行します。
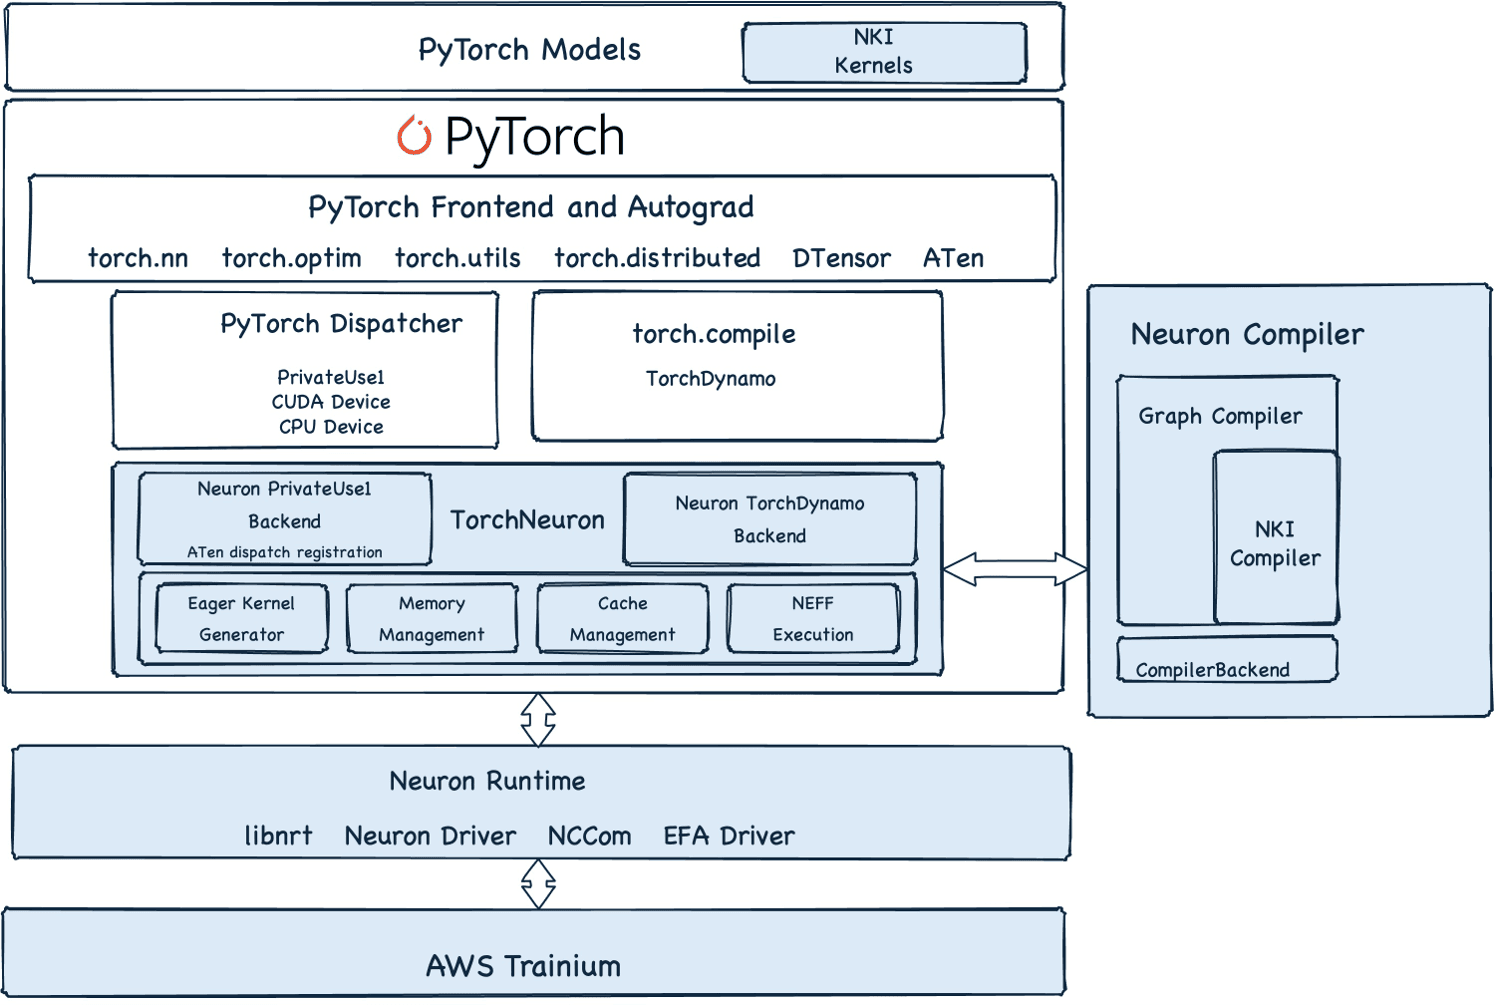
2つの経路はAbout TorchNeuronのページで詳しく説明されています。挙動がかなり違うので、私は2つの別製品として扱うのがよいと考えています。
イーガーモードは、呼び出した時点で各演算を実行します。演算子が初めて実行されるときに専用のNEFFへコンパイルされてディスク上のキャッシュに入り、以降はキャッシュから使われます。Neuron実装のない演算子は警告を出してCPUにフォールバックするので、モデルは動き続けます。実験的な適応型イーガーモード(TORCH_NEURONX_ENABLE_CONCATENATION=1を設定)もあり、対象の演算を融合して起動のオーバーヘッドを減らします。
**torch.compile**は、TorchDynamoとAOTAutogradでモデルをグラフとして捕捉し、Torch-MLIR経由でStableHLOに変換して、グラフ全体を1つのNEFFにコンパイルします。これが本番向けの経路です。引き換えに制約が厳しくなります。GitHubのREADMEによると、dynamicはFalse、modeは"default"のみ、テンソルは連続している必要があり、入力形状が変わるたびに再コンパイルされます。捕捉した演算子をバックエンドが変換できないと、デフォルトではコンパイルが失敗します。
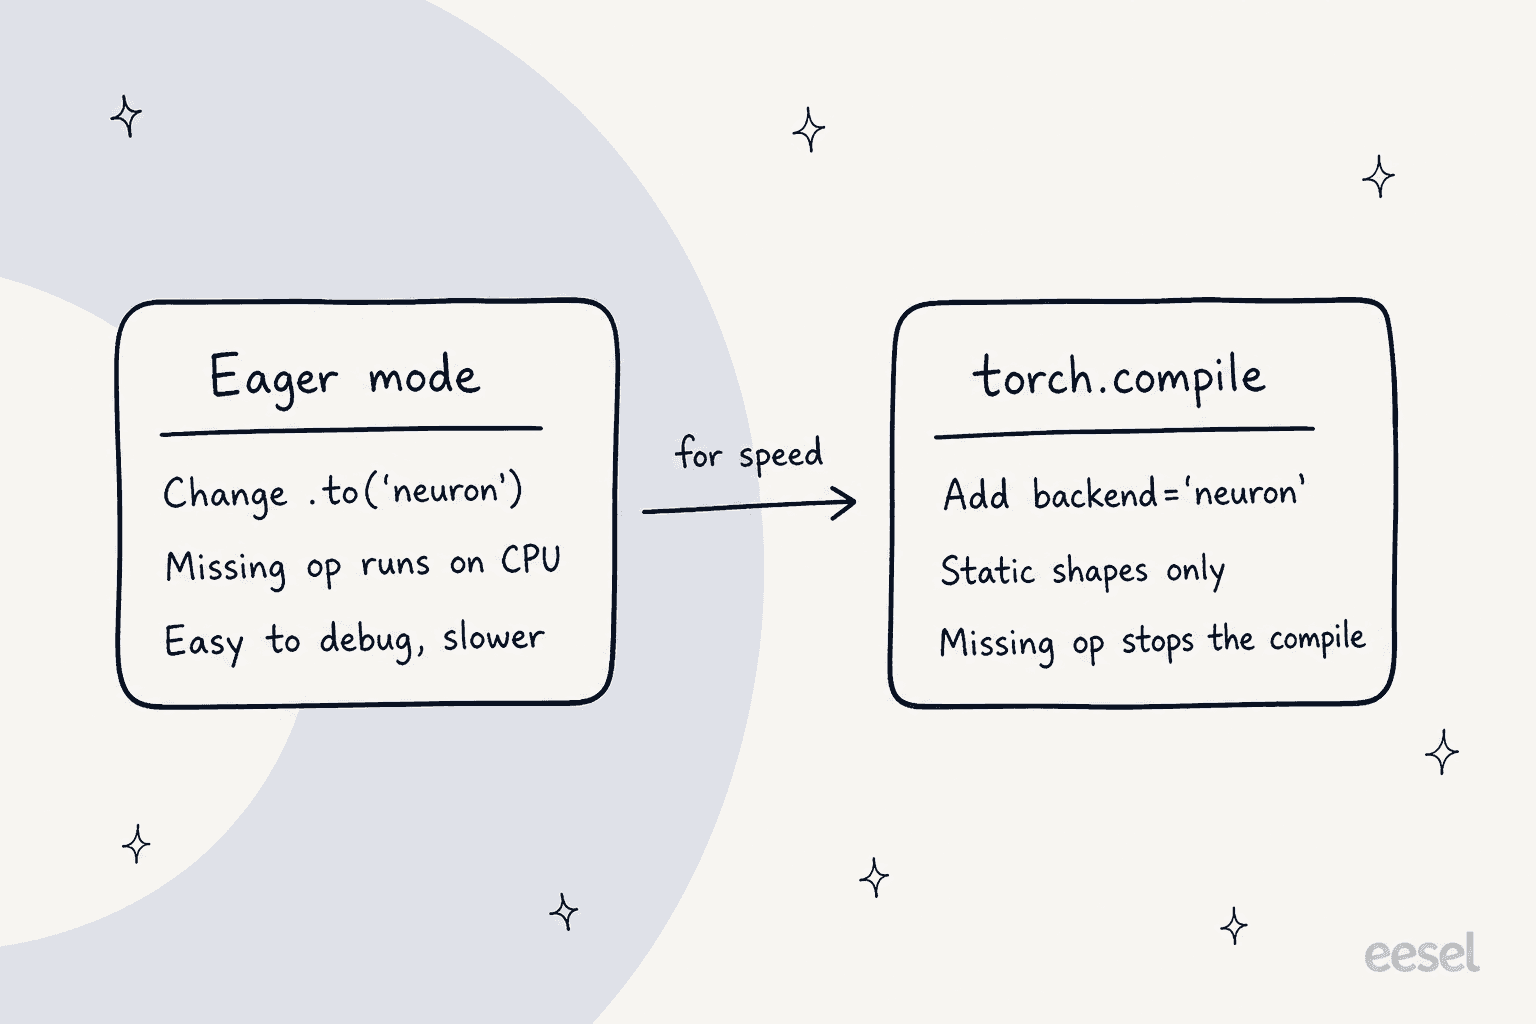
つまり「設定の変更が1つ」を正直に読むと、始めるための変更が1つあり、速くするための作業がもう1ラウンドあるということです。実際には、そのもう1ラウンドは主に、入力を少数の固定形状にパディングまたはバケット化することと、TORCH_NEURONX_NEFF_CACHE_DIRを共有ストレージ(ドキュメントではAmazon FSxを推奨)に向けることです。これで、インスタンスごとに同じグラフを再コンパイルせずに済みます。
両モードの上にはNKI(Neuron Kernel Interface)があり、コンパイラでは足りないときにカスタムカーネルを書けます。NKIカーネルはnki_opで通常のPyTorch演算子として登録でき、イーガーモードでもコンパイル済みグラフの中でも動きます。AWSは、FlashAttentionやMoEのブロックワイズカーネルを含む最適化済みカーネル集NKI-libもオープンソース化しました。
コード変更はどんな形か
学習ループについては、発表記事が差分全体を1行で示しています。
model = MyModel().to('neuron')   # the only change
optimizer = torch.optim.AdamW(model.parameters())
for batch in dataloader:
    optimizer.zero_grad()
    loss = criterion(model(batch), targets)
    loss.backward()
    optimizer.step()
コンパイル版では、torch.compiler.set_default_backend("neuron")でバックエンドを一度指定するか、呼び出しごとにtorch.compile(model, backend="neuron")と指定します。デバイスに依存しないPyTorchのAPIであるtorch.acceleratorで書かれたコードは、まったく変更が要りません。import torch_neuronxも不要で、パッケージはtorch.backendsのエントリポイント経由で自分を登録し、import torchで読み込まれます。
ドキュメントにある変更の全リストは短いものです。
.to('cuda')を.to('neuron')に変えるか、torch.acceleratorに任せます。- 混合精度には
torch.autocast(device_type="neuron")を使います。 - 分散ジョブでは、GPUではなくNeuronCore単位でシャーディングを設定します。
torch.compileではbackend="neuron"を追加し、mode="max-autotune-no-cudagraphs"のようなCUDA専用の設定を削除します。
Hugging Faceのモデルならさらに簡単です。device_map="neuron"でモデルを読み込むと重みがTrainiumに置かれ、device_map="auto"ならデバイスを自動で見つけます。Hugging Faceの例では、標準のTRL SFTTrainerスクリプトでTrainium2チップ8個(trn2.48xlargeの半分)を使ってファインチューニングしており、Neuron固有の設定はHF_DEACTIVATE_ASYNC_LOAD=1の1つだけです。重みの非同期読み込みがまだ未対応だからです。保存されるチェックポイントは通常のTransformersのチェックポイントで、どのハードウェアでも読み込めます。
こうした機械的な移植は、コーディングエージェントの得意分野です。リポジトリを移すなら、Claude CodeやOpenAI CodexのようなツールがCUDA固有の呼び出しを見つけて置き換えてくれます。ただしコンパイルログは自分で確認してください。
TorchNeuronの料金は?
ライブラリは無料です。TorchNeuronはApache 2.0で、Neuronのpipリポジトリからpip install torch-neuronxでインストールでき、Neuron Deep Learning AMIとDeep Learning Containersにはプリインストールされています。コストはTrainiumの利用時間です。
AWSは、固定期間でアクセラレーター容量を予約するCapacity Blocks料金ページでTrainiumの料金を公開しています。以下は2026年10月20日時点の実効時間料金で、AWSは次回の価格改定を2027年1月に予定していると述べています。
| インスタンス | アクセラレーター | インスタンス1時間あたり | チップ1時間あたり | TorchNeuronで動く? |
|---|---|---|---|---|
| trn2.48xlarge(US East、オハイオ) | 16 x Trainium2 | $35.7608 | $2.235 | はい |
| trn2.3xlarge(一部リージョン) | 1 x Trainium2 | $2.235 | $2.235 | はい |
| trn1.32xlarge | 16 x Trainium | $9.532 | $0.596 | いいえ |
| p5.48xlarge | 8 x H100 | $47.757 | $5.970 | GPU、Neuronではない |
| p5e.48xlarge | 8 x H200 | $54.924 | $6.866 | GPU、Neuronではない |
| p5en.48xlarge | 8 x H200 | $63.158 | $7.895 | GPU、Neuronではない |
これらのブロックでは、Linuxに追加のOSライセンス料はかかりません。最大144個のTrainium3チップまで拡張できるTrn3 UltraServerには、そのページに公開された時間料金がありません。
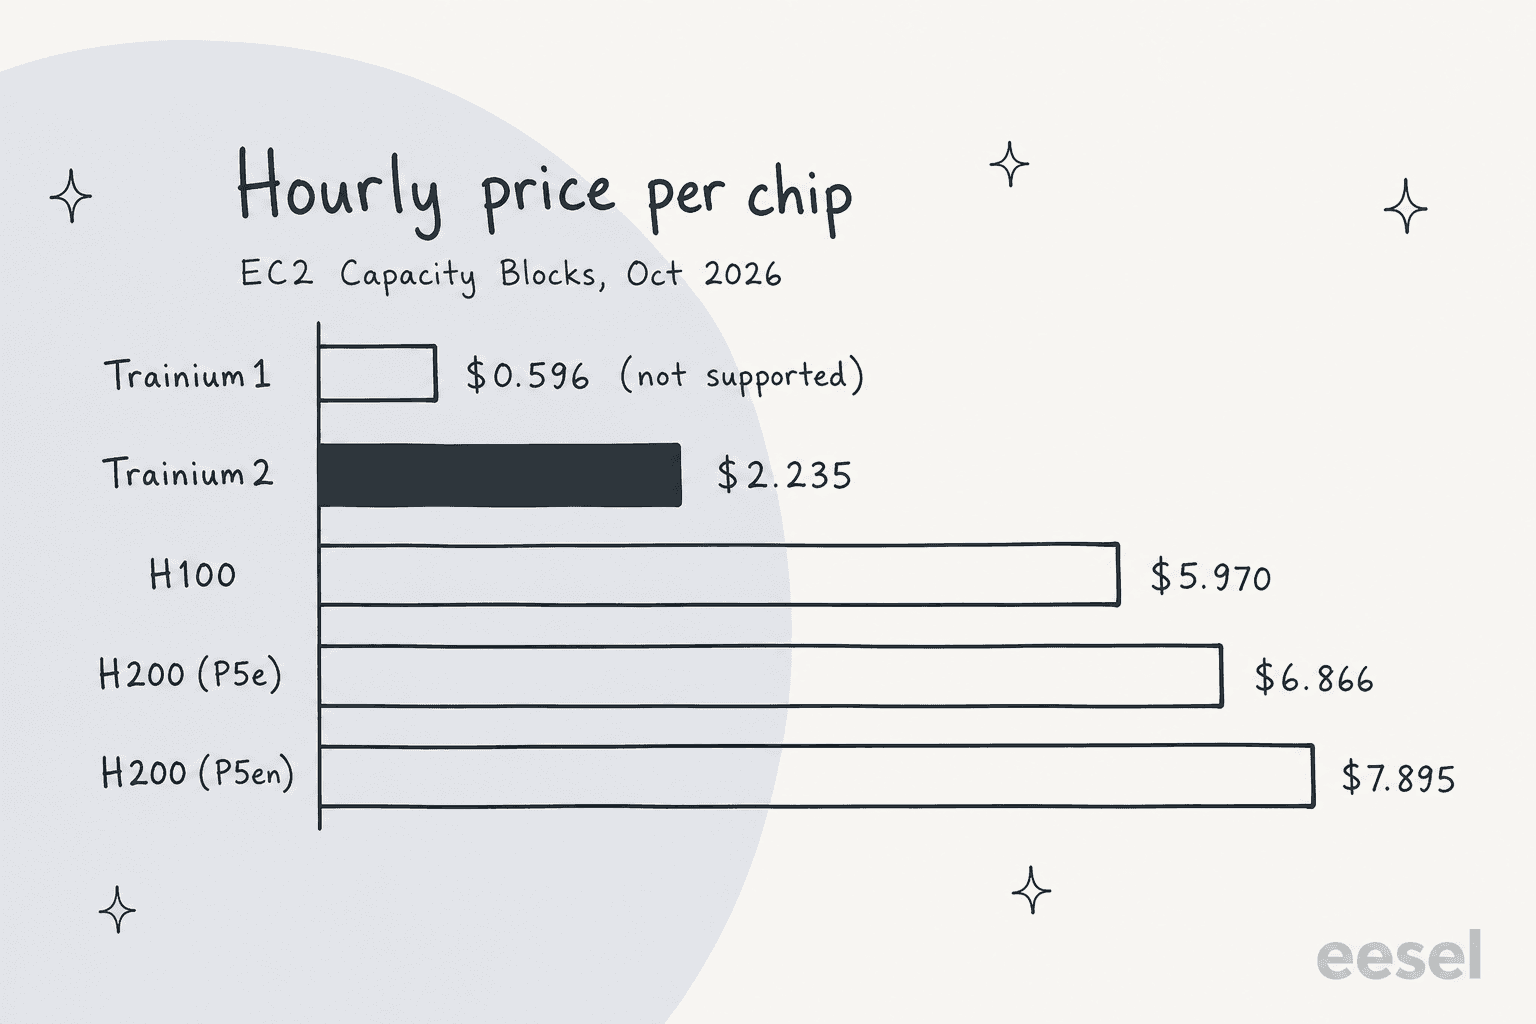
チップ単位では、Trainium2の1時間はH100の1時間のおよそ37%です。ただしTrainium2チップとH100では処理量が違うので、ジョブのコストが37%になるわけではありません。AWS自身のTrn2ページでの主張はもっと限定的で、Trn2インスタンスは"30-40% better price performance than GPU-based EC2 P5e and P5en instances."だというものです。trn2.48xlargeには、Trainium2チップ16個、1.5TBのHBM、最大20.8 FP8ペタフロップスが載っています。
発表時に出た顧客の数字は、音声認識企業Deepgramのものだけです。
"In the benchmarks we evaluated, Trainium processes about 60% more input audio seconds per dollar than our existing GPU baselines, which helps us bring better models to customers at lower prices."
Adam Sypniewski, CTO of Deepgram, PyTorchブログより
この数字の背景に注目してください。Deepgramは、AWS Generative AI Innovation Centerとの数カ月にわたる取り組みの中でモデルを移植しました。本物の成果ですが、支援付きの移行であり、週末で切り替えられる話ではありません。GPUクラウドを比較するなら、表のもう一方については私のCoreWeave料金とLambda料金の解説が、請求のそれ以外の部分についてはAWS料金ガイドが役立ちます。
ベンチマークとテストカバレッジ
AWSは発表時にモデルの速度ランキングを公開しませんでした。公開したのはカバレッジテストで、ベータ段階ではこちらのほうが有用な数字だと考えます。発表記事によると、AWSはダウンロード数で実際の利用の99.9%をカバーするように選んだ約100,000のHugging Faceモデルを、縮小構成でTrainium上で継続的に実行しています。各実行では、モデルが読み込めるか、フォワードとバックワードが動くか、コンパイルできるかを確認します。
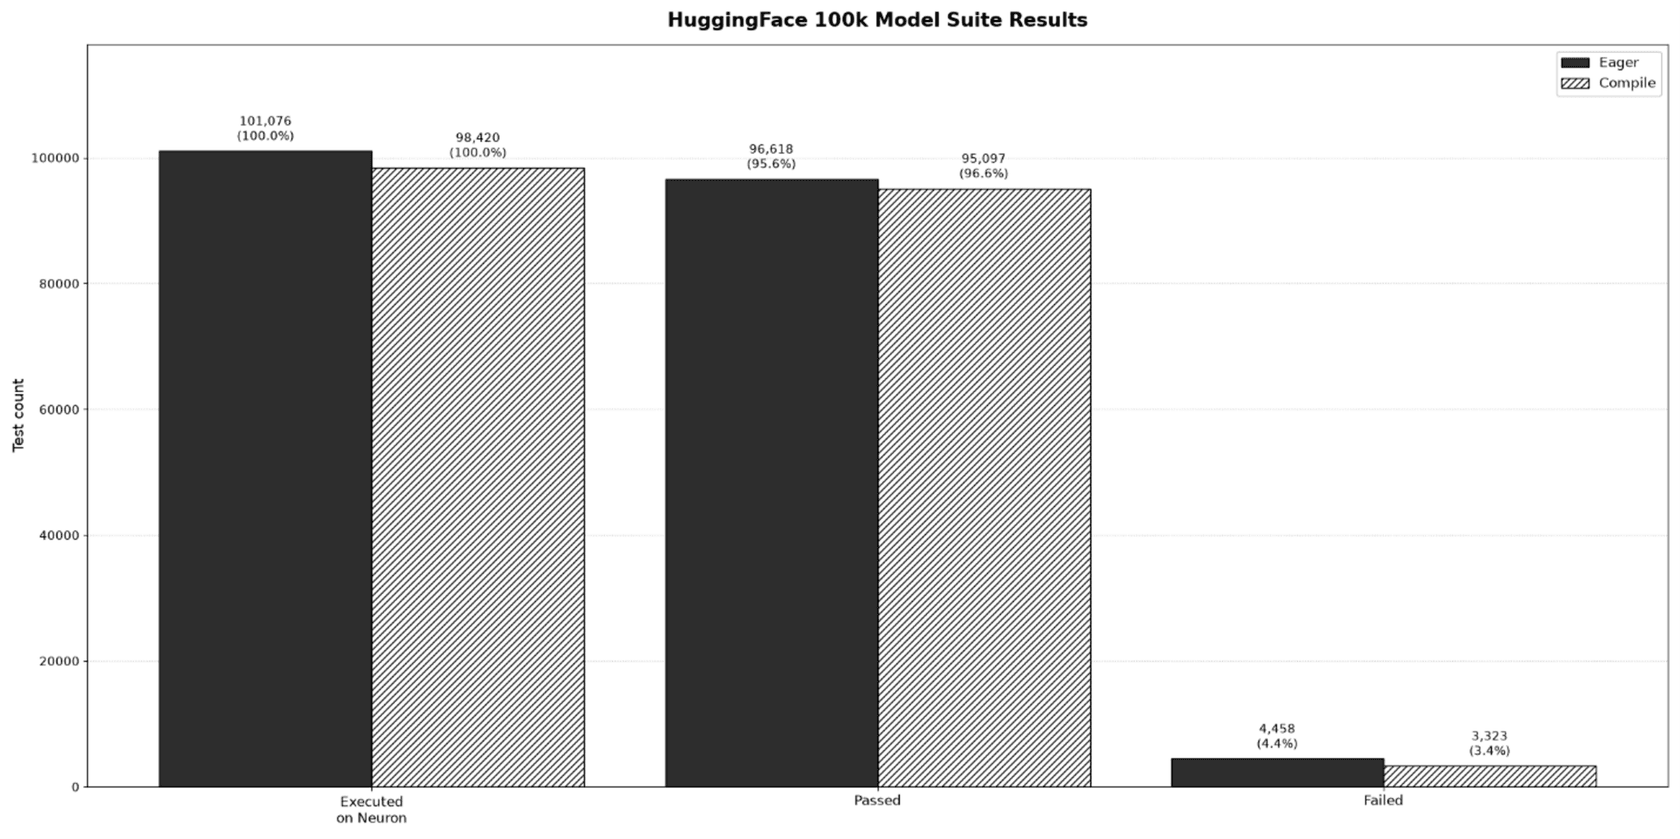
2026年9月の結果は、イーガーモードで95.6%、torch.compileで96.6%が合格で、失敗はそれぞれ4,458件と3,323件でした。ベータとしては強い数字で、テストの種類としても適切です。eeselでは逆の側から同じ教訓を学びました。デモで見事に見えるサポートエージェントでも、実際のチケットでは自信満々に間違った答えを返すことがあります。だから私たちは、本番投入の前にお客様の過去のチケットで毎回シミュレーションします。実在する100,000モデルを一斉に回すのは、AWSがコンパイラに対して行っている同じことです。
上流のPyTorchテストスイートは、穴がどこにあるかを教えてくれます。2026年8月の実行では約154,000件のテスト結果が出て、そのうち約69,000件がスキップされました。約30,000件はPyTorch自身の適格性チェックによるスキップ(CUDA専用とCPU専用のテスト)です。残りの約39,000件はNeuronによる意図的なスキップで、最大のグループはネイティブなNeuronへの変換がまだない演算子の約22,000件です。
ハードウェアについては、Trn3ページが、Trn3 UltraServerはTrn2 UltraServerの最大4.4倍の性能と4倍のワット当たり性能を提供し、144チップで最大362 MXFP8ペタフロップスに達すると主張しています。これはチップに関するAWSの数字であり、TorchNeuronの結果ではありません。どちらについても、独立したベンチマークはまだ見ていません。
TorchNeuronがまだできないこと
これは最初のリリースで、AWSは省いたものについて異例なほど率直です。発表記事とREADMEから整理します。
- 古いチップ。 対応はTrn2とTrn3のみです。上の表でチップ1時間あたり0.596ドルと最も安いアクセラレーターであるTrainium1と、Inferentiaは、XLAベースのtorch-neuronxライン(2.14より前のバージョン)に残ります。
- 動的な形状。
torch.compileには静的な形状が必要です。可変長の入力はパディングやバケット化が必要で、新しい形状ごとに再コンパイルされます。 - 精度。 float64はfloat32として動作するため、64ビット精度が必要な結果が変わる可能性があります。int64のサポートは演算によって異なります。
- 意図的に省かれた機能。 スパーステンソル、NestedTensor、フォワードモードの自動微分、ネイティブのマルチヘッドアテンションでの任意のアテンションマスク(マスクなしとコーザルは動作)、チャネルごとの量子化、バイリニア/バイキュービックのアップサンプリングは、このリリースに含まれません。
- FP8とTorchAO。 プライベートベータで、一般提供は次のリリースで予定されています。FlexAttentionのサポートは限定的です。
- 初回実行時のコンパイル時間。 READMEによると、演算またはコンパイル済みグラフの最初の呼び出しにはコンパイルが含まれ、これは"can be significant for a large model"とのことです。
コミュニティの反応は、これまでのところ、この種の移植を経験した人たちからの慎重な楽観論が中心です。ジャシーへの返信で、あるエンジニアはこう書きました。
"Big if this works flawlessly. I have been on the other end, it's not been pretty."
AWS CEOのMatt Garmanの投稿への別の返信は、もっと長期的な試金石を挙げました。AWSが変更をPyTorch本体に取り込み続けるかどうかです。
"Open sourcing is the easy half, upstreaming is the harder promise."
AWSはすでに動き出しています。発表記事には、テスト品質の向上とCUDA前提のハードコードの除去を目的としたPyTorchとTorchTitanへの26件のプルリクエストが挙がっています。
Capacity Blockを予約する前に、自分のコードベースをこのリストと照らし合わせる価値があります。当てはまるものにチェックを入れてください。
ワークロードが使っているものにチェックを入れると、各障害への対処法が表示されます。TorchNeuronのドキュメントとREADMEに基づいています。
モデルを動かす他の方法とTorchNeuronの比較
TorchNeuronの本当のライバルはGPUです。自前のモデルを学習・提供するチームにとっての選択肢は次のとおりです。
| 選択肢 | 管理するもの | コード変更 | 向いているケース |
|---|---|---|---|
| TrainiumでのTorchNeuron | インスタンス、コンパイルキャッシュ、形状 | デバイス名、コンパイル用の静的形状 | 安定した大規模ジョブを抱えるAWS中心のチーム |
| AWSのNVIDIA GPU(P5、P5e、P5en) | インスタンス | CUDAコードなら不要 | 独自CUDAカーネルを持つコード、最速の立ち上げ |
| GPUクラウド(CoreWeave、Lambda) | インスタンスまたはクラスター | CUDAコードなら不要 | 大手クラウド以外のGPU容量 |
| サーバーレスGPU(Modal、Baseten) | 自分のモデルコード | 小さなラッパー | 容量計画なしのバースト的な推論 |
| ホスト型モデルAPI(Together AI、Groq) | なし | API呼び出しのみ | ハードウェアに触れずにオープンモデルを使う |
面白いのは、最初の行のコード変更の欄が以前は「学習スタックの書き直し」だったことです。今ではGPUの行に近づいていて、それこそが今回の発表の狙いです。AWSは、Anyscale、Modular、Nota AIなど、すでにこの上で開発しているパートナーを挙げています。Hugging Faceのサポートのおかげで、私のKimi K3やDeepSeek V4 Flashの記事で扱ったオープンモデルの大半は、device_mapひとつでTrainiumで動かせます。
サービング面では、TorchNeuronは同じtorch.compileバックエンドをvLLM Neuronに渡します。これはOpenAI互換サーバー、連続バッチ処理、ページ化されたKVキャッシュを追加するプラグインです。最終的な目的が自前のサービングスタックではなく、AWS上のマネージドエージェントなら、Bedrock Managed Agentsはこれらすべての一層上にあります。
はじめ方
Trn2またはTrn3のインスタンスと、Python 3.12、3.13、3.14が必要です。Neuron Deep Learning AMIにはTorchNeuronがインストール済みです。他のLinuxインスタンスでは、READMEの手順に従ってNeuronドライバーとランタイムをインストールし、バージョンを固定します。
pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu
pip install "torch-neuronx==2.14.*" "neuronx-cc==2.*" "nki>=0.6" --extra-index-url https://pip.repos.neuron.amazonaws.com
python -m torch_neuronx.collect_env
固定したバージョンは守ってください。以前のtorch-neuronxは同じパッケージ名のXLAベースの製品で、間違ったものを入れてしまいやすいからです。collect_envのチェックでは、デバイスがtorchから使えると報告されるはずです。
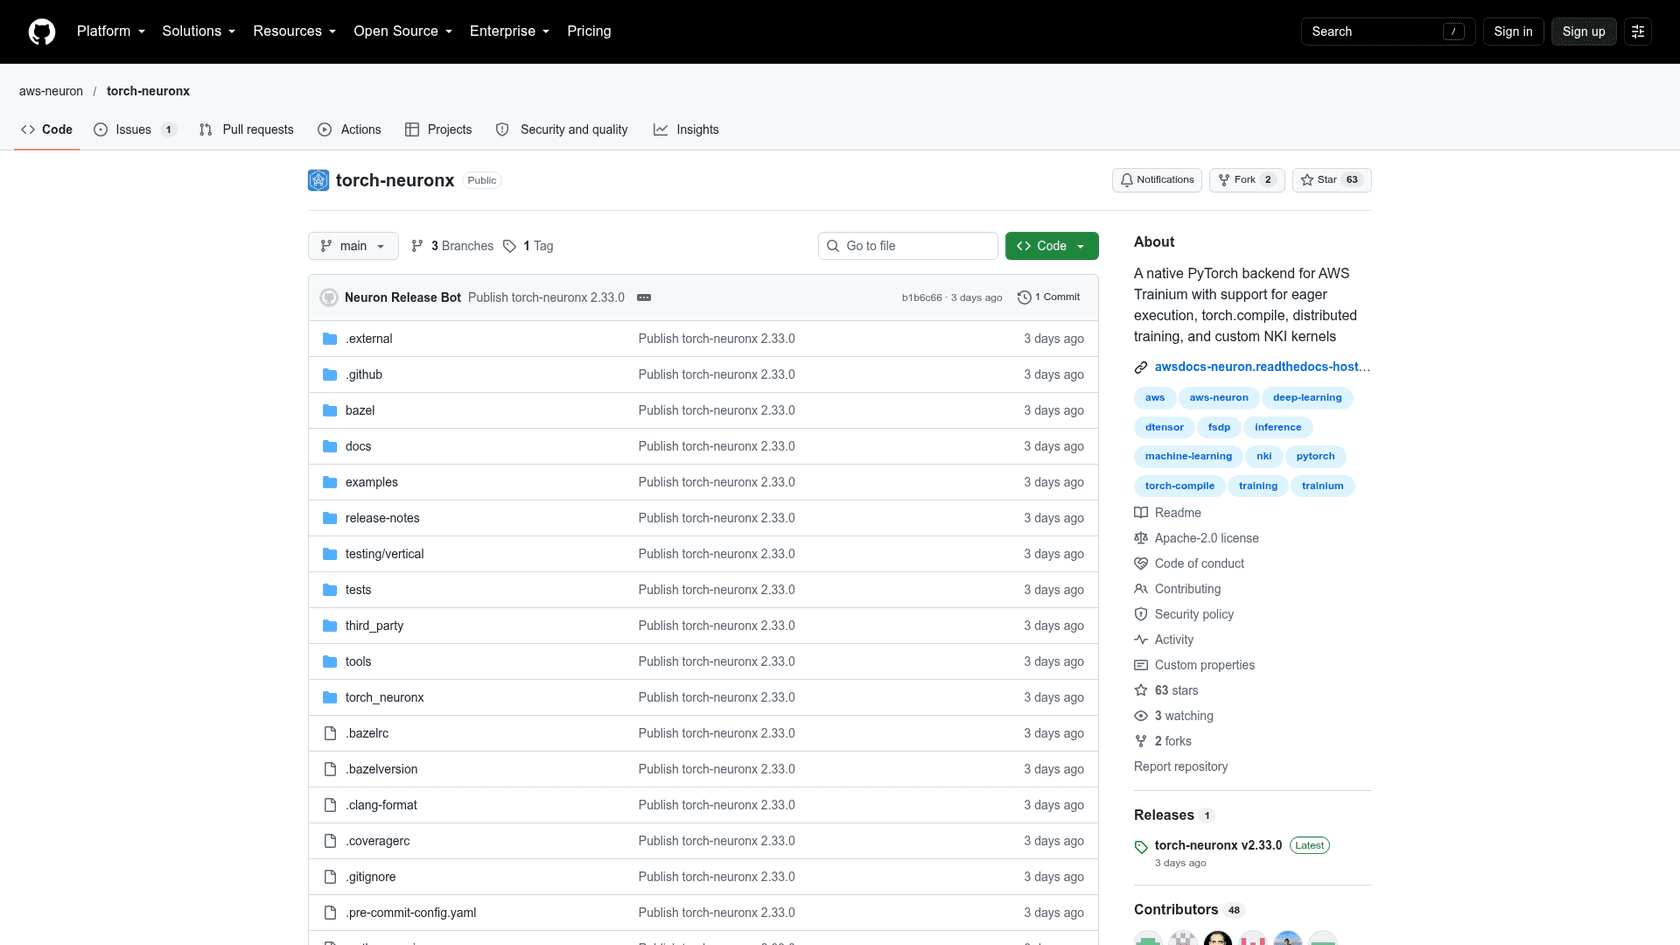
公開初日に私が確認した時点で、リポジトリは63スターと48人のコントリビューターで、Llama、Whisper、Qwen2、Mixture-of-Expertsモデル、GPT-2の学習、マルチノード実行のサンプルが揃っていました。大規模学習向けには、torchtitan-neuronがTrainiumに最適化したTorchTitanのレシピを提供しています。発表記事では、単一のtrn2.48xlargeでSimpleFSDPとtorch.compileを使ってLlama 3 8Bを学習する手順を紹介しています。
パイロットの進め方としてお勧めの順序です。
- trn2.3xlargeまたはtrn2.48xlargeでモデルをイーガーモードで動かし、CPUフォールバックの警告をすべて読みます。
- 形状を直してから、ホットパスを
fullgraph=True付きのtorch.compileに移します。 - スケールアウトする前に、インスタンス間でNEFFキャッシュを共有します。
- 1時間あたりのコストではなく、1学習ステップまたは1トークンあたりのコストを、現在のGPUと比べます。
TorchNeuronが向いている人
TorchNeuronが向いているのは、自前のPyTorchモデルを学習・提供していて、すでにAWSを使っていて、30〜40%の価格性能比の差がエンジニアリングのスプリントに見合うほどアクセラレーターに支出しているチームです。研究チームは、デバッグがようやく他のデバイスと同じように動くため、イーガーモードから最も恩恵を受けます。本番チームは、形状とキャッシュを整えたあとのコスト面から最も恩恵を受けます。
まだ書き直せない独自CUDAカーネルに依存している場合、Trainium1やInferentiaが必要な場合、モデルの重みにまったく触れない場合は、向いていません。AIを使う企業の大半、eeselでお話しするお客様のほとんども最後のグループです。AIに仕事をしてほしいのであって、その下で動くチップは他の誰かの問題です。
eeselの立ち位置:これはインフラであり、eeselは従業員
TorchNeuronはハードウェア層を安く、入れ替えやすくします。モデルを作る人すべてにとって良い知らせで、長い目で見れば、その上に作られるAI製品のコストも押し下げます。しかしチケットに答えることも、返信を下書きすることも、ブログ記事を書くこともしません。それらは仕事であり、仕事にはコンテキストが必要です。ヘルプセンター、過去の会話、返金に関するルールです。
eeselが働いているのはその層です。eeselはAIチームメイトのプラットフォームで、特定の仕事向けにすぐ働けるチームメイトを採用できます。現在はAIヘルプデスクチームメイトとAIブログライターです。ヘルプデスクチームメイトは既存のキューに加わり、ヘルプセンターと過去のチケットから学び、本物の顧客に答える前に過去の会話でシミュレーションされます。
SE Rankingは、技術系の読者にとって良い例です。ZendeskでSE Ranking、Planable、SE Visibleの製品ごとにeeselエージェントを1つずつ動かしており、2026年8月8日から9月8日までの間にeeselは約4,650件の会話を処理し、そのうち約2,100件がライブチャットでした。APIやLooker Studioに関する質問は、ボットが推測するのではなく、証拠を集めたうえでティア2のグループに回されます。
固定したpipインデックスからPyTorchバックエンドをインストールしたばかりの読者なら、こちらもターミナルから設定するほうが好みでしょう。eesel CLIはダッシュボードと同じチームメイトとワークスペースを操作するので、そこで設定したものはUIにも反映され、その逆も同じです。npx @eesel/cli init chat-bubble --site https://your-site.comは、アカウントなしでエージェントを作成し、ウェブサイトにチャットバブルを追加して、サイトの読み込みを始めます。その後はeesel loginでワークスペースを保持します。そこから、eesel chatでエージェントと会話し、eesel files uploadで知識を追加し、eesel integrations connectでヘルプデスクをつなぎ、eesel automationsでエージェントが自律的に行う内容を設定し、eesel approvalsで保留中のアクションを承認できます。
すべてのコマンドはJSONを出力し、エラーは{error, hint, retryable}で返り、--dry-runは書き込みが行うサーバー呼び出しをそのまま表示します。だからClaude CodeやCursorのようなコーディングエージェントでも使えます。エージェントがセットアップを実行し、その結果を自分で読めるからです。すべてのワークスペースはMCPサーバーでもあり、eesel mcp tokenはそのまま貼り付けられる設定行を出力します。

上のダッシュボードで見えているのと同じログが、ターミナルではeesel activityで新しい順に出力されます。
eeselを試す
TorchNeuronは、モデルに最適な安いチップを選べるようにします。eeselは、サポート業務ではその判断自体を省けるようにします。ZendeskやFreshdesk、Gorgiasに接続し、過去のチケットで学習し、本番の会話に触れる前に過去の会話で実力を証明するヘルプデスクチームメイトです。API関連の質問が多いSaaSチームなら、AIヘルプデスクAPIとCLIで、セットアップ全体をスクリプト化できます。eeselを無料で試すか、ターミナルからnpx @eesel/cliで始めてください。
よくある質問
TorchNeuronとは何ですか?
neuronデバイスを追加し、イーガーモード、torch.compile、torch.distributedがTrainium2とTrainium3で動作します。2026年10月20日にパブリックベータとして公開されました。モデルを動かすチップではなく、仕事をこなすAIがほしい場合は、AIチームメイトがスタックの反対側にあたります。TorchNeuronは無料ですか?
TorchNeuronは本当に1行変えるだけで済みますか?
.to('cuda')を.to('neuron')に変えるだけで、コードがすでにtorch.acceleratorを使っているなら何も変えなくて済みます。本番の速度を出すには、torch.compileにbackend="neuron"を加え、静的な形状を使い、CUDA専用のオプションを外す必要もあります。Claude Codeのようなエージェント型ツールは、こうした機械的な移植が得意です。