

Mercury 3は、Inceptionが2026年10月19日に公開した最新モデルです。拡散型の言語モデルで、1トークンずつ入力する代わりに、回答全体を下書きして数回のパスで磨き上げます。Inceptionは毎秒1,068トークンと計測しており、100万トークンのコンテキストウィンドウ、ツール呼び出し、構造化出力に対応します。
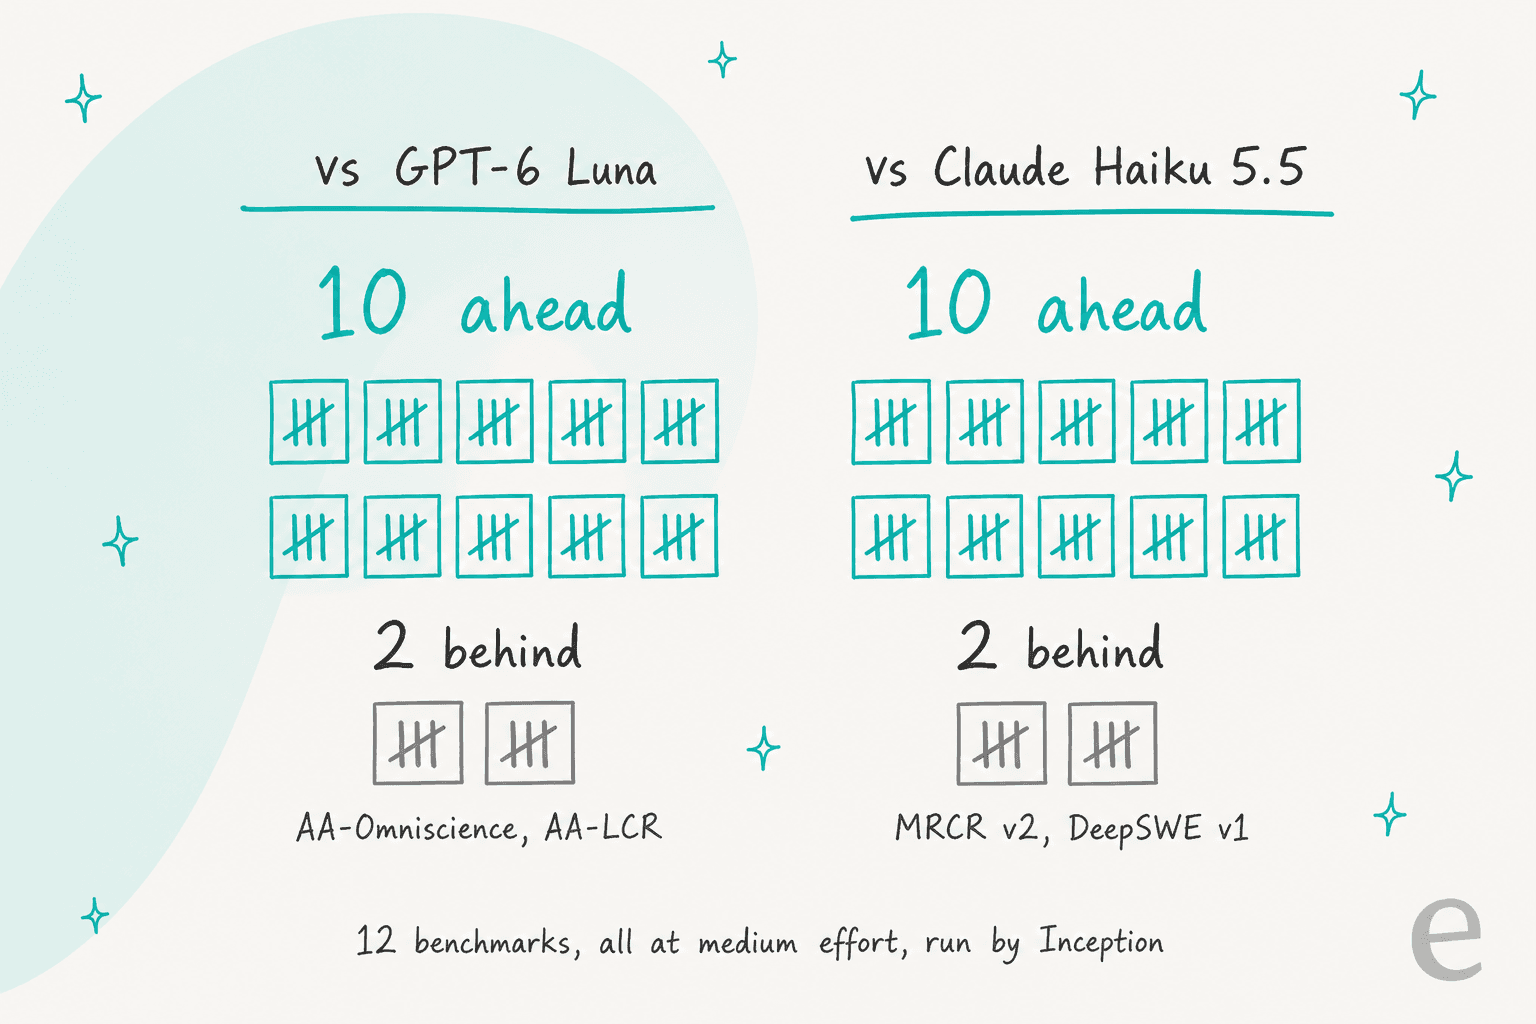
Inception自身のベンチマーク表では、すべて中程度の推論強度で、12テスト中10でGPT-6 LunaとClaude Haiku 5.5を上回っています。料金は100万トークンあたり入力$0.20、出力$0.70で、ローンチ時は半額($0.10 / $0.35)、新しいキーには1億トークンが無料で付きます。
注意点は、実際に体感する速度です。Mercury 3のリクエストをすべてInceptionに送るOpenRouterは、ローンチ週に毎秒160~254トークンの中央値を計測しました。高速ですが1,068には遠く及ばず、Hacker Newsのテスターは最初のトークンが遅いと指摘しています。待ち時間が積み重なるエージェントのループやサブエージェントに使うのが向いています。サポートチームにとっては強力なエンジンですが、あくまでインフラです。eeselは従業員であり、このようなモデルを回答済みのチケットに変えるのが、そのAIヘルプデスクのチームメイトです。
このローンチを詳しく見た理由
私は毎週の多くの時間を、人々が何を検索し、それが実際に何を意味するのかを読むことに使っています。「Mercury 3」は速度の検索です。毎秒1,000トークンという数字が、実際のAPIで通用するのかを知りたいのです。そこで、Inception自身のページを開き、OpenRouterのライブの数字とHacker Newsのローンチスレッドを並べて読みました。
もう1つ理由があります。eeselは長年、AIモデルを実際のサポートキューに載せてきましたが、何度も繰り返し得た教訓は、モデルのラボでの数字は、あなたのチケットで動くかどうかを決めないということです。だからeeselは、AIが誰かに回答する前に、顧客の過去チケットですべての展開をシミュレーションします。ここでも同じ習慣を適用しました。主張を前提に計画する前に、外部の測定と照らし合わせましょう。
Inception Mercury 3とは?
Mercury 3は、拡散型LLM(dLLM)を開発するラボInceptionのフラッグシップモデルです。Inceptionのローンチ記事は、これを"the most capable diffusion-based LLM released to date"と呼び、Mercury 1の40倍以上の大きさでありながら同じ速度で動くとしています。先月登場したばかりのMercury 2.5の後継です。
Inceptionのモデルドキュメントから、そのまま仕様を示します。
| 項目 | Mercury 3 |
|---|---|
| 公開日 | 2026年10月19日 |
| タイプ | 拡散型LLM、重みは非公開 |
| 出力速度(Inceptionの数値) | NVIDIA GPUで毎秒1,068トークン |
| コンテキストウィンドウ | 1Mトークン(Mercury 2.5は260K) |
| 最大出力 | 131,072トークン |
| 推論強度 | instant、low、medium、high |
| 機能 | ツール呼び出し、構造化出力 |
| 入力と出力 | テキストのみ |
| API | OpenAI互換、モデルID mercury-3 |
| 価格(定価) | 1Mトークンあたり入力$0.20 / 出力$0.70 |
| 価格(ローンチ、50%オフ) | 1Mトークンあたり入力$0.10 / 出力$0.35 |
| 無料枠 | 新しいAPIキーに1億トークン |
表に書かれていないことが2つあります。Inceptionはパラメータ数を公開しておらず、共同創業者はHacker Newsで「not publicly announcing the model size right now」と書いています。また、ダウンロードできる重みはありません。それが重要なら、比較対象にはGoogleのDiffusionGemmaというオープンな拡散モデルがあります。
拡散型LLMは何が違う?
GPT-6.1 SolからDeepSeek V4.1 Flashまで、今使われているほぼすべてのモデルは自己回帰型です。次のトークンを予測し、それを追加し、左から右へ繰り返します。長い回答に時間がかかるのはそのためです。2,000トークンの返信は、1ステップがどれだけ速くても、2,000ステップの連続になります。
拡散モデルはその逆です。回答全体の粗くノイズの多い下書きから始め、少数のパスで全体を並列に磨き上げます。InceptionのMercury 2ローンチ記事はうまく表現しています。"Less typewriter, more editor revising a full draft at once." 画像生成AIがノイズから絵を鮮明にしていく様子を見たことがあれば、それをテキストに応用した発想です。画像側の詳細は、拡散モデルベースのAIの解説記事で掘り下げています。
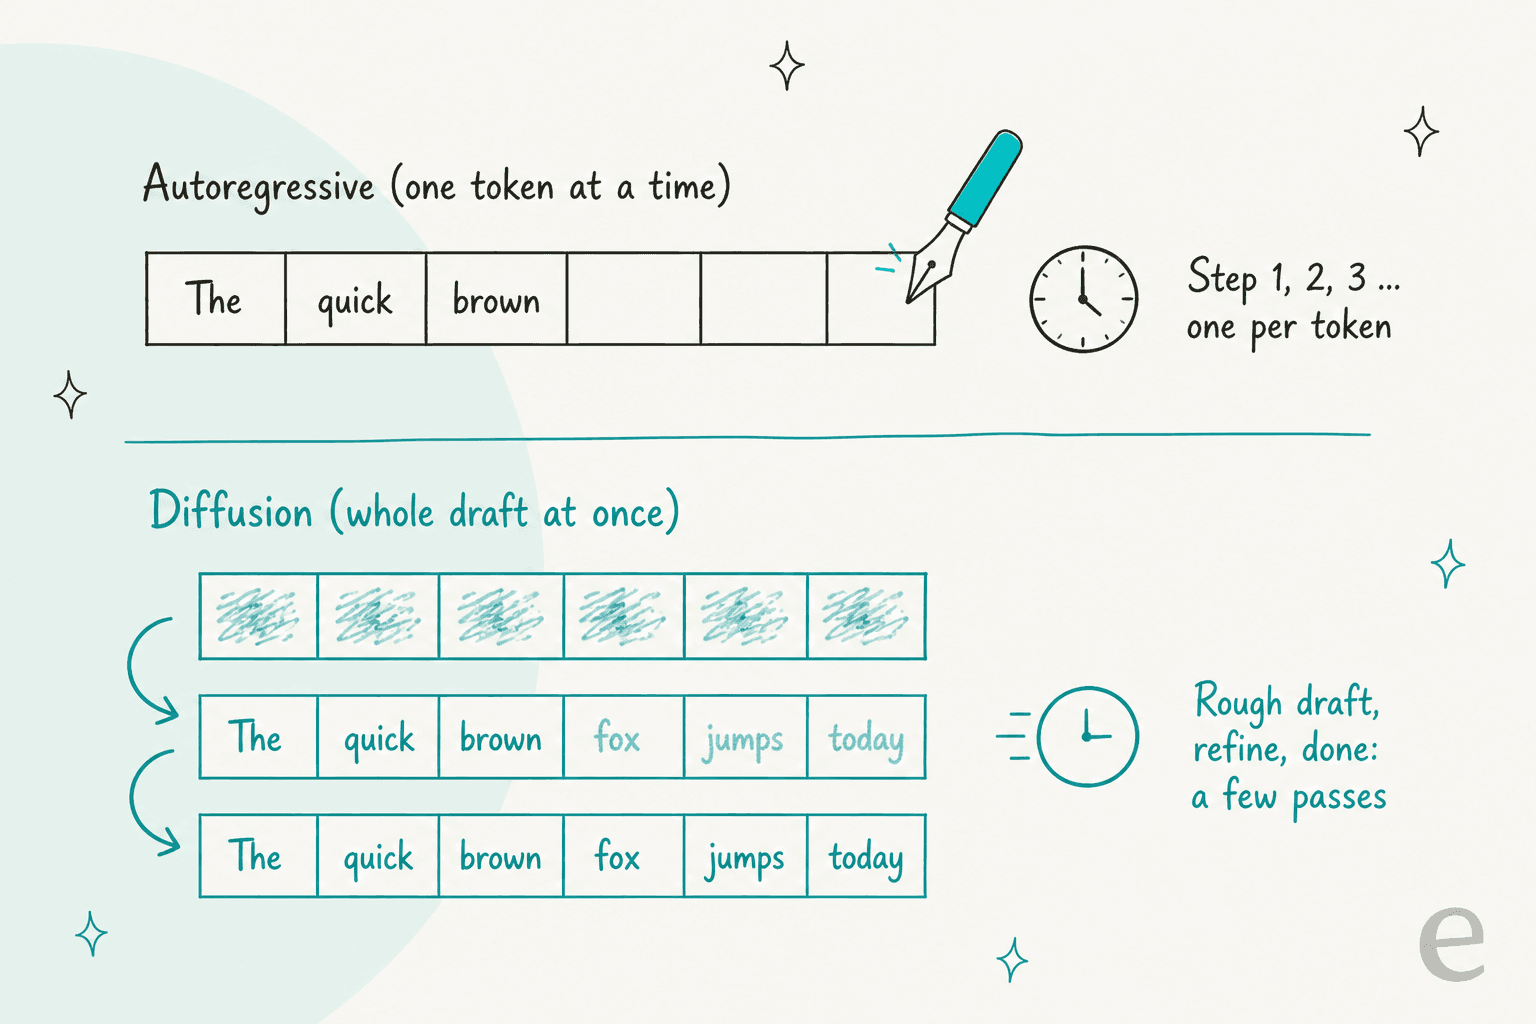
これが今になって重要な理由は、推論モデルは回答の前に考え、その思考が出力トークンだからです。Inceptionの共同創業者でチーフサイエンティストのVolodymyr Kuleshovはローンチスレッドで、拡散はトークンを並列に書くため、モデルが長く考えるほど速度差は広がると指摘しました。
"Diffusion generates tokens in parallel through iterative denoising rather than one at a time, so as reasoning models think longer per answer, the speed advantage over autoregressive models of the same size grows."

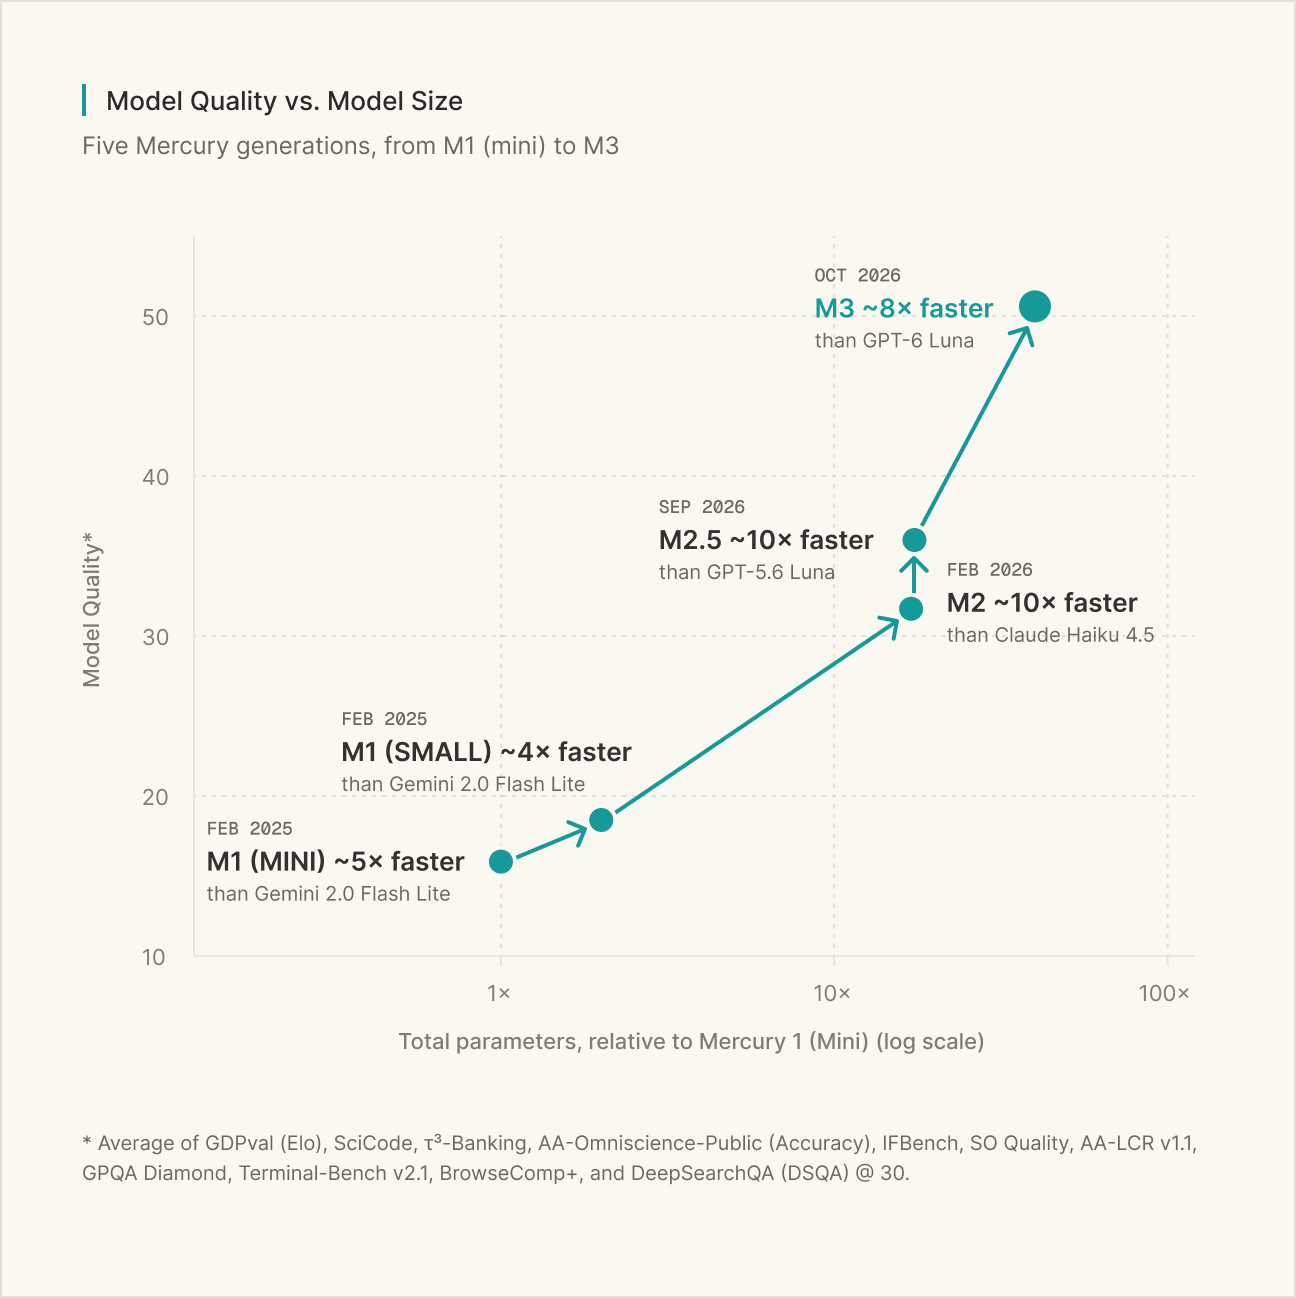
長年の未解決の問いは、拡散型LLMが速いだけでなく賢くなれるのかという点でした。Inceptionの答えはスケーリングのグラフです。2025年初頭から現在までの5世代のMercuryで、モデルが大きくなるにつれて品質が上がっています。
Mercury 3のベンチマーク:Inceptionの表が示すこと
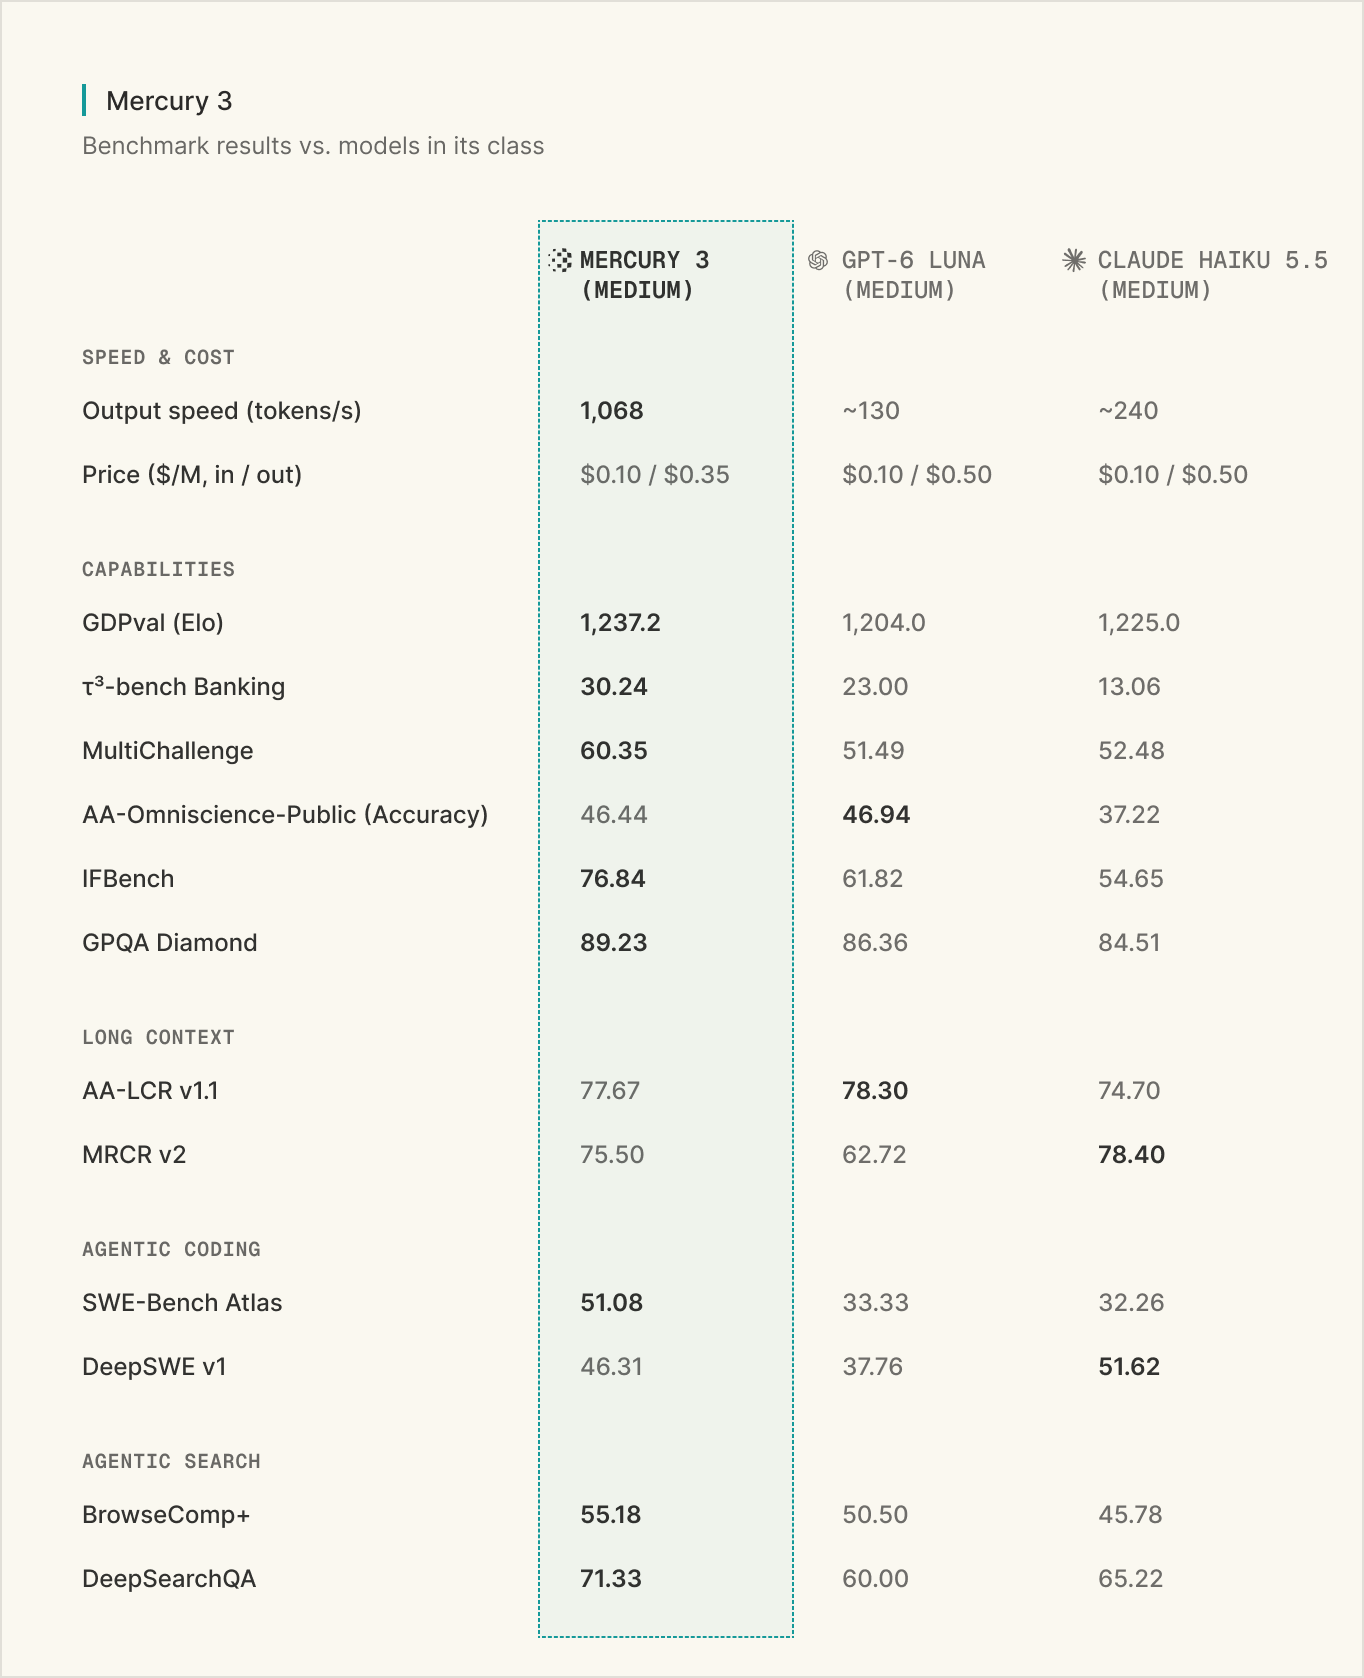
Inceptionは、Mercury 3を置き換え対象として価格設定された2つのモデル、OpenAIのGPT-6 LunaとAnthropicのClaude Haiku 5.5と、どちらも中程度の推論強度で比較しています。ローンチ記事の全体の表は次のとおりです。
| ベンチマーク | 測定内容 | Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|---|
| GDPval (Elo) | 実務タスク | 1,237.2 | 1,204.0 | 1,225.0 |
| τ³-bench Banking | カスタマーサービスのエージェント | 30.24 | 23.00 | 13.06 |
| MultiChallenge | 複数ターンのチャット | 60.35 | 51.49 | 52.48 |
| AA-Omniscience (Accuracy) | 事実の想起 | 46.44 | 46.94 | 37.22 |
| IFBench | 指示への追従 | 76.84 | 61.82 | 54.65 |
| GPQA Diamond | 大学院レベルの科学 | 89.23 | 86.36 | 84.51 |
| AA-LCR v1.1 | 長文脈の推論 | 77.67 | 78.30 | 74.70 |
| MRCR v2 | 長文脈の想起 | 75.50 | 62.72 | 78.40 |
| SWE-Bench Atlas | エージェント型コーディング | 51.08 | 33.33 | 32.26 |
| DeepSWE v1 | エージェント型コーディング | 46.31 | 37.76 | 51.62 |
| BrowseComp+ | エージェント型検索 | 55.18 | 50.50 | 45.78 |
| DeepSearchQA | エージェント型検索 | 71.33 | 60.00 | 65.22 |
表全体を見ると、Mercury 3は12行中8行で最高スコアです。1対1の比較では、どちらの相手に対しても12中10で上回っています。
引用する前に、次の3点を覚えておいてください。
- すべての数字はInception自身の実行結果です。 Mercury 3のArtificial Analysisのページはまだなく、KuleshovはHacker Newsで、第三者によるベンチマークは進行中だと述べています。
- すべて中程度の推論強度です。 多くの人が安価なモデルをhighやmaxで動かすため、あるコメント投稿者がその理由を尋ねました。lowからhighまでの曲線がないため、考える量を増やしたときにLunaやHaikuがどれだけ差を縮めるかは分かりません。
- 最大の勝利はエージェント系のテストです。 SWE-Bench Atlas(51対33)とτ³-bench Banking(30対23と13)は大きな差です。負けているのは、長文脈の想起と、Haiku 5.5が先行している1つのコーディングテストです。
率直なまとめはInception自身から出ています。HaikuがDeepSWEで勝った理由を聞かれて、Kuleshovは誇張しませんでした。
"overall we have found the model to be Haiku- or Luna-level in our own daily usage. That means that it won't yet replace Opus or Fable as the primary driver of a harness, but we have used it successfully for subagents"
私ならこの見方を使います。Luna級の賢さで、出力ははるかに高速。ローンチ記事のパートナー事例も同じ方向を示しています。TinyFishは、Mercury 3がMind2Webの実際のウェブ操作タスク50件の半分を完了し、"significantly more than GPT-6.1-Sol"だったとしており、Octenはスマートグラスの検索テストで中央値0.9秒の生成時間を計測しました。
Mercury 3の実際の速度は?
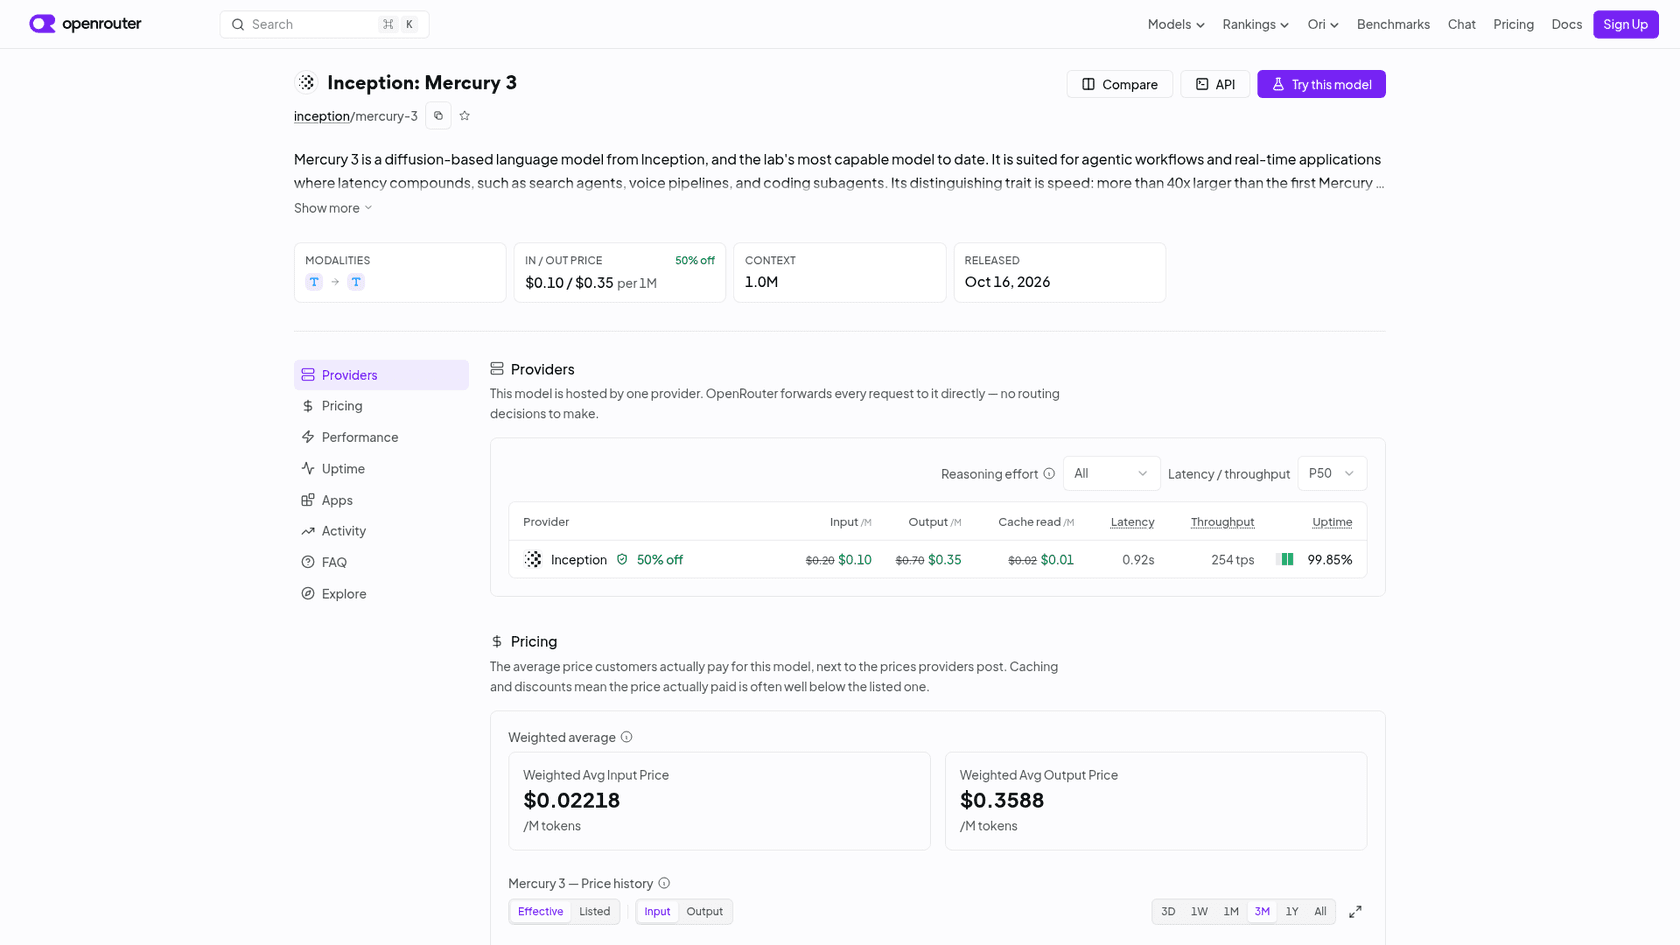
ローンチ報道の多くが飛ばす部分です。1,068という数字は、InceptionがNVIDIAの自社ハードウェアで測った値です。私が見つけた唯一の独立した数字はOpenRouterのもので、Mercury 3のプロバイダーはInception自身の1社のみ、スループットはライブで公開されています。
2026年10月20日に確認したとき、OpenRouterは中央値で毎秒160トークンを示し、同日あとの2回目のキャプチャでは254でした。中央値の1週間平均は203で、中央値のレイテンシは約1秒です。Inceptionが挙げるLunaの約130よりは速いものの、見出しの数字の約5分の1です。
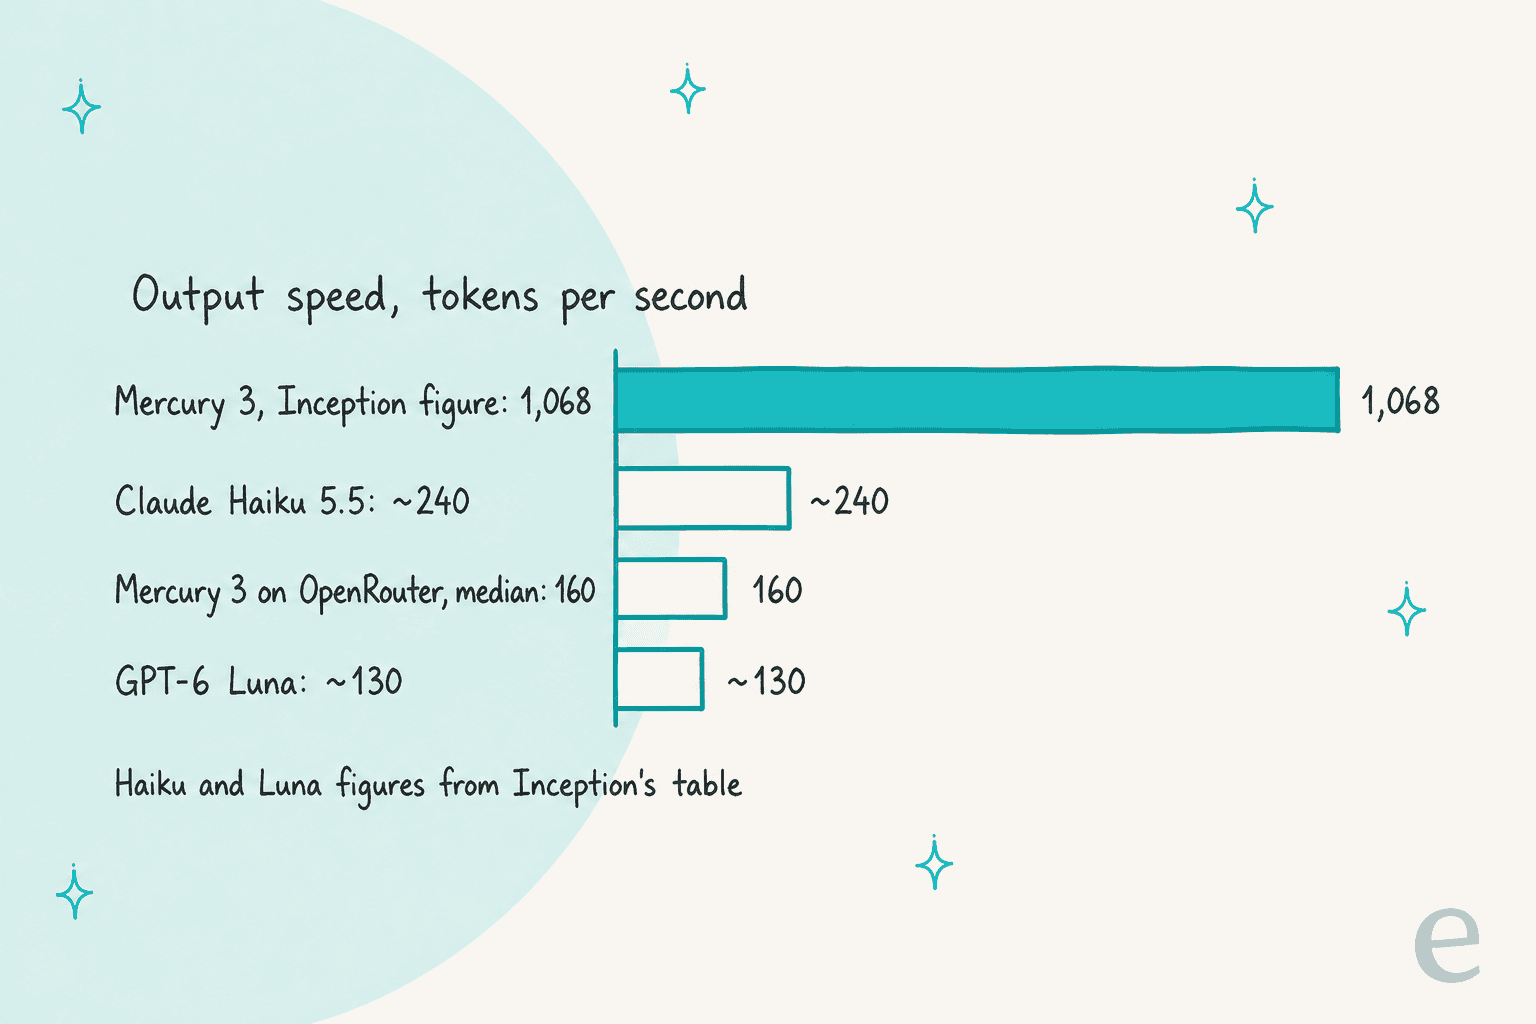
なぜ差が出るのでしょうか。OpenRouterのスループットは、実際のトラフィックで、呼び出し側が選ぶ推論強度のまま、サーバーにかかっている負荷のもとで測られます。拡散の速度面の強みは同時接続数が低いときに最大になります。これは、あるコメント投稿者がGoogleの実験的な拡散モデルについて述べたトレードオフです。
"It doesn't benefit from batching to reduce memory bandwidth in the same way that a "standard" autoregressive model does, which ends up meaning that it's great at reducing latency for individual/low-concurrency users and delivers better outcomes on certain tasks but much more expensive per token at scale."
Kuleshovは、Mercuryはバッチサイズに対してうまくスケールしたと述べ、Inceptionの価格設定は大量に提供できることを示唆しています。しかし、いつものペリカンのテストを実行したSimon Willisonは、速度を「a bit disappointing」と感じ、OpenRouterではなくInceptionのAPIを直接呼んでも"didn't seem to speed it up."と述べています。
実際の速度はそれでも重要でしょうか。それは、連続するモデル呼び出しの数によります。メッセージごとに1回しか呼ばないチャットボットは、1,068と160の違いにほとんど気づきません。12回の呼び出しを順番に行うエージェントは、その1回1回を体感します。下の計算ツールに自分のタスクを入れて、速度差がどこで重要でなくなるかを確かめてください。
ステップ数とステップあたりのトークン数を変えて、Inceptionの速度とOpenRouterの実測中央値で、Mercury 3がタスクごとにどれだけモデルの待ち時間を減らすかを確認できます。
デフォルト値(600トークンの呼び出し12回)では、Mercury 3の生成はInceptionの速度で6.7秒、OpenRouterの中央値で45秒で終わり、Lunaは55秒です。遅いほうの数字でも、長いチェーンでは時間を節約できます。呼び出しが1回なら差は1秒未満に縮むため、Mercury 3は単発の返信ではなくループ向けの選択肢です。
Mercury 3の料金を一目で
Inceptionは、自社APIでもOpenRouterでも同じ料金表を1つだけ公開しています。モデルページにはファミリー全体が載っています。
| モデル | 入力(定価 → ローンチ) | キャッシュ入力 | 出力(定価 → ローンチ) | コンテキスト | 向いている用途 |
|---|---|---|---|---|---|
| Mercury 3 | $0.20 → $0.10 | $0.02 → $0.01 | $0.70 → $0.35 | 1M | 汎用の推論、エージェント |
| Mercury Voice | $0.40 → $0.20 | $0.04 → $0.02 | $1.50 → $0.75 | 128K | 音声エージェント、TTFT 170ms未満 |
| Mercury Decide | $0.04 → $0.02 | $0 | $0(課金なし) | 該当なし | 分類、スコアリング |
| Mercury Edit 2 | $0.25 | $0.025 | $0.75 | 32K | コード補完、次の編集 |
価格はすべて100万トークンあたりです。アクセスは3つのプランがあります。Free(1億トークン、全モデル)、Developer(従量課金)、Enterprise(個別のレート制限、SLA、ボリューム価格)です。ローンチ割引がいつ終わるのか、Inceptionは明らかにしていません。
追いかけている相手のモデルとの比較を、各ベンダー自身の料金表で示します。
| モデル | 入力(1Mあたり) | 出力(1Mあたり) | 備考 |
|---|---|---|---|
| Mercury 3(ローンチ) | $0.10 | $0.35 | 当面50%オフ |
| Mercury 3(定価) | $0.20 | $0.70 | 割引終了後 |
| GPT-6 Luna | $0.10 | $0.50 | OpenAIの標準API |
| Claude Haiku 5.5 | $0.10 | $0.50 | プロンプト100Kトークンまで。超えると5倍 |
| DeepSeek V4.1 Flash | $0.15 | $0.60 | オフピーク、キャッシュミス。ピーク時は2倍 |
つまりローンチ時点では、Mercury 3はこのグループで最も安い出力トークンです。定価では出力が最も高くなります。Hacker Newsのコメント投稿者は、懸念をはっきり述べました。"I'm wondering if it'll still be useful once the discount is lifted?" 私の見方はこうです。速度のために買うなら、$0.70でもまだ安い。安いから買うなら、定価で予算を組んでください。OpenAI側の詳細はGPT-6 Lunaの料金ガイドで、DeepSeekのピーク時間のルールはV4.1 Flashの料金の記事で解説しています。
知っておきたい料金の詳細がもう1つあります。Mercury 2とMercury 2.5は新規ユーザーには閉鎖されました。既存顧客は2026年11月15日までアクセスできるので、どちらかを使っているなら今から切り替えを計画してください。
Mercury 3へのアクセス方法
ローンチ記事によると、入り口は4つあります。
- Inception API Platform。 platform.inceptionlabs.aiで登録し、キーを作成すると、1億トークンが無料で付きます。
- OpenRouter。 同じ価格でInceptionにルーティングされ、すでにOpenRouterで課金しているなら便利です。
- Baseten。 Basetenのモデルライブラリに掲載されていますが、アクセスにはBasetenへの問い合わせが必要です。プラットフォームはBasetenレビューで扱っています。
- Vercel。 InceptionはVercelもローンチパートナーとして挙げています。
APIはOpenAI互換なので、切り替えはほぼベースURLとモデル名だけです。Inceptionのドキュメントにある呼び出しは次のとおりです。
curl https://api.inceptionlabs.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $INCEPTION_API_KEY" \
  -d '{
    "model": "mercury-3",
    "messages": [{"role": "user", "content": "What is a diffusion model?"}],
    "reasoning_effort": "medium",
    "max_completion_tokens": 8192
  }'
Inceptionの連携ドキュメントは、コーディングツール(Cursor、Kilo Code、OpenCode)、LangChainのようなフレームワーク、ElevenLabsやVapiのような音声プラットフォームを扱っています。
コーディングについては、Kuleshov自身のアドバイスは、主役ではなく補助として使うことです。高速なモデルはClaude Codeのサブエージェントや副次的なタスクに向いており、メインの作業はより大きなモデルが担います。
初期ユーザーの声
Hacker Newsのローンチスレッドには、初日に85件のコメントが付きました。感心しつつも、速度の主張には懐疑的な空気でした。
好意的な意見は、実際の作業で試した人たちから出ました。
"If their benchmarks are to be believed they've made some real progress. [...] EDIT: just trying this out on a repo and it's actually pretty good so far. Pleasantly surprised."
最も多かった不満は最初のトークンまでの待ち時間で、毎秒トークン数では捉えられません。
"Hmm at least in Openrouter, deepseek v4.1 flash via together/baseten/fireworks still beat mercury 3 on latency and intelligence Ttft is quite slow with mercury"
別のテスターも同じ現象を見ましたが、価格は気に入っていました。"the issue with speed seems to be that ttft is still high,"と書き、試したいくつかのタスクでは"was as cheap as deepseek for a few tasks I tried."と付け加えています。また、あるコメント投稿者は採算について疑問を投げかけました。"Pricing can always be set at a loss, however, particularly for a private company." 妥当な問いですが、公開された答えはまだありません。
Mercury 3の弱点
- 独立したベンチマークがまだありません。 すべてのスコアはInceptionのもので、中程度の推論強度のみです。
- 実際の速度は見出しより低いです。 OpenRouterの中央値はローンチ週に毎秒160~254トークンで、テスターは最初のトークンが遅いと報告しています。
- テキストのみです。 画像や音声の入力はありません。Inceptionは社内にマルチモーダルのプロトタイプがあり、メールで初期テスターを受け付けているとしています。
- 重みは非公開、サイズも不明です。 セルフホストも内部の確認もできません。
- 2つのテストでHaiku 5.5に負けています。 長文脈の想起(MRCR v2)とDeepSWEのコーディングです。その領域で信頼する前に、長い文書でテストしてください。
- 価格はキャンペーンです。 定価の出力は$0.70でローンチ価格の2倍、終了日は発表されていません。
- 構造化出力は完璧ではありません。 OpenRouterは自社トラフィックで2.78%の構造化出力エラー率を示しているため、パイプラインにスキーマ検証を残してください。
Mercury 3はカスタマーサポートに向いている?
サポートはInceptionがローンチ時に挙げた4つの本番用途の1つで、サポート業務に最も関係する大きなベンチマーク差は、銀行の顧客に対応するエージェントをシミュレーションするτ³-bench Bankingです。Mercury 3が30.24、Lunaが23.00、Haiku 5.5が13.06です。サポートAIベンダーのLorikeetは、初期テストで"Mercury 3 beat other models on latency while also performing higher on evals and in production."とInceptionに伝えました。サポートベンダーを比較しているなら、その市場はLorikeetの代替の記事で扱っています。
速度が最も重要なのはライブチャネルです。Webチャットや音声エージェントでは、顧客は入力中のドットを見つめるか、無音を聞いています。メールのチケットでは、数秒は何も変えません。最初のトークンまで170ミリ秒未満のMercury Voiceが狙うのはそこで、おすすめのAI音声エージェントのまとめにあるツールと並べて検討する価値があります。
しかし、速い間違いは間違いのままです。eeselが実際のキューでAIを運用して学んだのは、自社の過去チケットをどう処理するかを見届けるまで、ライブのキューではどんなモデルも信頼できないということです。銀行ベンチマークの30という点数は、それらのタスクの大半に失敗したことも意味するため、モデルの周りにはガードレール、エスカレーション、テストが必要です。そのガードレールはAIのハルシネーション防止ガイドで、AIによるチケット分類は、このような安価で高速なモデルのリスクの低い最初の仕事として扱っています。
Mercury 3は誰が使うべき?
私ならこう判断します。
- 長い呼び出しチェーンを持つエージェント開発者。 ブラウザエージェント、検索エージェント、コーディングのサブエージェント。速度が積み重なり、Inceptionのパートナー事例が最も強い領域です。最初に試してください。
- 音声とリアルタイムチャットのチーム。 最初のトークンのレイテンシならMercury Voiceを見て、その背後の推論ステップにはMercury 3を試してください。音声スタックを丸ごと求めるならRetell AIと比較してください。
- 大量で低リスクの呼び出しにLunaやHaikuの料金を払っているチーム。 ローンチ価格なら、出力は安く、速くなります。確約する前に、定価で計算し直してください。
- ビジョン、重み、長い文書の想起が必要な人。 待つか、別のモデルを選んでください。Gemini 3.8 Flashは画像を扱え、DeepSeek V4.1 Flashは重みが公開されています。
- ボトルネックがモデルではないチーム。 1回の返信がどちらにせよ1秒なら、速度で数字は動きません。先にAIエージェントAPIの構成や検索を見直してください。
まだ全体像を整理している段階なら、おすすめのAIエージェントのまとめと、サポートチケットに最適なモデルのガイドが次の読み物としておすすめです。
eeselを試す
Mercury 3はインフラです。高速なモデルとAPIとトークン単位の請求書です。これをサポートキューに載せるには、ヘルプデスク連携、ヘルプセンターの検索、エスカレーションルール、テストの仕組みをこれから作る必要があります。eeselは従業員です。そのAIヘルプデスクのチームメイトは、すでに運用しているキューに加わり、過去のチケットとドキュメントから学び、顧客に1件も回答する前に、過去の会話で再生して確認できます。
SamCartは、速度とチャネルが交わる好例です。Freshdeskのチケット用に1つ、Webサイトのチャットバブル用に別の1つのeeselエージェントを運用し、それぞれ独自の挨拶とトーンを持ち、どちらも約280件のヘルプセンター記事から回答します。チケット用エージェントは、チームメンバーがチケットを引き継ぐまでだけ返信し、販売者が人間を求めた時点で役目を終えます。
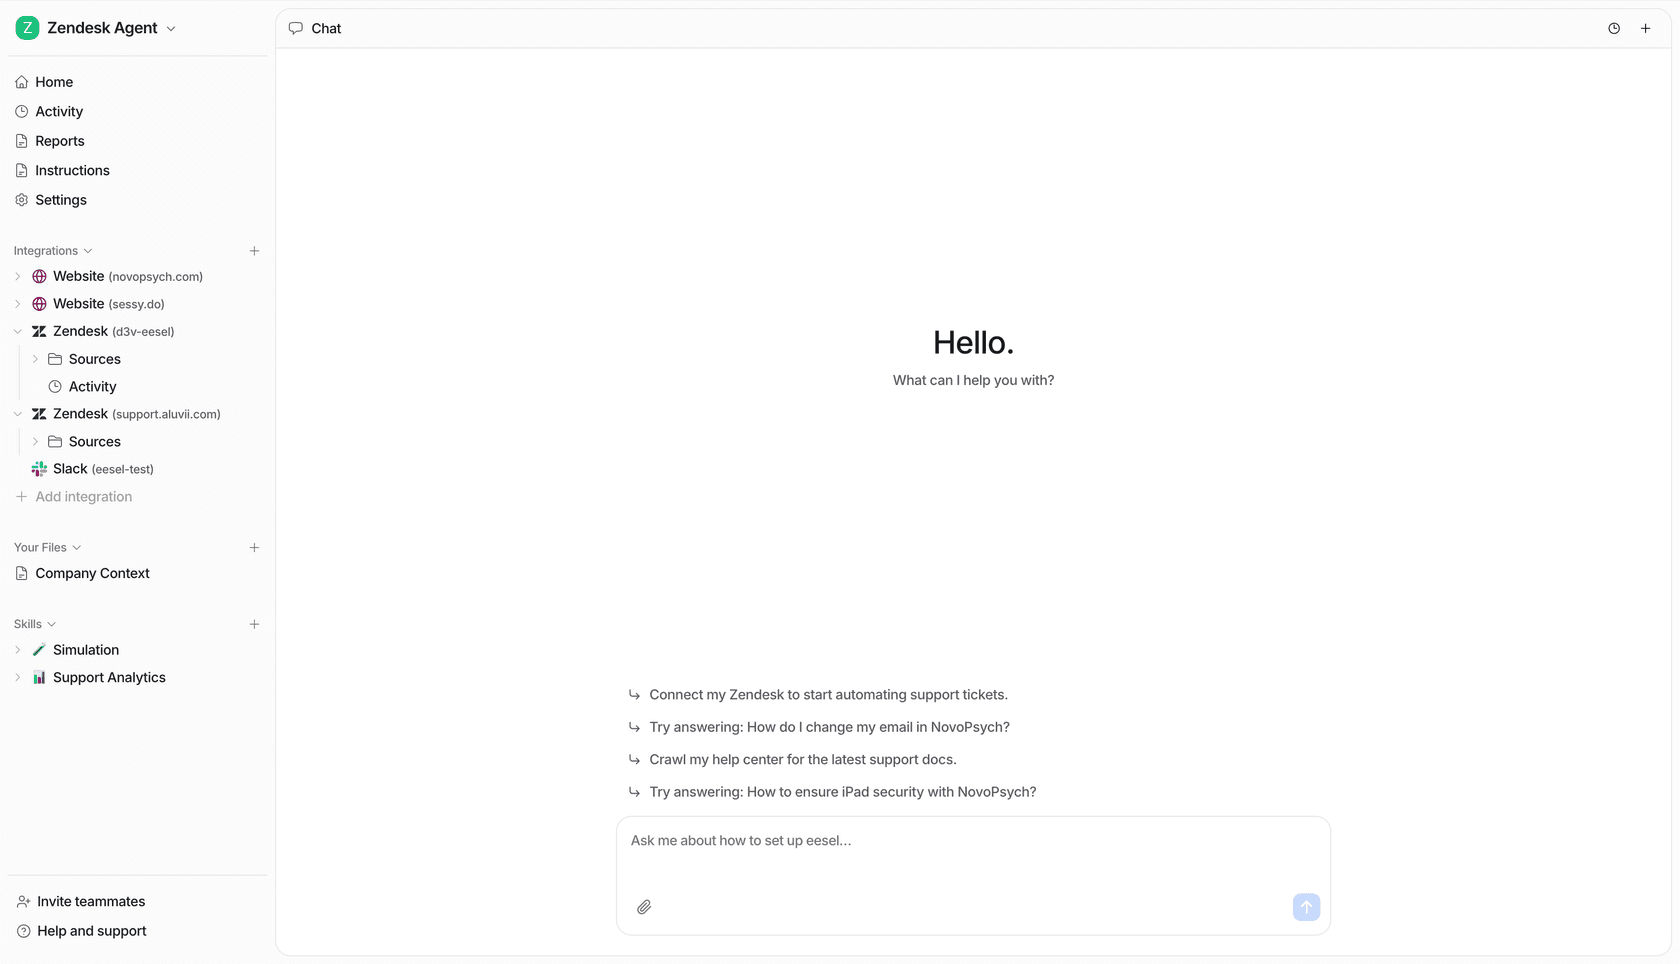
新しいモデルをターミナルから試すタイプの方には、eesel CLIが同じチームメイトを操作します。eesel init chat-bubble --site https://your-site.comでページを読み込むWebチャットエージェントを設定し、eesel instructionsでその常設ルールを編集し、eesel approvalsで人の承認待ちのアクションを一覧できます。すべてのコマンドはJSONを出力するので、Claude Codeのようなコーディングエージェントがセットアップを代行できます。詳しくはAIエージェントCLIのガイドをご覧ください。
プランは月額$299から500クレジットで、チケットまたはチャット1件が1クレジットです。無料トライアルではカード不要で100クレジットが付きます。先月のチケットでeeselを試すか、先に料金ページをご確認ください。チケットに回答する代わりにコンテンツを書くなら、ラインナップにはAIブログライターもあります。