

私の評価:5点満点で3.7。 Mercury 3は、拡散言語モデルが速いだけでなく賢くもなり得ることを示す、これまでで最良の例です。Inception自身の表では、12のベンチマークのうち10でGPT-6 LunaとClaude Haiku 5.5を上回り、OpenRouterのライブトラフィックでは中央値で毎秒221トークンを出しています。どちらのライバルより速いものの、Inceptionが公称する1,068の5分の1です。
スコアを押し下げている点:実リクエストの遅い側10%は毎秒79トークン以下に落ち込みます。ベンチマークはすべて中程度の強度で実行されたのに、APIのデフォルトはlowです。独立したリーダーボードはまだなく、テキストのみで温度の下限は0.5です。ローンチ時の価格は100万トークンあたり入力$0.10、出力$0.35で、予算は定価の$0.20 / $0.70で組んでください。
**向いている人:**モデル呼び出しの連鎖が長いエージェント開発者、検索・ブラウザエージェント、コーディングのサブエージェント。**待つべき人:**画像、オープンウェイト、決定的な出力、長文ドキュメントでの実証済みの想起が必要な人。サポートチームにとっては強力なエンジンですが、あくまでエンジンです。eeselのAIヘルプデスクのチームメイトは、モデルを回答済みのチケットに変える従業員です。Lesson Proでは、月に約1,900件のZendeskチケットにメモと下書きを残しています。
Mercury 3をどうレビューしたか
私はeeselで機能とAIエージェントを作っているので、モデルのローンチをベンチマーク表とは違う目で読みます。気にするのは継ぎ目です。APIがデフォルトで何をするか、出力がどうストリーミングされるか、遅いリクエストで何が起きるか、モデルが弱点になったときエージェントがどこで壊れるか。eeselは何年も実際のサポートキューでAIを動かしてきましたが、定着した習慣は1つです。実際の過去のチケットで再現してからでなければ、どのモデルも顧客に近づけないということ。ラボの数字は、それが機能するかどうかを教えてくれたことがありません。
そこでこのレビューは4つの材料で組み立てています。Inception自身のローンチ記事とAPIドキュメント。実トラフィックのパーセンタイルを公開するOpenRouterのパフォーマンスページ。数時間のうちに自分の仕事で試した人たちがいるHacker Newsのローンチスレッド。そして、拡散の過程を画面に表示するInception自身のチャットアプリです。
まずローンチの基本(仕様、ベンチマーク表の全体、アクセス方法)を知りたい場合は、私のMercury 3の概要から始めてください。コストだけが気になるなら、RamaのMercury 3の料金の解説がタスクごとに計算しています。この記事は結論編です。
Mercury 3のスコアカード
採点とその理由は次のとおりです。
| カテゴリ | スコア | 理由 |
|---|---|---|
| 実際の速度 | 4.0 / 5 | OpenRouterの中央値221 tok/sはLunaとHaikuを上回るが、テールが遅い |
| クラス内での品質 | 4.0 / 5 | ベンダーのベンチマーク12のうち10で上回り、日常ではLunaやHaikuと同等 |
| 価格 | 3.5 / 5 | ローンチ時はクラス最安の出力、定価では最も高い |
| 信頼性 | 3.5 / 5 | OpenRouterでツール呼び出しエラー0.58%、構造化出力エラー2.51% |
| 成熟度とオープン性 | 3.5 / 5 | 独立したベンチマークなし、テキストのみ、重みは非公開、サイズ非公表 |
| 総合 | 3.7 / 5 | 拡散LLMにとって確かな前進、高速な補助モデルとして最適 |
次の2つが起これば、スコアはすぐ上がるでしょう。Artificial Analysisのような独立したリーダーボードがベンチマーク表を裏付けること、そしてInceptionが容量を増やすにつれてOpenRouterの遅いテールが縮まること。ローンチ当日はどちらも満たされていません。
拡散が実際に何を変えるか
GPT-6.1 SolからDeepSeek V4.1 Flashまで、皆さんが使ってきたほぼすべてのモデルは、左から右へ1トークンずつ書きます。Mercury 3は回答全体をノイズの多いテキストとして下書きし、数回のパスで磨き上げます。理論は私の拡散モデルの解説で扱っています。レビューで重要なのは、それがコードとユーザーに何をもたらすかです。
テキストはトークンではなくブロックで届く
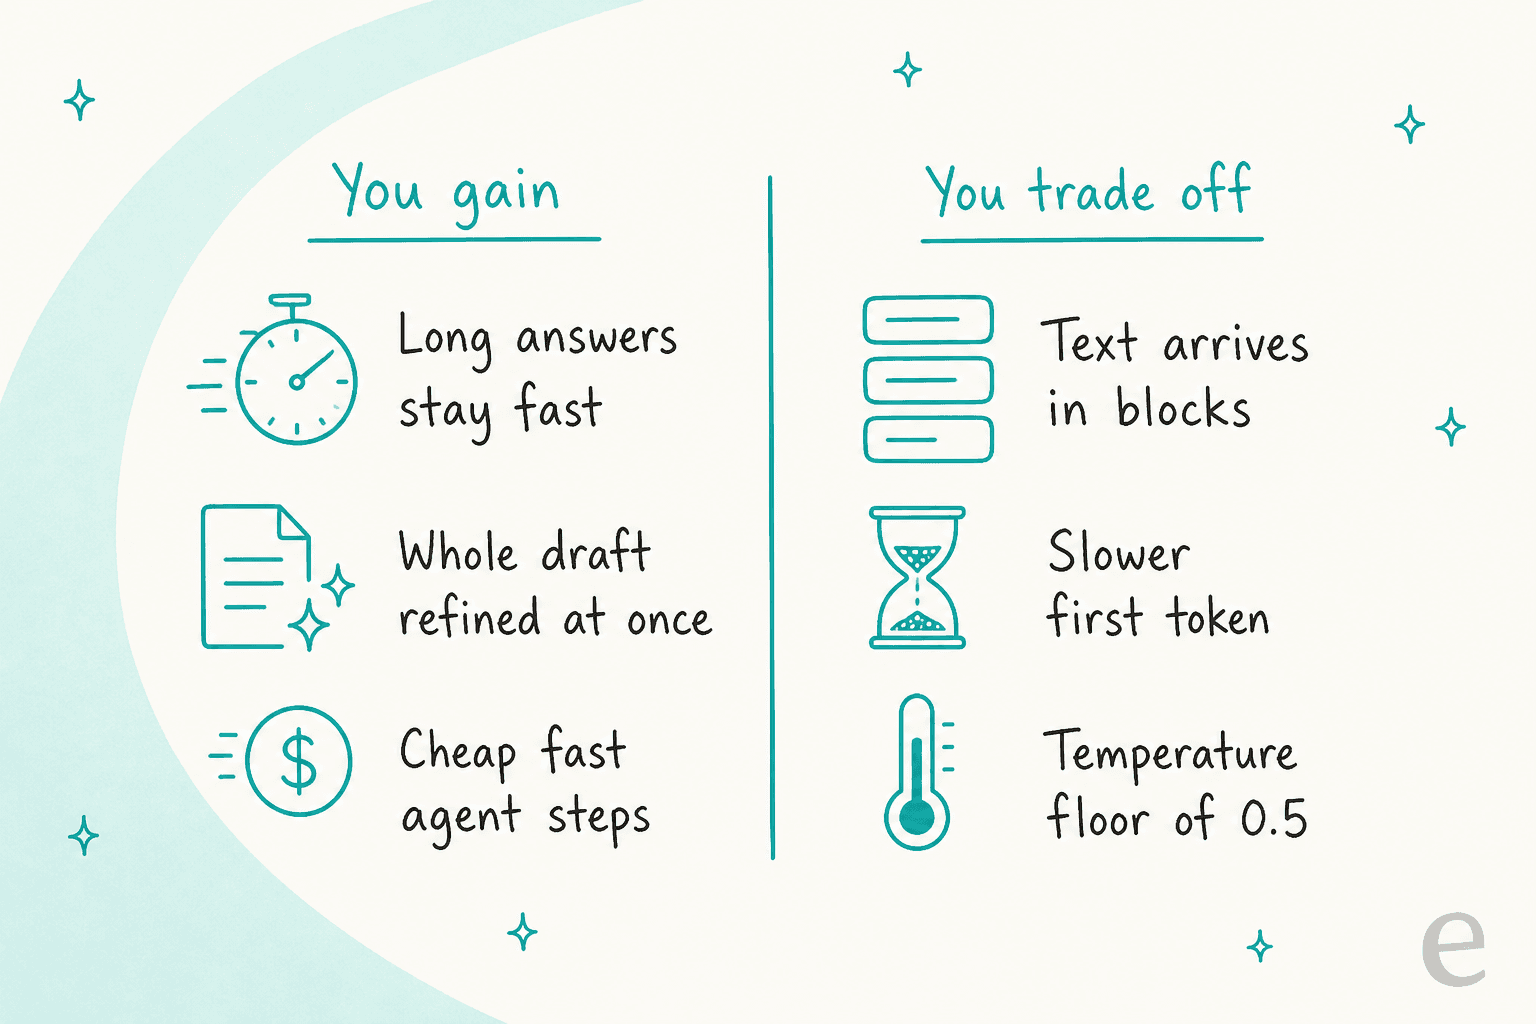
Inceptionのストリーミングのドキュメントには、レスポンスは"block-by-block"でストリーミングされるとあります。ブロックとは単一のトークンではなく、磨かれたテキストの塊です。チャットウィンドウでは、おなじみの1語ずつ流れる表示とは違って見えます。何も出ず、次に1文、その次の1文という具合です。さらに任意のdiffusingモードがあり、各塊がそこまでの回答全体になるため、UIは追記ではなく毎ステップでテキストを上書きする必要があります。デモとしては楽しいですが、フロントエンドが追記を前提にしているとバグになりやすい点です。
Hacker Newsのテスターが最初のトークンまでの時間にたびたび触れていた理由も、おそらくこれだと私は見ています。ある人はローンチスレッドで"Ttft is quite slow with mercury"と書き、別のテスターは"the issue with speed seems to be that ttft is still high."と述べました。毎秒トークン数は回答がどれだけ速く終わるかを示すもので、ユーザーが何かを目にするまでの早さではありません。
長い回答でも時間はほとんど増えない
利点はその裏返しです。トークンごとのモデルは、2倍書くのに2倍の時間がかかります。拡散モデルはブロック全体を並列で磨くため、回答と推論が長くなるほど差が開きます。Inceptionの共同創業者Volodymyr Kuleshovはローンチ当日にその点を述べました。推論モデルが1回の回答で長く考えるほど、速度の優位は大きくなります。だからこのモデルは、1行の返信より多段階のエージェントに向いています。
デフォルトはベンチマークされたモデルではない
試すチームすべてに伝えたい点です。Inceptionのローンチ表のスコアはすべて、中程度の推論強度で実行されています。しかし推論強度のドキュメントによると、reasoning_effortを省略するとmercury-3のデフォルトはlowです。Mercury 2と2.5のデフォルトはmediumでした。
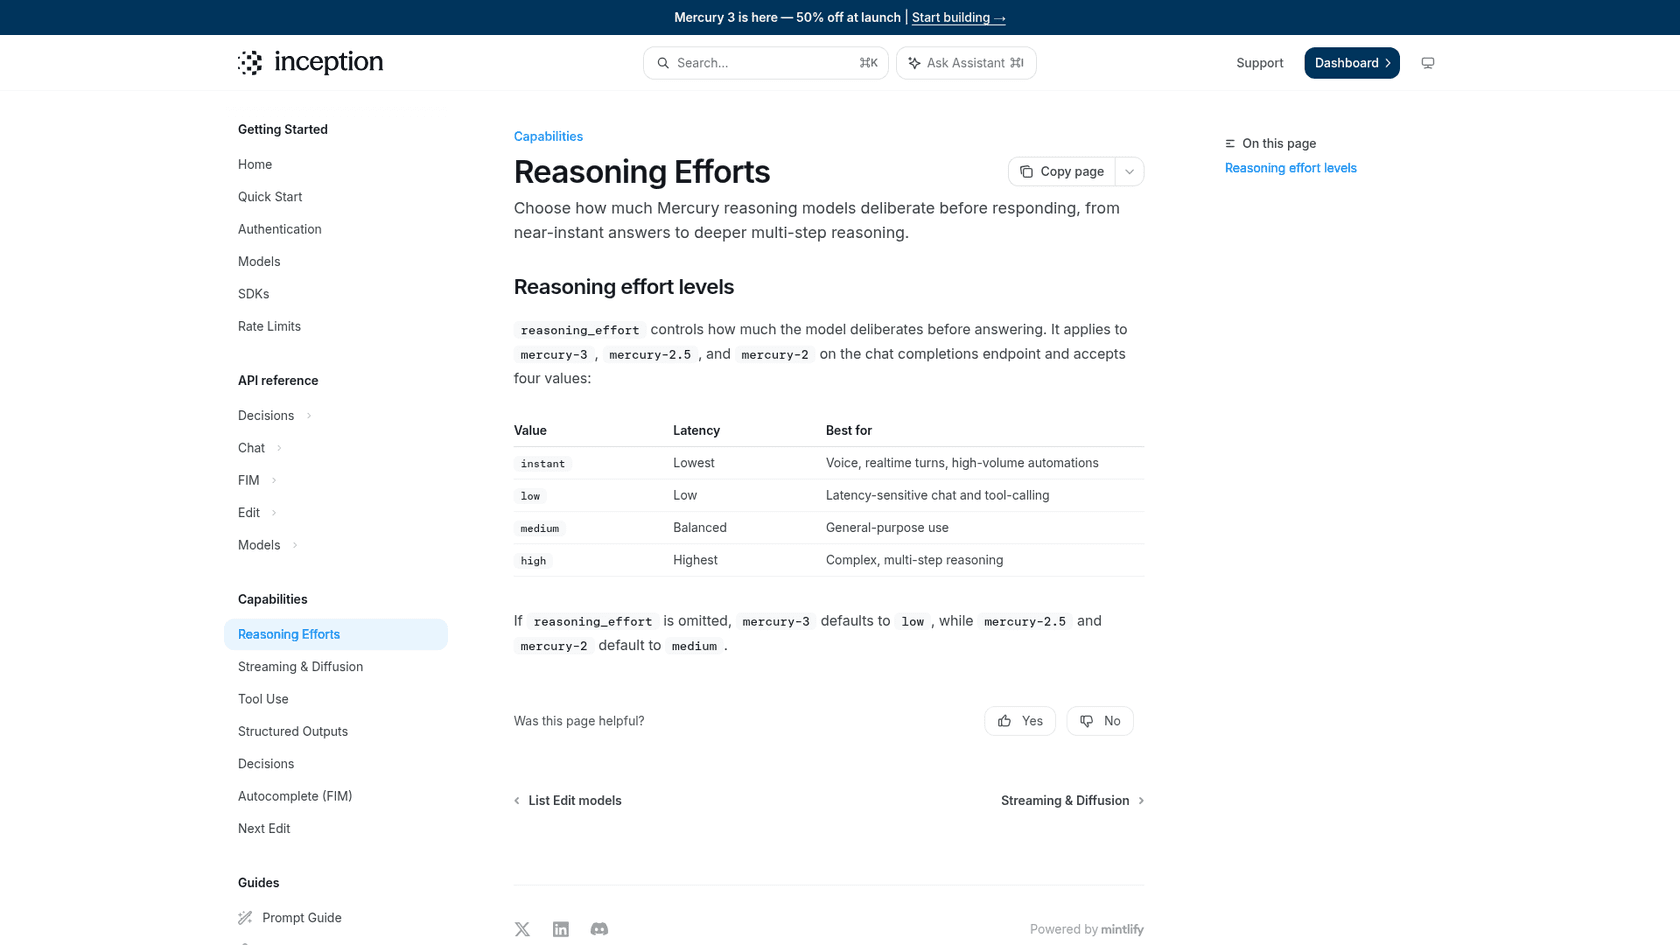
つまり強度を指定しない簡単なテストは、表より速くて軽い設定を試していることになります。速度重視のデフォルトとしては妥当ですが、品質を比較する前にmediumを明示的に設定してください。またhighが良いとも思い込まないでください。あるテスターはSimon Willisonのペリカンの絵で"the medium pelican is better than the high"と指摘しました。これは1枚の落書きでありベンチマークではありませんが、各レベルを自分のタスクで試す十分な理由になります。
温度は0.5から
Inceptionのモデルのドキュメントでは、Mercury 3の温度は0.5から1.0まで調整可能とされています。再現性のある出力のために温度を0にしているパイプライン(分類、抽出、テスト用フィクスチャ)では、ここではそれができません。代わりに構造化出力とスキーマチェックを組み合わせてください。純粋なラベル付けには、Inceptionの別モデルMercury Decideが分類用に作られています。
公称速度と実測速度
Inceptionの数字は、NVIDIA GPUで毎秒1,068出力トークンです。概要記事では中央値の差を扱いました。このレビューで知りたかったのはばらつきです。エージェントの総待ち時間を決めるのは平均的な呼び出しではなく、遅い呼び出しだからです。
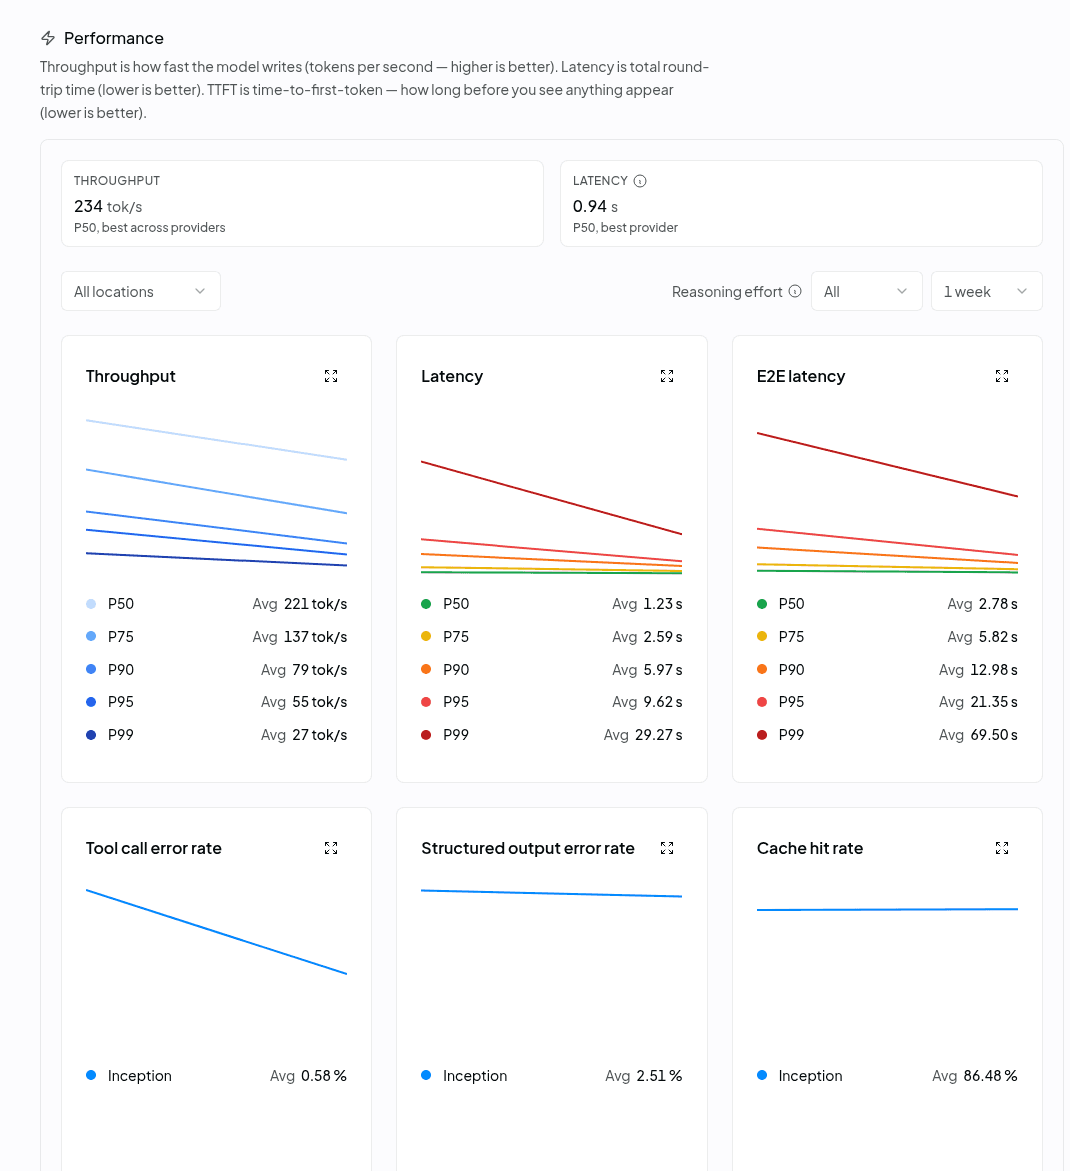
OpenRouterはMercury 3のリクエストをすべてInceptionに振り分け、パーセンタイルを公開しています。2026年10月20日にパフォーマンスページが示していた、1週間平均は次のとおりです。
| パーセンタイル | スループット | レイテンシ | エンドツーエンド |
|---|---|---|---|
| P50 | 221 tok/s | 1.23 s | 2.78 s |
| P75 | 137 tok/s | 2.59 s | 5.82 s |
| P90 | 79 tok/s | 5.97 s | 12.98 s |
| P95 | 55 tok/s | 9.62 s | 21.35 s |
| P99 | 27 tok/s | 29.27 s | 69.50 s |
中央値は良好です。Inception自身の表ではGPT-6 Lunaが毎秒約130トークン、Haiku 5.5が約240トークンなので、実トラフィックでのMercury 3はHaikuとほぼ同等で、Lunaを大きく上回ります。問題はテールです。10リクエストに1つは毎秒79トークン以下で、100に1つはエンドツーエンドで1分を超えます。
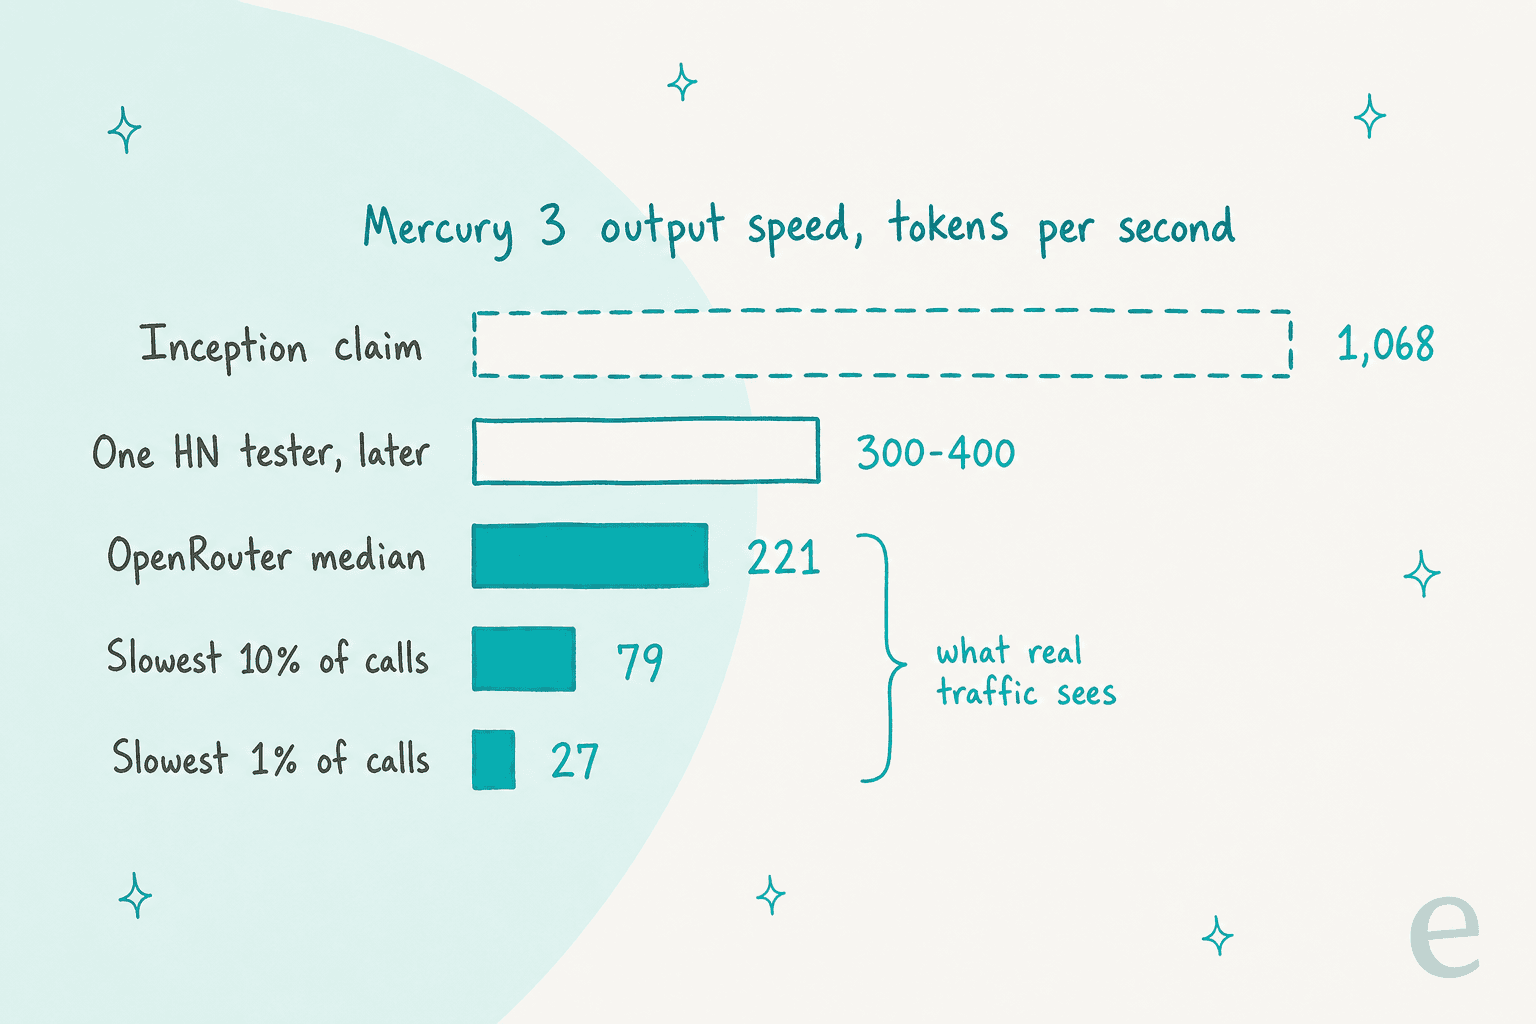
公平を期すため、2つの注意点があります。OpenRouterは利用者が選ぶすべての推論強度を混ぜており、ローンチ週のトラフィックは波があります。一部のユーザーでは、初日の終わりまでにすでに速度が改善していました。
"I've been trialing this for the last few hours. It was quite slow at first, but now I'm getting around 300-400tps. Still nowhere near 1000tps, but it's still incredibly fast compared to what I'm used to with other models."

一方Simon Willisonは、速度を「やや期待外れ」("a bit disappointing")と受け止め、OpenRouter経由ではなくInceptionのAPIを直接呼んでも改善は見られなかったと述べています。私の見立ては、中央値は本物で今日から役に立ち、1,068という数字はInception自身のハードウェアでのベストケースで、今後1か月で注目すべきはテールだ、というものです。純粋な速度の選択肢を比べているなら、モデルではなくハードウェアの道筋を扱った私のGroq 3 LPXの記事を参照してください。
ベンチマークの現実チェック
ローンチ表は強力です。Mercury 3は12テスト中10でLunaとHaiku 5.5のそれぞれを上回り、最大の差はエージェント系の作業にあります。SWE-Bench Atlasは51.08対Lunaの33.33、τ³-bench Bankingは30.24対23.00と13.06です。表の全体は私のMercury 3の概要にあるので、ここではそれがどれだけの重みに耐えるかに絞ります。
- **Inception自身の実行結果である。**Mercury 3のArtificial Analysisページはまだなく、KuleshovはHacker Newsで、第三者によるベンチマークとタスク完了時間はこれからだと述べました。
- **推論強度は1つだけ。**12行すべてがmediumです。あるコメント投稿者は、lowからmaxまでの曲線がないことを挙げて理由を尋ねました。強度を上げたときにLunaやHaikuが差を縮めるかは分かりません。
- **負けは僅差、勝ちには大差のものもある。**AA-Omniscience(46.44対46.94)とAA-LCR(77.67対78.30)ではLunaにわずかに及ばず、MRCR v2(75.50対78.40)とDeepSWE(46.31対51.62)ではHaiku 5.5に及びません。長文ドキュメントの想起は、私が最も厳しく試す領域です。
- **ベンダー自身の評価は控えめ。**Kuleshovは日常ではHaikuやLunaと同等と説明しており、それが正直な捉え方だと思います。
"That means that it won't yet replace Opus or Fable as the primary driver of a harness, but we have used it successfully for subagents"
実際に使った報告もこれに沿っています。ある開発者は、これで小さなmacOSアプリを最初から最後まで作りました。
"I made it come up with a plan for this tool and had it implement the thing end to end in about 8 or 9 steps. It originally messed up the coordinate calculation but quickly corrected that when I pointed it out and other than that it one-shotted all the other steps."
同じテスターによると、この作業では2,600万トークンを使い、うち130万トークンがキャッシュなしで、速度は毎秒約160トークンでした。実運用の姿として参考になります。コーディングハーネスは大量のコンテキストを再送するため、キャッシュ価格は表示料金と同じくらい重要です。別のテスターは3ターンでUMLレンダラーを作り直し、HTMLが正しく更新されたと述べています。
強みと限界
重みづけの順に、バランスの取れた見方を示します。
強い点:
- **エージェントのループ。**1つのタスクがモデル呼び出しを十数回連続で行うとき、速度は積み上がります。InceptionのローンチパートナーであるTinyFishは、Mind2Webの50のライブWebタスクの半分を完了し、"significantly more than GPT-6.1-Sol."だったと述べています。
- **補助・サブエージェントの仕事。**コンテキスト圧縮、ルーティング、ツール出力の要約。旧Mercury 2では、Augment Codeが従来のモデルと比べて圧縮のレイテンシが82%、コストが90%減ったと報告しました。これはMercury 2の話ですが、Mercury 3は同じ売り込みをより大きなモデルで行っています。
- **長いコンテキストが均一価格。**100万トークンのウィンドウが単一料金で、Haiku 5.5は10万トークンを超えると5倍で課金します。詳細は私のHaiku 5.5の料金ガイドにあります。
- **試しやすい。**OpenAI互換で、新しいキーには1億トークンの無料枠があり、Cursor、LangChain、Vapi向けのセットアップガイドもあります。
限界:
- **遅いテール。**OpenRouterの1週間ビューでP90スループットは79 tok/s、P99のエンドツーエンドは69.5秒。
- **構造化出力は完璧ではない。**OpenRouterでは構造化出力のエラー率が2.51%なので、バリデーターを組み込んでおいてください。
- **テキストのみ、重みは非公開、サイズ非公表。**Inceptionはマルチモーダルは社内プロトタイプ段階だと述べています。オープンな拡散モデルの重みなら、代替はDiffusionGemmaです。
- **プロモ後の価格。**100万出力トークンあたり$0.70で、定価はLunaとHaikuの$0.50を上回り、Inceptionは50%割引の終了日を発表していません。
- **可用性はまだ落ち着いていない。**OpenRouterの3日間の可用性は99.26%で、ローンチ当日には目に見える落ち込みがありました。
Mercury 3はあなたのワークロードに合うか
「切り替えるべきか」の判断は、ほとんど3つの質問に集約されます。連続する呼び出しがいくつあるか、人が待っているか、Mercury 3にないものが必要か。下のセレクターで順に確認できます。
3つの質問に答えて、Mercury 3がワークロードに合うか、切り替える前に何を試すべきかを確認できます。
パターンは単純です。連続する呼び出しが多く、人が待つほど、Mercury 3の価値は高まります。バックグラウンドの単発呼び出しなら速度は何も変えず、定価ならLunaやHaikuのほうが安い選択です。その計算の向こう側は、私のGPT-6 Lunaの料金の解説にあります。
Mercury 3はサポート業務にどう合うか
サポートはInceptionが挙げる4つの本番用途の1つで、ローンチではサポートAIベンダーのLorikeetが、Mercury 3は"beat other models on latency while also performing higher on evals and in production."と述べたと引用されています。サポートに最も近いベンチマークであるτ³-bench Bankingは、Mercury 3のリードが最も大きい項目でもあります。
ただし、このスコアは慎重に読んでください。30.24というのは、シミュレーションされた銀行業務のタスクの大半に失敗したという意味です。ライバルより失敗が少ないだけです。小さくて速いモデルでは普通のことで、モデルが決してサポートエージェントの全体にならない理由でもあります。速度が最も効くのは、顧客が画面を見ているAIライブチャットや音声エージェントのようなライブチャネルです。メールのチケットでは、2秒の差は何も変えません。
サポートで高速な補助モデルが最も役立つのは、各返信の周りにある細かな仕事の山です。チケットのトリアージ、タグ付け、長いスレッドの要約、注文詳細の取得などです。これはInceptionがコーディングで説明しているのと同じサブエージェントのパターンで、実際のサポート運用の中身そのものでもあります。
GOSKATEなどのプライベートレッスンブランドを運営するLesson Proが好例です。eeselのエージェントは2つのZendeskアカウントにまたがって動きます。各チケットでまず顧客がどのブランドに属するかを判断し、内部メモを残して、そのブランド名で署名した返信を下書きします。求人応募、留守番電話、注文フォームは意図的にスキップします。2026年8月8日から9月8日の間に、約1,900件のチケットを処理し、約1,700件のメモを残し、チームが送信する約560件の返信を下書きしました。チームメイトが"@eesel find instructors near this lesson"と書くと、近隣の町の過去のチケットから、そこで教えたことのあるインストラクターを探します。
これらはどれも、背後のモデルが毎秒221トークンか1,068トークンかには左右されません。ブランドのルール、スキップリスト、まず人に渡る下書き、そしてテストにかかっています。私が何度も立ち返る違いはこれです。Mercury 3はインフラであり、eeselは従業員です。モデル層を自分で選ぶなら、ガードレールは私のサポートチケット向けベストモデルとAIのハルシネーション防止のガイドが扱っており、多くのチームが飛ばす手順はAIエージェントのテストが扱っています。
Mercury 3を使うべき人、待つべき人
今すぐ使うべき人:
- 呼び出しの連鎖が長いエージェントを作る人:ブラウザエージェント、検索エージェント、リサーチのループ。ここで速度が積み上がります。
- コーディングハーネスを動かし、高速な補助役が欲しい人。Kuleshov自身の助言はリードモデルではなくサブエージェントで、大きなモデルが計画するClaude CodeやCursorの構成に合います。
- 大量で重要度の低い呼び出しにLunaやHaikuを使っていて、後で定価になっても許容できる人。入れ替える前にmedium強度でテストしてください。
待つか別のものを選ぶべき人:
- 画像入力、オープンウェイト、温度0が必要な人。Gemini 3.8 Flashは画像に対応し、小規模言語モデルならセルフホストも可能です。
- 長いドキュメント全体での正確な想起に頼る人。まず自分で評価してください。
- リクエストごとにモデル呼び出しが1回で、誰も待っていない人。速度は数字を変えないので、品質と価格で選んでください。
- 保証されたレイテンシが必要な人。P90とP99が縮まるまでは、フォールバックモデルかタイムアウトを併用してください。
まだ選択肢を整理している段階なら、私のベストAIエージェントのまとめとClaude Haiku 5.5レビューが次に読む記事として自然です。
eeselを試す
高速なモデルが与えてくれるのは、速いトークンです。Zendeskとの接続も、ブランドのルールも、スキップすべきチケットのリストも、公開前に先月の会話を再現する手段も与えてくれません。eeselのAIヘルプデスクのチームメイトはそれらを備えています。既存のZendeskやその他のヘルプデスクに参加し、ヘルプセンター、マクロ、過去のチケットを読み込み、内部メモでの@eesel メンションのように、あなたがオンにしたトリガーで動きます。
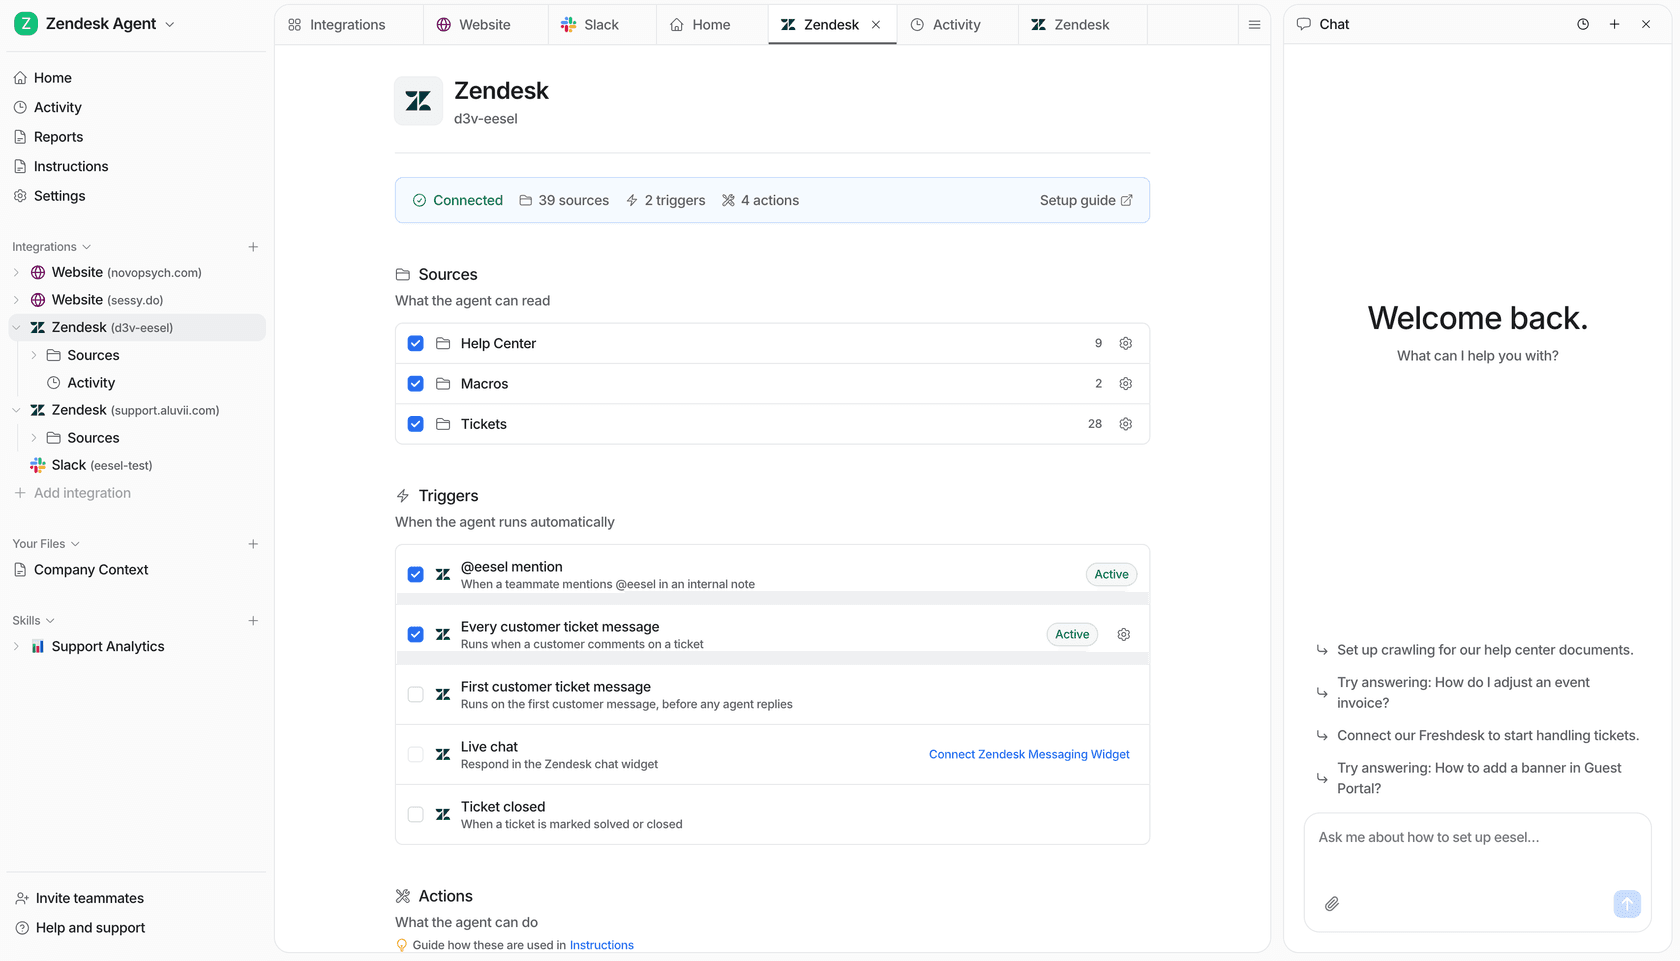
ターミナルからモデルを試すなら、eesel CLIが便利です。ダッシュボードと同じチームメイトを操作できます。eesel integrations connect zendeskでヘルプデスク接続を開始し、eesel automationsでエージェントが自動で行うことの一覧表示とオン切り替えを行い、eesel chat "how do I reset a password?"で質問して回答をストリーミングします。すべてのコマンドはJSONを出力するので、コーディングエージェントがセットアップを代行できます。さらに詳しくは私のAIエージェントCLIガイドをご覧ください。
プランは月額$299から(500クレジット)で、無料トライアルにはカード不要で100クレジットが含まれます。ご自身の過去のチケットでeeselを試すか、先に料金ページをご覧ください。チケットではなくコンテンツが仕事なら、ラインナップにはAIブログライターもあります。