

要点
Strands Decider 2Bは、AWSのStrands Labsが2026年10月1日に公開した、無料でオープンな1.9Bの意思決定モデルです。 テキストと型付きの質問(「どのチームか」「緊急か」)を渡すと、1回のパスで信頼度スコア付きのラベルを返します。スコアはJevBenchで0.762と同サイズクラスのトップ付近で、ゲーミングGPUでは約115 msで動きます。
ローンチ関連の記事の多くが触れていない点があります。重みは、この箱の中でいちばん面白くない部分だということです。ホスト型APIはなく、ローカルサーバーには認証がなく、普通のCPUサーバーでは1質問に115 msではなく約1.6秒かかります。AWSが実際に出したのは、学習データ、レシピ、研究ログまで含むオープンなキットで、RTX 3090 1枚で約11時間かけて自社の質問向けに再学習できます。
サポートチームにとって、チケットの仕分けは簡単な半分にすぎません。eeselが実トラフィックで行った試験では、AI振り分けの精度は93%でしたが、下書きされた返信のうち無編集で送られたのは12%だけでした。振り分け、ルーティング、返信をZendeskやFreshdesk内でまとめて処理したいなら、eeselのAIヘルプデスクチームメイトがモデルをホストすることなく対応します。
Strands Deciderとは?
Strands Decider 2Bは、AWSのオープンソースプロジェクトStrands Agentsの実験部門であるStrands Labsが公開した小型の意思決定モデルです。ローンチ記事の著者はMarc Brooker、Mike Chambers、Fabio Nonato de Paulaで、すべてApache-2.0で公開されています。
意思決定モデルは文章を書きません。しゃべる部分を取り除いた小規模言語モデルと考えてください。自分で定義した質問に、自分で定義した選択肢から答え、それぞれに確率を付けます。このカテゴリは9月にTypeSafe Jevが登場してから注目を集め、Strandsチームもそれをはっきり認めています。"a type of model that has been gaining a lot of attention since TypeSafe AI's launch of Jev."
私はeeselの連携機能とヘルプデスクAPIまわりを作っており、振り分けの呼び出し(どのチームか、どれほど緊急か、スパムか)は、どの工程よりも多くのヘルプデスクに組み込んできました。だからこのリリースも、パイプラインに組み込むかもしれない部品として読みました。何を返すのか、どれほど速いのか、どこで壊れるのか、自分で作るべき部分は何が残るのか、という観点です。
簡単なスペック表です。
| 項目 | Strands Decider 2B |
|---|---|
| 公開日 | 2026年10月1日 |
| パラメータ数 | 19億 |
| ベースモデル | Qwen3.5-2B-Base、LoRAランク16 + ポインターヘッド |
| 現在のリファレンスモデル | strands-decider-2B-hobson-v21(v19も引き続き公開) |
| 質問タイプ | noul(はい/いいえ)、choice(N個から1つ)、score(順序付き尺度) |
| 出力 | 質問ごとに1つの回答と、較正された確率 |
| コンテキスト | デフォルトで4,096トークン |
| ライセンス | Apache-2.0(重み、コード、データ、レシピ) |
| ホスト型オプション | なし |
| ハードウェア | CUDA、Apple MPSまたはMLX、CPU |
各行は、プロジェクトのGitHub READMEとHugging Faceのモデルカードに基づいています。
Strands Deciderの仕組みは?
ポイントは「引き算」です。Strandsは通常の言語モデルから、テキストを理解する層(胴体)を残し、単語を生成するヘッドを取り除きます。その代わりに置かれるのが、百万強のパラメータしかない小さなポインターヘッドで、各回答の選択肢にスコアを付けます。READMEはこうまとめています。"One forward pass, no generation, no decoding loop."
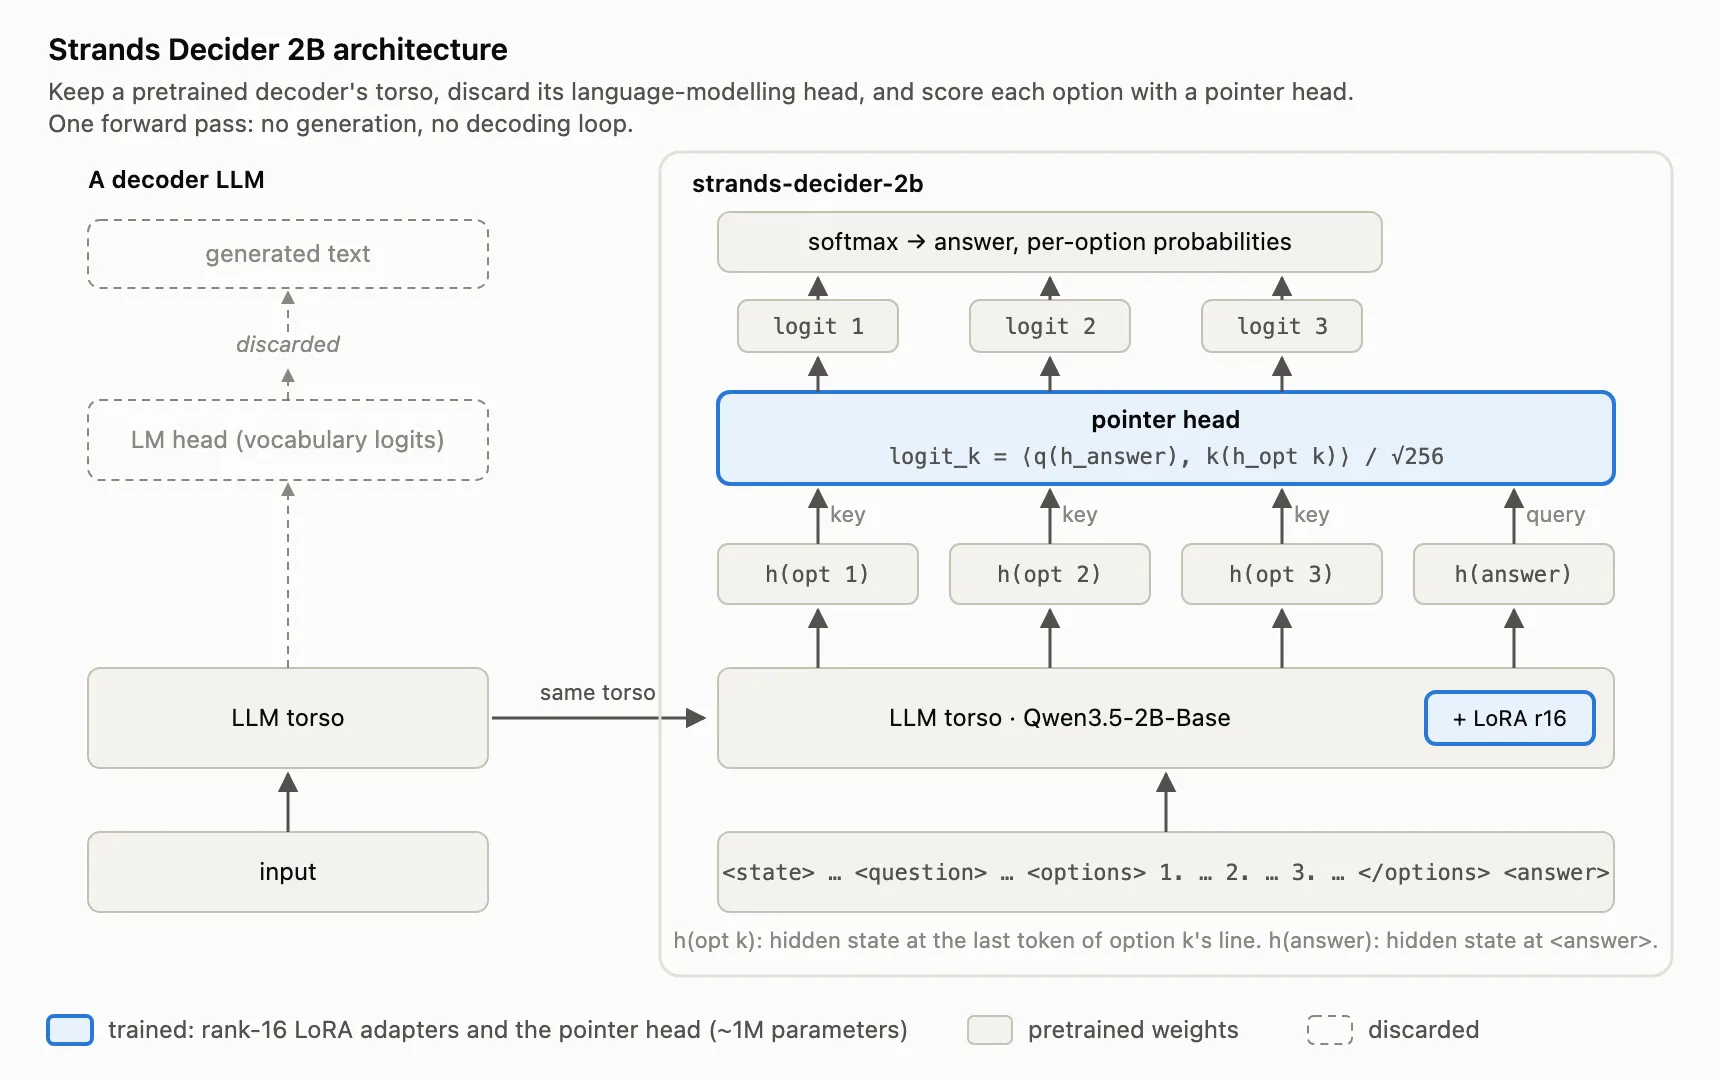
生成しないので、形式から外れることがありません。billing、sales、retailのどれかを求めれば、毎回その3つのどれかが返ります。これは大型LLMの関数呼び出し(あるいはもう少し緩いJSONモード)と同じ約束ですが、トークンごとのループもJSONの解析もないぶん安く済みます。
質問を増やしてもコストがほとんど増えないということでもあります。モデルはテキストを1回読むだけで、"each question adds only its own tokens." です。ですから「どのチームか」「緊急か」「書き手はどれほど苛立っているか」を1回の呼び出しで尋ねても、1つ尋ねるのとほぼ同じ費用です。
Hugging Faceのカードのデモはサポートチケットで、AWSが誰を買い手と見ているかがよくわかります。
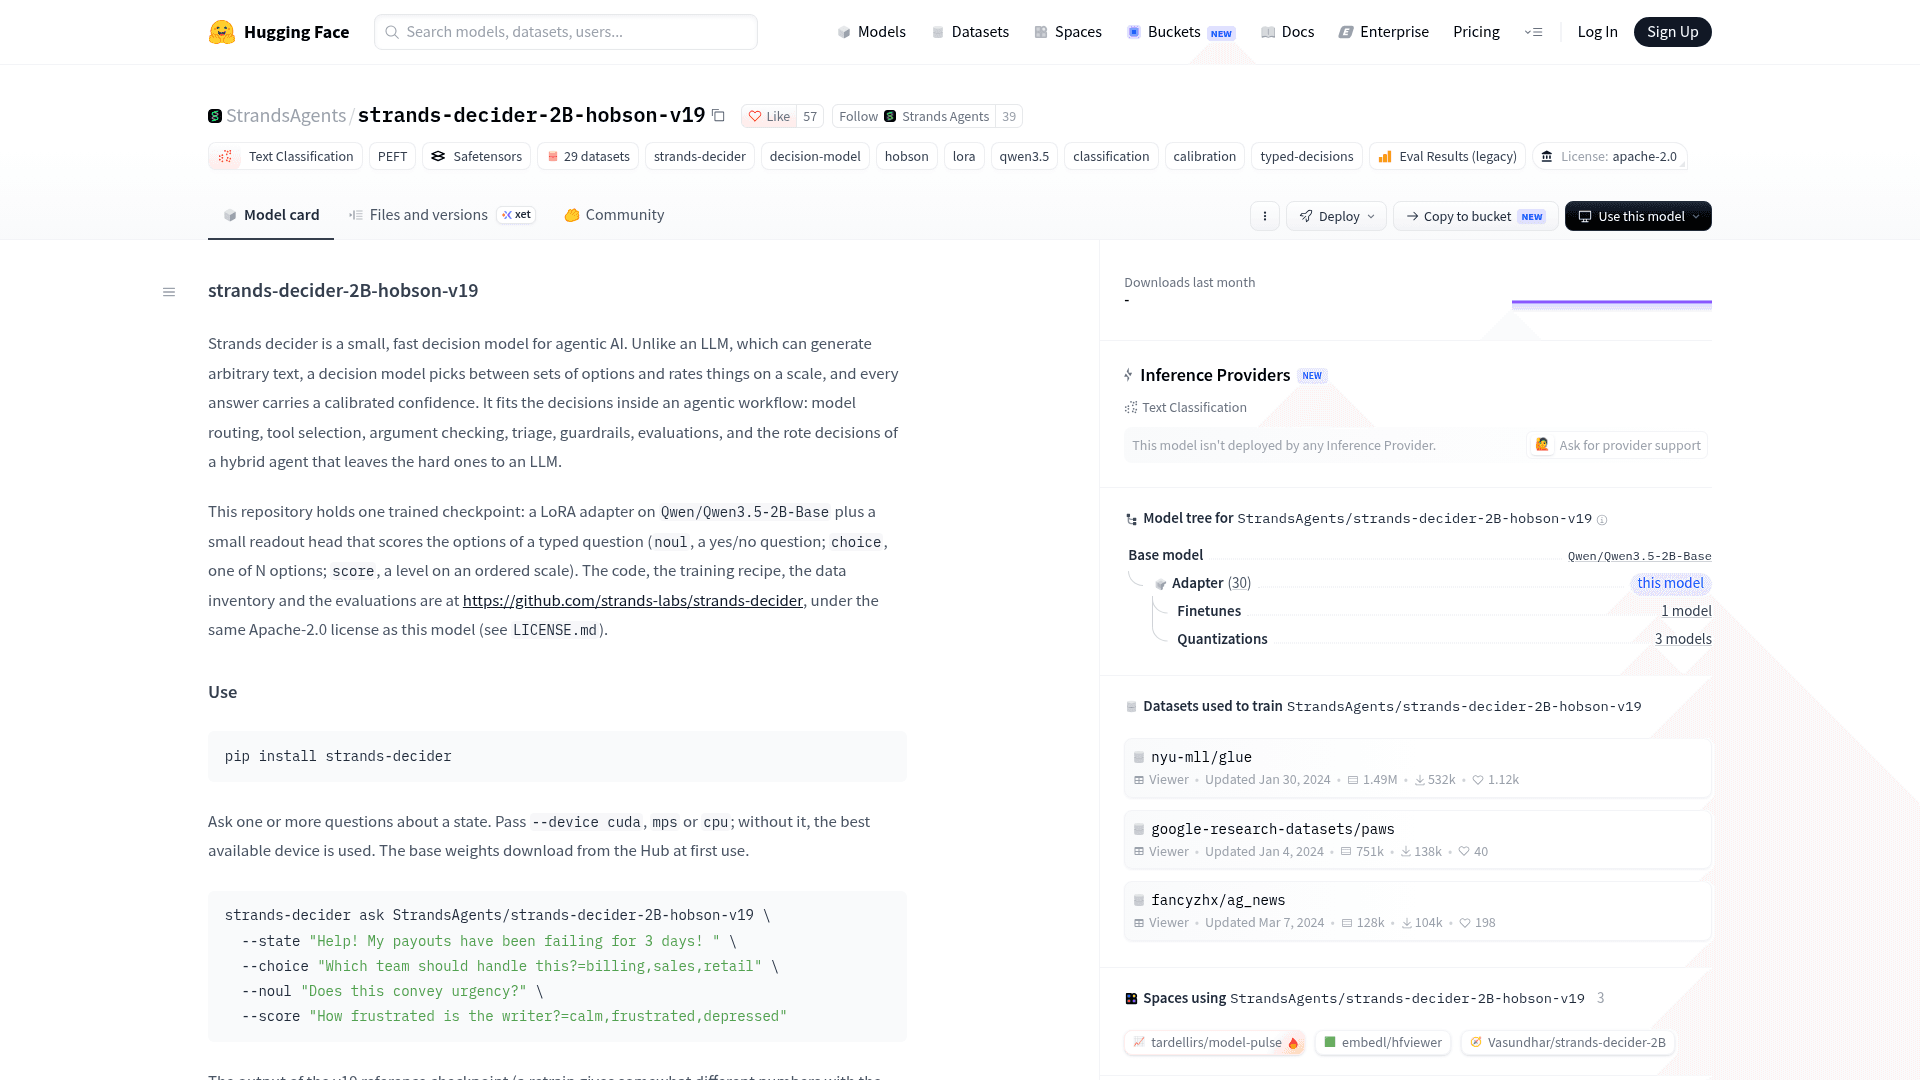
サービスとして動かすには、付属のサーバーを起動してリクエストを送ります。
pip install strands-decider
strands-decider serve StrandsAgents/strands-decider-2B-hobson-v21 --port 8000
重みは初回利用時にHugging Faceからダウンロードされます。あとはstateとquestionsのオブジェクトを付けてPOST /v1/systemoneを呼ぶと、質問ごとの回答、トークン使用量(output_tokens: 1)、latency_msが返ります。Jevの置き換えに期待しすぎる前に知っておくべき点があります。ドキュメントはJevBenchのアダプターがこのエンドポイントに対して無修正で動くとしたうえで、"Compatibility with the Jev API itself is not verified" と付け加えています(docs/inference.md)。
ベンダー自身も限界を率直に述べています。ローンチ記事は、1パス設計のせいで "significantly worse at solving complex problems than reasoning models" であり、"unsuited for coding, chatbots, document summarization." だとしています。モデルカードは、長く複数ステップにわたる文書が弱点だと付け加えています。
Strands Deciderの精度は?
JevBenchの公開セット(231タスク)での、リポジトリの数値は次のとおりです。
| 指標 | v21(リファレンス) | v19(ローンチ時) |
|---|---|---|
| 精度 | 0.762(176/231) | 0.723(167/231) |
| ブライアスコア(低いほど良い) | 0.323 | 0.342 |
| 較正誤差(ECE) | 0.064 | 0.052 |
| 易 / 標準 / 難の各段階 | 1.000 / 0.931 / 0.550 | 1.000 / 0.875 / 0.505 |
このリリースでいちばん敬意を払う一文は、チームが自分たちのアップグレードを控えめに語っているところです。それぞれ6回の学習で、v19とv21のレシピは平均で "172.8 and 172.3 JevBench tasks: the same accuracy." となっています。v21の見出しの数字が高いのは、おおむねシードの運です。彼らもそう明言しています。この誠実さは、4ポイントの上積みよりも価値があります。
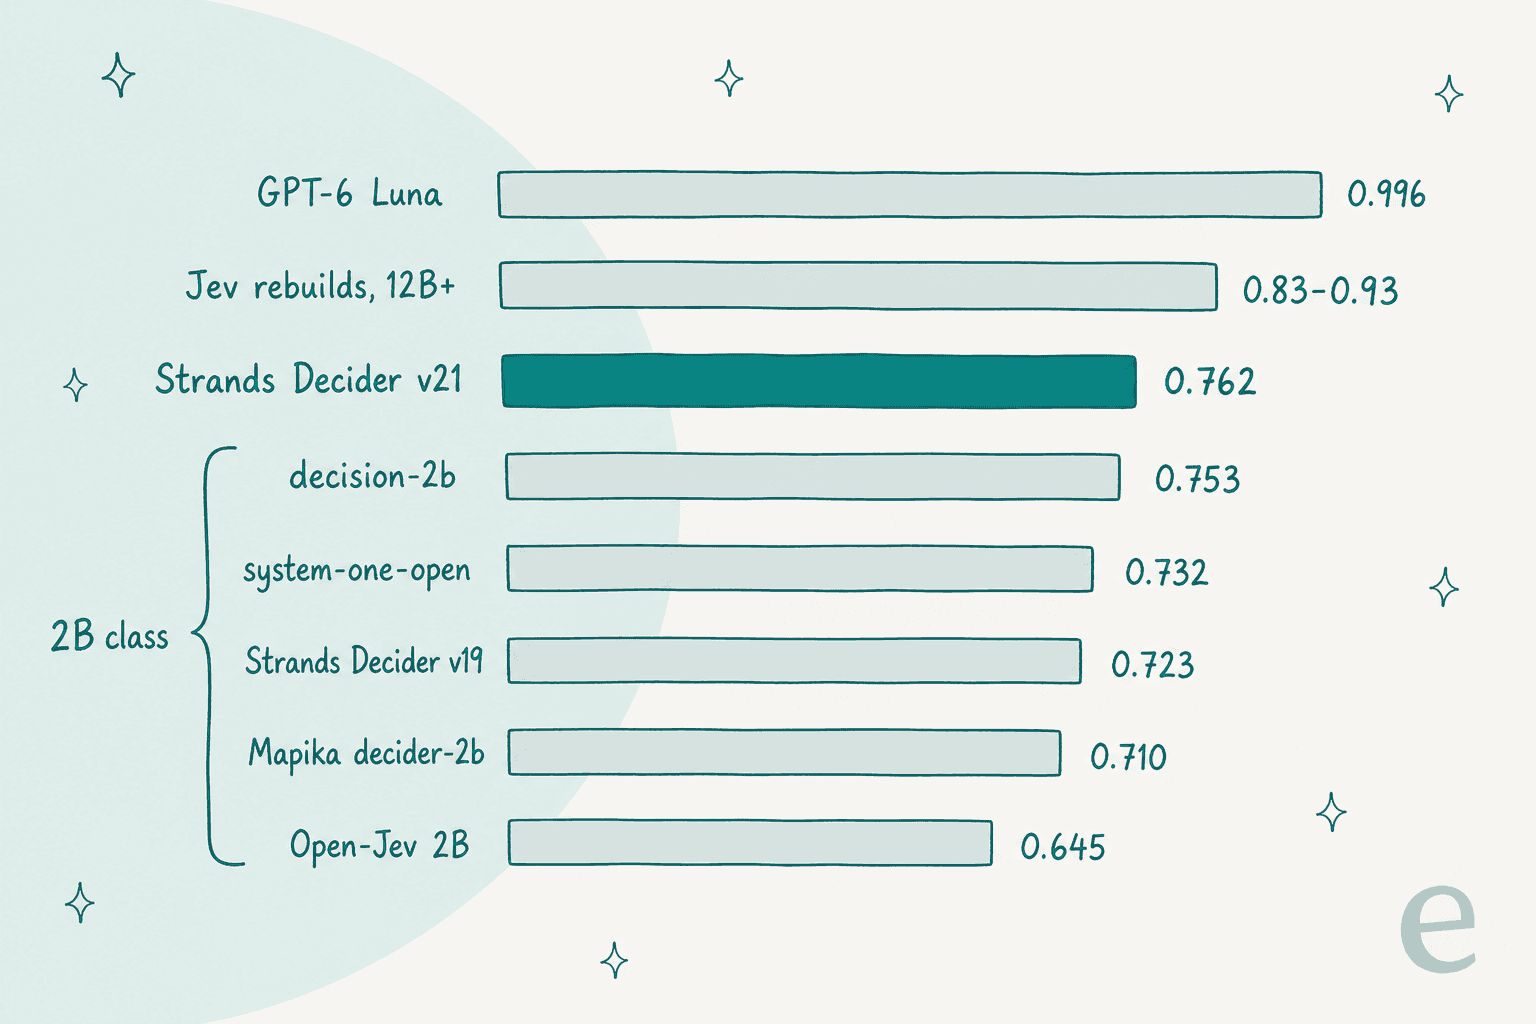
では順位表ではどこにいるのか。JevBench v1.4.2のリーダーボード(89システム、9月25日)で、v19は総合50位、2Bクラスでは33中3位でした。上にいるのはFlyMy.AIのdecision-2b(0.753)とGemmaベースのsystem-one-open(0.732)です(評価ノートによる)。表の頂点は推論型モデルのもので、GPT-6 Lunaが0.996、次いで12B超の胴体によるJev再構築が0.83〜0.93です。全体を並べて見たいなら、Jevの代替のまとめでランキングしています。
つまり正直な位置づけはこうです。Strands Deciderは「強い小型モデル」であって、「強いモデル」ではありません。フロンティアLLMに対して約23ポイントの精度を手放す代わりに、速度、価格、自前のマシンで動かせることを得ています。
ローンチ記事の学習履歴チャートを見る場合の注意点です。比較用の2点に "strands-decider-2b v10/v11" とラベルが付いていますが、Marc BrookerがHacker Newsで訂正しています。それは "decider-2B" という別のモデルで、"which isn't ours." とのことです。
信頼度スコアは意味があるのか?
較正こそが最大のセールスポイントです。信頼度スコアは、正直でなければ役に立ちません。「0.9を超えたら実行、下回れば人に回す」と言えてはじめて、ラベルは自動化に使えます。リポジトリは、未知の短い分類タスクでは "answers at a confidence of 0.9 or more are right about 95% of the time." と主張しています。
心強い話ですが、モデルカード自身が挙げる注意が2つあります。信頼度の帯域は短い分類だけで設定されたので、"measure on your own traffic before you trust a threshold" であること、そしてモデルは文書より質問を雑に読むため、言い換えた質問でも同じ答えになることが多いことです。初期のユーザーは3つ目も見つけています。
"From what i can tell from my (limited) experiments, there is a lot of variation caused by simply reordering options, plus a heavy bias toward the first option listed"

対処は地味ですが効きます。テストでは選択肢の順序をシャッフルし、どんな数字も信じる前に、自社のラベル付きチケット数百件でモデルを採点してください。Brooker自身がHNで示唆したとおり、2Bなら自社の質問でファインチューニングするか、ファインチューニングなしで再較正することもできます。
実機での速度は?
ローンチ記事の目玉の数字は、RTX 3090での中央値115 msです。これは本物ですが、GPUの数字です。リポジトリ、そのプルリクエスト、Hacker Newsから集めた、より広い全体像がこちらです。
| ハードウェア | 1質問あたりのレイテンシ | 出典 |
|---|---|---|
| RTX 3090(GPU) | 中央値115 ms、p95 299 ms | README |
| M3 Pro(Apple silicon) | ウォーム時の中央値 300トークン未満で153 ms、全タスクで234 ms | README |
| M4 Pro(CPUのみ) | ロード後0.3〜0.5 s | PR #46 |
| Xeon 8375C、8スレッド | 短い入力で約1.6 s、約3,000トークンで16〜18 s | docs/inference.md |
| Graviton 4、bf16(PR未マージ) | 1.15 s | PR #48 |
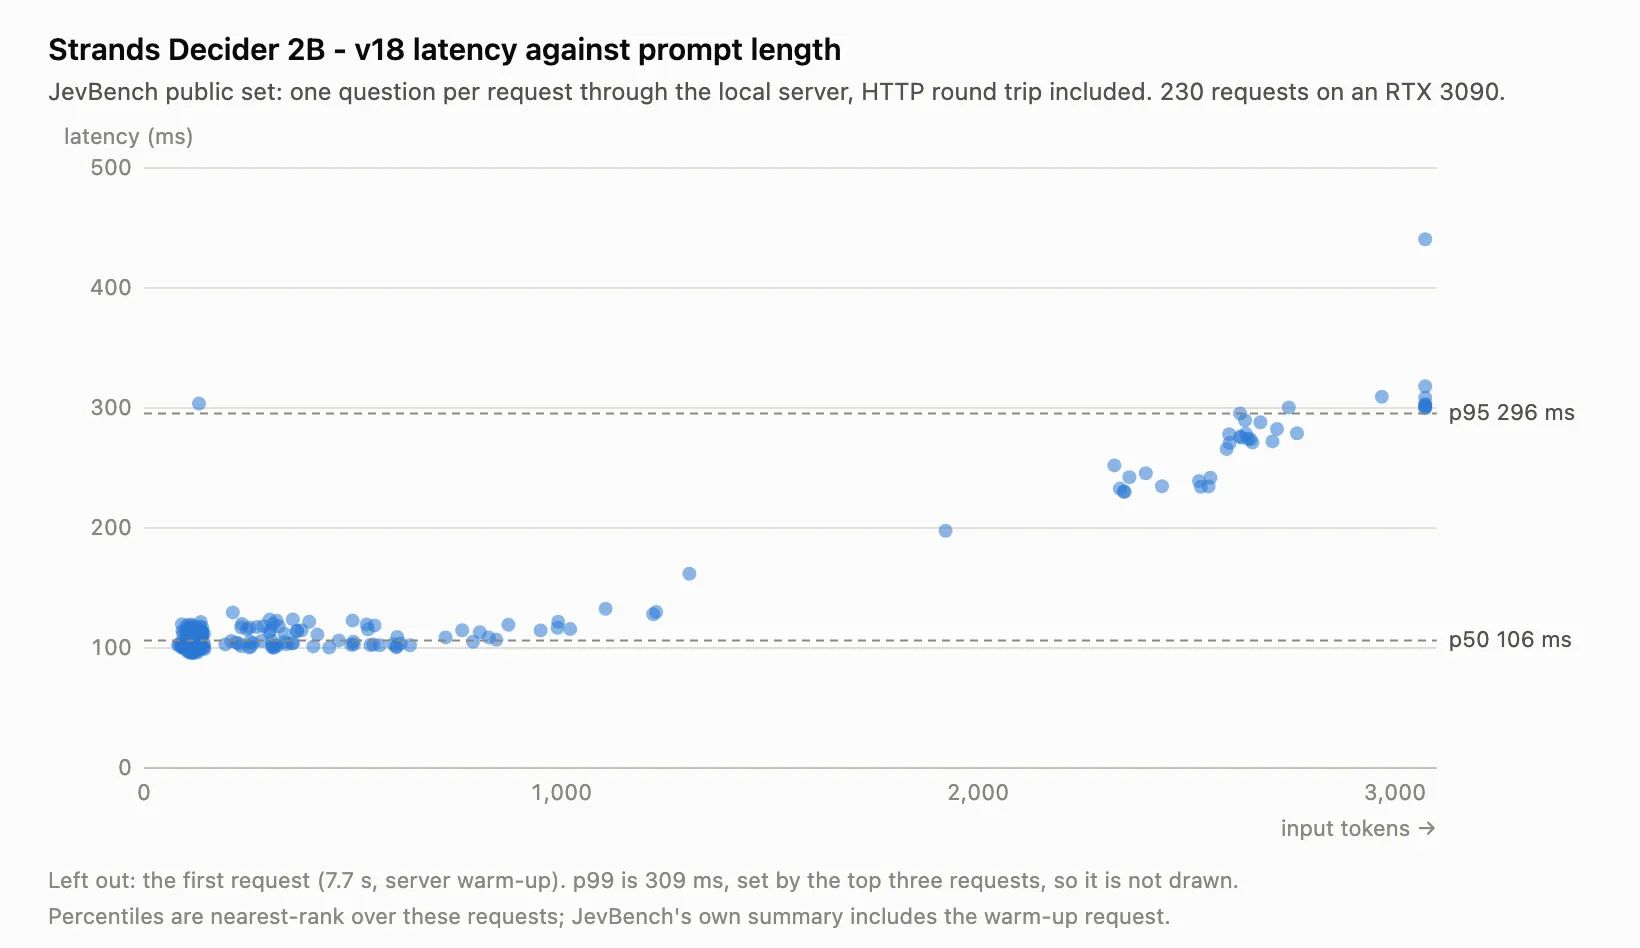
個々の数字よりパターンが大切です。レイテンシは入力の長さにおおむね比例して増えるため、長いメールのやり取りは1行のチャットよりずっと高くつきます。そして、多くのチームがデフォルトで立ち上げるタイプのCPUサーバーでは、1回の判定に数秒かかります。HNのあるユーザーは6コアで約0.5秒、別のユーザーはCPUのみのDockerコンテナで1,732 msを計測しました。判定がチャット返信を待つ顧客の前にある場合や、インテリジェントルーティングの工程の中にある場合は、GPUかApple siliconが必要です。
Strands Deciderの費用は?
モデルは無料です。動かすのは無料ではなく、それを払うのは自分以外にいません。
- ホスト型エンドポイントなし。 Hugging Faceのページには "This model isn't deployed by any Inference Provider" とあり、Bedrockの掲載もありません。Bedrockはローンチ記事にエージェント例のLLMとして出てくるだけです。
- 認証なし。 ローカルサーバーは
127.0.0.1にバインドされ、カードの言葉を借りれば "has no authentication: use it for local experiments." です。ロードバランサー、認証、監視を前段に置くのは自分の仕事で、エージェントのホスティングを扱うStrands harnessの代替で触れた雑務と同じです。 - 公式のllama.cppビルドはまだなし。 BrookerはHNで説明しています。LoRAだけを変換することはできません。"there's a whole pointer head and some custom layers." だからです。コミュニティ製のGGUF版やONNX版はありますが、どちらも非公式です。
多くのチームが比較する2つのホスト型の選択肢との比較はこうなります。
| Strands Decider 2B | TypeSafe Jev | Cloudflare Clef | |
|---|---|---|---|
| 重み | オープン、Apache-2.0 | クローズド | オープン、Apache-2.0 |
| サイズ | 1.9B | 非公開 | 27B(Clef-flash 9B) |
| ホスト型API | なし | あり(Workers AI含む) | Workers AI |
| 価格 | 無料(ハードウェア代は別) | 入力100万トークンあたり$0.042、出力は無料 | 入力100万あたり$0.24(flashは$0.09) |
| コンテキスト | デフォルト4,096 | 32,000 | ホスト型は64K |
| 自分でファインチューニング | 可、完全なレシピ | 不可 | Cloudflareチーム経由のRLチューニング |
| 詳細 | この記事 | Jevレビュー | Clefの解説 |
Jevの料金はWorkers AIの掲載ページ、Clefの料金はCloudflareのモデルページによるものです。詳しい計算はClefの料金の内訳にあります。
Jevの料金なら、500トークンの判定を100万回行って、入力トークン代はおよそ$21です。自前のGPUは、運用を続けるエンジニアの工数を加えたうえで、この金額を下回らなければなりません。ほとんどのチームでは下回れません(どの自前ホストモデルでも同じ計算で、Qwenの料金を参照)。ボリュームが非常に多い場合や、データをネットワーク外に出せない場合は別です。後者、つまり規制対象のデータこそが、Strands Deciderをいちばん正当化しやすい場面です。
AWSは実際に何を公開したのか?
ここがStrands DeciderとJevの違いで、開発者に最も勧めたい部分です。ローンチ記事は、リリースに "all the training data and scripts we used to build the model." が含まれると述べています。
- 学習データ。 Hugging Faceのデータセット、ContractNLI、MuSiQue、オープンウェイトのモデルで検証した合成データ、そして凍結したQwen3.5-4B教師モデルの出力分布。各ソースとライセンスはdata/sources.mdに一覧されています。
- レシピ。 スクリプトは1つ、
training/recipe.sh all。再学習は、RTX 3090 1枚で約11時間、H100 8枚で約1時間10分です。 - 事前登録された研究ログ。 各学習ランは、実行前に予測と失敗条件を明記しています。モデルのリリースでこれを見ることはめったになく、「v21はv19と同じ」という認め方を私が信頼する理由でもあります。
これにより、Strands DeciderはJevの競合というより、自分専用の振り分け分類器を作るためのキットに近くなります。カテゴリが固有(自社の製品ライン、返金ルール、エスカレーション階層)なら、自社のラベル付きチケット分類データ数千件で再学習するのが、著者たち自身が示す道です。ファインチューニングが初めてなら、このレシピは学ぶのに適した分かりやすい教材のひとつです。
リポジトリの動きも速いです。10月7日と8日にマージされたプルリクエストで、Gemma 4の胴体(E2B、E4B、12B、26B-A4B)への対応と、複数の学習ランを1つのチェックポイントに平均するsoupコマンドが追加されました。PRには近日公開予定の5つのチェックポイントが挙がっており、BrookerはHNに "we've got some new ones coming this week." と書いています。まだどれもベンチマーク結果は公表されていないので、計画に組み込むのは待つつもりです。
開発者はStrands Deciderについて何と言っている?
Hacker Newsのローンチスレッドは、1日で270ポイントを超えました。Jevのスレッドより温かい雰囲気で、主な理由は重みがオープンだからです。もっともはっきりした好意的な報告は、デバイス上で動かしている人からでした。
"This is a great model. I've been running it on device in chrome extension to filter things like email. It is just the right mix of size, capability and speed to make it generally useful for adhoc bulk classification tasks."
共著者のMarc Brookerは、これがどこへ向かうと見ているかを語っており、エージェントを作る人にとって役に立つ考え方です。
"There are a ton a ways to use models like this. Model routing is a popular emerging one. The one that really interests me is hybrid agentic workflows - filling the gap between deterministic workflows (e.g. AWS StepFunctions) and fully agentic workflows that use frontier intelligence."
反論ももっともで具体的です。あるスレッドは、ベンチマークでの高い較正は "does not establish reliability on unfamiliar production inputs" と主張しました(soltanov)。別のコメントは、CloudflareのClefはllama.cppで動くのに対し、Strandsは今のところ独自のCLIとサーバーが必要だと指摘しています。
"clef from cloudflare runs on llama.cpp - being locked-in to strands cli would be a bummer and will slow down adoption."
私の見方とも一致します。サイズのわりに良いモデルで、周辺ツールはまだ若く、いま価値を得ているのは自前で推論をホストすることに抵抗のない開発者です。
サポートキューのどこに収まるのか?
分かりやすい用途はチケット振り分けです。どのチームか、どれほど緊急か、スパムか。典型的なインテント分類で、意思決定モデルはこの呼び出しに向いています。ただ、ここは期待値を慎重に置きたいところです。
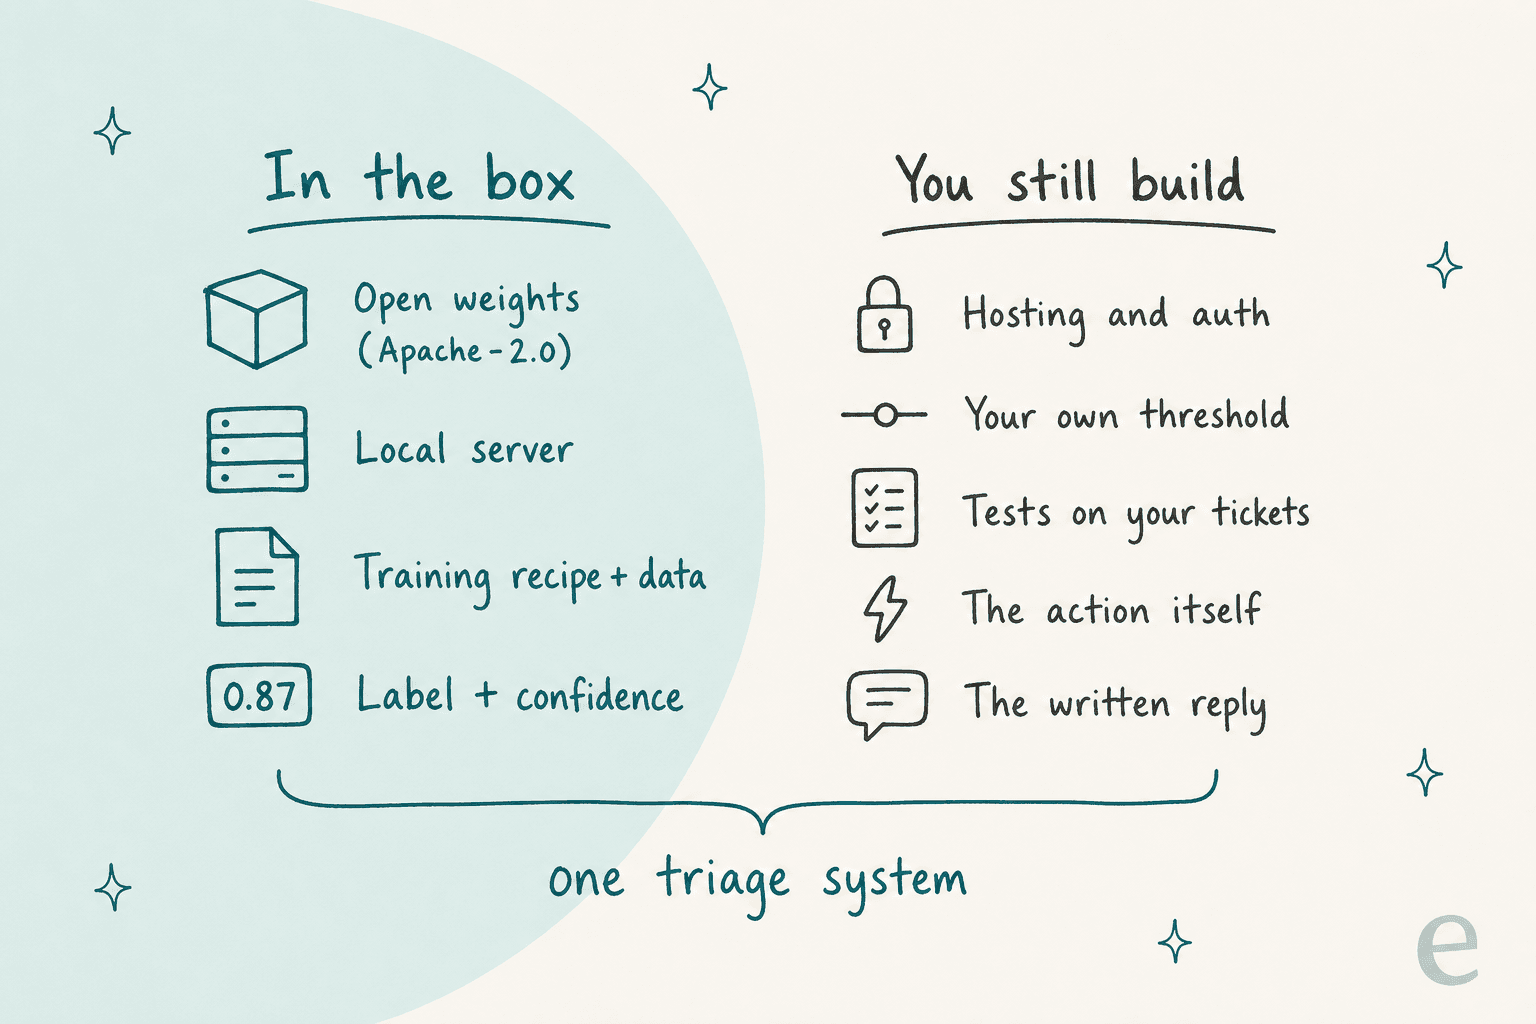
ラベルは、振り分けシステムのほんの一部です。誰かがモデルをホストし、しきい値を決め、実チケットでテストし、そのうえでZendeskやFreshdeskでチケットにタグを付け、割り当て、エスカレーションしなければなりません。しかもそれが終わっても、顧客には返事が必要です。
信頼度のしきい値が機能しているとき、流れはこうなります。
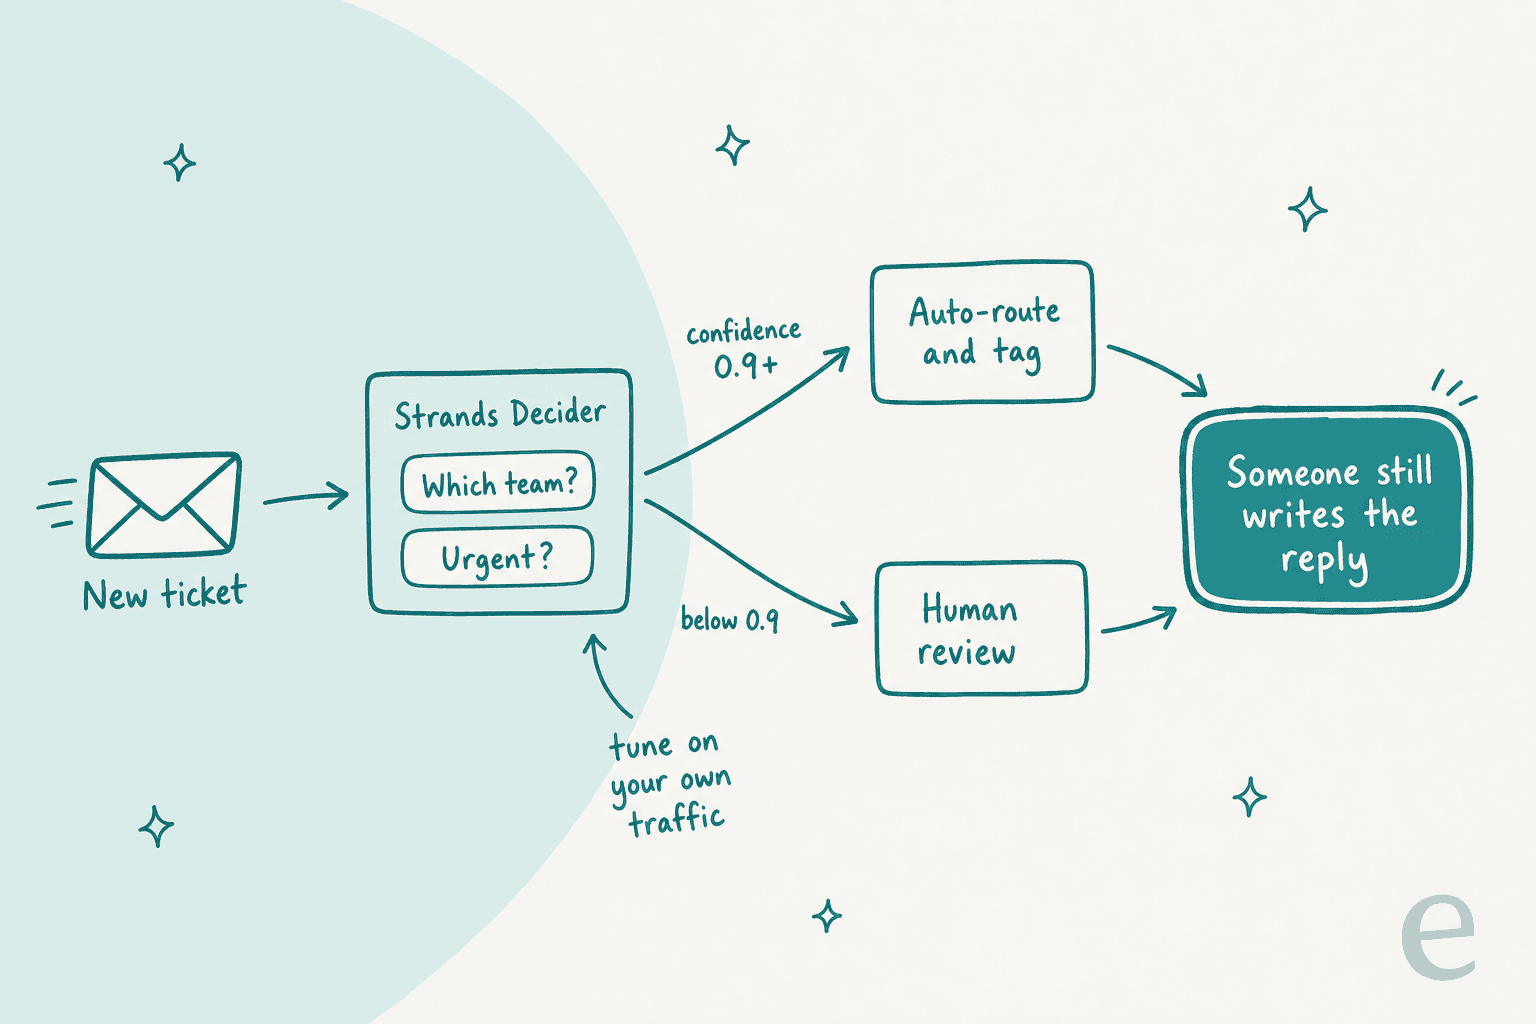
チームが過小評価するのが、この最後の箱です。実際のECサイトのZendeskの受信箱でクロスチェックしたeeselの試験では、AI振り分けの精度は93%、スパムは100%検出(受信箱の約22%)でしたが、下書きされた返信がそのまま送られたのは12%だけでした。仕分けは簡単な半分で、仕事があるのは返信のほうです。
買い手が求めているのは、較正された意思決定モデルが約束するものそのものです。月に約7,000件のチケットを扱うCXリーダーは、eeselの営業通話でこう語りました。
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
状況別のおすすめは次のとおりです。
- エージェントや独自のパイプラインを作る開発者で、データをネットワーク外に出せず、GPUがある: Strands Deciderは優れたベースです。自社のラベルで再学習してください。
- ホスティングなしで意思決定の呼び出しをしたい: まずJevから始めてください。ClefとOpenAIのDecisions APIもホスト型の選択肢です。
- サポートチームを率いていて、チケットを仕分けして返信までしたい: 意思決定モデルは必要ありません。判断を下し、それをヘルプデスク内で実行するものが必要です。その道筋はAI振り分けツールのまとめで扱い、用語は自動振り分けの用語集で説明しています。
振り分け、ルーティング、返信までをeeselで
Strands Deciderで思い描く仕事が「サポートキューを仕分けること」なら、eeselのAIヘルプデスクチームメイトがその仕事を最初から最後まで担います。Zendesk、Freshdesk、Gorgiasに数分で接続でき(最も一般的な構成はZendesk連携です)、過去のチケットとヘルプセンターから学習し、タグ付け、ルーティング、エスカレーション、返信の作成を行います。

Strands Deciderが前提とするのと同じ分業、つまり素早い判断には軽いモデル、難しい部分には重いモデルという考え方は、すでに設定として用意されています。各eeselの自動化には "Model strength" オプションがあり、下書きや複数ステップの作業には通常のモデル、タグ付けやチケットルーティングのような作業には軽いモデルを選べます。指示に合わないイベントは理由付きでスキップされログに残ります。あのCXリーダーが求めた "leave them alone" の挙動です。すべてのアクションはアクションと承認でAuto、Needs approval、Disabledのいずれかに設定でき、返金は人のクリックの後ろに置きつつ、タグ付けは自動で動かせます。
ターミナルでの作業が好きでStrands Deciderに手を伸ばしたのであれば、eesel CLIで同じチームメイトをコマンドラインから使えます。npx @eesel/cliはアカウント不要($5分の利用枠付きの一時ワークスペース)で動き、すべてのコマンドがJSONを出力し、エラーはretryableフラグ付きの1行JSONで返るため、Claude Code、Cursor、Codexがセットアップ全体を操作できます。開発者やコーディングエージェントは、eesel automations enable <platform> <key> --instructions "..."で振り分けジョブを組み、--dry-runで変更を事前確認し、eesel approvals approve <id>で保留中のアクションを解除できます。ダッシュボードと同じエージェントで、変更は双方向に同期されます。詳しくはエージェントCLIの分野を見渡した記事をご覧ください。
本番投入の前に、シミュレーションスキルが実際の過去チケットに対してエージェントを走らせ、各回答を採点するので、ベンチマークではなく自社トラフィックでの精度を確認できます。無料プランにはカード不要で100クレジットが含まれ、有料プランはeeselの料金で、500件のチケットまたはチャットにつき月額$299から、席ごとの料金はありません。
キューの一部でeeselを試して、今週どれだけのチケットを仕分けして返信できるかを確かめてください。
よくある質問
Strands Decider 2Bの精度はどのくらいですか?
リファレンスモデルのv21は、JevBenchの公開セット(231タスク中176)で0.762、v19は0.723です。2Bクラスではトップ付近ですが、GPT-6 Lunaのような推論型LLMは同じタスクで0.996を記録します。リポジトリ自体も、6回の学習の平均ではv21とv19の精度は同じだと述べています。
Strands DeciderはCPUで動きますか?
動きますが、ミリ秒ではなく秒単位を覚悟してください。リポジトリの測定では、8スレッドのXeonで短い入力なら1質問あたり約1.6秒、約3,000トークンでは16〜18秒です。RTX 3090 GPUでは中央値が115 msです。リアルタイムのルーティングの工程には、GPUかApple siliconを用意してください。
Strands DeciderとJev、どちらを使うべきですか?
オープンな重み、セルフホスティング、自社の質問でのファインチューニングが必要ならStrands Deciderを選びます。サーバー運用なしのホスト型APIと32,000トークンのコンテキストが欲しいならTypeSafe Jevを選びます。そのほかの選択肢はJevの代替のまとめで紹介しています。
Strands Deciderをサポートチケットの振り分けに使えますか?
はい。Hugging Faceのカードにある例では、支払い(ペイアウト)に関するクレームを請求、営業、小売のいずれかに振り分け、緊急度も判定しています。ただし、ホスティング、自社チケットでの信頼度しきい値の調整、そしてタグ付け、ルーティング、返信を行う工程は自分で作る必要があります。eeselのようなAIヘルプデスクチームメイトなら、その一連の流れをヘルプデスク内でまとめて処理します。
AWS BedrockにStrands DeciderのAPIはありますか?
2026年10月8日時点ではありません。唯一のサーバーはローカル用(strands-decider serve)で、認証なしで127.0.0.1にバインドされます。Bedrockはローンチ記事に、エージェント例で使うLLMとして登場するだけです。ホスト型の意思決定APIが欲しいなら、OpenAIのDecisions API、Jev、Clefを検討してください。