

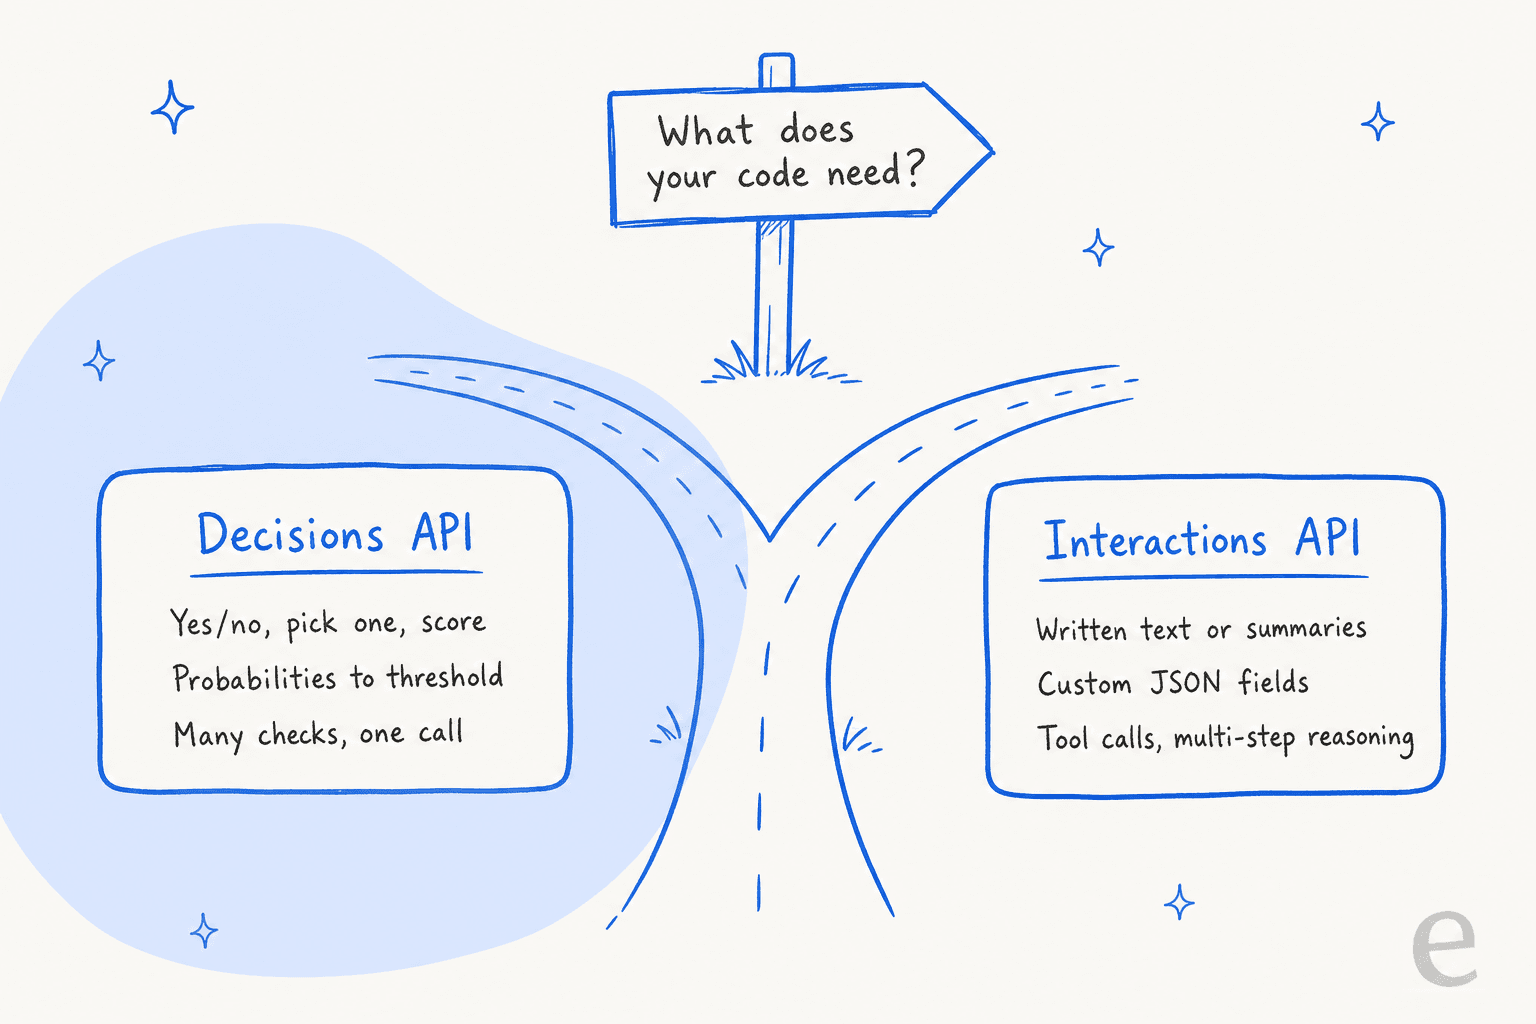
コードが同じクローズドセットの判定を1日に何千回も行っているなら、Gemini Decisions APIを試す価値があります。このチケットをどこに振るか、この写真は破損を示しているか、この返信はポリシーに違反していないか、といった判定です。Gemini Decision 1は最大1,000件のYes/No・選択・ルーブリック形式の質問を1回のパスで回答し、テキストではなく確率を返します。料金は入力100万トークンあたり0.10ドルで、出力は0円です。他の意思決定モデルに対する強みは入力で、音声・動画・PDFをネイティブに読み取れます。弱点はキャッシュ非対応、バッチ非対応、Vertex AIにまだ対応していないことです。チケットを振り分けることはできますが、回答はできません。その回答を担うのが、あなたのヘルプデスクの中で動くeeselのAIヘルプデスク・チームメイトです。eesel CLIを使えば、コーディングエージェントがトリアージ規則やヘルプ記事をアップロードし、公開前にテストチケットを走らせられます。
Gemini Decisions APIとは何か
Gemini Decisions APIは、高速なクローズドセット判定のための新しいGemini APIエンドポイントです。Googleは2026年11月11日、Gemini Decision 1(gemini-decision-1)という新モデルとともにこれを公開しました。1つの共有入力と複数の型付き質問のリストを送ると、質問ごとに1つの回答が、キャリブレーションされた確率とconfidence score付きで返ってきます。
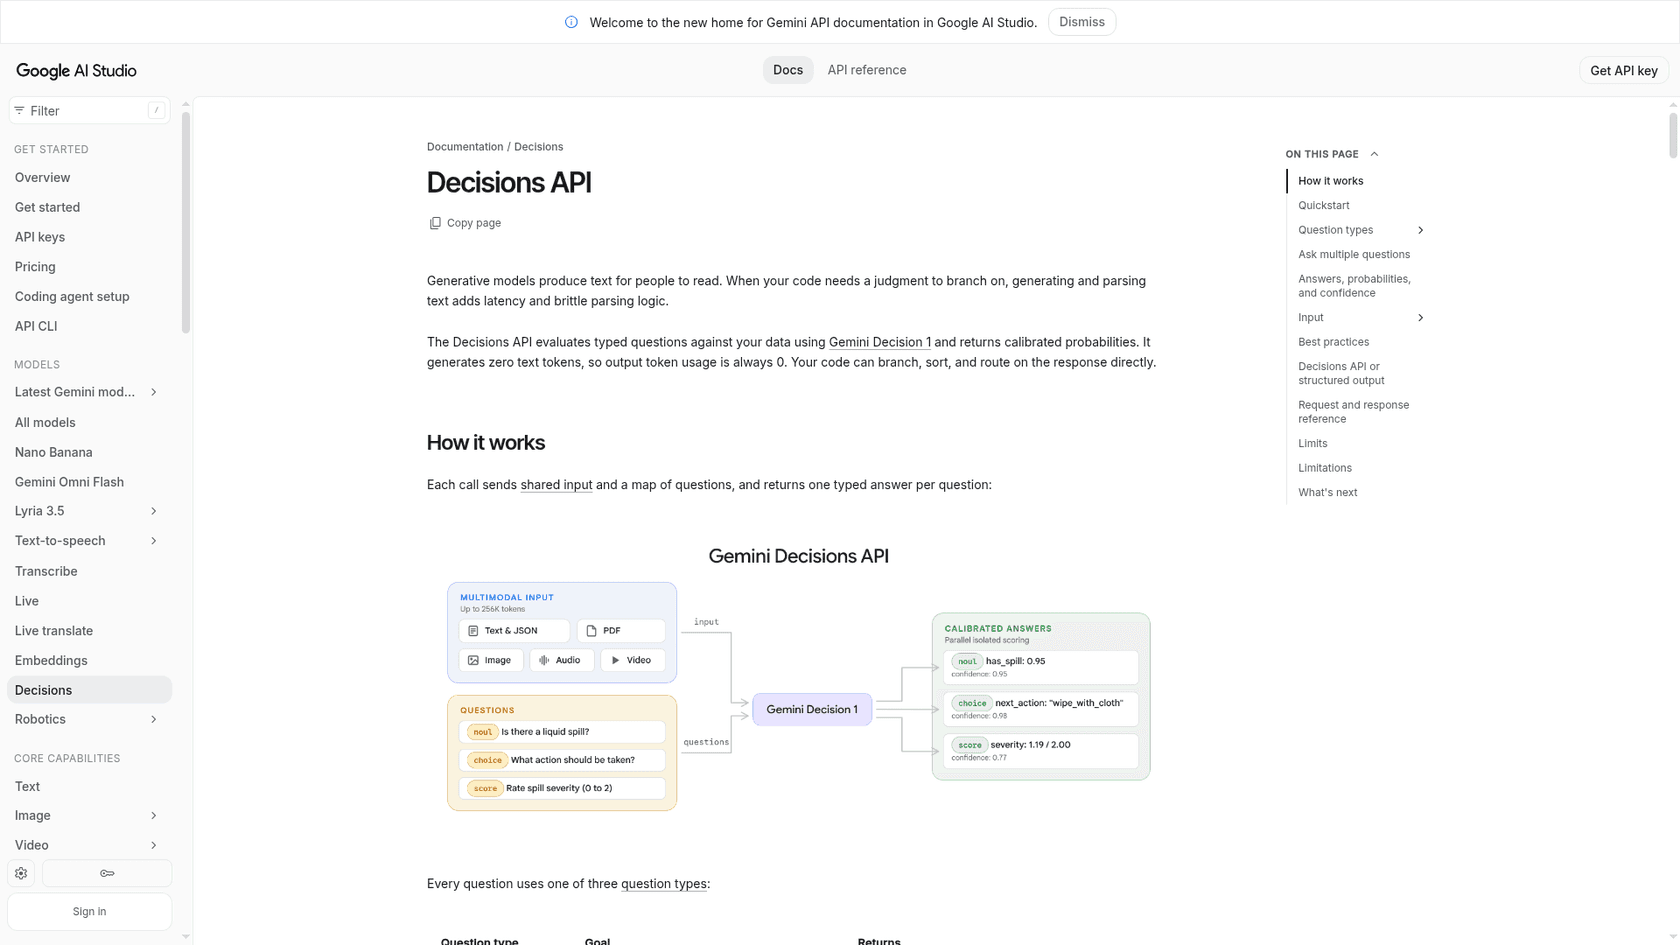
Decisions APIのドキュメントの肝心な一文は、「generates zero text tokens, so output token usage is always 0.」というものです。あなたのコードは、文章をパースする代わりに数値で分岐します。
私はeeselでインテグレーションとAPIを作っていますが、その仕事の中で二度と書きたくない部分が、1語だけ返すはずのLLMの周りに書くグルーコードです。「billing」か「shipping」かを尋ねて、ピリオド付きの「Billing.」や丁寧な一文が返ってきて、パーサーとリトライを書く羽目になる。意思決定エンドポイントはこの層をすべて取り除きます。これが、速度よりもむしろ本当の売りだと思います。
Googleがローンチ時に確認した仕様は次のとおりです。
| 仕様 | Gemini Decision 1 |
|---|---|
| モデルID | gemini-decision-1 |
| 入力 | テキスト、画像、音声、動画、PDFを1リクエスト内で混在可能 |
| 出力 | 確率とconfidence score、出力トークンは0 |
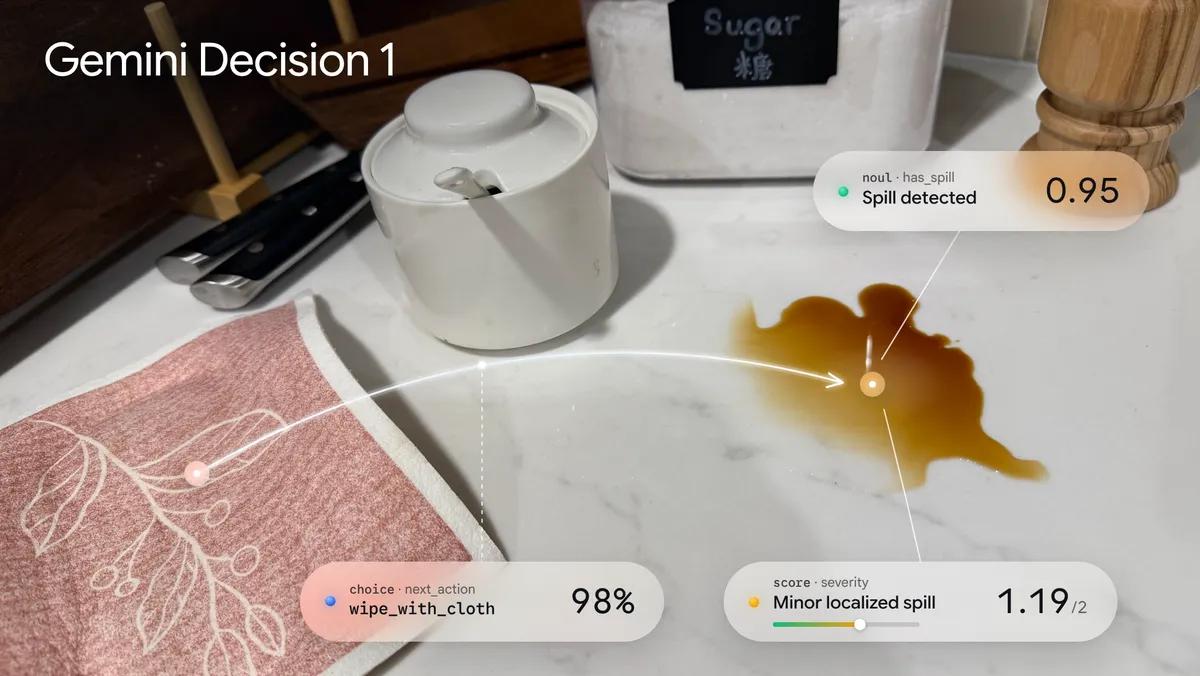
| 質問タイプ | Yes/No(noul)、選択、スコア |
| リクエストあたりの質問数 | 1〜1,000 |
| コンテキストウィンドウ | 262,144トークン(共有入力+全質問) |
| レイテンシ(Google発表値) | エンドツーエンドで150〜250ms |
| 価格 | 入力100万トークンあたり0.10ドル、AI Studioに無料枠あり |
| 利用先 | Gemini Developer API(v1beta)、OpenRouter。Google Cloudは「近日対応」 |
| 非対応 | テキスト生成、thinking、function calling、caching、Batch API、Flex、Priority |
Googleはこのカテゴリーに後発で参入しており、それを公然と認めています。TypeSafe Jevは9月にこれを始め、OpenAI Decisions APIは10月初旬にパブリックベータへ進みました。あるHacker Newsのコメント者はこのタイミングをはっきりと言い表しています。
"It took OpenAI 2 weeks after Jev to release a decision end point, and now google does it 2 months later."

Gemini Decision 1はどのように機能するか
Gemini Decision 1は入力を1度だけ読み、トークンを1つずつ生成する代わりに、1回のフォワードパスで許可されたすべての回答を採点します。そのため出力は無料で、質問を追加してもレイテンシはほぼ一定のままです。Googleによると、モデル計算の中央値は16,000トークンまでの入力で50〜100ms、リクエストあたり1〜100問ではほぼ一定としています。
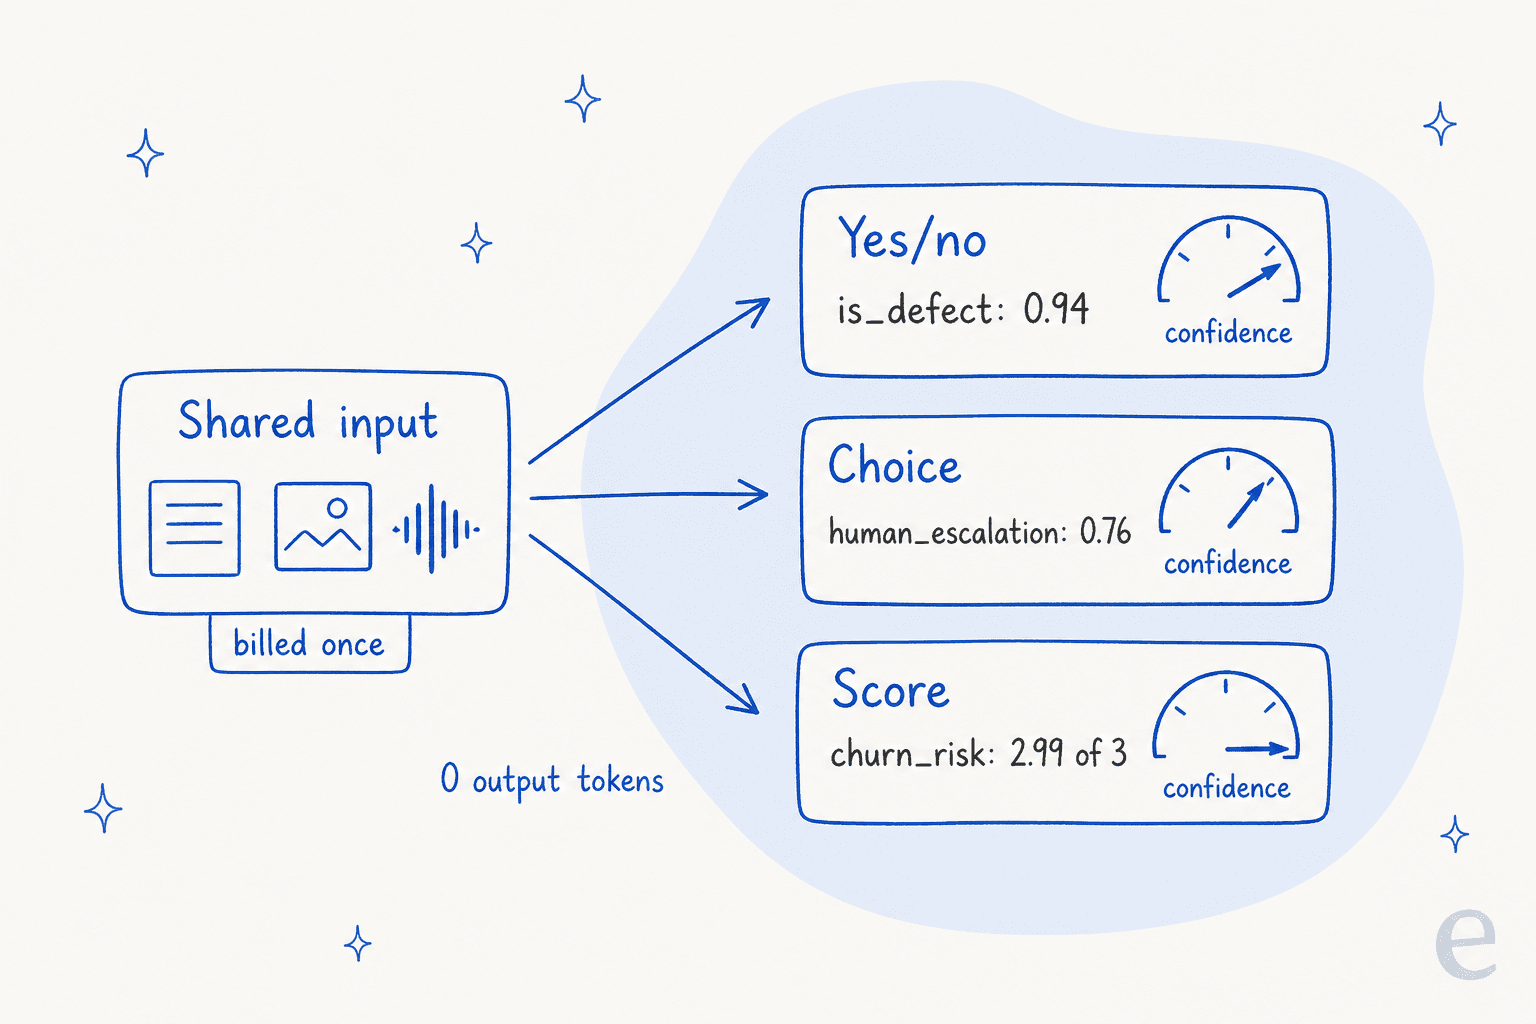
この図の数値は、ドキュメントにあるGoogle自身のサポートチケット例からそのまま取られたもので、順に見ていく価値があります。
3つの質問タイプ
質問は3つのタイプのいずれかで、1回の呼び出しの中で混在させられます。
- Yes/No(
noul) は、ある主張が成り立つ確率を0.01〜0.99で返します。「Yes」が曖昧な場合はtrue_descriptionとfalse_descriptionを追加できます。この変わった名前はJevのAPIを踏襲したもので(HNのコメント者たちは「Bernoulli」が由来だと考えています)、OpenAIは同じものをpredicateと呼んでいます。 - 選択は2〜255個のオプションから1つを選び、勝者と各オプションの確率(合計1になる)を返します。
- スコアは2〜255段階(Googleは2〜10を推奨)の順序付きルーブリックで入力を評価し、確率で重み付けした平均を返します。1.12というスコアは「ほぼレベル1、少しレベル2」を意味します。
Googleのドキュメントにあるサポート例
Google自身の複数質問の例はサポートチケットです。入力は注文データ(ヘッドフォン、240ドル、Goldティア)に加え、「Audio cuts out on the left earcup. Fix it today or I cancel my membership.」というメッセージです。これに対して3つの質問が実行されます。
| 質問 | タイプ | 回答 | Confidence |
|---|---|---|---|
| ハードウェア不良か? | Yes/No | 0.94 | 0.94 |
| どの解決方法が適切か? | 選択 | human_escalation(0.76)、replacement 0.18 | 0.76 |
| 解約の可能性は? | スコア、0〜3 | 2.99(「解約を示唆」) | 0.99 |
全体で入力324トークン、出力0トークンを使いました。そのあとの組み合わせはコード側の仕事です。不良の確率が0.9を超え、選択のconfidenceが0.6を超えればアクションを実行し、そうでなければ人に送ります。Googleはこれを「atomic checks, composed in code」と呼んでおり、これがこうしたモデルの正しい使い方です。各質問は他の質問を見ることができないため、1つ追加しても他の結果が変わることはありません。
これは、ヘルプデスクにおける優れたチケットルーティングの仕組みでもあります。すべてを決める1つの巨大なプロンプトは望ましくありません。意図、緊急度、センチメントといった小さくテスト可能なチェックと、いつ人が引き継ぐかという明確なルールが欲しいのです。ヘルプデスク側の話は、AIチケット分類と意図検出によるチケットルーティングのガイドで取り上げています。
ドキュメントが指摘する落とし穴
ドキュメントには、さらっと読むと足元をすくわれるルールがいくつかあります。
- オプションのキーは採点前にアルファベット順にソートされます。
none_of_the_aboveという総称はshippingより前に来てしまうため、otherという名前にしましょう。 - 選択は、どのオプションも当てはまらない場合でも、常に確率をオプション間に分散させます。 confidenceを確認するか、「このメッセージは注文に関するものか?」のような別のYes/Noスコープチェックを追加しましょう。
- モデルは質問のキーを一切見ません。 質問全文は
instructionsに書きましょう。 - 計算はコード側で行いましょう。 日付、金額、期間は自分で比較し、その結果を渡してください。
- 入力は信頼できないものとして扱いましょう。 Googleは、ユーザーのテキストは「can argue for its own classification」と警告しており、支払いや返金については人か二重チェックを残すべきです。これは、どのサポート環境でもAIガードレールの背後にあるのと同じ考え方です。
JevやOpenAIとの違い
入力タイプです。Gemini Decision 1は262Kのウィンドウで、テキスト、画像、音声、動画、PDFを1リクエストで読み取れます。ほとんどの競合はテキストのみ、またはテキストと画像のみで、24K〜65Kトークンにとどまります。
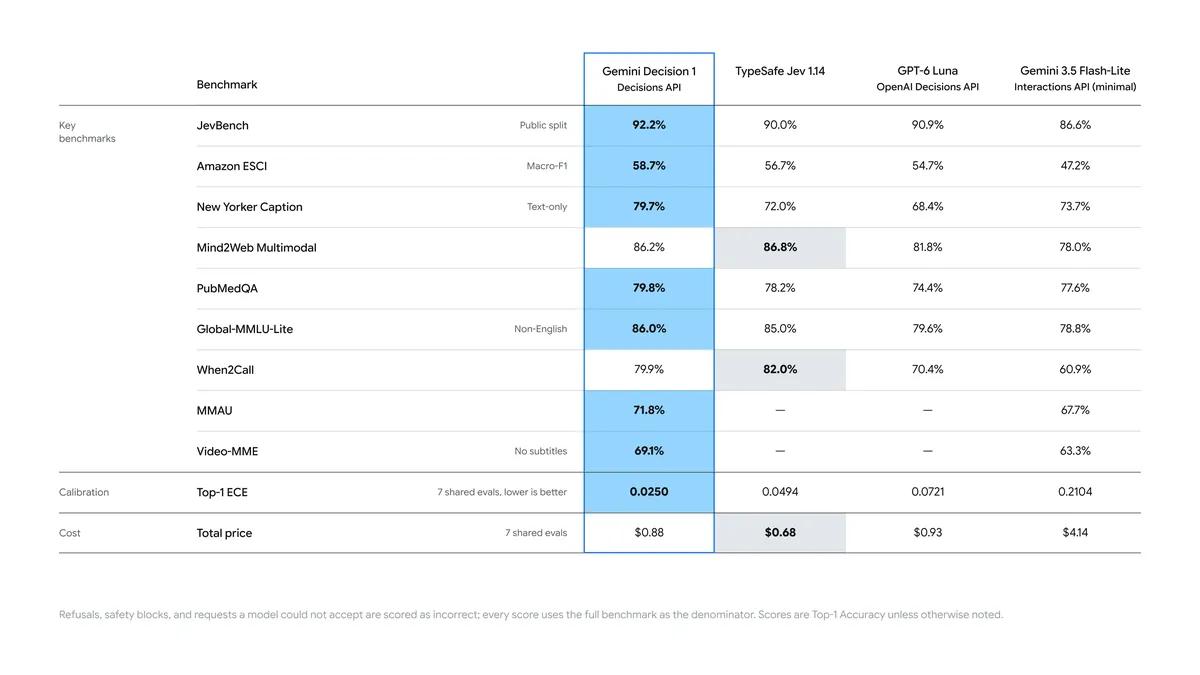
Googleのローンチ記事は、Decision 1が「leads across the suite, with the lowest calibration error.」としています。これは、外部の機関が検証するまでは、Googleが自分の宿題を自分で採点しているものとして受け取ってください。このカテゴリーが各ベンダー自身のページでどう見えるかは次のとおりです。
| モデル | 入力価格(100万あたり) | 出力 | コンテキスト | 読み取り |
|---|---|---|---|---|
| Gemini Decision 1 | 0.10ドル | 無料 | 262,144 | テキスト、画像、音声、動画、PDF |
| OpenAI Decisions API(GPT-6 Luna) | 0.10ドル | 無料 | Lunaのウィンドウ、272K超は入力2倍 | テキスト、インライン画像 |
| TypeSafe Jev | 0.042ドル | 無料 | 32,000 | テキスト |
| Microsoft-Decision-1 | 0.042ドル | 無料 | 32,768 | 非公開 |
| Cloudflare Clef | 0.24ドル | 出力価格なし | 65,536 | テキスト、JSON、画像、動画 |
| Cloudflare Clef-flash | 0.038ドル | 出力価格なし | 24,576 | テキスト、JSON、画像、動画 |
| Strands Decider 2B | 無料(セルフホスト) | 無料 | 実行ウィンドウ3K〜4K | テキスト |
Geminiの数値は2026年11月12日に確認。競合の数値は各ベンダーのページから、2026年10月11日に最終確認。
3つの点が目立ちます。
- Geminiの価格はOpenAIとまったく同じで、トークンあたりではJevの約2.4倍のコストです。マルチモーダル入力と大きなウィンドウの分を支払っていることになります。
- 音声とPDFはこのカテゴリーでは新しい要素です。 Google自身の例では「a call recording with account metadata or a scanned PDF claim with damage photos」を組み合わせています。文字起こしやOCRの別料金はかかりません。
- ホスティングの選択肢は見た目より狭いです。 オープンウェイトはなく、セルフホスティングもできず、Vertex AIにもまだ対応していません。JevはCloudflare上、MicrosoftのモデルはAzure上で動き、Strandsはどこでも動きます。
Hacker Newsのローンチスレッドも、価格と入力の関係について同じ結論に達していました。
"Its bit more expensive than other other Decision Models in the same lane. However, it can accept Audio and Video as input as well and for those specific cases it can be extremely useful."
入力がプレーンテキストのチケットなら、JevやClef-flashのほうが判定あたりのコストは安くなります。入力がボイスメール、通話録音、破損写真、PDFの請求書などなら、私が知る限りGeminiが唯一、すべてをネイティブに扱えるホスト型のdecisionモデルです。テキストのみの選択肢を広く見るなら、Jevの代替のまとめを参照してください。
Gemini Decisions APIの料金はいくらか
Gemini Decision 1は有料ティアで入力100万トークンあたり0.10ドルで、出力は存在しないため常に無料です。無料ティアはプロトタイピング向けに「Free of charge」で、Googleはそのデータを製品改善に利用できます(有料ティアではできません)。
レートより重要な課金の詳細が2つあります。
- 共有入力はリクエストごとに1回だけ課金されます。 質問がいくつあっても同じです。各質問が追加するのは、その質問自身のinstructionとcriteriaのトークンだけです。そのため、1件のチケットに対する10個の質問は、10回の呼び出しよりはるかに安く済みます。
- 割引は一切ありません。 context cachingもBatch APIもFlexティアもないため、毎回のリクエストで送る同じシステムコンテキストが、そのたびに全額課金されます。Gemini 3.5 Flash-Liteの構成なら、少なくとも0.03ドルのキャッシュ入力が得られます。
Googleは、自社のベンチマークスイートでDecision 1がFlash-Liteより「nearly 5x cheaper」だと主張しています。私自身のざっくりした計算も同じ結論になります。月に1万件のチケット、1件あたり600トークン、質問3つで各60トークン程度とすると、
- Decision 1: 入力780万トークン x 0.10ドル = 月額約0.78ドル。
- Structured outputを使うFlash-Lite: 780万 x 0.30ドル = 2.34ドル、さらに出力トークン約60万 x 2.50ドル = 1.50ドルで、合計約3.84ドル(thinkingトークンを除く)。
いずれにせよ、トリアージのモデル料金は、すべてのチケットを人が読むコストと比べればお小遣い程度です。ここに自分の数値を入れてみてください。
これで何ができるか
Googleは4つの用途を挙げています。リクエストをモデル、キュー、エージェント、ツールのいずれかに振り分けること、入力と出力を多数のポリシールールに対して一度にチェックすること、エージェントがどのツールを必要とするか、あるいは圧縮・エスカレーション・停止すべきかを決めること、候補の結果をルーブリックに対してフィルタリングまたはランキングすることです。Google自身のチームも、すでにこれを本番環境で使っています。
- Gemini Notebookは各クエリを適切なモデルティアとthinkingレベルに振り分け、Googleによると日常的なクエリを最大40%低いレイテンシで処理できるとしています。
- Google SearchはこれをMCPツールの安全層として使い、レイテンシの予算内で敵対的なコンテンツを検出します。
- Google Labsの CCは、200種類以上の選択肢から絵文字のリアクションを一瞬で選びます。
- Stitchはこれを高速なキャンバス実験に使い、数秒で操作可能なワイヤーフレームを構築します。
サポートチームにとっての活用先は明らかで、Google自身のドキュメント例もほとんどがサポートチケットです。私なら、次のような場面で使います。
- トリアージとルーティング。 人やエージェントがチケットを見る前に、部署、優先度、言語を1回の呼び出しで判定します。これは古典的な自動トリアージです。
- エスカレーションチェック。 「顧客は解約を示唆しているか?」「これは法律や安全に関わる問題か?」といったYes/No質問に固定の閾値を設け、エスカレーションのルールに反映します。
- 返信のQA。 送信前に、返信の下書きを10個のポリシールール(返金を約束しない、競合名を出さない、トーンが適切かなど)に照らします。これは、LLMにすべての下書きを判定させる代わりの安価な方法です。
- ボイスメールと写真の取り込み。 文字起こしの工程なしに、通話録音の意図や、顧客の写真に見える損傷を採点します。
- センチメントと解約のスコアリングをルーブリックで行い、「3段階中2.99」のようなスコアでチケットをキューの上位に上げられます。
できないのは、回答そのものを書くことです。これらの用途はどれも「そのあと何かが顧客に返信する」で終わります。ローンチスレッドで誰かがこうしたモデルがどこで役立つのかと尋ねたとき、ある返信は「Routing, classification, replacement for LLM-as-judge.」とまとめていました。それが正直な守備範囲です。
サポートチームにとっての意味
ほとんどのサポートチームにとって、Gemini Decisions APIは製品ではなく部品です。エンジニアがいて、トリアージを自前のスタックに組み込みたいなら、安価で速い方法ですし、confidence scoreのおかげで人への引き継ぎポイントもすっきりします。エンジニアがいないなら、ルーティングルール、閾値、テストハーネス、ヘルプデスクへの書き込みを自分で作ることになり、それらは何も付いてきません。
その周辺レイヤーこそが、eeselのAIヘルプデスク・チームメイトです。Zendesk、Freshdesk、HubSpotの既存キューに参加し、同じ分類・ルーティング・エスカレーションの判定を行い、そのうえでdecisionモデルにはできない部分を担います。つまり、あなた自身のマクロとヘルプセンターから返信を作成または送信します。実際のチケットに触れる前に、過去の対応履歴に対してシミュレーションされます。自信満々でも間違ったラベルは、やはり間違っているからです。
それがどのようなものか、eeselの2つの顧客事例で見てみましょう。
- smavaは、Zendeskを使うドイツのローン比較サイトで、decisionモデルの教科書的な用途に近い例です。1か月でeeselは2ブランドにわたる2万7,000件のチケットを処理し、そのうち1万4,600件を分類(言語、返信可否、カテゴリーをZendeskのフィールドに記入)し、同期済みの820件のマクロと記事から1万5,300件の返信ドラフトを作成しました。
- MentorShowは、HubSpotを使うフランスのオンライン学習プラットフォームで、すべてのチケットが分析され、返信ドラフトが添付されます。1か月で1,200件の会話・チケットが読まれ、フランス語・英語・スペイン語で432件のドラフトが書かれました。
どちらの場合も、ラベルが役立つのは、それをもとに何かが動くからです。それが、decision APIとチームメイトの間のギャップです。
Gemini Decisions APIを使うべきか
1語だけ返すLLM呼び出しの周りに、すでにコードを書いているなら、特に入力が音声・画像・PDFであるなら、使う価値があります。1回のパスで多数の質問をこなすこのモデルは、生成モデルからJSONをパースするよりも本当に改善されており、出力無料で100万トークンあたり0.10ドルという価格には反論しづらいです。
こういう場合は選ぶとよいでしょう。 マルチモーダルな判定が必要、32Kを超えるコンテキストが必要、同じ入力に対して数十個のチェックをかけたい、そしてGoogleのDeveloper APIで問題ない場合です。こういう場合は別のものを選びましょう。 入力がプレーンテキストである(JevやClef-flashのほうがトークンあたり安い)、今すぐVertex AIやセルフホスティングが必要である、コストを抑えるためにキャッシュやバッチ入力に頼っている場合です。
そして、本当に欲しいのがチケットの振り分けと回答の両方なら、この配線作業は飛ばしてしまいましょう。より広い視点については、両方をこなすツールを比較したチケットトリアージ向けベストAIのまとめを参照してください。
回答で終わるトリアージをeeselで試す
decisionモデルは、あるチケットがconfidence 0.94で請求関連の不良だと教えてくれます。eeselはZendesk、Freshdesk、HubSpotでそのチケットを受け取り、ラベル付けし、ルーティングし、まずあなた自身の過去チケットでテストしたうえで、チームが書いたであろう回答のドラフトを作成します。smavaはこれを使って、月に2万7,000件のドイツ語Zendeskチケットを振り分け、ドラフトを作成しています。料金を確認するか、無料でeeselを試してみてください。
よくある質問
Gemini Decisions APIとは何ですか?
Gemini Decisions APIは、2026年11月11日に公開されたGoogleのエンドポイントで、入力に対するクローズドセットの質問(Yes/No、1つを選択、またはルーブリックでのスコア付け)に答え、生成テキストではなくキャリブレーションされた確率を返します。Gemini Decision 1モデル上で動作し、TypeSafe Jevと同じ意思決定モデルのカテゴリーに属します。
Gemini Decisions APIの料金はいくらですか?
Gemini Decision 1は有料ティアで入力100万トークンあたり0.10ドルで、出力トークンは課金されません。無料ティアはプロトタイピングであれば無料です。共有入力は、質問数にかかわらずリクエストごとに1回だけ課金されます。参考として、Gemini 3.5 Flash-Liteの料金は100万トークンあたり入力0.30ドル、出力2.50ドルです。
Gemini Decisions APIはどのモデルを使っていますか?
gemini-decision-1という、1回のprefillパスでオプションを採点する専用のマルチモーダルモデルを使っています。入力上限は262,144トークンで、出力上限は0です。テキスト生成、ツール呼び出し、thinkingはできないため、Gemini 4 Carbonのようなモデルを置き換えるのではなく補完するものです。
Gemini Decisions APIはstructured outputとどう違いますか?
Structured outputは、生成モデルにスキーマに合うJSONを書かせるもので、出力トークンごとに料金がかかります。Gemini Decisions APIはテキストを一切書かず、許可された各回答の確率を返すので、閾値で判定できます。Googleは、抽出した値やカスタムオブジェクトが必要な場合はstructured outputを使うべきとしており、これはOpenAIのJSONモードとdecisionエンドポイントの間と同じトレードオフです。
Gemini Decisions APIはOpenAI Decisions APIより優れていますか?
料金は同じで、出力無料で入力100万トークンあたり0.10ドルです。Geminiはテキストと画像に加えて音声、動画、PDFを読み取れますが、OpenAI Decisions APIはテキストとインライン画像のみです。GoogleのベンチマークチャートではDecision 1が優位ですが、それはGoogle自身のテストであり、まだ独立した検証は行われていません。
Gemini Decisions APIをサポートチケットのトリアージに使えますか?
はい。Google自身のドキュメントもサポート例を使っており、チケットを請求や配送に振り分けたり、製品不良を確認したり、解約リスクを1回の呼び出しでスコア付けしたりします。チケットトリアージには非常に向いていますが、判定を下すだけです。返信を書くシステムは別に必要で、そこでヘルプデスクエージェントが登場します。
Gemini Decisions APIはVertex AIで利用できますか?
まだです。2026年11月12日時点では、Google AI Studio経由のGemini Developer API(v1beta)でのみ動作し、GoogleはGoogle CloudでのGemini対応は近日中としています。OpenRouterでも利用できます。今すぐVertexで必要な場合は、Geminiの代替を検討するか、待つ必要があります。
Gemini Decisions APIの制限は何ですか?
1回のリクエストで1〜1,000件の質問、選択質問1つあたり2〜255個のオプション、スコア質問1つあたり2〜255段階を、すべて262,144トークンのウィンドウ内で扱えます。context caching、Batch API、FlexやPriorityティアはないため、繰り返す入力はそのたびに全額課金されます。質問のinstructionsはテキストのみで、安全フィルターに引っかかった入力は回答の代わりにHTTP 400を返すため、エスカレーションの経路を用意しておきましょう。