

Microsoft-Decision-1の代替を一覧で見る
| モデル | 提供元 | 入力100万トークンあたり | 出力 | 1回の呼び出しあたりのコンテキスト | 画像 | 動かし方 | 重みとライセンス | Decision Index v0.3.1 (Full) | データとコンプライアンスの備考 | 無料枠 |
|---|---|---|---|---|---|---|---|---|---|---|
| Microsoft-Decision-1 (基準) | Microsoft | $0.042 | 無料 | 32,768 | なし | Azure Foundry、OpenRouter | クローズド | 掲載なし | Azure SLA、リージョン未公開 | Azure全般で$200、30日間 |
| Jev 1.13 | TypeSafe | $0.042 | 無料 | 1リクエストあたり64k、状態32k + 最長の質問 | なし | TypeSafe API、Cloudflare Workers AI | クローズド | 60.11 (基準、2位タイ) | Cloudflareの掲載でゼロデータ保持 | 記載なし |
| OpenAI Decisions API | OpenAI | $0.10 | 無料 | 1,050,000 (272K超は入力価格の2倍) | あり | OpenAI API、公開ベータ | クローズド | 掲載なし | 対象顧客向けZDRとHIPAA、米国とEUのデータレジデンシー | なし |
| Clef-flash | Cloudflare | $0.038 | 無料 | 24,576 | あり | Workers AI、またはセルフホスト | オープン、Apache 2.0 | 47.61 (#33) | Cloudflareのアカウント規約 | 1日10,000 Workers AI neurons |
| Clef | Cloudflare | $0.24 | 無料 | 65,536 | あり | Workers AI、またはセルフホスト | オープン、Apache 2.0 | 53.08 (#19) | Cloudflareのアカウント規約 | 1日10,000 Workers AI neurons |
| Perplexity Decider v1.1 | Perplexity | 自前のGPUコスト | 該当なし | 1回の判定あたり8,192 | あり | セルフホスト、重み約49 GiB | Apache 2.0、認証付きダウンロード | 62.75 (#1) | 自社インフラ内に留まる | 無料ダウンロード |
| Rune 26B-A4B v3 | Surogate (Invergent) | 自前のGPUコスト | 該当なし | 262k | あり | surogateエンジンでセルフホスト | Apache 2.0、連絡先入力あり | 57.43 (#10) | 自社インフラ内に留まる | 無料ダウンロード |
| Strands Decider 2B | AWS Strands Labs | 自前のGPUコスト | 該当なし | 4,096でテスト | 任意、未学習 | セルフホスト、3090に収まる | Apache 2.0 | 21.75 (#84) | 自社インフラ内に留まる | 無料ダウンロード |
| eesel (モデルではありません) | eesel | 月$299で500件のチケットまたはチャット | 該当なし | チケット全体と履歴 | あり | ヘルプデスクに接続 | ホスト型プロダクト | 該当なし | EnterpriseでHIPAA | 100クレジット無料 |
価格とコンテキストは各ベンダー自身のドキュメントに基づき、2026年10月11日に確認したものです。Decision Indexのスコアは、10月10日更新のバージョン0.3.1のJev Decision Indexボードによるものです。
なぜMicrosoft-Decision-1以外を見るのか
このモデルの概要はMicrosoft-Decision-1の概要で、料金は料金の内訳で書きました。強力なリリースです。Microsoft自身の表では、36ベンチマークで平均精度83.5%、Foundryでの中央値は85 msです。ただ、繰り返し挙がる不満がいくつかあります。
- オープンな重みがない。 ポストトレーニングされたQwen3.5-9Bですが、Microsoftが使うはずのHugging Faceのページは404を返します。借りるか、使わないかです。セルフホスト向けにQwenファミリーを気に入っていたなら、これはクローズドです。
- テキストのみ、コンテキスト32K。 スクリーンショット、スキャンした書類、非常に長いスレッドには別のモデルが必要です。
- Azure側の書類が薄い。 カタログ上はGAですが、AzureのFoundry料金ページにはまだ行がなく、リージョン、クォータ、バッチ料金も公開されていません。Azureのモデル経由で購入するチームは、決める前にこれらを求めるのが普通です。
- 独立したスコアがまだない。 Jev Decision Indexに載っていないため、これまでの精度の数字はすべてMicrosoft自身のものです。
この最後の点が、ローンチ当日の反応の大半を占めました。Satya Nadellaのローンチ投稿へのトップ返信は率直でした。
"How is Jev not ranked? That's literally the #1 model people are going to compare this to."
Microsoftはその後、投稿を更新し、精度とキャリブレーションの表にJevを加えました。それでも、その根底にある問いは正しいものです。判定モデルはいまや混み合った分野で、選ぶべき判定モデルは、どこで動くか、何を読むかで決めるべきで、ローンチ当日のチャートで決めるものではありません。
これらの代替をどう選んだか
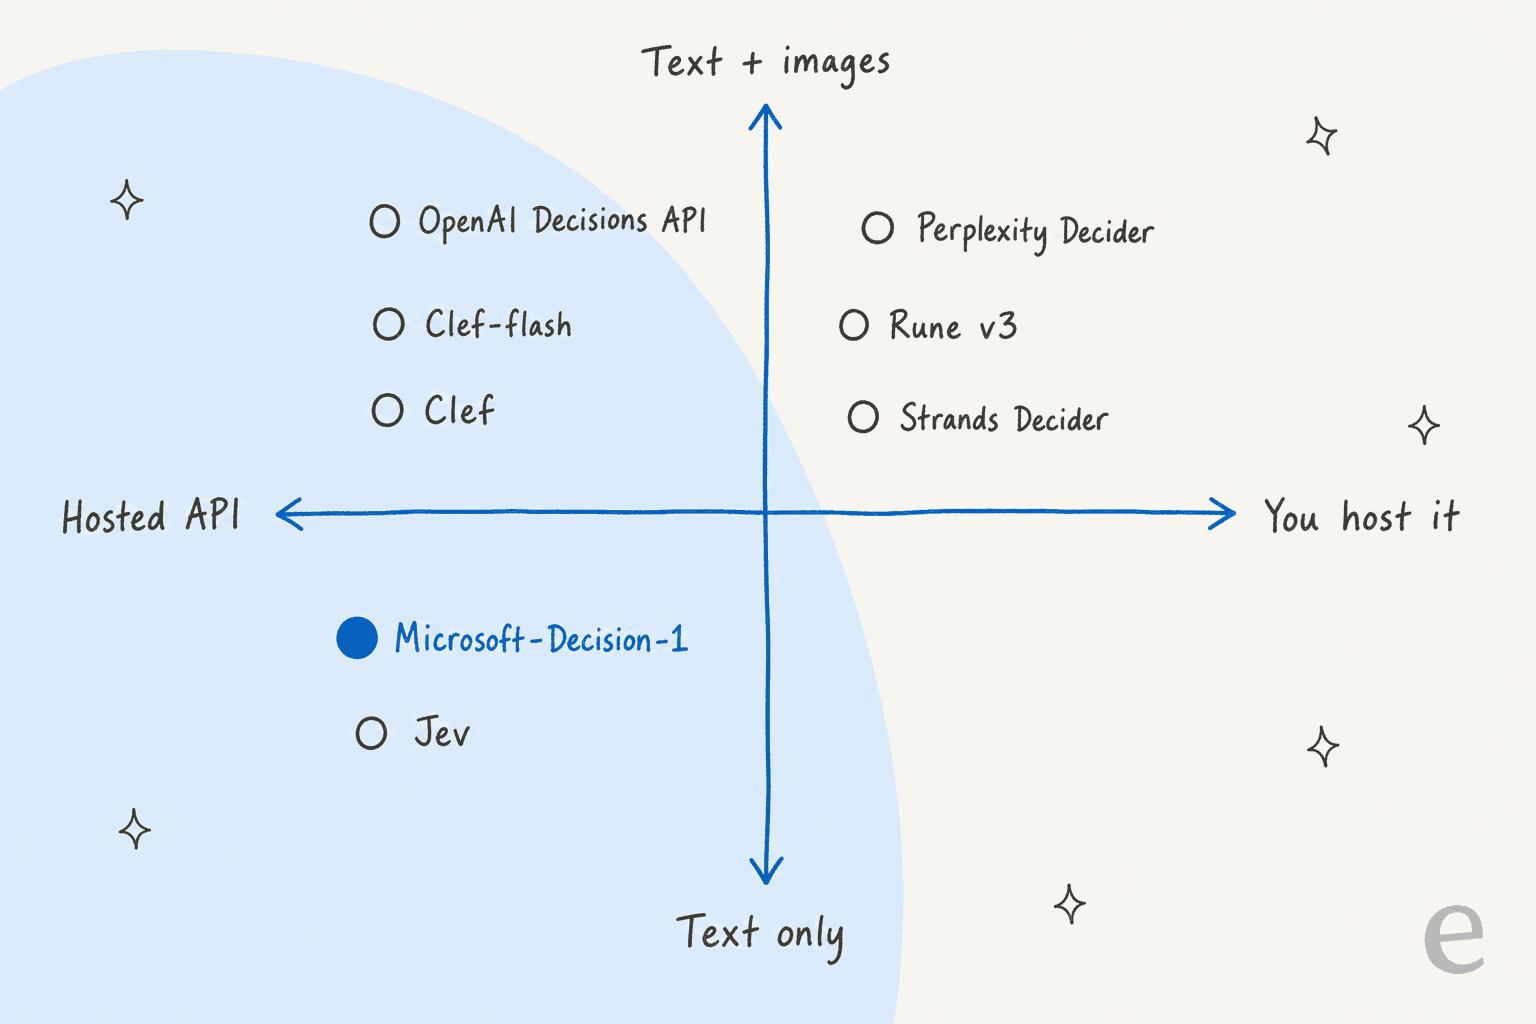
私は検索の側から入っています。eeselでの仕事は、主に買い手が検索窓に打ち込むときに本当は何を尋ねているのかを突き止めることで、ローンチの2日後の「Microsoft-Decision-1 alternatives」は、価格、ホスティング、入力タイプにきれいに分かれます。そこで、同じ仕事をするモデルに絞りました。状態と固定の回答選択肢を送ると、1回のパスでキャリブレーション済みの確率が返ってくるモデルです。
以下のモデルはすべて、Microsoft自身の比較表に載っているか、Decision Indexにランクインしているか、その両方です。JSONモードを備えた汎用のチャットモデルは除外しました。大きなモデルでのfunction callingは、コストの曲線がまったく別物だからです。各項目は同じ5つの見出しを使っているので、横断して見比べられます。
1回の呼び出しでどれだけのテキストを読めるか
サポート業務で最初に効いてくる仕様がコンテキストです。注文履歴、ポリシーの抜粋、3往復の返信がついた1件のチケットは、10,000トークンを超えることがあります。
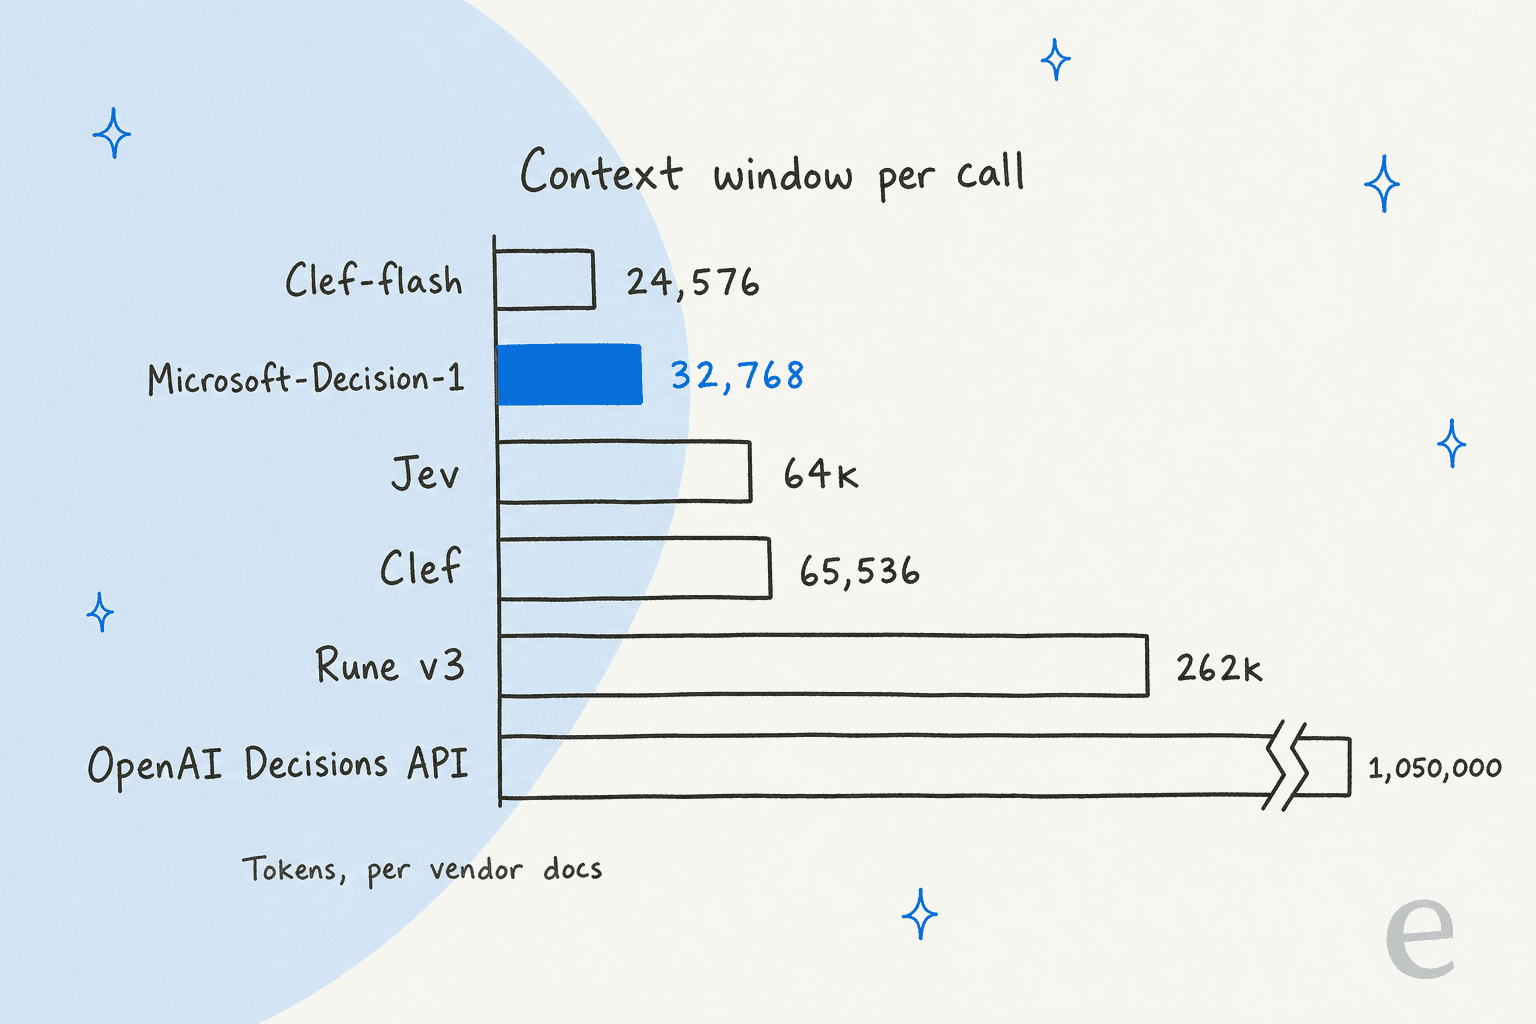
Perplexity Deciderはこのグラフに意図的に入れていません。そのモデルカードには、1回の判定のテキストと全画像が8,192トークンに収まる必要があり、それより長い入力は切り詰められずに拒否されると書かれています。最高のスコアで、最小のウィンドウです。
1. Jev 1.13 (TypeSafe)
概要
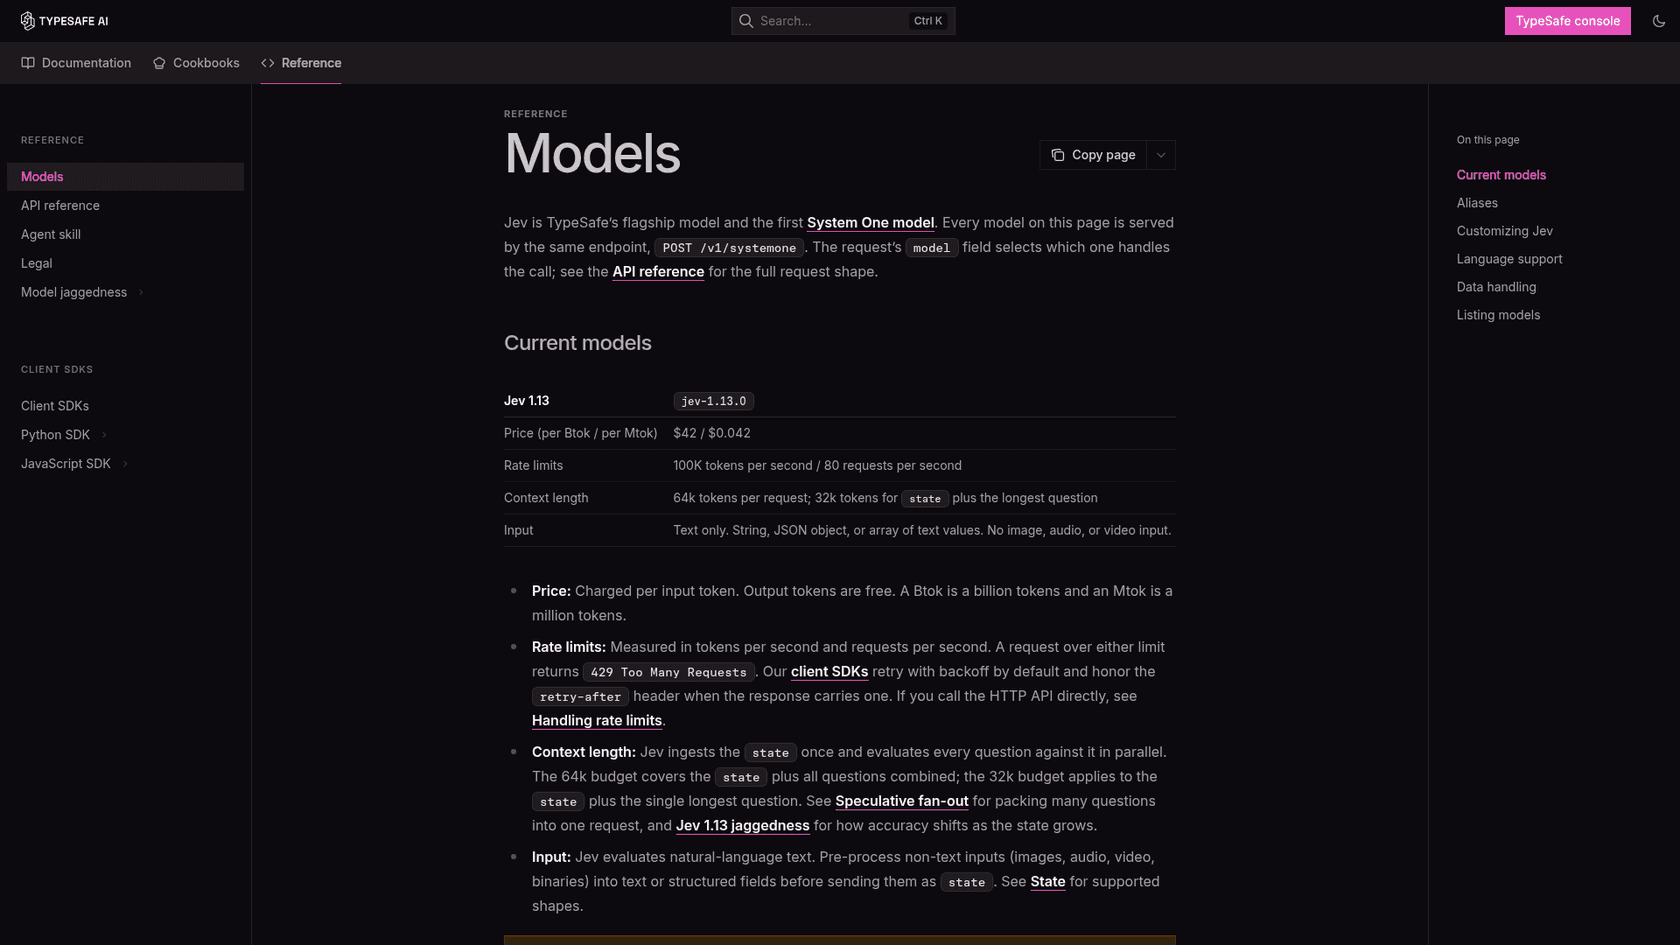
Jevはこのカテゴリを始めたモデルです。TypeSafeは単一のエンドポイントPOST /v1/systemoneで提供しており、送った質問をそれぞれ共有の状態に対して並列にスコアリングします。詳しくはJevの概要で解説しました。
Microsoft-Decision-1に勝る点
- より大きなリクエスト。 TypeSafeのモデルページによると、Jevは1リクエストあたり64kトークンを受け付け、うち32kは状態と最長の1つの質問のためです。Microsoftは32,768が上限です。
- より良いキャリブレーション。 Microsoft自身の表でも、キャリブレーションはJevが93.7、Microsoftが92.2です。
- 買える場所が多い。 TypeSafeのAPIに加え、JevはCloudflare Workers AIでも同じ価格で提供され、キャッシュ済み入力は無料、ゼロデータ保持です。
劣る点
- Microsoftと同じくテキストのみ。画像は先にテキストへ変換する必要があります。
- TypeSafeは"Rate limits are adjusting dynamically"と警告しており、予告なく変わり得ます。現在の上限は毎秒100Kトークンと80リクエストです。
- Microsoftの表では精度でわずかに下で、82.3%対83.5%です。
あるHacker Newsのテスターが、ローンチの翌日に自分のスイートで両方を試しました。
"In my minimal suite it was cheaper (by 0.72x) but higher latency (283ms vs 369ms p50) than Jev. Results were very comparable across all scenarios I measure, first of these that I have tested that actually justifies its existence as a commercial release."

定価は同じでも請求額は異なります。トークナイザーの数え方が違うので、自社のチケットで試してください。
料金
入力100万トークンあたり$0.042、出力は無料、文書化された無料枠はありません。Jevの料金の記事で判定あたりのコストを計算しており、Jev Ultrafastは高速ティアを扱っています。
こんな人向け
同じ価格とAPIの形で、より長い入力に対応し、Azureに依存しないMicrosoft-Decision-1の代替を求めるチーム。
2. OpenAI Decisions API (gpt-6-luna)
概要
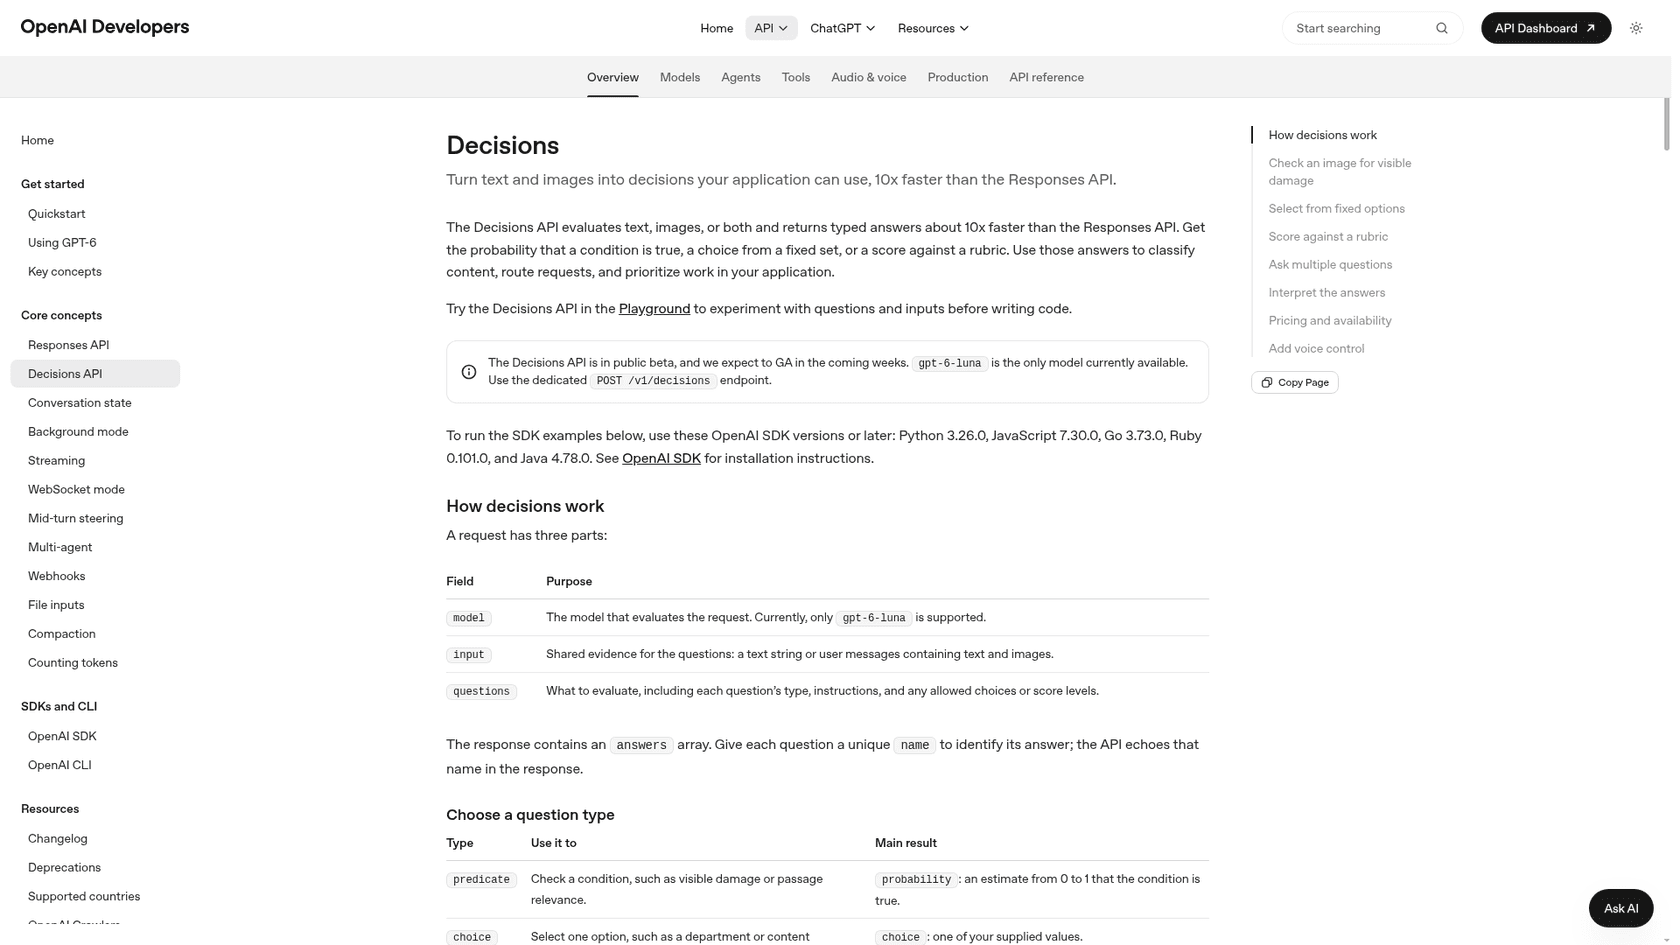
同じ発想に対するOpenAIの回答で、10月6日に公開ベータとして登場しました。gpt-6-lunaを指定してPOST /v1/decisionsを呼び出し、テキストと画像の入力と、predicate、choice、scoreのいずれかの型の質問リストを渡します。手順はDecisions APIのガイドにまとめています。
Microsoft-Decision-1に勝る点
- 画像。 テキストと画像を1回の呼び出しで読みます。画像はインラインのbase64データURLである必要があります。
- 巨大なコンテキスト。 GPT-6 Lunaの1,050,000トークンのウィンドウを引き継ぐので、チケットの履歴全体が収まります。
- コンプライアンスのオプション。 OpenAIのガイドには、対象顧客向けのZero Data RetentionとHIPAA、米国とEUのデータレジデンシーが記載されています。
劣る点
- トークンあたりのコストがMicrosoftの約2.4倍です。
- まだベータです。OpenAIはGAを"in the coming weeks"と見込んでいます。
- 272Kトークンを超えるプロンプトは入力の2倍で課金され、リージョン処理の割増も適用されます。
- OpenAIはミリ秒単位のレイテンシを公表しておらず、"about 10x faster than the Responses API"とだけ述べています。Microsoftの表では中央値300 ms、精度79.4%と測定されました。
料金
入力100万トークンあたり$0.10で、出力、キャッシュ読み取り、キャッシュ書き込みの料金はありません。この料金はDecisionsのガイドにあり、まだOpenAI APIの料金のメインページには載っていません。詳しくはLunaの料金の記事をご覧ください。
こんな人向け
すでにOpenAIを使っていて、スクリーンショットや長いスレッドをスコアリングしたい、あるいはHIPAAの書類を整えたいチーム。
3. Cloudflare Clef-flash
概要
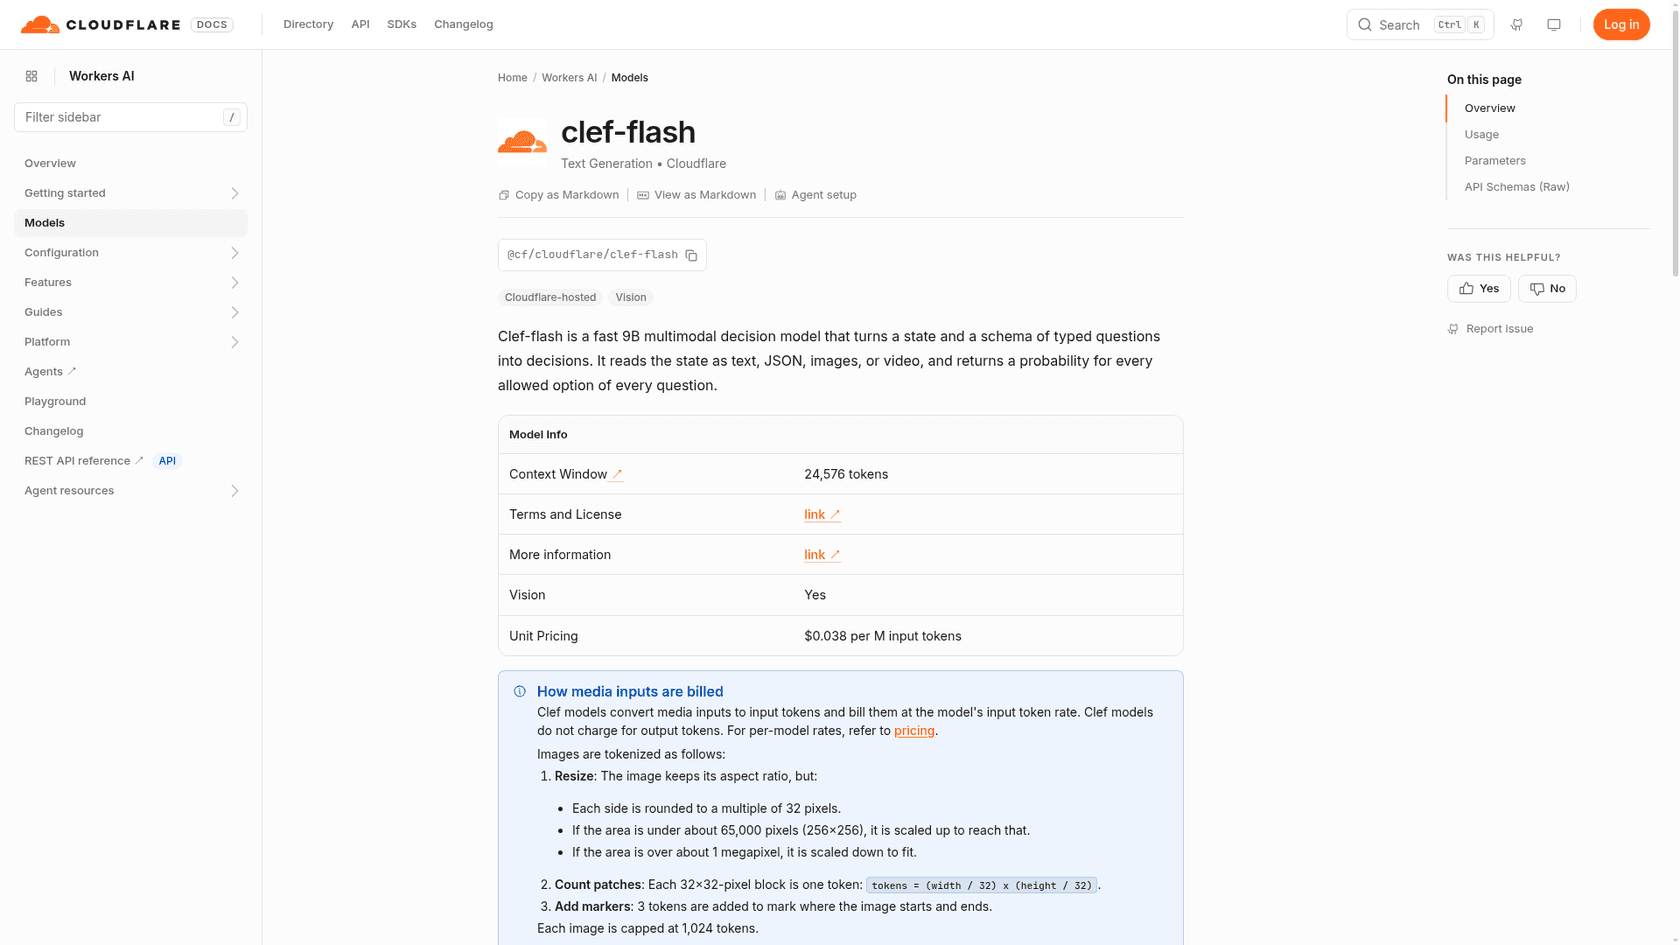
Cloudflareの小型の判定モデルで、Microsoftと同じQwen3.5-9Bをベースにした9Bです。Workers AIで@cf/cloudflare/clef-flashとして動き、重みはApache 2.0でHugging Faceにあります。Clefの概要で、2つのClefのサイズを扱っています。
Microsoft-Decision-1に勝る点
- ホスト型で最安の料金。 入力100万トークンあたり$0.038で、1週間前は$0.09でした。
- 画像。 Cloudflareのページはビジョン対応を掲載しており、画像は入力トークンとして課金されます。
- 1日の無料枠。 Workers AIはFreeとPaidのプランで1日10,000 neuronsを提供します。私の計算では、Clef-flashの入力トークンで1日およそ2.9M相当です。
- オープンな重みなので、あとで自社運用に移せます。
劣る点
- 値下げと引き換えにコンテキストウィンドウが24,576トークンに縮小し、Microsoftより小さくなりました。
- Decision Indexでは33位(47.61)で、ClefやJevをかなり下回ります。
- Microsoftの比較表には載っておらず、両者に共通のベンチマークがありません。
料金
入力100万トークンあたり$0.038で、出力料金はありません。無料のneuronsを超えると、Workers AIは1,000 neuronsあたり$0.011を請求します。
こんな人向け
呼び出しあたりのコストが最重要で、入力が短いままの、大量のテキストまたは画像の分類。
4. Cloudflare Clef
概要
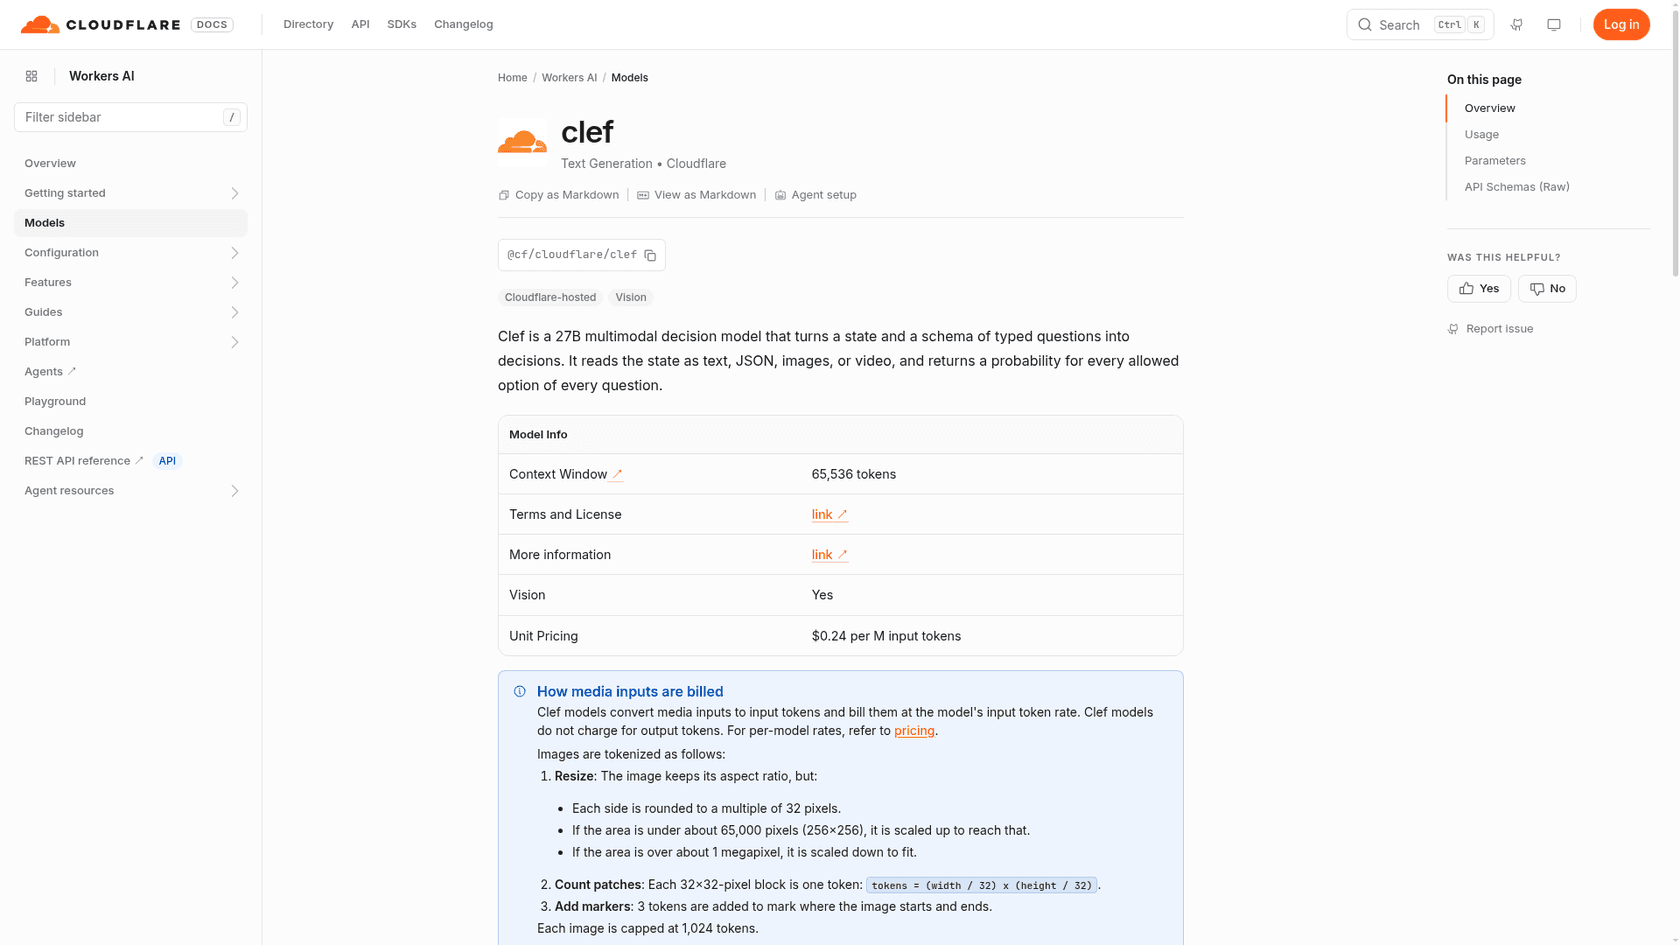
大きい方のClefで、Qwen3.8-27Bからポストトレーニングされた27Bのマルチモーダル判定モデルです。Workers AIでホストされ、Apache 2.0で公開されています。
Microsoft-Decision-1に勝る点
- 2倍のコンテキスト。 65,536トークンです。
- 画像と動画を状態に含められます(Cloudflareのモデルカードによる)。
- 独立したスコア。 Decision IndexでFull 53.08に載っており、公開ベンチマークのみのスコア61.71は、ここで挙げたホスト型の中で最も高い公開数値です。
劣る点
- 入力100万トークンあたり$0.24で、Microsoftの料金のほぼ6倍です。
- 非公開テストのスコアでは19位に下がるため、公開数値は実力以上によく見えます。
- Cloudflare自己申告の中央値は209 msで、Microsoftが主張する85 msより遅いです。
料金
入力100万トークンあたり$0.24で、出力料金はなく、同じく1日10,000 neuronsが無料です(Clefの入力で約458Kトークン)。計算はClefの料金の記事にあります。
こんな人向け
Cloudflareを使っていて、より長いマルチモーダル入力が必要で、そのために呼び出しあたりの高いコストを払えるチーム。
5. Perplexity Decider v1.1 (27B)
概要
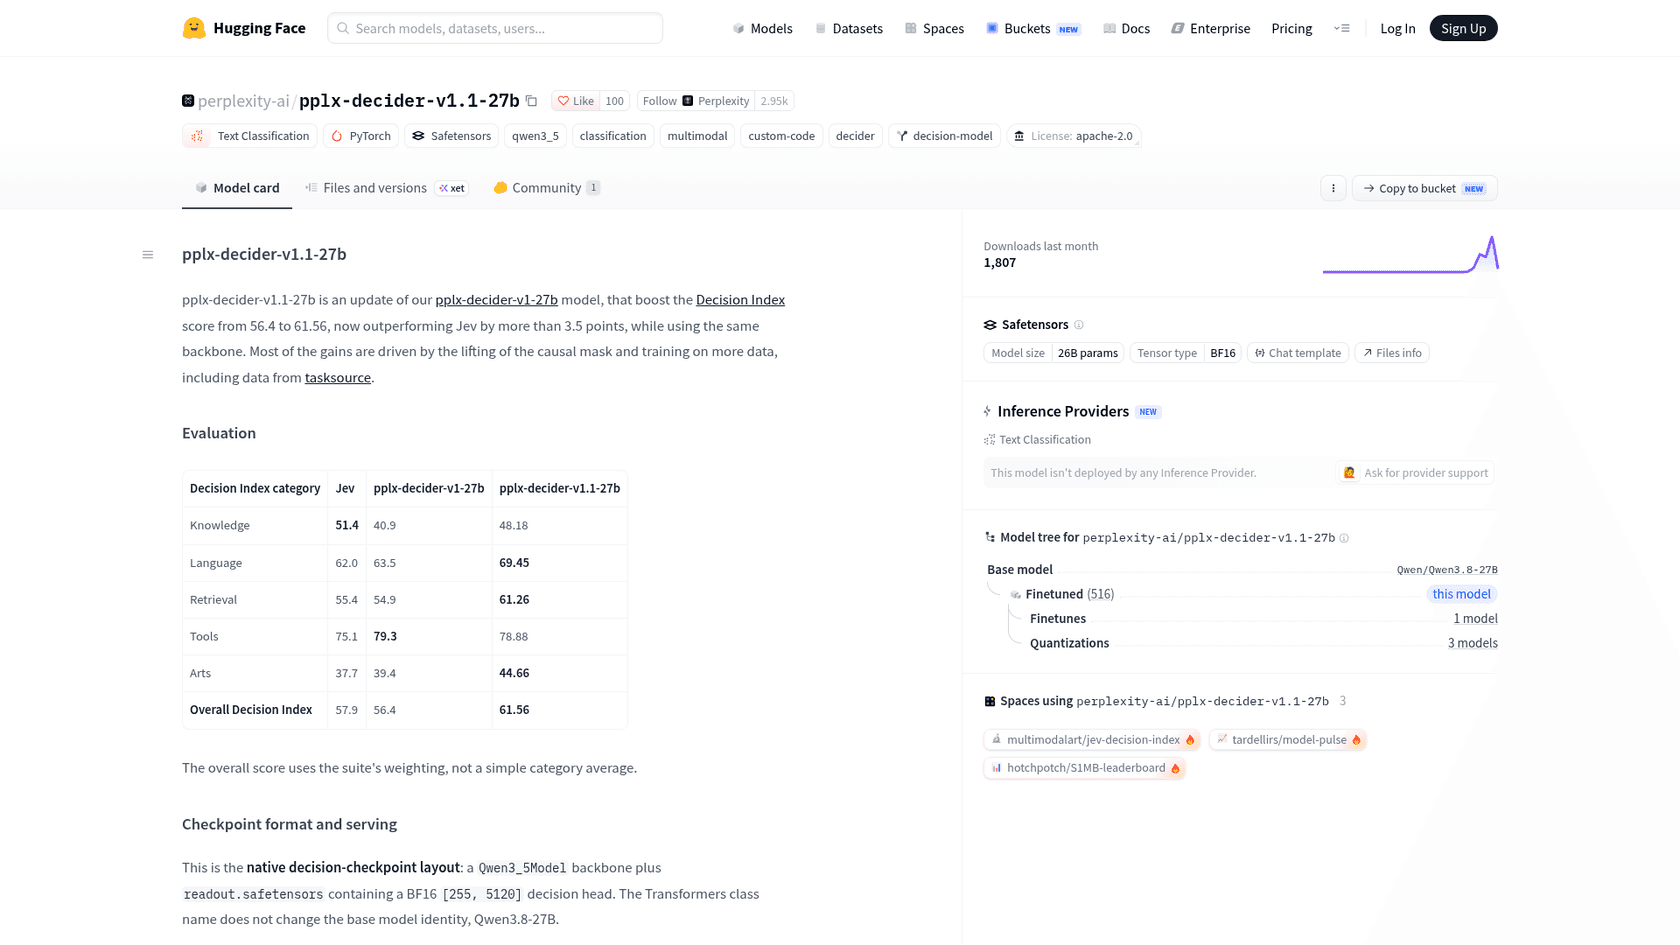
Perplexityのオープンな判定モデルで、Qwen3.8-27Bを別個の判定ヘッド付きでフルファインチューニングしたものです。Perplexityは、v1.1の改善の大部分は"the lifting of the causal mask"と学習データの増加によるものだと述べています。Hugging Faceからダウンロードし、付属のコードで動かします。
Microsoft-Decision-1に勝る点
- 独立したスコアで最高。 Decision Index v0.3.1で62.75の1位で、Jevの60.11を上回ります。
- 重みを自分で持てる。 Apache 2.0で、何もサーバーの外に出ません。
- 画像は、ファイルパス、PIL画像、base64のURLで渡せます。
劣る点
- 1回の判定あたり8,192トークンの厳格な上限があり、テキストと画像の合計です。
- 約49 GiBの重みと作業メモリを載せられるCUDA GPUと、ダウンロード用の認証済みHugging Faceアカウントが必要です。
- ホスト型APIはありません。モデルカードによると、これを提供する推論プロバイダーはありません。
- デフォルトの因果推論では評価時の構成を再現できないため、Perplexity自身のコードか、慎重なエクスポートを使う必要があります。
料金
ダウンロードは無料です。コストはGPUの時間です。コストについては、あるHacker Newsのコメント投稿者がうまく言い表しています。
"Open weight model pricing isn't really up to the company that built them (unless they are also serving them, in which case their API price may differ). It's really up to the serving cost and/or pricing of whoever is actually serving the model."
こんな人向け
GPUに余力があり、最も精度の高いオープンモデルを求めつつ、入力を短く保てるMLチーム。
6. Surogate Rune 26B-A4B v3
概要
Invergentのオープンな判定モデルで、Gemma 4 26B-A4B(トークンごとに128のエキスパートのうち8が有効)のフルファインチューニングです。choice、noul、scoreの質問に答え、オープンソースのsurogateエンジンで最も高速に提供されます。
Microsoft-Decision-1に勝る点
- 長い入力。 モデルカードは262kのコンテキストを謳い、Microsoftの8倍です。
- 画像に対応し、ビジョンタワーを維持しています。Invergent自身の画像テストでは、画像トークン1,120で83.4%でした。
- 任意の思考モード。
"thinking": trueを指定すると、自信のない質問は答える前に推論します。Invergentはこれで指数が約1.8ポイント上がると見積もっており、思考する質問1つあたり約5秒です。 - Microsoft自身の表では79.7%で、OpenAIのLunaに近い値でした。
劣る点
- ダウンロードは連絡先情報のフォームの先にあります。
- デフォルトの確率は自信過剰になりがちです。モデルカードは、キャリブレーションを直すために温度2で回答を読むことを推奨しています。
- Invergentは、RTX PRO 6000 1枚でリクエストあたりの中央値388 msを計測しており、Microsoftの主張より遅いです。
- Decision Indexでは10位(57.43)で、PerplexityとJevの後ろです。
料金
Apache 2.0でダウンロードは無料です。ハードウェア代を払います。
こんな人向け
長い入力や画像の多い入力が必要で、自分でサービングをチューニングできるセルフホスト派。
7. Strands Decider (AWS Strands Labs)
概要
AWSのStrands Labsによる小型のオープンな判定モデルで、ツール選択、ガードレール、ルーティングといったエージェントのステップ向けに作られています。リファレンスモデルはQwen3.5ベースの2Bで、10月10日と11日にGemma 4の4サイズが続きました。ローンチについてはStrands Deciderの記事で取り上げました。
Microsoft-Decision-1に勝る点
- 控えめなハードウェアで動く。 2Bは、Strands自身のテストでRTX 3090 1枚で中央値115 msを記録しました。
- 無料でオープン、Apache 2.0で、エージェント向けのより広いStrandsハーネスにも収まります。
--visionで任意の画像入力が使えますが、Strandsは画像での学習は一切行っていないと注記しています。
劣る点
- 精度はずっと低いです。Microsoftの表では36ベンチマークのうち23件だけで54.8%、Decision Indexでは84位(21.75)です。
- 3,072と4,096トークンのウィンドウでテストされました。
- Bedrockを含め、ホスト型APIはどこにもありません。
料金
無料です。自前のGPUまたはCPUを使います。
こんな人向け
小さなハードウェアでの速度が最高精度より重要な、安価でローカルなエージェントのガードレールやツール選択。
8. eesel (判断と作業の両方が欲しい場合)

概要
モデルではありません。上の7つの選択肢はインフラです。eeselは従業員です。ZendeskやFreshdesk、Gorgiasのキューに加わり、ルーティングの判断を下したうえで、返信を書いたりアクションを実行したりするAIヘルプデスクのチームメイトです。過去のチケットやヘルプセンターから学習します。
Microsoft-Decision-1に勝る点
- 構築するパイプラインがない。 しきい値、Webhook、ヘルプデスクAPIのつなぎ込みは不要です。
- 答えに基づいて動く。 タグ、優先度、エスカレーション、そして返信そのものまで行います。
- リスクのあるアクションは承認待ちにできるので、取り消せない操作の前に人が承認します。
劣る点
- 作業まで含むため、1回のモデル呼び出しよりチケットあたりはずっと高額です。
- ヘルプデスクの中で動きます。自社アプリのコード経路の中で判定が必要なら、モデルを使ってください。
料金
eeselのプランは月$299で500クレジットから始まり、チケット1件またはチャット1件が、長さに関係なく1クレジットです。5,000クレジットは月$1,749です。100クレジットで、カード不要の無料開始ができます。
こんな人向け
目的がモデルの配線ではなく、チケットを仕分けて回答することにあるサポートチーム。
Microsoft-Decision-1のどの代替を選ぶべきか
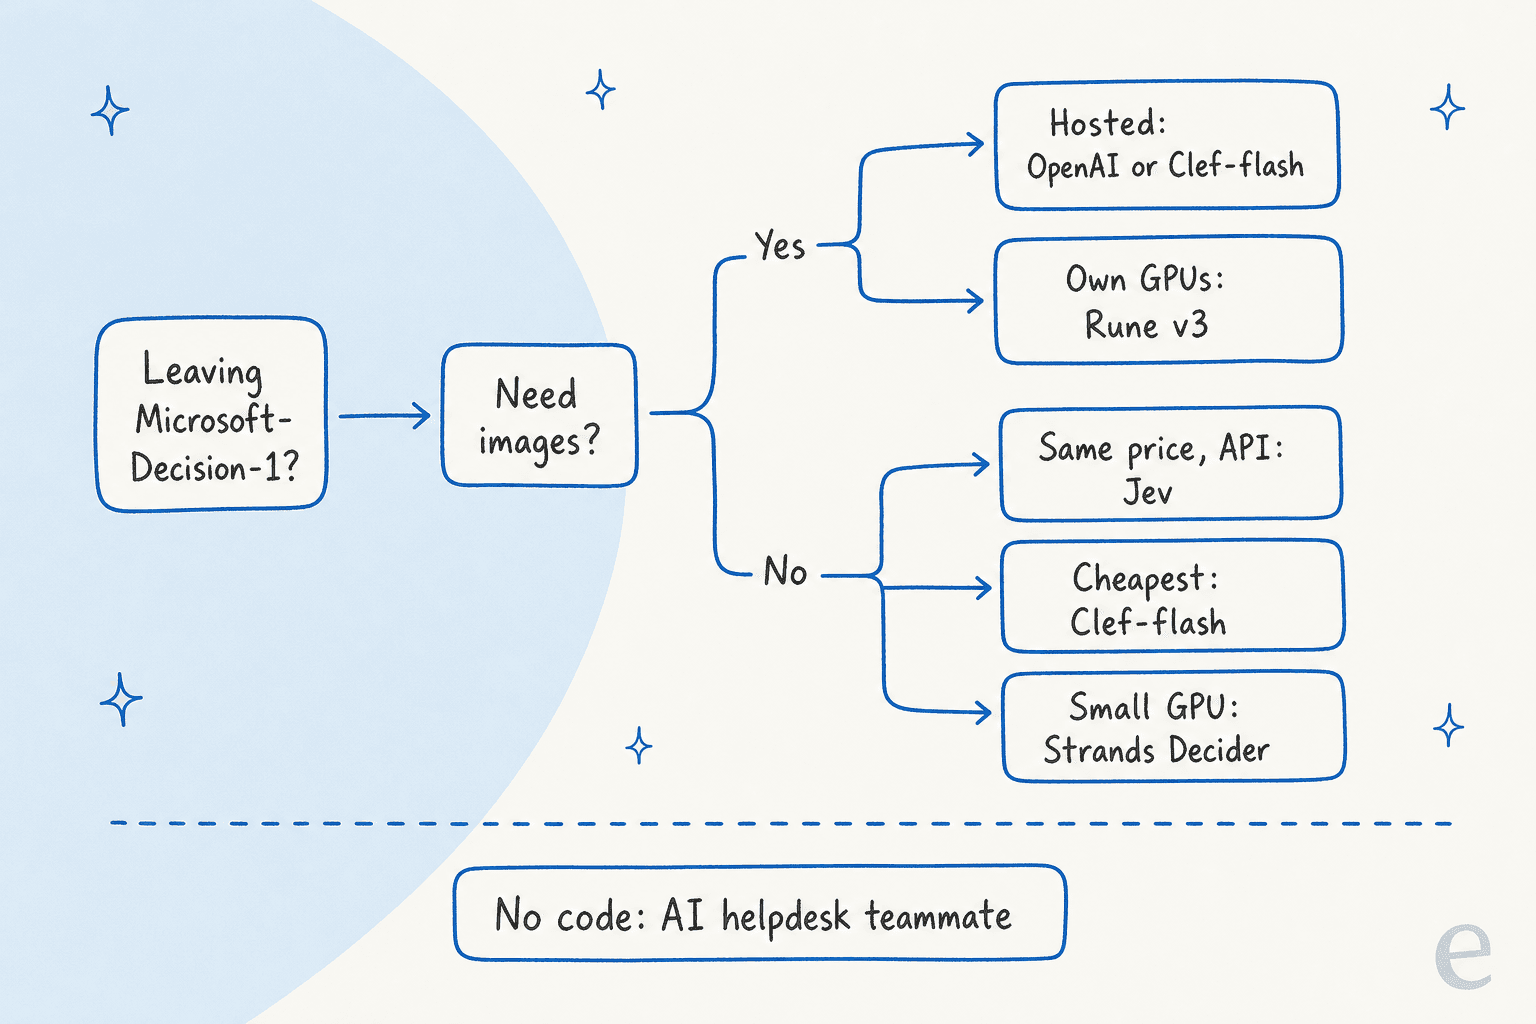
私の短いまとめです。
- 同じ仕事でAzureなし: 同じ価格のJev。まず自社のデータで両者を比べてください。
- 最も安い請求額: 入力が24,576トークンに収まるなら、Clef-flash。
- 画像や非常に長いスレッド: ホスト型ならOpenAIのDecisions API、セルフホストならRune v3。
- オープンで最高の精度: 8,192トークンで足りるなら、Perplexity Decider v1.1。
- 小型でローカル: エージェントのガードレール向けにStrands Decider。
サポートチームの用途は、ほぼ常にチケット分類とルーティングです。確率スコアが活きるのはそこで、モデルが確信を持てるものだけを自動化できます。実際のキューで難しいのはその後です。私たち自身のデータの例では、あるWeb3インフラ企業のAIが、連絡先リストから来た営業のコールドな売り込みを過去のZendeskチケットと突き合わせ、スパムと分類し、答えようとせずに丁寧な断りの文面を内部メモとして下書きしました。判定モデルが返すのは「スパム」というラベルです。履歴を読んでメモを書く作業は、まだ誰かがやらなければなりません。
タグ付けでの誤検知にも注意してください。エラー率1%は呼び出しごとには安上がりですが、返金のチケットを営業に回してしまうと高くつきます。トリアージに最適なAIのまとめでは、これを標準で扱えるツールを比較しています。
モデルは飛ばして、判断だけ手に入れる
チケットを振り分け、タグ付けし、優先順位を付けたくてMicrosoft-Decision-1の代替を比べているなら、モデルはそもそも要らないかもしれません。eeselはヘルプデスクの新入社員のように働きます。数分でZendeskやFreshdeskに接続し、過去のチケットを読み、判定モデルと同じトリアージの判断を下したうえで、顧客に回答します。本番のチケットに触れる前に、過去のチケットでシミュレーションできます。
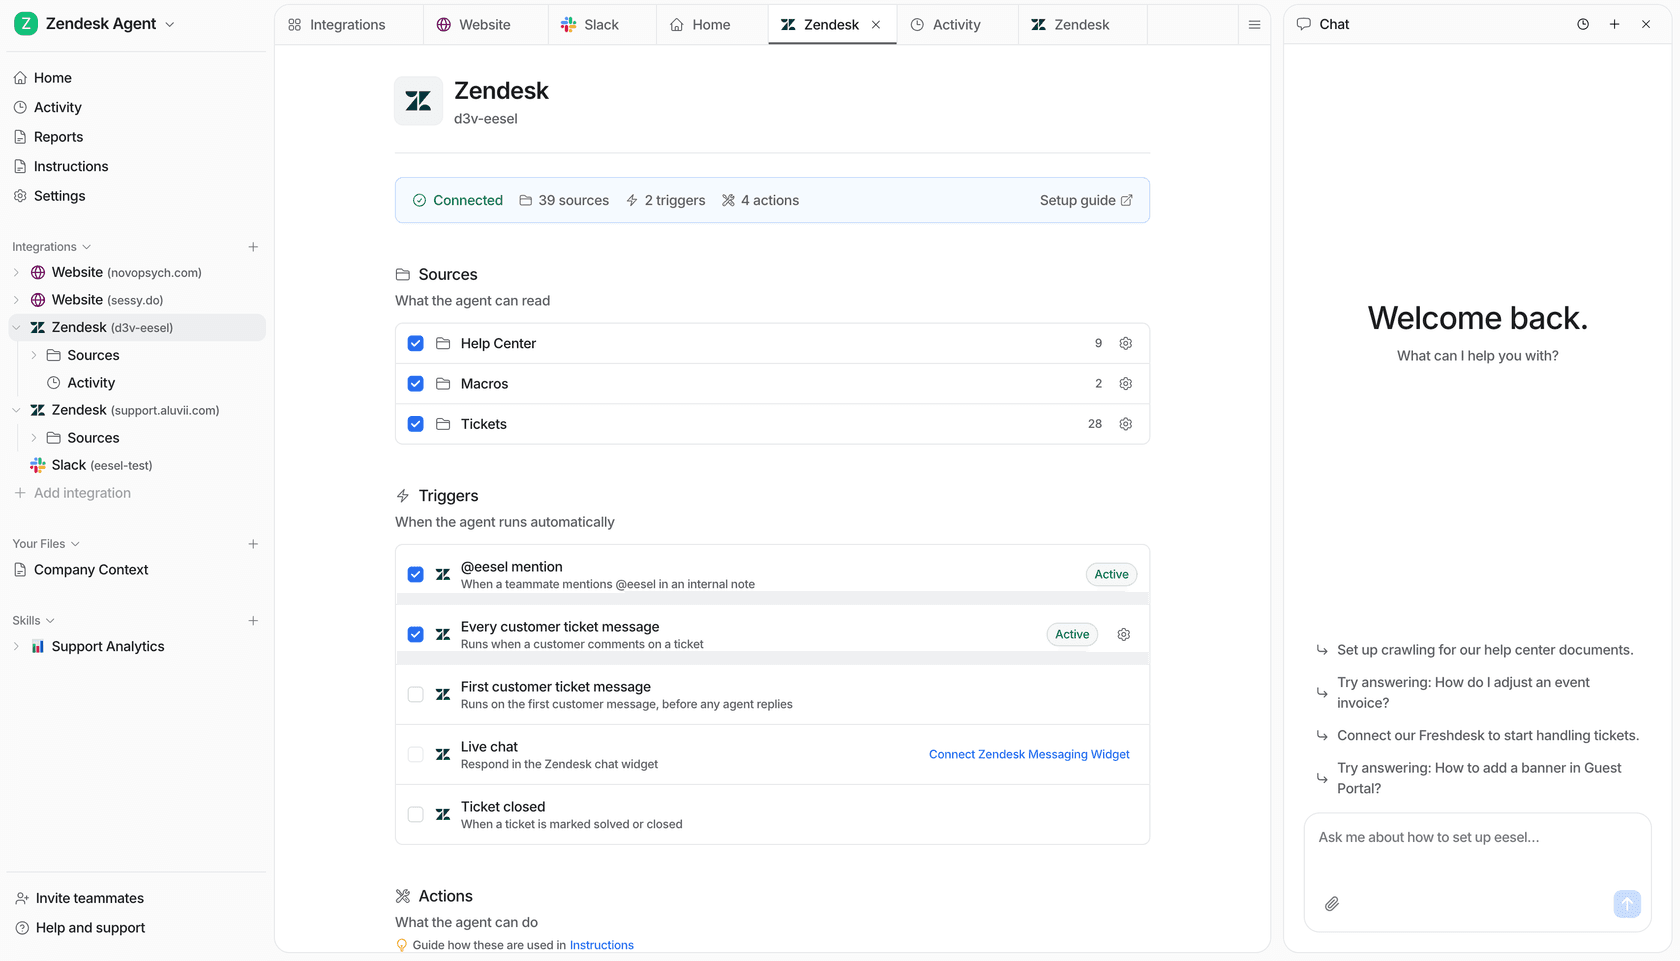
コードから操作したい場合、eesel CLIはダッシュボードと同じチームメイトを動かします。すべてのコマンドがJSONを出力するので、あなた、スクリプト、あるいはClaude Code、Codex、Cursorのようなコーディングエージェントが設定できます。eesel integrationsでヘルプデスクを接続し、eesel automations enable <platform> <key> --instructions "..."で普通の言葉でトリアージのルールを書き、eesel approvalsで保留中のアクションを一覧して承認または拒否します。これが重要な理由は、エージェントCLIの記事で詳しく書いています。
100クレジットでeeselを無料で試し、1週間分のチケットを向けてみてください。判定パイプラインと同じくらいうまく振り分けてくれるなら、構築の手間が省けたことになります。
よくある質問
Microsoft-Decision-1のおすすめの代替は何ですか?
最も近い乗り換え先はTypeSafeのJevで、入力100万トークンあたり$0.042と同じ価格です。OpenAIのDecisions APIは画像対応と非常に大きなコンテキストウィンドウが加わり、CloudflareのClef-flashは$0.038でホスト型として最安、Perplexity Decider、Rune v3、Strands Deciderは自分で動かせるオープンウェイトの代替です。
Microsoft-Decision-1より安い代替はありますか?
はい。CloudflareのClef-flashは入力100万トークンあたり$0.038で、Microsoftの$0.042より安く、どちらも出力は無料です。オープンウェイトのモデルはダウンロード自体は無料ですが、GPUの費用がかかります。Clefの料金の解説では、Workers AIの1日あたりの無料枠も取り上げています。
JevはMicrosoft-Decision-1より優れていますか?
Microsoft自身の36ベンチマークの表では、Microsoft-Decision-1の平均精度は83.5%、Jevは82.3%でしたが、キャリブレーションはJevの方が高くなっています(93.7対92.2)。価格は同じです。Jevは1リクエストあたり64kトークンを読み込めますが、Microsoftは32,768です。実際の挙動についてはJevのレビューで詳しく述べています。
Microsoft-Decision-1のオープンソースの代替はありますか?
Microsoftは重みを公開していないため、自前でホストすることはできません。Perplexity Decider v1.1、Surogate Rune 26B-A4B v3、CloudflareのClefモデル、AWSのStrands DeciderはいずれもApache 2.0で公開されています。現在、コミュニティのDecision IndexではPerplexity Decider v1.1が首位です。
画像に対応しているMicrosoft-Decision-1の代替はどれですか?
OpenAIのDecisions API、Cloudflare ClefとClef-flash、Perplexity Decider、Rune v3は画像を受け付けます。Microsoft-Decision-1とJevはテキストのみです。チケットトリアージのフローにスクリーンショットが含まれるなら、それだけで候補が絞られます。
Microsoft-Decision-1とOpenAI Decisions APIはどう違いますか?
OpenAIはgpt-6-lunaで入力100万トークンあたり$0.10を請求します。Microsoftの約2.4倍で、出力はやはり無料です。その代わり、画像、1,050,000トークンのウィンドウ、対象顧客向けのZDRとHIPAAのオプションが得られます。APIはまだ公開ベータです。Decisions APIの料金の記事もご覧ください。
サポートチケットを振り分けるのに判定モデルは必要ですか?
自社のプロダクトやパイプラインにルーティングを組み込む場合に限ります。ヘルプデスク内でチケットを仕分けして回答することが目的なら、AIヘルプデスクエージェントがコードなしで判断と作業の両方をこなします。チケットトリアージを自動化する方法のガイドでは、両方のやり方を紹介しています。