

Microsoft-Decision-1とは?
Microsoft-Decision-1は、意思決定にスコアを付けるモデルです。テキスト(MicrosoftとOpenRouterはstateと呼びます)と、固定の回答候補を持つ1つ以上の質問を渡すと、各回答の確率が返ってきます。インターフェースはこれだけです。
Microsoftは2026年10月9日、CTO室のソフトウェアエンジニアリング担当VPであるAchint Srivastava氏による、Command Lineブログの投稿で発表しました。投稿によると、「ルーティング、分類、優先順位付け、検証、ワークフロー制御」向けに作られています(Microsoft)。Satya Nadellaも同日にこのリリースを投稿し、Microsoftはすでにインシデント対応、品質管理、科学的発見の分野で社内テストを行っていると述べています(XのSatya Nadella)。
このカテゴリが初めての方は、意思決定モデルの解説に背景をまとめています。簡単に言えば、TypeSafe Jevが2026年9月にこのカテゴリを始め、Cloudflare、AWS、OpenAIが数週間以内に続き、Microsoft-Decision-1は自社クラウドでモデルを販売するハイパースケーラーとしては初の参入です。
何ではないかも、何であるかと同じくらい重要です。Microsoftのモデルカードには、「テキスト生成、自由回答の質問応答、会話、翻訳、要約向けには設計されていません」とあります(Foundryカタログ)。返信も要約もコードも書けません。選ぶだけです。
Microsoft-Decision-1はどう動く?
私は日々eeselのエージェント側を作っているので、まずこの部分を調べました。仕組みは、発表記事から受ける印象よりずっとシンプルです。
MicrosoftはAlibabaのオープンウェイトモデルQwen3.5-9Bを取り、「高速な1回のパスによる意思決定スコアリング」向けに追加学習させ、「近くMicrosoft AI(MAI)やOpenAIなど、他のモデルに切り替える予定」としています(Microsoft)。学習データは「Microsoftのオープンデータプロセスの対象となる公開データセットと、チームが作成した合成データ」です(Foundryカタログ)。ベースのQwenは、CloudflareのClef-flashやAWSのStrands Deciderと同じファミリーです。
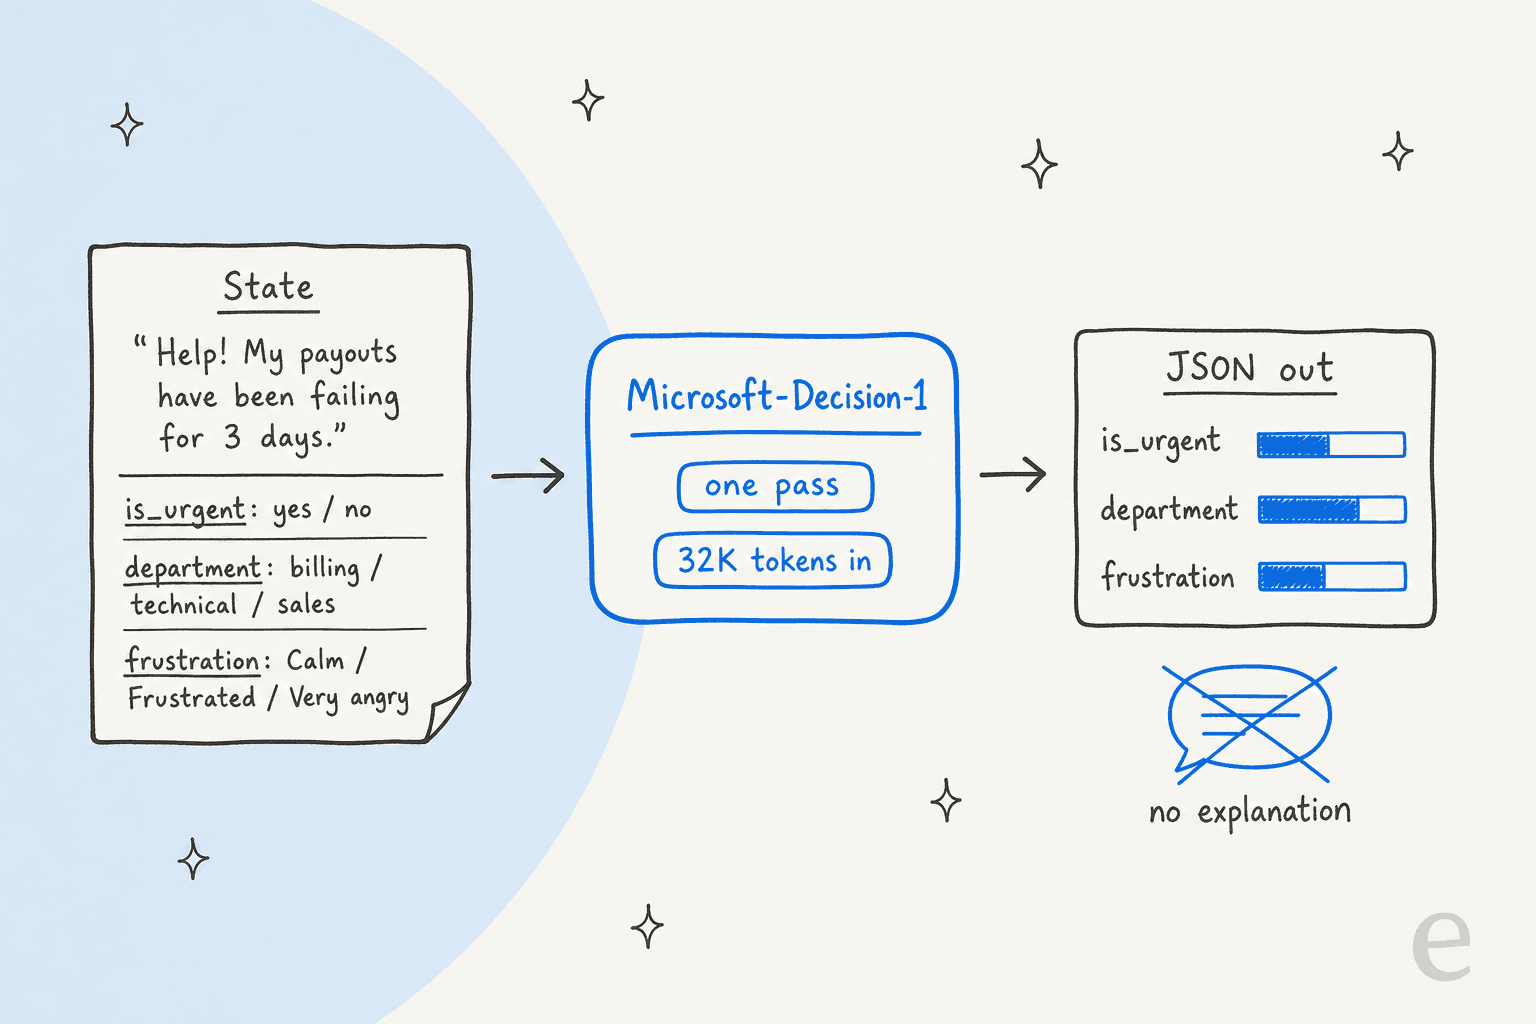
わかりやすく言うと、1回の呼び出しで3つのことが起こります。
- ステートと全質問を一度だけ読みます。 最大32,768トークンのテキストが入ります。Microsoftはこれを「シングルパススコアリング」と呼んでいます(Foundryカタログ)。
- 許可された各回答にスコアを付けます。 「billing」を1文字ずつ書く代わりに、billing、technical、salesの確率を同時に割り当てます。
- JSONを返して終了します。 理由は付きません。モデルカードには、モデルが「説明や根拠を生成しない」とはっきり書かれています。
質問タイプは、Jevユーザーにおなじみのものと同じです。OpenRouterでは、1つのリクエストに同じステートに対する名前付きの質問を複数含められます(OpenRouter)。
| 質問タイプ | 問う内容 | 返ってくるもの | サポートでの例 |
|---|---|---|---|
noul | これは真か? | 0(いいえ)から1(はい)の確率1つ | 「このメッセージは緊急性を伝えているか?」 |
choice | どの選択肢が合うか? | 選ばれた候補と、各候補の確率 | 「請求、技術、営業のどれか?」 |
score | この尺度のどこか? | 順序付きの評価基準上の位置 | 「落ち着いている、不満、非常に怒っているのどれか?」 |
Microsoftのカタログには、さらにいくつかの機能が載っています。AI応答やエージェントの行動に対する評価基準ベースの採点、提示された根拠に対する根拠性チェック、安全性チェック、そして「明示的な棄権」、つまり根拠が乏しいときの「判断できない」といった選択肢です(Foundryカタログ)。最後の機能は過小評価されています。「ここには判断できるだけの材料がない」と言えるモデルは、実際のキューの前に置きやすくなります。
こちらがOpenRouterのサンプルリクエストを少し短くしたものです。サポートチケットなので、MicrosoftとOpenRouterが最初の購入者として誰を想定しているかがわかります。
const decision = await openrouter.alpha.decisions.create({
  decisionsRequest: {
    model: "microsoft/microsoft-decision-1",
    state: "Help! My payouts have been failing for 3 days.",
    questions: {
      is_urgent: {
        type: "noul",
        instructions: "Does this message convey urgency?",
        criteria: { true: "Explicitly time-sensitive", false: "No urgency expressed" }
      },
      department: {
        type: "choice",
        instructions: "Which team should handle this?",
        criteria: {
          billing: "Payments, invoicing, refunds",
          technical: "Bugs, outages, integrations",
          sales: "Pricing, upgrades, new accounts"
        }
      },
      frustration: {
        type: "score",
        instructions: "How frustrated is the customer?",
        criteria: ["Calm", "Frustrated", "Very angry"]
      }
    }
  }
});
あとはコードが回答を読み、たとえばis_urgentが0.8を超え、かつ部門が請求ならエスカレーションする、といった判断をします。このしきい値のロジックが要点です。汎用LLMのJSONモードと比べてみてください。出力トークンのたびに料金がかかるうえ、得られるのは、信頼度が付かないラベルです。
Microsoft-Decision-1にはどうアクセスする?
入口は2つあり、挙動が異なります。
Microsoft Foundry、「Direct from Azure」。 カタログでは、Microsoft-Decision-1はバージョン1、ライフサイクルは「Generally available (GA)」、入力はテキスト、出力はJSON、コンテキストウィンドウは32,768トークンと記載されています(Foundryカタログ)。Microsoft Learnのドキュメントでは、Azureが直接販売するモデルに分類されており、そうしたモデルは「Azureサブスクリプション経由で請求され、Azureのサービスレベル契約の対象となり、Microsoftがサポートします」(Microsoft Learn)。すでにAzure OpenAIモデルを購入しているなら、これは慣れた調達経路です。
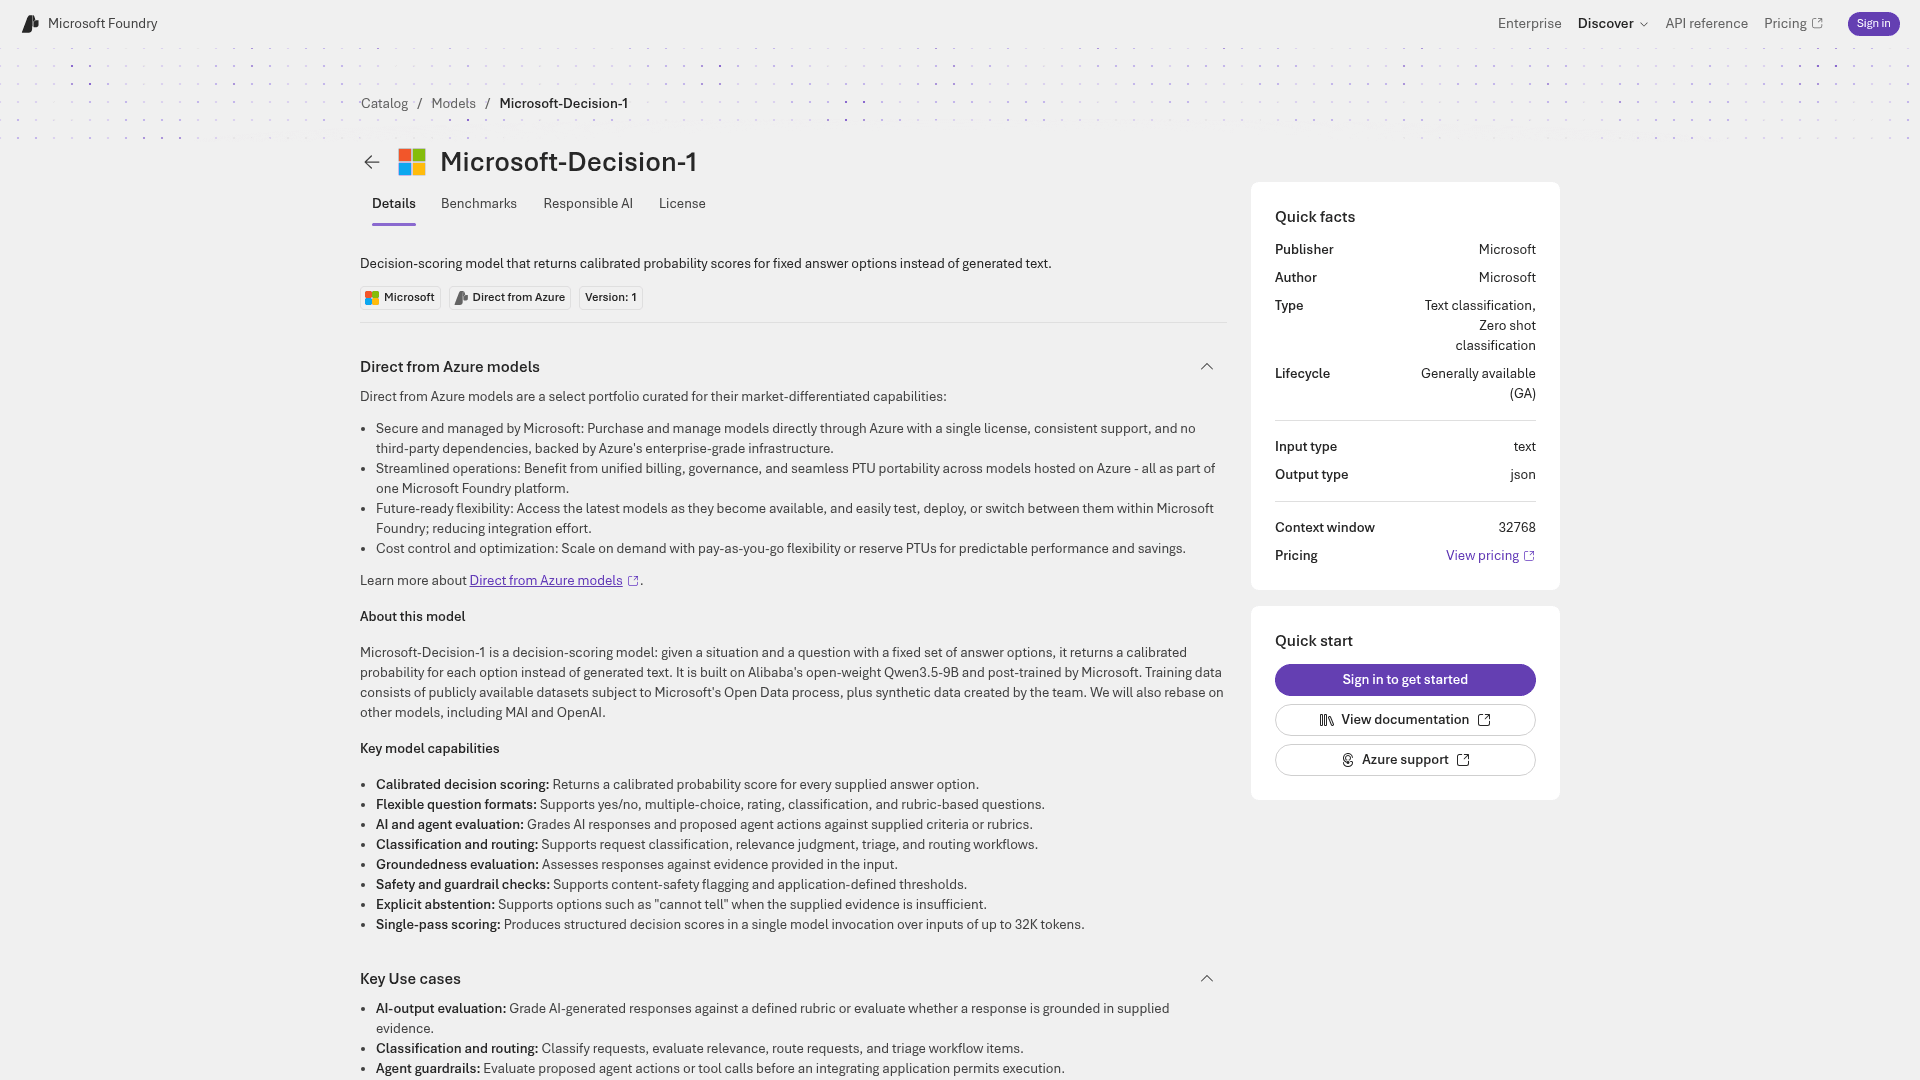
OpenRouterのDecisions API。 Azureアカウントは不要です。モデルIDはmicrosoft/microsoft-decision-1で、POST https://openrouter.ai/api/alpha/decisionsで動き、OpenRouterは「チャット補完SDKは使えません」と注意しています(OpenRouter)。背後のプロバイダーはAzureだけなので、すべてのリクエストは結局Microsoftのインフラに届きます。
| Microsoft Foundry | OpenRouter | |
|---|---|---|
| ステータス | GA、バージョン1 | 2026年10月9日から提供中 |
| アカウント | Azureサブスクリプション | OpenRouterキー |
| 請求 | Azureの請求書 | OpenRouterクレジット |
| SLA | AzureのSLAが適用 | AzureのSLAではない |
| リクエスト形式 | まだ公開ドキュメントなし | Decisions APIとして文書化済み |
| モデル更新 | カタログ上はバージョン1 | 「APIの形を保ったまま、ウェイトは継続的に更新されます」 |
| 測定速度 | p50で85ミリ秒、Microsoft自身のテスト | 最良プロバイダーのp50で0.19秒、OpenRouterの測定 |
この表の2行は、本番導入のしかたを変えるものです。1つ目は、Foundryは本番環境としてより安全ですが、リクエスト形式がまだ公開されていないことです。初日にデプロイしたHacker Newsのユーザーはこう書いています。
「探す場所が間違っているだけかもしれませんが、APIの形がどうなっているのか見つかりません。Foundry経由でこのモデルをデプロイまでしたのに、何をPOSTして何が返ってくるのか書かれていません。」

10月11日に確認した時点でも、このモデルのLearnのハウツーページはありませんでした。2つ目は、OpenRouterがウェイトを継続的に更新するとしているため、先月調整したしきい値が知らないうちにずれる可能性があることです。confidence > 0.9でルーティングしているなら、更新のたびに見直してください。
Microsoftのベンチマークは何を主張している?
Microsoftの発表記事は、「学習から切り離された」147,137問をカバーする36ベンチマークの比較から始まります(Microsoft)。公開された表の要点は次のとおりです。
| モデル | 平均精度 | 中央値レイテンシ | 較正(100=完全) |
|---|---|---|---|
| Microsoft-Decision-1 | 83.5% | p50で85ミリ秒、p95で125ミリ秒 | 92.2 |
| Jev 1.13.0 | 82.3% | 240ミリ秒 | 93.7 |
| Quyet-1.0-Large | 81.9% | 380ミリ秒 | 93.1 |
| GPT-6 Luna Decisions | 79.4% | 300ミリ秒 | 89.9 |
| H2O-Lightning-4B v1.1 | 77.2% | 210ミリ秒 | 91.8 |
| Strands-Decider 2B(36中23ベンチマーク) | 54.8% | 未測定 | 未採点 |
| GPT-6 Sol(参考) | 順位なし | 3.01秒 | 未採点 |
出典:Microsoftの発表。Microsoftはまた、摂動を加えた場合に回答が変わる割合は平均1.3%で、選択肢の言い換え、反転、シャッフルでは変化がゼロだったと報告しています。安全性テストは11のベンチマークで5,250件のリクエストをカバーしました。
この数字を引用する前に、脚注を読んでください。各競合のレイテンシは、10月7日に確認したJevBench v1.6.1の調整済み中央値によるものです。一方、Microsoft-Decision-1の85ミリ秒は「同じリージョンのFoundry経由で測定」されたものです。同じ条件の比較ではありません。さらに較正ではMicrosoftは3位で、Jevに1.5ポイント差をつけられています。信頼度のしきい値を超えたら自動で動かす予定なら、精度のリードよりこちらのほうが重要です。
当初、Jevは表に載っていませんでした。Nadellaのリリース投稿への返信で最も「いいね」を集めた335件の返信はこうでした。
「なぜJevがランク外なのか?みんながこれと比べる相手として、文字どおりナンバーワンのモデルなのに。」
発表記事には現在、「元の記事から更新し、精度と較正についてJevのベンチマークを追加した」という編集者注が付いています。素早く修正したMicrosoftは評価できます。比較対象となっているモデルについては、Jevレビューでさらに詳しく書いています。
社内の結果は薄いものの興味深いです。Microsoftによると、Copilotチームは「GPT5.6 Lunaに匹敵し、100倍高速」と評価し、XBOX Researchチームは10,000件を超えるフィードバックを処理して、GPT-6 Solより「14倍以上高速で、200分の1のコスト」だったとのことです(Microsoft)。Microsoftのチームが自社のモデルを評価したものなので、証明ではなく、ユースケースの手がかりとして扱います。
独立した測定でわかっていることは?
リリースから2日目なので、まだ多くはありません。Microsoft外部で確認できたことをすべて挙げます。
OpenRouterは、提供する全モデルについて独自のレイテンシを公開しています。3日間で、最良プロバイダーのp50は0.19秒、平均p50は0.27秒、p99は0.67秒、可用性は99.90%でした(OpenRouter)。
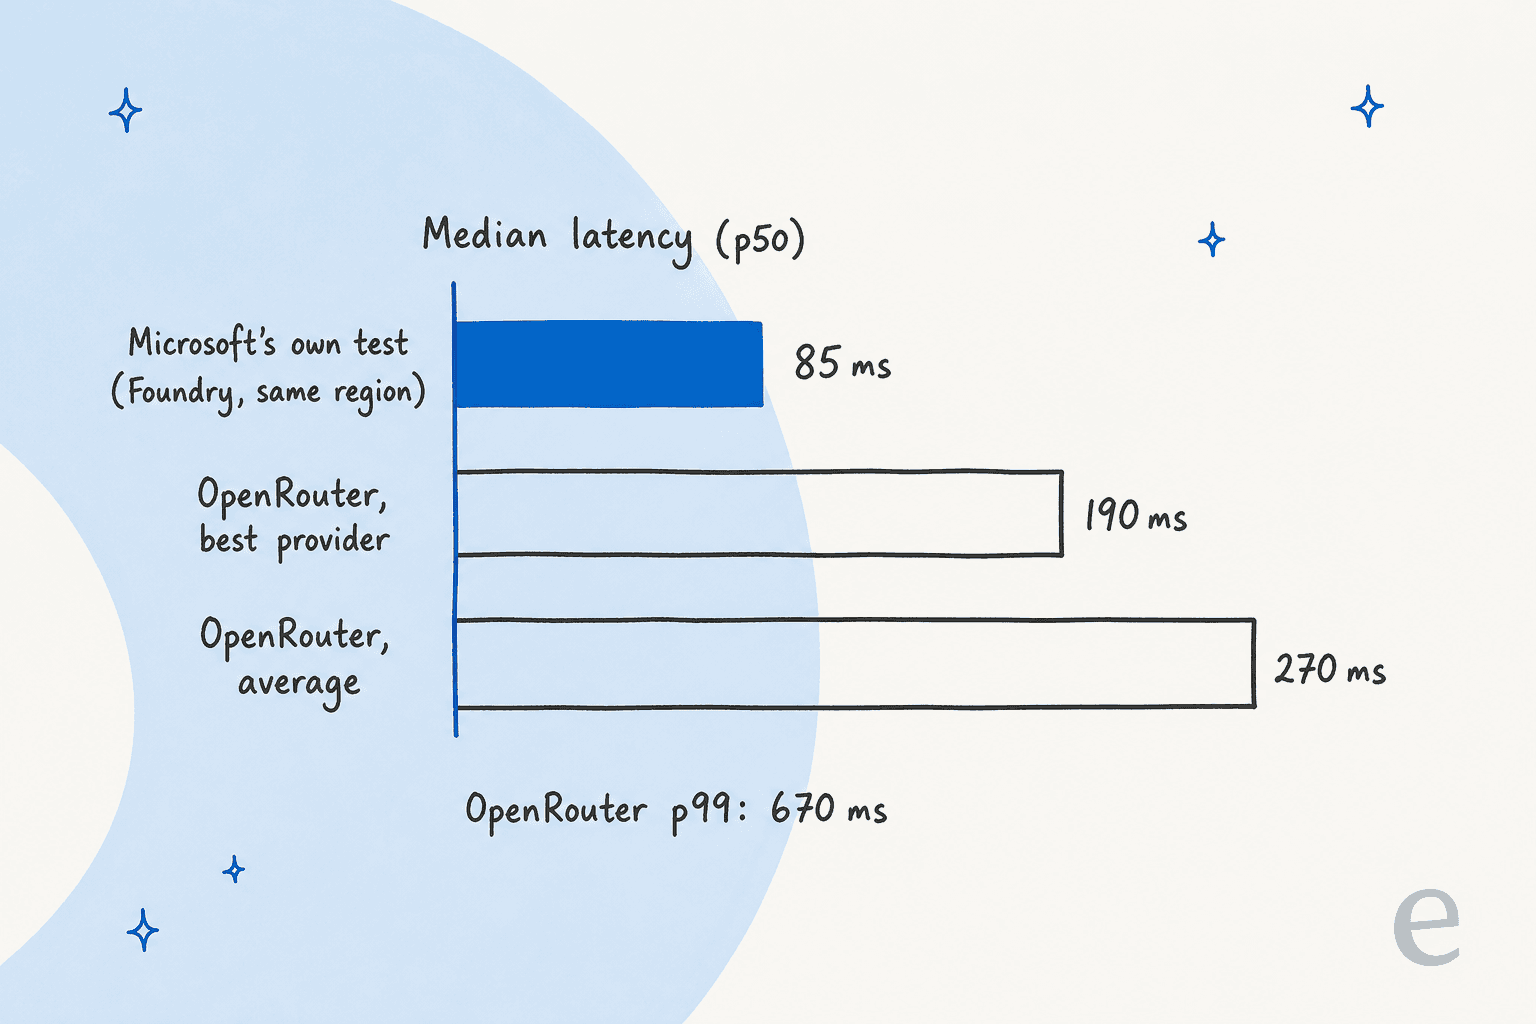
この差は、Microsoftの数字が間違っているという意味ではありません。Microsoftの数字はモデルのすぐ隣で測定され、OpenRouterの数字にはルーター経由のホップが含まれます。ただ、公共のインターネット経由で呼び出すなら、85ミリ秒ではなく、およそ200〜300ミリ秒を見込んでください。チケット1件に対するルーティング1回なら、それでも瞬時です。20回の判断を連鎖させるエージェントなら、Microsoft自身の計算が当てはまります。「20回の連続した判断それぞれに100ミリ秒を足すと、ワークフロー全体で2秒増える」。
私が見つけた唯一の実機比較は、Jevと比べたHacker Newsのコメンターによるものです。
「私の小さなテストスイートでは、Jevより安く(0.72倍)、レイテンシは高かった(p50で283ミリ秒対369ミリ秒)。私が測定するどのシナリオでも結果はほぼ同等で、これまで試した中で、商用リリースとしての存在意義を実際に示した最初のモデル。」
1人の小さなスイートによるものですが、おおよそJevと同等の回答を、Jevと同等の価格で、という話の形とは合っています。
欠けているもの:コミュニティ運営のJev Decision Indexは10月10日に117エントリーでv0.3.1に更新されましたが、Microsoft-Decision-1は入っていません。このボードの新しいFullスコアでJevは60.11で、明確な基準が待っています。利用もまだ初期です。OpenRouterの意思決定ランキングの今週の数字では、Jev 1.13が9億9,900万リクエスト、GPT-6 Luna Decisionsが1,170万、Microsoft-Decision-1はトップ10圏外です。
制限事項と不明点は?
本番に入れる前に、このセクションは2回読むことをおすすめします。意図的な範囲の選択もあれば、リリース週のドキュメントの空白もあります。
- 説明なし。 スコアを返すだけで、理由は返しません。サポートリーダーに「なぜこれが請求に回ったのか」と聞かれても、モデルは答えられません。
- テキストのみ、コンテキストは32K。 ClefやOpenAIのDecisions APIと違い、画像やスクリーンショットは使えません。引用履歴付きの長いメールスレッドは上限に達する可能性があります。
- オープンウェイトなし。 Hugging FaceのURLは404を返すため、セルフホストやファインチューニングは選べません。
- リージョン、レート制限、クォータが未公開。 Azureのリージョン提供状況ページに載っておらず、カタログのライセンスタブはサインインしていない訪問者には表示されなかったため、ライセンス条件は読めませんでした。
- Azureの料金表にまだ載っていない。 0.042ドルという料金は発表とOpenRouterにありますが、Foundry Modelsの料金ページには該当行がありません。その意味は、Microsoft-Decision-1の料金の記事で詳しく解説しました。
- 対象外の用途。 Microsoftは、「信用、雇用、住居、保険、教育、医療、法的権利に関わる意思決定の唯一の根拠として使用すべきではない」と述べています(Foundryカタログ)。
最初の点は、195ポイント、65コメントに達したHNスレッドで最も鋭いコメントを呼びました。
「ある判断の理由を知る手がかりなしに、『意思決定』モデルの出力を使うのは、ずいぶん信頼しすぎに思える。」
私も同感ですが、ひとつ付け加えます。モデルが何を見て、何を選び、どの信頼度だったかを記録し、信頼度の低いケースを人に回すなら、モデル自身に説明させる必要はありません。サポートボットでAIのハルシネーションを防ぐときに私が使うのと同じ規律です。実際の履歴でテストし、リスクの高い判断には関門を置き、記録を残します。
Microsoft-Decision-1はJev、Clefなどとどう比較できる?
Microsoft-Decision-1は、混み合った分野に登場しました。誰が誰かの早見表です(2026年10月11日確認)。
| モデル | 提供元 | 入力価格(100万あたり) | コンテキスト | 入力 | オープンウェイト | 実行場所 | Jev Decision Index v0.3.1 |
|---|---|---|---|---|---|---|---|
| Microsoft-Decision-1 | Microsoft | 0.042ドル、出力無料 | 32,768 | テキスト | なし | Foundry、OpenRouter | 未掲載 |
| Jev 1.13 | TypeSafe | 0.042ドル、出力無料 | 1リクエストあたり64K | テキスト | なし | TypeSafe API、Workers AI、OpenRouter | 60.11(2位タイ) |
| Clef | Cloudflare | 0.24ドル | 65,536 | テキスト、JSON、画像、動画 | あり、Apache 2.0 | Workers AI | 53.08(19位) |
| Clef-flash | Cloudflare | 0.038ドル | 24,576 | テキスト、JSON、画像、動画 | あり、Apache 2.0 | Workers AI | 47.61(33位) |
| OpenAI Decisions API | OpenAI | 0.10ドル、出力無料 | GPT-6 Lunaの1,050,000 | テキスト、画像 | なし | OpenAI API、パブリックベータ | 未掲載 |
| Strands Decider 2B | AWS Strands Labs | セルフホストなら無料 | 3,072〜4,096で実行 | テキスト | あり、Apache 2.0 | 自前のハードウェア | 21.75(84位) |
出典:各ベンダー自身のドキュメント(たとえばCloudflareのClefページやOpenAIのDecisionsガイド)と、10月10日時点のDecision Indexのデータ。
いくつか目に付く点があります。MicrosoftはJevの価格にぴったり合わせており、トークン単価でより安いのはClef-flashだけです。ClefとOpenAIのAPIは画像を受け付けますが、Microsoftは受け付けません。さらにOpenAIは、はい/いいえのタイプをnoulではなくpredicateと呼ぶため、移行は単純なURLの置き換えでは済みません。そのAPIのコストは、Decisions APIの料金の解説で取り上げました。
Microsoft自身の発表に載った価格比較には、反発もありました。Microsoftのコストグラフでは、Microsoft-Decision-1は分類テキスト100万件あたり約11ドル、GPT-6 Solは約2,434ドルです。あるHNのコメンターは、欠けているものを指摘しました。
「Microsoftは自社の価格をGPT Sol(!)としか比べていません。GPT TerraともGPT Luna(OpenAIのJev追随モデルのベース)とも比べておらず、当然Jev(Lunaの4/10のコスト)とも比べていません。」
もっともな指摘です。GPT-6 Lunaのような汎用モデルと比べれば、どの意思決定モデルも安く見えます。実際の同類と比べると、Microsoft-Decision-1は同額で、安くはありません。分野全体を比較検討するなら、Jevの代替モデルのまとめでモデルごとに見ていきます。
Microsoft-Decision-1はあなたの用途に合っている?
いちばん近い状況を選んでください。
速度が最優先の基準なら、Jev Ultrafastの解説で、Microsoftの速度訴求に最も近い競合であるTypeSafeの低レイテンシ版を取り上げています。
Microsoft-Decision-1はサポートチームにとって何を意味する?
サポートは誰もが真っ先に思い浮かべるユースケースで、それには十分な理由があります。チケットの振り分けは、固定の答えを持つ小さく限定された質問の集まりです。インテント分類はchoiceの質問です。緊急度と感情分析は固定尺度のスコアです。「人が見るべきか?」は、AIエスカレーションの核心であるはい/いいえの質問です。Microsoft-Decision-1は、そのすべてに1回の呼び出し、1セントにも満たない費用で答えられます。
ただ、盛り上がる前にすべてのサポートリーダーに知っておいてほしいことがあります。振り分けは、すでにうまくいっている部分だということです。
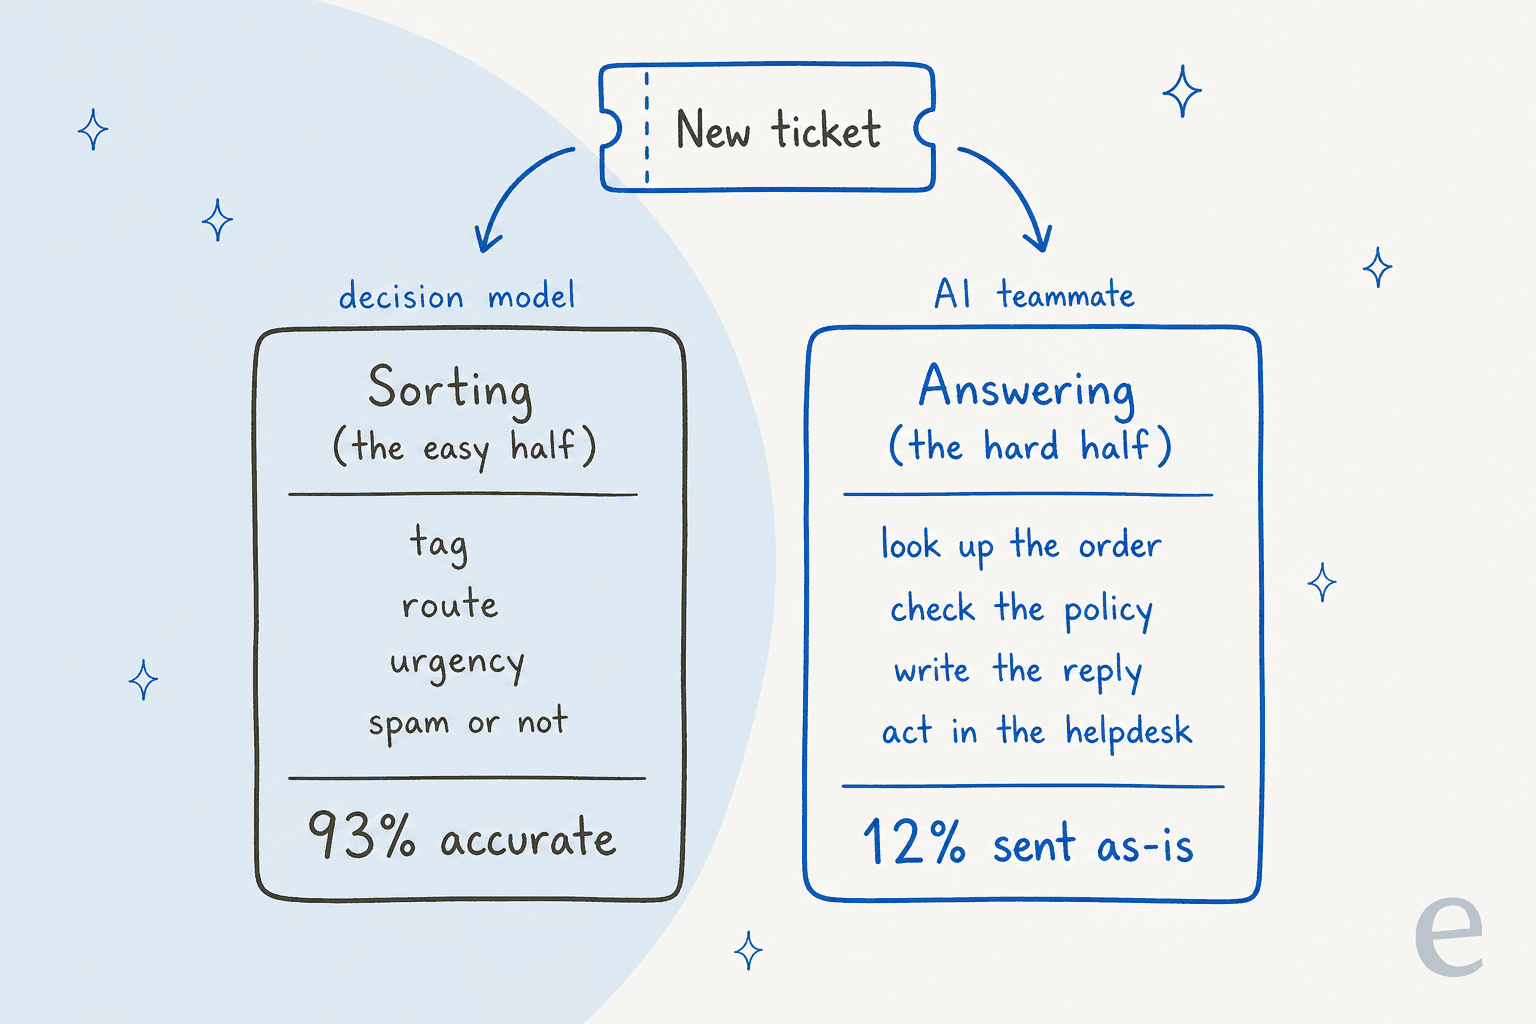
これらの数字は、私が見たEコマース企業の実際のZendeskトラフィックでの交差検証済みの試験によるものです。AI振り分けの精度は93%で、受信トレイの22%を占めたスパムの100%を、誤検知ゼロで捕捉しました。作成された返信は88%の確率で正しい方向を向いていました。しかし修正なしで送られたのは12%だけで、7%に事実誤認が含まれていました。ラベル付けは簡単でした。答えを書くことこそが仕事でした。
これは、eeselの購入者が実際に求めていることとも一致します。月7,000件のチケットを扱うCXリーダーは、通話でこう語りました。
「AIが100%の質問に答えられることはありませんが、試したうえで『申し訳ありません、わかりません』と答えるだけでは、7,000件のチケットを全部見て、AIが本当に良い回答をしたか確認することはできません。」
求められているのは、まず自信を持った判断(これは自分が対応できるものか?)、次に行動です。意思決定モデルは、最初の部分を数値として返します。その数値を、Zendeskのタグ、担当の振り替え、承認待ちの返金、ブランドの声での返信に変えるのは、モデルの周りにあるすべての仕組みです。だからこそ、Microsoft-Decision-1は、自前のAIチケットルーティングを構築するチーム向けの部品として扱い、単体のサポートツールとは見ません。
自分で構築するなら、順序の目安は次のとおりです。
- 振り分け担当者がすでに答えている質問から始める。 チーム、緊急度、スパム、チケット優先度付けのレベル。ヘルプデスクと同じラベルを使った
choiceとscoreの質問として書きます。 - 過去1か月分のチケットを再生する。 平均1つではなく、ラベルごとに、モデルの選択とチームが実際に行ったことを比較します。
- 質問ごとにしきい値を決める。 それ以上は自動でルーティングし、それ未満は人に回し、どちらもログに残します。
- 単純なルールが機能する場所では残す。 件名の「返金」が常に請求を意味するなら、Zendeskのルーティングルールは無料で、ずれることもありません。
- 誰が返信を書くか決める。 それは意思決定モデルにはできない部分で、顧客が実際に目にする部分です。
選択肢をもっと広く見たい場合は、AI振り分けツールのまとめで各ヘルプデスクの現在の組み込み機能を比較しています。チケット振り分けを自動化するガイドは、セットアップを最初から最後まで説明します。
チケットの振り分けと返信をeeselで試す
Microsoft-Decision-1はインフラです。コードが判断を下すための、高速で安価な手段です。eeselは、判断を下したうえで仕事までこなす従業員です。AIヘルプデスクチームメイトは、Zendesk連携、Freshdesk、Gorgiasを通じて既存のキューに参加します。タグ付け、ルーティング、エスカレーションを行い、ヘルプセンターと過去のチケットから返信を書きます。
この記事が繰り返し述べてきた役割分担は、すでに組み込まれています。各自動化には「モデル強度」の設定があり、「タグ付けやルーティングのような簡単な作業には軽量なもの」、下書きには通常のモデルを使えます(eeselドキュメント)。すべてのアクションは、自動、承認が必要、無効のいずれかに設定でき、エージェントがスキップしたイベントは理由付きでログに残ります。本番に出す前に、過去のチケットでエージェントをシミュレーションし、チームの返信とどこで一致したかを確認できます。

ターミナルから設定したい場合は、eesel CLIがダッシュボードと同じチームメイトを動かします。すべてのコマンドはJSONを出力するので、Claude Code、Codex、Cursorがセットアップ全体を操作できます。eesel automations enable <platform> <key> --instructions "..."のようなコマンドで、振り分けルールを自然な言葉で設定でき、eesel approvalsは承認または却下を待つ保留中のアクションを一覧し、--dry-runは書き込み前に確認します。これがなぜ重要かは、エージェントCLIの記事で詳しく書きました。
料金は固定の月額クレジットプランです。1チケットは、内部でどれだけの作業が行われても1クレジットで、500クレジットで月299ドルからです。カード不要で試せる100クレジットが無料で付きます。ヘルプデスクを接続し、先月のチケットに向けて、どう振り分け、何を返信しただろうかを確認してください。eeselを試す。
よくある質問
Microsoft-Decision-1とは何ですか?
Microsoft-Decision-1は、Microsoftが2026年10月9日に公開した意思決定モデルです。テキストと固定の回答候補を渡すと、文章を書く代わりに、各候補の較正済み確率をJSONで返します。ルーティング、分類、検証の呼び出し向けに作られた、急速に増えつつある意思決定モデルの1つです。
Microsoft-Decision-1は何をベースにしていますか?
Microsoftによると、AlibabaのオープンウェイトモデルQwen3.5-9Bを、1回のパスで意思決定をスコアリングできるよう追加学習させたもので、今後Microsoft AI(MAI)やOpenAIのモデルに切り替える予定です。Qwenファミリーは、CloudflareのClef-flashやAWSのStrands Deciderの基盤にもなっています。
Microsoft-Decision-1はどう使いますか?
方法は2つあります。Azureが直接販売し、Azureサブスクリプションに請求されるMicrosoft Foundryカタログからデプロイするか、モデルIDmicrosoft/microsoft-decision-1を指定してOpenRouterのDecisions API経由で呼び出します。チャット補完SDKは使えないため、TypeSafe Jevと同様に、型付きのリクエストを用意してください。
Microsoft-Decision-1の料金はいくらですか?
Microsoft-Decision-1は入力100万トークンあたり0.042ドルで、出力トークンは無料です。表示価格はJevと同じです。AzureのFoundry料金ページには、まだこのモデルの行がありません。競合のコスト計算については、Jevの料金の解説をご覧ください。
Microsoft-Decision-1はJevより優れていますか?
Microsoft自身の36ベンチマークの表では、Microsoft-Decision-1の平均精度は83.5%、Jev 1.13.0は82.3%です。一方、較正のスコアはJevのほうが高くなっています(93.7対92.2)。独立した評価ボードはまだMicrosoft-Decision-1をスコアリングしていないため、この優位性は主張として扱ってください。Jevの強みについては、Jevレビューをご覧ください。
Microsoft-Decision-1でサポートチケットを振り分けられますか?
はい。緊急度、担当チーム、感情の判定は、まさにこのモデルが得意とする固定選択肢の質問で、OpenRouterのサンプルリクエスト自体がサポートメッセージです。ただし、タグを付け、チケットを移動し、返信を書く処理は別に必要で、それがAIヘルプデスクチームメイトの仕事です。全体の流れはチケット振り分けの自動化をご覧ください。
Microsoft-Decision-1は判断の理由を説明しますか?
いいえ。Microsoftのモデルカードによると、テキスト専用で、説明や根拠は生成しません。監査証跡や人へのエスカレーションのために判断ごとの理由が必要な場合は、入力と選択肢を自分でログに残すか、その工程にはLLMを使う必要があります。
Microsoft-Decision-1のウェイトは公開されていますか?
いいえ。Microsoft-Decision-1にはHugging Faceのリポジトリがなく、Microsoftはライセンスもセルフホストの選択肢も公開していません。オープンウェイトが必要な場合、CloudflareのClefとAWSのStrands DeciderはApache 2.0です。