PostHog Jeevesとは?
Jeevesは「reasoning Jev-style classifier with a diffusion drafter」で、PostHogが2026年9月29日に公開しました。開発したのはPostHogのAI Researchチームで働くAIリサーチエンジニアのNicholas Waltzです。彼のPostHogプロフィールによると、以前はYC出身のスタートアップで2年間、ドローン配送向けのRLモデルを作っていました。
Jeevesを理解するには、何を模倣しているかを知る必要があります。「意思決定モデル」はテキストを書きません。状態(メール、チケット、JSONのかたまり)と型付きの質問群を送ると、各選択肢の確率が返ってきます。このカテゴリは2週間前、TypeSafeがJevを公開して一気に広まりました。質問の型は3種類で、はい/いいえのnoul、1つ選ぶchoice、ルーブリックのscoreです。Jevはクローズドでホスト型です。数日のうちにJared PalmerのKevがJev互換のオープンな重みを公開し、JeevesはKevをインスピレーションとして挙げています。
Jeevesが加えたのは「考えること」です。READMEは問題をはっきり述べています。Jev型のモデルは「give calibrated decision probabilities, but at low accuracy」であり、「a lot of pipelines therefore rely on a reasoning model as a fallback.」そのフォールバックは通常、トークン課金のホスト型LLMで、そのコストはClaude Sonnet 5.5 pricingで解説したとおりです。JeevesはJevと同じ形で、そのフォールバックになろうとしています。
主なスペックです。
| PostHog Jeeves | |
|---|---|
| ベースモデル | LoRAとポインタヘッドを備えたQwen3.5-9B(Qwenの代替も参照) |
| 質問の型 | noul(はい/いいえ)、choice、score。1つのリクエストで混在可 |
| API | Jev互換の/v1/systemone、およびそのまま差し替えられるPython SDK |
| ライセンス | コードはMIT、重みはApache-2.0(Qwen3.5から継承) |
| 重みのサイズ | bf16で21 GB、FP8線形層で11.5 GB |
| ハードウェア | CUDA対応GPU。推論には48 GB以上のApple Silicon Mac |
| ホスト型API | なし。セルフホストのみ |
| 公開時の反響 | Hacker Newsで241ポイント、GitHubスター356 |
私はAliciaで、eesel内のAIエージェントを作っています。そのため、まさにこの層、つまり何かを書く前にチケットが何であるかを決めるパイプラインの部分に多くの時間を割いています。Jeevesがそれをどう行い、どこで存在価値を発揮するかを見ていきます。
Jeevesは決める前にどう推論するのか?
この仕組みはよくできたエンジニアリングで、精度向上とレイテンシのコストの両方を説明してくれます。
Jeevesは、状態と各質問を、ほとんど使われない稀なトークンをマーカーとしてQwenのチャットテンプレートに読み込みます(状態には<|fim_prefix|>、各選択肢には<|box_start|>など)。そのうえでJevにはないことをします。<think>ブロックの中に自由記述の推論の連鎖を生成するのです。連鎖が閉じた後、質問と選択肢が繰り返され、小さなポインタヘッドが、<decide>トークン位置の隠れ状態と各選択肢の末尾の隠れ状態を比較して選択肢をスコアリングします。このスコアに対するsoftmaxを、開発データで調整した温度(1.859、Hugging Faceのモデルカードによる)で割ったものが最終的な確率になります。
自分で同種のモデルを訓練する場合に知っておきたい、アブレーションの2つの詳細があります。稀なトークンを「State」のような普通の単語に置き換えると、結果が悪化しました。推論ブロックの後に質問を繰り返すのをやめても悪化しました。モデルには、決定する直前に選択肢を思い出させる必要があるのです。
訓練は3段階で、すべてリポジトリに記録されています。
- 教師ありファインチューニング: 2エポック、8基のGPUで596ステップ。12の公開データセットと合成ポリシーデータから19,126問を使用。質問の半数には、ベースモデルからサンプリングした推論の連鎖が付いていました。
- CISPOによる強化学習: MiniMax-M1のRL手法で、9,992問に各8ロールアウト、思考トークンは2,560で上限。624ステップの計画はステップ402で打ち切られました。それ以降は「the head over-sharpens」して較正が悪化するためです。
- 較正: 開発データで調整した単一の温度を、チェックポイントとともに保存します。
私が強調したいのはステップ402での停止です。チームは確率を正直に保つために、生のスコアを少し手放しました。それこそが意思決定モデルを使う理由そのものです。90%と言って70%しか当たらないモデルは、ルーティングのパイプラインでは役立たず以下であり、サポートでのAIハルシネーションの大半の根っこにある問題と同じです。
速度を取り戻すため、Jeevesは投機的デコーディング用に、複数の推論トークンを一度に提案する拡散ドラフターを同梱しています。1つの質問では、ブロック4のドラフトで連鎖の速度が毎秒109から176トークンに上がり、8つの質問をバッチ処理すると合計で毎秒約960トークンになります。
JeevesはJevのどこに勝ち、どこで負けるのか?
PostHogの結果表は珍しく率直で、そこに現れるパターンこそ今回の発表で最も役に立つ点です。
| ベンチマーク | Kev-9B | Jev | Jeeves |
|---|---|---|---|
| テスト全体(ホールドアウトとドメイン外) | 0.822 | 0.857 | 0.889 |
| JevBench全体(公開231項目) | 0.715* | 0.866 | 0.935 |
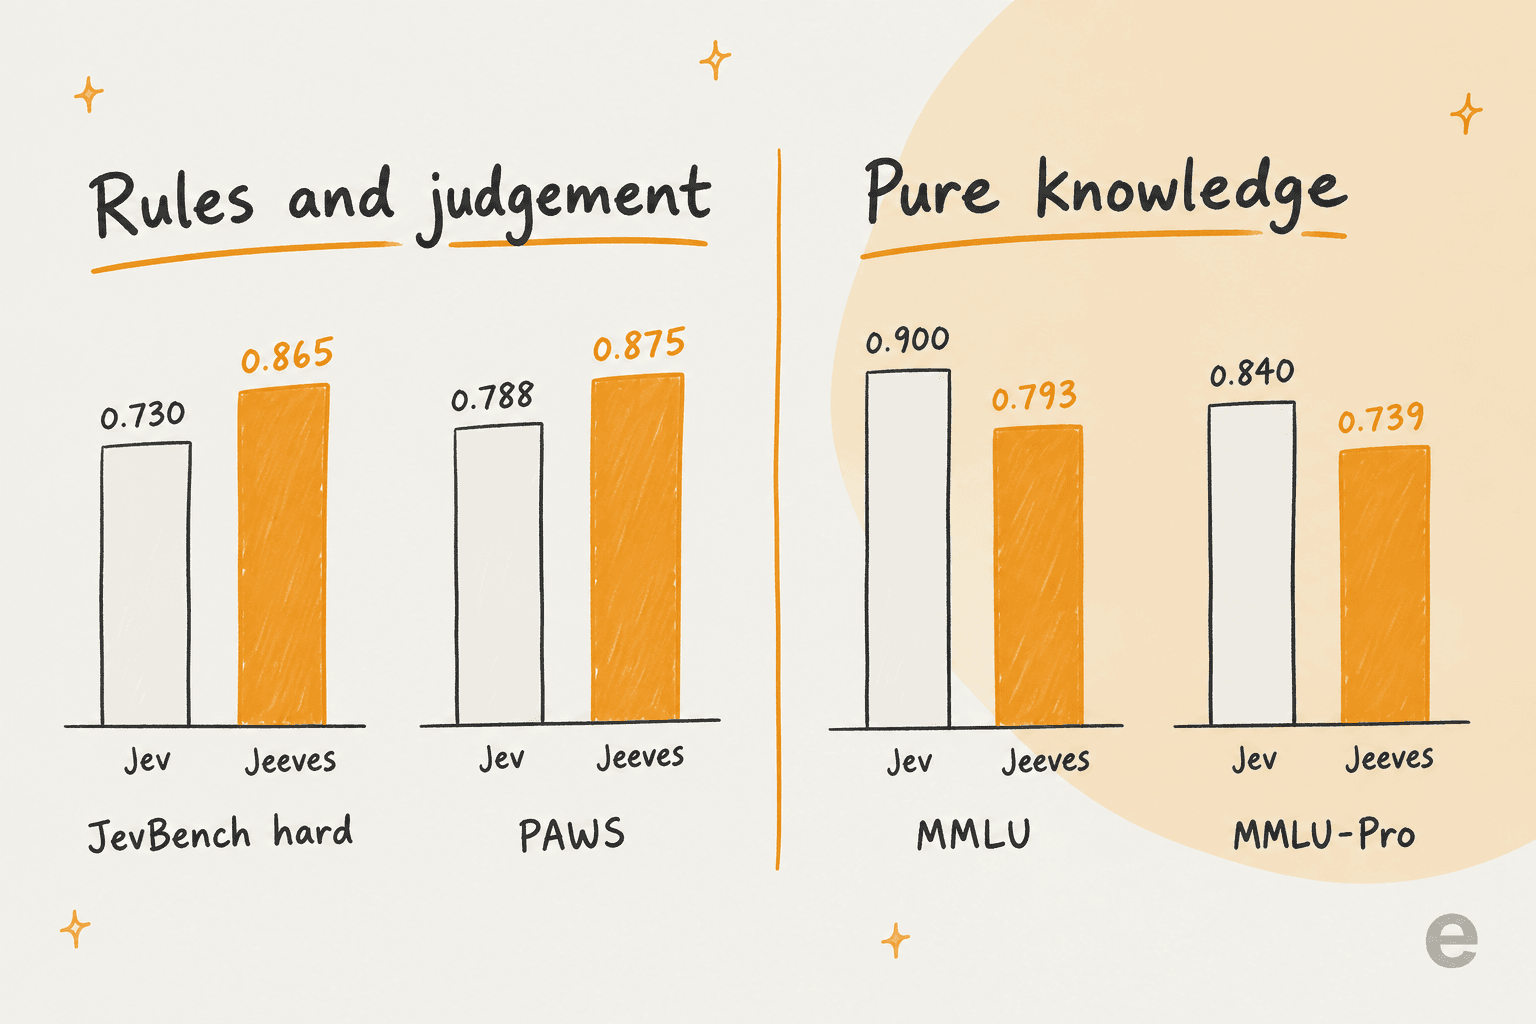
| JevBench hard(公開111項目) | 0.451* | 0.730 | 0.865 |
| PAWS(言い換え検出) | 0.763 | 0.788 | 0.875 |
| ホールドアウトのルール構造 | 0.896 | 0.885 | 1.000 |
| 対照的なポリシー | 0.900 | 0.963 | 1.000 |
| MMLU | 0.738 | 0.900 | 0.793 |
| MMLU-Pro(10択) | 0.515 | 0.840 | 0.739 |
| 答えられない問題にp ≥ 0.9で回答(低いほど良い) | 0.000 | 0.090 | 0.055 |
| JevBench較正誤差(低いほど良い) | 0.049 | 0.037 |
*PostHogによると、Kev-9BのJevBench結果は公開されておらず、これらのセルはKev-8Bのものです。数値はすべてJeevesのREADMEより。
表を上から読むと、分かれ目が見えてきます。質問が雑多な入力にルールを適用することである場合(ホールドアウトのルール構造、対照的なポリシー、言い換え検出、JevBench hard)は、思考が勝ち、ときには大差です。質問が事実を知っていることである場合(MMLU、MMLU-Pro)は、Jevが約10ポイント勝ちます。推論は、9Bモデルが持っていない知識を生み出せません。知識については、サポートチームは通常、自社のドキュメントにモデルを接地させます。そのトレードオフはRAGとファインチューニングで扱っています。
この分かれ目は、サポート業務にうまく当てはまります。「3段落目に埋もれた注文日を踏まえて、この返金依頼は30日ポリシーの範囲内か?」はルールの質問です。「ペルーの首都は?」はチケットキューには現れません。あなたの判断が前者のようなものなら、この表は味方です。
PostHog自身による率直な留意点が2つあります。JevBench以外でのKevやJevとの比較は「use different items from the same sources」であること、そして「no language consistency reward was included」ため推論の連鎖はあまり読みやすくないことです。答えと連鎖は得られますが、その連鎖を監査人に見せることは期待しないでください。
「考える」とは実際どれくらい遅いのか?
Hacker Newsのスレッドで最も強い反論があったのがここで、それは妥当なものでした。
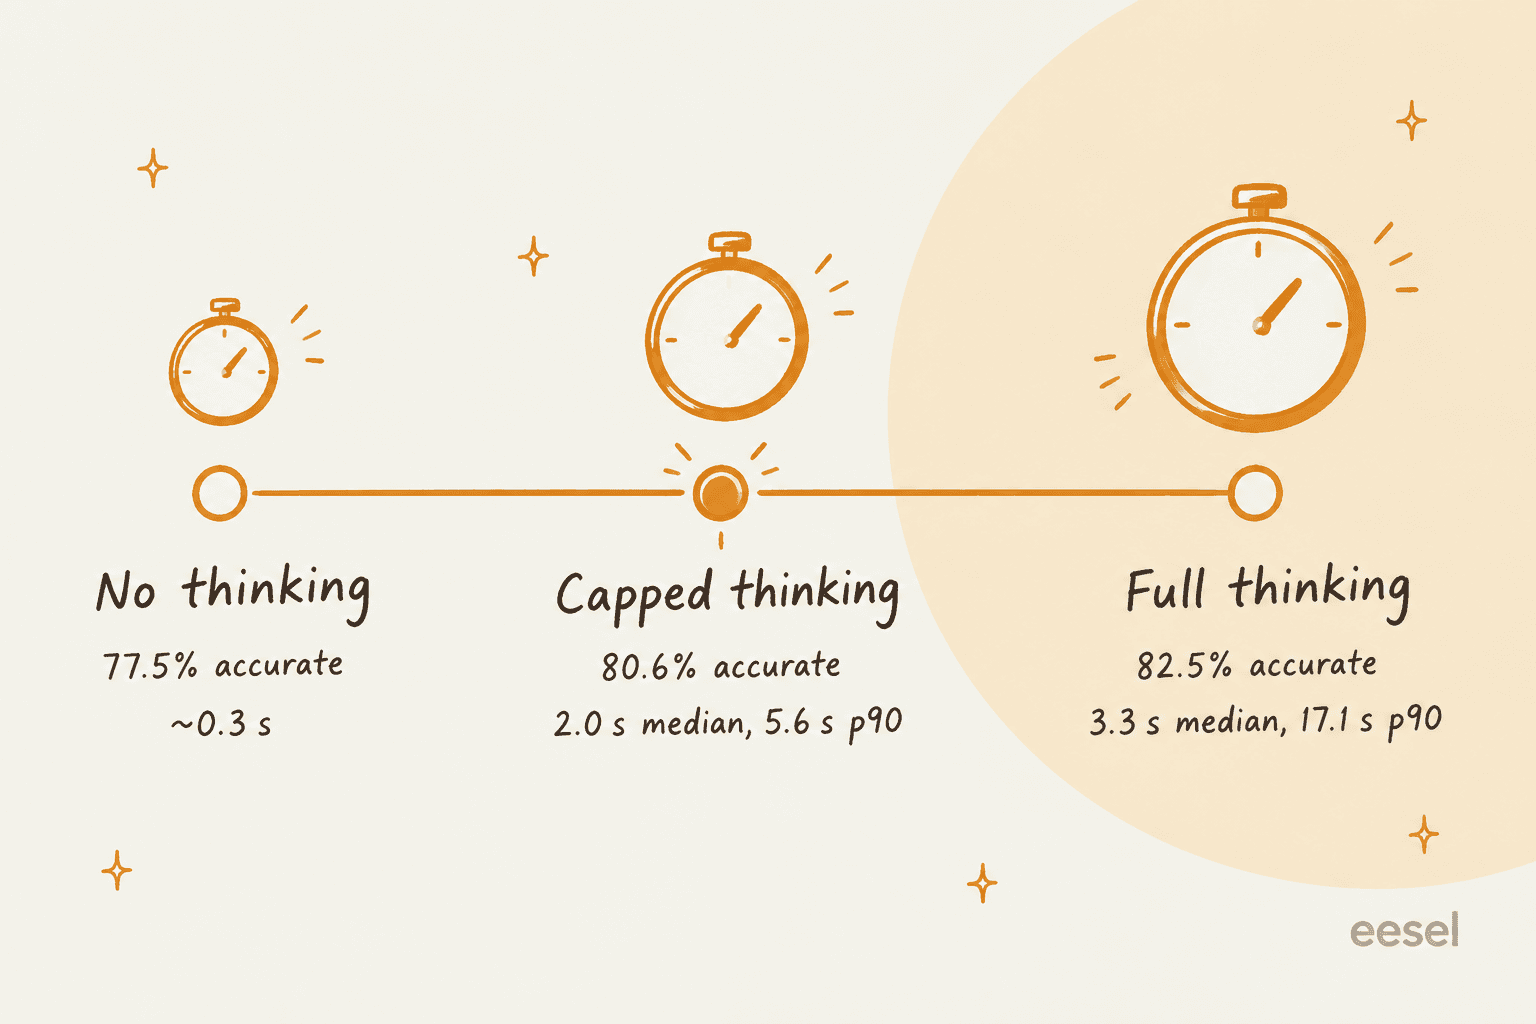
PostHogは、FP8のH100 1基で、開発用325問について3つの設定を計測しました。
| 設定 | 精度 | 推論トークン平均 | レイテンシ 中央値 / p90 |
|---|---|---|---|
| フル思考 | 0.825 | 1,138 | 3.3 s / 17.1 s |
max_think 768、nothink_threshold 0.9 | 0.806 | 344 | 2.0 s / 5.6 s |
| 思考なし | 0.775 | 0 | 約0.3 s |
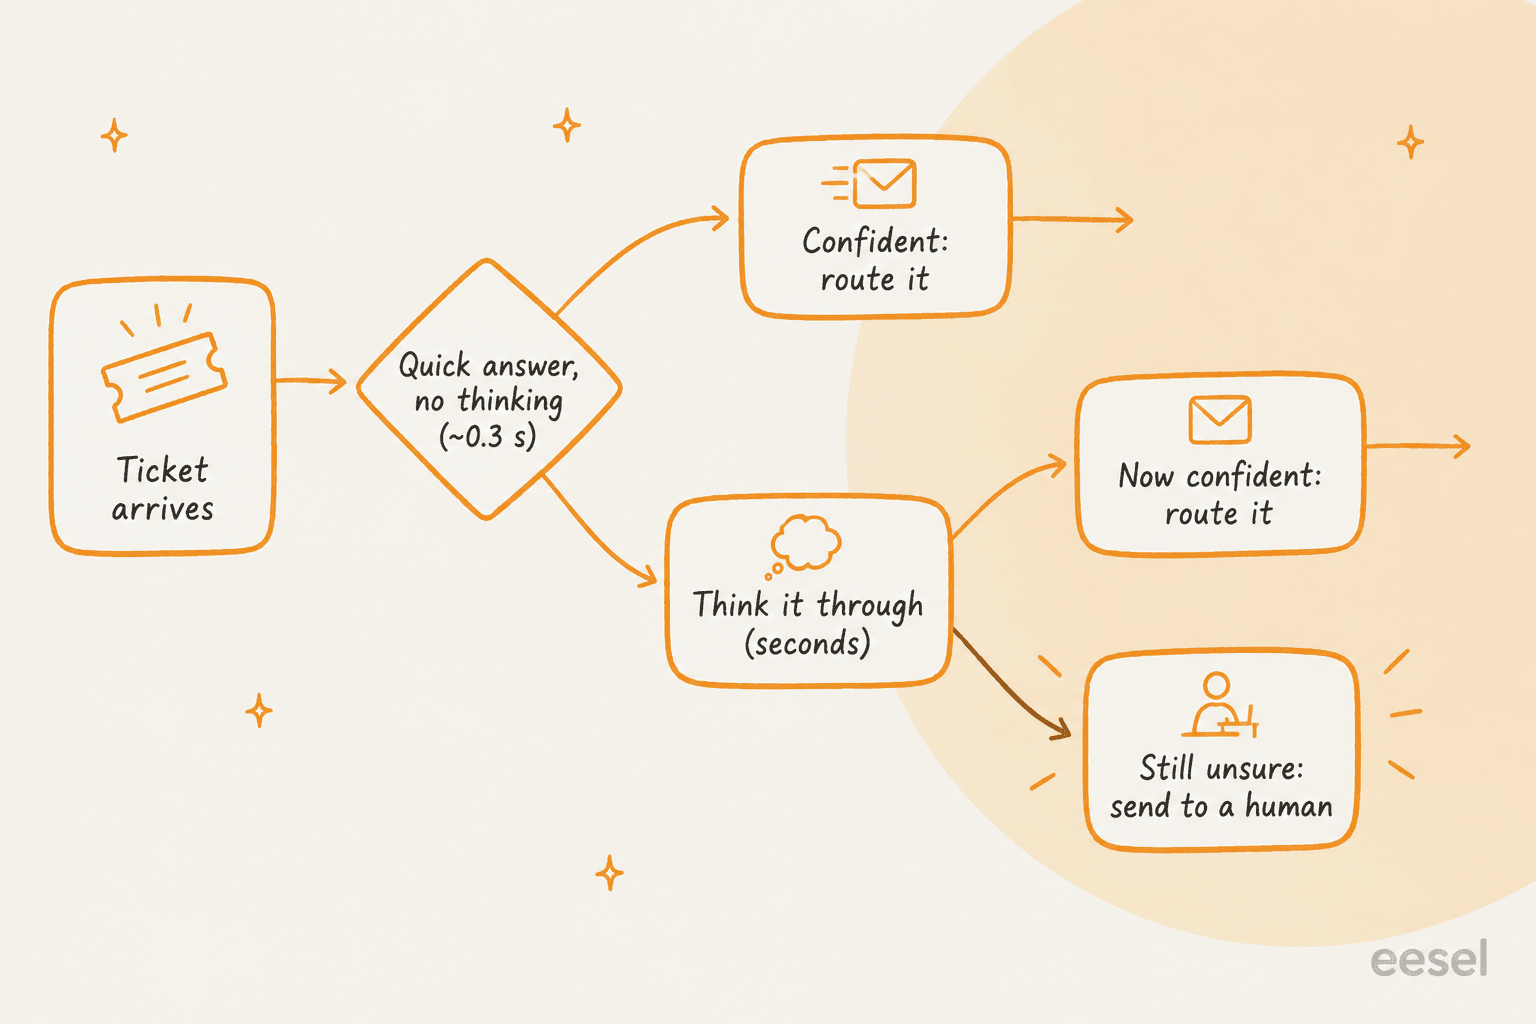
実際に本番に出すなら、真ん中の行です。max_thinkは各推論の連鎖をトークン予算で打ち切り、nothink_thresholdは素早い答えがすでに確信を持てる場合に思考を丸ごと省略します。精度向上の大部分(0.806対0.775)を保ちつつ、p90レイテンシを3分の2削減できます。
比較として、Jevの売りは1回あたり70〜500ミリ秒で、これはJevの速度テストで扱いました。HNの人たちも気づいていました。
"Cool engineering, but 17s p90 latency kind of defeats the point of a Jev-class model, which is supposed to be fast and cheap."

JeevesをJevの置き換えとして扱うなら、その通りです。高速モデルが首をかしげた後に動くものとして扱うなら、そうとは言えません。あるコメント投稿者は、アーキテクチャを端的にこう表現しました。
"Seems like this is the way, a hybrid approach where some of the pipeline will be jev like and some traditional LLM depending on the nature of the work."
Jeevesはそのハイブリッドを1つのモデルにまとめます。思考オフが高速層、思考オンが低速層です。2つの層が1つのAPIと1つの較正を共有するので、分類器の確率とLLMの自由記述の答えを突き合わせる必要がありません。
実際のサポートチケットを渡すとどうなる?
READMEのデモリクエストはサポートチケットなので、私の作業は楽でした。状態はこうです。*「Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.」*質問が3つ付きます。どの部署か、エスカレーションすべきか、顧客はどれくらい不満か。
Jeevesの返答はbilling 0.46、returns 0.40、shipping 0.14で、選択の信頼度はわずか0.19でした。エスカレーションは0.72。不満度は0〜2のスケールで1.5。3つの質問を並列で思考させて、リクエスト全体で8.1秒かかりました。
同じチケット(1文追加)をKevのプレイグラウンドでKev-4Bに通した結果がこちらです。
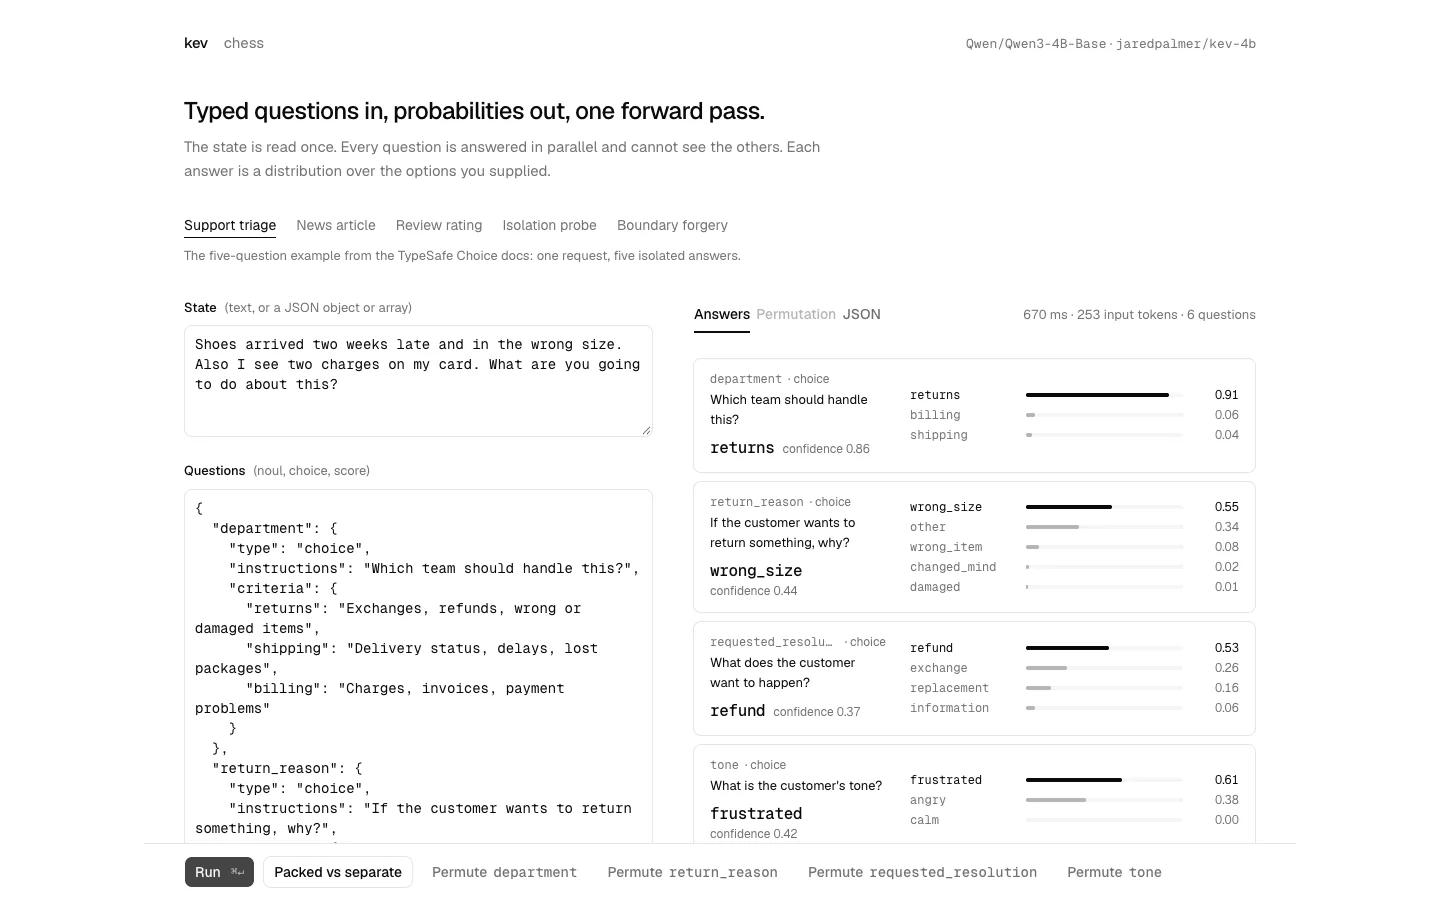
Kev-4Bは670ミリ秒でreturnsを0.91と答えました。より小さなモデルでプロンプトも少し違うため、厳密な一対一の比較ではありません。それでもチケットを見てください。2つのチームが担当する2つの問題が実際に含まれています。Kevは速く答え、自信があるように見えました。Jeevesは考えたうえで、要するに「これは接戦で、自信はない」と言ったのです。
サポートキューにとっては、後者のほうが有用です。自信満々の誤ったルーティングは、二重請求が放置されたまま顧客が返品キューで待たされることを意味します。低い信頼度の割れ方は、もっと賢いことをするサインです。請求に回して返品タグを付ける、チケットを分割する、あるいはきれいなAIから人への引き継ぎで担当者に送る、といった対応です。
これは、eeselのAIを実際のキューで動かして見てきたことと一致します。ECの受信トレイでの実トラフィックによる試験では、判断の部分が信頼できました。トリアージ精度93%、スパム検出100%で誤検出ゼロです。つまずいたのは生成された返信で、下書きの事実誤りは7%でした。分類は、モデルが自信のないときにそう認める限り、サポートAIの中で早い段階から信頼できる半分です。自信ありげなボットが静かに誤答するのも見てきたので、eeselの導入はすべて、実際の顧客に触れる前に過去のチケットでシミュレーションします。較正された「わかりません」は、素早い当て推量より価値があります。
結局、PostHog Jeevesは誰が使うべき?
Jeevesはプロダクトではなくリサーチリリースで、そう読めます。オープンソースAIエージェントの領域の多くがそうであるように、訓練コードの全体、train/dev/testデータ、再現スクリプトはありますが、ホスト型エンドポイントはありません。Hugging Faceのモデルページにも、このモデルは「isn't deployed by any Inference Provider.」と書かれています。
私の整理はこうです。
| あなたが... | 選ぶもの | 理由 |
|---|---|---|
| すでにJevまたはKevをLLMフォールバック付きで運用しているMLチーム | Jeeves | 同じAPI、両方の層を1つのモデルで、ルールの多いエッジケースに強い |
| すべての呼び出しで1秒未満の判断が必要なチーム | JevまたはKev | シングルパスで思考の長い尾がない |
| ノートPCでオープンな重みを使いたいチーム | Kev-0.8BまたはKev-4B、もしくはLaya | はるかに小さい規模 |
| 独自の意思決定モデルを訓練したいチーム | Jeeves | SFT、CISPO、ドラフターのレシピ一式がリポジトリにある |
| チケットを振り分けて、さらに処理までしてほしいサポートチーム | AIヘルプデスクエージェント | 意思決定モデルは返信もフィールド更新もエスカレーションもしない |
コミュニティの初期テストは、モデレーション系の作業については心強いものです。あるHNのコメント投稿者が自分のデータで試しました。
"Update: Jeeves took about 2 hours to moderate 394 data points and performed really well. It's not as good as Jev, but it's super close!"
「2 hours」に注目してください。H100ではないハードウェアでの、思考の税金がまた出ています。PostHogのエンジニアRobbie Coomberは同じスレッドで、Apple Siliconを高速化するためのMPS対応が進行中だと返信しており、リポジトリを見ると、その後マージされています。
これを組み込むのがあなたなら、まずJev代替の全体マップにざっと目を通す価値があります。ホスト型LLMの構造化出力機能で、GPUなしでもあなたのケースをカバーできるかもしれないからです。
意思決定モデルがヘルプデスクのためにやってくれないこと
ここで強調したい転換があります。意思決定モデルは「このチケットは何か?」には非常によく答えます。「では、どうするか?」には答えません。billing: 0.46を、ヘルプデスクのタグ、返信、返金の確認、メモ付きのエスカレーション、理由の記録に変えるコードを、誰かが書く必要があります。
そこでインフラと従業員の差が表れます。Jeeves、Jev、Kevはインフラです。チケット分類、優先順位付け、感情分析のための、優れていて動かすのが安価な部品です。AIチームメイトは、同じ判断をあなたの実際のヘルプデスクの中で行い、そのうえで仕事をこなす従業員です。両者を比べているなら、チケットトリアージの自動化のガイドで、自作と採用のトレードオフをより詳しく説明しています。
eeselを試す

より賢いトリアージがほしくてJeevesを検討しているなら、9Bモデルをホストしてその周りのつなぎ込みを書きたいわけではないでしょう。eeselのAIヘルプデスクのチームメイトは、Zendesk、Freshdesk、Help Scoutにある既存のキューに加わり、過去のチケットとヘルプセンターから学び、すでにお使いのエスカレーションルールに従って、すべてのチケットで振り分け、タグ付け、エスカレーションの判断を下します。そのうえで返信を下書きまたは送信し、本当に確信が持てないものはメモ付きで担当者に引き継ぎます。本番稼働の前に、過去の数百件のチケットでシミュレーションして、どこで正しく、どこで間違えたかを正確に確認できます。
Jeevesのセルフホストの魅力が、実はコードからの制御にあるなら、eesel CLIがそれを担います。同じチームメイトをターミナルから動かします。eesel activityはすべての実行を一覧し、1件を詳しく表示します。eesel approvalsは人の判断が必要なアクションを承認または拒否できます。eesel instructionsはチームメイトの常設ルールを編集します。すべてのコマンドはJSONを出力し、書き込み系は--dry-runに対応しているので実行前に正確な呼び出しを確認でき、ワークスペースはMCPサーバーとしても機能するため、Claude Codeのようなコーディングエージェントが直接操作できます。詳しくはAIエージェントCLIガイドをご覧ください。
ヘルプデスク標準のAIと比較しているなら、eesel vs Zendesk AIの比較記事が次に読むのに適しています。100クレジット付きでカード不要、無料で始められ、チケットまたはチャット1件が1クレジットとして数えられます(料金ページによる)。ご自身のキューでeeselを試して、先月どれだけのチケットを正しく振り分けられたかを確かめてみてください。
よくある質問
PostHog Jeevesとは何ですか?
PostHog Jeevesは、PostHogのAIリサーチチームによるオープンウェイトの9B意思決定モデルです。状態(テキストまたはJSON)と、はい/いいえ、多肢選択、評価の型付き質問を渡すと、推論の連鎖を書いたうえで、各選択肢に較正済みの確率を返します。TypeSafeのJevのリクエスト形式を踏襲しているため、同じ分類パイプラインにそのまま組み込めます。
PostHog Jeevesは無料で使えますか?
はい。コードはMITライセンス、Hugging Face上の重みはApache-2.0なので、PostHog Jeevesのダウンロードは無料です。代わりにハードウェアの費用がかかります。CUDA対応GPU、または48 GB以上のApple Silicon Macが必要です。ホスト型APIはなく、この点がJevのトークン課金との大きな違いです。
PostHog JeevesはJevとどう違いますか?
Jevは推論過程を見せずに1回のパスで答えます。PostHog Jeevesは先に考えるため、ホールドアウトテスト(0.889対0.857)とJevBench hard(0.865対0.730)で精度が上がりますが、フル思考ではp90レイテンシが17.1秒になります。MMLUのような知識問題ではJevが依然として上です。シングルパス側の詳細はJevレビューをご覧ください。
PostHog Jeevesでサポートチケットのトリアージはできますか?
チケットトリアージの判断部分、つまり担当部署の選択、緊急度のフラグ付け、不満度のスコアリングは担えます。READMEのデモもサポートチケットです。ただし、顧客への返信、ヘルプデスクの更新、自動エスカレーションは行わないため、その周りを担うコードかAIヘルプデスクエージェントが必要です。
PostHog Jeevesの速度はどれくらいですか?
FP8で動かす1基のH100では、PostHog Jeevesは思考オフで約0.3秒、上限付き思考で中央値2.0秒、フル思考で中央値3.3秒(p90は17.1秒)で答えます。シングルパスの意思決定モデルより遅いため、多くのチームは簡単なケースで思考を省略するnothink_thresholdオプションを使いたくなるでしょう。段階的なエスカレーションフローに近い考え方です。
PostHog Jeevesを動かすにはどんなハードウェアが必要ですか?
重みはbf16で21 GB、FP8の線形層なら11.5 GBです。READMEはPython 3.12とCUDA対応GPUを求めており、キャッシュを小さくすれば48 GB以上のApple Silicon Macでも推論できるとしています。GPUを管理したくない場合は、マネージド型のAIカスタマーサービスAPIのほうが簡単です。
PostHog JeevesはKevより優れていますか?
PostHogが公開した数値では、Jeevesはホールドアウトのテストデータ(0.889対0.822)とJevBench(0.935対Kev-8Bの0.715)でKev-9Bを上回ります。Kevはより小さく高速で、0.8Bから27Bまで4サイズあり、ノートPCで動きます。速度ならKev、難しいルール適用の判断ならPostHog Jeevesを選びましょう。どちらもオープンな意思決定モデルの分野でLayaと並びます。


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.