

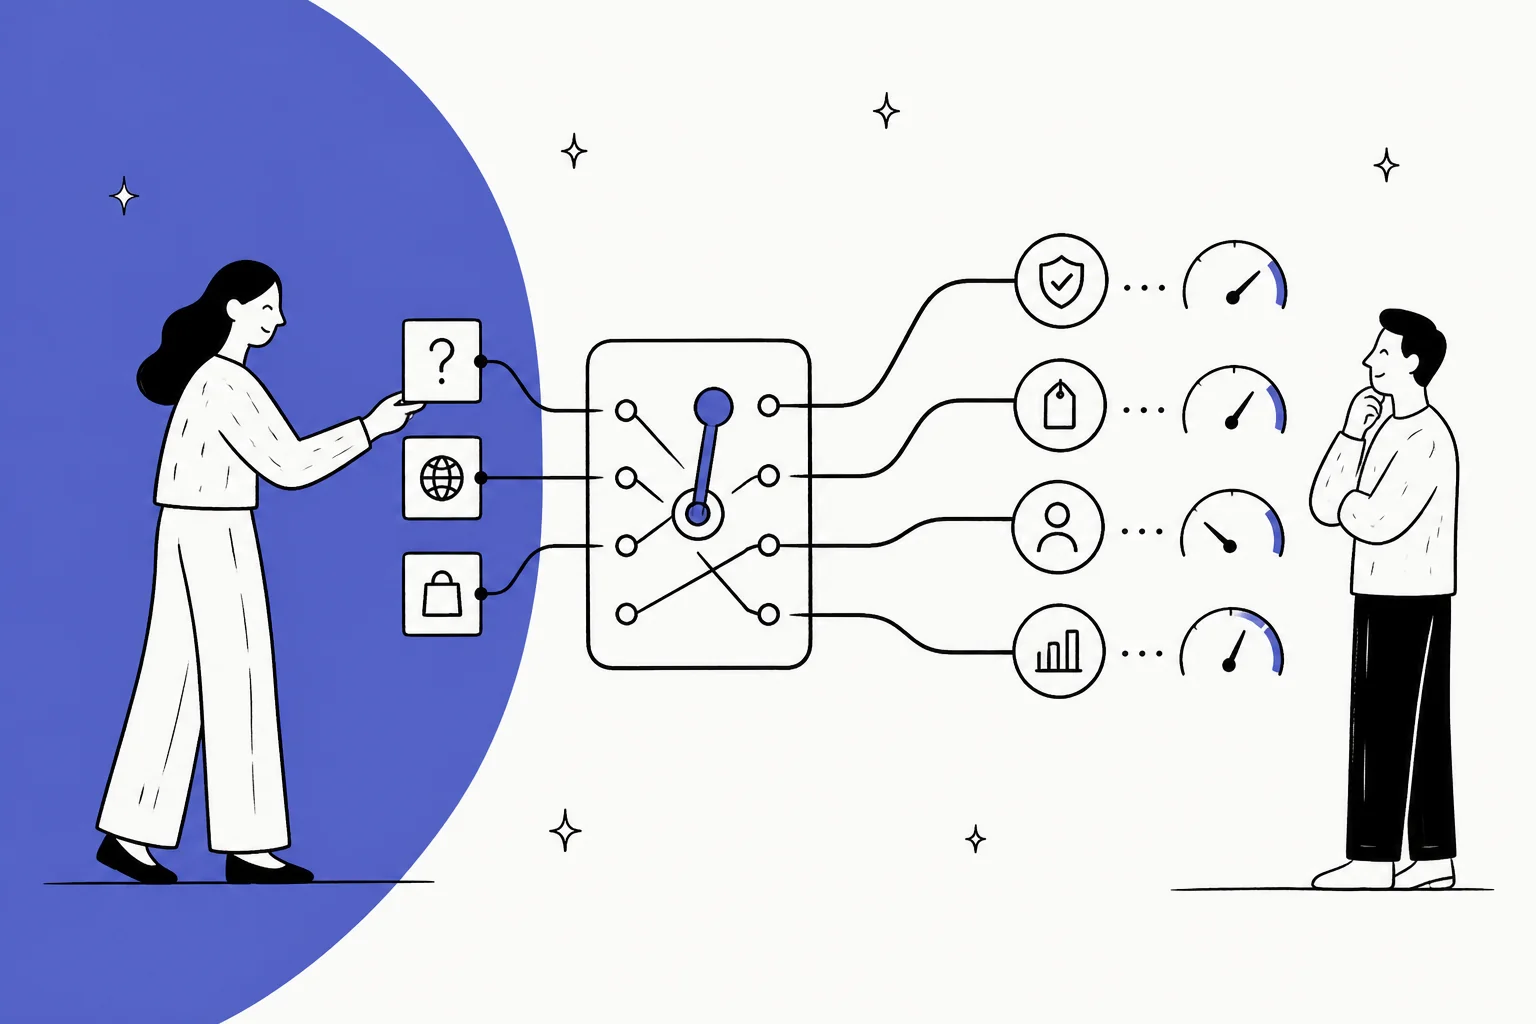
意思決定モデルとは何ですか?
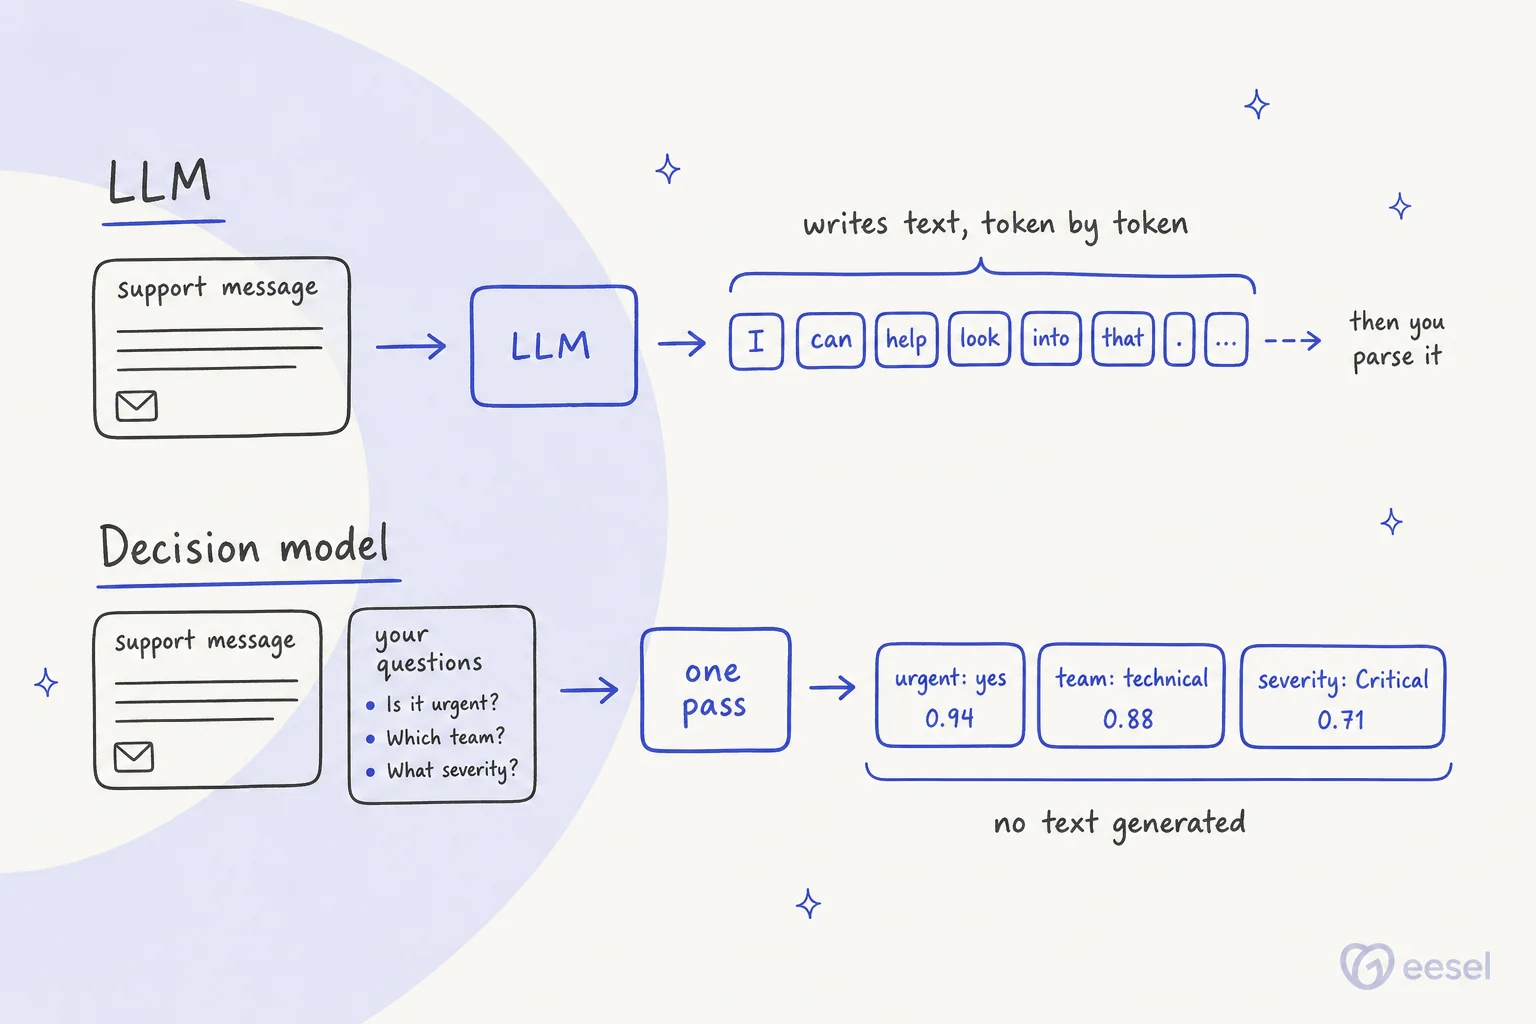
意思決定モデルは2つを受け取ります。ステート(サポートメール、JSONの塊、スクリーンショットなどの生の入力)と、そのステートに対する型付きの質問の集合です。質問ごとに型付きの答えを1つ、それぞれ確率つきで返します。段落もパースが必要なJSONも「もちろんです!分析結果はこちらです」もありません。
TypeSafeのドキュメントは、解決する課題を的確に述べています。コードが利用する判断をLLMに求めると、「テキスト生成システムに構造化された判断を出力させ、その結果をパースして戻すことを強いている」のです。意思決定モデルはテキストそのものを省きます。
このカテゴリのほぼすべてのモデルが同じ3種類の質問タイプに落ち着いており、TypeSafeはこれをプリミティブと呼んでいます。
| 質問タイプ | 何を問うか | 何が返るか | サポートでの例 |
|---|---|---|---|
| Noul | この記述は真か? | 0〜1の確率1つ | 「この依頼は緊急か?」 |
| Choice | どの選択肢が合うか? | 選択、選択肢ごとの確率、信頼度 | 「請求、技術、営業のどれか?」 |
| Score | この尺度のどこか? | レベル、レベルごとの確率、信頼度 | 「影響なし、軽微、重大、致命的のどれか?」 |
1つのリクエストで3つすべてを混在でき、各質問は同じステートに対して並列に評価されます。TypeSafeは「質問を増やしても応答時間はほとんど変わらない」と述べており、Strands DeciderのREADMEも同じ点を述べています。テキストは1回だけ読まれ、「各質問が加えるのはその質問自身のトークンだけ」です。
実際の形は、Cloudflare自身のローンチ例で確認できます。1回の呼び出しで、1件のサポートメッセージについて3つの質問をします。
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/cloudflare/clef \
  -X POST \
  -H "Authorization: Bearer $CLOUDFLARE_AUTH_TOKEN" \
  -d '{
    "model": "clef",
    "state": "Checkout has been failing for every customer for the last hour.",
    "questions": {
      "urgent": { "type": "noul", "instructions": "Is this support request urgent?" },
      "team": {
        "type": "choice",
        "instructions": "Which team should handle this request?",
        "criteria": {
          "billing": "Payments, invoices, and refunds",
          "technical": "Outages, errors, and configuration",
          "sales": "Plans and upgrades"
        }
      },
      "severity": {
        "type": "score",
        "instructions": "How severe is the customer impact?",
        "criteria": ["No impact", "Minor", "Major", "Critical"]
      }
    }
  }'
チケットのトリアージを手作業でやったことがあれば、このリクエストには見覚えがあるはずです。緊急度、チーム、重大度という、人間のトリアージ担当者が埋める3つの項目と同じで、多くのヘルプデスクにおける緊急度と影響度の分け方と同じです。
意思決定モデルは内部でどう動くのですか?
ここが一番おもしろいところです。マーケティングの印象よりも、仕掛けはずっとシンプルです。
オープンな意思決定モデルの多くは、普通のオープンなLLM(たいていQwenかGemmaがベース)から始め、答え方を変えています。Cloudflareのローンチ記事は、Clefが「プリフィルのみのパスを実行し、その後で有効なスキーマの選択肢を並列に採点する」と説明しています。Strandsは言語モデルのヘッドを完全に取り除いたため、Strands Decider 2Bは物理的にテキストを生成できず、そのローンチブログによれば追加したスコアリングヘッドは「合計でわずか100万強のパラメータ」です。
端的に言えば、次の3つが起こります。
- モデルがステートと質問を1回だけ読みます。 これは、あらゆるLLMが書く前に行う「プリフィル」の工程です。意思決定モデルはここで止まります。
- 小さなヘッドが許可された各答えを採点します。 「technical」を1文字ずつ生成する代わりに、いま読んだ内容に照らして、請求、技術、営業を一度に採点します。
- スコアは正直になるよう学習されます。 TypeSafeは学習手法をReinforcement Learning for Calibrated Decisions(RLCD)と呼んでいます。CloudflareはClef用に独自のRLCDを構築し、過信した確率に対する標準的なペナルティであるBrier損失と組み合わせています(Cloudflare)。
この3番目の工程こそが本当の製品価値です。信頼度0.9は、0.9の答えがおよそ90%の確率で正しい場合にだけ役立ちます。Strandsは、未見の短い分類タスクで「信頼度0.9以上の答えはおよそ95%の確率で正しい」と報告しています。だからこそ、意思決定モデルはチケットの優先順位付けや、安全なカットオフが欲しい判断に向くとされています。if confidence > 0.9: auto-route, else: send to a humanと書けるのは、この性質のおかげです。
何も生成しないため、出力コストはゼロかほぼゼロになります。LLMの関数呼び出しでは、すべての波括弧や引用符が課金対象の出力トークンになるのと比べてみてください。JSONモードも同じです。Jevは出力に課金せず、Clefは出力価格自体を掲載していません。Jevのトップページが「よりコードに近い」という打ち出しを強調するのもそのためです。1回のリクエストで、毎回1つの型付きレスポンスが返ります。
意思決定モデル vs LLM vs 従来の分類器
Hacker Newsで最も声が大きい反論は、これは新しい看板を掲げただけの分類器だというものです。あるコメントは「意思決定モデル=分類器」とまとめました。数学の面では間違っていません。間違っているのは、実際に出荷する人にとって何が変わったかという点です。
"LLM as judges - generalized, but too slow. ... traditional classifiers, very specific 1 trick pony, super fast and cheap once built. ... decision models/jev - are generic, you can throw them at most generic classification problems, and they are good enough."

これが正直な見方です。典型的なAIチケットルーティング業務で、3つの選択肢を比べるとこうなります。
| 厳密なスキーマ付きLLM | 意思決定モデル | 従来の学習済み分類器 | |
|---|---|---|---|
| 新しいラベル | プロンプトを変更 | リクエストを変更 | データ収集、再学習 |
| 出力 | パースが必要なテキスト | 型付きの答え+確率 | ラベル+確率 |
| 典型的なレイテンシ | 1〜3秒(私のLunaのテスト:1.3〜2.6秒) | 中央値39〜524 ms | 10 ms未満 |
| 出力トークンのコスト | 課金あり(Luna:$0.50/M) | 無料または課金なし | なし(セルフホスト) |
| 較正された信頼度 | ポストトレーニング後は弱い | 中核機能 | 可能だが難しい |
| 返信を書ける | はい | いいえ | いいえ |
| 最適な用途 | オープンな作業、返信、推論 | 多数の小さなゼロショット呼び出し | 固定された大量処理の1タスク |
Lunaのレイテンシの数値は、Decisions APIの料金の記事のために、推論をオフにしたGPT-6 Lunaで行った私のテストによるものです。意思決定モデルの範囲は、Layaを除いた下のCloudflareのベンチマークです。分類器の行はLayaを反映しています。Layaは従来の分類器にかなり近い挙動をする4.21億パラメータのエンコーダで、Cloudflareは5.8 msと計測しました。
注目したいのは「新しいラベル」の列です。別のコメントが、どのベンダーよりも実用的な論点を述べています。「任意の分類問題を1週間ではなく数分で片付けられるのは大きい」。サポートチームが四半期ごとに新しい製品ラインと新しいルーティングカテゴリを追加するなら、四半期ごとに分類器を再学習するのは、意思決定モデルが取り除く隠れたコストです。
今使える意思決定モデルは?
このカテゴリの動きは驚くほど速いものでした。コミュニティ運営のJev Decision Indexは9月22日に31のオープンな参加モデルで始まり、9月28日の更新では70のオープンモデルが掲載されました。その多くは趣味の再現実装です。ここでは、実在のベンダーや注目すべきスコアがあるものを挙げます。
| モデル | 開発元 | サイズ | オープンウェイト | ホスト型 | 価格 | 入力 | Decision Index |
|---|---|---|---|---|---|---|---|
| Jev | TypeSafe | 非公開 | なし | TypeSafe API、Workers AI | 入力$0.042/M、出力無料 | テキスト | 57.9 |
| Clef | Cloudflare | 27B | あり、Apache 2.0 | Workers AI | 入力$0.24/M | テキスト、JSON、画像、動画 | 61.2(自己申告) |
| Clef-flash | Cloudflare | 9B | あり、Apache 2.0 | Workers AI | 入力$0.09/M | テキスト、JSON、画像、動画 | 57.1(自己申告) |
| pplx-decider-v1-27b | Perplexity | 26B | あり | 未確認 | セルフホスト | テキスト、画像 | 56.4 |
| Strands Decider 2B | AWS Strands Labs | 1.9B | あり、Apache 2.0 | なし | 無料(セルフホスト) | テキスト(画像は実験的) | ボード未掲載 |
| Bespoke-Nimble-9B-v2 | Bespoke Labs | 9Bアダプタ | あり | なし | セルフホスト | テキスト | 39.6 |
| Kev 9B | Jared Palmer | 9Bアダプタ | あり、Apache 2.0 | なし | セルフホスト | テキスト | 38.5 |
| Tev1-4B | Together AI | 4B | あり、ライセンス未確定 | Together serverless | 未取得 | テキスト | 29.0 |
| Laya | Convai Innovations | 421M | あり、Apache 2.0 | なし | セルフホスト | テキスト、100以上の言語 | 6.0 |
| Decisions API | OpenAI | GPT-6 Lunaベース | なし | 限定プレビュー | 未公開 | テキスト、画像 | ボード未掲載 |
出典:Decision Index、Cloudflareの自己申告ボード、そして以下の各セクションにリンクした各モデル自身のページ。Indexは38のベンチマークで偶然補正されているため、0はランダムな当て推量を意味します。
最初に見るべき4つを以下に挙げます。
TypeSafe Jev
Jevは元祖であり、今も誰もがベンチマークの基準にしているモデルです。TypeSafe AIのクローズドモデルで、同社はサンフランシスコのチームで、ChatGPTの基盤となったRLHFとInstructGPTの手法を共同で考案したDiogo Almeidaが率いています。9月27日にTypeSafeはウェイトリストを廃止し、誰でもアカウントを作成できるようになりました。
ローンチ記事での目玉価格は、入力100万トークンあたり$0.042で出力は無料、TypeSafeはエンドツーエンドの応答時間を70〜500 msとしています。テキストのみで、コンテキストは32Kです。導入前に知っておきたい点が2つあります。Jevのアーキテクチャとウェイトは公開されていないこと、そしてTypeSafe自身が「補助金で成り立っていないとは証明できない」と述べていることです。
ご自身の利用量でのコスト計算は、Jevの料金の内訳をご覧ください。実際に使った感触はJevのレビューで取り上げました。別の低レイテンシ枠もあり、Jev Ultrafastとしてまとめています。
Cloudflare ClefとClef-flash
ClefはJevを上回ると主張するオープンモデルです。CloudflareはQwen3.8-27B(Clef-flashはQwen3.5-9B)をベースに構築し、両方をApache 2.0で公開し、Jev APIと完全互換にしたため、切り替えはほぼURLの変更だけで済みます。
ClefがJevに対して持つ本当の強みは2つ、ビジョン(画像と動画を読める)と64Kのコンテキストです。Cloudflareの数値では、TypeSafe自身の4つのワークフロー評価のうち3つでも勝っており、カスタマーサービスでは3つのモデルが1ポイント以内に収まっています(Clef 76.3、Clef-flash 77、Jev 76.0)。ただし注意点として、Clefの両スコアはCloudflareが自社の宿題を自分で採点したものです。上流のボードでは再現されておらず、Cloudflareは2つのベンチマークを省いています。さらにトークンあたりの価格はJevの約5.7倍です。1判定あたりの計算は、Cloudflare Clefの料金の記事で行いました。
Strands Decider 2B
Strands Decider 2BはAWS Strands Labsの製品で、Marc Brooker、Mike Chambers、Fabio Nonato de Paulaが執筆しました。ノートPCで動く小型の選択肢で、Qwen3.5-2Bをベースにした1.9Bパラメータ、ウェイト、学習データ、学習スクリプトがすべて公開されています。
CPU、NVIDIA GPU、Apple siliconで動作し、短いプロンプトでRTX 3090では中央値115 ms、M3 Proでは153 msです(GitHubリポジトリによる)。JevBenchでは最新版で0.762を記録しています。ローンチ記事が率直なのも好印象です。シングルパス設計のため「複雑な問題の解決では推論モデルより大幅に劣る」うえ、チャットボットや要約には向かないと述べています。実用上の注意が2つあります。ホスト版はなく(Hugging Faceには推論プロバイダーが表示されません)、ローカルサーバーには認証がないため、本番トラフィックではなく実験用です。すでにStrandsハーネスで構築しているなら、ツール呼び出しフックに続行/拒否のゲートとして組み込めます。
OpenAI Decisions API
OpenAIは9月29日のDevDayでDecisions APIを発表し、DevDayのまとめは「Lunaの知能を、有限の事前定義された答えを持つユーザー定義の質問群に集中させる」ものと説明しています。7日後の現在も、ドキュメントページ、リファレンススキーマ、価格の行、変更履歴の記載は見つかりません。/v1/decisionsエンドポイントは存在しますが、標準のキーではこのユーザーにはAPIが有効化されていないというHTTP 403が返ります。
そのため当面、確認できるOpenAIの数字はGPT-6 Lunaのトークン料金だけです。入力100万トークンあたり$0.10、出力$0.50です。いまOpenAIを使っているなら、厳密なenumスキーマ付きのLuna呼び出しで同じことができます。その回避策はOpenAI Decisions APIの記事で解説しています。
意思決定モデルはどれくらい速いですか?
速度はこのカテゴリが名前にふさわしい点です。Cloudflareは自社のスタック上で、6つの意思決定モデルの中央値レイテンシを43のベンチマークで計測しました。
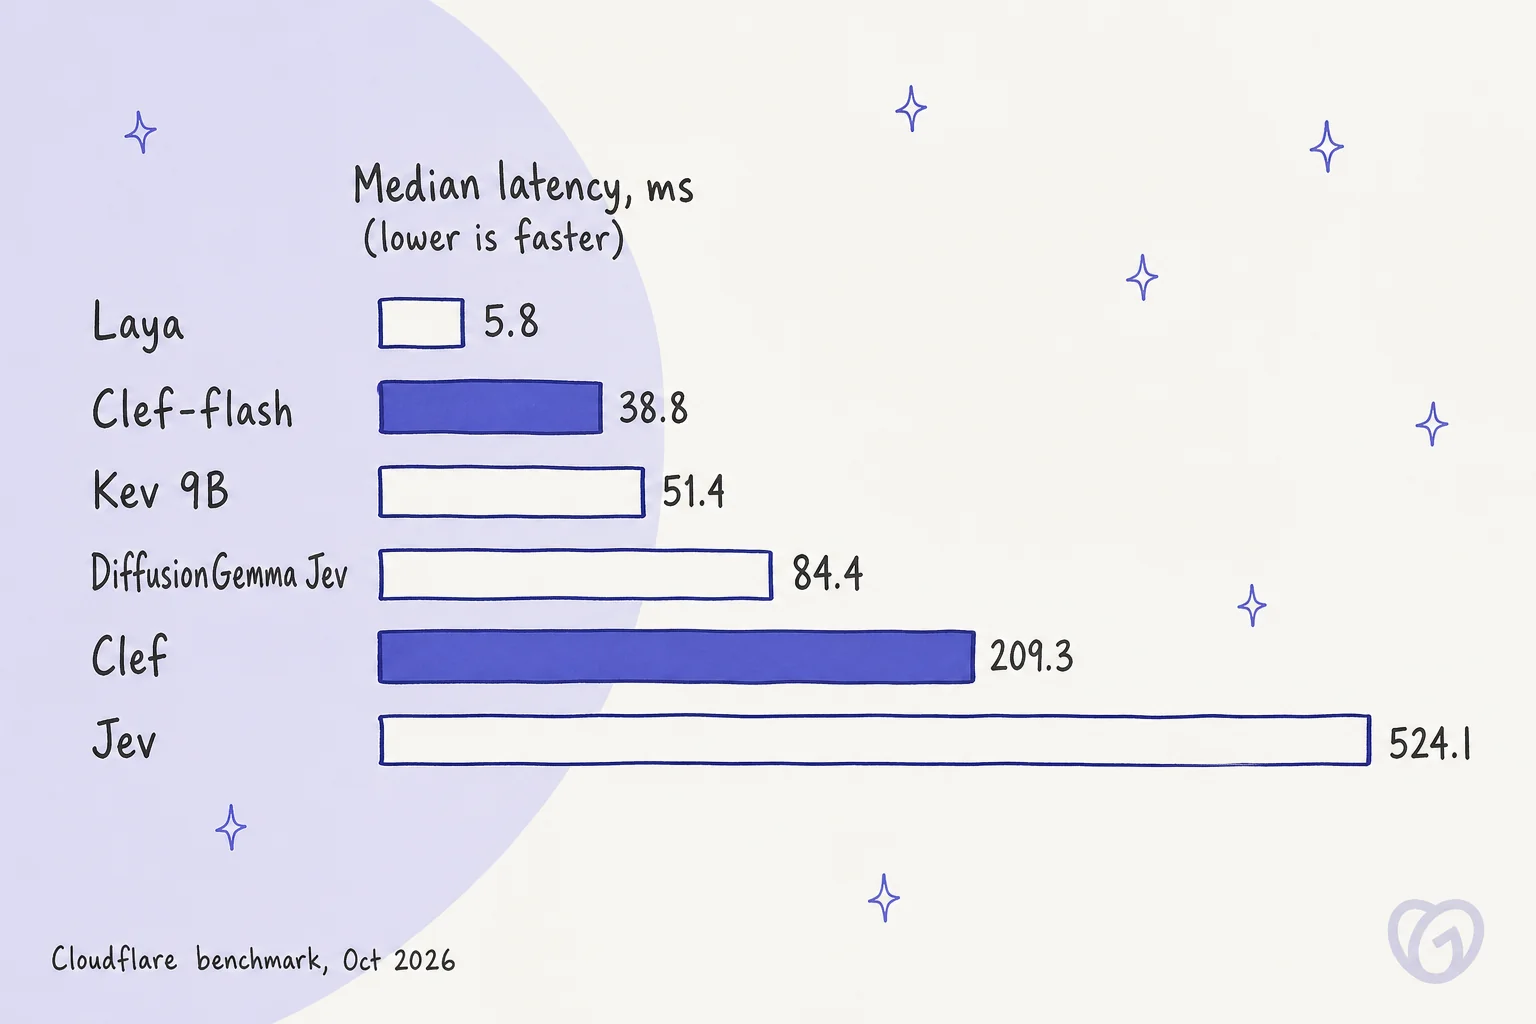
このグラフには正直な注意点が2つあります。第一に、Jevの524 msはインターネット越しのホスト型の往復時間である一方、オープンモデルはCloudflare自身のGPUで計測されているため、同条件の比較ではありません。第二に、Layaは非常に高速ですがDecision Indexでは6.0です。精度のない速度は、ただ速い誤答です。
比較として、同じ仕事をするLLMは秒単位で計測されます。模擬サポートエージェントのガードレール層をLLMからJevに替えたある開発者は、51件の小さなテストで「194ms対5,825ms。100万件のレビューあたり$125対$5,894」と報告しました。この差こそが、AIヘルプデスクエージェントの前段にガードレールとして意思決定モデルを置く理由のすべてです。
意思決定モデルは正確ですか?
ここは誇大広告に異議を唱えたいところです。意思決定モデルは多くの仕事には十分ですが、手元の選択肢の中で最も正確というわけではありません。
JevBenchについて、Strandsの評価ノートはボードの上位を「推論モデル(GPT-6 Luna 0.996)、次に、より大きな胴体の上に再構築されたJev、多くは12B以上(0.83-0.93)」と述べています。LunaやClaudeのような推論型LLM、たとえばClaude Sonnet 5.5は、精度では今も勝ります。意思決定モデルはコスト、速度、較正で勝ち、その代わりに数ポイントの精度を手放します。
ラベル数が増えると精度も下がります。Layaのモデルカードは、BANKING77(77ラベル)で0.425、Jevは0.870と示しています(Laya)。ヘルプデスクに60のルーティングカテゴリがあるなら、きれいな4つのデモではなく、60すべてでテストしてください。
そして最大の売りである信頼度スコアは、まだ確立された科学ではありません。
"for production routing, you almost always want to threshold on confidence ('auto-handle above 0.9, route to a human below'), and that only works if the probabilities mean what they say. A 96% model with overconfident outputs is operationally worse than a 94% model with honest ones."
あるテスターは、公平なサイコロの目をJevに尋ねたところ、「1」にほぼ80%の信頼度が返ってきたと報告しました(wat10000)。別のテスターは、メール自体が正当だと書いてあると、オープンなJevのコピーが「100%正当」に変わる例を示しました(FooBarWidget)。意思決定モデルは段落をでっち上げることはできませんが、自信たっぷりに間違えたり、言いくるめられて答えを変えたりすることは十分にあります。
Strandsのモデルカードは適切な既定の姿勢を示しています。「しきい値を信頼する前に、自社のトラフィックで測定すること」。これはサポートにおけるAIのハルシネーションを防ぐときの教訓と同じです。デモではなく、実際のチケットでテストしてください。
あなたの用途に合う意思決定モデルは?
最も近い状況を選んでください。
最後のタブは冗談ではありません。あるRedditのコメントが見事に言い表しています。「私が書いたルーティングの半分は、仮装したif文だった」。単純なZendeskルーティングのルールでも、かなりの範囲をカバーできます。
カスタマーサポートで意思決定モデルはどこに収まりますか?
サポートは、どのベンダーも最初に挙げる用途で、それには理由があります。自動トリアージは、ほとんどが小さく限定された判断の積み重ねです。Cloudflareのローンチ例はサポートチケットです。TypeSafe自身のワークフロー評価にも、5,330行のカスタマーサービスのセットが含まれています。
インテント分類はchoiceの質問です。スパム検出もそうです。緊急度はscoreで、「人に回すべきか?」ははい/いいえであり、AIによるエスカレーションの核心です。感情分析でさえ、固定された尺度でのscoreです。どれも、答えが固定された限定的な質問です。まさに意思決定モデルが得意とする形です。
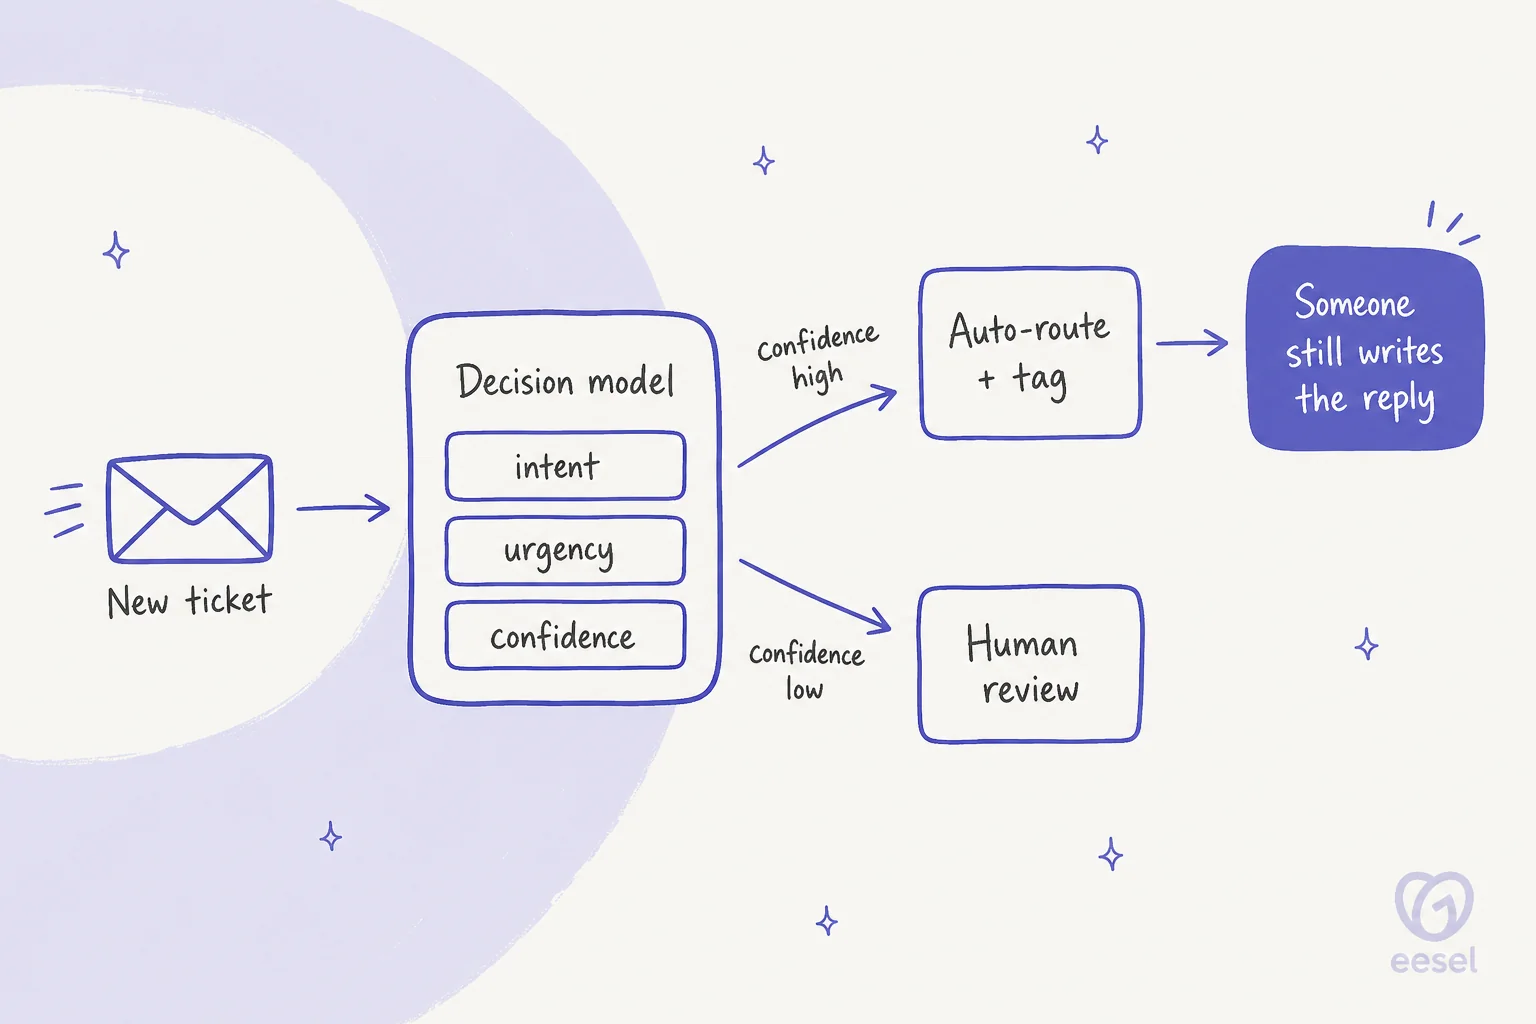
eeselで何年もAIを実際のサポートキューに導入してきて学んだのは、仕分けは簡単な半分だということです。あるECの実際のZendeskの受信箱でクロスバリデーションした試行では、AIトリアージの精度は93%で、受信箱の22%を占めたスパムを100%検出しました。同じ試行で、AIが下書きした返信のうちそのまま送られたのは12%だけで、7%には事実の誤りがありました。チケット分類はほぼ解決済みでした。手間がかかったのは返信のほうでした。
信頼度スコアは、購入を検討する方々がずっと求めてきたものです。月7,000件のチケットを扱うCXリーダーは、営業の通話でeeselのチームにこう語りました。
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
これが意思決定モデルの中核の考えを一言で表しています。eeselが本番に出す前に、チームの過去のチケットですべての展開をシミュレーションするのもそのためです。自信満々の誤答は答えがないよりも悪く、しきい値がどこにあるかを知る唯一の方法は、実際のトラフィックでテストすることです。
速度を軸にスタックを作り直す前に、あるMSP経営者の実用的な指摘に耳を傾ける価値があります。r/SmallMSPのスレッドで彼は、モデルがボトルネックではないと述べました。「速度の面では、Autotaskが私の弱い環だと思う」。ルーティング呼び出しを2秒縮めても、その後チケットがキューで40分待つなら、大した意味はありません。
では意思決定モデルはどこに属するのでしょうか。自分で構築するワークフローの中の、安価な最初のパスです。コードを書いて何百万ものイベントを処理するなら、意思決定モデルはルーティング、モデレーション、ガードレールの優れた部品で、自作の選択肢はJevの代替の比較記事で扱っています。既存のヘルプデスクでチケットのタグ付け、振り分け、エスカレーション、返信までしてほしいサポートチームにとって、生のモデルはプロジェクトの出発点であり、終点ではありません。タグ付け、エスカレーションのプロセス、ナレッジの検索、返信をまだ自分で作る必要があります。
自作の全手順は、チケットトリアージの自動化のガイドから始めてください。作るより買いたい場合は、AIトリアージツールの比較記事で既製の選択肢を比べています。
eeselでトリアージと返信を試す
eeselのAIヘルプデスクチームメイトは、意思決定モデルが片方しか担えない仕事の両半分をこなします。既存のキューに参加し(Zendesk連携のほか、FreshdeskとGorgiasにも対応)、チケットのタグ付けと振り分けを行い、触れるべきでないものはエスカレーションし、ヘルプセンターと過去のチケットから返信を書きます。各オートメーションには「Model strength」の設定もあり、タグ付けや振り分けのような「簡単な仕事」には軽量なモデルを(オートメーションのドキュメント)、下書きにはより強力なモデルを使うので、安価な判断と難しい返信はすでに別々のモデルで動いています。

信頼度の考え方もここに引き継がれています。すべてのアクション(タグ、返信、返金)は、自動、承認が必要、無効のいずれかに設定され、指示に含まれないイベントはスキップされ、理由つきで記録されます。本番前に、過去のチケットでシミュレーションを実行できます。
開発者としてこの記事に来た方には、eesel CLIが橋渡しになります。npx @eesel/cliを実行すると、ヘルプデスクを接続し、eesel automationsで平易な言葉のルーティング指示を使ったオートメーションを設定し、eesel approvalsで保留中のアクションを承認または拒否できます。すべてターミナルから行えます。すべてのコマンドはJSONを返すので、Claude Code、Cursor、Codexがセットアップ全体を操作でき、--dry-runで書き込みの前に確認できます。意思決定モデルの周りに作るはずだったルーティングのロジックに加えて、顧客に返信する部分まで、つなぎのコードを書かずに手に入ります。
プランはeeselの料金で月$299から500クレジットで、1クレジットは1チケット、ユーザーごとの料金はなく、100クレジットの無料枠もあります。ご自身のチケットでeeselを試して、信頼度のラインが実際にどこにあるかを確かめてください。
よくある質問
AIにおける意思決定モデルとは何ですか?
意思決定モデルは、入力に対する型付きの質問(はい/いいえ、ひとつ選ぶ、尺度で採点する)に答え、テキストを書く代わりに各答えを確率つきで返す小さなAIモデルです。TypeSafe Jevが2026年9月にこのカテゴリを始め、現在ではチケットのトリアージなどの業務で使われています。チケットをトピックで仕分けること(インテント分類とも呼ばれます)は典型的な用途です。
意思決定モデルはLLMとどう違いますか?
LLMはトークンごとにテキストを生成するため、回答をパースする必要があります。意思決定モデルは入力を一度だけ読み、許可された答えを1回のパスで採点するので、生成するテキストがなく、出力コストはほぼゼロです。その代わり、意思決定モデルは返信、コード、要約を書けないため、サポートチームには返信用のAIヘルプデスクエージェントか人が引き続き必要です。
意思決定モデルは単なる分類器ではないのですか?
数学的にはほぼ同じです。ラベルから選び、確率を返します。新しいのは、リクエスト時に定義したラベルでゼロショットに動作する点です。新しいチケット分類の課題ごとにデータを集めてモデルを学習させる必要がありません。
最も優れた意思決定モデルはどれですか?
コミュニティのDecision Indexでは、Jevが57.9で、独立にテストされたオープンモデルでこれを上回るものはまだありません。CloudflareはClefを自社のボードのコピーで61.2と報告していますが、このスコアは自己申告です。画像ならClef、オフラインやCPUで使うならStrands Decider 2B、ホスト型で最も安価なテキスト判定ならJevです。
チケットの振り分けに意思決定モデルを使えますか?
はい。チケットのルーティング、緊急度、エスカレーションの判断は教科書的な用途で、Cloudflare自身のローンチ例もサポートメッセージをチームと重大度で振り分けています。ただし、ラベルに基づいて動くコードやヘルプデスクツールは別途必要で、それを端から端まで担うのがAIヘルプデスクチームメイトです。
OpenAIのDecisions APIは利用できますか?
OpenAIはDevDay 2026でDecisions APIを限定プレビューとして発表しました。2026年10月6日時点で、公開ドキュメント、スキーマ、価格はなく、標準のAPIキーではエンドポイントが「有効化されていません」というエラーを返します。わかっている内容はOpenAI Decisions APIの記事で追跡しています。
意思決定モデルはAIサポートエージェントの代わりになりますか?
いいえ。意思決定モデルは、どのチームが担当するか、どれだけ緊急か、といった限定された判断を1つ下します。注文の照会、返金ポリシーの適用、返信の作成はしません。意思決定モデルはチケットトリアージの自動化の部品であり、チケットを解決するチームメイトの代わりではありません。