

要約
LFM3は、Liquid AIが2026年10月27日にリリースした、それぞれ約2Bパラメータの6つのオープンモデルからなる新しいファミリーです。テキストモデルのLFM3-1.7Bは、Liquidの29ベンチマークの表で平均49.37を記録し、規模が5倍のQwen3.5-9Bの47.24を上回っています。ローカルエージェント向けに作られており、iPhone 17 Pro上で1.90 GBのメモリを使い、毎秒43.6トークンをデコードします。これはLiquidがテストした次点のモデルの約2.8倍の速さです。
このファミリーには、テキスト、ビジョン、音声、見て聞いて話せる「omni」モデルに加え、返信を書く代わりにチケットや文書に関する質問にミリ秒単位で答える2つの判断モデル(d1-2Bとd1-Omni-2B)が含まれます。重みはHugging Faceで無料公開されていますが、無料なのは年間売上高が$10M未満の企業のみで、LFM3のAPI料金はまだ公開されていません。
注意点もあります。Liquid自身のモデルカードでは、エージェント型コーディングや複雑な多段階推論にLFM3-1.7Bを使わないよう案内しており、上記の数値はすべてベンダーの報告によるものです。サポートチームにとって興味深いのは、1回の処理でチケットの振り分けとタグ付けができるd1-2Bです。ただし、モデルにはそれを取り巻くヘルプデスクの仕組みが必要です。そのため、Dokument 24のようなチームは、モデルを自分たちで組み込むのではなく、すぐに使えるAIヘルプデスクチームメイトを使って、Zendeskの新規チケットすべてにタグを付け、返信の下書きを作成しています。
LFM3とは?
LFM3は、データセンターではなくスマートフォン、ノートPC、自動車上で動く小型モデルを手がけるLiquid AIの、Liquid Foundation Modelsの第3世代です。Liquidは2026年10月27日、"every modality for specialized intelligence," としてLFM3を発表しました。初回リリースには、"in the 2B parameter range." のモデルが含まれています。
私は新しいモデルを見るとき、検索の観点(実際に人々が何を知りたがっているのか?)から入りますが、その根底には作り手としての疑問があります。実際の製品の裏側でこれを動かすには、何が必要なのでしょうか?LFM3の場合、その答えは多くの新モデルの発表より興味深いものです。単独のモデルではなく、ファミリーだからです。
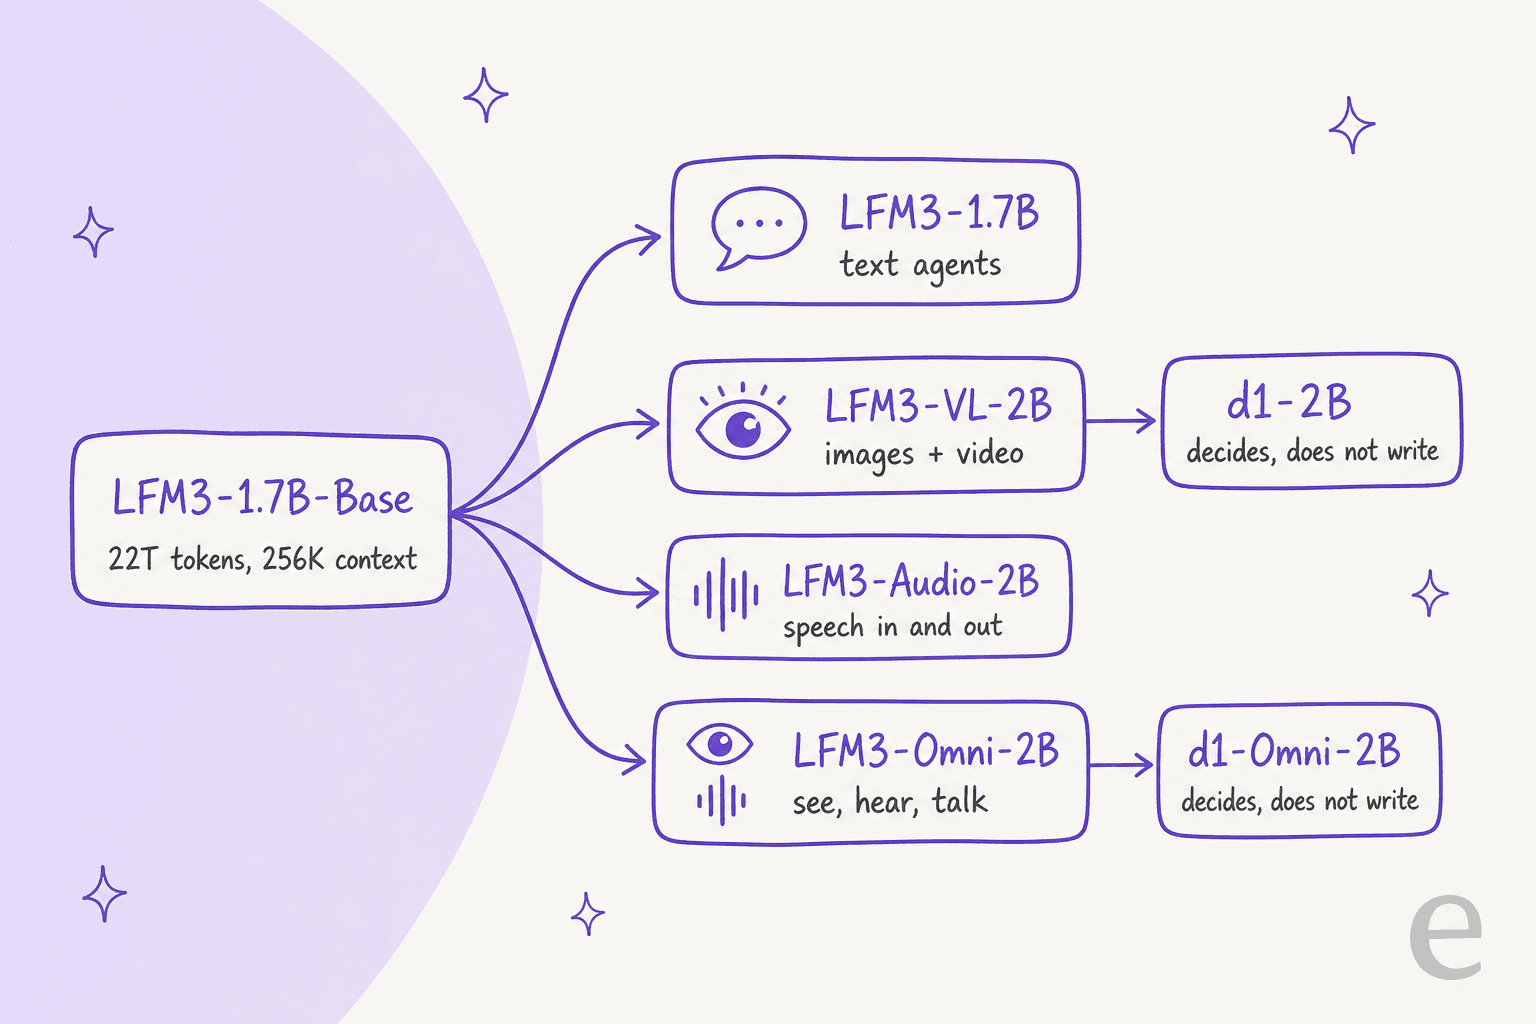
事後学習済みの6つのモデルはすべて、22兆トークンで事前学習され、256Kトークンのコンテキストウィンドウを持つ単一のバックボーン、LFM3-1.7B-Baseから派生しています。Liquidの提案は、1つの大きな汎用モデルを使うのではなく、仕事に合った小さなモデルを選び、自社データでファインチューニングして、デバイス上で動かすというものです。
LFM3モデルの一覧
初回リリースの全モデルと、それぞれのHugging Faceモデルカードに掲載された数値をまとめました。
| モデル | できること | パラメータ数 | コンテキスト |
|---|---|---|---|
| LFM3-1.7B | テキスト、ツール呼び出し、ローカルエージェント | 1.73B | 256K |
| LFM3-VL-2B | 画像と動画を入力し、段階的に思考してテキストを出力 | 1.92B | 128K |
| LFM3-Audio-2B | 音声認識、音声出力、音声翻訳 | 2B | 32K |
| LFM3-Omni-2B | テキスト、画像、動画、音声を入力し、テキストと音声を出力 | 2.17B | 32K |
| d1-2B | テキストと画像に基づく判断、テキスト生成なし | 1.92B | 128K |
| d1-Omni-2B | テキスト、画像、音声に基づく判断 | 2B | 記載なし |
モデルカードによると、テキストモデルは英語、アラビア語、中国語、日本語、ヒンディー語、ポーランド語など16言語を理解します。これは多言語サポートを運営する際に重要です。omniモデルは19の言語とロケールで話せます。
LFM3のアーキテクチャでは何が変わったのでしょうか?
LFM2は、短い畳み込みとアテンションを組み合わせることで、スマートフォン上でも高速に動作できることを示しました。LFM3はその考え方を維持しつつ、3つ目の要素を加えています。注目すべきは24層の内訳で、13層がゲート付き短畳み込み、5層が256トークンのウィンドウを持つスライディングウィンドウアテンション、6層がグローバルアテンションです。Liquidはこれを"tri-hybrid." と呼んでいます。
再設計の主な狙いは、長いコンテキストへの対応です。発表記事によると、LFM3-1.7Bは各種エッジデバイスで、短いプロンプトに対するパラメータ当たりの性能がLFM2-1.2Bと同等で、コンテキストに8Kトークンがある場合は約25%高速です。Liquidは、Samsung Galaxy S26 UltraやRaspberry Pi 5から、Apple M4 Max搭載ノートPC、Qualcomm Hexagon NPUまで、14通りのデバイスとバックエンドの組み合わせで、ハードウェアをループに組み込んだ探索を行い、この設計にたどり着きました。
今回は、エージェントの作業をより重視した学習になっています。事前学習の最後の3.5兆トークンには、"a larger share of agentic traces and diverse tool calls," を含む選別されたデータを使い、その後テキストモデルは4段階の事後学習を受けました。1.75兆トークンでの教師ありファインチューニング、混合強化学習、6つの専門教師モデルからの蒸留、そしてOpenClawやHermes Agentのような実際のエージェント実行基盤内でのエージェント型強化学習です。
LFM3-1.7Bのベンチマーク性能はどれほどでしょうか?
Liquid AI自身の表では、LFM3-1.7Bはエージェントや指示追従のタスクで、はるかに大きなモデルを上回っていますが、コーディングと知識では劣ります。29ベンチマークの平均は49.37で、Qwen3.5-9Bは47.24、Qwen3.5-4Bは39.27、MiniCPM5 2Bは39.19、Gemma 4 E4Bは31.74です。
公開された結果の一部をご紹介します。
| ベンチマーク | LFM3-1.7B | MiniCPM5 2B | Gemma 4 E4B | Qwen3.5-4B | Qwen3.5-9B |
|---|---|---|---|---|---|
| AutomationBench(公開) | 41.29 | 4.71 | 1.92 | 8.67 | 15.10 |
| WebArena-Verified | 38.42 | 9.11 | 17.06 | 21.92 | 28.94 |
| BFCL V4(ツール呼び出し) | 71.39 | 62.65 | 48.25 | 55.12 | 62.83 |
| τ³-bench | 68.01 | 69.44 | 33.53 | 65.98 | 67.11 |
| IFBench | 73.03 | 62.08 | 44.56 | 38.16 | 48.84 |
| SWE-bench Verified (OpenCode) | 43.40 | 34.80 | 0.50 | 41.20 | 51.20 |
| GPQA Diamond | 63.37 | 65.15 | 57.88 | 75.76 | 80.40 |
| RULER 128K | 65.56 | 37.96 | 18.82 | 84.63 | 87.11 |
| 平均(29ベンチマーク) | 49.37 | 39.19 | 31.74 | 39.27 | 47.24 |
サポート業務に携わっているなら、私が最初に見るのはτ³-benchの行です。τ-benchは、ツールとポリシーを使いながら、複数ターンの会話を通じて顧客を支援するエージェントをシミュレートするからです。LFM3-1.7Bは68.01で、Qwen3.5-9Bの67.11とほぼ同水準、MiniCPM5 2Bの69.44をわずかに下回っています。この規模としては優秀で、それ自体は良いことですが、AutomationBenchで見られるような圧倒的なリードではありません。(より大きなホスト型モデルのサポート業務での比較については、サポートチケットに最適なAIモデルの選定を継続的に更新しています。)
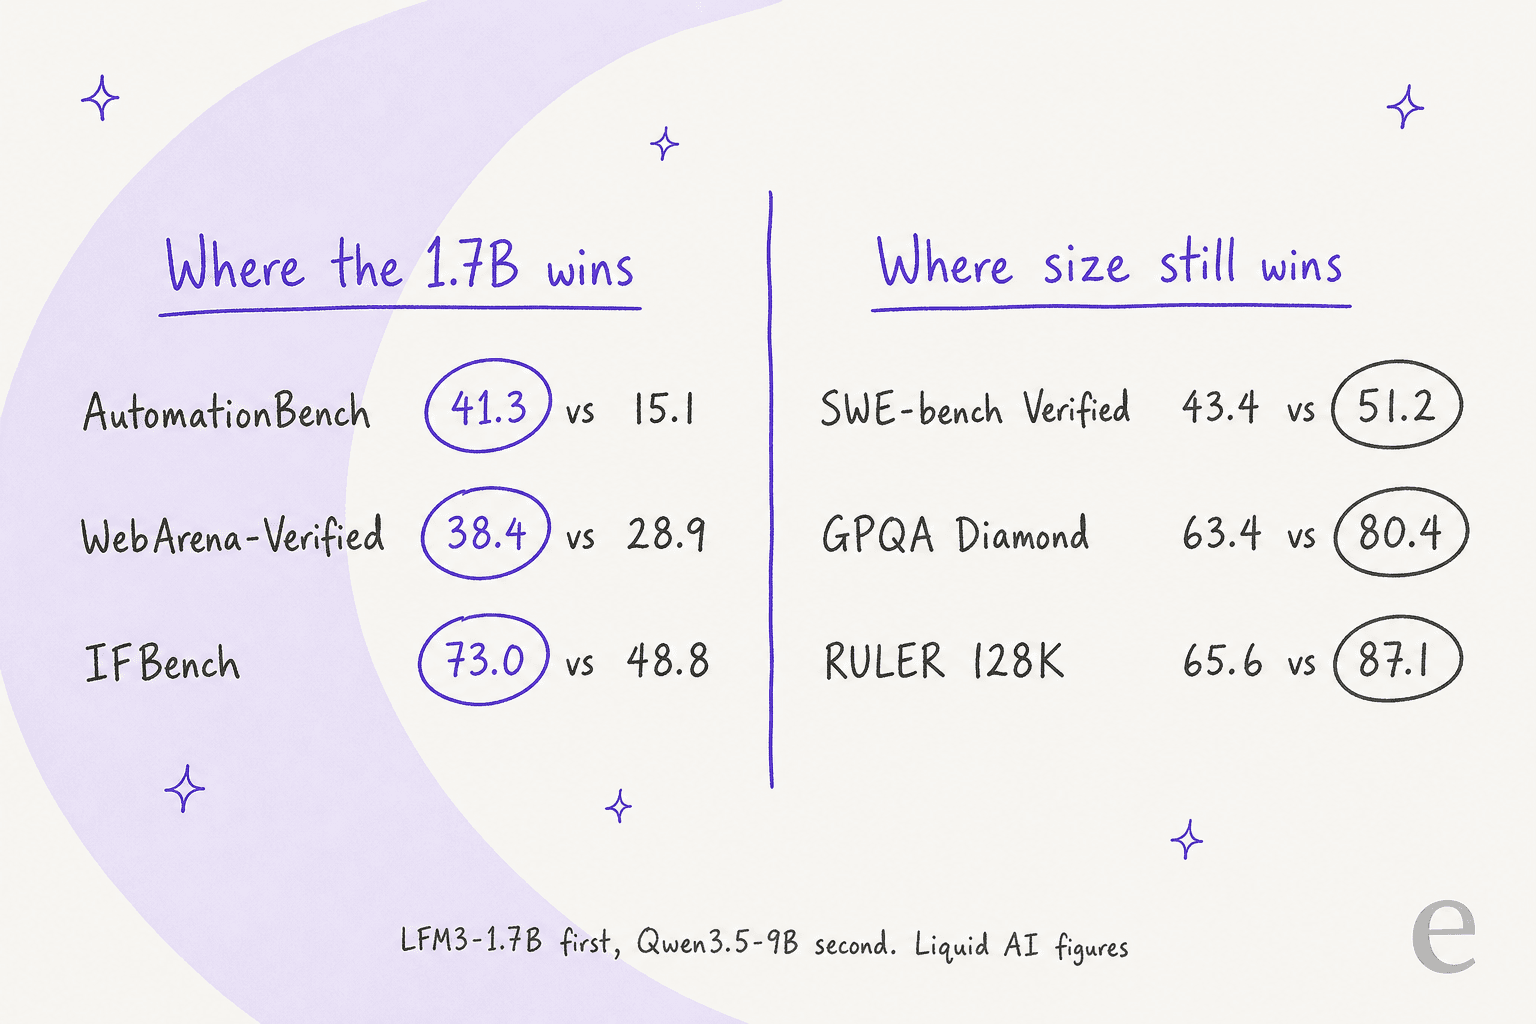
本当に重要なのは、この得意不得意の分かれ方です。LFM3-1.7Bは指示への追従とツール呼び出しが得意で、素の知識や長いコンテキストからの想起がスコアを左右する領域は苦手です。Liquidも同じことを述べています。検索は"helps close the knowledge gap," とされ、ツールを許可するとHumanity's Last Examのスコアが7.17から13.90へとほぼ倍増します。発表スレッドのある読者は、この表を次のようにまとめています。
"Agentic coding numbers on par with Qwen3.5-4B, the rest of the numbers on par with Qwen3.5-9B. Most impressive for a 1.7B model!"

もう1つ知っておきたい数値があります。推測するよりも「わかりません」と答えることを評価するAA-Omniscienceというテストでは、LFM3-1.7Bの非ハルシネーションスコアは92.93で、Qwen3.5-4Bは13.64でした。同じテストでの正答率はわずか7.07なので、主に回答を控えることでこのスコアを達成しています。もともと検索やナレッジベースを呼び出すことを想定したモデルとしては適切な傾向ですし、サポートでAIのハルシネーションを防ぐ際にも求めたい姿勢です。
スマートフォンやノートPC上でのLFM3の速度は?
同クラスでは非常に高速です。Liquidはllama.cppをQ4_0、32Kトークンのコンテキストでテストしました。LFM3-1.7Bは3つのデバイスすべてで最速となり、次点のモデルより1.8〜2.8倍速くデコードし、メモリ使用量も最少でした。
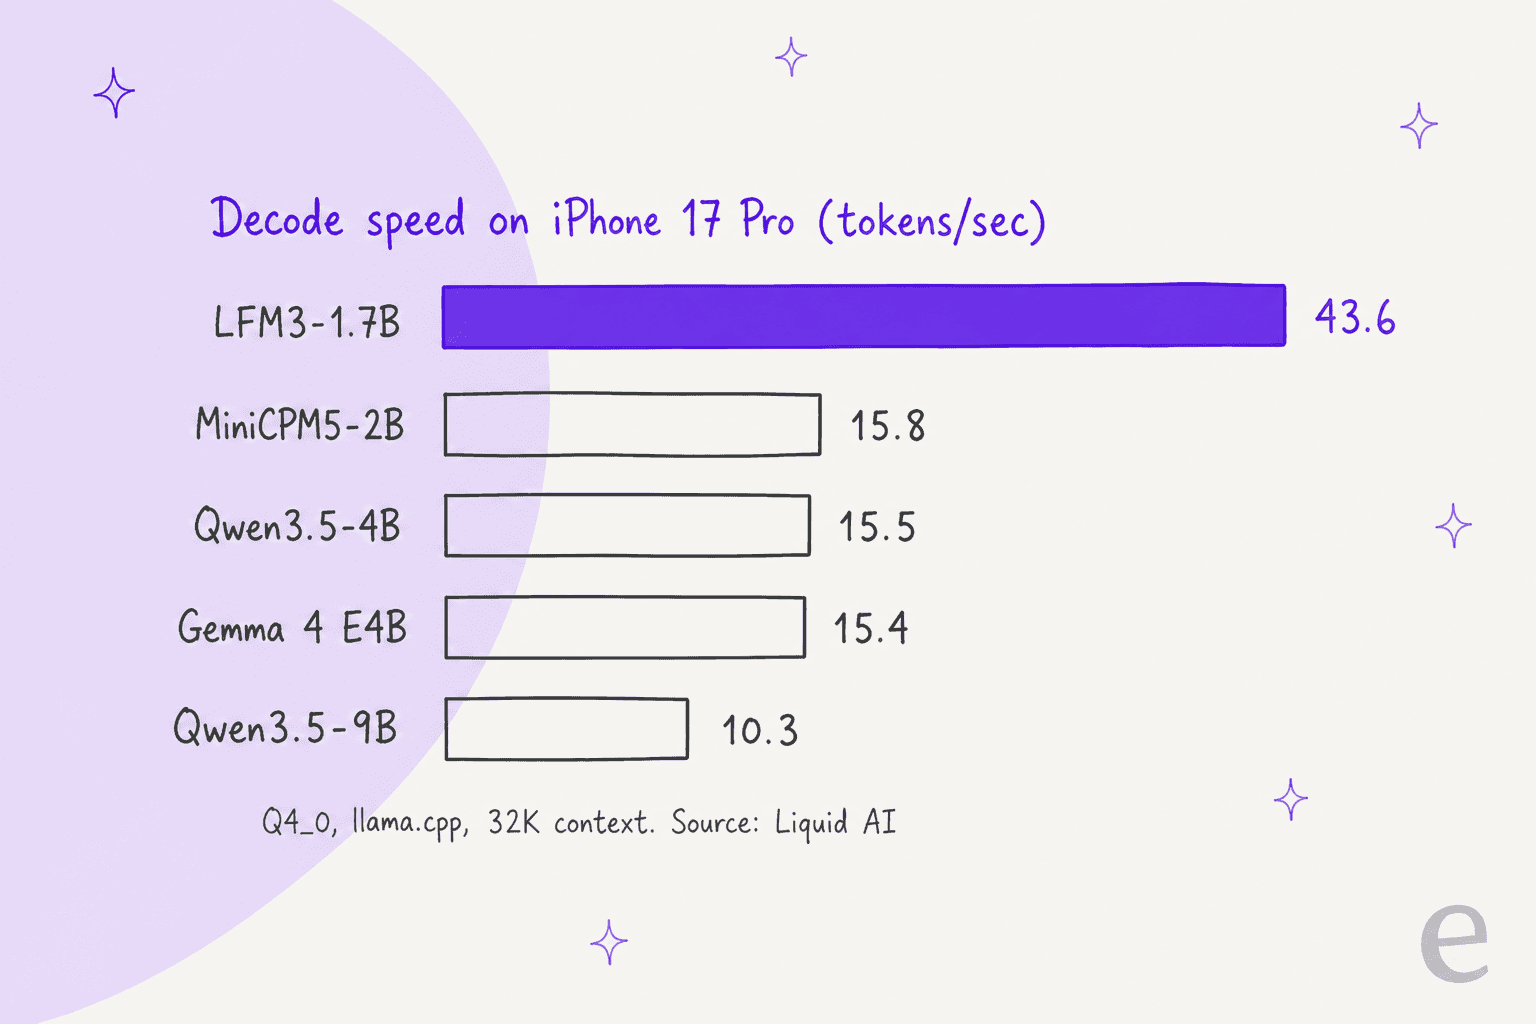
| デバイス | LFM3-1.7Bのデコード速度 | 次に速いモデル | LFM3-1.7Bのメモリ使用量 |
|---|---|---|---|
| iPhone 17 Pro | 43.6 tok/s | 15.8 (MiniCPM5-2B) | 1.90 GB |
| Apple M5 Max | 237.1 tok/s | 106.0 (MiniCPM5-2B) | 2.25 GB |
| AMD Ryzen AI Max+ 395 | 129.6 tok/s | 70.1 (MiniCPM5-2B) | 2.75 GB |
長いコンテキストでも負担は低いままです。128Kトークンのコンテキストをフルに使う場合、モデルがそれまでの会話を保持するためのメモリであるKVキャッシュは1.6 GBで済みます。対して、Qwen3.5-4Bは4.3 GB、MiniCPM5-2Bは5.6 GBです。Nanbeige 4.3のような中規模の密モデルでは、同じ長さで約28 GBのキャッシュが必要になります。
サーバー上では、少し桁外れの数値になります。NVIDIA B300を1基使い、1,024件の同時リクエストを処理したところ、LFM3-1.7Bは毎秒41,710トークンを出力しました。Liquidはこれを丸めて1日あたり3.6十億トークンとしています。これを実証するため、LiquidはEnronのメールアーカイブに対し、300,000を超えるLFM3-1.7Bエージェントを並列実行しました。独自の低遅延配信スタックでは、B200を1基使い、毎秒500件のリクエストを処理しても、短いリクエストのp95レイテンシは150 msにとどまりました。
ビジョン、音声、omniモデルには何ができるのでしょうか?
2BモデルのリリースとしてLFM3が異彩を放つのは、ファミリー内のほかのモデルです。どれもスマートフォン上で動くほど小さく、通常はより大きなクラウドモデルが必要になる仕事を担います。
LFM3-VL-2Bは、動画を入力できるLiquid初のビジョンモデルで、回答前に段階的に推論します。62のビジョンベンチマークの平均は71.4で、Gemini 3.5 Flash Lite(70.0)を上回り、6倍以上大きなGemma 4 12B(71.7)と同水準です。GPT-5.6 Luna(73.4)との差も2ポイント以内です。文書、OCR、グラフの読み取り(83.9)とGUIの理解(83.1)で最も高いスコアを記録しています。
LFM3-Audio-2Bは文字起こし、発話、音声翻訳を行います。新しいストリーミング音声エンコーダーにより、話している最中から処理を開始します。Liquidによると、最初のトークンが出るまでの時間は最短で50 msです。
LFM3-Omni-2Bは、見る、聞く、話すを1つでこなすLiquid初のモデルです。画像について音声で質問し、音声で回答を受け取ったり、音付きの動画について質問したりできます。また、音声による依頼と画面上の内容を、そのまま構造化されたツール呼び出しに変換することもできます。Liquidのデモでは、ノートPC上で音声によるフライト予約を行っています。サポート窓口向けの音声ツールを検討しているなら、私がまとめたおすすめのAI音声エージェントではホスト型サービスを、サポート向けAI音声エージェントのガイドでは導入方法を紹介しています。
d1判断モデルは何のためのものですか?
サポートチームを運営しているなら、LFM3の中で私が最も注目するのはこの部分です。d1-2Bとd1-Omni-2Bは文章を一切書きません。入力と質問のリストを渡すと、1回の順伝播ですべてに回答し、それぞれに較正された確率を付けます。Liquidは典型的な入力として、"a support ticket, an invoice, an app screen, a photo, a voice note" を挙げています。
d1-2Bのモデルカードでは、二重請求され、荷物も届いていない顧客のサポートチケットを主な例として使っています。モデルは1回の処理で担当チーム(請求、配送、技術)を選び、返金すべきかを判断し、さらにトピックを列挙して緊急度を採点します。Liquidは、H100上で判断1件当たり5.7 msと報告しています。これはまさにチケットのトリアージの仕事そのものです。そのため、今回のリリースではヘルプデスクチームにとって最も実用的なモデルだと私は考えています。この分野全体については、判断モデルの解説記事で取り上げました。
この世代で新しく加わったのが、型付き回答です。はい/いいえ、選択式、スコアに加え、d1モデルは次のことができます。
- Point: 説明した対象を枠で囲む、または該当するものをすべて数えます。
- Read: 文書からテキスト、数値、日付を正確な範囲とともに取り出すか、"not found." と答えます。
- Estimate: 数値と、あり得る範囲を示します。
- Pick: 該当する選択肢をすべて選び、それぞれに確率を付けます。
d1-2Bは、旧モデルのd1-3Bを、パラメータ数を3分の1減らして置き換えます。Liquidの"Typed Decisions (customer service cases)" テストでは、d1-Omni-2Bは文字入力で50.5、同じ質問を音声で入力した場合は48.0を記録し、業務の振り分けとトリアージを評価するDecisionBenchでは83.4でした。これらはLiquid独自のベンチマークなので、自分たちでテストする際の出発点として捉えてください。まず同じ仕事を手作業で設定する方法を知りたいなら、ルールを使ってチケットのトリアージを自動化する方法をご覧ください。発表スレッドでは、Liquidのエンジニアがハードウェア面の利点を端的に述べています。
"If you want to do local classification/image processing, I think the d1-2B is amazing, it can run on 1GB of unified RAM."
モデルカードは限界についても率直です。知識を多く必要とする質問では大きなモデルが有利で、入力が約64Kトークンを超えると回答の信頼性が下がります。
LFM3の料金はいくらですか?
ほとんどの企業は重みを無料で利用でき、API料金はまだ公開されていません。2026年10月28日時点のLiquidの料金ページとライセンスの内容は次のとおりです。
| 選択肢 | 料金 | 備考 |
|---|---|---|
| オープンウェイト、売上高$10M未満の企業 | 無料 | Apache 2.0を基にしたLFM Open License v1.0 |
| オープンウェイト、売上高$10M以上の企業 | 有料ライセンス、個別見積もりのみ | Liquidの営業担当に問い合わせ。売上高は企業グループ全体で集計 |
| 研究および条件を満たす非営利団体 | 無料 | 売上高の上限なし |
| Liquid API、LFM3モデル | 未公開 | 料金ページにはまだ掲載なし |
| Liquid API、d1 | 入力1Mトークン当たり$0.02、出力$0 | 旧d1であり、LFM3ベースのd1-2Bではありません |
| Liquid API、LFM2.5-24B-A2B | 1Mトークン当たり入力$0.05 / 出力$0.70 | Liquidのより大きなホスト型モデル |
| Liquid Consoleの新規アカウント | $2の無料クレジット | 組織ごと |
料金以上に重要な点が2つあります。まず、$10Mという売上高の基準は製品単位ではなく企業グループ全体に適用され、ユーザー数は関係ありません。次に、ライセンスにはコピーレフト条項がないため、再配布時に帰属表示とライセンスのコピーを含めれば、ファインチューニングしたバージョンを非公開のまま保持できます。
OpenRouterは初日からのリリースパートナーとして挙げられていますが、10月28日時点のLiquidのページには、旧世代のLiquidモデルとd1.1のみが掲載されており、LFM3モデルはまだありませんでした。公開料金表のあるホスト型モデルを今すぐ使いたいなら、比較対象はGPT-6 Lunaの料金です。Gemini 3.5 Flash Liteも、もう1つの低価格な選択肢です。
LFM3はどうやって動かすのでしょうか?
Hugging Faceからダウンロードしてローカルで実行するか、まずLiquidのブラウザ版プレイグラウンドで試せます。LFM3コレクションには、各モデルのBF16、GGUF、MLX 4-bit、ONNX版に加え、サーバー向けのFP8とNVFP4ビルドがあります。
ローカルで最も手早く始められるのはllama.cppです。LFM3-1.7Bのドキュメントには、Liquidの推奨設定を使った次のコマンドが掲載されています。
llama-cli -hf LiquidAI/LFM3-1.7B-GGUF --temp 0.1 --top-k 50 --repeat-penalty 1.1
始める前に知っておきたいことがいくつかあります。
- 新しいビルドが必要です。 GGUFのカードによると、LFM3対応のllama.cppビルドが必要です。Q4_0ファイルは
1.05 GB、Q8_0は1.85 GBです。 - 配信にはvLLMとSGLangが使えます。 Liquid自身のGPUベンチマークでは、LFM3対応のSGLang 0.5.22を使っています。
- 思考はデフォルトで有効です。 チャットテンプレートは
<think>ブロックを開きます。モデルカードでは、これを無効にすると動作が不安定になる場合があると注意しています。 - ツール呼び出しの形式が変わりました。 LFM3は、LFM2独自の形式ではなく、Qwen3-Coderの形式のスーパーセットとなるXML形式を使うため、古いパーサーは更新が必要です。
- ファインチューニングは低コストです。 LiquidはLFM3-1.7B向けに、SFT、DPO、GRPO用のTRLノートブックを用意しています。風力タービン点検のデモでは、A100を1基使い、約3,000枚の写真でLFM3-VL-2Bを数時間でファインチューニングしました。(サポートコンテンツでは、RAGとファインチューニングのどちらを使うかのほうが、よくある疑問です。)
ダウンロード前に試したいなら、Liquid Playgroundのモデル選択画面にLFM3-1.7B、LFM3-VL-2B、LFM3 Omni 2B、LFM3 Audio 2Bが用意されています。
初期ユーザーはLFM3についてどう言っていますか?
リリースからまだ1日なので、実際に使った報告は少なく、その大半は101ポイントと36件のコメントを集めたHacker Newsの発表スレッドにあります。初期の使用感は、ベンチマーク表を現実に照らして確認するうえで役立ちます。
ある読者はプレイグラウンドで基本的な事実の誤りを見つけ、量子化が原因だと考えました。
"when asked “what does a cow say?”, LFM3-1.7B said that a cow can say “Oink”... I assume this is lower quant problem, though: Q8 versions I’ve played with through llama both give the correct “moo” answer."
別の読者は、システムプロンプトなしの雑学の質問で、求めてもいないのに、ツール使用を重視した学習の影響が表れることに気づきました。
"I am seeing the following in the reasoning trace: > However, the instructions say I must use available tools when answering questions."
初日のツール環境にも、まだ粗い部分がありました。ある読者は、LM Studioでも、ほかの2つのMLXランナーでも、MLXビルドを読み込めませんでした。サポート業務に最も関係の深いコメントは、前世代のモデルで受信メッセージをトリアージしている人からのものでした。
"The LFM annotations are basically triage... Right now LFM 2.6 gets trustworthy annotations on just over 40% of data points."
これは、本番環境における小型モデルの現実的な姿です。簡単な部分を処理し、残りはより大きなモデルや人が担当します。私もAIによるチケット分類では、同じ役割分担を使います。
LFM3の弱点はどこですか?
率直な制約の大半は、Liquid自身の注意事項に書かれています。
- エージェント型コーディングや難しい推論向けではありません。 LFM3-1.7Bのカードには、"not recommended for agentic coding or complex multi-step reasoning," とあり、知識を多く必要とするタスクには情報取得や検索を勧めています。ビジョンモデルのカードでは、さらに複数ターンの会話もこのリストに加えています。
- 数値はすべてベンダーによる報告です。 10月28日時点でArtificial AnalysisにはLFM3が掲載されていなかったため、独立したスコアはまだありません。
- ライセンスはApache 2.0ではありません。 近いものではありますが、売上高$10Mという基準があるため、大企業は製品に組み込んで提供する前に有料契約が必要です。
- 音声モデルのコンテキストは短めです。 LFM3-Audio-2BとLFM3-Omni-2Bのウィンドウは32Kトークンで、テキストモデルの8分の1です。
- ツール対応はまだ追いついていません。 ビジョンモデルのカードでは、llama.cpp対応はレビュー中で動画には未対応、vLLM対応は進行中とされています。
LFM3を使うべきでしょうか?
何を作っているかによります。
- オンデバイスアシスタントとローカルエージェント: はい、まずLFM3-1.7Bを試してください。Liquidが比較したほかのモデルには、これほど少ないメモリでこれほど速く動くものはなく、実際のエージェント実行基盤内で学習されています。テストするオープンソースAIエージェントのリストには、ぜひ入れておきたいモデルです。
- 大規模な分類、振り分け、抽出: d1-2Bに注目してください。1回の処理で多くの質問に答え、判断1件当たりミリ秒単位、RAMは約1 GBです。チケットの振り分けやタグ付けに自然に適合します。
- 音声やカメラを使うアプリ: LFM3-Omni-2Bは、聞くことも話すこともできる珍しい小型モデルです。32Kのコンテキストには注意してください。
- コーディングエージェント: おすすめしません。Liquid自身がそう述べていますし、Nanbeige 4.3のようなモデルや、Nemotron 3.5 Boltのペアから始めるほうがよいでしょう。
- カスタマーサポートエージェント: LFM3は、特にトリアージなど、仕事の一部を担う強力なエンジンですが、それ自体がエージェントというわけではありません。次のセクションでは、何が足りないのかを説明します。
実際のサポートキューで小型モデルを動かす
d1-2Bのようなモデルは、チケットが請求に関するもので、緊急性が高いと判断できます。しかし、実際に役立つには、ヘルプデスク内で動き、届いたチケットを読み、ヘルプセンターや過去のチケットを調べ、タグを書き戻し、返信の下書きを作り、どのチケットを人が担当すべきかを判断する仕組みが必要です。その仕事のために作られたのが、eeselのAIヘルプデスクチームメイトです。自分で組み込む必要があるモデルではなく、特定の役割のために採用する、すぐに働けるAIチームメイトの1つです。

デンマークのオンライン法的文書サービス企業であるDokument 24は、トリアージを実務で活用する好例です。2026年8月8日から9月8日までの間に、eeselは約680件のZendeskチケットの対応準備を行い、そのうち約430件に商品別(遺言書、婚前契約、将来の代理権委任、会社設立)のタグを付け、チームが送信できるよう、デンマーク語の返信下書き約670件を社内メモとして残しました。回答には、約2,600のWebページとZendesk内の項目を使っています。オークランドのERPソフトウェア企業Qontroは、すべてのFreshdeskチケットで下書きを作成していますが、障害、データ損失、移行、請求は直接人に回します。こうした振り分けルールは、ベンチマークでは決してテストされない部分であり、実際のチケット当たりのコストを決める要素でもあります。
本番稼働前に、eeselは過去のチケットに対して設定を試すため、顧客が目にする前に回答を確認できます。そのテストの仕組みについては、別の記事にまとめました。また、ローカルモデルを使うときのようにターミナルで作業したいなら、eesel CLIを使えば、自分自身、スクリプト、Claude Codeのようなコーディングエージェントから、外部サービスとの連携、エージェントの常設指示の編集、保留中の操作の承認や拒否、アクティビティログの閲覧を、すべてJSONで行えます。
eeselを試す
LFM3は、オンデバイスエージェントや、チケットの振り分けのように1回の処理で行う判断に向いた、高速で低コストなエンジンです。今週中にZendesk AIやFreshdeskの環境で、チケットのタグ付け、振り分け、返信下書きの作成を実現したいなら、eeselのAIヘルプデスクチームメイトは数分でヘルプデスクに加わり、過去のチケットとヘルプセンターから学び、設定したルールの範囲内で働きます。カード不要で100クレジットから無料で始められるので、導入を決める前に実際のチケットでテストできます。eeselを試す。
よくある質問
LFM3とは何ですか?
LFM3は、Liquid AIが2026年10月27日にリリースした第3世代のLiquid Foundation Modelsです。初回リリースは、それぞれ約2Bパラメータのオープンウェイトモデル6種で、すべてLFM3-1.7B-Baseという共通の基盤モデルをもとに構築されています。内訳は、テキストモデル、画像モデル、音声モデル、オムニモデル、そして2種の判断モデルです。これらは、MiniCPM5 2Bや小型のGemma 4と同じ小規模言語モデルのグループに属します。
LFM3は無料で使えますか?
ウェイトは、Apache 2.0をベースとするLFM Open License v1.0のもと、Hugging Faceから無料でダウンロードできます。商用利用が無料なのは、企業グループの年間売上高が$10 million未満の場合に限られます。それ以上の場合は、Liquid AIの有料ライセンスが必要です。研究目的および条件を満たす非営利目的の利用には、売上高の制限はありません。Nanbeige 4.3のように、全面的にApache 2.0を採用したモデルと比較してみてください。
LFM3 APIの料金はいくらですか?
Liquid AIは、まだどのLFM3モデルについてもトークン単位の料金を公開していません。料金ページに掲載されているのは、d1(入力100万トークンあたり$0.02、出力$0)、d1-ultra($0.042 / $0)、LFM2.5-24B-A2B($0.05 / $0.70)のみで、新規組織には$2の無料クレジットが付与されます。LFM3はまだOpenRouterにも掲載されていません。ホスト型モデルの料金については、GPT-6 Lunaの料金をご覧ください。
LFM3-1.7Bにはどのくらいのメモリが必要ですか?
4ビットでは約1 GBです。Q4_0 GGUFファイルは1.05 GB、Q8_0は1.85 GBです。Liquid AIのテストでは、iPhone 17 Proで32Kコンテキストを使用した際のメモリ使用量は1.90 GBでした。また、128Kのコンテキスト全体を使うには1.6 GBのKVキャッシュが必要で、Qwen3.5-4Bでは4.3 GBが必要です。そのため、スマートフォン上で長いコンテキストを扱える数少ない小型モデルの1つとなっています。
LFM3-1.7BはQwen3.5より優れていますか?
Liquid AI自身の比較表では、29のベンチマークにおけるLFM3-1.7Bの平均は49.37で、約5倍の規模を持つQwen3.5-9Bの47.24を上回っています。業務自動化とブラウザ操作のタスクでは明確に優位に立っていますが(AutomationBenchは41.29対15.10)、コーディングと知識では劣っています(GPQA Diamondは63.37対80.40)。これらはベンダーによる数値であり、独立したテストの結果ではありません。もう一方については、Qwenの概要をご覧ください。
LFM3はカスタマーサポートのチケットトリアージに使えますか?
最も適しているのは、判断モデルのd1-2Bです。モデルカードでは、1回の処理でチケットを請求、配送、技術サポートに振り分け、返金に関するフラグを付け、緊急度をスコア化する例が示されています。ただし、ヘルプデスクへの接続と、自社のチケットを使ったテストは必要です。すぐに使える選択肢については、サポートチケットのトリアージに最適なAIをご覧ください。
LFM3のd1判断モデルとは何ですか?
d1-2Bとd1-Omni-2Bは、文章を生成しないモデルです。チケット、請求書、写真、音声メモなどの入力と質問のリストを渡すと、1回の処理ですべての質問に回答し、各回答の確率も返します。d1-2Bはテキストと画像に対応し、d1-Omni-2Bはさらに音声にも対応します。詳しくは判断モデルをご覧ください。