

Nanbeige 4.3は、無料かつApache 2.0ライセンスの330億パラメータのオープンモデルであり、開発元が公開した20のベンチマークのうち18でQwen3.8-27Bを上回っています。 特にエージェント型コーディングにおいて、DeepSWEで65.5対42.5、Terminal-Bench 4.0で23.8対6.3と圧倒的なリードを見せています。2026年10月24日にHugging Faceで公開され、Nanbeigeはこれを「教師(teacher)」と呼んでいます。真の狙いは、まだリリースされていない蒸留版のNanbeige4.3-3Bにあります。
注意点はメモリです。これは標準的な密なLlamaスタイルのモデルであるため、コンテキストキャッシュに1トークンあたり約0.2 MBのコストがかかります。128Kコンテキストでは、4ビットウェイトの約21 GBに加えて約28 GBのキャッシュが必要となり、ほとんどの個人向けGPUでは実行不可能です。
また、サポート業務への活用を検討している場合は、詳細を確認する必要があります。Nanbeige自身のJobBenchチャートでは、カスタマーサービス業務においてQwenの31.6に対し21.1というスコアでした。サポートエージェントの価値は、コーディングのスコアではなくヘルプデスクの設定によって決まります。そのため、smavaのようなチームは、自前で構築するのではなく、eeselのような既製のAIヘルプデスクエージェントをこれらのモデルの上で運用しています。
Nanbeige 4.3とは何ですか?
Nanbeige 4.3は、中国の求人プラットフォームBOSS Zhipin(Kanzhun Limited運営)内のAIチームであるNanbeige LLM Labによる第4世代のモデルシリーズです。現在、公開されているのはNanbeige4.3-33Bと、チューニング前のベースモデルの2つです。どちらも2026年10月24日に公開され、翌日にはラボがXで発表し、2,248件の「いいね」を集めました。
私はeeselでインテグレーションとAPIを構築しているため、新しいオープンモデルが登場すると、常に同じ最初の疑問を抱きます。それは「実際の製品の裏側でこれを動かすには何が必要か?」ということです。本記事ではその視点から解説します。
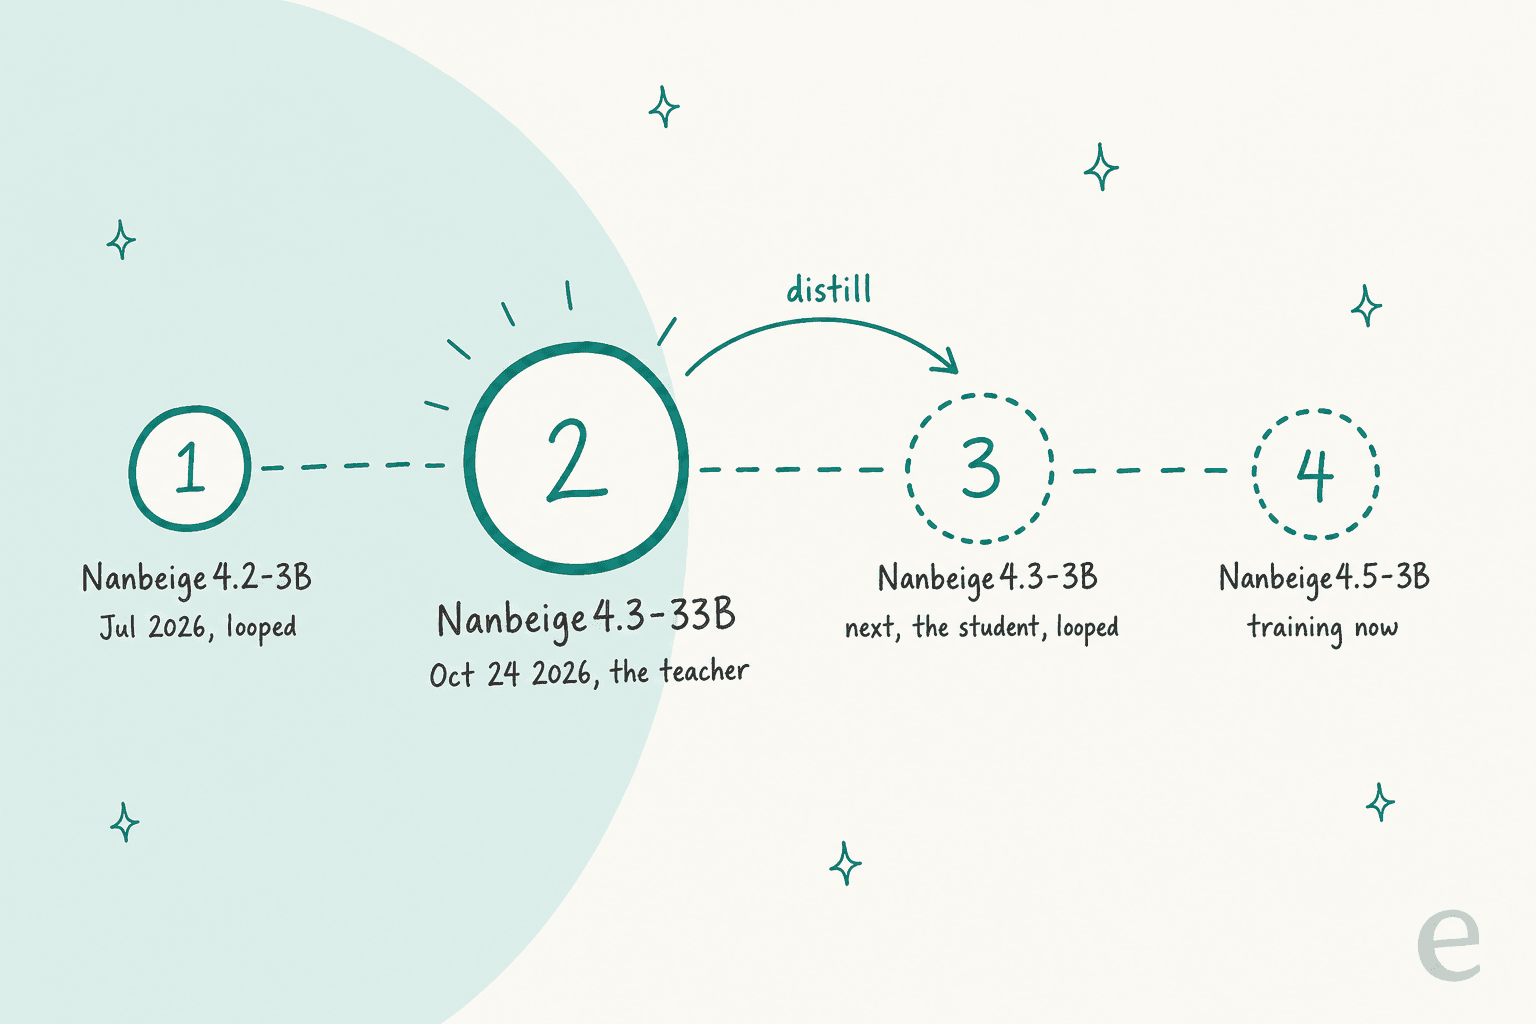
興味深いのはそのサイズではありません。Nanbeigeは小型言語モデル(SLM)で名を馳せました。レイヤーを再利用してトークンあたりの思考を深める「Looped Transformer(ループ型トランスフォーマー)」を採用したNanbeige4.2-3Bは(GPT-6 Astraでも注目されたアイデアです)、先月だけで116,000回以上のダウンロードを記録しています。では、なぜ33Bモデルをリリースしたのでしょうか?モデルカードには、「まず能力の高い教師エージェントを構築し、そのスキルを小型モデルに蒸留する」という戦略が直接記されています。ローンチ時の投稿によると、この取り組みは「Nanbeige4.3-3Bから」開始されるとのことです。
つまり、33Bモデルは通過点に過ぎません。それ自体も有用ですが、Nanbeigeが本当に重視しているのは、生徒役となる3Bモデルなのです。
仕様の一覧
以下の情報は、リポジトリ内のモデルカードおよび設定ファイルに基づいています。
| 仕様 | Nanbeige4.3-33B |
|---|---|
| パラメータ数 | 331億、密(dense) |
| アーキテクチャ | LlamaForCausalLM、52レイヤー、56アテンションヘッド、8キーバリューヘッド |
| コンテキストウィンドウ | 524,288トークン (512K) |
| 入出力 | テキストのみ、英語および中国語 |
| ライセンス | Apache 2.0 |
| ウェイトのサイズ | BF16形式で66.2 GB(14ファイル) |
| バリアント | 指示(Instruct)モデルおよびベース(Base)モデル |
| 思考モード(Thinking mode) | デフォルトでオン、enable_thinkingで切り替え可能 |
| ツール呼び出し | XMLを推奨、JSONをサポート |
| 対応フレームワーク | Transformers、vLLM、SGLang |
ローンチ時の投稿に対するある返信は、多くの人の手間を省いてくれました。
「33Bの密なモデル、テキストのみで画像認識(vision)はなし。時間の節約になれば。」
Nanbeige 4.3のベンチマーク結果は?
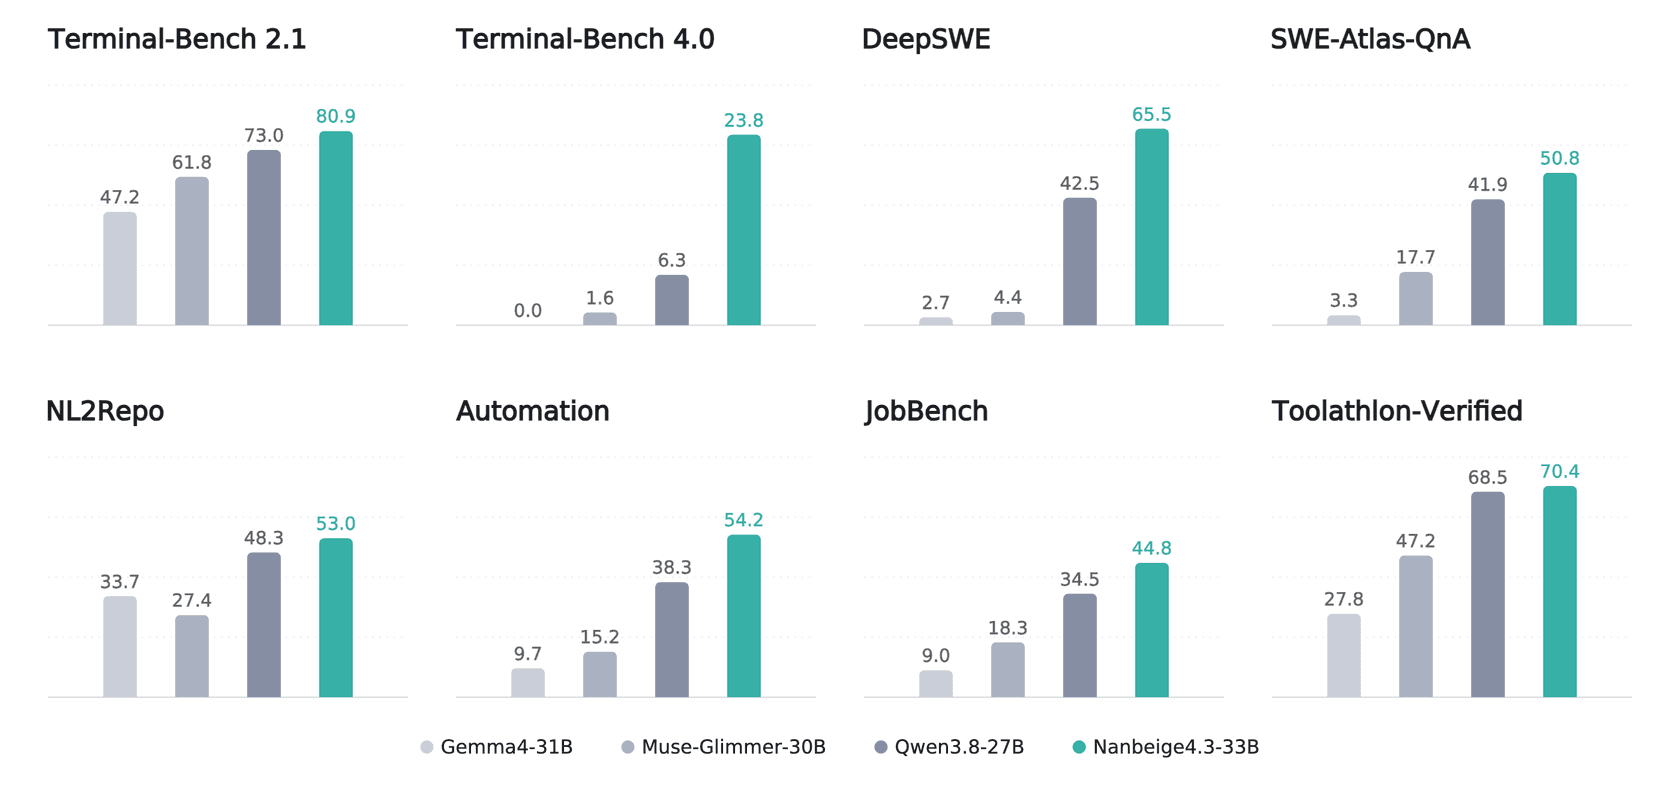
机上では非常に優れています。Nanbeigeは、同程度のサイズの3つのオープンモデル(すべて最高レベルの思考設定)と比較し、20のスコアを公開しました。Nanbeige4.3-33Bは、17の項目で3つのライバルすべてを上回り、最も近い競合であるQwen3.8-27Bに対しても18の項目で勝利しています。以下はモデルカードから引用した全データです。
| ベンチマーク | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma4-31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 80.9 | 73.0 | 61.8 | 47.2 |
| Terminal-Bench 4.0 | 23.8 | 6.3 | 1.6 | 0.0 |
| DeepSWE | 65.5 | 42.5 | 4.4 | 2.7 |
| SWE-Bench Pro | 60.3 | 61.7 | 36.9 | 51.2 |
| SWE-Atlas-QnA | 50.8 | 41.9 | 17.7 | 3.3 |
| NL2Repo | 53.0 | 48.3 | 27.4 | 33.8 |
| Scicode | 52.6 | 46.7 | 44.9 | 45.5 |
| SkillsBench | 61.1 | 56.4 | 39.7 | 28.9 |
| Automation Bench | 54.2 | 38.3 | 15.2 | 9.7 |
| JobBench | 44.8 | 34.5 | 16.6 | 9.0 |
| GDPval | 84.8 | 86.4 | 75.8 | 71.4 |
| Claw-Eval (pass^3) | 78.3 | 75.2 | 57.3 | 44.2 |
| Toolathlon-Verified | 70.4 | 68.5 | 47.2 | 27.8 |
| DeepPlanning | 63.3 | 49.2 | 21.4 | 19.4 |
| EnterpriseOps-Gym | 41.0 | 40.2 | 30.5 | 27.3 |
| YC-bench | $1,025,437 | $641,290 | $513,978 | $265,152 |
| Tau3-Bench | 48.8 | 48.5 | 33.7 | 18.6 |
| GPQA Diamond | 89.5 | 89.2 | 83.5 | 91.3 |
| AIME 2026 | 95.2 | 94.5 | 94.7 | 89.2 |
| AA-LCR | 84.0 | 82.0 | 83.3 | 72.0 |
コーディングの数値が最大の注目点です。Terminal-Bench 4.0は、コマンドライン操作をテストする新しい、より難易度の高いバージョンですが、Nanbeigeは同クラスの次点のモデルが6.3であるのに対し、23.8を記録しています。DeepSWEも同様で、42.5に対して65.5となっています。もしClaude CodeやOpenClawのようなターミナル用コーディングエージェントをローカルモデルで動かすなら、この差を実感することになるでしょう。それらのツールの違いについては、エージェント型コーディングCLIガイドで詳しく解説しています。
ただし、この表を鵜呑みにする前に3つの注意点があります。
- ラボ独自の実行結果であること: Nanbeigeはすべてのモデルに対して同じツールと設定を使用しており、公平ではありますが、第三者による再検証はまだ行われていません。Artificial Analysisには過去のNanbeigeモデルは掲載されていますが、本モデルはまだです。
- 使用する環境(harness)に左右されること: Terminal-Bench 2.1はTerminus 2、DeepSWEはmini-swe-agent v2.4.6、NL2RepoはClaude Code内で実行されました。エージェントの設定によって、これらの数値は変動します。
- 細かなデータの不一致: 棒グラフと表の間で、2つのセルに相違があります(Muse-GlimmerのJobBenchはグラフでは
18.3ですが、表では16.6です)。些細なことですが、引用する際には注意が必要です。
Nanbeige 4.3が劣っている点はどこですか?
コーディング関連以外の項目に目を向けると、リードは急速に縮まります。特に、Qwen3.8 Maxの弟分であるQwen3.8-27Bと比較すると、SWE-Bench Pro(60.3対61.7)やGDPval(84.8対86.4)で後れを取っています。また、航空会社や小売業の顧客対応をシミュレートするTau3-Benchでは、48.8対48.5と、ほぼ互角の結果です。
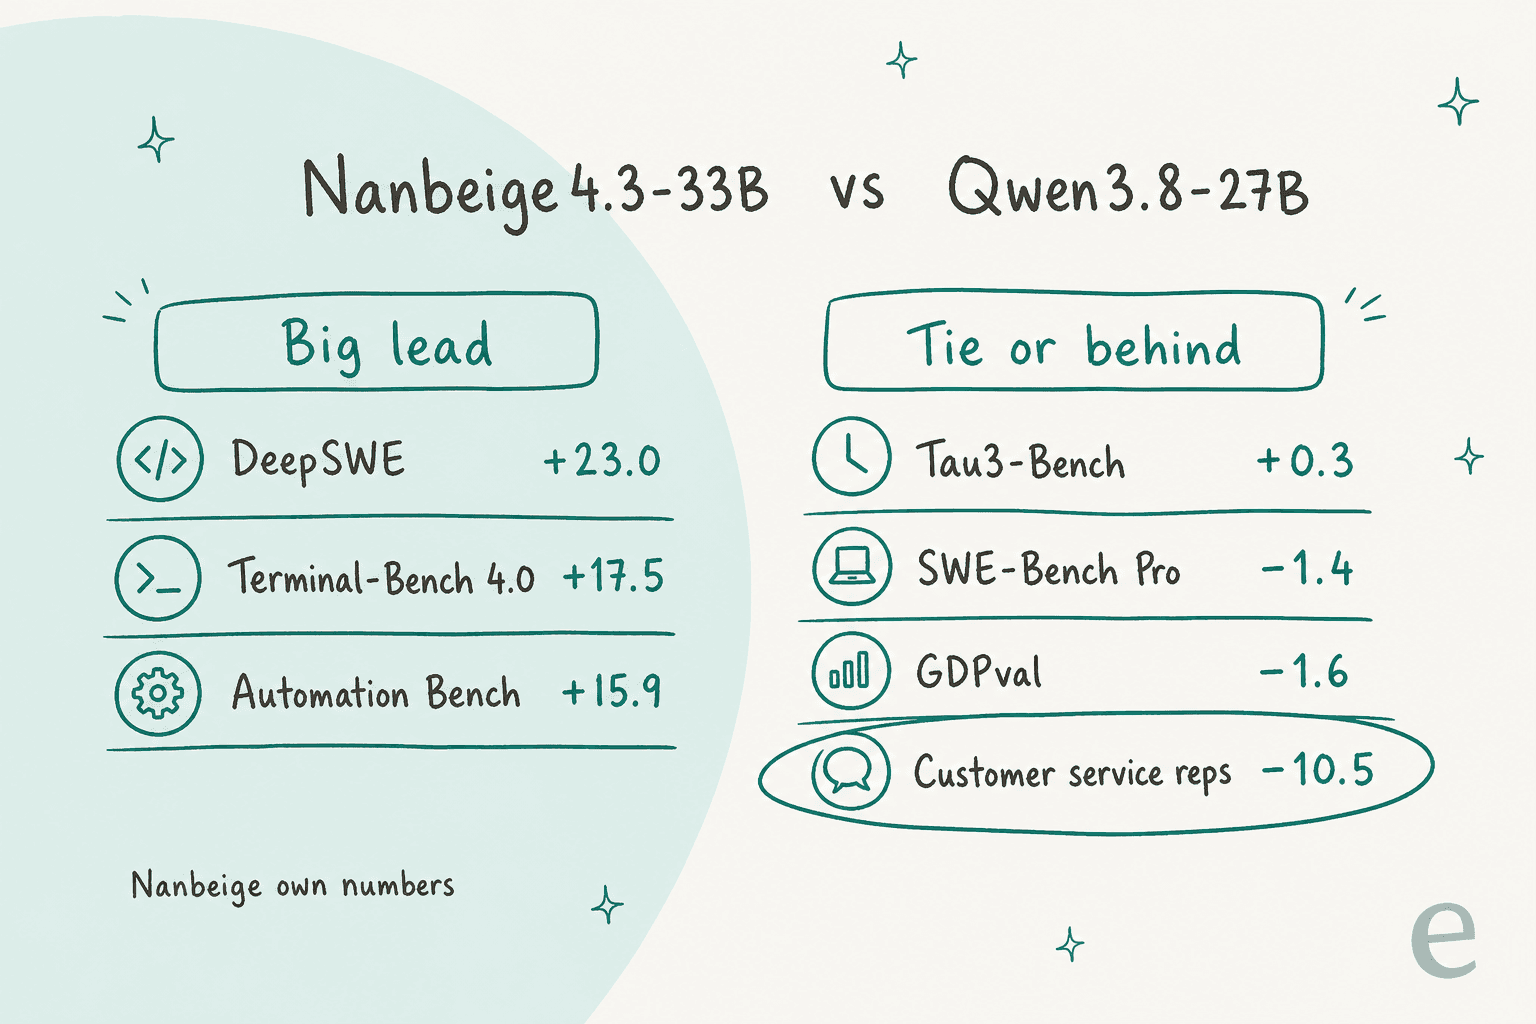
特筆すべき詳細は、35の職種別にスコアを分解したJobBenchチャートにあります。Nanbeigeはほとんどの職種で勝利しており、Web管理者(72.0対36.0)やテクニカルライター(72.1対53.7)では大差をつけています。しかし、カスタマーサービス担当者のタスクでは、Qwenの31.6に対し21.1となっており、秘書や事務アシスタント(28.8対47.5)でも敗北しています。
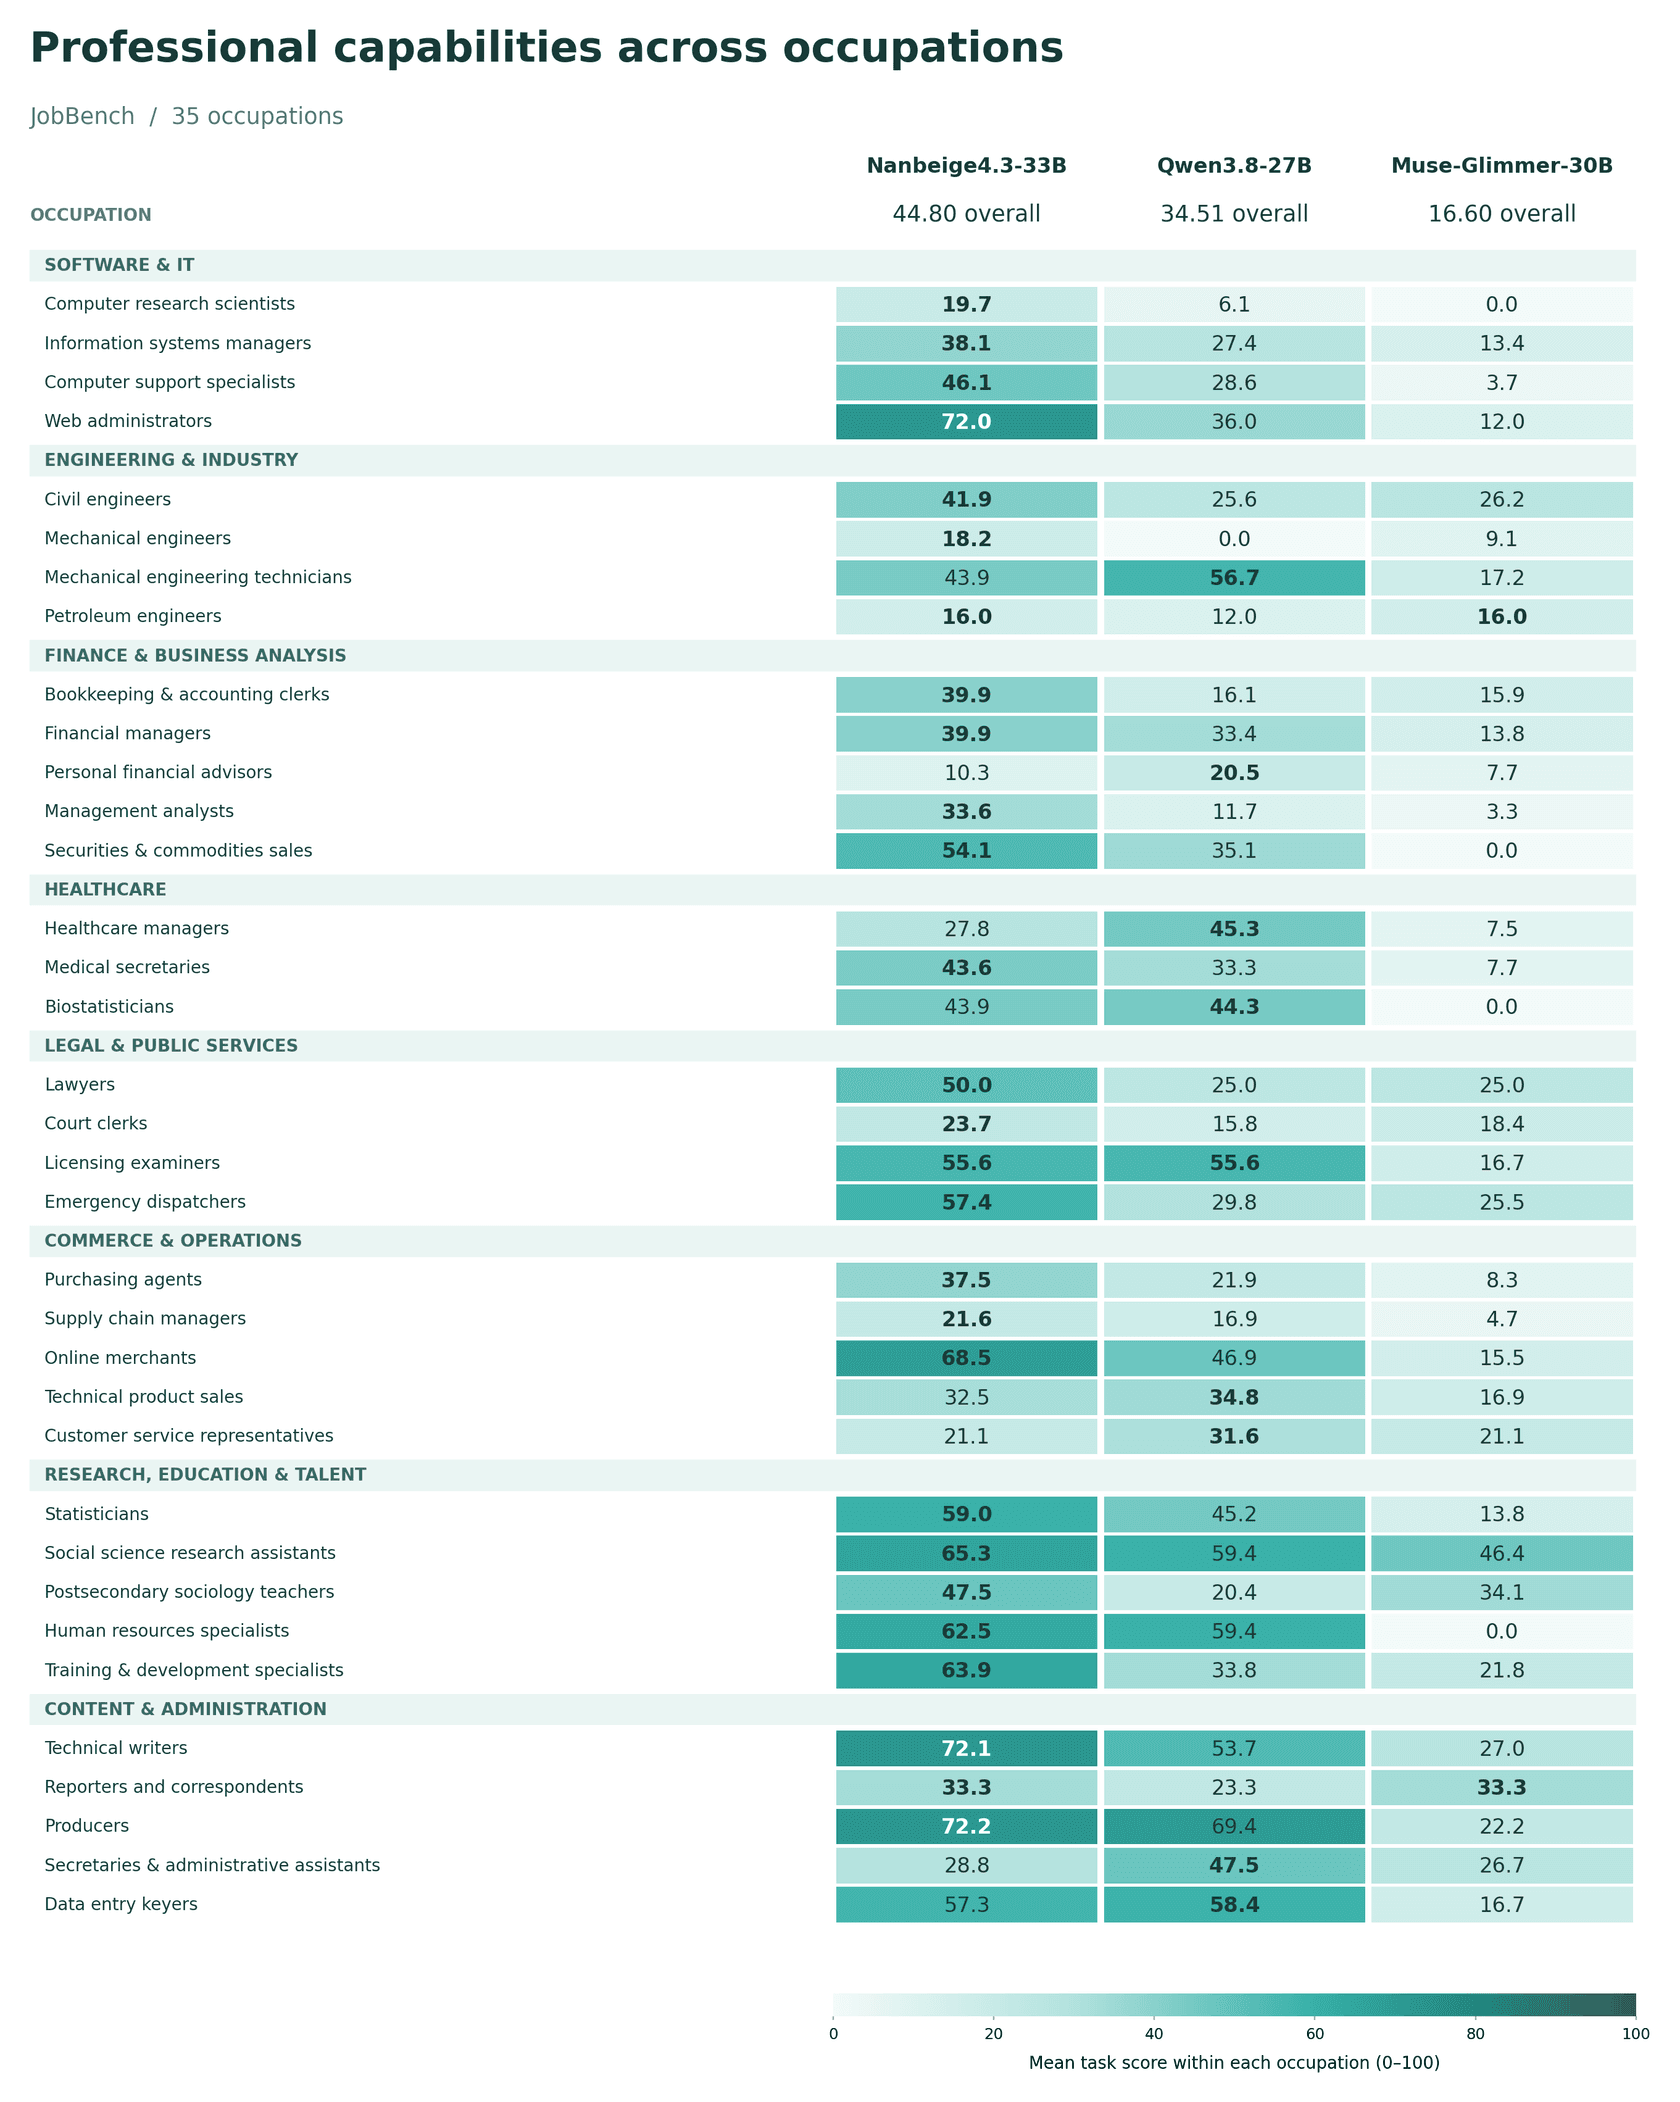
これは、私がサポート業務の現場で見ている状況と一致します。ターミナルでコードを書くのが得意だからといって、返金について怒っている顧客への対応が自動的に上手くなるわけではありません。これがAIエージェントとチャットボットが別物である理由でもあります。サポートの質は、モデル自体よりも、モデルがどれだけ適切な情報を参照できるかに依存します。サポートチケットに最適なモデルのまとめでも述べましたが、回答の根拠がツールではなくドキュメントにある場合、同じモデルでもSierraのTauベンチマークで68ポイントも低下することがあります。
Nanbeigeは公式リポジトリを使用してTau3-Benchを実行しましたが、そのスコアはSierraの公式リーダーボードには掲載されていないため、リーダーボードの数値と単純に比較しないよう注意してください。
Nanbeige 4.3の実行にはどのくらいのメモリが必要ですか?
ここが、ローンチ時の投稿で触れられていない部分です。ウェイト自体は管理可能な範囲です。bartowskiによるコミュニティ版の4ビットGGUFは、Q4_K_Mで20.79 GB、Q8_0で35.2 GBです。問題はコンテキストです。
Nanbeige4.3-33Bは、52レイヤー、それぞれ128次元の8つのキーバリューヘッドを備えた、Grouped-Query Attention(GQA)を採用した古典的な密なトランスフォーマーです。コンテキスト内に保持するすべてのトークンには、16ビットで 2 × 52 × 8 × 128 × 2バイト、つまり1トークンあたり212,992バイトのコストがかかります。パラメータ数ではなく、この数値が使用すべきGPUを決定します。
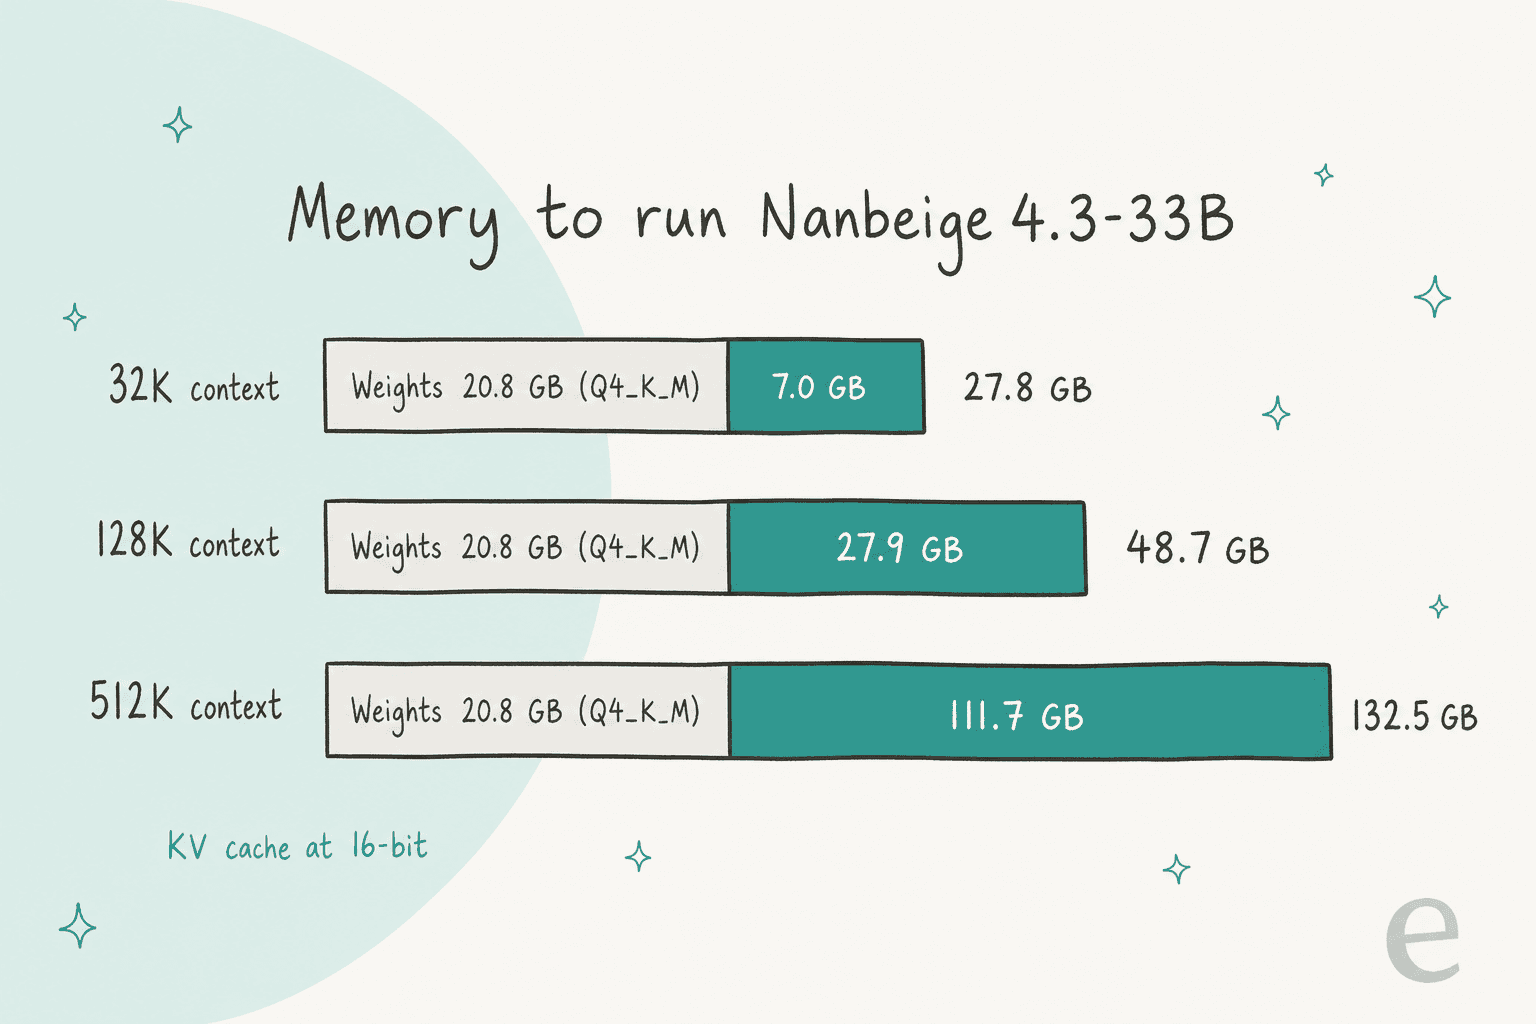
| コンテキスト長 | KVキャッシュ (16ビット) | KVキャッシュ (8ビット) | Q4_K_Mウェイト時の合計 (16ビットキャッシュ) |
|---|---|---|---|
| 32K | 7.0 GB | 3.5 GB | 約27.8 GB |
| 128K | 27.9 GB | 14.0 GB | 約48.7 GB |
| 256K | 55.8 GB | 27.9 GB | 約76.6 GB |
| 512K | 111.7 GB | 55.8 GB | 約132.5 GB |
したがって、「512Kコンテキスト」という見出しは嘘ではありませんが、それをフルに活用するにはサーバー級のハードウェアが必要です。Nanbeige自身のvLLMおよびSGLangのサーバー実行例では、テンソル並列化(tensor-parallelism)を4に設定しており、これは4枚のGPUを想定しています。
これにはユーザーもすぐに気づきました。リポジトリで最も議論されているスレッドは、KVキャッシュの最適化を求めるもので、同サイズの一部のライバルは、同じコンテキスト長でも数分の一のキャッシュで済むことが指摘されています。モデルカードの「コスト効率が高い(cost-effective)」という謳い文句に対し、長いコンテキストにおいては密な33Bモデルは決して安上がりではないという、妥当な指摘です。
シンプルな設計の利点は、互換性の高さです。標準的なLlamaアーキテクチャであるため、2日以内にHugging Face上には30以上のコミュニティによる変換モデル(GGUF、Apple Silicon向けのMLX、NVFP4、FP8など)が登場しました。また、Qwenの推論およびツール呼び出しパーサーを使用して、標準的なvLLMやSGLangで動作します。
Nanbeige 4.3の動かし方は?
Nanbeigeからのホスト型API提供はなく、2026年10月26日時点でOpenRouterにも掲載されていません。ウェイトをダウンロードして自前で動かす必要があります。モデルカードでは3つの方法が紹介されています。
- Transformers: クイックテスト用。
trust_remote_code=Trueとdevice_map='auto'を設定してNanbeige/Nanbeige4.3-33Bをロードします。 - vLLM: サーバー運用向け。例では
--tensor-parallel-size 4、--reasoning-parser qwen3、--tool-call-parser qwen3_coderを使用しています。 - SGLang: 同様のパーサーを使用し、
--tp-size 4で実行します。
チャットテンプレートの2つの設定が、見た目以上に重要です。
enable_thinking:デフォルトでオンです。素早い回答が必要な場合はオフにします。preserve_thinking:前のターンの推論を保持します。ツール利用やコーディングエージェントにはTrue、単純なチャットにはFalseを推奨しています。ベンチマークスコアはこれをオンにして測定されました。
推奨設定も用途によって異なります。エージェントやツール利用には、温度(temperature)1.0で最大65,536トークン。推論やチャットには、温度0.6で最大262,144トークンが推奨されています。
ローカルでの選択肢を比較しているなら、最近紹介したGemma 4、Mistral Large 4、DeepSeek V4 Flashなどが、サイズ、コンテキストコスト、ホスト型アクセスの有無において異なるトレードオフを提供しています。オープンソースAIエージェントのリストでは、これらのモデルを組み込めるフレームワークを、AIコーディングアシスタントのまとめではホスト型サービスをカバーしています。自前でのホスティングではなくAPIアクセスを好むなら、Kimi K3やMiniMax 3が有力な候補になります。
Nanbeigeの今後の展開は?
NanbeigeのチームはHugging Faceのページで質問に直接回答しており、そこから3つのロードマップが見えてきました。33Bモデルが4.2のようなループ型設計を再利用しているかという質問に対し、チームメンバーは否定し、その理由を次のように述べました。
「我々の実験に基づくと、Looped Transformerアーキテクチャは、より小さなモデルサイズにおいて、品質と計算コストのより良いトレードオフを提供します。今後登場するNanbeige4.3-3BやNanbeige4.5-3Bといった小型モデルは、Looped Transformerを採用し、パフォーマンスを向上させる予定です。」
また、テクニカルレポートはNanbeige4.3-3Bと同時に公開されること、高速な生成のためにDFlash2投機的デコードモジュールが計画中であること、そしてFP8ウェイトが「近日公開」であることが語られています。9月にはラボがXで、Nanbeige 4.5がすでにトレーニング中であるとも述べています。
私の見解では、手軽なハードウェアで小型エージェントを動かしたいなら、待つべきは今回のモデルではなくNanbeige4.3-3Bです。33Bモデルは「教師が強力であること」の証明です。そのコーディングの優位性を、ラップトップで動くサイズにまで引き継げるかどうかが真の焦点であり、それはリリースされるまで誰にも分かりません。
Nanbeige 4.3を使うべきですか?
それは何を構築しているかによります。ベンチマークの表がすでに答えを示しています。
- 自前ハードウェアでのコーディングエージェント: はい、試す価値があります。Terminal-Bench 4.0やDeepSWEでのリードは、多少の環境の差異を考慮しても十分な大きさです。Apache 2.0なのでライセンスの心配もありません。ただし、KVキャッシュの予算を確保するか、コンテキストを32Kから64Kに制限してください。
- 1枚のGPUでの長文ドキュメント処理: おそらく不向きです。128Kのプロンプトには、4ビットウェイトでも約49 GBのVRAMが必要です。
- 独自エージェントのファインチューニング: ベースモデルは良い出発点です。Nanbeigeの報告によると、MMLU-Pro(
66.9対59.3)を含む8つのベースベンチマークすべてでGemma4-31B-Baseを上回っています。 - カスタマーサポート: 現時点の数値ではお勧めしません。カスタマーサービス業務ではQwenに敗れており、Tau3-Benchでは互角です。そもそもモデル単体ではチケットに回答できません。最適なカスタマーサービス向けAIエージェントの選び方では、モデルだけでなくシステム全体を評価しています。
ベンチマークではなく、実際のサポートチケットでAIを動かす
私が日々取り組んでいるのは、まさにこの最後のポイントです。Nanbeige4.3-33Bのようなモデルはインフラに過ぎません。実際のチケットに回答するには、ヘルプデスクに常駐し、マクロや過去のチケットを読み込み、どの顧客を人間に引き継ぐべきかを判断し、絶対に言ってはいけないルールを守る仕組みが必要です。それが、特定の役割のために採用するAIチームメイトの一つである、eeselのAIヘルプデスクエージェントの役割です。これはZendesk AIのような既存ツールを置き換えるのではなく、その中で動作します。最終的な判断基準は、通常、チケットあたりのコストの計算になります。
ベルリンのローン比較プラットフォームであるsmavaは、その実践例を示しています。eeselは、smavaとその姉妹ブランドFinanzcheckを合わせて、1ヶ月間に約27,000件のZendeskチケットを処理しました。約820個のマクロやヘルプセンターの記事から、約14,600件のカテゴリー分けを行い、約15,300件の回答下書きを準備しました。すでに担当者がついている顧客はスキップされるため、顧客は自分の担当者から連絡を受けることができます。また、eeselが勝手に回答を送信することはありません。エージェントが各回答を承認します。これらはコーディングベンチマークには現れませんが、AIが役に立つか、あるいは害になるかを決定づける重要な要素です。

本運用を開始する前に、eeselは過去の数百件のチケットに対してテスト実行を行います。これにより、顧客に届く前にAIの回答を確認することができます。これは、ベンダーが引用するどのベンチマークよりも多くのことを教えてくれます。このテストの仕組みについては別途記事を書きました。SamCartもFreshdeskで同様の体制を整えており、メールチケット用とウェブサイトチャット用の2つのエージェントが、約280件のヘルプセンター記事に基づいて回答しています。ローカルモデルを扱うようにターミナルから作業したい場合は、eesel CLIを使用して、連携の接続、エージェントへの指示の編集、保留中のアクションの承認や拒否、アクティビティログの読み取り(すべてJSON形式)を、自分自身やスクリプト、あるいはClaude Codeのようなコーディングエージェントから行うことができます。
eesel AIの料金体系は、チケットまたはチャットセッション1回あたり0.40ドル、ブログ記事1件あたり4.00ドルで、50ドルの無料トライアル(月額最低料金やプラットフォーム手数料なし)が提供されています。
eeselを試す
Nanbeige 4.3は、コーディングエージェントのための強力なオープンエンジンです。もし、今週中にサポートキューに対応するエージェントが必要なら、eeselのAIヘルプデスクエージェントを検討してください。数分でZendesk、Freshdesk、またはGorgiasに接続し、過去のチケットやヘルプセンターから学習し、設定したルールに従って回答の下書き作成や送信を行います。クレジットカード不要で100クレジットから無料で始められるため、本運用の前に実際のチケットでテストすることが可能です。eeselを試す。
よくある質問
Nanbeige 4.3とは何ですか?
Nanbeige 4.3は、BOSS Zhipin(Kanzhun)のNanbeige LLMラボによるモデルシリーズです。最初のリリースであるNanbeige4.3-33Bは、2026年10月24日にApache 2.0ライセンスでHugging Faceに公開されました。これは512Kのコンテキストウィンドウを持つ、330億パラメータの密な(dense)テキストモデルであり、エージェント型のコーディングやオフィス業務向けに構築されています。また、より小さなNanbeige4.3-3Bを教育するための「教師」役としても意図されています。これはGemma 4やQwenと同じオープンモデルのカテゴリに属します。
Nanbeige 4.3は無料で利用できますか?
はい、利用できます。Nanbeige4.3-33BおよびNanbeige4.3-33B-BaseのウェイトはApache 2.0ライセンスで公開されており、商用利用が可能です。ただし、ハードウェアのコストはかかります。BF16ウェイトだけで66GBあり、4ビットのGGUF形式でもコンテキストメモリを除いて約21GB必要です。ホスト型モデルのコストについては、DeepSeek V4 Flashの価格を参考にしてください。
Nanbeige 4.3 33Bの実行にはどのくらいのVRAMが必要ですか?
4ビットウェイトで約21GBに加え、16ビットで1トークンあたり約0.2MBのKVキャッシュが必要です。これは、32Kコンテキストで合計約28GB、128Kで49GB、フルコンテキストの512Kでは130GBを超える計算になります。Nanbeige公式のvLLMやSGLangの例では、4通りのテンソル並列化(tensor parallelism)を使用しています。単一の小型カードに収まるものが必要な場合は、Nanbeigeラインナップの初期の小型言語モデル(SLM)である3Bモデルがあります。
Nanbeige 4.3はQwen3.8-27Bよりも優れていますか?
Nanbeigeが公開した表によると、Nanbeige4.3-33Bは20のベンチマークのうち18でQwen3.8-27Bを上回っています。特にDeepSWE(65.5対42.5)やTerminal-Bench 4.0(23.8対6.3)で大きな差をつけています。一方で、QwenはSWE-Bench ProやGDPvalで依然として勝利しており、第三者機関による再検証はまだ行われていません。Qwenのより大きなモデルについては、Qwen3.8 Maxのレビューで詳しく解説しています。
Nanbeige 4.3をカスタマーサポートに使用できますか?
使用は可能ですが、ベンチマーク結果はそれを強く推奨するものではありません。JobBenchでは、カスタマーサービス担当者のタスクにおいて、Qwen3.8-27Bの31.6に対し21.1というスコアでした。また、Tau3-Benchでは48.8対48.5とほぼ互角です。サポートエージェントにはヘルプデスク、マクロ、引き継ぎルールの連携も不可欠であり、これらはeeselのようなAIヘルプデスクエージェントが提供する機能です。
Nanbeige 4.3にはAPIがありますか?
Nanbeigeはモデルのウェイトを公開していますが、ホスト型のAPIは提供していません。モデルカードではTransformers、vLLM、またはSGLangを使用した自前での実行方法が説明されています。2026年10月26日時点で、OpenRouterには掲載されていません。ホスト型のオープンモデルを利用したい場合は、Kimi K3やGLM-5.3 FlashがAPI経由で利用可能です。
Nanbeige4.3-3Bはいつリリースされますか?
Nanbeigeは具体的な日付を明らかにしていません。NanbeigeのチームメンバーはHugging Faceのページで、4.3シリーズのテクニカルレポートはNanbeige4.3-3Bと同時に公開される予定であること、また3BモデルにはNanbeige4.2-3Bで採用されたLooped Transformer設計が使用されることを示唆しています。ループ型モデルの背景については、GPT-6 Astraの解説記事をご覧ください。