

Metaが10月12日に実際に公開したもの
Metaは、Muse WonderとMuse Wonder Fullの2つのモデルを公開記事で発表し、「最も高性能なモデル」「パーソナル超知能に向けた大きな飛躍」と表現しています。ギガワット級のMetaのPrometheusデータセンターで学習され、より安価な主力モデルであり続けるMuse Sparkシリーズの上位に位置づけられます。
公開時点での、それぞれの提供場所は次のとおりです。
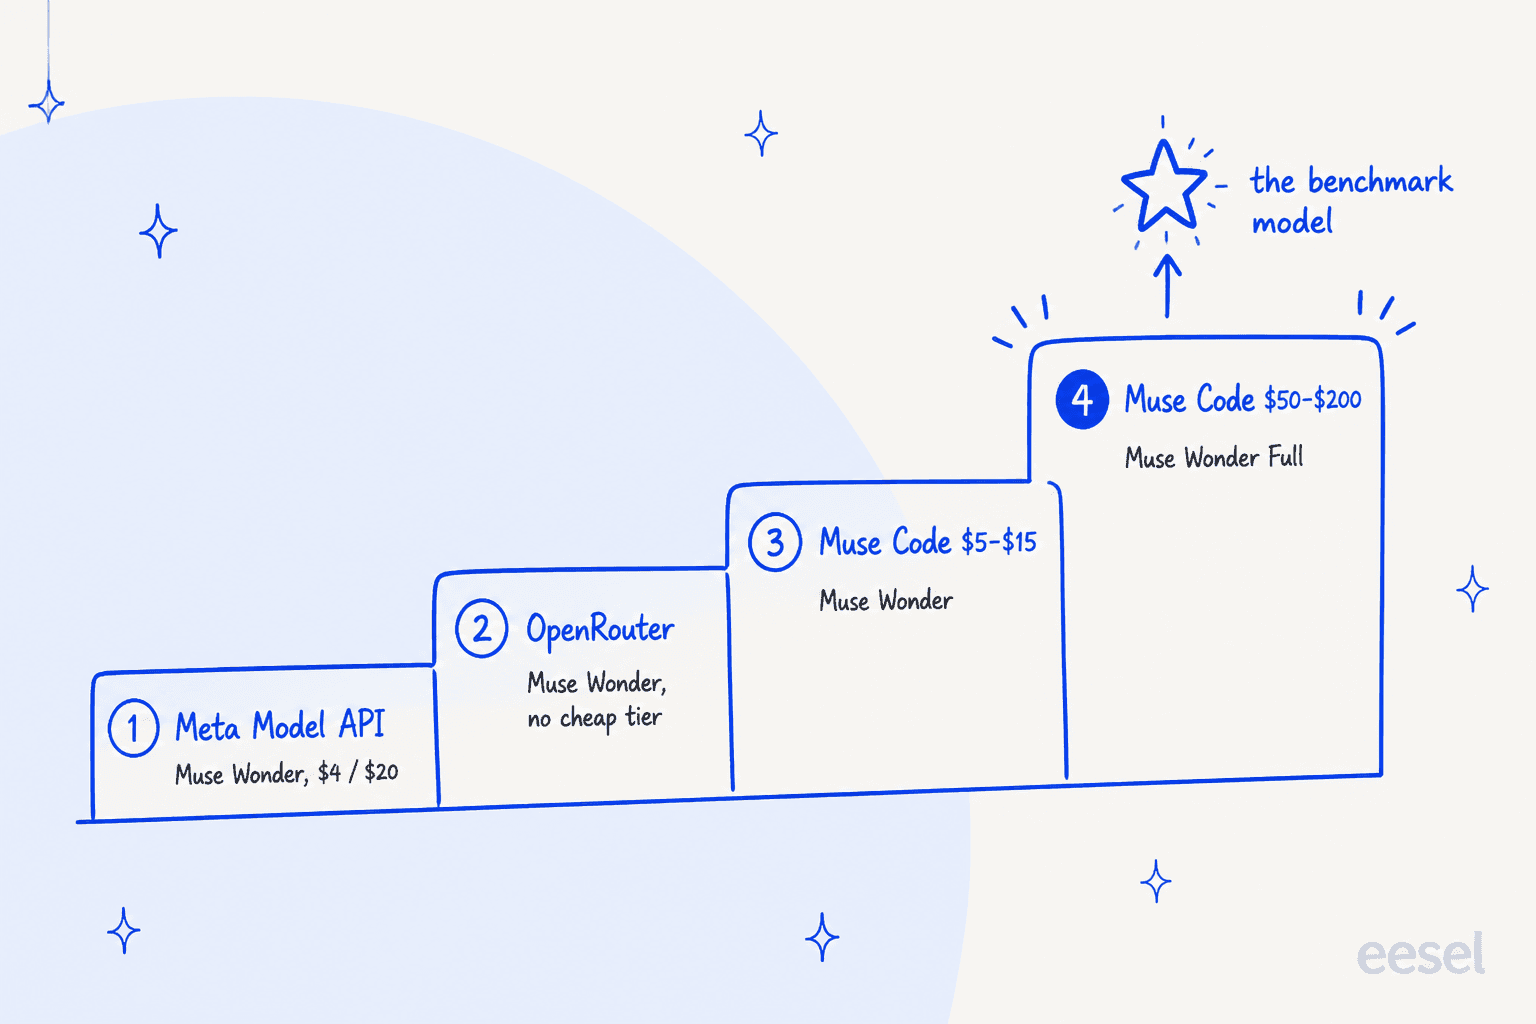
- Muse Wonder(
muse-wonder-1.0)は、Meta Model API、OpenRouter、すべてのMuse Codeプランで利用できます。 - Muse Wonder Fullは、Muse Code Power(月額50ドル)とMax(月額200ドル)のプランでのみ利用できます。Metaのモデルドキュメントには、Wonderの推論強度を
maxにしてもFullは選択されないと明記されています。 - MuseアプリはMetaのコンシューマー向けエージェントで、Wonderは「近日中」に、まずサブスクライバーに提供されます。現時点ではこのアプリはまだSpark 1.3で動いています。
APIではまだプレビュー扱いです。入力はテキスト、画像、動画、音声、PDFに対応し、出力はテキストで、コンテキストウィンドウは1,048,576トークンです。推論強度はminimalからmaxまで選べます。Metaの料金とレート制限のページでは、muse-wonder-1.0について1分あたり3,000リクエスト、1分あたり400万トークンとされており、プレビューとしては余裕のある数字です。
Metaのドキュメントには、近ごろ見たなかで最も分かりやすい使い分けの基準が書かれています。長時間かかる複雑な作業にはWonder、処理量、レイテンシ、コストが重要ならSparkを選ぶというものです。この記事の残りも、この区分で読むのがよいと思います。
Metaが売り込む2つの考え方:Active MemoryとActive Focus
発表の宣伝文を削ぎ落とすと、Metaが主張している製品の特長は2つで、どちらも数秒ではなく数時間働くエージェントを想定しています。
Active Memoryは、会話をまたいでユーザーに関する文脈を保持し、必要なときに適切な情報を呼び出すというMetaの呼び名です。MetaはMemoryBenchで測定しており、これはAPI版のモデルがFullを含めてすべてに勝つ唯一の項目です。Wonderが85.6、Fullが85.5、Opus 5.5が81.5です。数週間にわたってユーザーを覚えておく必要があるものを作っているなら、この数字が表の中で最も興味深い行です。
Active Focusは「やり続ける」という主張で、障害にぶつかったら別の方法を試す、確認が必要なら質問する、重要な操作の前に確認を取る、といった動きを指します。MetaはFocusBenchと、長期にわたるソフトウェアプロジェクトでの持続的な作業を測るSWE-Marathonで測定しています。発表のデモはこの点を強く打ち出していました。画像から作った遊べる3Dキッチンゲーム、ブラウザとアプリを横断して組み立てた土曜日のランニング計画、誰かのInstagram写真から作ってそのまま注文するオリジナルグッズ、制約条件のリストをもとに解いた結婚式の席次表などです。
その裏には、本当に興味深い研究上の主張もあります。Metaは、学習済みのタスクと未学習のタスクについてMuse Spark 1.3とWonder Fullをプロットし、Fullは未知のタスクでSparkの傾向線から予測される以上の成績を出すとしています。Metaはその理由を、より大きなベースモデルだからだと説明しています。これは「大きなモデルならではの手応え」という議論で、誰も想定しなかったタスクに出会う汎用エージェントにとっては、個々のベンチマークよりも重要です。
Muse Wonderの料金:Claude Opus 5.5と同じ価格表
実際に購入できるバージョンのAPI料金表を、Metaのモデルページと料金ドキュメントからそのままご紹介します。
| 項目 | Muse Wonder(muse-wonder-1.0) |
|---|---|
| 入力 | 100万トークンあたり4.00ドル |
| キャッシュ入力 | 100万トークンあたり0.20ドル |
| 出力 | 100万トークンあたり20.00ドル |
| コンテキストウィンドウ | 1,048,576トークン、長文コンテキストの割増なし |
| Contributor(トラフィックを学習に使う)ティア | 利用不可 |
| Web検索ツール | 1,000クエリあたり2.50ドル |
| レート制限 | 3,000 RPM / 4M TPM |
| ステータス | プレビュー |
では、人々が実際に比べるであろうモデルと並べてみましょう。
| モデル | 入力 / 100万 | 出力 / 100万 | 出典 |
|---|---|---|---|
| Muse Spark 1.3 | 1.25ドル | 4.25ドル | Metaの料金ドキュメント |
| GPT-6.1 Sol | 2.00ドル | 10.00ドル | GPT-6.1 Solの料金 |
| Muse Wonder | 4.00ドル | 20.00ドル | Metaのモデルページ |
| Claude Opus 5.5 | 4.00ドル | 20.00ドル | Anthropicの料金 |
| Claude Fable 5.1 | 10.00ドル | 50.00ドル | Anthropicの料金 |
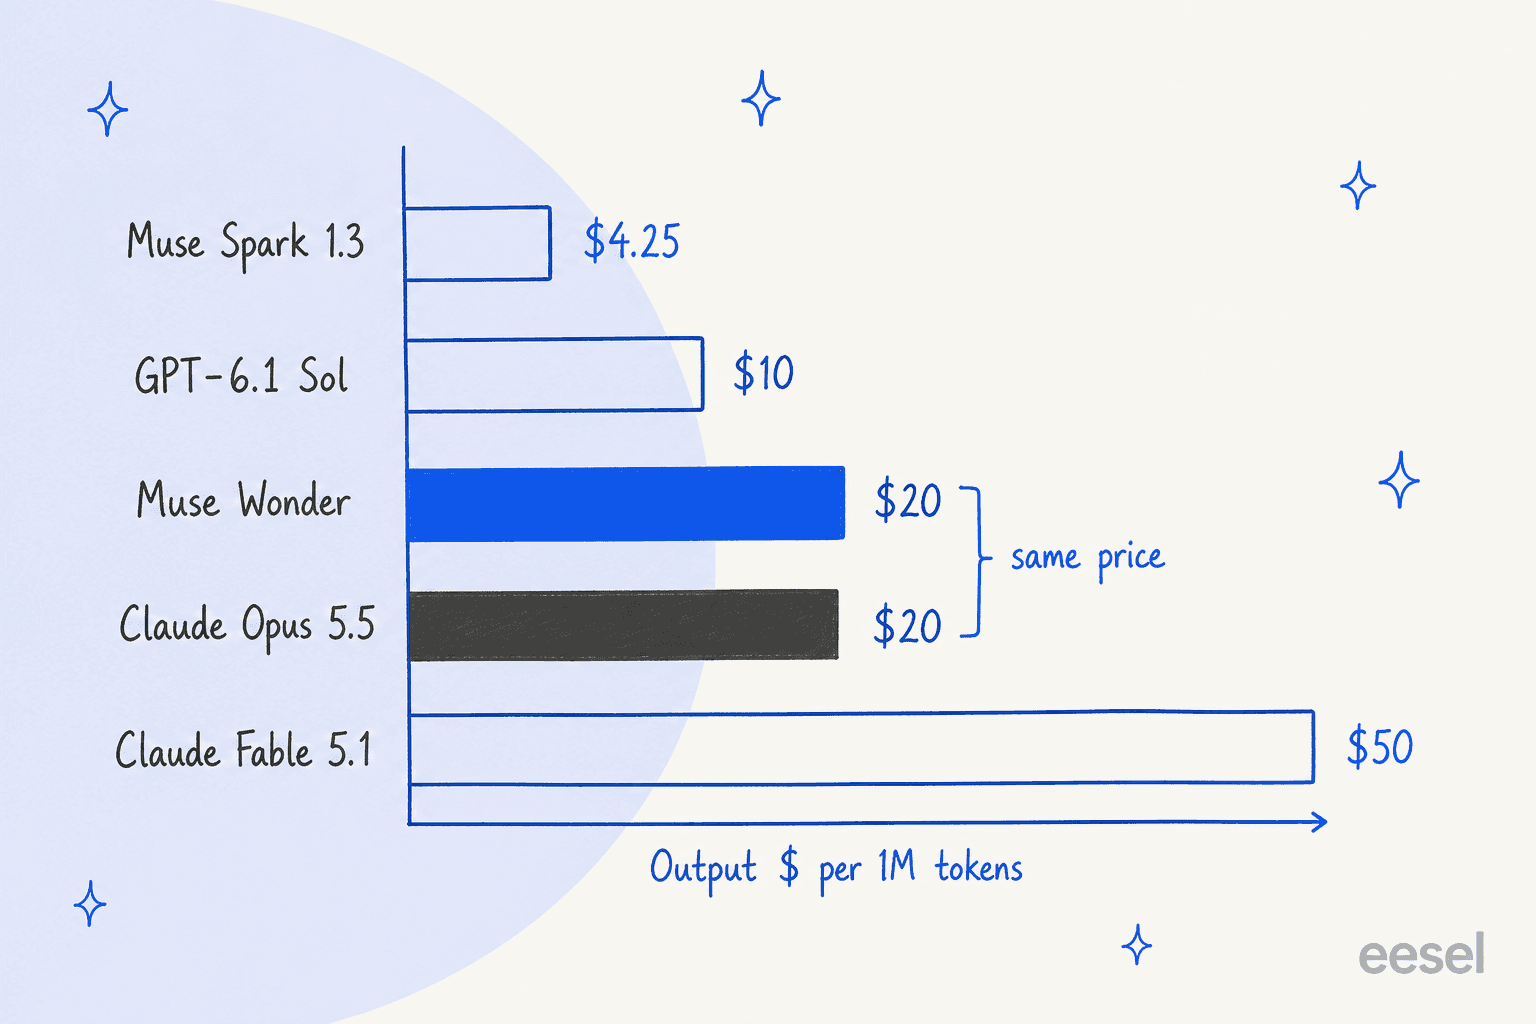
キャッシュ入力の料金もOpus 5.5と一致していて、どちらも100万トークンあたり0.20ドルです。これは偶然だとは思えません。Metaのこれまでのモデルは他社より大幅に安い価格で登場しており、公開スレッドの最初のコメントもまさにそこに触れていました。
「他のMetaのモデルと違って、今回は価格がかなり跳ね上がっているのが興味深い…入力/出力が4ドル/20ドルで、Solより高く、Opusと同水準だ。」

具体的な例で考えてみましょう。5万トークンを読み込み、1万5千トークンを書き出す1時間のエージェントセッションを想定します。Muse Wonderでは入力が0.20ドル、出力が0.30ドルで、合計0.50ドルです。Opus 5.5でも同じ0.50ドルです。GPT-6.1 Solなら0.25ドル、Muse Spark 1.3なら約0.13ドルです。同じセッションで4倍の開きがあり、WonderはOpusとともにその最上位にいます。
Sparkシリーズとのもう1つの変化は、安価なティアがなくなったことです。Spark 1.3には、トラフィックをMetaの学習に使わせる代わりに入力0.10ドル、出力0.20ドルになるコントリビューターIDがあります。Wonderの従量課金にはそのようなIDはありません。サブスクリプションの計算を含む詳しいコスト内訳は、Muse Spark 1.3の料金の記事で、旧来の2ID方式の仕組みとあわせて紹介しています。
Muse Codeプラン:Wonder Fullはここにある
Metaのチャートでトップに立つモデルを使いたいなら、購入するのはコーディングのサブスクリプションです。公開時点でのMuse Codeプランは次の4つです。
| プラン | 価格 | 利用量 | モデル |
|---|---|---|---|
| Everyday Usage | 月額5ドル | 5時間ごとに10〜50プロンプト | Muse Spark、Muse Wonder、Muse Image |
| High Usage | 月額15ドル | Everydayの5倍 | Everydayと同じ、マルチモーダル入力が増える |
| Power Usage | 月額50ドル | Everydayの20倍 | Muse Wonder Fullが加わる、新機能への早期アクセス |
| Maximum Usage | 月額200ドル | Everydayの80倍 | Powerのすべて |
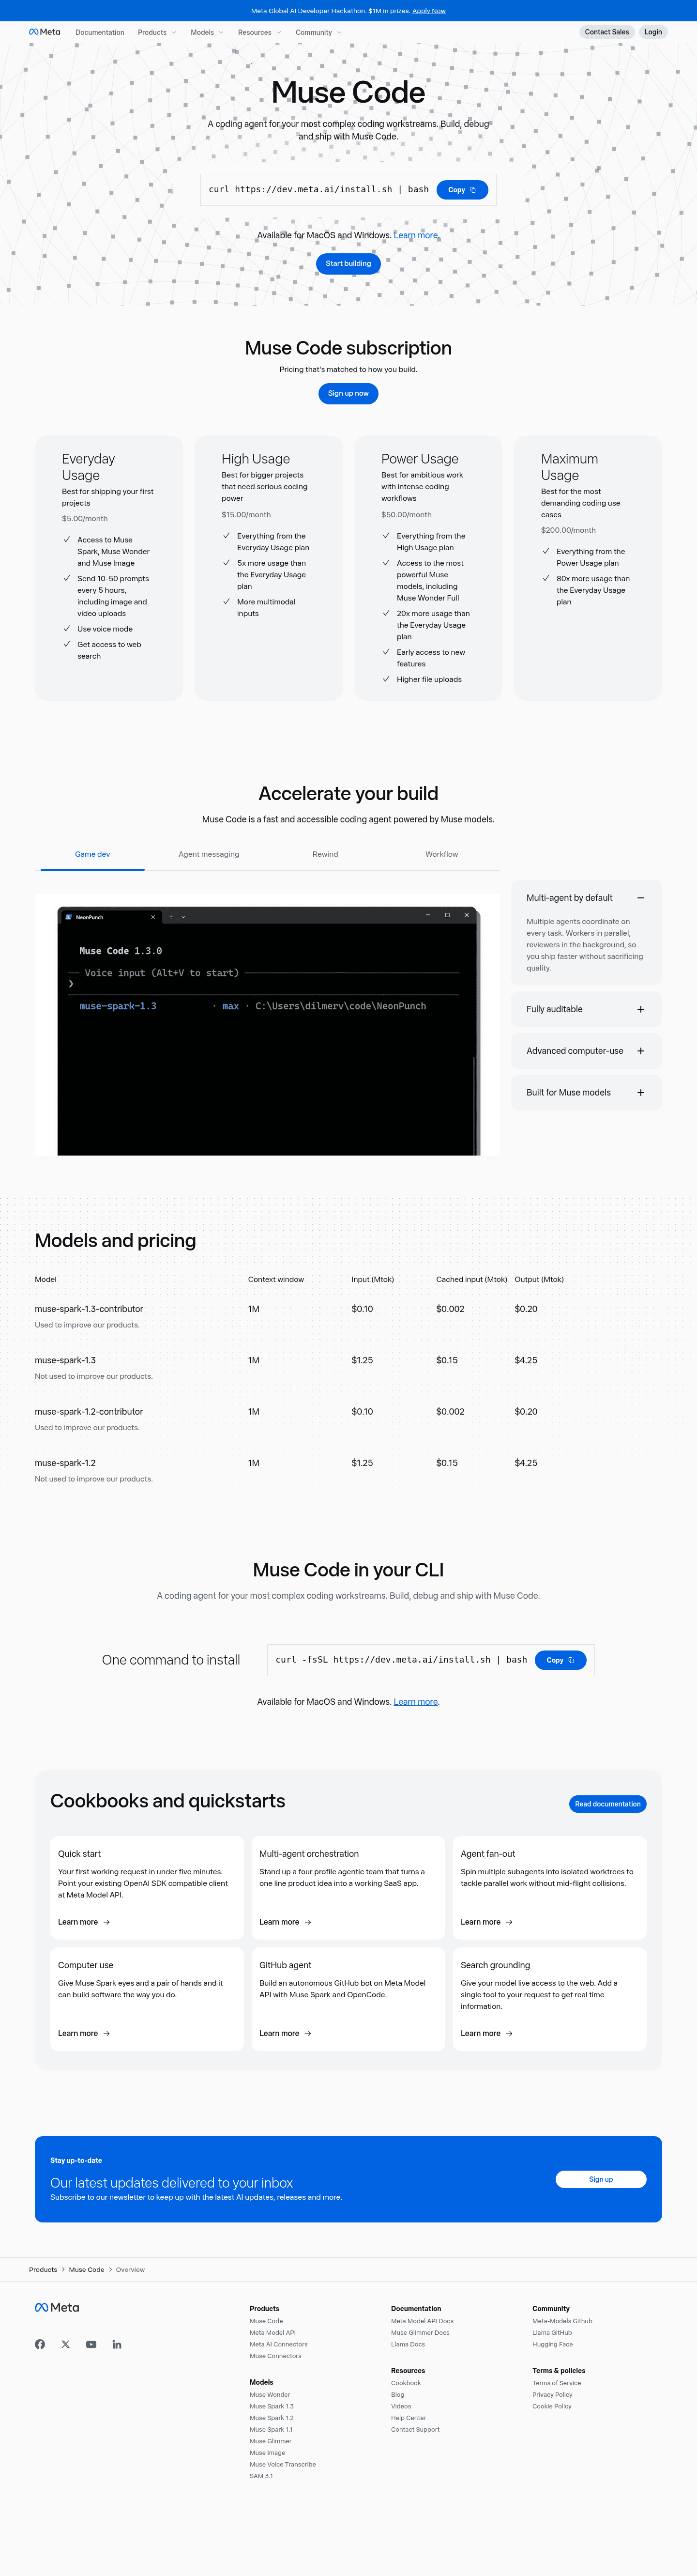
支払う前に読んでおきたいのが、Metaのサブスクリプション規約にある3点です。プランは18歳以上が対象であること、提供状況は地域によって異なること、返金はないことです。Metaのモデルドキュメントにはさらに4点目があります。サブスクリプションは初期設定でContributorモードになっているため、オフにしない限り、あなたのトラフィックがMetaの製品の学習に使われます。
5ドルのプランは、Wonderではすぐに上限に達します。ある開発者は、3回の小さなリクエストのあとの使用量メーターを投稿していました。
「お試し用の基本の5ドルのコードプランの利用上限が、ばかばかしいほど低い。たった数回質問しただけで週の使用量の14%を使い切った…」
すでにClaude Codeのようなターミナル向けAIコーディングツールを使っているなら、現実的な問いは、Fullに到達するためだけに2つ目のサブスクリプションを払う価値があるかどうかです。以前のMuse Codeレビューではハーネス自体を取り上げ、Muse Codeの料金の記事では、各プランでSparkについて何が手に入るかを解説しています。
Muse Wonderのベンチマークと、勝ったのはどのバージョンか
Metaは、Wonder Full、Wonder、Claude Fable 5.1、GPT-6 Astra、Claude Opus 5.5を比べた14行のベンチマーク表を公開しました。勝ち数を数えると、構図ははっきりします。Wonder Fullが6行、Opus 5.5が6行、GPT-6 Astraが1行、API版のWonderが1行(MemoryBench)で勝っています。
| ベンチマーク | Wonder Full | Wonder(API) | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| Harvey LAB-AA(法務) | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2 | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| AutomationBench-AA | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| MemoryBench | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| DeepSWE 1.1 | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon | 57.5 | 53.1 | 45.6 | 42.5 | 46.3 |
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| ProgramBench | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| OSWorld V2.1(一部) | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 |
| HealthBench Pro | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| GDP.pdf | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
出典:MetaのMuse Wonderモデルページ。太字は各行の勝者を示します。FullのSWE-Marathonはxhighの強度、その他の行はmaxです。
Wonder Fullの勝利は、Metaが約束していたとおりの分野、つまり法務・金融の成果物、エンドツーエンドの業務ワークフロー、何時間も続くコーディングに集中しています。Opus 5.5は、ターミナル、コンピューター操作、ゼロからのプログラミング、総合指数を押さえています。
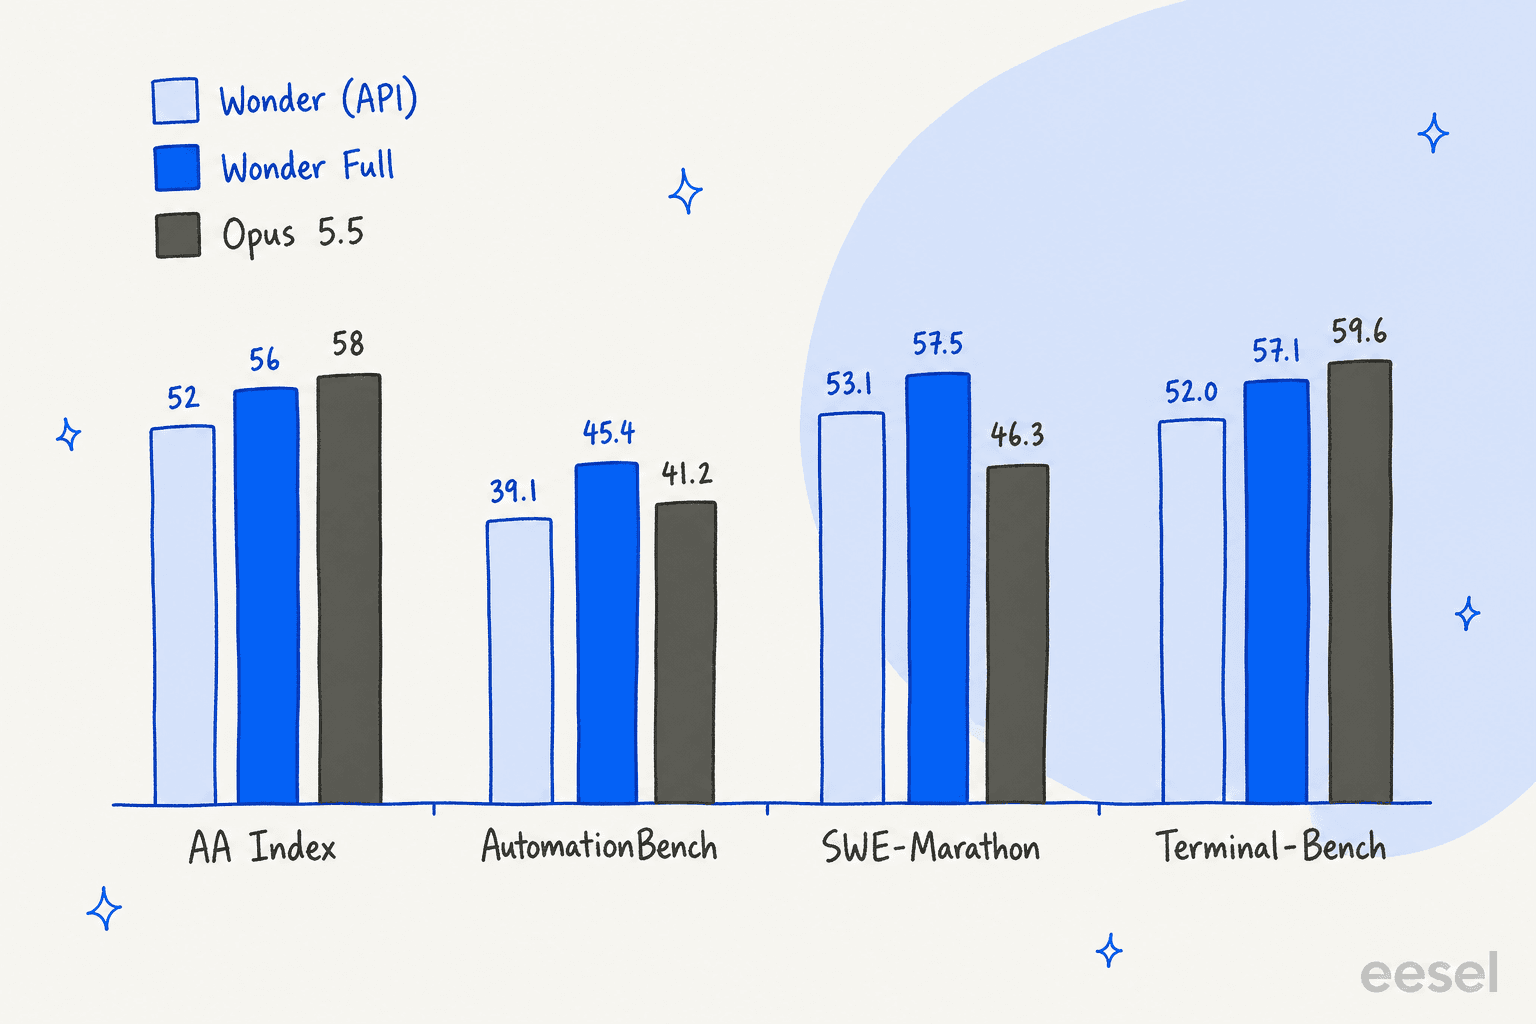
問題は、最初の列がほとんどの人にはトークン単位で購入できないものだということです。公開スレッドのコメント投稿者が、数時間のうちにそれに気づきました。
「よく見ると、メインのマーケティングページに載っている「Muse Wonder」のベンチマークスコアは、実は上位プランのサブスクリプションでしか使えない「Muse Wonder Full」のものだ。この価格設定は「Muse Wonder」のものである。」
API版にも本物の強みが2つあります。記憶の項目でトップであることと、SWE-Marathon(53.1対46.3)とDeepSWE(78.8対74.2)でOpus 5.5に勝っていることです。長時間稼働するコーディングエージェントにとって、これは小さくありません。ただ、総合指数では同じ価格のOpus 5.5に6ポイント差で負けており、Artificial Analysisのランキングも公開当日のうちに動きました。あるコメント投稿者は、モデルが数時間で2位から、Gemini 4 Argonの後ろの5位に下がったと指摘しています。
最初の48時間で開発者が語っていること
Hacker Newsの公開スレッドは657ポイント、362コメントに達し、反応ははっきり二分されています。ベンチマークの向上への敬意と、それにたどり着く方法への不満です。
最も参考になった実地テストは、同じ画像からHTMLを作るタスクを両方のモデルに実行した開発者によるものです。
「Muse Wonderでの画像→HTMLのテスト。Opus 5.5よりずっと悪い。個人的な感想では、このテストに関してはSonnetやHaikuに近い…ビジョンモデルがまだ成熟していなくて、現時点ではテキスト向けに強く最適化されているのだと思う。」
これはhigh強度での1回のテストであり、結論ではありませんが、表とも一致します。Wonderの勝利はテキスト中心のエージェント作業にあり、視覚的なタスクにはありません。ハーネスは、モデルよりも厳しい評価を受けました。
「ベンチマークは確かにすばらしい。あとは、日常的に使えるようにコーディングハーネスを直してくれれば。Muse Codeを試すために1か月分を払ったが、サンドボックスはMacでもLinuxでも一度も動かなかった。」
ほかによく挙がった指摘が2つあります。Simon Willisonは、APIに出てくるのはmuse-wonder-1.0だけで、FullのモデルIDはないことを確認しました。また別のコメント投稿者は、公開時点でサブスクリプションは北米限定だったと報告しています。Metaの規約には提供状況が地域によって異なると書かれており、これと矛盾しません。
安全性:レポートはまだ公開されていません
Metaは、Muse Wonderを「これまでで最も整合性の高いモデル」と述べ、化学、生物、放射性物質、核、サイバーの悪用に対するこれまでで最も強力な安全対策を備えつつ、防御的なサイバー能力は引き続き使えるようにしているとしています。公開記事には、不正なコード実行、個人情報の扱い、拒否率に関するグラフが示されています。
安全性に関する完全なレポートは「近日公開」とされています。それが出るまでは、安全性の主張はMeta自身のグラフに頼ることになります。MetaがWonderを、メッセージ、カレンダー、非公開ドキュメントを読むパーソナルエージェント向けに売り込んでいる以上、これはいつも以上に重要です。顧客データに触れる用途で検討しているなら、私はレポートを待ちます。Museエージェントのセキュリティ設計を、じっくり読む価値のある部分として扱ったときと同じ考え方です。
では、Muse Wonderを実際に使うべきなのは誰か?
状況別に私の見立てをまとめます。
- **APIの予算で、長時間稼働するコーディングやワークフローのエージェントを作っている。**自分のタスクでMuse WonderとOpus 5.5を比較してください。価格は同じで、SWE-Marathonと記憶では確かにリードし、ターミナルと総合指数では確かに劣ります。決め手になるのはポスターではなく、あなたのワークロードです。
- **Metaで最強のモデルが欲しく、対応地域に住んでいる。**それはWonder Fullで、最も安く入る方法は月額50ドルのMuse Code Powerです。ハーネスはモデルよりも新しいものだと見込んでおいてください。
- 大量の処理を安く行いたい。Muse Spark 1.3のままにしましょう。Meta自身も、処理量、レイテンシ、コストならSparkだと述べています。
- **視覚やコンピューター操作の強さが必要。**OSWorldではOpus 5.5がリードしており、公開されている画像からHTMLへのテストでもそうです。Wonderはまだ選択肢になりません。
- **オープンウェイトやセルフホストが必要。**Wonderはクローズドです。代わりにオープンソースのAIエージェントを検討してください。
とくにカスタマーサポートについては、モデルの選択は小さいほうの判断です。サポート向けモデルガイドでは、数ポイントの指数の差よりも、検索、エスカレーション、テストのほうが解決の質を大きく左右する理由を説明しています。総合ベンチマークの6ポイント差がキューに現れることはめったにありませんが、古いヘルプセンターの記事は毎日現れます。
eeselを試す
Muse Wonderはインフラです。呼び出し、レート制限、プロンプト、監視をすべて自分で行うモデルです。eeselは従業員です。当社のAIヘルプデスクチームメイトは、ZendeskやFreshdesk、Gorgiasなどにすでに接続された状態で参加し、過去のチケットとヘルプセンターで学習します。実際の顧客に1件も回答する前に、過去の数百件のチケットを使って試運転することもできます。「全車種に対応しています」という回答を、顧客より先に見つけ出すのが、このシミュレーションの段階です。
Muse Codeを操作するのと同じ感覚で使いたいなら、eesel CLIがターミナルから使えます。eesel instructionsはチームメイトの常設ルールを読み取り、編集します。eesel approvalsは人間の承認待ちのアクションを一覧表示し、eesel activityは何を、なぜ行ったかを表示します。すべてのコマンドはJSONを出力し、書き込み系は--dry-runに対応しているため、Claude Codeのようなコーディングエージェントが、リポジトリを管理するのと同じ方法でサポートチームメイトを管理できます。コンテンツを書く側の方には、同じラインナップにAIブログライターもあります。

100クレジットでカード不要、無料で始められます。ご自身のキューでeeselを試して、先月のチケットにどう対応するか確かめてみてください。
よくある質問
Meta Muse Wonderとは何ですか?
Meta Muse Wonderの料金はいくらですか?
muse-wonder-1.0の料金は入力が100万トークンあたり4.00ドル、キャッシュ入力が0.20ドル、出力が20.00ドルで、コンテキストウィンドウは100万トークン、長文コンテキスト向けの割増はありません。これはClaude Opus 5.5の料金とまったく同じです。Wonder Fullにはトークン単価がなく、月額50ドルのMuse Code Powerか月額200ドルのMaxを通じてのみ利用できます。Muse WonderとMuse Wonder Fullの違いは何ですか?
maxにしてもFullに切り替わるわけではなく、FullはAPIにもOpenRouterにもありません。これから開発に使うなら、トークン単位で購入できるのはMuse Wonderのほうです。