

Meta Muse Spark Open とは?
私は eesel で AI エージェントを作っていて、新しいモデルが出たら、まずローンチ記事よりモデルカードを読みます。Hugging Face 上の Muse Spark Open のモデルカードによると、これは816Bパラメータのエキスパート混合(MoE)モデルで、トークンごとに42Bパラメータが動作します。エキスパートは256個で、トークンごとに8個がアクティブになり、1Mトークンのコンテキストウィンドウと、画像・動画用に追加された1.8Bパラメータのビジョンエンコーダーを備えています。
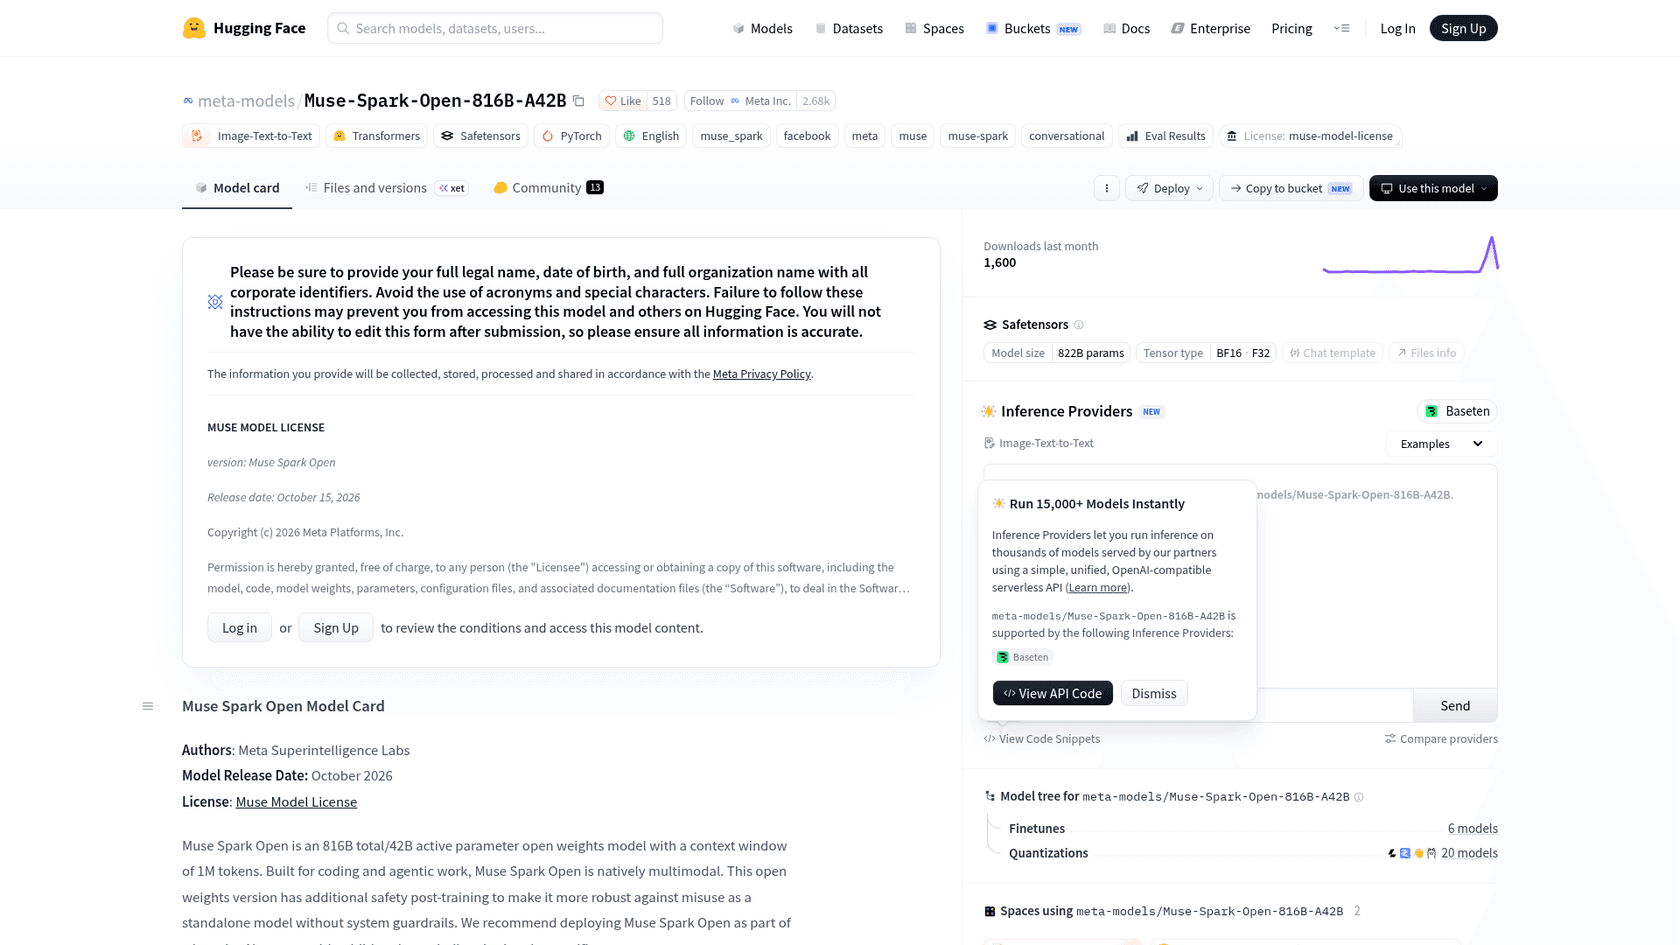
これはクローズドな Muse Spark シリーズのオープンウェイト版の兄弟で、別のファミリーではありません。同じ Muse の名前は、Meta のコーディングハーネスである Muse Code や、Muse パーソナルエージェントにも使われています。
Meta のリサーチ記事は、これを「the most capable US open-weight model to date」と呼び、ウェイトが公開されるとサーバー側でガードレールを追加できなくなるため、追加の安全性ポストトレーニングを施したと述べています。開発者向け投稿には、私の分野で重要な点がもう1つ書かれています。Meta は「such as coding and customer service agents」といった長期的なエージェント作業向けに訓練した、というものです。
モデルカードから、実用的なスペックをいくつか挙げます。
| スペック | Muse Spark Open |
|---|---|
| パラメータ | 総計816B、アクティブ42B |
| コンテキスト | 1Mトークン |
| 入力 | テキスト、画像、動画、音声 |
| 出力 | テキスト |
| 推論の強度 | low、medium、high、xhigh(デフォルトは xhigh) |
| ウェイト | BF16(約1.6TB)と NVFP4(約530GB) |
| リリース | 2026年10月15日 |
注意点として、推論は常にオンです。Groq のモデルページには「always reasons before answering」とあり、デフォルトの強度は最もコストが高い xhigh です。短くて安い回答が欲しい場合は、自分で low か medium を指定する必要があります。
評価方法
私はこのモデルを1年間サポートキューで運用したわけではなく、運用したふりもしません。このレビューは、Meta 自身のベンチマーク表、独立した Artificial Analysis の結果、ローンチ時の各ホストのライブ価格と速度データ、ライセンス全文、そして最初の72時間に Hacker News で開発者が語った内容をもとにしています。Meta の数字と独立した数字が食い違う場合は、そう明記します。
私が持ち込む視点は、eesel でヘルプデスクチームメイト用のモデルを選ぶときに使うものと同じです。ツールを確実に呼び出せるか、ルールの範囲内にとどまるか、1か月の実トラフィックでいくらかかるか、の3点です。eesel で何年も、自信満々のモデルが本番のキューで間違った回答をするのを見てきました。だから eesel の導入では、必ず過去のチケットでシミュレーションを行います。ベンチマークでの勝利は、そこで再現されて初めて意味を持ちます。これが、本番前にあなたのデータでテストされる AI チームメイトの考え方です。
Muse Spark Open が優れている点
Meta は、このモデルを7つの他のオープンウェイトモデルと比較しています。Inkling、Nemotron 3 Ultra、Reflection Beam、Mistral Large 4、Qwen 3.8、GLM 5.3、Kimi K3 です。以下は Meta が公開したスコアカードです。
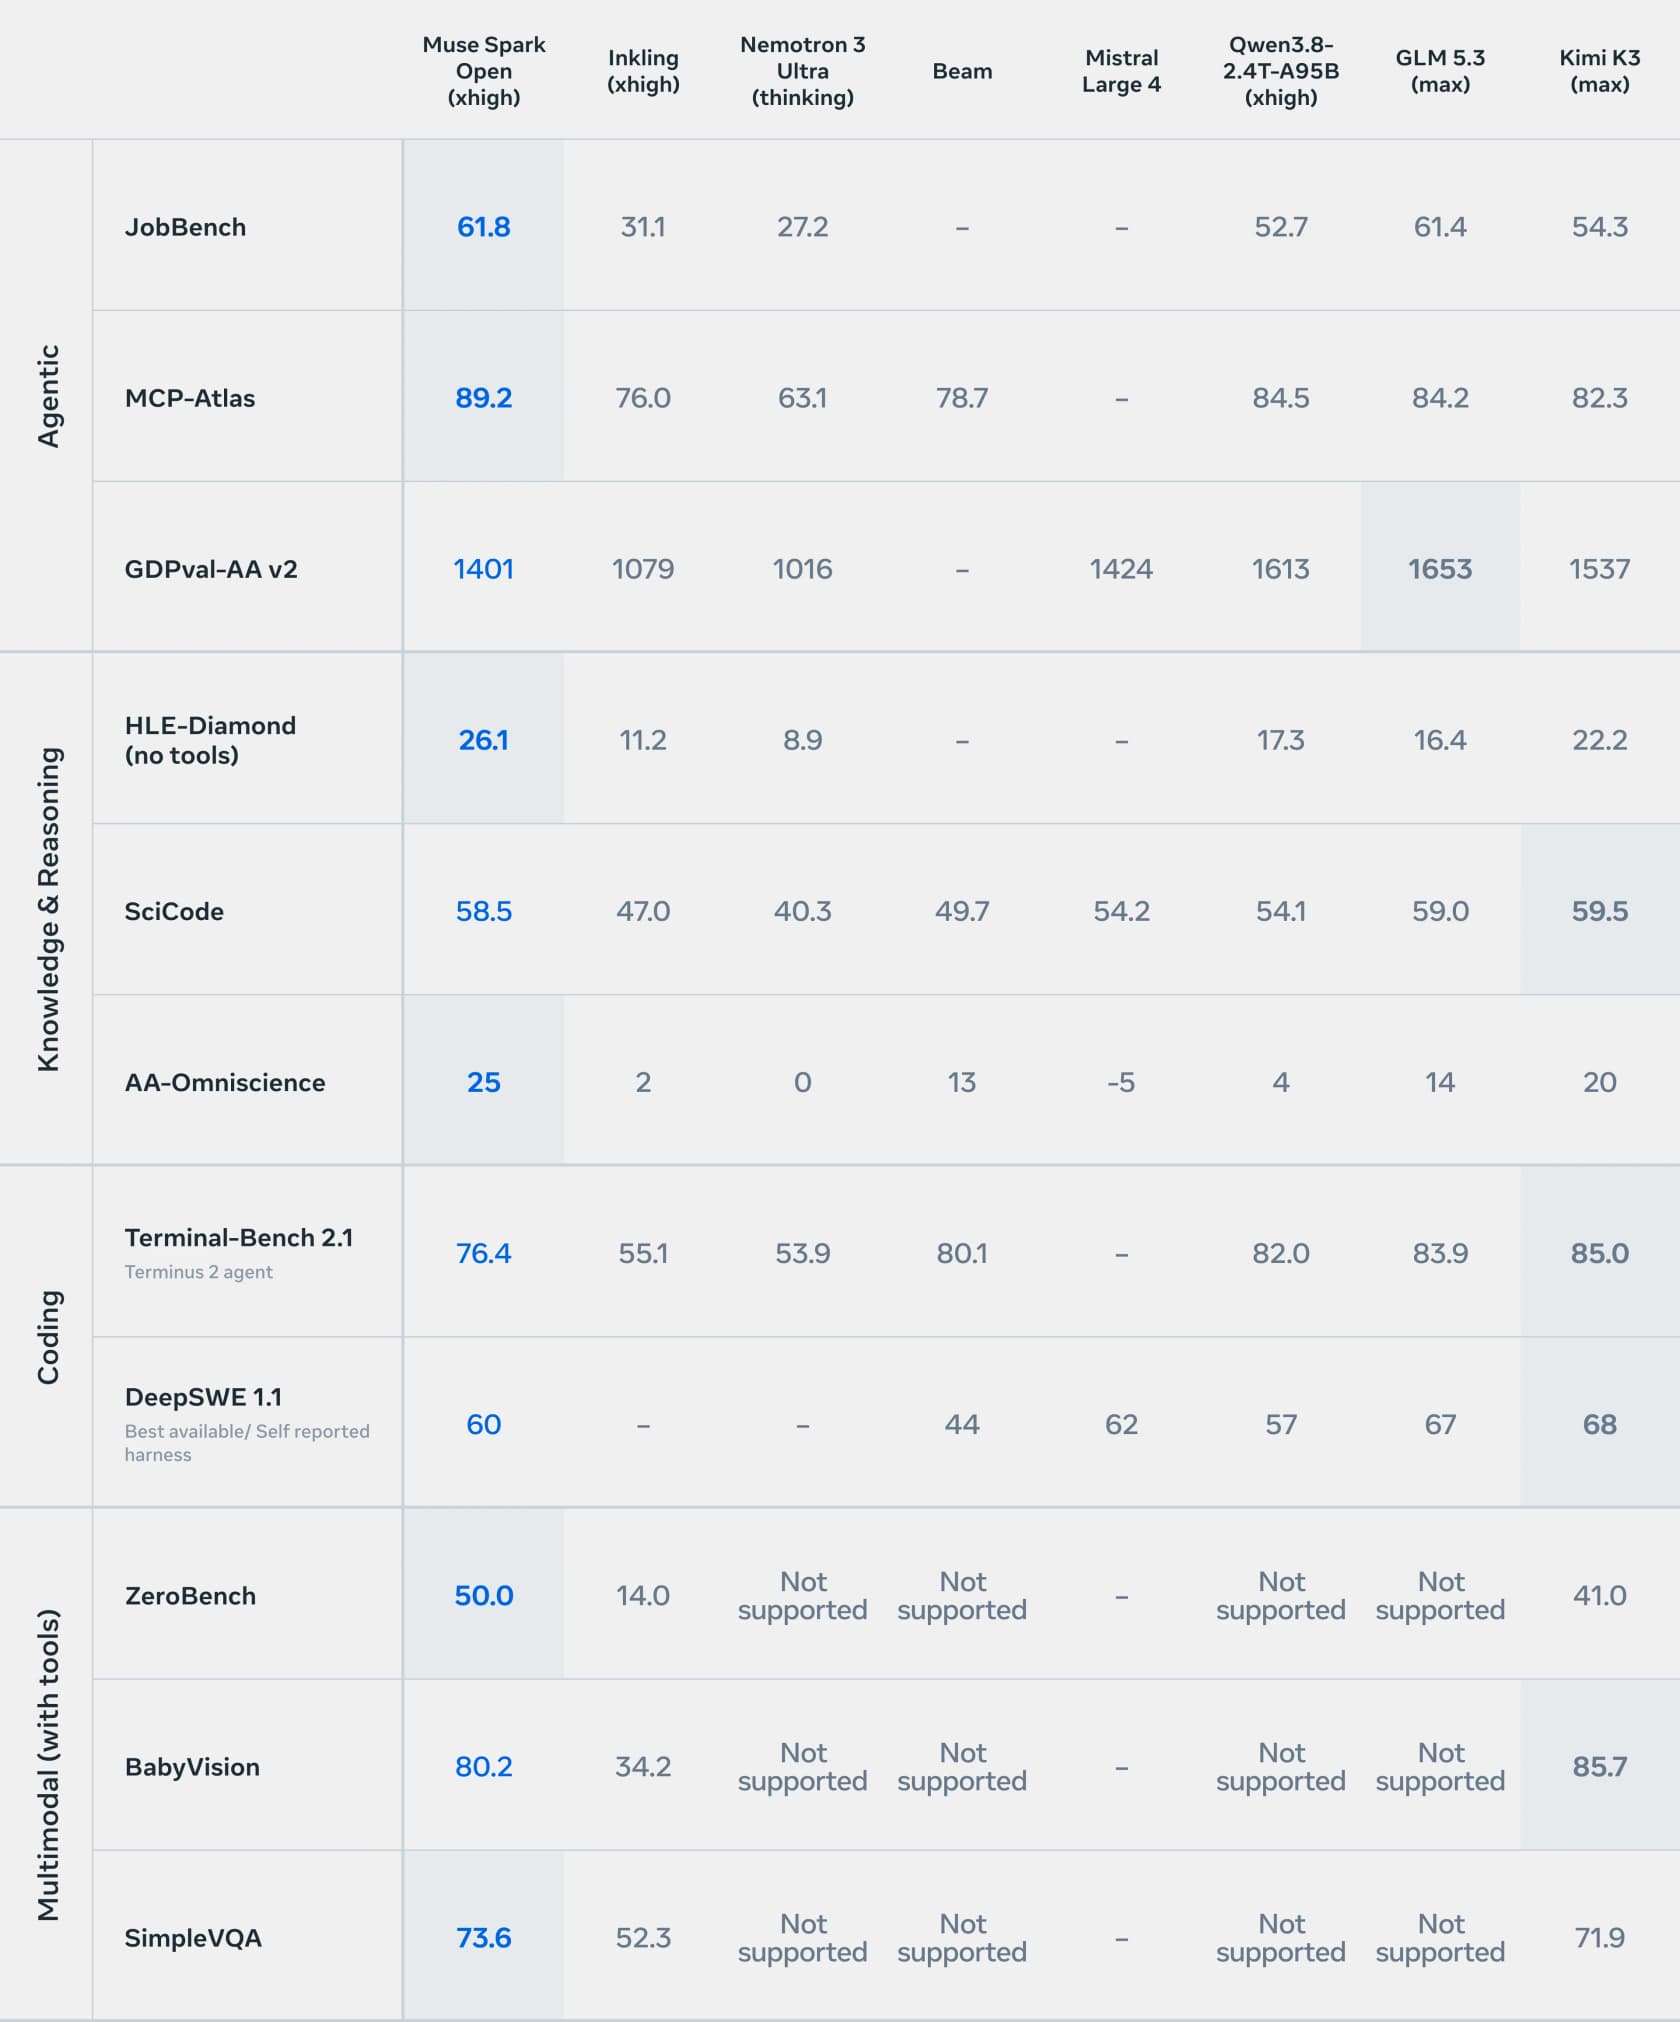
優位性は本物で、1か所に集中しています。ツールを呼び出すエージェントです。
- MCP-Atlas
89.2:表の中で最高スコアです。これは MCP サーバー経由で公開されたツールの呼び出しを測るテストで、MCP はいまやほとんどのエージェントがヘルプデスク、CRM、データベースに接続するために使う仕組みです。 - JobBench
61.8:GLM 5.3 の61.4をわずかに上回り、Kimi K3 の54.3を大きく引き離しています。 - HLE-Diamond
26.1(ツールなし)と AA-Omniscience25:でたらめな回答に減点がつく難しい知識問題で、比較対象の中で最高です。 - マルチモーダル:これらのテストに対応する唯一の他モデルである Kimi K3 に対して、ZeroBench(
50.0)と SimpleVQA(73.6)で首位です。
Meta が引用したローンチパートナー2社のコメントも、この見方と一致します。
"Muse Spark Open consistently selected the right next tool and kept its responses compact, exactly the decisiveness production agents need."
Zimu Li, Member of Technical Staff at Factory, quoted in Meta's developer post
効率性についても、独立したデータが裏付けています。Artificial Analysis は、指数全体を完了するのに出力 110M トークンを要したと計測しました。中央値の 130M を下回り、速度は毎秒 130.7 トークンでした。これは重要です。クローズドな兄弟モデルは逆の結果になったからです。Muse Spark 1.3 のレビューで書いたとおり、1.3 は 120M トークンを消費し、冗長さへの不満が出ました。
劣っている点
ツール利用で首位に立つのと同じ表が、多くの開発者が重視するカテゴリーでは負けていることも示しています。
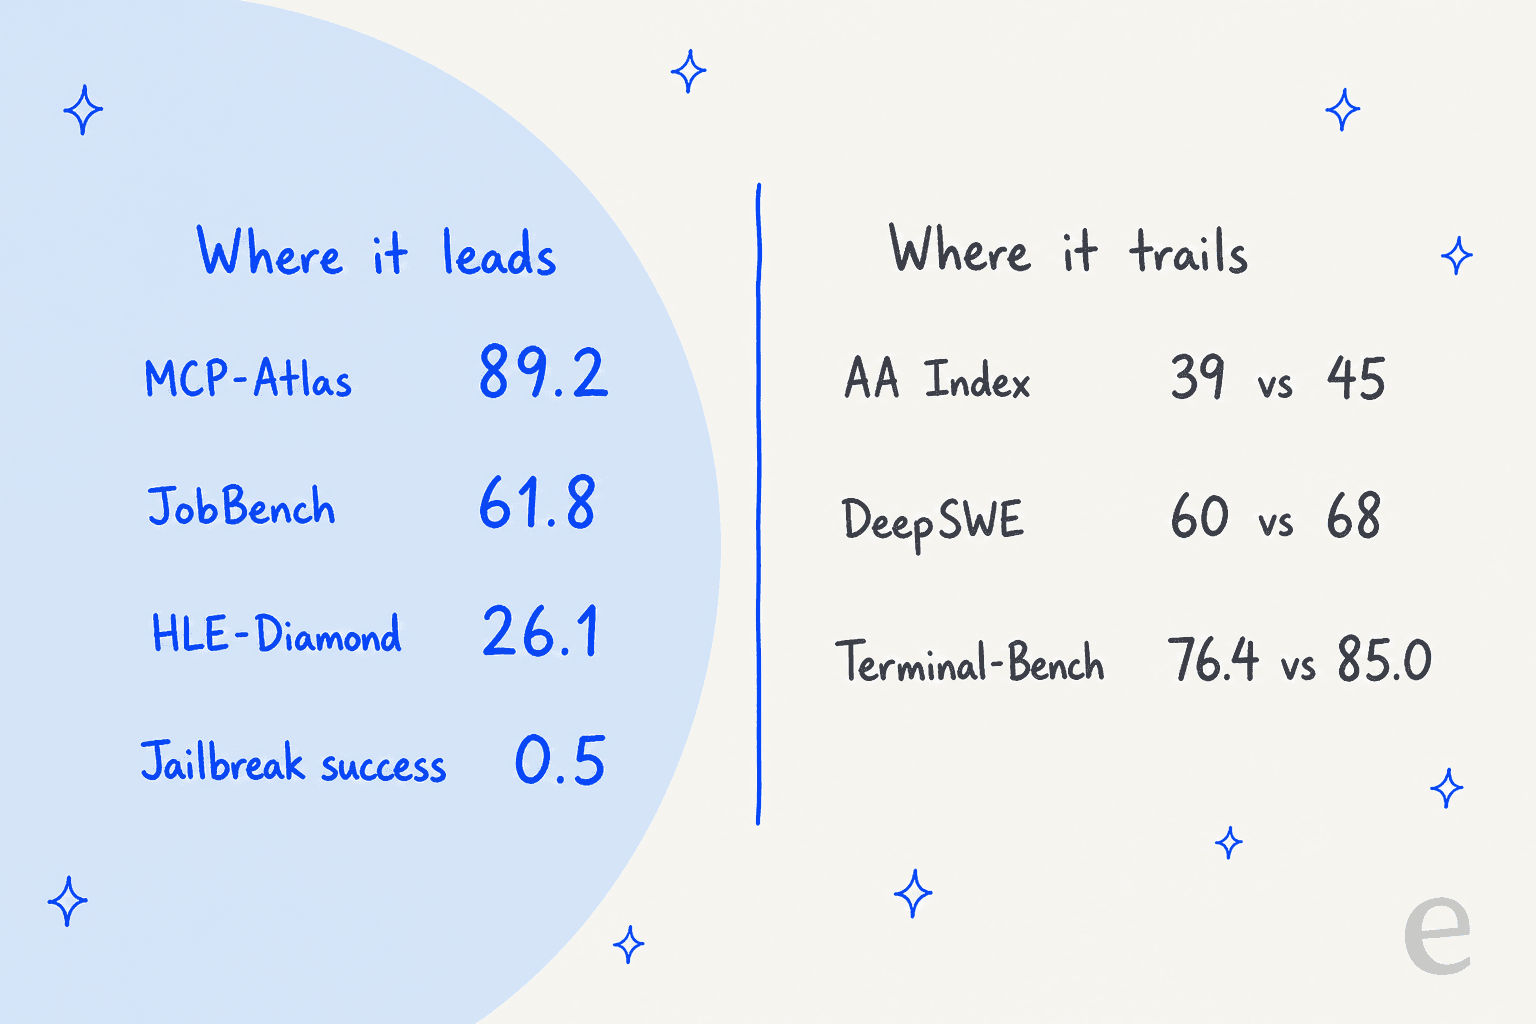
- 総合的な知能:Meta 自身の表の Artificial Analysis Intelligence Index の行では
39で、GLM 5.3(45)、Kimi K3(44)、Qwen 3.8(40)に及ばず、Mistral Large 4(38)を1ポイント上回る程度です。Artificial Analysis は、追跡している120モデル中の#10と評価しています。 - コーディング:DeepSWE 1.1 では
60で、Kimi K3 の68、GLM 5.3 の67に及びません。Terminal-Bench 2.1 では76.4で、Kimi K3 の85.0に対して劣ります。Reflection Beam の80.1にも負けています。 - 実務タスク:GDPval-AA v2 では
1401で、Mistral Large 4(1424)、Kimi K3(1537)、Qwen 3.8(1613)、GLM 5.3(1653)を下回ります。
開発者たちもそれに気づきました。ローンチスレッドで最も引用された初期の印象は短いものでした。
"Feels dumber than GLM 5.3 (only open model I use extensively). But is really fast (fireworks.ai)."

別のコメント者は、2つのクローズドな兄弟モデルの中間に位置づけています。"somewhat worse benchmarks than Muse Spark 1.3, closer to 1.2"(modeless, Hacker News)。数字が示すこととも一致します。主な用途がコードを書くことなら、現時点では Kimi K3 か GLM 5.3 のほうが優れたオープンモデルの選択肢です。
誰も触れない安全性のトレードオフ
Meta は安全性を前面に押し出しており、目玉の数字は印象的です。適応型ジェイルブレイクテストの StrongREJECT v2(低いほど良い)で、Muse Spark Open のスコアは 0.5 です。Kimi K3 は 66.6、GLM 5.3 は 62.9、Qwen 3.8 は 65.6 です。モデルカードには、Meta 社内ベンチマークでのサイバー系ジェイルブレイクの拒否率 99.2%、MASK での誠実さの割合 98.1% も記載されています。
しかし、同じ表にはほとんどの報道が見落とした2つ目の数字があります。FORTRESS は2つのスコアを報告しています。敵対的リスクスコア(ARS、有害な支援をどれだけ行うか)と、過剰拒否スコア(ORS、答えるべきことをどれだけ拒否するか)です。どちらも低いほど良い指標です。
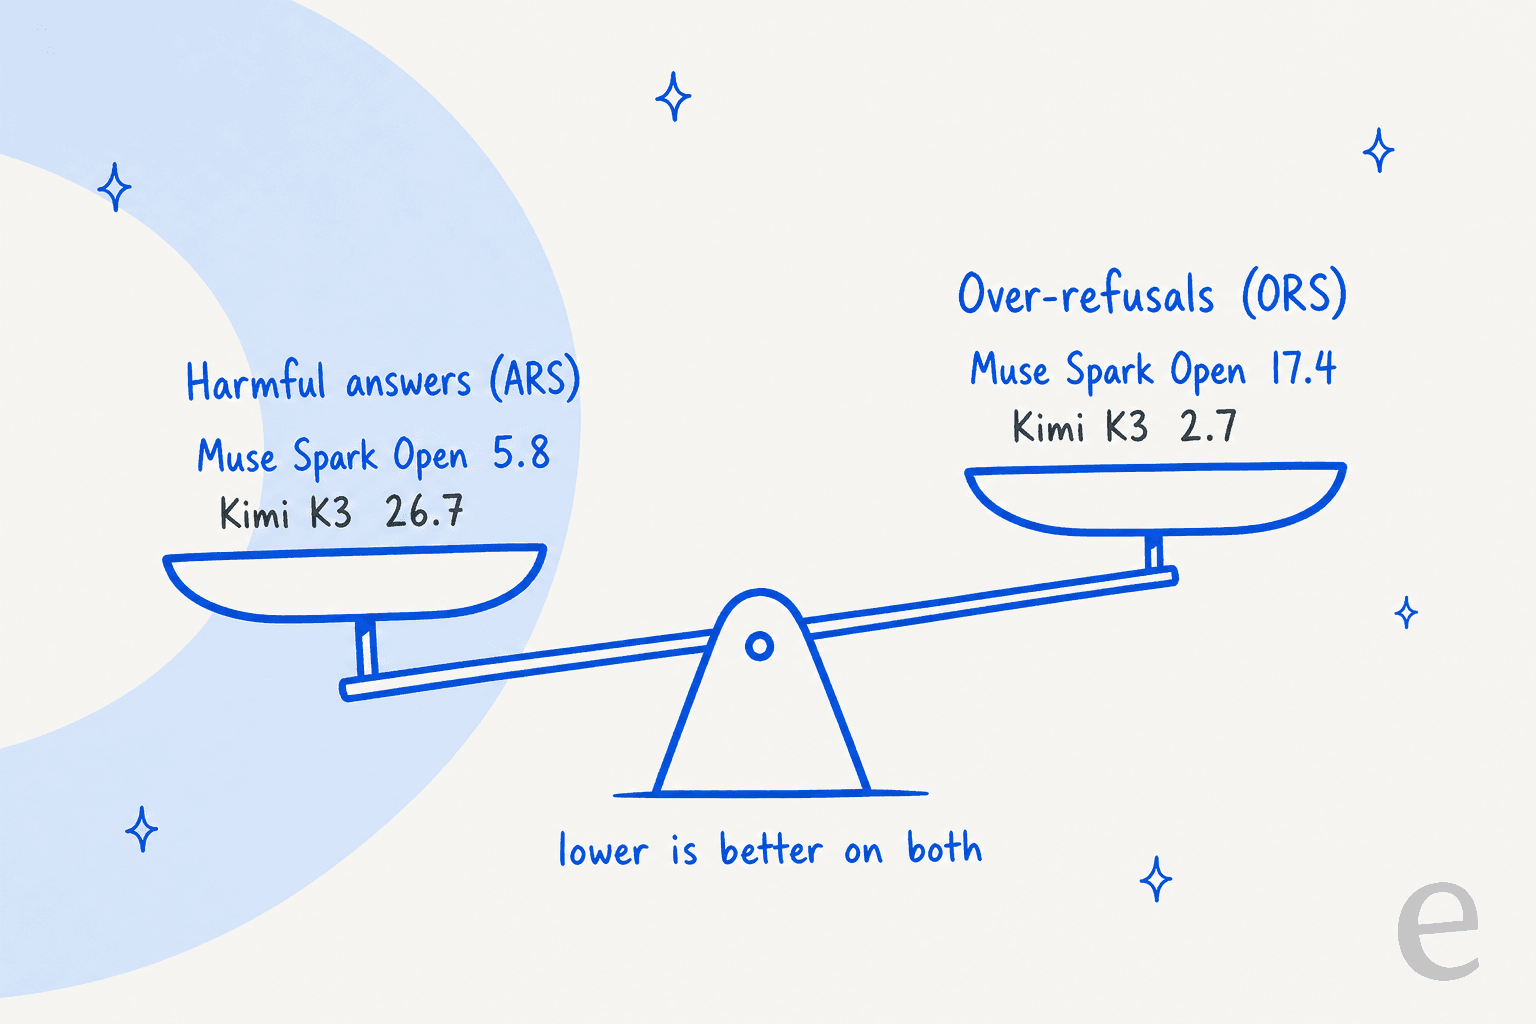
Muse Spark Open の ORS は 17.4 です。Kimi K3 は 2.7、GLM 5.3 は 3.2 です。つまり、表の中で最もだましにくく、正当なリクエストを最も断りやすいモデルです。カスタマーサービスエージェントにとって、これは現実的なトレードオフです。言い回しがぎこちない返金の質問や、医療機器の不具合を伝えるお客様のメッセージは、慎重すぎるモデルが断りかねない無害なメッセージの典型です。どちらの方向であっても、安全性の見出しの数字を信じる前に、あなた自身の雑多なチケットでテストすることをお勧めします。
料金:オープンウェイトなのにクローズドモデル並みの価格
私が最も驚いたのはここです。OpenRouter 上のローンチ時のホストは、すべてまったく同じ料金です。
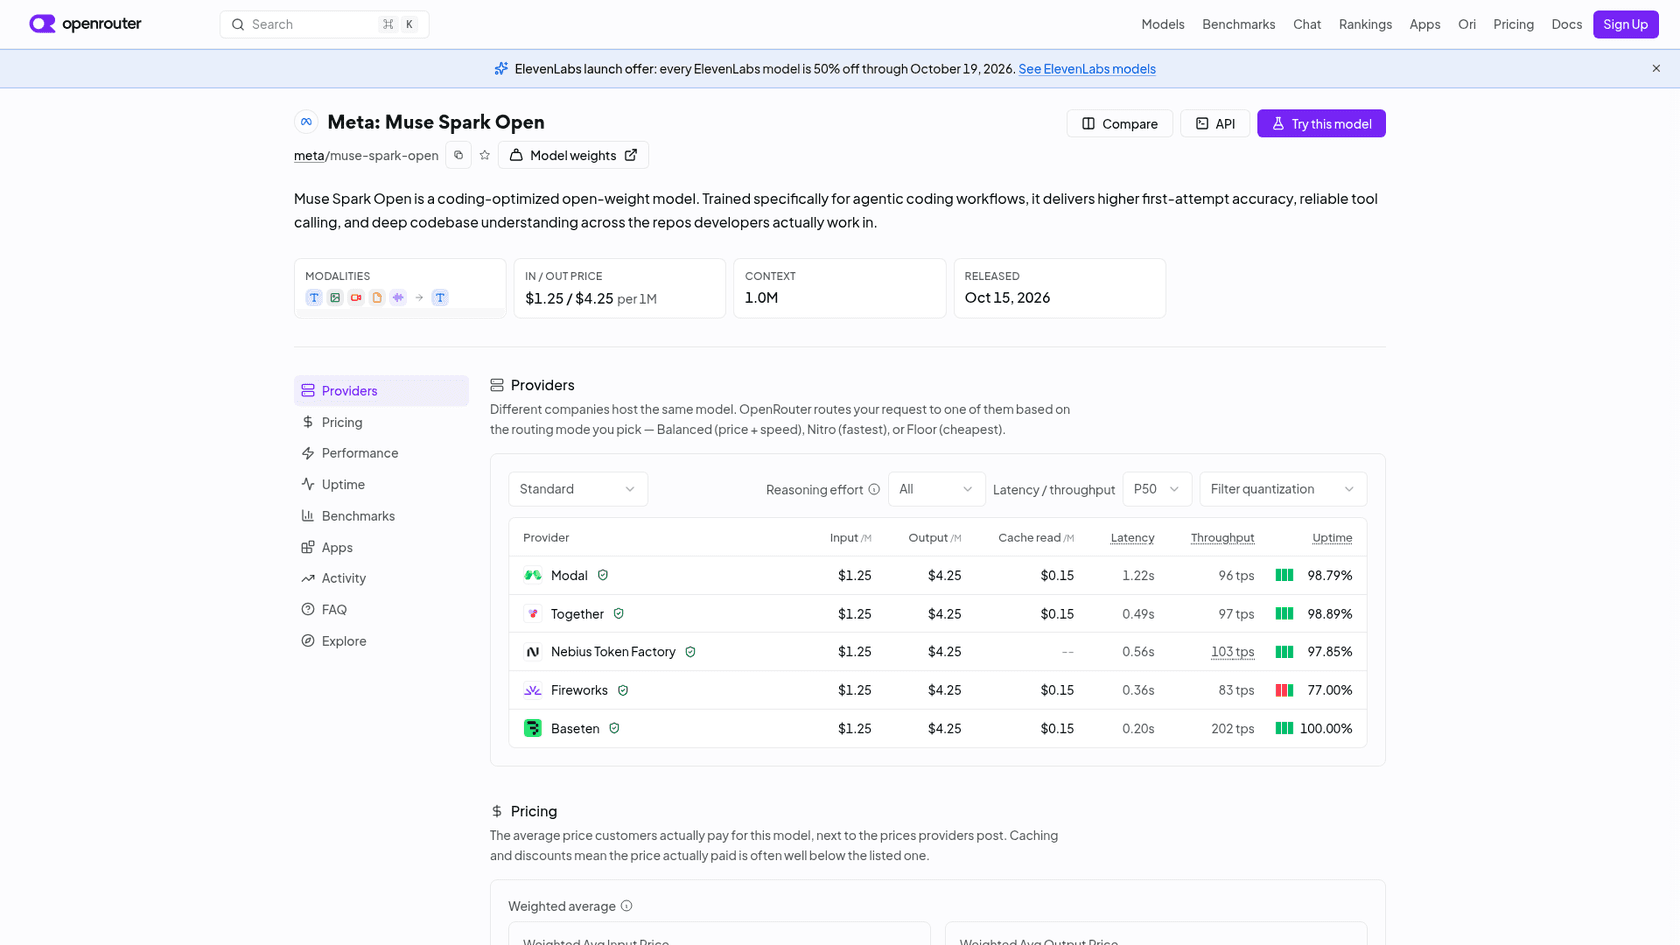
| プロバイダー | 入力 / 100万 | 出力 / 100万 | キャッシュ入力 / 100万 | 備考 |
|---|---|---|---|---|
| Baseten | $1.25 | $4.25 | $0.15 | NVFP4、1Mコンテキスト、毎秒約200トークン、Baseten の料金を参照 |
| Fireworks AI | $1.25 | $4.25 | $0.15 | サーバーレス LoRA ファインチューニング、Fireworks の料金を参照 |
| Together AI | $1.25 | $4.25 | $0.15 | 99.9% SLA の専用エンドポイント、Together の料金を参照 |
| Modal | $1.25 | $4.25 | $0.15 | 共有または専用エンドポイント |
| Nebius Token Factory | $1.25 | $4.25 | なし | |
| Groq | 記載なし | 記載なし | なし | 限定プレビュー、131Kコンテキスト、毎秒約350トークン以上 |
この $1.25 / $4.25 という料金は、Meta がクローズド版の Muse Spark 1.3 に xhigh で課す料金と同じです。Artificial Analysis はこの点を直接指摘しています。このモデルは同規模の他のオープンウェイトモデルと比べて "particularly expensive" で、中央値は入力 $0.43、出力 $1.68 です。指数の1タスクを実行するコストは $0.84 です。
競合する5つのホストがなぜ同じ価格になるのでしょうか。理由はおそらくライセンスです。ローンチスレッドのある開発者がはっきり書いています。
"The model license requires large inference providers to contact Meta separately to obtain a license to serve the model... The usual effect of separate licensing is decreased price competition from public providers."
同じスレッドからの妥当な反論もあります。固定価格には、ホスト同士が互いに安売りするために壊れた、あるいは劣化したバージョンを提供することを防ぐ効果もあります(dannyw, Hacker News)。どちらも成り立ちえます。
実際にはいくらかかるのでしょうか。読む量が多く書く量が少ないエージェントを想定した概算例です(出力は100万トークンあたり $4.25 で計算)。
| 月間ボリューム | 入力 | 出力 | 月額のおおよその請求額 |
|---|---|---|---|
| 小規模なパイロット | 10Mトークン | 2Mトークン | $21 |
| 稼働の多い1エージェント | 100Mトークン | 20Mトークン | $210 |
| チーム全体への展開 | 1Bトークン | 200Mトークン | $2,100 |
エージェントが毎回同じナレッジベースを再利用する場合、繰り返し使うコンテキストを $1.25 ではなく $0.15 でキャッシュすれば、入力側のコストを大幅に減らせます。xhigh の推論がデフォルトであることを忘れずに、短い回答には medium に下げてください。
自分で動かす:ハードウェアに本当に必要なもの
最も注目を集めたのは Apple の売り込みでした。最先端クラスのモデルを机の上で動かす、というものです。Apple の MLX 解説は、それが何を意味するかについて率直です。NVFP4 のウェイトは約 493GB を占め、作業用メモリを加えると "the model cannot fit on a single machine" とのことです。
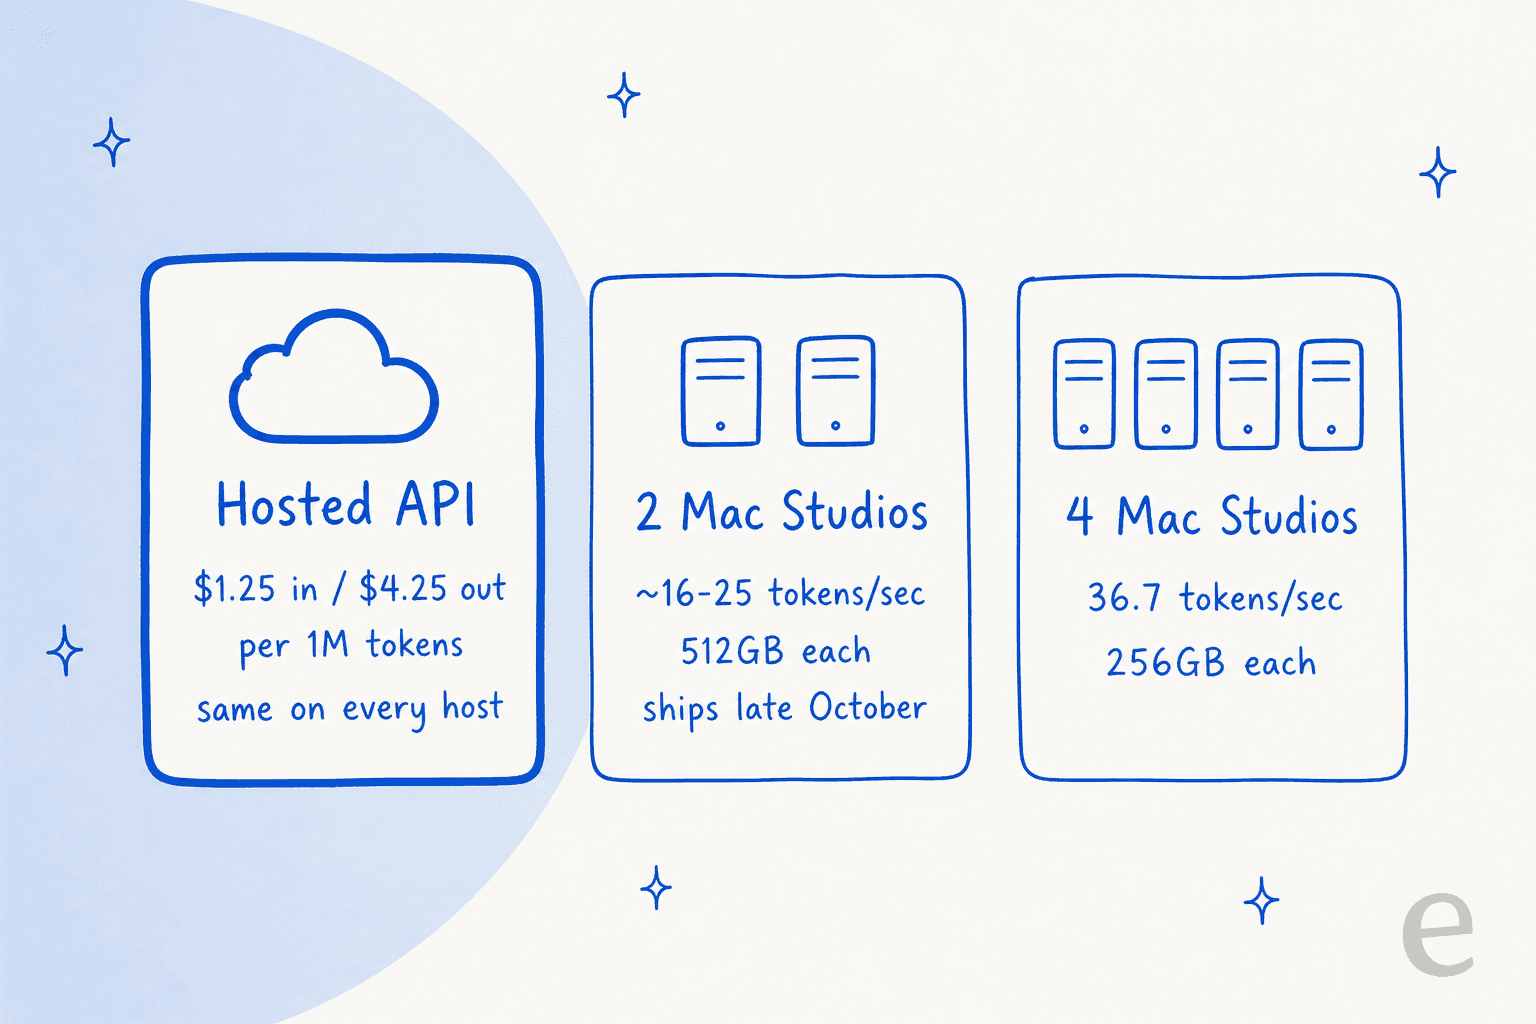
コンテキスト8,192トークンでの Apple の実測デコード速度は次のとおりです。
| 構成 | デコード速度 |
|---|---|
| Mac Studio(M5 Ultra)2台、パイプライン分割 | 15.74トークン/秒 |
| Mac Studio(M5 Ultra)2台、テンソル分割 | 24.99トークン/秒 |
| Mac Studio(M5 Ultra)4台、テンソル分割 | 36.73トークン/秒 |
2台構成には512GBの M5 Ultra が必要で、Apple のストアでは "coming late October" と表示され、価格はまだ示されていません。M5 Ultra の構成はメモリがずっと少ないものが $5,499 から始まります。あるコメント者は、反応をこうまとめました。
"A single Mac Studio w/ M5 Ultra and half that RAM (256 GB) is around $11k, and the 512 GB option isn't even available yet. So.... yeah."
GPU については、モデルカードが NVFP4 で少なくとも 700GB、BF16 で 2TB の VRAM を求めています。Meta の開発者向け投稿では、NVFP4 は Blackwell Ultra GPU 4基、または H200 8基で動作するとされています。Unsloth の2ビット版なら合計メモリは約 300GB まで下がりますが、品質は多少落ちます。
Meta の名誉のために言えば、初日からのサポートは異例なほど充実しています。SGLang、vLLM、TensorRT-LLM、Transformers、MLX、llama.cpp、Unsloth がすべてローンチ時に動作し、ファインチューニングは TorchTitan、Fireworks、Together で行えます。ある開発者が指摘したように、Meta は "did the actual work of testing and documenting deployments on several platforms" しました(bahmboo, Hacker News)。
では、誰がセルフホストすべきでしょうか。スレッドでの答えは私の考えと一致します。契約上または法律上の理由で、データを自社のハードウェアに置く必要があるチームです(mbreese, Hacker News)。それ以外の人にとっては、稼働の多いエージェントで月 $210 なので、コメント者がすでに $20,000 超と見積もっている Mac 2台構成より、ホスト API のほうが長い間安く済みます。
ライセンスの注意点
Muse Model License は表面上は寛容で、無料の利用、ファインチューニング、蒸留、再販が認められています。重要な条件は次のとおりです。
- 製品内での表示義務:これを使う製品、またはその派生物(出力で訓練されたモデルを含む)の UI、ドキュメント、ウェブサイト、設定画面に、"prominently display 'Built with Muse Spark Open'" する必要があります。
- ホスト向けの2,000万ドルのライン:モデルへのアクセスをサービスとして販売し、会社の売上が12か月間のいずれかで
$20 millionを超える場合は、先に Meta との別途書面契約が必要です。 - 18歳未満の利用は不可:利用ポリシーには、モデルは "is not intended for individuals under the age of 18" とあり、未成年者がアクセスできる場合の責任は導入者が負います。
- 幅広い利用ポリシー:ライセンスのない専門業務(法律、医療、金融)、権利なしでの機微な個人データの処理への利用、出力を人間が書いたものとして提示することが禁止されています。
4つ目の点は、規制の厳しい業界のサポートチームにとって重要です。医療や金融の会社向けに返信を下書きするエージェントは、いずれにせよ人が介在する設計が必要で、Meta 自身のカードも "human-in-the-loop confirmation for irreversible actions" を推奨しています。これを「オープンソース」と呼べるかどうかは妥当な議論です。ローンチスレッドでは、複数の開発者がせいぜい "open-weight" だと呼んでいました(isityettime, Hacker News)。
Muse Spark Open と他の選択肢の比較
| モデル | AA Index(Meta の表) | DeepSWE 1.1 | MCP-Atlas | StrongREJECT(低いほど良い) | 最適な用途 |
|---|---|---|---|---|---|
| Muse Spark Open | 39 | 60 | 89.2 | 0.5 | ツールを多用するエージェント、慎重な運用 |
| Kimi K3 | 44 | 68 | 82.3 | 66.6 | オープンモデルでのコーディングとターミナル作業 |
| GLM 5.3 | 45 | 67 | 84.2 | 62.9 | オープンモデルで最高の総合スコア |
| Qwen 3.8 | 40 | 57 | 84.5 | 65.6 | 幅広い汎用用途 |
| Mistral Large 4 | 38 | 62 | なし | なし | EU ホストでの運用 |
クローズドモデルを使えるなら、差はさらに開きます。Meta 自身の最上位ティアは Muse Wonder のレビューで、Claude Opus 5.5 は Opus 5.5 のレビューで同様に取り上げています。どちらも同じ指数で 39 を大きく上回っています。
ツール利用より価格が重要なら、DeepSeek V4 Flash のレビューから始めてください。Qwen 3.8 は、検討に値するもう1つのオープンモデルで、Qwen 3.8 のレビューで取り上げています。
結論:Muse Spark Open を使うべき人
評価:3.5/5
- 選ぶべき人:ダウンロード可能なウェイトが必要で、エージェントが正しいツールを呼べるかどうかにすべてがかかっていて、拒否が少なすぎるより多すぎるほうがよい場合です。MCP のスコアと安全性のチューニングは本物の強みです。
- 見送るべき人:主にコードを書く場合(Kimi K3 か GLM 5.3)、最安のオープンモデルのトークンが欲しい場合(
$1.25 / $4.25が下限として固定されています)、1台のマシンで動かすつもりだった場合です。 - 信頼する前にテストする:自社のトラフィックでの過剰拒否率です。
サポートチームにとってのより大きな教訓は、壊れるのはたいていモデルではないということです。eesel の営業での会話で最もよく聞く失敗は、ナレッジベースに該当する情報がなかったときに、ボットが作り話の詳細で実際のお客様に回答したというものです。別の購入検討者であるハードウェア企業の技術評価担当者は、AI が知らないことについて一般的なウェブ知識で回答するのか、それをオフにできるのかをストレートに尋ねました。これらは、検索、ガードレール、引き継ぎの問題です。より賢い、あるいはより安全なモデルに入れ替えるだけでは解決しません。AI エージェントによるサポート自動化のガイドで、解決につながる各層を解説しています。
ヘルプデスクに eesel を試す
サポートキューを担当する AI エージェントが欲しくて Muse Spark Open を検討していたなら、eesel の AI ヘルプデスクチームメイトなら GPU 選びは不要です。Zendesk、Freshdesk、Gorgias などに数分で接続し、過去のチケットとヘルプセンターから学び、お客様に一度も返信する前に、過去のチケットでシミュレーションされます。どのチケットに回答し、どれを社内メモとして下書きし、いつ担当者に引き継ぐかは、あなたが決めます。

モデルを自分で組み込みたい場合は、Claude をヘルプデスクに接続するガイドで必要な作業がわかります。Meta 自身のアプローチは Muse for customer support で取り上げています。
料金は eesel の料金ページで月 $299 からで、先に無料でお試しいただけます。eesel を試して、先月のチケットに対して何と回答したかを確認してみてください。