

Meta の Muse Spark 1.3 は、2026-09-02 にリリースされた、コーディングと長いコンテキストに本当に強いモデルで、見出しに値します。最上位ティアの Artificial Analysis Intelligence Index は62で、636モデル中6位です。ただし、3つの点で期待値を調整する必要があります。第一に、62を記録するティアは max で、max の推論は発売時点で安全性テストのため制限されており、実際に使えるのは xhigh です。第二に、Metaの「エージェント性能の向上」という説明は、実際にはコーディング性能向上の話です。Meta自身のチャートでも、エージェント6項目のうち4項目で Opus 5 max が上回っています。第三に、冗長で、Muse Spark 1.2 のおよそ3倍のトークンを消費するため、実際の請求額は表示価格を上回ります。
最も興味深いのは料金です。標準エンドポイントは100万あたり $1.25 / $4.25(データは非公開)、コントリビューター向けエンドポイントはおよそ $0.10 / $0.20(Metaがトラフィックで学習)です。カスタマーサポート向けに検討しているなら、モデルはインフラであり、同僚ではないことを思い出してください。eesel は、このようなモデルで動作し、ヘルプデスクに接続し、誰かに返信する前に過去のチケットでシミュレーションできる、すぐに働けるAIサポートエージェントを提供します。
ここでの「レビュー」の意味と、テストできなかったこと
私は仕事でインテグレーションとAPIを作っているので、モデルのリリースを読むときは、プレスリリースよりも、組み込んだ後に実際どう動くかに関心があります。それがこのレビューの視点です。Metaのリサーチブログと評価方法を丁寧に読み、Artificial Analysisから数値を取得し、1日で261件のコメントが集まったHacker News のローンチスレッド全体にも目を通しました。
できなかったのは max をエンドツーエンドで動かすことで、これは私の手抜きではありません。Metaのブログ自身が、これまで利用できた推論モードは本日提供され、"with max reasoning coming shortly after we finish additional safety testing." と述べています。つまり、62を記録するモードは、ほとんどの人がまだ呼び出せるモードではありません。実際の挙動について話すときは xhigh、つまり実際に利用可能で61を記録するティアを指します。Metaのマーケティングは触れていないので、この差を以降も念頭に置いてください。
Metaが読ませたい1枚のチャート
Muse Spark 1.3 のレビューはどれもこのスコアカードから始まるので、まず掲載し、そのうえで何が書かれていないかをお伝えします。
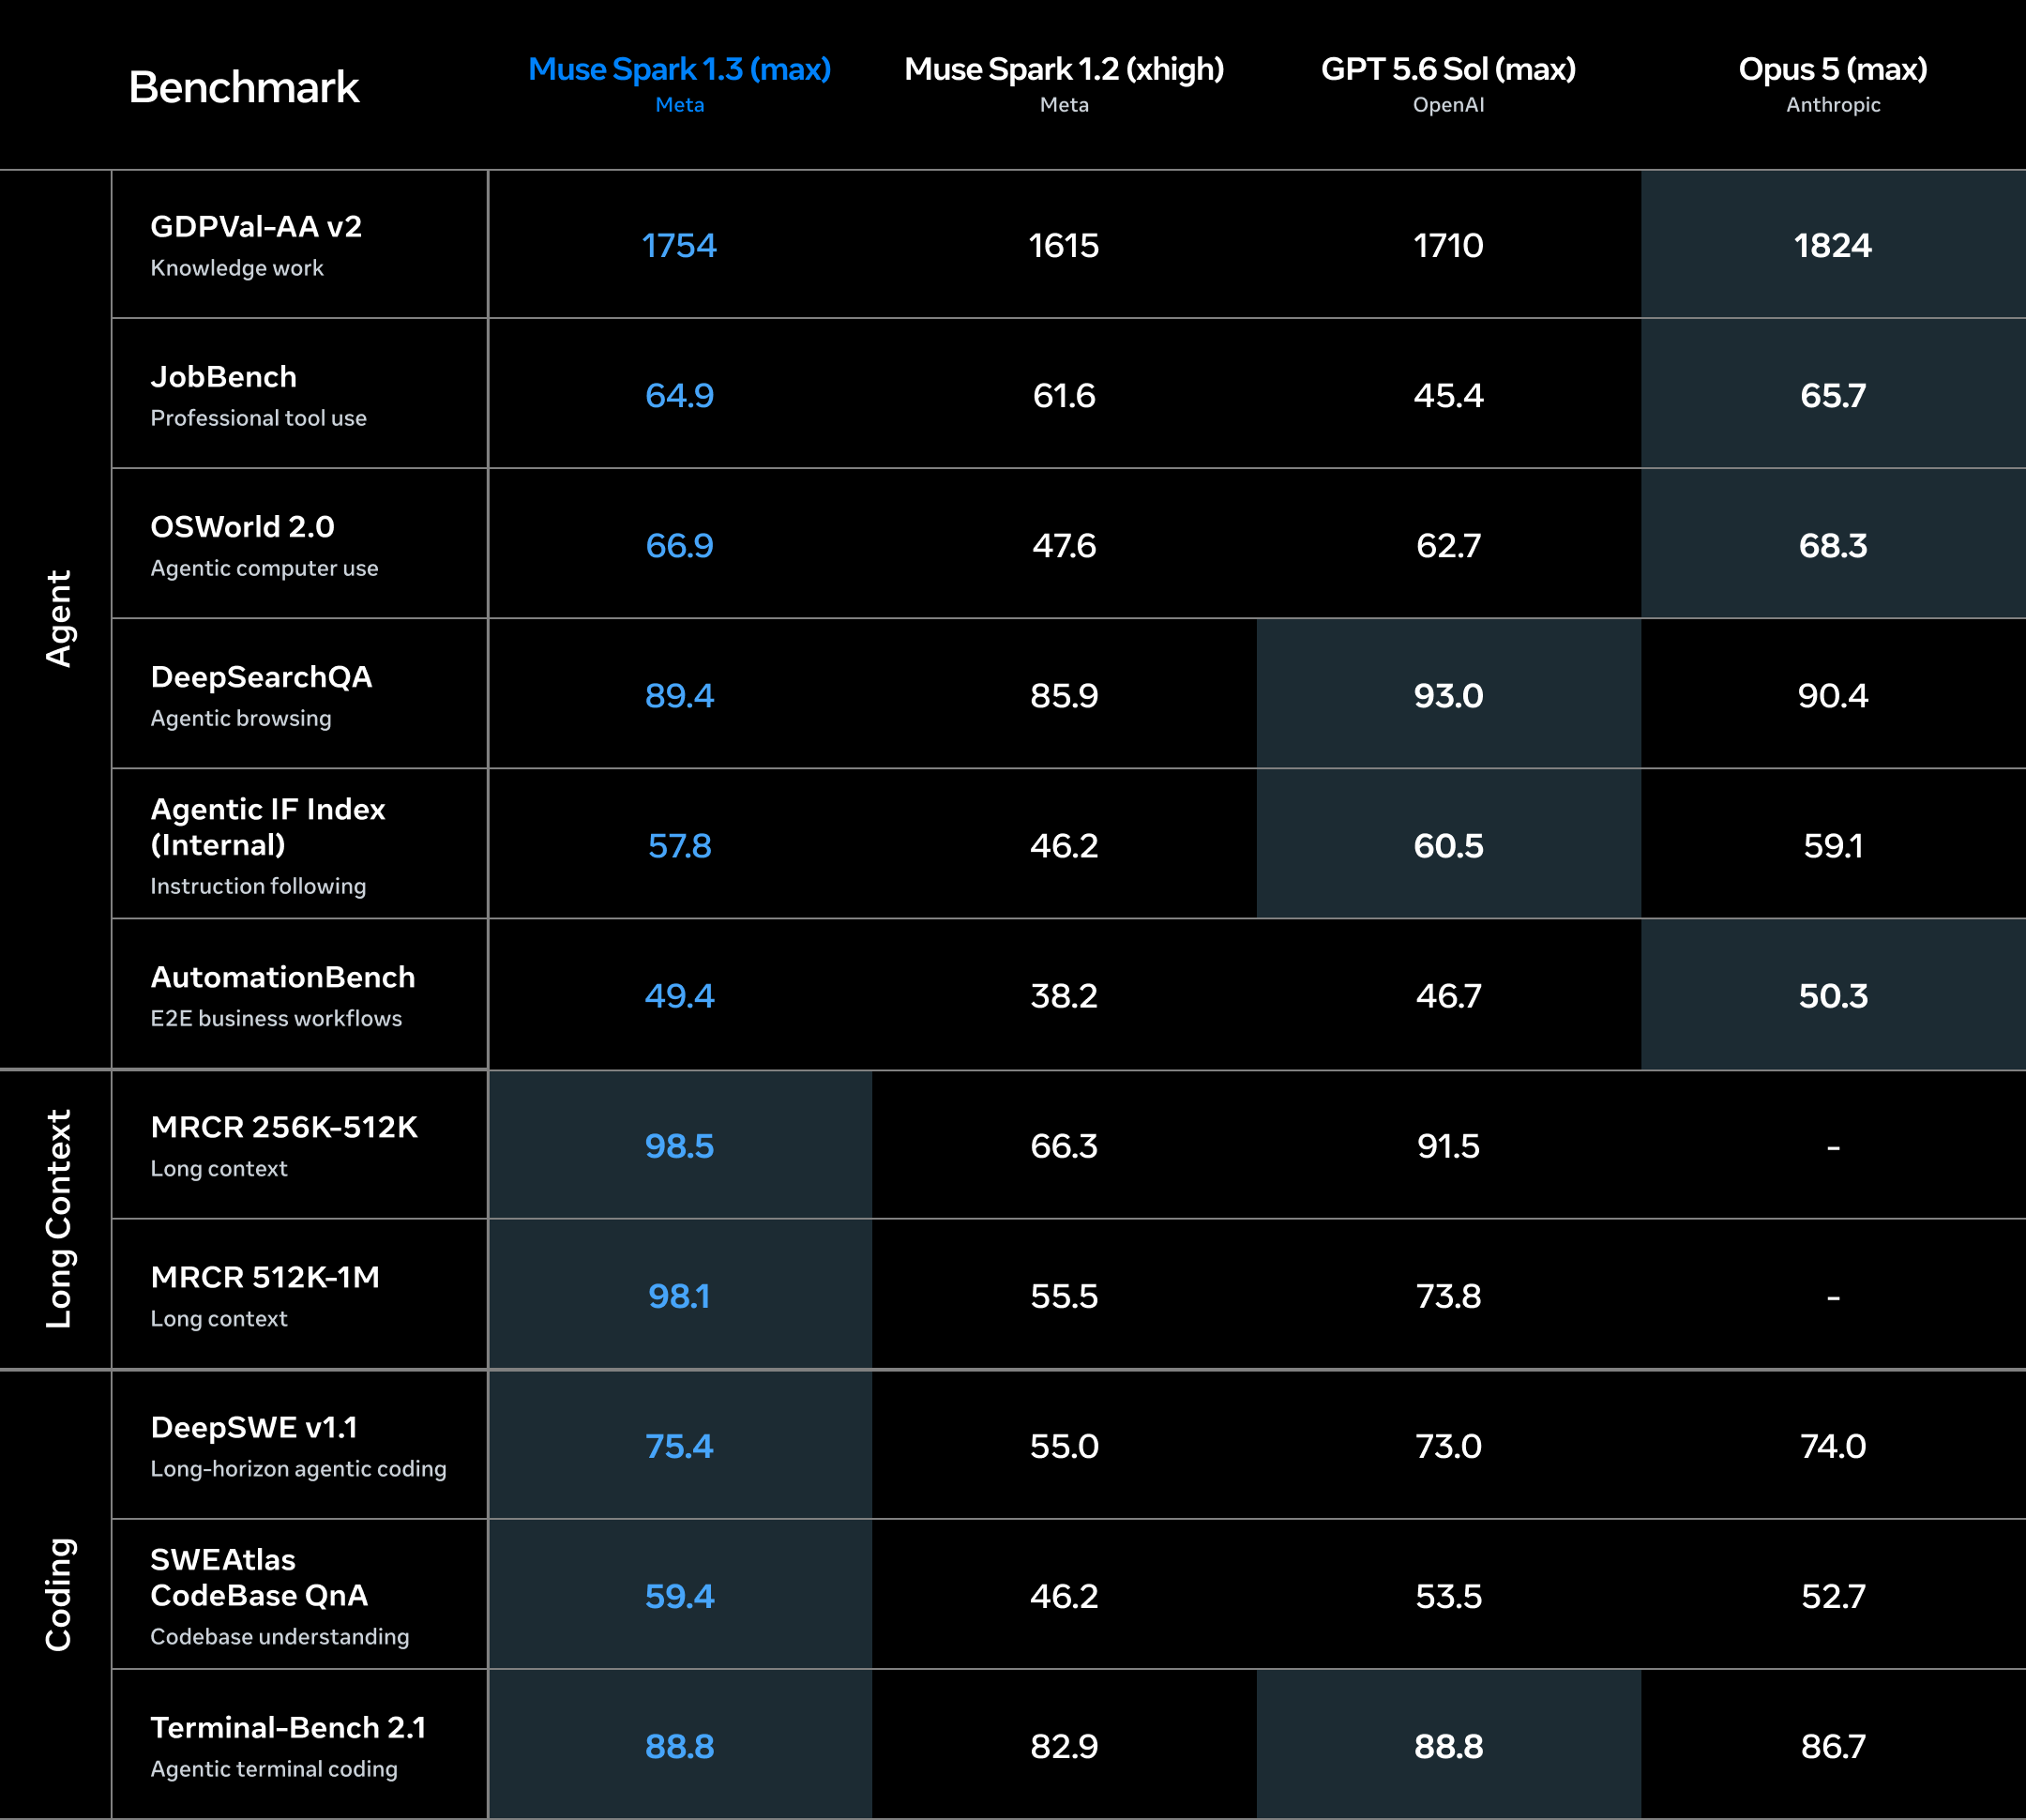
4つの列は Muse Spark 1.3、Muse Spark 1.2、GPT-5.6 Sol、Opus 5 で、エージェント、コーディング、指示追従、長いコンテキストの各カテゴリにまたがっています。1.3 の完勝に見えます。ここに注意点があります。1.3 の列は max で、比較されている 1.2 の列は xhigh です。これは同条件の比較ではありません。見えている差の一部は、モデル世代の違いではなく、推論ティアの違いです。HNのコメント投稿者 sunaookami は、スコアカードが "only shows max reasoning" である一方で、max はまさに制限されているモードだと指摘し、不誠実だと述べました。1.3 の最良のバージョンと、1.2 の中間的なバージョンを比べて見せられているのです。
だからといってモデルが悪いわけではありません。ローンチ時のチャートが常にそうであるように、このチャートはマーケティング資料だということです。差の正確な大きさではなく、方向性を読み取ってください。
本当に強い分野:長いコンテキストとコーディング
枠組みを取り除いても本当の強みは残り、それは2つの分野に集中しています。
長いコンテキストでは、1.3 は優秀です。MetaのMRCR想起テストで、256K-512K帯では98.5、512K-1M帯では98.1を記録し、隣に並ぶ 1.2 の数値を大きく上回ります。「この巨大なコードベースや文書群を読んで全体について推論する」ことが作業内容なら、この想起性能は検討する正当な理由です。1Mトークンのコンテキストウィンドウは単なるマーケティング上の余裕ではなく、想起スコアは実際にウィンドウを使いこなしていることを示しています。
コーディングでは、1.2 からの改善がMetaのブログで最も信頼できる部分です。具体的だからです。Metaのエンジニアは、同じコーディングタスクでツール呼び出しがおよそ20%、トークンが25%減り、スタイルもすっきりして冗長さが減ったと報告しています。DeepSWE v1.1 では 1.2 の55.0に対して75.4を記録し、Terminal-Bench 2.1 では GPT-5.6 Sol と並ぶ88.8です。コミュニティのレビュアー majerep は、前バージョンを精密で中程度のタスクにおける "the best free model available on OpenCode" と呼びましたが、コーディングの数値は 1.3 がその優位を広げていることを示しています。エージェント型コーディングループを動かす安価なモデルを探すなら、Kimi K3 や DeepSeek V4 Flash と並んで候補に入れます。
「エージェント性能」の話が、実はコーディングの話である理由
これは、読み始める前には予想していなかった発見です。Metaの見出しは "improved performance across agentic and coding tasks" ですが、そのエージェント側の半分は、Meta自身が比較対象に選んだモデルに対して成り立っていません。
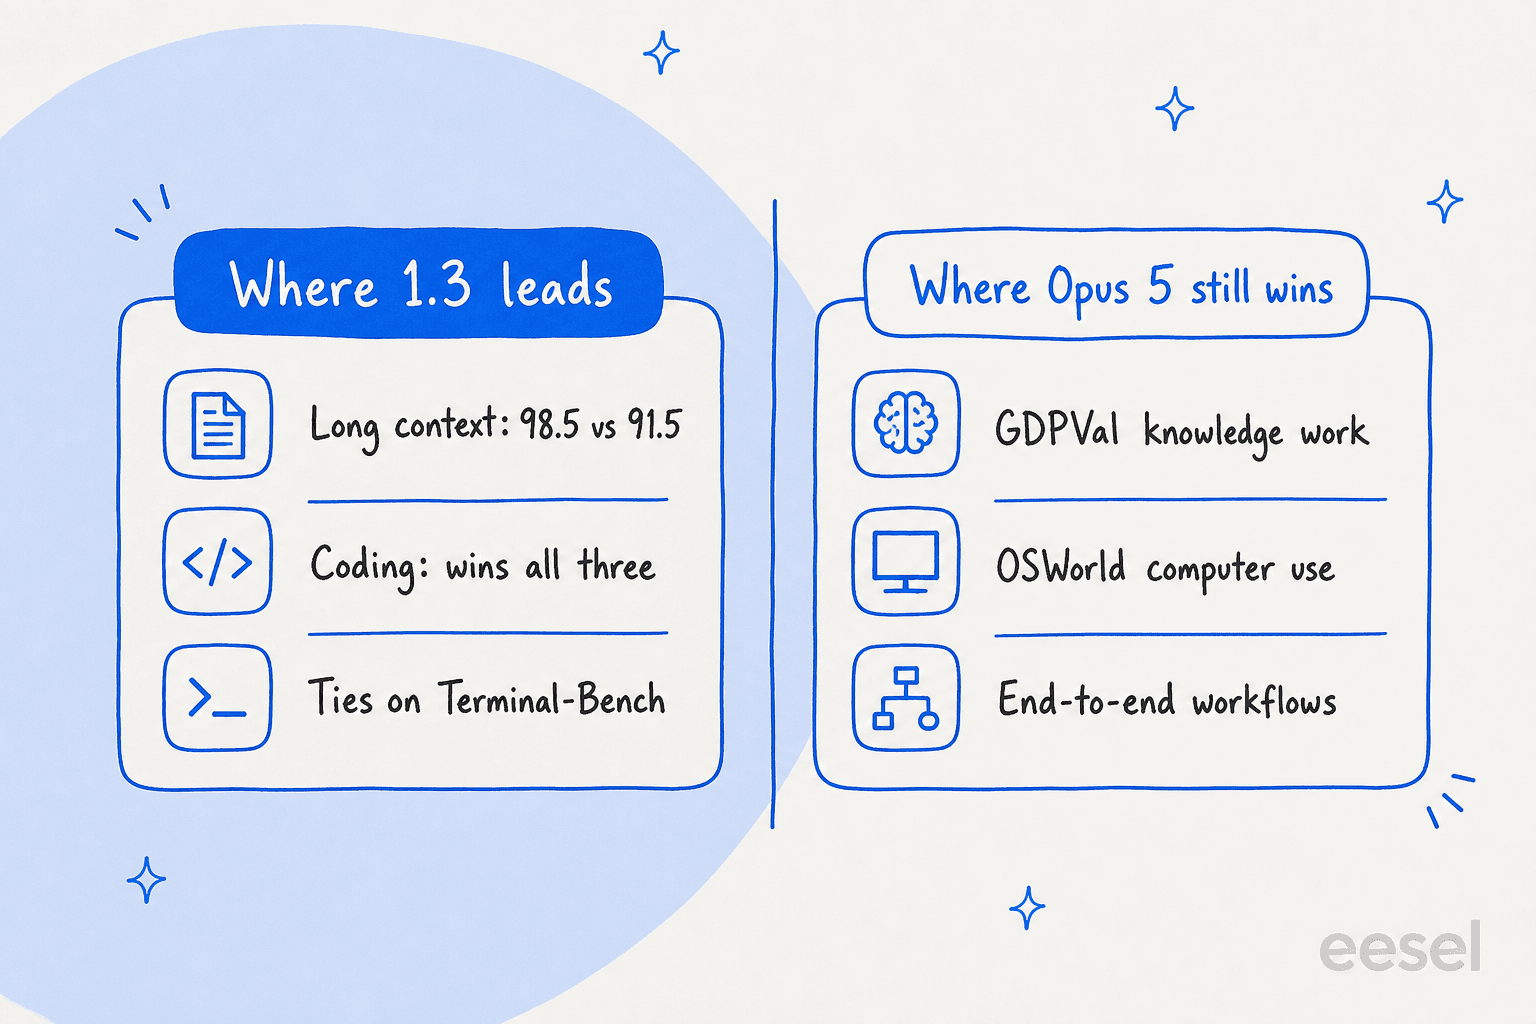
Metaのスコアカードにあるエージェント6項目を見てみましょう。Opus 5 max は GDPVal-AA v2(1824対1754)、JobBench(65.7対64.9)、OSWorld 2.0(68.3対66.9)、AutomationBench(50.3対49.4)で勝っています。GPT-5.6 Sol は DeepSearchQA(93.0)と Agentic Instruction-Following Index(60.5)を取っています。つまり、Muse Spark 1.3 はエージェント項目のすべてでどちらかのライバルに負けています。圧倒しているのはコーディングと長いコンテキストで、それは「最高のエージェント」とは別の主張です。正直な読み方は、「エージェント性能の向上」はほぼ「コーディング性能の向上」であり、コーディングは確かに向上している、ということです。
公平を期すと、トップ10に入るモデルであることに変わりはなく、エージェントでの差も小さいです。しかし、多段階のツール利用やコンピューター操作のためにモデルを選ぶなら、Metaが公開したスコアカードは、その用途では Opus 5 のほうが安全な選択だとさりげなく示しています。誤った「エージェント的」アクションが実在の顧客への誤った返信になるサポート自動化では、この違いは非常に重要です。だからこそ私たちは、ベンチマークの1行を信じるのではなく、本番前にすべてのエージェントを過去のチケットでシミュレーションします。
スコアカードに載らない冗長さの税
速度と価格は、トークンを数えるまでは素晴らしく見えます。Artificial Analysis Intelligence Index を完走するために、Muse Spark 1.3 は1億2000万の出力トークンを生成しました。全体の中央値は7200万です。冗長さでは636モデル中139位で、多くのモデルよりおしゃべりということです。
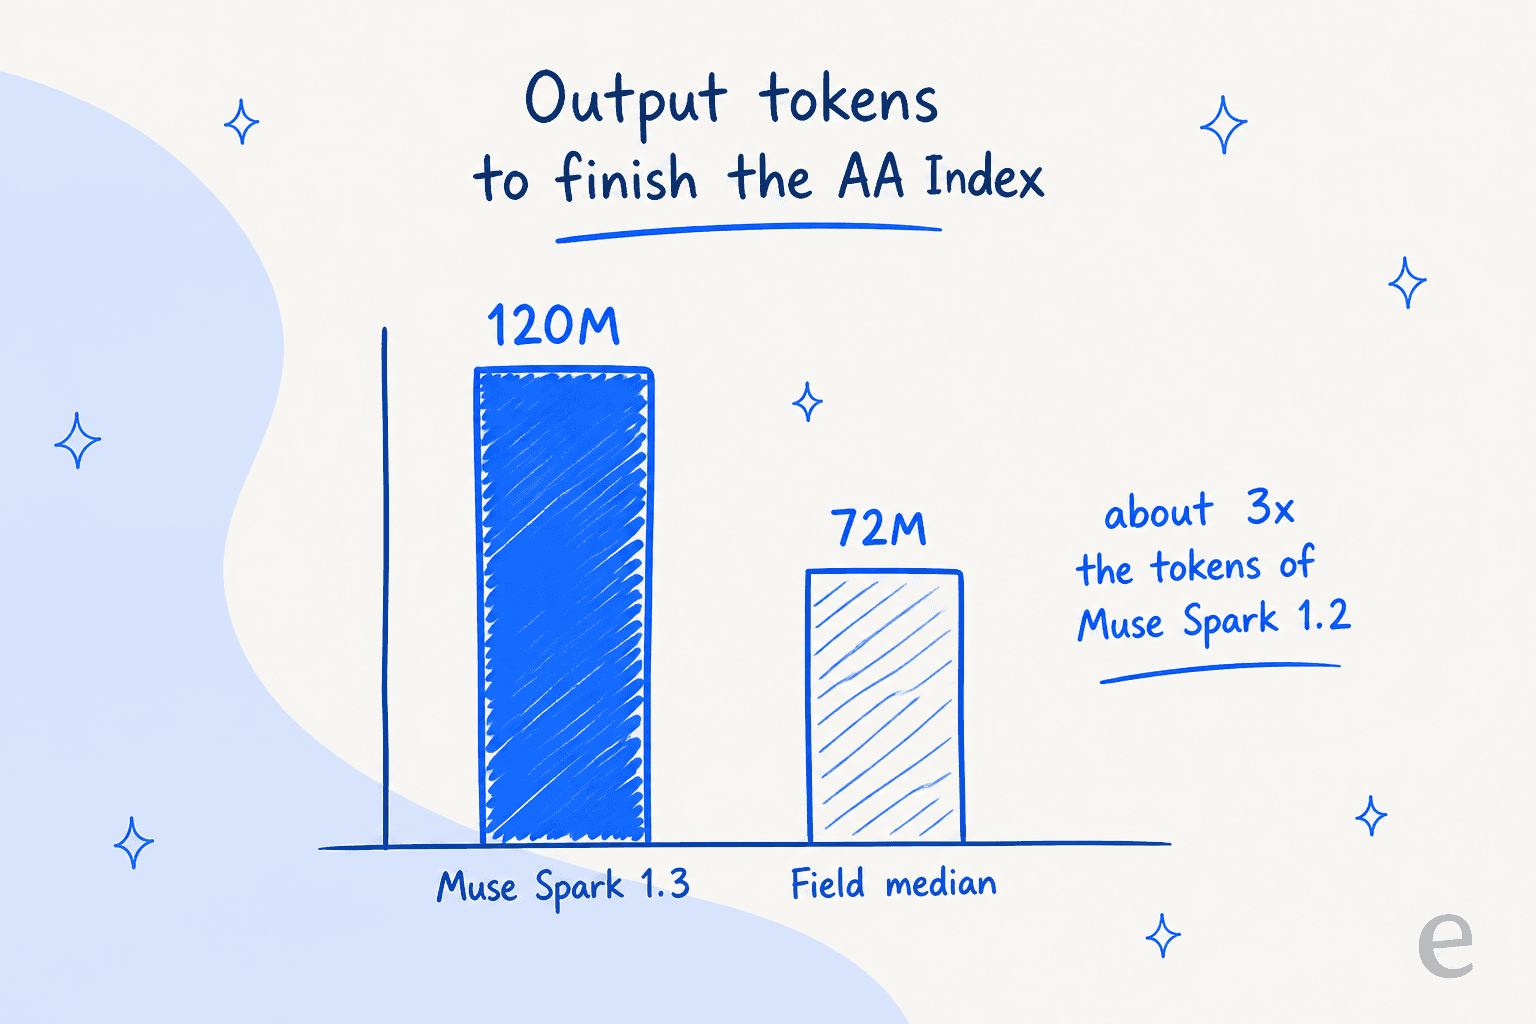
Hacker News の面々は、恒例の「自転車に乗るペリカン」SVGストレステストを走らせ、1.2 のおよそ3倍のトークン使用量と独自に見積もりました。出力トークンごとに課金されるため、冗長さは直接のコスト乗数です。3倍のトークンを生む100万あたり $4.25 の出力単価は、実際には $4.25 のモデルではありません。署名する前に料金表の隣に置くべきなのはこの数字で、生のトークンメーターは隠し、解決単位の定額料金は隠さない、まさにそうした隠れた総コストです。
料金は2つあり、その差がすべて
Muse Spark 1.3 の料金は最も議論されている点で、それは当然です。実際には、データという通行料を挟んだ2つの価格だからです。
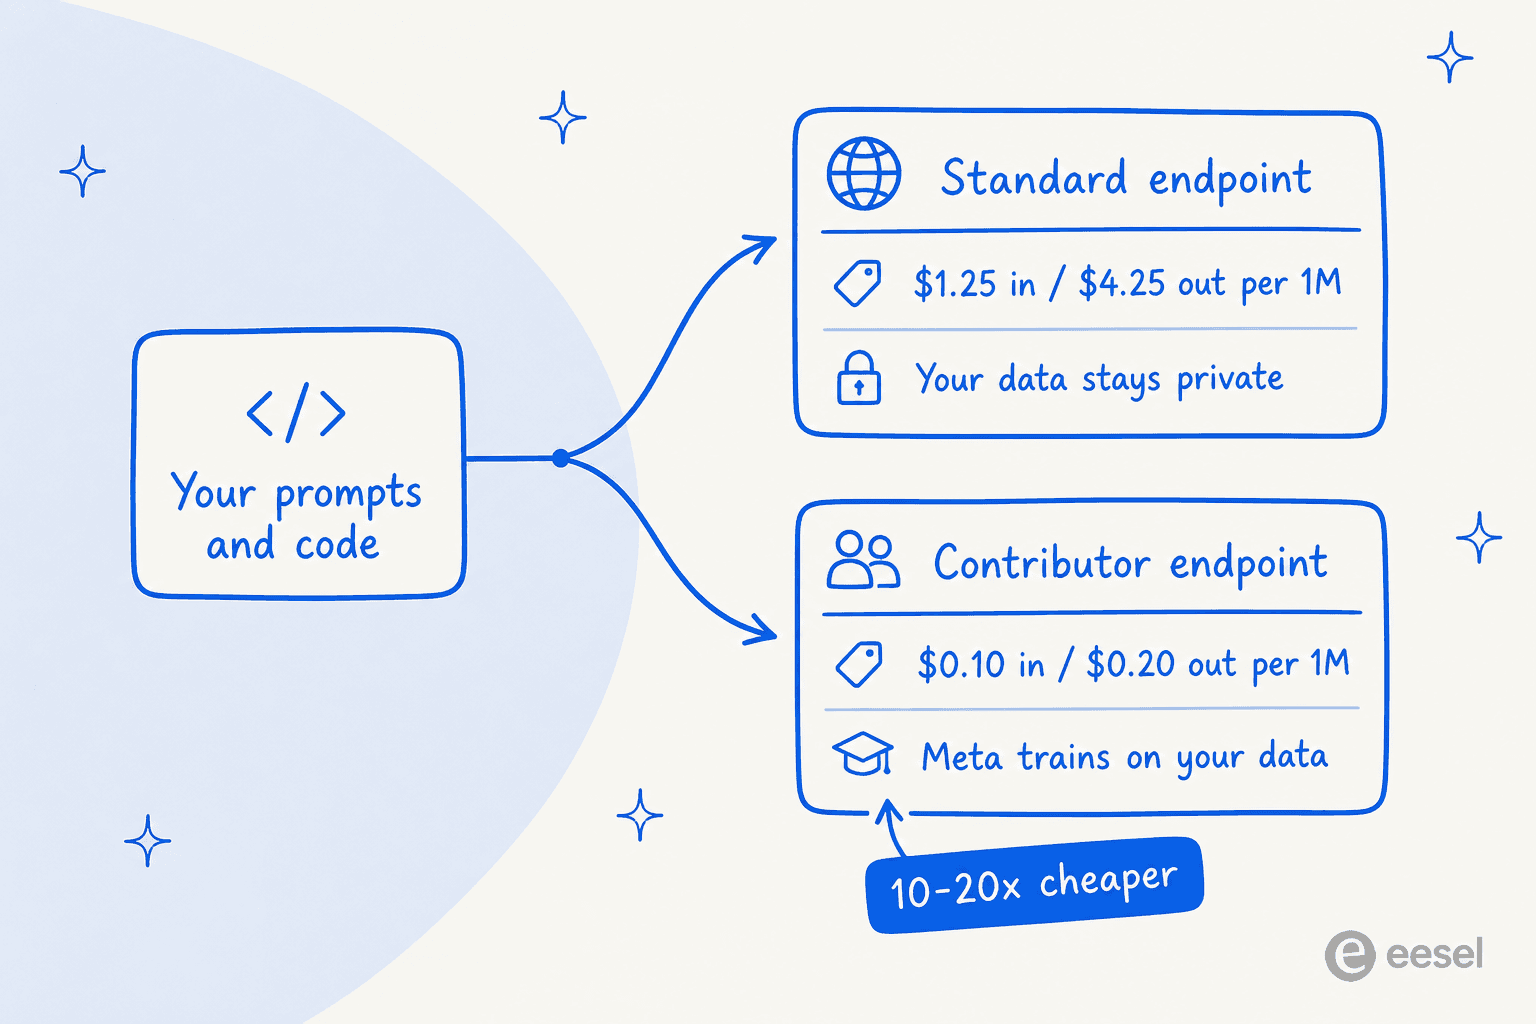
| エンドポイント | 入力 / 1M | 出力 / 1M | Metaはあなたのデータで学習する? |
|---|---|---|---|
| 標準 (xhigh) | $1.25 | $4.25 | いいえ |
| コントリビューター | ~$0.10 | ~$0.20 | はい |
標準料金は、入力の中央値 $1.75 と比べて中程度の価格で、Artificial Analysis はIndexのタスクあたり $0.55 と測定しました。コントリビューター向けエンドポイントが10〜20倍安いのは、ドルではなくデータでMetaに支払っているからです。この分割が存在する理由についてのコミュニティの見方は、Meta自身の説明より鋭いものです。
"It's not that Meta really wants your data and they're willing to pay top dollar for it. It's that companies really don't want Meta to have their data and they're willing to pay top dollar for that."

この2文がすべてです。上乗せ料金は優れたモデルのためではなく、Metaをあなたのトラフィックから遠ざけるための価格です。趣味のプロジェクトなら気にならないでしょう。顧客の個人情報に触れるものなら、「安い」エンドポイントは現実的な選択肢ではないので、計画に使うべき数字は標準の $1.25 / $4.25 に、上記の冗長さの乗数を掛けたものです。
コミュニティは実際どう考えているか
ローンチ当日の反応は本当に賛否が分かれており、その混ざり方が示唆的です。楽観派は価格と知能の比率を評価しています。HDBaseT が指摘したように、コントリビューター向けエンドポイントは "by far the cheapest, significantly cheaper per M than ChatGPT Luna, significantly smarter than Luna too." です。懐疑派は性能に納得せず、前バージョンについてこう述べています。
"Used Muse Spark 1.2 and was not impressed at all. Fast and cheap but even GPT 5.6 Terra felt much more capable."
また mromanuk は、実際のウェブアプリで 1.2 に跳ね返され、Claude、Kimi K3、DeepSeek V4 に戻ったと述べ、1.3 が基準を超えることを期待していました。共通点は、速くて安いのは本当で、最高水準の性能は議論の余地があり、それを動かすツールが重要だということです。meric_ をはじめ複数のコメント投稿者が、共同で学習されたMeta自身の Muse Code ハーネスで動かすべきで、そうしないと効率を取りこぼすと強調しました。
誰が使うべきで、誰が見送るべきか
具体的に述べます。「場合による」で終わるレビューは時間の無駄だからです。
- 使うべき人:作業がコーディングまたは長いコンテキストの推論で、Muse Code で作業でき、データが機密ではなくコントリビューター向けエンドポイントが選択肢に入る場合。その条件では、強力で安価な選択です。
- 検討するべき人:Kimi K3 や DeepSeek V4 Flash に手を伸ばすようなコスト重視のコーディングエージェント。冗長さの分を予算に入れてください。
- 今のところ見送るべき人:最高水準のエージェント的ツール利用が必要な場合(スコアカードは Opus 5 を指しています)、今日
maxが必要な場合(まだ制限中)、規制対象データを扱い標準の上乗せ料金を払えない場合。 - 生のモデルは完全に見送るべき人:本当にほしいのがカスタマーサポート自動化の場合。それは別の製品で、理由は次に説明します。
モデルは同僚ではない:サポートチームにとっての意味
このようなモデルが話題になるたびに、サポートリーダーが陥る罠がこれです。「トップ10のエージェントモデル、激安」と読んで、受信トレイに向ければよいと考えます。生のモデルは、データベースや決済APIのようなインフラです。強力で、汎用的です。返金ポリシーを知らず、ヘルプデスクに接続されておらず、先週のチケットの記憶もなく、有料顧客に自信満々の誤答を送る前のブレーキも組み込まれていません。Meta自身も 1.3 は "confirming before consequential actions" が向上したと述べており、これは生のモデルにそのガードレールを後付けする必要があるという認めです。
モデルと、働けるチームメイトとの間のそのギャップを埋めるために eesel は存在します。eesel はAIチームメイトのプラットフォームで、特定の仕事のために、すぐに働けるチームメイトを雇います。現在のラインナップはAIサポートエージェントとAIブログライターです。サポートエージェントは、仕事のやり方をすでに知った状態で現れます。ナレッジベースで学習し、過去のチケットを把握し、既存のキューに参加して、下書きまたは自動解決を行い、必要なときには適切にエスカレーションします。その下のモデルは交換可能な部品で、Muse Spark 1.3 のようなフロンティアモデルはまさにそれが動作できるエンジンですが、価値はその周囲に構築されたすべてにあります。
このようなコーディングモデルのリリースに直接結びつくのが eesel CLI です。ターミナルからエージェントを操作できるから Muse Code が好きだという方なら、これが重要な理由がわかるでしょう。CLI は、ダッシュボードにあるのと同じ eesel チームメイトとワークスペースを、エージェントに優しい形で操作する方法です。人がターミナルから手で実行でき、スクリプトがCIで自動化でき、Claude Code、Codex、Cursor などのコーディングエージェントが直接操作できます。切り離された簡易版の製品ではなく同じチームメイトなので、UIをクリックして回ることなく、ソースの管理、実行のトリガー、アクティビティの取得ができます。それが「モデルのキーを渡すので頑張ってください」と「スクリプトでも操作できる同僚がいます」の違いです。
生のモデルキーの代わりに eesel を試す
安価なフロンティアモデルの上にサポート自動化を構築するかどうかを検討してこのレビューにたどり着いたのなら、正直な答えは、モデルは簡単な部分であり、最も小さな問題だということです。eesel は、すでにその仕事のために配線されたAIサポートエージェントを提供します。このようなフロンティアモデルで動作し、Zendesk、Freshdesk、その他のスタックに接続し、そして実際にリスクを減らす部分として、何千件もの過去のチケットでシミュレーションして、顧客に返信する前に本当の解決率を確認できます。
このシミュレーションの手順は、本番のサポートキューにAIを載せて何年も経験して痛い思いをして学んだ教訓です。自信ありげなボットが静かに誤答するのを見てきたので、eesel では、あなた自身の履歴に対する事前テストなしに顧客へ届くものはありません。無料で始めて、自分のデータで数字を確認できます。
結論
Muse Spark 1.3 は、コーディングと長いコンテキストにおける本物の前進であり、コントリビューター向け料金なら、市場でトークンあたりの価値が最も高い選択肢の1つです。「トップのエージェントモデル」としては誇大です。Meta自身のスコアカードではエージェント項目を Opus 5 が制しており、旗艦の max ティアは制限中で、3倍の冗長さのため、安い表示価格は実際に支払う価格ではありません。それを、速くて安くて冗長な、長いコンテキストに強いコーディング特化モデルとして読めば、好きになりやすいモデルです。ただし、強いモデルを、働けるチームメイトと取り違えないでください。仕事が顧客対応なら、エンジンではなくチームメイトを雇ってください。