

Meta Muse Wonderとは?
Muse Wonderは、Meta Superintelligence Labsの最新のモデルシリーズで、Metaはこの2つを「our most capable models」と呼んでいます。Muse Spark 1.3のモデルラインの上位に位置し、9月に登場した個人向けパーソナルエージェントのMeta Museとは別のものです。Wonderはエンジン、Museはそのエンジンがまもなく載る車の1台、と考えてください。
私はeeselで連携機能とAPIを作っているので、ベンダーのドキュメントを読むのと同じ姿勢でリリースページを読みます。実際に何を呼び出せるのか、いくらなのか、どんな条件が付くのか、という点です。ローンチ週は、Metaのモデルドキュメント、料金とレート制限のページ、ベンチマーク表、そして362件のコメントが付いたHacker Newsのスレッドを読み込みました。このレビューはプレスリリースではなく、それらをもとにしています。
Metaが提供するものを、1つの表にまとめます。
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| モデルID | muse-wonder-1.0 | muse-wonder-full-1.0 |
| 入手先 | Meta Model API、OpenRouter、すべてのMuse Codeプラン | Muse CodeのPower UsageとMaximum Usageプランのみ |
| コンテキストウィンドウ | 1,048,576トークン | 1Mトークン |
| 入力タイプ | テキスト、画像、動画、音声、PDF | 個別の記載なし |
| 推論の強度 | 「minimal」から「max」 | maxで表示(SWE-Marathonではxhigh) |
| 料金 | 100万トークンあたり入力4.00ドル / キャッシュ0.20ドル / 出力20.00ドル | 月額50ドルまたは200ドルのプランに含まれる |
| ステータス | プレビュー | サブスクリプション限定 |
モデルドキュメントの2点は、見た目以上に重要です。1つ目は、Muse Wonderがプレビュー扱いであること。2つ目は、Metaが「setting reasoning effort to 'max' on Muse Wonder doesn't select」Wonder Fullだと明記していることです。大きいほうのモデルを解放するAPIフラグは存在しません。
ベンチマーク: Wonder Fullが勝つ分野と勝てない分野
Metaのモデルページには、2つのWonderモデルをClaude Fable 5.1、GPT-6 Astra、Claude Opus 5.5と比較した14行の表が掲載されています。すべてmax推論での比較です。各行で太字になっている勝者を数えました。
| ベンチマーク | 測定内容 | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|---|
| Personal Superintelligence Index | Meta独自の総合指標 | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA | 法務エージェントの業務 | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2 | 金融リサーチ | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro | 自由形式の健康に関する質問 | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA | エンドツーエンドの業務ワークフロー | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| GDP.pdf | 専門業務 | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| JobBench | 専門的なツール利用 | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
| OSWorld V2.1 (partial) | コンピューター操作 | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 |
| MemoryBench | 文脈の記憶 | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| Terminal-Bench 4.0-AA | ターミナルでのコーディング | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | 長期のコーディング | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon | 超長時間のエンジニアリング | 57.5 (xhigh) | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench | ゼロからのプログラミング | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| Artificial Analysis Index | 総合 | 56 | 52 | 53 | 53 | 58 |
集計結果です。Wonder Fullが6行、Opus 5.5が6行、GPT-6 Astraが1行、通常のMuse Wonderが1行で勝っています(MemoryBenchで、上位のWonder Fullをわずか0.1ポイント上回っただけです)。Claude Fable 5.1は1行も勝っていません。
これは本物の成果です。1年前、Metaをフロンティアのラボに数える人はいませんでしたが、Wonder Fullは14行中11行でGPT-6 Astraを上回っており、大きな飛躍です。特に目を引くのは法務の数字です。Harveyの法務エージェントのベンチマークで13.1というのは絶対値としては低いものの、Opus 5.5の4.2の3倍以上です。Harvey AIを追っている方なら、このベンチマークがどのモデルにとっても難しいことをご存じでしょう。
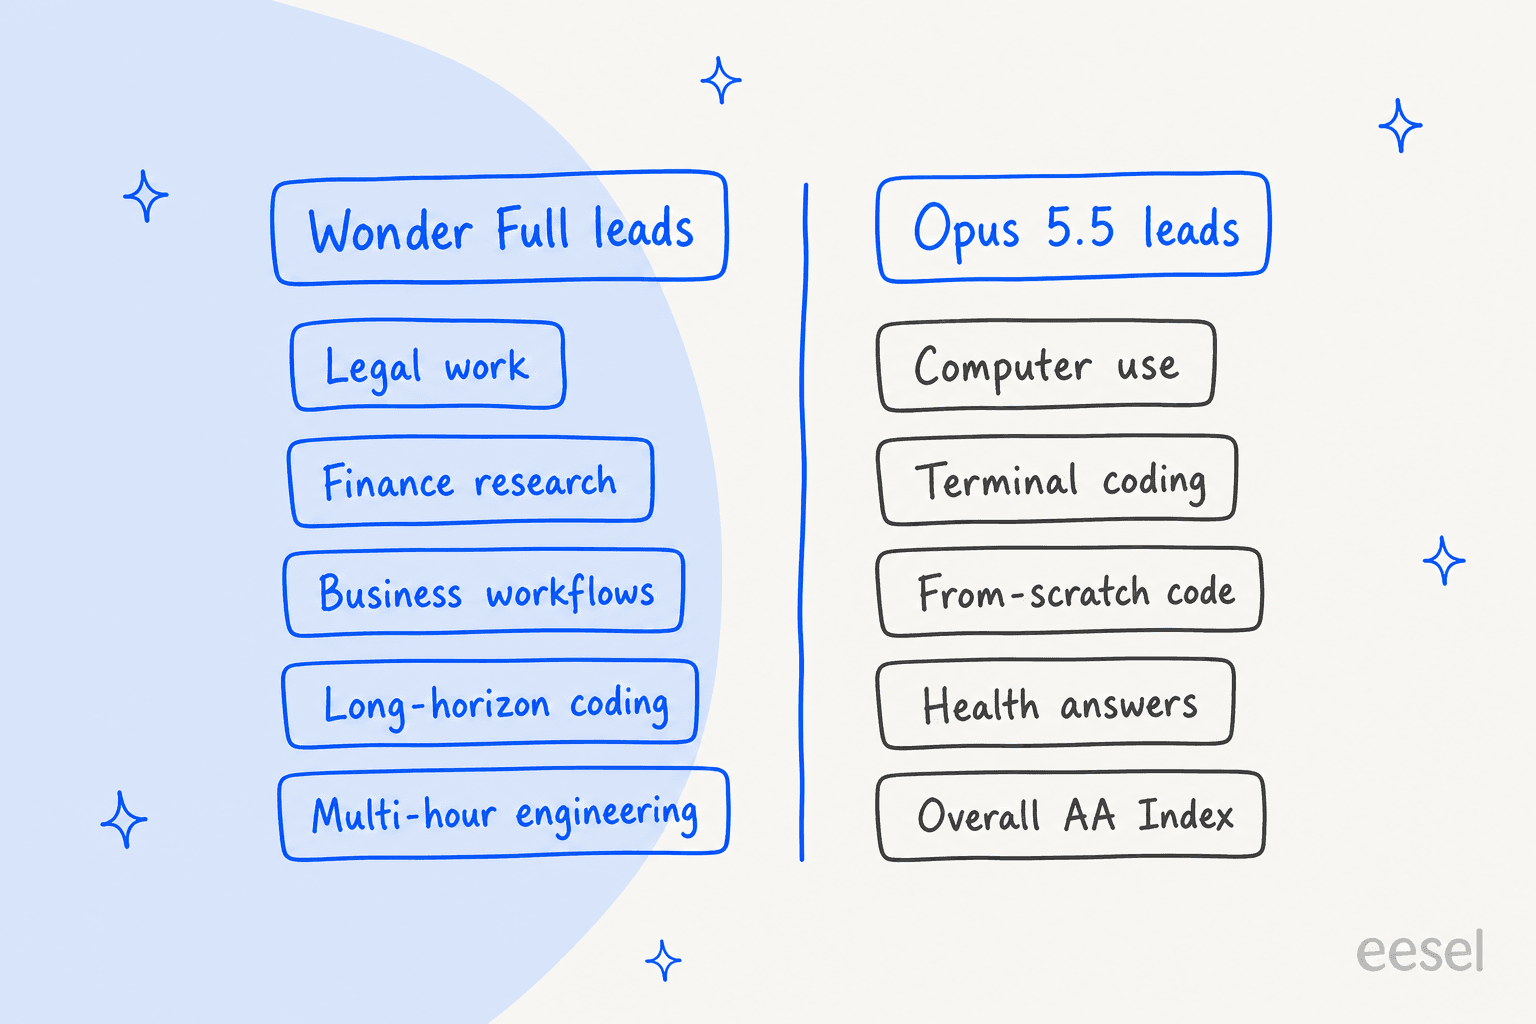
この勝ち負けには傾向があります。Wonder Fullが勝つのは、長くてドキュメントの多いタスクです。法務の成果物、金融リサーチのブリーフ、何時間もかかるコーディングプロジェクトなどです。一方、モデルがコンピューターを操作したりゼロから何かを書いたりする場面では、今もOpus 5.5が勝ちます。ProgramBenchでのリード(70.5対59.0)は、表全体で最大の差です。Metaの見せ方について1点だけ補足すると、Personal Superintelligence IndexはMeta独自の総合指標なので、私は第三者による行より重みを下げて見ています。
Metaのローンチブログには、10月12日時点で第三者機関のArtificial Analysisによるランキングも掲載されており、Wonder Fullは2位です。
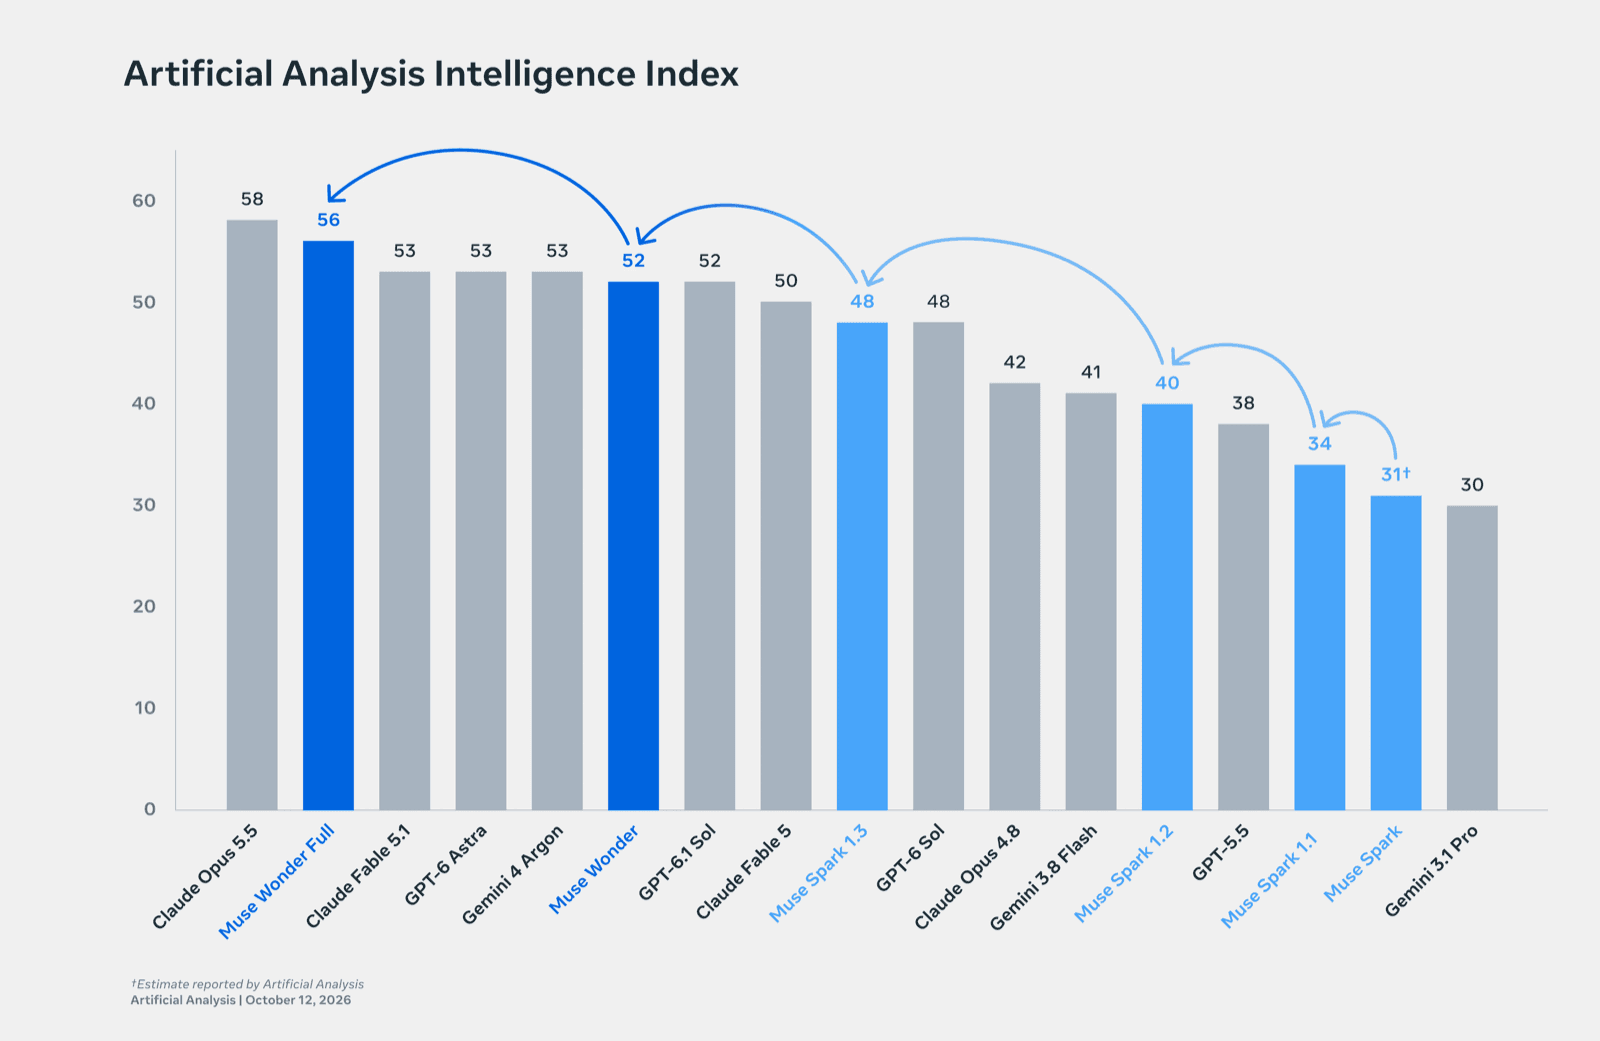
この2位に対するHNの反応は、ご想像のとおりでした。
"2nd place model on aa according to them, losing only to opus 5.5 is really really not bad"

ただし、順位の動きは速いです。同じ日の後半には、別のコメント投稿者が、Wonder Fullがライブのランキングで5位に下がったと報告しています。Gemini 4 Argonの後ろです。1枚のリーダーボードのスクリーンショットは、あくまでスナップショットとして扱ってください。
落とし穴: 買えるWonderは、チャートに載っているWonderではない
ローンチ関連の報道の多くが素通りしているのが、この部分です。AAのチャートをもう一度見てください。APIで呼び出せるモデルのスコアは52です。これはFable 5.1、GPT-6 Astra、Gemini 4 Argon(いずれも53)より低く、GPT-6.1 Solと同水準です。同じチャートでMuse Spark 1.3より約4ポイント高い、強力なモデルではあります。しかし、Opus 5.5を上回っているのはこのモデルではありません。
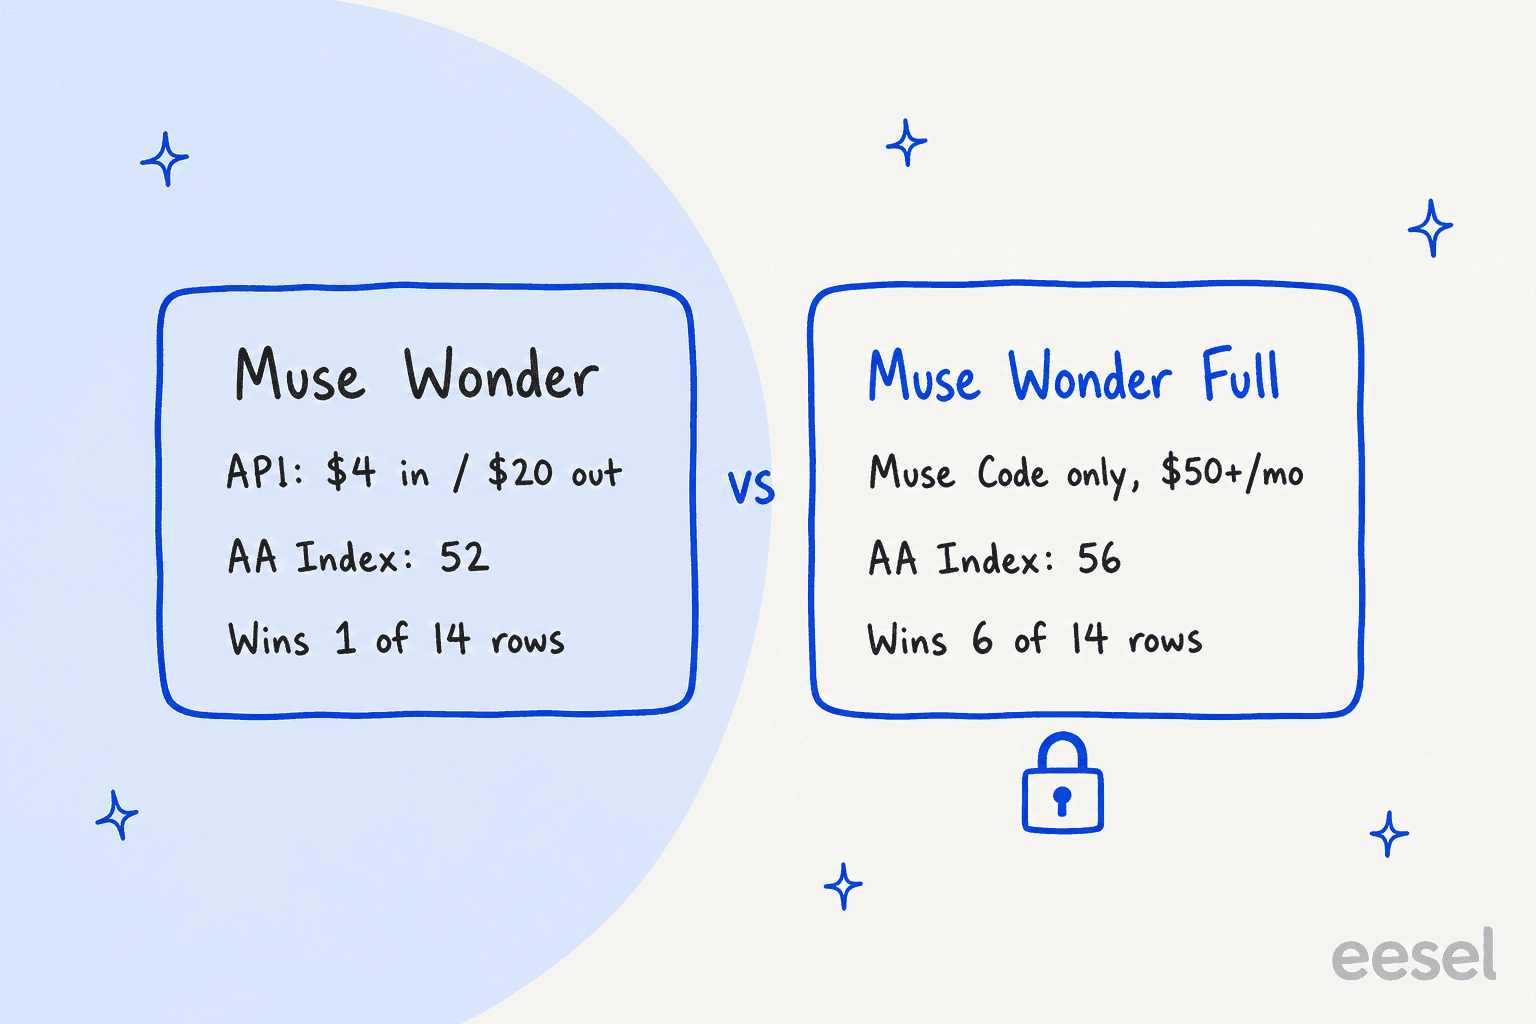
あるHNのコメント投稿者は、ローンチから数時間でこれに気づきました。
"Upon closer inspection, the benchmark scores for "Muse Wonder" on the main marketing page are actually for "Muse Wonder Full," which is only available on the higher-tier subscription plans. This pricing is for "Muse Wonder.""
Simon Willisonは、自分のAPIキーから見えるモデルを一覧にしましたが、リストにあったWonderはmuse-wonder-1.0だけでした。つまり、プロダクトを作る開発者にとっての選択は「Muse Wonder FullかOpus 5.5か」ではありません。「52点のMuse Wonderか、58点のOpus 5.5か。価格は同じ」という選択です。これはかなり売りにくい話です。
Muse Wonderの料金
料金は2つの別々の形で提供され、重なり合いません。
Meta Model APIの従量課金(Metaの料金表より):
| 利用項目 | Muse Wonder(Standardモード) | Contributorモード |
|---|---|---|
| 入力 | 100万トークンあたり4.00ドル | 利用不可 |
| キャッシュ入力 | 100万トークンあたり0.20ドル | 利用不可 |
| 出力 | 100万トークンあたり20.00ドル | 利用不可 |
| Web検索グラウンディング | 1,000クエリあたり2.50ドル | 利用不可 |
| レート制限 | 毎分3,000リクエスト、400万トークン | 利用不可 |
Metaは、長いコンテキストに割増料金はなく、すべてのプロンプトに挿入されるステアリングトークンも課金されないとも述べています。公平で分かりやすい料金表です。同時に、他社より安くするというMetaのこれまでの習慣からは大きな転換でもあります。Muse Spark 1.3の料金は1.25ドル/4.25ドルで、Contributor階層では0.10ドル/0.20ドルまで下がります。WonderにはAPI上の割引階層が一切ありません。
"$4/$20 in vs out making it higher than Sol and on par with Opus."
Metaの表に載っている競合と比べると次のとおりです。いずれも各ベンダー自身の料金ページにある標準APIレートです。
| モデル | 100万トークンあたり入力 | 100万トークンあたりキャッシュ入力 | 100万トークンあたり出力 |
|---|---|---|---|
| Muse Wonder | $4.00 | $0.20 | $20.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| Claude Fable 5.1 | $10.00 | $0.25 | $50.00 |
| Muse Spark 1.3 | $1.25 | $0.15 | $4.25 |
Muse WonderとOpus 5.5は、キャッシュ料金も含めて1セントまで同じ価格です。下に月間のボリュームを入力すると、他モデルとの差が分かります。
Muse Codeのサブスクリプションは、Wonder Fullに到達できる唯一の方法で、4つのプランがあります。
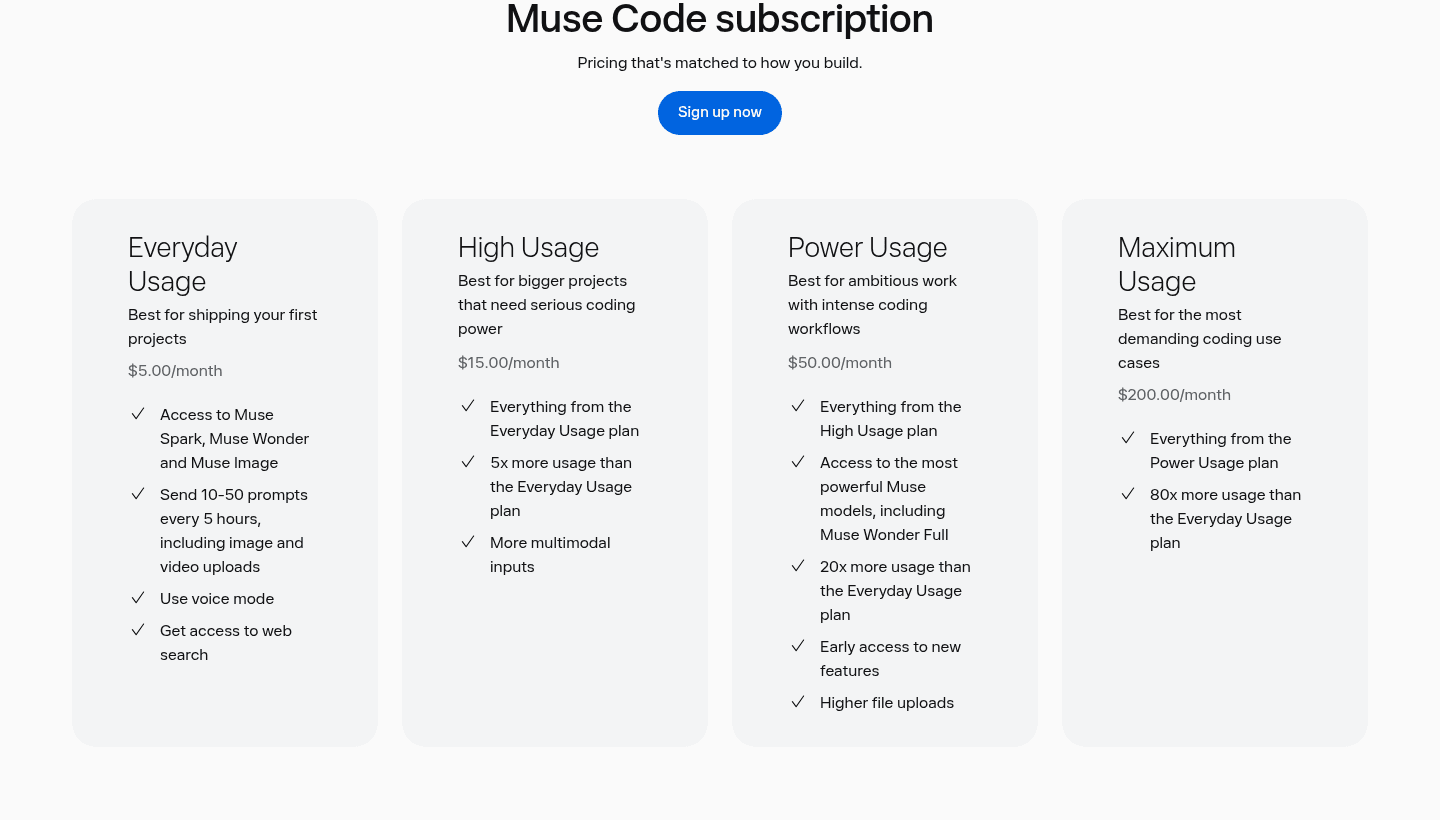
| プラン | 料金 | 利用枠 | Wonder | Wonder Full |
|---|---|---|---|---|
| Everyday Usage | 月額5ドル | 5時間ごとに10〜50プロンプト | 可 | 不可 |
| High Usage | 月額15ドル | Everydayの5倍 | 可 | 不可 |
| Power Usage | 月額50ドル | Everydayの20倍 | 可 | 可 |
| Maximum Usage | 月額200ドル | Everydayの80倍 | 可 | 可 |
料金はMuse Codeのページ、プランの規約はサブスクリプションのドキュメントによるものです。細かい条件は読んでおく価値があります。18歳以上であること、提供状況は「may vary by region」であること、解約時の返金はないこと、そしてポリシー違反があればMetaはサブスクリプションを即座に取り消せることです。また、サブスクリプションのキーはMuse Code CLIの中でしか使えないため、アプリのトラフィックを50ドルのプラン経由で流すことはできません。コーディングエージェント自体の費用の全体像については、Muse Codeの料金の解説をご覧ください。
エントリープランについては、制限が厳しいと感じた初期ユーザーがいました。
"The usage limits on their basic $5 code plan to try things out are ludicrously low?"
彼は、短いプロンプトを3回送っただけで週の利用枠の17%を使ったと報告しています。Wonder Fullはそもそも50ドルの階層からなので、Fullが目当てならPower Usageを前提に予算を組むのがよいでしょう。
Active MemoryとActive Focus: 本当に新しいもの
Metaは、Wonderを2つの名前付きの機能で説明しています。Active Memoryは「carrying important context about you across conversations and actively retrieving the details relevant to the task at hand」です。Active Focusは、難しい目標に向かってモデルが作業を続ける仕組みで、「trying alternative approaches, working through blockers, and adapting to new information」を行い、「before taking important actions」に確認を求めたり報告したりします。
どちらも表の行に対応しています。MemoryBenchは通常のWonderが単独で勝つ唯一の行(85.6)で、SWE-MarathonはFullのリードが最も大きい行(Opus 5.5の46.3に対して57.5)です。これは、Wonderを「long-running, complex tasks where capability matters more than cost per token, such as multi-file coding changes, multi-hour agent runs, and sub-agent orchestration」向けと位置づけ、大量処理やレイテンシーが重要な用途はMuse Sparkに誘導しているMetaの開発者向けドキュメントとも合致します。
ローンチのデモは、企業向けというより個人向けです。アプリをまたいで作るランニングプラン、Instagramの写真からのオリジナルグッズの注文、結婚式の席次表、保険の請求などです。これは、このモデルが向かう先、つまりMetaが「will soon power」と述べているMuseパーソナルエージェント(まず購読者向け)を先取りして見せるものです。
安全性については、Metaは化学、生物、サイバーの悪用に対して最も強力な防御策を備えた「most aligned model to date」だとしつつ、同社のスケーリングフレームワークのもとで防御目的のサイバー作業は許可するとしています。安全性に関する完全なレポートは「available soon」とされているため、この部分はまだ検証できません。
データとアクセス: Contributorモードは初期設定でオン
私が何よりも先に確認する設定がこれです。
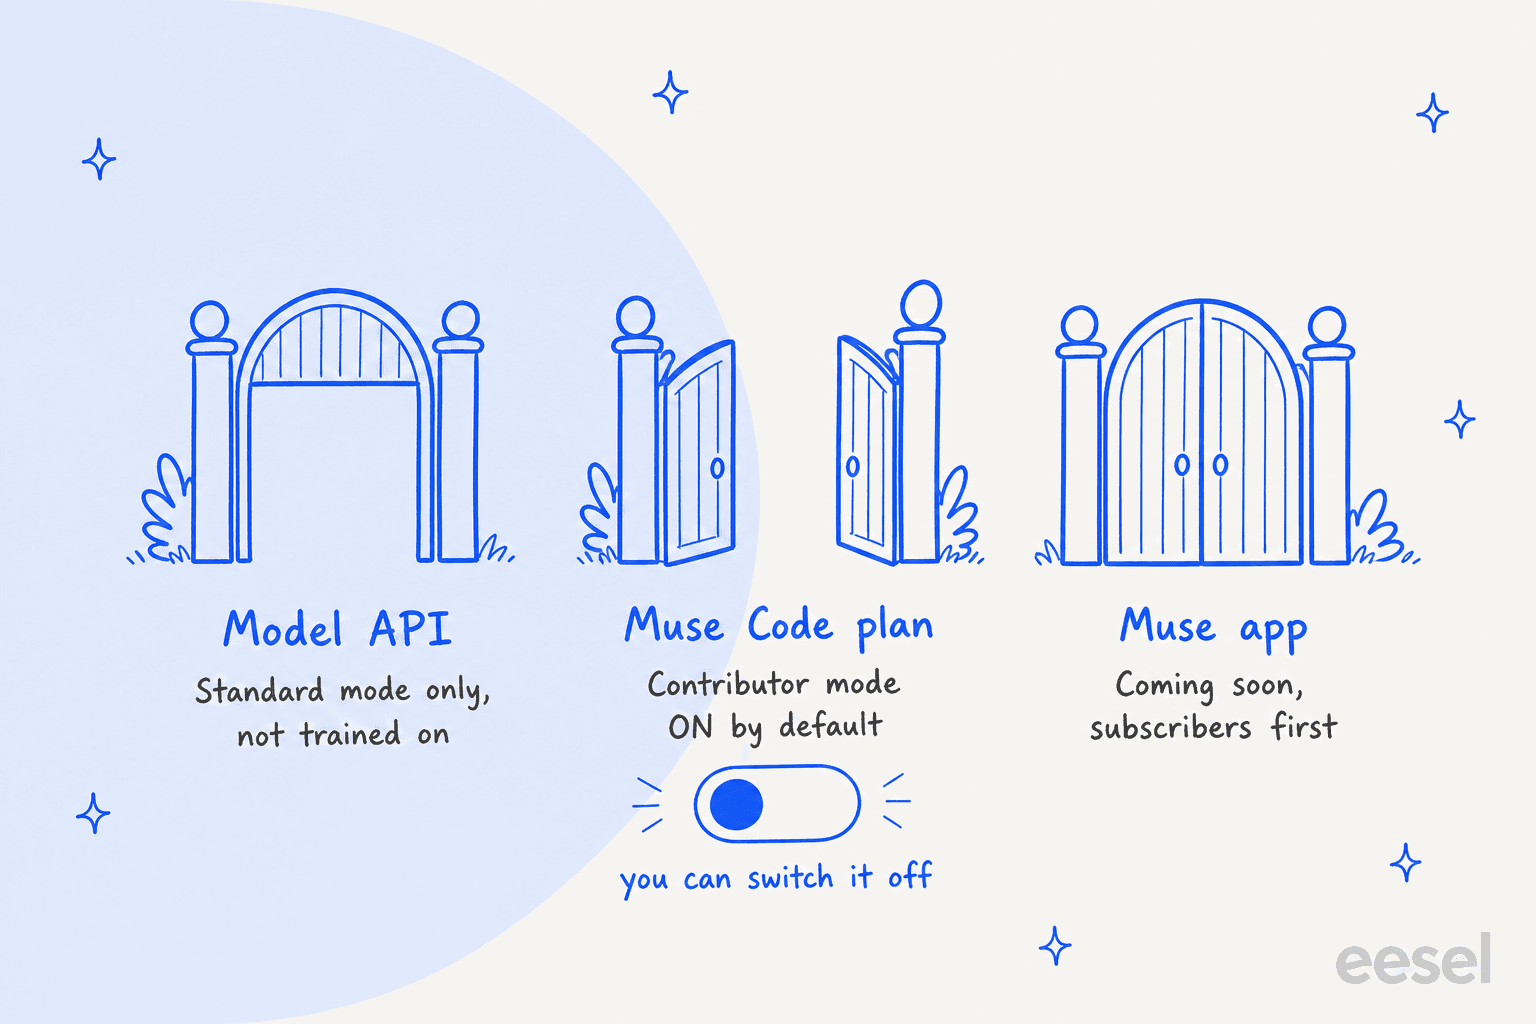
APIでは、Muse WonderはStandardモードのみで動作します。Metaのドキュメントによると、あなたのコンテンツは「is not used to train Meta models」です。Muse Codeの中では逆になります。サブスクリプションのページには「Muse Code subscriptions default to Contributor mode」とあり、「in exchange for letting Meta use your content to train future Meta models」より多くの利用枠が与えられます。ここでのコンテンツとは、プロンプト、コード、ファイル、コンテキスト、そして応答を指します。いつでもオフにでき、その後の新しいコンテンツは学習に使われません。
つまり、Wonder Fullへの最安ルートであるMuse Codeプランは、設定を変えない限りコードで学習が行われるルートでもあります。趣味のプロジェクトなら妥当な取引です。会社のリポジトリなら、初日にオフにしてください。
この質問は、どのベンチマークよりもeeselの営業の場でよく出ます。あるハードウェア企業の技術担当の評価者は、デモの最中に、eeselが答えを知らないときにこっそり別のChatGPTにフォールバックしていないか、そしてそれをオフにできるかを尋ねました。求めていたのは単純なことで、承認済みのナレッジからのみ回答すること、そして自社のナレッジが自社のものであり続けることです。その下でどのフロンティアモデルが動いているかは、このルールに比べればはるかに重要ではありませんでした。
初期ユーザーの声
2日たった時点でのコミュニティの評価は「数字は印象的だが、自分で確かめるべし」です。いくつかの実際の使用報告が目に留まりました。
ビジョン(画像認識)については、ある開発者のテストで通常のWonderは苦戦しました。
"Image->HTML test for Muse Wonder. It's much worse than Opus 5.5. IMO it's closer to Sonnet or Haiku for this test."
彼はその後、OpenRouterにFullがなかったため、それが通常のWonderだったと認めています。これは前のセクションで述べたのと同じ差が、実際に表れた例です。
ハーネスについては、ある有料ユーザーが、モデルが問題になる以前にセットアップでつまずきました。
"I paid them for a month to try out Muse Code, but their sandbox never worked across Mac or Linux (both very stock installs, nothing special)."
また、Museラインアップ全般については、前モデルの常用ユーザーは好意的です。ある人は、Muse Spark 1.3は「very fast and powerful」で、自分の「work horse for open source development」だと書いています。別のコメント投稿者は、サブスクリプションは今のところ北米限定で、APIはOpenRouter経由で利用できると指摘しました。
メリットとデメリット
メリット
- Wonder FullはMetaの14行の表でOpus 5.5と6勝ずつで並び、法務(13.1対4.2)と超長時間のエンジニアリング(57.5対46.3)では明確にリード
- ローンチ時のArtificial Analysis指標で2位(56)、Metaとして大差の最高成績
- 分かりやすいAPI料金表: 長いコンテキストの割増なし、ステアリングトークンは非課金、キャッシュ入力は0.20ドル
- 1Mトークンのコンテキスト、5種類の入力タイプ、初日から毎分3,000リクエスト / 400万トークンという余裕のあるレート制限
- OpenRouterで利用できるため、すでに使っているツールの中で試せる
デメリット
- APIモデル(AAで52)は目玉のスコアを出したモデルではなく、Opus 5.5(58)と同じ価格
- Wonder FullはMuse Codeの月額50ドルまたは200ドルのサブスクリプション限定で、トークン課金のルートがない
- Muse Codeプランは初期設定でContributorモードになっており、オフにするまでコンテンツが学習に使われる
- プレビュー段階であること、安全性レポートがまだ「coming soon」であること、リーダーボードの順位が同じ日に変動したこと
- 通常のWonderは、コンピューター操作、ターミナルでのコーディング、ゼロからのプログラミングでOpus 5.5に劣る
Meta Muse Wonderは誰に向いている?
Wonder Fullを選ぶ人は、長いコーディングプロジェクト、法務の起案、金融リサーチを行う個人開発者や小さなチームで、Muse Codeの月額50ドルが納得できる場合です。先にContributorモードをオフにしてください。これはMetaのコーディングエージェントを試す、これまでで最も強い理由です。同じ予算ならMuse Codeの代替ツールも見ておく価値があります。
API版の通常のMuse Wonderを選ぶ人は、記憶力の高い長時間のエージェント実行が必要で、Anthropicに並ぶ2社目のフロンティアベンダーが欲しい場合です。価格が同一なので、本番のトラフィックを移す前に、自分のタスクでOpus 5.5とA/Bテストすることをおすすめします。
今は見送る人は、主にコンピューター操作やゼロからのコード生成が必要な場合(Opus 5.5がまだ優位)、または大量処理で価格に敏感なワークロードの場合(Meta自身のドキュメントがMuse Sparkを案内しています)です。幅広く比較しているなら、おすすめのAIコーディングアシスタントの比較記事とClaude Codeの料金のガイドで、ほかの選択肢を確認できます。
そしてサポートリーダーの方へ。モデルのリリースは、始める場所として適切ではありません。WonderはAIエージェントを動かせますが、それをヘルプデスクに接続し、ナレッジの範囲内にとどめ、引き継ぐタイミングを決め、お客様に触れる前に正しいと証明する作業は、誰かがやらなければなりません。それがモデルとチームメイトの違いであり、サポートチケットに最適なモデル選びが最初の一歩にすぎない理由です。ZendeskでMuseを使うためのメモを読むと、そのつなぎ込みにどれだけの手間がかかるかが分かります。
モデルをつなぎ込むより、eeselを採用する
Muse Wonderはインフラで、eeselは従業員です。eeselは、特定の仕事に対してすぐに働けるチームメイトを採用するAIチームメイトのプラットフォームで、現在は2つの役割があります。AIヘルプデスクチームメイトとAIブログライターです。
サポートチーム向けのヘルプデスクチームメイトは、Zendesk、Freshdesk、Gorgiasに接続し、過去のチケット、ヘルプセンター、ドキュメントから学習し、承認した内容からのみ回答します。誰かに返信する前に、過去のチケットを使ってシミュレーションし、実際にどう答えていたかを正確に確認できます。私は、自信ありげなボットが本番のキューで誤った答えを返すのを見たことがあり、だからこそこのテスト実行があります。プランは月額固定料金で、1チケットが1クレジット、月額299ドルで500クレジットから、無料で試せる100クレジット付きです(eeselの料金ページによる)。

AIにキューを任せたいからMuse Wonderについて読んでいたのなら、モデル選びはスキップしてください。eeselを無料で試して、あなた自身のチケットで返信案を作る様子を確かめましょう。