要点
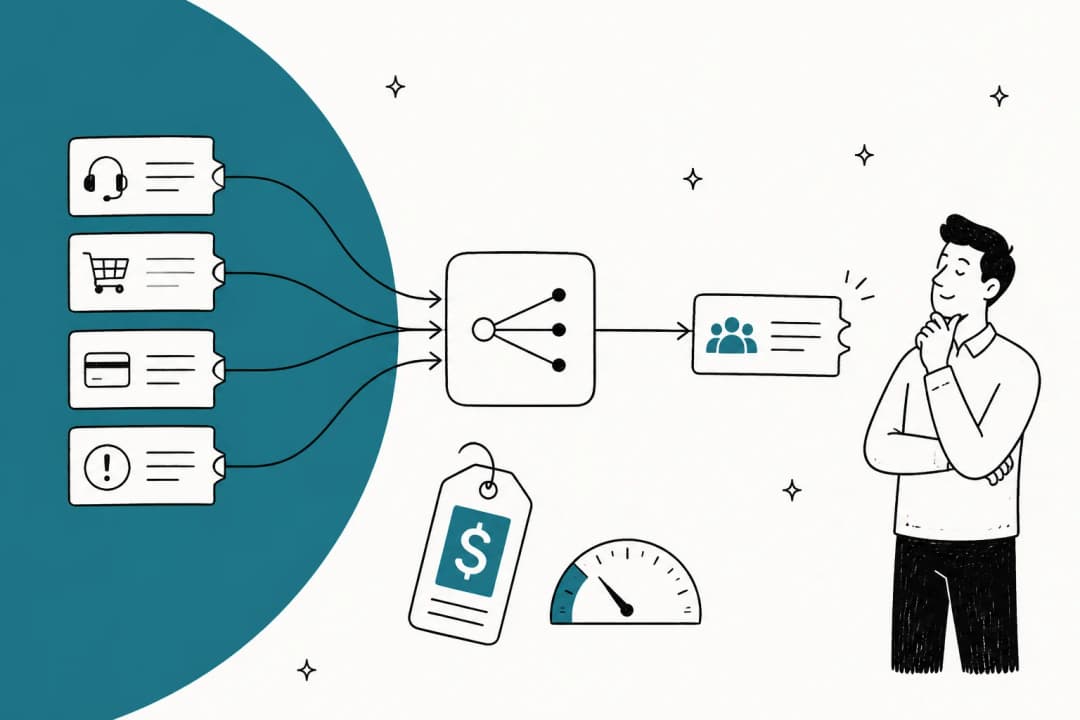
OpenAI Decisions APIは、コンテキスト(テキストまたは画像)と、あなたが書いた「選択肢が固定された質問」を受け取り、質問ごとに答えを1つ返します。文章を書くのではなく、選ぶことに特化したGPT-6 Lunaです。OpenAIは2026年9月29日のDevDayで、コンテンツの分類、リクエストの振り分け、エージェントの次の行動の選択といった用途として発表しました。
まだ公開されていません。10月2日の時点で、私の通常のAPIキーではPOST /v1/decisionsから「not enabled」の403エラーが返り、ドキュメントも価格もありません。同じ振り分け機能は、今日でもLunaと厳密なJSONスキーマで作れます。私のテスト160回の呼び出しすべてで正しいキューを選び、チケット1,000件あたり約$0.047でした。及ばなかったのは速度で、中央値は1.46秒、OpenAIの「数百ミリ秒未満」という主張には届きませんでした。
サポートチームにとってこのテストから得られる大きな教訓は、キューを選ぶのは簡単な判断だということです。難しいのは「自動返信しても安全か?」で、Lunaは40件中33件でした。eeselのAIヘルプデスクチームメイトは、まさにこの部分を中心に作られています。確信のあるチケットだけに対応し、残りは人に引き継ぎます。
OpenAI Decisions APIとは?
Decisions APIは、事前に定義した選択肢の中から選ぶという、ひとつの狭い仕事のためのOpenAIの新しいエンドポイントです。OpenAIのDevDay 2026まとめでは、次のように説明されています。
"Decisions API enables real-time decision-making by focusing Luna's intelligence on a specific set of user-defined questions with finite pre-defined answers. Developers supply context using text or images, and get back answers they can use to classify content, route requests, or choose an agent's next action."
私は仕事でAIエージェントを作っていますが、その中のモデル呼び出しの大半は、何も書き出しません。このチケットはどのチームの担当か、人間が必要か、といった小さな分かれ道です。汎用モデルでも問題なく答えられますが、まずテキストを生成するという遠回りをします。Decisions APIは、この種の呼び出しには専用のレーンが必要だというOpenAIの賭けです。
これは、常時稼働のOpenAI Dotsエージェント、GPT-6.1 Solモデル、Codex Security Cloudといった大きなDevDayの発表と並ぶものです。
ステージでの扱いはそれらより小さく、基調講演のパートは1分未満で、基調講演の22:15付近から始まります。同じ週にはChatGPT Spaceも登場しました。それでも、サポートキューを運用しているなら、日々の業務に最も近い発表はこれです。
Decisions APIの仕組みは?
3つを送り、1つが返ってきます。OpenAIがこれまでに説明した範囲では、流れは次のようになります。
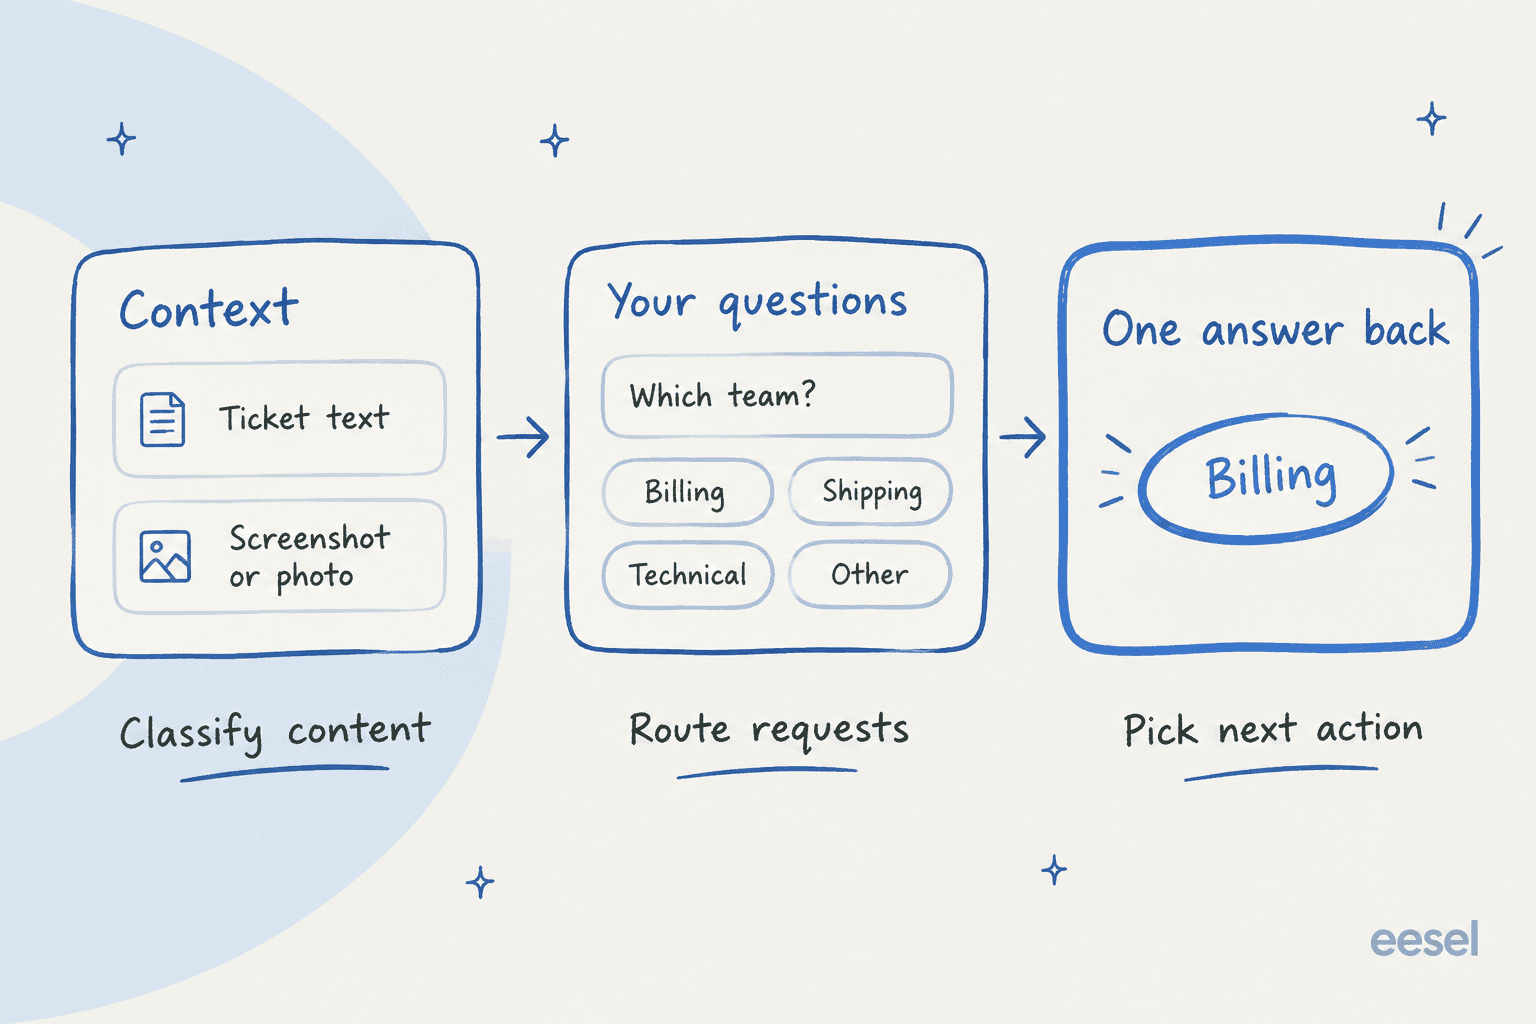
- **コンテキスト。**テキストまたは画像です。チケット本文、チャットの記録、顧客が添付した商品写真などです。
- **選択肢が固定された質問。**各質問と、その質問が返してよい答えの全リストを自分で定義します。
- **返ってくる選択。**リストの中から答えが1つ返り、あとはあなたのコードがそれに基づいて動きます。
サポートの例は、実はOpenAIの開発者アカウント自身が出したもので、@OpenAIDevsのスレッドにあります。
"Send text or images as context. For example, supply a support request and the teams it could go to. The API returns a selection your app can use."
内部ではGPT-6 Luna上で動きます。OpenAIはLunaのモデルページで、Lunaを「most efficient model for focused, high-volume tasks」と呼んでいます。基調講演での速度の説明は、選択肢があらかじめ決まっているからこそ、Lunaが1秒未満で答えられる、というものです。1語ずつ書き出す必要がないので、待つ時間が減ります。
これを使って作るつもりなら、OpenAIがまだ説明していない部分も同じくらい重要です。
- リクエストとレスポンスのスキーマ。APIリファレンスのページがまだありません。
- 1回の呼び出しで複数の質問を扱えるか、各質問にいくつ答えを設定できるか。
- レスポンスに確信度スコアが含まれるか。報道では含まれるとされていますが、OpenAIのページや投稿で言及しているものは見つかりませんでした。
- 課金単位とレート制限、そしてBatchやFlexが使えるか。
あるHacker Newsの読者が、DevDayのスレッドでこの仕組みを推測していました。"I think they simply use the LLMs softmax scores (uncalibrated confidence)"。もっともらしい見方ですが、誰も確認していません。
Decisions APIはもう使える?
OpenAIに選ばれた場合のみです。まとめには「available in limited preview today with a broad release planned in the coming days」とあり、OpenAI Developersのスレッドには「preview access is limited to selected API customers for testing」とあります。
実際にどうなるか確認しました。POST https://api.openai.com/v1/decisionsは実在するルートで、通常のキーでは次の応答が返ります。
{"error":{"message":"Decision API is not enabled for this user.","type":"invalid_request_error","param":null,"code":null}}
これはHTTP 403で、ルートがないのではなく機能がゲートされていることを意味します。近くの/v1/decisions/createや/v1/beta/decisionsは404を返します。空のボディでもゲートが作動するので、エラーからリクエスト形式が漏れることもありません。同じ403を10月1日に確認し、「数日以内」という約束から3日後の10月2日にも確認しました。
資料もわずかです。10月2日時点では次のとおりです。
| 確認した項目 | 結果 |
|---|---|
ドキュメントガイド(/api/docs/guides/decisions) | 404 |
APIリファレンス(/api/reference/decisions) | 404 |
| APIチェンジログの9月29日の項目 | Decisions APIの項目なし |
| API料金ページ | Decisions APIの行なし |
| 単独の発表記事 | なし(DevDayのまとめのみ) |
GET /v1/models | "decision"を含むモデルIDなし |
つまり現時点でのDecisions APIは、約束とゲートされたエンドポイントです。プレビューとしてはごく普通ですが、負荷テストも料金の試算もできず、制限も読めないということです。
Decisions APIは構造化出力に何を加える?
ローンチから数時間で、あるHNのコメント投稿者が当然の疑問を投げかけました。
"It seems a bit silly since OpenAI LLMs already can output structured data."

もっともな指摘です。Lunaに固定リストから答えさせることは、今日でもできます。Responses APIを使い、reasoningをnoneに設定し、答えのenumだけをフィールドに持つ厳密なJSONスキーマを渡します。Decisions APIがゲートされたままの間に、私が実行したリクエストは次のとおりです。
{"model":"gpt-6-luna","reasoning":{"effort":"none"},
 "input":[{"role":"developer","content":"Route the support ticket. Which queue?"},
          {"role":"user","content":"I was charged twice for my order #4471"}],
 "text":{"format":{"type":"json_schema","name":"route","strict":true,
   "schema":{"type":"object","properties":{"queue":{"type":"string","enum":["billing","shipping","technical","other"]}},
   "required":["queue"],"additionalProperties":false}}}}
3回とも{"queue":"billing"}が返り、入力60トークン、出力12トークンでした。LunaのStandard料金では1回あたり$0.000012です。OpenAIのfunction callingを使ったことがある人には馴染みのある考え方で、ただ縛りがより厳しいだけです。今日のSaaS向けAIチケット振り分けの大半も、この構成です。
ただし落とし穴があります。OpenAIとJevに関する以前のHNスレッドで、あるコメント投稿者が指摘しました。
"It's not guaranteed to be correct: it's guaranteed to be formatted in a particular way. You can get the same thing with grammars on any LLM."
つまり、形式の問題はすでに解決済みです。Decisions APIがその上で約束するのは、速度と、「Lunaの知能を集中させる」ことが意味する精度のチューニングです。現時点で公開されている情報で比べると、次のようになります。
| Decisions API | Luna + 構造化出力 | |
|---|---|---|
| ステータス | 限定プレビュー、選ばれた顧客のみ | 今すぐ利用可能 |
| 入力 | テキストまたは画像 | テキストと画像 |
| 出力 | あなたの答えからの「選択」 | スキーマに合致するJSON |
| 速度 | 「Less than a few hundreds of milliseconds end to end」(OpenAIスタッフの主張) | 私のテストで中央値1.46秒 |
| 価格 | 未公開 | 入力100万あたり$0.10 / 出力100万あたり$0.50 |
| 確信度スコア | 未確認 | デフォルトではなし |
| ドキュメント | まだなし | 構造化出力ガイド |
Decisions APIはどれくらい速い?
OpenAIによる速度に関する唯一の文書化された主張はスタッフの発言で、ドキュメントには何もありません。OpenAIのThibault Sottiauxがローンチ当日に投稿しました。
"Decisions API, for lightning fast constrained decision making powered by Luna. Supports visual inputs, and tuned to be able to make decisions in less than a few hundreds of milliseconds end to end."
それが何を上回ることになるのかを見るため、20件のサポートチケットを各設定で2回ずつLunaに通し、キューと優先度、そして自動返信しても安全かどうかを尋ねました。合計160回の呼び出しで、ノートパソコンからエンドツーエンドで計測したため、ネットワークの往復も含まれています。
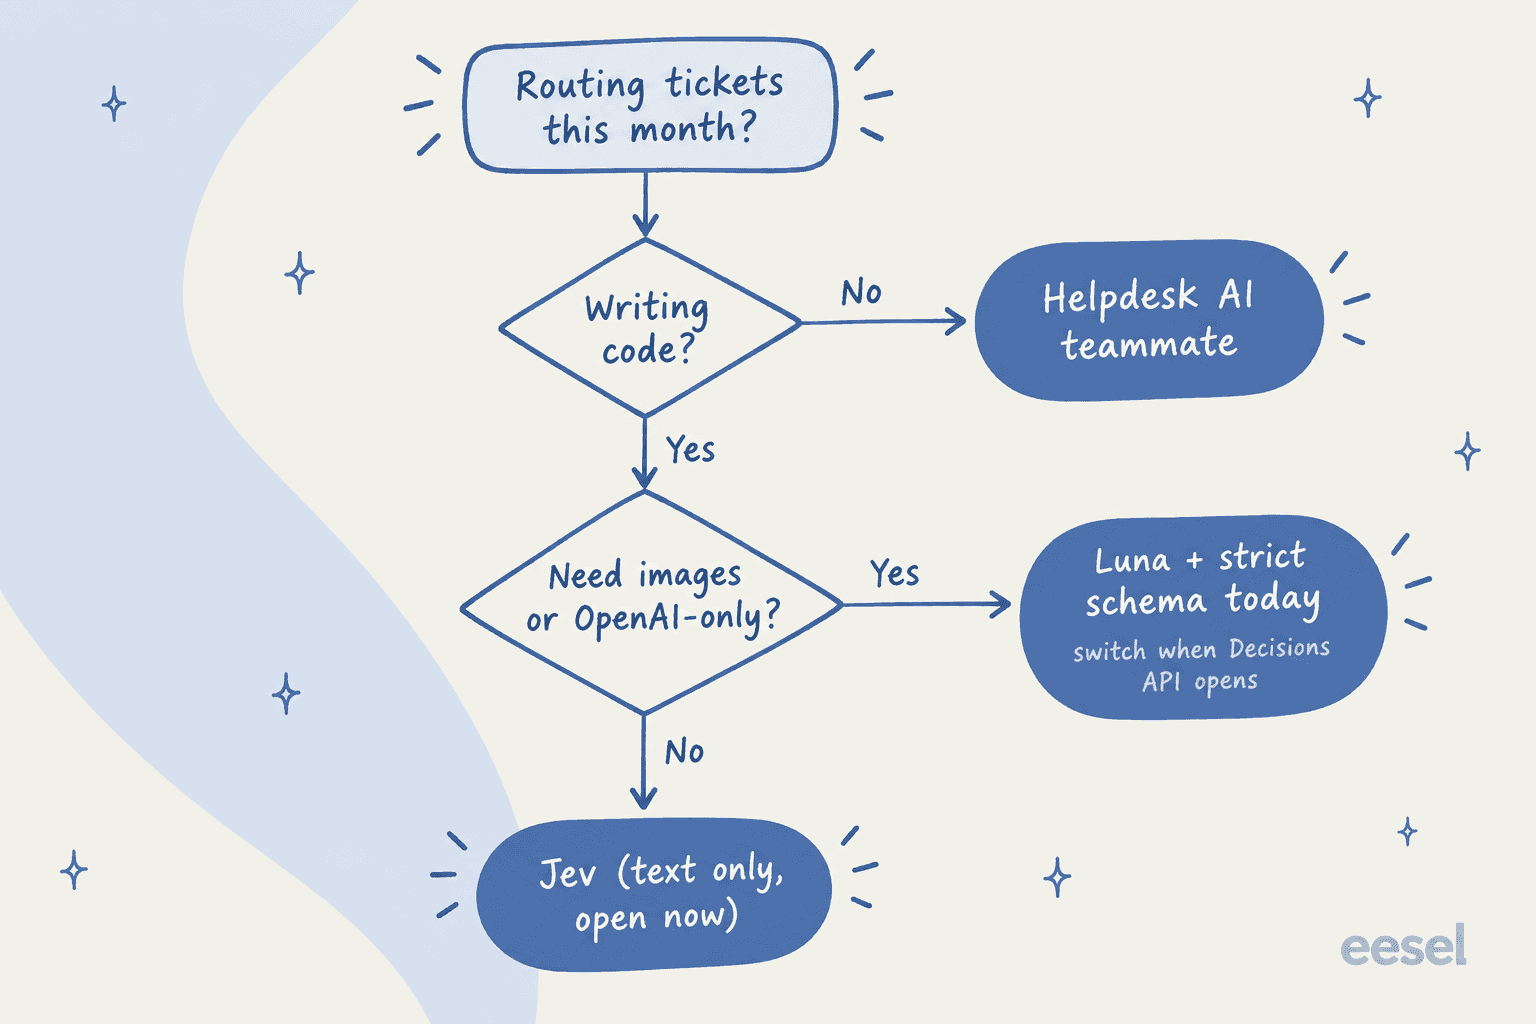
| 設定(私のテスト) | 中央値 | 最速 | 最遅 |
|---|---|---|---|
| GPT-6 Luna、reasoning none | 1.46秒 | 0.95秒 | 2.79秒 |
| GPT-6 Luna、reasoning low | 1.62秒 | 0.95秒 | 3.20秒 |
| GPT-6 Luna、reasoning medium | 2.33秒 | 1.44秒 | 5.75秒 |
| GPT-6.1 Sol、reasoning low | 2.17秒 | 1.52秒 | 4.98秒 |
OpenAIの主張が本当なら、Decisions APIは私の最良のLuna設定のおよそ5倍速いことになります。この差が重要な場面と、そうでない場面は次のとおりです。
- **メールやチケットのトリアージ。**あまり重要ではありません。チケットのタグ付けが300msだろうと1.5秒だろうと、誰も気づきません。
- **ライブチャット。**重要です。ボットが誰が答えるべきかを決める前に1.5秒の間が空くと、会話全体では積み重なります。
- **エージェント。**最も重要になる場面です。OpenAI AgentKitのようなもので作られ、1タスクで20回の小さな選択を行うエージェントは、Lunaだと30秒待つことになり、主張どおりの速度なら数秒で済みます。
一部の報道では「150ms対1.6秒」というチャートが出ています。この数字はOpenAIのどのページにも投稿にも見つからなかったので、ドキュメントが公開されるまで当てにしないほうがよいでしょう。
TypeSafe Jevとの比較は?
この発表を語るうえで、TypeSafe Jevの話は避けられません。TypeSafeは9月15日に、型付きの判断だけのために作ったモデルとしてJevを公開し、その2週間後にDecisions APIが登場しました。あるHNのコメント投稿者はDevDayのスレッドで率直にこう言っています。「Decisions API is a validation for Jev and the entire space it created.」
各社が公開している内容に基づくと、次のように並びます。
| OpenAI Decisions API | TypeSafe Jev | |
|---|---|---|
| アクセス | 限定プレビュー | 9月27日から誰でも利用可能 |
| 入力 | テキストまたは画像 | Jevのモデルページによるとテキストのみ |
| 質問の種類 | 答えが固定された質問 | Choice、Score、Noul(真偽の確率) |
| 出力 | 選択 | 選択に加えて確率と確信度 |
| 価格 | 未公開 | 入力100万トークンあたり$0.042、出力は無料 |
| 速度 | 「Less than a few hundreds of milliseconds」 | ローンチ記事によるとエンドツーエンドで「70ms-500ms」 |
| 質問あたりの選択肢数 | 未公開 | Choiceで最大255 |
| レート制限 | 未公開 | 10万トークン/秒または40リクエスト/秒 |
多くのチームにとっては、2つの行に絞られます。Jevは画像を受け付けないので、キューがスクリーンショットや破損写真だらけならOpenAIに軸足が向きます。一方でJevは各答えに確率を返し、それこそ「いつ動かないか」を決めるために必要なものです。
私のJevレビューでは、テストでの実力を紹介しています。料金の計算はJevの料金の解説にあり、より高速なJev Ultrafastティアも含まれます。
価格については、Lunaとの早期の比較はすでにJevに傾いています。
"They say it's built on Luna, which costs $0.10M/in, vs Jev which only costs $0.04M/in, which is interesting ..."
これはLunaの定価であってDecisions APIの価格ではない点に注意してください。OpenAIはエンドポイントが公開されたとき、かなり違う価格を付ける可能性があります。
サポートでDecisions APIは何に使える?
OpenAIは3つの用途を挙げていて、それぞれにサポート版の使い方があります。
- **コンテンツを分類する。**意図、製品、感情でチケットをタグ付けし、スパムを見つけ、返金依頼と返品を見分けます。
- **リクエストを振り分ける。**チケットを請求、配送、技術、あるいは言語やティアごとのキューに送ります。これは古典的なインテリジェントルーティングで、OpenAIが自らの例に使った仕事です。同じパターンがECの振り分けにも使えます。
- **エージェントの次の行動を選ぶ。**注文を調べるか、確認の質問をするか、返信するか、人にエスカレーションするかを、通常は意図検出に基づいて決めます。
最初の2つは、多くのチームがチケットトリアージと呼ぶものを指し、型付きの判断はそこですでにうまく機能しています。多くのヘルプデスクには、Freshdeskの自動トリアージから多数のZendesk分類アプリまで、ネイティブ版も用意されています。ZendeskとShopifyで月約1,000件のチケットを扱うジュエリーECストアでの実トラフィック試験では、eeselの型付き呼び出しはトリアージ精度93%、スパムを100%検出し、誤検知はゼロでした。そのインボックスの22%がスパムでした。
私自身のテストは、問題が始まる場所を示しました。どの設定も、キューの選択は40件中40件で正解でした。しかし「自動返信しても安全か?」では、reasoningなしのLunaは40件中33件、GPT-6.1 Solでさえ40件中39件でした。振り分けは簡単な判断で、動かないべきときを知るのが難しい判断です。キューを間違えても数分のロスで済みますが、自動返信を間違えると顧客にそのまま届きます。
買い手も同じところに線を引いています。Gorgiasで月約7,000件のチケットを扱うサプリメントブランドのCXリーダーは、営業通話でeeselに対し、AIの返信をすべて手作業で確認することはできないので、確信のないものには手を出さないAIでなければならない、と話しました。
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
decisionsエンドポイントは答えを返してくれます。ただし較正された確信度も返さない限り、チケットをいつそのままにすべきかは教えてくれないので、そのルールは依然としてあなたが作るものです。分類器にアクションを任せる前に、AIタグ付けの誤検知について読んでおく価値があります。
Decisions APIの料金はどうなる?
OpenAIの外にいる人は、まだ誰も知りません。価格の行はなく、トークン単位、呼び出し単位、質問単位のどれで課金するかも明らかにされていません。現時点で唯一公開されている目安は、Luna自身の料金表です。
| GPT-6 Lunaティア | 入力 100万あたり | キャッシュ入力 100万あたり | 出力 100万あたり |
|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.50 |
| Batch / Flex | $0.05 | $0.005 | $0.25 |
| Fast | $0.20 | $0.02 | $1.00 |
この料金だと、私の160回のテストはreasoningなしでチケット1,000件あたり$0.047、mediumで$0.089でした。月1万チケットでも1ドルを十分に下回ります。詳しい計算と隠れたコスト、Jevとの価格競争は、私のDecisions APIの料金記事にあり、より広いOpenAI APIの料金ガイドに全モデルの料金があります。料金だけで見れば、サポート基盤の中で判断が高くつく部分になることはありません。
今Decisions APIで構築すべき?
プレビューに入っていない限り、まだです。ただし同じ機能は今日でも作れ、あとでエンドポイントを差し替えられます。私ならこう判断します。
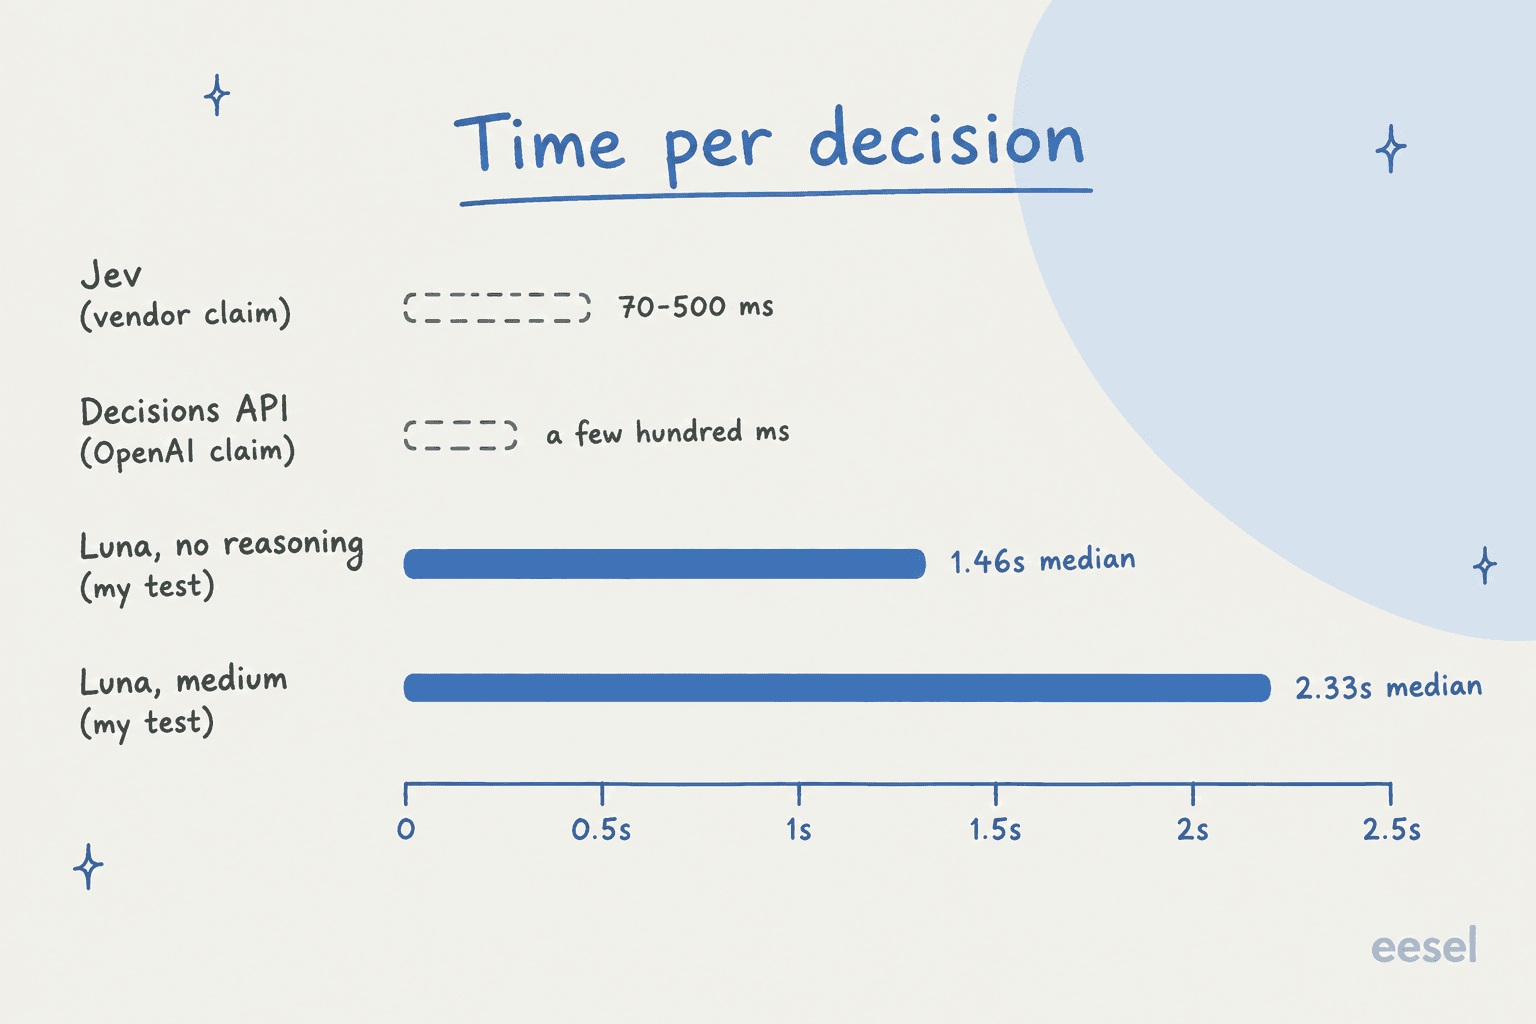
- **コードを書き、OpenAIに留まる場合。**厳密なenumスキーマとreasoningを
noneまたはlowにしたLunaを出荷します。質問と答えのリストを1か所にまとめておけば、/v1/decisionsへの移行は小さな変更で済みます。フォールバックが欲しければ、Lunaの代替の記事で、Gemini 3.5 Flash-Liteなど他の小型モデルを紹介しています。 - **テキストで1秒未満の応答が必要な場合。**今すぐJevを試してください。公開されていて価格も出ており、確率も返します。この分野の他の選択肢はJevの代替の一覧にあります。
- **入力が画像の場合。**OpenAIに留まってください。Lunaは今日画像を受け付けており、APIチェンジログによると、OpenAIは9月25日に「degraded image understanding」を引き起こしていた画像エンコードのバグを修正したため、古い画像評価は再実行してください。
- **APIではなく、ZendeskやFreshdesk内で振り分けたい場合。**それならエンドポイントの問題は完全に飛ばせます。まずはチケットトリアージを自動化する方法のガイドか、チケットトリアージに最適なAIのまとめから始めてください。ZendeskのチームはZendesk Intelligent Triageとも比較できます。
タイミングについては、懐疑派にも一理あります。
"It's another Jev copy, like we've seen so many over the last few weeks. But with no benchmarks or price comparison, which likely means it doesn't compare that well."
私はそこまで厳しくは見ません。価格のないゲート付きプレビューは普通のことで、画像入力は本当の違いです。それでも「ドキュメントなし、価格なし、ベンチマークなし」は、今週ロードマップをこれに載せない十分な理由です。
eeselで確信を持ったチケット振り分けを
Decisions APIはインフラです。リストから答えを選びますが、その答えの周り、つまりヘルプデスクとの接続、タグ、「人に送る」ルール、動作のログは、自分で作る必要があります。eeselは、すでにその仕事をこなしているチームメイトです。eeselのAIヘルプデスクチームメイトはZendeskまたはFreshdeskのキューに参加し、ヘルプセンターと過去のチケットから学び、普通の言葉で書いたエスカレーションルールに従って、振り分け、タグ付け、返信を行います。

私のテストによれば、最も重要なのは「自動返信しても安全か」の判断で、eeselはそこに力を注いでいます。eeselはライブのキューに触れる前に、過去のチケットを数百件再生し、回答をあなたのチームが実際に送った内容と照らして採点するので、リスクのある判断は顧客に届く前に表に出ます。確信のないチケットは人に回されます。
コードから構築したくてここに来たのなら、eesel CLIは同じチームメイトとワークスペースをターミナルから動かします。eesel instructionsで振り分けルールを編集し、eesel activityで触れたすべてのチケットを一覧し、eesel approvalsでアクションの実行前に人が承認できます。すべてのコマンドはJSONを出力して--dry-runに対応しているため、スクリプトやClaude Code、Cursorのようなコーディングエージェントから操作でき、各ワークスペースはMCPサーバーとしても機能します。
料金はトークン単位ではなくチケット単位です。チケットまたはチャット1件が1クレジットで、プランは500クレジットで$299から、無料枠はカード不要で100クレジットです。キューの一部でeeselを試して、どのチケットを任せられるだけの確信を持てるか確かめてください。
よくある質問
OpenAI Decisions APIとは何ですか?
OpenAI Decisions APIはもう使えますか?
OpenAI Decisions APIの料金はいくらですか?
Decisions APIと構造化出力はどう違いますか?
OpenAI Decisions APIはTypeSafe Jevのコピーですか?
OpenAI Decisions APIでサポートチケットを振り分けられますか?
Decisions APIは確信度スコアを返しますか?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.