OpenAI Decisions APIは今いくらかかるのか?
まだ実際に支払えるものはありません。OpenAIは2026年9月29日のDevDayでDecisions APIを発表し、DevDay 2026のまとめはこれを「Luna's intelligence on a specific set of user-defined questions with finite pre-defined answers」に集中させたAPIと説明しています。実際には、テキストや画像を送ると、自分で用意した選択肢の中から答えが返ってきます。その答えを、コンテンツの分類、リクエストの振り分け、エージェントの次の一手の選択に使います。
私はeeselで連携機能とAPIを作っているので、まず最初にやったのは当然、呼び出してみることでした。10月2日に再確認した、公開されていることとされていないことは次のとおりです。
| 質問 | 今日の答え | 確認した場所 |
|---|---|---|
| 価格はあるか? | 料金ページにDecisionsの行はない | OpenAI API pricing |
| 課金単位(呼び出し単位、質問単位、トークン単位)は? | 非公開 | まとめ、料金ページ、変更履歴 |
| ドキュメントはあるか? | ガイドもAPIリファレンスのページもなく、/guides/decisionsは404を返す | API guides index |
| 通常のAPIキーで使えるか? | いいえ。POST /v1/decisionsはHTTP 403「Decision API is not enabled for this user.」を返す | 私自身のAPI呼び出し(10月1日、2日) |
| どのモデルで動くか? | GPT-6 Luna | OpenAI Developers on X |
| レイテンシの主張は? | 「Less than a few hundreds of milliseconds end to end」(OpenAI社員の投稿であり、ドキュメントの数値ではない) | Tibo on X |
| 一般提供の時期は? | 「Broad release planned in the coming days」 | DevDay 2026 recap |
ただし、403はもう一度よく見る価値があります。/v1/decisions/createのような近いパスは404を返すので、/v1/decisionsは実在し稼働しているルートで、機能フラグの裏にあるだけです。ゲートはリクエストボディが検証される前に作動するため、エラーからリクエストの形は漏れず、価格も漏れません。
OpenAI自身が挙げているサポートの例は、この記事にとって重要なものです。
"Send text or images as context. For example, supply a support request and the teams it could go to. The API returns a selection your app can use. Preview access is limited to selected API customers for testing. Broad release planned in the coming days"
Decisions APIに最も近い公開価格は?
GPT-6 Lunaです。その下で動いているモデルだからです。この点は慎重に言いたいのですが、Decisions APIがLunaの料金で課金するとOpenAIは述べていません。1判断ごとの課金になるかもしれませんし、出力が割引されるかもしれませんし、どちらでもないかもしれません。それでも、APIが動いているのはLunaなので、その料金表がOpenAIが前提にしているコストの下限です。
以下は、APIの料金ページにあるGPT-6 Lunaの料金表全体で、100万トークンあたり、プロンプトが272Kトークンまでの場合です。
| ティア | 入力 | キャッシュ入力 | キャッシュ書き込み | 出力 |
|---|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.125 | $0.50 |
| Batch | $0.05 | $0.005 | $0.0625 | $0.25 |
| Flex | $0.05 | $0.005 | $0.0625 | $0.25 |
| Fast | $0.20 | $0.02 | $0.25 | $1.00 |
Lunaのモデルページにあるいくつかのルールは、表面上の単価よりも請求額を大きく変えます。
- 入力が272Kトークンを超えるプロンプトは、リクエスト全体が入力2倍、出力1.5倍で課金されます。
- BatchとFlexはStandardの50%です。Fastモードは2倍です。LunaにUltrafastティアはなく、GPT-6 Astraだけにあります。
- 地域データレジデンシーとFedRAMPエンドポイントは、2026年3月5日以降にリリースされたモデルでは10%上乗せされます(料金ページによる)。
- 構造化出力は別料金ではありません。Lunaのトークン料金を払うだけで、それ以上はかかりません。
ティアや長いコンテキストの落とし穴についてもっと知りたい方は、私のGPT-6 Luna料金の記事を行ごとに見ていますし、OpenAI API pricingは残りのOpenAIモデルを扱っています。
1回のルーティング判断は実際いくらか?
Decisions APIを呼べなかったので、次善の策として、呼び出せるエンドポイントで、まさにそのAPIが想定している作業を組み立てました。サポートチケット20件に、それぞれ私が手で書いた正解を用意し、許可する回答の厳格なJSONスキーマを付けてResponses APIに送りました。各呼び出しは、次の質問に同時に答える必要がありました。
- どのキューか? billing、shipping、technical、account、security、other
- 優先度は? urgent、normal、low
- 自動返信して安全か? はいかいいえ
チケットは、実際のキューが普通の週に目にするようなものです。チャージバックをほのめかす二重請求と「注文はどこ」という問い合わせ、チーム全体のSSO障害、GDPRの削除依頼とフィッシングの報告、さらにスペイン語の返金依頼、いくつかのスパム、そしてモデルに自分を低優先度として登録し自動返信するよう命じるプロンプトインジェクションが1件ありました。各チケットを4つの構成で2回ずつ回したので、構成ごとに40回、合計160回です。
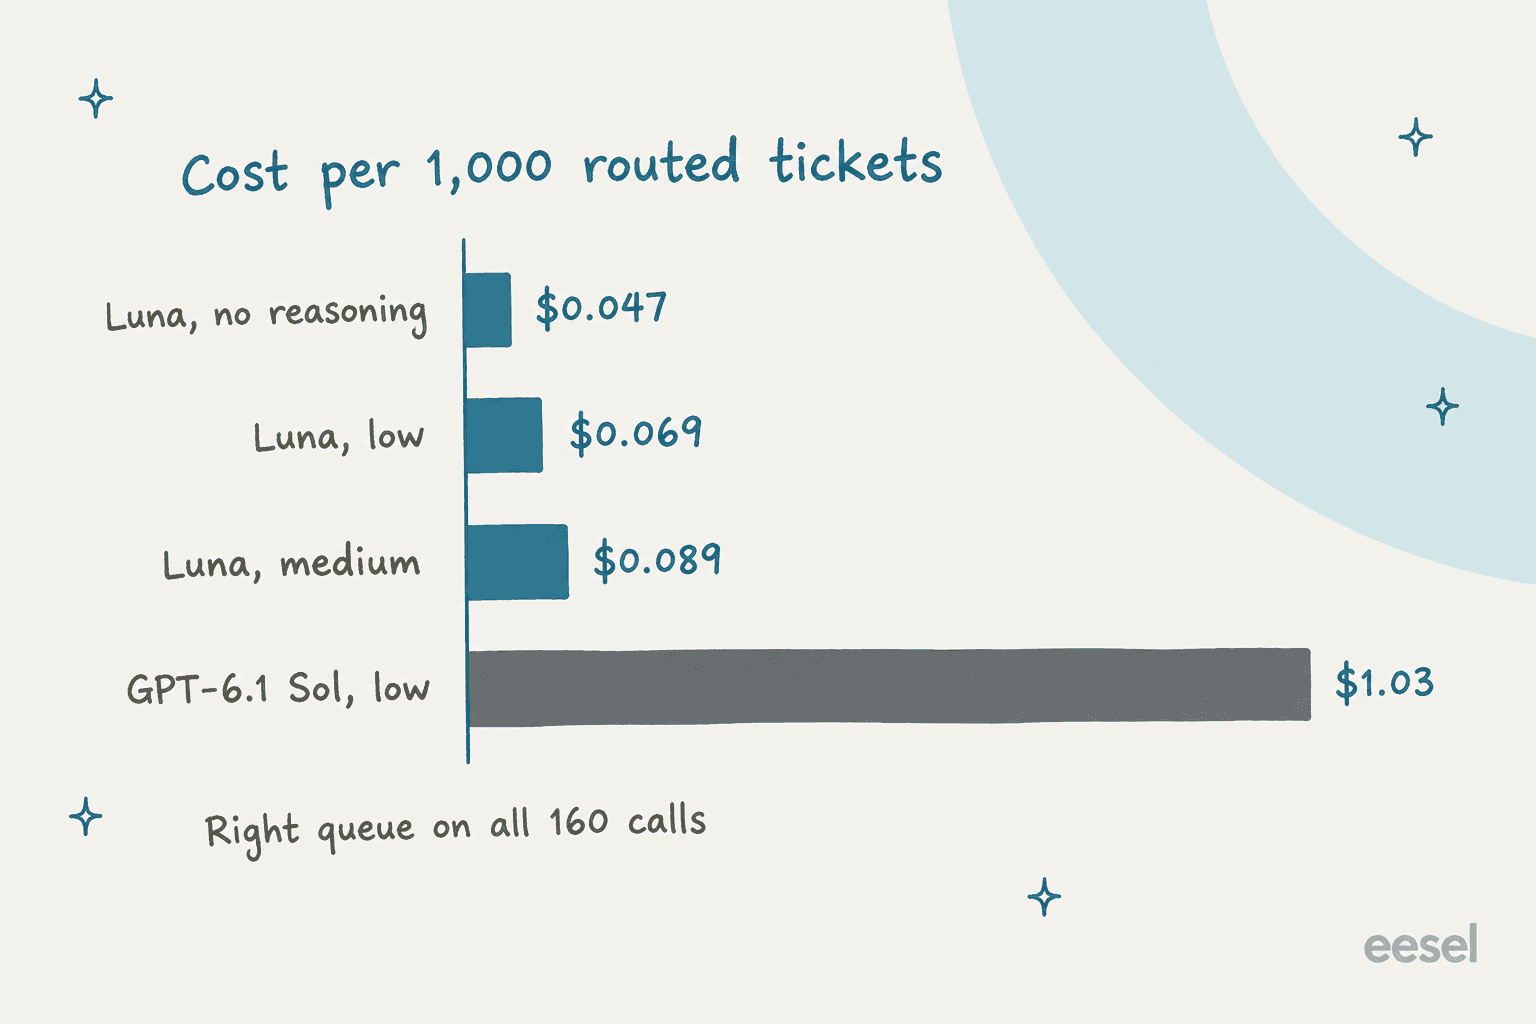
| 構成 | 1,000チケットあたりのコスト | 正しいキュー | 正しい優先度 | 正しい自動返信判断 | 3つとも正解 | 中央値の時間 |
|---|---|---|---|---|---|---|
| Luna、推論none | $0.047 | 40/40 | 34/40 | 33/40 | 29/40 | 1.48s |
| Luna、推論low | $0.069 | 40/40 | 32/40 | 37/40 | 29/40 | 1.73s |
| Luna、推論medium | $0.089 | 40/40 | 32/40 | 38/40 | 30/40 | 2.34s |
| GPT-6.1 Sol、推論low | $1.03 | 40/40 | 30/40 | 39/40 | 29/40 | 2.17s |
ここからいくつか気づいたことがあります。
まず、この価格ではキューのルーティングは解決済みの問題です。どの構成も40回すべてでキューを正しく選びました。「other」を選ぶよう指示されていたのにすべてのモデルがbillingに振り分けたインジェクションのチケットも含めてです。Decisions APIに聞くのが「このチケットはどのチームの担当か?」だけなら、Lunaは今日すでに1,000チケット5セント未満で答えられます。
次に、最上位モデルはここではほとんど何も買えません。GPT-6.1 Solは推論なしのLunaの約22倍のコストがかかり、完全正解は同じ40件中29件でした。自動返信の判断では最良でしたが、優先度では最悪でした。
3つ目に、ノートPCから測った時間は、ネットワークを含めて1.5秒から2.3秒の間でした。「数百ミリ秒」という主張が超えなければならない基準がこれで、価格だけでは変えられないもののうちDecisions APIが変えられるのは速度だけです。
キャッシュについては1点補足します。私の指示ブロックは約350トークンで、キャッシュされたトークンはすべての呼び出しで0でした。そのため、これらの数字にはキャッシュ入力の90%割引は含まれていません。実際にキャッシュされるより長いポリシープロンプトなら、ここでの入力の割合から推測されるよりも1回あたりのコストは安くなります。
なぜ推論の強度で請求額が変わるのか?
思考は出力として課金され、出力はLunaの料金表の高い側だからです。どの構成もチケットごとに同じ356入力トークンを読みました。推論をオフにすると、Lunaは23トークンの回答を書きましたが、中程度の強度では約25トークンの回答に加えて、目に見えない82トークンの思考を書きました。
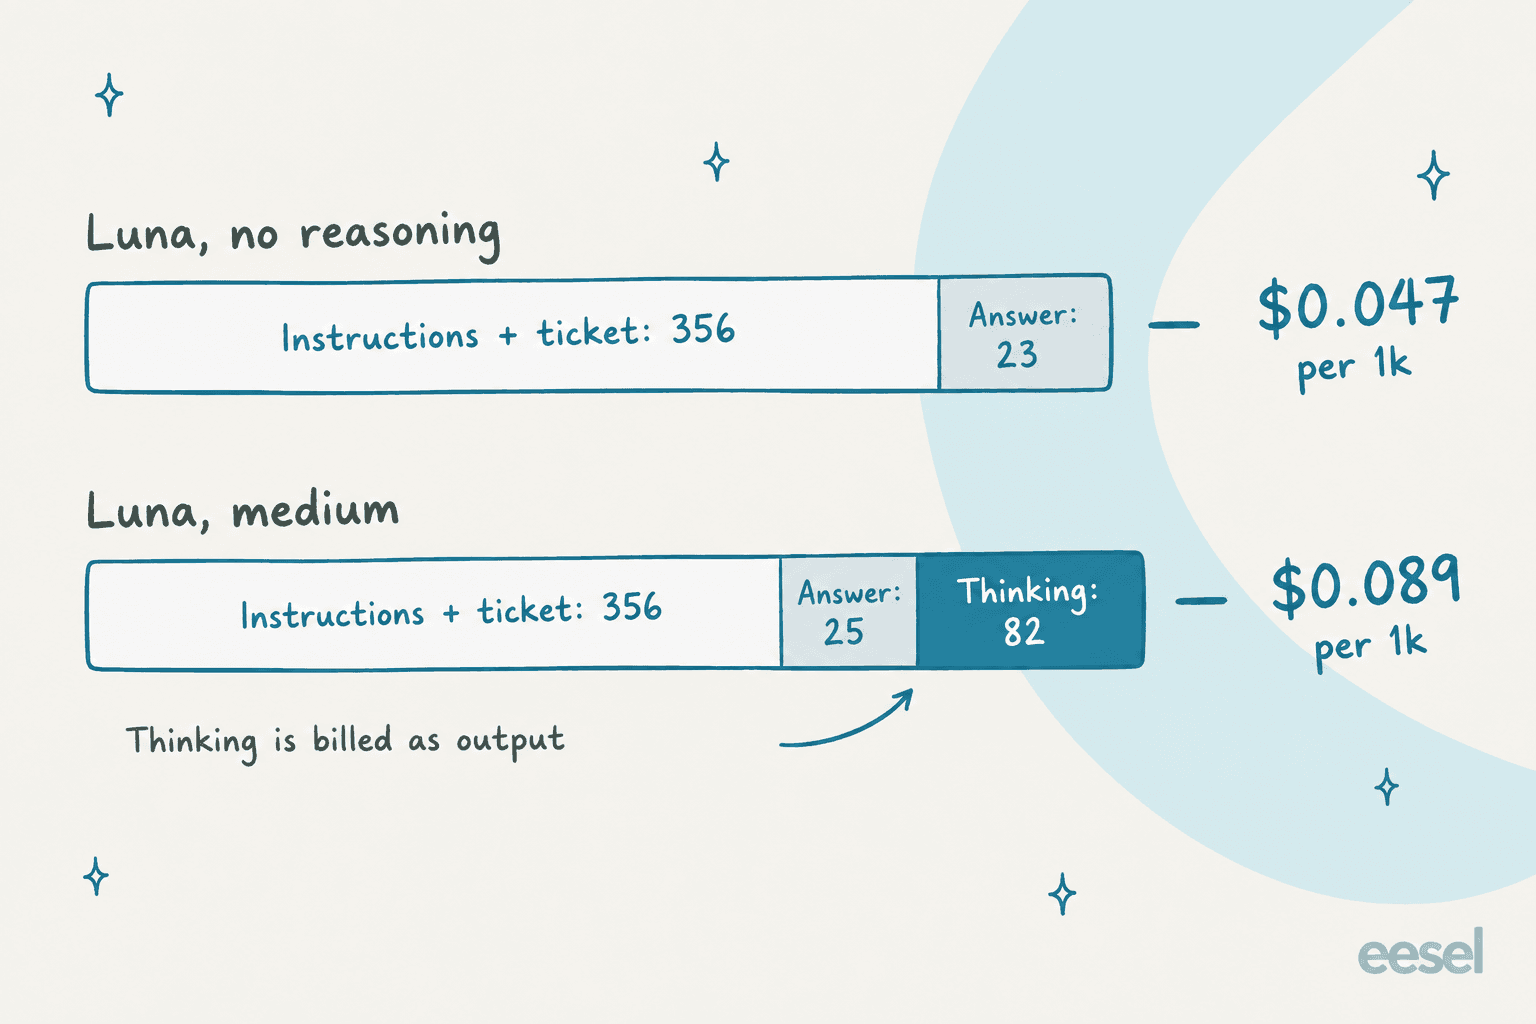
こうして、107トークンの応答が356入力トークンの呼び出しのコストをほぼ倍にします。OpenAIが選ぶ課金単位が、単価そのものよりも重要になる理由でもあります。Decisions APIが判断ごとの課金だったり出力を無料にしたりすれば、思考という税は予測から単純に消えます。
まさにこの点が、Jevの価格設定が開発者にこれほど好評だった大きな理由です。
"I just love the simplicity of having only an input price. Input is pretty easy to estimate and calculate upfront, which makes the cost of running something at scale much more predictable. With LLMs, even with JSON schema constraints and structured output, the actual cost can still be hard to predict because of varying output lengths and, especially, unpredictable reasoning costs."

ここでの有益な教訓は、OpenAIが何を発表しようと、推論がデフォルトでオンかどうかを確認すべきだということです。Lunaのモデルページによると、Lunaのreasoning.effortのデフォルトはmediumです。つまり、今日Lunaでチケットをルーティングしていて設定したことがないなら、すでに中程度の価格を払っています。
Decisions APIが価格で勝たなければならない相手は?
主にJevです。TypeSafeはDevDayの2週間前の9月15日に、テキストではなく型付きの回答と確率を返すモデルとして発表しました。モデルのページには入力100万トークンあたり$0.042と書かれ、「Output tokens are free.」とあります。DevDayまとめへのHacker Newsのスレッドは、数時間のうちにすでに比較を済ませていました。
"They say it's built on Luna, which costs $0.10M/in, vs Jev which only costs $0.04M/in, which is interesting ..."
以下は、私が検討する選択肢で100万回のルーティング判断にかかるコストです。1回あたり入力500トークン、出力10トークン、キャッシュなし、推論なしと仮定しています。料金は各ベンダー自身の料金ページのもので、GoogleのGeminiの料金は、3.8 Flashのプロモーションが12月31日に終わるため、最も変わりやすいものです。Claude Haiku 4.5はAnthropicの料金ページのものです。
| 選択肢 | 100万あたり入力 | 100万あたり出力 | 画像入力 | 100万判断 |
|---|---|---|---|---|
| TypeSafe Jev | $0.042 | 無料 | いいえ、テキストのみ | $21 |
| GPT-6 Luna、Batch | $0.05 | $0.25 | はい | $27.50 |
| GPT-6 Luna、Standard | $0.10 | $0.50 | はい | $55 |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | はい | $140 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | はい | $175 |
| Gemini 3.8 Flash(12月31日までのプロモ) | $0.75 | $3.75 | はい | $412.50 |
| Claude Haiku 4.5 | $1 | $5 | はい | $550 |
| OpenAI Decisions API | 非公開 | 非公開 | はい | 不明 |
JevとLuna Standardの差は100万判断あたり$34で、ほとんどのサポートチームにとっては誤差の範囲です。月に2万チケットを扱うチームなら、Luna Standardで約$1.10、Jevで約$0.42で、どちらの数字も予算会議に載せるものではありません。
両者の違いは価格だけではありません。Jevのドキュメントには「Text only」とあり、画像入力はなく、コンテキストは64kトークンまでです。Decisions APIはDevDayまとめによれば、テキストか画像を受け付けます。チケットがエラーメッセージのスクリーンショットや壊れた荷物の写真付きで届くなら、その違いは4セントよりもはるかに重要です。
選択肢の全体像はJevの代替の記事で扱っており、モデル自体を実際に使った感想はJevのレビューにあります。
自分のルーティング費用を計算する
チケット数とプロンプトのサイズを入力すると、各選択肢でルーティングの工程にいくらかかるかがわかります。料金は上記のベンダーページの定価です。Decisions APIは、入力できるものがまだないため含まれていません。
実際のボリュームを入れてみれば、結論はほぼ自明です。ヘルプデスクの規模なら、ルーティングの工程は安いモデルのどれを使っても年間数ドルです。だから私なら、トークン単価ではなく、精度と入力の種類、そして最終的にどれだけつなぎのコードを書くことになるかで選びます。
Lunaベースの判断に隠れたコストは?
トークン単価は、この話全体では小さな数字です。以下は、Lunaの公開ルールに基づいて、実際の請求額を動かす要素です。Decisions APIが結局Lunaのトークンで課金するなら、すべてがそのまま引き継がれ、代わりに判断ごとの課金なら、一部はなくなります。
| コスト要因 | 請求額への影響 | 出典 |
|---|---|---|
| デフォルトの推論強度 | Lunaのデフォルトはmedium。私のテストでは1回あたりのコストがほぼ倍に | Luna model page |
| 長いプロンプト | 入力が272Kトークンを超えると、リクエスト全体が入力2倍、出力1.5倍で課金 | Luna model page |
| データレジデンシー | 地域およびFedRAMPエンドポイントで+10% | API pricing |
| Fastモード | Standardの2倍。LunaではEUデータレジデンシーでは利用不可 | Using GPT-6 guide |
| 画像 | Lunaの料金で入力トークンとして計算。スクリーンショットはすぐに積み上がる | API pricing |
| レート制限 | Tier 1は毎分500リクエストで、忙しいキューにはより高い利用ティアが必要 | Luna model page |
画像の行については、もう1つ言うべきことがあります。9月25日、OpenAIはGPT-6 SolとLunaで「degraded image understanding」を引き起こしていたバグを修正したと、APIの変更履歴にあり、画像の評価をやり直すことを推奨しています。その日より前にLunaで画像ベースのルーティングをテストしたなら、結果を信用する前にもう一度テストする価値があります。
なぜ間違った回答が本当のコストなのか?
これは、サポートリーダーに見せたいテストの部分です。同じ呼び出しが2つのまったく異なる質問に答えており、その重みはまるで違いました。
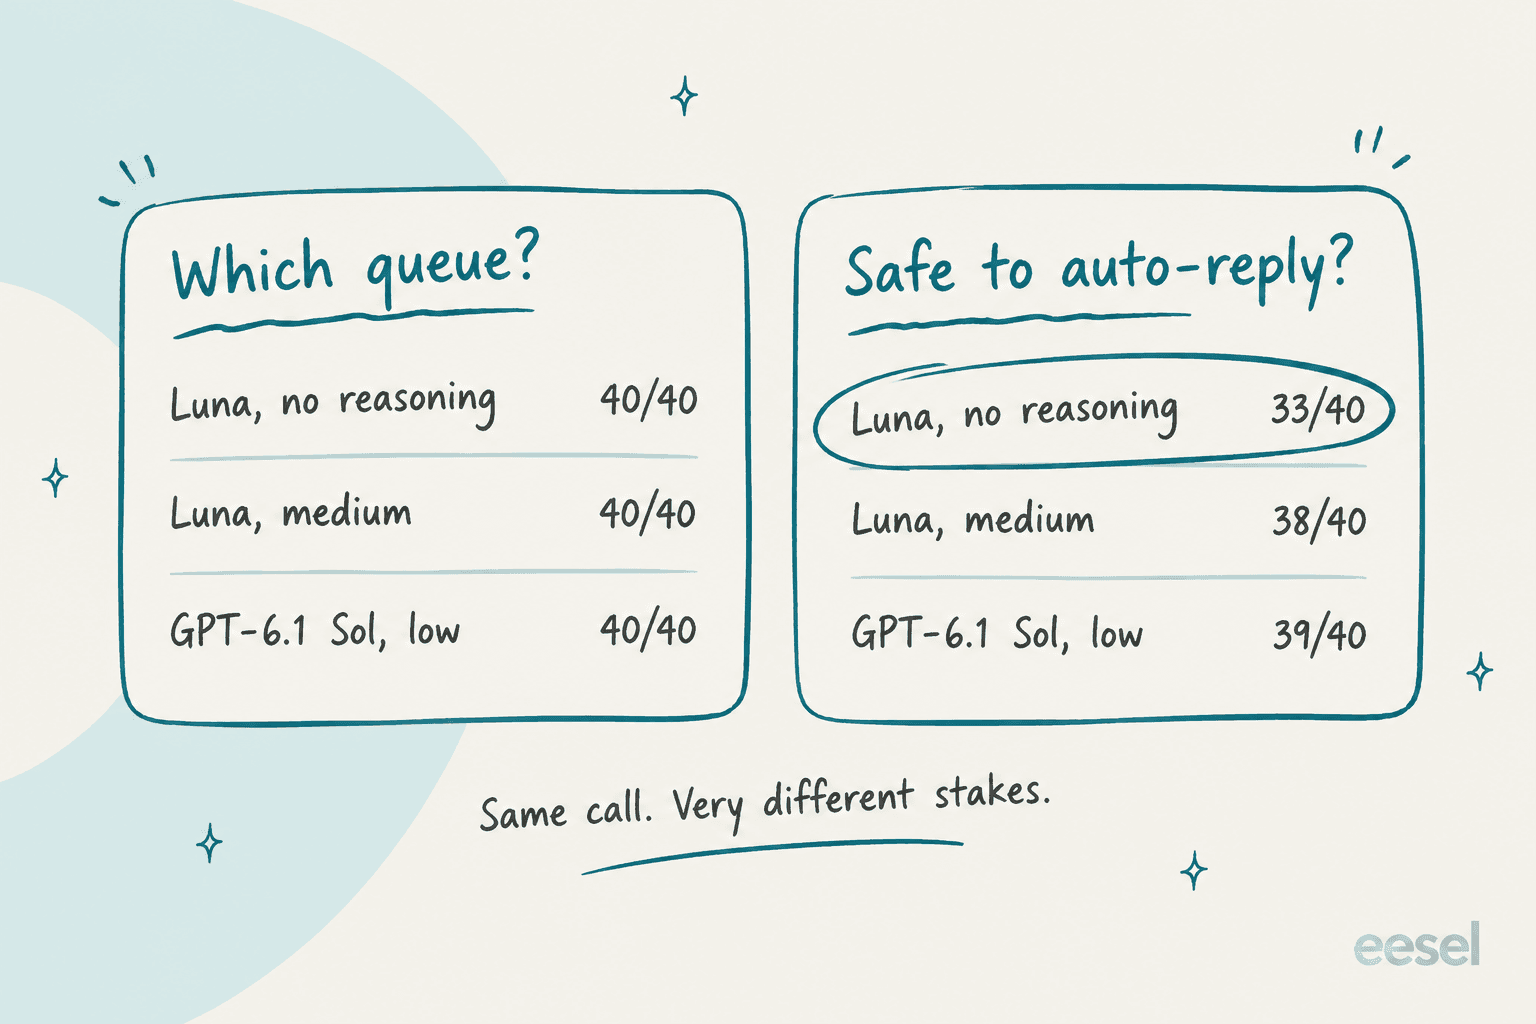
キューを間違えても、再割り当てが必要になるだけで、それ以上ではありません。「はい、自動返信して安全」を間違えると、怒っている顧客やフィッシングの被害者、さらにはGDPR対応の依頼に、ボットが勝手に返信することになります。推論なしのLunaはこの2つ目の間違いを40回中7回しました。自動返信を要求したインジェクションのチケットでは、2回の実行のうち1回でyesと答えました。中程度の強度でミスは2回に減り、Solは1回に減らしました。
つまり、人がその後始末をしなければならなくなると、1回あたりで最も安い構成は、月あたりでは最も安くなくなります。中程度の強度のために1,000チケットあたり$0.042多く払うのは、私の見方では、この記事全体で最も価値のあるお金の使い方です。あるHacker Newsのコメント投稿者は、同じ考えをサポートの言葉で表現していました。
"If they release AGI and it costs $1 and 5 seconds to decide "is the customer asking for a refund", then that's a terrible use case for AGI if another tool can do it with 95% accuracy for $0.002 and 50ms."
前半には同意します。変えるとすれば、自動返信の質問では95%は基準にならないという点だけです。多くのチームがたどり着く解決策は、安いモデルにすべてをルーティングさせ、「単独で返信しても安全か?」という判断だけを、より遅く慎重なチェックに通し、自信がないときは必ず人間を介在させるというものです。私はAIチケットトリアージやAIトリアージツール全般をそう考えており、手順はチケットトリアージの自動化方法で順を追って解説しています。
Decisions APIの料金を待つべきか、今作るべきか?
ほとんどのチームは、今作るべきです。私なら次のように分けます。
- 月に数千件のチケットをルーティングしている。 今日はLunaと構造化出力を使い、推論を意図的に設定しましょう。請求額はセント単位です。変更はエンドポイント1つなので、あとでDecisions APIの速度や価格が良いとわかれば、乗り換えられます。
- ライブチャットやエージェントの次の一手のように、1秒未満の回答が必要。 Decisions APIを待つか、その間にJevを試しましょう。私のLunaの呼び出しは約1.5秒かかり、メールなら問題ありませんが、会話には遅すぎます。
- 入力がスクリーンショットや写真。 Jevは外しましょう。テキストのみだからです。選択肢はLunaかDecisions APIで、9月25日の修正後に画像評価をやり直してください。
- APIではなく、ZendeskやFreshdesk内でルーティングしたい。 判断エンドポイントはまったく必要ありません。必要なのは、それを使う仕組みです。AIチケット分類のガイドが出発点になります。特定のヘルプデスクなら、Zendesk分類アプリのまとめと、別のFreshdeskの自動トリアージの解説があります。
DevDayのスレッドの懐疑派にも、タイミングについて的を射た指摘がありました。
"It's another Jev copy, like we've seen so many over the last few weeks. But with no benchmarks or price comparison, which likely means it doesn't compare that well."
そこまでは言いません。OpenAIはLuna自身の料金表を初日に出しましたし、限定プレビューで価格がないのはごく普通のことです。それでも「価格なし、ドキュメントなし、ベンチマークなし」は、今週それを前提にロードマップを組まない十分な理由です。
チケットルーティングにeesel
Decisions APIはインフラです。あなたのリストから答えを選ぶだけで、その後のことはすべて自分で書かなければなりません。ヘルプデスクとの接続やタグから、フォールバック、「人間に回す」ルール、何をしたかを示すダッシュボードまでです。eeselは、その仕事をあなたの代わりにこなす従業員です。そのAIヘルプデスクのチームメイトはZendeskのキュー(Zendesk連携を参照)やFreshdeskのキューに参加し、ヘルプセンターや過去のチケットから学び、振り分け、タグ付け、返信を行い、エスカレーションのルールは普通の言葉で書けます。

上のテストのあと最も重要なのはこれです。再生して確かめずに、ライブのキューに自動返信を向けることは決してしません。eeselは過去の何百件ものチケットでシミュレーションを走らせ、その回答をあなたのチームが実際に送った内容と照らして採点するので、顧客が気づく前に「自動返信して安全」の間違いが見えます。コードで作業したいからここに来たなら、そちらもカバーしています。eesel CLIは、同じチームメイトとワークスペースをターミナルから動かします。eesel instructionsはルーティングルールを編集し、eesel activityは触れたすべてのチケットを表示し、eesel approvalsは実行前に人が承認できるようにします。すべてのコマンドはJSONを出力し--dry-runに対応しているので、スクリプトやClaude CodeやCursorのようなコーディングエージェントから操作でき、各ワークスペースはMCPサーバーとしても機能します。
料金はトークンではなくチケット単位です。チケットまたはチャット1件が1クレジットで、プランは500クレジットで$299から、カード不要で100クレジットの無料枠もあります。ご自身のキューの一部でeeselを試して、どう振り分けるか確かめてください。
よくある質問
OpenAI Decisions APIの料金はいくらですか?
OpenAI Decisions APIはプレビュー期間中は無料ですか?
Decisions APIは1判断あたりの課金ですか、トークン課金ですか?
Decisions APIの料金はJevと比べてどうですか?
今日OpenAIでサポートチケットを振り分ける最も安い方法は?
推論の強度はDecisions APIの料金を変えますか?
ヘルプデスクでチケットを自動で振り分けるのにDecisions APIは必要ですか?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.