要点
Bedrock Managed Agents(BMA)は、2026年9月29日に始まったパブリックプレビュー中、サービス自体は0ドルです。実際に支払うのは次の3つです。BedrockのIn-Region単価(OpenAI自身の価格より10%高い)でのOpenAIモデルのトークン、AgentCoreを使う場合のAgentCore RuntimeのCPUとメモリ、そしてAWSのサンプルスタックにあるNATゲートウェイの月約33ドルで、これは何も動いていなくても課金されます。
AgentCore上でGPT-5.6 Lunaを使った典型的な10分間のタスク(入力20万、出力2万トークン)では、1タスクあたり約0.09ドルになります。GPT-5.6 Solに替えると、同じタスクが約1.34ドルです。つまりモデル選びで請求額は約15倍動きますが、Lunaのタスクに対するAWSの上乗せは約0.5セントです。そしてAWSは、GA時に料金が「is subject to change」としています。
私の見解では、OpenAIのエージェントをAWSの中に留めたいチームにとって、BMAの料金は妥当です。ただし予算は0ドルという見出しではなくモデルで組んでください。価格を検討しているのがサポートエージェントなら、eeselがすぐ使える選択肢です。月額固定のクレジットプランで、ヘルプデスク連携と過去チケットでのテストが最初から用意されています。
Bedrock Managed Agentsの料金はいくら?
プレビュー中のAWSの料金に関する記述は一文だけです。"During preview, there is no additional charge for BMA beyond the underlying AWS resources your agents consume. Pricing is subject to change at general availability"(AWS What's New)。
2年間SEOに携わって、料金検索について学んだことがあります。「無料」という言葉は、他のどの言葉よりも多くの人を誤った結論に導きます。「bedrock managed agents pricing」と検索する人が知りたいのは経理部門が目にする数字で、それが0ドルになることはありません。開発者向けドキュメントは「基盤となるリソース」が何を指すかを明記しています。"You incur charges for model inference and the AWS resources that your application uses,"、そしてAgentCoreの例は "can continue to incur charges when no BMA turn is running" とあります(AWS docs)。
サービス自体が初めてなら、セッション、exec server、実行環境の関係は私のBedrock Managed Agentsガイドで解説しています。この記事は請求額だけを扱います。
発生しうるすべての項目を1つの表にまとめます。
| コスト項目 | プレビュー中の価格 | 課金単位 | 適用される場面 |
|---|---|---|---|
| BMAサービス料 | $0 | n/a | 常時(GA時に変更の可能性あり) |
| OpenAIモデルのトークン | In-Region単価。例:GPT-5.6 Lunaは入力$0.22 / 出力$1.32 | 入力、キャッシュ、出力の100万トークンあたり | 毎ターン |
| AgentCore Runtime v2 CPU | 1 vCPU時間あたり$0.1276 | 秒単位、アクティブなCPUのみ | AgentCoreを実行環境にする場合 |
| AgentCore Runtime v2 メモリ | 1 GB時間あたり$0.0169 | 秒単位、アイドルメモリは120秒後に回収 | AgentCoreを実行環境にする場合 |
| NATゲートウェイ | 1時間あたり$0.045 + 1GBあたり$0.045 | 時間単位(端数の時間も1時間として課金) | AWSのAgentCoreサンプルスタック |
| S3、S3 Files、CloudWatch | AWS標準料金 | ストレージとリクエスト | スキル、出力、ログ |
| 自前ホストの計算資源 | ホストにかかる費用 | 既存の請求 | codex exec-serverを自分で動かす場合 |
これが全体像です。ただしすべての項目が同じ重みではないので、この記事の残りでは重要なものを取り上げます。
項目1:モデルのトークンと10%のIn-Region上乗せ
BedrockのOpenAIモデルは、それぞれのモデルカードに価格が載っています。BMAで重要なのはプレビューの制限事項で、クロスリージョン推論には対応していません。つまりBMAのすべてのリクエストにIn-Region単価が適用され、AWSもそれをはっきり述べています。"Commercial In-Region prices include a 10% fee over OpenAI rates"(GPT-5.6 Lunaカード)。
エージェント用に検討するOpenAIモデルの、Standardティア・短いコンテキスト(入力27.2万トークン以下)での100万トークンあたりの単価です。すべてAWSのOpenAIモデルのページにあるBedrockのカードから取りました。
| モデル | 入力(BMA単価) | キャッシュ書き込み | キャッシュ読み取り | 出力(BMA単価) | OpenAI自身の単価(入力 / 出力) |
|---|---|---|---|---|---|
| GPT-6 Luna | $0.11 | $0.1375 | $0.011 | $0.55 | $0.10 / $0.50 |
| GPT-5.6 Luna | $0.22 | $0.275 | $0.022 | $1.32 | $0.20 / $1.20 |
| GPT-6.1 Sol | $2.20 | $2.75 | $0.11 | $11.00 | $2.00 / $10.00 |
| GPT-5.6 Terra | $2.20 | $2.75 | $0.22 | $13.20 | $2.00 / $12.00 |
| GPT-5.6 Sol | $4.40 | $5.50 | $0.44 | $22.00 | $4.00 / $20.00 |
| GPT-6 Astra | $11.00 | $13.75 | $1.10 | $55.00 | $10.00 / $50.00 |
これらのカードに書かれた次の4点は、表から受ける印象以上に見積もりを左右します。
- 長いコンテキストは入力が2倍になる。 リクエストが27.2万入力トークンを超えると、超過分だけでなく "to the full request" に長コンテキスト単価が適用されます(GPT-6.1 Solカード)。GPT-5.6 Solでは入力$8.80、出力$33.00です。毎ターン大きなコンテキストウィンドウを引きずるエージェントは、すぐここに達します。
- PriorityやFlexの割引はない。 上のどのカードにも、PriorityとFlexのティアは非対応とあるため、夜間ジョブ向けのバッチ型の安いティアはありません。使えるのはStandardだけです。
- キャッシュは一様ではない。 GPT-6.1 Solのカードにはキャッシュ価格が載っていますが、"Explicit prompt caching is not supported for this Bedrock model." とあります。キャッシュ読み取り90%割引を当てにする前に、対象モデルのカードを確認してください。
- 最新モデルは1つのリージョンにしかない。 BMAが使う
bedrock-mantleエンドポイントでは、GPT-6 LunaとGPT-6.1 Solはus-east-1でしか使えません。オレゴンやオハイオにデプロイするなら、GPT-5.6ファミリーになります。
ここでは最新世代がトークン単価も最安です。GPT-6 Lunaは、入力も出力もGPT-5.6 Lunaの半額です。どのみちLunaを選ぶつもりなら、まずGPT-6 Lunaを試してください。GPT-6 Lunaの料金とGPT-6.1 Solの料金の記事で、OpenAIのラインナップ全体と比較しています。
項目2:AgentCore Runtimeの稼働時間
BMAはツールを自分では実行しません。ツールはあなたが用意する計算資源、つまり自前のホストか、AWSの例でデフォルトになっているAmazon Bedrock AgentCore Runtimeの上で動きます。AgentCoreを使うなら、そのランタイム料金を支払います(AgentCoreの料金)。
| AgentCore Runtimeのリソース | 従量課金レート | コミット型ベースライン |
|---|---|---|
| v2 microVM CPU | 1 vCPU時間あたり$0.1276 | 1 vCPU時間あたり$0.0997(2026年10月までに開始) |
| v2 microVM メモリ | 1 GB時間あたり$0.0169 | 1 GB時間あたり$0.0132(2026年10月までに開始) |
| v1 microVM CPU | 1 vCPU時間あたり$0.0895 | n/a |
| v1 microVM メモリ | 1 GB時間あたり$0.00945 | n/a |
| ランタイムインスタンス(EC2) | EC2オンデマンド料金 | 加えて12%の管理手数料 |
この課金モデルは、見た目よりエージェントに優しい仕組みです。AWSによれば、CPUは "scales to zero during I/O wait (waiting for LLM responses, tool / API calls, or database queries)" で、v2では120秒後に "idle memory is reclaimed automatically" となります。エージェントは生涯の大半をモデルの応答待ちに費やすため、実時間の大部分でCPUは課金されません。
AWS自身の料金ページには、サポートエージェントに近い計算例があります。月100万セッション、1セッション10分、I/O待ち90%、1 vCPU、最大2.5GBです。合計は1セッションあたり$0.006703、100万セッションで月$6,703です。これはランタイムだけで、トークンは1つも払う前の数字です。
注意点が1つあります。BMAのAgentCoreの例では、ランタイムのアイドルタイムアウトと最大寿命が28,800秒、つまり8時間に設定されています。アイドルメモリは回収されますが、忘れられたセッションはやはりセッションです。
項目3:エージェントが眠っている間も課金されるNATゲートウェイ
AWSのAgentCoreサンプルスタックは、プライベートサブネット、S3ゲートウェイエンドポイント、NATゲートウェイ1つを持つVPCを作ります。米国東部のAmazon VPCの料金では、NATゲートウェイは1時間あたり$0.045に加えて処理1GBあたり$0.045で、端数の時間は1時間として課金されます。
730時間の月では、エージェントが何もしなくても$32.85です。本番のチームにとっては小さな金額です。しかし開発アカウントで、誰かが金曜にサンプルを試して忘れたような場合、誰かがクリーンアップ手順を実行するまで、毎月この項目が請求に出続けます。AWS自身のドキュメントが、サンプルは開発アカウントで実行するよう勧めているのはこのためです。
そのほかのストレージ項目(スキルや出力用のS3バケット、S3 Filesのマウント、CloudWatchログ)は、テスト規模ならたいてい数セントです。エージェントの書き込み量に応じて増えるので、本番に入ったらAWSの請求で確認する価値があります。
1つのエージェントタスクの実際のコスト
私が使っている計算例です。エージェントがコードとドキュメントを読み、結果を書き出す1つのタスクです。入力20万トークン、出力2万トークン、キャッシュなし、2 vCPU / 4 GBのAgentCoreセッションで10分、CPUが稼働しているのは20%の時間とします。
- ランタイム: 稼働120秒 x 2 vCPU x 1時間あたり$0.1276 = $0.0085、加えて600秒 x 4 GB x 1時間あたり$0.0169 = $0.0113。約**$0.02**で、v2がアイドルメモリを回収すればそれ以下です。
- GPT-5.6 Lunaのトークン: 0.2M x $0.22 + 0.02M x $1.32 = $0.070。
- GPT-5.6 Solのトークン: 0.2M x $4.40 + 0.02M x $22.00 = $1.32。
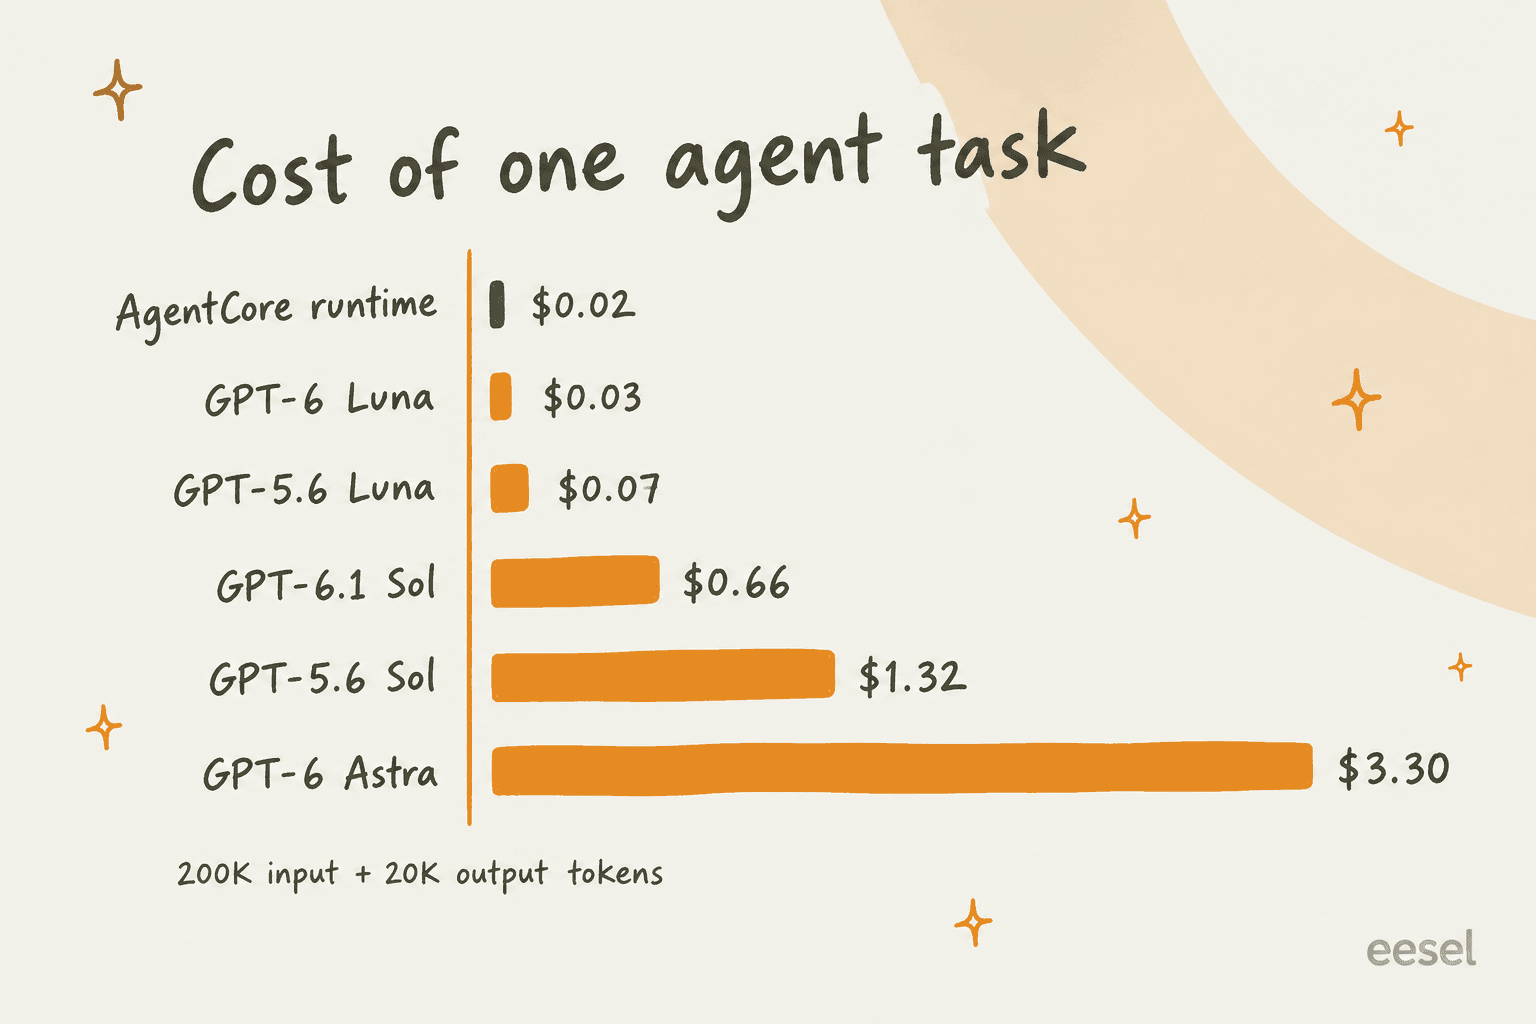
この記事から1つだけ持ち帰るなら、このグラフです。ランタイムはグラフの中で一番小さい棒です。同じタスクでGPT-6 LunaからGPT-6 Astraに替えると、トークンコストは100倍に跳ね上がりますが、AgentCoreのランタイムは約2セントのままです。BMAの請求を減らしたいなら、効くのはモデル選びです。vCPUの調整はほとんど影響しません。
GPT-5.6 Lunaで、NATゲートウェイを残したまま月間でどうスケールするかを示します。
| 月間タスク数 | トークン | AgentCoreランタイム | NATゲートウェイ | 月額合計 | 1タスクあたり |
|---|---|---|---|---|---|
| 1,000 | $70 | $20 | $33 | $123 | $0.123 |
| 10,000 | $704 | $198 | $33 | $935 | $0.093 |
| 100,000 | $7,040 | $1,977 | $33 | $9,050 | $0.091 |
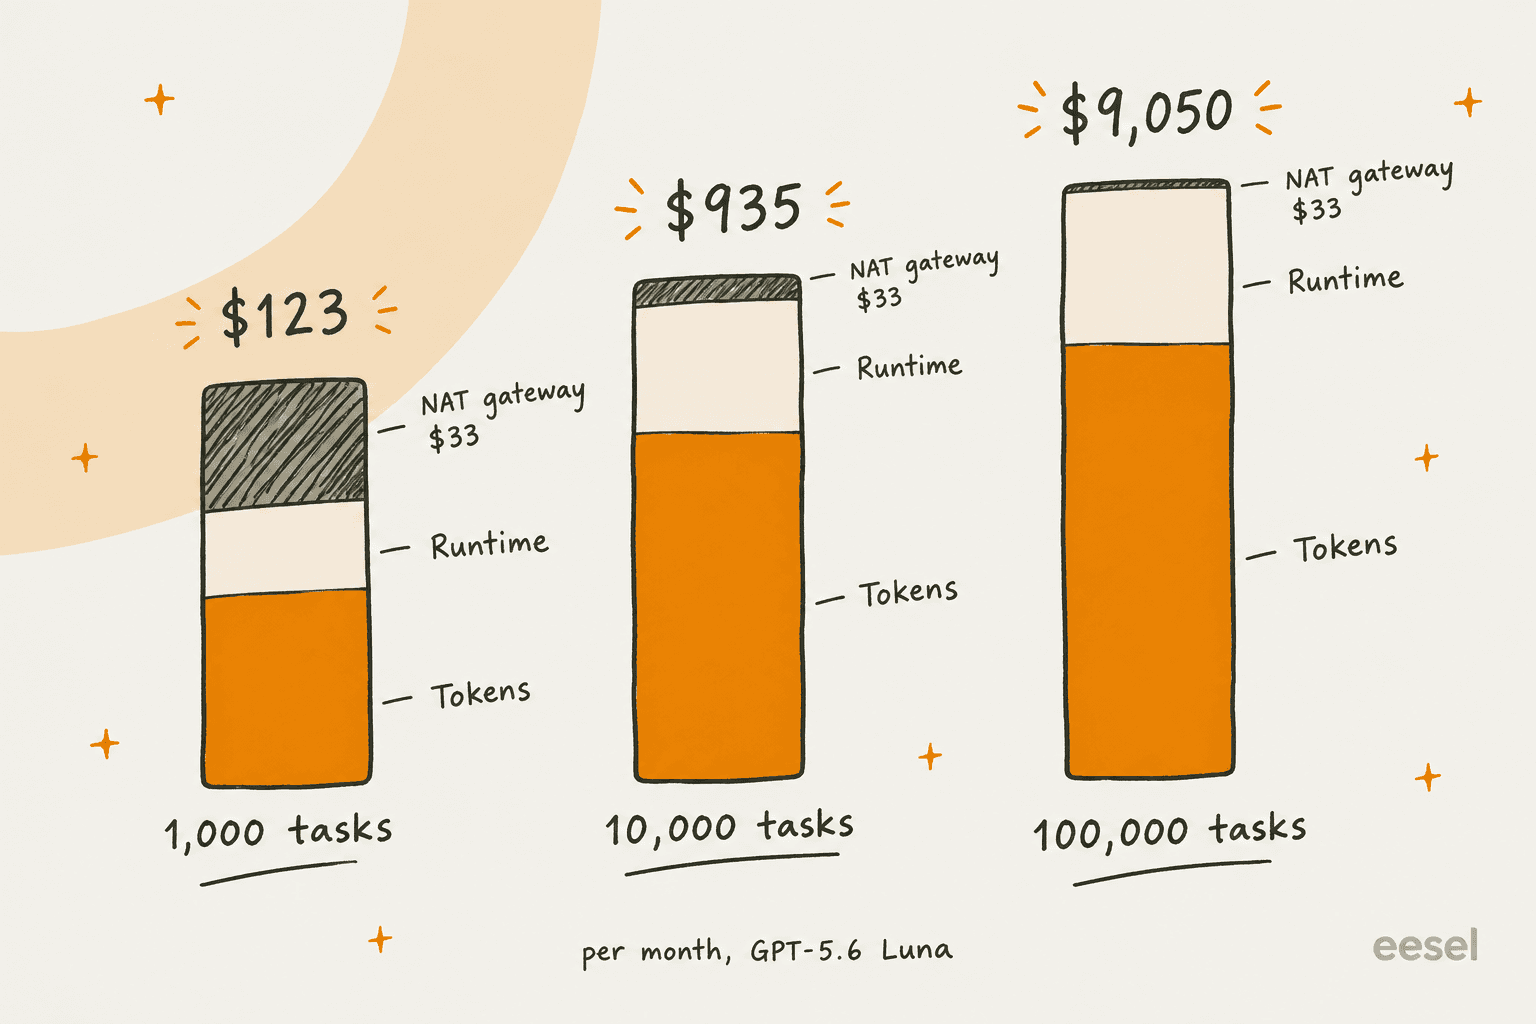
少量のうちは、固定のNATゲートウェイが請求の4分の1以上を占めます。10万タスクになるとほぼ誤差で、トークンが8割近くになります。つまり規模によって助言が逆転します。小規模なチームは自前ホスティングにするか、テストの合間にサンプルスタックを撤去し、大規模なチームはモデル選びとプロンプトキャッシュ(繰り返し使うコンテキストをキャッシュ可能にすること)に力を注ぐべきです。
下の計算ツールに自分の数字を入れてみてください。上の表と同じ単価を使っています。
AWSの10%上乗せは払う価値があるか?
多くの購入者が本当に知りたいのはこの点だと思います。答えは、見出しの印象よりAWSに有利です。同じ10分間のGPT-5.6 Lunaタスクを4通りで試算します。
| 構成 | トークン | ランタイム | 1タスクあたり |
|---|---|---|---|
| OpenAI Agents API、自前ホストのサンドボックス | $0.064(OpenAI単価) | $0 | $0.064 |
| Bedrock Managed Agents、自前ホスト | $0.070(In-Region単価) | $0 | $0.070 |
| AgentCore上のBedrock Managed Agents | $0.070 | 約$0.020 | $0.090 |
| OpenAI Agents API、ホスト型4 GBコンテナ | $0.064 | $0.06 | $0.124 |
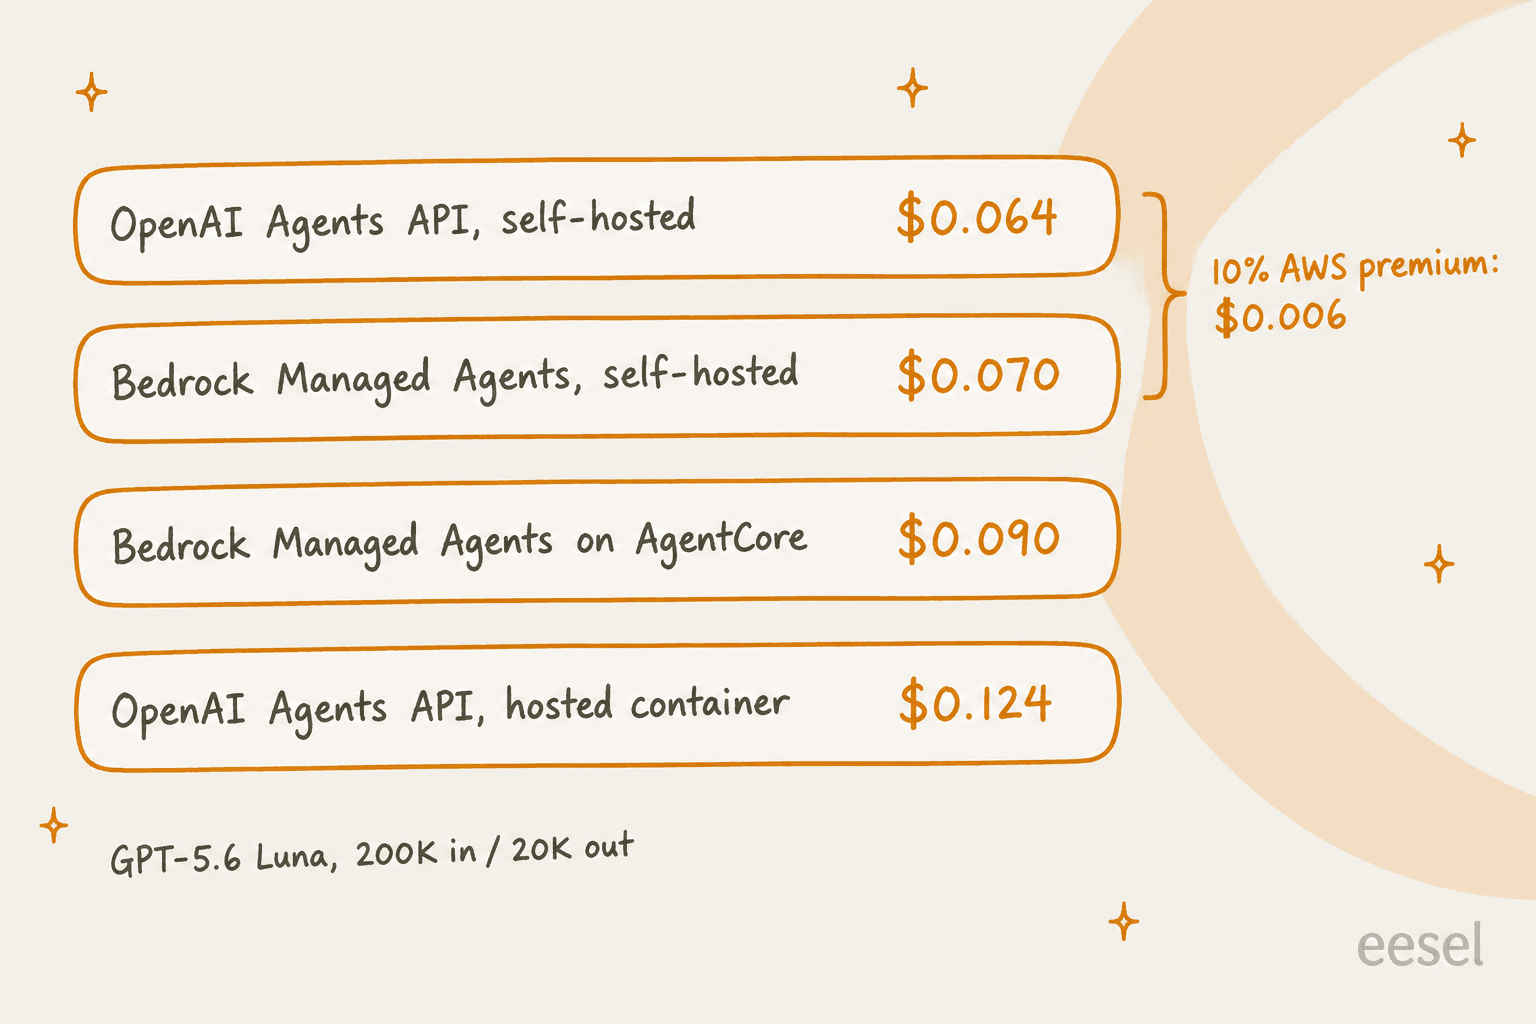
ホスト型コンテナの行は、4 GBコンテナで20分セッションあたり$0.12というOpenAIの公表レートを使っており、分単位で課金され最低5分です(OpenAIの料金)。コンテナの全サイズはAgents APIの料金の記事で紹介しています。
したがって、このタスクでのAWSの上乗せは約$0.006です。月100万タスクなら実際のお金になります(約$6,400)が、OpenAIのホスト型コンテナとAgentCoreのI/O対応課金との差より小さい額です。もしOpenAIのホスト型サンドボックスで動かすつもりだったなら、AgentCore上のBMAのほうがタスクあたりは安くなる場合があります。どちらにしても自前ホストにするなら、BMAのコストはちょうどその10%です。
この上乗せで得られるのは、セキュリティレビューで重要な部分です。エージェントのランタイム、モデル推論、ツールのすべてが、AWSの契約のもと、あなたのAWSアカウント内にとどまります。調達の理屈は、あるHacker Newsのコメントがうまく言い表しています。
"A lot of companies already have data processing agreements and compliance sign-off for using AWS. Many are hesitant to send their data to AI startups with an incentive to train their models and a history of being.... loose with how they intake training data. Even when they do give assurances otherwise. AWS is more trusted in this aspect. If this ends up similar to Claude on Bedrock, it's the same price."

結果的にまったく同じ価格にはなりませんでしたが、近いです。In-Regionの保証のために10%上乗せです。すでにAWSの書類が整っていて、新しいAIベンダーの承認に数か月かかる会社なら、この10%は今年買えるコンプライアンス対応で最も安いものでしょう。
BMAの料金は他のマネージドエージェントランタイムとどう比べるか
主要なラボはどこも今やマネージドなエージェントループを販売しており、ランタイムの課金方法はそれぞれ違います。トークンは常に別で、各ベンダーのモデル単価がかかります。
| ランタイム | ランタイム料金 | 課金単位 | モデル |
|---|---|---|---|
| Bedrock Managed Agents | プレビュー中は$0、計算資源は別 | n/a | Bedrock上のOpenAI |
| Claude Managed Agents | 1セッション時間あたり$0.08 | running状態の時間 | Claudeのみ |
| OpenAI Agents API | 20分コンテナあたり$0.03〜$1.92 | 分単位、最低5分 | OpenAIのみ |
| Gemini Managed Agents | 計算資源はプレビュー中は課金なし | n/a | Geminiのみ |
| AgentCore harness | harness料金なし、AgentCore Runtimeは別 | CPUとメモリの秒単位 | Bedrock、OpenAI、Gemini、またはLiteLLM互換の任意のモデル |
現在、ランタイム層が無料なのはこのうち2つで、どちらもプレビューです。ここに注目すべきパターンがあります。このカテゴリのローンチ価格は寛大で、どのラボも一般提供後の料金を明らかにしていません。
AgentCore harnessは、すでに一般提供されていて、モデルを問わず、harness料金が別にかからない、唯一のAWSネイティブの選択肢です。OpenAIのharnessに特にこだわらないなら、同じランタイム課金でより多くのモデルから選べます。Claude Managed Agentsはランタイム料金が加わりますが、現時点で機能が豊富です。メモリストア、マルチエージェント、ベンダーのサンドボックスなどです。トークン面の比較はAnthropic APIの料金の記事に、より広い選択肢はOpenAI Agents APIの代替のまとめにあります。
戦略面の視点もあり、あるLinkedInの投稿が私よりうまく述べています。
"Near-zero switching costs between frontier models on the same bill sounds like a buyer's market. It is, for now. When you can swap Claude for GPT-5.5 with a one-line code change, models start looking interchangeable, and the platform hosting them all owns the customer relationship and the pricing power."

これはエージェントのコードを移植しやすく保つ理由であって、BMAを避ける理由ではありません。
予算に入れておきたい隠れたコスト
料金表自体は十分に明快です。チームがつまずくのは、どの料金表にも載っていないものです。
- 誰も発表していないGA時の料金。 AWSはプレビュー後の価格も日付も公表していません。仮の数字がほしいなら、Claudeの1セッション時間あたり$0.08を使うと、上の10分タスクに約$0.013が加わります。予測ではなく予算上のシナリオとして扱ってください。
- ターンをまたぐコンテキストの増加。 毎ターンそれまでの会話を再送するため、20ターンのタスクは最初のターンの20倍よりはるかに高くなりえます。キャッシュは対応モデルでは効きますが、非対応モデルでは27.2万の長コンテキストの壁が響きます。
- BMAがまだ含まないもの。 プレビューには長期記憶が組み込まれていないため、AWSは "provision and authorize any application-specific datastore separately" としています(プレビューの制限事項)。AgentCore Memoryを追加すると、新規イベント1,000件あたり$0.25に加え、保存された長期レコード1,000件あたり月$0.75です(AgentCoreの料金)。
- 人によるレビュー。 外部に影響するアクションについては、セキュリティのドキュメントが、認可とhuman-in-the-loopのレビューを自分で実施するよう求めています。これはエンジニアリングの時間であり、AWSの請求項目ではありません。
- エンジニアリングの時間、これに尽きる。 最大の項目であり、AWSの請求には決して現れません。
この最後の点について、AgentCoreの批判者の声も聞く価値があります。
"There's not really a good solution, as AgentCore runtime sucks and is expensive. You basically have to build this yourself because nobody is solving for self-hosted managed infra for agents, and we don't really have the time to build this sort of system on top of building our actual product."
上の数字を見る限り、ランタイムが高いという点には同意しません。ただしこのコメントの後半は、どのマネージドランタイムにも共通する本当のコストです。プロダクトを作る作業は、依然としてあなたの仕事です。
サポートエージェントにBedrock Managed Agentsは向いているか?
私が最も計算が狂うのを見るのはここです。誰かがBMAでサポートエージェントを試算し、1会話あたり約9セントと見て、とても安く済むと判断します。トークンの計算も正しいのですが、そこにはヘルプデスク連携、ナレッジベースに対する検索、エスカレーションのルール、実際のチケットでのテスト、そして保守するオンコールのエンジニアが含まれていません。
eeselでは、長年この両方の方向を見てきました。連携の不具合とサポートの遅さを理由に離れた中堅の元顧客は、eeselのチームに "long term we will just build our own, which is so possible now with AI" と話しました。逆の例として、300以上の記事のナレッジベースを持つハードウェア企業のエンジニアリングリードは、購入を選んだ理由をこう説明しました。
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
どちらも妥当な判断です。AIエージェントを自分で所有したいエンジニアがいて、OpenAIモデルをAWS内で使う必要があるなら、BMAの料金が障害になることはないでしょう。BMAと既製のエージェントの導入を比べるなら、トークン代だけでなく作るか買うかの総コストで比べてください。サポートエージェントの作り方のガイドに、必要になるすべての部品を挙げています。
eesel:料金が固定のサポートエージェント
実際に検討しているのがAIヘルプデスクのチームメイトなら、eeselは予算からトークンの従量メーターを取り除きます。Zendesk、Freshdesk、Gorgiasなどのヘルプデスクに接続し、過去のチケットとヘルプセンターから学習します。実際の顧客に回答する前に、過去のチケット数百件でシミュレーションとして検証されます。
料金はトークン課金ではなくクレジットプランです。100クレジットの無料プランがあり、有料プランは月$299で500クレジットから、チケットまたはチャット1件の対応が1クレジットで、全機能と無制限のシートが付きます。経理はコンテキストの増加を推測せずにこの数字を表計算に入れられます。カスタマーサポートの面では、Gridwiseが最初の月にティア1の問い合わせの73%を解決しました。
また、BMAを見ていた理由がターミナルやスクリプトからエージェントを動かしたいことなら、eesel CLIがダッシュボードで見るのと同じチームメイトに対してそれを実現します。連携の接続、指示の編集、保留中のアクションの承認や拒否、アクティビティの確認ができ、JSON出力と書き込み時の--dry-runに対応しています。Claude Code、Codex、Cursorのようなコーディングエージェントからも操作でき、これはAIエージェントCLIの記事で取り上げました。
eeselを無料で試して、配管がすでに整っているときサポートエージェントにいくらかかるかを確かめてください。
よくある質問
Bedrock Managed Agentsの料金はいくらですか?
Bedrock Managed Agentsはプレビュー中は無料ですか?
Bedrock Managed Agentsの料金がOpenAIのAPIより高いのはなぜですか?
Bedrock Managed Agentsを最も安く動かす方法は?
Bedrock Managed Agentsの料金はClaude Managed Agentsと比べてどうですか?
Bedrock Managed Agentsの料金は一般提供時に変わりますか?
コスト削減のためにBedrock Managed Agentsでサポートエージェントを作るべきですか?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.