Amazon Bedrock Managed Agentsとは?
Amazon Bedrock Managed Agents(powered by OpenAI)は、AWS上でステートフルなAIエージェントを動かすためのマネージドランタイムです。モデル、指示、ツール、実行環境を指定してセッションを作成し、メッセージを送ると、サービスがエージェントループとモデル呼び出しを実行します。AWSの言葉では「built on a customized version of OpenAI's Agents API engineered to be AWS-native」(AWS What's New)であり、製品ページでは「combines OpenAI models with the Codex harness and Amazon Bedrock AgentCore」(AWS)と書かれています。
私はeeselの連携とAPIを開発しているので、この種のループを手作業で組んだことは一度や二度ではありません。そして最初に知っておくべきなのは、マーケティングページではやや目立たない点です。ここでの「マネージド」が指すのは会話と推論ループであり、エージェントが作業するマシンではありません。そのマシンは自分で動かします。
ここまでには時間がかかりました。一次情報をもとにした年表は次のとおりです。
| 日付 | 出来事 | 出典 |
|---|---|---|
| 2026年2月27日 | AmazonとOpenAIがパートナーシップを発表。Bedrock上の「Stateful Runtime Environment」を含む | Amazon |
| 2026年4月28日 | BMAが限定プレビューとして発表。BedrockでのOpenAIモデルとCodexも同時に発表 | OpenAI |
| 2026年6月1日 | BedrockのOpenAIモデルとCodexがGA。BMAはまだ「coming soon」 | AWS ML blog |
| 2026年9月29日 | BMAが米国3リージョンでパブリックプレビューとして開始 | AWS What's New |
名前が挙がっているローンチ顧客はBoxとSalesforceです。Amazonのローンチ記事で、BoxのCTOであるBen Kus氏は、OpenAIのモデルを「with the scale, security, and infrastructure of AWS」と組み合わせるものだと述べており、SalesforceはAWSの製品ページで自社のHeadless 360製品と組み合わせています。
私のOpenAI Agents APIのガイドを読んだ方なら、構造はおなじみのはずです。OpenAI Codex(料金は別)と同じハーネスの系譜で、エージェント、セッション、イベントのオブジェクトも同じです。違いは主に、誰がループをホストし、誰がリクエストに署名するかです。
Bedrock Managed Agentsの仕組み
AWSのドキュメントでは、サービスを6つの要素に分けています(AWSドキュメント)。
- セッション: エージェントとのステートフルな会話。モデル、指示、ツール、IAMロール、実行環境を指定します。
- ターン: 1つのメッセージに対して行われる作業(推論、ツール呼び出し、出力)。
- 実行環境: ご自身が用意するコンピュートで、コマンドやローカルツールが実際に動く場所です。
- Execサーバー: 実行環境とBMAをアウトバウンド接続でつなぐ
codex exec-serverプロセス。 - アイテムとイベント: アイテムは起きたことの永続的な記録、イベントは進捗のライブストリームです。
- セッションロール: BMAがモデル呼び出し(使う場合はAgentCore Runtimeの起動)のために引き受けるIAMロール。
これらの要素がどうやり取りするかは、AWS自身の図で確認できます。
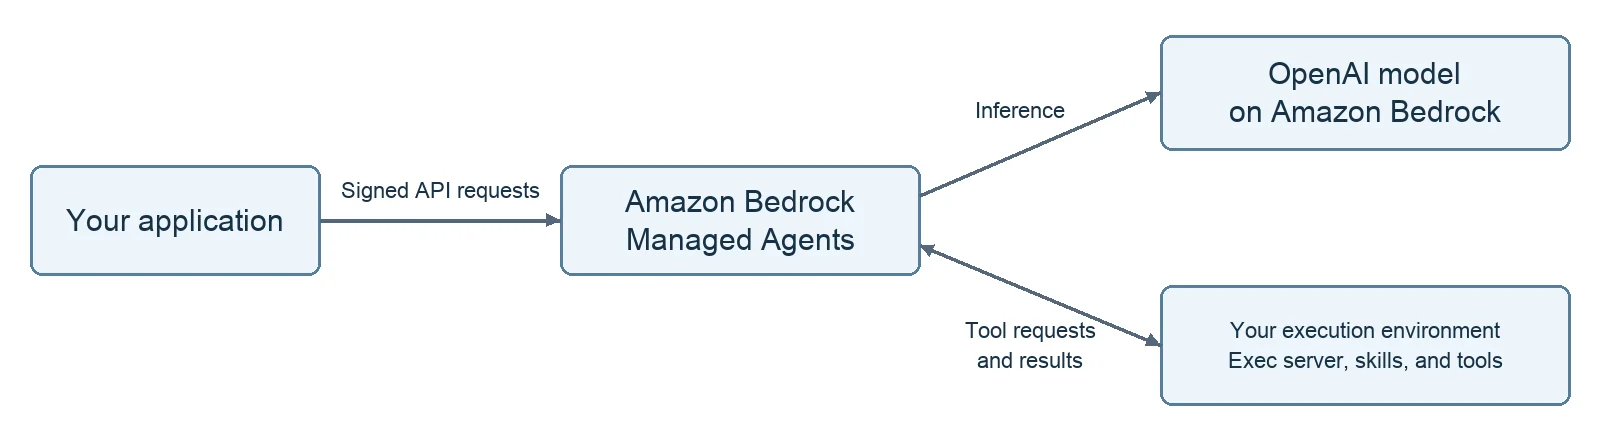
意外だったのは、右下のボックスです。Claude Managed AgentsやOpenAIのホスト型Agents APIでは、ベンダーにサンドボックスを任せることができます。BMAにはベンダーのサンドボックスという選択肢がまったくありません。ツールは「execute in the compute environment that you provide」(AWSドキュメント)なので、execサーバー、ワークスペース、ネットワークルール、MCPサーバーはすべて自己責任です。
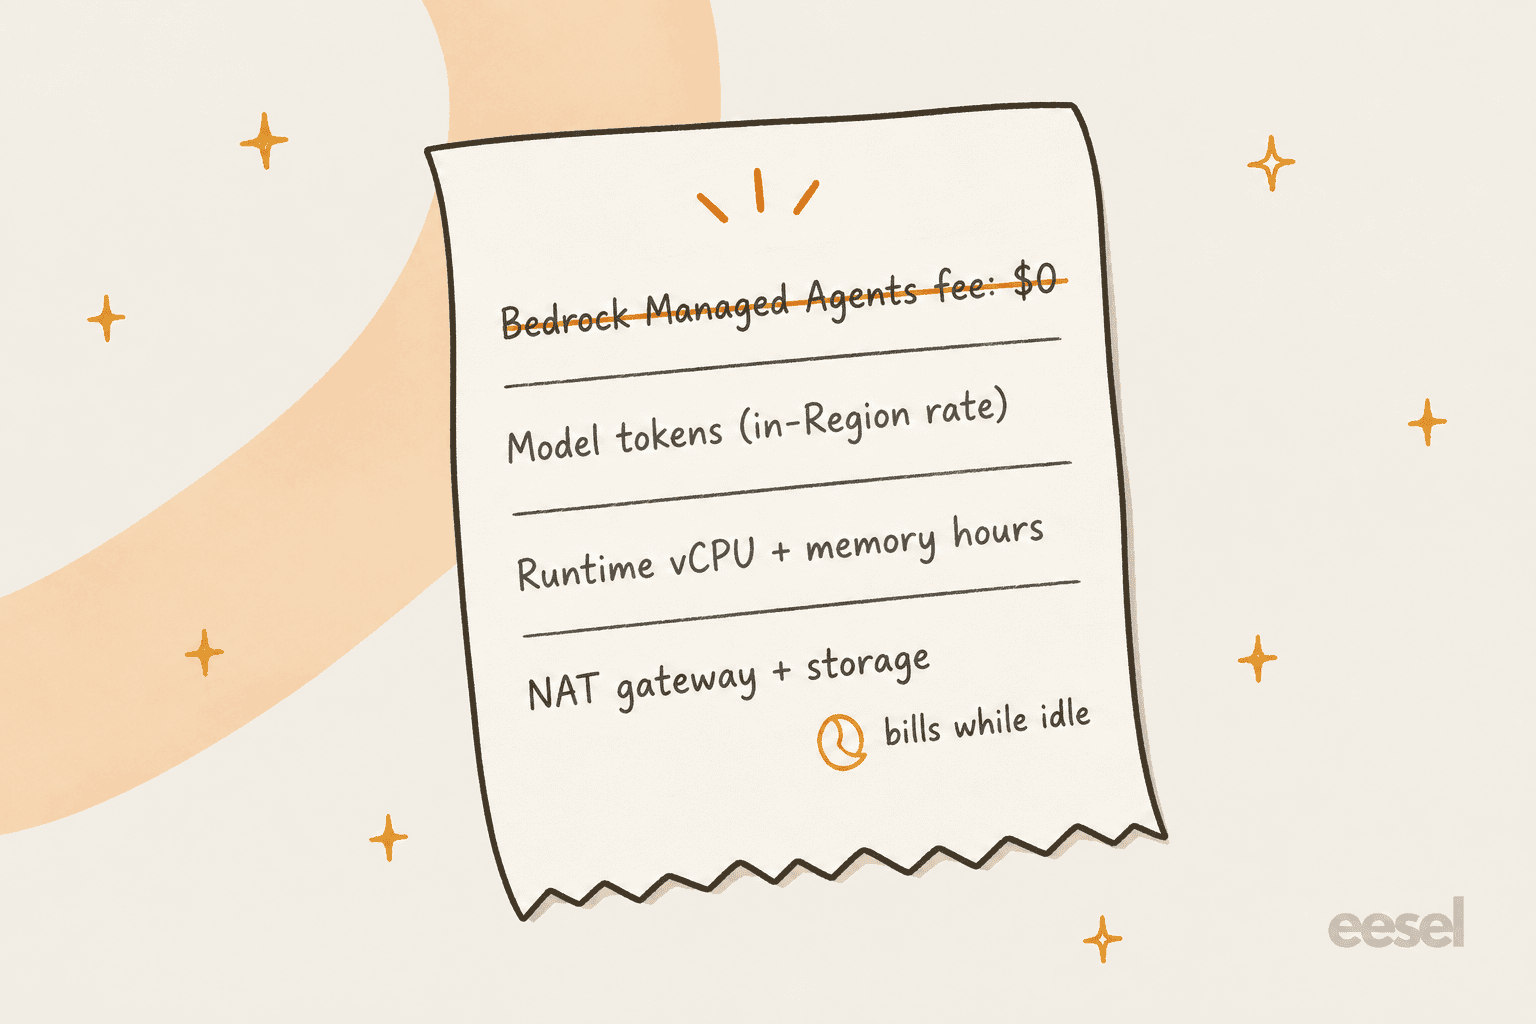
これがトレードオフであり、おすすめAIエージェントの比較で毎回目にするのと同じ構図です。利便性を手放す代わりに、すっきりしたセキュリティの説明が手に入ります。モデル推論、エージェントランタイム、ツールのすべてがAWS内にとどまります。AWSの製品ページにも「The agent runtime and model inference remain inside AWS」(AWS)とあります。
APIは小さい
プレビューのREST APIは、リージョンごとのbedrock-mantleエンドポイントにある7つの操作で、すべてOpenAIのAPIキーではなくAWS SigV4で署名します(APIリファレンス)。セッションの作成、一覧、取得、削除、イベントの送信、イベントのストリーミング、アイテムの一覧です。メッセージはagent.session.input.messageイベントをPOSTして送り、結果はアイテムのエンドポイントから1ページ1〜100件で読み取ります(セッションガイド)。
ドキュメントには、半日を節約できる細かい点が2つあります。
- 送信が成功すると空のボディが返ります。これは「受理された」であって「完了した」ではありません。完了はセッションの状態、アイテム、イベントに現れます。
idleのセッションは、タスクが成功した証拠ではありません。AWSは、出力アイテムと、コマンドの場合は終了コードを確認するよう述べています。また、ターンをキャンセルしても「does not undo side effects from tools that already completed.」です。
スキルとツール
スキルはSKILL.mdファイルを含むフォルダで、セッションのケイパビリティディレクトリのいずれか(最大32パス)に置きます。ツールは実行環境内で動くSTDIOのMCPサーバーから提供され(この仕組みはAIエージェントのMCPサーバーのガイドで解説しています)、サーバーごとにallowed_toolsリストで制限できます(スキルとツール)。Claude Codeのスキルを使ったことがあれば、形式がかなり近いので馴染みやすいでしょう。
セキュリティ面について、AWSははっきり書いています。「Treat instructions from documents, websites, and tool responses as untrusted input」(セキュリティドキュメント)。これはプロンプトインジェクションへの注意で、エージェントが本物のホスト上で本物のシェルを持つとなると、受け止め方が変わります。
エージェントが実際に動く場所:セルフホストかAgentCoreか
実行環境は2種類あり、どちらを選ぶかでセットアップ作業の大半と請求の一部が決まります(AWSドキュメント)。
| セルフホストのコンピュート | AgentCore Runtime | |
|---|---|---|
| 用意するもの | ホスト、ワークスペース、ネットワークアクセス、稼働中のcodex exec-server | execサーバーとそのアダプターをARM64コンテナに組み込んだAgentCore Runtime |
| AWSのサンプルスタックが作るもの | IAMロールのみ(ホストなし) | Runtime、プライベートサブネット付きVPC、NATゲートウェイ1つ、スキルと出力用のバージョニング有効なS3バケット、S3 Filesマウント |
| execサーバーを起動する人 | 自分で、2つ目のターミナルから | BMAがRuntimeを起動 |
| サンプルの時間制限 | 自分で決める | アイドルと最大存続時間がどちらも28,800秒(8時間) |
| 向いている用途 | 開発マシン、既存のコンテナ、手早いテスト | 自分のアカウント内にとどまる、セッション単位のマネージドコンピュート |
AgentCoreはAWSのより広いエージェントプラットフォームで、BMAのデフォルトのコンピュートです。AWSの主張は、エージェントが成長するにつれて、認可、エージェントとツールの検出、オブザーバビリティ、評価といった機能をさらに活用できるというものです(AWS)。
とにかく動くところを見たいなら、セルフホストが最速です。実際に本番へ出すのはAgentCoreの道で、「追加料金なし」の行に表れないコストが積み上がり始めるのもここです。
プレビューに含まれるものと含まれないもの
導入を決める前に1つの節を2回読むなら、ここです。AWSのプレビューの制限ページは、境界線がめずらしく明確に書かれています。
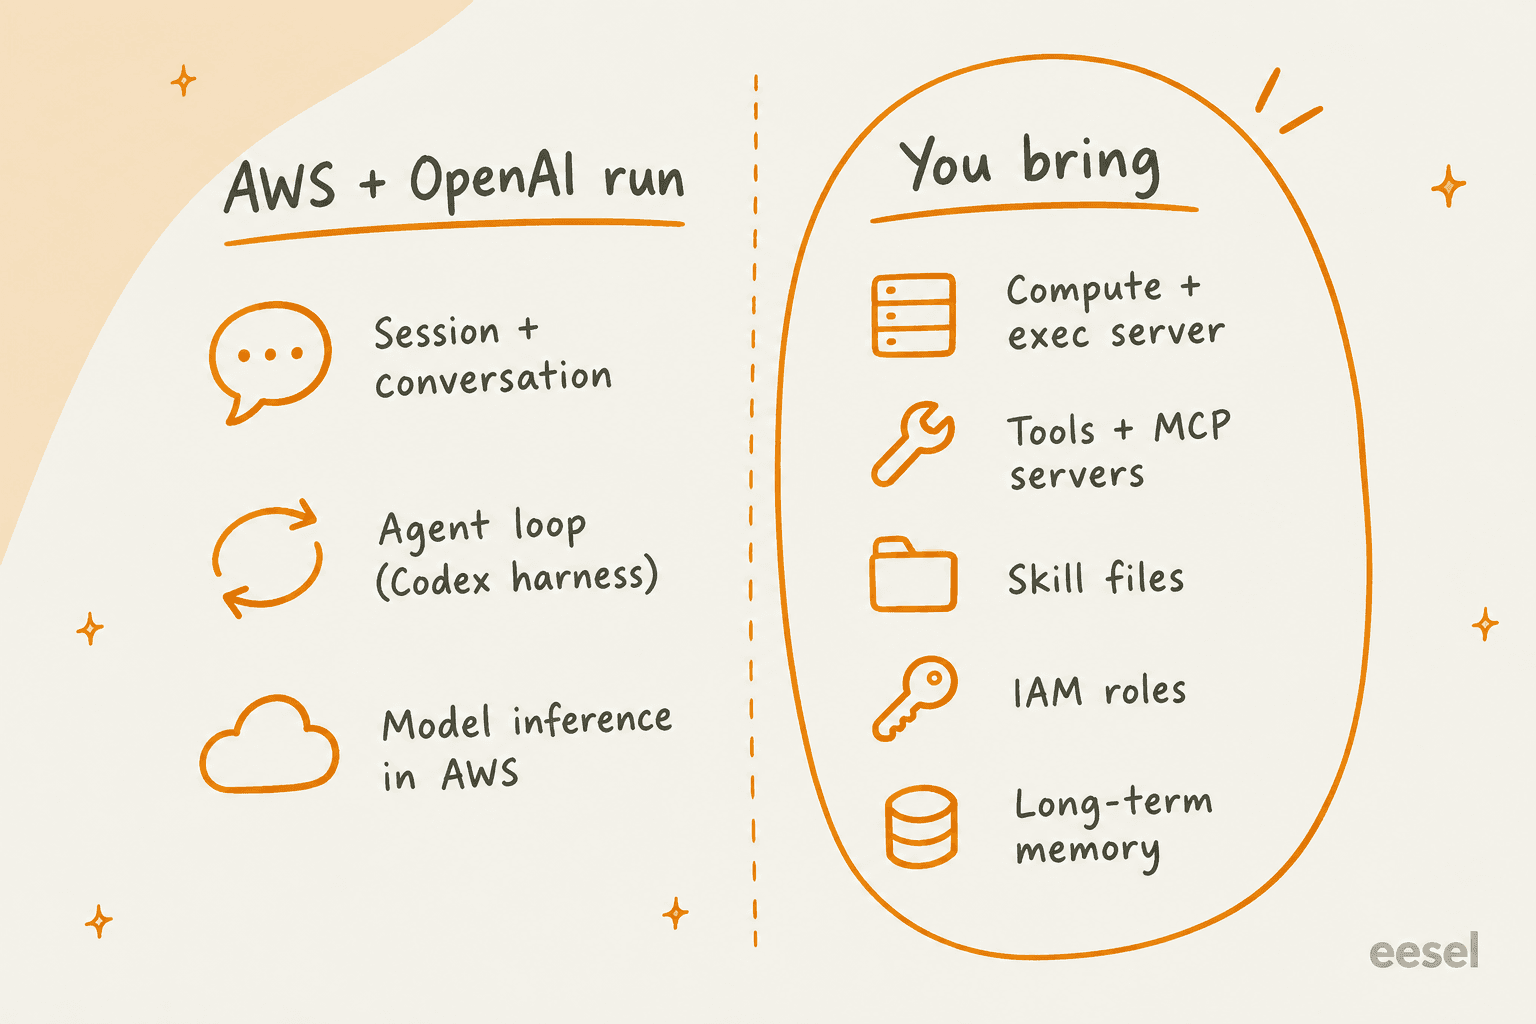
- 入力はテキストのみ。 ドキュメント化されているセッション入力はテキストです。
- サブエージェントもcode modeもなし。 AWSはセッション設定で有効にしないよう述べているため、サブエージェントのオーケストレーションパターンは今のところ使えません。
- 長期メモリなし。 「The preview does not provide a built-in long-term memory integration; provision and authorize any application-specific datastore separately.」
- クロスリージョン推論なし。 後述するとおり、価格に影響します。
- サービス管理のセッションデータに、カスタマーマネージドKMSキーは使えません。
- コンソールなし。 すべてAPIとAWSのサンプルバンドル経由です。
- 専用のターン一覧APIなし。 ターンはアイテムの
turn_idの値で突き合わせます。
見落としやすいギャップがあります。ローンチのメッセージでは、マネージドランタイムが「handles inference, memory, and skills」(AWS)を担い、同じプレビュー発表によれば各エージェントは「supports human approval before consequential actions」とされています。しかし、どちらも開発者向けドキュメントはもっと限定的な書き方をしています。メモリは1つのセッション内の文脈を意味し、外部に影響する操作については、セキュリティガイドが「enforce authorization and any required human review in the application or tool implementation」(セキュリティドキュメント)と述べています。つまり、ヒューマン・イン・ザ・ループの関門は、スイッチで有効にするものではなく、自分で作るものです。
プレビューとしては、どれも珍しいことではありません。ただし、今日使えるバージョンは、完成したエージェントプラットフォームというより「マネージドなループと良質なサンプルリポジトリ」に近いということです。OpenAI自身のBMAページには、文字どおり受け取るべき注意書きがあります。「Shared concepts don't imply identical API contracts or feature availability.」OpenAI Agents APIのリクエストをそのままコピーしても、Bedrockで動くとは限りません。
Bedrock Managed Agentsの料金
AWSの価格の記述は短いものです。「During preview, there is no additional charge for BMA beyond the underlying AWS resources your agents consume. Pricing is subject to change at general availability」(AWS What's New)。ドキュメントでは「基盤となるリソース」の意味を、モデル推論とアプリが使うAWSリソースと説明しており、AgentCoreのサンプルは「can continue to incur charges when no BMA turn is running」(AWSドキュメント)としています。
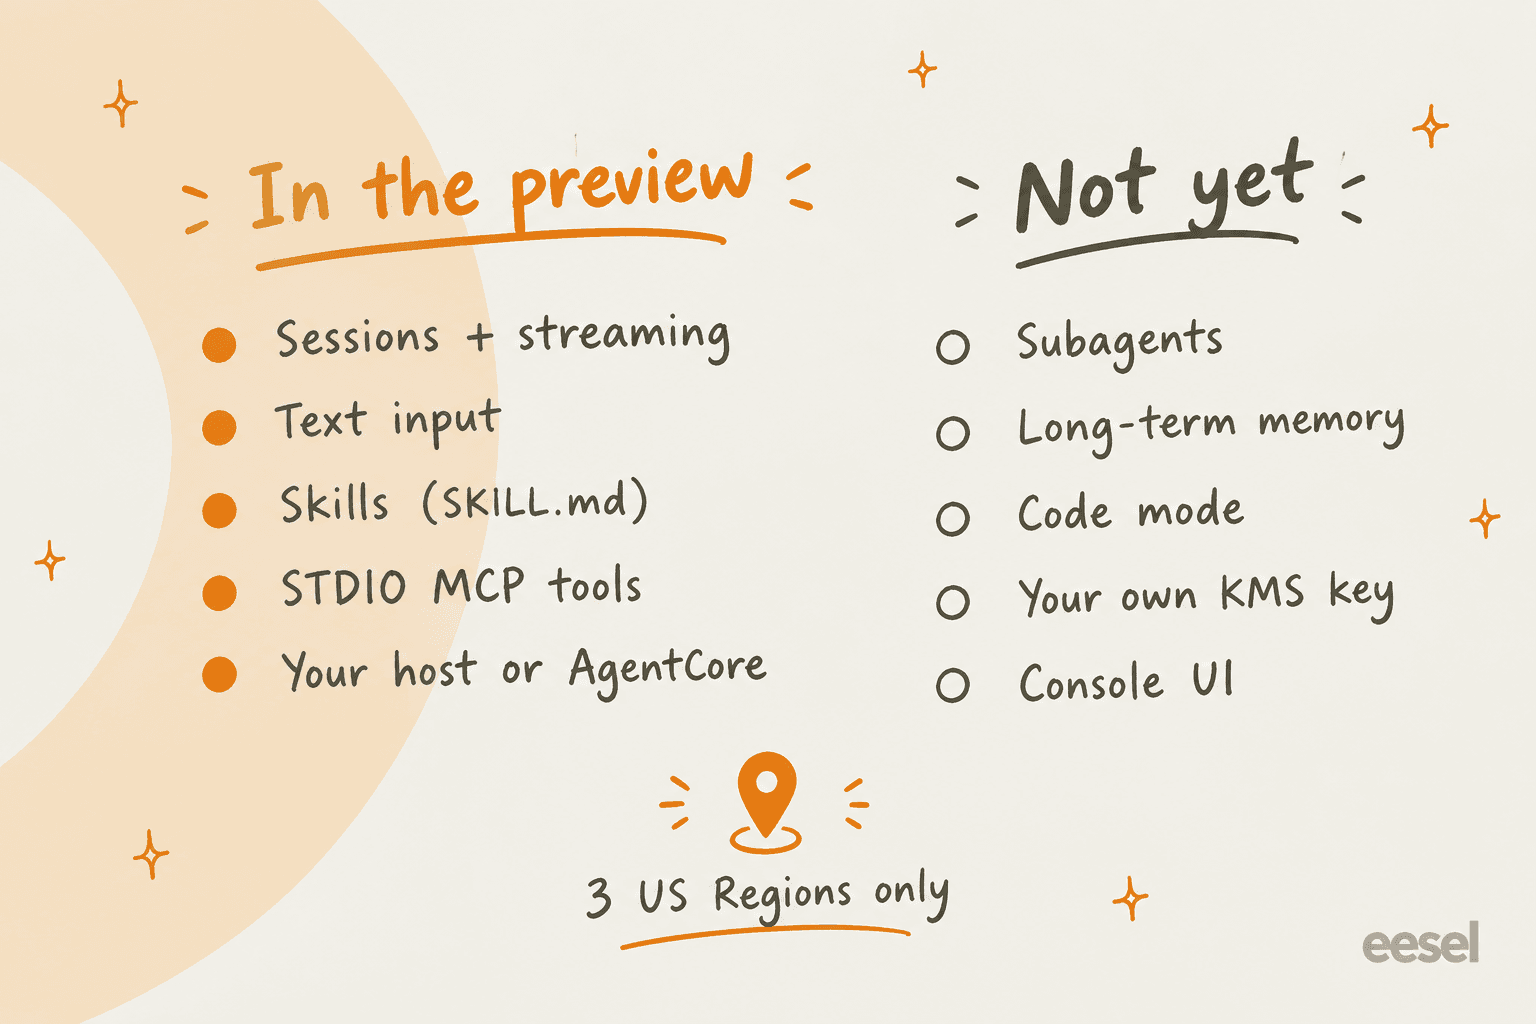
1行目:In-Regionレートのモデルトークン
BedrockのOpenAIモデルは、どれも価格がモデルカードに載っています。落とし穴は、BMAのプレビューがクロスリージョン推論プロファイルに対応していないため、In-Regionレートを支払うことになる点です。AWSは「Commercial In-Region prices include a 10% fee over OpenAI rates」(GPT-5.6 Lunaのカード)と記しています。以下は、100万トークンあたりの短コンテキスト(入力272Kトークン以下)の料金です。
| モデル | 入力(In-Region) | キャッシュ入力 | 出力(In-Region) | グローバル料金(OpenAIと同じ、入力 / 出力) |
|---|---|---|---|---|
| GPT-5.6 Luna(BMAサンプルのデフォルト) | $0.22 | $0.022 | $1.32 | $0.20 / $1.20 |
| GPT-6 Luna | $0.11 | $0.011 | $0.55 | $0.10 / $0.50 |
| GPT-6.1 Sol | $2.20 | $0.11 | $11.00 | $2.00 / $10.00 |
| GPT-5.6 Terra | $2.20 | $0.22 | $13.20 | $2.00 / $12.00 |
| GPT-5.6 Sol | $4.40 | $0.44 | $22.00 | $4.00 / $20.00 |
| GPT-6 Astra | $11.00 | $1.10 | $55.00 | $10.00 / $50.00 |
各料金は、そのモデルのBedrockカードから取っており、すべてAWSのOpenAIモデルのページからリンクされています。AWSはBMA対応モデルの固定リストを公開しておらず、GPT-6.1 Solのカードには、BedrockではそのモデルでExplicit prompt cachingが未対応と書かれています。キャッシュ割引をあてにする前に、ご自身のモデルを確認してください。長いコンテキスト(入力272K超。100万超のコンテキストウィンドウのごく一部)では、さらに高くなります。GPT-5.6 Solは、入力$8.80、出力$33.00に跳ね上がります。
2行目:ランタイムの稼働時間
AgentCore Runtimeを使う場合は、そのコンピュート料金がかかります。v2のmicroVMでは、vCPU時間あたり$0.1276、GB時間あたり$0.0169で、秒単位課金です。AWSによれば、モデルの返答待ちなどI/O待ちの間はCPUが課金されません(AgentCoreの料金)。セルフホストなら、ホストにすでにかかっている費用だけです。
3行目:誰も触れないNATゲートウェイ
AWSのAgentCoreサンプルスタックは、NATゲートウェイを1つ作ります。公表されている米国東部の料金では、1時間あたり$0.045に、処理したGBあたり$0.045が加わり、端数の時間も1時間として課金されます(Amazon VPCの料金)。1か月(730時間)動かし続けると、エージェントが何もしなくても月額約$33です。企業にとっては小さな金額です。それでも、誰かがクリーンアップ手順を実行し忘れて3か月後に、開発アカウントの請求に現れるタイプの項目です。
試算例
エージェントの1タスクで、コードベースとドキュメントを読み込むとします。入力200,000トークン、出力20,000トークン、2 vCPU / 4 GBのAgentCoreセッションで約10分です。
- GPT-5.6 Lunaの場合: 入力$0.044 + 出力$0.026 = トークン代で約**$0.07**。
- GPT-5.6 Solの場合: 入力$0.88 + 出力$0.44 = トークン代で約**$1.32**。
- ランタイムの上限: 2 vCPU x $0.1276 + 4 GB x $0.0169 = CPUが常にフル稼働した場合で1時間あたり$0.32、つまり10分で約$0.05。モデルの待ち時間はCPU課金されないため、実際はそれ以下です。
結論:モデルの選択で請求額が約19倍動くのに対し、ランタイムはほとんど動かしません。少量のうちは固定費(NATゲートウェイ、ストレージ)が目につき、大量になるとトークン代が支配的になります。OpenAIのホスト版で同じ計算をしたい場合は、20分あたりのコンテナ料金を扱ったAgents APIの料金の記事と、AWSの請求全体を扱ったAWSの料金のガイドをご覧ください。
他のマネージドエージェント基盤との比較
主要なラボはどこも、今や「エージェントループはこちらで動かします」という形のサービスを売っています。本当に違うのは、ループとツールという2つがどこにあるかです。
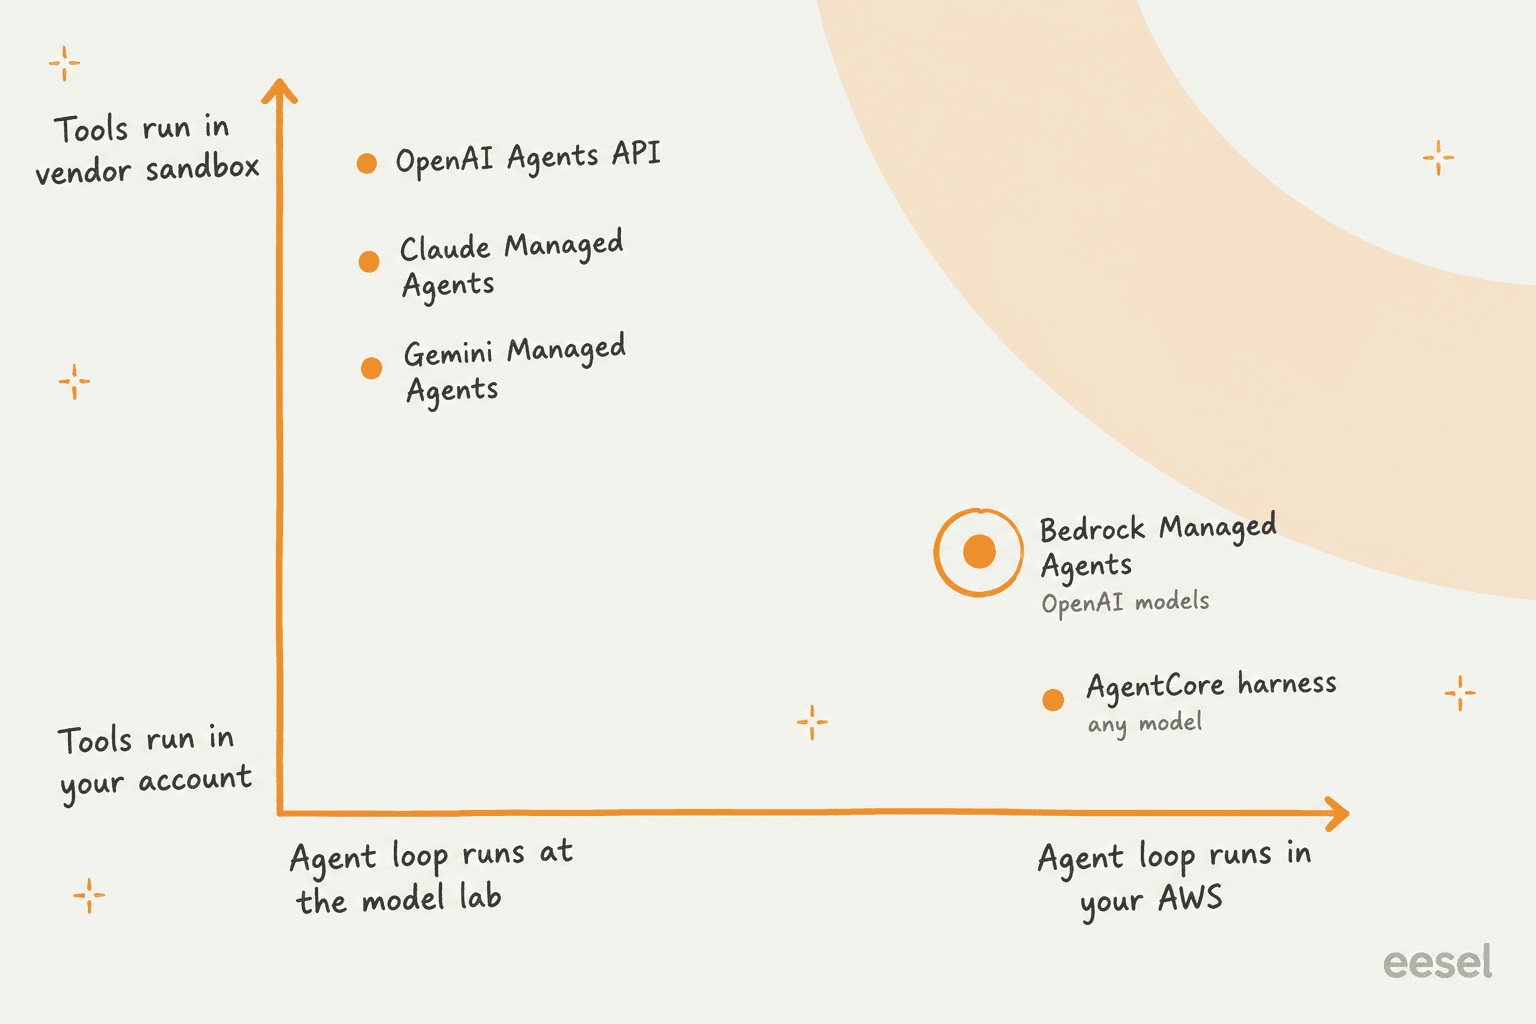
Claude Managed AgentsとOpenAIのAgents APIにもセルフホストのサンドボックスがあるため、左上のグループは「唯一のモード」ではなく「デフォルト」です。ただし、その場合でもオーケストレーションはラボ側に残ります。Anthropic版ではツールの入出力がAnthropicのコントロールプレーンに流れ続け、OpenAI版ではセルフホストのサンドボックスを選んでもツールの実行場所が移るだけです。OpenAIのハーネス、OpenAIのモデル、そして自分のツールのすべてをAWS内にとどめられるのは、ここではBMAだけです。
| Bedrock Managed Agents | Claude Managed Agents | OpenAI Agents API | Gemini Managed Agents | AgentCoreハーネス | |
|---|---|---|---|---|---|
| ステータス | パブリックプレビュー、米国3リージョン | ベータ | パブリックベータ(2026年9月10日) | パブリックプレビュー(2026年5月19日) | 一般提供 |
| モデル | BedrockのOpenAI | Claudeのみ | OpenAIのみ | Geminiのみ | Bedrock、OpenAI、Gemini、LiteLLM対応の任意のプロバイダー |
| ツールの実行場所 | 自前ホストまたはAgentCoreのみ | Anthropicのサンドボックスまたは自前 | OpenAIのサンドボックス、自前、パートナープロバイダー、またはなし | Googleのサンドボックス(4 CPU / 16 GB) | 自分のアカウント内のセッション単位のmicroVM |
| ランタイム料金 | プレビュー中はなし | 稼働中は1セッション時間あたり$0.08 | 20分コンテナあたり$0.03〜$1.92。セルフホストはなし | プレビュー中はコンピュート課金なし | vCPU時間あたり$0.1276 + GB時間あたり$0.0169 |
| 長期メモリ | なし(プレビュー) | メモリストア | 未公表 | なし(ファイルは7日間保持) | AgentCore Memory |
| MCP | 実行環境内のSTDIO | リモートサーバー + トンネル | リモートまたはローカル | リモートHTTP | AgentCore Gateway経由 |
| サブエージェント | なし | あり(マルチエージェント) | あり | 未公表 | 未公表 |
この表には、もう一度見ておきたい点がいくつかあります。
AgentCoreハーネスはBMAにとって最も近いライバルで、同じAWS製です。 GAであり、「any model provided by Amazon Bedrock, OpenAI, Google Gemini, or any LiteLLM-compatible provider」に対応し、ハーネス単体の追加料金はありません(AgentCoreハーネス)。AWSは従来のBedrock Agentsもメンテナンスモードに移行しています。名称がBedrock Agents Classicに変わり、2026年7月30日に新規顧客の受け付けを終了し、新規構築にはハーネスを案内しています(AWSドキュメント)。したがって、OpenAIのハーネスにこだわる理由がなければ、私ならそちらから始めます。
Claude Managed Agentsは、現時点でより完成度の高い製品です。 メモリストア、マルチエージェントのオーケストレーション、ベンダーのサンドボックス、リモートMCPがあり、AnthropicのClaude Platform on AWS経由でも利用できます。ただしその経路では、データを処理するのはAWSではなくAnthropicです。「AWSが唯一の処理者であること」が要件なら、BMA(または私がBedrockでのClaude Codeで扱ったAmazon BedrockのClaude)のほうがすっきりした答えです。より広い一覧は、OpenAI Agents APIの代替のまとめをご覧ください。
Bedrock Managed Agentsの始め方
最速の道は、AWSのセルフホストのサンプルです。AWS CLIがすでに設定済みなら、1時間ほどを見込んでください。AWSのセルフホストのチュートリアルに、コマンドがすべて載っています。
- ツールをインストールする。 Node.js 20以上、AWS CLI v2、SigV4対応の
curl、jq、Codex CLI 0.154.0以降(codex exec-serverを含む)。 - リージョンとエンドポイントを選ぶ。
us-east-1、us-west-2、us-east-2のいずれかで、エンドポイントはhttps://bedrock-mantle.<region>.api.aws。 - サンプルバンドルをダウンロードする。 あわせて、ホストに合ったCodexバイナリも用意します(AgentCoreでは常にLinux ARM64)。
- IAMロールをデプロイする。
self-hosted/フォルダでnpm ci、npx cdk bootstrap、npm run deployを実行します。クライアントロールと、BMAが引き受けるセッションロールができます。 - セッションを作成し、execサーバーを接続して、ターンを送信する。 バンドルの番号付きスクリプト(
0.create-session.sh、1.attach-exec-server.sh、2.submit-turn.sh、3.read-result.sh)が順に案内します。
最初の実行でつまずく原因は、たいていIAMのモデルです。IDは3つあります。呼び出し元(BMAの権限に加え、セッションロールへのiam:PassRoleが必要)、セッションロール(bedrock-mantle.amazonaws.comから信頼され、対象モデルへのbedrock-mantle:CreateInferenceが許可されている)、そして実行環境が使うIDです(セキュリティドキュメント)。始める前にトラブルシューティングのページをブックマークしておくと役立ちます。特に、各ターミナルでAWS_PROFILEを確認する、という部分です。また、専用のワークスペースを使ってください。「the agent can use the files, tools, and permissions available to that environment.」からです。
構築者たちの声
パブリックプレビューが始まったのは今週なので、実際に使ったフィードバックはまだ少ない状況です。あるのは、AWSを日常的に使っている人たちのローンチ時の反応で、魅力についてはおおむね一致しています。
"Bedrock Managed Agents (limited preview): AWS runs OpenAI's agent harness, and all inferences run through Bedrock. Basically, you'd use the OpenAI SDK against AWS-owned infrastructure, and your data stays in AWS.
AgentCore Runtime is the only one that's GA right now, so it's the only viable option if you need something for production."

コンプライアンスの観点は、最初のローンチを扱ったHacker Newsのスレッドで繰り返し出てきます。
"This would be a nice compliance win. One less sub-processor and all our data is already on AWS so less worrying about sending it off somewhere else"

懐疑的な声にも耳を傾ける価値があります。アナリストのMitch Ashley氏は、ロックインの問題をはっきり指摘しました。
"The question for enterprise architects is whether AgentCore stays open enough to govern non-AWS execution, or quietly becomes the lock-in seam."
そして、BMAがデフォルトで使うコンピュート層について、あるHacker Newsのコメント投稿者は遠慮なく語りました。
"There's not really a good solution, as AgentCore runtime sucks and is expensive. You basically have to build this yourself because nobody is solving for self-hosted managed infra for agents, and we don't really have the time to build this sort of system on top of building our actual product."
最後の一文の「on top of building our actual product」こそが、マネージドエージェント基盤の本質です。インフラの仕事は小さくなりますが、プロダクトの仕事は依然として自分のものです。
Bedrock Managed Agentsを使うべき人、使わないほうがいい人
使うべき人: すでにAWSに深く入り込んでいて、セキュリティや調達の部門がAWSは承認したが新しいAIベンダーは承認していない、そしてOpenAIのハーネスとモデルを特に使いたい場合です。エージェントごとのIAMモデル、CloudTrailのログ、「アカウントの外に何も出ない」という説明が本当の価値で、OpenAIモデルでは他ではなかなか得られません。
待つべき人: サブエージェント、長期メモリ、画像入力、米国3リージョン以外のどれかが必要な場合です。どれもプレビューにはなく、GAの日程もありません。
見送るべき人: OpenAIモデルにこだわらない場合(AgentCoreハーネスはGAでモデル非依存です)、またはベンダーにサンドボックスも運用してほしい場合(Claude Managed AgentsまたはOpenAIのホスト型Agents API)です。
よく考えるべき人: 本当の目的がサポートチケットに回答するようなビジネス向けエージェントの場合です。サポートエージェントは、ランタイムではなく製品です。このパターンはよく目にします。eesel自身の解約メモでは、AR・建設テック企業やDTCの美容ブランドなど複数のお客様が、LLM APIの上に直接サポートエージェントを作るために離れていきました。逆の道を選んだ方もいます。Confluenceに300本以上の記事のナレッジベースを持つ、ビットコインATMハードウェア企業のエンジニアリングリードは、購入を選んだ理由をeeselチームにこう語りました。
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
BMAは「作る」道のりを短くします。ただし、ヘルプデスク連携、ナレッジ検索、エスカレーションのロジック、テストはなくなりません。そして、何か月もかかるのはまさにその部分です。
配管ではなくエージェントが欲しいチームへ:eesel
Bedrock Managed Agentsはインフラです。eeselは従業員です。具体的には、eeselは決まった仕事を担う即戦力のAIチームメイトを採用できるプラットフォームで、サポートならAIヘルプデスクチームメイトです。ZendeskやFreshdesk、Gorgiasなどのヘルプデスクに数分で接続し、過去のチケットとヘルプセンターから学び、実際のお客様に返信する前に、数百件の過去チケットを使ったシミュレーションで実行されます。eesel自身の顧客統計では、Gridwiseは最初の1か月でティア1チケットの73%を解決しました。
BMAに注目した理由が、ターミナルからエージェントを操作するのが好きだから、という場合も、eeselにはそれがあります。eesel CLI(@eesel/cli)は、ダッシュボードで見るのと同じチームメイトとワークスペースを操作します。連携の接続、エージェントの常設指示の編集、eesel approvalsでの保留中アクションの承認や却下、eesel activityでの全実行の確認ができます。すべてのコマンドはJSONを出力し、書き込みコマンドは--dry-runで送信前に正確な呼び出しを確認でき、ヘッドレス認証はCIでも動きます。Claude Code、Codex、Cursorなどのコーディングエージェントからも操作でき、各ワークスペースはMCPサーバーも公開しています。BMAのAPIファーストの設計と同じ発想を、空のループではなく完成したサポートエージェントに向けたものです。
eeselを無料で試すことができます。料金は、100クレジットの無料プランから始まり、有料プランは500クレジットで月額$299からです。チケットまたはチャット1件の対応が1クレジットです。
よくある質問
Amazon Bedrock Managed Agentsとは何ですか?
Bedrock Managed Agentsの料金はいくらですか?
Bedrock Managed Agentsは一般提供されていますか?
Bedrock Managed AgentsとOpenAI Agents APIの違いは何ですか?
Bedrock Managed Agentsにメモリはありますか?
Bedrock Managed Agentsはどのモデルに対応していますか?
カスタマーサポートにBedrock Managed Agentsを使うべきですか?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.