なぜ人々はGPT-6 Lunaの代替を探すのか
まずはLunaに対してフェアでいたい。それに値するモデルだからだ。OpenAIが2026年9月23日にSolとLunaを発表したとき、見出しはGPT-5.6世代と比べて一律50%の値下げというものだった。Simon Willisonは発表スレッドでその空気感をこうまとめている。
"GPT-6 Luna being half the price of GPT-5.6 Luna is a really big deal."

1Mトークンあたり$0.10/$0.50、1.05Mトークンのコンテキストウィンドウ、そして画像入力対応と、Lunaはその価格にしては非常に高性能なモデルだ。また、ChatGPTのFreeとGoで使える唯一のGPT-6モデルであるため、何百万人ものデフォルトの低価格モデルにもなっている。別のコメント投稿者はその価値をこう端的に表現した。
"6-luna is at the pareto for most of the tasks! I dont know how they make money here but its insane value from a closed source model."
では、なぜ他を探すのか。繰り返し挙がる本当の理由は3つある。
- 大量利用時の価格。 分類器や要約器、バッチパイプラインで毎日何百万ものトークンを処理しているなら、Lunaのわずかな出力単価でも積み重なっていき、いくつかのモデルはそれより低い価格を提示している。
- オープンウェイト。 Lunaはクローズドで、APIでしか使えない。プライバシー、主権、コスト管理の理由で自前ホストが必要なら、OpenAIを完全に離れる必要がある。
- 特定の強み。 より豊かなマルチモーダル入力(音声、動画、PDF)、ライブチャットウィジェット向けのより速い応答時間、あるいはすべてを西側インフラに留めるデータポリシー。Lunaは優れたジェネラリストだが、これらのどれにおいても先頭ではない。
ここで、多くの人がまず見る一つの数字、1Mトークンあたりの出力価格において、8つの代替モデルが実際どのあたりに位置するかを示す。
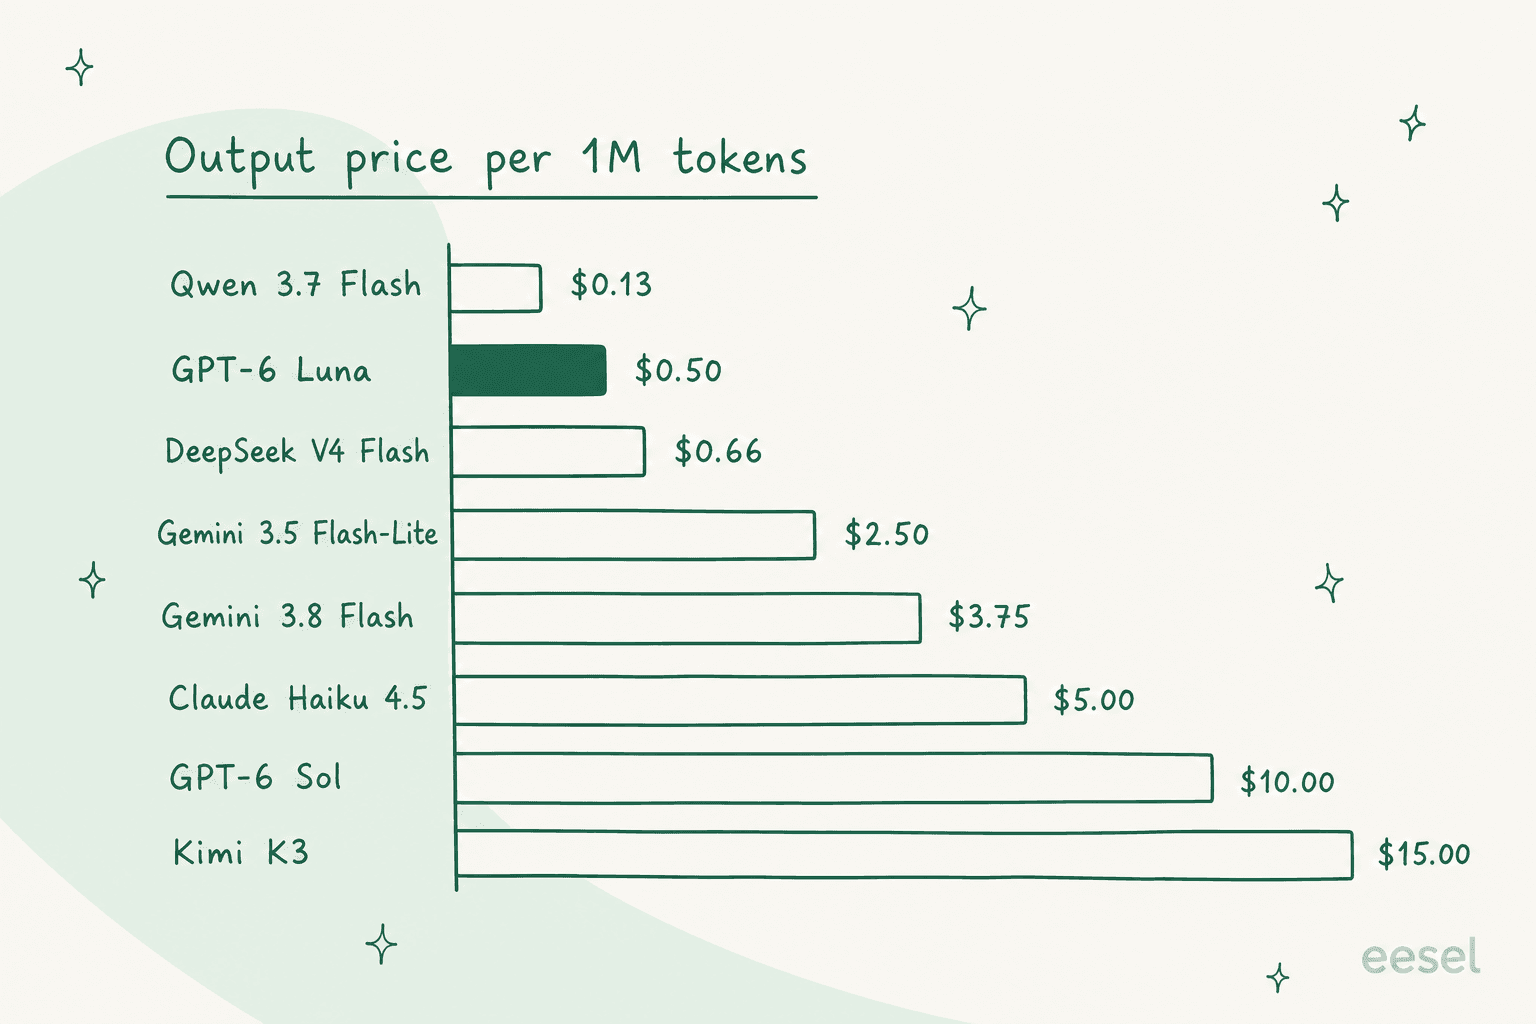
これらの代替モデルをどう選んだか
このリストは、本当にLunaと同じ重量級に属するモデル、つまり安く、速く、大量利用や軽量な用途向けに作られたモデルに絞った。一日中コードを書くために使うような、OpenAIのモデル一覧にあるフロンティア級のフラッグシップは含めていない。GPT-6 AstraやClaude Opusもここには含めなかった。Lunaの出力価格の20倍から100倍もするモデルは「代替」ではなく、まったく別の予算だからだ。(フロンティア級のエンジンこそ本当に欲しいなら、私のGPT-6 Astra代替のまとめのほうが読む価値がある。)
各モデルについて、ベンダー自身の料金表に基づく実際のトークン単価、コンテキストウィンドウ、ウェイトがオープンかどうか、入力として何を受け付けるか、そして実際にどこで優れていてどこで劣るかを見た。以下はすべて一次情報源に基づく価格であり、モデルの価格設定が特殊な場合(段階制、ピーク/オフピークの割増、値上げ予定など)は明記した。こうした癖こそが「安い」モデルを予想外の請求額に変える原因だからだ。
全体像をざっと見てみよう。
| モデル | 最適な用途 | 入力 $/1M | 出力 $/1M | コンテキスト | オープンウェイト | 画像入力 |
|---|---|---|---|---|---|---|
| GPT-6 Luna(現行) | バランスの取れたデフォルト | $0.10 | $0.50 | 1.05M | いいえ | はい |
| Gemini 3.8 Flash | マルチモーダルなバッチ処理 | $0.75 | $3.75 | 1M | いいえ | はい |
| Gemini 3.5 Flash-Lite | 最安のマルチモーダル | $0.30 | $2.50 | 1M | いいえ | はい |
| Claude Haiku 4.5 | ドル当たりの信頼性 | $1.00 | $5.00 | 200K | いいえ | はい |
| DeepSeek V4 Flash | 最安のオープンウェイト | $0.22 (off-peak) | $0.66 (off-peak) | 1M | はい (MIT) | いいえ |
| Qwen 3.7 Flash | 小規模プロンプトでの最安単価 | $0.03-$0.20 | $0.13-$0.80 | 1M | いいえ | はい |
| Kimi K3 | オープンウェイトのヘビー級 | $3.00 | $15.00 | 1M | はい | はい |
| GPT-6 Sol | OpenAI内に留まり、より余裕を持つ | $2.00 | $10.00 | 1.05M | いいえ | はい |
| Grok 4.7 | エージェントループとリアルタイム性 | $2.00 | $6.00 | 500K | いいえ | はい |
それでは、各モデルを見ていこう。
1. Gemini 3.8 Flash
最適な用途: マルチモーダル入力と、夜間のノンインタラクティブな処理での大規模なスループットを求めるチーム。
Gemini 3.8 FlashはGoogleの最新Flashモデルであり、正直な位置づけはGoogle自身が示している通りだ。新しいベースモデルではなく、Gemini 3.7 Flashの上に直接構築されている。モデルカードにも、4つの異なるセクションでそのことがはっきり書かれている。3.7と同じ価格で得られるのは、「より頑張って働く」モデルであり、追加の推論ステップを実行し、ツールをより頻繁に呼び出す。難しいタスクには最適だが、簡単なタスクには無駄が多い。
Lunaを明らかに上回るのは入力面だ。テキスト、画像、音声、動画、PDFのすべてを受け付けるのに対し、Lunaはテキストと画像のみだ。また、Artificial AnalysisのIntelligence Indexでも59という強いスコアを記録しており、そのクラスの中央値を大きく上回る。
メリット:
- 音声、動画、PDFを含む完全なマルチモーダル入力に対応(Lunaは非対応)。
- 生のスループットが本当に速い:302トークン/秒で、Artificial Analysisの速度ランキングでほぼトップに位置する。
- 無料プランと1Mトークンのコンテキストウィンドウ。
デメリット:
- あまり報じられていない数字が最初のトークンまでの時間だ。Artificial Analysisの計測では
13.3秒で、クラス中央値の約3秒と比べてかなり遅い。これはチャット返信のように人間が待つ用途では致命的だが、夜間のバッチ処理には無関係だ。 - 価格は2027年1月1日に倍増し、
$1.50/$7.50になる。Google自身も、効率を重視する開発者には3.7 Flashに留まるよう勧めている。
価格: 2026年12月31日まで1Mトークンあたり$0.75入力/$3.75出力で、2027年1月からはちょうど2倍になる。BatchとFlexは50%オフだ。各段階の詳細はGeminiの価格ページで確認できる。
私の見解: 音声や動画を入力する必要があり、かつ処理がインタラクティブでない場合は、LunaよりGemini 3.8 Flashを選ぶとよい。ライブチャットウィジェット用途では、この最初のトークンまでの時間の数値が致命的なので、代わりにFlash-LiteかLunaを検討したい。
2. Gemini 3.5 Flash-Lite
最適な用途: Googleのマルチモーダル入力を大量に、最も安く使う方法。
Gemini 3.8 Flashが「より頑張って働く」モデルなら、Flash-Liteは「とにかく安くて速い」ことを目指すモデルだ。Gemini 3.5シリーズの中で低価格・高スループットを担う存在であり、GoogleによるLunaへの最も直接的な回答と言える。テキスト、画像、動画、音声、PDFという同じ豊富な入力を受け付けてテキストを返し、コンテキストウィンドウは約1Mトークンだ。Googleの他の選択肢をもっと知りたければ、より幅広いGemini代替の記事も参考になる。
際立つスペックは速度だ。Artificial Analysisの計測では出力速度が約490トークン/秒とこの分野のほぼトップに位置し、3.8 Flashのレイテンシ問題とはまったく違う世界にある。トレードオフは知性の面で、Intelligence Indexは36にとどまるため、分類・抽出・ルーティングの働き手であり、重い推論を要するタスク向きではない。
メリット:
- 本当に低価格なマルチモーダル入力。
- 出力が非常に速く、3.8 Flashでは難しいインタラクティブ用途にも対応できる。
- Google自身の比較によれば、両方の料金指標でClaude Haiku 4.5より安い。
デメリット:
- 知っておくべき本当の機能的な欠落が一つある。モデルページではコンピュータ操作が非対応と記載されており、ブラウザを操作するエージェントを構築するには向かない。
- Lunaより生の知性が低く、用途が狭いツールだ。
価格: 1Mトークンあたり$0.30入力/$2.50出力(標準)。BatchとFlexはこれを半分の$0.15/$1.25にする。無料プランはあなたのコンテンツで学習するため、機密データには向かない。
私の見解: これは、安価で大量のテキストと画像処理においてLunaと実際に真っ向勝負させたいGeminiモデルだ。出力価格はLunaより高いが、画像を含む用途であれば、マルチモーダル対応と速度がその差に見合う価値を持つ。
3. Claude Haiku 4.5
最適な用途: ファストティアの価格でClaudeファミリーならではの信頼性と指示追従性を求めるチーム。
Claude Haiku 4.5はAnthropicの小型で高速なモデルであり、ここでの真の「安価」ティアの中では$1.00/$5.00と最も高価だ。その対価として得られるのは、慎重な指示追従と、脱線しにくいというAnthropicの評判である。これはモデルの出力が何か自動化された処理に流れ込む場合に大きく重要になる。
コンテキストウィンドウは他より小さく(1Mではなく200K)、ほとんどのタスクには十分だが、コードベースやナレッジベース全体を一つのプロンプトに詰め込みたい人にとっては本当の制約になる。
メリット:
- Claudeらしい、強力で予測可能な指示追従性。
- 応答が速く、インタラクティブな用途にも使える。
- Claudeのエコシステム、ツール、ドキュメントは非常に優れている。
デメリット:
- Lunaの出力単価の10倍のため、単純な大量利用ではこのグループの中で高価な選択肢になる。
- 200Kのコンテキストはここでは最小。
- オープンウェイトではなく、1Mトークンモデルのような巨大コンテキストのオプションもない。
価格: 1Mトークンあたり$1.00入力/$5.00出力。プロンプトキャッシュとバッチ割引が適用され、反復的なワークロードでは実効単価が下がる。
私の見解: 信頼性が気がかりで、プロンプトが200Kに収まるなら、HaikuはLunaに対するプレミアムに見合う価値がある。最安の請求額を追求しているなら向いておらず、以下で紹介する中国製のオープンモデルのどれかが、同じ定型作業をはるかに低いコストでこなしてくれるだろう。
4. DeepSeek V4 Flash
最適な用途: 実際にダウンロードして自前でホストできる、オープンウェイトの中で最も安い選択肢。
DeepSeek V4 Flashは低価格チャンピオンともいえる選択肢であり、価格に関する注釈が最も重要になるモデルでもある。総パラメータ284B/アクティブパラメータ13Bのミクスチャー・オブ・エキスパートモデルで、MITライセンスのもとでダウンロード可能なウェイトとして公開されており、自前のハードウェアで動かすことができる。
この定価に心躍る前に知っておくべきことが2つある。まず、テキスト専用であり、画像入力は文書化されていない。次に、公式APIはピーク/オフピーク料金制を採用しており、オフピークでは1Mあたり$0.22/$0.66、ピーク時には$0.44/$1.32に上がる。ピーク時間帯はUTCの01:00〜10:00(中国のビジネスアワー)であるため、米国や欧州のキューは大部分が安いオフピーク料金で請求される。これは都合が良い癖であると同時に、不安定な癖でもある。
さらに、Lunaの発表スレッドで直接持ち上がった、もう少し微妙なコストの落とし穴もある。あるコメント投稿者が自分のDeepSeekとLunaの請求額を比較したところ、別の人からこんな反論があった。
"This isn't right. You're comparing cost per token, but DeepSeek V4 Flash uses more tokens. Artificial Analysis found GPT 6 Luna to be significantly cheaper than DeepSeek."
このやり取りに、このカテゴリー全体の本質が詰まっている。DeepSeekは饒舌であり、おしゃべりなモデルは同じ仕事を終えるのにより多くのトークンを使うため、トークン単価が低くても請求額が低くなるとは限らない。
メリット:
- MITのオープンウェイトなので、自前でホストしてデータを社内に留められる。
- ここで紹介する実用的なモデルの中で公開されている最安のトークン単価(オフピーク時)。
- 巨大な1Mトークンのコンテキストと組み込みの推論機能。
デメリット:
- テキストのみで、文書化された画像入力はない。
- 饒舌な出力が、実際のタスクにおけるトークン単価の節約分を帳消しにすることがある。
- 有料APIの利用規約は学習利用について明示的に許可しているわけではなく沈黙しており、データは中国の法律の下に置かれるため、顧客データにそのまま使えるものではない。
価格: オフピークで1Mあたり$0.22入力/$0.66出力、ピークで$0.44/$1.32。推論用トークンは出力単価で課金され、thinkingはデフォルトでオンになっているため、その分も予算に含める必要がある。
私の見解: オープンウェイトと絶対的な最低コストが欲しいなら、DeepSeek V4 Flashは試す価値がある。ただし、実際のプロンプトでテストし、単価だけでなくトークン数を測定してほしい。顧客データについては、この「沈黙している」学習ポリシーを、公式APIを使わずに自前でホストする理由として捉えるべきだ。
5. Qwen 3.7 Flash
最適な用途: ドキュメントが薄くても構わないなら、小規模プロンプトでの見出し上の最安単価。
AlibabaのQwen 3.7 Flashは、この表全体の中で最も低い数字、1Mあたり$0.03/$0.13を提示しているが、見逃せない注釈がある。価格はプロンプトサイズによって段階制になっているのだ。この安い単価は32Kトークン未満でのみ適用される。32Kから256Kでは$0.10/$0.40に、256Kから1Mでは$0.20/$0.80に上がる。つまり「最安のビジョンモデル」という単価と「1Mコンテキスト」は、同じ呼び出しの中で両立しない。
もう一つ正直に言っておくべきなのは、このモデルについてはほとんど何も独立して検証されていないということだ。Alibabaはベンチマークもアーキテクチャもパラメータ数も公開しておらず、ウェイトはクローズドだ。唯一の第三者評価であるRoboflowのビジョンテストでは、総合23モデル中22位にランクされている一方、コスト面では23モデル中1位だ。そして、ここでの「Flash」は安いという意味であって速いという意味ではない。約59トークン/秒しか出ず、GeminiのFlash-Liteよりはるかに遅い。
メリット:
- 小規模プロンプトにおいて、ここで最も安い入力単価。
- DeepSeekと違い、画像入力に対応している。
- 1Mトークンのコンテキストも利用可能(最高価格帯において)。
デメリット:
- 段階制の価格により、大きなプロンプトでは安い単価が消え去る(最高価格帯では入力が6.7倍高くなる)。
- 出力が遅く、ドキュメントも薄く未検証。
- ウェイトはクローズドで単一ベンダーのため、自前ホストもフォールバックのルーティングもできない。
価格: プロンプトサイズによる3段階で、32K未満の$0.03/$0.13から256K〜1Mの$0.20/$0.80まで。決める前にQwenの価格全体を確認してほしい。
私の見解: Qwen 3.7 Flashは、コストがすべてを決め、品質を自分で検証できるなら、大量かつ短いプロンプトのビジョンタスクに非常によく合う。大きなコンテキストや文書化されたベンチマークが必要な用途には見送りたい。もっと余裕が欲しいなら、私のQwen代替の記事でQwenファミリー全体を紹介している。
6. Kimi K3
最適な用途: 本当にオープンウェイトのヘビー級モデルを求め、その対価を払う覚悟があるチーム。
Kimi K3はこのリストの中で異色の存在であり、あえて意図的に含めている。1Mあたり$3/$15と決して安くはなく、Claude Sonnetと同じ価格帯に位置し、Lunaの出力単価のおよそ30倍だ。ではなぜここに載せているのか。人々が有能なモデルを完全に自分のものとして所有したいときに頼るオープンウェイトモデルであり、そのウェイトは実際に予定通りHugging Faceで公開されたからだ。
総パラメータ2.8T/アクティブパラメータ104Bのミクスチャー・オブ・エキスパートモデルで、ネイティブなビジョン対応、1Mトークンのコンテキスト、そしてArtificial AnalysisのIntelligence Index 57を備えており、これは低価格帯だけでなく分野全体の中でもトップ近くに位置する。
メリット:
- 約束通り公開され、Hugging Faceで検証可能なオープンウェイト。
- このリストの他のモデルをはるかに上回る高い知性。
- ネイティブなビジョン対応と1Mトークンのコンテキスト。
デメリット:
- 低価格モデルではない。「オープンで有能」という意味でのみLunaの代替であり、「安い」という意味では代替にならない。
- 推論をオフにできず、デフォルトで最大限の労力をかけるため、レイテンシとトークン消費が高くなる。
価格: 1Mあたり入力$3/キャッシュヒット$0.30/出力$15。コンシューマーアプリのプランは無料から$199/月まで幅がある。もっと幅広いオープンモデルの分野については、私のKimi K2.5代替のまとめで扱っている。
私の見解: 「Lunaの代替」に本当に求めていたのが、自前でホストできるオープンで有能なモデルであるなら、Kimi K3が選択肢であり、DeepSeek V4 Flashはより安いいとこにあたる。最安の請求額を求めていたのなら、Kimiはそもそも見当違いの選択肢だ。
7. GPT-6 Sol
最適な用途: Lunaの余力が尽きたときにOpenAI内に留まりたい場合。
場合によっては、Lunaへの最良の代替は同じファミリーの一段階上のモデルだ。GPT-6 SolはOpenAIのミドルティアのGPT-6モデルで$2/$10であり、Lunaの回答が十分でなくなったものの、プロバイダーやSDK、データ契約を変えたくない、まさにその瞬間のために存在する。
OpenAI自身の位置づけは「Solで構築し、Lunaでスケールする」というもので、ベンチマークの実態も正直だ。SolのIntelligenceとCodingの指標はGPT-5.6とほぼ同水準であり、これは能力面の飛躍というよりは価格の引き下げに近い。ただし事実性の面では本物の進歩があり(OpenAIによれば、以前のSolと比べて誤りがおよそ半分になったという)。
メリット:
- Lunaと同じAPI、ツール、データ規約なので、切り替えは1行の変更で済む。
- Responses APIのフルセットのツール:ウェブ検索、コードインタープリター、ホスト型シェル、コンピュータ操作、MCP。
- 難しいタスクにおいてLunaより明確に有能で、事実性が大きく向上している。
デメリット:
- Lunaの出力価格の20倍のため、節約ではなくコスト増になる。
- FreeプランやGoプランでは使えず、Plus、Pro、Business、またはAPIが必要。
価格: 標準で1Mあたり$2入力/$10出力、BatchとFlexは50%オフ。長いコンテキストやFastモードの料金は、GPT-6 Solの価格ページ全体に記載されている。
私の見解: Solは価格で比較する人向けの代替ではなく、Lunaの品質がボトルネックになったときの自然なアップグレード先だ。解決したい問題がコストではなく精度であるときに頼るとよい。
8. Grok 4.7
最適な用途: 大規模なエージェントループの実行や、リアルタイムまたはXのデータを求めるタスク。
xAIのGrok 4.7は$2/$6とミドルティアの選択肢の中で最も高価だが、特定の仕事、つまり数時間に及ぶ長いエージェントタスク向けに作られている。4.6より新しく大きなベースモデル上で動作し、多段階の作業に重みを置いたより長い強化学習を経ており、xAI自身のエージェントハーネスをネイティブに理解する。
売り文句は「フロンティアに近い性能を、量に優しい価格で」というものだ。xAI自身の表では、強力なエージェント性能とターミナル関連のスコアを記録しているが、最高のコーディングとターミナルの座は依然としてFable 5.1のようなモデルが握っている。HealthBenchのような一部のベンチマークでは負けており、GPT-6 SolとFableの両方に上回られていることも公平に指摘しておきたい。
メリット:
- 非常に長い実行向けのContext Compaction APIを備え、長期的なエージェントタスクに強い。
- xAIのツールを通じたリアルタイムおよびXデータへのアクセス。
- Grok 4.6と同じ価格で使える有能なモデル。
デメリット:
- ここでのミドルティアの選択肢の中で最も高価であり、ロングコンテキスト料金(200Kプロンプトトークンを超えると
$4/$12)はオーバーフロー分だけでなくリクエスト内のすべてのトークンに適用される。 - コンテキストは500Kで、1Mトークンモデルより小さい。
- トークン以外の課金項目(検索、コード実行)がエージェントループの中で積み重なる。
価格: 200Kプロンプトトークン未満は1Mあたり$2入力/$6出力、それを超えると$4/$12。ツール呼び出しは別料金で、例えばウェブ検索とX検索は1,000回あたり$5だ。
私の見解: Grok 4.7は、安価なテキストタスクにおいてLunaの本当の競合とは言えない。ライブデータを必要とするような長いエージェント実行が仕事である場合の選択肢だ。単純で大量の要約や分類作業には、Lunaと比べてオーバースペックで割高だ。
実際に決め手となる2つの問い
モデル名を取り払ってしまえば、この比較全体は2つの問いに集約される。
一つ目はオープンかクローズドかだ。ここに挙げたモデルの大半はクローズドで、API経由でしか使えない。自前ホストが絶対条件であれば、候補リストは一気に絞られる。
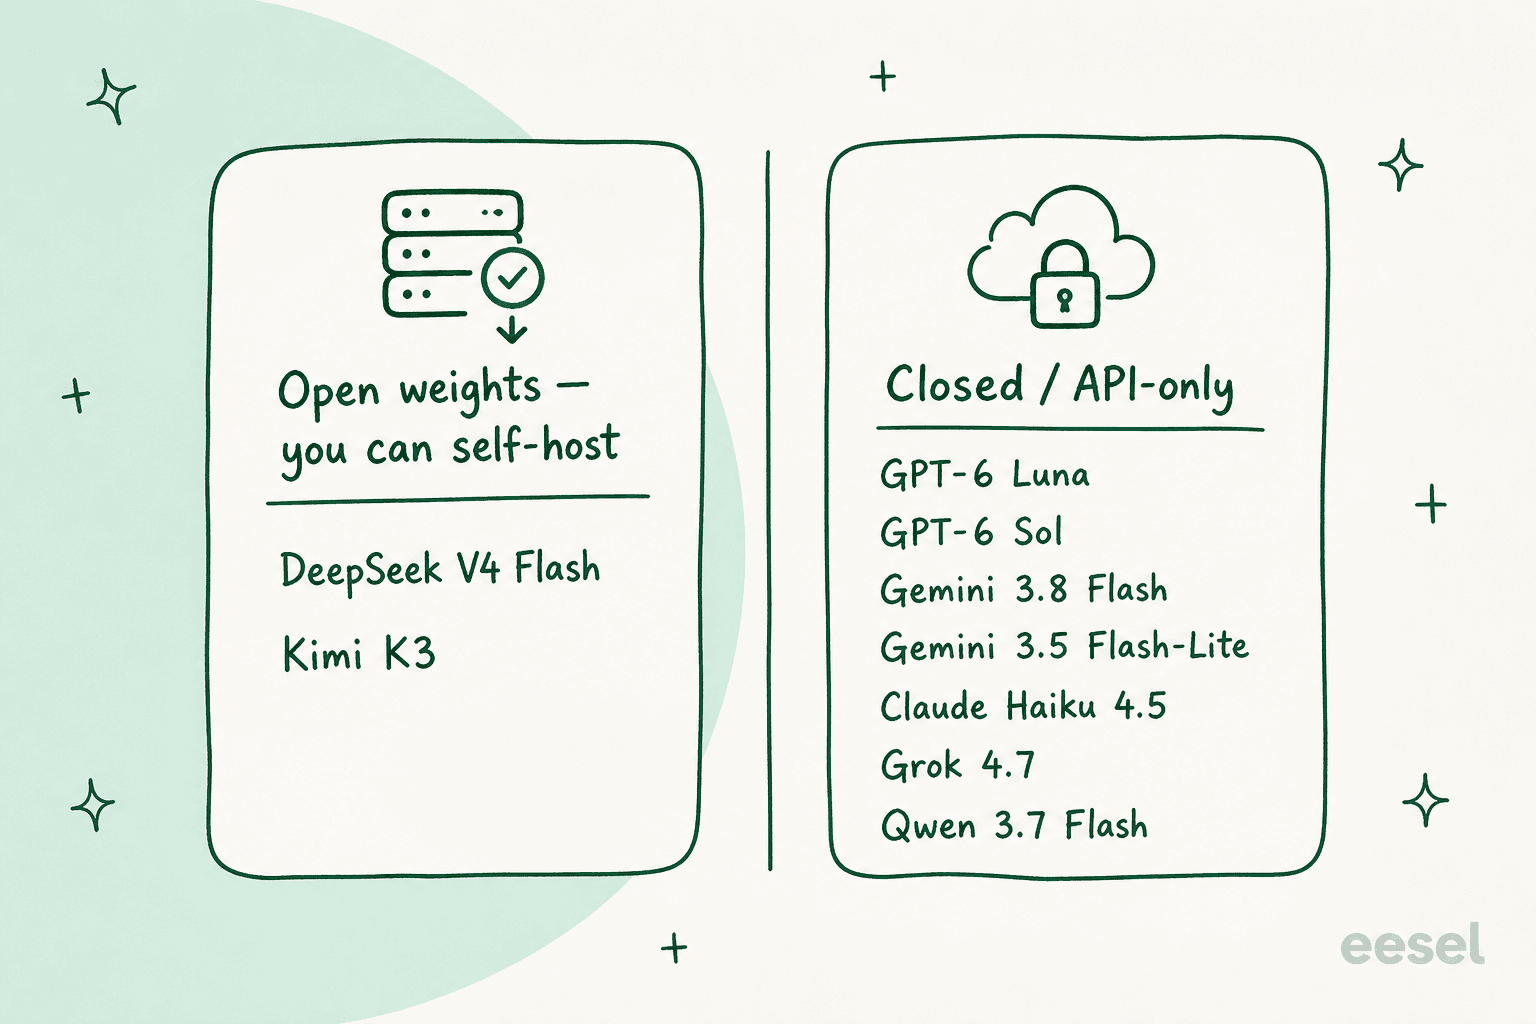
この同じトレードオフは、最良のAIエージェントを比較するときにも常に現れる。ライセンスは、ベンチマークよりも先にアーキテクチャを決めてしまう。二つ目の問いは、あらゆるスプレッドシートをつまずかせるものだ。**トークン単価が最安であることは、タスク単価が最安であることを意味しない。**Lunaの価格の3分の1で提示されていても、同じ仕事を終えるのに2倍のトークンを書き出すモデルなら、何も節約になっていない。それを知る唯一の方法は、実際のプロンプトを2つか3つの候補に通し、料金表ではなく実際の請求額を比較することだ。これは、個人利用ではChatGPTのサブスクリプションがこれらのAPI料金すべてを静かに上回ることがある理由でもある。定額の月額料金は、トークン単価という仕組みそのものを完全に迂回するからだ。
モデルだけでは解決しない部分
これは、もし自分がこの記事を読む側だったら聞きたいと思うことだ。実際に繰り返し発生する業務を動かすために安価なモデルを選ぼうとしていて、この手の記事を読む大半のチームにとってその業務がカスタマーサポートであるなら、モデル選びは仕事全体のうち簡単な10%にすぎない。
ここ数年、チームがライブのサポートキューにAIを導入する様子を見てきたが、パターンはいつも同じだ。生のモデルはトークンを入れればテキストが出てくるだけだ。顧客に安全に答えられるようになる前に、誰かがヘルプセンターを理解させる検索拡張を構築し、返金ポリシーを自信たっぷりにでっち上げないようにガードレールを整え、注文を調べられるように連携を組み、顧客より先にその挙動を把握できるようテストを行い、人間に引き継ぐべきタイミングのためのエスカレーション経路を用意しなければならない。AIコパイロット for カスタマーサービスは、これらすべてを解決する必要がある。それが残りの90%だ。
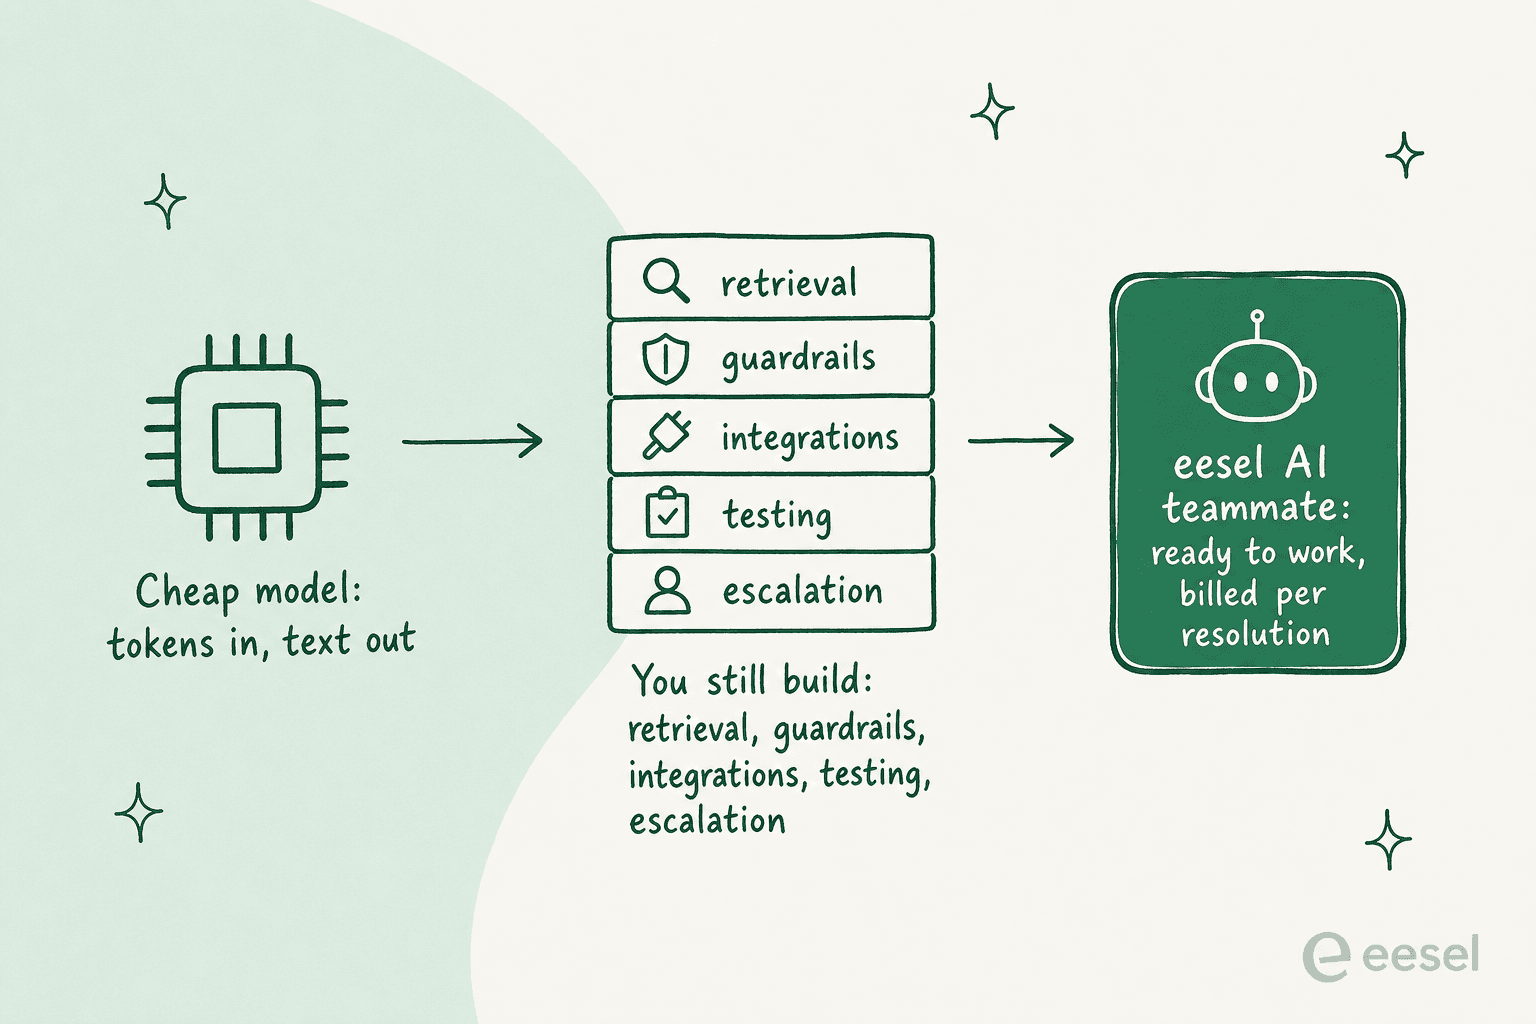
私が見てきた中で最も高くつく失敗は、安価なモデルをそのままキューに投入し、実際の顧客に自信満々の誤った回答をするのを目の当たりにしてから、ようやく足りない90%を探し始めるというチームのパターンだ。だからこそ、私が信頼できると思うすべてのロールアウトは、まず過去のチケットに対してシミュレーションされる。そうすることで、間違った回答が人に届く前にそれを見ることができる。
eesel AIを試す
ここからは、自分が作っているものについて率直に話させてほしい。上で紹介したモデルはインフラだ。eesel AIは、その上で働く従業員にあたる。モデルとパーツの寄せ集めを売るのではなく、特定の仕事のためにすぐ働けるAIチームメイトを提供している。この記事を読んでいる大半の人が求めているのは、おそらくAIヘルプデスクチームメイトだろう。

既存のキューに参加し、過去のチケットとヘルプセンターから学習し、解決件数に応じて課金されるため、燃やしたトークンではなく完了した仕事に対して支払うことになる。そして、実際のキューに触れる前に自分たちの過去のチケットに対してシミュレーションできるため、実際の顧客をどう扱ったかを事前に正確に確認できる。
これらすべてをターミナルやスクリプトから操作したい場合は、eesel CLIもある。同じチームメイトとワークスペースをエージェントフレンドリーな方法で操作できるもので、人が手動で実行することも、スクリプトが自動化することも、Claude Code、Codex、Cursorのようなコーディングエージェントが直接操作することもできる。ダッシュボードを開かなくても、ソースを接続し、指示をプッシュし、シミュレーションを開始し、実行をトリガーし、アクティビティを読み戻すことができる。生のモデルAPIを比較している理由がプログラムによるヘッドレス制御を求めているからなら、これはまさにそのために作られたインターフェースであり、その土台には、モデルが解決しない90%をすでに担っているチームメイトがいる。
eesel AIは無料で試すことができ、サポートが解決したい仕事であるなら、安価なモデルを自分で組み上げるよりもはるかに近道だ。
よくある質問
2026年におけるGPT-6 Lunaの代替候補として最も優れているのは?
GPT-6 Lunaより安価な代替モデルはあるか?
最も安いGPT-6モデルは何か?
カスタマーサポート用途に最適なGPT-6 Lunaの代替は?
GPT-6 Lunaの代替モデルにオープンウェイトのものはあるか?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.